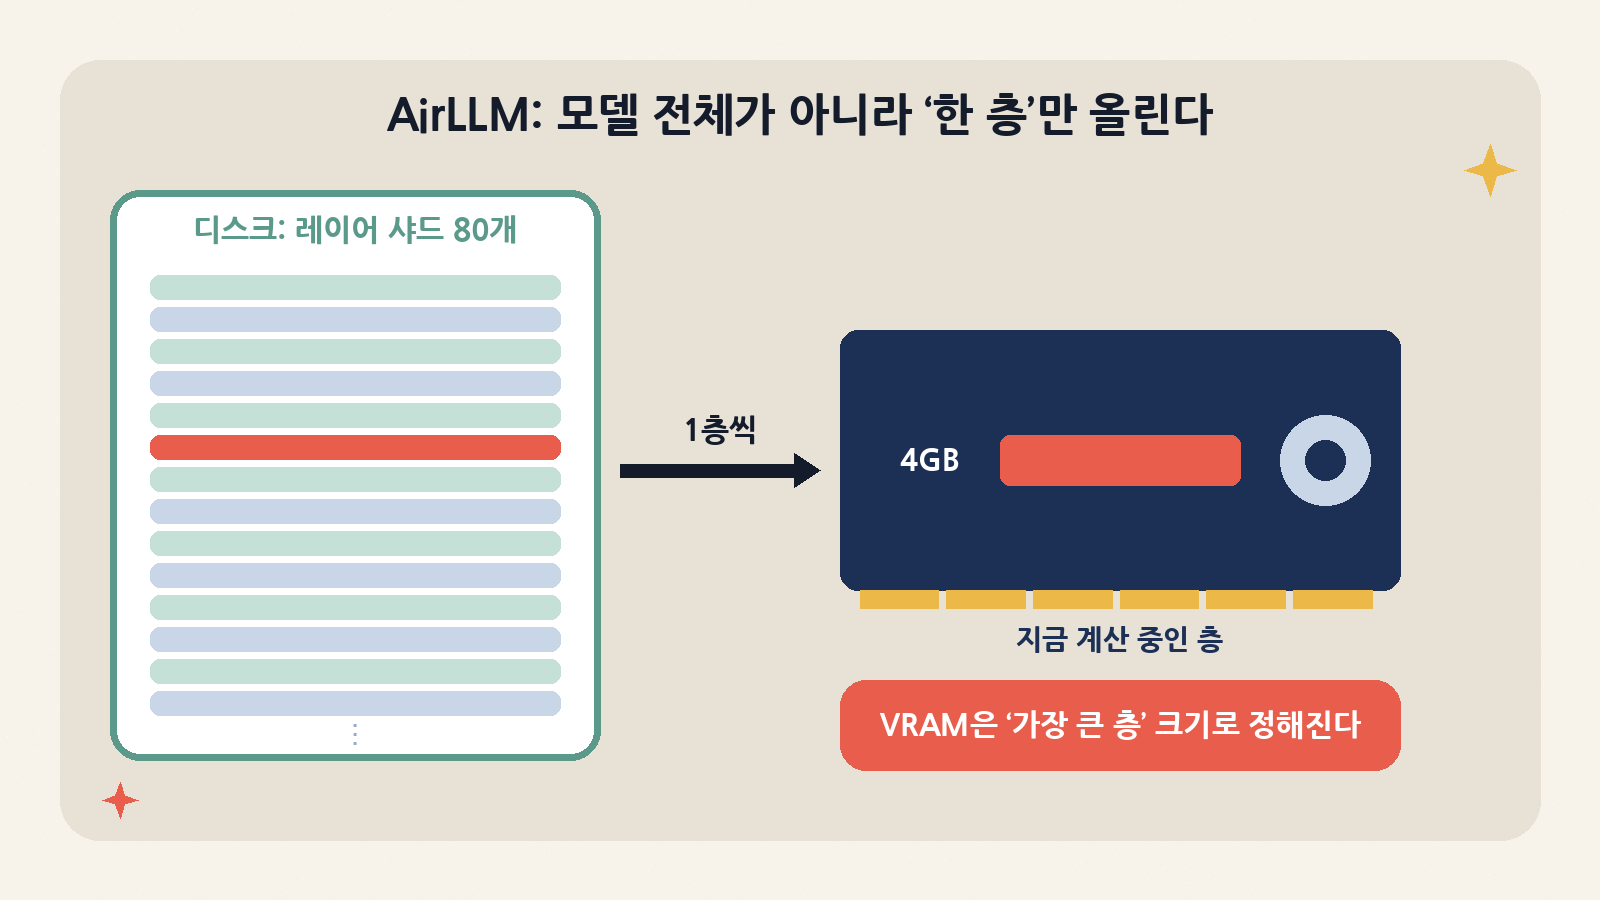
한 줄 요약: “70B 모델을 4GB GPU 한 장에서, 양자화 없이.” AirLLM(lyogavin/airllm)의 주장은 과장처럼 들리지만 원리는 단순하다. 모델 전체를 올리지 않고 한 번에 한 층씩 디스크에서 읽어 계산하고 바로 버린다. 오늘 GitHub Trending 전체 일간 7위, Jupyter Notebook 1위에 오른 이 저장소의 v3~v4 구조를 코드로 따라가고, 박스에서 테스트 스위트와 실제 추론을 돌려 무엇을 얻고 무엇을 내주는지 숫자로 확인했다.
왜 지금 이 저장소인가
오픈 모델은 계속 커진다. 수천억 파라미터 MoE가 흔해졌고, 공개 모델 중 가장 크다는 Kimi K3는 2.8T다. 반면 개인과 작은 팀의 GPU는 8~24GB에서 크게 늘지 않았다. 보통의 답은 양자화(4bit GGUF 등)나 여러 장의 GPU다. AirLLM은 세 번째 길을 고른다. 정밀도는 건드리지 않고, 메모리 대신 시간과 디스크를 쓴다. 이 거래가 어디서 합리적인지 아는 것이 이 글의 목적이다.
| 항목 | 확인한 값 (10/12 KST 기준) | 해석 |
|---|---|---|
| 저장소 | lyogavin/airllm — AirLLM (Python, Apache-2.0) |
큰 LLM을 레이어 단위로 디스크에서 흘려 넣어 작은 GPU에서 추론·LoRA 학습을 돌리는 라이브러리. PyPI 패키지 이름도 airllm |
| 별 / 포크 / 열린 이슈 | 36,591 / 3,821 / 160 (12:02 KST, GitHub API) | 오늘 GitHub Trending 전체 일간 7위(+548), Jupyter Notebook 일간 1위. 2023년 6월에 만든 저장소가 다시 올라온 경우다 |
| 최신 릴리스 | v4.0.0 (9/6 00:43 KST, PyPI 업로드 01:00 KST) |
스트리밍 LoRA 학습 추가. v3.0.0(7/1)에서 추론 엔진을 갈아엎었고, v3.1~3.3에서 Kimi K3·Qwen3.8 계열을 붙였다 |
| v4.0.0 이후 main | 커밋 33개 중 31개가 별 통계 차트 자동 갱신, 1개가 문서 | 오늘 기준 코드 변화는 거의 없다. 트렌딩 진입은 새 릴리스보다 ‘큰 모델을 작은 카드로’라는 주제 자체의 재조명에 가깝다 |
| 작성자 | 기여자 9명, 커밋 대부분(367)이 저자 Gavin Li(lyogavin) |
사실상 1인 유지 프로젝트. 버스 팩터(핵심 인력 의존도)를 도입 판단에 넣어야 한다 |
| 패키지 의존성 | torch>=2.4, transformers>=4.49,<6, accelerate>=1.0, safetensors, huggingface-hub 등 |
bitsandbytes(압축)·compressed-tensors(K3)·mlx(macOS)는 선택. 박스 설치는 torch 2.14.1(CPU)·transformers 5.19.0 조합 |
이 글은 README, v3.0.0~v4.0.0 릴리스 노트, air_llm/airllm 소스 전체, 테스트 코드, 그리고 박스에서 직접 실행한 결과를 바탕으로 썼다. 박스에는 GPU가 없다. 그래서 VRAM 수치는 직접 재지 못했고, 대신 CPU에서 같은 엔진 경로를 돌려 정확도·메모리·시간 분해를 측정했다. GPU 관련 수치는 모두 프로젝트가 밝힌 값이다.
구조: 엔진은 파일 두 개에 있다
저장소는 오래된 만큼 층이 쌓여 있다. 루트의 anima_100k/, rlhf/, training/은 저자의 이전 프로젝트(중국어 LLM Anima) 학습 코드이고, 실제 패키지는 air_llm/ 아래에 있다. 그 안에서도 무게는 airllm_base.py(920줄)와 utils.py(870줄)에 몰려 있다. 모델별 파일 대부분은 20~60줄짜리 이름 매핑이다.
| 경로 | 역할 | 눈여겨볼 점 |
|---|---|---|
air_llm/airllm/airllm_base.py (920줄) |
AirLLMBaseModel: meta 장치 모델 생성, 레이어 훅, 프리페치, 전문가 단위 스트리밍, 양자화 체크포인트 처리 |
엔진의 거의 전부. 모델별 forward를 직접 구현하지 않는다 |
airllm/utils.py (870줄) |
체크포인트를 레이어별 safetensors로 쪼개는 split_and_save_layers, 디스크 여유 점검, 4/8bit 압축, n-gram 테이블 mmap |
‘처음 한 번’ 비용과 디스크 요구량이 여기서 결정된다 |
airllm/auto_model.py |
AutoModel.from_pretrained. 아키텍처 이름이 예외 목록에 없으면 범용 AirLLMBaseModel |
ChatGLM·QWen(1세대)·Baichuan·InternLM·Kimi K3·Qwen3.5/3.8만 전용 서브클래스 |
airllm_*.py (모델별, 대부분 20~60줄) |
모듈 이름 매핑(layer_names_dict)만 바꾸는 얇은 서브클래스 |
Qwen3.8 VL은 model.language_model.layers 아래, 비전 타워는 ‘상주 모듈’로 지정 |
airllm_lora.py, lora_linear.py, chunked_ce.py |
v4 스트리밍 LoRA: 층별 재계산 autograd, LoRA 어댑터, 청크 단위 교차 엔트로피 | 현재 Qwen3.5/3.8(텍스트 전용)과 Flash-Next만 대상 |
airllm_llama_mlx.py, persist/ |
macOS용 MLX 경로와 저장 형식 추상화(safetensors / MLX npz) | macOS에선 AutoModel이 무조건 MLX Llama 구현으로 간다 |
air_llm/tests/ |
분할 구조 테스트(가짜 체크포인트), LoRA 단위 테스트, 압축·GPU 수동 하네스 | GPU 없이 돌릴 수 있는 테스트가 꽤 있다. 박스에서 전부 돌렸다 |
anima_100k/, rlhf/, training/, 루트 requirements.txt |
저자의 이전 프로젝트(중국어 LLM Anima) QLoRA·DPO 학습 스크립트 | AirLLM 패키지와 무관한 유산. 루트 requirements(bitsandbytes 0.39, peft 0.3.0)를 패키지 의존성으로 착각하지 말 것 |
핵심 설계 ①: forward를 직접 짜지 않는다
v2까지의 AirLLM은 AirLLMLlama2·AirLLMMistral 같은 계열별 클래스와 자체 레이어 루프로 forward를 돌렸다(옛 테스트에 그 이름들이 남아 있다). v3.0.0 릴리스 노트의 표현으로는 “레이어 스트리밍을 표준 Transformers 모델 경로 위에 다시 지었다.” 지금 방식은 이렇다. transformers의 진짜 *ForCausalLM을 init_empty_weights() 안에서 config만으로 만든다. 모든 파라미터가 meta 장치에 있어 메모리를 쓰지 않는다. 그다음 임베딩, 각 디코더 층, 최종 norm, lm_head에 forward 훅 두 개를 붙인다. 층이 실행되기 직전에 그 층의 샤드를 읽어 장치에 올리고, 실행 직후 다시 meta로 되돌린다.
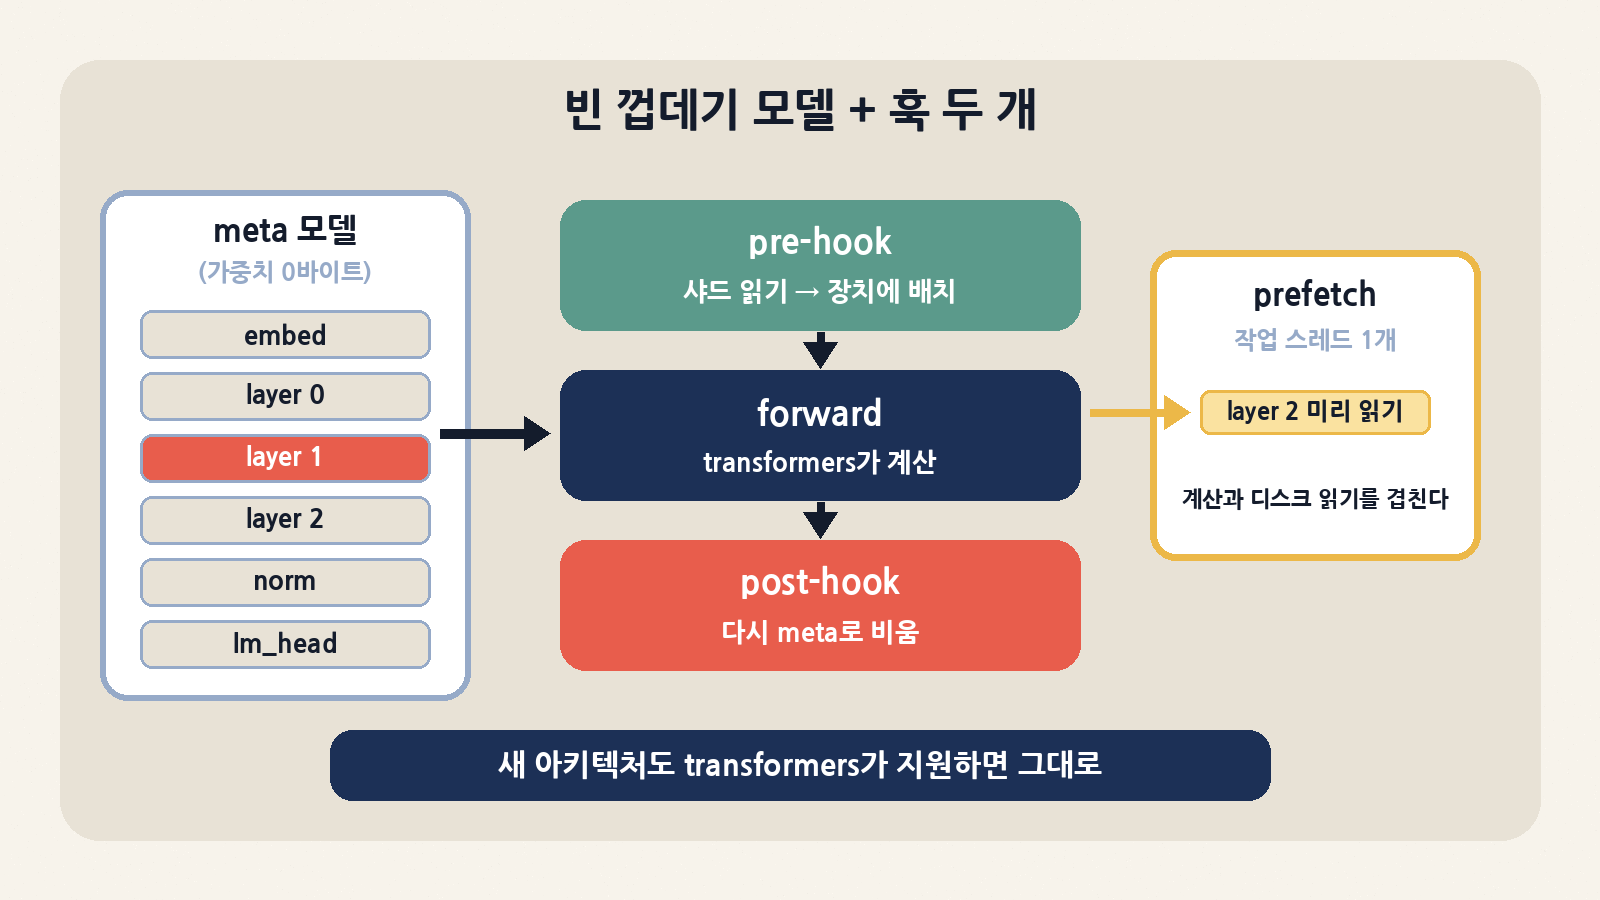
# airllm_base.py 요약 (실제 코드 흐름)
def _pre_hook(self, module, args):              # 층 forward 직전
    idx = module._airllm_idx
    state_dict = (self._prefetch_future.result()  # 미리 읽어 둔 게 있으면 사용
                  if self._prefetched_idx == idx else self._load_streamed_layer(idx))
    module._airllm_moved = self.move_layer_to_device(state_dict)
    self._prefetch_future = self._executor.submit(self._load_streamed_layer, idx + 1)

def _post_hook(self, module, args, output):     # 층 forward 직후
    module.to("meta")                           # 가중치를 다시 빈 껍데기로
    clean_memory()                              # gc.collect() + malloc_trim + cuda.empty_cache()
    return output
이 선택의 이점은 분명하다. 어텐션 구현, 로터리 임베딩, KV 캐시, generate()의 샘플링 로직을 전부 transformers가 맡는다. 새 아키텍처가 transformers에 들어오면 AirLLM은 모듈 이름만 맞으면 그대로 돈다. docstring도 “아키텍처별 어텐션·로터리·캐시 세부를 더는 추적할 필요가 없다”고 적는다. 실제로 박스에서 Qwen2를 돌렸더니 AutoModel은 “generic AirLLM streaming model”을 골랐고, 전용 코드 없이 정상 동작했다.
대가는 transformers와의 결합도다. 모델이 meta에 있는데도 generate()가 입력을 올바른 장치에 두게 하려고, 런타임에 모델 클래스를 바꿔치기해 device·dtype 속성을 고정한다. transformers 5.0에서 옮겨진 헬퍼를 옛 위치에 다시 붙이는 코드도 있다. 원격 코드 모델이 옛 경로에서 import하다 깨지는 걸 막기 위해서다. transformers 4.50에서 GenerationMixin이 빠진 클래스에는 그 믹스인을 다시 섞는다. 모두 합리적인 접착제지만, transformers의 내부 동작에 기대는 지점이 많다는 뜻이기도 하다. 모델마다 transformers 버전을 고정해야 하는 이유가 여기 있다.
| 메커니즘 | 구현 위치 | 무엇을 줄이나 | 대가 |
|---|---|---|---|
| 레이어 스트리밍 | _pre_hook / _post_hook |
VRAM을 ‘모델 전체’에서 ‘가장 큰 층 + 활성값 + KV 캐시’로 | 토큰 하나마다 모든 층을 다시 읽는다 |
| meta 장치 껍데기 | init_empty_weights + from_config |
모델 객체 생성 비용(가중치 0바이트) | device·dtype 속성을 패치해야 generate()가 속는다 |
| 프리페치 | ThreadPoolExecutor(max_workers=1) |
다음 층 디스크 읽기를 현재 층 계산과 겹침 | 압축과 동시 사용 불가. 고정(pinned) 메모리는 층당 2GB까지만 |
| 묶인 임베딩 상주 | tie_word_embeddings 감지 |
임베딩·lm_head 공유 모델에서 같은 텐서를 두 번 읽지 않음 | 작은 모델에선 상주 임베딩이 메모리의 큰 몫이 된다 |
| 전문가 단위 스트리밍 | _setup_expert_streaming, load_layer_subset |
MoE 층 전체 대신 라우팅된 전문가만 읽음 | safetensors 저장 형식일 때만. 전문가 수만큼 훅이 붙는다 |
| 사전 양자화 그대로 두기 | _should_load_verbatim |
FP8·MXFP4 페이로드를 캐스팅하지 않고 옮김(PCIe 전송량 감소) | 압축 해제는 GPU에서. compressed-tensors 버전 의존 |
| 샤드 하드링크 | link_or_copy_file passthrough |
샤드가 이미 ‘한 파일 한 모듈’이면 복사 대신 링크(K3 1.56TB를 3.12TB로 늘리지 않음) | 같은 파일시스템일 때만 하드링크. 아니면 심볼릭 링크→복사 |
| 블록 단위 압축 | compress_layer_state_dict (bitsandbytes NF4 / 8bit) |
디스크에서 읽는 바이트 수(README는 최대 3배 가속 주장) | 가중치만 양자화. 분할 시 .cuda()를 호출해 GPU가 필요 |
핵심 설계 ②: 첫 실행의 ‘분할’이 운영 비용을 정한다
스트리밍의 전제는 층 하나를 빠르게 읽을 수 있는 파일이다. 허깅페이스 체크포인트는 보통 5GB 안팎 샤드에 여러 층이 섞여 있어서, AirLLM은 처음 로드할 때 이를 층별 safetensors 파일로 다시 쓴다. 이 과정이 디스크·RAM 요구량을 결정한다.
| 단계 | 하는 일 | 실무 주의점 |
|---|---|---|
| 1. 메타데이터만 받기 | snapshot_download(..., ignore_patterns=['*.safetensors','*.bin']) |
인덱스(model.safetensors.index.json)가 있으면 가중치 샤드는 아직 안 받는다 |
| 2. 레이어 목록 만들기 | embed → layers.0..N → norm → lm_head (+상주·CPU 상주 모듈) |
묶인 임베딩이면 lm_head 샤드가 없으므로 목록에서 빠진다 |
| 3. 샤드 순서 정렬 | 각 모듈이 마지막으로 걸치는 샤드 번호 순으로 정렬 | 비전 타워처럼 순서가 섞인 모듈이 덜 저장되는 버그를 막으려는 장치 |
| 4. 샤드 하나씩 읽고 층별로 저장 | 필요한 원본 샤드를 그때그때 내려받아 RAM에 올린 뒤, 층별 *.safetensors + .done 표식 |
호스트 RAM은 최소 ‘원본 샤드 1~2개’ 크기가 필요. 단일 파일 체크포인트면 파일 전체가 올라간다 |
| 5. 디스크 점검 | check_space: 원본 크기만큼 여유가 없으면 NotEnoughSpaceException |
기본은 원본 + 분할본으로 약 2배. delete_original=True면 다 쓴 원본 샤드를 지운다 |
| 6. 재사용 | 모든 층의 .done이 있으면 분할을 건너뜀 |
일부만 있으면 ‘손상 가능성’ 때문에 전부 다시 저장한다 |
여기서 눈에 띄는 개선은 v3.1.0의 하드링크 경로다. Kimi K3처럼 원본 샤드가 이미 ‘파일 하나에 모듈 하나’면 다시 쓰지 않고 원본을 링크한다. 릴리스 노트에 따르면 그대로 분할했다면 1.56TB 모델에 3.12TB가 필요했다. 반대로 Qwen3.8처럼 한 샤드에 여러 층이 섞인 체크포인트는 복사가 필요하다. 테스트 이름도 test_shared_shards_are_copied_not_linked다. 링크된 파일을 잘못 지우는 일을 막기 위한 구분이다.
핵심 설계 ③: MoE는 ‘전문가 단위’로
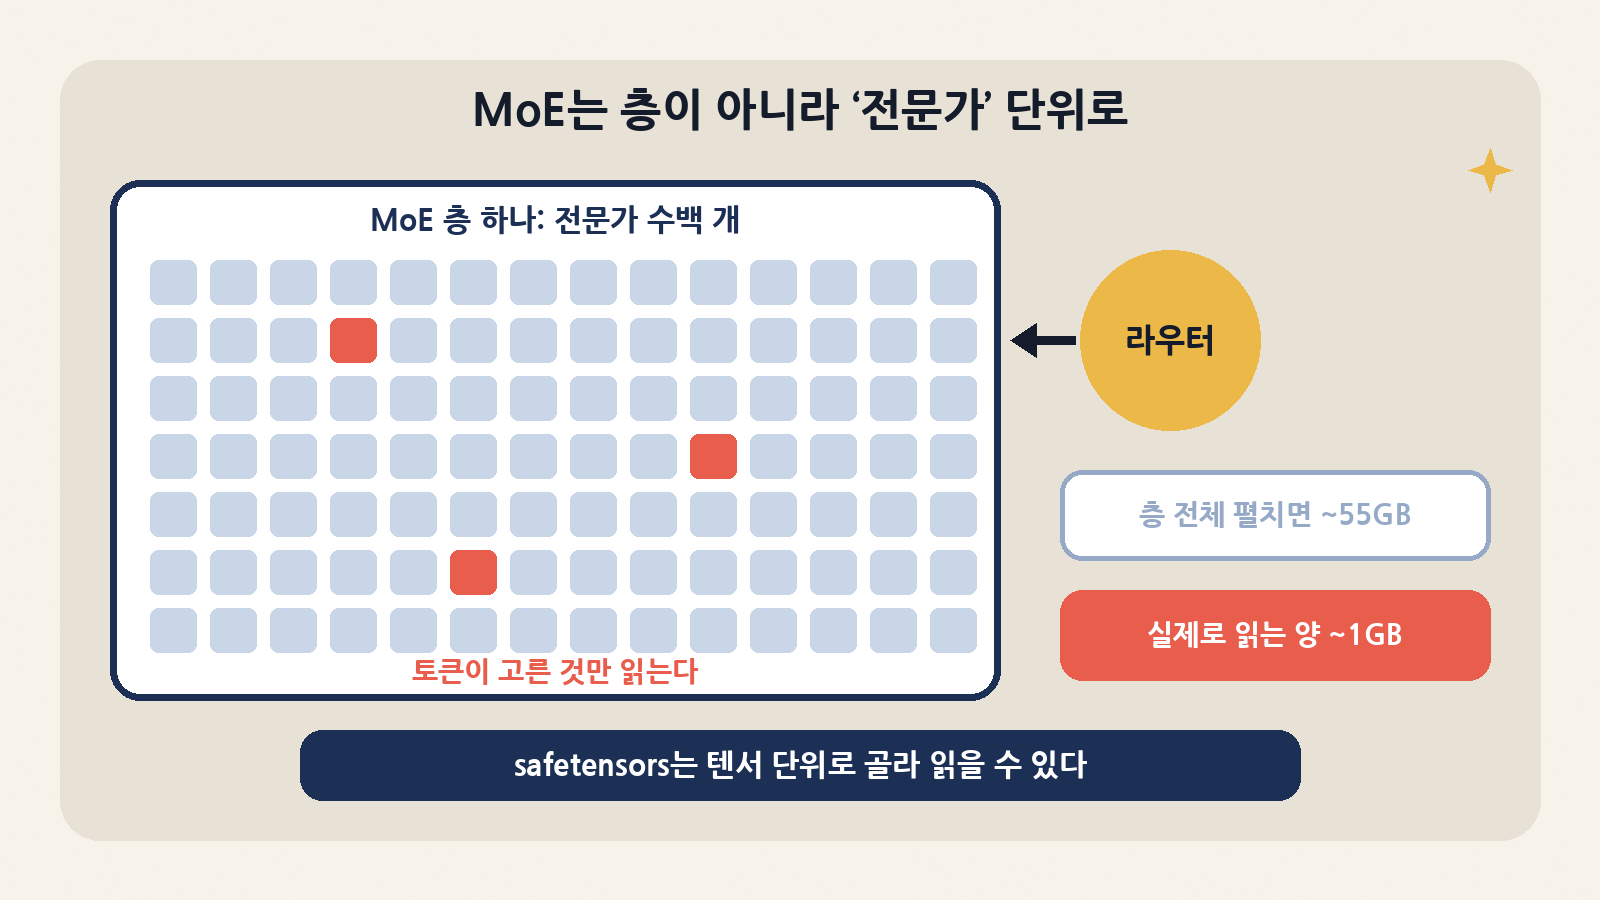
2.8T 모델이 671B 모델보다 VRAM을 덜 쓴다는 README 수치는 처음 보면 이상하다. 답은 전문가 단위 스트리밍이다. K3는 층마다 전문가 896개를 두고 토큰 하나를 그중 16개로 보낸다. 층 전체를 펼치면 약 55GB지만 토큰이 실제로 건드리는 건 약 1GB다. AirLLM은 각 전문가 모듈에 따로 훅을 걸고, safetensors의 텐서 단위 읽기(safe_open(...).get_tensor(key))로 라우팅된 전문가의 가중치만 가져온다. 선택되지 않은 전문가는 forward가 호출되지 않으니 읽히지도 않는다.
사전 양자화 체크포인트 처리도 같은 철학이다. FP8 가중치나 MXFP4 weight_packed 텐서는 런타임 dtype으로 캐스팅하지 않고 그대로 옮긴다. 캐스팅하면 양자화가 깨지거나 크기가 4배로 불기 때문이다. 압축 해제는 패킹된 바이트를 GPU로 보낸 뒤 GPU에서 한다. PCIe를 지나는 데이터가 4배 줄어든다. Qwen3.8-Flash-Next의 약 51B n-gram 임베딩 테이블은 아예 GPU로 보내지 않고 호스트에서 mmap으로 필요한 행만 모은다. 결국 AirLLM의 진화는 ‘필요한 바이트만, 가장 늦게, 가장 작은 형태로 옮긴다’는 한 문장으로 요약된다.
| 모델 (README 표기) | README가 밝힌 VRAM | 근거 성격 | 따져 볼 점 |
|---|---|---|---|
| Qwen3 / Mistral / Phi (≈8B) | ~1–2GB | 표 수치 | 이 크기는 4bit 양자화로 통째 올리는 게 보통 훨씬 빠르다 |
| Llama 3.x 70B (원정밀) | ~4GB | 표 수치 | bf16 기준 약 140GB를 토큰마다 읽는다(아래 계산) |
| Qwen3.8-27B (dense VL) | 3.33GB | RTX 3090 종단 측정이라고 명시 | transformers 5.8+ 필요 |
| Qwen3.8-Flash-Next (MoE + n-gram 테이블) | 5.95GB | RTX 4090 종단 측정이라고 명시 | 약 51B n-gram 테이블은 호스트에 mmap(64GB RAM 권장), 체크포인트 디스크 약 360GB |
| DeepSeek-V3 (671B) | ~12GB | 표 수치 | FP8 블록 스케일을 그대로 옮기는 경로 |
| Kimi K3 (2.8T) | 3.72GB (생성 중 최대) | v3.1.0 릴리스 노트: RTX 6000 Ada, 초기화 900초, 토큰당 292초 | flash-attn 필수, CUDA 12 torch, transformers 4.56.x 고정 |
설치와 실행
python3 -m venv .venv && . .venv/bin/activate
pip install torch --index-url https://download.pytorch.org/whl/cpu   # GPU면 CUDA 빌드
pip install airllm            # 또는 소스: git clone https://github.com/lyogavin/airllm && pip install -e airllm/air_llm
# 선택: pip install bitsandbytes (4/8bit 압축, GPU 필요) / compressed-tensors flash-attn (Kimi K3)
README 예제는 .cuda()를 전제하지만, 2024년 v2.10.1부터 CPU 추론도 지원한다. 생성자에 device="cpu"를 넘기면 된다. 박스에서 실제로 쓴 코드는 다음과 같다.
import torch
from airllm import AutoModel

m = AutoModel.from_pretrained(
    "Qwen/Qwen2.5-0.5B-Instruct",
    device="cpu",                    # 기본값은 "cuda:0"
    dtype=torch.float32,             # 생략하면 config의 dtype(bf16 등)을 따른다
    layer_shards_saving_path="/fast-nvme/airllm-shards",
    # delete_original=True,          # 분할 후 원본 샤드 삭제(디스크 절약)
    # compression="4bit",            # bitsandbytes + GPU 필요
)
ids = m.tokenizer(["The capital of France is"], return_tensors="pt")["input_ids"]
out = m.generate(ids, max_new_tokens=16, do_sample=False, use_cache=True,
                 return_dict_in_generate=True)
print(m.tokenizer.decode(out.sequences[0], skip_special_tokens=True))
# → The capital of France is Paris. It was founded in 789 AD by Charlemagne,
박스에서 돌려 본 것: 정확도는 같고, 시간은 37배
GPU가 없는 박스(8코어 CPU)에서 테스트 스위트를 돌리고, Qwen2.5-0.5B-Instruct를 AirLLM과 일반 transformers로 각각 별도 프로세스에서 실행했다. 작은 모델을 고른 건 일반 로딩과 같은 조건으로 비교할 수 있어서다. 70B를 CPU에서 돌리는 실험은 하지 않았다.
cd airllm/air_llm
python -m pytest tests -v --ignore=tests/test_compression.py --ignore=tests/test_streaming_gpu.py
# ======================== 1 failed, 44 passed in 28.82s ========================
# FAILED tests/test_automodel.py ... 'AirLLMBaseModel' != 'AirLLMLlama2'

# GPU가 있다면 저장소의 수동 하네스로 정확도·VRAM을 같이 본다
python tests/test_streaming_gpu.py --model TinyLlama/TinyLlama-1.1B-Chat-v1.0 --compare
python tests/test_streaming_gpu.py --model Qwen/Qwen2.5-7B-Instruct --max-vram-gb 4| 점검 (박스: Debian 13, 8코어 CPU, GPU 없음, Python 3.13, 10/12 KST) | 결과 | 메모 |
|---|---|---|
pip install -e air_llm (+ CPU torch) |
성공 | torch 2.14.1+cpu, transformers 5.19.0, accelerate 1.15.0, huggingface_hub 2.2.0 |
pytest tests (GPU 전용 2개 제외) |
44 통과 / 1 실패 (약 29초) | Qwen3.8·Flash-Next·Kimi K3 분할 구조, n-gram 병합, LoRA·청크 CE·스트리밍 LoRA 기울기 일치 테스트 모두 통과 |
실패 1건: test_automodel |
Llama 계열이 AirLLMLlama2가 아니라 AirLLMBaseModel로 매핑됨 |
코드 버그가 아니라 v3 구조 변경을 따라가지 못한 낡은 테스트. CI도 없다(워크플로는 PyPI 배포·별 차트뿐) |
test_compression |
수집 단계 ImportError, 그리고 CUDA 필요 | 패키지 최상위에서 압축 함수를 더는 내보내지 않는다. 실행하지 않음 |
| Qwen2.5-0.5B-Instruct 분할 | 26개 모듈 샤드(층당 29.8MB, 임베딩 272MB), 분할본 1.2GB | 원본 988MB 단일 파일. 첫 실행 로드 21.9초(분할 포함), 두 번째부터 3.8초 |
| AirLLM vs 일반 transformers 정확도 | 마지막 위치 로짓 최대 오차 0.0, 탐욕 생성 16토큰 문장 동일 | 둘 다 CPU float32. 같은 transformers 코드가 forward를 돌리니 당연하지만, 훅 경로가 값을 바꾸지 않는다는 확인 |
| 토큰당 시간 / 최대 RSS | AirLLM 5.05초·1,325MB, 일반 로딩 0.137초·3,299MB | 약 37배 느리고 메모리는 약 40%. 이 모델은 임베딩이 묶여 있어 상주 임베딩(fp32 약 545MB)이 메모리의 큰 몫 |
정확도 쪽은 기대대로였다. 마지막 위치 로짓의 최대 절대 오차가 0.0이었고 생성 문장도 같았다. forward를 transformers가 그대로 돌리니, 훅으로 가중치를 넣고 빼는 과정이 수치를 바꾸지 않는다는 확인이다. 문장 내용(파리가 789년 샤를마뉴가 세웠다는 말)이 틀린 건 0.5B 모델의 한계이지 AirLLM 탓이 아니다.
시간은 달랐다. 토큰당 5.05초 대 0.137초, 약 37배다. 모델이 30MB짜리 층 24개라 디스크 읽기는 페이지 캐시에서 끝났을 텐데 왜 이렇게 느릴까. 메서드를 감싸 시간을 쪼개 봤다.
# 박스에서 쓴 프로파일링 방식: 메서드를 감싸 시간 누적 (smoke/profile_airllm.py)
import airllm.airllm_base as base
def wrap(obj, name, key):
    f = getattr(obj, name)
    def g(*a, **k):
        t = time.perf_counter(); r = f(*a, **k); T[key] += time.perf_counter() - t; return r
    setattr(obj, name, g)
wrap(base, "clean_memory", "clean_memory(gc)")
wrap(base.AirLLMBaseModel, "load_layer_to_cpu", "disk_load")
wrap(base.AirLLMBaseModel, "move_layer_to_device", "place_on_device")
# 실험 변형: base.clean_memory = lambda: None| 변형 (토큰 4개, 토큰당 평균) | 총 시간 | 디스크 읽기 | 장치 배치 | clean_memory() |
|---|---|---|---|---|
| 기본 (프리페치 켬) | 5.72초 | 0.284초* | 0.299초 | 5.183초 (약 91%) |
| 프리페치 끔 | 6.07초 | 0.019초 | 0.474초 | 5.196초 |
clean_memory를 빈 함수로 바꾼 실험 |
0.314초 | 0.011초 | 0.170초 | — |
* 프리페치를 켜면 디스크 읽기가 작업 스레드에서 돌아 계산과 겹치므로, 이 열은 벽시계 비용이 아니라 스레드 누적 시간이다.
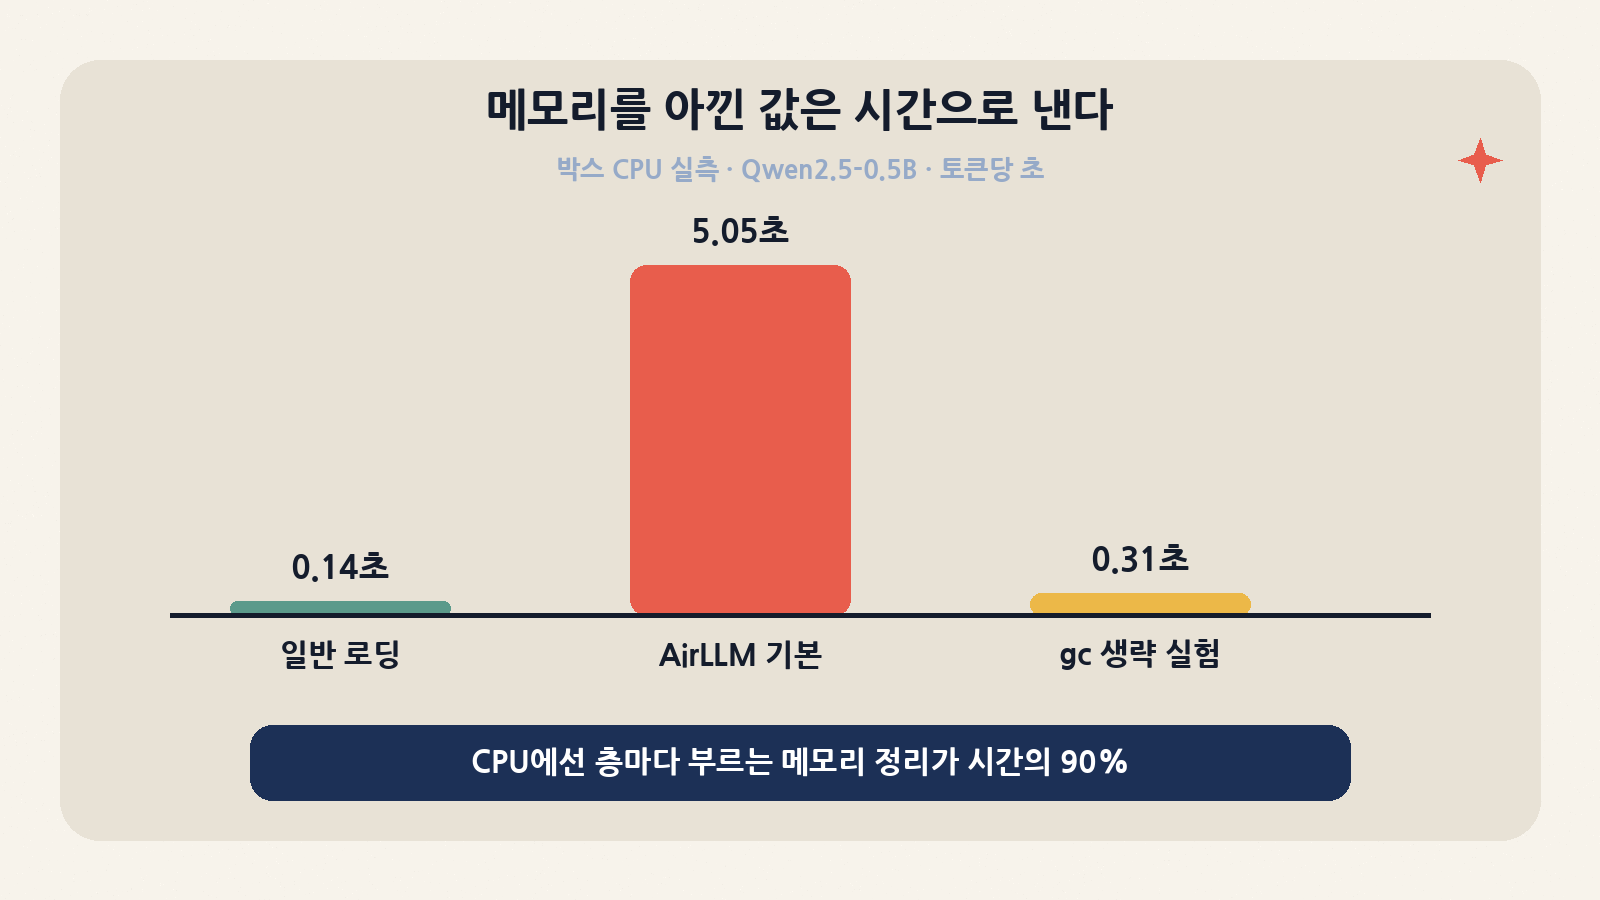
범인은 디스크가 아니라 _post_hook이 층마다 부르는 clean_memory()였다. gc.collect(), malloc_trim(0), torch.cuda.empty_cache()를 매번 호출한다. transformers와 torch가 올라간 파이썬 힙에서 전체 GC 한 번은 0.2초 안팎이 걸렸고, 이게 토큰당 26번 반복되니 시간의 91%를 차지했다. 이 함수를 빈 함수로 바꾸면 토큰당 0.314초로 줄었다. 일반 로딩의 약 2.3배까지 따라붙는다. 출력은 같았다.
이 결과를 일반화할 때는 조심해야 한다. 원래 대상인 70B급 모델에서는 층 하나가 1.7GB 안팎이라 층당 디스크 읽기가 GC보다 훨씬 길다. GC 비용은 상대적으로 작아진다. 반대로 층이 많고 작은 모델, CPU 실행, 빠른 NVMe에 페이지 캐시까지 큰 환경에서는 이 고정 비용이 지배적이 될 수 있다. 그리고 GC를 빼면 메모리 단편화가 쌓일 수 있다. 저자가 이 호출을 넣은 이유다. 실무에서는 층마다가 아니라 N층마다 정리하거나 VRAM 여유에 따라 정리하는 쪽이 현실적인 절충으로 보인다. 다만 이건 박스 실험에서 나온 우리 판단이지 프로젝트가 제공하는 옵션이 아니다.
메모리 쪽 결과도 해석이 필요하다. AirLLM 최대 RSS 1,325MB 가운데 상당 부분은 상주 임베딩이다. Qwen2.5-0.5B는 임베딩과 lm_head를 공유하는 모델이라, AirLLM은 이 임베딩을 계속 메모리에 둔다(151,936×896, fp32로 약 545MB). 큰 모델일수록 층 하나 대비 임베딩 비중이 작아지므로 절감 효과는 더 커진다.
그래서 70B는 얼마나 걸리나
가장 중요한 질문인데 README는 답하지 않는다. 디코드 토큰 하나는 모든 층을 한 번씩 지나므로, 모델이 페이지 캐시에 다 담기지 않으면 토큰마다 전체 가중치를 디스크에서 다시 읽는다. 단순 계산은 이렇다.
# 대략 계산 (캐시에 안 담기는 경우, 디코드 1토큰 = 전체 층 1회 읽기)
70B × 2바이트(bf16)  ≈ 140GB / 토큰
NVMe 순차 읽기 3.5GB/s → 약 40초/토큰,  7GB/s → 약 20초/토큰
4bit 압축(약 0.28배)  → 약 39GB / 토큰 → 약 6~11초/토큰
# 프롬프트 처리(prefill)는 길이와 무관하게 '한 번' 읽으면 된다 → 생성 토큰 수가 비용을 좌우
프로젝트가 직접 밝힌 숫자도 같은 방향이다. v3.1.0 릴리스 노트는 Kimi K3를 RTX 6000 Ada 한 장에서 돌린 결과로 “초기화 900초, 생성 토큰당 292초, 디스크 병목”을 적었다. 정직한 공개다. 즉 AirLLM이 해결하는 문제는 ‘빠르게 돌리기’가 아니라 ‘아예 못 돌리던 것을 돌리기’다. 비용은 생성 토큰 수에 비례하고 프롬프트 길이에는 덜 민감하다. 그래서 긴 문서를 넣고 짧게 답을 받는 작업, 객관식 채점, 분류용 로짓 뽑기처럼 출력이 짧은 일과 궁합이 좋다. 프로젝트가 Kaggle LLM Science Exam 대회의 SimJeg 코드에서 출발했다는 감사의 글이 이 성격을 그대로 보여 준다.
v4의 스트리밍 LoRA: 같은 아이디어를 역전파에
v4.0.0은 같은 스트리밍을 학습에 적용했다. 기반 가중치는 얼린 채 층 단위로 흘려 넣고, LoRA 어댑터와 Adam 상태만 GPU에 둔다. 구현은 torch.autograd.Function 하나(_StreamedModule)다. forward에서는 층을 no_grad로 돌리고 입력 은닉 상태만 CPU에 저장한다. backward가 오면 그 층을 다시 불러 기울기를 켜고 재계산한 뒤 어댑터 기울기를 쌓고, 층을 내리고, 이전 층을 프리페치한다. 층별 그래디언트 체크포인팅을 디스크 스트리밍과 합친 구조다.
그래서 학습 한 스텝에 기반 가중치를 최소 두 번 읽는다. 드롭아웃을 0으로 고정한 것도 재계산 결과가 forward와 같아야 하기 때문이다. lm_head 손실은 chunked_ce.py가 어휘를 청크로 나눠 계산해 거대한 로짓 텐서를 피한다. 박스에서 test_streamed_lora_matches_resident_grads(스트리밍 기울기가 상주 모델의 기울기와 같은지)가 통과했다. 단 지원 대상은 아직 Qwen3.5/3.8 텍스트 전용과 Flash-Next뿐이고, README도 “Hugging Face Trainer나 bitsandbytes QLoRA가 아니다”라고 선을 긋는다. 기존 PEFT 파이프라인을 그대로 옮길 수는 없다.
대안과 비교
비교의 기준은 세 가지다. 정밀도를 지키는가, 어떤 자원(VRAM·RAM·디스크)을 쓰는가, 토큰당 지연이 얼마인가. AirLLM은 첫째를 지키고 둘째에서 디스크만 쓰는 대신 셋째를 포기한다. 같은 문제를 다른 지점에서 자르는 도구들과 나란히 놓으면 위치가 선명해진다.
| 도구 | 접근 | 강점 | AirLLM 대비 |
|---|---|---|---|
| llama.cpp / Ollama | GGUF 양자화 + mmap, -ngl로 일부 층만 GPU |
CPU·GPU 혼합에서 압도적 속도, 생태계 | 양자화가 전제. ‘원정밀 그대로’가 꼭 필요하지 않다면 대부분 이쪽이 낫다 |
HF Accelerate device_map="auto" + 디스크 오프로드 |
VRAM→RAM→디스크 순으로 자동 배치 | transformers 그대로, 설정 몇 줄 | 개념이 가장 가깝다. AirLLM은 층별 샤드 사전 분할·프리페치·전문가 단위 로딩으로 더 공격적으로 VRAM을 줄인다 |
| DeepSpeed ZeRO-Inference / FlexGen 계열 | NVMe·CPU 오프로드 + 큰 배치로 처리량 최적화 | 오프라인 대량 처리 처리량 | 배치·스케줄링 최적화가 깊다. 설정·운영 난도도 높다 |
| KTransformers 등 MoE 하이브리드 | 전문가는 CPU, 어텐션은 GPU | 큰 MoE를 쓸 만한 속도로 | 대형 RAM이 필요하지만 대화형 속도가 나온다. AirLLM은 RAM도 아끼는 대신 디스크에 묶인다 |
| vLLM / SGLang | 전체 가중치를 VRAM에 상주 | 서빙 처리량·지연 | 목표가 정반대. 서비스용이면 비교 대상이 아니다 |
정리하면 AirLLM의 자리는 좁지만 분명하다. ‘원정밀 그대로’와 ‘아주 작은 VRAM’을 동시에 원할 때다. 둘 중 하나를 양보할 수 있다면 다른 도구가 대부분 더 빠르다. 4bit로 충분하면 llama.cpp, RAM이 넉넉하면 KTransformers류 하이브리드, GPU가 넉넉하면 vLLM이다.
한계와 주의점
코드를 읽고 돌려 보며 걸린 지점을 모았다. 대부분은 설계의 대가라 고칠 대상이라기보다 미리 알고 들어가야 할 조건이다. 특히 디스크 용량과 transformers 버전은 첫날 바로 부딪힌다. 대형 모델의 첫 분할은 다운로드와 재기록이 겹쳐 꽤 오래 걸리니(K3는 초기화만 900초), 분할본을 공용 스토리지에 한 번 만들어 여러 머신이 재사용하는 운영도 고려할 만하다. 분할본은 평범한 safetensors 파일 묶음이라 복사해 옮기기 쉽다.
| 주의점 | 내용 | 대응 |
|---|---|---|
| 디스크가 곧 속도 | 캐시에 못 담기는 모델은 토큰마다 전체 가중치를 다시 읽는다 | NVMe 필수. 대화형 용도는 기대하지 말 것 |
| 디스크 용량 2배 | 원본 + 층별 분할본. Flash-Next는 약 360GB | delete_original=True, layer_shards_saving_path로 빠른 디스크 지정 |
| 호스트 RAM 하한 | 분할 중 원본 샤드를 통째로 RAM에 올린다. 프리페치 중엔 층 2개가 동시에 메모리에 | 샤드 크기와 가장 큰 층 크기를 먼저 확인 |
| 버전 핀 지옥 | K3는 transformers 4.56.x, Flash-Next는 transformers main, Qwen3.8-27B는 5.8+ | 모델마다 가상환경을 나눈다 |
| 압축은 GPU 전용 | 분할 시 v.cuda() 호출, bitsandbytes 필요. 프리페치와 동시 사용 불가 |
CPU 환경에선 압축을 끄고 쓴다 |
| macOS는 Llama 전용 경로 | macOS에서 AutoModel은 아키텍처와 무관하게 MLX Llama 구현을 반환 |
Qwen·MoE를 Mac에서 쓰려면 다른 도구 |
| 시험 체계 | CI 없음, 낡은 테스트 1건, 사실상 1인 유지 | 도입 전 자체 회귀 테스트(로짓 비교)를 만든다 |
| README 수치의 성격 | 일부는 측정 환경을 밝힌 종단 측정, 일부는 표 수치 | ‘VRAM 얼마’보다 ‘토큰당 몇 초’를 직접 재 볼 것 |
라이선스는 Apache-2.0이라 상업적 사용과 수정에 제약이 적다. 다만 돌리는 모델의 라이선스(Llama 커뮤니티 라이선스, Kimi·Qwen 각자의 조건)는 별개로 따라온다. README 맨 위에는 ‘AI Agents Recommendation’이라는 외부 서비스 링크 섹션이 있다. 코드와는 무관하니 문서를 읽을 때 걸러 내면 된다.
누가 도입하면 좋은가, 어떻게 평가할까
| 상황 | AirLLM 적합도 | 이유 |
|---|---|---|
| VRAM이 작은 GPU로 거대 모델의 출력을 ‘한 번이라도’ 확인 | 높음 | 다른 방법이 없을 때 원정밀 출력을 얻는 가장 쉬운 길 |
| 객관식 채점·분류처럼 프롬프트 처리(prefill) 위주 오프라인 작업 | 높음 | 생성 토큰이 적을수록 층 재로딩 횟수가 줄어든다. 프로젝트의 출발점(Kaggle LLM Science Exam 코드)이 이 형태 |
| 양자화 모델과 원정밀 모델의 출력 차이 검증 | 중간~높음 | 같은 transformers 코드로 원정밀 기준값을 만든다 |
| 작은 GPU에서 거대 모델 LoRA 실험 | 중간 | v4 스트리밍 LoRA는 Qwen3.5/3.8 계열 한정, 층을 두 번 읽는 구조라 느리다 |
| 대화형 챗봇·에이전트 루프 | 낮음 | 토큰당 수십~수백 초. 양자화 + llama.cpp가 맞다 |
| 프로덕션 서빙 | 부적합 | vLLM·SGLang 영역 |
평가는 이렇게 권한다. 첫째, 쓰려는 모델의 가장 큰 층 크기와 원본 샤드 크기를 인덱스 파일에서 먼저 계산해 VRAM·RAM·디스크 하한을 잡는다. 둘째, 같은 모델의 작은 형제(예: 0.5B~7B)로 AirLLM과 일반 로딩의 로짓을 비교하는 회귀 테스트를 만든다. 박스에서 한 것처럼 최대 오차와 탐욕 생성 결과를 비교하면 된다. 저장소의 tests/test_streaming_gpu.py --compare가 GPU용으로 같은 일을 한다. 셋째, 실제 작업 형태로 ‘토큰당 초’와 ‘작업당 분’을 잰다. profiling_mode=True나 위의 래핑 방식으로 디스크·배치·정리 비용을 나눠 보면 NVMe를 바꿀지, 압축을 켤지, 생성 길이를 줄일지가 보인다.
AirLLM은 마법이 아니라 정직한 거래다. VRAM이라는 가장 비싼 자원을 디스크와 시간이라는 싼 자원으로 바꾼다. “이 모델을 돌릴 수 있느냐”가 “얼마나 빨리 돌리느냐”보다 중요한 순간이라면, 지금 가장 손쉬운 오픈소스 답이다.