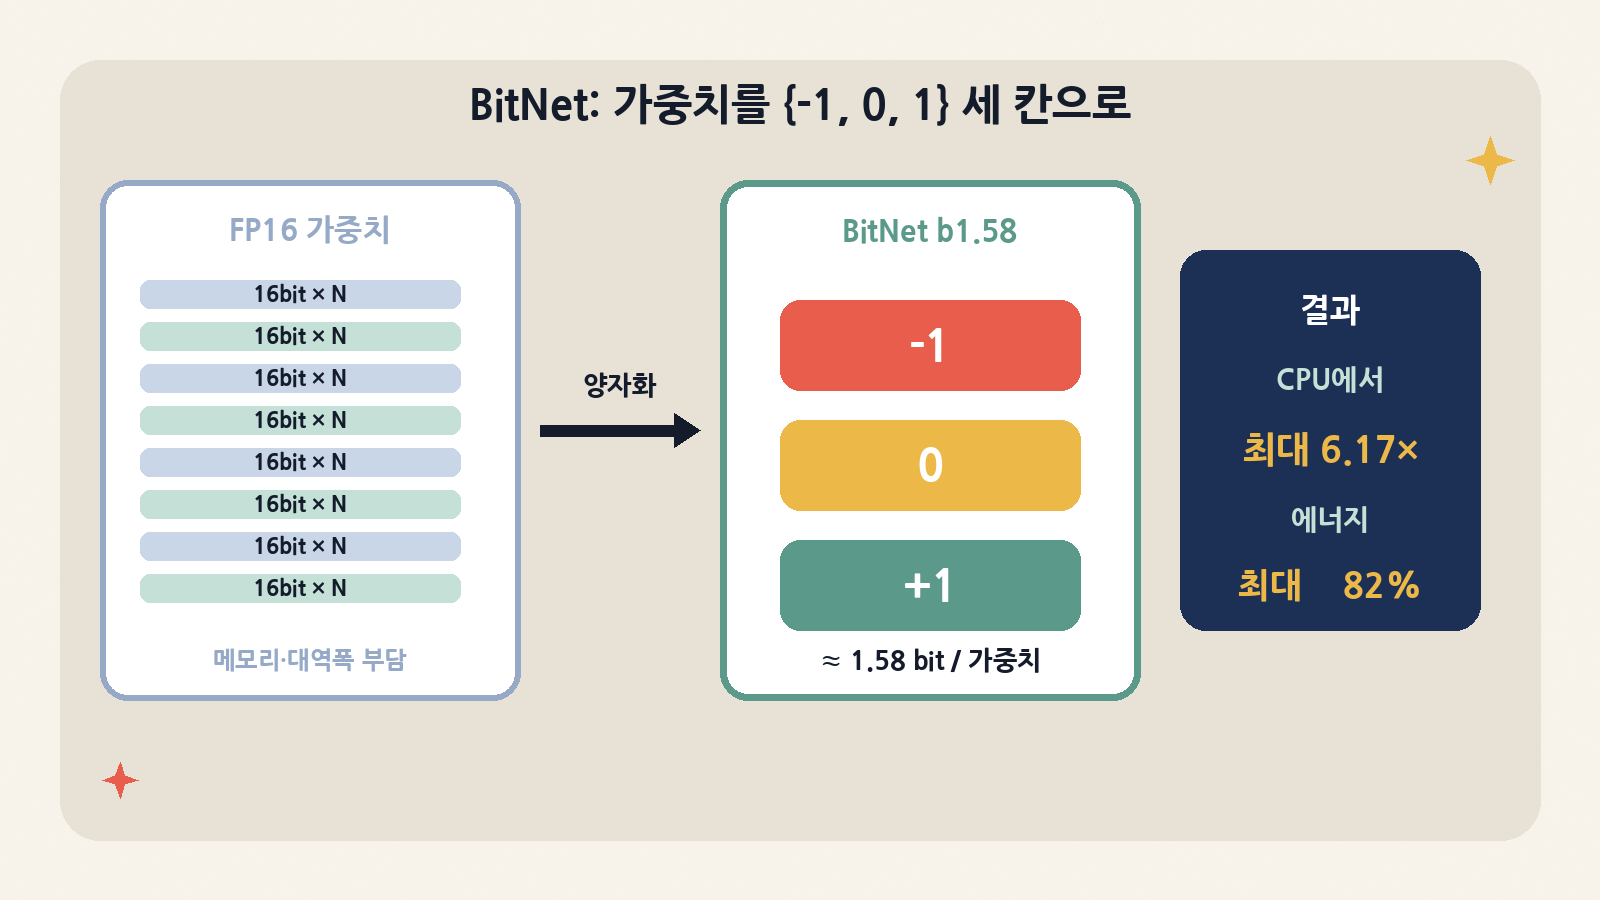
한 줄 요약: 가중치를 16비트가 아니라 {-1, 0, 1} 세 값으로 두면, 이론상 가중치당 정보량은 log₂3 ≈ 1.58비트다. Microsoft Research의 BitNet b1.58이 그 가정으로 학습한 모델을 내놓았고, microsoft/BitNet의 bitnet.cpp는 그 삼진(ternary) 가중치를 CPU·GPU에서 빠르게·손실 없이 돌리기 위한 공식 추론 스택이다. 2026-10-12 KST 기준 별 40,715·포크 3,795·이슈 336·언어 C++·라이선스 MIT. 오늘 오전의 AirLLM(레이어 스트리밍)과 달리, BitNet은 정밀도·커널 쪽 해법이다. 이 글은 README, arXiv 논문, 저장소 트리·헤더·파이썬 래퍼를 대조해 실무자가 빌드·선택·운영할 때 필요한 구조만 깊게 정리한다.
왜 지금 이 저장소인가
로컬·엣지 LLM의 병목은 보통 두 갈래다. (1) 모델이 커서 메모리에 안 들어가거나, (2) 들어가도 대역폭·전력이 버티지 못하는 경우. AirLLM류는 (1)을 층 단위 오프로드로 푼다. BitNet/bitnet.cpp는 (2)에 가깝다. 학습 단계에서 이미 가중치를 삼진으로 제약했기 때문에, 추론 시 일반적인 INT4/GGUF 후처리 양자화와 달리 “원래 그 정밀도”로 커널을 짤 수 있다. README가 강조하는 “fast and lossless”는 이 전제 위에서만 성립한다.
| 항목 | 확인한 값 (2026-10-12 16:53 KST) | 해석 |
|---|---|---|
| 저장소 | microsoft/BitNet — Official inference framework for 1-bit LLMs |
제품명은 bitnet.cpp. 학습 코드가 아니라 추론·커널·변환 스택 |
| 별 / 포크 / 열린 이슈 | 40,715 / 3,795 / 336 (GitHub API) | 2024-08-05 생성, 최근 push 2026-07-27. GitHub Releases/Tags는 비어 있고 README 배지는 version-1.0 |
| 언어·라이선스 | C++ (주), Python 래퍼·유틸 / MIT (Copyright Microsoft Corporation) | 상용·재배포 허용. llama.cpp 포크 서브모듈 라이선스도 따로 확인해야 함 |
| 기반 | 3rdparty/llama.cpp → isHuangXin/llama.cpp 브랜치 release-bitnet-embedding-0.6b-270m |
업스트림 llama.cpp가 아니라 BitNet용 포크. GGUF·cli·server 경로를 재사용 |
| 요구사항 | Python ≥3.10, CMake ≥3.22, Clang ≥18 (Windows는 VS2022+ClangCL) | conda 강력 권장. 이 박스에는 cmake/clang이 없어 전체 빌드·모델 스모크는 생략 |
| 최근 README 뉴스 | 2026-07-23 VibeASR.cpp, 07-20 임베딩 0.6B/270M, 01-15 CPU 커널 최적화, 2025-05 GPU 커널, 2025-04 공식 2B | LLM 추론뿐 아니라 ASR·임베딩으로 표면이 넓어지는 중. NPU는 “coming next” |
이 글에서 인용하는 속도·에너지·무손실 수치는 주로 arXiv 2410.16144(1-bit AI Infra Part 1.1)와 저장소 README/gpu README에 적힌 값이다. 박스에서 재측정하지 않았다.
BitNet b1.58이 말하는 ‘1.58비트’
원 논문 계열(2310.11453 BitNet, 2402.17764 The Era of 1-bit LLMs)에서 b1.58은 가중치를 삼진 {-1,0,1}으로 양자화(학습 시 absmean 스케일 등)하고, 활성값은 보통 8비트 부근으로 두는 설정이다. \(\log_2 3 \approx 1.585\)라서 “1.58-bit”라는 이름이 붙는다. 이진 BitNet({-1,+1})보다 0을 허용해 표현력이 늘고, 곱셈을 사실상 부호·선택·덧셈 위주로 줄일 수 있다.
| 구분 | 가중치 | 활성값(대표) | 실무 함의 |
|---|---|---|---|
| FP16/BF16 학습·추론 | 16bit | 16bit | 기준선. 메모리·전력 큼 |
| 후처리 INT4/GGUF (Q4_K 등) | ~4bit (블록 스케일) | 보통 FP16/BF16 경로 | 임의 체크포인트에 적용 가능. 품질·커널 일반화 트레이드오프 |
| BitNet b1.58 (학습 시 삼진) | {-1,0,1} ≈1.58bit | W1.58A8 계열 | 전용 커널이 있어야 이득. 일반 matmul으로는 이득이 거의 없음 |
| bitnet.cpp GPU 경로 | 2bit 패킹(W2) | A8 | CUDA GEMV, dp4a. 공식 2B용으로 문서화 |
중요한 구분: Hugging Face에 올라온 “1.58-bit” 커뮤니티 모델과 Microsoft 공식 BitNet-b1.58-2B-4T는 학습 주체가 다르다. README도 “We use existing 1-bit LLMs available on Hugging Face to demonstrate… We hope the release of bitnet.cpp will inspire…”라고 명시한다. 추론 엔진의 능력과 모델 품질을 섞어 읽으면 안 된다.
커널 세트: I2_S · TL1 · TL2
bitnet.cpp의 핵심은 ggml에 꽂힌 삼진 전용 matmul이다. 논문·README가 나란히 소개하는 세 커널을 실무 선택 기준으로 압축하면 다음과 같다.
| 커널 | 패킹 | 계산 방식 | 권장 맥락 (문서) | 아키텍처 기본 |
|---|---|---|---|---|
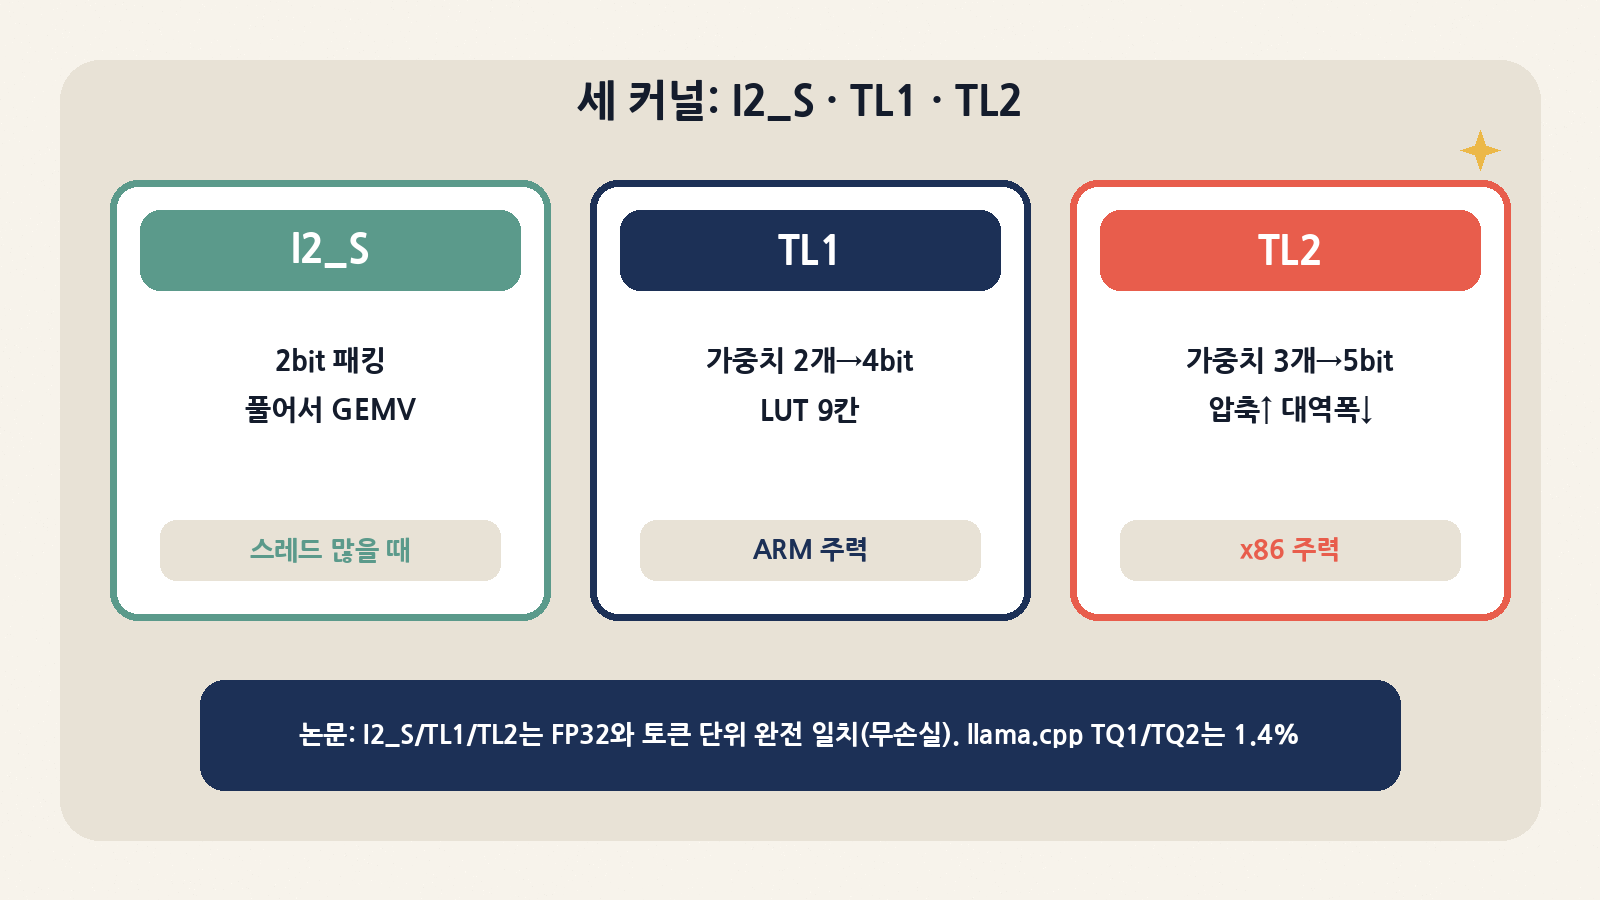
| I2_S | 값당 2bit (−1→00, 0→01, 1→10) | 언팩 후 일반 multiply-add GEMV | 스레드를 충분히 쓸 수 있을 때. 컴파일러 파이프라인에 유리 | x86·ARM 모두 공식 2B에서 ✅ |
| TL1 | 가중치 2개 → 4bit 인덱스 | 활성화 LUT \(3^2=9\)칸, int16 LUT+가산 | 스레드가 적을 때·대형 모델 서빙 | ARM 쪽 주력 (setup_env: arm64 → i2_s/tl1) |
| TL2 | 가중치 3개 → 1bit 부호+4bit ≈5bit 인덱스 | LUT. TL1 대비 모델 크기 약 1/6 추가 절감(문서) | 메모리·대역폭이 빡셀 때 | x86 쪽 주력 (setup_env: x86_64 → i2_s/tl2) |
setup_env.py의 SUPPORTED_QUANT_TYPES가 이를 코드로 고정한다. arm64는 i2_s/tl1, x86_64는 i2_s/tl2. CMake 옵션 BITNET_ARM_TL1, BITNET_X86_TL2가 ggml 정의(GGML_BITNET_*)로 넘어간다. 헤더 include/ggml-bitnet.h에는 LUT 전처리·qgemm API와 함께 “i-quantization GGUF를 쓰면 결과가 틀리다”, “지금은 BitNet 양자화 또는 스케일만 있는 GPTQ-like”라는 주석이 있다. 아무 GGUF나 넣으면 안 된다.
| 정확도 실험 (논문 Table 7) | 커널 | FP32 대비 무손실 샘플 비율 |
|---|---|---|
| llama.cpp | TQ1_0 / TQ2_0 | 각 1.4% |
| bitnet.cpp | I2_S / TL1 / TL2 | 각 100% |
조건은 WildChat에서 고른 1,000 프롬프트, 토큰 단위 최대 100토큰 완전 일치, 700M급 bitnet_b1_58-large(커뮤니티 모델) 기준이다. “무손실”은 삼진 모델의 기준 정밀도 출력을 그대로 재현한다는 뜻이지, FP16으로 학습한 일반 LLM을 삼진 커널에 넣으면 품질이 유지된다는 뜻이 아니다.
저장소 레이아웃
트리는 비교적 작다(API tree blob 약 81개, 서브모듈 제외). 무게 중심은 커널 C++와 변환 유틸이다.
| 경로 | 역할 | 실무 포인트 |
|---|---|---|
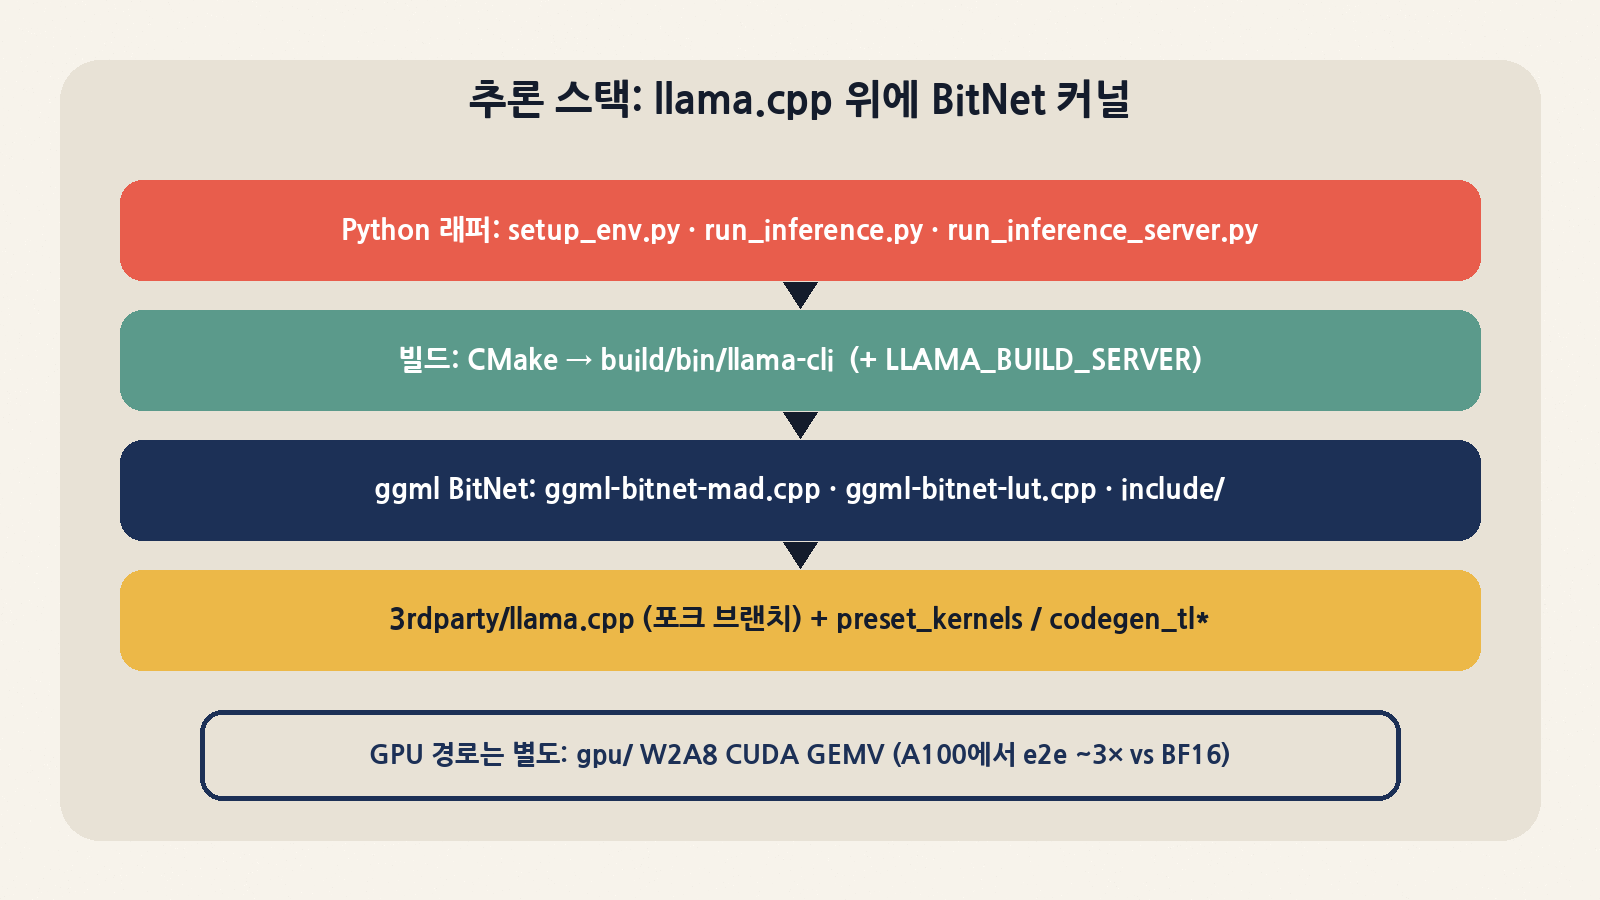
CMakeLists.txt |
프로젝트 bitnet.cpp. src/ + 3rdparty/llama.cpp, LLAMA_BUILD_SERVER ON |
결과물은 사실상 llama-cli·서버 바이너리 |
src/ggml-bitnet-mad.cpp (~42KB) |
병렬 I2_S GEMM/GEMV, 타일링 | 2026-01 CPU 최적화 문서(src/README.md)의 본체 |
src/ggml-bitnet-lut.cpp |
LUT 경로 | TL1/TL2와 연결 |
include/ggml-bitnet.h, bitnet-lut-kernels.h, gemm-config.h |
공개 API·사전생성 커널·타일 상수 | ROW_BLOCK_SIZE/COL_BLOCK_SIZE/PARALLEL_SIZE로 미세 튜닝 |
preset_kernels/ |
모델별 사전 튜닝된 bitnet-lut-kernels-tl*.h |
setup_env.py -p(use-pretuned)와 연결 |
utils/codegen_tl1.py, codegen_tl2.py |
BM/BK/bm 타일 파라미터로 커널 코드 생성 | 새 레이아웃을 올릴 때 필수. docs/codegen.md 확인 |
utils/convert-*-bitnet.py, convert-helper-bitnet.py |
HF/MS 체크포인트 → GGUF | safetensors → gguf 헬퍼가 README 퀵스타트에 연결 |
setup_env.py / run_inference.py / run_inference_server.py |
다운로드·양자화·빌드·실행 오케스트레이션 | CLI는 결국 build/bin/llama-cli 호출(-ngl 0) |
gpu/ |
별도 W2A8 CUDA 스택(bitnet_kernels/, generate.py) |
CPU CMake 경로와 분리. conda python<3.13 권장 |
docs/bitnet-embeddings-i2s-guide.md |
임베딩 모델 I2_S 변환·추론 | 2026-07 임베딩 릴리스와 짝 |
빌드·실행 파이프라인
문서상 표준 경로는 짧다. 다만 Clang 18과 재귀 클론(서브모듈)이 전제다.
git clone --recursive https://github.com/microsoft/BitNet.git
cd BitNet
# conda create -n bitnet-cpp python=3.10 && conda activate bitnet-cpp
pip install -r requirements.txt

# 공식 GGUF 받아서 I2_S로 환경 구성(양자화+빌드)
huggingface-cli download microsoft/BitNet-b1.58-2B-4T-gguf \
  --local-dir models/BitNet-b1.58-2B-4T
python setup_env.py -md models/BitNet-b1.58-2B-4T -q i2_s

# 추론 (대화 모드)
python run_inference.py \
  -m models/BitNet-b1.58-2B-4T/ggml-model-i2_s.gguf \
-p "You are a helpful assistant" -cnv| 단계 | 누가 하나 | 산출물 / 주의 |
|---|---|---|
| 재귀 클론 | git submodule | 포크 llama.cpp. shallow만 하면 빌드 깨짐 |
| 의존성 | requirements.txt → llama.cpp convert requirements 체인 |
변환 스크립트용. 추론 런타임은 C++ 바이너리 |
setup_env.py |
아키텍처 감지 → CMake 플래그 → 양자화 → 빌드 | -q {i2_s,tl1}, --quant-embd(임베딩 Q6_K), -p pretuned |
run_inference.py |
llama-cli -ngl 0 ... |
GPU 오프로드 끔(CPU 커널 경로). -cnv면 시스템 프롬프트로 -p 사용 |
| safetensors 변환 | utils/convert-helper-bitnet.py |
microsoft/bitnet-b1.58-2B-4T-bf16 등 BF16 체크포인트 경로 |
| 벤치 | utils/e2e_benchmark.py, dummy 모델 생성기 |
공개 모델 없이도 레이아웃 성능 측정 가능(논문도 dummy 설정 사용) |
이 박스에서 실제로 한 일: GitHub API로 메타데이터·트리 수집, README/LICENSE/헤더/setup_env.py/run_inference.py/src/README.md/gpu/README.md 원문 확인, shallow 클론으로 루트·서브모듈 URL 검증. cmake·clang이 없어 바이너리 빌드와 2B GGUF 다운로드·추론은 돌리지 않았다. 아래 성능 숫자는 모두 1차 문서 인용이다.
모델 动物园과 커널 매트릭스
README의 Supported Models 표를 운영 관점으로 다시 정리한다. ✅/❌는 문서 표 기준이다.
| 모델 | 파라미터 | 제공 | x86 I2_S/TL1/TL2 | ARM I2_S/TL1/TL2 |
|---|---|---|---|---|
| BitNet-b1.58-2B-4T | 2.4B (4T tok) | Microsoft 공식 | ✅ / ❌ / ✅ | ✅ / ✅ / ❌ |
| BitNet-embedding-0.6B | 0.6B | Microsoft 공식 | ✅ / ❌ / ❌ | ❌ / ❌ / ❌ |
| BitNet-embedding-270M | 270M | Microsoft 공식 | ✅ / ❌ / ❌ | ❌ / ❌ / ❌ |
| bitnet_b1_58-large | 0.7B | 커뮤니티 | ✅ / ❌ / ✅ | ✅ / ✅ / ❌ |
| bitnet_b1_58-3B | 3.3B | 커뮤니티 | ❌ / ❌ / ✅ | ❌ / ✅ / ❌ |
| Llama3-8B-1.58-100B-tokens | 8.0B | 커뮤니티 | ✅ / ❌ / ✅ | ✅ / ✅ / ❌ |
| Falcon3 / Falcon-E 패밀리 | 1B–10B / 1B–3B | 커뮤니티(tiiuae) | ✅ / ❌ / ✅ | ✅ / ✅ / ❌ |
임베딩 모델 README 주장: 0.6B prefill에서 F16 대비 1.42×~2.28×, 270M에서 1.32×~1.74×(8스레드, x86). ARM 칸이 전부 ❌인 점은 배포 전에 반드시 재확인할 것. setup_env.py의 SUPPORTED_HF_MODELS에는 공식 2B·임베딩·Falcon3/E·커뮤니티 1bitLLM/HF1BitLLM 키가 명시되어 있다.
지연·에너지·GPU 트레이드오프
CPU 쪽 헤드라인(논문·README 공통): ARM에서 1.37×~5.07× 가속·에너지 55.4%~70.0% 절감, x86에서 2.37×~6.17×·71.9%~82.2% 절감(대비군은 llama.cpp FP16). 또한 “100B BitNet b1.58을 단일 CPU에서 사람 읽기 속도(5–7 tok/s) 수준”이라는 주장도 같은 보고서 Figure 1 맥락이다. 측정은 Apple M2 Ultra 64GB, Intel i7-13700H 20스레드 64GB 등.
| 시나리오 (문서) | 대비 | 대략적 이득 | 읽을 때 주의 |
|---|---|---|---|
| CPU bitnet.cpp vs llama.cpp FP16 | 동일 삼진/더미 레이아웃 | 최대 ~6×, 에너지 최대 ~82%↓ | 대형일수록 이득↑. 대역폭이 큰 M2가 체감이 다름 |
| GPU W2A8 vs BF16(vLLM Gemma-2-2B급) | A100 40GB, 동급 2B | e2e 지연 약 2.9×~3.3× | 모델·스택이 다름. “동일 가중치 포맷” 비교 아님 |
| GPU 커널 microbench | W2A8 vs BF16 GEMV | shape별 1.27×~3.63× | 큰 K/N에서 이득 확대 |
| 임베딩 Q6_K (src/README) | F32/F16 임베딩 | 퍼플렉서티 소폭 상승, 처리량↑ | 문서가 Q6_K를 권장. 임베딩을 I2_S로 깎으면 N/A(실패) |
GPU 경로 요약: 가중치를 16×32 블록으로 퍼뮤트하고, 16개의 2bit 값을 32bit에 인터리브 패킹한 뒤 dp4a로 int8 도트. 엔드투엔드은 gpu/generate.py이며, CPU의 run_inference.py와 파일이 다르다. “bitnet.cpp 하나로 CPU/GPU 완전 통합”이라기보다 같은 모델 패밀리의 두 런타임에 가깝다.
2026-01 CPU 최적화(src/README.md)는 가중치/활성 병렬, native I2_S GEMM·GEMV, 타일 설정, 임베딩 Q6_K를 추가했다고 적는다. AMD EPYC·i7-13800H·Cobalt 100 그래프 기준으로 원 구현 대비 추가 1.15×~2.1×(README 뉴스 문구)를 주장한다. 캐시 크기별로 gemm-config.h를 만지는 것이 운영 레버다.
AirLLM·llama.cpp·일반 GGUF와의 위치
| 접근 | 무엇을 줄이나 | 전제 | 대가 |
|---|---|---|---|
| bitnet.cpp | 가중치 비트폭·대역폭·전력 | 삼진으로 학습·변환된 모델 + 전용 커널 | 모델 생태계가 좁음. 빌드 툴체인 무거움 |
| llama.cpp + Q4/Q5 GGUF | 임의 모델의 디스크·RAM | 후처리 양자화 | 삼진 전용만큼의 무손실·가속은 기대하기 어려움 |
| AirLLM 레이어 스트리밍 | 피크 VRAM | 큰 체크포인트를 층/전문가 단위로 흘림 | 토큰당 I/O·시간. 정밀도는 유지 가능 |
| T-MAC (README 권고) | 일반 저비트 LLM CPU 추론 | LUT 방법론 공유 | 삼진 특화가 아닐 때 대안 |
같은 “작은 기기에서 큰 모델” 문제라도, BitNet은 모델 형식에 동의한 뒤 커널로 이득을 뽑는 쪽이고, AirLLM은 기존 고정밀 가중치를 시간에 쪼개 올리는 쪽이다. 보완 관계는 될 수 있어도 대체재는 아니다.
평가·운영 시 빠지기 쉬운 함정
| 함정 | 왜 생기나 | 완화 |
|---|---|---|
| 일반 Q4 GGUF를 bitnet 커널에 투입 | 헤더가 i-quant 결과를 “wrong”으로 경고 | 지원 표·변환 헬퍼 경로만 사용 |
| 공식 2B 품질 = 모든 1.58bit 모델 품질 | 커뮤니티 모델은 학습 토큰·레시피가 다름 | 벤치마크를 모델별로 분리 |
| CPU 스크립트로 GPU 가속 기대 | run_inference.py가 -ngl 0 고정 |
gpu/ 스택을 따로 빌드 |
| 임베딩을 ARM 서버에 바로 배포 | README 표상 ARM ❌ | x86 또는 후속 커널 지원 확인 |
| Clang 미비·Windows 개발자 셸 미초기화 | FAQ Q1/Q2가 chrono/clang 이슈를 다룸 | 문서 FAQ·VS DevShell 준수 |
| GitHub Release로 버전 고정 | Tags/Releases 비어 있음 | 커밋 해시·서브모듈 브랜치를 인프라에 핀 |
| NPU/모바일 “지원”으로 로드맵 오해 | README는 NPU coming next | 현재는 CPU(+공식 GPU 커널)로 계획 |
언제 BitNet을 고를까
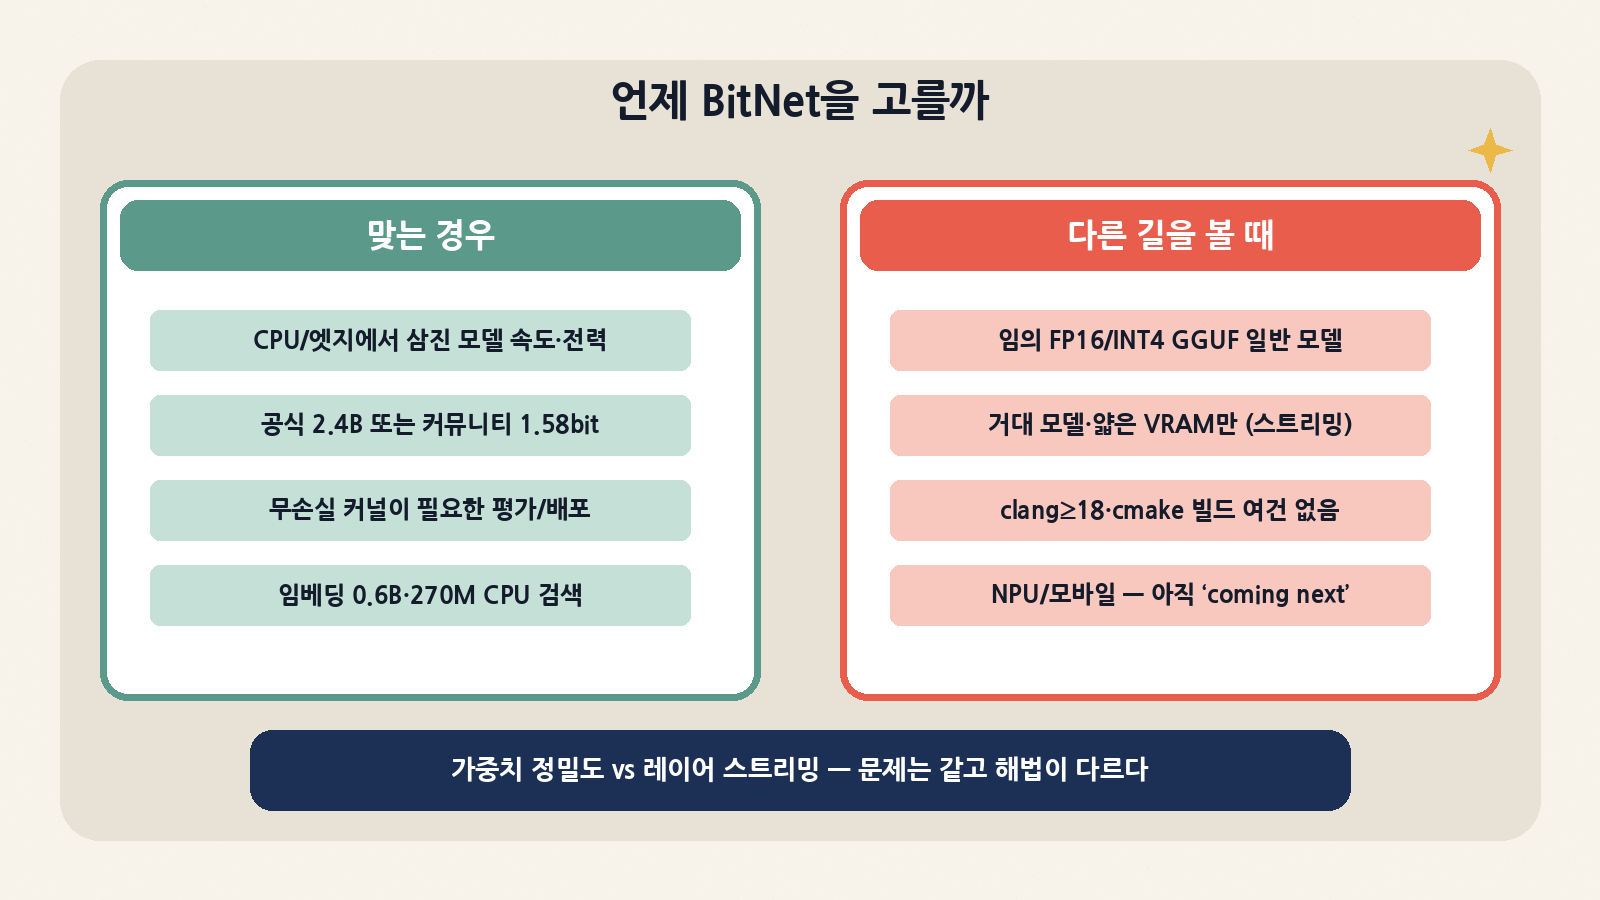
고르는 편이 나은 경우: (1) 이미 BitNet b1.58/공식 2B·지원 커뮤니티 체크포인트를 쓰기로 했고, (2) CPU(특히 전력·엣지) 또는 문서화된 W2A8 GPU 경로에서 지연·에너지를 줄여야 하며, (3) 평가에서 “커널이 기준 정밀도를 깨지 않는지”가 계약 조건에 가깝고, (4) Clang/CMake 빌드 파이프라인을 유지할 수 있을 때. 임베딩 검색을 CPU에서 싸게 돌리려 할 때도 2026-07 공식 임베딩은 후보가 된다.
다른 도구를 먼저 볼 경우: 임의 Hugging Face 모델을 당장 돌려야 하거나, VRAM만 부족하고 정밀도·체크포인트는 유지해야 하거나(스트리밍/오프로드), 팀에서 llama.cpp 업스트림 일반 양자화로 충분한 경우. 삼진이 아닌 저비트 일반론은 README가 T-MAC을 가리킨다.
정리하면, microsoft/BitNet은 “1비트 시대” 슬로건의 마케팅 저장소가 아니라, 삼진 가중치를 전제로 한 ggml 커널 + llama.cpp 포크 + 변환/벤치 유틸 + (별도) CUDA 경로의 실무 묶음이다. 모델을 그 형식에 맞출 수 있다면 CPU에서 나오는 배수·전력 숫자는 논문과 README가 꽤 공격적으로 제시한다. 맞출 수 없다면, 이 저장소의 별 4만 개는 관심 지표에 가깝다.