코딩 에이전트에게 낯선 코드베이스를 맡기면 가장 먼저 새는 건 돈이 아니라 컨텍스트다. grep은 ‘어느 줄’인지는 알려 주지만, 그 줄이 정답인지 판단하려면 결국 파일을 통째로 읽어야 한다. 오늘(2026-10-17) GitHub Trending Rust 일간 1위에 오른 xerj-org/xerj는 이 문제를 “에이전트 옆에 검색 엔진을 하나 띄워 주자”로 푼다. 폴더를 가리키면 스키마 없이 알아서 인덱싱하고(autoindex), Elasticsearch 8.x 와이어 프로토콜로 질의를 받고, MCP로 에이전트에 꽂히며, /_memory로 장기 기억까지 맡는 단일 Rust 바이너리다.
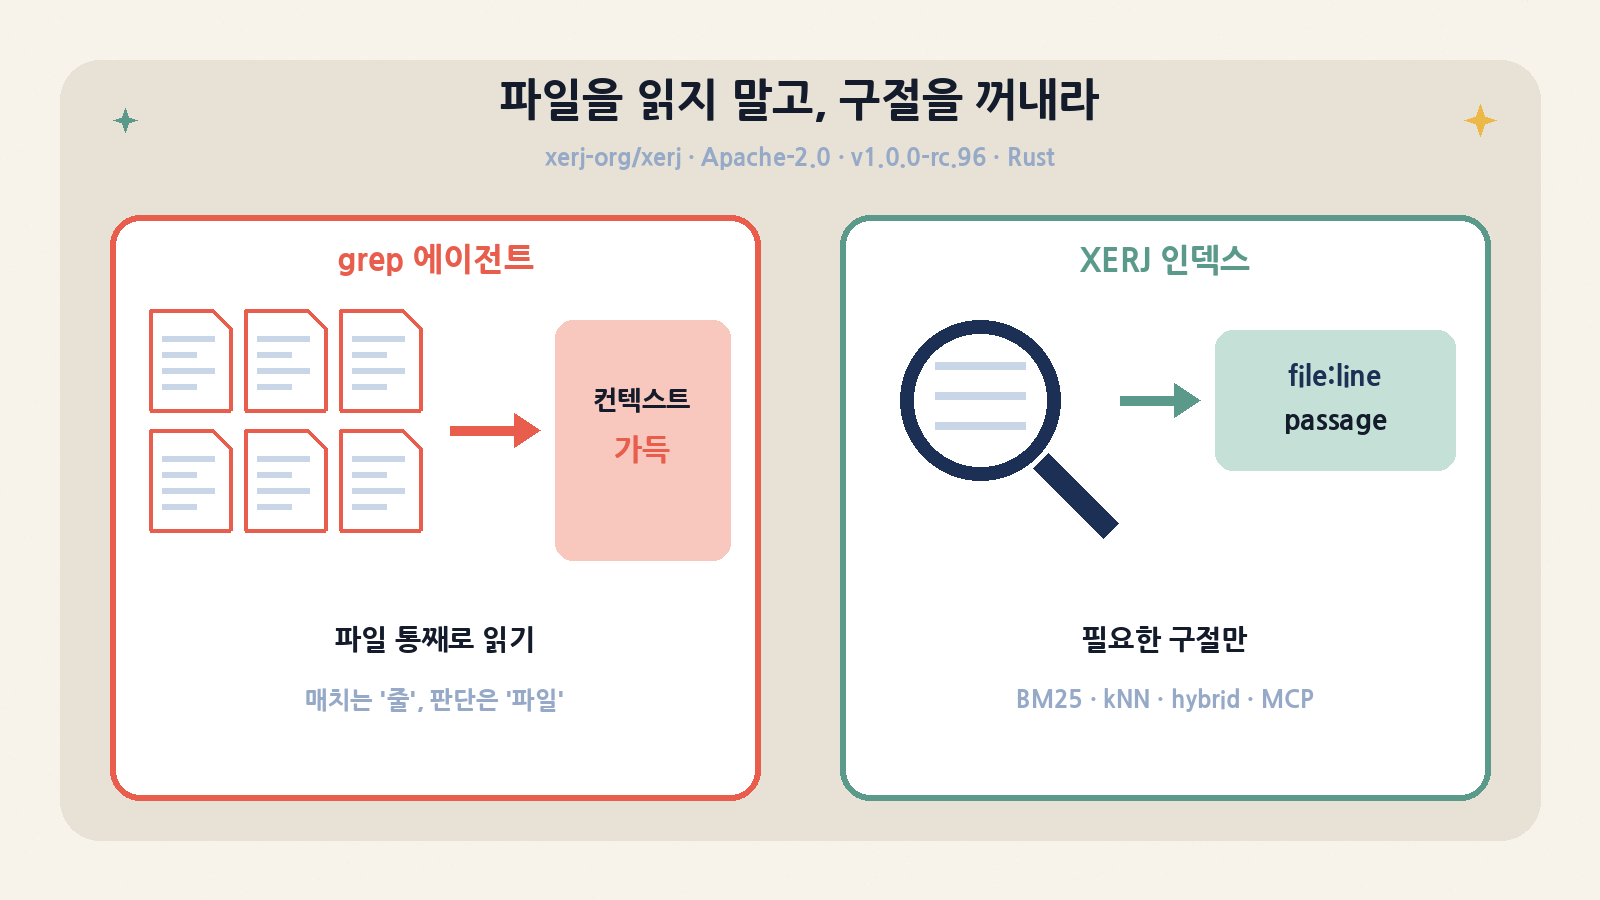
이 글은 설치 튜토리얼이 아니라 실무자 관점의 해부다. 저장소 구조와 크레이트 계층, autoindex 파이프라인, 검색·벡터·메모리 경로, 보안 경계, 그리고 박스에서 직접 돌린 rc.96 스모크 결과(좋은 것과 걸리는 것 모두)를 정리했다. 수치는 모두 2026-10-17 오전(KST)에 확인한 값이며, 프로젝트 자체 측정치는 “프로젝트 주장”으로 구분해 적었다.
한눈에 보기: 오늘 체크아웃 기준
| 항목 | 값 |
|---|---|
| 저장소 | github.com/xerj-org/xerj (생성 2026-06-30) |
| 라이선스 | Apache-2.0 (LICENSE + NOTICE), 코드 기여는 CLA 서명 필요 |
| 최신 릴리스 | v1.0.0-rc.96 — GitHub 릴리스 2026-10-16 23:51 KST, CHANGELOG 표기 2026-10-15 |
| main HEAD | 928e004 · 2026-10-17 08:32 KST (nightly 크로스 빌드 CI 조정) |
| 언어/형태 | Rust 워크스페이스 18개 크레이트 + ES-YAML 적합성 러너 |
| 배포물 | Linux/macOS/Windows × x86-64/arm64 tar.gz·zip·deb + sha256 |
| GitHub 지표 | 7,012 stars · 356 forks (API, 2026-10-17 11:52 KST) |
| Trending | Rust 일간 #1, 전체 일간 목록 #13, 오늘 +1,648 stars |
무엇을 해결하려는가: ‘읽기’를 ‘질의’로 바꾸기
문서 docs/WHY_XERJ.md는 이 프로젝트를 “Rust로 다시 쓴 Elasticsearch”로 읽지 말라고 못 박는다. 설계 대상은 대시보드를 보는 사람이 아니라 AI 에이전트이고, ES 호환은 Postgres 프로토콜을 말하는 CockroachDB처럼 ‘도입 다리’일 뿐이라는 입장이다. 에이전트가 처음 보는 데이터 앞에서 겪는 세 가지 문제를 이렇게 정의한다.
| 문제 | 기존 엔진의 한계 | XERJ의 답 |
|---|---|---|
| 온보딩 | 매핑·파이프라인을 사람이 설계해야 첫 질의 가능 | xerj autoindex <folder> — 내용 스니핑, 13개 포맷 패밀리 추출기, 타입·날짜 추론 |
| 오리엔테이션 | _cat/indices로는 “여기 뭐가 있지?”에 답 못 함 |
xerj autoindex map + autoindex-catalog 인덱스(필드 타입·예시값·gotchas) |
| 연속성 | 세션 간 기억에 별도 벡터DB·임베딩 서비스 필요 | /_memory/{ns} 저장·회상·네임스페이스·최신성 가중 |
| 자기 문서화 | 사람용 문서만 존재 | llms.txt, MCP/OpenAI/Anthropic 도구 스키마 공개 |
대표 사용처로 내세우는 건 reference coding이다. 지금 짜려는 기능과 가장 가까운 오픈소스 저장소를 클론·인덱싱해 두고, 코드를 쓰기 전에 “그 프로젝트는 이걸 어떻게 풀었나”를 구절 단위로 꺼내 쓰게 하는 루프다. 이 루프는 바이너리에 xerj corpus / xerj code 서브커맨드로 들어 있다.
프로젝트가 공개한 reference coding 측정치
| 조건 | 출력 토큰 | 비용 | 해결 |
|---|---|---|---|
| 기억만으로(검색 없음) | 260,916 | $11.18 | 11/16 |
| grep 기반 에이전트 | 26,477 | $3.27 | 16/16 |
| XERJ 질의 | 9,982 | $1.58 | 16/16 |
README 기준 8개 과제·4개 언어·조건당 16회, 실제 claude -p 토큰 집계다. 즉 grep 대비 출력 토큰 2.7배 절감, 같은 해결률이라는 주장이다. 다만 프로젝트 스스로 “모델이 외운 코드인지가 효과를 가른다”고 적는다. 사내·니치·컷오프 이후 코드에서는 이득이 크지만, 모델이 이미 잘 아는 유명 라이브러리에서는 중립이거나 오히려 해롭다. 사용자 체감 “약 5배” 수치는 field report 기반이라 통제 실험이 아니다.
아키텍처: 바이너리 하나, 리스너 셋, 크레이트 열여덟
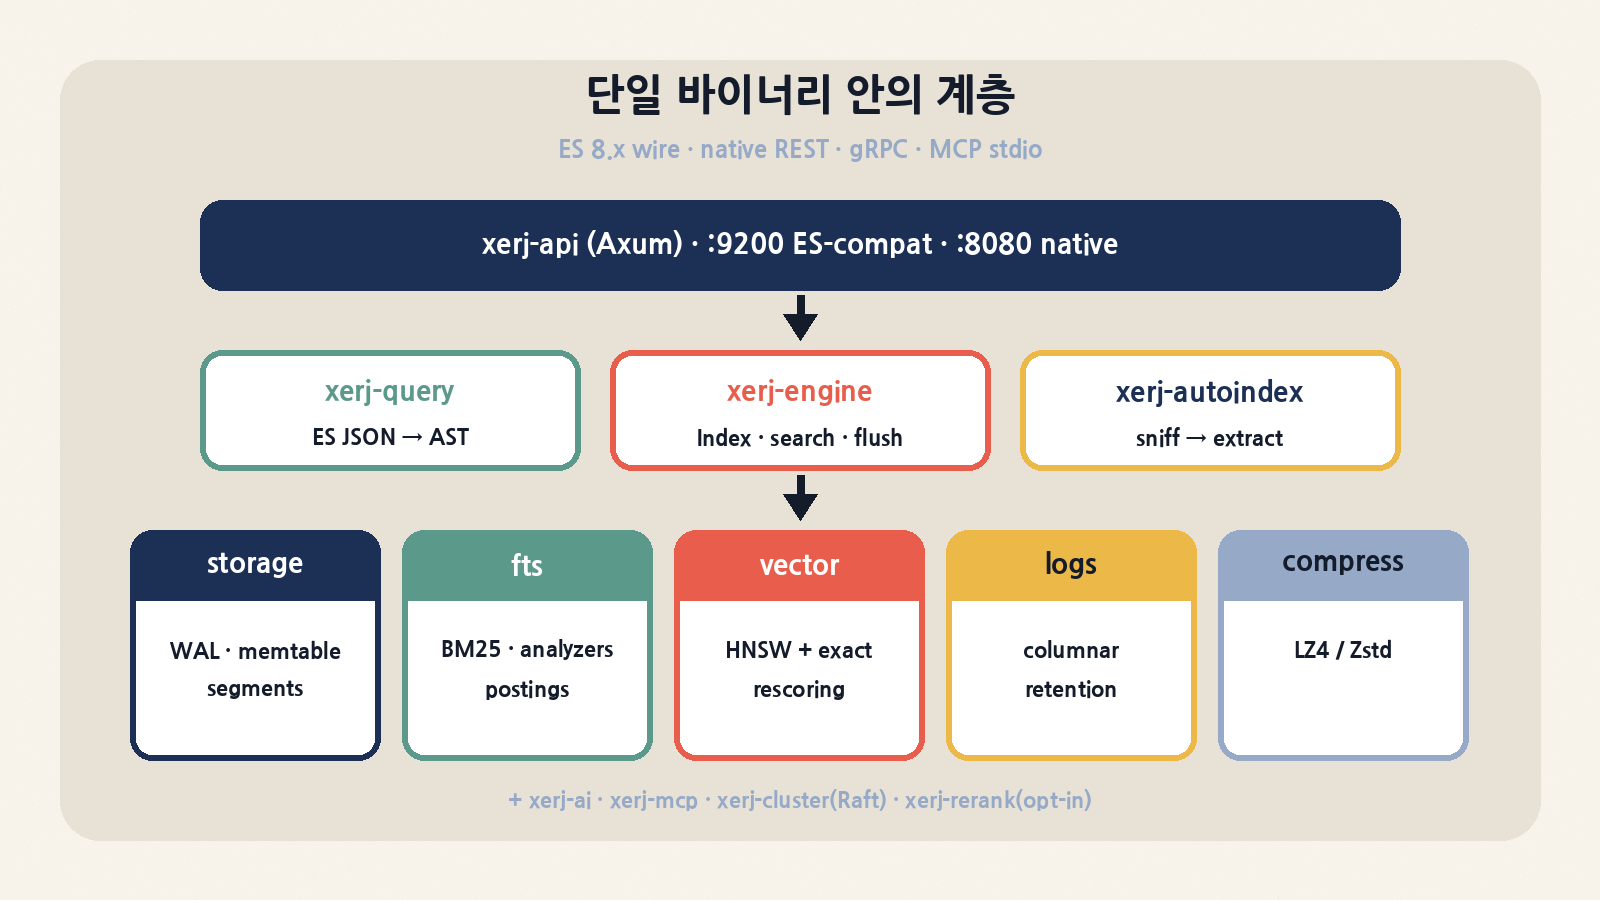
docs/ARCHITECTURE.md의 조감도는 HTTP 계층(xerj-api, Axum) 아래에 질의 파서(xerj-query), 통합 엔진(xerj-engine), 그 밑으로 저장·전문검색·벡터·로그·압축 크레이트가 깔리는 구조다. 박스에서 서버를 띄우면 리스너가 세 개 열린다: 127.0.0.1:9200(ES 호환), :8080(native REST), :8081(gRPC). GET /는 ES 8.13.0 모양의 응답을 돌려줘 기존 클라이언트가 그대로 붙는다.
| 크레이트 | 역할 |
|---|---|
| xerj-server | 바이너리 진입점: CLI 파싱, 설정 로드, API 기동 |
| xerj-api | Axum HTTP — ES 호환 핸들러(es_compat.rs)와 native API |
| xerj-query | ES JSON → QueryNode AST, 플래너·리라이터·실행기 |
| xerj-engine | Engine/Index: 저장·FTS·벡터·집계를 묶는 통합 계층 |
| xerj-storage | WAL, 샤딩된 memtable, 불변 세그먼트, version map, S3 백엔드 |
| xerj-fts | BM25, 분석기 레지스트리(CJK 바이그램 포함), 포스팅 리스트 |
| xerj-vector | 영속 HNSW + 정확 재채점, 필터 걸린 kNN은 정확 스캔, SQ8 양자화 |
| xerj-autoindex | 스니핑·추출(tree-sitter)·추론·카탈로그·증분 재인덱싱 |
| xerj-ai / xerj-mcp | 청킹·임베딩 프록시·메모리 스토어 / MCP stdio 서버 |
| xerj-cluster | 내장 Raft(클러스터 메타데이터, 외부 의존 없음) |
| xerj-rerank | 선택적 2단계 재순위 — 문서 텍스트를 외부로 보내는 유일한 검색 시점 기능 |
| xerj-logs · compress · wasm · hub · console-api | 컬럼형 로그, LZ4/Zstd, WASM 변환, Corpus Hub, 내장 콘솔 |
쓰기·읽기·복구 경로
| 경로 | 동작 |
|---|---|
| 쓰기 | WAL append(전역 AtomicU64 seq_no) → storage memtable + FTS memtable(engine.ingest_shards, 2의 거듭제곱 ≤256) → flush 시 샤드별 불변 세그먼트 + FTS/doc-values 사이드카 |
| 병합 | 백그라운드 세그먼트 병합, _forcemerge는 동기·정지 상태(ES 유사) |
| 읽기 | memtable 스캔 + 세그먼트 스캔을 병합 → 방금 쓴 문서도 즉시 검색. size>0이면 상위 from+size만 물질화 |
| 집계 | size:0 요청은 컬럼형 fast path + doc-value 프리필터 |
| 복구 | 재시작 시 인덱스별 WAL 재생으로 memtable 재구성, 외부 코디네이터 없음 |
실무적으로 의미 있는 대목은 “flush 전후로 답이 바뀌는” 버그 클래스를 계속 잡고 있다는 점이다. rc.96 CHANGELOG의 첫 항목들이 바로 그것이다 — 추론된 text 필드가 doc_values: true로 남아 flush 이후 terms가 토큰화되지 않은 원문으로 답하던 문제, 같은 조건에서 term이 flush 후 0건으로 떨어지던 문제, 세그먼트를 가로지르는 페이지의 동점 정렬(score DESC, seq_no ASC, _id ASC)이 깨지던 문제가 수정됐다. 엔진이 젊다는 신호이자, 회귀를 공개적으로 추적한다는 신호다.
autoindex: ‘스키마 없음’은 어떻게 가능한가
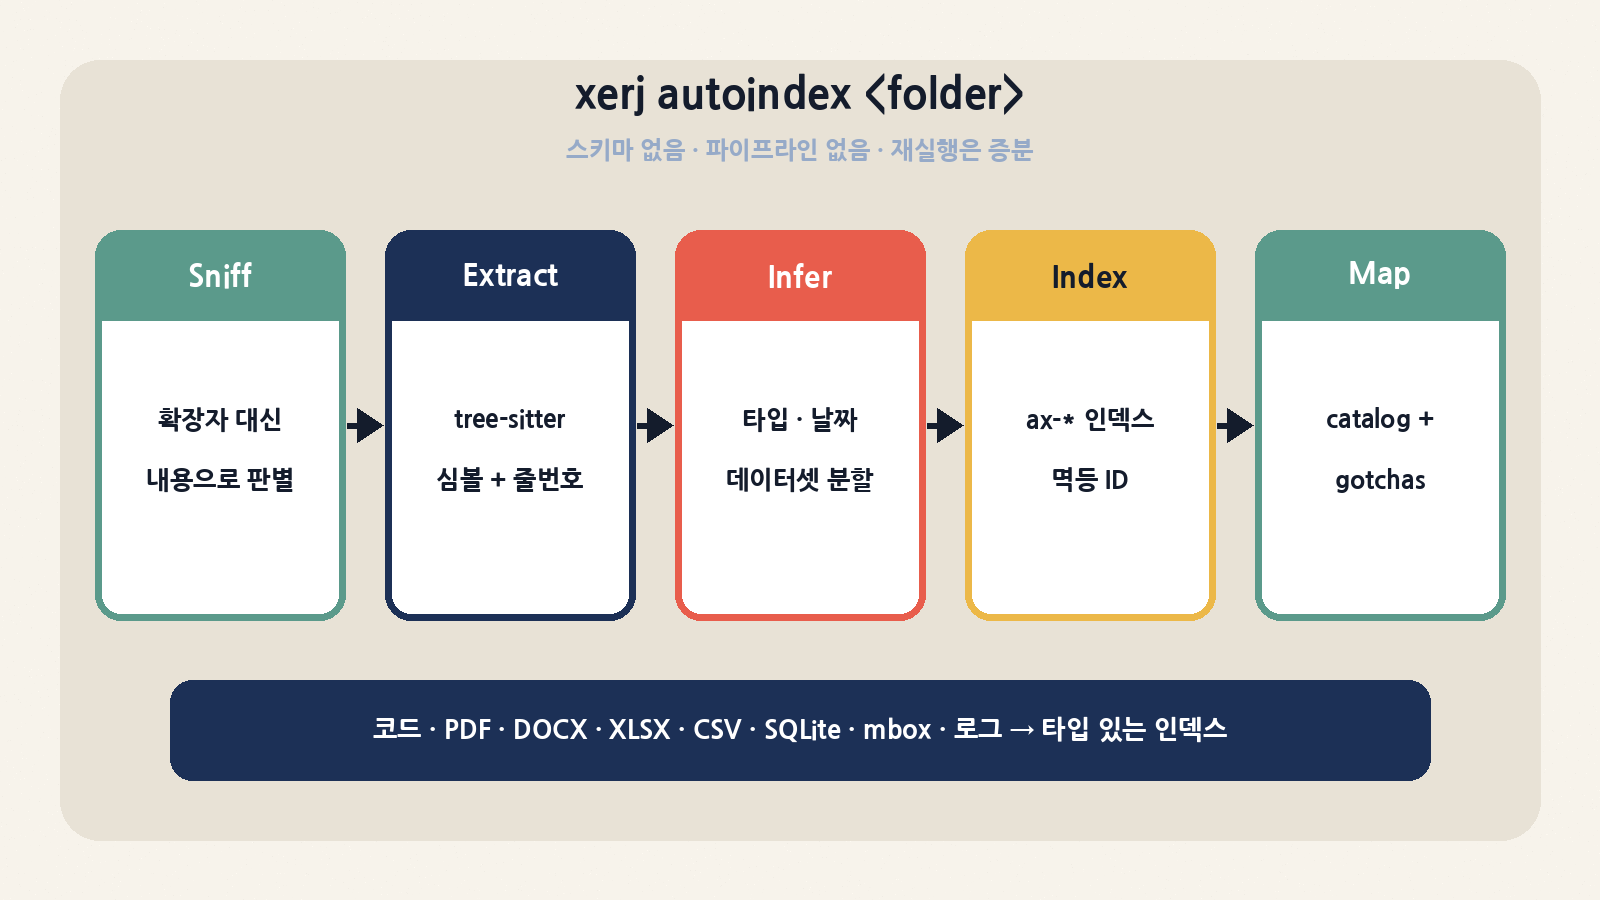
autoindex는 확장자가 아니라 바이트 내용으로 포맷을 판별(sniff)하고, 데이터셋 단위로 인덱스를 쪼갠다. 소스 코드는 tree-sitter로 파싱돼 심볼·종류(function/struct/const…)·시작/끝 줄 번호가 필드로 들어가므로, 에이전트는 “줄”이 아니라 “함수”를 받는다. 실패는 치명적이지 않고 junk로 기록되며, kill -9 이후 재개 가능하다는 것이 설계 원칙이다.
| 포맷 패밀리 | 인덱싱 단위/특징 |
|---|---|
| 코드 | tree-sitter AST — 심볼, kind, line/end_line, defs, _passage(감싸는 블록) |
| 문서 | PDF, DOCX, PPTX(슬라이드당 1건), EPUB(장당 1건), HTML, man 페이지 |
| 표/데이터 | CSV(까다로운 방언 포함), JSON/JSONL, XML, YAML, XLSX(시트당 데이터셋), SQLite |
| 메일 | .eml, mbox(Google Takeout 포함) — 스레드 엣지 생성 |
| 로그 | 일반 로그 포맷 → 타입 있는 인덱스 + ES식 집계 |
| 특수 | Unity 씬/프리팹(GameObject 단위), Jupyter(헤딩 섹션 단위), 레거시 .xls/.doc |
| 열지 않는 것 | zip/tgz 등 아카이브 — 먼저 풀어야 함(스모크에서 확인) |
방어적 설계도 눈에 띈다. ROADMAP에 따르면 .xls를 읽는 calamine 0.26.1이 악성 BIFF에 panic-safe하지 않고 엔진은 panic=abort로 빌드되므로, .xls는 rlimit이 걸린 xerj __extract-xls 워커 서브프로세스에서 파싱한다. 신뢰할 수 없는 덤프를 인덱싱해도 죽는 건 워커뿐이라는 얘기다. 재인덱싱은 콘텐츠 해시 기반 증분이라 바이트가 같은 파일은 파싱을 건너뛴다(해시 계산 자체는 매번 수행).
| 프로젝트 측정 항목 | 공개 수치 |
|---|---|
| 단일 스레드 코드 추출(Apache Lucene 6,113 파일, 51MB) | ~1,500 files/s (13MB/s), tree-sitter 파싱이 ~72% |
| autoindex 정답 검증(1,995 파일 코퍼스) | 81개 중 80개 ground-truth 체크 통과 |
| README 예시 대형 실행 | 25,329 파일 / 593 데이터셋 / 83,103 레코드 / 158.1s (8 workers) |
검색·벡터·메모리: 세 개의 질의 표면
1) Elasticsearch 호환 질의
인덱스·문서·bulk·search·aggregations·mappings·kNN·scroll·reindex·_cat을 구현했고, ES 8.13 REST spec YAML 스위트 기반 적합성 테스트가 매 커밋 돈다. README 기준 1,366/1,369 통과이며 남은 격차는 테스트 디렉터리에 공개돼 있다. 한 가지 함정: scroll은 세그먼트를 걷는 커서가 아니라 상한이 있는 선행 스냅샷이라, 정확한 total이 창을 넘으면 조용히 잘라내지 않고 400을 돌려준다. 대량 내보내기는 search_after를 써야 한다.
2) 벡터·하이브리드
| –embed-mode | 구현 | 실무 메모 |
|---|---|---|
| lexical (기본) | 384차원 feature-hashing, 오프라인·무의존 | ‘의미 검색’이 아니라 하이브리드 lexical+vector라고 문서가 명시 |
| neural | 내장 BERT all-MiniLM-L6-v2, 첫 사용 시 ~90MB 다운로드 | 진짜 의미 유사도, 에어갭은 모델 파일 사전 배치 |
| proxy | 외부 OpenAI 호환 /v1/embeddings | 문서·질의 텍스트가 외부로 나감 |
| onnx-experimental | FP32 MiniLM 호환 ONNX + tokenizer.json | 자동 다운로드 없음, 프로토타입 |
kNN은 필터 없는 경우 영속 HNSW 후보를 정확 재채점해 점수가 정확 경로와 비트 단위로 일치하도록 했고, 필터·비코사인·SQ8·소형 인덱스는 정확 스캔으로 떨어진다. 프로젝트 측정으로는 공식 벤치 쿼리 recall@10 1.00, 100-probe 평균 0.976(같은 프로토콜의 ES 8.13.4는 0.937)이다.
3) 에이전트 메모리 /_memory
| 엔드포인트 | 동작 |
|---|---|
| POST /_memory/{ns} | 기억 저장 {text, vector?, metadata?, id?} |
| POST /_memory/{ns}/_recall | top-k 회상 — query/vector/semantic/hybrid, filter, recency_weight |
| GET /_memory/{ns} | 최근 항목 목록(최대 100, 디버깅·감사용) |
| DELETE /_memory/{ns}/{id} | 하나 잊기 |
| DELETE /_memory/{ns} | 네임스페이스 삭제 |
메모리는 예약 네임스페이스 .xerj-memory-*에 저장되고, role_descriptors 없이 발급한 Unscoped 키로는 접근할 수 없다. 즉 “검색용 키”와 “기억용 키”를 분리할 수 있다는 점이 별도 벡터DB를 붙이는 구성보다 깔끔한 부분이다.
MCP: 13개 도구
| 도구 | 역할 |
|---|---|
| xerj_search / xerj_semantic_search / xerj_vector_search / xerj_hybrid_search | ES DSL·semantic_text·dense_vector·RRF/선형 융합 검색 |
| xerj_memory_store / xerj_memory_recall | 네임스페이스 기반 장기 기억 |
| xerj_brain_overview / ego / link / unlink | second-brain 링크 인덱스(증거 기반 이웃 확장) |
| xerj_plan | 평문 필터 → 검증된 DSL (POST /_ask, 규칙 기반·LLM 아님) |
| xerj_map | autoindex 카탈로그의 인덱스별 필드 맵 |
| xerj_code_search | xerj code reference-coding 파이프라인 실행 |
xerj mcp는 노드를 띄우지 않는다. stdio로 클라이언트와, HTTP로 XERJ_URL(기본 http://localhost:9200)의 노드와 대화하는 프록시일 뿐이라 신뢰 경계는 노드 쪽 설정이 결정한다. 도구 스키마는 라이브 tools/list에서 생성해 CI(scripts/mcp-schema-check.sh)로 고정한다.
설치와 실행: README 명령 그대로
# 공식 원라이너(설치 스크립트)
curl -fsSL https://xerj.org/get | sh

# 로컬 개발: TLS·인증 끔(루프백 전용)
xerj --insecure --data-dir ./data &
xerj init                                  # Claude Code/Cursor에 MCP + skill 연결
xerj autoindex ~/my-project
xerj search "how do we rotate the WAL segment"
xerj def "euler_to_rotationmatrix"
xerj gain                                  # 감사 로그 기반 실사용 집계
# 인증 켠 기본 기동(권장: 공유 호스트)
xerj --data-dir ./data & # 첫 부팅 시 admin.key 생성
export XERJ_API_KEY="$(cat ./data/admin.key)"
xerj autoindex ~/my-project
# reference coding 루프
xerj corpus add xerj-storage https://github.com/spacejam/sled
xerj corpus index xerj-storage
xerj code xerj-storage "how does sled fsync its WAL segment on rotation?"
# 소스 빌드 + 적합성 스위트
git clone https://github.com/xerj-org/xerj && cd xerj/engine
cargo build --release -p xerj-server
cargo run --release -p es-yaml-runner -- --dir tests/es-compat-yaml/yamlxerj.org/get 설치 엔드포인트(Cloudflare Functions, 저장소 functions/get.js)는 요청마다 시각·User-Agent·국가·OS·아키텍처를 담은 설치 레코드를 남긴다(IP는 저장하지 않는다고 명시). 이게 싫거나 공급망을 직접 검증하고 싶다면 GitHub Releases에서 tarball과 .sha256을 받아 대조하는 편이 낫다. 이번 스모크도 그렇게 했다.박스 스모크 테스트: rc.96을 직접 돌려 보니
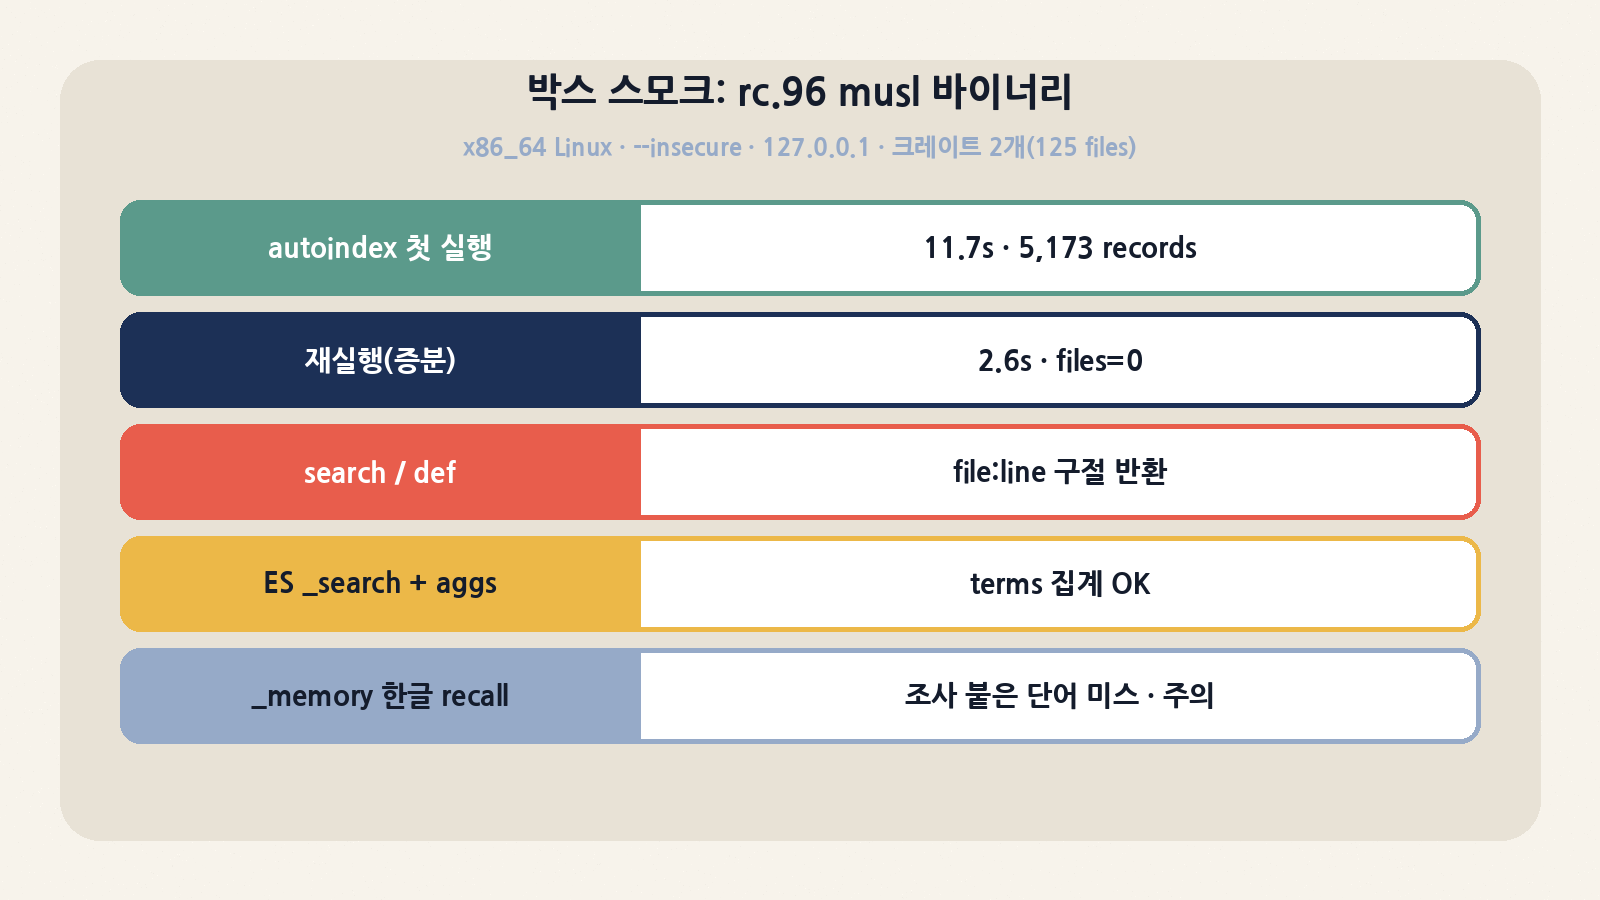
환경: x86_64 Linux 박스, xerj-1.0.0-rc.96-x86_64-unknown-linux-musl.tar.gz(31.6MB)를 Releases에서 받아 sha256 일치 확인, --insecure --data-dir ./data로 루프백 기동. 코퍼스는 이 저장소의 xerj-autoindex·xerj-mcp 크레이트 사본(Rust 코드 + 테스트 픽스처). GPU·neural 임베더는 쓰지 않았다.
| 항목 | 결과 | 판정 |
|---|---|---|
| 다운로드 검증 | sha256 007b9929… 일치, --version → v1.0.0-rc.96 |
OK |
| 기동 | 수 초 내 9200/8080/8081 리슨, ES 8.13.0 형태 응답 | OK |
| autoindex 1회차 | 125 파일 제출 → 5,173 레코드, 데이터셋 2개, 11.7s, 코드 112개 전부 인덱싱, 그래프 엣지 168 | OK (exit 3) |
| autoindex 2회차 | 변경 없음 → files=0, 2.6s | 증분 동작 확인 |
| xerj def sniff | sniff.rs:199 pub fn sniff(path: &Path) 정확히 반환 |
OK |
| xerj search(자연어) | 상위 2건 lib.rs:1397, sniff.rs:233 — 질문과의 관련성은 절반 정도 | 보통 |
ES _search + terms 집계 |
kind별: function 3,632 · const 502 · struct 323 … | OK |
| 질의 지연 | 첫 질의 505~766ms(콜드), 같은 질의 반복 시 took 0ms | 캐시 효과 큼 |
| xerj gain | 검색 2회, 100% 적중, p50 213ms — 자기 검증 프로브 3회는 별도 표기 | OK |
| 데이터 디렉터리 | 23MB (ax-docs 15.8MB) | — |
| 프로세스 RSS | 인덱싱 직후 약 1.8GB | 작은 코퍼스 대비 큼 |
autoindex가 exit code 3(completed-with-junk)으로 끝난 이유는 테스트 픽스처 안의 zip/tgz 두 개를 열지 않았기 때문이다. 실패가 아니라 “아카이브는 풀어서 다시 돌려라”는 안내와 함께 기록된다 — CI에서 exit code를 그대로 성공/실패로 쓰면 오탐이 날 수 있으니 3을 별도 처리해야 한다.
한국어 메모리 회상: 기본값 그대로면 조심
| 회상 질의 | 모드 | 결과 |
|---|---|---|
| “발행 경로는?” | 기본 query | 0건 |
| “발행한다” | 기본 query | 2건 (발행한다가 들어간 문장) |
| “MacBook” | 기본 query | 0건 — 원문은 “MacBook에서” |
| “publishing host” | semantic:true (lexical 임베더) | 2건, 점수 0.5 동률로 무관한 순서 |
원인은 단순하다. 기본 분석 경로에서는 조사가 붙은 어절(“MacBook에서”)이 하나의 토큰으로 남아, 어간만으로는 매치되지 않았다. xerj-fts에는 한글·한자·가나를 바이그램으로 쪼개는 cjk 분석기가 들어 있으므로 한국어 문서 인덱스는 매핑에서 이를 지정하는 것이 맞고, 메모리를 ‘의미’로 회상하려면 --embed-mode neural(또는 proxy)을 켜야 한다. 기본 lexical 임베더로 semantic 회상을 기대하면 위처럼 동률 점수가 나온다. 이건 문서가 이미 정직하게 경고한 부분이지만, 한국어 사용자에게는 체감 차이가 크다.
보안 모델: –insecure는 진짜로 ‘슈퍼유저’다
| Principal | 되는 방법 | 접근 범위 |
|---|---|---|
| Superuser | --insecure(auth 끔), 빈 admin 키, 또는 admin 키 제시 |
모든 것 — 권한 검사 경로 자체를 건너뜀 |
| Scoped | POST /_security/api_key + 유효한 role_descriptors |
역할이 지정한 인덱스·권한만 |
| Unscoped | role_descriptors 없이 발급한 키 | 일반 인덱스, .xerj-memory-*는 불가 |
| Denied | 자격 없음·만료·무효 | 없음 |
새 노드는 127.0.0.1에만 바인딩하고, TLS가 꺼진 상태로 다른 인터페이스에 바인딩하려 하면 server.allow_insecure_network_bind = true를 명시하지 않는 한 기동을 거부한다. 반대로 말하면 README의 빠른 시작(--insecure)을 팀 서버에 그대로 옮기면, 포트에 닿는 모든 호출자가 모든 인덱스와 모든 에이전트 기억을 읽고 지울 수 있다. 외부로 텍스트가 나가는 경로는 문서가 전부 열거한다: rerank(TypeSafe의 Jev로 상위 hit 텍스트 전송), proxy 임베딩, WAL tap. 셋 다 운영자가 켜야 동작한다.
대안과 비교: 어디에 놓을 도구인가
| 도구 | 라이선스 | 강점 | 약점/주의 |
|---|---|---|---|
| XERJ | Apache-2.0 | 단일 Rust 바이너리, autoindex·map·/_memory·MCP 내장, ES 와이어 호환 | 젊은 엔진(rc), 한국어는 분석기 설정 필요 |
| Elasticsearch | AGPL/SSPL/ELv2 중 택1 | 성숙한 생태계·운영 도구·nori 한국어 분석기 | JVM 운영 부담, 매핑·파이프라인을 사람이 설계 |
| OpenSearch | Apache-2.0 | ES 7 계열 포크, 플러그인 생태계 | 클러스터 운영 비용, 에이전트용 온보딩 없음 |
| Meilisearch / Typesense | MIT / GPL-3.0 | 가벼운 즉답형 검색, 쉬운 API | ES DSL 비호환, 코드 AST 인덱싱 없음 |
| ripgrep / grep | MIT·Unlicense / GPL | 설치 0, 정확 매치, 인덱스 불필요 | 줄 단위 결과 → 파일 통째 읽기로 컨텍스트 소모 |
| zoekt 등 코드 검색 | Apache-2.0 | 대규모 코드 트라이그램 검색 | 문서·메일·로그 혼합 코퍼스와 메모리 API는 범위 밖 |
| Qdrant 등 벡터DB | Apache-2.0 | 대규모 ANN·필터 성숙 | BM25·집계·자동 인덱싱은 별도 구성 |
정리하면 XERJ의 경쟁자는 ES의 쿼리 DSL이 아니라 “폴더를 에이전트가 답할 수 있게 만들려고 사람이 짜는 수집 파이프라인”이다. 프로젝트 문서도 그렇게 평가해 달라고 요청한다. 이미 ES/OpenSearch 클러스터와 한국어 분석기를 운영 중이라면 XERJ는 대체재라기보다 에이전트 전용 로컬 사이드카로 보는 편이 현실적이다.
벤치마크를 읽는 법
| 항목 | 프로젝트 공개 수치 | 해석 시 주의 |
|---|---|---|
| ES 8.13.4 대비 전체 매트릭스 | 55승 / 26무 / 4패 (+3 N/A) | 4패는 모두 고빈도 쓰기 중 읽기 p99 |
| 수집 처리량 | 1.72× | 프로젝트 측정, 재현 스크립트 공개 |
| 디스크 점유 | 1.61× 작음 | 동일 코퍼스 기준 |
| ES 적합성 | 1,366 / 1,369 | 남은 3건은 저장소에 공개 |
| Jev 재순위(FiQA) | nDCG@10 0.24 → 0.36, 648회 약 $0.64 | 외부 전송 발생, 점수 보정 안 됨 |
| 로컬 /v1/systemone(AG News) | 정답 라벨 92% | 라벨된 예시가 있어야 작동 |
프로젝트는 “재현하지 못한 수치는 우리 것까지 의심하라”고 적고, 패배 4건을 별도 문서로 남겼다. 태도는 좋지만 모두 자체 하네스 결과라는 점은 변하지 않는다. 도입 전에는 demo/playbooks와 scripts/bench/로 자기 코퍼스에서 다시 재 보는 것이 맞다.
한계와 주의점 체크리스트
| 항목 | 내용 |
|---|---|
| 버전 성숙도 | 아직 1.0.0-rc 단계. rc.96 시점 열린 결함 5건(#1094, #1110, #1122, #1170, #1267)을 ROADMAP이 명시 |
| Corpus Hub v2 | 코드는 들어왔지만 rc.96에는 허브 서명 키가 없어 xerj ask·hub sync/pull은 exit 5. reference coding은 xerj corpus/xerj code로 |
| 바이너리 크기 | WHY_XERJ.md는 61.6MB라 적지만, 이번 rc.96 musl 압축 해제본은 139.7MB였다(문서 수치가 이전 빌드 기준일 가능성) |
| 메모리 사용 | 박스 스모크에서 작은 코퍼스에도 RSS 약 1.8GB — 노트북 상주용이면 확인 필요 |
| 한국어 | 기본 분석으로는 조사 붙은 어절 매치 실패, cjk 분석기·neural 임베더 설정 권장 |
| scroll | 선행 스냅샷 상한 → 큰 결과는 search_after |
| CLA | CLA.md 자체에 ‘변호사 검토 전, 프로젝트 소유 법인·연락처 자리표시자 미기입’ 경고. 코드 기여 전 확인 |
| 에이전트 기여 유도 | README와 xerj --help가 에이전트에게 field report PR·이슈 작성을 권한다. 에이전트에 gh 권한을 줬다면 의도치 않은 외부 게시가 없도록 정책을 걸어 둘 것 |
| 효과의 전제 | 모델이 외운 유명 라이브러리에서는 reference coding 이득이 없거나 역효과(프로젝트 명시) |
도입 판단 가이드
| 상황 | 권장 |
|---|---|
| 사내·니치 코드베이스에서 코딩 에이전트를 돌린다 | 적극 검토 — reference coding·def·_passage가 바로 이득 |
| 메일·PDF·CSV가 섞인 감사/조사 폴더를 에이전트에게 맡긴다 | 적합 — autoindex map이 첫 질문을 대신함 |
| 한국어 문서 중심 RAG | 가능하지만 cjk 분석기 매핑 + neural 임베더 설정이 전제 |
| 운영 중인 ES 클러스터를 갈아엎고 싶다 | 보류 — rc 단계, 먼저 사이드카로 검증 |
| 여러 사람이 쓰는 공유 서버 | auth 기본값 유지, Scoped 키 발급, --insecure 금지 |
XERJ가 오늘 Rust 트렌딩 꼭대기에 오른 이유는 “ES를 Rust로 다시 썼다”가 아니라, 에이전트가 파일을 읽는 대신 질의하게 만드는 온보딩·오리엔테이션·기억을 바이너리 하나에 묶었기 때문이다. 박스에서 확인한 범위에서는 autoindex·def·ES 집계·증분 재인덱싱이 문서대로 동작했고, 걸리는 지점은 한국어 기본 분석, 메모리 점유, rc 단계의 성숙도였다. 사내 코드나 잡다한 조사 폴더를 에이전트에게 맡기고 있다면, 루프백 전용 --data-dir 하나로 반나절 시험해 볼 가치는 충분하다.