LLM이 “다음 단어”를 맞히듯, 캔들차트의 “다음 봉”을 토큰으로 생성하면 어떨까. shiyu-coder/Kronos는 칭화대 연구진이 공개한 금융 K-라인(OHLCV 캔들) 전용 파운데이션 모델이다. 시가·고가·저가·종가·거래량·거래대금 6개 값을 한 묶음으로 보고, 이를 20bit 이산 토큰으로 바꾼 뒤 디코더 전용 Transformer가 자기회귀로 미래 토큰을 샘플링한다. 논문(arXiv 2508.02739)은 AAAI 2026에 채택됐고, 사전학습 가중치 3종(mini·small·base)이 Hugging Face에 MIT 라이선스로 올라와 있다. 오늘(2026-10-20) GitHub Trending 전체 일간 12위(+363), Python 일간 6위에 다시 올라왔다.
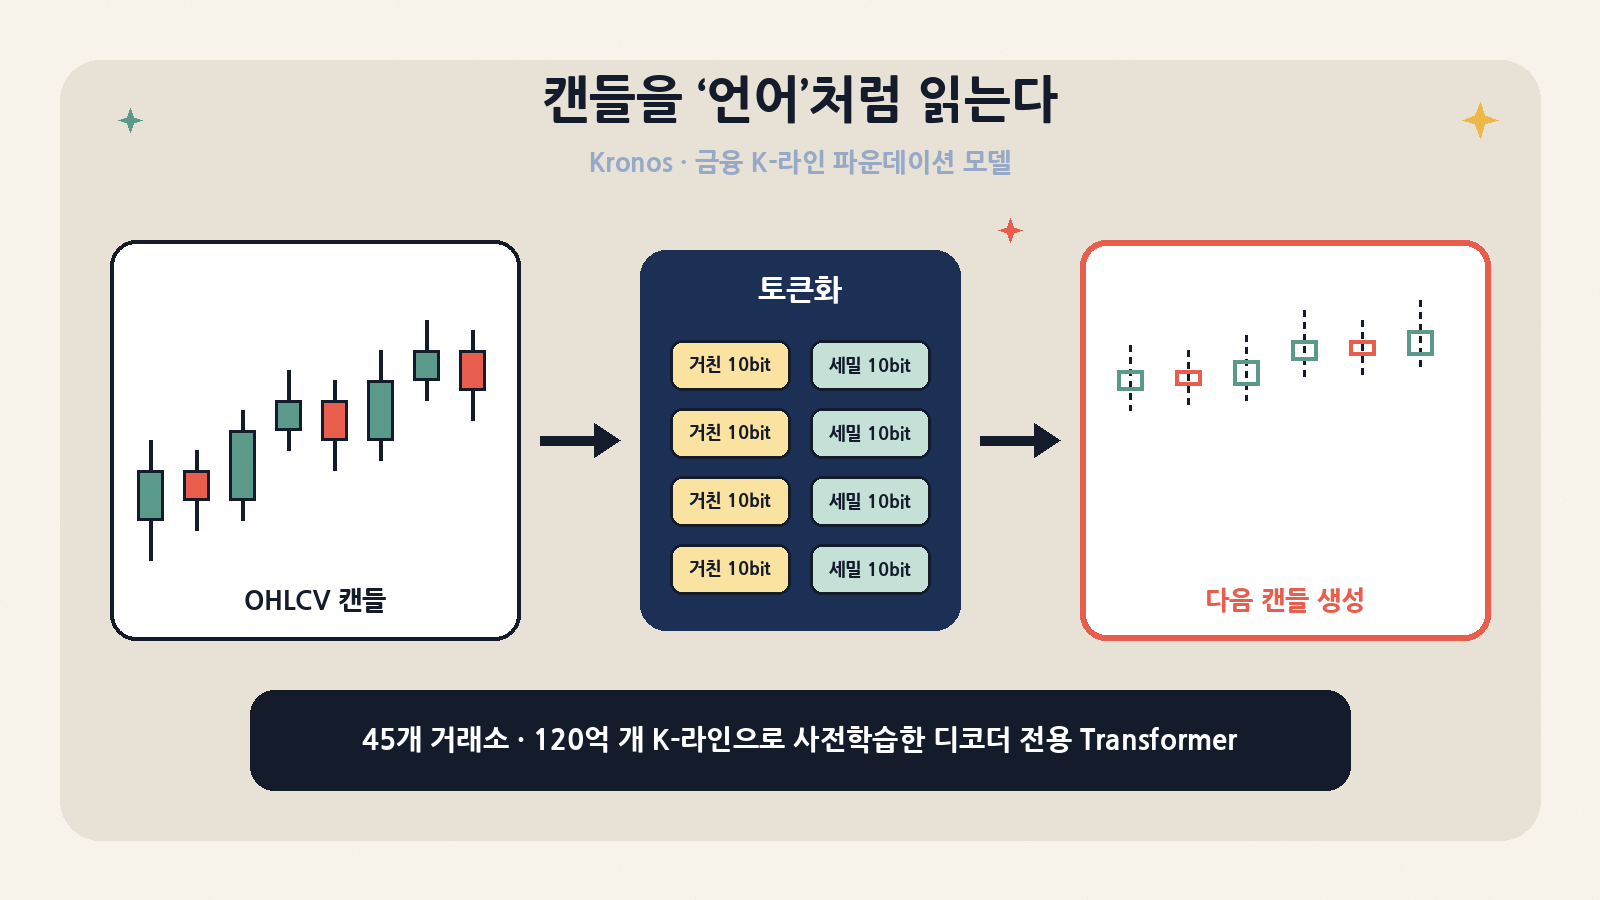
이 글은 “주가 예측 AI”라는 자극적인 포장을 걷어 내고 실무자 관점에서 본다. ① 저장소 구조와 공개 범위, ② BSQ(Binary Spherical Quantization) 토크나이저와 “거친 토큰→세밀 토큰” 계층적 자기회귀 구조, ③ 코드 레벨에서 본 추론 루프의 비용(KV 캐시 부재, 창 재계산, 표본 평균), ④ 논문 수치와 우리가 직접 확인할 수 있는 것의 경계, ⑤ 웹 UI의 보안 문제. 그리고 박스(리눅스 VM, 8 vCPU, GPU 없음)에 격리된 venv·HOME을 만들어 공식 회귀 테스트를 돌리고, 저장소에 동봉된 알리바바(09988.HK) 5분봉으로 2025년 구간(논문이 밝힌 사전학습 데이터 종료 시점 2024년 6월 이후) 40개 창을 직접 예측해 단순 기준선과 비교했다. 모든 수치는 2026-10-20 16:57~17:30 KST 실측이거나 GitHub·Hugging Face API, 논문에서 확인한 값이다.
한눈에 보기: 오늘 기준 스냅숏
| 항목 | 값 |
|---|---|
| 저장소 | github.com/shiyu-coder/Kronos (생성 2025-07-01 11:54 KST) · 기본 브랜치 master · 언어 Python |
| 라이선스 | MIT (저장소 LICENSE, Hugging Face 모델 카드 모두 MIT) |
| 버전 | GitHub Release·태그 없음. 사실상의 버전은 HF 체크포인트 리비전(예: Kronos-small 901c26c, Tokenizer-base 0e01173, 둘 다 2025-09-09 23:10 KST 갱신)과 저장소 커밋. 마지막 커밋 67b630e(2026-04-13 21:38 KST) |
| GitHub 지표 | 41,905 stars · 6,949 forks · 열린 이슈 213 + 열린 PR 69 · 병합된 PR 19 · 커밋 76 · 커밋 작성자 21명 (API, 16:58 KST) |
| Trending | 전체 일간 #12(+363), Python 일간 #6 (16:57 KST) |
| 논문 | “Kronos: A Foundation Model for the Language of Financial Markets” arXiv 2508.02739 (2025-08) · AAAI 2026 채택(README 2025-11-10 공지) |
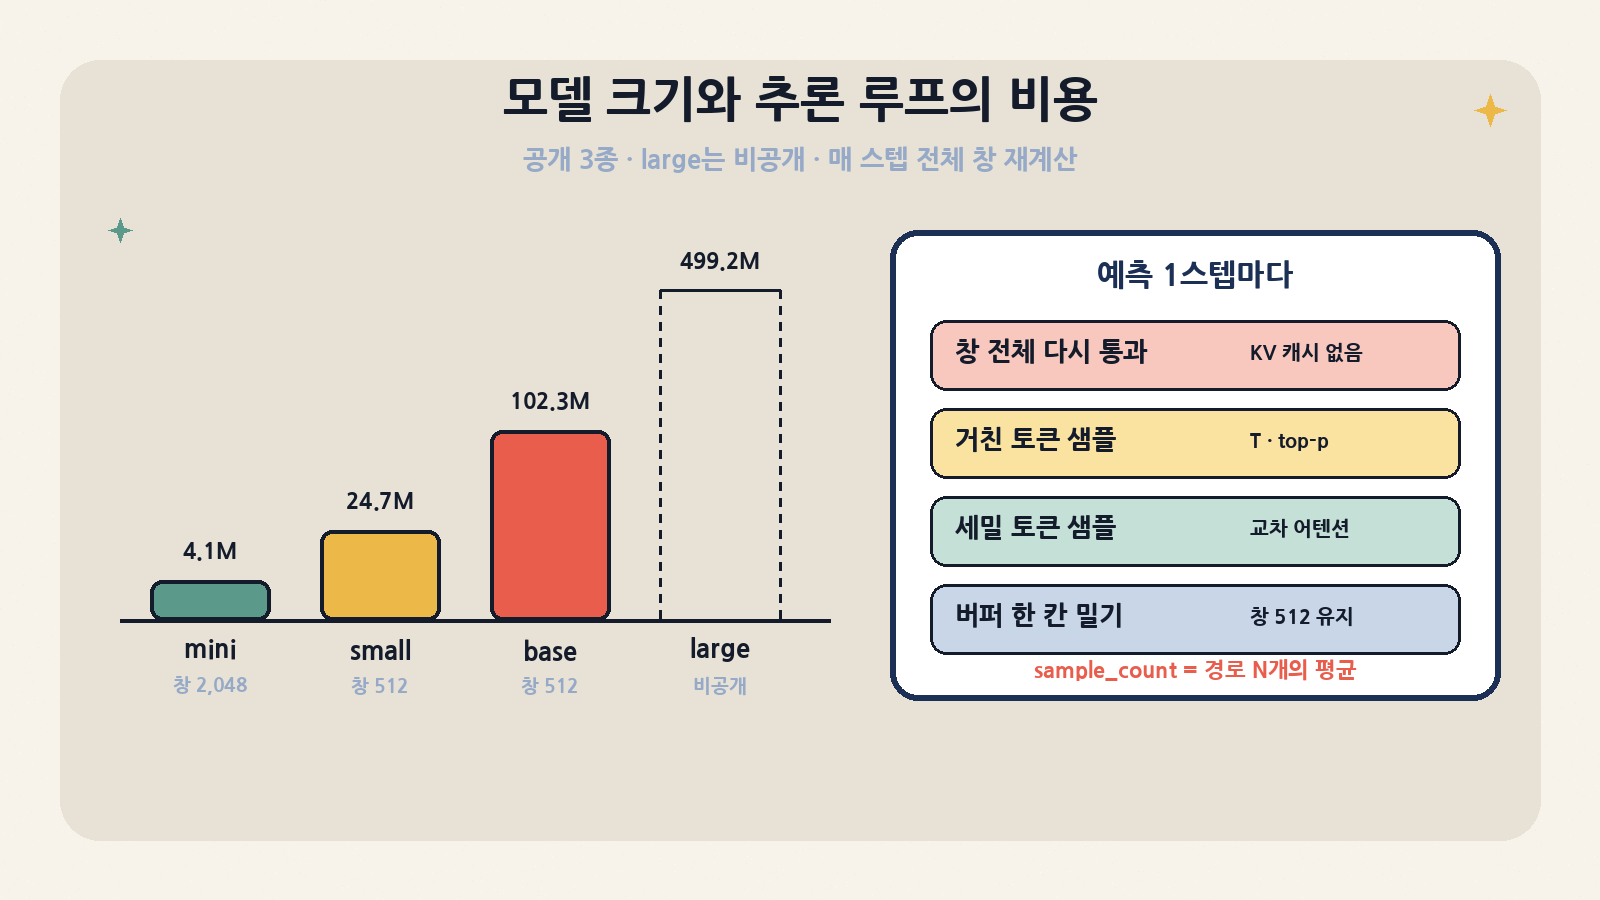
| 공개 모델 | Kronos-mini 4.1M · small 24.7M · base 102.3M (HF NeoQuasar/*). large 499.2M은 비공개 |
| 의존성 | torch>=2.0, einops 0.8.1, huggingface_hub 0.33.1, pandas 2.2.2, safetensors 0.6.2 등 7개. README는 공식 pip 패키지 없이 저장소 clone 후 from model import ... 방식만 안내 |
왜 다시 트렌딩인가: 다운로드는 꾸준, 코드는 반년째 정체
Kronos는 새 프로젝트가 아니다. 2025년 여름 공개 직후 한 차례 크게 주목받았고, 지금은 저장소 코드보다 모델 사용량이 더 큰 단계에 있다. Hugging Face API의 최근 30일 다운로드를 보면 토크나이저만 240만 회를 넘는다. 반면 마지막 커밋은 2026-04-13이고, 그날 커뮤니티 PR 5건(top-k 샘플링 버그, 미세조정 데이터셋의 정규화 누수, 배치 차원 보존, WebUI 의존성 등)을 한꺼번에 병합한 뒤로 멈춰 있다. 열린 PR 69건 대비 병합된 PR이 19건이라는 점도 유지보수 속도를 보여 준다. 최근 트렌딩 재진입은 “에이전트가 시장 데이터를 다룬다”는 흐름 속에서 금융 시계열 모델을 찾는 수요가 다시 몰린 결과로 보인다.
| HF 모델 | 최근 30일 다운로드 | 좋아요 | 메모 |
|---|---|---|---|
| NeoQuasar/Kronos-Tokenizer-base | 2,436,561 | 103 | small·base 공용 토크나이저 |
| NeoQuasar/Kronos-small | 1,194,878 | 42 | 회귀 테스트가 고정하는 리비전 901c26c |
| NeoQuasar/Kronos-base | 708,963 | 291 | 공개 모델 중 최대 |
| NeoQuasar/Kronos-mini | 431,203 | 33 | 컨텍스트 2,048 |
| NeoQuasar/Kronos-Tokenizer-2k | 404,779 | 12 | mini 전용 |
저장소 구조: 모델 두 파일 + 예제·미세조정 스크립트
코드는 의외로 작다. 핵심은 model/kronos.py(662줄)와 model/module.py(570줄) 두 파일이고, 나머지는 예제·미세조정·웹 UI다. 파이썬 전체가 약 11,200줄이지만 그중 상당 부분이 예제 스크립트다. 설치형 패키지가 아니어서 다른 프로젝트에 넣으려면 model/ 디렉터리를 벤더링하거나 PYTHONPATH로 잡아야 한다.
| 경로 | 역할 |
|---|---|
model/kronos.py |
KronosTokenizer, Kronos(예측기), 샘플링 함수, auto_regressive_inference, 고수준 KronosPredictor(정규화·예측·역정규화). 두 모델 클래스 모두 PyTorchModelHubMixin을 상속해 from_pretrained 지원 |
model/module.py |
BSQ 양자화기(공식 BSQ 구현 차용), RMSNorm, SwiGLU FFN, RoPE 어텐션, 계층 임베딩, 의존성 인지 교차 어텐션 층, 이중 헤드, 시간 임베딩 |
examples/ |
단일·배치·거래량 없는 예측, A주 일봉 예측, 백테스트 예제. README가 가리키는 ./data/XSHG_5min_600977.csv는 저장소에 없다 |
finetune/ |
Qlib 기반 A주 파이프라인: 전처리 → 토크나이저 미세조정 → 예측기 미세조정(torchrun 멀티 GPU) → top-K 백테스트. 주석 다수가 AI(Gemini 2.5 Pro) 생성이라고 README가 명시 |
finetune_csv/ |
임의 CSV용 미세조정. YAML 설정 + 알리바바 5분봉 예시 데이터(93,912행, 2019-11-26~2025-09-17) |
webui/ |
Flask + Plotly 예측 UI(포트 7070). 아래 보안 절에서 따로 다룬다 |
tests/ |
고정 리비전·고정 시드로 CPU 출력 일치(rtol 1e-5)와 MSE를 확인하는 회귀 테스트 4건 |
아키텍처 ①: 캔들을 20bit 토큰으로 바꾸는 BSQ 토크나이저
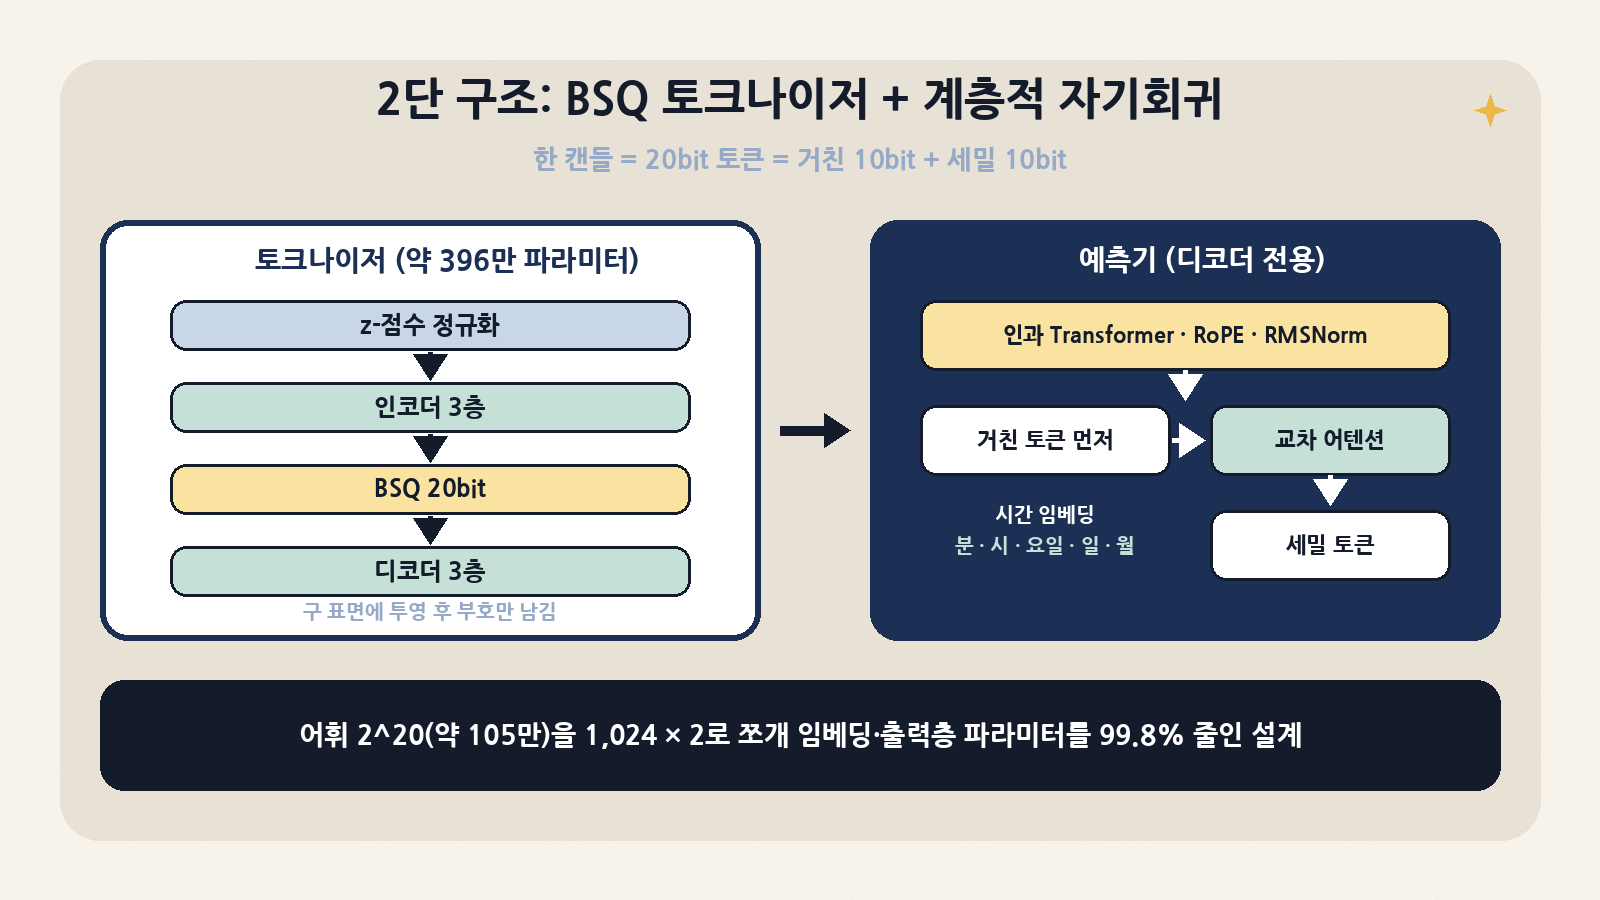
일반 시계열 파운데이션 모델은 값을 균일 구간으로 자르거나(Chronos), 연속값 패치를 그대로 넣는다(TimesFM 등). Kronos는 이미지·비디오 토크나이저 계열의 BSQ를 가져왔다. 한 시점의 6차원 벡터(OHLCVA)를 작은 Transformer 인코더로 임베딩하고, 20차원으로 투영한 뒤 단위 구 위로 정규화하고 각 차원의 부호만 남긴다. 그러면 각 시점이 220(약 105만) 가지 중 하나인 20bit 코드가 된다. 코드북을 명시적으로 저장하지 않는 “룩업 없는” 양자화라 코드북 붕괴 문제가 적고, 논문은 구 투영 덕분에 양자화 오차의 기댓값이 상한을 갖는다는 점(이상치에 강함)을 근거로 든다.
핵심은 20bit를 앞 10bit(거친 토큰 s1)와 뒤 10bit(세밀 토큰 s2)로 나눈 것이다. 학습 시 거친 토큰만으로 복원한 결과와 전체 토큰으로 복원한 결과를 함께 손실에 넣어서, 앞 절반이 큰 그림을, 뒤 절반이 잔차를 담도록 강제한다. 입력 전처리는 창 단위 z-점수 정규화 후 ±5로 자르는(clip) 방식이다.
| 항목 | Tokenizer-2k | Tokenizer-base | 설명 |
|---|---|---|---|
| d_in / d_model | 6 / 256 | 6 / 256 | OHLCVA 6개를 256차원으로 |
| 인코더·디코더 블록 | 설정값 4 → 실제 3블록 | 설정값 4 → 실제 3블록 | 코드가 range(n_enc_layers - 1)로 생성. 논문 서술(3층)과 일치 |
| s1 / s2 bits | 10 / 10 | 10 / 10 | 거친·세밀 각 1,024가지 |
| BSQ group_size | 5 | 4 | 엔트로피 손실 근사용 그룹 크기(파라미터 수에는 영향 없음) |
| β / γ0 / γ / ζ | 0.05 / 1.0 / 1.1 / 0.05 | 0.05 / 1.0 / 1.1 / 0.05 | BSQ 공식 구현 기본값 |
| 실측 파라미터 | 3,958,042 | 3,958,042 | 박스에서 sum(p.numel()) |
| 짝지어 쓰는 모델 | Kronos-mini | Kronos-small·base | 토크나이저를 섞으면 안 된다 |
아키텍처 ②: 거친 토큰 먼저, 세밀 토큰은 교차 어텐션으로
예측기는 표준적인 Pre-LN 디코더다. 거친·세밀 토큰을 각각 1,024개짜리 임베딩으로 바꿔 이어 붙이고 선형층으로 합친 다음, 분·시·요일·일·월 시간 임베딩을 더한다. 블록은 RoPE 인과 셀프 어텐션 + SwiGLU FFN + RMSNorm 조합이다. 출력은 두 단계다. 먼저 마지막 은닉 상태로 거친 토큰 s1의 분포를 내고 샘플링한다. 그다음 샘플된 s1의 임베딩을 쿼리로, 은닉 상태를 키·값으로 쓰는 의존성 인지 교차 어텐션 층을 거쳐 세밀 토큰 s2를 샘플링한다. 즉 p(s1|과거)·p(s2|과거, s1)로 분해한 것이다.
이렇게 쪼개는 이유는 파라미터다. 논문 부록 표 12에 따르면 base 기준으로 220 어휘를 통째로 쓰면 임베딩·출력층만 약 17억 4천만 파라미터가 되지만, 1,024×2로 나누면 340만으로 줄어든다(99.8% 감소). 대신 토큰 하나를 만들 때 순차 단계가 두 번 필요하다. 논문은 n=4, 5로 더 쪼개면 파라미터 이득은 미미하고 지연만 커진다며 n=2를 택했다. 학습 때 s2 예측에 정답 s1이 아니라 모델이 샘플한 s1을 쓰는 것(노출 편향 완화)도 특징인데, 실제 코드의 forward()에서도 use_teacher_forcing=False이면 torch.multinomial로 s1을 뽑는다.
| 모델 | 층 | d_model | d_ff | 헤드 | 컨텍스트 | 파라미터(박스 실측) | 토크나이저 |
|---|---|---|---|---|---|---|---|
| Kronos-mini | 4 | 256 | 512 | 4 | 2,048 | 4,108,032 | Tokenizer-2k |
| Kronos-small | 8 | 512 | 1,024 | 8 | 512 | 24,741,376 | Tokenizer-base |
| Kronos-base | 12 | 832 | 2,048 | 16 | 512 | 102,310,592 | Tokenizer-base |
| Kronos-large (비공개) | 18 | 1,664 | 3,072 | 32 | 512 | 499.2M(논문) | Tokenizer-base |
설정값은 HF config.json에서, 파라미터 수는 박스에서 직접 셌다. README·논문의 4.1M/24.7M/102.3M과 정확히 맞는다. 세 모델 모두 learn_te=true(학습형 시간 임베딩)이고, small만 attention·token dropout이 0.1로 다르다. mini는 작지만 컨텍스트가 2,048로 가장 길다는 점이 실무에서 의외로 중요하다(아래 실측에서 확인).
추론 루프를 코드로 읽기: 비용과 함정
auto_regressive_inference()는 60줄 남짓이다. 입력을 sample_count만큼 복제해 배치로 만들고, 토크나이저로 과거를 인코딩한 뒤, 길이 max_context의 토큰 버퍼를 굴리며 한 스텝씩 생성한다. 마지막에 생성 토큰을 토크나이저 디코더로 연속값으로 되돌리고 표본 경로들의 평균을 반환한다. 읽어 보면 실무에서 알아야 할 성질이 바로 드러난다.
| 성질 | 코드에서 확인한 동작 | 실무 의미 |
|---|---|---|
| KV 캐시 없음 | 매 스텝 decode_s1()이 창 전체(최대 512 토큰)를 처음부터 다시 통과 |
예측 길이에 비례해 비용이 선형 이상으로 늘어난다. GPU에서도 긴 예측은 느리다 |
| 창 밀기 | 창이 차면 torch.roll로 버퍼를 한 칸 밀고 새 토큰을 끝에 씀 |
small·base는 과거 512봉 이상을 기억하지 못한다 |
| 정규화 범위 | KronosPredictor.predict()는 넘겨준 과거 전체로 평균·표준편차를 계산한 뒤 모델에는 마지막 512개만 보임 |
lookback을 길게 주면 모델이 보지 않는 구간이 정규화 기준을 바꾼다 |
| sample_count | N개 경로를 생성해 np.mean(axis=1) |
반환값은 점 예측(평균 경로). 분위수·분포가 필요하면 직접 루프를 돌려 경로를 모아야 한다 |
| top_k vs top_p | top_k>0이면 top-k만 적용하고 바로 반환(top_p 무시). 4월 PR #232가 이 함수의 호출 버그를 고쳤다 |
회귀 테스트는 top_k=1로 사실상 그리디 디코딩을 고정 |
| 거래량 누락 | volume 없으면 volume·amount를 0으로, amount만 없으면 volume×평균가로 채움 | 논문도 학습 중 5% 샘플의 거래량을 0으로 지워 대비했다고 설명 |
| 캔들 일관성 | OHLC를 독립적으로 복원하므로 고가<max(시가,종가) 같은 모순 가능 | 후처리 검증 필요(실측: 최대 11.8% 봉에서 발생) |
| 장치 선택 | device=None이면 CUDA → MPS → CPU 순 자동 선택(PR #211, 2026-01 병합) |
맥북(MPS)에서도 그대로 동작하도록 설계 |
# model/kronos.py 핵심부(요약): 매 스텝 창 전체를 다시 계산한다
for i in range(pred_len):
    s1_logits, context = model.decode_s1(pre_buf, post_buf, stamp)   # 전체 창 forward
    s1 = sample_from_logits(s1_logits[:, -1, :], T, top_k, top_p)
    s2_logits = model.decode_s2(context, s1)                           # 교차 어텐션
    s2 = sample_from_logits(s2_logits[:, -1, :], T, top_k, top_p)
    # 버퍼가 차면 torch.roll로 한 칸 밀고 맨 끝에 (s1, s2) 기록
z = tokenizer.decode([full_pre, full_post], half=True)
preds = z.reshape(-1, sample_count, L, 6).mean(axis=1)                # 경로 평균
논문이 주장하는 것과 우리가 확인할 수 있는 것
논문 수치는 인상적이다. 다만 대부분은 공개되지 않은 데이터셋과 비공개 large 모델을 포함한 결과라 그대로 재현할 수 없다. 무엇이 검증 가능한지부터 나눠 두는 게 좋다.
| 항목 | 논문 주장 | 검증 가능성 |
|---|---|---|
| 사전학습 데이터 | 45개 이상 거래소, 7가지 주기, 120억 개 이상 K-라인. 한국거래소(XKRX)는 “분포 내” 시장으로 분류 | 데이터 비공개. 재현 불가 |
| 데이터 종료 시점 | 사전학습 데이터는 2024년 6월까지, 평가는 2024년 7월부터 | 공개 체크포인트가 같은 데이터로 학습됐는지는 별도 명시 없음 |
| 가격 시계열 예측 | 최고 TSFM 대비 RankIC +93%, 비사전학습 최고 모델 대비 +87% | 평가 코드·데이터 미공개 |
| 변동성·생성 | 실현 변동성 MAE 9% 감소, 합성 K-라인 충실도 22% 개선 | 미공개 |
| 모의 투자 | CSI300·800 top-k 전략에서 연환산 초과수익 1위(large 0.2084, small 0.1789 평균) | Qlib 파이프라인은 공개, 데이터는 직접 준비해야 함 |
| 추론 권장값 | 예측 과제 T=0.6, top-p 0.9, 표본 N=10. 표본을 늘릴수록 IC 상승(테스트 타임 스케일링) | 공개 모델로 직접 실험 가능 → 아래 실측 |
| 코드북 사용률 | 거친 97.66%, 세밀 85.25% | 토크나이저로 일부 확인 가능 → 아래 실측 |
설치와 실행: 10분이면 첫 예측
git clone https://github.com/shiyu-coder/Kronos && cd Kronos
python3 -m venv .venv && . .venv/bin/activate
pip install torch --index-url https://download.pytorch.org/whl/cpu   # GPU면 CUDA 휠
pip install -r requirements.txt
export HF_HOME=$PWD/.hf            # 가중치 캐시 위치 고정(약 530 MB, 3종 전부)
python - <<'EOF'
import pandas as pd
from model import Kronos, KronosTokenizer, KronosPredictor
tok = KronosTokenizer.from_pretrained("NeoQuasar/Kronos-Tokenizer-base", revision="0e0117387f39004a9016484a186a908917e22426")
mdl = Kronos.from_pretrained("NeoQuasar/Kronos-small", revision="901c26c1332695a2a8f243eb2f37243a37bea320")
p = KronosPredictor(mdl, tok, max_context=512)            # device 자동 선택
df = pd.read_csv("finetune_csv/data/HK_ali_09988_kline_5min_all.csv", parse_dates=["timestamps"])
x, y = df.iloc[-176:-48], df.iloc[-48:]
out = p.predict(df=x[["open","high","low","close","volume"]].reset_index(drop=True),
                x_timestamp=x.timestamps.reset_index(drop=True),
                y_timestamp=y.timestamps.reset_index(drop=True),
                pred_len=48, T=0.6, top_p=0.9, sample_count=5, verbose=False)
print(out[["open","high","low","close"]].tail())
EOF
python -m pytest -q tests/test_kronos_regression.py # 고정 리비전 회귀 테스트| 명령 | 용도 | 주의 |
|---|---|---|
pip install -r requirements.txt |
추론 의존성 | pandas·huggingface_hub 버전이 고정(==)돼 있어 기존 환경과 충돌 가능 → 전용 venv 권장 |
from_pretrained(..., revision=...) |
가중치 고정 | 리비전을 안 주면 main을 받는다. 재현성이 필요하면 커밋 해시 고정 |
python -m pytest tests/ |
환경 검증 | CPU에서 기대 출력과 rtol 1e-5 일치 확인. 첫 실행 시 HF 다운로드 |
python finetune/qlib_data_preprocess.py |
A주 데이터 준비 | pip install pyqlib + Qlib 데이터 별도 다운로드 필요 |
torchrun --standalone --nproc_per_node=N finetune/train_tokenizer.py |
토크나이저 미세조정 | 멀티 GPU 전제. 이후 train_predictor.py |
python finetune_csv/train_sequential.py --config ...yaml |
CSV 미세조정 | YAML의 /xxx/ 경로를 모두 바꿔야 함 |
cd webui && python app.py |
웹 UI | 0.0.0.0:7070 + 디버그 모드로 뜬다. 아래 보안 절에서 다룬다 |
박스 실측 ①: 환경과 회귀 테스트
실험 환경은 다음과 같다. 다른 작업과 섞이지 않도록 venv·HOME·HF 캐시를 작업 폴더 안에 따로 만들고, API 키나 HF 토큰 없이 공개 가중치만 받았다. 가중치를 받은 뒤에는 HF_HUB_OFFLINE=1로 오프라인에서 돌렸다.
| 항목 | 값 |
|---|---|
| 하드웨어 | 리눅스 VM, 8 vCPU, RAM 15 GB, GPU 없음 |
| 소프트웨어 | CPython 3.12 (uv venv) · torch 2.14.1+cpu(CPU 전용 휠) · pandas 2.2.2 · huggingface_hub 0.33.1 |
| 코드 | master 67b630e (2026-04-13 21:38 KST) |
| 가중치 | HF main 리비전 5종 다운로드, 캐시 531 MB. 로드 시간 mini 2.2초 · small 2.6초 · base 3.4초 |
| 회귀 테스트 | 4 passed / 16.0초. 고정 시드 MSE 0.008979(512 컨텍스트, 기대값과 차이 +9.6e-9), 0.003742(256 컨텍스트, 차이 +5.1e-7) |
| 재현성 | 같은 시드에서 스레드 1개·8개 결과가 동일(종가 116.94로 일치) → CPU에서는 결정적 |
박스 실측 ②: CPU 추론 속도
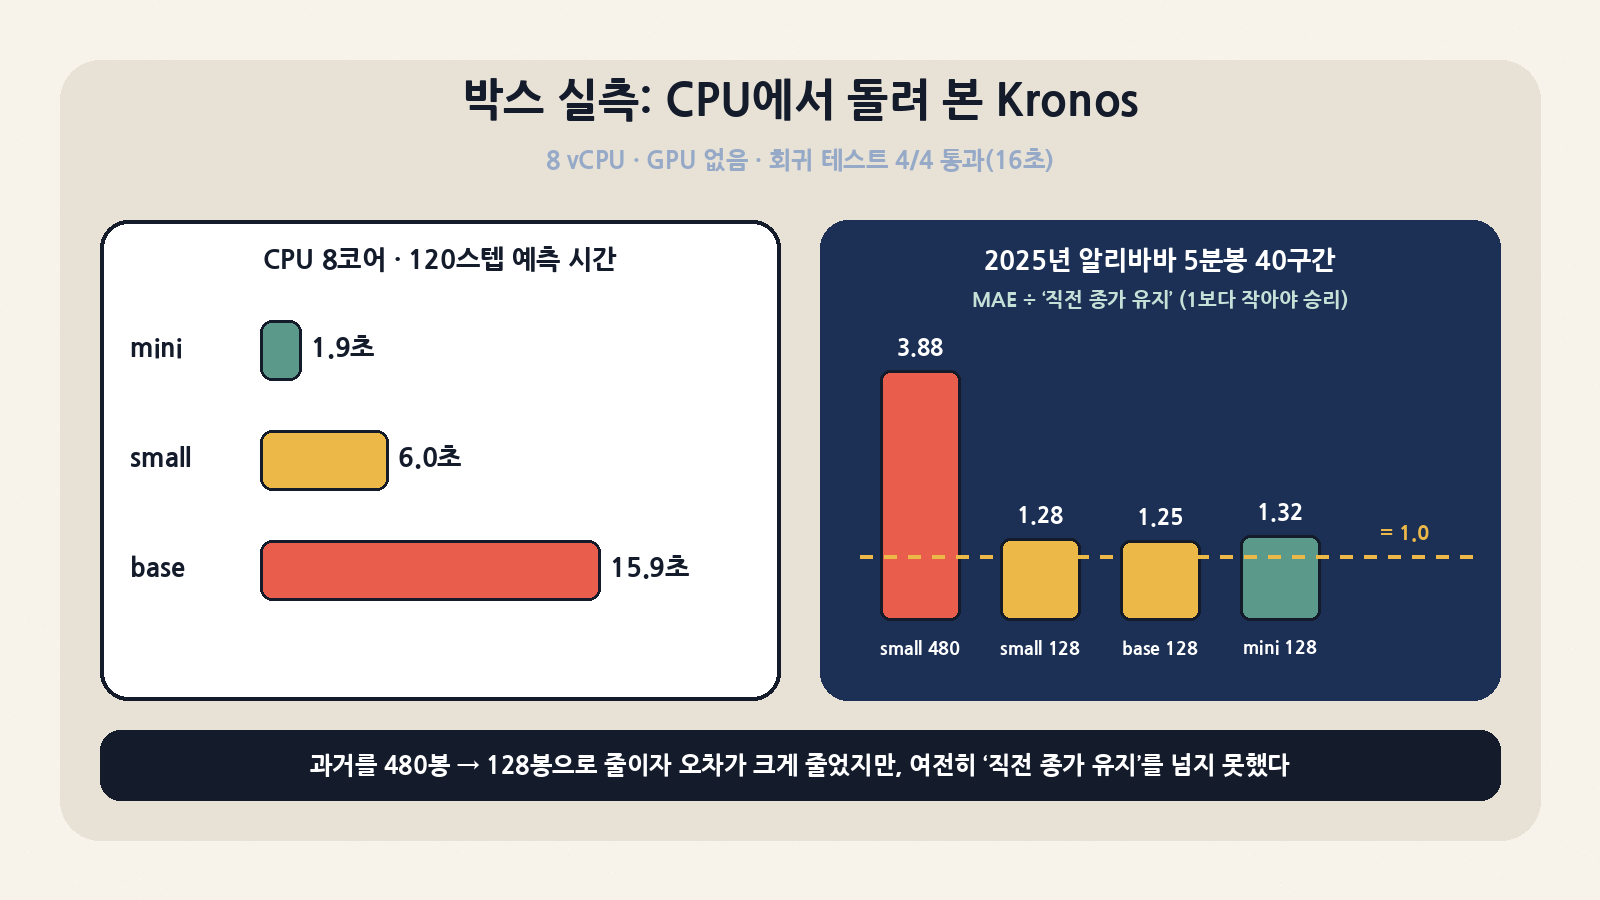
알리바바 5분봉에서 2025-06-02 직전 구간을 넣고 시간을 쟀다. 예측 스텝당 비용은 모델 크기에 거의 비례한다. 표본 수(sample_count)는 배치로 처리되지만 CPU에서는 거의 선형으로 늘었다.
| 모델 | 과거 → 예측(봉) | 표본 | 총 시간 | 스텝당 |
|---|---|---|---|---|
| mini | 400 → 120 | 1 | 1.94초 | 16.1 ms |
| mini | 1,500 → 120 | 1 | 4.44초 | 37.0 ms (긴 컨텍스트) |
| small | 400 → 120 | 1 | 6.00초 | 50.0 ms |
| small | 400 → 120 | 5 | 24.85초 | 207.1 ms (표본 5배 → 4.1배) |
| small | 400 → 30 | 1 | 1.50초 | 49.9 ms |
| small | 480 → 96 (논문 5분봉 설정) | 1 | 4.54초 | 47.3 ms |
| small | 1,000 → 120 | 1 | 5.20초 | 43.3 ms (512로 잘려 400과 비슷) |
| small | 400 → 120, 거래량 없음 | 1 | 5.64초 | 47.0 ms |
| small | 400 → 120, 스레드 1개 | 1 | 19.25초 | 160.4 ms (8스레드 대비 3.2배) |
| base | 400 → 120 | 1 | 15.89초 | 132.4 ms |
수백 종목을 매일 장 마감 후 돌리는 배치라면 CPU로도 감당할 수 있는 수준이다. 하지만 5분봉 종목 수천 개를 장중에 실시간으로 갱신하거나, 논문 권장대로 표본 10개를 쓰려면 GPU와 predict_batch가 사실상 필수다.
박스 실측 ③: 2025년 알리바바 5분봉 40개 창, 기준선과 비교
정확도 실험은 이렇게 설계했다. 저장소에 동봉된 알리바바(09988.HK) 5분봉에서 2025-01-09 ~ 2025-09-16 사이 예측 시작점 40개를 무작위(시드 고정)로 뽑았다. 논문이 밝힌 사전학습 데이터 종료(2024년 6월) 이후 구간이다. 과거 480봉(논문의 5분봉 설정)을 넣고 다음 48봉(약 4시간)을 예측했다. 비교 기준은 가장 단순한 “직전 종가 유지”(persistence)다. 지표는 ① 48봉 종가 경로의 MAE와 그 기준선 대비 비율(1보다 작아야 기준선보다 낫다), ② 48봉 뒤 수익률 방향 적중률, ③ 40개 창에 걸친 예측 수익률과 실제 수익률의 IC(피어슨)·RankIC(스피어먼), ④ 예측 경로로 계산한 실현 변동성(로그수익률 제곱합)의 MAE, ⑤ 고가·저가가 시가·종가를 감싸지 못하는 “모순 봉” 비율이다.
| 설정 (과거 480봉) | 종가 MAE(HKD) | ÷기준선 | 기준선보다 나은 창 | 방향 적중 | IC / RankIC | 실현변동성 MAE ×1e-4 | 모순 봉 | 예측 1회 |
|---|---|---|---|---|---|---|---|---|
| mini · T=1.0 · 표본 1 | 1.53 | 1.38 | 14/40 | 47.5% | -0.15 / -0.13 | 5.0 (기준 6.4) | 11.8% | 0.5초 |
| small · T=1.0 · 표본 1 | 4.32 | 3.88 | 2/40 | 45.0% | +0.23 / -0.00 | 11.4 (기준 6.4) | 7.1% | 2.1초 |
| small · T=0.6 · 표본 5 | 3.94 | 3.54 | 4/40 | 45.0% | +0.24 / -0.00 | 6.0 (기준 6.4) | 0.8% | 10.9초 |
| base · T=1.0 · 표본 1 | 4.22 | 3.79 | 4/40 | 45.0% | +0.26 / -0.06 | 12.2 (기준 6.4) | 7.6% | 6.0초 |
박스 실측 ④: 원인 추적 — 창 평균으로 끌려가는 예측
small·base의 오차가 유독 큰 이유를 확인하려고 한 창을 뜯어봤다. 2025-06-02 시작 창에서 직전 종가는 111.95였지만 과거 480봉의 평균은 115.43이었다. small은 온도·top-k·거래량 유무를 바꿔도 예측 종가가 115.7~117.8로 창 평균 쪽으로 올라갔고, 실제는 110.45로 내려갔다. 그래서 40개 창 전체에서 “예측 수익률”과 “창 평균과 직전 종가의 괴리”의 상관을 계산했다. 같은 40개 창·같은 시드로 과거 길이만 바꿔 다시 돌렸다(480봉 small 결과가 앞 실험과 소수점까지 같아 재현성도 확인됐다).
| 설정 (T=1.0, 표본 1) | MAE ÷기준선 | 기준선보다 나은 창 | 방향 적중 | RankIC | 예측수익률 vs 창평균 괴리 상관 | 평균 |예측 수익률| | 실현변동성 MAE ×1e-4 |
|---|---|---|---|---|---|---|---|
| small · 128봉 | 1.28 | 18/40 | 55.0% | +0.23 | +0.63 | 1.43% (실제 1.58%) | 4.2 |
| small · 256봉 | 1.52 | 12/40 | 42.5% | -0.03 | +0.40 | 1.65% (실제 1.58%) | 3.1 |
| small · 480봉 | 3.88 | 2/40 | 45.0% | -0.00 | +0.90 | 5.44% (실제 1.58%) | 11.4 |
| base · 128봉 | 1.25 | 16/40 | 42.5% | -0.03 | +0.62 | 1.18% (실제 1.58%) | 4.3 |
| mini · 128봉 | 1.32 | 13/40 | 55.0% | +0.15 | +0.16 | 1.16% (실제 1.58%) | 4.1 |
| mini · 480봉 | 1.38 | 14/40 | 47.5% | -0.13 | -0.09 | 1.12% (실제 1.58%) | 5.0 |
패턴이 분명하다. small 480봉에서 예측 수익률과 창 평균 괴리의 상관은 +0.90이고, 예측 수익률의 평균 크기(5.44%)가 실제(1.58%)의 3배를 넘는다. 실제 수익률과 그 괴리의 상관은 +0.25에 그친다. 즉 이 종목·이 기간에서 small·base는 “창 평균으로 되돌아간다”는 사전 분포를 지나치게 강하게 적용했다. 창 단위 z-점수 정규화를 쓰는 모델에서 자연스럽게 생길 수 있는 편향이다. 과거를 128봉으로 줄이면 상관이 +0.62~0.63으로 낮아지고 MAE 비율도 1.25~1.28로 크게 좋아진다. 컨텍스트 2,048짜리 토크나이저를 쓰는 mini는 이 편향이 거의 없었다(상관 −0.09~+0.16).
그래도 어느 설정도 경로 MAE에서 “직전 종가 유지”를 넘지 못했다. 다만 짧은 구간 가격 수준에서 랜덤워크 기준선을 이기기 어렵다는 건 거의 모든 예측 모델에 해당하는 이야기다. 반대로 실현 변동성에서는 128봉 설정 세 모델의 MAE가 4.1~4.3(×1e-4), small 256봉은 3.1로, 과거 48봉 변동성을 그대로 쓰는 기준선(6.4)보다 좋았다(480봉 small·base는 11~12로 오히려 나빴다). 논문이 강조하는 강점(변동성·분포 생성)과 같은 방향이다. 실무적 결론은 이렇다. lookback은 “길수록 좋다”가 아니라 반드시 튜닝해야 하는 하이퍼파라미터이고, 가격 점 예측보다 변동성·시나리오 생성에 먼저 써 보는 편이 합리적이다.
| 토크나이저 | 종가 복원 MAE(z단위) | 고가 / 저가 | 거래량 | 쓰인 거친 토큰 | 쓰인 세밀 토큰 |
|---|---|---|---|---|---|
| Tokenizer-2k | 0.043 | 0.044 / 0.043 | 0.050 | 274 / 1,024 | 78 / 1,024 |
| Tokenizer-base | 0.039 | 0.040 / 0.041 | 0.052 | 214 / 1,024 | 106 / 1,024 |
토크나이저만 따로 떼어, 같은 40개 창(19,200봉)을 인코딩했다가 다시 디코딩했다. 정규화 공간에서 종가 복원 오차는 약 0.04 표준편차로 작다. 즉 위 예측 오차의 대부분은 양자화가 아니라 예측기 쪽에서 생긴다. 한 종목만 넣었을 때 쓰인 거친 토큰은 1,024개 중 214~274개였다. 논문의 코드북 사용률(거친 97.66%)은 전체 말뭉치 기준이라 직접 비교할 수는 없지만, 한 종목의 일상적인 봉 모양이 어휘의 일부에 몰린다는 점은 확인할 수 있다.
웹 UI 보안 점검: 0.0.0.0 + 디버그 모드
webui/app.py의 마지막 줄은 app.run(debug=True, host='0.0.0.0', port=7070)이다. 실제로 어떤지 보려고 박스에서 네트워크가 끊긴 별도 네임스페이스(unshare -rn)에 웹 UI를 띄우고 루프백에서만 요청을 보냈다. 확인한 내용은 아래와 같다.
| 항목 | 박스 확인 결과 | 위험 |
|---|---|---|
| 바인드 주소 | 0.0.0.0:7070 LISTEN 확인 |
같은 와이파이·사내망의 누구나 접속 가능 |
| 디버그 모드 | 로그에 “Debug mode: on”, “Debugger is active!”. /console이 HTTP 200 |
Werkzeug 대화형 콘솔은 PIN으로 보호되지만, 뚫리면 곧바로 원격 코드 실행. 외부 노출 금지가 Flask 공식 권고 |
| CORS | 임의 Origin(http://evil.example)에 Access-Control-Allow-Origin을 그대로 돌려줌 |
아무 웹페이지나 브라우저를 경유해 API를 호출 가능 |
| 파일 경로 | POST /api/load-data가 저장소 밖 /tmp/*.csv도 그대로 읽음(OHLC 열이 있으면 요약 반환) |
경로 제한 없음. 민감 CSV가 있는 서버라면 문제 |
| 인증 | 없음 | 모델 로드·예측 엔드포인트를 누구나 호출 가능(CPU·메모리 소모) |
app.run(debug=False, host='127.0.0.1', port=7070)로 바꾸고, CORS(app)는 지우거나 허용 Origin을 명시하자. 팀에서 공유하려면 리버스 프록시 뒤에 인증을 두고, /api/load-data는 data/ 디렉터리 안 파일명만 받도록 고쳐야 한다.비슷한 도구와 비교
논문 부록 표 3은 주요 시계열 파운데이션 모델을 구조·토큰화·확률 예측 여부·사전학습 데이터 중 금융 비중으로 비교한다. 금융 비중은 논문 저자들의 추정치다.
| 모델 | 구조 | 토큰화 | 확률 예측 | 금융 데이터 비중(논문 추정) | 특징 |
|---|---|---|---|---|---|
| Kronos | 디코더 전용 | 이산(BSQ, 2단 토큰) | 예(샘플링) | 100% | OHLCV 6채널을 한 토큰으로 묶어 다변량 캔들 구조를 직접 모델링 |
| Chronos | 인코더-디코더 | 이산(스케일링+균일 양자화) | 예 | 0.45% | 단변량 값 토큰화. 범용 벤치마크 강자 |
| TimesFM | 디코더 전용 | 연속(패치) | 아니오 | <0.01% | 범용 장기 예측, 패치 단위로 빠름 |
| Moirai | 인코더 전용 | 연속 | 예 | 0.10% | 다변량·다주기 범용 |
| Time-MoE | 디코더 전용 | 연속 | 아니오 | <0.01% | MoE로 대규모화 |
| Lag-Llama | 디코더 전용 | 연속 | 예 | 0.01% | 확률 예측 초기 모델 |
| Sundial | 디코더 전용 | 연속 | 예 | 1.02% | 범용 생성형 TSFM |
Kronos의 차별점은 두 가지다. 하나는 사전학습 데이터가 100% 금융 K-라인이라는 것, 다른 하나는 OHLCV를 따로따로 예측하지 않고 한 봉 전체를 하나의 토큰으로 다룬다는 것이다. 반대로 범용 TSFM은 금융 외 도메인(수요·센서·트래픽)에서 쓰기 편하고, 대부분 패키지로 설치된다. Microsoft Qlib 같은 퀀트 플랫폼은 경쟁자라기보다 Kronos의 미세조정·백테스트 파이프라인이 기대는 기반이다.
라이선스·데이터·운영 리스크
| 주제 | 현황 | 실무 판단 |
|---|---|---|
| 코드·가중치 라이선스 | MIT(저장소·HF 모델 카드) | 상업적 사용·수정 자유. 저작권 고지 유지 |
| 학습 데이터 | 120억 봉의 출처·라이선스 목록 비공개(부록 표 13에 거래소별 통계만) | 데이터 라이선스 이슈가 생겨도 사용자가 판단할 근거가 적다 |
| 재현성 | large·평가 데이터 비공개, GitHub 릴리스·태그 없음 | HF 리비전 해시를 반드시 고정. 회귀 테스트로 환경 검증 |
| 유지보수 | 마지막 커밋 2026-04-13, 열린 PR 69 / 병합 19 | 버그 수정은 직접 포크해 반영할 각오 |
| 예제 코드 품질 | README 예제 데이터 파일 누락, 미세조정 주석 다수 AI 생성(README 고지), 4월에야 미세조정 데이터셋의 미래 정보 누수(정규화 범위) 수정 | 백테스트 결과는 누수 여부부터 의심하고 검증 |
| 모델 공급망 | from_pretrained가 safetensors를 받음(pickle 아님) |
가중치 로드 자체의 코드 실행 위험은 낮다. 다만 finetune/은 데이터셋을 pickle로 저장·로드하므로 남이 준 .pkl은 열지 말 것 |
| 규제·책임 | 예측 결과를 자동매매에 연결하면 투자 판단 책임은 사용자에게 | 실거래 전 슬리피지·수수료·체결을 반영한 별도 백테스트 필수 |
도입 체크리스트
- 버전 고정: 저장소 커밋(
67b630e)과 HF 리비전 해시를 함께 고정하고,tests/test_kronos_regression.py를 CI에 넣어 환경 표류를 잡는다. - lookback 튜닝: 자산·주기별로 64~512봉을 그리드 탐색한다. 이번 실측처럼 길게 줄수록 나빠질 수 있다. mini(컨텍스트 2,048)도 반드시 후보에 넣는다.
- 기준선부터: “직전 종가 유지”, 이동평균, GARCH 같은 단순 기준선을 같은 창·같은 지표로 먼저 돌린다. Kronos가 기준선을 못 이기면 미세조정으로 넘어간다.
- 점 예측보다 분포:
sample_count는 평균만 돌려주므로, 시나리오·변동성 용도라면 경로를 직접 모으는 래퍼를 만든다. - 후처리 검증: 고가≥max(시가,종가), 저가≤min(시가,종가), 거래량≥0을 강제하거나 위반 봉을 걸러 낸다.
- 웹 UI는 로컬 전용으로:
debug=False,127.0.0.1바인드, CORS 제한. - 미세조정 시 누수 점검: 정규화 통계를 과거 구간에서만 계산하는지(2026-04 PR #227 반영 여부) 확인한다.
정리
Kronos는 “캔들 하나를 토큰 하나로”라는 아이디어를 꽤 깔끔하게 구현한 프로젝트다. BSQ로 OHLCV를 20bit 코드로 바꾸고, 그 코드를 거친 10bit와 세밀 10bit로 나눠 어휘 폭발을 피했으며, 디코더는 거친 토큰을 먼저 뽑은 뒤 교차 어텐션으로 세밀 토큰을 뽑는다. 코드는 1,200줄 남짓으로 읽기 쉽고, MIT 라이선스의 가중치 3종이 공개돼 있으며, 공식 회귀 테스트는 CPU에서 16초 만에 4건 모두 통과했다. 그러나 박스에서 2025년 알리바바 5분봉 40개 창으로 재 보니, 논문 설정(과거 480봉)의 small·base는 창 평균 쪽으로 강하게 끌려가며 “직전 종가 유지”보다 3.5~3.9배 큰 오차를 냈다. 과거를 128봉으로 줄이면 크게 나아졌고, 변동성 추정은 기준선보다 좋았다. 정리하면 Kronos는 “설치하면 바로 맞히는 주가 예측기”가 아니라, lookback·샘플링·미세조정을 직접 다듬어야 하는 금융 시계열용 생성 모델의 출발점이다. 웹 UI만큼은 그대로 띄우지 말자.