테크부터 경제, 생활까지. 복잡한 소식을 쉽게 풀어봅니다. — 오늘 오후 오픈소스 딥다이브는 쉬운 설명보다 깊이를 먼저 챙겼습니다.
2026년 11월 9일(KST) GitHub Trending 일간 전체 2위, Go 언어 1위에 오른 저장소는 모델도 에이전트도 아닌 Kubernetes 관리 평면이었습니다. dsx-ai-factory/nvke, 즉 NVIDIA Kubernetes Engine(NVKE)입니다. 이날 하루 345개, 누적 956개(17시 전후 기준)의 별을 받았습니다. README의 한 줄 소개는 “Run a managed Kubernetes service on your own NVIDIA GPU infrastructure”, 자기 GPU 인프라 위에서 매니지드 Kubernetes 서비스를 직접 운영하라는 뜻입니다.
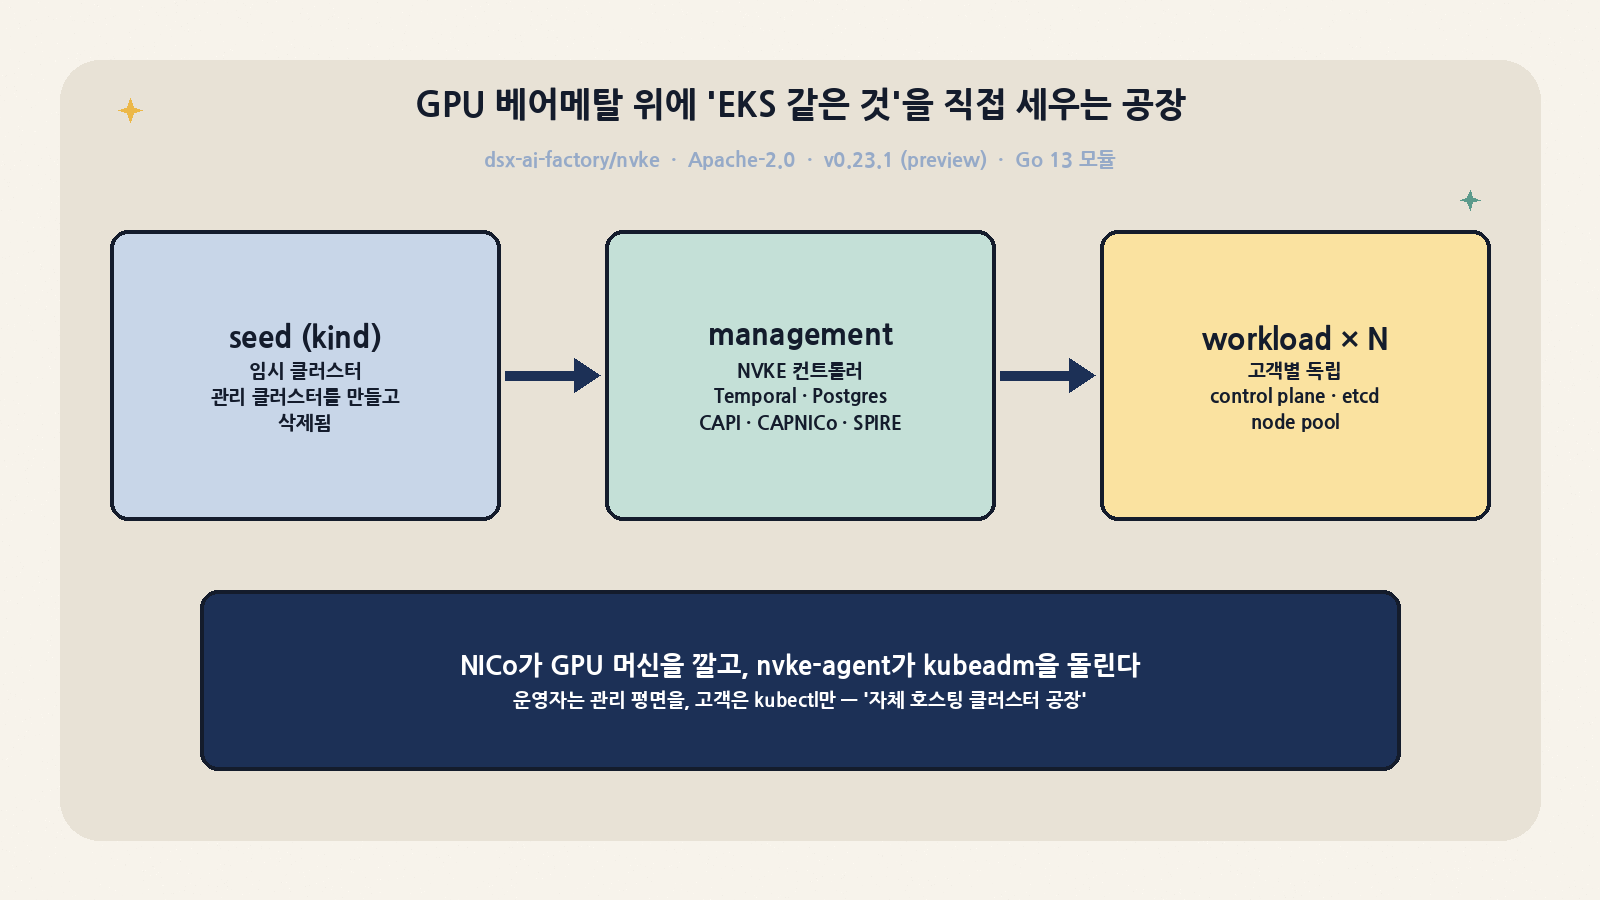
쉽게 말하면 “EKS나 GKE 같은 것을 GPU 베어메탈 위에 직접 세우는 데 필요한 관리 소프트웨어”를 NVIDIA가 Apache-2.0으로 공개한 것입니다. AI 팩토리 운영자, 문서 표현으로는 NVIDIA Cloud Partner 같은 GPU 클라우드 사업자가 주 대상입니다. 이 글에서는 저장소의 13개 Go 모듈, transactional outbox → Temporal → Cluster API → nvke-agent로 이어지는 요청 경로, TPM/SPIFFE 기반 노드 신원, preview 단계의 한계를 코드와 문서로 확인했습니다. 마지막으로 박스에서 nvkectl을 빌드하고 site spec 생성·검증과 단위 테스트를 직접 돌려 봤습니다.
한눈에 보기
| 항목 | 내용 |
|---|---|
| 저장소 | dsx-ai-factory/nvke (NVIDIA CORPORATION & AFFILIATES 저작권) |
| 라이선스 | Apache License 2.0 (LICENSE, NOTICE) |
| 최신 정식 릴리스 | v0.23.1 — 2026-11-04 08:54 KST 게시 (tenant kubeconfig 파싱 allowlist 버그 수정 백포트) |
| 분석 기준 커밋 | 92c39b8a = 태그 v0.24.0-beta.7 (2026-11-07 09:45 KST) |
| 상태 | Preview: API·설정·동작이 릴리스마다 바뀔 수 있으며, 프로덕션 워크로드에는 권장하지 않음 |
| 첫 공개 프리뷰 | v0.22.0 (2026-10-22 01:38 KST 게시), “first public preview release” |
| 언어·빌드 | Go 1.27.3(go.work 고정), GNU Make 4+, make build로 바이너리 9개 |
| Kubernetes | 1.36.3 고정(Pinned), CNCF conformance 인증 언급 |
| 인프라 공급자 | NVIDIA Infra Controller(NICo) + CAPNICo v0.1.0 (preview 기본값), LaunchLayer는 활성화 시 지원 |
| GitHub 지표 | 956★ · 113 fork · open issue/PR 192 (2026-11-09 17시경 KST API 기준), 일간 Trending 2위 |
왜 지금 트렌딩에 올랐나
공개 시점과 릴리스 속도를 보면 이해가 됩니다. 첫 공개 프리뷰 v0.22.0이 10월 22일에 나왔고, 9일 뒤인 10월 31일에 v0.23.0(자격증명 수명주기, 인가 라이브러리 기반, nvkectl로 스택 설치)이, 11월 4일에 v0.23.1이 나왔습니다. 그사이 v0.24.0-rc.6과 beta.7 태그가 이미 붙어 있고, 11월 2일 이후 커밋만 62개입니다. GPU 클라우드 업계에서는 “GPU는 샀는데 고객에게 Kubernetes를 서비스로 파는 계층은 각자 조립한다”는 문제가 오래 있었습니다. NVIDIA가 그 계층을 DSX OS라는 AI 팩토리 소프트웨어 스택의 일부로 공개했으니, 플랫폼 엔지니어들이 몰려든 것은 자연스럽습니다.
README가 강조하는 정체성도 눈여겨볼 만합니다. “NVKE is not a Kubernetes distribution and not a Cluster API flavour. It is a self-hosting factory for Kubernetes clusters.” 업스트림 Kubernetes, kubeadm, Cluster API를 그대로 쓰면서 그 위에서 클러스터를 찍어내는 공장 역할을 하겠다는 뜻입니다.
큰 그림: 세 종류의 클러스터와 DSX OS 계층
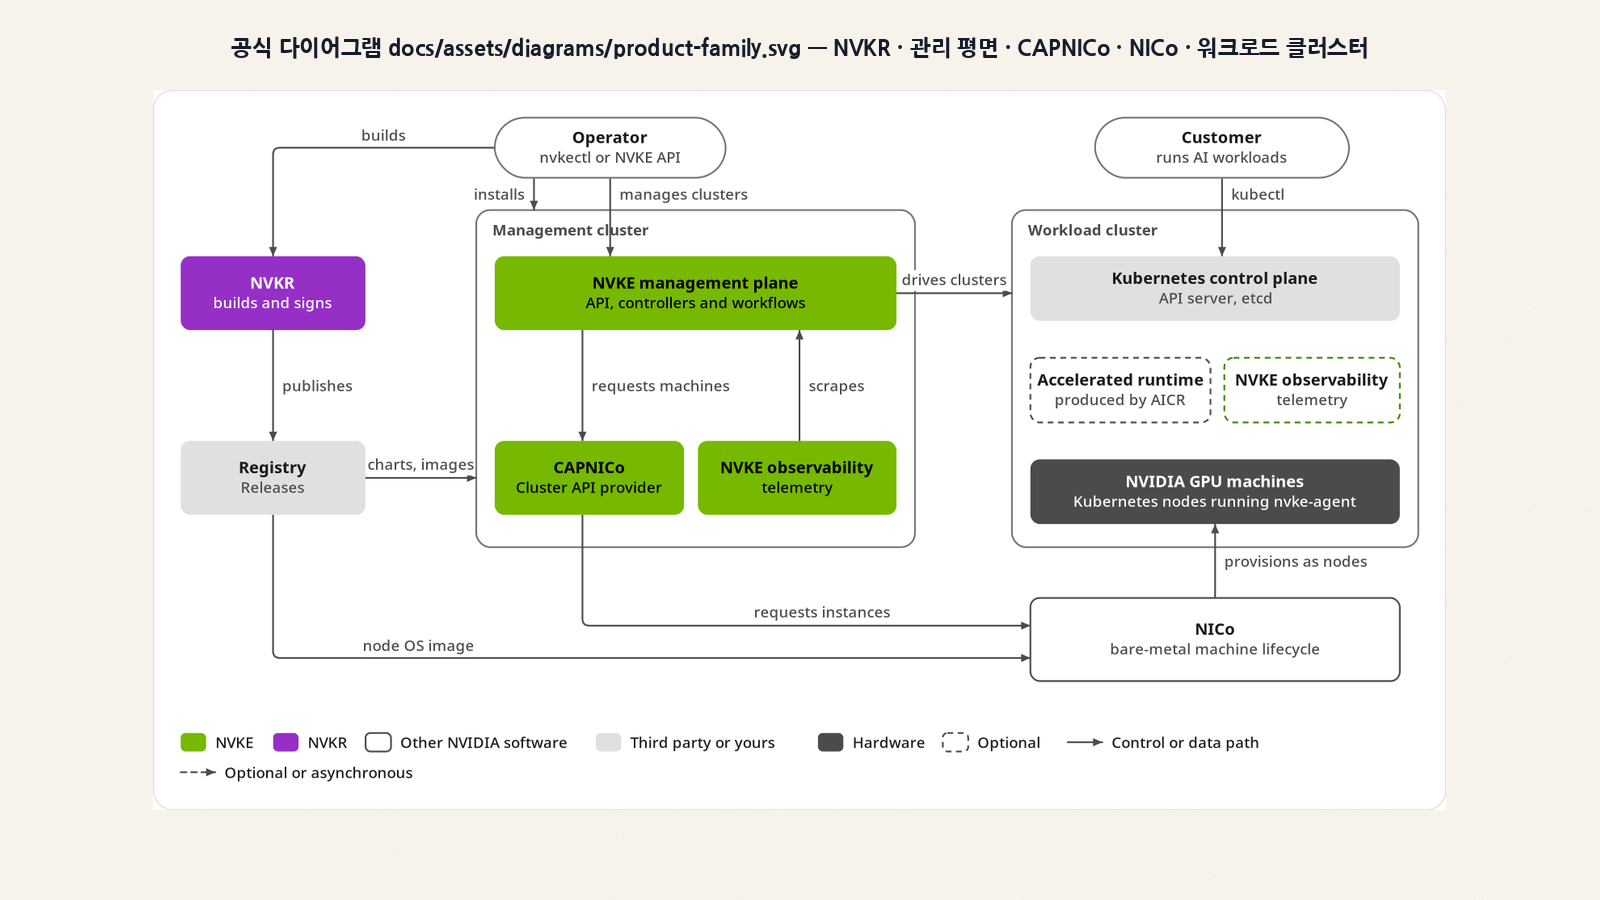
NVKE 설치에는 세 종류의 클러스터가 등장합니다.
- Seed 클러스터:
nvkectl bootstrap site가 띄우는 임시 클러스터입니다. 이 안에서 “Provisioned” 인프라 공급자(cluster-api-provider-provisioned)가 미리 준비된 호스트를 Cluster API 리소스로 다뤄 관리 클러스터를 kubeadm으로 만들고, 성공하면 삭제됩니다. - Management 클러스터: 문서상 3노드 HA 구성입니다. NVKE 컨트롤러, Temporal, PostgreSQL, SPIRE, CAPI 코어, CAPNICo, 텔레메트리 파이프라인(NKTP)이 여기서 돕니다. 운영자만 접근합니다.
- Workload(tenant) 클러스터: 고객마다 하나씩 생기며, 자체 control plane, etcd, node pool을 가집니다. 고객은 kubeconfig와
kubectl만 받습니다.
| DSX OS 계층 | 구성요소 | 역할 |
|---|---|---|
| Infrastructure | NICo | 베어메탈 머신·네트워크 수명주기: 탐색, 펌웨어, 네트워크 설정, 호스트 프로비저닝 |
| Build | NVKR (NVIDIA Kubernetes Recipes) | NVKE가 배포할 노드 이미지·바이너리·차트를 고정 입력으로 빌드하고 SBOM·서명·프로비넌스 기록 |
| Kubernetes | NVKE | NICo 머신 위에 클러스터 생성·운영 |
| Accelerated runtime | AICR | GPU Operator, Network Operator, DRA 등을 버전 고정 조합으로 워크로드 클러스터에 설치 |
| Health | NVSentinel | 노드별 GPU 장애 탐지, NVKE에 재부팅·교체 요청 |
“NVKE가 하지 않는 일”도 문서에 분명히 적혀 있습니다. 베어메탈 관리는 NICo가, OS 이미지와 Kubernetes 바이너리 배포는 운영자(NVKR 이용)가, 고객 워크로드는 고객이 맡습니다. NVKE는 그 사이에서 클러스터 형성, 노드 신원, 암호화 설정, 업그레이드, 노드 교체, 인증서 갱신을 담당합니다.
저장소 구조: 13개 모듈의 Go workspace
go.work가 모듈 목록의 기준입니다. 이 중 프로덕션에서 실제로 도는 것은 컨트롤러(Helm 차트), 노드 에이전트(Debian 패키지 + systemd), CAPI 인프라 공급자 세 가지이고, 나머지는 CLI, 생성된 API, 인증 라이브러리, CRD 타입, 테스트·개발 도구입니다. 박스에서 _test.go를 뺀 Go 코드 줄 수를 세어 규모도 함께 적었습니다(주석·생성 코드 포함, 대략치).
| 모듈 | 바이너리 | 역할 | 비테스트 Go 줄 수 / 테스트 파일 |
|---|---|---|---|
controller/ |
controller |
REST API, Temporal 워크플로, Postgres, 리컨사일러 | 약 120,058 / 503 |
agent/ |
agent |
노드마다 도는 gRPC 서버 (kubeadm, CNI, 패키지, etcd 암호화) | 약 36,816 / 57 |
cli/ |
nvkectl |
부트스트랩·클러스터·릴리스 관리 CLI | 약 24,027 / 95 |
management-engine/ |
(CRD 타입) | NVKECluster, NodePool 등 | 약 6,610 / 14 |
auth/ |
(라이브러리) | API 인증(authn)·인가(authz, Cedar 정책 번들) 라이브러리 | 약 4,598 / 25 |
cluster-api-provider-provisioned/ |
manager |
이미 프로비저닝된 호스트용 CAPI 공급자 (seed 단계) | 약 2,290 / 8 |
controller/nico-sim/ |
nico-sim |
Forge 호환 VM/컨테이너 시뮬레이터 (mock-NICo) | — |
os-image/, release/ |
nvke-os-image-check, qualify |
OS 이미지 검사, 릴리스 자격 검증 매트릭스 | — |
흥미로운 점은 거의 모든 모듈에 AGENTS.md와 CLAUDE.md가 들어 있다는 것입니다. 코딩 에이전트와 함께 개발하는 것을 전제로 한 저장소라는 뜻입니다. ROADMAP의 Exploring 항목에도 “NVKE MCP 서버와 agent skills로 AI 어시스턴트가 클러스터를 점검·운영”이 올라 있습니다. 다만 아직 계획 단계입니다.
핵심 1: API는 Temporal을 직접 부르지 않는다 (transactional outbox)
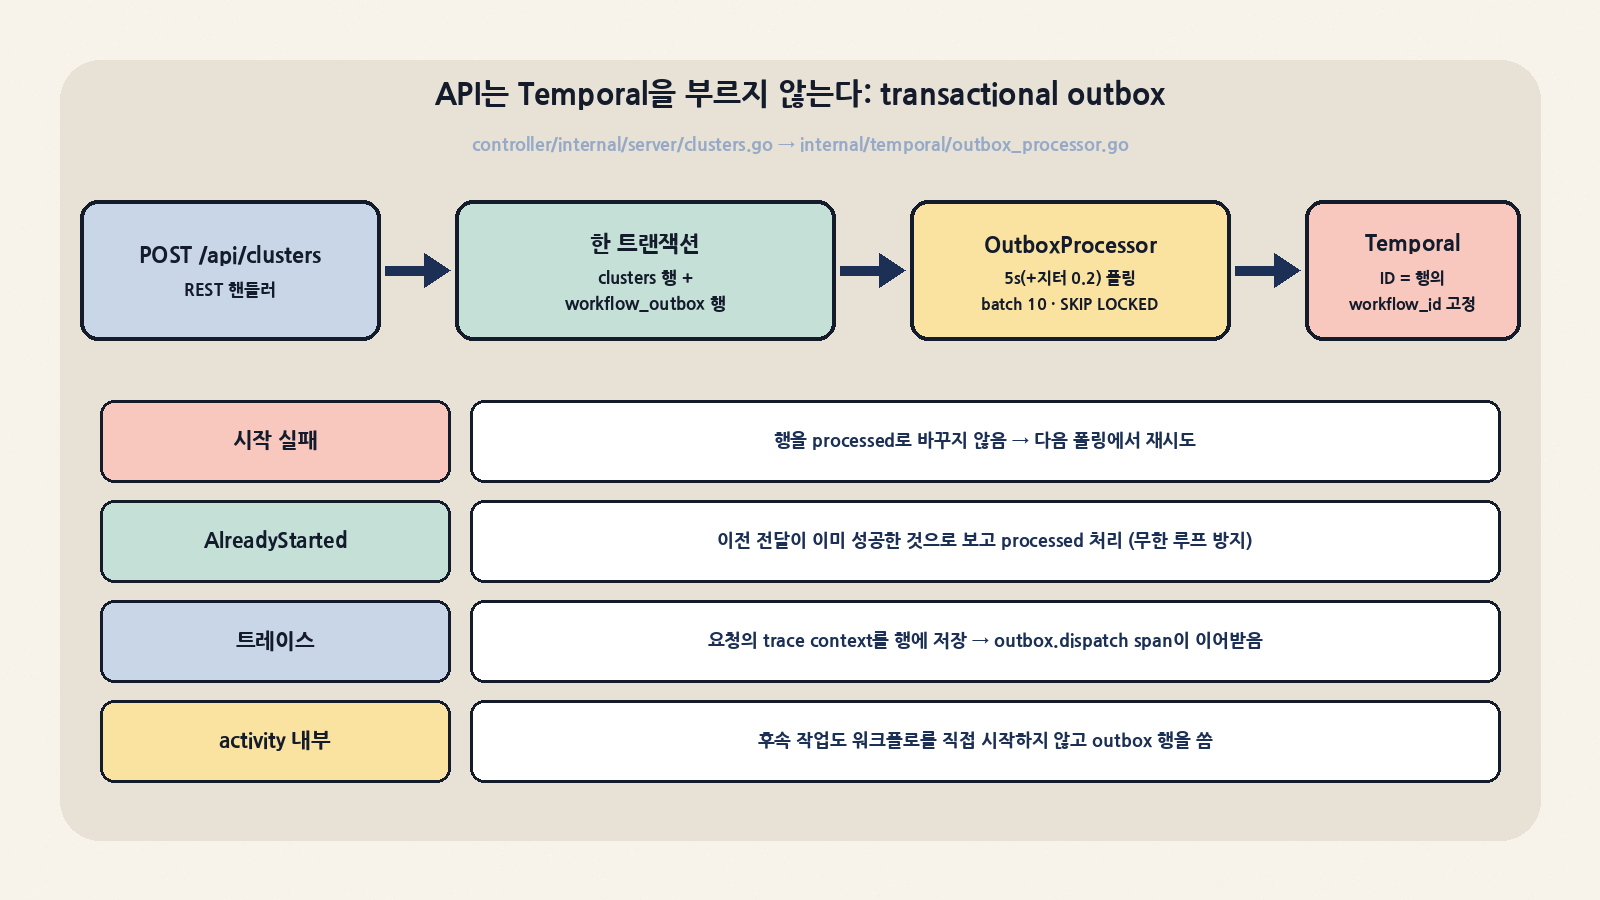
docs/architecture.md는 이 부분을 두고 “처음 핸들러를 읽는 사람이 가장 많이 오해하는 부분”이라고 직접 적어 두었습니다. POST /api/clusters가 들어오면 핸들러는 한 DB 트랜잭션 안에서 cluster 레코드와 workflow_outbox 행을 함께 씁니다(CreateWorkflowOutboxEntry). 둘 다 커밋되거나 둘 다 롤백되므로, 커밋된 클러스터에는 반드시 실행할 작업이 큐에 남아 있습니다.
실제 워크플로 시작은 OutboxProcessor가 맡습니다. 코드를 보면 다음과 같습니다.
- 폴링 주기
OUTBOX_POLLING_INTERVAL기본 5s에, thundering herd를 막는 지터 계수OUTBOX_JITTER_FACTOR기본 0.2를 더합니다. 배치 크기OUTBOX_BATCH_SIZE기본값은 10입니다. - 미처리 행을
FOR UPDATE SKIP LOCKED로 가져오므로 컨트롤러 복제본이 여러 개여도 같은 행을 중복 처리하지 않습니다. - Temporal
StartWorkflowOptions.ID에 행의WorkflowID를 그대로 씁니다. 그래서 이전 전달이 이미 성공했다면WorkflowExecutionAlreadyStarted가 돌아오고, 이를 성공으로 보고 processed 처리합니다. 중복 전달이 생겨도 무해한 멱등 디스패치입니다. - 시작에 실패한 행은 processed로 바꾸지 않으므로 다음 폴링에서 다시 시도됩니다. 한 행이 실패해도 배치의 나머지는 계속 처리됩니다.
- 요청의 trace context를 행에 함께 저장해 두고
outbox.dispatchspan에서 복원합니다. 그래서nvkectl명령 하나의 Trace ID가 Temporal 워크플로까지 이어집니다. v0.22.0 릴리스 노트의 “Each nvkectl command carries a single trace ID”가 바로 이 구조에서 나옵니다.
워크플로 activity 안에서 후속 작업을 띄울 때도 워크플로를 직접 시작하지 않고 똑같이 outbox 행을 씁니다. 이 설계에는 대가가 있습니다. 요청과 실제 실행 사이에 최대 폴링 주기(5s + 최대 1s 지터)만큼 지연이 생기고, Postgres가 진실의 원천이 되므로 DB 가용성이 관리 평면 전체의 가용성이 됩니다. 반대로 “API는 200을 줬는데 워크플로가 안 떴다” 같은 분산 트랜잭션 버그는 구조적으로 사라집니다.
핵심 2: 한 프로세스에 세 가지 반응 경로
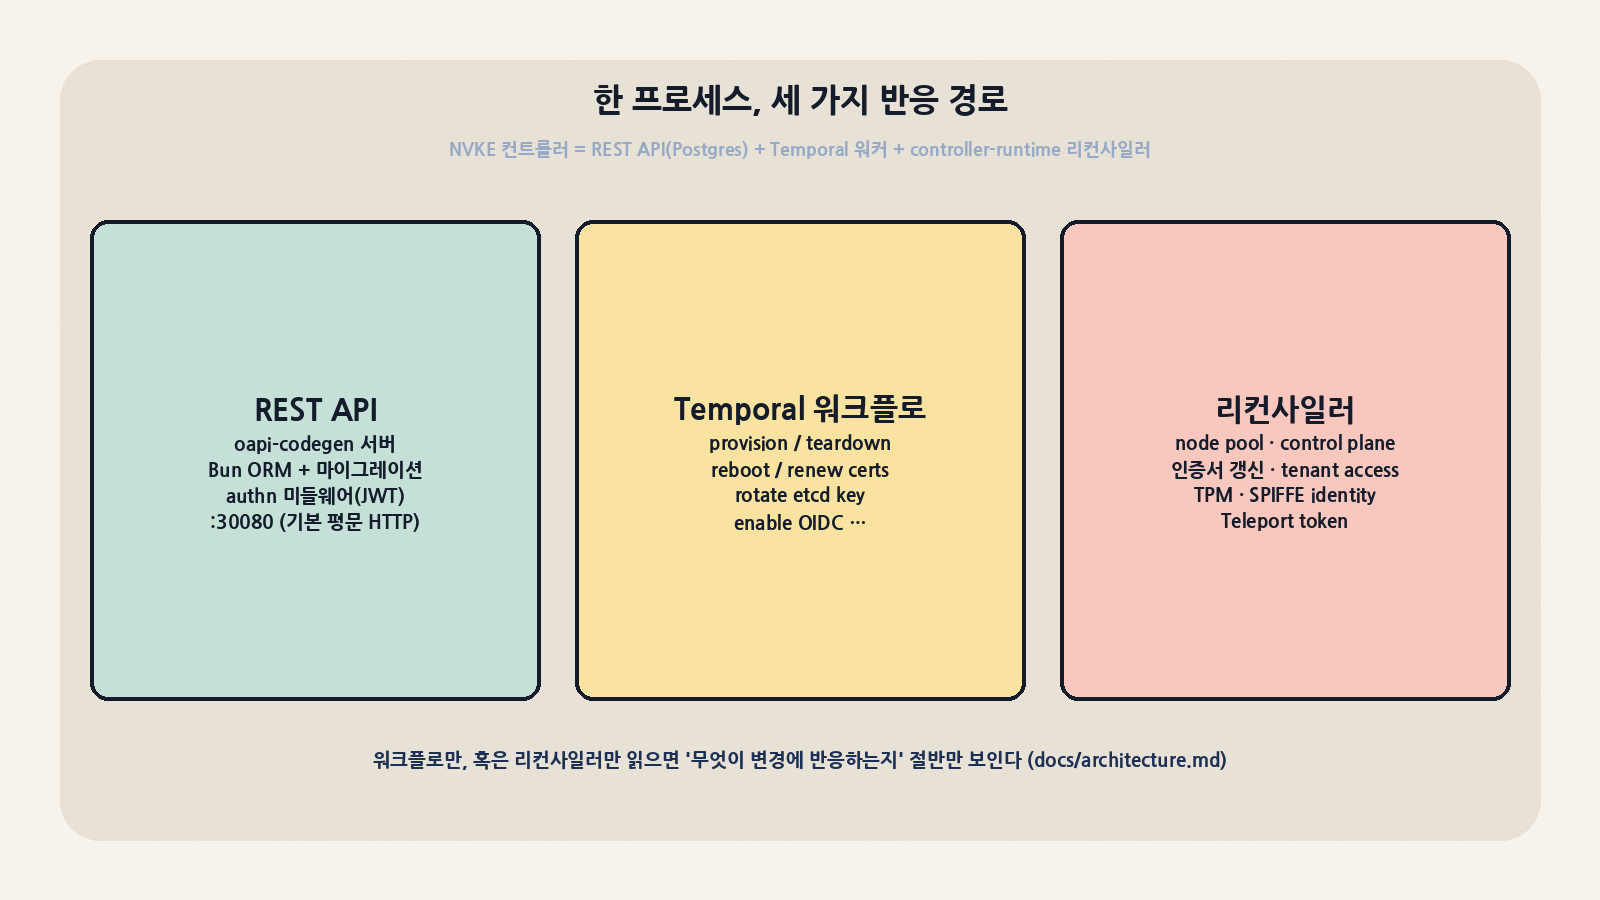
NVKE 컨트롤러 프로세스 하나가 ① Postgres를 쓰는 REST API, ② Temporal 워커, ③ controller-runtime 리컨사일러 묶음을 함께 돌립니다. 문서도 “이 조합은 흔치 않다”며 워크플로나 리컨사일러 한쪽만 읽으면 변경에 무엇이 반응하는지 절반만 보인다고 경고합니다.
| 경로 | 무엇을 다루나 (코드 위치) | 성격 |
|---|---|---|
| Temporal 워크플로 | internal/temporal/workflows/: provision_cluster, provision_node_pool, join_node, teardown_*, reboot_node, renew_k8s_certs, rotate_etcd_encryption_key, enable_oidc, update_spire_server 등 |
길고 실패할 수 있는 다단계 절차. 중간에 실패하면 그 지점부터 재개 |
| 리컨사일러 | internal/controllers/: nodepool, controlplane, automode, certrenewal, tenantaccess, tpmpubhashes, machineannotations, teleporttoken 등 |
Kubernetes 리소스 상태를 보고 수렴시키는 루프 |
| REST API | api/ OpenAPI 3.0 + oapi-codegen, internal/db/ Bun ORM·마이그레이션 |
진실의 원천(Postgres) 기록, outbox 적재 |
설정 처리도 엄격합니다. 컨트롤러는 시작할 때 nvke-controller-config ConfigMap을 한 번 읽어 검증합니다. 잘못된 파일이면 기본값으로 넘어가지 않고 아예 기동하지 않습니다. 이 파일이 대체한 환경변수를 Helm 차트 env로 다시 넣으려 하면 차트가 렌더링을 거부합니다. “설정이 두 군데에 있어서 어느 쪽이 이겼는지 모르는” 사고를 막기 위한 장치입니다.
핵심 3: 노드 에이전트와 TPM 기반 신원
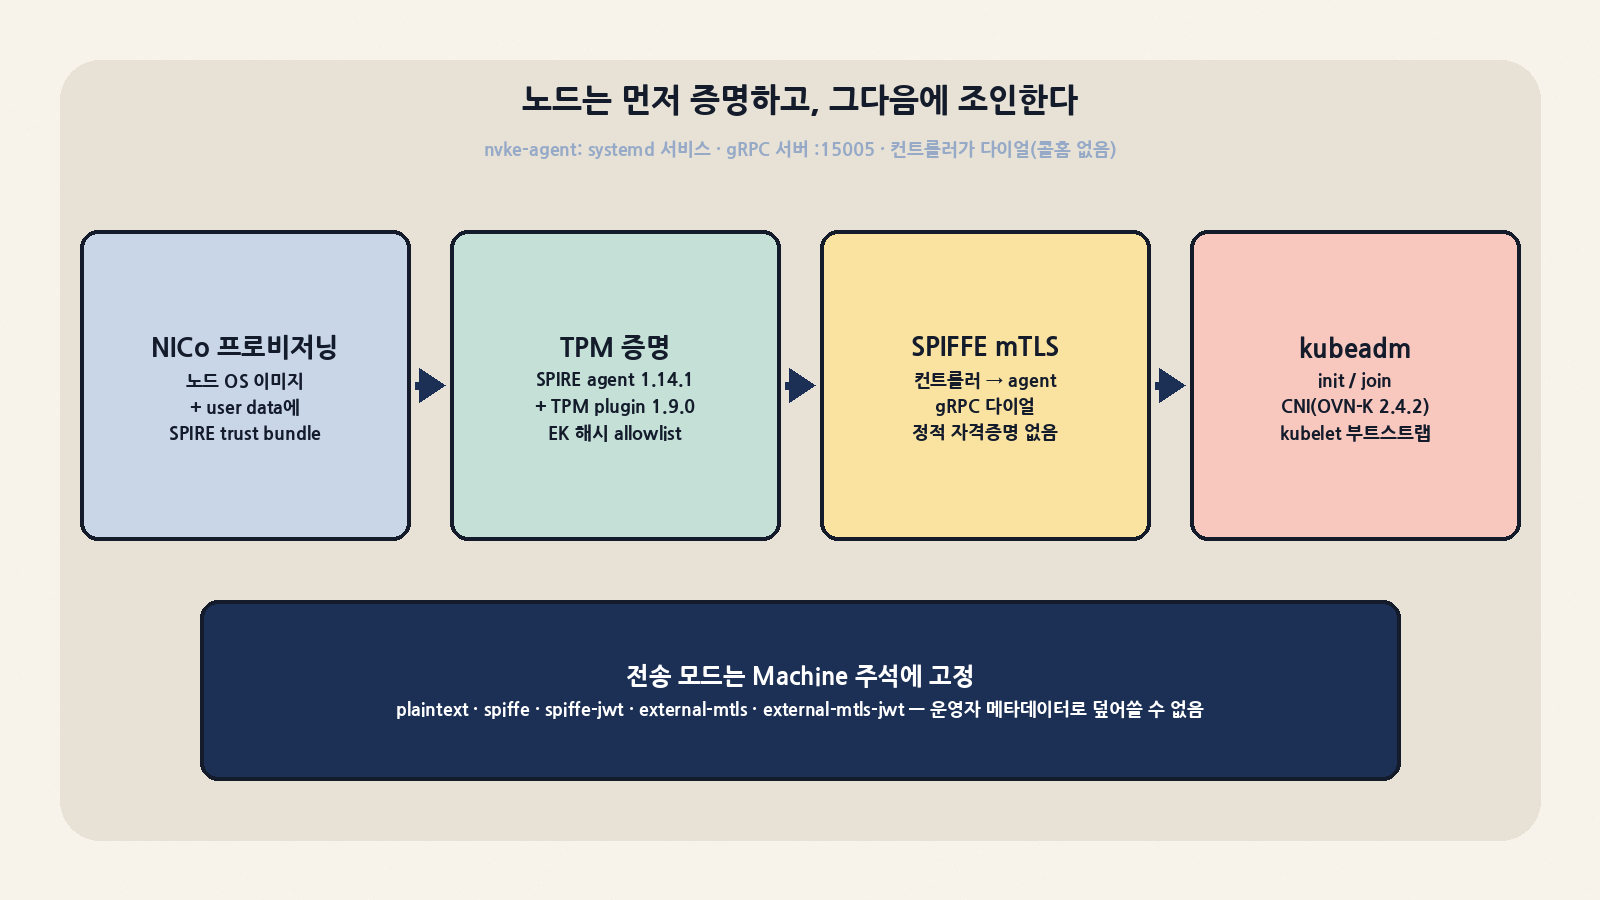
nvke-agent는 모든 노드에서 systemd 서비스로 도는 gRPC 서버입니다(기본 포트 15005). 노드가 먼저 연락하는 구조가 아니라 컨트롤러가 노드로 다이얼합니다. 그래서 컨트롤러에는 노드 등록 엔드포인트가 없습니다. agent/docs/DESIGN.md는 에이전트를 “특권이 필요한 노드 로컬 명령형 작업(kubeadm, apt, 디스크 암호화, static pod 조작, 스크립트 실행)을 인증·감사 가능하고 필요한 곳에서는 멱등인 gRPC API로 바꾼 것”이라고 요약합니다. SSH로 들어가 즉석에서 명령을 치는 방식을 대신하는 셈입니다.
- 에이전트는 리컨사일러가 아닙니다. API 서버를 감시하며 수렴하는 루프가 없고, 노드 간 순서(“CP 하나 init → 나머지 join → CNI 설치”)는 컨트롤러가 결정합니다.
- bare metal에서는 각 노드가 TPM으로 SPIFFE/SPIRE 증명을 마친 뒤에야 join 자격증명을 받습니다. site spec의
tpmEkThumbprint는 TPM endorsement key의 SHA-256이고, 여기 적힌 값만 SPIRE 서버 allowlist에 오릅니다. 공개키 해시라 비밀값은 아닙니다. - Machine에 기록되는 전송 모드는
plaintext,spiffe,spiffe-jwt,external-mtls,external-mtls-jwt다섯 가지이고, 운영자가 넣은 Machine 메타데이터로 덮어쓸 수 없습니다. - etcd 저장 데이터 암호화는 클러스터 단위 옵션입니다. 관리 클러스터 site spec에서는 기본값이 켜짐이고 부트스트랩 때만 고를 수 있어서, 끈 채로 만든 관리 클러스터는 나중에 암호화할 수 없습니다.
지원 버전 매트릭스 (이번 릴리스 소스 기준)
| 항목 | 값 | 비고 |
|---|---|---|
| Kubernetes | 1.36.3 | Pinned. 노드 이미지에 1.34.2/1.35.3/1.37.2 패키지도 있지만 미지원 |
| Control plane 업그레이드 | 한 마이너 위 또는 이후 패치 | 다운그레이드 거부, VIP 필요, 동시에 한 건만 |
| Worker 버전 skew | control plane보다 최대 3 마이너 뒤 | CP 업그레이드 시 검사 |
| CNI | ovn-kubernetes 2.4.2 (NVIDIA 배포판) | IPv4만. 기본 pod 192.168.0.0/16, service 10.96.0.0/12 |
| Cluster API | v1.13.6 | clusterctl·kubeadm bootstrap/control plane 공통 |
| 노드 OS | Ubuntu 26.04 LTS / 24.04 LTS, amd64·arm64 | 커널 linux-nvidia(amd64), arm64는 64k 페이지 커널 |
| SPIRE agent | 1.14.1 + TPM plugin 1.9.0 | 노드 이미지에 포함 |
| 부트스트랩 호스트 런타임 | rootful nerdctl + containerd |
Docker 미지원 (로컬 quickstart는 Docker 사용) |
| Helm | v4.2.4 | Helm 3으로는 차트 설치 불가 |
| Feature gate | 업스트림 기본값 그대로 | alpha 게이트를 켜지 않고, 변경 필드도 없음 |
설치·실행 경로 세 가지
| 목표 | 경로 | 요구사항 |
|---|---|---|
| GPU 없이 평가 | docs/get-started/quickstart-local.md (mock-NICo + kind + Tilt) |
Linux amd64/arm64, 6 CPU, 여유 메모리 12GiB, 디스크 100GiB, Docker, tpm_vtpm_proxy 커널 모듈, kind v0.32.0, Helm 4, tilt, inotify 인스턴스 1024 이상 |
| 실제 설치 | plan-installation → bootstrap-management-cluster → deploy path(deploy/nico) |
머신·네트워크·노드 이미지·레지스트리 직접 준비, NICo 접근 설정 |
| 빌드·기여 | make build, 제출 전 make preflight |
Go 1.27.3, GNU Make 4+, (선택) Flox |
로컬 quickstart의 핵심 흐름은 다음과 같습니다(문서 그대로 발췌·요약).
git clone https://github.com/dsx-ai-factory/nvke.git && cd nvke
sudo sysctl -w fs.inotify.max_user_instances=1024
make -C controller host-up          # /dev/vtpmx 준비
make -C cli build && export PATH="$PWD/cli/bin:$PATH"
# CAPNICo 소스를 go mod download로 받아 ../nvke-quickstart-capnico 에 복사
# controller/tilt_config.json: providers ["capi_core","bgp-containers","nico"]
cp controller/.env.tilt.example controller/.env.tilt   # 빈 값 5개 채우기
make -C controller capd-up          # kind + CAPI + 노드 이미지
cd controller && tilt up            # 모든 리소스가 green 이 될 때까지

# 두 번째 터미널
kubectl config view --raw --minify --context kind-controller-capi > local-mgmt.kubeconfig
nvkectl config set-site --name local --url http://localhost:8080 --kubeconfig "$PWD/local-mgmt.kubeconfig"
nvkectl get providers               # nico 행이 CONFIGURED
nvkectl create cluster -f cli/examples/nico-mock-cluster.yaml
nvkectl get clusters                # STATUS Provisioned 까지 반복
nvkectl get kubeconfig my-cluster --output-file my-cluster.kubeconfig
kubectl --kubeconfig my-cluster.kubeconfig get nodes
예제 클러스터 스펙(cli/examples/nico-mock-cluster.yaml)은 controlPlaneKubernetesVersion: 1.36.4, cniPlugin: ovn-kubernetes, controlPlaneVIP: 172.31.2.1을 쓰고, control plane 1대와 worker 풀 1대로 구성됩니다. 각각 NicoMachineTemplate에 VPC·인스턴스 타입·서브넷 UUID와 iPXE 스크립트를 담습니다. 이 클러스터 스펙의 필드는 REST API의 CreateClusterRequest와 같고, 스키마에 없는 필드는 nvkectl이 거부합니다.
박스 실측: nvkectl 빌드, site spec, 단위 테스트
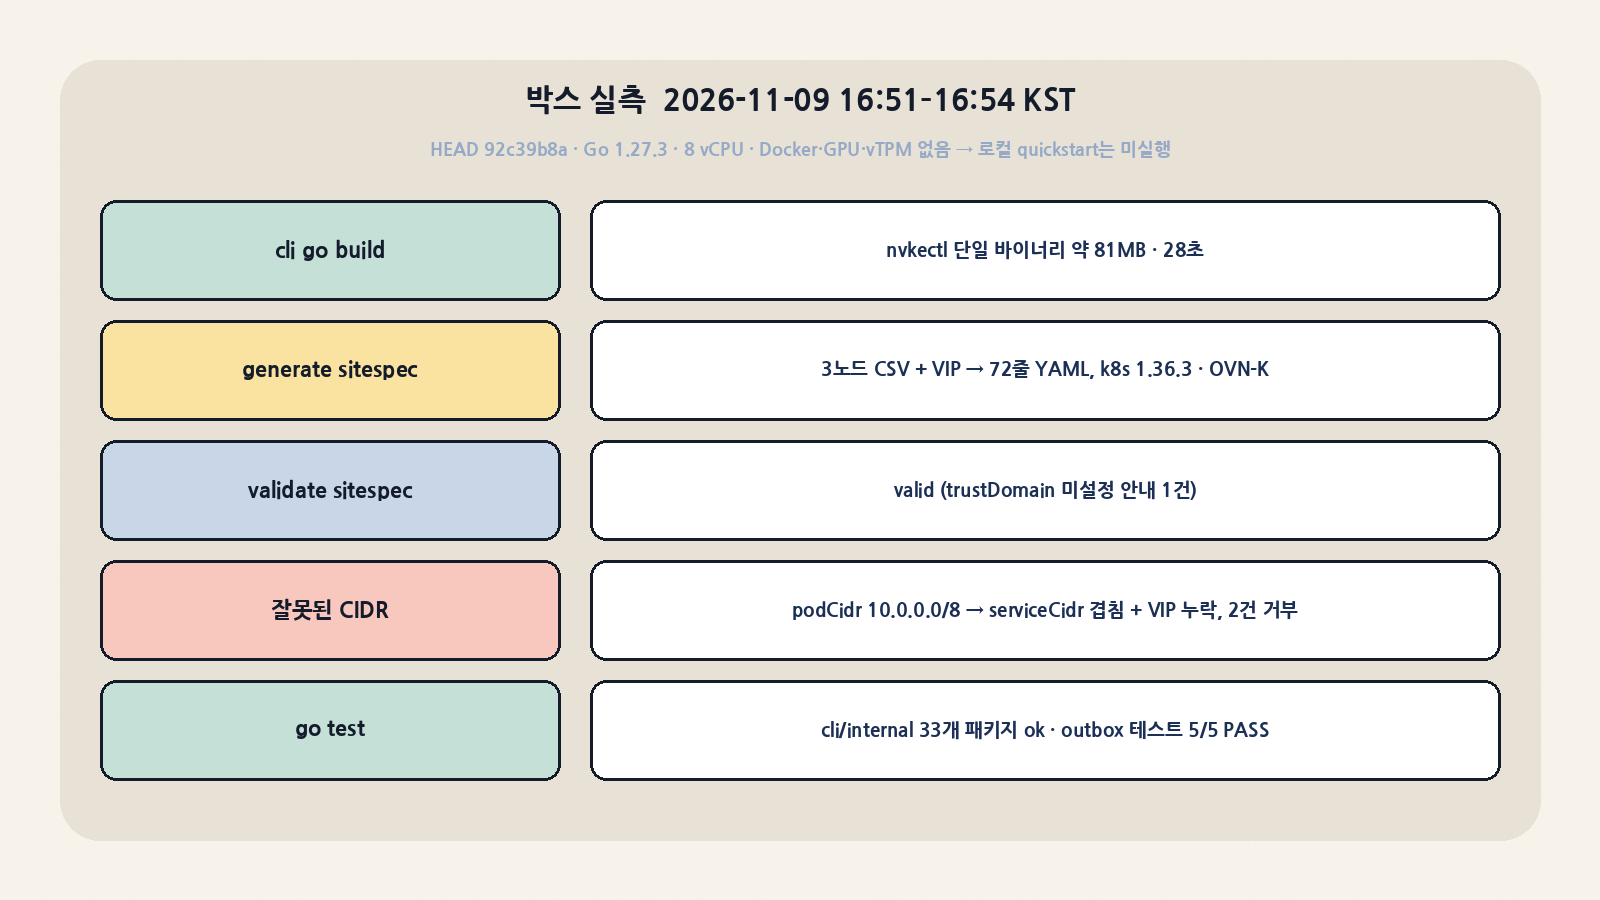
측정 환경은 HEAD 92c39b8a(v0.24.0-beta.7), Go 1.27.3, 8 vCPU, 사용 가능 메모리 약 3GiB입니다. Docker, GPU, vTPM은 없습니다. 로컬 quickstart 요구사양(여유 메모리 12GiB, Docker, vTPM)을 채우지 못하므로 워크로드 클러스터 생성까지의 E2E는 실행하지 않았습니다. 아래 결과는 CLI와 컨트롤러 일부 단위의 동작 확인입니다(2026-11-09 16:51–16:54 KST).
| 시험 | 명령 | 결과 |
|---|---|---|
| CLI 빌드 | cd cli && go build -o ../bin/nvkectl ./cmd/... |
성공, real 28.4s (모듈 첫 다운로드 포함), 바이너리 80,850,563 bytes |
| 버전·명령 | nvkectl version / --help |
nvkectl dev (commit: unknown…). bootstrap, create, delete, deprecate, generate, get, patch, validate 등 |
| site spec 생성 | nvkectl generate sitespec demo-site --nodes hosts.csv --set cluster.controlPlaneVIP=10.10.50.10 |
rc 0, 72줄 YAML. k8sVersion 1.36.3, cniName ovn-kubernetes, podCidr 192.168.0.0/16, serviceCidr 10.96.0.0/12, kubelet systemReservedMemory 16Gi |
| site spec 검증 | nvkectl validate sitespec -f sitespec.yaml |
valid. spire.trustDomain 미설정 시 nvkectl-bootstrap.nke.local을 쓴다는 안내와 Trace ID 출력 |
| 오류 입력 | 3노드 CSV, VIP 없이 --set cluster.podCidr=10.0.0.0/8 |
rc 1. podCidr가 serviceCidr와 겹친다는 오류, 노드 2대 이상인데 controlPlaneVIP가 없다는 오류 두 건을 한 번에 보고 |
| CLI 단위 테스트 | cd cli && go test ./internal/... -p 4 |
33개 패키지 ok, 실패 0, 테스트 파일 없는 패키지 1 |
| Outbox 테스트 | cd controller && go test ./internal/temporal/ -run Outbox -v |
5/5 PASS: trace 이어받기, trace 없는 행 디스패치, 시작 실패 시 pending 유지, AlreadyStarted→processed, mark 실패 span 기록 |
“생성된 파일은 수정 없이 bootstrap이 받아들인다”는 generate sitespec의 약속은 생성 전에 모든 필드를 검증하는 방식으로 지켜집니다. 생성기는 인벤토리 환경변수도 무시하므로 “아무도 입력하지 않은 값”이 site spec에 섞이지 않습니다. 작은 부분이지만 운영 도구로서 신뢰를 주는 설계입니다.
Day 2 운영에서 알아둘 동작
- Node pool 변경은 롤링 교체가 아닙니다. 설정을 바꾸면 새로 생기는 노드부터 적용됩니다.
recycleBudget이 0보다 크면 auto mode가 오래된 노드에nvke.nvidia.com/NeedsRecycle조건을 붙이지만, cordon·drain·삭제는 하지 않습니다. 사람이나 별도 break-fix 시스템이 지워야 하고, 그러면 NVKE가 현재 설정으로 대체 노드를 만듭니다. - 예산 계산: 한 번에 표시하는 노드 수는
recycleBudget에서 부족분(desiredNodeCount− 사용 가능 노드 수)을 뺀 값입니다. 문서 예시로 desired 4, budget 2, NotReady 1이면 최대 1대만 표시합니다. 기본값 0에서는 아무것도 표시하지 않습니다. - Control plane 노드 수: 홀수를 권장하며, 2대 이상이면
controlPlaneVIP가 필수입니다(개발용 override 제외). VIP 없이 만들면 control plane을 1대 넘게 늘리거나 업그레이드·교체할 수 없습니다. 정확히 2대인 구성은 자동 인증서 갱신 대상에서 빠집니다. nvkectl업그레이드 범위:patch cluster는 control plane 버전만 올리고,patch nodepool은desiredNodeCount만 받습니다. 풀 버전을 바꾸려면 REST/api/nodePools/<ID>에kubernetesVersion을 보내야 합니다.- 라벨·테인트는 생성 시 고정되고 노드가 조인할 때 한 번만 적용됩니다. 나중에 지워져도 다시 붙지 않습니다.
preview의 한계: 도입 전에 반드시 읽을 것
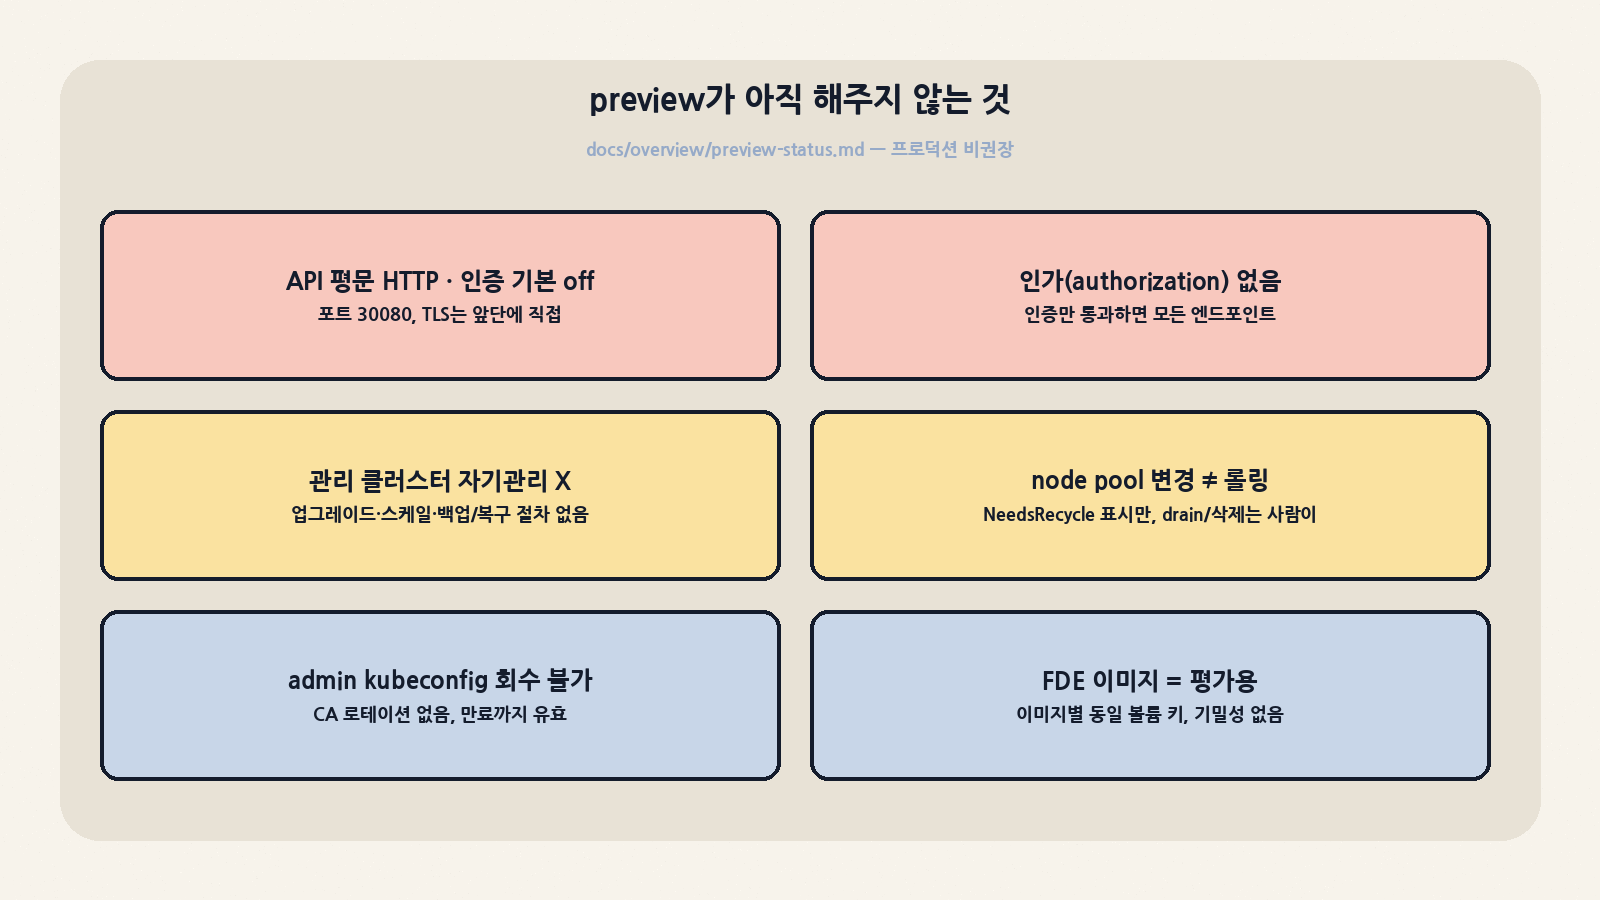
| 영역 | 현재 한계 (preview-status.md) | 실무 대응 |
|---|---|---|
| API 전송 | 설치 직후 포트 30080에서 TLS 없는 평문 HTTP, 인증 꺼짐 | 허용 네트워크 최소화, JWT 인증 켜기, 앞단에 자체 TLS 종단 |
| 인가 | 인증을 통과한 호출자는 클러스터 생성·삭제를 포함한 모든 엔드포인트 호출 가능 | 토큰은 전 클러스터 관리 권한자에게만 발급. ROADMAP “Coming soon”에 고객별 인가 예정 |
| 관리 클러스터 | 자기 업그레이드·스케일·교체 없음, 관리 평면 업그레이드·백업/복구 절차 없음 | 부트스트랩 kubeconfig와 etcd 암호화 키 파일을 안전하게 보관(노드 밖 유일한 사본) |
| 고객 접근 | 고객에게는 admin kubeconfig만 제공. CA 로테이션이 없어 클라이언트 인증서 만료 전까지 회수 불가 | 고객 쪽 관리자가 클러스터 안에서 좁은 권한의 자격증명을 따로 발급 |
| FDE 이미지 | 이미지마다 같은 볼륨 키를 쓰고 bootstrap passphrase가 공개·GRUB에 남음 → 저장 데이터 기밀성 없음 | 평가용으로만 사용 |
| 텔레메트리 | 기본 NKTP 백엔드는 메모리 저장, Grafana 익명 admin | 자체 OTLP 백엔드로 지정 |
| 인프라 공급자 | NICo가 기본(LaunchLayer는 활성화 시) | NICo 없는 환경에서는 실제 설치 경로가 사실상 막힘 |
이 목록이 길다는 점이 오히려 이 프로젝트의 장점이기도 합니다. “알려진 한계 전부”를 한 페이지에 숨김없이 적어 두었기 때문에, 평가하는 쪽에서 위험을 계산하기 쉽습니다.
비슷한 도구와 비교
“여러 Kubernetes 클러스터를 API로 찍어내는 관리 평면”이라는 기준으로 자주 함께 거론되는 도구들과 설계 축을 비교했습니다. 다른 도구는 일반적인 아키텍처 특징만 정리했고, 성능 수치는 비교하지 않았습니다.
| 도구 | Control plane 위치 | 인프라 계층 | 강점 | NVKE 대비 |
|---|---|---|---|---|
| NVKE | 고객 클러스터마다 전용 control-plane 머신(+etcd) | NICo(GPU 베어메탈) via CAPNICo | TPM/SPIFFE 노드 신원, GPU 런타임(AICR)·장애 탐지(NVSentinel)와 한 스택, 고정 버전·SBOM | — |
| Cluster API 단독 | 공급자에 따라 다름 (보통 전용 머신) | 공급자 플러그인 (Metal3, vSphere, 클라우드 등) | 표준·생태계 | NVKE는 CAPI v1.13.6을 그대로 쓰고, 그 위에 REST API·워크플로·노드 에이전트·인증서/키 수명주기를 얹은 형태 |
| Rancher (RKE2/K3s) | 다운스트림 클러스터 노드 | 노드 드라이버·클라우드, 커스텀 노드 | 멀티 클러스터 UI·RBAC·앱 카탈로그 | NVKE는 UI가 아니라 API·CLI 중심이고 GPU 팩토리 사업자를 겨냥. 업스트림 kubeadm 사용 |
| Gardener | “seed” 클러스터 안 파드(hosted) | 클라우드·OpenStack 등 extension | 대규모 hosted control plane 운영 경험 | NVKE도 ‘seed’라는 말을 쓰지만 부트스트랩용 임시 클러스터라는 뜻. 고객 control plane은 파드가 아니라 노드에 있음 |
| Kamaji / HyperShift 계열 | 관리 클러스터 안 파드(hosted control plane) | 워커만 외부 머신 | control plane 밀도·비용 효율 | NVKE는 고객 격리 강도를 위해 전용 control plane 노드를 택함. 대신 머신 비용이 듦 |
| EKS/GKE 같은 퍼블릭 매니지드 | 클라우드 사업자 소유 | 클라우드 사업자 | 운영 부담 최소 | NVKE는 이 ‘사업자’ 쪽 역할을 직접 하려는 운영자용 소프트웨어 |
공개된 스케일 측정 결과는 어떻게 읽을까
benchmarks/results/1.34.2/에는 NVKE Scale Team의 결과 문서가 들어 있습니다. 기준 버전이 현재 지원 버전(1.36.3)이 아닌 Kubernetes 1.34.2이고, 각 문서가 스스로 “최대 규모를 주장하는 것이 아니다”라고 밝힌다는 점을 먼저 알고 읽어야 합니다.
| 문서 | 시나리오 | 보고된 결과 (원문 TL;DR) |
|---|---|---|
| cl2-slo-conformance-2026-05-25 | ClusterLoader2 업스트림 load, 42 워커, 최대 3,920 파드, 40 QPS |
모든 SIG-Scalability SLO 충족: pod startup p99 2.54s(SLO ≤ 5s), API verb p99 약 49–50ms, APF 429 거부 0건 |
| node-density-2026-09-21 | 42 워커, 4,120 pause 파드(노드당 평균 105) | 212초에 생성, pod-ready p99 2s, 최대 Pending 23, 4,120/4,120 Ready |
42 워커 규모의 측정이고, 문서도 스스로 측정 범위의 제약(ClusterLoader2 커밋보다 앞선 실행, QPS 파라미터 미기록 등)을 적어 두었습니다. ROADMAP의 Exploring 항목에 “노드 5,000대 같은 업스트림 확장 한계에서 검증”이 따로 있다는 것은 대규모 검증이 아직 진행 중이라는 뜻입니다.
누가 지금 써볼 만한가
| 상황 | 권장 | 이유 |
|---|---|---|
| NICo 기반 GPU 팩토리 운영자 / NVIDIA Cloud Partner | 평가 시작 적극 권장 | 대상 사용자 그대로. CAPNICo·AICR·NVSentinel과 맞물림 |
| Kubernetes ISV·플랫폼 팀 | 부분 채택 검토 | CAPNICo, NKTP, outbox·워크플로 패턴, site spec 검증기 등 부품 단위 재사용 가능 |
| 사내 GPU 클러스터 몇 개를 운영하는 팀 | 관찰 | NICo 의존, preview 한계(인가·백업 없음) 때문에 지금은 과한 선택일 수 있음 |
| 프로덕션 고객 워크로드 | 비권장 (공식 입장) | 문서가 프로덕션 사용을 권장하지 않음 |
정리
NVKE는 “GPU 위 Kubernetes”를 새로 발명하지 않습니다. 업스트림 Kubernetes, kubeadm, Cluster API, Temporal, SPIRE, OVN-Kubernetes를 고정 버전으로 묶었고, 그 사이를 transactional outbox, 멱등 워크플로 디스패치, 컨트롤러가 다이얼하는 노드 에이전트, TPM 증명 후 조인 같은 보수적인 설계로 이었습니다. 엔지니어링 관점에서 볼 만한 것은 화려한 기능보다 이 이음매들입니다. 단일 프로세스에 API·워크플로·리컨사일러를 합친 구조는 읽기는 어렵지만 배포는 단순하고, 설정을 엄격하게 검증하고 한계를 숨김없이 문서화한 태도는 운영자에게 신뢰를 줍니다.
반대로 지금 당장은 인가 없음, 평문 API, 관리 클러스터 백업/업그레이드 부재, NICo 의존이라는 분명한 벽이 있습니다. 첫 공개 프리뷰 후 18일 만에 v0.24 rc/beta 태그까지 붙을 만큼 개발 속도가 빠르니, GPU 클라우드를 운영하거나 준비하는 팀이라면 mock-NICo quickstart로 한 번 돌려 보고 ROADMAP의 “Coming soon”(고객별 인가, 관리 클러스터 자기관리, 자체 PKI, Kubernetes 1.37)이 언제 들어오는지 지켜볼 만합니다.