“AI 비서한테 일을 시키면, 그 뒤에서는 누가 일하고 있을까?” 요즘 AI 에이전트(사람 대신 여러 단계를 알아서 처리하는 AI)는 생각보다 잔심부름이 많아요. 파일 하나 열어 보고, 표에서 숫자 하나 꺼내고, 다른 앱에 기록 하나 남기고… 이런 작은 단계를 수십, 수백 번 반복하죠. 메타가 미국 시간 11월 9일(한국 시간 11월 10일 새벽) 공개한 뮤즈 엠버(Muse Ember)는 바로 이 반복 잔심부름을 싸고 빠르게 맡으려고 만든, 메타의 가장 작고 효율적인 AI 모델이에요. 오늘은 “작은 모델이 왜 뉴스가 되는지”, “‘하이쿠급 성능에 비용 3분의 1’이라는 숫자를 어떻게 읽어야 하는지”를 차근차근 풀어 볼게요.
한 줄 요약부터
| 질문 | 짧은 답 |
|---|---|
| 무엇이 나왔나요? | 메타 슈퍼인텔리전스 랩(MSL)의 새 경량 모델 뮤즈 엠버(모델 이름 muse-ember-1.0) |
| 어디에 쓰나요? | AI 에이전트가 하루 종일 반복하는 일: 도구 호출, 작은 코드 수정·테스트 실행, 일 나눠 주기(라우팅), 정보 뽑기, 긴 문서 읽기 |
| 얼마나 싸요? | 입력 100만 토큰당 0.10달러, 출력 100만 토큰당 0.50달러(입력 20만 토큰 이하 기준) |
| 얼마나 잘해요? | 독립 평가 회사 아티피셜 애널리시스 종합 점수 36점으로 클로드 하이쿠 5.5와 반올림 점수가 같고, 과제당 비용은 약 0.14달러 대 0.41달러 |
| 나도 쓸 수 있나요? | 일반 채팅 앱 버튼이 아니라 개발자용 Meta Model API와 코딩 도구 뮤즈 코드(Muse Code), 구글 클라우드·오라클 클라우드에서 제공돼요 |
먼저, ‘작은 모델’이 왜 필요할까?
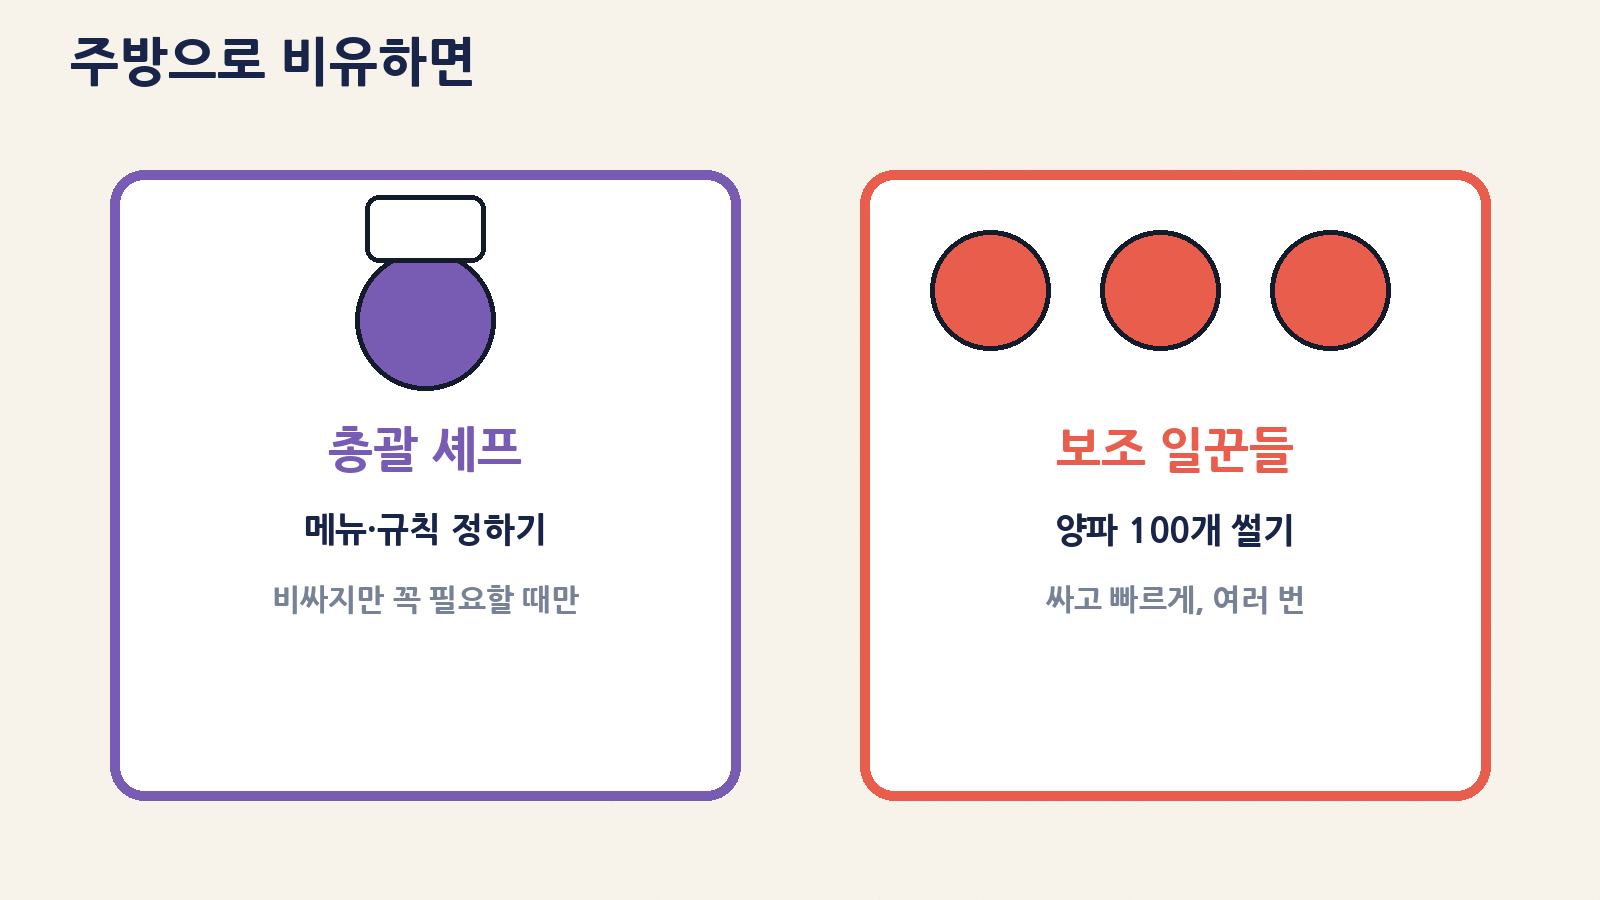
식당 주방을 떠올려 보세요. 메뉴를 짜고 맛을 결정하는 건 총괄 셰프지만, 양파 100개 썰기, 접시 200장 나르기는 셰프가 직접 하지 않아요. 셰프 시급으로 양파를 썰면 너무 비싸니까요. AI도 똑같아요. 아주 똑똑하고 비싼 큰 모델이 계획을 세우고, 정해진 규칙대로 반복하는 일은 작고 싼 모델에게 맡기면 전체 비용이 확 줄어요.
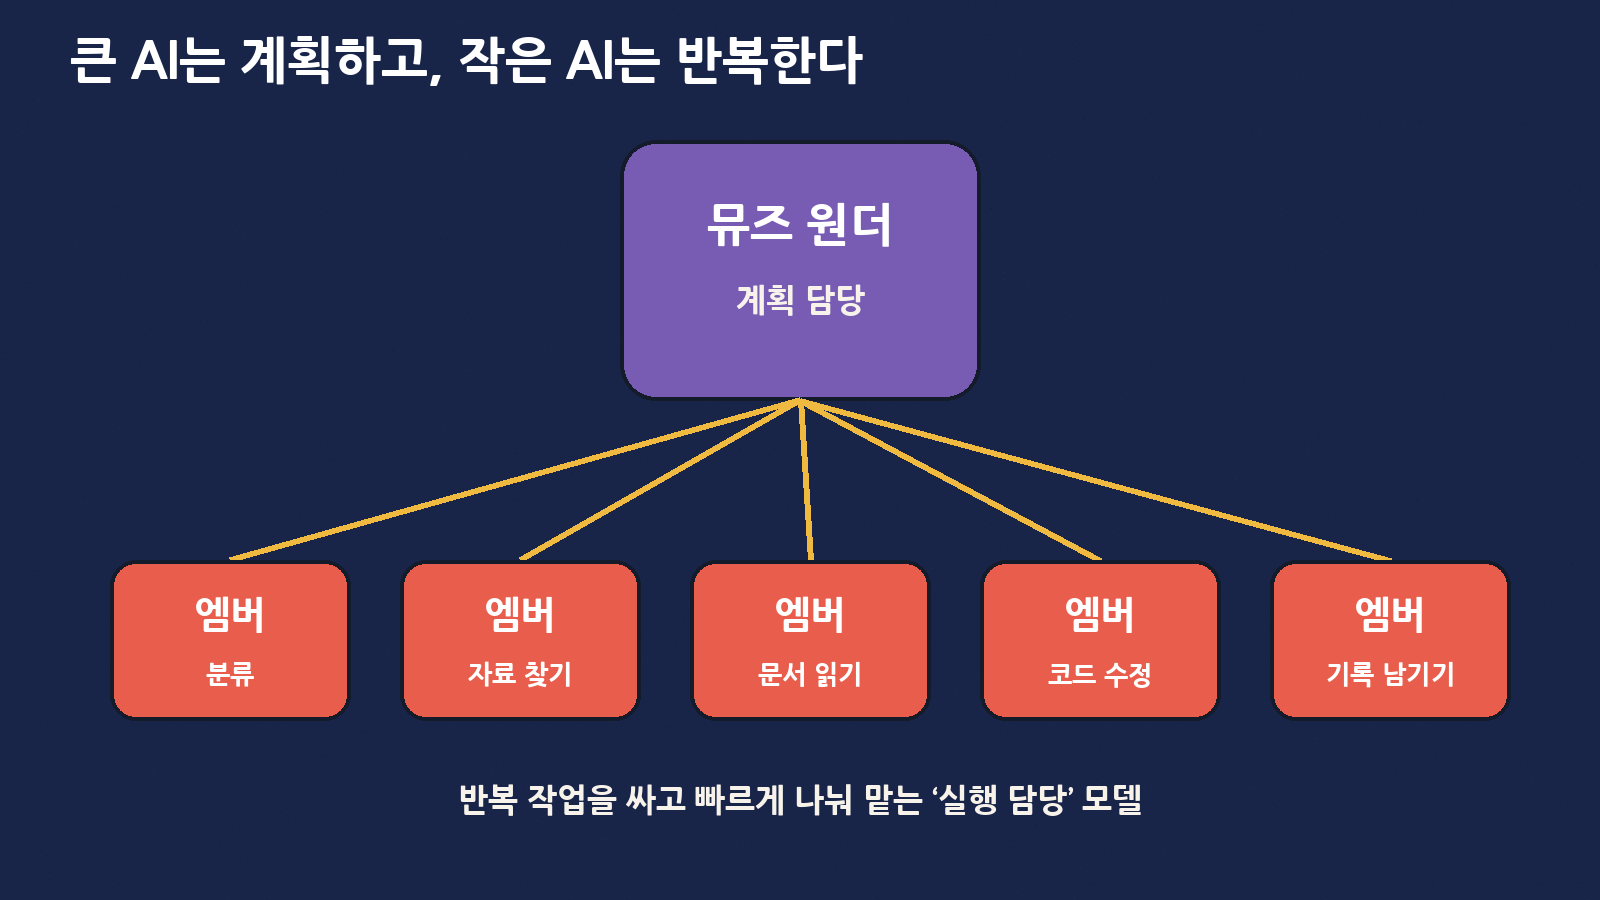
메타도 이 구조를 그대로 말해요. 발표문의 표현을 빌리면 “뮤즈 원더(Muse Wonder)가 계획하고, 뮤즈 엠버가 물량을 처리한다”예요. 큰 모델 밑에서 일을 나눠 받아 처리하는 이런 모델을 흔히 서브에이전트(보조 일꾼)라고 불러요.
| 단계 | 고객센터 AI 예시 | 누가 맡으면 좋을까 |
|---|---|---|
| 1. 규칙 정하기 | “환불 문의는 이렇게, 배송 문의는 이렇게 처리하자” | 큰 모델(뮤즈 원더 등) |
| 2. 분류하기 | 들어온 문의 1만 건을 ‘환불/배송/기타’로 나누기 | 작은 모델(뮤즈 엠버) |
| 3. 자료 찾기 | 주문 번호로 주문 기록·배송 기록 불러오기 | 작은 모델(도구 호출) |
| 4. 답변 초안 | 정해진 규칙대로 답장 초안 쓰기 | 작은 모델 |
| 5. 중요한 결정 | 계좌 변경·큰 금액 환불 같은 일 | 사람 승인 또는 큰 모델로 넘기기 |
이 예시는 테크크런치와 벤처비트가 소개한 활용법(큰 모델이 처리 규칙을 정하고, 가벼운 모델이 수만 건에 적용)을 쉽게 풀어 쓴 거예요.
메타 ‘뮤즈’ 가족, 누가 누구예요?
메타는 올해 ‘뮤즈’라는 이름으로 모델을 하나씩 내놓고 있어요. 엠버는 그중 네 번째로, 가장 작은 막내예요. 메타는 엠버를 가장 큰 모델인 뮤즈 원더 풀(Muse Wonder Full)을 활용해 훈련한 첫 모델이라고 설명했어요.
| 모델 | 공개 시기 | 역할(메타 설명 기준) |
|---|---|---|
| 뮤즈 스파크(Spark) | 4월 | 코딩·에이전트 작업용 중간급 모델 |
| 뮤즈 글리머(Glimmer) | 8월 | 내려받아 직접 돌릴 수 있는 300억 파라미터 공개 모델(Apache 2.0) |
| 뮤즈 원더(Wonder) | 10월 | 가장 어려운 문제용 최상위 모델 |
| 뮤즈 엠버(Ember) | 11월 9일 | 반복 작업을 대량으로 싸게 처리하는 실행 담당 |
‘하이쿠급 성능에 비용 3분의 1’, 숫자 제대로 읽기
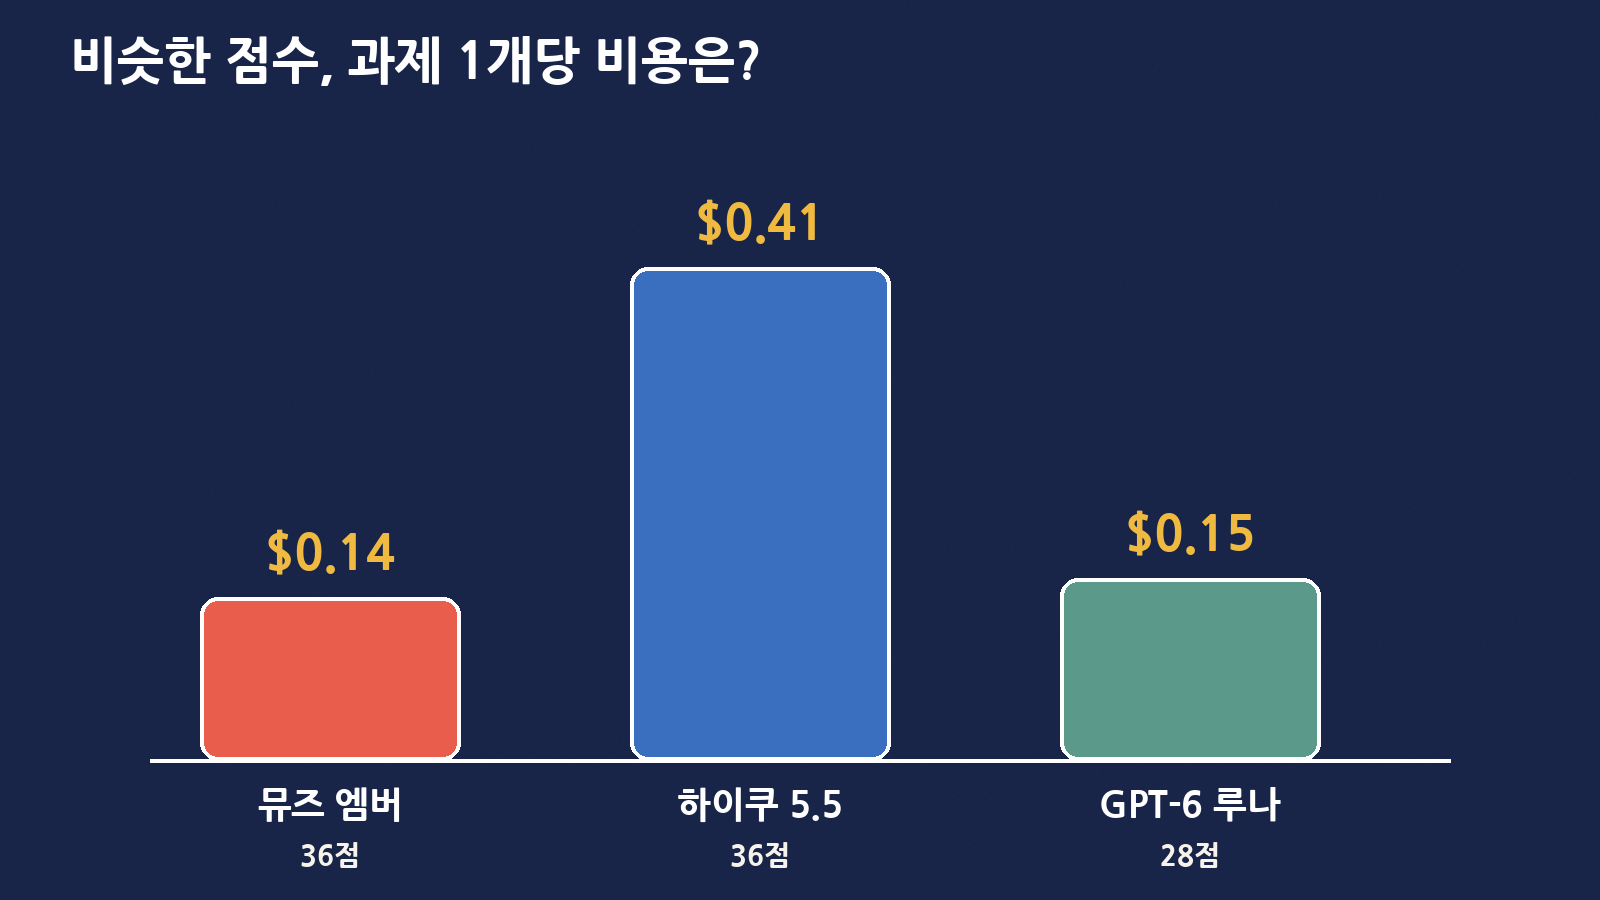
헤드라인 숫자는 이거예요. 독립 평가 회사 아티피셜 애널리시스(Artificial Analysis)의 종합 지능 점수에서 엠버는 최대 추론 설정 기준 36점을 받아, 앤트로픽 클로드 하이쿠 5.5와 반올림 점수가 같았어요. 그런데 이 평가 과제를 한 번 풀 때 든 비용은 엠버가 약 0.14달러, 하이쿠가 약 0.41달러였어요. 그래서 “비슷한 성적을 약 3분의 1 비용으로”라는 말이 나온 거예요.
| 모델(최대 추론 설정) | 종합 점수 | 과제당 비용 | 한 줄 해석 |
|---|---|---|---|
| 뮤즈 엠버 | 35.8(반올림 36) | 약 $0.136 | 비슷한 점수를 가장 싸게 |
| 클로드 하이쿠 5.5 | 36.2(반올림 36) | 약 $0.411 | 점수는 살짝 높지만 비용은 약 3배 |
| GPT-6 루나 | 27.8 | 약 $0.152 | 비용은 비슷하지만 점수가 낮음 |
| 뮤즈 스파크 1.3(참고) | 37 | 약 $2.39 | 점수 1점 높지만 비용은 약 17배 |
여기서 꼭 알아 둘 점이 있어요. 점수는 반올림하면 같지만, 소수점까지 보면 하이쿠가 0.4점 높아요. 또 엠버의 과제당 비용은 메타가 정한 정가로 계산한 추정치예요. 벤처비트에 따르면 아티피셜 애널리시스는 엠버가 싼 이유로 캐시(반복해서 넣는 내용) 요금이 낮고, 최대 설정에서 하이쿠보다 출력 토큰을 약 3분의 1만 썼다는 점을 꼽았어요. 즉 ‘단가가 싸서’라기보다 ‘말을 덜 하고 같은 일을 해서’ 싸진 부분이 커요.
토큰 요금표, 다른 모델과 나란히 보기
토큰은 AI가 글을 읽고 쓰는 단위예요. 대략 글자 조각이라고 생각하면 돼요. 요금은 보통 “100만 토큰당 얼마”로 매겨요.
| 모델 | 입력 100만 토큰 | 출력 100만 토큰 | 메모 |
|---|---|---|---|
| 뮤즈 엠버(입력 20만 토큰 이하) | $0.10 | $0.50 | 캐시 입력은 $0.004 |
| 클로드 하이쿠 5.5(입력 10만 토큰 이하) | $0.10 | $0.50 | 긴 입력은 $0.50 / $2.50 |
| GPT-6 루나 | $0.10 | $0.50 | 긴 입력은 $0.20 / $0.75 |
| 뮤즈 스파크 1.3 | $1.25 | $4.25 | 엠버보다 입력 12.5배 |
재밌는 건 기본 단가는 세 모델이 똑같다는 거예요. 그러니 “엠버가 무조건 싸다”가 아니라, 같은 일을 할 때 토큰을 얼마나 덜 쓰는지, 입력이 길어질 때 단가가 어떻게 바뀌는지가 실제 청구서를 가른다는 뜻이에요. 벤처비트도 입력이 아주 길고 답도 긴 작업이라면 토큰 단가만 놓고 볼 때 루나가 더 유리할 수 있다고 짚었어요.
20만 토큰의 ‘요금 문턱’을 조심하세요
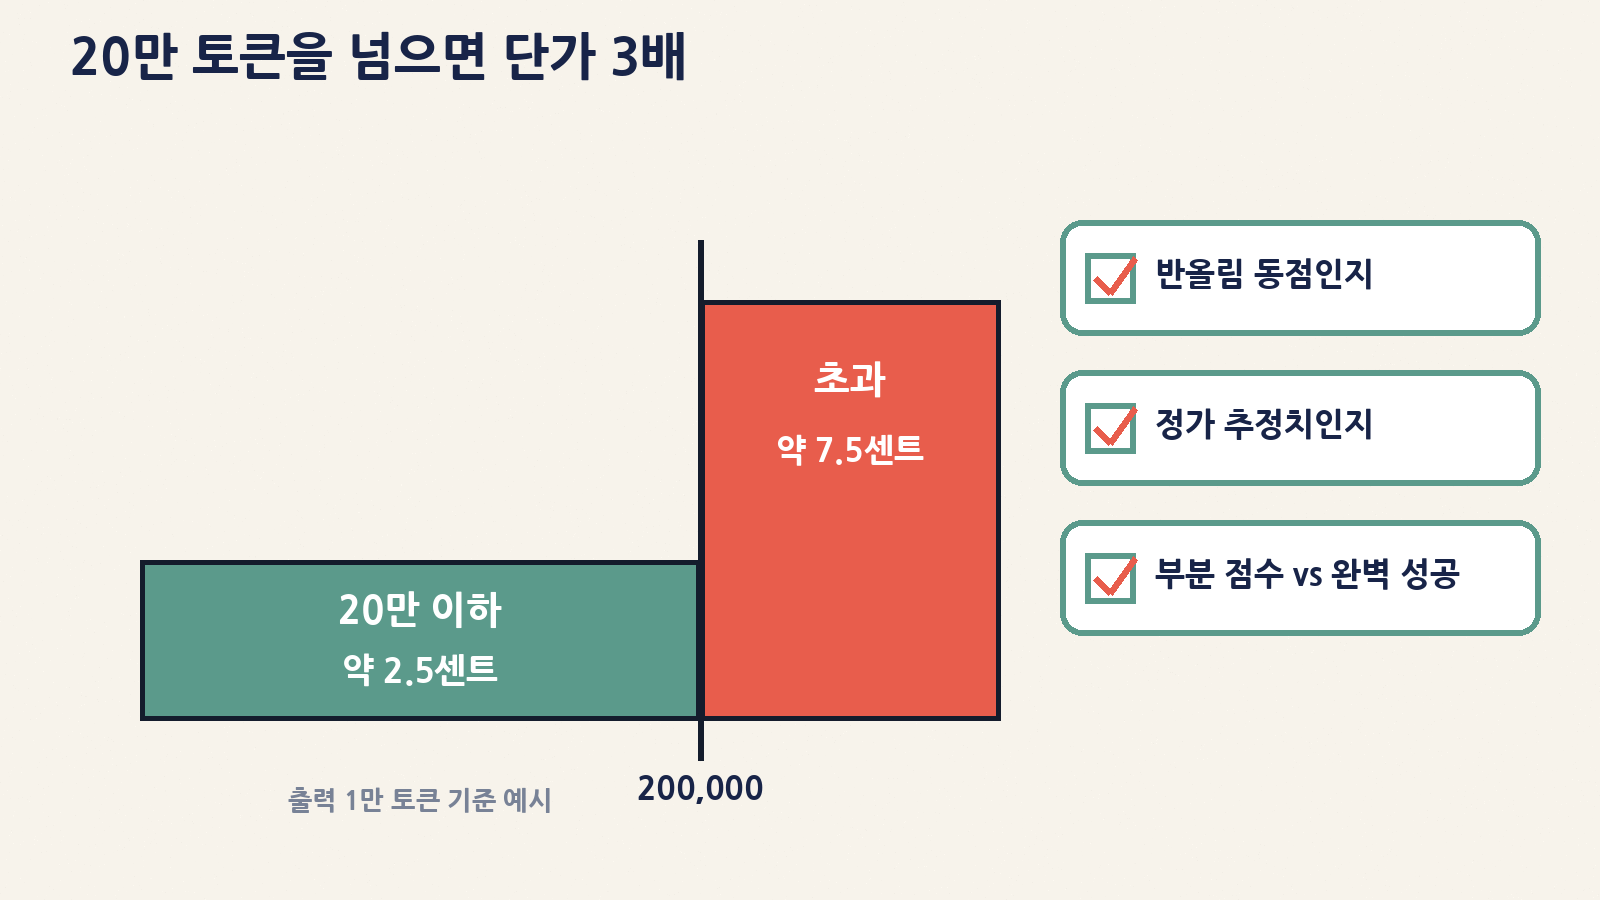
엠버는 한 번에 최대 약 100만 토큰(1,048,576토큰)을 읽고, 최대 약 51만 토큰(524,288토큰)까지 쓸 수 있어요. 코드 저장소 전체나 문서 묶음을 한 번에 넣을 수 있는 크기예요. 그런데 입력이 20만 토큰을 넘으면 그 요청 전체 요금이 3배가 돼요. 출력까지 통째로 비싸지는 게 포인트예요.
| 구간 | 입력 | 캐시 입력 | 출력 |
|---|---|---|---|
| 입력 20만 토큰 이하 | $0.10 | $0.004 | $0.50 |
| 입력 20만 토큰 초과 | $0.30 | $0.012 | $1.50 |
벤처비트의 계산 예시를 그대로 따라가 볼게요. 입력 200,000토큰에 출력 10,000토큰이면 모델 요금은 약 2.5센트예요(아래 표에 계산을 풀어 놨어요). 그런데 입력이 딱 1토큰 늘어 200,001토큰이 되면 같은 요청이 약 7.5센트로 뛰어요. 대화 기록이 계속 쌓이는 에이전트라면 모르는 사이에 문턱을 넘을 수 있어요. 이전 대화와 캐시 입력도 이 문턱 계산에 포함된다고 해요.
| 계산 | 20만 토큰 이하(200,000) | 20만 토큰 초과(200,001) |
|---|---|---|
| 입력 요금 | 200,000 × $0.10 ÷ 100만 = $0.020 | 200,001 × $0.30 ÷ 100만 ≈ $0.060 |
| 출력 요금(10,000토큰) | 10,000 × $0.50 ÷ 100만 = $0.005 | 10,000 × $1.50 ÷ 100만 = $0.015 |
| 합계 | 약 $0.025(2.5센트) | 약 $0.075(7.5센트) |
예시: 고객 문의 1만 건을 분류하면 얼마?
감을 잡기 위해 아주 단순한 가상 계산을 해 볼게요. 문의 1건마다 입력 5,000토큰(문의 내용+처리 규칙), 출력 500토큰(분류 결과와 짧은 답)을 쓴다고 가정해요. 정가만 넣은 계산이라, AI가 속으로 생각하는 데 쓰는 토큰이나 재시도까지 더해지면 실제 요금은 달라질 수 있어요.
| 항목 | 뮤즈 엠버 | 뮤즈 스파크 1.3 |
|---|---|---|
| 입력 5천만 토큰(5,000 × 1만 건) | $5.00 | $62.50 |
| 출력 500만 토큰(500 × 1만 건) | $2.50 | $21.25 |
| 합계(가상 계산) | $7.50(1달러≈1,350원으로 어림하면 약 1만 원) | $83.75(약 11만 원) |
같은 회사 모델끼리도 열 배 넘게 차이가 나죠. 그래서 기업들은 “어려운 판단만 큰 모델, 반복은 작은 모델”로 나누는 데 관심이 커요. 우리가 쓰는 앱 속 AI 기능이 점점 싸지고 많아지는 배경에도 이런 작은 모델들이 있어요.
잘하는 일 vs 아직 약한 일
메타가 공개한 성적표를 보면 엠버가 모든 걸 이기는 건 아니에요. 어떤 일에 맡기면 좋을지 감이 오도록 나눠 봤어요(모두 최대 추론 설정 기준, 메타 발표 자료).
| 시험 | 무엇을 보나 | 엠버 | 하이쿠 5.5 | 루나 | 읽는 법 |
|---|---|---|---|---|---|
| AutomationBench-AA | 가상 업무 앱 여러 개를 오가며 업무 끝까지 처리 | 37.8% | 13.9% | 20.2% | 엠버가 가장 크게 앞선 분야 |
| Coding Agent Index-AA | 실제 코딩 도구 안에서 코딩 | 46 | 37 | 31 | 각자 자기 회사 도구에서 측정 |
| FrontierCode 2.0-AA | 바로 합칠 수 있는 수준의 코드인가 | 27.2% | 34.9% | 25.2% | 완성도 높은 코드는 하이쿠가 앞섬 |
| OSWorld 2.1 | 컴퓨터 화면을 보고 앱 조작 | 69.5%(부분 점수) / 33.8%(완벽 성공만) | 68.9% / 27.8% | 50.5% / 17.0% | ‘완벽 성공’ 기준이면 3분의 1 수준 |
| PerceptionBench | 이미지 속 세밀한 부분 보기(도구 사용) | 80.6% | 78.6% | 62.8% | 세 모델 중 가장 높음 |
특히 OSWorld 숫자를 보세요. 부분 점수로는 69.5%지만, 과제를 끝까지 완벽하게 해낸 비율만 세면 33.8%로 떨어져요. 벤처비트는 이를 두고 엠버에게는 범위가 정해지고 결과를 확인할 수 있는 일을 맡기는 게, 개발 업무 전체나 데스크톱 작업을 통째로 맡기는 것보다 낫다고 정리했어요. 또 일부 시험은 메타 내부 평가라는 점도 기억해 두면 좋아요.
함께 테스트한 회사들은 뭐라고 했나
| 회사 | 테스트 소감(메타 발표문 인용 요약) |
|---|---|
| 박스(Box) | 계약서를 회사 협상 기준에 맞춰 조항별로 점수 매기고 전체 위험 등급을 정확히 매겼다 |
| 클라인(Cline) | 코딩·문서 분석 같은 서브에이전트 작업에 맞춰 만들어졌다 |
| 클라우드플레어(Cloudflare) | 비교 모델보다 느린 구간(꼬리 지연) 기준 최대 30% 빨랐다 |
| 유닷컴(You.com) | 코딩 과제를 모두 완료했고 p95 응답 2.2초, 출력 토큰 36~48% 적게 사용 |
이 소감들은 메타가 직접 고른 파트너 인용이라, 우리 일에서도 똑같을지는 직접 시험해 봐야 알아요.
안전은 괜찮을까?
메타는 출시 전 자체 기준(메타 슈퍼인텔리전스 스케일링 프레임워크)으로 화학·생물, 사이버보안, 통제 상실 위험을 평가했고, 엠버가 고위험 기준선 아래였다고 밝혔어요. 작은 모델이지만 큰 모델과 같은 핵심 안전 훈련을 받았다고 해요. 또 사용자를 대신해 일할 때 ① 사용자 의도를 지키는지 ② 민감한 정보를 조심히 다루는지 ③ 웹페이지·문서에 몰래 숨겨진 명령(프롬프트 인젝션)에 넘어가지 않는지 ④ 큰 영향이 있는 행동 전에 사람에게 묻는지도 봤다고 설명했어요. 벤처비트에 따르면 API의 표준 모드로 보낸 내용은 모델 학습에서 제외된다고 해요.
그래서 나와는 무슨 상관이에요?
| 나는… | 알아 둘 점 |
|---|---|
| 일반 사용자 | 엠버를 직접 고를 일은 드물어요. 다만 앞으로 앱 속 AI 기능이 더 싸고 많아지는 배경이 이런 ‘작은 실행 모델’이에요 |
| 회사에서 AI 도입 담당 | 반복되고 정답 확인이 쉬운 일(분류·추출·테스트 실행)부터 작은 모델로 시험해 보고, ‘합격한 결과 1건당 비용’을 재 보세요 |
| 개발자 | muse-ember-1.0로 Responses·Chat Completions·Messages 방식 모두 지원. 20만 토큰 요금 문턱과 재시도 비용을 꼭 계산에 넣으세요 |
| AI 소식을 따라가는 분 | “점수 같음”은 반올림 기준인지, “비용 3분의 1”은 정가 추정인지, 어떤 시험이 회사 내부 평가인지 확인하는 습관이 중요해요 |
숫자에 속지 않는 체크리스트
- 반올림 확인: 36점 동점이지만 실제로는 35.8 대 36.2예요.
- 추정치 확인: 과제당 비용 0.14달러는 정가로 계산한 추정이에요.
- 기준 확인: OSWorld는 부분 점수(69.5%)와 완벽 성공(33.8%)이 두 배 넘게 달라요.
- 내부 평가 확인: OSWorld·PerceptionBench·Agents’ Last Exam 등은 메타 내부 평가예요.
- 요금 문턱 확인: 입력 20만 토큰을 넘으면 요청 전체가 3배 단가예요.
마무리: ‘가장 똑똑한 AI’ 경쟁 옆에서 벌어지는 ‘가장 알뜰한 AI’ 경쟁
그동안 AI 뉴스는 “누가 더 똑똑한가”가 주인공이었어요. 그런데 AI 에이전트가 실제 일을 하기 시작하면서 “같은 일을 누가 더 싸고 빠르게 반복하나”도 똑같이 중요해졌어요. 뮤즈 엠버는 그 경쟁에 메타가 내놓은 답이에요. 총괄 셰프 혼자 주방을 돌리지 않듯, 앞으로의 AI도 큰 모델 하나와 작은 모델 여럿이 팀으로 일하는 모습이 점점 흔해질 거예요. 다음에 “○○급 성능에 비용 몇 분의 1”이라는 제목을 보면, 오늘 본 반올림·추정치·요금 문턱 세 가지만 떠올려 보세요.