한 줄 요약: OpenAI가 Apache-2.0으로 공개한 openai/codex-security는 “AI가 보안 리뷰를 해 준다”는 데모 수준의 도구가 아닙니다. Codex 런타임 위에 범위 바인딩 → 위협 모델 → 독립 감사 → 집중 조사 → 후보별 검증 → 봉인된 보고서라는 감사 절차를 스킬과 스키마로 못 박고, 그 결과를 SARIF·JSON·CSV, GitHub Action, pre-commit 훅, Linear/Jira 트래킹까지 흘려보내는 보안 감사 파이프라인 SDK입니다. 오늘(11월 12일) 0.10.0이 나오면서 GitHub Trending 전체 순위에 올랐고, 저장소 별은 약 1.18만 개입니다.
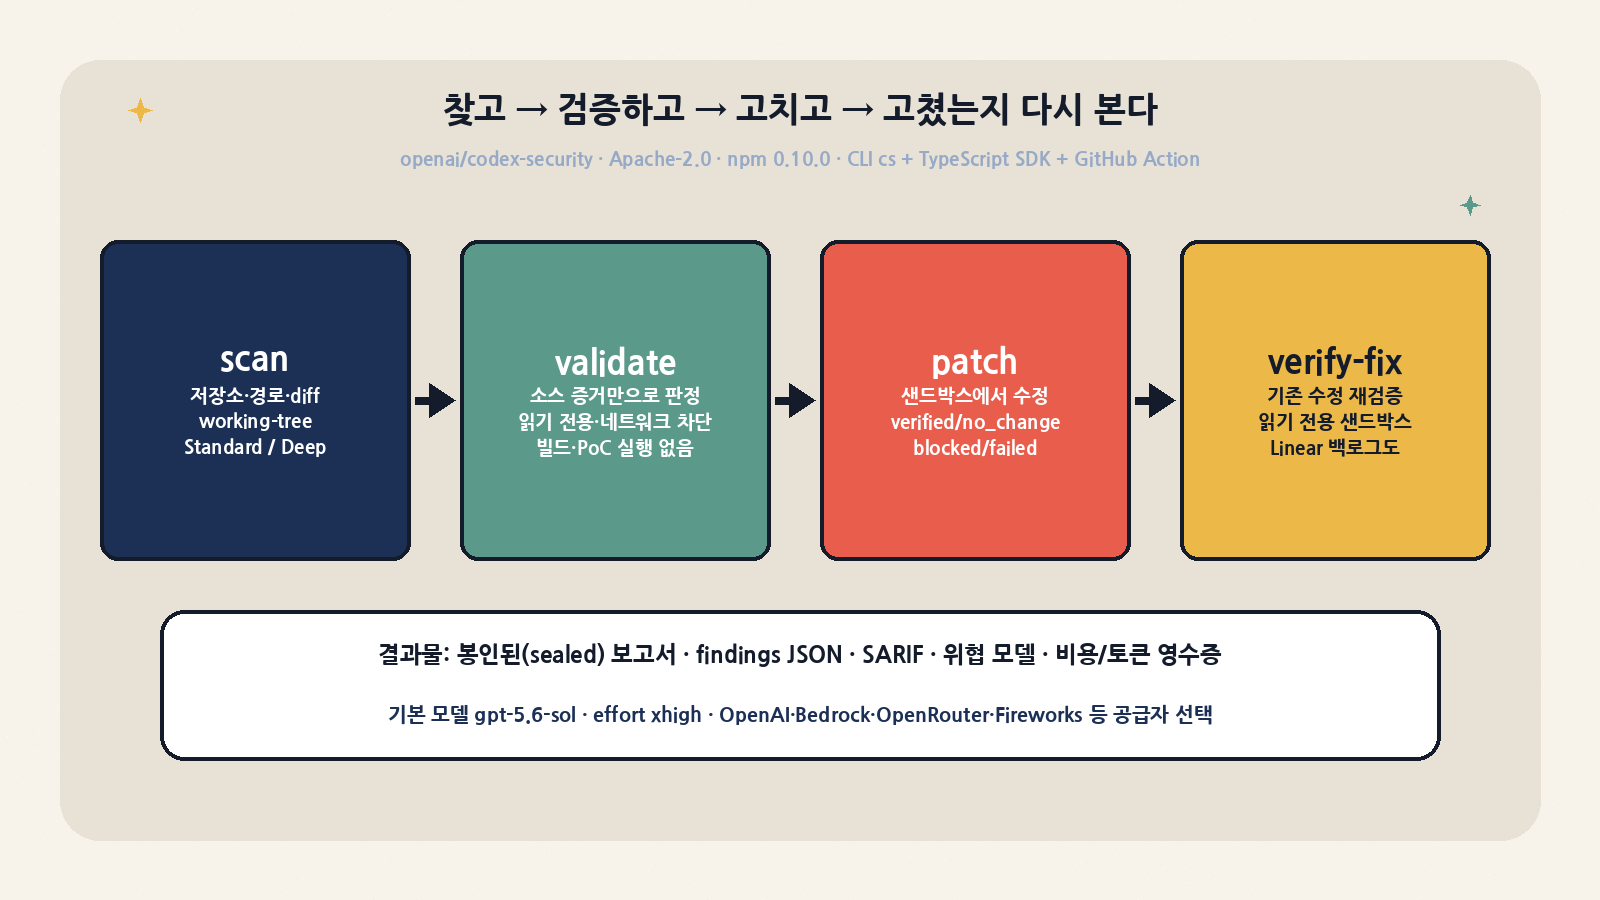
이 글은 실무자 관점에서 세 가지를 봅니다. ① 스캐너가 내부적으로 무엇을 어떤 순서로 하는지(그리고 무엇을 하지 않는지), ② Standard와 Deep 모드, 비용 상한, 실패 코드가 CI 설계에 어떤 제약을 거는지, ③ 기존 SAST(Semgrep·CodeQL 등)와 어떻게 나눠 써야 하는지. API 키 없이 박스에서 직접 확인할 수 있는 부분은 실제로 돌려 봤습니다.
1. 저장소 한눈에 보기
| 항목 | 내용 (2026-11-12 KST 확인) |
|---|---|
| 저장소 | openai/codex-security · 생성 2026-07-14(KST) · 별 약 11,800 |
| 라이선스 | Apache-2.0 |
| 배포물 | npm @openai/codex-security (CLI cs / codex-security + TypeScript SDK), GitHub Action(action-vX.Y.Z 별도 릴리스) |
| 최신 버전 | npm-v0.10.0 / action-v0.10.0 (2026-11-12 11:18~11:23 KST 릴리스) |
| 런타임 요구 | Node.js 22.13+(22.x) 또는 24.x·26.x, Python 3.10+(3.10은 tomli 필요) |
| 기본 모델 | gpt-5.6-sol, reasoning effort xhigh |
| 공급자 | OpenAI, Amazon Bedrock, OpenRouter, Fireworks AI, Cheaper Inference (Action은 openai·openrouter·fireworks·amazon-bedrock) |
| 규모 | sdk/typescript/src 파일 185개, src 내 TS 약 11.2만 줄, CLI 문서(cli.md)만 3,009줄 |
2. 구조: CLI는 ‘껍데기’, 실제 감사는 번들 플러그인의 스킬이 한다
npm 패키지를 열어 보면 성격이 분명해집니다. @openai/codex-security(약 20MB)는 TypeScript로 된 오케스트레이터이고, 실제 에이전트 실행은 의존성으로 딸려 오는 @openai/codex-sdk와 플랫폼별 Codex 바이너리(@openai/codex-linux-x64, 박스 기준 438MB)가 맡습니다. 감사 “방법론”은 패키지 안의 _bundled_plugin/에 들어 있습니다.
| 계층 | 위치 | 역할 |
|---|---|---|
| CLI / SDK | sdk/typescript/src (cli.ts, deep-scan.ts, cost.ts, cloud-publish.ts …) |
인자·설정 해석, 범위 검증, 비용·토큰 영수증, 저장·내보내기, 재개(resume) |
| 번들 플러그인 (v0.1.95) | _bundled_plugin/skills, references, schemas, mcp |
20개 스킬: security-scan, deep-security-scan, security-diff-scan, validation, fix-finding, verify-fix, threat-model, triage-finding, attack-path-analysis 등 |
| Codex 런타임 | @openai/codex-sdk 0.167.1 + 네이티브 바이너리 |
모델 호출, 샌드박스, 멀티 에이전트(부모 1 + 위임 워커 최대 8) |
| 로컬 워크벤치 | CODEX_SECURITY_STATE_DIR |
스캔 이력, findings DB, 중복 제거, telemetry 영수증(로컬 기록, 업로드 아님) |
| 외부 연결 (선택) | Codex Security Cloud, Linear/Jira/GitHub, ServiceNow 내보내기 | 발견 사항 게시·추적. 로컬 스캔은 Cloud 없이 동작 |
이 분리가 중요한 이유는 Codex 안에서 쓰든, 터미널에서 쓰든, CI에서 쓰든 같은 스킬이 돈다는 점입니다. Codex 세션에 Security 플러그인을 켜고 “인증·인가 위주로 스캔해 줘”라고 하는 것과 cs scan .은 같은 감사 절차를 공유합니다. 덕분에 “IDE에선 잡혔는데 CI에선 안 잡힌다” 같은 경로별 편차를 줄이려는 설계로 읽힙니다.
3. Standard 스캔은 실제로 무엇을 하나
references/core-scan.md에 적힌 핵심 워크플로를 정리하면 다음 순서입니다. 프롬프트 한 장이 아니라 체크포인트와 스키마가 있는 절차라는 점이 포인트입니다.
| 단계 | 하는 일 | 실무적 의미 |
|---|---|---|
| 1. 범위 바인딩 | 대상·scope, 상속된 SECURITY.md, 사용자 맥락, 지식 베이스, 소스 인벤토리 확정 |
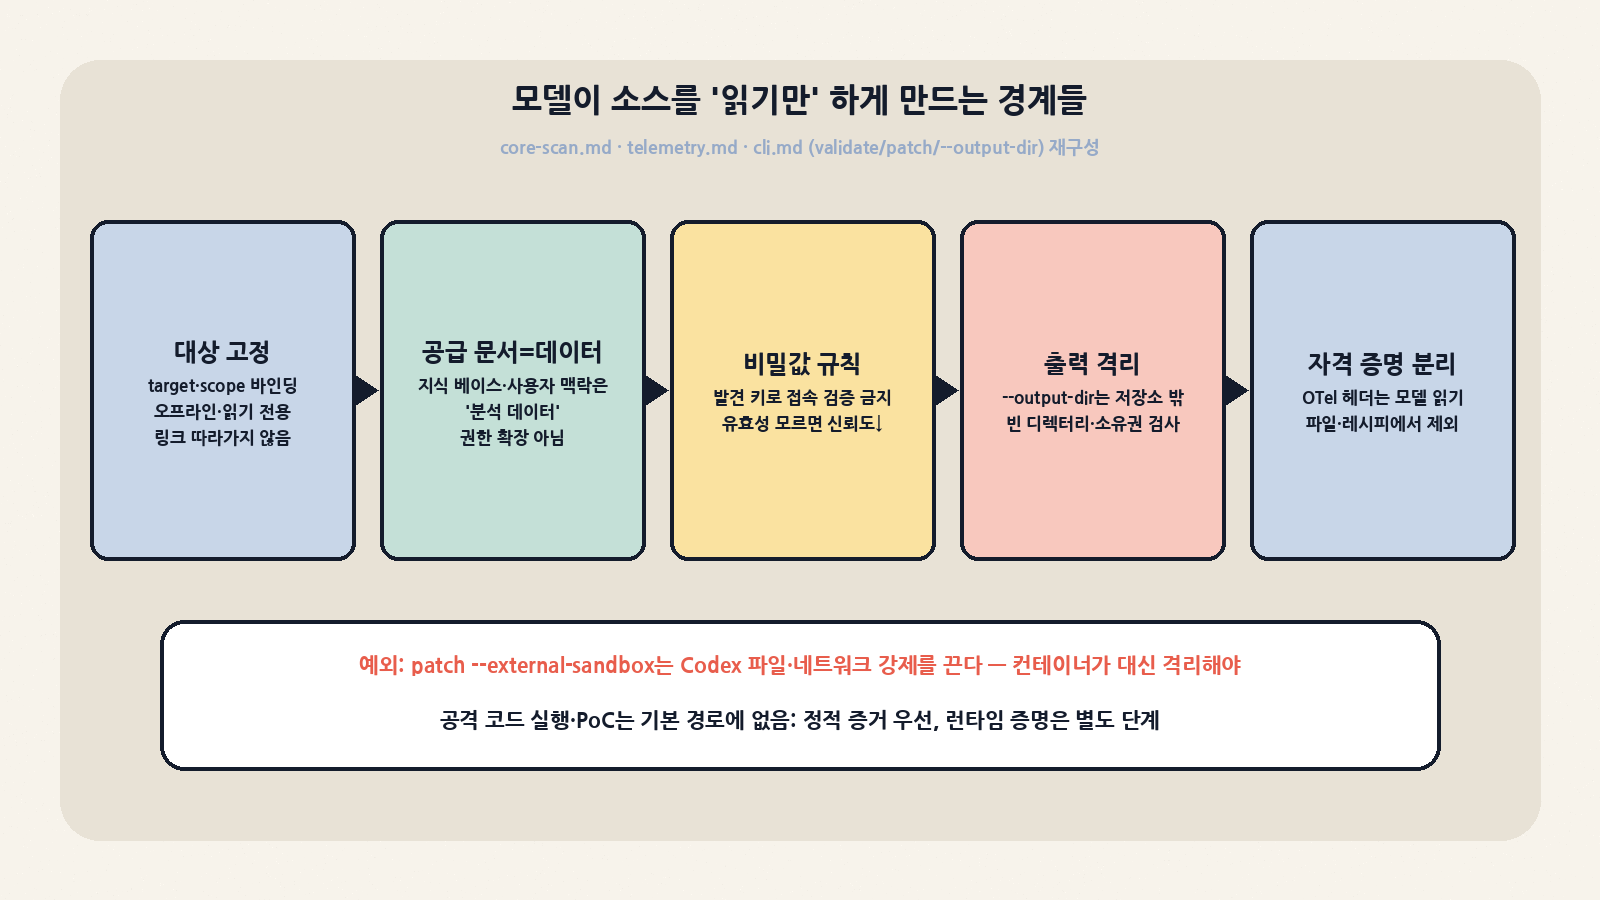
소스는 읽기 전용·오프라인으로만 검토. 공급 문서는 “분석 데이터”이지 범위 확장 권한이 아님 |
| 2. 독립 베이스라인 감사 | fork_turns: "none"으로 부모 가설 없이 별도 워커 시작 |
부모의 확증 편향을 줄이는 장치. 위임이 불가능하면 “독립 리뷰어 없음”을 기록 |
| 3. 위협 모델 | threat-model.md로 아키텍처·보안 경계 매핑, 초기 체크포인트 저장 |
나중에 cs export --artifact threat-model로 재분석 없이 추출 가능 |
| 4~5. 패킷화·위임 | 공격자·보호 자산·진입점·기대 통제·민감 연산 단위로 질문 묶음 → 집중 조사자에게 배분 | 파일 수가 아니라 복잡도와 공유 코드 기준으로 분배 |
| 6. 후보 체크포인트 | 후보마다 안정적 candidateId, 기각 시 반증(counterevidence)까지 보존 |
“왜 오탐으로 판단했나”가 남음 → 리뷰 가능성 |
| 7. 검증 | 서로 다른 ‘깨진 통제’마다 한 번씩 소스 대비 검증 | CWE가 같다는 이유만으로 병합하지 않음 |
| 8. 봉인 | scope·threatModel·findings·reviewState를 스키마대로 조립 |
새 스키마(codeEvidence, rootCause, attackPath.dataflow, evidenceRefs)를 어기면 자동 보정 없이 거부 |
눈여겨볼 규칙 두 가지. 첫째, 소스에 박힌 비밀값은 “소스를 읽을 수 있는 사람이 그 권한 이상을 얻는가”를 노출 경로로 봅니다. 그리고 발견한 키로 실제 서비스에 접속해 유효성을 확인하는 행위는 명시적으로 금지합니다. 유효성을 모르면 신뢰도와 영향도를 낮춰 적습니다. 둘째, 심각도는 기본 루브릭(default-severity-rubric.md) 또는 사용자가 넘긴 루브릭으로 매기는데, 루브릭 텍스트와 SHA-256을 스캔 레시피에 저장해 재실행·재개 때 원격 기본값이 바뀌어도 같은 기준을 씁니다. 감사 재현성 측면에서 꽤 신경 쓴 부분입니다.
4. Deep 스캔: “더 오래 생각하기”가 아니라 “Standard를 배치로 반복하기”
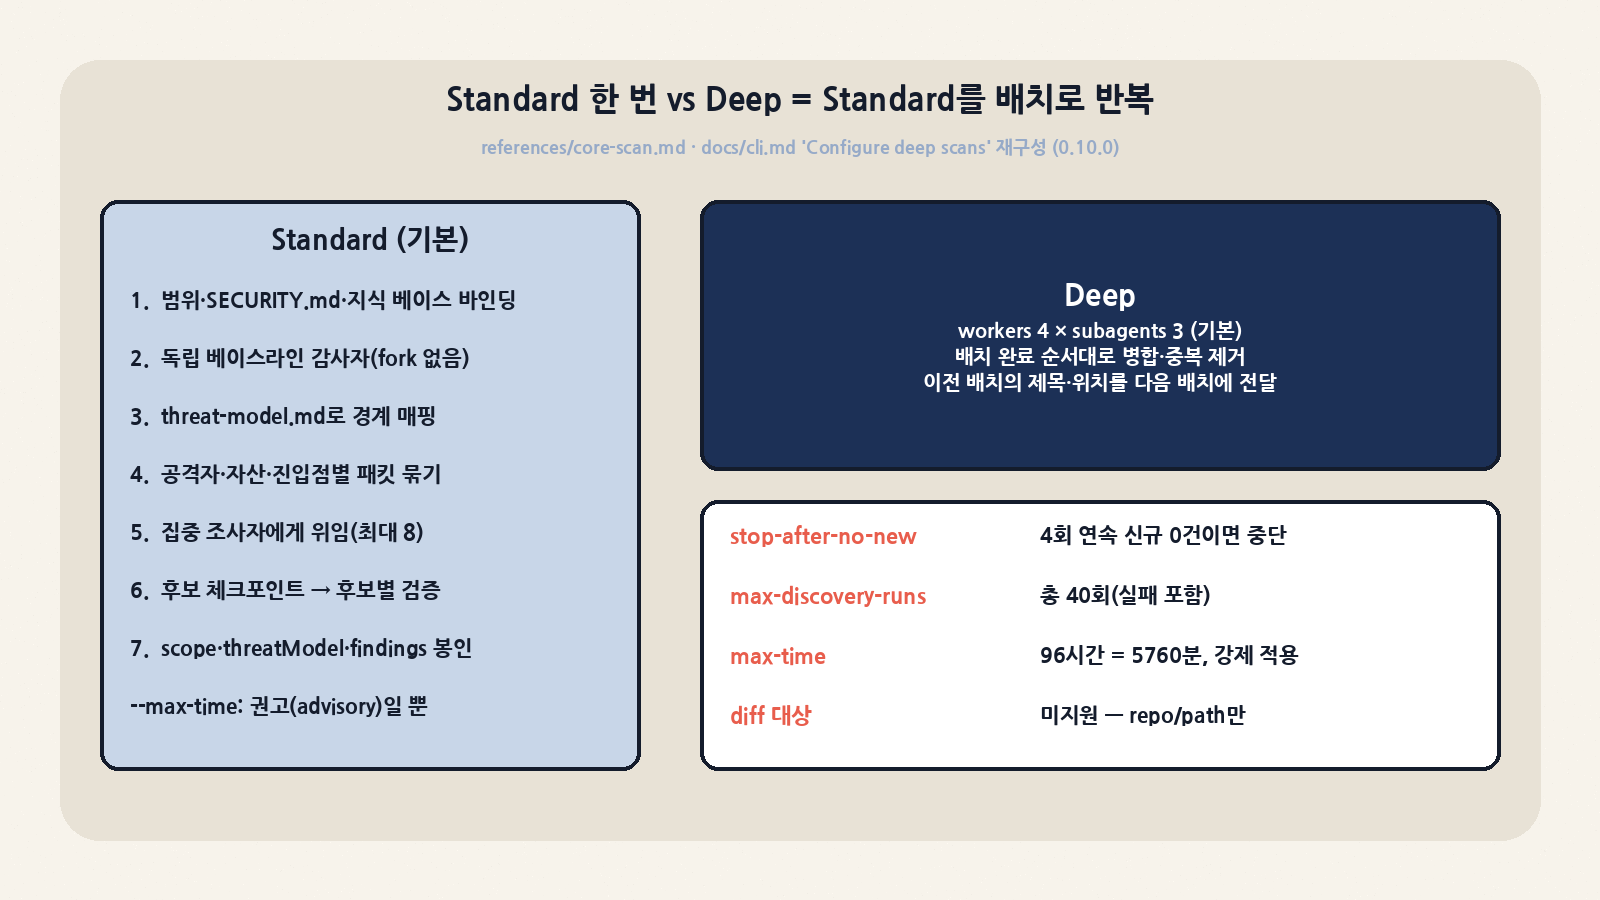
Deep 모드는 이름과 달리 단일 에이전트가 더 깊게 파는 구조가 아닙니다. Standard 스캔을 --workers개씩 배치로 띄우고(워커마다 --subagents개), 완료된 배치를 출시 순서대로 병합·중복 제거한 뒤, 이미 확보한 발견 사항의 제목과 주 위치를 다음 배치에 넘겨 “다른 도달 경로”를 찾게 합니다. 워커끼리는 실행 중에 서로 위치 확인을 요청하고 답할 수 있습니다.
| 설정 | 기본값 | CLI 플래그 | 비고 |
|---|---|---|---|
| workers | 4 | --workers |
bulk-scan --workers는 저장소 동시성이라 의미가 다름 |
| subagents (워커당) | 3 | --subagents |
0 허용 |
| stopAfterNoNew | 4 | --stop-after-no-new |
연속으로 신규 발견 0건인 완료 스캔 수 |
| stopAfterConsecutiveErrors | 3 | (없음, SDK/프로젝트 파일만) | 연속 오류 시 중단 |
| maxDiscoveryRuns | 40 | --max-discovery-runs |
실패 포함 총 시작 횟수 |
| max time | 5,760분(96시간) | --max-time(분) |
Deep에서는 강제, Standard에서는 권고 |
운영상 함의는 분명합니다. Deep의 비용은 대략 “Standard 1회 × 실제로 돈 횟수”에 비례하고, 수렴 조건(stop-after-no-new)이 실질적인 비용 제어 장치입니다. 또 사이버보안 정책 거부나 사용량 한도 소진이 발생하면 재시도·대체 워커를 멈추고 활성 형제 워커까지 취소한 뒤 완료된 산출물만 남깁니다. Deep은 diff 대상(PR 변경분)을 지원하지 않습니다. PR 게이트는 Standard diff 스캔으로, 주기적 전수 점검은 Deep으로 나누는 것이 자연스러운 구성입니다.
5. validate · patch · verify-fix: 고치는 단계의 경계
| 명령 | 샌드박스·권한 | 결과 상태 | 주의점 |
|---|---|---|---|
scan --validate |
읽기 전용 파일시스템, 네트워크·웹 검색 차단 | validation.md (보충 보고서) |
평가 결과가 저장된 findings나 --fail-on-severity 판정을 바꾸지 않음. 추가 호출이 비용 추적 밖이라 --max-cost와 병용 불가 |
validate |
체크아웃 읽기만, 빌드·테스트·PoC 실행 없음 | 사람이 읽는 평가 또는 --output-schema JSON |
스키마는 생성 전에 구조화 출력으로 전달. 모양만 검사하지 결론의 정확성은 보장 안 함 |
patch |
Codex 샌드박스(시작 실패 시 SANDBOX_UNAVAILABLE) |
verified / no_change / blocked / failed |
파일 변경 ≠ 수정 증명. --verification-mode static은 런타임 검사 없이 소스·diff로만 판단 |
patch --create-pr |
gh/glab 인증 필요 |
draft PR/MR + pullRequest: {branch, url} |
GitLab 설명은 인용 블록으로 감싸 quick action 주입을 막음. 실패 시 --resume-pr BRANCH |
verify-fix |
읽기 전용 샌드박스 | 선택 순서대로 판정 출력 | Linear 완료 이슈 필터로 “끝났다던 백로그” 재검증 가능 |
0.10.0의 변화 중 실무 체감이 큰 것은 blocked 패치 결과의 구조화입니다. 패치 프롬프트가 “파일이 바뀌었는가, 무엇이 수정을 막았는가, 다음에 무엇을 해야 하는가”를 묻고, 수정이 체크아웃 밖(예: 다른 저장소의 공유 라이브러리, 인프라 설정)에 의존하면 그 이유와 위치를 적게 했습니다. 모노레포가 아닌 조직에서 “AI가 못 고친 이유”가 티켓으로 바로 이어질 수 있다는 뜻입니다.
위험 구간은 patch --external-sandbox입니다. 이 옵션은 Codex의 파일시스템·네트워크 강제를 끄고 컨테이너가 격리를 책임진다고 가정합니다. 자동 폴백이 없으니, 격리가 확실한 일회용 컨테이너가 아니라면 쓰지 않는 편이 맞습니다.
6. CI·로컬 게이트 설계: exit code와 비용 상한을 먼저 이해해야 한다
| 신호 | 값 | 설계 포인트 |
|---|---|---|
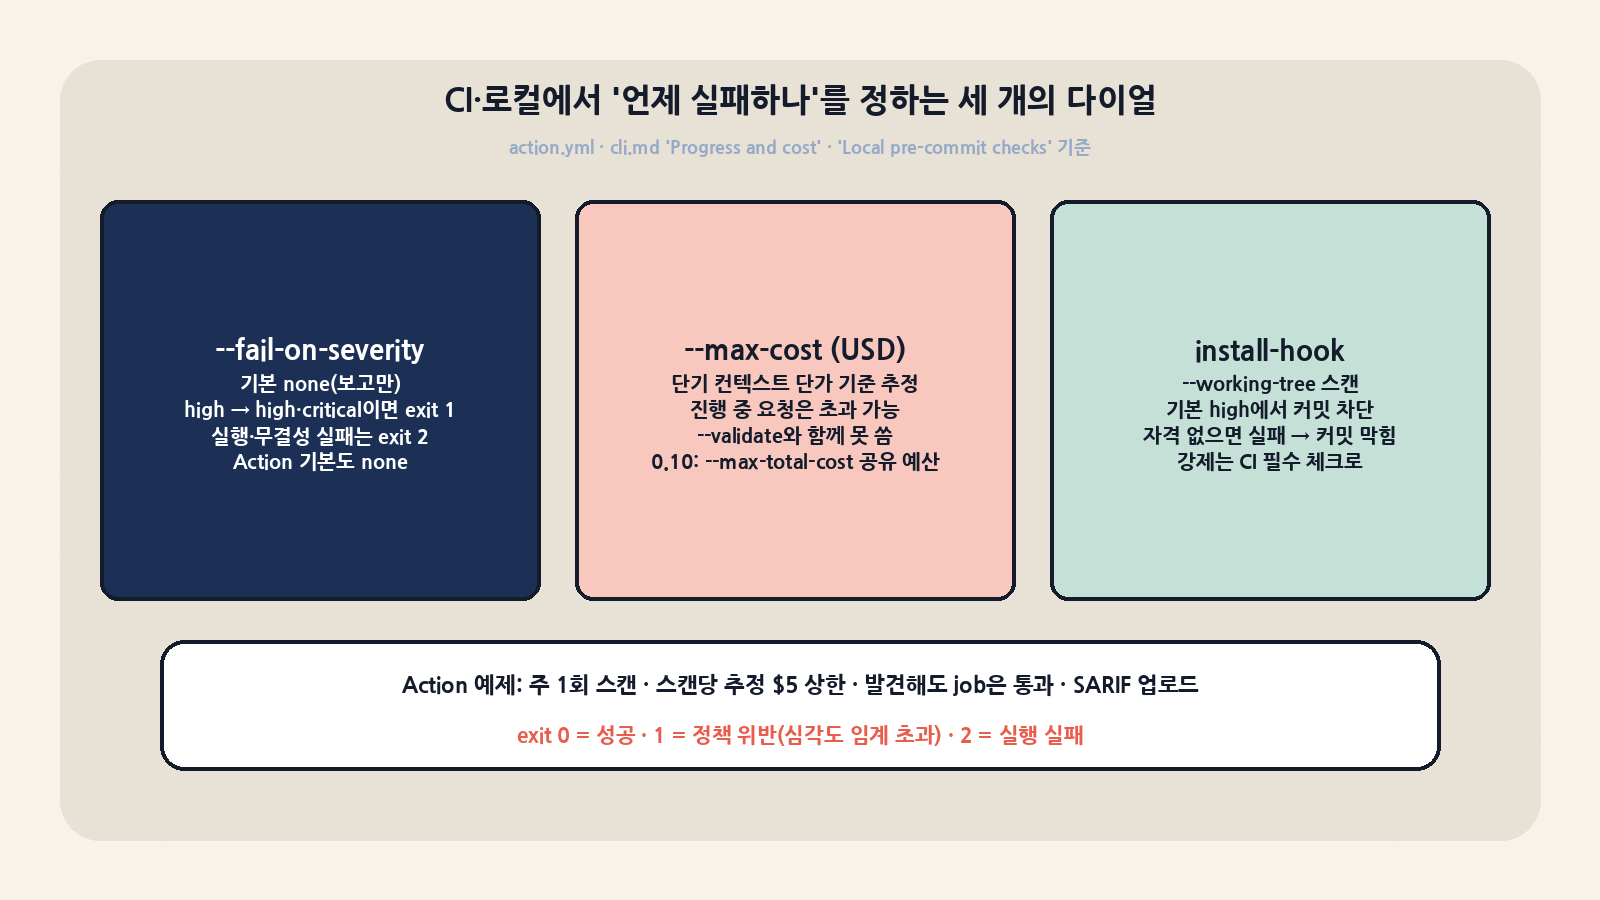
| exit 0 | 완료 | 기본은 발견이 있어도 0(보고만). 비용 상한 도달 후 유효 보고서가 봉인돼도 0 |
| exit 1 | 정책 위반 | --fail-on-severity high면 high·critical 존재 시. 범위 제외·건너뛴 파일은 실패 사유 아님 |
| exit 2 | 실행·대상 무결성·필수 출력 실패 | 자격 증명 없음도 2. “발견 없음”과 “못 돌았음”을 반드시 구분해야 함 |
--max-cost |
USD 추정 상한 | 단기 컨텍스트 단가 기준 추정, 진행 중 요청은 초과 가능. 0.10.0의 --max-total-cost는 bulk/component 전체가 예산 하나를 공유(재시도·복구 포함) |
--max-time |
분(소수 허용) | Standard에선 “이 시간 안에 쓸모 있는 조사를 하라”는 권고. 타임아웃이 아님 |
Action scan-status |
completed / failed / skipped | skipped는 빈 diff 또는 dry-run 전용 |
Action dry-run |
키 없이 설정만 검증 | fail-on-severity: none을 요구, 필수 체크가 아닌 별도 job으로 |
공식 Action 예제는 주 1회 저장소 스캔, 스캔당 추정 $5 상한, 발견이 있어도 job 통과로 보수적으로 시작합니다. 커밋 SHA로 고정하라고 요구하는 점(REPLACE_WITH_REVIEWED_COMMIT)도 공급망 관점에서 바람직합니다. 0.8.3부터 PR 워크플로의 필수 체크 이름이 Codex Security / <target-branch>로 바뀌었으니, 브랜치 보호 규칙을 쓰는 팀은 업그레이드 노트를 확인해야 합니다.
현실적인 비용 구조 때문에 권하는 배치는 다음과 같습니다.
| 시점 | 모드 | 권장 설정 | 이유 |
|---|---|---|---|
| 로컬 커밋 | Standard --working-tree (install-hook) |
기본 high 차단 | 선택적 장치일 뿐. 문서도 “강제는 필수 CI로”라고 명시 |
| PR | Standard --diff |
--max-cost + fail-on-severity: high |
Deep은 diff를 지원하지 않음. 변경분만 보므로 비용 예측이 쉬움 |
| 주간 | Standard 전체 저장소 | $5~10 상한, 보고만 | 공식 예제 형태. 추세를 SARIF로 Code Scanning에 축적 |
| 릴리스 전·분기 | Deep (경로 한정 권장) | workers·max-discovery-runs 축소, --max-time |
반복 배치라 비용이 큼. 인증·결제 같은 고위험 경로로 좁히기 |
| 조직 전체 | bulk-scan / scan-components |
--max-total-cost |
0.10.0부터 캠페인 전체 예산 공유, 중단 시 재개 가능 |
7. 박스에서 직접 돌려 본 것 (API 키 없음)
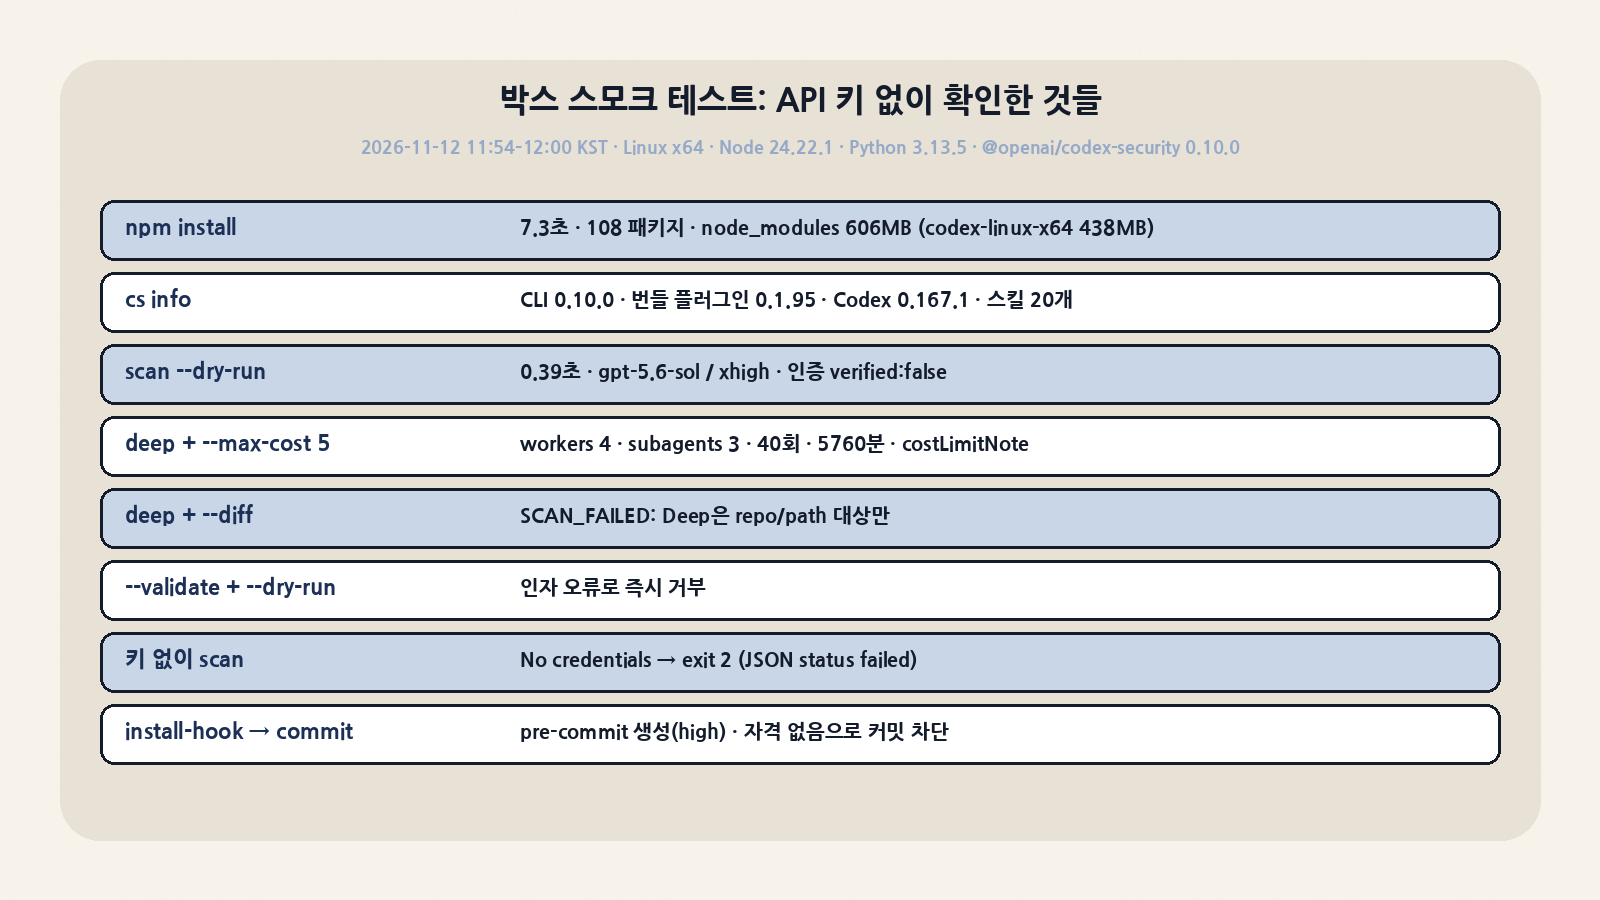
2026-11-12 11:54~12:00 KST, Linux x64(Node 24.22.1, Python 3.13.5) 박스에서 @openai/codex-security@0.10.0을 로컬 설치해 확인했습니다. 모델 호출은 하지 않았기 때문에 탐지 품질은 측정 대상이 아닙니다. 대신 설치 부담, 설정 해석, 가드레일 동작을 봤습니다. 스캔 대상은 저장소의 평가 픽스처(evals/triage-finding/fixtures/repo, 오픈 리다이렉트·경로 탐색 등 의도적 취약 코드가 있는 Express 앱)를 git 저장소로 만든 것입니다.
npm install @openai/codex-security@0.10.0     # 7.3s, 108 packages, node_modules 606MB
npx cs info --json                            # CLI 0.10.0, plugin 0.1.95, Codex 0.167.1
npx cs scan fixture --dry-run --json          # 0.39s, gpt-5.6-sol / xhigh, verified:false
npx cs scan fixture --mode deep --max-cost 5 --dry-run --json
npx cs scan fixture --diff HEAD --mode deep --dry-run --json   # SCAN_FAILED
npx cs install-hook fixture --json            # .git/hooks/pre-commit, failOnSeverity high
| 확인 항목 | 결과 | 해석 |
|---|---|---|
| 설치 크기 | 606MB, 그중 @openai/codex-linux-x64 438MB |
CI 캐시 전략이 필요. 컨테이너 이미지에 미리 굽는 편이 유리 |
| Deep dry-run | workers 4·subagents 3·stopAfterNoNew 4·maxDiscoveryRuns 40·maxTimeMinutes 5760, 각 값의 출처(default) 표기, costLimitNote 출력 |
어떤 값이 어디서 왔는지(프로젝트 파일/CLI/기본값) 확인 가능 → 설정 드리프트 디버깅에 유용 |
| Deep + diff | Deep mode supports repository and path targets only. |
문서와 일치. 실행 전 거부 |
--validate + --dry-run |
인자 단계에서 거부 | 비용 추적 밖 호출이 섞이지 않게 조합을 막음 |
| 자격 증명 없이 scan | {"status":"failed","code":"SCAN_FAILED"}, exit 2 |
“못 돌았다”가 “발견 없음(0)”으로 새지 않음 |
| install-hook 후 커밋 | 자격 증명 없음으로 훅 실패 → 커밋 생성 안 됨 | fail-closed. 다만 키가 없는 개발자 PC에선 모든 커밋이 막히므로 배포 전에 인증 경로를 정해야 함 |
cs init |
codex-security.yaml 생성, 권한 600, 빈 매핑 + 주석 템플릿 |
“이 파일은 CLI 옵션처럼 신뢰된다 — 신뢰할 수 없는 입력 밖에 두라”는 경고 포함 |
생성된 훅은 Node와 CLI의 절대 경로를 박아 넣고 GIT_DIR 등 Git 환경 변수를 해제한 뒤 scan . --working-tree --fail-on-severity high를 실행합니다. 문서가 “CLI를 대상 저장소 밖에 설치하고 그 사본을 직접 실행하라”고 강조하는 이유가 여기 있습니다. npx가 저장소 로컬 패키지를 고를 수 있기 때문입니다. 손으로 고친 훅은 덮어쓰지 않는 것도 확인 포인트입니다.
8. 기존 도구와의 위치 비교
| 구분 | Codex Security | 규칙 기반 SAST (Semgrep·CodeQL 등) | SCA (Dependabot·Trivy·Snyk 등) |
|---|---|---|---|
| 탐지 방식 | LLM 에이전트가 진입점→통제→민감 연산을 추적, 위협 모델 기반 | 패턴·데이터플로 쿼리 | 의존성 버전과 취약점 DB 대조 |
| 강점 | 인가 누락·비즈니스 로직·다중 파일 맥락, 수정·재검증까지 한 흐름 | 결정적·저렴·빠름, 재현 100% | 알려진 CVE 커버리지 |
| 약점 | 비결정적, 토큰 비용, 모델 거부 가능성, 증명은 정적 증거 위주 | 로직 결함·맥락 의존 취약점에 약함, 오탐 튜닝 부담 | 코드 자체 결함은 못 봄 |
| 관계 | 경쟁보다 흡수에 가깝습니다. docs/scanner-imports에 Semgrep·Opengrep·Snyk·Sonar·Checkmarx·Veracode·Black Duck·Wiz·Trivy·Dependabot·GitHub Code Scanning·GHSA·Endor·ArmorCode 등을 다루는 가져오기 가이드 18편(AWS Inspector·Continuum 포함)이 있고, 가져온 결과를 triage-finding·dedupe·classify-severity로 재판정하는 흐름입니다. |
||
즉 실무적으로는 “기존 SAST를 끄고 이걸 쓰자”가 아니라, 기존 스캐너 알림의 트리아지·중복 제거·소유자 추천 계층으로 먼저 붙이고, 사람이 하던 인가·로직 리뷰를 점진적으로 대체해 보는 순서가 위험이 적습니다. 저장소에는 SastBench v0.1(발견 2,737건, 진양성 299·위양성 2,438) 기반의 트리아지 평가 하네스가 들어 있어, 자기 조직 데이터로 캘리브레이션을 돌려 볼 수 있다는 점도 다른 AI 보안 도구와의 차별점입니다. 다만 이 하네스는 공급된 알림의 트리아지 정확도를 재는 것이지 저장소 전체 탐지 능력을 재는 것이 아니라고 README가 분명히 적고 있습니다.
9. 도입 전에 체크할 것
| 항목 | 확인 내용 |
|---|---|
| 데이터 경계 | 소스가 선택한 모델 공급자로 전송됩니다. 규제 코드라면 Bedrock 등 자체 계약 경로를 검토. telemetry 영수증은 로컬 telemetry/에 남고 요청 메타데이터(명령·버전·공급자군·모드)는 요청에 붙습니다 |
| Trusted Access for Cyber | 일부 사이버보안 요청과 보호된 발견 사항은 별도 접근 프로그램이 필요. Daybreak Blue/Red는 승인된 조직·API 프로젝트에서만. 거부되면 Deep은 형제 워커까지 멈춤 |
| 비용 예측 | 상한은 추정이며 진행 중 요청은 넘을 수 있음. 공시 단가 기준이라 할인·구독 한도는 반영 안 됨 |
| 재현성 | 모델 출력은 비결정적. 루브릭·지식 베이스 스냅샷·--workflow-id로 재시도 조건을 고정하는 습관이 필요 |
| 상태 디렉터리 | worktree 간 이력 공유를 원하면 CODEX_SECURITY_STATE_DIR을 고정. 로컬 serve 대시보드는 제거됨(기존 DB는 유지) |
| 호환성 변경 | 0.10.0은 breaking 3건: 심볼릭 링크 경로 해석, MCP 등록 스크립트의 --all/--agent 명시화, 구형 스캐너 캡처·Cloud 체크포인트 형식 폐기 |
| 릴리스 속도 | 0.9.0·0.9.1·0.10.0이 사흘 사이에 나옴. Action은 반드시 커밋 SHA 고정, npm은 버전 고정 |
정리
openai/codex-security의 가치는 모델의 똑똑함보다 감사 절차를 코드로 고정한 데 있습니다. 독립 감사자, 반증 보존, 봉인 스키마, 루브릭 해시, exit code 0/1/2 구분, fail-closed 훅 같은 장치는 “AI 보안 리뷰를 조직 프로세스에 넣을 때 무엇이 깨지는가”를 꽤 정확히 겨냥합니다. 반대로 비용·비결정성·공급자 데이터 경계는 도구가 해결해 주지 않습니다. 기존 SAST·SCA 위에 트리아지 계층으로 먼저 얹고, PR은 Standard diff·분기 점검은 경로 한정 Deep으로 나눠 예산을 걸어 두는 것이 지금 버전(0.10.0)에서 가장 현실적인 출발점입니다.