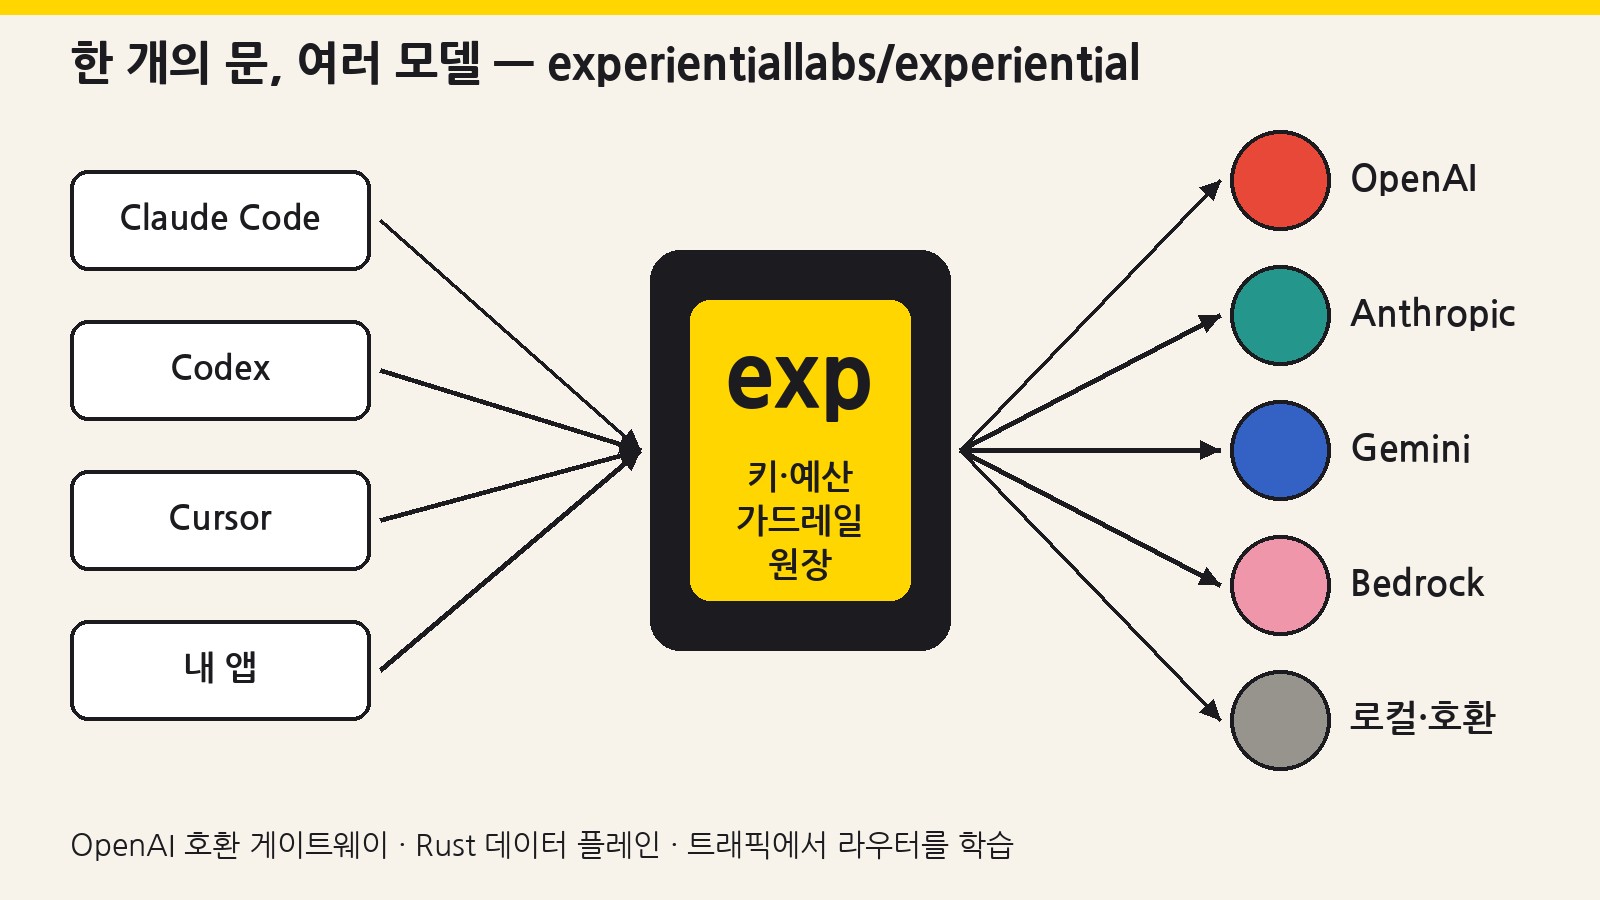
테크부터 경제, 생활까지. 복잡한 소식을 쉽게 풀어봅니다. 오늘 오후 오픈소스 심층 분석은 2026년 11월 12일 GitHub Trending(Python, daily)에 올라온 experientiallabs/experiential입니다. 한 줄로 줄이면 “OpenAI 호환 API 하나로 호스티드·BYOK·로컬 모델을 묶고, 누가 어떤 모델을 얼마까지 쓰는지 통제하며, 그 운영 트래픽을 다시 라우터·전용 모델 학습 재료로 돌리는 게이트웨이”입니다. LiteLLM 류의 프록시와 겉모습은 비슷하지만, 내부는 Rust로 컴파일된 데이터 플레인 + Python 컨트롤 플레인 + fsync되는 SQLite 원장이라는 꽤 독특한 설계를 택했고, 그 위에 exp build(트레이스→시뮬레이터)와 exp optimize(라우터/모델 최적화)를 얹었습니다. 이 글은 README·docs/·release-scope.md를 근거로 구조를 해부하고, 박스(리눅스 x86_64, Python 3.13.5)에서 API 키 없이 로컬 목(mock) 업스트림으로 게이트웨이 전 구간을 직접 돌려 본 결과를 공유합니다.
1. 오늘 왜 이 저장소인가: 트렌딩 근거와 기본 정보
아래 수치는 GitHub REST API와 PyPI JSON API에서 2026-11-12 16:56 KST 무렵 직접 조회한 값입니다. 스타 수는 시시각각 바뀌므로 “그 시점의 스냅샷”으로 읽어 주십시오.
| 항목 | 값 (2026-11-12 KST 기준) | 비고 |
|---|---|---|
| 저장소 | experientiallabs/experiential | Apache-2.0, 주 언어 Python |
| Stars / Forks | 16,624 / 300 | GitHub API, 16:56 KST 조회 |
| Trending | Python daily 목록에 “589 stars today” | github.com/trending/python?since=daily |
| 생성일 | 2026-06-25 07:40 KST | 약 4.5개월 된 프로젝트 |
| 최신 PyPI | experiential 0.7.238 (11-12 11:15 KST 업로드) |
네이티브 확장 exp-gateway-native 0.3.185 고정 |
| 오늘의 신규 릴리스 | exp-code-v0.1.0(05:12) → v0.1.1(09:41) → v0.1.2(10:10 KST) |
Pi 기반 오픈소스 코딩·코워크 에이전트 exp code 공개 |
| 릴리스 속도 | PyPI에 240개 버전이 올라와 있음 | 0.7.236→0.7.238이 하루 사이에 나옴 |
| 코드 규모(체크아웃 기준) | Python 약 24.3만 줄(테스트 제외) + 테스트 파일 749개, Rust 약 9.1만 줄, TypeScript(agent) 약 4천 줄 | 단순 wc -l 집계 |
오늘 상승의 직접적인 계기는 exp code(오픈소스 코딩 에이전트) 추가와 Anthropic 프롬프트 캐싱 자동화(#1332, #1339) 같은 굵직한 커밋이 같은 날 몰린 것으로 보입니다. 다만 “왜 별이 늘었는가”는 추정이고, 확인된 사실은 위 표의 릴리스·커밋 타임라인까지입니다.
2. 이 프로젝트가 풀려는 문제
README가 스스로 정리한 목표는 세 가지입니다.
- 호스티드, BYOK(Bring Your Own Key), 로컬 모델을 하나의 OpenAI 호환 API로 사용
- 어떤 사용자·에이전트가 어떤 모델을, 어떤 용도로, 얼마까지 쓸 수 있는지 통제
- 운영 트래픽을 품질·속도·비용에 맞춘 맞춤 라우터 또는 모델로 전환
1·2번은 LLM 게이트웨이의 “기본기”이고, 차별점은 3번입니다. 에이전트 트레이스를 가져와 시나리오를 채굴하고, 기록된 사실을 검색하는 RAG 인덱스와 “월드모델 시뮬레이터”를 만든 뒤, 그 위에서 후보 모델 조합을 비교해 라우터를 고르는 흐름입니다. 즉 “어느 모델이 더 좋냐”를 벤치마크가 아니라 내 트래픽을 재연한 시뮬레이션으로 판단하자는 접근입니다.
3. 저장소 구조 한눈에 보기
| 경로 | 역할 | 실무자가 볼 포인트 |
|---|---|---|
exp/cli/ |
Typer 기반 CLI: build, run, code, login, config, capture, optimize, eval | 모든 명령이 --non-interactive --json을 지원해 자동화 친화적 |
exp/runtime/gateway/ |
게이트웨이 컨트롤 플레인: 인증, 예산(budgets.py, budget_authority.py), 캐싱, 페일오버, 가드레일 등 |
파일마다 *_test.py가 짝을 이루는 구조 |
exp/runtime/gateway/native/ |
Rust 크레이트 → PyO3 확장 exp_gateway_native |
소켓·디스패치·SSE를 GIL 밖에서 처리하는 데이터 플레인 |
exp/runtime/openai_protocol, anthropic_protocol |
Chat Completions / Responses / Messages 와이어 처리 | Responses-over-WebSocket(Codex CLI 방식)까지 지원 |
exp/simulation/ |
ingest, mining, retrieval, reconstruction, engines | 트레이스를 시나리오·시뮬레이터로 바꾸는 부분 |
exp/optimize/ |
router, model, evaluation, simulation | 라우터 적합(fit)·held-out 평가, Tinker SFT |
agent/ |
exp-code (TypeScript, Node.js 22.19+) | Pi 위에 얹은 코딩·코워크 에이전트 |
docs/reference/ |
게이트웨이 계약 문서 30여 개 | 페일오버 규칙, 가드레일, 이그레스 정책 등 “계약” 단위로 문서화 |
docs/release-scope.md |
지원·검증된 것과 명시적으로 제외된 것 | 도입 검토 시 가장 먼저 읽을 문서 |
인상적인 점은 문서 문화입니다. release-scope.md에 “공급자별 라이브 검증은 자격 증명이 필요하므로 Not run”이라고 표로 적어 두었고, 픽스처 성공을 라이브 결과처럼 포장하지 않겠다고 명시합니다. 오픈소스 게이트웨이에서 보기 드문 정직함이라 평가 시 참고 가치가 큽니다.
4. 내부 동작: 요청 한 건이 지나가는 길
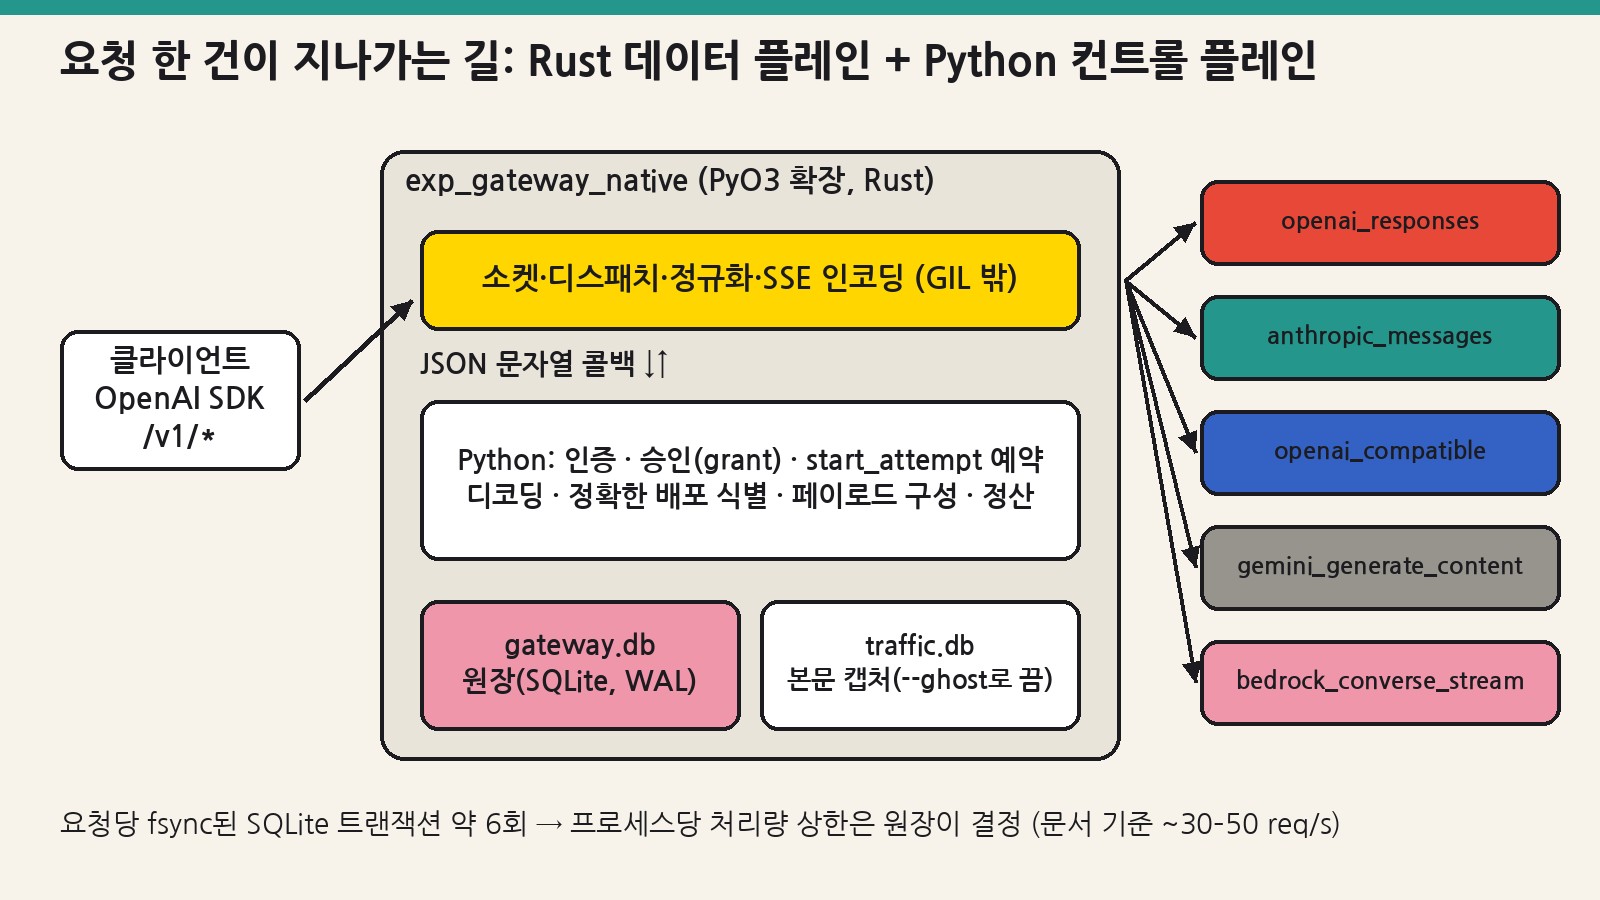
docs/reference/gateway-architecture.md에 따르면 게이트웨이의 데이터 플레인은 단 하나, PyO3 확장 exp_gateway_native 안의 Rust HTTP 서버입니다. 확장이 없으면 Python 폴백 없이 빌드 명령을 안내하며 실패합니다. 역할 분담은 다음과 같습니다.
| 계층 | 담당 | 설계 의도 |
|---|---|---|
| Rust 데이터 플레인 | 소켓, 업스트림 디스패치, 응답 정규화, SSE 인코딩 | 스트리밍 토큰 릴레이를 GIL에서 해방 |
| Python 콜백(JSON 문자열) | 인증·승인(admit), 물리적 디스패치마다 start_attempt로 예산 예약, 결과 정산 |
정책·권한 로직은 Python에서 빠르게 진화 |
| Python 디코딩·권한 | 표면별 디코딩, 정확한 배포(deployment) 식별, 페이로드 구성 | “어느 정확한 모델로 갔는가”를 원장에 남김 |
| SQLite 원장 | 인증·승인·수락·시도 시작(예산 예약)·라우트 컨텍스트·정산 등 요청당 약 6회 fsync 트랜잭션(synchronous=FULL) | 크래시·재시도에도 이중 과금 없는 회계 |
| 와이어 방언 | openai_responses, anthropic_messages, openai_compatible(Azure·OpenRouter 포함), gemini_generate_content, bedrock_converse_stream, 결정 전용 typesafe_systemone |
Bedrock은 SSE가 아닌 AWS 이벤트 스트림, SigV4 서명은 대기열 통과 직후에 수행해 서명 만료 방지 |
예산은 정수 nano-USD로 월 단위 집행됩니다. 요청 전에 o200k 토크나이저로 입력 토큰을 추정해 최악의 경우를 예약하고, 공급자가 보고한 usage로 정산하는 방식입니다. 스트리밍 툴 호출 인자는 “JSON 객체 하나로 조립돼야 한다”는 엄격한 계약이 있어, 객체가 닫힌 뒤 공급자가 흘린 꼬리는 보류·판정하고, 중간에 잘린 인자는 malformed_response가 아니라 finish_reason: length(예산 부족)로 정리합니다. 실무에서 에이전트가 “깨진 툴 콜”로 무한 재시도하는 문제를 게이트웨이 계층에서 구분해 주는 셈입니다.
성능 근거: 병목은 언어가 아니라 원장
docs/research/rust-gateway-engine.md는 16 vCPU Azure VM(Standard_D16ds_v5)에서 측정한 결과를 공개합니다. 핵심만 옮기면 다음과 같습니다(문서 수치 그대로이며, 제가 재현한 값이 아닙니다).
| 측정 | Python 엔진 | 네이티브(Rust) 엔진 |
|---|---|---|
| 저동시성 첫 바이트 추가 지연(목 업스트림) | 약 25 ms | 약 25 ms |
| 스트림 64개 동시 중앙값 TTFB | 938 ms | 약 25 ms 유지(128 스트림까지 평탄) |
| 릴레이 토큰 처리량/프로세스 | 약 2,000 tokens/s에서 포화 | 약 21,000 tokens/s |
| 즉답 업스트림 req/s 상한 | 약 48 | 약 33 (GIL 왕복 3회 추가) |
| 라이브 공급자 저동시성 추가 TTFB | 약 150 ms | 약 20 ms |
요점은 명확합니다. 네이티브 엔진은 토큰 스트리밍을 GIL 병목에서 꺼내 주지만, 프로세스당 요청 수(req/s)는 SQLite fsync가 상한입니다. 문서 스스로 “30~50 req/s를 넘기려면 그룹 커밋, fsync 완화, 루트 샤딩 같은 내구성 아키텍처 결정이 필요하다”고 적고 있습니다. 즉 대량의 짧은 요청(분류·임베딩 폭주)을 단일 프로세스로 받기엔 적합하지 않고, 긴 스트리밍 에이전트 트래픽에 강한 구조입니다.
5. 설치와 실행 (README 기준)
README의 시작 경로는 두 줄입니다. 첫 실행 시 설정 마법사가 공급자·모델·추론 강도를 고르고, 공개 별칭(alias)·아이덴티티·명령 예산(기본 $50.00)을 보여 준 뒤 일회성 키를 출력합니다.
pip install experiential
exp
발급받은 키로 OpenAI 호환 요청을 보내면 됩니다.
export EXP_GATEWAY_KEY=...
curl http://127.0.0.1:8000/v1/chat/completions \
  -H "Authorization: Bearer $EXP_GATEWAY_KEY" \
  -H 'Content-Type: application/json' \
  -d '{"model":"opus-5","messages":[{"role":"user","content":"Help me"}]}'
그 밖의 주요 명령은 다음과 같습니다.
| 명령 | 하는 일 | 요구 조건·주의 |
|---|---|---|
exp / exp run [PROJECT] |
로컬 인증 게이트웨이(127.0.0.1) 실행 | 기동 시 공급자 호출 없음, --ghost로 본문 캡처 끔 |
exp config gateway ... |
init / provider / alias / identity / grant / key / usage | grant는 deny-by-default |
exp code |
exp-code 에이전트 실행(-p 프린트 모드 포함) |
Node.js 22.19+ |
exp capture |
Codex·Claude Code 데스크톱 앱 트래픽 수집 | macOS, Python 3.13+, 확장·인증서 승인 필요, 실험적 |
exp build NAME |
트레이스로 시뮬레이션 구축 + 라우터 최적화 | 학습 비용이 정해져 있지 않아 자동화에선 --yes 필요 |
exp optimize model NAME |
Tinker로 오픈 모델 SFT | sft extra, 유한한 상한이 없으면 fail-closed |
exp config telemetry disable |
익명 PostHog 텔레메트리 끄기 | 기본값은 켜짐 |
Python에서는 학습된 프로젝트 라우터를 공식 OpenAI 클라이언트로 불러 쓸 수 있습니다.
import exp

with exp.load_router("my-project") as client:
    response = client.chat.completions.create(
        model="my-project",
        messages=[{"role": "user", "content": "hello"}],
    )
6. 박스 실측: 키 없이 게이트웨이 전 구간 돌려 보기
실제 공급자 키를 쓰지 않고, 127.0.0.1:9100에 OpenAI 호환 목 서버(Python 표준 라이브러리 30여 줄)를 띄워 게이트웨이의 인증·권한·회계 경로를 검증했습니다. 독립 실행 게이트웨이는 기본적으로 로컬·사설 업스트림을 허용합니다(호스티드 임베더는 public_upstreams_only=True를 켜야 한다고 gateway-egress.md에 명시). 사용한 명령은 exp run --check가 직접 안내한 순서 그대로입니다.
python3 -m venv venv && ./venv/bin/pip install experiential   # 0.7.238 + exp-gateway-native 0.3.185
exp config telemetry disable
exp config gateway init --non-interactive --json
exp config gateway provider add mock --provider openai-compatible \
  --credential-env MOCK_KEY --base-url http://127.0.0.1:9100/v1 --non-interactive --json
exp config gateway alias create pong --deployment mock:mock-1 --exact-model mock-1 \
  --input-price 1000000000 --output-price 2000000000 --non-interactive --json
exp config gateway identity create default --non-interactive --json
exp config gateway grant add default pong --non-interactive --json
exp config gateway key issue default --key-id k1 --json
exp run --non-interactive --port 8011| 시험 | 결과 | 해석 |
|---|---|---|
GET /health/ready |
{"status":"ready"} |
기동 시 공급자 호출 없음(목 로그에도 요청 0건) |
| 키 없이 chat 요청 | HTTP 401 | 가상 키 인증 필수 |
| grant 없는 모델 이름 | HTTP 403 | deny-by-default 동작 확인 |
max_tokens 없이 요청 |
400 invalid_parameter: “출력·컨텍스트 한도가 선언되지 않은 라우트이니 max_tokens를 명시하라” |
예산 예약을 위해 상한을 강제. 별칭에 --maximum-output...을 선언하면 해소 |
| 목이 비스트리밍 JSON만 줄 때 | 502 all_routes_failed |
게이트웨이는 클라이언트가 비스트리밍이어도 업스트림엔 stream: true + stream_options.include_usage로 보냄 → 호환 서버가 SSE·usage를 지원해야 함 |
| 목을 SSE로 고친 뒤 Chat(비스트리밍) 3회 | 모두 200, 10~16 ms(curl total) | 스트림을 모아 단일 응답으로 재조립 |
| Chat 스트리밍 | 정상 SSE 청크 릴레이, model은 공개 별칭 pong으로 치환 |
내부 모델명(mock-1)을 클라이언트에 노출하지 않음 |
OpenAI SDK responses.create |
“pong from mock”, usage 9/3 | Responses API를 Chat 방언 업스트림으로 번역 |
exp config gateway usage --json |
입력 45·출력 15 토큰, known_estimated_cost_nano_usd 75,000 |
45×1,000 + 15×2,000 = 75,000 nano-USD($0.000075) — 단가 설정과 정확히 일치. 실패한 4회는 unknown_cost_attempts로 별도 집계 |
파일 측면에서는 .exp/gateway/ 디렉터리가 0700, DB 파일이 0600으로 생성됐고, 프롬프트 문자열 “ping”은 traffic.db에서만 발견되고 회계용 gateway.db에서는 발견되지 않았습니다. 문서가 말하는 “content-free 회계 + 선택적 본문 캡처” 분리가 실제로 지켜지는 것을 확인했습니다. 반대로 말하면 기본 실행에서는 프롬프트 본문이 로컬 디스크에 남는다는 뜻이므로, 민감 데이터라면 --ghost를 기본값처럼 쓰는 편이 안전합니다.
7. exp build / optimize: 트래픽을 라우터로 바꾸는 루프
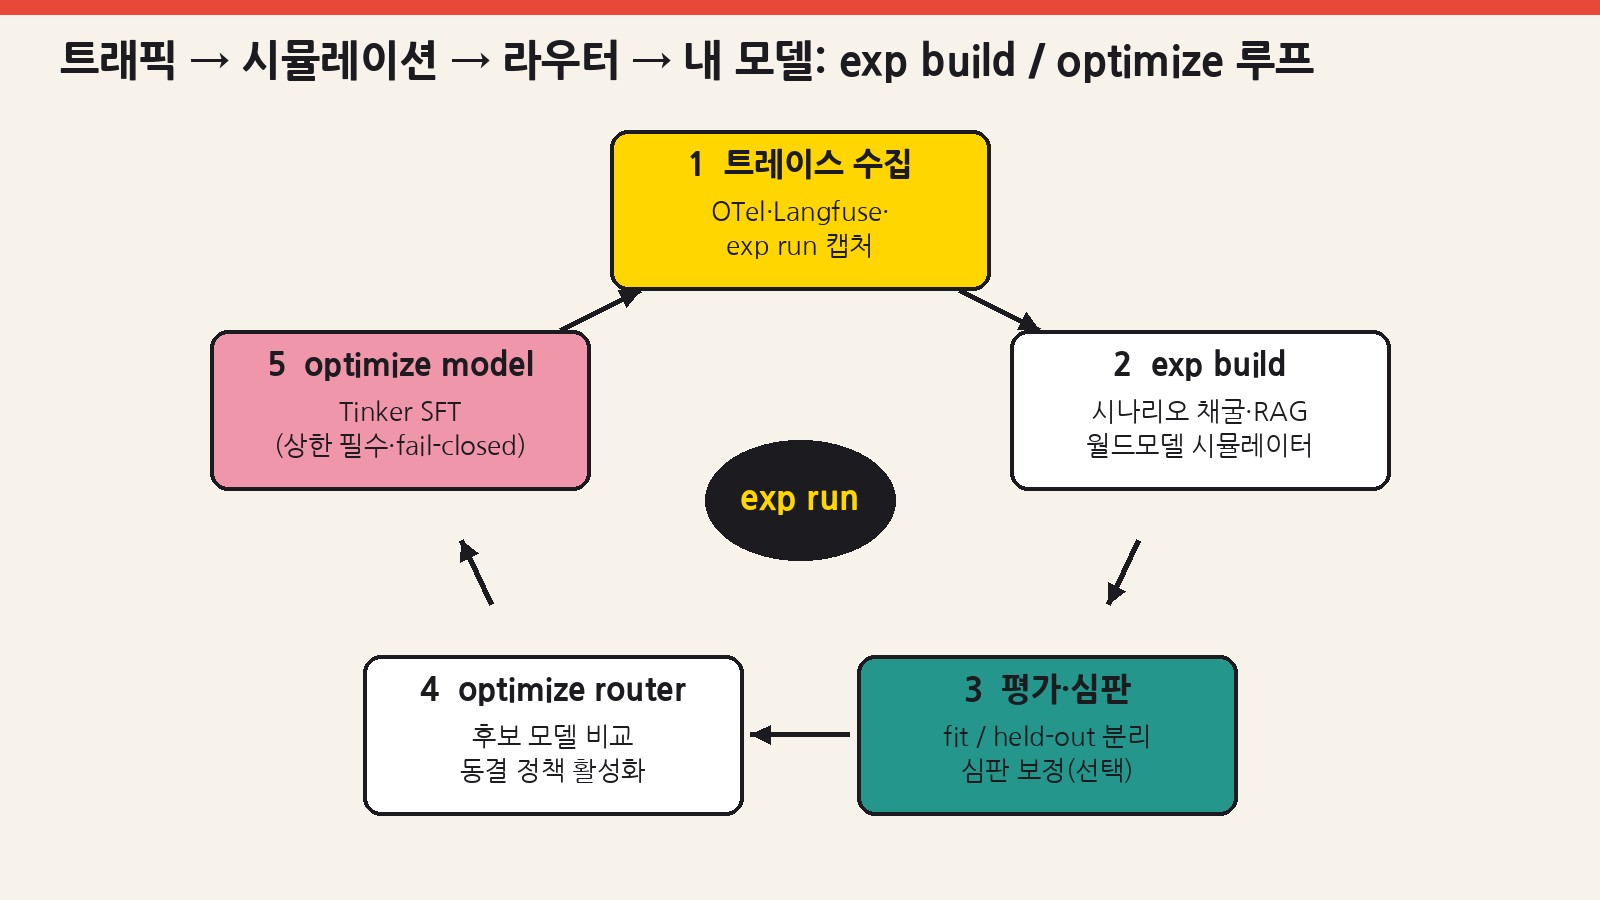
docs/usage.md의 “Learning from traces” 절은 이 프로젝트의 야심이 어디 있는지 보여 줍니다. exp build PROJECT -t PATH는 인덱스와 시뮬레이터를 만든 뒤 모든 트레이스를 내보낸 순서대로 한 번씩 재연합니다. 각 스텝은 기록된 응답이 공개되기 전에 먼저 예측되고, 불일치는 조사(investigation)되며, 조사자가 “전이 가능”하다고 표시한 것만 관찰 가능한 단서로 표현된 메모리 규칙이 됩니다.
평가 방식도 신경 썼습니다. 학습은 test-then-train으로 측정돼 각 트레이스는 그 이전에 고정된 메모리로만 예측되고, 같은 작업 계열(lineage)의 메모리와 검색 결과는 가려집니다. 보고서는 학습 곡선과 함께 “마지막 1/4 트레이스를 거의 최종 메모리로 예측한 unseen-task 추정치”를 출력합니다. 데이터 누수를 막기 위한 장치가 문서 수준에서 명시돼 있다는 점은 평가 설계를 직접 해 본 분들이라면 반가울 부분입니다.
| 단계 | 입력 | 출력 | 비용·안전장치 |
|---|---|---|---|
| 트레이스 수집 | OTLP, otel-genai, Phoenix, Braintrust, Langfuse, LangSmith, Mastra, PostHog, chat-json 등 | 정규화 트레이스 | 공개 예시 데이터셋(HF wmo-terminal-tasks-traces) 제공 |
exp build |
트레이스 + 공급자·모델·예산 | 시나리오, 서빙/적합용 RAG 인덱스, 월드모델 시뮬레이터, 메모리 | 학습 비용 미정 → 동의 필요, 재개 가능(완료 트레이스는 재호출 없음) |
| 심판·보정 | 루브릭 | 판정, 사람 보정 시 불변 후속 버전 | 보정은 권장이지만 선택 |
exp optimize router |
완료된 grounded 프로젝트 + router-optimization.json |
동결된 선택 전용 라우터 정책 | 라우터 적합에는 월드모델 충실도 테스트를 쓰지 않음 |
exp optimize model |
라우터에서 쌓인 트레이스 | Tinker SFT 결과 | 유한 상한·보수적 견적 없으면 거부 |
근거의 수준은 냉정하게 봐야 합니다. release-scope.md의 W16 증거는 정규화 트레이스 100개, fit 50개, held-out 20개, 계획 셀 140개를 결정론적 가짜 클라이언트로 돌린 것이며 관측 지출은 $0.00입니다. 또한 “실제 Tinker 학습은 돌리지 않았고, 학습 모델 대 베이스 모델 비교도 없으며, 품질 향상 주장도 하지 않는다”고 명시합니다. 즉 파이프라인의 배관은 검증됐지만, “내 트래픽으로 라우터를 만들면 비용이 얼마나 줄고 품질이 얼마나 유지되는가”는 각자 측정해야 합니다.
8. 비슷한 도구와 비교
| 항목 | Experiential | LiteLLM Proxy | Portkey AI Gateway(OSS) | OpenRouter | RouteLLM |
|---|---|---|---|---|---|
| 형태 | 셀프호스트 게이트웨이 + 호스티드 플랫폼 | 셀프호스트 프록시(Python) | 셀프호스트 게이트웨이(TypeScript) | 호스티드 모델 마켓플레이스 | 라우터 학습·서빙 프레임워크 |
| 데이터 플레인 | Rust(PyO3) + Python 컨트롤 | Python | Node/엣지 런타임 | 비공개(서비스) | Python |
| API 표면 | Chat, Responses(+WebSocket), Anthropic Messages, 미디어, Decisions | OpenAI 호환 중심, 다수 엔드포인트 | OpenAI 호환 중심 | OpenAI 호환 | OpenAI 호환 서버 |
| 키·예산 통제 | 아이덴티티·grant·가상 키, 월 nano-USD 원장 | 가상 키·팀·예산 | 설정 기반, 상용판에서 확장 | 계정 크레딧 | 해당 없음 |
| 라우팅 근거 | 내 트레이스 기반 시뮬레이션·평가로 적합 | 규칙·가중치·폴백 | 규칙·조건부·폴백 | 가격·가용성 기반 자동 선택 | 선호 데이터로 강/약 모델 이진 라우팅 |
| 전용 모델 학습 | Tinker SFT 연계(실험적) | 없음 | 없음 | 없음 | 없음 |
| 잘 맞는 곳 | 에이전트 트래픽이 많고 비용·품질 최적화를 데이터로 하고 싶은 팀 | 빠른 다공급자 통합, 넓은 생태계 | 가볍고 빠른 엣지 게이트웨이 | 인프라 없이 다양한 모델 시험 | 연구·라우터 실험 |
비교 대상의 세부 기능은 버전마다 달라지므로 위 표는 “설계 철학의 차이”로 읽어 주십시오. Experiential의 확실한 차별점은 (1) 원장 정확성에 대한 강한 집착, (2) Responses·Anthropic Messages·Codex WebSocket 같은 에이전트 클라이언트 와이어의 세밀한 호환, (3) 트레이스→시뮬레이션→라우터 루프입니다.
9. 평가 방법 제안
| 평가 축 | 방법 | 통과 기준 예시 |
|---|---|---|
| 호환성 | 사용 중인 SDK·에이전트(Codex CLI, Claude Code, 자체 앱)를 base_url만 바꿔 연결, 툴 호출·스트리밍·캐싱 경로 확인 |
툴 콜이 필요한 별칭은 --supports-tools --supports-streaming-tool-arguments로 생성(미설정 시 툴 요청 전부 거부) |
| 지연 | 직접 호출 대비 TTFB 차이를 동시성 1/16/64에서 측정 | 문서상 저동시성 추가 TTFB 약 20 ms 수준 재현 여부 |
| 처리량 | 짧은 요청 req/s 래더 | 프로세스당 30~50 req/s 상한을 전제로 프로세스 수 산정 |
| 회계 정확성 | 공급자 청구서와 /usage.json 대조, 재시도·폴백·취소 시나리오 포함 |
이중 과금·누락 0건 |
| 장애 동작 | 업스트림 429/5xx, 스트림 중단, 잘린 툴 인자 주입 | 페일오버 규칙(failover_only_on)대로 동작, 커밋 후 모델 전환 없음 |
| 라우터 가치 | held-out 트레이스로 라우터 vs 단일 최강 모델 비교 | 품질 저하 허용폭 안에서 비용 절감이 유의미한지 |
10. 한계와 보안 고려 사항
| 항목 | 내용 | 대응 |
|---|---|---|
| 텔레메트리 기본 켜짐 | 익명 집계 PostHog. 프롬프트·트레이스·모델명·자격 증명은 포함하지 않는다고 명시 | 사내 정책상 필요하면 exp config telemetry disable |
| 본문 캡처 기본 켜짐 | 로컬 traffic.db에 요청 내용 저장(실측 확인) |
민감 업무는 --ghost, 디스크 암호화·보존 기간 관리 |
exp capture |
mitmproxy 포크 + macOS Network Extension + 신뢰 CA 설치. 실험적이며 인증서 피닝 우회는 하지 않음 | 회사 단말에선 보안팀 승인 후, 이름 제약 CA 범위 확인 |
| 호스티드 설정 프롬프트 | SETUP.md는 코딩 에이전트에 붙여 넣는 프롬프트로 이메일 즉시 가입·BYOK 연결을 진행하며, BYOK 프롬프트는 에이전트가 로컬에서 내 공급자 키를 찾도록 요청 |
붙여 넣기 전 전문을 읽고, 키 탐색 범위를 직접 지정하거나 수동으로 등록 |
| 이그레스 | 독립 실행은 로컬·사설 업스트림 허용(기본값) | 고객 엔드포인트를 받는 멀티테넌트 배포라면 public_upstreams_only=True 필수, Python 콜백 측 HTTP는 별도 통제 필요 |
| 처리량 상한 | SQLite fsync 원장이 req/s 상한 | 프로세스 샤딩, 짧은 고빈도 요청은 별도 경로 |
| 라이브 검증 범위 | 공급자별 라이브 셀은 Not run, Tinker 실학습·품질 향상 주장 없음 | 도입 전 자체 라이브 스모크와 비용 대조 |
| 변경 속도 | 하루에 여러 릴리스, 의존성은 정확한 버전 고정 | 운영 환경은 버전 고정 후 주기적 업그레이드 |
| 업스트림 호환 요구 | 업스트림에 항상 스트리밍+usage로 요청(실측) | 자체 OpenAI 호환 서버(vLLM 등)는 stream_options.include_usage 지원 확인 |
11. 누가 쓰면 좋을까
- 코딩 에이전트를 팀 단위로 굴리는 조직: Codex·Claude Code·Cursor를 한 게이트웨이로 모으고, 사람·에이전트별 월 예산과 grant를 걸고 싶다면 바로 가치가 있습니다.
- “어느 모델을 쓸지”를 데이터로 결정하고 싶은 플랫폼 팀: 트레이스를 이미 OTel·Langfuse 등으로 모으고 있다면
exp build로 시뮬레이션 기반 라우터 실험을 해 볼 만합니다. 다만 결과의 품질 주장은 직접 검증해야 합니다. - 회계 정확성이 중요한 사내 AI 게이트웨이 운영자: nano-USD 정수 원장, 재시도·폴백·크래시에도 이중 과금 없는 설계는 FinOps 관점에서 매력적입니다.
- 맞지 않는 경우: 초당 수백 건의 짧은 요청을 단일 노드로 받아야 하거나, 이미 LiteLLM 생태계(플러그인·대시보드)에 깊게 묶여 있고 라우터 학습이 필요 없다면 전환 이득이 크지 않을 수 있습니다.
정리하면 Experiential은 “또 하나의 LLM 프록시”라기보다, 정확한 회계를 갖춘 Rust 게이트웨이를 입구로 삼아 운영 트래픽을 최적화 루프로 끌어들이려는 프로젝트입니다. 게이트웨이 부분은 오늘 박스에서 확인했듯 이미 꽤 단단하고, 시뮬레이션·라우터·SFT 부분은 배관은 갖췄지만 성과는 각자의 데이터로 증명해야 하는 단계입니다. 도입을 검토하신다면 release-scope.md부터 읽고, 위 평가 표대로 하루짜리 스모크를 돌려 보시길 권합니다.