형님 회사에 이런 일이 생겼다고 상상해 보세요. 홍보물에 쓸 효과음 10개, 새 카페 로고, 욕실 리모델링 도면을 외주로 맡기려고 프리랜서 사이트를 둘러보던 중에 누군가 이렇게 말합니다. “요즘은 이런 거 AI한테 시키면 10건 중 4건은 그냥 납품 가능한 수준으로 나온대.”
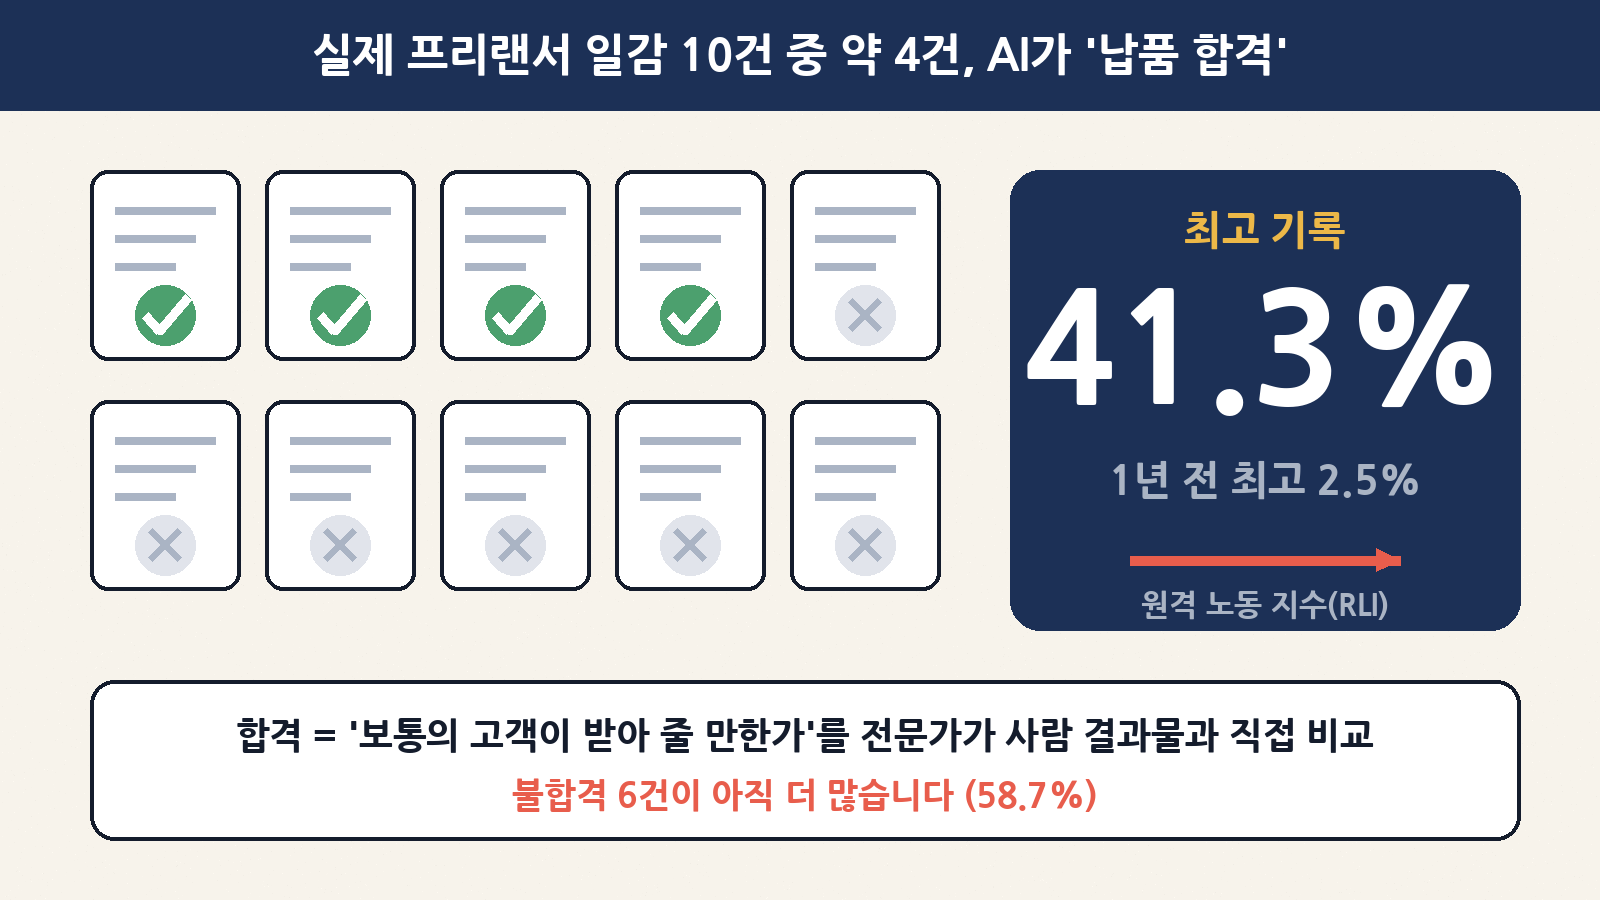
과장 같지만 실제로 나온 숫자입니다. 미국 AI 안전센터(CAIS)와 스케일 AI(Scale AI, 스케일 랩스)가 운영하는 시험 ‘원격 노동 지수(RLI·Remote Labor Index)’의 최신 순위표에서, 앤트로픽의 클로드 페이블 5.2가 자동화율 41.3%로 1위에 올랐습니다. 이 시험이 처음 공개된 2025년 당시 최고 기록은 2.5%였습니다. AI타임스가 11월 12일 이 소식을 전했고, 해외 IT 매체들도 “1년 새 16배”라며 크게 다뤘습니다.
오늘은 이 숫자가 정확히 무엇을 셌는지, 왜 다른 AI 점수와 다른지, 그리고 “일자리 41%가 사라진다는 뜻인가?”라는 오해를 어떻게 풀어야 하는지 차근차근 정리해 보겠습니다.
1. 한눈에 보는 오늘의 소식
| 항목 | 내용 |
|---|---|
| 시험 이름 | 원격 노동 지수(RLI, Remote Labor Index) |
| 만든 곳 | AI 안전센터(CAIS) + 스케일 AI(스케일 랩스) |
| 무엇을 재나 | 실제 프리랜서 일감을 AI가 처음부터 끝까지 해서, 고객이 받아 줄 수준으로 납품하는 비율 |
| 현재 1위 | 클로드 페이블 5.2 — 41.30% |
| 2·3위 | 클로드 오퍼스 5.5 21.25%, GPT-6 아스트라 20.83% |
| 1년 전 1위 | 마누스(Manus) — 2.5% |
| 핵심 주의점 | 41.3%는 “시험 문제 중 합격한 비율”이지 “일자리 감소율”이 아님 |
2. 원격 노동 지수(RLI)가 뭔가요? “AI 수능”이 아니라 “AI 납품 시험”
지금까지 우리가 뉴스에서 본 AI 점수는 대부분 문제 풀이였습니다. 수학 문제를 몇 개 맞혔는지, 코드 문제를 몇 개 통과했는지 같은 것이죠. 비유하면 요리사 필기시험입니다. 칼 쓰는 법, 불 조절 이론을 잘 알면 점수가 높습니다.
RLI는 다릅니다. 실제 손님이 주문한 요리를 끝까지 만들어 내놓고, 손님이 “이 정도면 돈 내겠다” 하는지를 봅니다. 그래서 문제도 시험용으로 만든 게 아니라, 프리랜서 플랫폼 업워크(Upwork)에서 실제 전문가가 돈을 받고 끝낸 일감을 모았습니다.
| 구분 | 보통의 AI 시험(벤치마크) | 원격 노동 지수(RLI) |
|---|---|---|
| 비유 | 요리사 필기시험 | 실제 손님 주문 요리 |
| 문제 출처 | 연구자가 만든 문제 | 업워크 실제 일감(프리랜서 358명) |
| 결과물 | 정답 하나, 짧은 답 | 문서·음성·영상·3D 모델·CAD 파일 등 여러 파일 |
| 채점 | 자동 채점이 많음 | 훈련받은 전문가가 직접 파일을 열어 비교 |
| 합격 기준 | 정답과 일치 | “보통의 고객이 받아 줄 만한가” |
3. 시험은 어떻게 치르나요? 4단계로 보기
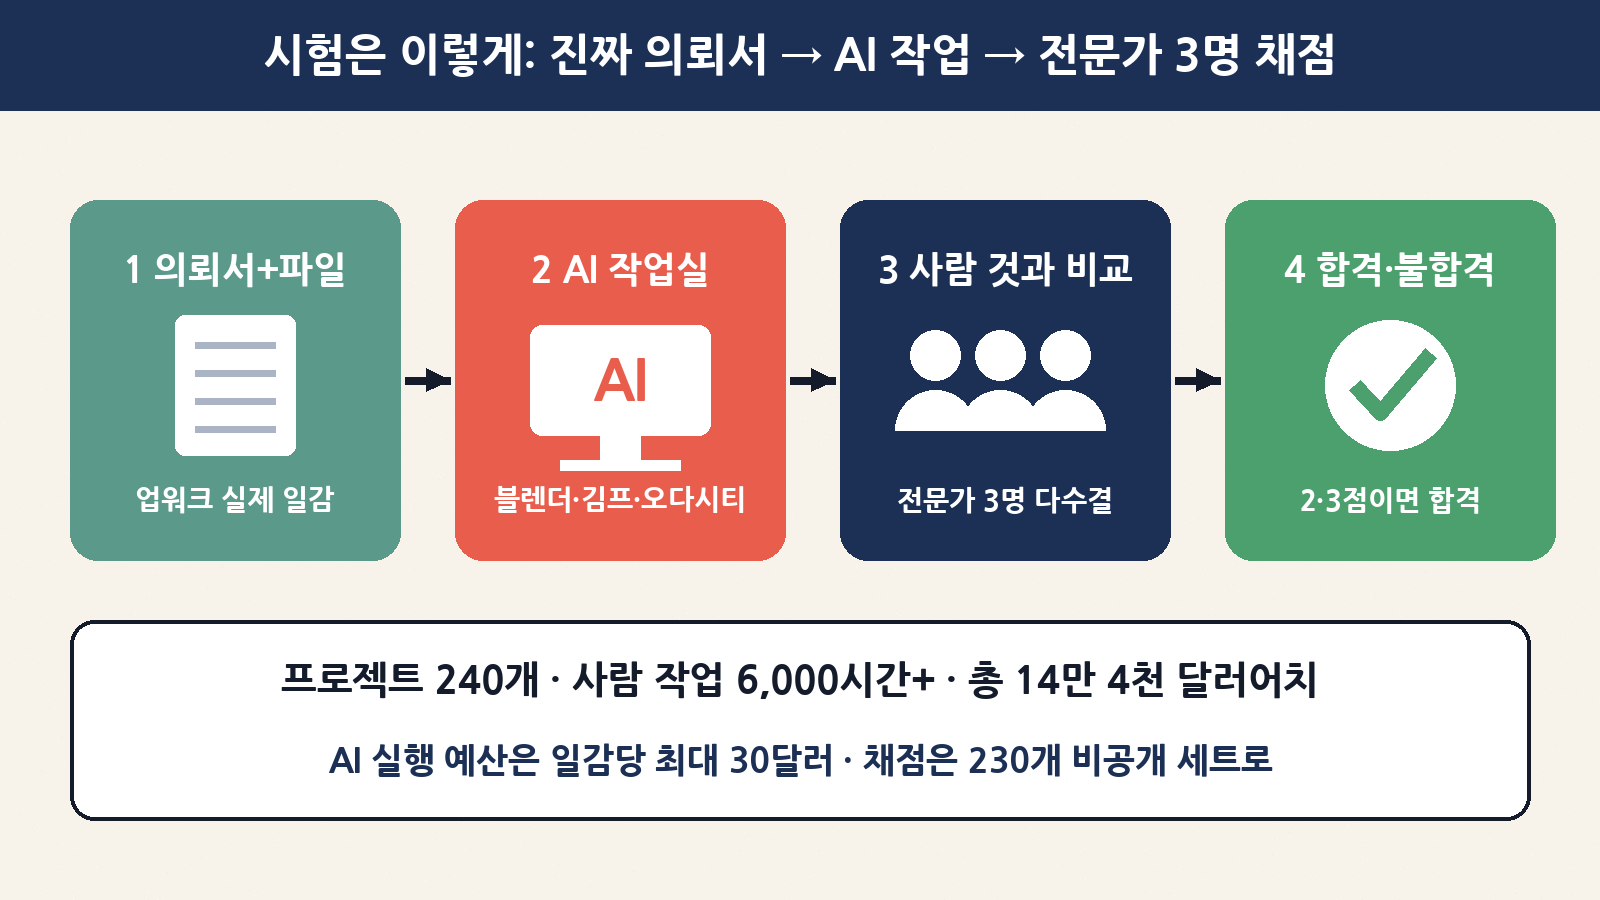
스케일 랩스가 공개한 방법을 쉬운 말로 풀면 이렇습니다.
| 단계 | 무슨 일이 일어나나 | 일상 비유 |
|---|---|---|
| 1. 의뢰서 받기 | 일감 설명서(브리프)와 필요한 원본 파일을 AI에게 줌 | 인테리어 업체가 집 평면도와 요청서를 받음 |
| 2. 작업하기 | 가상 작업실에서 블렌더·김프·오다시티 같은 전문 프로그램과 이미지·음성·영상 생성 도구를 씀. 일감당 실행 예산은 최대 30달러 | 업체가 정해진 재료비 안에서 시공 |
| 3. 비교 채점 | 전문가가 AI 결과물과 실제 프리랜서 결과물을 나란히 놓고 비교, 3명 다수결 | 감리사 3명이 견본 주택과 비교 |
| 4. 합격 판정 | 1점(미달)·2점(기준 충족)·3점(기준 초과) 중 2·3점이면 합격 | “이 정도면 잔금 치르겠다” |
재미있는 점은 채점을 사람이 직접 한다는 것입니다. 3D 모델, 영상, 설계 파일은 겉보기엔 그럴싸해도 열어 보면 깨져 있는 경우가 많아서입니다. 해외 매체 더 디코더(The Decoder)에 따르면, CAIS가 이 채점을 다른 AI에게 맡겨 보려 했지만 AI 채점관은 겉만 번지르르한 결과물에 속아 점수를 너무 후하게 줬다고 합니다. 사람 채점관끼리의 일치율은 94.4%로 공개돼 있습니다.
4. 시험지는 얼마나 “진짜”인가요? 숫자로 보는 RLI
| 항목 | 숫자 | 쉽게 말하면 |
|---|---|---|
| 전체 프로젝트 | 240개 (처음 모은 550개에서 걸러 냄) | 품질 미달·재현 불가 일감은 뺐음 |
| 순위 채점용 | 230개 비공개 + 10개 공개 | 시험지 유출(학습 오염)을 막으려 대부분 비공개 |
| 참여 프리랜서 | 358명, 업워크 23개 분야 | 게임 개발, 제품 디자인, 건축, 데이터 분석, 영상 애니메이션 등 |
| 전체 작업량 | 6,000시간 이상 | 한 사람이 하루 8시간씩 2년 넘게 해야 하는 양 |
| 총 금액 | 143,991달러(약 14만 4천 달러) | 실제로 사람에게 지급된 돈 기준 |
| 일감 평균 가격 | 632.60달러 (중앙값 200달러) | 소수의 비싼 일감이 평균을 끌어올림 |
| 사람 평균 작업 시간 | 28.9시간 (중앙값 11.5시간) | 일부는 100시간 이상, 1만 달러 이상짜리도 있음 |
여기서 하나 눈여겨볼 점은 평균과 중앙값의 차이입니다. 평균 가격은 632달러인데 중앙값은 200달러죠. 반 학생 10명 중 한 명이 용돈을 엄청 많이 받으면 “평균 용돈”이 확 올라가는 것과 같습니다. “보통의 일감”은 200달러, 11시간 남짓 걸리는 일이라고 보는 편이 실감에 가깝습니다.
5. 순위표 읽기: 1위가 2위의 거의 2배
| 순위 | AI 모델(스케일 표기) | 자동화율 | 한 줄 해석 |
|---|---|---|---|
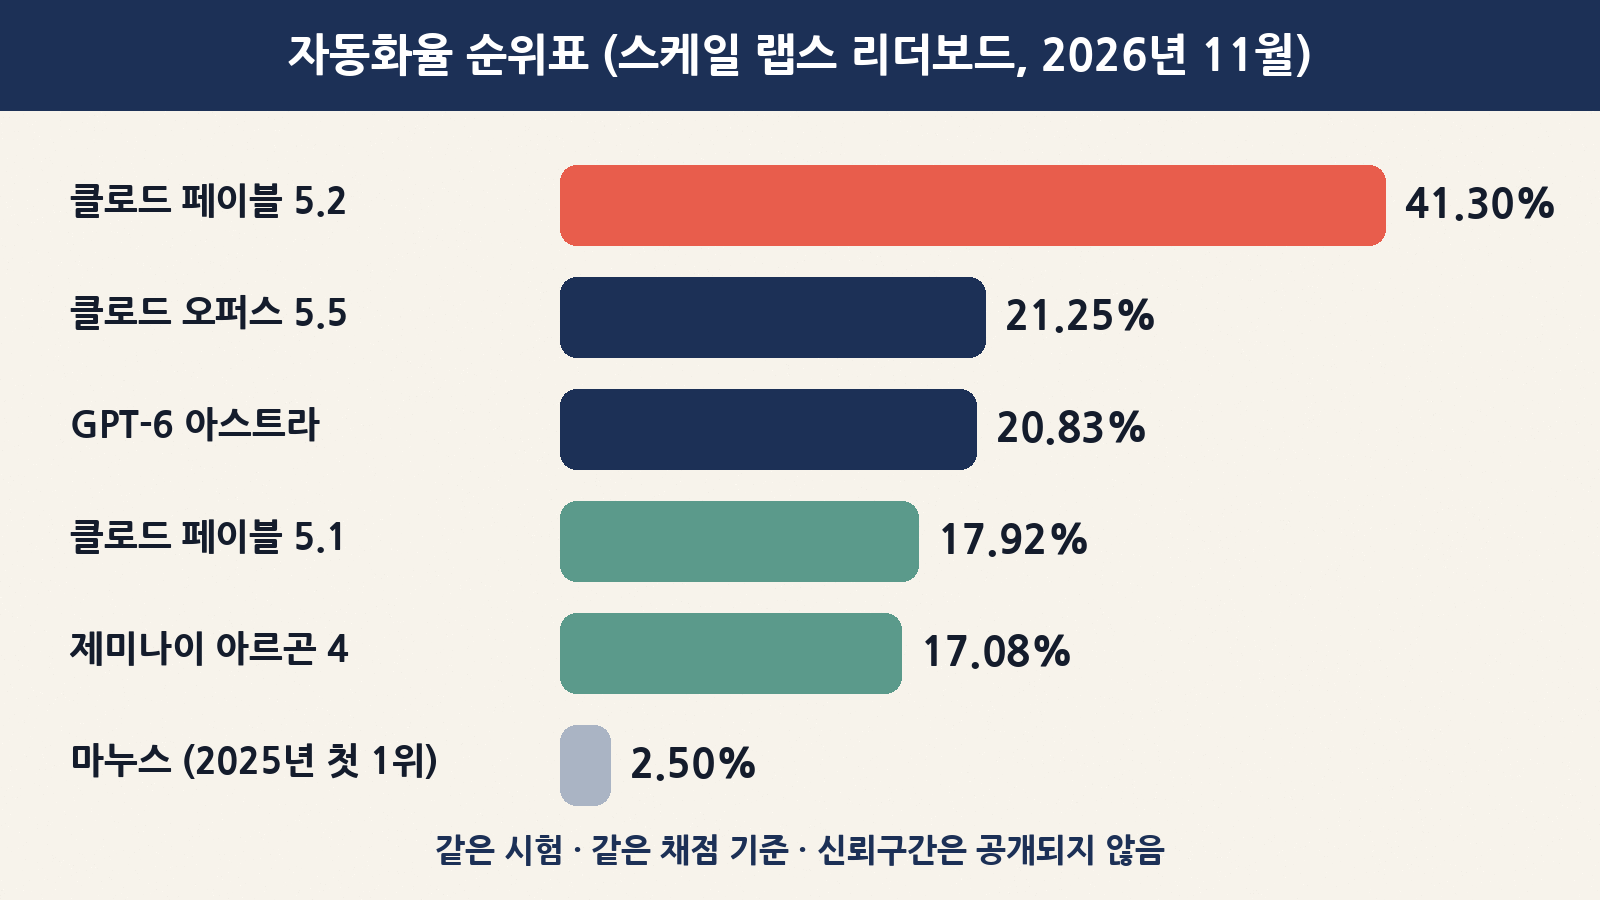
| 1 | 페이블 5.2 (앤트로픽) | 41.30% | 230개 중 약 95개 합격 꼴 |
| 2 | 오퍼스 5.5 (앤트로픽) | 21.25% | 1위의 약 절반 |
| 3 | GPT 6 아스트라 (오픈AI) | 20.83% | 2위와 거의 비슷 |
| 4 | 페이블 5.1 (앤트로픽) | 17.92% | 바로 전 세대, 5.2가 2배 이상 |
| 5 | 제미나이 아르곤 4 (구글) | 17.08% | 구글 모델 중 최고 |
| 6 | 페이블 5 (앤트로픽) | 15.83% | 7월 무렵 1위였던 기록 |
| 참고 | 마누스 1.0 (2025년 첫 공개 당시 1위) | 2.50% | 1년 전 출발점 |
“약 95개”는 41.30%에 230을 곱해 본 어림셈입니다(230 × 0.413 ≈ 95). 또 스케일은 자동화율에는 신뢰구간(오차 범위)이 없다고 밝혀 두었습니다. 그러니 21.25%와 20.83%처럼 1%p도 안 되는 차이는 “거의 비슷하다” 정도로만 읽는 게 안전합니다.
6. “1년 새 2.5% → 41.3%”는 얼마나 빠른 걸까?
| 시점 | 최고 기록 | 무엇이 있었나 |
|---|---|---|
| 2025년 첫 공개 | 2.5% (마누스) | “AI는 실무 납품을 거의 못 한다”는 결론 |
| 2026년 7월 무렵 | 약 16% (페이블 5) | 8개월 새 4배 이상 (더 디코더 집계) |
| 2026년 11월 | 41.3% (페이블 5.2) | 4개월 만에 다시 약 2.5배 |
RLI 공식 사이트는 최근 추세를 “약 3.3개월마다 2배”로 표시합니다. 다만 이건 지금까지의 속도를 선으로 이어 본 것일 뿐, 앞으로도 똑같이 2배씩 오른다는 약속은 아닙니다. 50%, 70%로 갈수록 남은 일감이 더 어렵기 때문에 속도가 느려질 수도 있습니다. 시험 점수가 30점에서 60점 되는 것보다 90점에서 95점 되는 게 더 어려운 것과 비슷합니다.
7. AI가 잘하게 된 일, 아직 못 하는 일
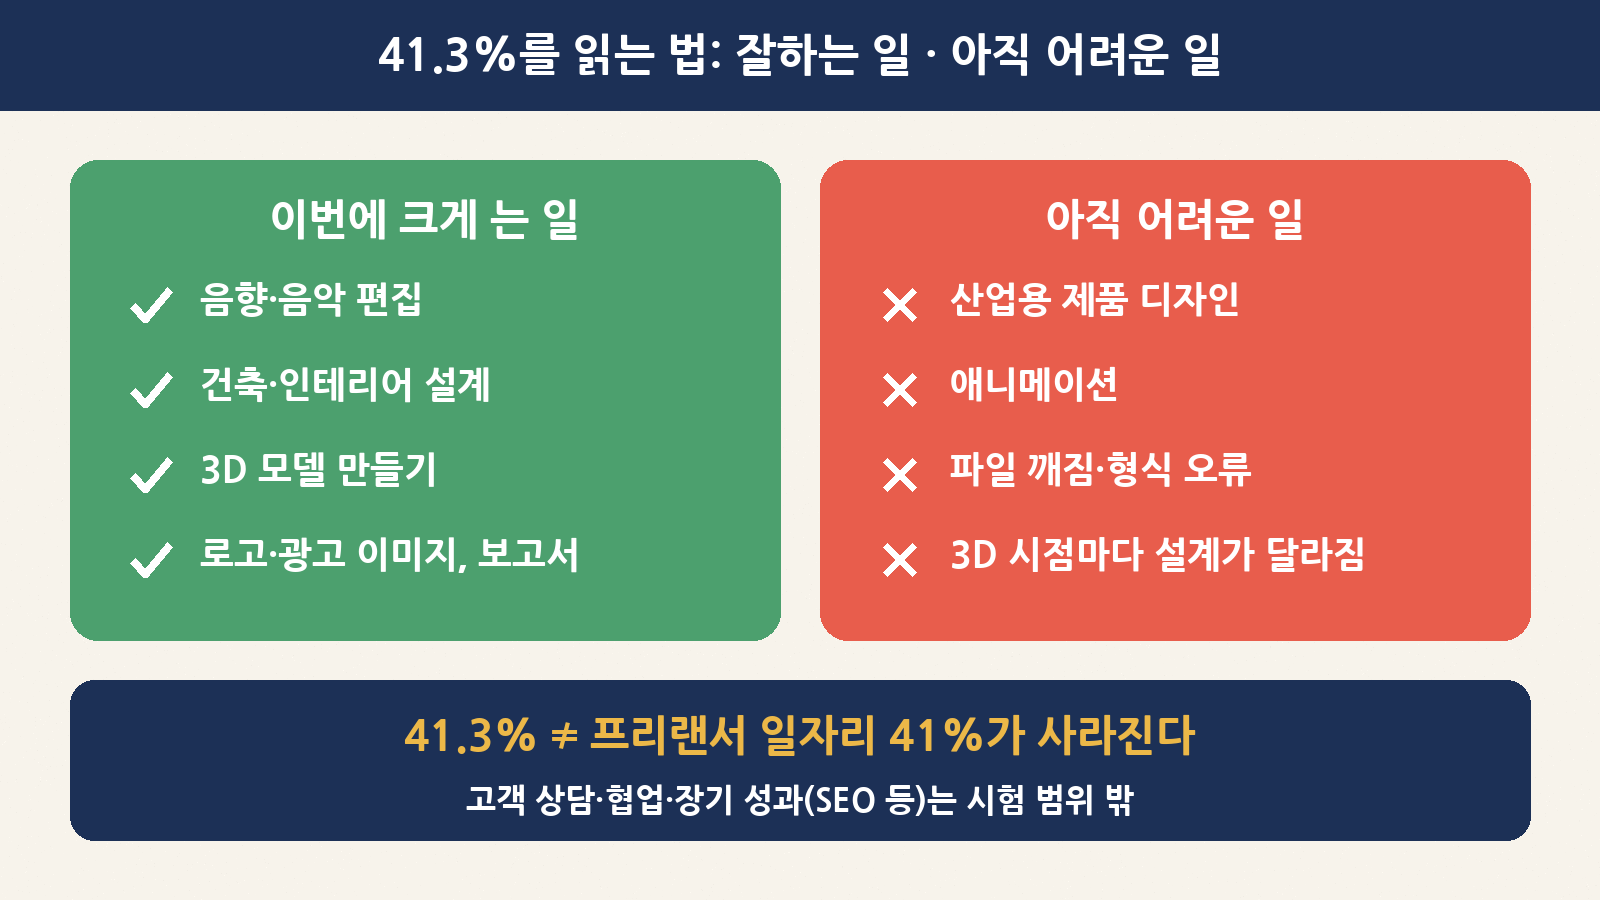
스케일 랩스는 페이블 5.2가 특히 음향·음악 편집, 건축·인테리어 설계, 3D 모델 제작에서 크게 늘었다고 밝혔습니다. 페이블 5.2가 합격한 일감 중 약 50건은 이전에 어떤 AI도 통과하지 못했던 일이었다고 합니다. 반대로 산업용 제품 디자인과 애니메이션은 여전히 거의 못 한다고 했습니다.
| 구분 | 예시 | 형님이 떠올릴 상황 |
|---|---|---|
| 원래 강했던 일 (첫 공개 때부터) | 효과음, 보컬 분리, 로고·광고 이미지, 보고서 작성, 자료 찾기 | 유튜브 영상 효과음, 동네 가게 전단 시안, 시장 조사 요약 |
| 이번에 크게 는 일 | 음향·음악 편집, 건축·인테리어 설계, 3D 모델 | 욕실 리모델링 평면도와 렌더링, 쇼핑몰 제품 3D 이미지 |
| 아직 어려운 일 | 산업용 제품 디자인, 애니메이션 | 실제 생산할 가전 외형 설계, 캐릭터가 움직이는 홍보 영상 |
8. 떨어질 때는 왜 떨어지나요? 실패 유형 4가지
RLI를 처음 공개할 때(2025년, 당시 모델 기준) 연구진은 불합격 사례를 분석해 실패 이유를 정리했습니다. 최신 모델에 그대로 들어맞는 비율은 아니지만, AI 결과물을 받았을 때 어디를 확인해야 하는지 알려 주는 좋은 체크리스트입니다. (한 일감이 여러 이유에 겹칠 수 있어 합이 100%를 넘습니다.)
| 실패 유형 | 비율(첫 공개 분석) | 예시 | 내가 확인할 것 |
|---|---|---|---|
| 품질 미달 | 45.6% | “어린아이가 그린 듯한” 그림·3D·코드 | 전문가 결과물과 나란히 비교 |
| 미완성 | 35.7% | 잘린 영상, 빠진 파일, 반쯤 한 작업 | 요청한 파일 목록과 하나씩 대조 |
| 파일·기술 문제 | 17.6% | 깨지거나 빈 파일, 잘못된 형식 | 직접 열어 보기, 요구 형식(PSD·DWG 등) 확인 |
| 앞뒤 안 맞음 | 14.8% | 3D 시점마다 집 설계가 바뀜 | 여러 장면·페이지의 일관성 확인 |
9. “41.3%면 프리랜서 일자리 41%가 사라지나요?” — 아닙니다
AI타임스도 분명히 짚었듯이, 41.3%는 이 시험의 일감 중 AI 결과물이 사람과 같거나 더 낫다고 인정받은 비율입니다. 일자리 통계가 아닙니다. 그렇게 읽으면 안 되는 이유를 정리하면 이렇습니다.
| 오해 | 실제 |
|---|---|
| “프리랜서 일의 41%를 AI가 대체” | 시험에 들어간 230개 일감 중 합격 비율일 뿐 |
| “모든 직종에 해당” | 고객 상담·과외처럼 사람과 직접 소통하는 일, 몸을 쓰는 일, SEO처럼 오래 지켜봐야 하는 일은 애초에 제외 |
| “AI 혼자 다 한다” | 실제 일에는 요구 사항 협의, 수정 요청, 팀 협업이 있는데 이 시험은 그 부분을 재지 않음 |
| “41%면 거의 절반 성공” | 뒤집으면 58.7%는 아직 고객이 안 받아 줄 결과 |
| “내가 쓰는 챗봇도 똑같이 한다” | 시험은 전문 프로그램이 깔린 작업실, 일감당 최대 30달러 예산 등 정해진 환경에서 치름 |
10. 그럼 나는 어떻게 써먹을까? 일상 활용 팁
이 시험 결과에서 우리가 가져갈 실용적인 교훈은 “AI에게 끝까지 맡겨 볼 만한 일이 생각보다 늘었다, 하지만 검수는 여전히 사람 몫”입니다.
| 상황 | AI에게 맡겨 볼 것 | 꼭 내가 볼 것 |
|---|---|---|
| 동네 가게 사장님 | 로고 시안 여러 개, 전단 문구, 메뉴판 초안 | 글자 오타, 가격·전화번호, 다른 브랜드와 비슷한지 |
| 유튜브·SNS 운영 | 효과음, 배경 음악 편집, 썸네일 시안 | 저작권·라이선스 조건, 영상 길이와 끊김 |
| 집 리모델링 고민 | 평면 배치 아이디어, 분위기 렌더링 | 실제 치수, 배관·전기 위치는 시공 전문가에게 확인 |
| 회사 보고서 | 자료 조사 요약, 초안 작성 | 숫자 출처·날짜, 회사 내부 자료 넣어도 되는지 |
| 외주 맡기는 담당자 | “AI로 1차 시안 → 사람이 다듬기” 구조 검토 | 파일 형식, 여러 파일 사이의 일관성(위 실패 유형 4가지) |
11. 3줄 요약
- 원격 노동 지수(RLI)는 업워크 실제 일감 240개로 “AI가 고객이 받아 줄 수준으로 납품하나”를 사람이 직접 채점하는 시험입니다.
- 최신 1위는 클로드 페이블 5.2의 41.3%로, 1년 전 최고 2.5%에서 크게 뛰었고 2위(21.25%)의 약 2배입니다.
- 하지만 일자리 41% 감소라는 뜻은 아니며, 소통·협업·장기 성과는 시험 밖이고 58.7%는 여전히 불합격입니다. AI 결과물은 “파일 목록·형식·일관성·품질” 네 가지를 꼭 직접 확인하세요.
AI가 “문제를 잘 푸는 학생”에서 “일을 맡길 만한 동료”로 옮겨 가는 중이라는 신호로 읽으시면 딱 좋겠습니다. 다만 동료에게 일을 맡겨도 마지막 검수는 내가 하듯, AI도 마찬가지입니다.