테크부터 경제, 생활까지. 복잡한 소식을 쉽게 풀어봅니다.
오늘(11월 17일) 깃허브 트렌딩 전체·Python 일간 목록 상단에 mvanhorn/last30days-skill이 다시 올라왔습니다. 스타 68,393개(11/17 오후 기준), 포크 6,084개, 전날(11/16) v4.3.0 릴리스, 오늘 오전 README 개편 커밋(9cee917)까지 이어졌습니다. 겉으로 보면 “Reddit·X·YouTube·HN·Polymarket을 한 번에 뒤져 최근 30일 요약을 만들어 주는 Claude Code 스킬”입니다. 그런데 코드를 열어 보면 정체는 호스트 LLM과 계약을 맺는 증거 수집·랭킹 엔진에 가깝습니다. 런타임 의존성이 0개인 파이썬 엔진이 8만 줄 넘게 깔려 있고, 그 위에 SKILL.md라는 프롬프트 계약이 얹혀 있습니다. 이 글은 실무자 눈높이에서 구조, 점수 공식, 설계 트레이드오프, 박스 실측, 도입 판단 기준까지 정리합니다.
1. 한눈에 보는 프로젝트 카드
| 항목 | 내용 (2026-11-17 확인) |
|---|---|
| 저장소 | github.com/mvanhorn/last30days-skill |
| 최신 릴리스 | v4.3.0 (2026-11-17 08:57 KST 게시, CHANGELOG 표기 2026-11-16) |
| 분석 기준 커밋 | 9cee917 “docs: README shows what v4 does (#1497)” (2026-11-17 11:38 KST) |
| 라이선스 | MIT |
| 스타 / 포크 | 68,393 / 6,084 (생성 2026-01-24 KST) |
| 언어·런타임 | Python 3.12+ (표준 라이브러리만, dependencies = []), X 검색용 Node.js 벤더링 클라이언트, MCP 래퍼는 Go |
| 규모 | 추적 파일 721개, scripts/lib 파이썬 약 82,450줄, 테스트 함수 약 7,768개(360개 파일) |
| 설치 경로 | Claude Code 마켓플레이스, Grok Build CLI, npx skills add(50개 이상 호스트), claude.ai 업로드, Claude Desktop .mcpb, OpenClaw |
| 오늘 트렌딩 | 전체 일간 목록 + Python 일간 목록 동시 진입 |
2. 무엇을 푸는 도구인가: “편집자 대신 사람”이라는 가설
README의 한 줄 요약은 “Google aggregates editors. /last30days searches people.”입니다. 검색 엔진이 SEO와 편집 매체를 모아 준다면, 이 도구는 업보트·좋아요·조회수·예측시장 베팅액처럼 사람들이 실제로 행동으로 남긴 신호를 모아 점수화하겠다는 것입니다. 사용 예로는 미팅 전 인물 파악(/last30days Peter Steinberger), 회사 동향(/last30days Apple), 도구 비교(OpenClaw vs Hermes vs Paperclip), 주제 없는 트렌드 발굴(what's exploding in AI agents?)을 듭니다.
핵심은 “어떤 단일 AI도 이 소스 전부에 접근하지 못한다”는 문제 인식입니다. 각 플랫폼이 자체 API·토큰·인증을 가진 담장 안 정원이니, 사용자가 키와 브라우저 세션을 가져오면 에이전트가 이를 이어 붙인다는 발상입니다. 그래서 이 프로젝트의 가치 대부분은 LLM 쪽보다 소스 어댑터, 정규화, 랭킹, 실패 처리에 있습니다.
지원 소스와 요구 조건
| 소스 | 기본 상태 | 필요한 것 | 신호 종류 |
|---|---|---|---|
| 기본 on | 없음(키리스). 동의 시 로그인 세션 | 업보트, 상위 댓글 | |
| Hacker News | 기본 on | 없음 | 포인트, 댓글 |
| Polymarket | 기본 on | 없음 | 배당·거래량, 변동폭 |
| GitHub | 기본 on | 없음(토큰 있으면 레이트리밋 완화) | 이슈·PR, 릴리스, 인물 PR 속도 |
| X / Twitter | 설정 필요 | 브라우저 쿠키(동의), X API bearer, xAI 등 | 좋아요, 리포스트 |
| YouTube | 설정 필요 | yt-dlp |
조회수, 자막 전문 |
| TikTok / Instagram | 설정 필요 | ScrapeCreators 키 | 조회수, 캡션·음성 자막 |
| arXiv / Techmeme / Digg / Yahoo Finance | CLI 설치 시 자동 | printing-press 계열 CLI | 논문, 편집 레이어, 스토리 점수, 주가 |
| Patents / Jobs | 회사 주제일 때 자동 | 없음 | USPTO 출원, 채용 페이지 “비밀 신호” |
| 로컬 코퍼스 | 옵트인 | --corpus, PDF는 pdftotext |
내 문서 |
3. 아키텍처: Skill = 프롬프트 계약 + 엔진
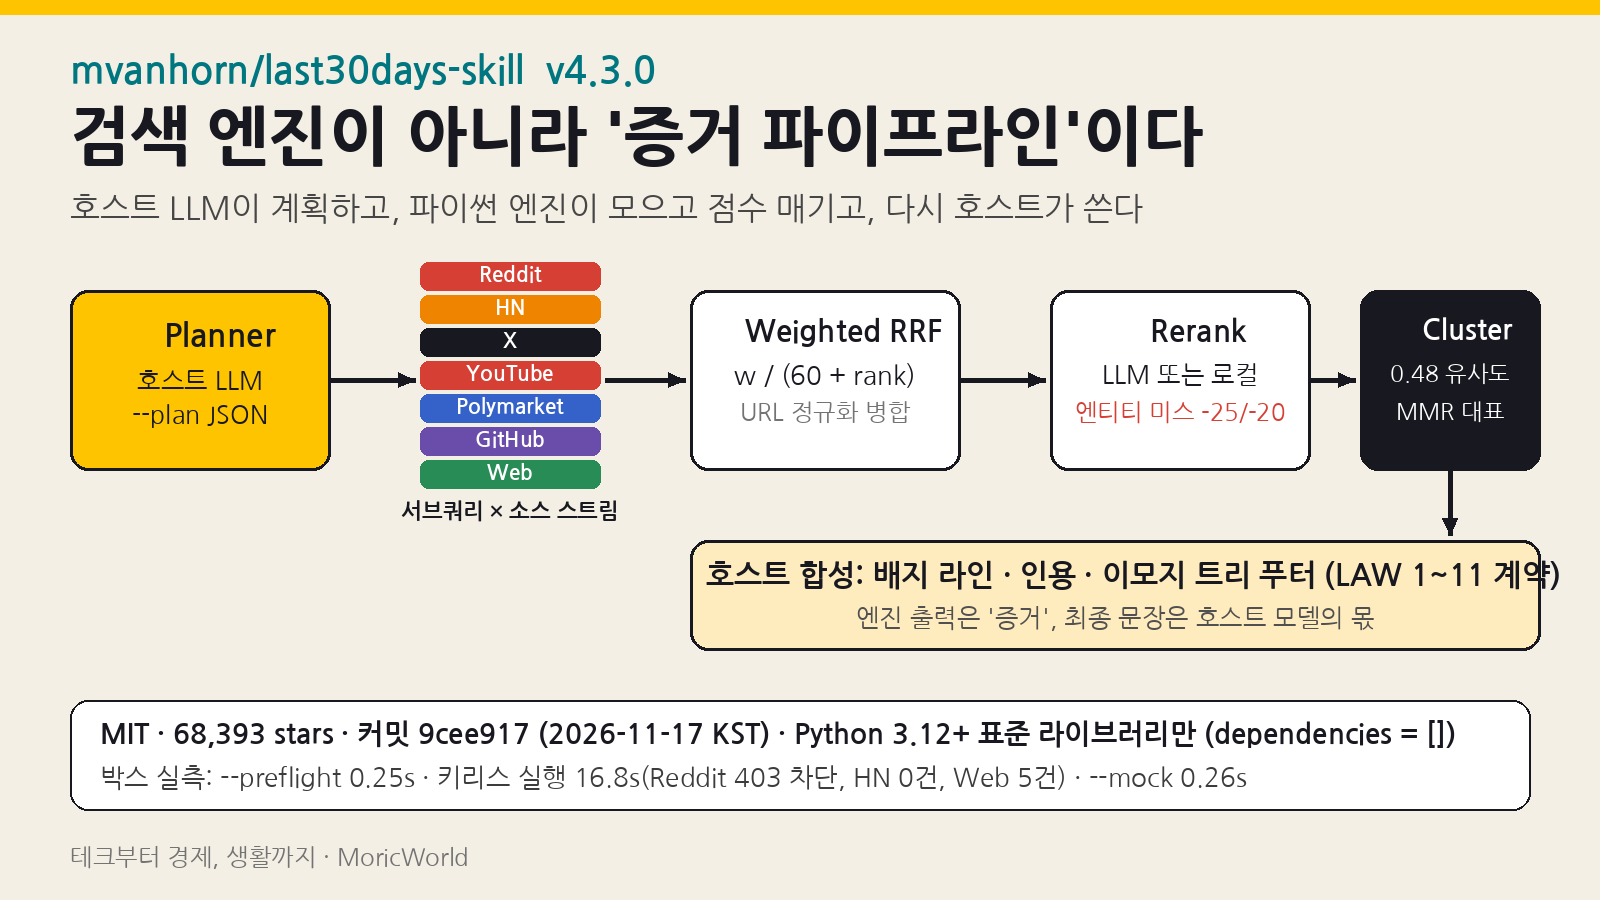
CONCEPTS.md가 용어를 정확히 정의해 둔 점이 인상적입니다. Skill은 SKILL.md(에이전트에게 주는 산문 계약)와 scripts/(실행 코드)의 묶음이고, Engine은 scripts/last30days.py입니다. 둘 사이 계약은 이렇습니다. SKILL.md는 모델에게 어떤 플래그(--plan, --x-handle, --subreddits, --emit=compact 등)를 넘길지 알려 주고, 엔진은 정해진 출력 모양(배지 라인, 랭킹된 증거 클러스터, 이모지 트리 푸터)을 내놓습니다. 모델은 그 출력을 계약대로 전달해야 합니다.
저장소 구조
| 경로 | 역할 |
|---|---|
skills/last30days/SKILL.md |
262줄 런타임 계약. LAW 1~11(인라인 인용, 대시 금지, 본문 헤더 금지, 푸터 패스스루, “네가 플래너다” 등) |
skills/last30days/references/ |
17개 세부 런북: research-runbook, comparison, discovery, synthesis, grok-bot-x, patent-signals 등 |
scripts/last30days.py |
CLI 진입점(5,204줄). 플래그 파싱, 설정 로드, 렌더 모드 |
scripts/lib/pipeline.py |
오케스트레이션 핵심(7,902줄). 소스 가용성, 스트림 팬아웃, 디스커버리 3단 프로토콜 |
scripts/lib/planner.py |
LLM 우선 계획 + 위험 쿼리용 결정적 가드 |
scripts/lib/fusion.py / rerank.py / cluster.py |
가중 RRF 병합, 점수화·감점, 유사도 클러스터링 |
scripts/lib/reddit_*.py 등 소스 어댑터 |
Reddit만 14개 모듈(키리스, 세션, 아카이브, 하이드레이트 등) |
scripts/lib/vendor/bird-search |
X 검색용 벤더링 Node 클라이언트 |
mcp/ |
Go MCP 서버. 엔진을 embed.FS로 품고 단일 research 툴 노출 |
.claude-plugin, .codex-plugin, .grok-plugin, gemini-extension.json |
호스트별 매니페스트 |
tests/, .github/workflows/ |
pytest 커버리지 바닥 81%, OSV·Scorecard·zizmor 보안 워크플로, Reddit 카나리아 |
파이프라인 5단계
- 계획(Planner): 주제를 intent(breaking_news, product, comparison, concept 등), freshness_mode, 1~4개 서브쿼리로 쪼갭니다. SKILL.md LAW 7은 “
--plan은 고유명사 주제에서 필수, 호스트 모델이 곧 플래너”라고 못 박습니다. 엔진 내부 결정적 플래너는 헤드리스/cron용 폴백입니다. - 팬아웃: 서브쿼리 × 소스마다 독립 스트림을 돌립니다. 상위 실행은 최대 16 워커, 경쟁자 비교 서브런은 4 워커로 제한해 6자 비교에서도 스레드가 약 30개를 넘지 않게 합니다.
- 융합(Weighted RRF): 스트림마다 순위를 매기고, 정규화된 URL로 같은 항목을 병합해
weight / (60 + rank)를 누적합니다. - 재랭킹: 추론 키(Gemini → OpenAI → xAI → OpenRouter 순)가 있으면 LLM이 관련도를 매기고, 없으면 로컬 점수로 대체합니다. 엔티티 그라운딩 감점이 여기서 들어갑니다.
- 클러스터링·렌더: 토큰 유사도 0.48(속보 의도는 0.42) 이상을 묶고 MMR로 대표를 고릅니다. 결과는 compact/json/md/html/brief 중 하나로 나가고, 최종 문장은 호스트 모델이 씁니다.
깊이 프로파일
| depth | per_stream_limit | pool_limit | rerank_limit | Reddit 댓글 보강 슬롯 | 비고 |
|---|---|---|---|---|---|
--quick |
6 | 15 | 12 | 4 | 특허·채용 레인 생략 |
| default | 12 | 40 | 40 | 8 | 회사 주제면 Jobs 레인 on |
--deep |
20 | 60 | 60 | 12 | Digg 스트림 30 |
--max-results, --max-per-source, --max-source-fetches로 덮어쓸 수 있고, 0도 유효한 하한으로 존중하도록 is not None 비교를 씁니다(이슈 #716).
4. 점수 공식: 참여도는 “조율자”일 뿐
이 프로젝트에서 가장 배울 만한 부분은 점수 설계에 붙은 주석입니다. 상수 하나하나에 “왜 이 값인지”와 실제 실패 사례(예: 2026-04-19 “Hermes Agent Use Cases” 실행에서 Hermes 언급이 전혀 없는 영상이 2위에 오른 사건)가 적혀 있습니다.
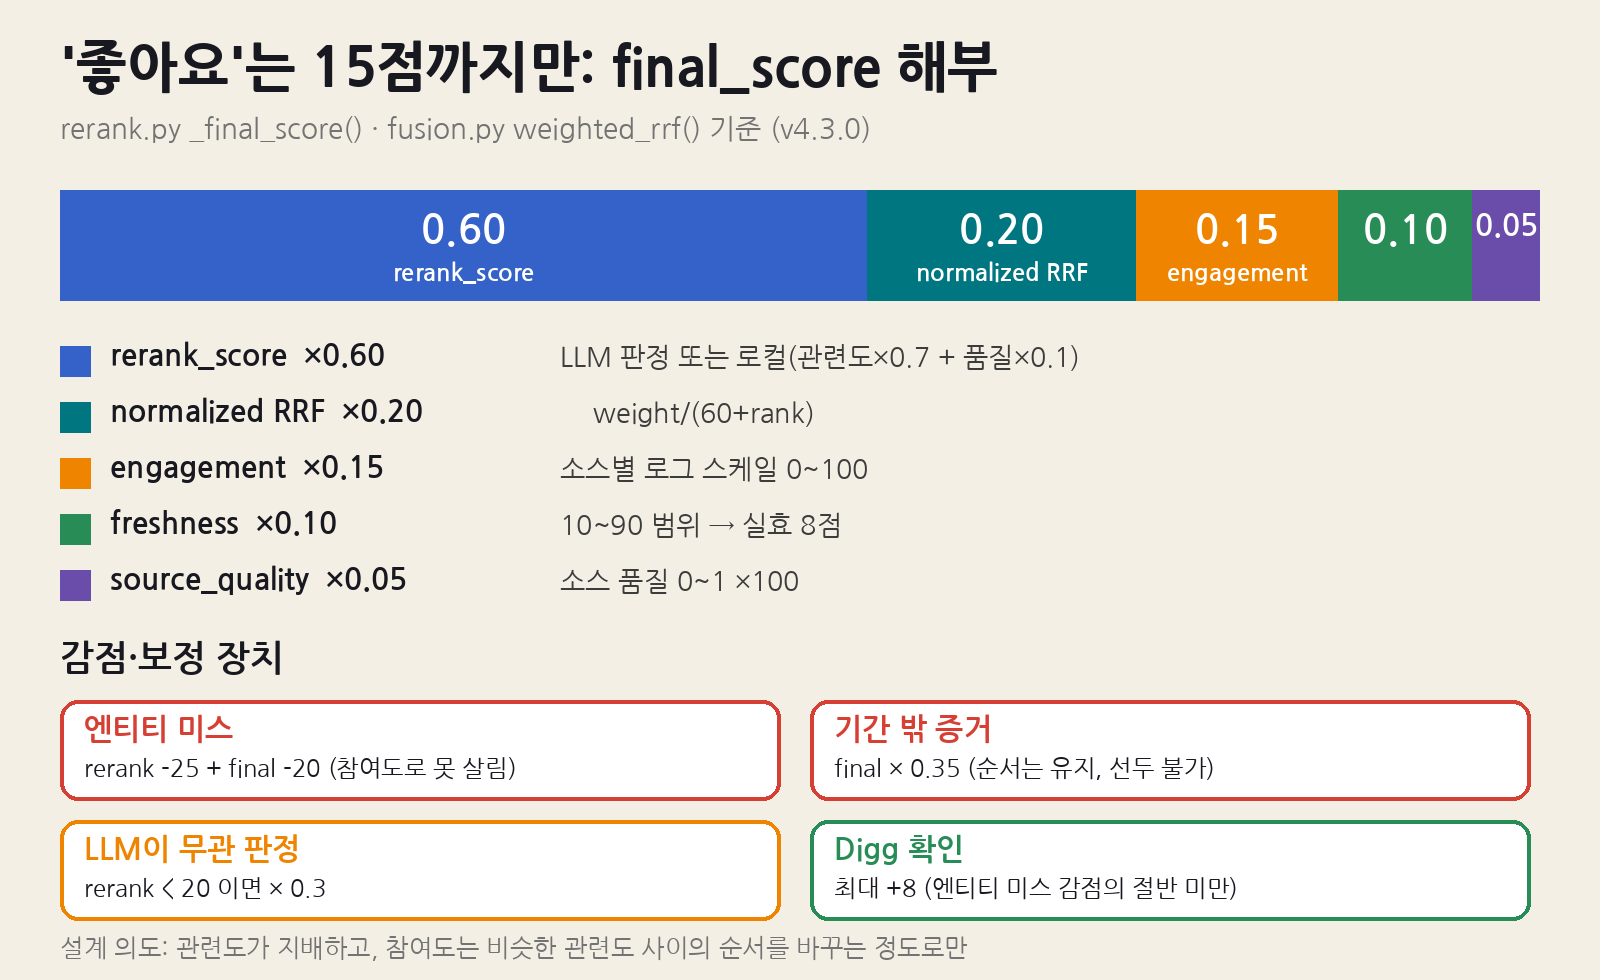
# rerank.py _final_score() 요지 (v4.3.0)
known = 0.60*rerank_score + 0.20*normalized_rrf + 0.10*freshness + 0.05*(source_quality*100)
base  = known + 0.15*engagement(0~100, 소스별 로그 스케일) + digg_bonus(최대 8)
if llm_judged and rerank_score < 20: base *= 0.3      # 판정자가 무관하다고 한 경우만
if "entity-miss" in explanation:      base -= 20        # 2차 감점 (1차는 rerank -25)
if out_of_window:                     base *= 0.35      # 30일 밖 증거는 선두 불가

# 키가 없을 때 로컬 rerank (_fallback_tuple)
score = local_relevance*100*0.7 + source_quality*100*0.1   # freshness는 일부러 제외
| 설계 결정 | 코드 근거 | 의도 / 트레이드오프 |
|---|---|---|
| 엔티티 미스 이중 감점 | ENTITY_MISS_PENALTY=25, ENTITY_MISS_FINAL_PENALTY=20 |
-25가 0.6 가중치를 거치면 -15로 희석되고, 고조회 영상의 참여도 보너스가 이를 상쇄했음. 2차 감점으로 “참여도가 주제 이탈을 구제하지 못하게” 함 |
| 그라운딩은 헤드 토큰 기준 | CONCEPTS “Entity grounding” | 전체 구문을 요구하면 뒤쪽 수식어 때문에 정상 항목이 강등됨. 대신 실패 모드가 “감점 없음” 쪽으로 기울도록 보수적으로 설계 |
| 참여도 상한 15점 | ENGAGEMENT_FINAL_WEIGHT=0.15 |
380점 HN 글과 3점 글의 차(~12점)는 한 달 나이 차(~7점)를 이길 수 있지만, 관련도를 뒤집지는 못함 |
| 신선도는 한 번만 | 폴백 점수에서 freshness 제거 | 이중 반영 시 “오늘 올라온 3점 글이 지난주 380점 글을 이기는” 문제가 있었음 |
| 기간 밖은 곱셈 감쇠 | OUT_OF_WINDOW_FINAL_MULTIPLIER=0.35 |
빼기 대신 곱하기라 오래된 항목끼리의 순서는 유지. “30일” 계약을 깨는 1위는 막음 |
| 참여도 미확정은 평균 대입 | _engagement_pending → known/0.95 |
아카이브 스냅샷뿐인 스레드는 0점이 아니라 “모름”으로 처리 |
| 1인칭 작성자 크레딧 +5 | FIRST_PARTY_AUTHOR_CREDIT |
본인은 자기 이름을 글에 쓰지 않으므로 그라운딩에서 빠지는 문제 보정. 단 작게 줘서 저자만으로 1위가 되지 않게 |
| 표준 RRF 상수 | RRF_K = 60 (Cormack et al. 2009) |
스트림 간 점수 스케일이 달라도 순위만으로 병합. 대신 원래 점수의 크기 정보는 버림 |
5. 설치와 실행
에이전트 호스트에 설치
# Claude Code (권장: 마켓플레이스 자동 업데이트)
/plugin marketplace add mvanhorn/last30days-skill
/plugin install last30days

# Grok Build CLI
grok plugin marketplace add mvanhorn/last30days-skill
grok plugin install last30days

# Codex, Cursor, Copilot, Gemini CLI 등 Agent Skills 호스트
npx skills add mvanhorn/last30days-skill -g
npx skills add mvanhorn/last30days-skill -g -a codex -a cursor   # 특정 호스트 지정
Claude Code는 설치 방식 간 중복 제거를 하지 않으므로 마켓플레이스 플러그인과 npx skills 사본을 같이 켜면 /last30days가 두 번 보입니다. 하나만 쓰는 편이 낫습니다.
엔진 직접 실행 (스크립트·CI용)
git clone https://github.com/mvanhorn/last30days-skill
cd last30days-skill
python3 skills/last30days/scripts/last30days.py --preflight          # 읽기/쓰기/자격증명 요약, 네트워크 없음
python3 skills/last30days/scripts/last30days.py --diagnose           # 소스 가용성
python3 skills/last30days/scripts/last30days.py "AI coding agents" --emit=json
python3 skills/last30days/scripts/last30days.py "AI coding agents" --quick --no-browser-cookies \
  --save-dir ./out --output ./out/brief.md
호스트 플랜 주입 예시
cat > plan.json <<'JSON'
{"intent":"product","freshness_mode":"balanced_recent","cluster_mode":"story",
 "subqueries":[
  {"label":"primary","search_query":"claude code",
   "ranking_query":"What are developers saying about Claude Code in the last month?",
   "sources":["hackernews","reddit","polymarket","github"],"weight":1.0},
  {"label":"skills","search_query":"claude code skills plugin",
   "ranking_query":"Which Claude Code skills and plugins are people discussing?",
   "sources":["hackernews","github"],"weight":0.6}]}
JSON
python3 skills/last30days/scripts/last30days.py "Claude Code" --plan plan.json --emit=compact
런북 규칙상 search_query는 플랫폼 제목처럼 짧은 키워드, ranking_query는 자연어 질문입니다. “last 30 days”, 월 이름, 연도 같은 시간 표현과 “news”, “updates” 같은 메타 표현은 넣지 말라고 합니다. 주 서브쿼리 가중치 1.0, 보조 0.6~0.8, 주변 0.3~0.5가 권장값입니다.
자주 쓰는 플래그
| 플래그 | 용도 |
|---|---|
--emit {compact,json,context,md,html,brief} |
출력 형태. 에이전트·워크플로에는 json(버전 있는 agent 프로필), 원본은 --json-profile=raw |
--search reddit,hackernews |
소스 제한 |
--days N, --as-of YYYY-MM-DD |
창 길이·종료일 변경(과거 시점 재현) |
--discover [DOMAIN], --nominate-only / --judgments / --finalize |
주제 없는 트렌드 발굴, 호스트 판정 3단 프로토콜 |
--competitors [N], --competitors-list |
경쟁자 자동 탐색 후 병렬 서브런 비교 |
--store + scripts/watchlist.py |
SQLite 누적, 정기 실행(Slack·웹훅 알림 옵션) |
--corpus DIR |
로컬 md/txt/pdf를 비공개 소스로 추가(항상 로컬 점수) |
--mock |
픽스처로 전체 경로 실행(테스트·데모) |
--no-browser-cookies, --research-only |
쿠키 읽기 차단, 주제를 관리 명령으로 해석하지 않음(MCP 서버 기본값) |
6. 박스 실측: 키 없이 서버에서 돌려 보니
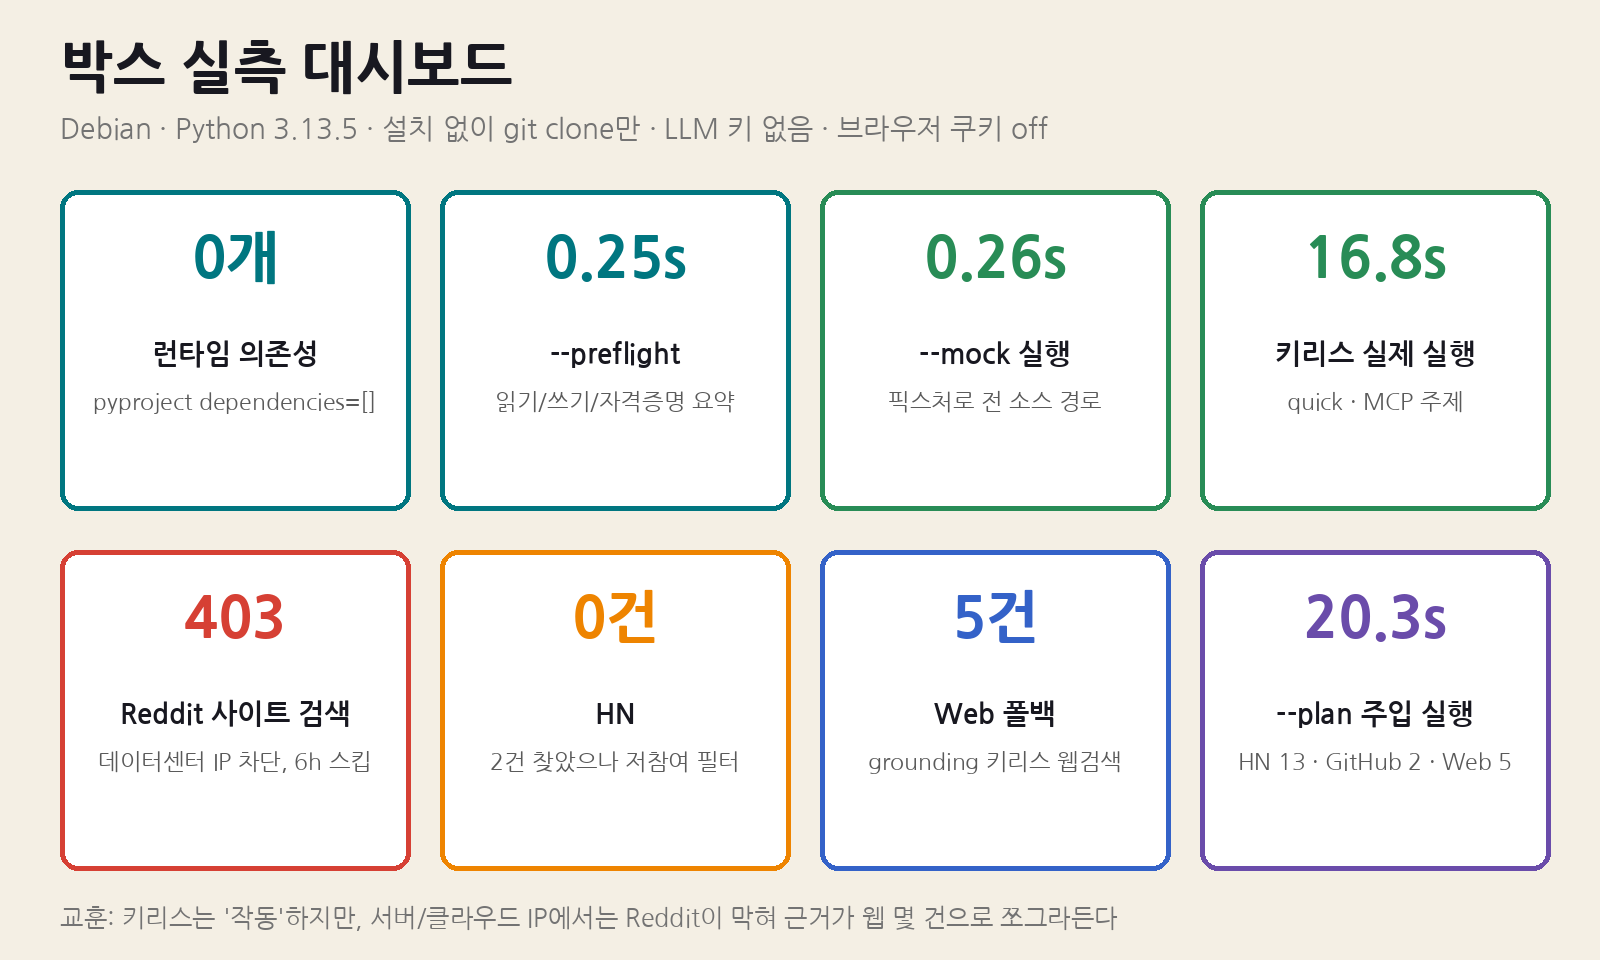
Debian 박스(Python 3.13.5)에서 git clone만 하고 별도 설치 없이 돌렸습니다. LLM 추론 키는 하나도 없고, 브라우저 쿠키는 끈 상태입니다. 실제 실행 두 번 모두 GitHub 토큰 환경변수 없이 진행했습니다.
| 테스트 | 명령 | 결과 |
|---|---|---|
| 도움말 | --help |
exit 0, 295줄. 의존성 설치 없이 바로 실행 |
| 프리플라이트 | --preflight |
0.25s. “Ready to research with safe defaults”, 쿠키 off, 쓰기 예정 없음, 사용 가능 소스 reddit·hackernews·polymarket·github·grounding |
| 목 실행 | --mock --emit=json |
0.26s, exit 0. 플랜에 24개 소스 + perplexity 서브쿼리가 잡히고 픽스처로 렌더 확인 |
| 키리스 실제 실행 | "Model Context Protocol" --quick |
16.8s, exit 0. Reddit 사이트 검색 HTTP 403 Blocked → 6시간 스킵 기록. HN은 2건 찾았으나 저참여 필터로 0건. 최종 Web 5건만. 푸터에 “Limited recent data” 경고 |
| 플랜 주입 실행 | "Claude Code" --plan plan.json |
20.3s, exit 0. HN 13건(5,324점·2,790댓글), GitHub 2건(비인증 REST, 10건 중 8건 무관 제거), Polymarket 14건 전부 “주제 미언급” 필터, Web 5건. “최근 7일 증거는 15건 중 7건” 경고 |
관찰 포인트는 세 가지입니다. 첫째, 플래너 경고가 시끄럽습니다. --plan 없이 돌리면 “YOU ARE the planner”라는 긴 경고가 출력됩니다. 엔진이 헤드리스 사용을 2급 경로로 본다는 뜻입니다. 둘째, 클라우드 IP에서는 Reddit이 막힙니다. 엔진은 이를 감지해 건강 상태 파일(~/.config/last30days/reddit-health.json)에 6시간 스킵을 기록하고, 다음 실행은 바로 건너뜁니다. 실패를 조용히 삼키지 않고 푸터와 로그에 드러내는 점은 좋습니다. 셋째, 필터가 공격적입니다. Polymarket 14건이 전부 걸러지고 GitHub 10건 중 8건이 버려졌습니다. 오탐보다 누락을 택한 설계라 “결과가 적다”가 곧 “버그”는 아닙니다.
실행 후 ~/.config/last30days/ 아래 last-report.json, last-run.json이 생겼습니다. SECURITY.md가 밝힌 대로 증거 원문이 담기는 파일이라, 공용 서버에서 돌린다면 이 경로를 관리해야 합니다.
7. 보안·프라이버시 모델
| 영역 | 기본 동작 | 운영 시 주의 |
|---|---|---|
| 텔레메트리 | 없음(분석·업데이트 체크 없음) | – |
| 주제 전송 | 켜진 모든 소스와 웹검색 백엔드로 전송. 키 없으면 DuckDuckGo → Startpage | 민감한 인물·사내 프로젝트명은 외부로 나감 |
| Wikidata 조회 | 회사·인물처럼 보이는 주제는 설정 없이 Wikidata로 전송 | 끄는 설정이 없음 |
| LLM 재랭킹 | Gemini·OpenAI·xAI·OpenRouter 키 중 하나라도 보이면 매 실행 스니펫 전송 | X 검색용으로 넣은 XAI_API_KEY도 재랭킹에 쓰임. 로컬 유지하려면 모든 설정 계층에서 4개 키 제거 |
| 자격증명 | env → 신뢰된 프로젝트 파일 → ~/.config/last30days/.env → macOS 키체인 → pass |
저장소가 스스로 프로젝트 설정을 신뢰시킬 수 없음(LAST30DAYS_TRUST_PROJECT_CONFIG 필요) |
| 브라우저 쿠키 | 기본 off, 동의 필요. X는 auth_token·ct0만 도메인·이름으로 필터 후 복호화 |
쿠키 DB 사본을 0600 임시 파일로 읽고 삭제. MCP 서버는 기본 차단 |
| 외부 설치 | 첫 설정에서 npx -y @mvanhorn/printing-press-library@0.1.27로 CLI 설치 |
저장소 밖 코드 공급망. 사내 환경은 사전 검토 필요 |
| 비신뢰 콘텐츠 | 수집 텍스트를 이스케이프하고 LLM 프롬프트에서 untrusted 펜스로 감쌈 | 프롬프트 인젝션 방어는 최종적으로 호스트 모델 몫 |
| 로컬 데이터 | 보고서, last-run, 코퍼스 캐시, research.db, library.db | 퍼지 명령이 없음. 직접 삭제해야 함 |
또 하나 눈여겨볼 부분은 CONCEPTS의 Official X policy입니다. 호스트가 Grok Bot이라고 신호를 보내면 X 백엔드 체인에서 브라우저 세션 경로를 아예 빼고 라이선스 경로(X API bearer, xAI 라이선스 검색, X 공식 CLI)만 남깁니다. 같은 엔진이 호스트에 따라 데이터 접근 정책을 바꾸는 구조라, 기업 도입 시 “어느 호스트에서 돌리느냐”가 컴플라이언스 변수가 됩니다.
8. 비슷한 도구와 비교
| 구분 | last30days-skill | 범용 Deep Research(ChatGPT·Gemini·Perplexity) | GPT Researcher류 오픈소스 리서치 에이전트 | 소셜 리스닝 SaaS |
|---|---|---|---|---|
| 주 데이터 | Reddit·X·YouTube·TikTok·HN·Polymarket 등 커뮤니티 신호 | 웹 문서 중심(제휴 소스는 벤더마다 다름) | 웹 검색 API 결과 | 소셜 플랫폼 계약 데이터 |
| 랭킹 기준 | 관련도 + 참여도·베팅액(상한 있음) | 모델 내부 판단 | LLM 요약 품질 | 멘션량·감성 |
| 시간 창 | 30일 계약(기간 밖 0.35배) | 명시적 계약 없음 | 설정 가능 | 대시보드 기간 |
| 실행 위치 | 내 머신(BYO 키·세션) | 벤더 클라우드 | 내 머신/서버 | 벤더 클라우드 |
| 비용 구조 | 무료 코어 + 선택 API 키 | 구독 | LLM·검색 API 사용량 | 고가 라이선스 |
| LLM 의존 | 호스트가 계획·합성, 엔진은 키 없이도 동작 | 필수 | 필수 | 선택 |
| 재현성 | --as-of, --store, json 프로필 |
낮음 | 중간 | 높음(저장 데이터) |
| 약점 | 플랫폼 차단·약관 리스크, 설정 복잡도 | 커뮤니티 원문 접근 제한 | 소셜 신호 약함 | 개발자 워크플로 연동 약함 |
9. 한계와 주의점
- “키리스”의 실제 품질은 네트워크에 달렸습니다. 박스처럼 데이터센터 IP면 Reddit이 403으로 막히고, 결과가 웹 몇 건으로 쪼그라듭니다. 노트북 가정용 회선과 서버 cron의 결과가 크게 다를 수 있습니다.
- 플랫폼 약관 리스크. 브라우저 쿠키로 X·Reddit을 “본인처럼” 검색하는 경로는 동의 기반이지만, 회사 계정이나 자동화 환경에서는 약관 검토가 필요합니다. Grok Bot 호스트에서 라이선스 경로만 쓰게 한 정책이 바로 이 지점을 의식한 설계입니다.
- 프롬프트 계약이 무겁습니다. SKILL.md의 LAW(대시 금지, 본문 헤더 금지, 푸터 원문 전달 등)는 출력 일관성을 주지만, 호스트 시스템 지시와 충돌할 수 있습니다. 계약 첫머리에 “호스트·사용자 지시가 우선”이라고 적어 둔 것은 다행입니다.
- 변경 속도가 매우 빠릅니다. CHANGELOG가 230KB, 11/16 하루에만 v4.2.1과 v4.3.0이 나왔습니다. 마켓플레이스 자동 업데이트는 편하지만 운영 파이프라인에서는 버전 고정이 필요합니다.
- 참여도는 조작 가능한 신호입니다. 상한과 그라운딩으로 완화했지만, 봇 업보트·바이럴 마케팅이 섞인 주제에서 “사람들이 말한다”가 곧 사실은 아닙니다. Polymarket 배당도 유동성이 얇으면 신호가 약합니다.
- 라이선스. 코드 자체는 MIT로 상업 이용이 자유롭지만, 수집 데이터의 재배포 권리는 각 플랫폼 약관을 따릅니다. 첫 설정이 설치하는 printing-press 계열 CLI는 저장소 밖 패키지입니다.
10. 누가 도입하면 좋은가
| 대상 | 추천도 | 이유 |
|---|---|---|
| Claude Code·Codex·Cursor를 매일 쓰는 개발자/PM | 높음 | 미팅·기술 선정 전 “지난 한 달 현장 분위기”를 1회 명령으로 확보. 이후 같은 세션에서 후속 질문 가능 |
| 콘텐츠·리서치 팀(뉴스레터, 트렌드 리포트) | 높음 | --discover, --store+watchlist, library feed(Atom)로 반복 리서치 자동화 |
| 투자·IR·경쟁사 분석 | 중간 | 특허·채용 “비밀 신호”, Yahoo Finance 라인은 흥미롭지만 근거 검증은 별도로 필요 |
| 서버 cron만으로 무인 운영하려는 팀 | 낮음~중간 | Reddit 차단과 플래너 부재로 품질이 떨어짐. 호스트 LLM 플랜 주입과 소스 키 확보가 전제 |
| 규제 산업·사내 기밀 주제 | 신중 | 주제가 다수 외부 서비스로 전송됨. 코퍼스 모드만 쓰거나 네트워크 정책부터 정비 |
정리
last30days-skill이 트렌딩 상단을 오래 지키는 이유는 “멀티 소스 검색”이라는 아이디어보다 운영 디테일에 있습니다. 표준 라이브러리만으로 쓴 엔진, 주석에 실패 사례까지 남긴 점수 상수, 실패를 숨기지 않는 푸터, 호스트별 데이터 접근 정책이 그 디테일입니다. 반대로 말하면 이 도구의 품질은 결국 어떤 키와 세션을 주고, 어떤 네트워크에서, 어떤 호스트 모델이 계획을 세우느냐에 달려 있습니다. 개인 개발 환경에서 Claude Code나 Codex와 붙여 쓰면 체감 가치가 가장 크고, 서버 자동화에 쓰려면 플랜 주입과 소스 자격증명부터 설계하는 편이 맞습니다.