에이전트에게 “인터넷에서 찾아 줘”라고 맡겨 보면 금방 벽에 부딪힌다. 공개 웹 문서는 잘 읽지만 정보 밀도가 높은 곳, 즉 X(트위터) 스레드, Reddit 댓글, YouTube 자막, 샤오훙수 후기, B站 영상은 플랫폼마다 로그인·IP 차단·유료 API라는 다른 문이 달려 있다. 오늘(10월 6일) GitHub Trending 일간 상위권에 오른 Panniantong/Agent-Reach는 이 문제를 “또 하나의 스크레이퍼”가 아니라 플랫폼별 접근 경로를 골라·설치하고·점검하고·라우팅하는 능력 층(capability layer)으로 풀겠다고 말한다. 별은 약 9만 2천 개, 오늘 하루에만 1,100개 넘게 늘었다. 이 글은 실무자 관점에서 구조, 설계 판단, 실행·평가 방법, 대안 비교와 리스크를 정리한다. 테크부터 경제, 생활까지 복잡한 소식을 쉽게 풀어보는 MoricWorld의 오후 오픈소스 심층 편이다.
한눈에 보는 프로젝트 상태
| 항목 | 확인한 값 (10/6 KST 기준) | 해석 |
|---|---|---|
| 저장소 | Panniantong/Agent-Reach |
Python 패키지 이름은 agent-reach, CLI 진입점도 같은 이름 |
| 별 / 포크 | 약 92,170 / 약 8,086 | 오늘 Trending 일간 집계로 하루 +1,155개 |
| 최신 릴리스 | v1.5.0 (2026-06-11) | main 마지막 커밋은 9/16(Boss直聘 채널 추가, CHANGELOG상 Unreleased) |
| 라이선스 | MIT | 상업적 사용 제약은 작다. 단, 호출하는 상류 도구·플랫폼 약관은 별개 |
| 런타임 | Python 3.10+, 의존성 7개(requests, feedparser, yt-dlp 등) | PyPI classifier는 4 – Beta |
| 등록 채널 | 16개 (ALL_CHANNELS) |
README·SKILL 문서마다 13/15/16으로 숫자가 섞여 있으니 코드를 기준으로 볼 것 |
숫자보다 중요한 건 포지셔닝이다. 저장소의 CLAUDE.md는 스스로를 installer + doctor + config tool. NOT a wrapper라고 정의한다. 설치가 끝나면 에이전트는 Agent Reach를 거치지 않고 yt-dlp, gh, twitter-cli, OpenCLI, Jina Reader 같은 상류 도구를 직접 호출한다. Agent Reach는 “어떤 도구를 어떤 순서로 쓰면 지금 동작하는가”를 결정하고 그 판단을 문서(SKILL.md)와 진단 결과(doctor)로 에이전트에게 넘긴다.
무엇을 푸는가: 플랫폼마다 다른 ‘문’을 관리하는 일
README가 꼽는 고통은 구체적이다. X API는 사용량 과금이라 적당히 써도 월 200달러대가 나오고, Reddit은 서버 IP에 403을 돌려주며, 샤오훙수는 로그인 없이는 볼 수 없고, B站은 해외·서버 IP를 막는다. 더 골치 아픈 건 이 경로들이 계속 바뀐다는 점이다. 실제로 v1.5.0 릴리스 노트에는 B站이 yt-dlp를 412 응답으로 막아 bili-cli로 갈아탔다는 기록이 있고, README는 2026년 3월 단일 플랫폼 CLI 여러 개가 관리 중단돼 경로를 다시 짰다고 적고 있다. 즉 이 프로젝트의 진짜 가치는 개별 수집 코드가 아니라 ‘깨짐’을 흡수하는 운영 계층에 있다.
아키텍처: 문서가 라우팅하고, 코드는 점검한다
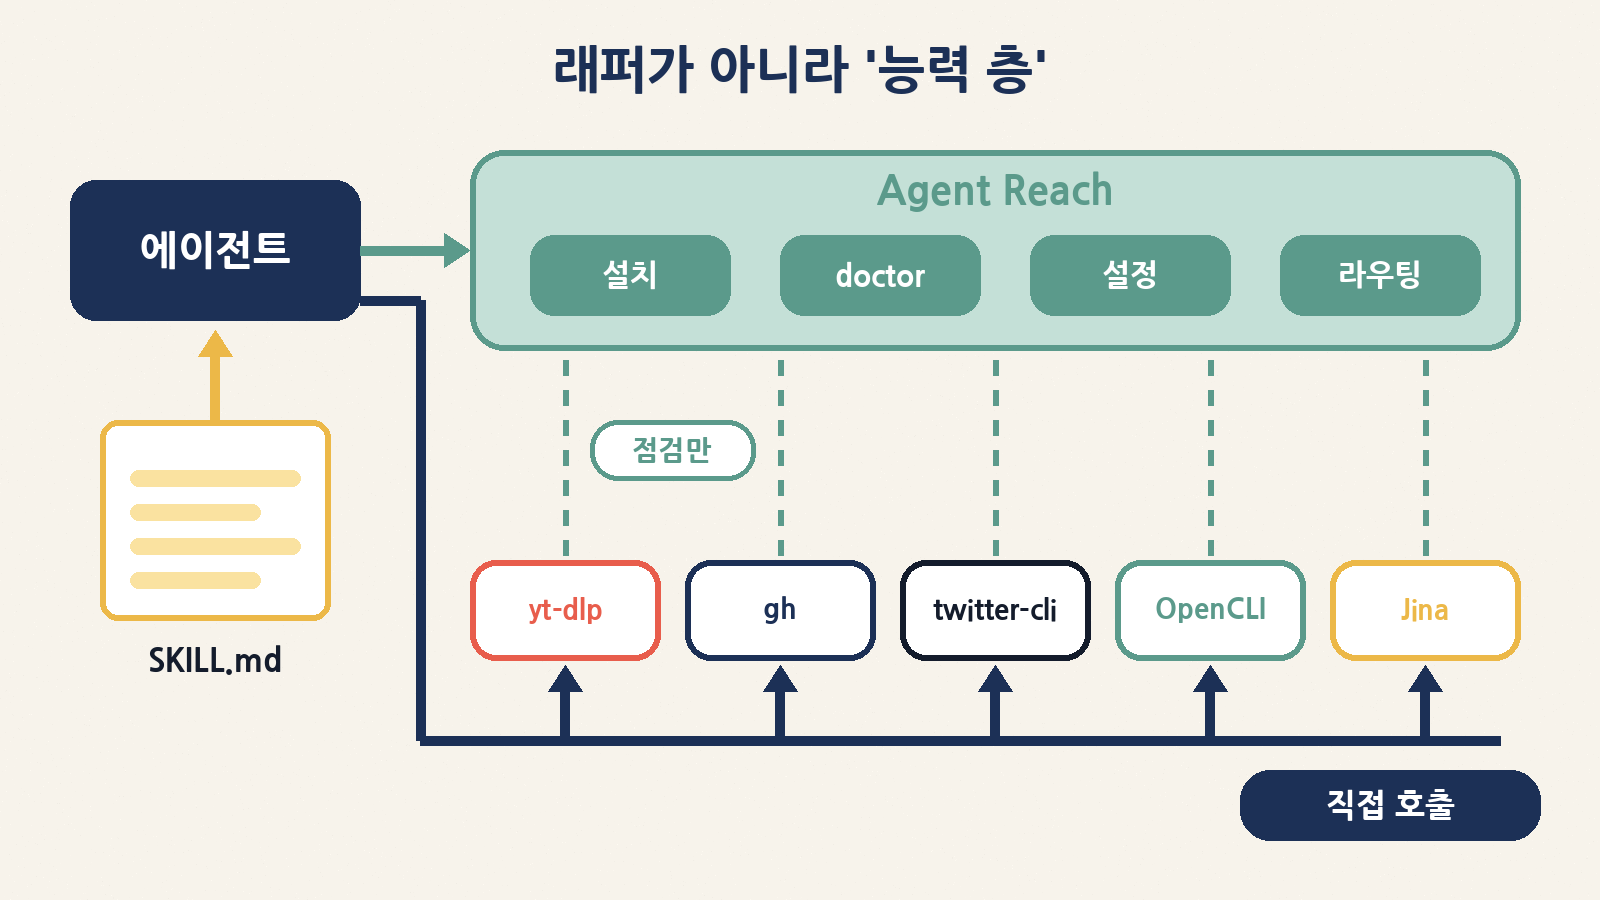
데이터 흐름은 세 갈래다. ① 에이전트(Claude Code, Cursor, OpenClaw 등 셸을 실행할 수 있는 에이전트)가 설치된 SKILL.md를 읽는다. 이 문서에는 “인터넷 조사·특정 플랫폼·URL 공유 시 반드시 사용”이라는 트리거, 세션 내내 지킬 규칙, 의도별 라우팅 표, references/ 하위의 플랫폼별 명령과 재시도 체인이 들어 있다. ② 로그인 기반 플랫폼을 쓰기 전에 에이전트는 agent-reach doctor --json을 실행해 채널별 active_backend를 확인한다. ③ 그다음 실제 읽기·검색은 해당 상류 CLI를 직접 부른다. Agent Reach 파이썬 코드가 데이터 경로에 끼지 않는다는 점이 핵심이다.
| 모듈 | 역할 | 눈여겨볼 점 |
|---|---|---|
channels/base.py |
채널 추상 클래스. can_handle(url), check(config), ordered_backends() |
backends 리스트 순서가 곧 우선순위. <channel>_backend 설정·환경변수로 강제 지정 |
channels/*.py |
플랫폼별 백엔드 탐지(twitter, reddit, bilibili, xiaohongshu, youtube, github, web 등) | 대부분 수십~수백 줄. 실제 읽기보다 ‘지금 무엇이 동작하나’를 판정하는 코드가 중심 |
probe.py |
상류 명령을 실제로 실행해 ok / missing / broken / timeout / error로 분류 | 종료 코드 126·127, FileNotFoundError를 ‘broken’으로 잡아 venv 끊김을 구분 |
doctor.py |
채널 전체 점검과 리포트·JSON 출력 | doctor --json의 active_backend를 에이전트가 읽고 경로를 고른다 |
cli.py (약 2,400줄) |
install / configure / doctor / check-update / watch / transcribe 등 | install 기본값은 점검만 하는 safe 모드, 실제 설치는 --system |
config.py |
~/.agent-reach/config.yaml 관리 |
원자적 교체 + 소유자 전용(0600) 권한, 심볼릭 링크 거부, read_only 모드 |
skill/SKILL.md + references/ |
에이전트가 읽는 라우팅 규칙과 플랫폼별 명령·재시도 체인 | 사실상 제품의 절반. 코드보다 이 문서가 에이전트 행동을 결정 |
integrations/mcp_server.py |
MCP 서버 | 노출 도구는 get_status 하나뿐. 읽기·검색 도구는 MCP로 제공하지 않음 |
재미있는 대목은 MCP 서버다. 많은 에이전트 도구가 기능을 MCP 도구로 감싸는 데 반해, 이 프로젝트의 MCP 서버는 get_status 하나만 노출한다. 읽기 기능을 MCP로 다시 감싸면 상류 도구의 옵션·에러를 숨기는 래퍼가 되고, 경로가 바뀔 때마다 스키마를 고쳐야 하기 때문으로 읽힌다. 대신 그 부담은 SKILL.md라는 자연어 문서와 에이전트의 해석 능력으로 넘어간다.
설계 판단 ① 플랫폼 = 순서 있는 백엔드 목록
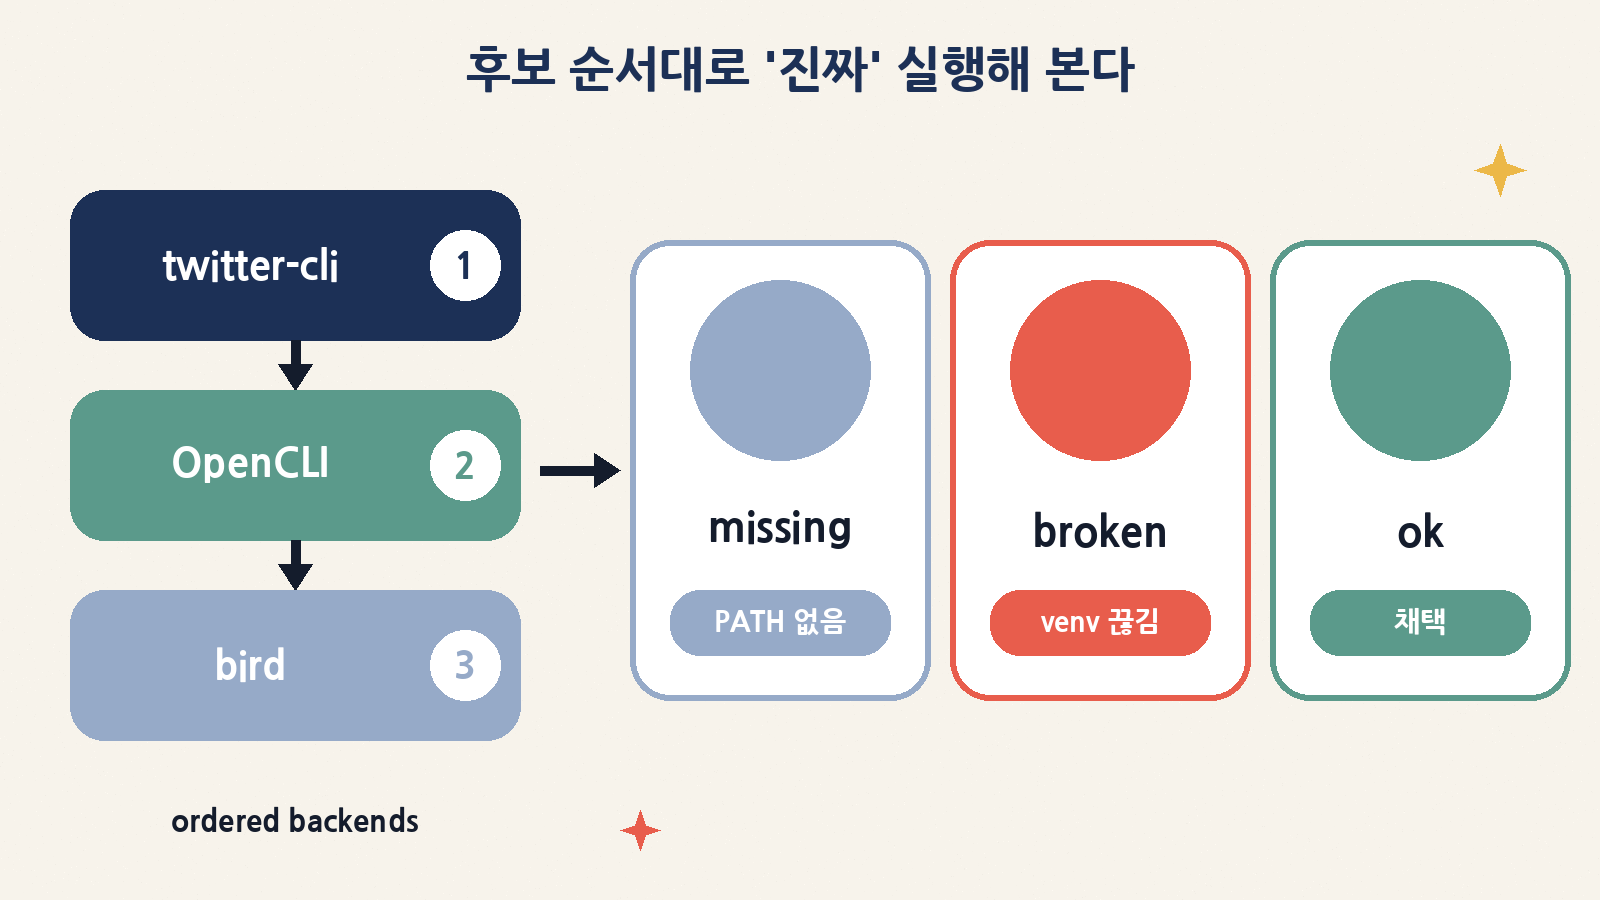
각 채널 클래스는 backends 리스트를 갖는다. 예를 들어 X는 twitter-cli ▸ OpenCLI ▸ bird(레거시), Reddit은 OpenCLI ▸ rdt-cli, 샤오훙수는 OpenCLI ▸ xiaohongshu-mcp ▸ xhs-cli, B站은 bili-cli ▸ OpenCLI ▸ 검색 API 순이다. 경로 교체는 코드 재작성이 아니라 리스트 순서 변경이며, 사용자는 twitter_backend 같은 설정이나 TWITTER_BACKEND 환경변수로 특정 백엔드를 앞으로 당길 수 있다(모르는 값은 무시해 잘못된 설정이 정상 경로를 가리지 않게 했다).
판정 로직도 꼼꼼하다. probe.py는 shutil.which()로 “명령이 있다”를 확인하는 데서 멈추지 않고 실제로 --version 같은 부작용 없는 명령을 실행한다. 시스템 파이썬이 업그레이드되면 pipx·uv로 깐 CLI의 shebang이 사라진 인터프리터를 가리키는데, 이때 which()는 통과하지만 실행은 실패한다. 이를 broken으로 분류하고 uv tool install --force 같은 재설치 처방을 붙인다. 재시도는 timeout·error 같은 일시 장애에만 하고, missing·broken은 재시도해도 낫지 않으니 즉시 반환한다. X 채널은 후보 전체 상태를 모은 뒤 첫 ok를 고르고, 없을 때만 warn으로 내려간다. “설치됐지만 로그인 안 된 1순위”가 “완전히 동작하는 2순위”를 가리는 문제를 막기 위한 2단계 판정이다.
설계 판단 ② 진단은 ‘부작용 없이’가 우선
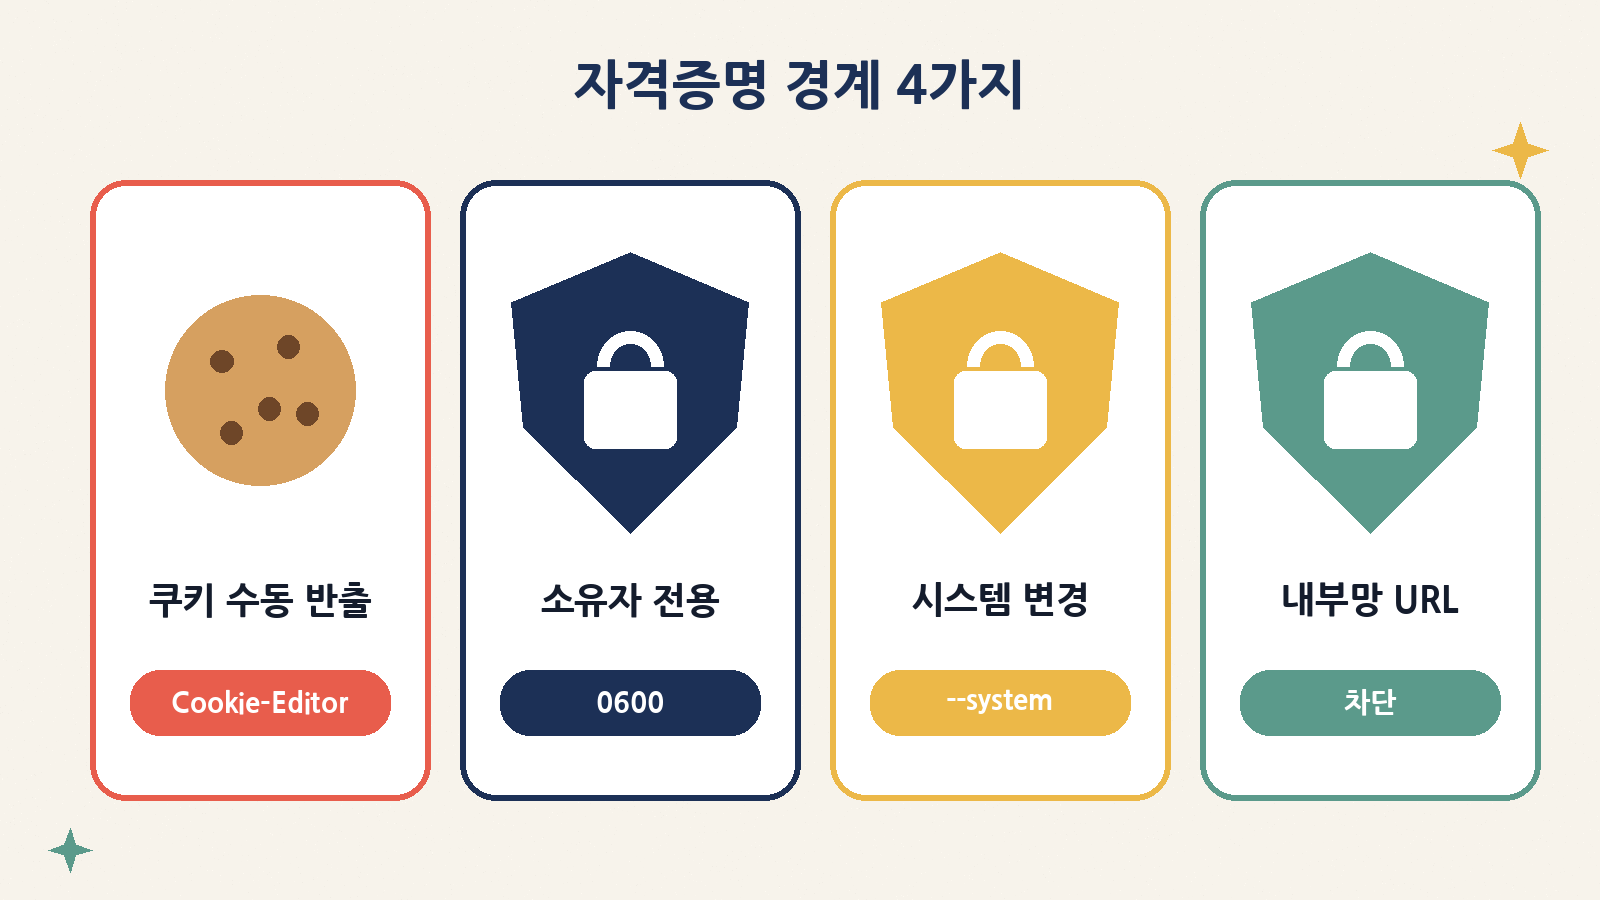
이 프로젝트에서 가장 실무적인 결정은 doctor가 일부러 확인하지 않는 것들이다. X 채널은 twitter status를 실행하지 않는다. 상류 CLI가 자격증명이 없거나 틀리면 브라우저 쿠키를 자동으로 읽어 오는 폴백이 있어, 진단만 했는데 브라우저 쿠키에 접근하는 일이 생길 수 있어서다. 그래서 결과는 ‘자격증명은 있음, 실시간 검증은 안 함’이라는 warn으로 남고 active_backend는 null이 된다. GitHub도 gh auth status를 자동 실행하지 않는다. 정확도 대신 사용자 동의 경계를 고른 셈이고, SKILL.md는 에이전트에게 “null은 백엔드가 없다는 뜻이 아니라 일부러 실시간 점검을 건너뛴 것”이라고 해석하도록 지시한다.
설치도 같은 철학이다. agent-reach install의 기본값은 시스템 패키지를 깔거나 설정을 쓰지 않는 점검 전용(safe) 모드이고, 전역 도구·스킬 설치는 --system을 명시해야 한다. --dry-run으로 무엇을 할지만 볼 수도 있다. 설정 파일은 임시 파일에 쓰고 os.replace로 원자적으로 교체하며, 소유자 읽기·쓰기(0600) 권한으로 만들고 심볼릭 링크 경로는 거부한다. 쿠키 입력은 X·샤오훙수의 경우 Cookie-Editor 확장으로 사람이 직접 내보내는 방식만 허용하도록 문서화돼 있다(Xueqiu(雪球)처럼 configure --from-browser로 브라우저 쿠키를 추출하는 경로도 코드에 남아 있으니 정책 검토 시 함께 볼 것).
설치와 실행
README가 권하는 방식은 에이전트에게 설치 문서 URL을 그대로 주는 것이다. 실무에서는 아래처럼 사람이 먼저 가상환경에 설치해 점검하는 쪽을 권한다.
# 격리된 가상환경에 설치 (릴리스 태그 고정 권장)
python3 -m venv ~/.venvs/agent-reach && source ~/.venvs/agent-reach/bin/activate
pip install "https://github.com/Panniantong/agent-reach/archive/refs/tags/v1.5.0.zip"

agent-reach version            # Agent Reach v1.5.0
agent-reach install --dry-run  # 무엇을 바꿀지 미리 보기
agent-reach doctor --json      # 채널별 status / active_backend
# 필요한 채널만 명시적으로 설치 (시스템 변경 동의 후)
agent-reach install --env=auto --system --channels=twitter,reddit
# 스킬만 설치하는 경로
npx skills add Panniantong/Agent-Reach@agent-reach우리 쪽 리눅스 박스에서 main 브랜치(커밋 a19a171)를 pip install -e '.[dev]'로 설치해 확인한 결과, pytest는 607개 테스트가 약 11초에 모두 통과했다(v1.5.0 릴리스 노트의 107→162개 이후 크게 늘었다). 아무 자격증명 없는 깨끗한 환경에서 doctor는 4/16 채널 가용을 보고했다. V2EX·RSS·웹(Jina Reader)·B站 검색 API는 바로 됐고, GitHub은 gh는 있지만 인증 미설정으로 경고, YouTube는 venv를 활성화하지 않은 상태라 PATH에서 yt-dlp를 찾지 못해 미설치로 떴다. 마지막 사례가 시사하듯 doctor는 PATH 기준이므로 에이전트 프로세스의 환경변수와 venv 활성화 상태를 맞추는 게 첫 번째 운영 포인트다.
평가·벤치마크는 이렇게
이 도구의 품질은 “기능이 있다”가 아니라 “다음 주에도 동작한다”로 재야 한다. 플랫폼 정책이 바뀌면 상류 CLI가 먼저 깨지고, Agent Reach는 그 뒤에 경로를 바꾼다. 따라서 평가는 일회성 데모가 아니라 시계열이어야 한다.
| 점검 항목 | 방법 | 합격 기준 예시 |
|---|---|---|
| 설치 무결성 | pytest tests -q, agent-reach version |
전부 통과, 버전 3곳(pyproject, __init__, 테스트) 일치 |
| 채널 가용성 | agent-reach doctor --json을 일 단위로 저장 |
필요 채널의 status/active_backend가 기대값, 변동 시 알림 |
| 수집 성공률 | 채널별 고정 URL·쿼리 20~50개로 하루 1회 실행 | 성공률·빈 응답·반봇(anti-bot) 페이지 비율 추적 |
| 지연·비용 | 명령별 소요 시간, 에이전트 토큰 사용량 | 리서치 1건당 시간·토큰 상한 설정 |
| 회귀 감지 | agent-reach watch 또는 check-update를 스케줄러에 |
새 버전·경로 변경을 사람이 검토한 뒤 반영 |
팀 단위로 쓴다면 doctor JSON을 하루 한 번 저장해 채널별 status 변화를 대시보드로 보는 것만으로도 “어제까지 되던 Reddit이 왜 안 되지?” 같은 문의 대부분을 선제적으로 잡을 수 있다. 수집 성공률은 반드시 빈 응답과 반봇 페이지를 실패로 세야 한다. 웹 채널은 Jina Reader가 Cloudflare 챌린지 페이지를 돌려주면 이를 감지해 예외를 던지고, 응답은 5MB로 제한하는데, 상류 CLI 쪽은 그런 보호가 제각각이라 평가 스크립트에서 따로 검사하는 편이 안전하다.
대안과 비교
| 접근 방식 | 강점 | 약점 | 어울리는 상황 |
|---|---|---|---|
| Agent Reach | 플랫폼별 ‘지금 되는 경로’를 골라 주고 doctor로 상태를 보여 줌. 소셜·중국권 플랫폼 커버리지가 넓음 | 실제 수집 안정성은 상류 CLI·쿠키·플랫폼 정책에 좌우. 문서 중심이라 동작이 에이전트 해석에 의존 | 개인·소규모 팀의 리서치 에이전트, 데스크톱 기반 조사 업무 |
| 플랫폼 공식 API 직접 연동 | 약관상 가장 명확, 쿼터·SLA·감사 로그 확보 | 비용과 승인 절차. README도 X API 비용(월 약 215달러 수준 예시)을 진입 장벽으로 든다 | 서비스 백엔드, 규정 준수가 중요한 조직 |
| 웹 추출 API(Jina Reader 같은 리더/크롤러 서비스) | URL → 마크다운이 간단, 인프라 불필요 | 로그인 필요한 소셜 콘텐츠는 대부분 못 읽음, URL이 외부 서비스로 전송 | 공개 웹 문서 요약·RAG 수집 |
| 브라우저 자동화 MCP(Playwright 계열 등) | 로그인 세션까지 범용으로 다룸 | 느리고 토큰을 많이 씀, 셀렉터 깨짐, 세션 권한이 넓음 | 정형화 안 된 사이트, 일회성 조사 |
| 상용 스크레이핑 플랫폼 | 프록시·캡차 처리·결과 보장형 과금 | 비용, 데이터 경계, 약관 리스크를 벤더와 나눠 짐 | 대량 수집, 운영 SLA가 필요한 경우 |
요약하면 Agent Reach는 “여러 플랫폼을 넓게, 싸게, 개인 세션으로”라는 영역에서 강하다. 반대로 수집 결과를 제품 기능이나 고객 데이터 파이프라인에 넣어야 한다면 공식 API나 계약 기반 벤더가 맞다. 둘을 섞는 구성, 예컨대 사내 리서치 에이전트는 Agent Reach로 빠르게 탐색하고 운영 파이프라인은 공식 API로 고정하는 방식도 현실적이다.
주의할 점: 라이선스보다 무거운 것들
| 리스크 | 구체 내용 | 완화책 |
|---|---|---|
| 플랫폼 약관·법무 | 쿠키·로그인 세션으로 소셜 플랫폼을 읽는 구조. 계정 제한, 약관 위반 소지 | 업무 계정과 분리한 전용 계정, 읽기 전용 용도 한정, 법무 검토 |
| 자격증명 노출 | X 쿠키(auth_token, ct0)·각종 키가 로컬 YAML·환경변수에 존재 |
0600 권한 확인, 전용 OS 사용자, 디스크 암호화, 주기적 토큰 폐기 |
| 공급망·프롬프트 주입 | 설치 방식이 ‘main 브랜치의 install.md를 에이전트에게 읽혀 따르게’ 하는 형태. 상류 CLI도 다수 | 태그(v1.5.0 등)·커밋 고정, 문서 사전 검토, 샌드박스에서 먼저 실행 |
| 외부 서비스로의 데이터 흐름 | 웹 읽기는 r.jina.ai, 검색은 Exa MCP를 경유. 조회 URL·쿼리가 제3자에게 전달 |
민감 URL은 사내 리더로 우회, 데이터 분류 정책에 맞춰 채널 비활성화 |
| SSRF 방어 범위 | normalize_public_http_url은 사설 IP 리터럴·localhost·.internal 등은 막지만 DNS 해석 결과까지는 검사하지 않음 |
에이전트 실행 환경에 네트워크 이그레스 정책을 별도로 둘 것 |
| 성숙도 | Beta 분류, 릴리스는 6월이 마지막이고 main에 미릴리스 변경 누적 | 릴리스 태그 기준 운영, 업데이트는 스테이징에서 doctor·회귀 확인 후 |
README 상단에는 “공식 토큰·코인·투자 상품·지갑 연결·Solana/Pump.fun 프로젝트가 없으며, 이름을 쓰는 암호화폐 프로젝트는 무관하다”는 고지가 있다. 인기 저장소를 사칭한 토큰 사기가 잦다는 방증이니 사내 공지에도 함께 적어 둘 만하다. 또 README 스폰서 영역에는 스크레이핑·데이터 수집 서비스들이 올라 있다. 문서가 권하는 도구 선택과 상업적 이해관계를 구분해서 읽으면 된다. 프로젝트 자체는 MIT지만, 실제로 데이터를 가져오는 건 각 상류 도구와 플랫폼이므로 법적 검토 대상은 Agent Reach가 아니라 ‘어떤 계정으로 어떤 플랫폼을 어떻게 읽는가’다.
도입 체크리스트
- 용도 한정: 읽기·검색 전용 리서치로 범위를 정한다. SKILL.md도 게시·댓글·좋아요 같은 쓰기 작업은 대상이 아니라고 명시한다.
- 버전 고정:
main.zip·main 브랜치 문서 대신 릴리스 태그나 커밋 해시로 설치하고, 상류 CLI도 고정 버전을 쓴다(일부 채널은 이미 커밋 고정을 쓴다). - 격리 실행: 전용 OS 사용자나 컨테이너, 전용 브라우저 프로필에서 돌린다. OpenCLI·Boss直聘 채널은 로그인된 Chrome 세션과 로컬 CDP 포트를 재사용하므로 개인 브라우저와 분리한다.
- 자격증명 위생:
~/.agent-reach/권한(0600)을 점검하고, 업무용 계정과 분리된 수집 전용 계정을 쓰며, 토큰을 주기적으로 교체한다. - 데이터 경계: Jina Reader·Exa처럼 외부 서비스를 거치는 채널을 데이터 분류 기준에 맞게 켜고 끈다.
- 관측: doctor JSON 일일 기록, 채널별 성공률·반봇 비율 추적,
check-update결과는 사람이 검토한 뒤 반영한다. - 에이전트 권한: 셸 실행 권한이 필요한 구조다. OpenClaw는
exec를 켜야 동작한다고 문서화돼 있으니 최소 권한 원칙과 승인 흐름을 함께 설계한다.
정리하면 Agent Reach의 본질은 수집기보다 “깨지는 경로를 관리하는 운영 지식의 패키지”다. 코드량은 크지 않지만 부작용 없는 진단, 순서 있는 폴백, 동의 경계를 지키는 설계가 촘촘하다. 대신 그 지식의 상당 부분이 자연어 스킬 문서에 있어 에이전트가 문서를 어떻게 따르느냐가 품질을 좌우한다. 도입할 팀이라면 문서를 코드처럼 리뷰하고, 버전을 고정하고, doctor를 관측 지표로 삼는 것부터 시작하면 된다.