코딩 에이전트를 오래 써 본 팀이라면 비슷한 장면을 겪는다. 어제 세션에서 왜 그 설계를 골랐는지, 어떤 버그를 어떻게 잡았는지 새 세션은 전혀 모른다. 결국 사람이 CLAUDE.md를 손으로 늘리거나 매번 맥락을 다시 붙여 넣는다. 오늘(10월 6일) GitHub Trending 상위권에 다시 오른 thedotmack/claude-mem은 이 문제를 훅(hook) 기반 자동 캡처 → 관찰자(observer) LLM 압축 → 로컬 SQLite/FTS5 저장 → 다음 세션 주입·검색이라는 파이프라인으로 푼다. 2025년 8월에 생긴 저장소인데 별이 약 9만 6천 개이고, 하루에만 500개 넘게 늘었다. 주목할 점은 인기보다 최근 3일간 연달아 나온 릴리스(v13.29~v13.31)가 성능과 비용 구조를 크게 손봤다는 것이다. 이 글은 실무자 눈높이에서 구조와 운영 포인트, 평가 방법, 도입 판단을 정리한다.
무엇을 푸는가: “세션 간 연속성”을 시스템으로
claude-mem의 정의는 README 한 줄로 요약된다. Persistent memory compression system built for Claude Code. 에이전트가 세션 중에 쓴 도구 호출(파일 읽기, 편집, 셸 명령 등)을 훅으로 잡아 저장하고, 별도 LLM이 이를 구조화된 관찰(observation)로 압축한다. 다음 세션이 시작될 때는 최근 관찰이 컨텍스트로 들어가고, 더 깊은 기억은 MCP 검색 도구로 필요할 때만 꺼낸다. 처음엔 Claude Code 전용으로 출발했지만 지금은 OpenCode, T3 Code, Antigravity CLI, Oh My Pi(OMP), OpenClaw, Codex, Cursor, Kimi Code 등으로 설치 대상을 넓혔다. 훅이 없는 환경은 채팅 로그 파일을 감시(transcript watch)하는 방식으로 붙는다.
핵심 설계 판단은 두 가지다. 첫째, 기억 생성은 사람 손이 아니라 자동 파이프라인에 맡긴다. 둘째, 기억을 꺼낼 때는 한 번에 다 넣지 않고 단계적으로 공개(progressive disclosure)한다. 두 번째가 토큰 경제성의 핵심이다.
아키텍처: 훅 → 스풀 → 워커 → 저장소 → 주입/검색
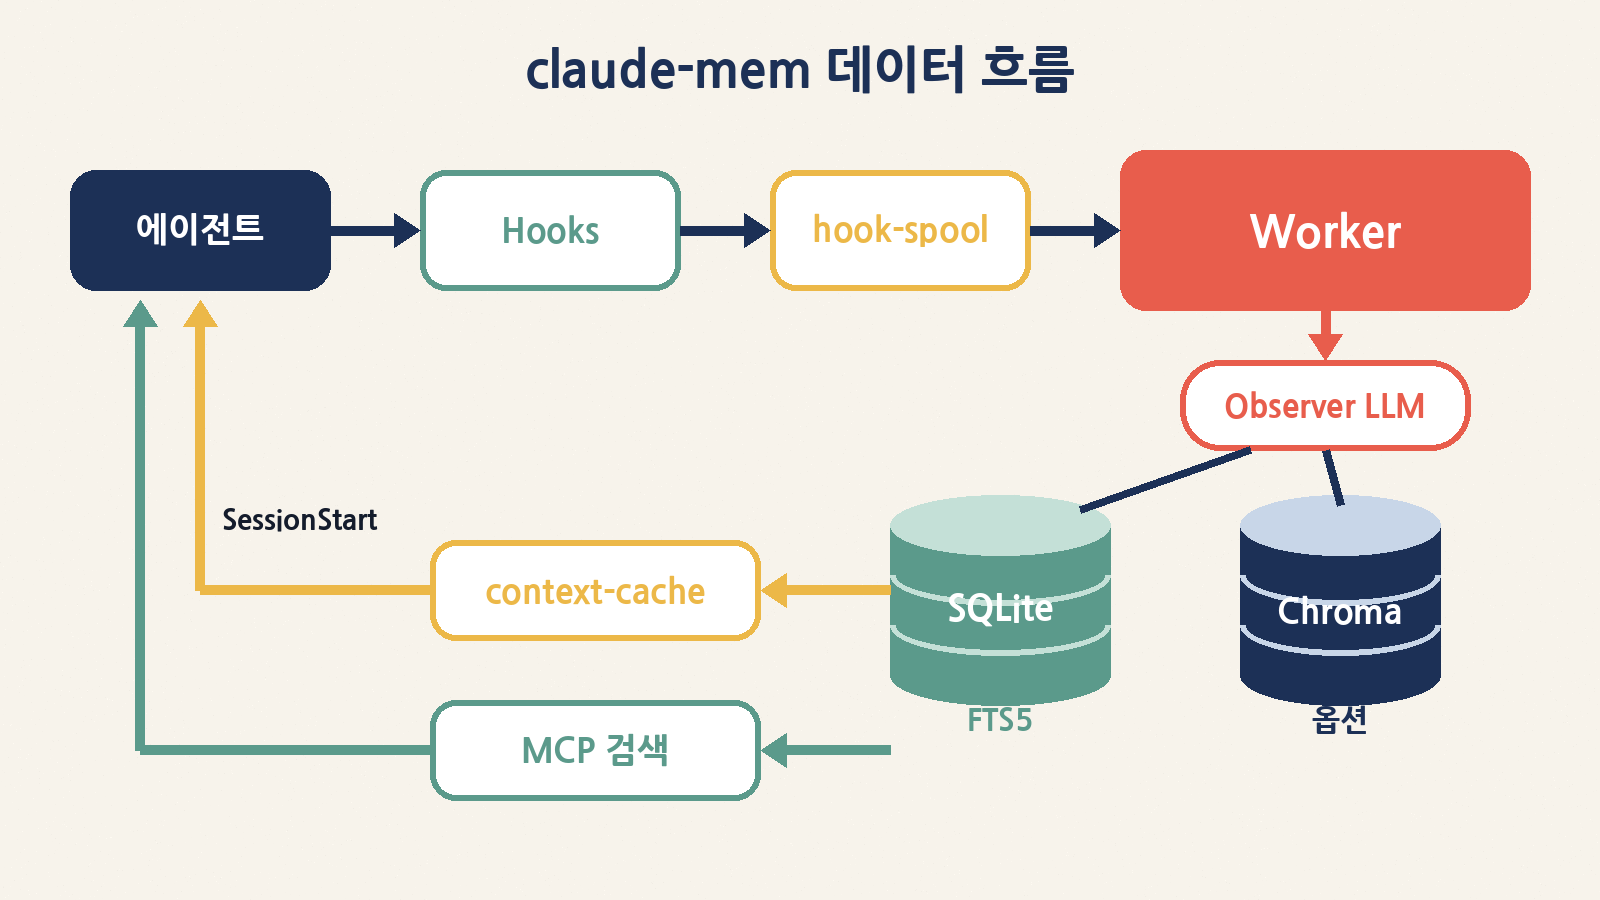
| 구성요소 | 역할(문서 기준) | 실무 함의 |
|---|---|---|
| Plugin Hooks | Setup(version-check.js) + SessionStart, UserPromptSubmit, PreToolUse(Read), PostToolUse(*), Stop. 모든 훅은 bun-runner.js가 worker-service.cjs를 단일 디스패처로 호출 |
PostToolUse는 세션당 100회 넘게 불릴 수 있어 훅 지연이 곧 에이전트 지연이 된다 |
| hook-spool (v13.30+) | 훅은 이벤트를 ~/.claude-mem/state/hook-spool/에 파일로 쓰고 바로 종료. 중복 전달은 파일 덮어쓰기로 처리하고, 7일 넘게 처리되지 않으면 expired/로 이동 |
워커가 죽거나 느려도 에이전트는 멈추지 않는 구조로 바뀜 |
| Worker Service | Express 5 HTTP + SSE, Bun 관리. 포트 기본값 37700 + (uid % 100). 관찰 압축은 Claude Agent SDK 또는 Gemini/OpenRouter/OpenAI 호환/Codex 경로 |
사용자별 로컬 데몬. 웹 뷰어와 검색 API를 함께 제공 |
| SQLite + FTS5 | ~/.claude-mem/claude-mem.db. observations, session_summaries, user_prompts 등과 트리거로 동기화되는 FTS5 가상 테이블 |
단일 파일 DB라 백업·이관이 쉽다. 커지면 인덱스 설계가 성능을 좌우(v13.31 사례) |
| Chroma (옵션) | 시맨틱+키워드 하이브리드 검색. 연결 실패 시 FTS 경로로 폴백 | uv(파이썬) 의존성이 추가되는 대신 키워드가 안 맞는 질의에 강함 |
| context-cache · MCP | 워커가 SessionStart용 컨텍스트를 미리 만들어 두고(변경 뒤 약 2초 안에 갱신), MCP 서버(mcp-server.cjs)가 HTTP API를 감싼 검색 도구 제공 |
세션 시작은 파일 읽기 한 번으로 끝남. 24시간 넘게 지난 캐시는 실시간 경로로 폴백 |
관찰 레코드는 title·subtitle·narrative·facts·concepts·files_read·files_modified 같은 계층형 필드를 가진다. 유형은 decision, bugfix, feature, refactor, discovery, change로 나뉜다. 그래서 “지난주 인증 관련 버그픽스” 같은 질의를 유형 필터와 전문 검색으로 처리할 수 있다. 덧붙여 README는 수명주기 훅을 SessionStart·UserPromptSubmit·PostToolUse·Stop·SessionEnd로 적고, 아키텍처 문서는 Setup·PreToolUse(Read)를 포함해 다르게 적는다. 버전이 빠르게 바뀌는 프로젝트라 실제 동작은 설치된 plugin/hooks/hooks.json으로 확인하는 편이 안전하다.
File Read Gate: 읽기를 막는 훅
흥미로운 부분은 PreToolUse 훅이 Read 호출을 거부할 수 있다는 점이다. 읽으려는 파일에 과거 관찰이 있으면 파일 내용 대신 그 파일의 작업 타임라인(세션당 1건으로 중복 제거, 최대 15건)을 보여 주고, 에이전트가 정말 원문이 필요한지 다시 판단하게 한다. 1,500바이트 미만 파일은 타임라인이 원문보다 비싸므로 그대로 통과시킨다. 토큰은 아끼지만, 오래된 관찰이 최신 코드와 어긋날 위험도 생긴다. 리팩터링이 잦은 저장소라면 이 게이트의 효과를 따로 측정해 볼 만하다.
검색: 3단계 점진적 공개
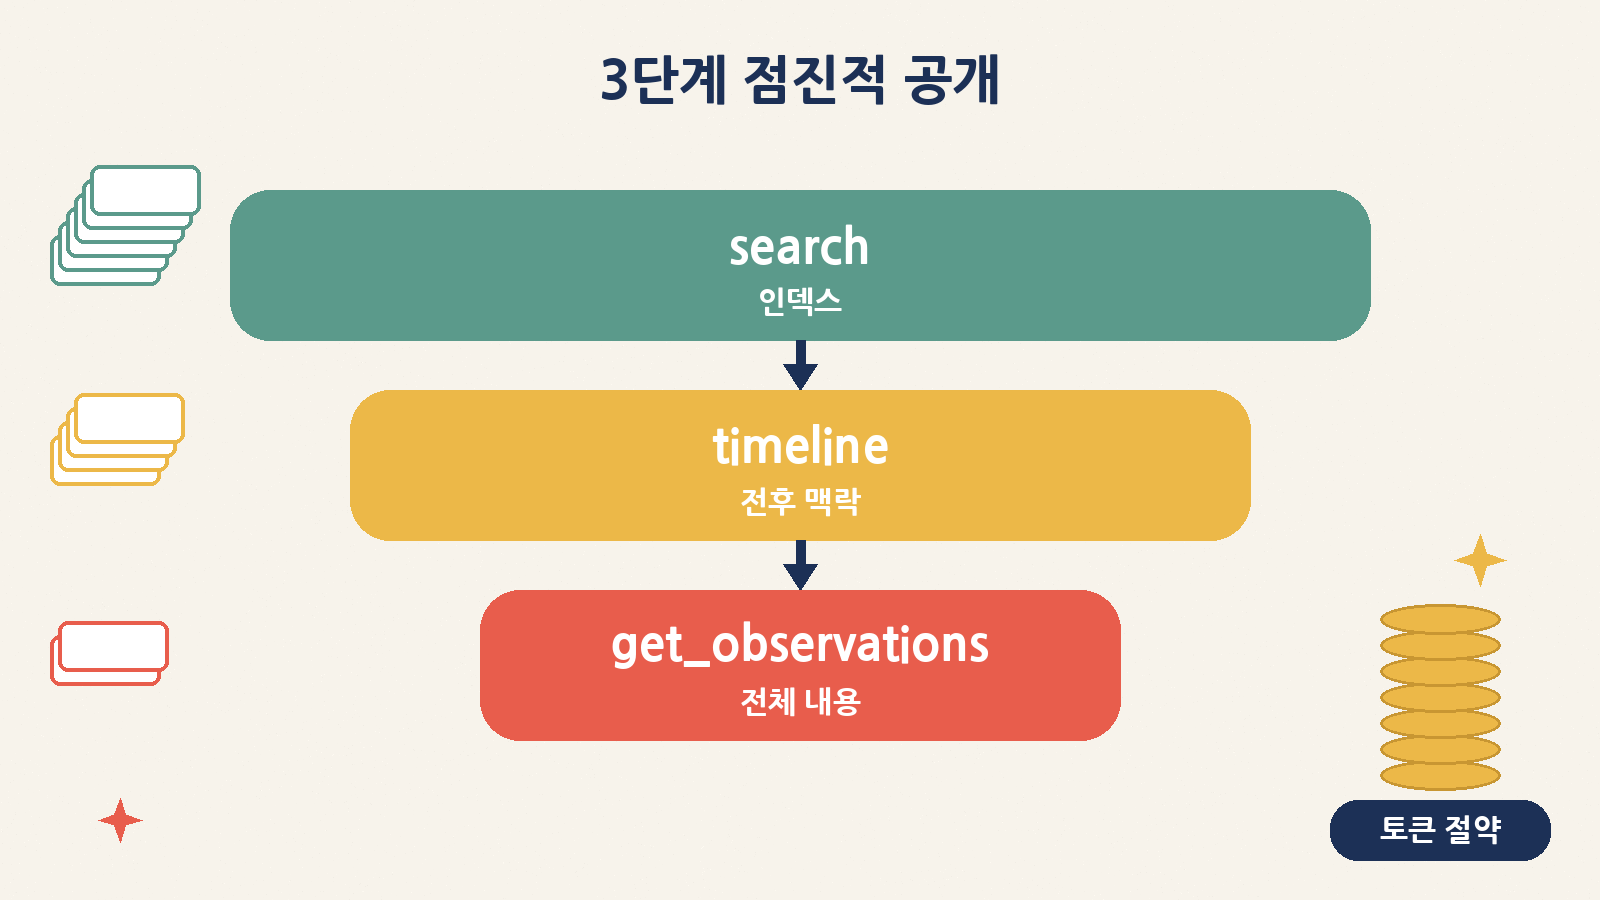
| 단계 | MCP 도구 | 반환 | 결과당 토큰(README) |
|---|---|---|---|
| 1 | search |
ID가 붙은 압축 인덱스(유형·날짜·프로젝트 필터) | ~50–100 |
| 2 | timeline |
특정 관찰 전후의 시간순 맥락 | 명시 없음 |
| 3 | get_observations |
고른 ID의 전체 내용(배치 호출 권장) | ~500–1,000 |
README는 먼저 거른 뒤 가져오는 방식으로 약 10배 토큰 절약을 주장한다. 다만 이는 설계상 추정치다. 독립된 재현 실험은 문서에 없다.
최근 3일 릴리스가 바꾼 것
| 버전(KST) | 핵심 변경 | 릴리스 노트가 밝힌 수치 |
|---|---|---|
| v13.29.0 10/3 14:35 |
work_state_write/work_state_read로 할 일 목록을 claude-mem에 보관. openai-compatible 프로바이더 프리셋, Codex 구독 프로바이더, 옵트인 쿼터 폴백 추가 |
— |
| v13.30.0 10/5 07:45 |
훅은 “저장 후 즉시 반환”(hook-spool), SessionStart는 사전 생성 캐시 사용. 관찰자 프롬프트의 앞부분을 고정해 프로바이더 프롬프트 캐시를 재사용. 사용자 프롬프트 단독 관찰자 호출 제거 | 세션 간 공통 프롬프트 접두부 422자 → ~7,260자. Claude 경로에서 thinking 비활성화 옵션이 무시돼 Sonnet 4.5 관찰자 출력 토큰의 약 70%가 thinking에 쓰이던 버그 수정. 2.16GB 트랜스크립트 처리 ~1ms·27MB |
| v13.30.1 10/5 13:37 |
--continue/--resume 때 타임라인을 다시 주입하지 않음(복원 대화의 프롬프트 캐시 보존) |
— |
| v13.31.0 10/5 14:17 |
프로젝트·날짜 인덱스(schema v63)와 커버링 인덱스(v64). 클라우드 동기화가 켜져 있어도 로컬 DB 우선 | 1.2GB DB에서 SessionStart 약 3초(최악 44초) → 쿼리 약 4ms. 별칭 조회 7,499페이지 → 355페이지(9ms) |
요약하면 이번 릴리스들은 “기억이 쌓일수록 느려지고 비싸지는” 문제를 정면으로 다뤘다. 관찰자 LLM 비용은 이 시스템의 숨은 운영비다. 프롬프트 캐시 친화적 구조와 불필요한 호출 제거가 들어간 시점이라 지금 다시 평가해 볼 가치가 있다.
설치와 실행
# 기본 설치 (Node.js 20+, Bun·uv는 없으면 자동 설치)
npx claude-mem install

# 하네스별 설치
npx claude-mem install --ide opencode
npx claude-mem install --ide t3code
npx claude-mem install --ide antigravity
npx claude-mem install --ide omp

# Claude Code 안에서 마켓플레이스로 설치
/plugin marketplace add thedotmack/claude-mem
/plugin install claude-mem

# 운영 점검
npx claude-mem telemetry disable      # 사용 통계 끄기 (DO_NOT_TRACK도 존중)
curl -s http://127.0.0.1:$CLAUDE_MEM_WORKER_PORT/api/health | jq .port
주의할 점이 몇 가지 있다. npm install -g claude-mem은 SDK/라이브러리만 설치하고 훅과 워커는 등록하지 않는다. 대화형 설치는 끝에 cmem.ai 로그인(이메일 매직 링크)을 권하고, 로그인하면 호스팅 “claude-mem observer”를 최대 14일 무료로 쓴다. 체험이 끝나면 Anthropic 플랜 경로로 돌아간다. 로그인 없이 쓰려면 --provider를 명시하거나 CLAUDE_MEM_ONLINE_OPTIN=false를 설정하면 된다. CI처럼 비대화형으로 실행해도 로그인 없이 설치가 끝난다.
// ~/.claude-mem/settings.json (발췌, 주석은 설명용이며 실제 JSON에는 넣지 않는다)
{
  "CLAUDE_MEM_PROVIDER": "claude",              // claude | codex | gemini | openrouter | openai-compatible
  "CLAUDE_MEM_MODEL": "claude-haiku-4-5-20251001",
  "CLAUDE_MEM_CONTEXT_OBSERVATIONS": "50",
  "CLAUDE_MEM_REDACT_ENABLED": "true",          // 기본은 꺼짐: 내장 시크릿 패턴 11종 마스킹
  "CLAUDE_MEM_MODE": "code"
}
저장소 구조 한눈에
src/services/: 워커(worker-service.ts),sqlite/저장 계층,sync/ChromaSync.ts.src/ui/viewer/는 React 뷰어(단일 HTML 번들)다.plugin/: 배포 단위.hooks/hooks.json, 빌드된scripts/(worker-service.cjs,mcp-server.cjs,context-generator.cjs),skills/(mem-search 등),modes/(code,code--zh,code--ja등 관찰 언어·워크플로).- 하네스 어댑터:
openclaw/,cursor-hooks/,claude-mem-cursor/,omp/등. 테스트는bun test기반이다. - 브랜치: 안정판은
main(npm 배포),core-dev·community-edge는 소스에서 직접 실행한다.
대안과 비교
| 접근 | 기억 생성 | 통합 지점 | 강점 / 약점 |
|---|---|---|---|
수동 CLAUDE.md·AGENTS.md |
사람이 작성 | 하네스 기본 기능 | 결정적이고 추가 LLM 비용 0 / 갱신이 누락되고 매 세션 고정 토큰을 씀 |
| claude-mem | 훅 자동 캡처 + 관찰자 LLM 압축 | 코딩 에이전트 하네스 플러그인 + MCP | 손이 거의 안 가고 검색이 단계적 / 관찰자 비용이 들고, 요약 품질이 관찰자 모델에 좌우됨 |
| 범용 메모리 레이어(예: Mem0) | 애플리케이션이 API로 추가·검색 | 자체 앱 코드에 SDK로 내장 | 제품 기능으로 기억을 설계할 수 있음 / 코딩 에이전트 훅은 직접 구현해야 함 |
| 상태형 에이전트 런타임(예: Letta) | 런타임이 메모리 계층 관리 | 에이전트 자체를 그 위에 구축 | 메모리가 런타임의 일급 개념 / 기존 Claude Code·Codex 워크플로를 그대로 쓰기 어려움 |
정리하면 claude-mem의 자리는 “이미 쓰는 코딩 에이전트를 바꾸지 않고 기억만 덧붙이는” 쪽이다. 자체 에이전트 제품에 기억 기능을 설계하는 일과는 문제 정의가 다르다.
어떻게 평가할까
문서에서 확인되는 정량 자료는 두 종류다. 하나는 릴리스 노트의 성능 측정이고, 다른 하나는 Smart Explore 벤치마크다. 후자는 tree-sitter AST 기반 smart_search/smart_outline/smart_unfold를 Glob·Grep·Read 기반 Explore 에이전트와 비교했다. 탐색 단계 약 17.8배, 특정 심볼 읽기 약 19.4배, 전체 흐름 10~12배 토큰 절약을 보고한다. 하지만 이 실험은 claude-mem 자체 코드베이스(TypeScript 194개 파일)에서 5개 질의, Claude Opus 4.6으로 프로젝트 측이 직접 수행한 것이다. 반면 “주입된 기억이 실제로 맞는가, 다음 작업 성공률을 올리는가”를 재는 기억 품질 벤치마크는 공개되지 않았다. 결국 팀이 직접 재야 한다.
- A/B 과제 세트: 같은 저장소에서 여러 세션에 걸친 실제 작업 10~20개를 플러그인 켠 상태와 끈 상태로 나눠 돌리고, 완료율과 사람 개입 횟수를 비교한다.
- 토큰과 관찰자 비용 분리: 에이전트 토큰과 관찰자 토큰을 따로 집계한다(저장소에 비용 리포트 스킬이 있다). 이득이 관찰자 비용을 넘는지 확인한다.
- SessionStart 지연: DB가 커진 뒤(수백 MB 이상) 세션 시작 지연을 다시 잰다. v13.31 이전 버전과 비교하면 회귀 여부도 드러난다.
- 낡은 기억(staleness) 점검: 대규모 리팩터링 뒤 File Read Gate가 오래된 타임라인을 보여 준 사례 수를 센다.
트레이드오프와 주의점
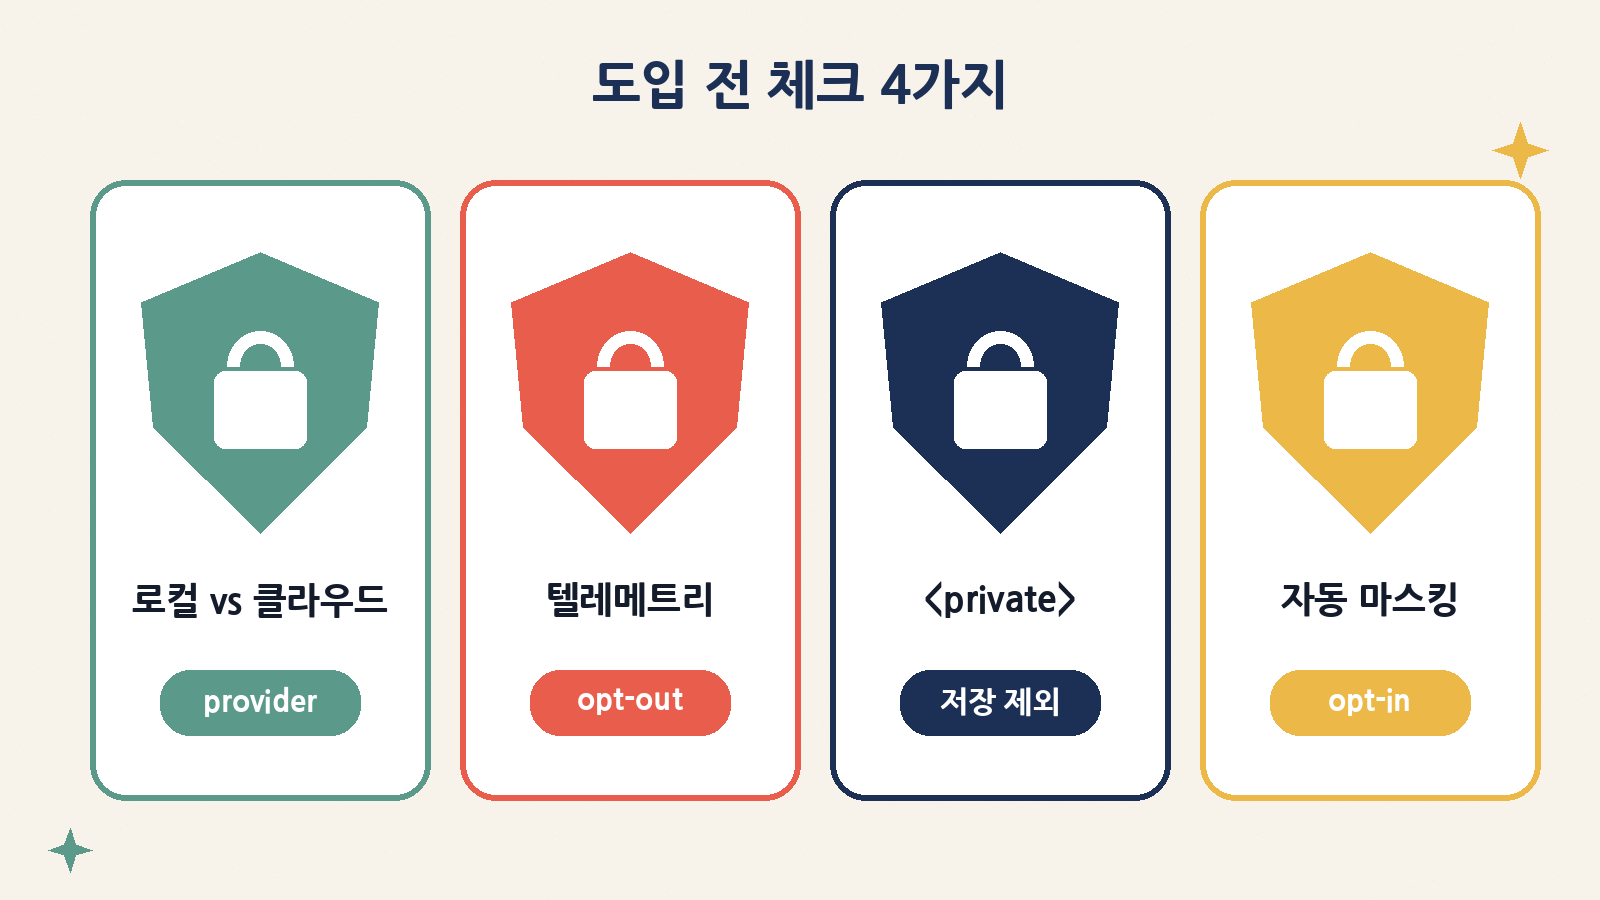
- 데이터 경계: 기본 저장은 로컬이지만, 관찰 압축을 위해 도구 입출력이 선택한 LLM 프로바이더로 전송된다. 사내 코드라면 프로바이더 선택(OpenAI 호환 로컬 엔드포인트 포함)부터 정해야 한다.
<private>태그 안의 내용은 저장되지 않는다. 자동 마스킹은 기본값이 꺼져 있고, 정규식 기반이라 패턴 밖의 비밀값은 걸러내지 못한다. - 텔레메트리: PostHog 익명 사용 통계가 기본으로 켜져 있다(옵트아웃). 문서에 따르면 속성은 화이트리스트로 거르고 검색어·결과 본문은 보내지 않는다. 오류 메시지는 개인정보·비밀값을 지운 뒤 전송한다. 그래도 조직 정책에 따라
DO_NOT_TRACK을 일괄 적용하는 편이 깔끔하다. - 오픈 코어: 코어(엔진·CLI·SDK·MCP·어댑터)는 Apache-2.0이다. 호스팅 클라우드, 팀/조직 동기화, SSO/RBAC, 감사 로그 UI 등은 공개 구현 범위 밖으로 명시돼 있다. 클라우드 백업·동기화는 호스팅 서비스인 CMEM Pro로 제공된다.
- 변경 속도: 13.x 버전이 하루에 여러 번 나오기도 한다. 문서끼리 서술이 어긋나는 곳도 있다. 운영 환경에서는 버전을 고정하고,
npx claude-mem update는 검증한 뒤에 적용하는 것이 좋다. - 거버넌스 점검: README 하단에는 제3자가 만든 “CMEM” 토큰을 제작자가 공식 지지한다는 안내가 있다. 코드와는 무관하지만, 기업 도입 심사라면 확인해 둘 항목이다.
누가 지금 도입하고, 누가 기다릴까
| 상황 | 권고 |
|---|---|
| 개인·소규모 팀, 같은 저장소에서 Claude Code/Codex를 매일 오래 씀 | 지금 시험: 로컬 프로바이더 + 텔레메트리 끔 + 마스킹 켬으로 2주 A/B |
| 규제 산업, 코드 외부 전송이 막힌 조직 | 조건부: OpenAI 호환 사내/로컬 엔드포인트로 관찰자를 돌릴 수 있을 때만 |
| 팀 전체의 공유 기억, SSO·감사가 필요 | 대기 또는 상용 검토: 팀/조직 동기화는 Apache-2.0 공개 범위 밖이다 |
| 자체 에이전트 제품에 기억 기능을 넣으려는 개발팀 | 설계 패턴 차용: 점진적 공개, 훅 스풀, 프롬프트 캐시 친화 구조는 가져다 쓸 만한 패턴 |
claude-mem의 가치는 기능 목록보다 “에이전트 기억은 저장 문제가 아니라 비용·지연·신선도 문제”라는 점을 코드로 보여 준다는 데 있다. 이번 주 릴리스로 그 세 축이 눈에 띄게 다듬어졌다. 도입을 고민했다면 지금이 직접 측정해 볼 좋은 시점이다.