새벽 3시에 알림이 울리면 온콜 엔지니어가 하는 일은 대체로 같다. Grafana에서 지연 그래프를 열고, 같은 시간대 로그를 뒤지고, 최근 배포 목록을 확인하고, 런북을 찾아 읽고, 결론을 Slack에 적는다. 이 반복을 에이전트에게 맡기려는 시도는 많지만, 코딩 에이전트와 달리 프로덕션 장애 대응에는 SWE-bench 같은 공통 훈련·평가 바닥이 없다. 오늘 GitHub Trending Python 일간 목록에 오른 Tracer-Cloud/opensre(OpenSRE)는 바로 그 빈칸을 내세운다. 자기 인프라에서 돌리는 AI SRE 에이전트 프레임워크이자, 장기적으로는 장애 대응 에이전트용 강화학습·평가 환경을 만들겠다는 프로젝트다. 이 글은 저장소 구조와 실행 경로, 안전장치 설계, 박스에서 직접 돌려 본 결과, 도입 전 따져 볼 점을 실무자 관점에서 정리한다.
한눈에 보는 프로젝트 현황
| 항목 | 확인한 값 (10/9 KST 기준) | 해석 |
|---|---|---|
| 저장소 | Tracer-Cloud/opensre (Python, Apache-2.0) |
2026년 1월 13일 생성. README 배지는 ‘public alpha’. 핵심 흐름은 쓸 만하지만 API와 통합은 바뀔 수 있다고 스스로 밝힌다 |
| 별 / 포크 | 11,668 / 1,708 (16:52 KST, GitHub API) | 같은 시각 GitHub Trending Python 일간 4위, ‘오늘 +81’. 전체 일간 목록에는 없지만 Python 카테고리에서 꾸준히 오르는 유형 |
| 기여자 | 약 360명 (API 페이지네이션, 익명 포함) | README 하단에 ‘community-built’를 내세우고 good first issue를 따로 관리 |
| main 상태 | HEAD 2082b19 (10/9 09:06 KST), ‘에이전트 도구 점진 공개’(#6678) |
기본 출력 예산 25,000토큰 상향, GitHub 작업에 앱 연결 필수화 등이 같은 날 들어왔다 |
| 릴리스 | v0.1.2026.10.9 (10/9 10:25 KST) |
날짜형 버전이 매일 자동 발행된다. wheel·sdist와 macOS(arm64·x64)·Linux(arm64·x64)·Windows x64 바이너리, 각 SHA-256 동봉 |
| 코드 규모 (직접 집계) | Python 파일 3,672개, 테스트 제외 약 32만 줄, 테스트 파일 1,197개 | integrations/ 아래 벤더 디렉터리만 85개. README의 ‘60+ 통합’보다 디렉터리가 많은 건 보조·내부 패키지가 섞여 있어서다 |
| 런타임 | Python 3.12 이상 (.tool-versions는 3.13.11), uv, Docker 이미지는 python:3.12-slim |
의존성에 anthropic·openai·litellm·mcp·kubernetes·boto3·slack-sdk·discord.py·OpenTelemetry가 함께 들어 있어 설치 크기가 크다 |
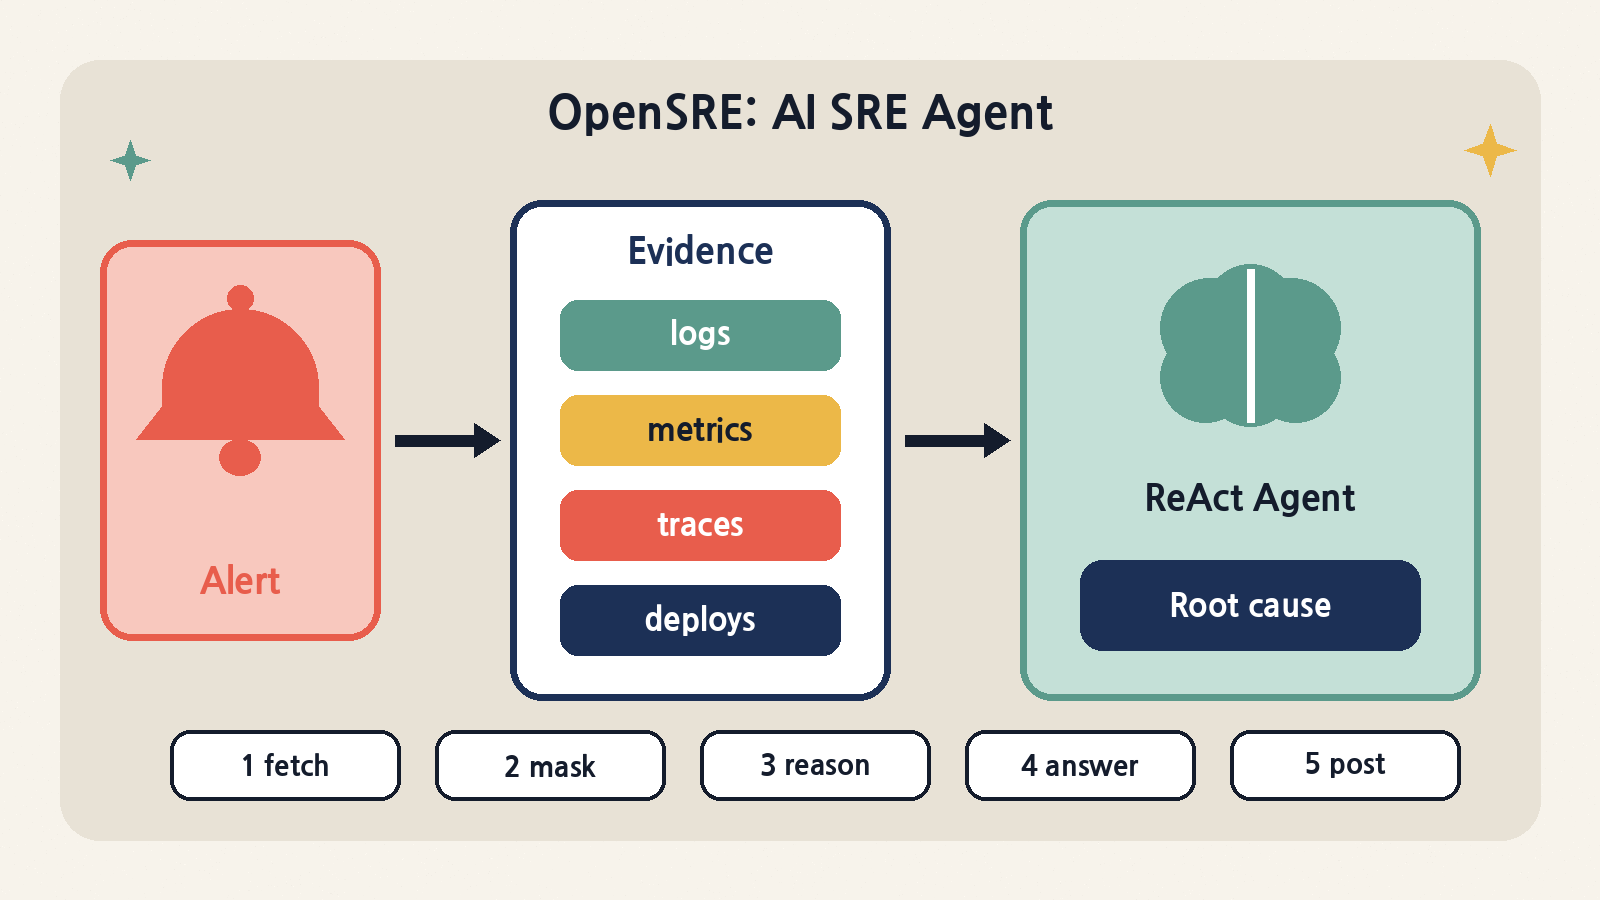
README가 설명하는 한 턴의 흐름은 여섯 단계다. 질문이나 알림이 들어오면 관련 로그·메트릭·트레이스·최근 배포를 가져오고(fetch), 외부 LLM 호출 전에 민감한 식별자를 선택적으로 가리고(mask), 연결된 시스템을 오가며 도구 호출 루프로 가설을 검증하고(reason), 근거가 연결된 답을 내고(answer), 다음 조치를 제안하거나 선택적으로 실행하고(suggest), 요약을 Slack·PagerDuty·Telegram에 올린다(post). 개념 자체는 새롭지 않다. 차이는 이 흐름을 얼마나 단단한 경계 위에 올렸느냐에 있고, OpenSRE의 진짜 볼거리는 그 경계 설계다.
짚어 둘 점이 하나 있다. README의 ‘강화학습 환경’과 ‘AI SRE 벤치마크’는 목표로 적혀 있다. 지금 저장소에 있는 것은 실서비스를 상대로 하는 e2e 시나리오(tests/e2e/ 아래 deploy·grafana_validation·incident_io·install·posthog·quickstart·tempo·trello)와 스케줄러 용량 벤치 정도다. SWE-bench급 공개 장애 시나리오 세트를 기대하고 들어가면 실망한다.
저장소 구조: CI가 강제하는 5계층
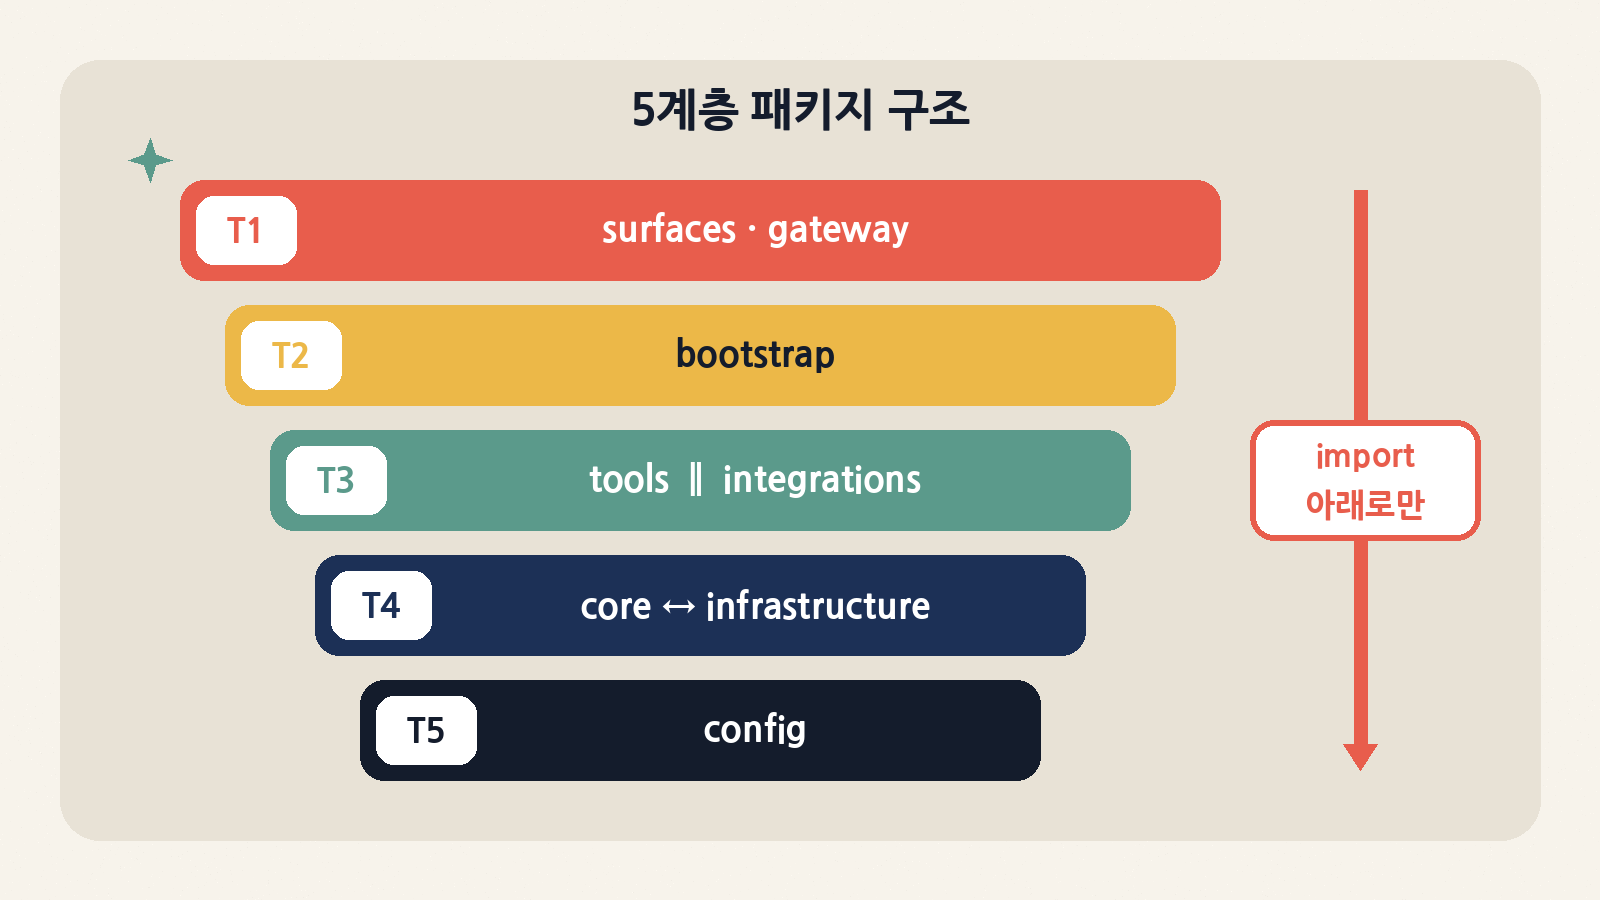
32만 줄짜리 Python 저장소가 버티는 방법은 의존 방향 규칙이다. docs/ARCHITECTURE.md는 여덟 개 1차 패키지를 다섯 계층으로 나누고, 위 계층은 아래를 import할 수 있지만 아래는 절대 위를 import할 수 없다고 못 박는다. 이 규칙은 문서 속 희망 사항이 아니다. make check-imports(import-linter, .importlinter.strict)로 CI에서 검사된다.
| 계층 | 패키지 | 역할 | 가져올 수 있는 것 |
|---|---|---|---|
| Tier 1 (호스트) | surfaces/, gateway/ |
CLI(opensre), 대화형 셸(REPL), Telegram·Slack·Discord·Buzz 게이트웨이, FastAPI 웹(헬스·알림 수신) |
아래 전부. 단 두 호스트끼리는 서로 import 금지(추적되는 예외 3개) |
| Tier 2 (조립 지점) | bootstrap/ |
configure_process(profile)로 프로세스 부팅 순서를 고정하고 어댑터를 등록 |
tools와 integrations를 동시에 가져올 수 있는 유일한 패키지 |
| Tier 3 (능력) | tools/, integrations/ |
벤더 중립 도구 레지스트리 / 벤더별 설정 정규화·검증·클라이언트·도구 | core, infrastructure, config. 둘은 서로 import 금지 |
| Tier 4 (런타임) | core/, infrastructure/ |
ReAct 루프·상태·컨텍스트 예산·도구 계약 / 가드레일·마스킹·샌드박스·턴 호스트·스케줄러 | config. 그리고 서로(의도된 유일한 양방향 쌍) |
| Tier 5 (바닥) | config/ |
공유 상수, 환경 변수 이름, 프롬프트, UI 테마 | 1차 패키지는 아무것도 import하지 않는다 |
설계 의도가 잘 보이는 지점이 두 군데 있다. 첫째, tools와 integrations를 동급(peer)으로 두고 서로 import를 막았다. 한 벤더 전용 도구는 integrations/<vendor>/tools/에 그 벤더의 클라이언트·설정과 함께 둔다. 여러 벤더를 가로지르는 도구만 tools/cross_vendor/에 간다. 그러면 두 묶음을 이어 붙이는 일은 누가 하나? bootstrap/이다. 둘을 동시에 가져올 수 있는 유일한 패키지로 지정해 ‘배선’을 한곳에 몰았다. 둘째, core와 infrastructure만은 의도적으로 양방향이다. core는 가드레일·마스킹·관측을 위해 infrastructure로 가고, infrastructure는 공유 상태와 세션 타입 때문에 core로 돌아온다. 이 둘을 억지로 갈랐다면 순환 import 우회 코드가 곳곳에 생겼을 것이다.
코드 규칙 문서(AGENTS.md)도 이 저장소의 성격을 보여 준다. 공유 환경 변수 이름은 반드시 config/constants/에, HTTP 상태 코드는 HTTPStatus 상수로, __init__.py는 공개 API 재수출만 하라는 식이다. CodeQL이 잡지 못하는 함정(Protocol 스텁의 pass, 함수 내부 import도 순환으로 세는 문제 등)까지 길게 적어 두었다. 사람과 코딩 에이전트가 함께 대량으로 PR을 내는 저장소가 품질을 지키는 방식이다. 특히 눈에 띄는 규칙은 SKILL.md와 시스템 프롬프트는 사람만 고칠 수 있다는 조항이다. 에이전트는 수정안을 제안만 할 수 있고, 사람이 브라우저에서 직접 타이핑하고 diff를 확인하라고 권한다. 에이전트 행동을 결정하는 텍스트를 에이전트가 고치지 못하게 막은 것이다.
핵심 컴포넌트와 한 턴의 데이터 흐름
| 구성 요소 | 경로 | 핵심 동작 |
|---|---|---|
| ReAct 루프 | core/agent/react_loop.py |
LLM에 다음 행동을 묻고 → 도구를 실행해 결과를 되먹이고 → 도구 호출 없이 답하거나 안전 한도에 걸릴 때까지 반복. 루프는 Agent를 모르고 AgentRunInput과 LoopHost 콜백만 받는다 |
| 컨텍스트 예산 | core/context_budget.py |
모델 ID 부분 문자열로 창 크기를 찾는다(claude 200k, gemini 1M 등). 모르는 모델은 보수적인 기본값으로 일찍 잘라 넘침을 막는다 |
| 에이전트 하네스 | core/agent_harness/ |
세션·턴 오케스트레이션. run_turn은 route decide → route execute → answer finalize 세 단계를 섞지 않는다 |
| 턴 호스트 | infrastructure/turn_host |
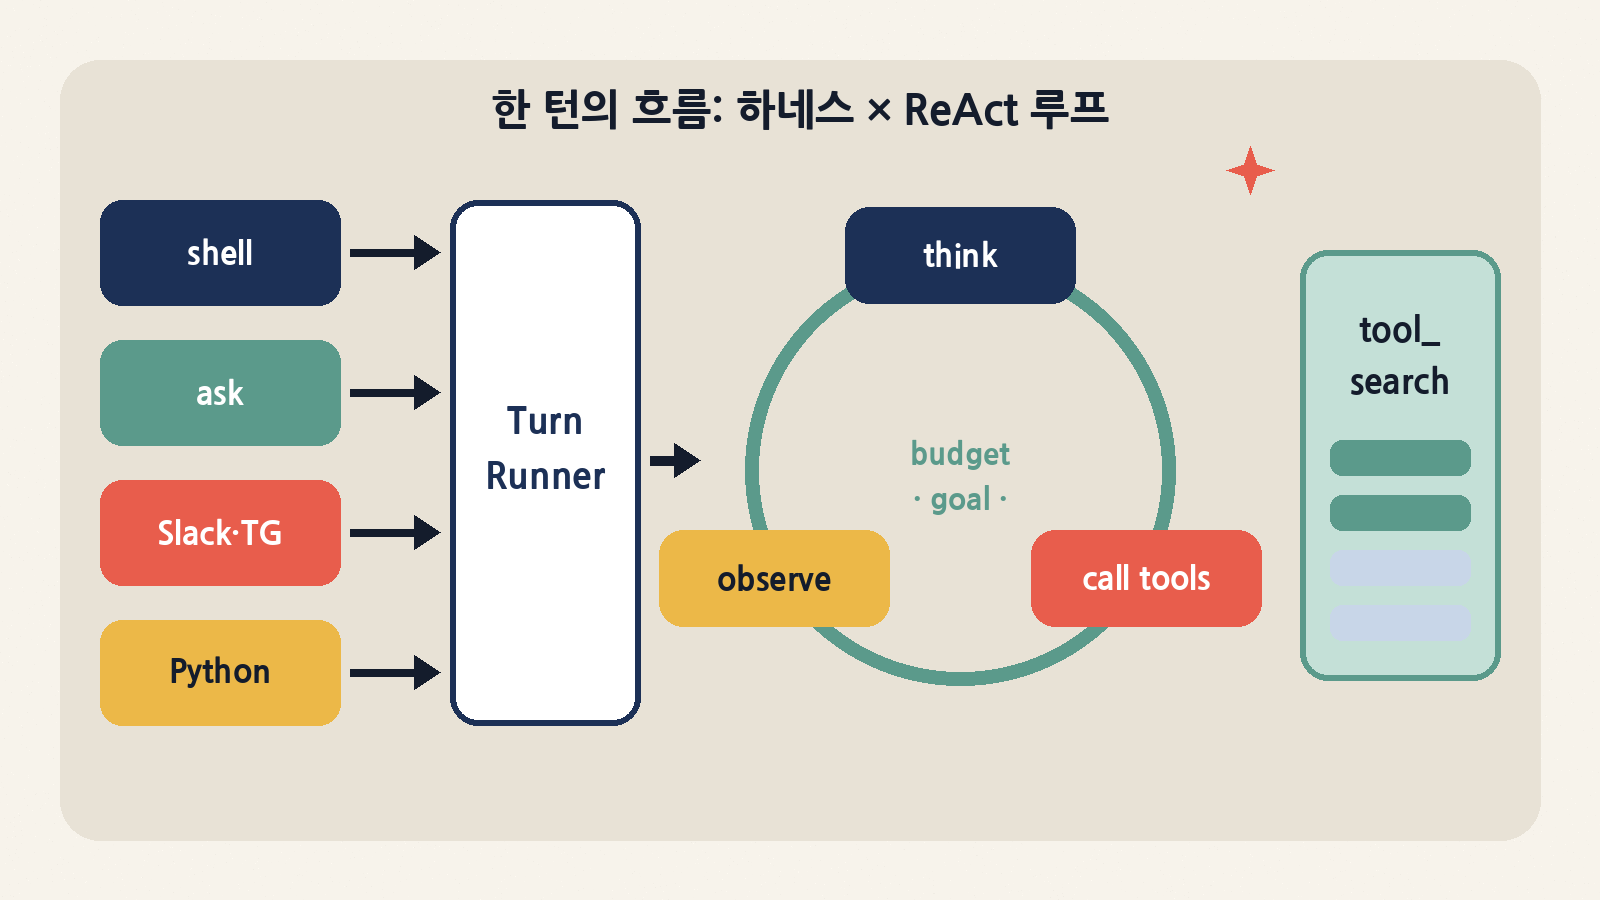
대화형 셸과 모든 게이트웨이가 같은 TurnRunner→SessionAgentPool을 지난다. 입구가 달라도 동작이 갈라지지 않게 하는 장치 |
| 도구 레지스트리 | core/tool/, tools/ |
BaseTool 서브클래스 또는 @tool 함수. 모듈을 넣으면 자동 발견. 큰 카탈로그는 tool_search로 점진 공개 |
| 스킬 카드 | core/agent_harness/prompts/skills/ |
런북 기반 장애 조사, GitHub CI 수리·보고, 머지 충돌·보안 알림 수정, 아침 브리핑, 스케줄링 등. 결정적 파이프라인이 아니라 모델이 읽는 자연어 카드 |
| 세션 목표 | core/agent_harness/session_goal/ |
체크리스트 완료는 session_goal_complete 도구로만 체크. 저가 모델 검증기·판정기가 모델의 자기 보고와 별개로 ‘달성 / 아직 / 불가’를 판정 |
사용자가 대화형 셸에 “checkout-api가 왜 느려?”라고 치든, Telegram으로 같은 말을 보내든, CI가 opensre ask를 부르든 경로는 하나로 모인다. 호스트가 메시지를 TurnRunner에 넘기고, 세션마다 한 번 만들어진 에이전트가 agent.handle()로 턴을 처리한다. 하네스는 ReAct 루프를 돌리며 컨텍스트 예산 안에서 생각하고, 도구를 부르고, 결과를 관찰한다. 도구 디스패치는 bootstrap이 부팅 때 등록한 콜백을 거치므로 core가 tools나 integrations를 직접 import하지 않는다. 벤더 도구는 자기 integration 패키지의 클라이언트와 자격 증명을 쓰고, infrastructure가 그 주변에 가드레일·마스킹·관측을 두른다.
최근 들어온 변화 중 실무적으로 의미 있는 것이 도구의 점진 공개다. 통합이 85개 디렉터리에 이르면 모든 도구 스키마를 매번 LLM에 보내는 것만으로 컨텍스트가 크게 줄고, 모델이 엉뚱한 도구를 고를 확률도 오른다. 이제는 기본 제어 도구와 tool_search만 먼저 보이고, tool_search가 필요한 전문 도구 스키마를 다음 반복에서 활성화한다. 스킬이 활성화되면 그 스킬 전용 스크립트 도구는 곧바로 보인다. 같은 날 기본 출력 예산도 25,000토큰으로 올랐다. 장애 보고서처럼 긴 답을 잘라 먹지 않으려는 조정으로 읽힌다.
하네스 쪽에서 가장 공들인 부분은 ‘에이전트가 끝났다고 말하는 것’을 믿지 않는 장치들이다. 작업 계획(task_plan/)은 도구 결과 없이 단계를 완료로 바꾸지 못하게 막는다. 실패한 도구 호출(ok: false, 0이 아닌 셸 종료 코드)은 완료로 치지 않아서, 이후 성공한 작업이 없으면 멈추기를 거부한다. /goal로 거는 세션 목표는 체크리스트 항목을 전용 도구로만 체크하게 하고, 저가 모델 검증기가 체크를 거부할 수 있으며, 별도 판정 모델이 대화 기록을 보고 달성 여부를 판단한다. 그리고 문서는 반복해서 경고한다. 사용자 문장을 정규식·키워드로 훑어 의도를 라우팅하지 말라. 의도 판단은 에이전트 턴 안의 구조화된 태그와 명시적 API로만 하라는 것이다. 운영 환경에서 ‘반쯤 맞는’ 키워드 라우팅이 만드는 기묘한 버그를 겪어 본 팀이라면 공감할 원칙이다.
설치와 실행: 네 가지 입구
가장 빠른 길은 설치 스크립트다. 기본값은 main의 최신 빌드를 sudo 없이 받는다. 운영 환경이라면 릴리스 노트에 적힌 대로 날짜형 버전을 고정하는 편이 낫다.
# macOS / Linux: main 최신 빌드
curl -fsSL https://install.opensre.com | bash -s -- -gh

# 특정 릴리스로 고정
curl -fsSL https://install.opensre.com | bash -s -- --release --version 0.1.2026.10.9

opensre                      # 대화형 셸 (활성 계정 필요, TTY 필요)
opensre integrations setup   # Grafana, Datadog, Kubernetes 등 연결
opensre integrations verify  # 연결 확인 (셸에서는 /integrations verify)
export OPENSRE_NO_TELEMETRY=1  # 제품 분석 + Sentry 끄기
대화형 셸은 처음 실행할 때 로그인하고 호스티드 모델을 활성화한다. 계정 없이 셸만 쓰는 것은 안 된다. 반면 헤드리스 ask와 Python 임베딩은 로그인하지 않은 머신에서도 LLM_PROVIDER와 공급자 API 키로 돈다. 지원 공급자는 Anthropic, OpenAI, Codex, Ollama, Gemini, OpenRouter, TrustedRouter, NVIDIA NIM, Bedrock이고, OpenAI·Anthropic 호환 사용자 정의 엔드포인트(custom-openai, custom-anthropic)도 있다. 자체 호스팅 모델을 쓰려는 팀에게는 이 점이 중요하다.
# CI·스크립트용 헤드리스 실행
export LLM_PROVIDER=anthropic ANTHROPIC_API_KEY=...
opensre ask -i alert.json -i deployment.md "Correlate the alert with the recent deployment"

# 기계가 읽을 JSON 출력 (--json은 ask 앞에 두는 전역 옵션)
opensre --json ask "investigate the failing CI"
opensre --json ask --resume 489e2ba8 "1"      # needs_input(종료 코드 4)에 답하기

# 필요한 도구만 이번 실행에 허용
opensre ask "inspect the repository and run its focused tests" \
  --allowed-tool shell_run --allowed-tool github_cli
# Python 서비스에 임베딩 (소스 체크아웃 필요)
from bootstrap.embedded import start_embedded_session
session = start_embedded_session()
result = session.chat("why is checkout-api slow?")
if result.answered:
print(result.primary_response_text)임베딩할 때 문서가 강조하는 원칙은 세션 하나에 에이전트 하나, 메시지마다 다시 만들지 말 것이다. 프로세스 부팅(configure_process)과 에이전트 생성은 다른 계층이고, 여러 단계짜리 작업은 chat_until_goal()로 세션 목표 루프를 돈다. 상시 운영은 Docker 이미지의 MODE 환경 변수로 고른다. web은 FastAPI(헬스·알림 수신·비동기 조사, 8000 포트), gateway는 Slack Socket Mode·Telegram 양방향 메시징, scheduler는 cron·루프 전용 워커다.
# 저장소 Dockerfile 기반 자체 호스팅
docker build -t opensre .
docker run -e MODE=web -e LLM_PROVIDER=anthropic -e ANTHROPIC_API_KEY=... -p 8000:8000 opensre
curl http://localhost:8000/health

# AWS EC2 + systemd Telegram 게이트웨이 (AMI를 한 번 굽고 배포)
make build-gateway-image
make deploy-gateway
여러 레플리카를 띄울 때는 함정이 있다. Slack Events API를 쓰는 게이트웨이는 레플리카 간 공유 상태를 위해 DATABASE_URL(Postgres)이 필요하다. 스케줄러 작업 파일은 공유 마운트의 OPENSRE_HOME에 있어야 한다. 그리고 Slack Socket Mode는 소비자가 하나여야 해서 EC2 경로는 SLACK_* 변수를 아예 싣지 않는다. 둘째 소비자가 붙으면 이벤트가 쪼개지기 때문이다.
헤드리스 승인 모델: 기본은 ‘읽기만’
| 옵션 / 동작 | 값 | 운영 의미 |
|---|---|---|
| 읽기 전용 도구 | 자동 실행 | 로그·메트릭 조회 같은 조사 단계는 묻지 않고 돈다 |
| 상태 변경·외부 접촉·부작용 미선언 도구 | 기본 거부 | 도구가 부작용을 선언하지 않으면 위험한 쪽으로 간주한다. 보수적인 기본값 |
--allowed-tool <name> |
이번 프로세스에서만 해당 도구 허용 (반복 지정) | 저장되지 않는다. 모르는 이름은 에이전트 시작 전에 거절 |
--dangerously-bypass-approvals |
승인 대상 도구 전부 허용 | 프롬프트와 연결 통합을 통제하는 신뢰 환경 전용. --allowed-tool과 함께 쓸 수 없다 |
-i / --context-file |
최대 16개, 파일당 64KiB, 합계 128KiB, UTF-8 텍스트만 | 첨부는 ‘신뢰하지 않는 문맥’으로 취급되지만 내용은 LLM 공급자로 간다. 비밀값 점검이 먼저 |
--ephemeral |
재개 가능한 세션 기록을 남기지 않음 | 프롬프트 로깅은 별도. OPENSRE_PROMPT_LOG_DISABLED=1로 끈다 |
| 종료 코드 | 0 완료 · 1 설정/실행 실패 · 2 인자 오류 · 3 승인 거부 · 4 입력 필요 · 130/143 시그널 | CI에서 분기하기 좋다. 4가 나오면 session_id로 --resume |
이 표가 OpenSRE를 CI나 알림 파이프라인에 넣을 때 가장 중요한 부분이다. 상태를 바꾸거나 외부 서비스에 접촉하는 도구는 물론, 부작용을 선언하지 않은 도구까지 기본 거부한다. 새 통합을 붙였는데 메타데이터를 대충 채웠다면 그 도구는 안전한 쪽으로 막힌다. 루트 옵션 --yes가 에이전트 도구를 승인하지 않는다는 점도 의도된 설계다. ‘설치 프롬프트에 예라고 답하기’와 ‘에이전트에게 프로덕션 변경을 허락하기’를 같은 스위치로 묶지 않았다.
LLM 앞의 세 겹 안전장치
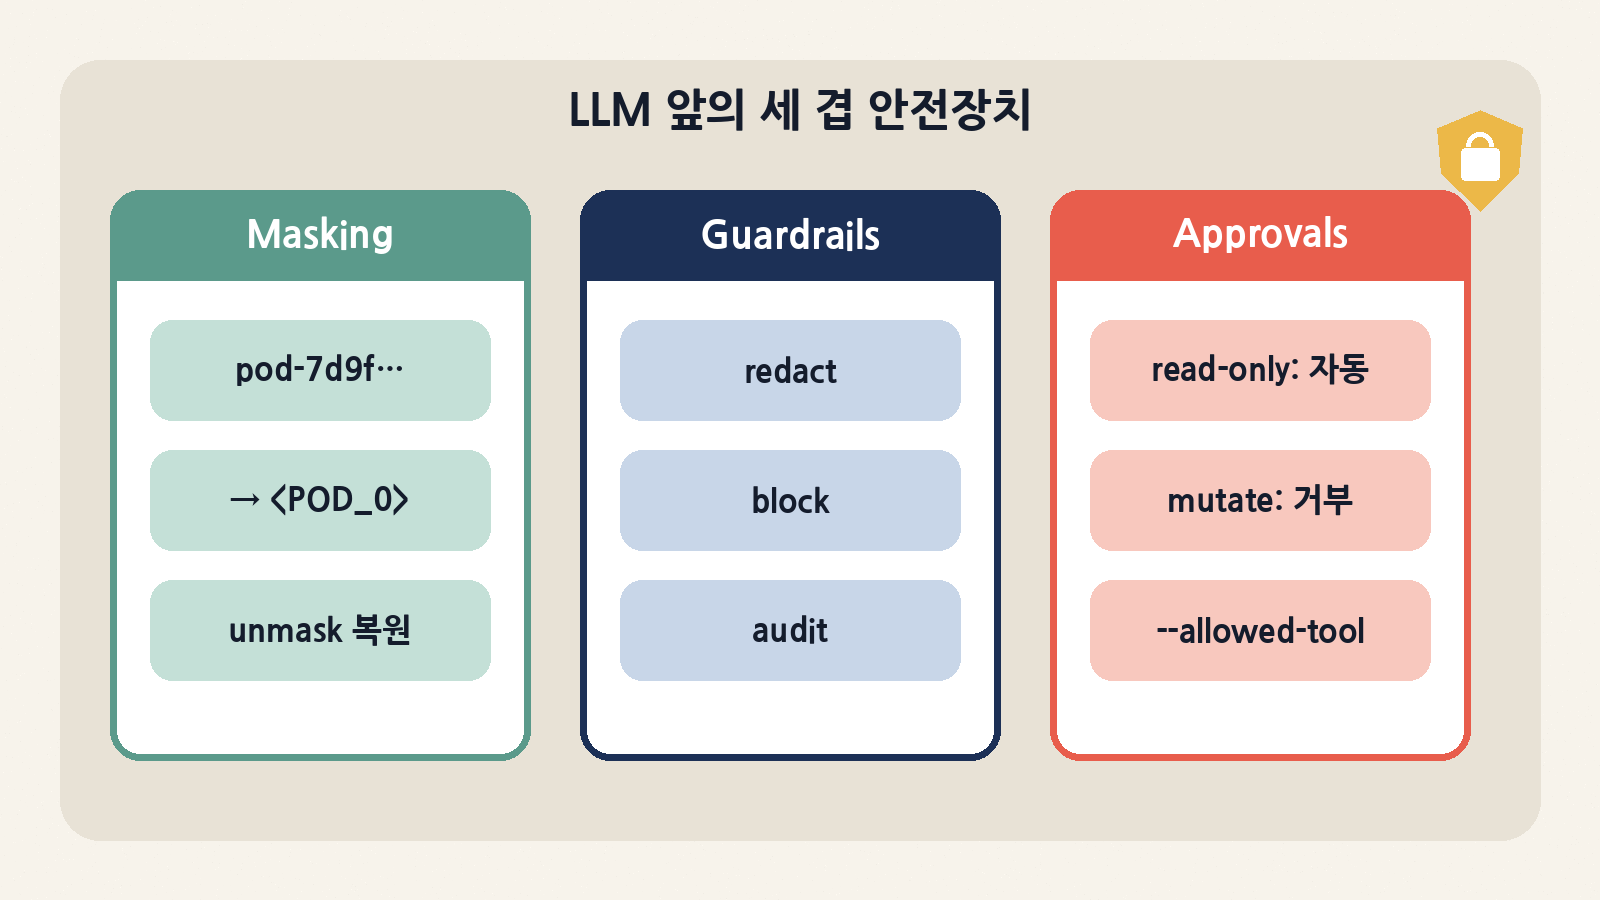
가역 마스킹은 pod·namespace·cluster·hostname·account ID·IP·email·서비스 이름을 <POD_0>, <CLUSTER_1> 같은 안정적인 자리표시자로 바꿔 LLM에 보내고, 사용자에게 보여 줄 출력에서는 원래 값으로 되돌린다. 같은 값은 한 실행 안에서 늘 같은 자리표시자를 받기 때문에, 모델은 “POD_0이 재시작을 반복한다” 같은 추론을 그대로 할 수 있다. OPENSRE_MASK_KINDS로 종류를 고르고 OPENSRE_MASK_EXTRA_REGEX로 사내 패턴을 더한다. 다만 기본값은 꺼짐이다(OPENSRE_MASK_ENABLED=true로 켠다).
가드레일은 일방향이다. ~/.opensre/guardrails.yml의 규칙이 모든 LLM 요청 직전에 메시지 내용을 훑어 redact([REDACTED:<rule>]로 치환), block(GuardrailBlockedError로 요청 거부), audit(기록만)을 적용한다. 일치 내역은 ~/.opensre/guardrail_audit.jsonl에 남는다. 설정 파일이 없으면 아무것도 하지 않으므로 opensre guardrails init을 배포 절차에 넣어야 한다. 정규식은 대소문자를 구분하지 않고, 키워드 목록과 함께 쓸 수 있다.
opensre guardrails init       # 기본 규칙 5개로 시작 파일 생성
opensre guardrails rules      # 규칙 목록
opensre guardrails test "my key is AKIAIOSFODNN7EXAMPLE"
#  [REDACT] aws_access_key: matched 'AKIAIOSFODNN7EXAMPLE'
#  Redacted output: my key is [REDACTED:aws_access_key]

export OPENSRE_MASK_ENABLED=true
export OPENSRE_MASK_KINDS=pod,namespace,cluster,hostname,account_id
세 번째 겹은 앞서 본 도구 승인이다. 세 장치는 역할이 다르다. 마스킹은 ‘모델은 구조를 봐야 하지만 실명은 몰라도 되는’ 식별자를, 가드레일은 ‘절대 나가면 안 되는’ 비밀값을, 승인은 ‘모델이 할 수 있는 행동’의 범위를 맡는다. 개발 문서에는 외부 표면(HTTP 응답, Slack·Telegram 메시지)으로 예외 상세나 스택 트레이스를 보내지 말라는 규칙(CWE-209)도 있다. 로컬 터미널은 예외다.
직접 돌려 본 결과
Linux 박스에서 저장소를 얕게 클론해 실제 LLM이나 외부 서비스 없이 가능한 범위만 확인했다. 사용자 홈을 건드리지 않도록 임시 HOME을 썼고 텔레메트리는 껐다.
| 점검 항목 (박스: Linux x86_64, uv venv Python 3.12.15, 10/9 KST) | 결과 | 메모 |
|---|---|---|
uv sync --frozen → --extra dev |
성공 | 기본 동기화에는 pytest-asyncio·xdist가 없다. 개발 extra까지 받아야 make install과 같은 상태 |
단위 테스트 tests/masking·tests/infrastructure/safety·tests/core (-n 8) |
2,570 passed, 1 failed, 1 xfailed (33.4초) | 실패 1건은 메모리 캐시 테스트(test_an_edited_body_is_re_read). 캐시 키가 파일별 (mtime_ns, 크기)라서, 같은 크기로 고친 내용이 같은 타임스탬프 안에 쓰이면 갱신을 놓친다. 단독 재실행에서도 재현됐고 박스 파일시스템의 타임스탬프 해상도 영향으로 보인다(원인 확정은 못 함) |
opensre --help |
정상 | setup·onboard·ask·doctor·integrations·gateway·cron·guardrails·fleet·remote-sync 등 하위 명령 확인 |
opensre guardrails init / rules / test |
기본 규칙 5개 생성, AWS 키 예제 문자열이 [REDACTED:aws_access_key]로 치환 |
임시 HOME 사용. 기본 규칙: aws_access_key·aws_secret_key·generic_api_token(redact), credit_card·private_key(block) |
| 마스킹 API 직접 호출 | pod·namespace·cluster·IP·email·account가 <POD_0> 형태로 바뀌고 unmask 결과가 원문과 일치 |
MaskingPolicy(enabled=True)로 강제. 실제 런타임 기본값은 꺼짐 |
LLM 키 없이 opensre --json ask |
종료 코드 1, status: error와 해결 명령 안내 |
문서대로 에이전트가 돌기 전에 멈춘다 |
| 실행하지 않은 것 | — | 실제 LLM을 붙인 조사 턴, Grafana·Datadog·Kubernetes 등 실통합, 게이트웨이·EC2 배포, tests/e2e(실서비스 필요), 전체 테스트 스위트 |
테스트 스위트는 넓고 빠르다. core·safety·masking만 2,500개가 넘는 테스트가 30초 남짓에 돈다. 실패한 한 건은 오히려 운영 힌트를 준다. 에이전트 메모리 파일을 같은 길이의 값으로 고치면(예: eks-prod-1→eks-prod-2) 파일시스템의 타임스탬프 해상도에 따라 캐시가 갱신을 놓칠 수 있다. 네트워크 파일시스템이나 일부 컨테이너 오버레이에 OPENSRE_HOME을 둘 계획이라면 한 번 확인해 볼 만하다. 실제 장애 조사 품질은 이번에 재지 않았다. 그 품질은 연결한 모델과 통합, 런북의 질에 크게 좌우되므로 사내 과거 장애 몇 건을 재현해 보는 것이 가장 정직한 평가다.
평가는 어떻게 할까
OpenSRE가 공개 벤치마크 점수를 내세우지 않는 만큼, 도입 평가는 직접 설계해야 한다. 현실적인 순서는 이렇다. ① 지난 분기 장애 5~10건을 골라 당시 알림 JSON과 배포 기록을 파일로 만든다. ② opensre --json ask -i ...로 읽기 전용 조사만 돌리고, 근본 원인 일치 여부·근거 링크의 정확성·걸린 시간과 토큰(/cost)을 기록한다. ③ 가드레일 감사 로그와 마스킹 결과를 보며 무엇이 밖으로 나갔는지 확인한다. ④ 같은 시나리오를 모델만 바꿔 다시 돌린다. JSON 출력과 종료 코드가 안정적이라 이 과정을 스크립트로 묶기 쉽다. 저장소의 tests/e2e/ 시나리오(Grafana·Tempo 검증 등)는 실제 클라우드 자원이 필요하지만 시나리오 설계 방식을 보기에 좋다.
대안과 비교
| 도구 | 형태 | 강점 | OpenSRE와의 차이 |
|---|---|---|---|
| OpenSRE | 범용 AI SRE 에이전트 프레임워크 + 게이트웨이 + 스케줄러 | 60개 이상 통합, CLI·REPL·Slack·Telegram·Python 임베딩, 가드레일·마스킹·승인 체계, 스킬 카드 | 기준점. 범위가 넓은 만큼 의존성과 학습량이 크고 아직 알파 |
| HolmesGPT | 오픈소스 AI 조사 에이전트 (Robusta 출신, CNCF 샌드박스) | Kubernetes·관측 도구 중심 조사, 툴셋 확장 구조 | 목적은 비슷하지만 OpenSRE는 메시징 게이트웨이·스케줄 루프·로컬 코딩 에이전트 플릿 모니터링까지 한 저장소에 담았다 |
| K8sGPT | Kubernetes 진단 CLI·오퍼레이터 | 클러스터 상태를 분석기로 먼저 거르고 LLM은 설명에 사용. 가볍고 범위가 분명 | ReAct 도구 루프로 여러 시스템을 넘나드는 상관 분석은 OpenSRE 쪽이 넓다. 반대로 K8s 전용이면 K8sGPT가 훨씬 단순 |
| 상용 AI SRE·AIOps | 관측 플랫폼·인시던트 관리 제품의 AI 기능 | 자사 데이터와 긴밀한 통합, 운영 지원 | 데이터가 벤더 안에 머문다. OpenSRE는 자기 인프라에서 돌리고 모델을 고르는(BYO LLM) 쪽 |
| 직접 만든 런북 봇 | 스크립트 + LLM API | 작고 통제가 쉽다 | 도구 계약·승인·마스킹·세션 재개·평가를 다 다시 만들어야 한다. OpenSRE는 그 바닥 공사를 이미 해 둔 셈 |
정리하면 OpenSRE는 ‘한 가지를 잘하는 도구’보다 장애 대응 에이전트를 만드는 플랫폼에 가깝다. Kubernetes 하나만 보면 되는 팀에게는 과하다. 반대로 관측·클라우드·DB·데이터 파이프라인·메시징이 뒤섞인 환경에서 여러 시스템을 넘나드는 상관 분석을 원하고, 모델 선택권과 데이터 경로를 직접 쥐고 싶은 팀에게는 지금 공개된 선택지 중 가장 범위가 넓은 축에 든다. 대가는 설치 크기, 빠른 변경 속도, 그리고 아직 알파라는 사실이다.
라이선스·보안·운영 주의점
| 위험 | 어디서 생기나 | 완화책 |
|---|---|---|
| 프로덕션 데이터의 외부 LLM 전송 | 로그·트레이스·첨부 파일이 프롬프트로 들어감 | 마스킹(OPENSRE_MASK_ENABLED=true)과 가드레일(~/.opensre/guardrails.yml)을 명시적으로 켠다. 둘 다 기본은 꺼짐/무규칙. 가능하면 Bedrock·Ollama 등 내부 경로 모델 |
| 자동 조치의 폭주 | 상태 변경 도구, --dangerously-bypass-approvals |
CI에서는 --allowed-tool로 필요한 도구만. 통합 자격 증명 자체를 읽기 전용 역할로 발급 |
| 프롬프트 인젝션 | 알림 본문·로그·이슈 텍스트에 섞인 지시문 | 첨부는 비신뢰 문맥으로 다루지만 완전한 방어는 아니다. 쓰기 권한 도구와 비신뢰 입력을 같은 턴에 두지 않는 구성 |
| 공개 노출된 게이트웨이 | EC2 배포의 웹 API 인그레스 기본값 0.0.0.0/0 |
OPENSRE_WEB_API_INGRESS_CIDR로 대역 제한, TELEGRAM_ALLOWED_USERS 지정 |
| 텔레메트리 | 제품 분석(app.opensre.com)과 Sentry가 opt-out 방식 | OPENSRE_NO_TELEMETRY=1 또는 DO_NOT_TRACK=1. 망분리 환경이면 이미지에 미리 박아 둔다 |
| 빠른 변경 속도 | 매일 자동 릴리스, 알파 단계 API | --release --version으로 버전 고정, 업데이트 전 스테이징 검증 |
| 호스티드 계정 의존 | 대화형 셸은 활성 계정이 있어야 열림 | 헤드리스 ask·Python 임베딩은 LLM_PROVIDER+키로 계정 없이 동작. 셸 사용 정책을 미리 정한다 |
- 라이선스: Apache-2.0. 상업적 사용·수정·재배포가 가능하고 특허 조항이 있다. 다만 설치 스크립트가 받는 빌드와 호스티드 모델·크레딧(
opensre credits)·클라우드 관리형 게이트웨이는 Tracer의 서비스다. 오픈소스 코드와 호스티드 서비스의 경계를 구분해서 계약·보안 검토를 해야 한다. - 제품 연락 조항:
SECURITY.md에는 계정을 만들거나 설치하면 피드백·업데이트 관련 연락을 받을 수 있다는 문구가 있다. 사내 배포 전 법무·보안팀이 읽어 둘 대목이다. - 취약점 신고: 공개 이슈가 아니라 support@opensre.com으로 비공개 신고를 요구한다. 보안 태세는 별도 Trust Center에 정리돼 있다.
- 로컬 코딩 에이전트 플릿:
opensre fleet은 같은 머신의 Claude Code·Cursor·Codex 등을 감시한다. 편리하지만 개발자 PC에 설치할 때는 무엇을 읽는지 사용자에게 알려야 한다. - 저장소 AGENTS.md 비주입: 하네스는 조사 대상 저장소의
AGENTS.md를 에이전트 프롬프트에 넣지 않는다고 명시한다. 남의 저장소 문서가 지시문이 되는 경로를 하나 끊은 셈이다.
누가 도입하면 좋은가
- 관측 스택이 여러 벤더에 흩어진 플랫폼·SRE 팀: Grafana(Loki·Mimir·Tempo), Datadog, CloudWatch, Sentry, Kubernetes, PagerDuty를 한 에이전트가 오가게 할 수 있다. 첫 단계는 읽기 전용
ask로 과거 장애 재현이다. - AI SRE 에이전트를 직접 만들려던 팀: 도구 계약, 승인, 마스킹, 세션 재개, 게이트웨이, 스케줄러를 다시 짓지 않고 스킬 카드와 통합만 더하면 된다. 5계층 규칙을 따르는 기여 비용은 감수해야 한다.
- 신중해야 할 경우: 외부 LLM으로 운영 데이터를 보낼 수 없는데 내부 모델 경로가 준비되지 않은 조직, 자동 조치까지 바로 원하는 조직(알파 단계에서 쓰기 권한은 이르다), 버전 고정과 스테이징 없이 매일 업데이트를 받으려는 환경.
OpenSRE의 가치는 ‘AI가 장애 원인을 찾아 준다’는 약속보다 그 약속을 운영 가능하게 만드는 경계에 있다. 의존 방향을 CI로 강제하고, 모든 입구를 한 턴 호스트로 모으고, 끝났다는 모델의 말을 도구 증거로 검증하고, 읽기 외의 행동은 기본으로 막는다. 도입한다면 텔레메트리를 끄고, 가드레일과 마스킹을 켜고, 버전을 고정한 뒤, 읽기 전용 헤드리스 조사로 사내 과거 장애부터 재 보는 순서를 권한다.