코딩 에이전트에게 “이 저장소 보안 감사 좀 해 줘”라고 맡기면 보통 두 가지 문제가 생긴다. 하나는 컨텍스트가 금방 차서 저장소의 일부만 보고 끝난다는 것, 다른 하나는 자기가 찾은 버그를 자기가 채점한다는 것이다. 그러면 “exec()가 실행된다, 고로 치명적 취약점” 같은 동어반복 보고서가 쌓인다. cloudflare/security-audit-skill은 Cloudflare 보안팀이 사내 취약점 탐지 하네스를 만들기 전에 실제로 쓰던 단일 저장소용 감사 스킬을 MIT로 공개한 것이다. 오늘(2026-10-21) GitHub Trending 전체 일간 2위(오늘 +1,712 stars)에 올라 있다.
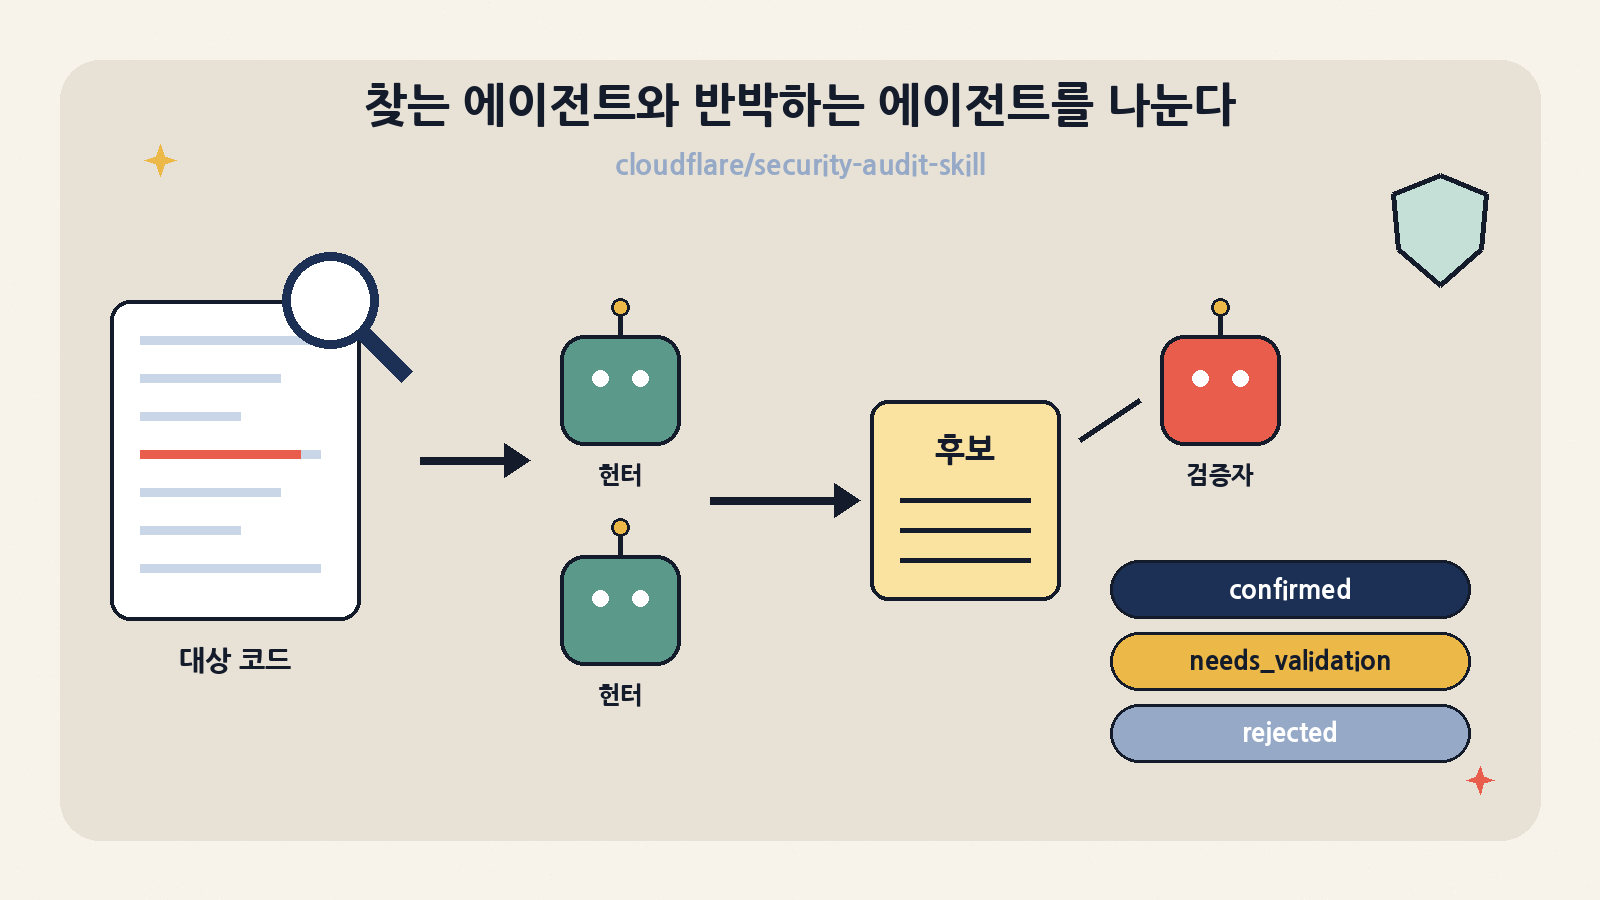
핵심 아이디어는 단순하다. 탐지(헌터)와 판정(검증자)을 서로 다른 새 에이전트로 쪼개고, 진행 상태는 대화가 아니라 coverage-ledger.json·findings.json 같은 파일에 남기며, 그 파일의 형식은 의존성 없는 Node 검증기 두 개가 기계적으로 막는다. 이 글은 ① 저장소 구조와 6단계 워크플로, ② 커버리지 원장과 세 판정(confirmed/needs_validation/rejected) 계약, ③ 샌드박스·쓰기 격리라는 신뢰 경계, ④ 비용 예산 규칙, ⑤ 비슷한 도구와의 차이를 실무자 눈높이에서 뜯어본다. 그리고 박스(리눅스 VM)에서 API 키 없이 공식 테스트와 직접 만든 정상·비정상 입력 20여 개로 검증기를 돌려, 무엇을 막고 무엇을 그냥 통과시키는지 확인했다. 수치는 모두 2026-10-21 11:51~11:56 KST에 실측했거나 저장소·GitHub API·Cloudflare 블로그에서 확인한 값이다.
한눈에 보기: 오늘 기준 스냅숏
| 항목 | 값 |
|---|---|
| 저장소 | github.com/cloudflare/security-audit-skill · 생성 2026-06-18 23:08 KST · 기본 브랜치 main |
| 라이선스 | MIT (Copyright 2025-2026 Cloudflare, Inc.) |
| 버전 | GitHub Release·태그 없음. 사실상의 버전은 커밋 — HEAD c1c8a8c “Clarify guidance and full audit modes”(2026-09-15 04:28 KST). 전체 커밋 14개, 작성자 5명 |
| GitHub 지표 | 34,411 stars · 2,157 forks · 열린 이슈+PR 72건 (GitHub API, 11:52 KST) |
| Trending | 전체 일간 #2(오늘 +1,712). 1위는 이미 다룬 ai-job-search |
| 구성 | 파일 22개: 마크다운 15개(약 18만 3천 바이트) + report-schema.json(461줄) + 검증기 2개와 테스트 2개(.cjs, 합계 약 3,000줄) |
| 런타임 요구 | 도구 호출과 병렬 서브에이전트를 지원하는 코딩 에이전트 + Node.js(검증기용) + OS 수준 샌드박스(대상 코드를 실행할 때만) |
| 출처 맥락 | Cloudflare 블로그 “Build your own vulnerability harness”(2026-06-18)와 함께 공개. 블로그는 이 스킬이 128개 저장소를 도는 사내 VDH/VVS 파이프라인의 출발점이라고 설명 |
왜 지금 주목받나: ‘하네스’의 씨앗을 그대로 꺼내 놓았다
저장소 자체는 4개월 전에 만들어졌고 마지막 커밋도 9월 중순이다. 그런데도 오늘 트렌딩 상위에 오른 건, 에이전트에게 보안 리뷰를 맡기는 흐름이 실무로 내려오면서 “그럼 결과를 어떻게 믿느냐”는 질문의 답으로 이 스킬이 다시 회자되고 있기 때문으로 보인다. 실제로 열린 이슈·PR은 10월 들어 계속 늘고 있다(10-20 하루에만 PR #82~#85, 이슈 #80·#81). 내용도 대부분 원장 상태 전이, 완료 조건, Windows 검증기 같은 계약의 빈틈을 메우자는 것이다.
| 시점(KST) | 변화 |
|---|---|
| 2026-06-18 | Initial commit, 블로그 공개와 동시 |
| 06-24 ~ 06-29 | #2 파일을 skills/security-audit/로 옮겨 npx skills add 호환 |
| 07-02 ~ 07-03 | #4 trace 단계 순서(entrypoint → propagation → sink) 검증 추가 |
| 07-04 | #3 메모리 안전성·바이너리·커널 동반 문서 추가 |
| 07-06 | #6 AI/LLM, HTTP 프로토콜·인증, 클라이언트 측 동반 문서 추가, 문체 통일 |
| 09-10 | #12 “워크플로·findings 계약·검증기를 처음부터 끝까지 재작업” — 현재 구조의 뼈대 |
| 09-15 | guidance 모드와 full audit 모드 구분 명확화 (HEAD) |
| 10월 (열린 PR) | #63 CLI 추가 인자 거부, #75 Windows 검증기·CI, #76 신뢰할 수 없는 대상의 git·심볼릭 링크 하드닝, #84 terminal 원장에서 in_progress 거부, #85 run-metadata.json 검증 |
저장소 구조: 코드가 아니라 ‘프롬프트 + 계약 + 검증기’
이 저장소에는 실행 엔진이 없다. 오케스트레이션은 사용자의 코딩 에이전트(Claude Code, Codex, OpenCode 등)가 맡고, 저장소는 그 에이전트가 따라야 할 절차서와 결과물이 지켜야 할 형식 계약, 그 계약을 확인하는 결정적 코드만 제공한다. SKILL.md가 진입점이고, 나머지 문서는 필요한 단계·도메인에서만 읽히는 동반 문서다.
| 파일 | 규모 | 역할 |
|---|---|---|
SKILL.md |
192줄 / 3,115단어 | 모드 구분, 실행 안전 규칙, 쓰기 격리, 프로필·예산, 핵심 원칙, 안티패턴 10개 |
RECONNAISSANCE.md |
156줄 | 1단계: 정찰 에이전트 4종(1a~1d) 프롬프트, 원장 시드 규칙 |
HUNTING.md |
251줄 / 3,066단어 | 2단계: 헌터 프롬프트, 후보 게이트 7조, 승격 절차, 커버리지 비평가 웨이브 |
ATTACK-CLASSES.md |
130줄 | 공통·와일드카드·“뻔한 것” 공격 클래스 |
| 도메인 동반 문서 10개 | 73~105줄씩 | AI·LLM, 웹 프로토콜·인증, 클라이언트, 공급망, 클라우드, RPC·메시징, 자원 고갈, 데이터 격리, 데스크톱·모바일·IPC, 메모리 안전성 |
VALIDATION-AND-REPORTING.md |
186줄 | 3~6단계: 후보 검증자 프롬프트, findings 작성, 재검증, 보고서 3종 |
report-schema.json |
461줄 | 세 판정의 oneOf 스키마 |
validate-findings.cjs |
773줄 | 스키마 해석기 + 판정별 의미 검사 |
validate-coverage-ledger.cjs |
872줄 | 원장 단위의 상태·소유자·증거 검사 |
| 테스트 2개 | 652줄 / 740줄 | node --test용, 적대적 입력(제어 문자, 심볼릭 링크 등) 포함 |
두 가지 모드: 불러오는 것과 감사를 시작하는 것은 다르다
9월 15일 커밋의 요점은 “스킬을 불러왔다고 전체 감사를 시작하는 건 아니다”라는 구분이다. 보안 질문이나 특정 버그 조사는 guidance 모드로 필요한 부분만 쓰고, 파일을 만들지 않는다. “이 코드베이스를 감사해 줘”, “침투 테스트 해 줘”, “보고서 파일로 줘”처럼 명시적으로 요청할 때만 full audit 모드로 6단계를 모두 돈다. 어느 쪽인지 애매하면 파일을 만들기 전에 한 번 묻도록 돼 있다.
| guidance 모드 | full audit 모드 | |
|---|---|---|
| 시작 조건 | 보안 질문, 특정 리뷰, 방법론, 특정 발견 조사 | 명시적 감사·펜테스트, ‘전체/종합/끝까지’, 보고서 산출물 요청 |
| 단계 | 필요한 부분만 | 1~6단계 전부, 순서대로 |
| 파일 생성 | 하지 않음 (대상 코드가 만든 파일도 남기지 않음) | 출력 디렉터리에 메타·원장·findings·보고서 3종 |
| 서브에이전트 | 필요하면 집중 에이전트를 띄우되 결과는 현재 대화로 | 정찰 4종 + 헌터 웨이브 + 비평가 + 검증자 |
| 출력 위치 | — | 기본 ~/security-audit-skill/<repo>/run-<N>. 대상 저장소 안은 VCS가 무시하는 디렉터리를 사용자가 지정할 때만 |
| 종료 조건 | 답변 | (a) 6단계 산출물 + 검증기 2개 통과, 또는 (b) run_status: "incomplete"와 정확한 사유 기록. 단계 중간 종료 금지 |
6단계 워크플로와 산출물
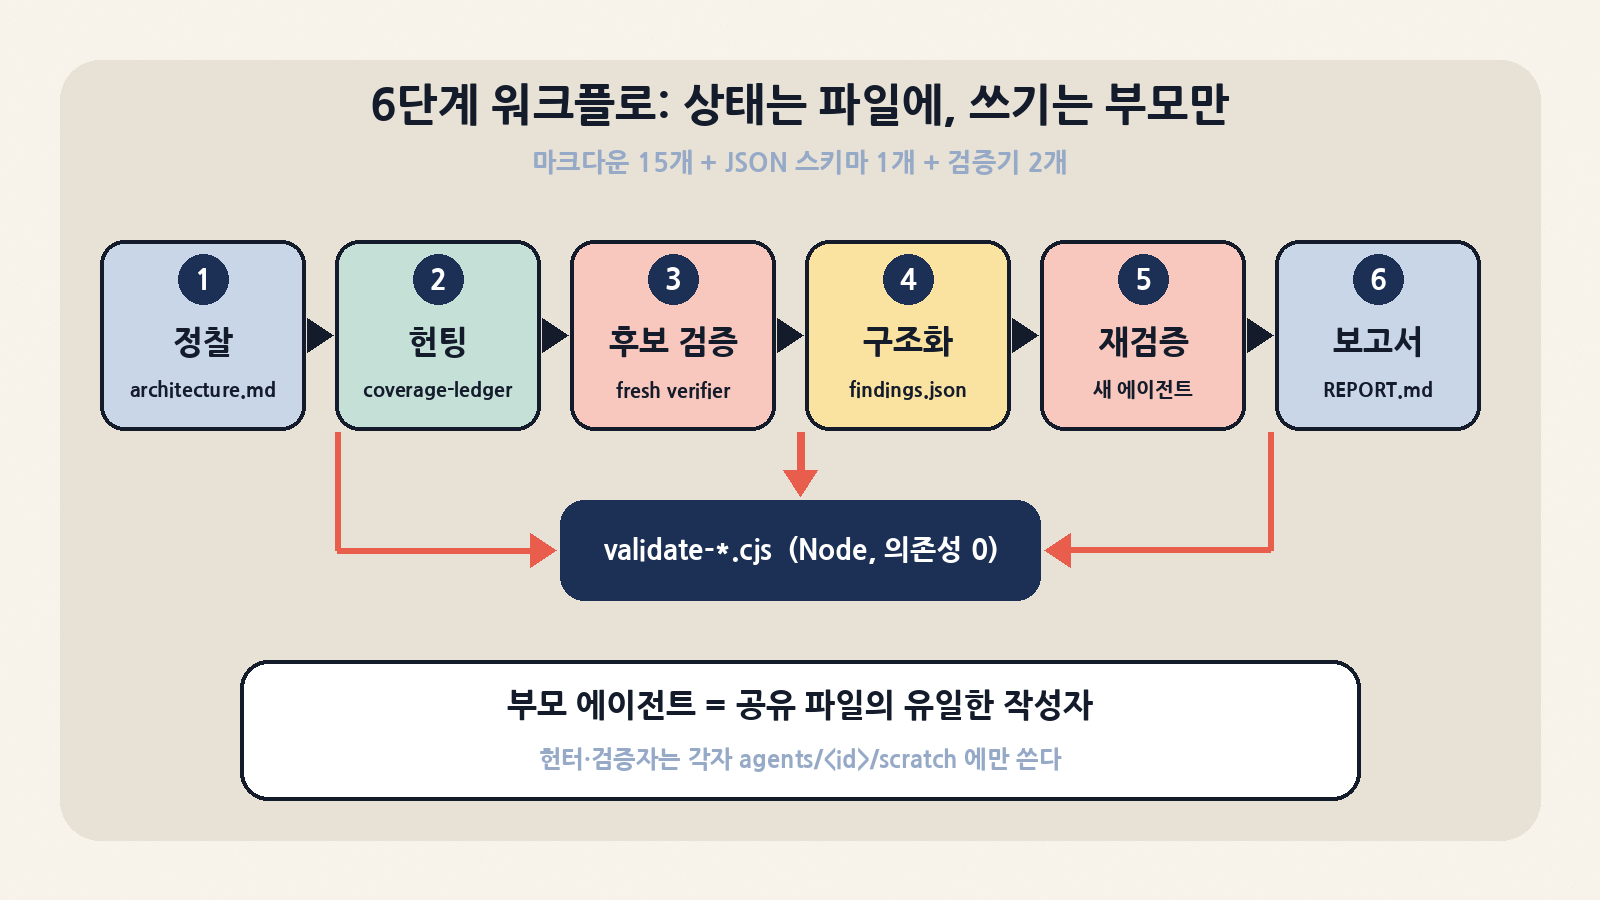
| 단계 | 하는 일 | 산출물 / 기계 검사 |
|---|---|---|
| 1. 정찰 | research 에이전트 4종 병렬: 1a 제품·스택·오프라인 빌드, 1b 주체·권한·통제, 1c 입력면·복사본·싱크, 1d 로컬 실행 가능성·배포 가시성. 네트워크 사용 금지, 파일 쓰기 금지 | run-metadata.json, architecture.md, coverage-ledger.json(부모가 작성) → 원장 검증기 |
| 2. 헌팅 | 원장 단위(표면×경계×서브시스템×공격 클래스)마다 격리된 헌터 배정. 웨이브가 끝나면 커버리지 비평가가 빈칸을 찾음 | 헌터별 구조화 결과(JSON), 원장 갱신 → 원장 검증기 |
| 3. 후보 검증 | 지문(fingerprint)으로 중복 제거 후, 후보마다 그 후보를 찾지 않은 새 검증자가 반증 시도 | 판정 초안 |
| 4. 구조화 | 세 판정을 findings.json에 기록 |
validate-findings.cjs + 원장 검증기 |
| 5. 독립 재검증 | 새 에이전트가 최종 레코드의 소스 주장을 다시 확인. 내용이 크게 바뀌면 또 다른 검증자 | 교체 시마다 findings 검증기 재실행 |
| 6. 보고 | 검증된 레코드와 원장에서만 파생. 라이브 프로빙 지시 금지 | REPORT.md, FINDINGS-DETAIL.md, NEEDS-VALIDATION.md |
눈여겨볼 점은 Cloudflare가 블로그에서 말한 세 가지 벽(컨텍스트 고갈, 중간 실패 시 처음부터 다시, 저장소 간 추론 불가) 중 앞의 두 개를 파일 기반 상태로 부분적으로 완화한다는 것이다. 원장과 이전 findings를 다음 실행이 읽고 이어 가므로 “여러 번 돌리면 누적된다”. 반면 저장소 간 추적은 이 스킬의 범위 밖이고, 블로그도 그건 하네스(데이터베이스 + 오케스트레이터)의 몫이라고 선을 긋는다.
커버리지 원장: ‘봤다’를 셀 수 있게 만드는 장치
원장의 한 단위는 canonical_refs의 네 값(surface, boundary, subsystem, attack_class)으로 정의되고, coverage_id는 이 네 값을 퍼센트 인코딩해 ::로 이은 결정적 문자열이다. 박스에서 실제로 계산해 보니 src/router.ts#POST /users/:id 같은 입력은 src%2Frouter.ts%23POST%20%2Fusers%2F%3Aid::src%2Fauthz.ts%23requireOwner::…가 됐고, 임의 값을 넣으면 검증기가 기대값을 보여 주며 거부했다. 같은 단위는 실행이 바뀌어도 같은 ID를 가지므로 이전 실행과 대조할 수 있다.
| status | 의미 | 검증기가 강제하는 조건 |
|---|---|---|
planned |
배정 전 | agent_id는 null이어야 함 |
in_progress |
헌터가 작업 중 | 정규 소문자 agent ID 필수 (^[a-z0-9][a-z0-9_-]{0,63}$, con·nul·com1 등 Windows 장치명 금지) |
covered |
확인 완료 | reviewed_paths와 local_checks가 비어 있으면 거부 |
candidate |
후보 발견 | result_fingerprints 필요 (다른 상태에서는 비어 있어야 함) |
blocked |
막힘 | 소유자 ID와 unresolved 사유 필요 |
deferred / out_of_scope / not_applicable |
미룸·범위 밖·해당 없음 | 미배정 상태 유지 + 사유 기록. 범위 밖은 절대 covered로 쓰지 않음 |
이전 실행과의 관계는 prior_status 11개 값(prior_confirmed_same_source, prior_covered_changed_source, prior_rejected_claim_changed 등)으로 표현한다. 원칙은 “이전 소스 ref가 같다는 것만으로는 바뀌지 않았다는 증거가 아니다”이다. 이전에 확인된 취약점도 현재 소스가 그대로일 때만 이어받고, 그래도 현재 검증 경로를 다시 통과해야 한다. 이전 quick 실행이나 범위 지정 실행은 “나머지는 괜찮다”는 뜻이 절대 아니다.
세 판정 계약: 심각도는 confirmed에만
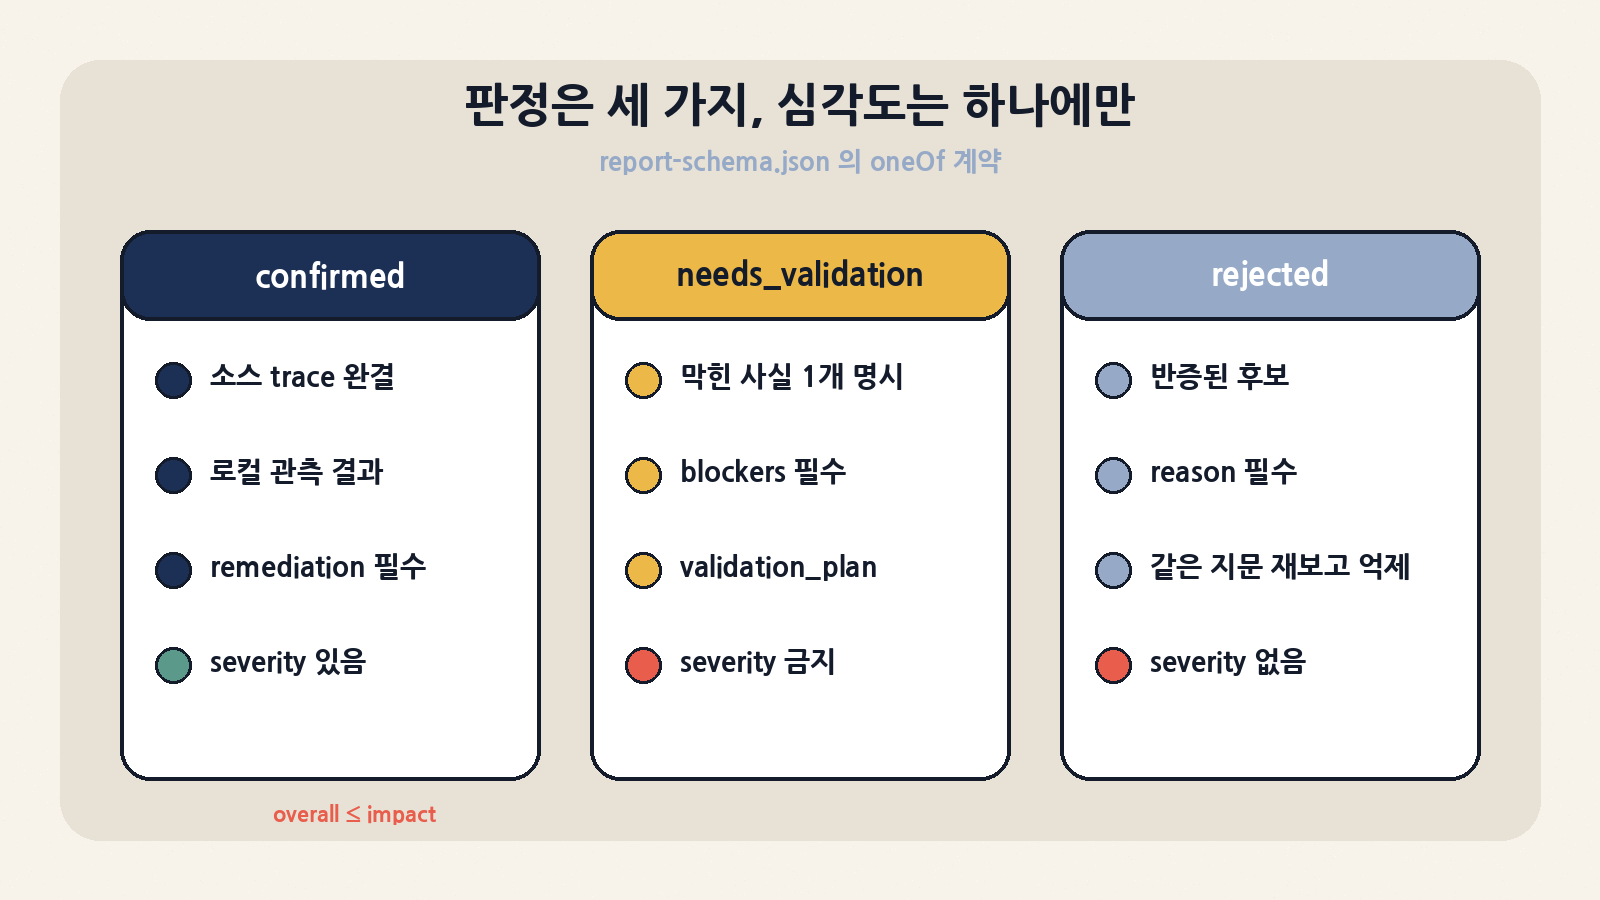
| confirmed | needs_validation | rejected | |
|---|---|---|---|
| 필수 필드 | fingerprint, title, description, root_cause, intended_behavior, trace, evidence, conditions, execution(공격자 관점·페이로드·절차·관측 결과), remediation, severity, confidence | fingerprint, title, description, claimed_root_cause, trace, evidence, blockers, validation_plan(local 또는 deployment) | fingerprint, title, description, claimed_root_cause, trace, evidence, reason |
| severity | 필수. likelihood·impact·overall, overall은 impact를 넘을 수 없음 | 있으면 거부 | 없음 |
| 의미 | 완결된 소스 trace + 제한된 로컬 관측 결과 | 소스로 뒷받침되지만 결정적 사실 하나가 막힌 가설 | 소스로 반증된 후보 |
| 흔한 오용 | 체크리스트 위반을 취약점으로 격상 | ‘확신 낮은 confirmed’로 쓰는 것 | 반증 안 된 후보를 여기로 치우는 것 |
스키마 외의 의미 검사도 꽤 촘촘하다. 배열은 fingerprint 사전순 정렬·중복 금지, trace는 entrypoint로 시작해 sink로 끝나고 중간은 모두 propagation, 파일 경로는 저장소 상대 경로만(../·절대 경로·제어 문자·Windows 예약 이름 거부), 문자열은 “보이는 글자”가 하나는 있어야 한다(공백·제로폭 문자만 있으면 거부). 심각도 기준점도 문서에 명시돼 있다. critical은 “인증 없는 공격자의 코드 실행·전체 데이터 접근·임의 계정 탈취”, high는 “명시적 통제를 완전히 무력화”, medium은 “영향 범위가 제한된 실제 경계 위반”이다. 판별 질문은 하나다. “통제를 완전히 무너뜨렸나, 약하게 만들었을 뿐인가?”
후보 게이트: 프롬프트 인젝션만으로는 발견이 아니다
헌터는 후보를 내기 전에 7조짜리 게이트를 통과해야 한다. 핵심은 “낮은 신뢰 주체, 받아들여진 입력, 의도된 통제, 넘어간 경계, 영향받은 주체·자원, 관측 결과”를 모두 이름 붙이라는 요구다. LLM 기반 대상을 위한 AI-AND-LLM.md는 이 원칙을 더 날카롭게 적용한다.
| 주제 | 스킬의 판정 기준 |
|---|---|
| 프롬프트 인젝션 | 그 자체로는 발견 아님. 내용이 다른 주체의 컨텍스트에 들어가거나, 요청자에게 없는 권한을 쓰거나, 읽을 수 없는 데이터를 노출하거나, 직접 닿을 수 없는 싱크를 움직여야 함 |
| 가드레일 프롬프트 | 보안 경계로 치지 않음. 결정적 검사·자원 단위 인가·격리·바인딩·제한된 자격 증명만 통제로 인정 |
| 모델 출력·메모리·MCP 응답 | 모두 신뢰할 수 없는 입력. 권한을 주거나 싱크로 보내는 코드를 지목해야 함 |
| 인가 vs 행동 바인딩 | 별개 통제. 피해 주체의 유효 권한으로 실행됐어도 그가 그 행동을 의도·승인하지 않았다면 바인딩 실패 |
| 메모리 오염 | 사용자가 일부러 저장하고 자기 요청에만 쓰는 기억은 경계 위반 아님. 낮은 신뢰 관찰이 다른 세션의 지시·사실로 굳을 때만 |
| 확인 불가 요소 | 제공자·배포·모델·렌더러 동작을 로컬에서 볼 수 없으면 needs_validation |
신뢰 경계: 대상 코드는 적대적이라고 가정한다
감사 대상 저장소는 공격자가 쓴 코드일 수도 있다. 그래서 스킬은 소스 읽기는 읽기 전용으로 하고, 대상이 통제하는 빌드·테스트·프로세스는 아래 통제를 전부 갖춘 OS 수준 샌드박스에서만 돌리라고 요구한다. 하나라도 못 갖추면 대상 코드를 실행하지 말고 그 후보를 needs_validation으로 남기라는 것이 기본값이다.
| 통제 | 요구 사항 |
|---|---|
| 네트워크 | 외부 네트워크 없음. 로컬 클라이언트·서버가 필요하면 격리된 루프백 네임스페이스만 |
| 환경 변수 | 빈 환경에서 시작해 허용 목록만 채움. HOME·임시·캐시는 스크래치 안. 사후 마스킹이 아니라 처음부터 비운 상태로 실행 |
| 파일 시스템 | 대상과 툴체인은 읽기 전용, 쓰기는 배정된 scratch/만. /tmp·호스트 HOME을 쓰기 대체 경로로 쓰지 말 것 |
| 자원 | CPU·메모리·프로세스 수·파일 크기·디스크·실행 시간 상한을 명시 |
| 의존성 | 설치 금지, 빌드가 패키지를 받아 오는 것도 금지. 이미 로컬에 있는 것만 |
| 외부 대상 | 배포된 엔드포인트·공유 인프라·운영 계정·유료 API 할당량을 건드리지 않음. 최소 효과에서 멈춤 |
| 산출물 승격 | 부모가 미리 연 디렉터리 디스크립터로, 심볼릭 링크를 따라가지 않고, 일반 파일·링크 수 1·크기 상한을 fstat로 재확인하며 파일 단위로 복사 (11단계 절차) |
이 승격 절차는 꽤 편집증적으로 보이지만 이유가 있다. 헌터가 샌드박스 안에서 만든 “증거 파일”이 사실은 호스트의 다른 파일을 가리키는 심볼릭 링크이거나 하드 링크, FIFO일 수 있다. 검증기 CLI도 같은 철학으로 입력 파일을 연다. 박스에서 심볼릭 링크와 FIFO를 넘기자 각각 “input must not be a symlink”, “input must be a regular file”로 바로 거부했다. 다만 이 규칙들은 문서화된 절차이고, 실제로 지키는 건 사용자의 에이전트와 사용자가 준비한 샌드박스다. 스킬 저장소는 샌드박스를 제공하지 않는다. Cloudflare 블로그에 따르면 사내 하네스는 unshare 기반 샌드박스를 썼고, Docker 안에서 돌릴 때는 seccomp·AppArmor 설정이 필요했다고 한다.
프로필과 비용 예산: 에이전트 호출 수로 센다
| 프로필 | 내용 | 주의 |
|---|---|---|
quick |
헌터 웨이브 1회 + 최종 비평가 1회, 후보마다 검증자 1명이 후보 검증과 최종 재검증을 겸함. 비평가가 찾은 추가 작업은 deferred | 부분 커버리지로 표시해야 함 |
standard |
문서 그대로 (기본값) | 웨이브마다 사후 비평가 + 별도 최종 비평가 예약 |
deep |
서브시스템·수명 주기 모드별로 단위 분할, 비평가가 깨끗해질 때까지 반복, 후보 검증과 최종 재검증을 다른 에이전트로, 이전 same-source covered 단위에 독립 2차 패스 | 고위험·대형 대상용 |
| 범위 지정 실행 | 지정 경로·서브시스템·두 ref 사이 diff만. 나머지는 out_of_scope | covered로 쓰면 안 됨 |
예산은 “전체 단계의 최대 에이전트 호출 수”로 run-metadata.json에 기록한다. 정찰 전에 엄격한 게이트를 먼저 적용한다. 기본 정찰 4회, 비평가(quick은 1회, standard·deep은 2회), 검증자 최소 1회를 예약하지 못하면 에이전트를 하나도 띄우지 않고 budget_cannot_fund_reconnaissance_and_reserves로 끝낸다. 헌터는 비평가·검증 예약분에 절대 손대지 않는다(애매하면 남은 예산의 30%를 검증에 예약). 검증 예산이 바닥나면 미검증 후보를 needs_validation으로 둔갑시키지 말고 validation_budget_exhausted로 미완료를 선언하라고 못 박는다. 사용자가 정한 예산을 조용히 넘기지 말라는 규칙도 있다.
설치와 실행
설치는 Vercel의 Skills CLI(npx skills)로 한다. 박스에서는 격리된 HOME과 빈 git 저장소를 만들어 Claude Code 대상으로 설치해 봤다.
# 프로젝트 단위 설치 (Claude Code 대상, 비대화형)
mkdir proj && cd proj && git init -q .
npx -y skills add https://github.com/cloudflare/security-audit-skill \
  --skill security-audit -a claude-code -y
#  → ./.claude/skills/security-audit (copied)
#  → skills-lock.json 에 source·skillPath·computedHash 기록

# 사용자 전역 설치
npx skills add https://github.com/cloudflare/security-audit-skill \
  --skill security-audit --global
# 에이전트 안에서의 호출 예 (README)
security audit this codebase # full audit 모드
find security vulnerabilities in ./src # 범위 지정
do a security review, output to ~/audits/my-project
# 검증기는 단독으로도 쓸 수 있다 (Node만 필요, 의존성 0)
node .claude/skills/security-audit/validate-coverage-ledger.cjs <out>/coverage-ledger.json
node .claude/skills/security-audit/validate-findings.cjs <out>/findings.json
node --test .claude/skills/security-audit/*.test.cjs| 항목 | 박스 관측 (2026-10-21 11:53 KST) |
|---|---|
| Skills CLI | 1.5.18 (npx 자동 설치) |
| 설치 결과 | .claude/skills/security-audit/에 20개 파일 복사. diff -rq로 원본 skills/security-audit/와 동일 확인 |
| 설치 시 표시된 외부 스캔 | Gen “Safe” · Socket “0 alerts” · Snyk “Med Risk” (CLI가 skills.sh에서 가져와 보여 준 값. 근거는 따로 확인하지 않음) |
| 잠금 파일 | skills-lock.json v1: sourceType github, skillPath skills/security-audit/SKILL.md, computedHash 98b97aad…6973 |
| CLI 마지막 안내 | “Review skills before use; they run with full agent permissions.” |
npx skills add는 기본 브랜치의 최신 상태를 가져온다. 팀에서 쓴다면 skills-lock.json을 커밋하고 해시가 바뀌면 리뷰하거나, 커밋 SHA로 포크·벤더링하는 편이 안전하다. 보안 감사 절차가 말없이 바뀌면 이전 실행 원장과의 비교도 흔들린다.박스 스모크 테스트: 검증기는 무엇을 막고 무엇을 놓쳤나
전체 감사는 돌리지 않았다. 그러려면 도구 호출과 병렬 서브에이전트를 지원하는 코딩 에이전트와 모델 API가 필요한데, 이번 테스트는 비밀 값 없이 하는 것이 원칙이었다. 대신 이 스킬에서 결정적으로 동작하는 유일한 부분인 두 검증기를 집중적으로 두드렸다. 환경은 박스 리눅스 VM, Node v20.19.2, 커밋 c1c8a8c, 네트워크는 설치 단계에서만 사용했다.
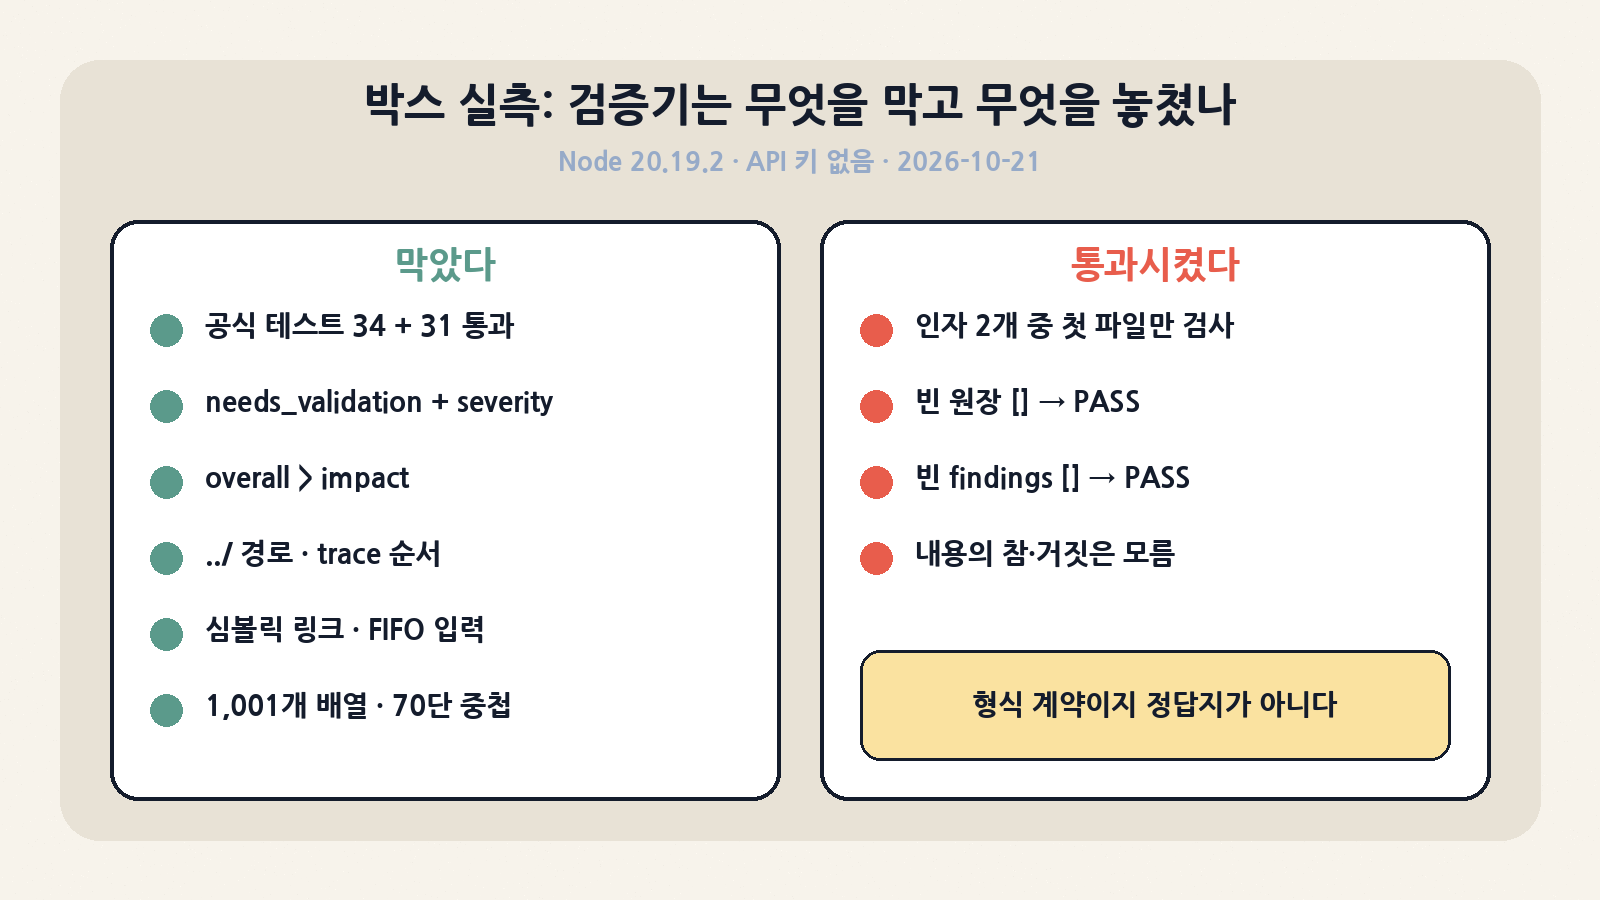
| 입력 | 결과 |
|---|---|
공식 테스트 validate-findings.test.cjs |
34/34 통과, 1.62초 |
공식 테스트 validate-coverage-ledger.test.cjs |
31/31 통과, 1.31초 |
| 정상 findings (rejected·confirmed·needs_validation 각 1건) | PASS: 3 findings valid, 종료 코드 0, 약 0.1초 |
| needs_validation에 severity 추가 | 3개 오류로 거부 (oneOf 불일치, 예상 외 필드, “must not contain severity”) |
| overall_severity critical, impact medium | 거부: “cannot exceed demonstrated impact” |
| fingerprint 정렬 뒤집기 | 거부: “must be sorted lexicographically” |
trace 파일 ../../etc/passwd |
거부: “must be a safe repository-relative source path” |
| observed_result를 공백+제로폭 문자로 | 거부: “must contain a visible character” |
| trace를 propagation으로 시작 | 거부: entrypoint로 시작해야 함 |
| remediation 삭제 | 거부: “confirmed finding requires visible remediation” |
| 심볼릭 링크 / FIFO 입력 | 각각 거부 (symlink 금지, regular file만) |
| 1,001개 배열 / 70단 중첩 | 각각 거부 (1,000개·64단 상한) |
| 입력 | 결과 |
|---|---|
| 원장: planned 단위 1개 | PASS |
| 원장: in_progress인데 agent_id 없음 | 거부 |
| 원장: covered인데 reviewed_paths·local_checks 비어 있음 | 거부 (2개 오류) |
원장: agent_id COM1 |
거부 (안전한 ID 아님) |
| 원장: coverage_id 임의 값 | 거부, 기대하는 정규 ID를 출력 |
| 인자 2개: 정상 파일 + 잘못된 파일 | PASS, 종료 코드 0 — 첫 번째 파일만 검사하고 두 번째는 무시 |
빈 원장 [] |
PASS: 0 coverage units valid |
빈 findings [] |
PASS: 0 findings valid |
정리하면, 형식 계약 위반과 적대적 파일 입력에는 매우 단단하다. 대신 아래 세 가지는 그냥 통과했다. ① 추가 CLI 인자를 조용히 무시한다. CI에서 validate-findings.cjs a.json b.json처럼 쓰면 b가 틀려도 초록불이 뜬다. 열린 PR #63(“Reject extra CLI arguments”)이 바로 이 문제다. ② 빈 원장이 통과한다. 원장 검증기는 단위 하나하나가 올바른지 보지 정찰이 충분한 단위를 만들었는지는 보지 않는다. 이슈 #79(“complete가 in_progress/blocked 없는 원장을 요구하지 않는다”)와 PR #84도 같은 맥락이다. ③ 당연하지만 내용의 참·거짓은 모른다. 파일·줄 번호가 실제로 존재하는지도 이 두 검증기는 확인하지 않는다. Cloudflare 블로그의 사내 하네스는 이걸 별도 결정적 코드로 검사한다고 했다.
비슷한 도구와 비교
| 도구 | 형태 | 작동 방식 | 결과 신뢰 장치 | 라이선스·비용 |
|---|---|---|---|---|
| security-audit-skill | 에이전트용 절차서 + 형식 계약 + 결정적 검증기 | LLM 서브에이전트가 읽고 추론, 대상 코드는 샌드박스에서만 실행 | 3판정 + 원장, 반증 전담 검증자 | MIT, 무료 (모델 비용은 별도) |
| Semgrep / CodeQL 류 SAST | 규칙·쿼리 기반 정적 분석 | 결정적 패턴·데이터 흐름 분석 | 규칙별 결과, 오탐은 사람이 분류 | 엔진별 라이선스 상이 |
| 코딩 에이전트 내장 보안 리뷰 명령·액션 | PR·diff 단위의 단일 패스 리뷰 | 단일 에이전트 판단 | 보통 자유 형식 코멘트 | 제품 정책에 따름 |
| Cloudflare 사내 하네스(VDH/VVS) | 플릿 단위 파이프라인 | DB 상태 + 오케스트레이터, 발견과 판정에 서로 다른 모델 | Dedup·Judgment·Fixer, 사람 승인 후 병합 | 비공개 (블로그는 추후 공개 희망) |
| iFixAi (이전 글) | AI 에이전트 자체의 행동 감사 | 정책 기준 점검 | 정책 준수 여부 | — |
Cloudflare 블로그에는 흥미로운 관찰이 하나 있다. Semgrep을 파이프라인 끝까지 연결해 뒀는데 헌터들이 한 달 동안 한 번도 부르지 않았다는 것이다. 에이전트는 규칙 엔진보다 코드를 직접 읽고 돌려 보는 쪽을 택했다. 그렇다고 SAST가 필요 없다는 뜻은 아니다. 결정적 도구는 매 PR마다 싸게 돌고, 이 스킬은 주기적으로 깊게 도는 감사에 가깝다. 둘은 대체 관계보다 보완 관계로 보는 편이 맞다.
주의할 점과 한계
| 항목 | 내용 |
|---|---|
| 권한 | 스킬은 에이전트의 전체 권한으로 실행된다. 샌드박스 요구는 문서상 규칙이고 스킬이 강제하지 않는다. 대상 저장소의 README·주석에 섞인 지시문이 에이전트를 흔들 수 있으니, 감사 세션은 비밀이 없는 일회용 환경에서 돌리는 것이 기본 |
| 모델 의존성 | 절차가 아무리 엄격해도 서브에이전트를 제대로 못 띄우거나 긴 지시를 생략하는 에이전트에서는 품질이 급락. 블로그도 모델마다 찾는 버그 비율이 다르다고 함 |
| 비용 | standard 이상은 정찰 4 + 헌터 N + 비평가 2 이상 + 후보당 검증자 1~2. 대형 저장소는 반드시 예산·범위·프로필을 먼저 정할 것 |
| 재현성 | 릴리스·태그가 없고 main을 그대로 설치. 절차가 바뀌면 이전 원장과 비교가 어려워짐 → lock 해시 관리 |
| 플랫폼 | Windows에서 검증기 CLI가 입력을 못 읽는다는 이슈가 열려 있고(O_NOFOLLOW 계열), PR #75가 수정 중 |
| 완료 의미 | 빈 원장·빈 findings도 검증기를 통과. ‘0건’ 보고는 커버리지 서술(어떤 단위를 covered로 봤는지)과 함께 읽어야 함 |
| 범위 | 단일 저장소 한정. 저장소 간 의존성 추적·중복 제거 에이전트·자동 수정은 하네스의 몫 |
| 법·윤리 | 배포된 엔드포인트·남의 시스템 프로빙 금지가 스킬의 기본값. 사내 정책상 승인된 대상에만 쓸 것 |
누가 도입하면 좋은가
| 대상 | 판단 | 이유 |
|---|---|---|
| 사내 보안팀·AppSec | 적극 권장 | 에이전트 감사 결과를 사람이 검토하기 전 단계의 ‘형식 필터’와 상태 관리 틀로 바로 쓸 수 있음. 자체 하네스로 가기 전 프롬프트를 다듬는 출발점 |
| 오픈소스 메인테이너 | 선택적 | 주기적 심층 점검에 유용. 단 결과 공개 전 사람 검증 필수, 보고서의 needs_validation을 공개 이슈로 바로 올리지 말 것 |
| LLM 앱·MCP 서버 개발팀 | 권장 | AI-AND-LLM 동반 문서의 판정 기준만으로도 위협 모델 리뷰 체크 기준으로 가치가 있음 (guidance 모드) |
| PR마다 빠른 검사가 필요한 팀 | 비권장 | 몇 시간짜리 다중 에이전트 감사는 PR 게이트에 맞지 않음. SAST·경량 리뷰 + 주기적 이 스킬 조합 |
| 샌드박스를 못 갖춘 환경 | 제한적 | 대상 코드 실행 없이 소스 읽기만 하게 되고, 후보 다수가 needs_validation으로 남는 것이 정상 동작 |
정리하자면 cloudflare/security-audit-skill은 “AI가 보안 감사를 해 준다”는 마법 상자가 아니다. AI가 낸 보안 결과를 어떤 형식으로 남기고, 누가 반박하며, 무엇을 아직 모른다고 말해야 하는지를 정한 운영 규약에 가깝다. 그 규약의 기계적 부분은 박스에서 확인한 대로 단단하지만 몇 군데 빈틈이 있고, 나머지는 쓰는 사람의 에이전트와 샌드박스에 달려 있다. 에이전트 보안 리뷰를 이미 실험하고 있다면 프롬프트보다 이 계약과 원장 구조를 먼저 가져다 쓰는 것을 권한다.