요약: HKUDS/DeepTutor(Apache-2.0)는 홍콩대 데이터 인텔리전스 랩(HKUDS)에서 나온 “에이전트 네이티브” 학습 워크스페이스입니다. 2026년 10월 28일 오전(한국 시간) 기준 GitHub Trending 전체 9위, Python 1위에 올랐고, 하루 +1,598 스타로 누적 46,116 스타를 기록했습니다(API 조회 46,120, 포크 5,779). 최신 정식 릴리스는 v1.6.15입니다(2026-10-19 05:13 KST). 이 글은 튜터 챗봇 소개가 아니라 런타임 설계를 뜯어보는 글입니다. 2층 플러그인 모델(Tools·Capabilities), 저장·재생되는 턴 엔진, L1/L2/L3 메모리, RAG 엔진 추상화와 kb eval, 샌드박스 계층을 차례로 살펴봅니다. 이어서 박스에서 PyPI 패키지를 설치하고 로컬 모의(mock) OpenAI 호환 서버로 실제 한 턴을 끝까지 돌린 결과, 그리고 그 과정에서 확인한 기본 바인딩·인증 관련 주의점을 정리했습니다.
1. DeepTutor는 무엇이고, 왜 지금 다시 트렌딩인가
README의 한 줄 정의는 “튜터링, 문제 풀이, 퀴즈 생성, 리서치, 시각화, 숙달(mastery) 연습을 하나의 확장 가능한 시스템으로 묶은 agent-native learning workspace”입니다. 실무자가 주목할 부분은 기능 목록이 아니라 구조입니다. Chat, Quiz, Deep Research, Visualize, Mastery Path, Immersive Reading, Audio Overview가 모두 하나의 capability 런타임과 세션 컨텍스트를 공유합니다. 각 모드는 목적별 루프나 파이프라인만 따로 가집니다. 지식베이스, 노트북, 문제은행, 페르소나, 메모리도 이 모드들 사이에서 그대로 다시 쓰입니다.
2025-12-29 공개 후 39일 만에 1만 스타, 111일 만에 2만 스타, 9개월 만에 4만 스타를 넘었습니다(README News 기준). 트렌딩 상위권에 다시 오른 데는 세 가지 흐름이 겹쳐 있습니다. 첫째, 10월 들어 릴리스가 촘촘했습니다(10/4 v1.6.13, 10/8 v1.6.14, 10/19 v1.6.15). 둘째, dev 브랜치에 큰 변경이 들어오고 있습니다. 10/28 새벽(KST)에 “modularize installation and enforce feature dependency boundaries” 커밋이 병합됐습니다. 셋째, Claude Code·Codex 같은 코딩 에이전트에게 설치를 맡기는 SKILL.md + AGENT_SETUP.md 흐름이 요즘 “에이전트가 설치하는 오픈소스” 트렌드와 맞물렸습니다. 다만 스타 급증의 정확한 원인을 저장소가 밝히고 있지는 않으므로, 위 내용은 관측된 사실을 나열한 것입니다.
| 항목 | 값 (2026-10-28 KST 조회) | 메모 |
|---|---|---|
| 저장소 | HKUDS/DeepTutor | 리드 메인테이너 Bingxi Zhao, HKU Data Intelligence Lab |
| 라이선스 | Apache-2.0 | GitHub API license.spdx_id 및 LICENSE 파일 |
| 스타 / 포크 | 46,120 / 5,779 | 트렌딩 페이지 표기 46,116, 당일 +1,598 |
| 트렌딩 순위 | 전체 9위 · Python 1위 | daily 기준 |
| 최신 릴리스 | v1.6.15 (PyPI 1.6.15) | 2026-10-19 05:13 KST, requires-python >=3.11,<3.15 |
| 스택 | Python(FastAPI·Typer) + Next.js 16 / React 19 | deeptutor/ 약 31만 줄, web/ TS/TSX 약 30만 줄(얕은 클론 wc 기준) |
| 논문 | arXiv 2604.26962 | “DeepTutor: Towards Agentic Personalized Tutoring” |
| 열린 이슈+PR | 218 | API open_issues_count |
2. 아키텍처: 진입점 3개, 턴 엔진 1개, 플러그인 2층
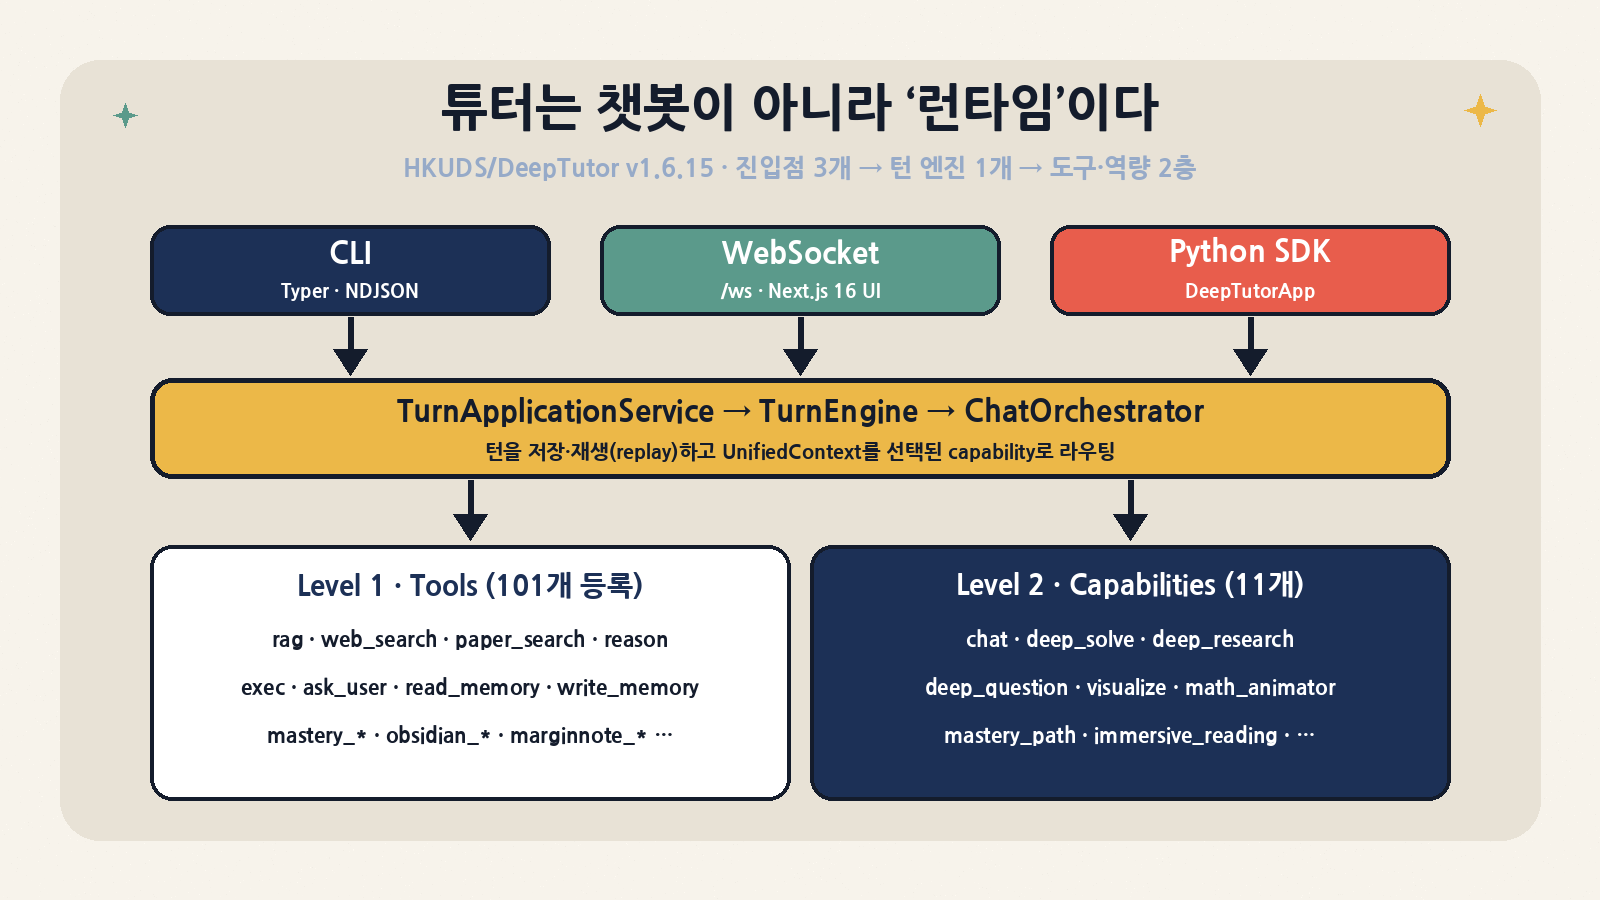
저장소의 AGENTS.md는 구조를 꽤 솔직하게 적어 둡니다. CLI(Typer), WebSocket /ws, Python SDK(DeepTutorApp) 세 진입점은 모두 TurnApplicationService로 들어갑니다. 이 서비스가 턴 상태를 세션 스토어에 영속화하고 재생(replay)을 담당합니다. 그 아래 TurnEngine → ChatOrchestrator가 정규화된 UnifiedContext를 선택된 capability로 라우팅하며, 지정하지 않으면 chat이 기본입니다. 턴마다 StreamBus가 하나씩 생기고, 오케스트레이터가 이벤트를 내보내면 턴 런타임이 이를 저장하고 어댑터가 소비자에게 다시 흘려보냅니다. 끊긴 웹 클라이언트가 재연결해 “실제 종료 이벤트”를 기다리는 v1.6.15의 복구 기능도 이 설계 위에 있습니다.
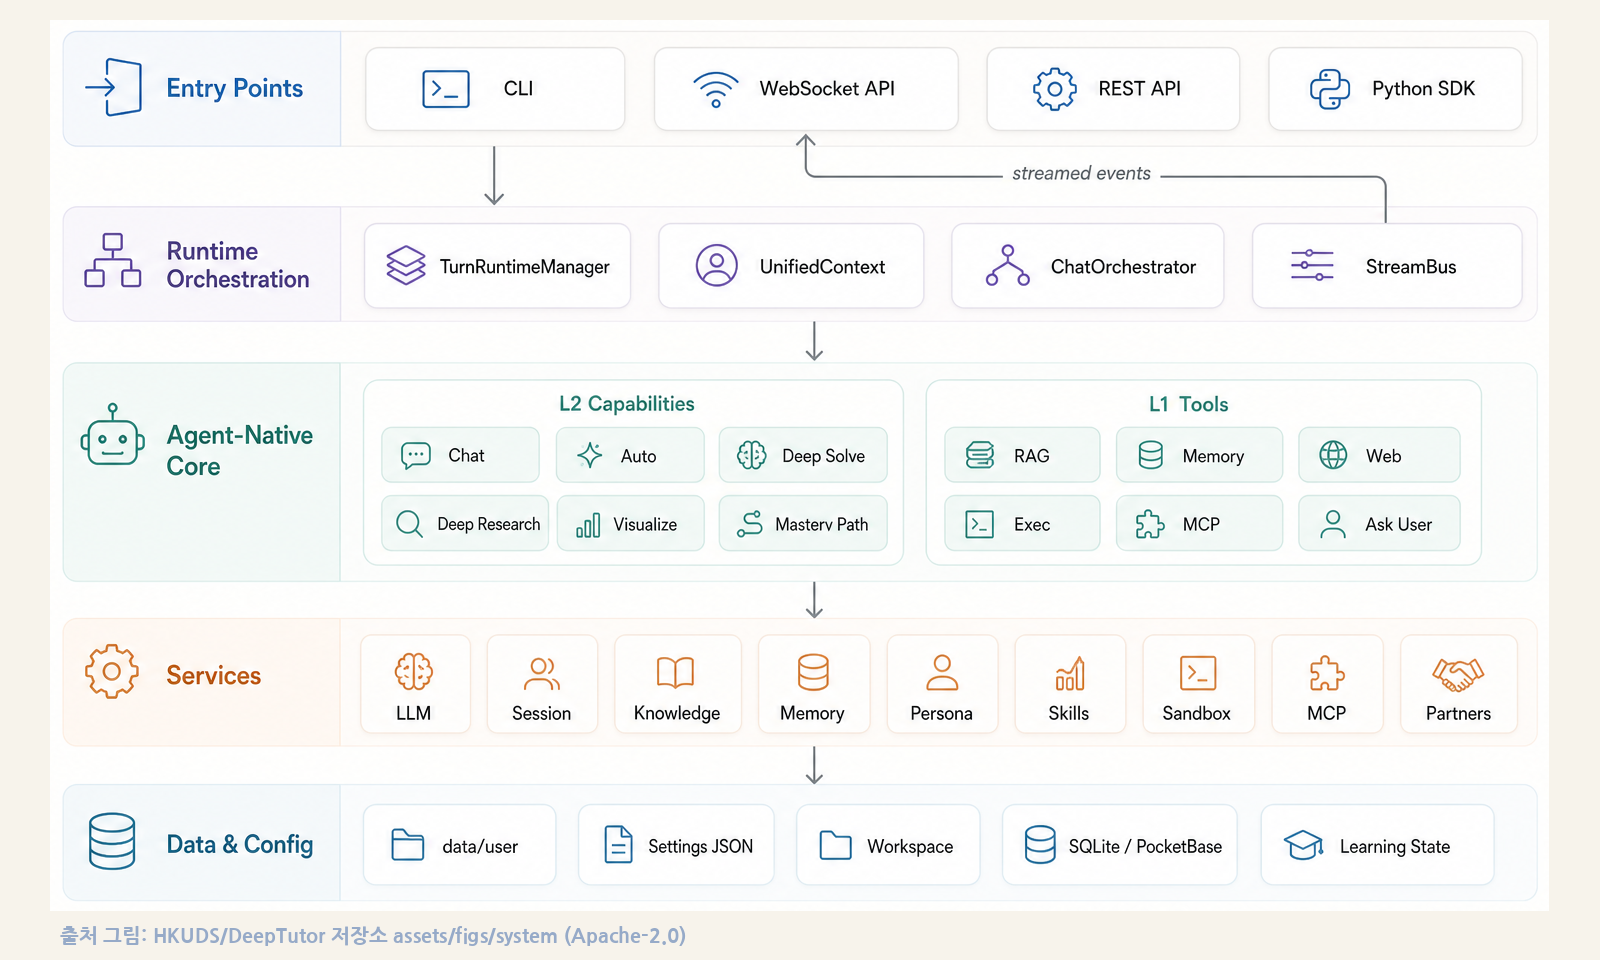
| 계층 | 핵심 코드 | 역할 | 설계 포인트 |
|---|---|---|---|
| 진입점 | deeptutor_cli/main.py, deeptutor/api/routers/unified_ws.py, deeptutor/app.py |
REPL/NDJSON, 웹 UI 스트림, SDK | 세 경로가 같은 서비스로 수렴해 동작 차이가 작다 |
| 턴 영속화 | TurnApplicationService, runtime/turn_engine.py |
턴 저장·조정·재생 | 스트리밍 중간 내용을 주기적으로 저장해 복구 |
| 라우팅 | runtime/orchestrator.py (ChatOrchestrator) |
UnifiedContext → Capability | 모드 전환이 프롬프트가 아니라 코드 경로 |
| Level 1 Tools | core/tool_protocol.py, tools/builtin/ |
LLM이 고르는 단발 함수 | 사용자 토글 도구 7개 + 컨텍스트 게이트 도구 |
| Level 2 Capabilities | core/capability_protocol.py, capabilities/ |
턴 전체를 맡는 다단계 파이프라인 | 모두 emit_capability_result()로 같은 봉투 + cost_summary |
| 서비스 | services/{rag,memory,sandbox,subagent,llm,…} |
RAG, 메모리, 샌드박스, 서브에이전트 | 설정은 data/user/settings/*.json, 프로젝트 루트 .env는 의도적으로 무시 |
2-1. Tools와 Capabilities를 나눈 이유
Level 1 Tools는 LLM이 필요할 때 부르는 단일 함수입니다(rag, web_search, paper_search, reason, exec, ask_user 등). Level 2 Capabilities는 턴 자체를 넘겨받는 다단계 파이프라인입니다. 예를 들어 deep_research는 rephrasing → decomposing → researching → reporting, math_animator는 concept_analysis → … → render_output 단계를 거칩니다. 이렇게 나누면 “도구를 몇 번 부를지”는 모델에 맡기고, “보고서를 어떤 단계로 만들지”는 코드가 고정할 수 있습니다. 교육 도메인에서는 채점 기준, 숙달 게이트, 출처 인용처럼 흔들리면 안 되는 절차가 많아서 이 분리가 효과적입니다. 대신 capability마다 프롬프트가 capabilities/prompts/{en,zh}/<name>.yaml로 따로 관리되므로, 다국어 품질은 capability 단위로 고르지 않을 수 있습니다.
박스에서 deeptutor plugin list로 확인한 v1.6.15 등록 현황은 tool 101개, capability 11개입니다. --tool 플래그는 사용자 토글 화이트리스트 안에서만 고를 수 있고, 컨텍스트·capability 게이트를 우회하지 못합니다(AGENTS.md 명시). 도구가 이렇게 많으니 모든 도구를 매번 프롬프트에 싣지 않습니다. load_tools로 “Extended Tools”를 지연 로딩하는 구조이며, 이 부분은 5장 스모크 테스트 수치와 연결됩니다.
| Capability | 단계(stages) | 실무적 의미 |
|---|---|---|
chat |
exploring → responding (단일 agentic loop) | 기본 모드, 대부분의 도구가 여기서 마운트 |
deep_solve |
responding (+ solve_plan / replan / finish_step) | 계획·재계획 도구로 풀이 과정을 구조화 |
deep_question |
ideation → generation | 문제 생성 후 문제은행으로 연결 |
deep_research |
rephrasing → decomposing → researching → reporting | --config mode=report depth=standard |
visualize |
analyzing → generating → reviewing | SVG / Chart.js / Mermaid / HTML, Manim 분기 |
math_animator |
concept_analysis → … → render_output | .[math-animator] extra + LaTeX/ffmpeg 필요 |
mastery_path |
responding (주제 유형별 숙달 게이트) | v1.6.15에서 그룹 문항·리뷰형 개요 수정 추가 |
immersive_reading · course_study · ask_questions · audio_overview |
responding 중심 | 문서·영상 타임스탬프 기반 읽기, 코스 상태 감지 |
3. 메모리: “개인화”를 감사 가능한 문서로
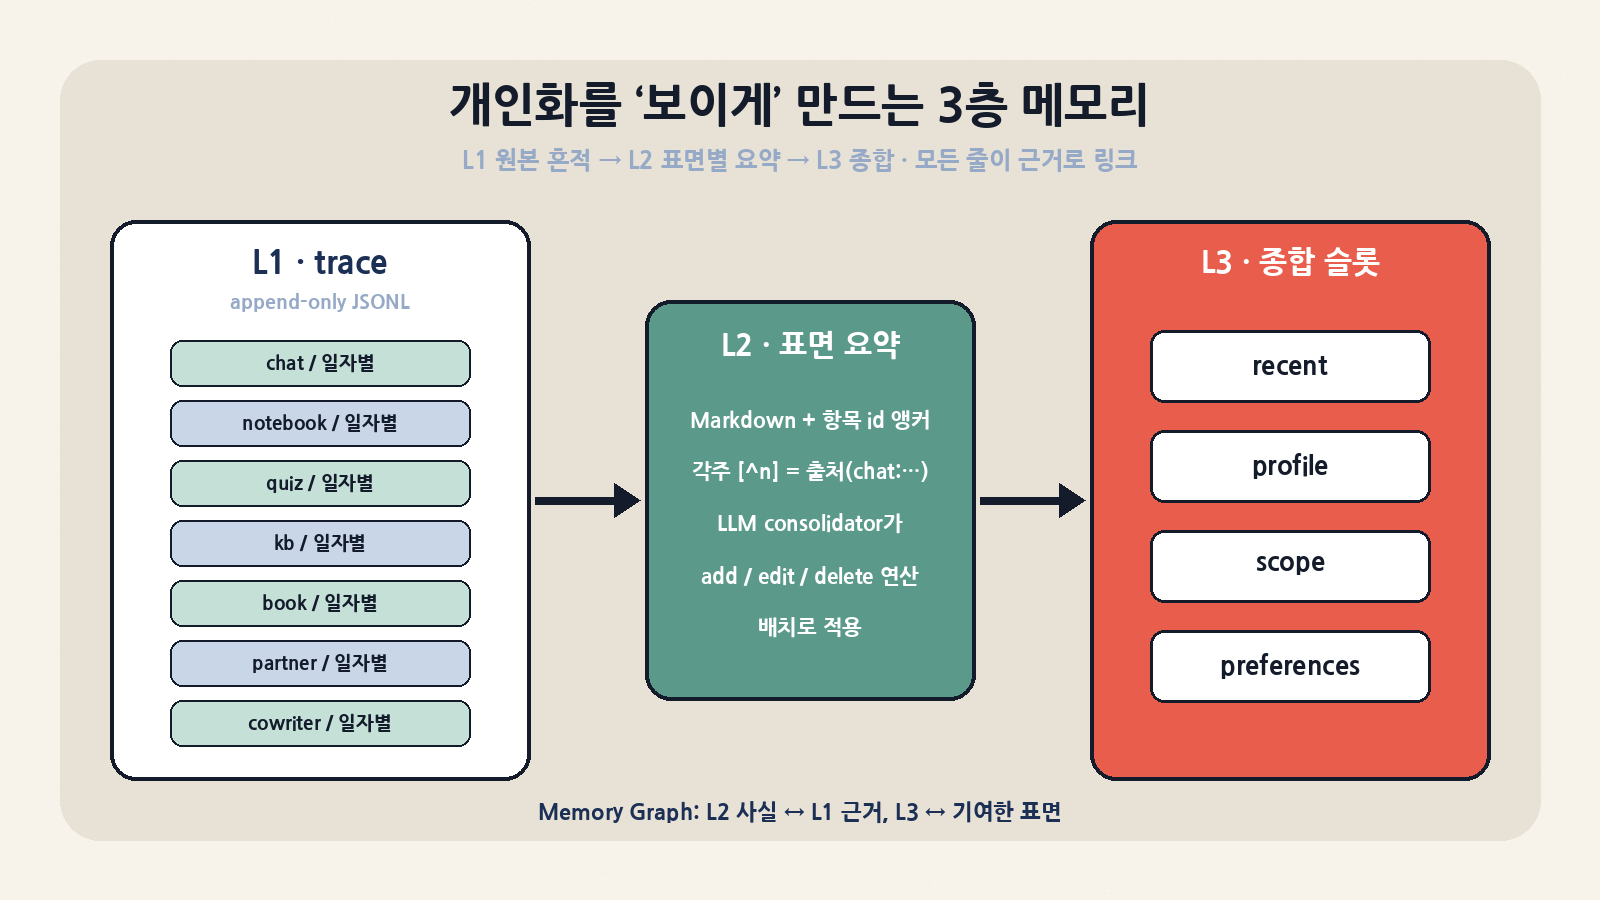
튜터링 제품의 핵심은 “학습자를 기억한다”는 점인데, 대부분의 구현은 이 부분이 블랙박스입니다. DeepTutor의 services/memory는 이를 세 층으로 풀어 냈습니다.
- L1 trace: 표면(surface)별·일자별 append-only JSONL입니다. 표면은
chat,notebook,quiz,kb,book,partner,cowriter7개입니다. - L2 표면 요약: 각주식 인용이 달린 Markdown 문서입니다. 각 bullet 끝에
[^1]같은 각주와<!--m_xxx-->항목 id 앵커가 붙고, 각주 행은chat:def처럼 출처를 가리킵니다. - L3 종합:
recent,profile,scope,preferences4개 슬롯입니다.
L1→L2, L2→L3 갱신은 LLM consolidator가 맡습니다. 다만 모델이 문서를 통째로 다시 쓰지 않고 add / edit / delete 연산 배치를 내놓으면, 순수 함수가 이를 적용합니다(ops.py). 같은 id에 delete와 edit가 충돌하는 경우도 규칙으로 처리합니다. 문서 파서·직렬화기는 I/O도 LLM도 없는 순수 함수이고, serialize(parse(x))가 멱등이라고 docstring에 명시돼 있습니다. 메모리 오염 문제를 “무엇이 왜 기억됐는지 추적하고 한 줄씩 지울 수 있게” 만드는 쪽으로 푼 설계입니다. v1.6.15에서는 Guided Learning 세션에 이 메모리를 상한이 있는(bounded) 형태로 붙였습니다. 압축 호출 비용은 이제 사용량 합계에 포함됩니다.
4. 지식 엔진, 평가, 샌드박스: 운영자가 볼 부분
4-1. RAG 엔진을 “교체 가능한 파이프라인”으로
services/rag/pipelines/ 아래에는 llamaindex, pageindex, graphrag, lightrag, lightrag_server, weknora, ima, kiwix가 나란히 있습니다. README는 여기에 MarginNote 4 라이브러리와 Obsidian vault 연결도 함께 소개합니다. 인덱스는 버전 관리되고, v1.6.10부터는 “어떤 설정으로 빌드됐는지 기록하고 강제”합니다. v1.6.15에서는 읽을 수 없는 PDF나 MinerU 네이티브 파서 실패가 문서 단위로 격리됩니다. 큰 교재 묶음을 인덱싱하다 한 파일 때문에 전체가 멈추는 문제를 겪어 본 팀이라면 반가울 변경입니다.
4-2. kb eval / eval-diff: 검색 품질을 숫자로 비교
실무자에게 가장 쓸모 있는 기능은 v1.6.15의 검색 평가 루프입니다. QA 세트(.jsonl/.json)를 주면 deeptutor kb eval이 recall@k, precision@k, nDCG@k, MRR, hit@k, MAP@k를 계산합니다(services/rag/eval/metrics.py). --rewrite off|standalone을 주면 질의 재작성 레이어를 강제로 끄거나 켜고, 그 사실(provenance)이 리포트에 기록됩니다. 그다음 eval-diff로 기준선과 후보 리포트를 지표별·케이스별로 비교합니다. 질의 재작성은 기본값이 꺼짐이고, 켜면 모델 호출이 하나 더 생깁니다.
# 기준선 → 설정 변경 → 후보 → 비교
deeptutor kb eval textbook -d qa.jsonl -k 5 --rewrite off --save base.json
deeptutor kb eval textbook -d qa.jsonl -k 5 --rewrite standalone --save cand.json
deeptutor kb eval-diff base.json cand.json --format json
박스에서 지표 함수를 직접 호출해 정의를 확인했습니다. 상위 5개 결과 중 2·4위에 정답 2개가 걸린 경우 recall@5=1.0, hit@1=0.0, hit@3=1.0, nDCG@5=0.6509가 나왔습니다. 매칭은 기본적으로 “검색 청크가 정답 토큰을 50% 이상 덮는가”(--min-ratio 0.5)로 판정합니다. 따라서 의미는 같지만 표현이 다른 청크는 놓칠 수 있다는 점을 감안해야 합니다.
4-3. 코드 실행 샌드박스의 3단 폴백
docx·pdf·pptx·xlsx 같은 오피스 스킬은 모델이 짧은 파이썬 스크립트를 쓰고 단일 exec 도구로 실행하는 방식입니다. 백엔드는 강한 순서대로 고릅니다. ① Dockerfile.runner로 띄우는 최소 권한 Runner 사이드카(DEEPTUTOR_SANDBOX_RUNNER_URL), ② Linux bubblewrap(bwrap), ③ 제한된 subprocess 폴백 순입니다. ③은 sandbox_allow_subprocess 기본값이 true입니다. UI에서 “best effort”로 표시될 뿐 격리 수준은 가장 약하므로, 공용 서버라면 DEEPTUTOR_SANDBOX_ALLOW_SUBPROCESS=0으로 막고 ①이나 ②를 갖추는 편이 맞습니다. 콘텐츠 워크스페이스에서 outputs/ 밖은 읽기 전용이고, 다른 위치로 복사하려면 경로 쌍마다 “Allow once” 확인을 거쳐야 합니다.
| 운영 포인트 | 기본값 | 권장 조치 |
|---|---|---|
인증 (auth.json) |
enabled: false |
로컬 1인 외에는 활성화 + cors_origins 정확히 지정 |
| 백엔드 바인딩 | serve 옵션 기본 0.0.0.0, launcher도 uvicorn에 --host 0.0.0.0 |
--host 127.0.0.1 또는 방화벽, Docker는 -p 127.0.0.1:… |
| 요청 스크리닝 | 꺼짐 (deeptutor[guard] 미설치) |
필요 시 extra 설치 후 security_guard.enabled. 본문·WebSocket은 검사하지 않음 |
| 코드 실행 | subprocess 폴백 허용 | Runner 사이드카 또는 bwrap, 폴백은 0으로 |
| 스킬 설치 | EduHub 기본, ClawHub 내장 | 보안 판정 확인, always: 자동 제거, .hub-lock.json 감사 |
| 자격 증명 | 설정 JSON에 저장 | config apply는 리터럴 키를 거부하고 api_key_env 참조만 허용 |
5. 박스 스모크 테스트: API 키 없이 한 턴을 끝까지
테스트 환경은 Linux 박스, Python 3.13.5, Node 20.19.2입니다. 실제 모델 키를 쓰지 않으려고, /v1/chat/completions에 고정 문장을 스트리밍으로 돌려주는 30여 줄짜리 모의 OpenAI 호환 서버를 띄웠습니다. 이 서버는 받은 요청의 메타데이터(메시지 수, 도구 이름, 시스템 프롬프트 길이)를 기록합니다. DeepTutor에는 custom 프로바이더로 연결했습니다.
python3 -m venv .venv && . .venv/bin/activate
pip install -U deeptutor==1.6.15          # 의존성 포함 venv 약 1.2GB
export DEEPTUTOR_HOME=$PWD/home
deeptutor init --non-interactive          # 기본 설정 생성
deeptutor config providers                # llm 43 · embedding 14 · search 15
cat > setup.json <<'J'
{"llm":{"provider":"custom","model":"mock-tutor",
        "base_url":"http://127.0.0.1:18765/v1","api_format":"openai_chat"},
 "system":{"backend_port":18001,"frontend_port":13782}}
J
deeptutor config apply setup.json --check && deeptutor config apply setup.json
deeptutor doctor --online --format json
deeptutor run chat "Explain the Fourier transform in one line" --format json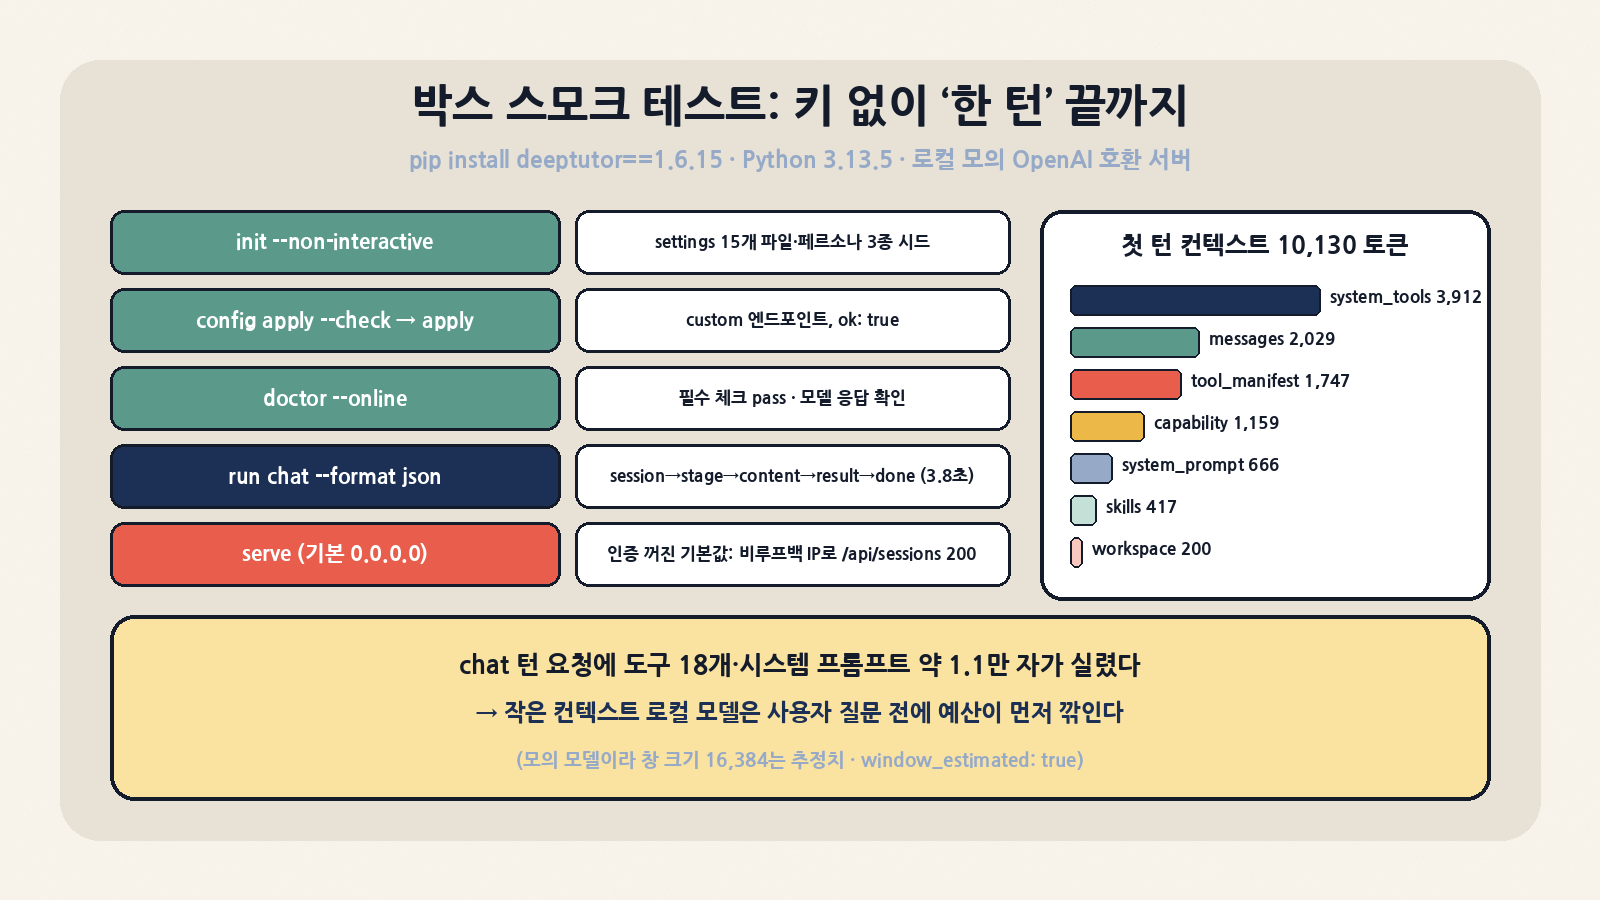
| 단계 | 관측 결과 | 해석 |
|---|---|---|
deeptutor --help |
0.51초, 하위 명령 19개 | CLI 임포트는 가벼운 편 |
init --non-interactive |
data/user/settings에 파일 15개, 페르소나 peer·research-assistant·teacher 시드, "next_step": "deeptutor config apply setup.json" |
에이전트가 이어받기 좋은 JSON 출력 |
doctor (설정 전) |
ok: false — llm_config·llm_credentials fail, storage pass, rag skip |
필수·선택 체크가 분리돼 있음 |
config apply --check → apply |
"status": "validated" → "applied" |
쓰기 전 검증 단계가 명확 |
doctor --online |
필수 체크 모두 pass, online “The model returned a response.” | 실제 요청 1회 발생 |
run chat --format json |
3.8초, NDJSON session → stage_start → progress → content ×2 → stage_end → result → done → session_meta |
모든 줄에 session_id·turn_id·seq |
| 모의 서버 요청 로그 | 요청 3건: doctor --online 비스트리밍 1, 본 턴 스트리밍 1(메시지 5·도구 18·시스템 프롬프트 약 10,941자), 세션 제목 생성으로 보이는 짧은 호출 1 |
chat 한 턴에 LLM 호출 2회(본 응답 + 제목) |
result.metadata.context_budget |
사용 10,130 토큰: system_tools 3,912 · messages 2,029 · tool_manifest 1,747 · capability 1,159 · system_prompt 666 · skills 417 · workspace 200 | 창 16,384는 추정치(window_estimated: true) |
session list / memory show |
세션 1건(메시지 2) / L3 비어 있음 | 메모리는 별도 갱신 흐름에서 채워짐 |
serve + /openapi.json |
“DeepTutor API”, 경로 560개, /docs 200 |
API 표면이 매우 넓음 |
두 가지가 눈에 띕니다. 첫째는 컨텍스트 기본 비용입니다. 사용자 질문 한 줄을 보내기 전에 이미 1만 토큰 남짓이 시스템 도구 설명, 도구 매니페스트, capability 프롬프트로 채워집니다. 도구를 지연 로딩하는데도 이 정도입니다. 컨텍스트 창이 8K~16K인 로컬 모델(Ollama, llama.cpp 등)로 붙이면 실제 대화와 RAG 근거에 쓸 공간이 빠르게 줄어듭니다. 결과 봉투에 이 내역이 세그먼트별로 그대로 나오므로, 튜닝할 때 이 값을 먼저 보시길 권합니다. 둘째는 done 이벤트의 usage_summary입니다. TTFT, 캐시 적중, 호출별 상세(call_details)까지 담겨 있어 별도 계측 없이도 비용과 지연을 추적할 수 있습니다.
주의할 점: deeptutor serve의 --host 기본값은 0.0.0.0입니다. v1.6.15 런처 코드(runtime/launcher.py)도 백엔드 uvicorn에 --host 0.0.0.0을 넘깁니다. 인증 기본값은 꺼져 있습니다. 박스에서 비루프백 인터페이스 IP로 /api/sessions를 호출하자 인증 없이 200과 함께 대화 세션 목록(제목·마지막 메시지 포함)이 돌아왔습니다. 혼자 쓰는 노트북에서 Wi-Fi 방화벽이 열려 있거나, 교내·사내 공용 서버에 “일단 띄워 보기”로 올리면 학습 기록이 같은 네트워크에 노출될 수 있습니다. README의 Docker 예시가 일관되게 -p 127.0.0.1:3782:3782를 쓰는 이유도 이것으로 보입니다. 로컬 설치라면 --host 127.0.0.1(serve)이나 호스트 방화벽을 쓰고, 여러 사람이 쓴다면 반드시 인증을 켜고 리버스 프록시 뒤에 두세요.
6. 비슷한 도구와 비교
“내 문서 위에서 돌아가는 AI 비서”는 많지만 지향점이 다릅니다. 아래 표는 각 저장소의 설명과 라이선스(2026-10-28 KST 조회)를 바탕으로 포지셔닝을 비교한 것이며, 성능 비교는 아닙니다.
| 프로젝트 | 라이선스 · 스타 | 중심 개념 | DeepTutor 대비 |
|---|---|---|---|
| HKUDS/DeepTutor | Apache-2.0 · 46,120 | 학습 런타임: 숙달 게이트, 문제은행, 코스, 3층 메모리, 다중 RAG 엔진, 서브에이전트 | 기준. 교육 절차를 코드로 고정한 것이 차별점 |
| lfnovo/open-notebook | MIT · 40,645 | NotebookLM의 오픈소스 구현 | 노트·요약·팟캐스트형 이해에 가깝고, 숙달 추적·채점 루프는 DeepTutor가 더 깊음 |
| Mintplex-Labs/anything-llm | MIT · 67,658 | 범용 문서 채팅·에이전트 워크스페이스 | 범용성은 높고 학습 특화 capability는 없음 |
| open-webui/open-webui | 자체 라이선스(API상 NOASSERTION) · 156,984 | Ollama/OpenAI 호환 채팅 UI | 모델 프런트엔드에 가까움. 라이선스 조건을 따로 검토해야 함 |
| khoj-ai/khoj | AGPL-3.0 · 37,858 | 셀프호스트 “second brain” | 개인 지식 검색 중심. AGPL이라 사내 SaaS 재배포 시 의무 검토 필요 |
7. 설계상 트레이드오프와 한계
- 표면적이 매우 넓습니다. 도구 101개, capability 11개, API 경로 560개, 15개 이상의 설정 파일, IM 채널·서브에이전트·스킬 허브까지 갖췄습니다. 기능이 많은 만큼 업그레이드 회귀 위험도 큽니다. 릴리스 노트의 상당 부분이 “quiet failure” 수정이라는 점이 그 방증입니다. 사내 도입이라면 버전을 고정(
ghcr.io/hkuds/deeptutor:1.6.15)하고 단계적으로 올리세요. - 설치 무게: PyPI 전체 설치만으로 venv가 약 1.2GB입니다(llama-index, litellm, onnxruntime, PyMuPDF, faiss 등). GraphRAG(Python 3.11–3.13), Manim(LaTeX/ffmpeg), Matrix E2EE(libolm)는 별도 extra와 시스템 라이브러리가 필요합니다.
dev에서 진행 중인 설치 모듈화가 정식 릴리스에 들어오면 달라질 수 있습니다. - 문서와 배포 상태의 불일치:
AGENTS.md는pip install deeptutor-cli를 안내하지만 PyPI에서deeptutor-cli는 404였습니다. README는 “아직 PyPI 미배포, 소스에서pip install -e ./packaging/deeptutor-cli“라고 적고 있으니 README를 따르세요. 화면 캡처 일부도 v1.4.6 기준이라고 README가 스스로 밝힙니다. - 컨텍스트 예산: 위 스모크 테스트처럼 기본 프롬프트만 약 1만 토큰입니다. 작은 로컬 모델에는 불리합니다.
- 평가의 범위:
kb eval은 검색 품질 지표입니다. 튜터 답변의 교육적 정확성이나 채점 공정성을 재는 도구는 아닙니다. 토큰 커버리지 매칭이라 패러프레이즈에 약합니다. - 보안 기본값: 인증 꺼짐,
0.0.0.0바인딩, subprocess 폴백 허용, 요청 스크리닝 꺼짐 모두 “로컬 1인 사용”을 전제로 한 기본값입니다. 저장소는 이를 문서화해 두었지만, 기본값 그대로 공유 환경에 올리는 것은 위험합니다.
8. 누가 도입하면 좋은가
| 대상 | 적합도 | 이유 / 시작점 |
|---|---|---|
| 에듀테크 제품팀(프로토타이핑) | 높음 | 숙달 경로·문제은행·코스를 처음부터 만들지 않고 capability 단위로 실험. run … --format json으로 백엔드처럼 호출 |
| 대학 연구실·교강사 | 높음 | 교재 PDF로 KB를 만들고 kb eval로 검색 품질 기준선 확보. Docker + 인증 활성화로 수업 단위 운영 |
| RAG 엔지니어 | 중~높음 | LlamaIndex/LightRAG/GraphRAG/PageIndex를 같은 UI·같은 평가 루프로 비교하는 테스트베드 |
| 에이전트 하네스 개발자 | 중 | NDJSON 이벤트 계약, 턴 재생, 서브에이전트 커넥터(Claude Code·Codex·Grok CLI 등) 구현 참고 |
| 개인 학습자(비개발자) | 중 | Docker 한 줄로 시작은 쉽지만 설정 표면이 넓음. 루프백 바인딩을 꼭 유지 |
| 규제 환경 대규모 서비스 | 낮음(현재) | 멀티유저·권한 기능은 있으나 빠른 릴리스 주기와 넓은 API 표면 때문에 자체 보안 검토 부담이 큼 |
9. 정리
DeepTutor의 진짜 기여는 “AI 튜터”라는 이름보다 교육 절차를 런타임으로 만든 방식에 있습니다. 진입점 세 개가 하나의 영속 턴 엔진으로 모이고, 모델이 고르는 Tools와 코드가 고정하는 Capabilities를 분리했습니다. 메모리는 각주가 달린 문서로 남겨 감사할 수 있게 했고, 검색 품질은 eval/eval-diff로 숫자로 비교합니다. 반면 기본 컨텍스트 비용이 약 1만 토큰이고, 설치가 무겁고, 인증 꺼짐 + 0.0.0.0 바인딩이라는 로컬 지향 기본값을 갖고 있다는 점은 도입 전에 반드시 짚어야 합니다. 시작은 Docker 예시 그대로 127.0.0.1에 묶어 두고, 교재 KB 하나와 QA 세트 수십 개로 kb eval 기준선부터 잡아 보시길 권합니다.