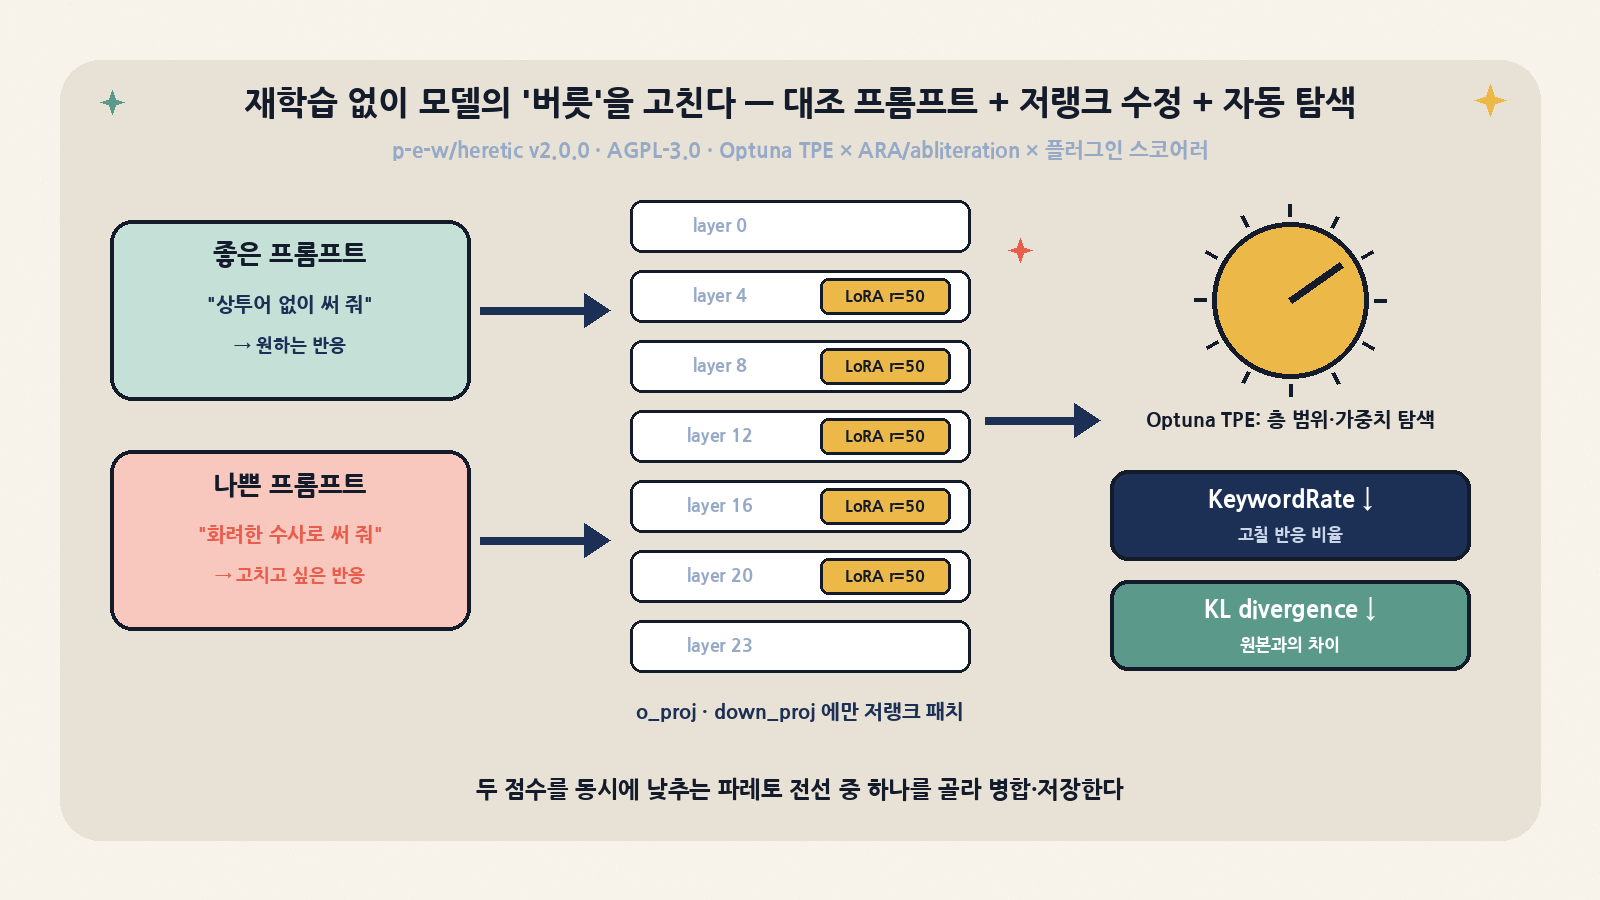
한 줄 요약: p-e-w/heretic는 가중치를 다시 학습하지 않고, 대조 프롬프트 두 묶음이 만드는 활성값 차이와 Optuna 하이퍼파라미터 탐색만으로 LLM의 특정 행동을 바꾸는 파이썬 도구입니다. 11월 1일(KST 11/01 22:03) 나온 v2.0.0에서 큰 구조 변경이 있었습니다. 기본 수정 방식이 고전적인 abliteration에서 ARA(Arbitrary-Rank Ablation)로 바뀌었고, “무엇을 바꿀지”와 “무엇을 좋다고 볼지”가 모두 플러그인이 됐습니다. 오늘(11/04) GitHub Trending 전체 6위(+701★, 38,867★)에 올랐습니다. 이 글에서는 구조와 코드, 설계 선택, 운영상 주의점을 살펴보고, GPU가 없는 8코어 박스에서 검열 해제가 아닌 상투어(slop) 억제 설정으로 직접 돌려 본 결과도 함께 정리합니다.
1. 왜 지금 heretic인가: v2.0.0에서 달라진 것
heretic은 2025년 11월에 처음 공개됐고, 처음에는 “안전 거부(refusal)를 자동으로 지우는 abliteration 도구”로 알려졌습니다. README의 기본 동작도 여전히 검열 제거(config.default.toml)입니다. 그런데 v2.0.0의 실제 변화는 범용화에 가깝습니다. 저장소 설명도 “Training-free language model modification: Remove censorship, suppress slop, reduce sycophancy, and more”로 바뀌었고, 거부 억제는 여러 목표 중 하나가 됐습니다.
| 항목 | 확인한 값 (2026-11-04 KST) | 출처/비고 |
|---|---|---|
| 저장소 | p-e-w/heretic (작성자 Philipp Emanuel Weidmann) |
Codeberg 미러 병행 |
| 최신 릴리스 | v2.0.0 · GitHub 2026-11-01 22:03 KST / PyPI heretic-llm 2.0.0 같은 날 21:21 KST 업로드 |
master는 이미 2.1.0.dev0 |
| 라이선스 | AGPL-3.0-or-later | 네트워크 서비스로 제공할 때도 소스 공개 의무 |
| 스타 / 포크 | 38,867★ (트렌딩 페이지) · API 38,870★ / 4,389 포크 | 오늘 +701★ |
| 트렌딩 순위 | 전체 6위 · Python 1위 | 11/04 daily |
| 요구 사항 | Python 3.10+, PyTorch 2.6+ (torch 버전은 의도적으로 고정하지 않음) | CI는 3.10~3.15 |
| 코드 규모 | src/heretic 약 7,100줄 (main 1,485 · model 978 · ARA 396 · abliteration 466) |
wc -l 실측 |
| HF 생태계 | heretic 태그가 붙은 모델이 API 한 페이지 상한인 1,000개를 넘김 |
README에는 “수천 개”라고 적혀 있음 |
v2.0.0 릴리스 노트에서 운영에 영향이 큰 변경만 추리면 다음과 같습니다.
| 변경 | PR | 실무 영향 |
|---|---|---|
| modifier 플러그인 + ARA를 기본값으로 | #446 | 같은 설정이라도 v1과 결과가 다름. abliteration을 쓰려면 modifiers를 명시해야 함 |
| 범용 플러그인 시스템 (scorer) | #53 (리뷰 코멘트 약 350개) | import 경로나 path.py:Class 형식으로 외부 스코어러를 붙일 수 있음 |
| 헤드리스 실행 + E2E 테스트 | #392 | checkpoint_action·trial_index·model_action·save_directory로 대화형 질문 없이 실행 가능 → CI·배치 작업용 |
| BenchmarkScore (lm-eval) | #444 | PIQA 같은 표준 벤치 점수를 최적화 목표나 감시 지표로 사용 |
| BERT 분류기 스코어러 | #500 | 키워드 매칭 대신 ModernBERT 거부 분류기(VINAY-UMRETHE/Refusal-Classifier)로 판정 |
config.nosyco.toml |
#349 | 아첨(“great question!”) 억제 프리셋 |
| Hyper-Connections 모델 지원 | #519, #525 | 잔차 스트림이 여러 갈래인 최신 아키텍처 대응 |
| ARA 클로저 저랭크화 | #499 | 밀집 가중치를 만들지 않고 (x·Aᵀ)·Bᵀ만 다시 계산 → 메모리·속도 개선 |
| 연구 기능 제거, KL 균형 옵션 제거 | 마이그레이션 문서 | 잔차 플롯 등은 별도 프로젝트 Lophius로 이동. v1 설정 파일은 그대로 쓸 수 없음 |
2. 동작 원리: “측정 → 탐색 → 선택”을 한 프로세스에서
heretic의 핵심 루프는 main.py의 objective() 함수 하나로 끝납니다. 매 trial마다 ① modifier가 Optuna Trial에서 파라미터를 받고(suggest_parameters), ② 모델을 초기화한 뒤(reset_model), ③ 수정하고(modify_model), ④ 설정된 모든 스코어러로 평가해 다목적 값을 돌려줍니다. 샘플러는 TPESampler(multivariate=True, n_ei_candidates=128)이고, 기본값은 100 trial 중 처음 30회를 무작위 탐색에 씁니다. 체크포인트는 JournalStorage(JSONL)에 저장되므로 중단 후 이어서 돌릴 수 있습니다.
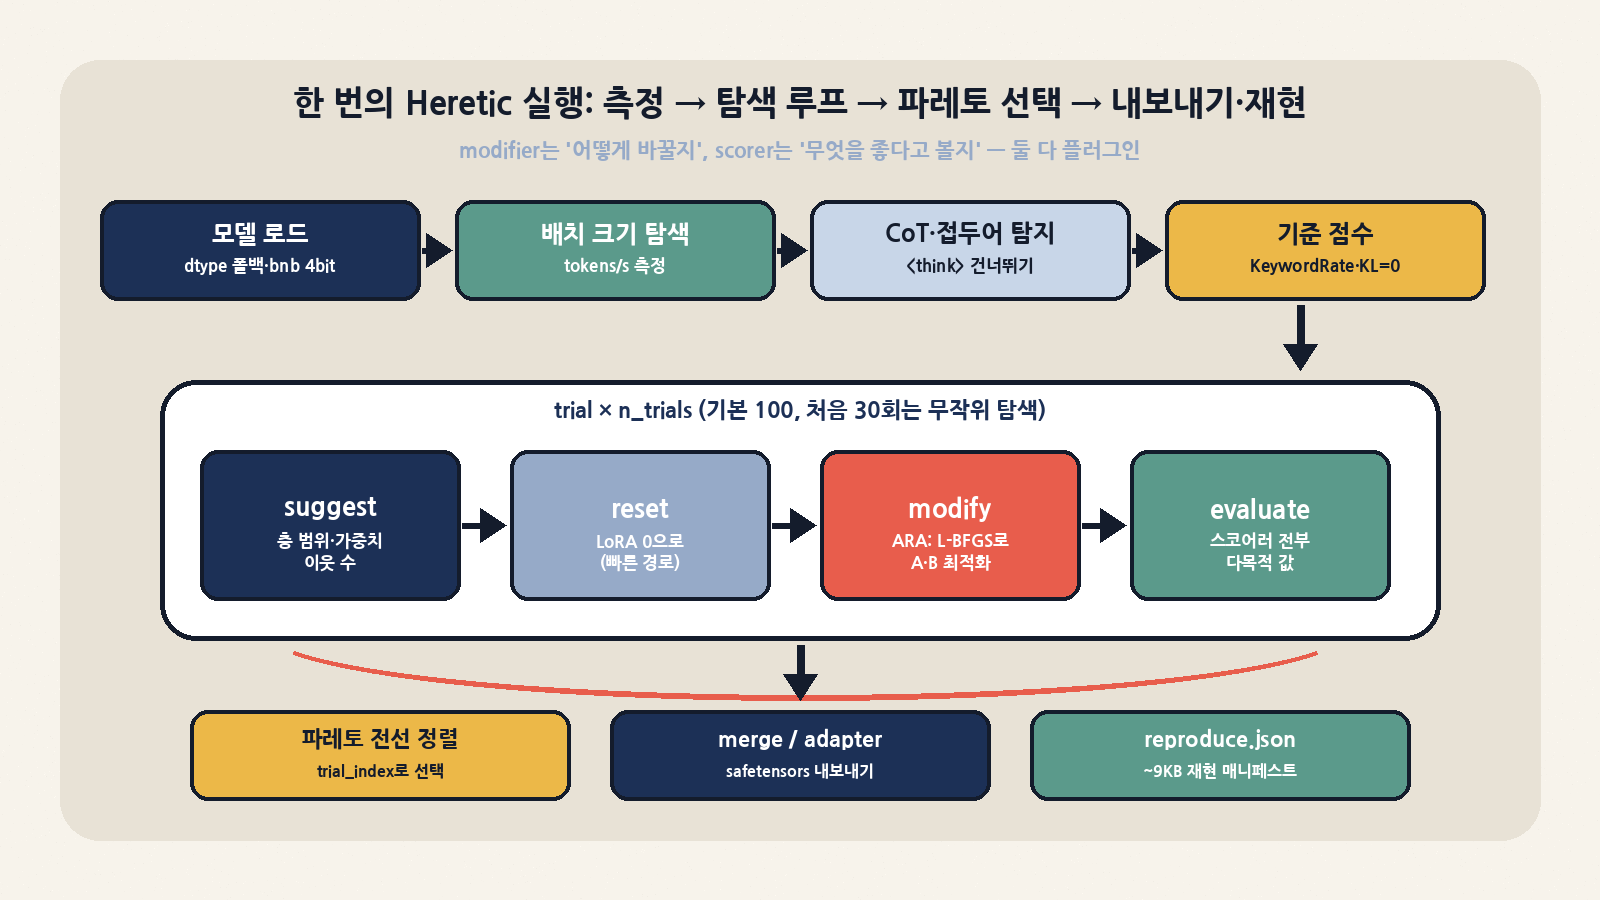
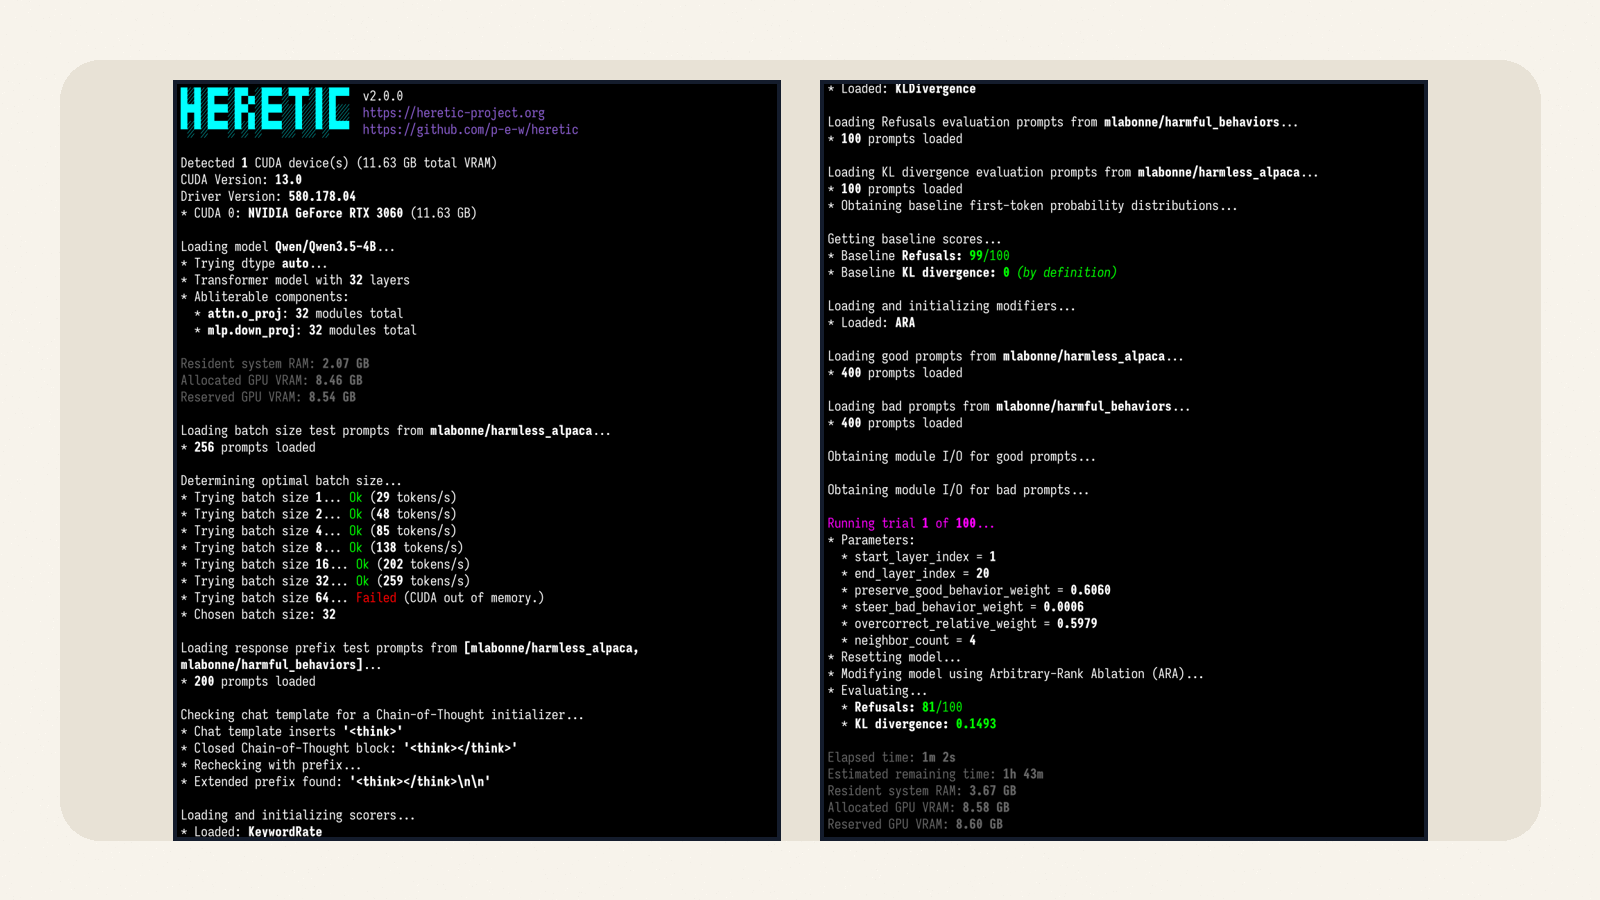
루프 앞에서 하는 준비 작업도 결과에 영향을 줍니다. dtype은 auto → float16 → bfloat16 → float32 순서로 시도하다 실패하면 다음으로 넘어갑니다. 배치 크기는 1부터 두 배씩 늘리며 tokens/s를 재서 고릅니다. 채팅 템플릿에 <think> 같은 CoT 블록이 있으면 이를 감지해 건너뛰고, 응답 공통 접두어도 찾아서 평가가 “실제 답의 첫머리”에서 이뤄지도록 맞춥니다. 추론 모델을 다룰 때 이 처리가 없으면 KeywordRate가 생각 과정의 문구에 걸려 점수가 틀어집니다.
2-1. 두 개의 기본 스코어러
| 스코어러 | 측정 방식 | 강점 | 함정 |
|---|---|---|---|
KeywordRate |
응답에 마커 문자열(대소문자 무시)이 하나라도 있으면 1건으로 셈. 기본 마커는 “sorry”, “as an ai”, “i cannot” 등 33개 | 빠르고 투명하며 목적을 바꾸기 쉬움 (noslop 프리셋은 “tapestry”, “ethereal” 등 130여 개) | 마커를 피하면서 실제 행동은 그대로인 “우회 문체”를 잡지 못함. 응답이 망가져도 마커만 없으면 점수가 좋아짐 |
KLDivergence |
무해 프롬프트에서 첫 토큰 확률분포가 원본과 얼마나 다른지 측정 (기준선 0) | 모델 손상을 싸게 대리 측정 | 첫 토큰만 보므로 긴 생성의 품질 저하는 놓칠 수 있음 → BenchmarkScore로 보완 |
BERTClassifier |
(프롬프트, 응답) 쌍을 분류기로 판정. full/partial_refusal 라벨 등 | 문장 표현이 바뀌어도 의미 단위로 판정 | 분류기의 편향이 그대로 최적화 목표가 됨. 모델 커밋 고정 권장 |
BenchmarkScore |
lm-eval 태스크 지표 (기본 piqa acc_norm) |
지능 보존을 직접 확인 | trial마다 돌리면 매우 느림. 보통 optimization = "none"으로 두고 감시용으로 사용 |
스코어러 인터페이스(scorer.py)는 get_score(ctx) → Score(value, rich_display, md_display) 하나만 구현하면 됩니다. 문서에는 “value의 크기가 1 정도여야 다목적 최적화에서 비교할 수 있다”는 조건이 적혀 있습니다. 직접 스코어러를 만들 때 가장 놓치기 쉬운 부분입니다. 예를 들어 퍼센트를 0~100 그대로 반환하면 KL 쪽 신호가 사실상 묻혀 버립니다.
3. 두 가지 modifier: abliteration과 ARA
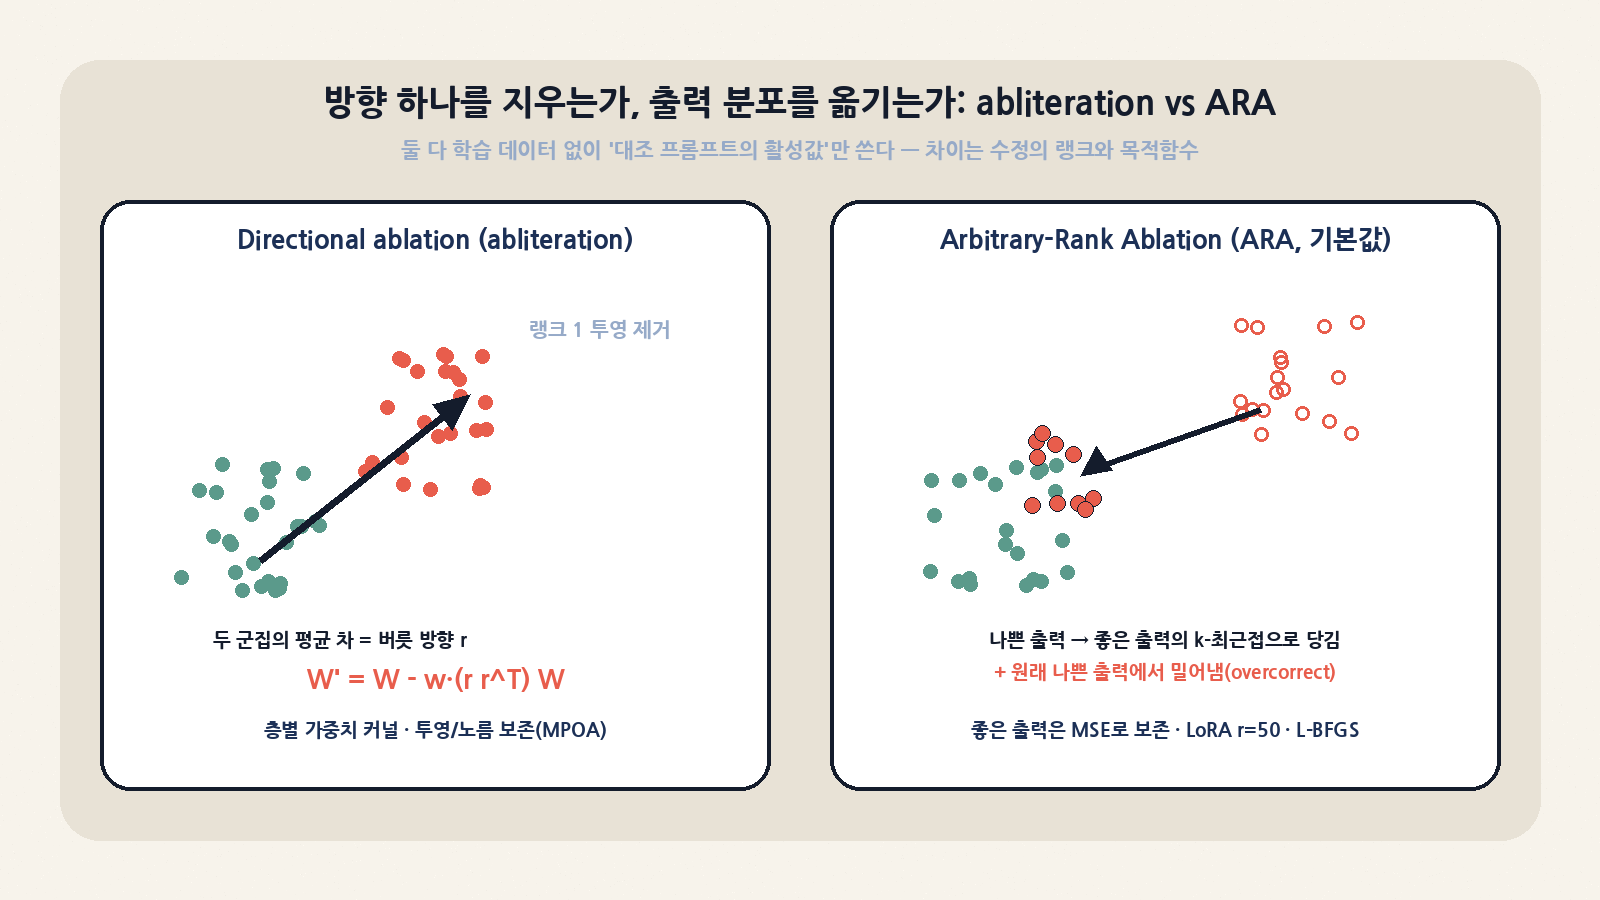
Directional ablation(abliteration)은 Arditi et al.(2024)의 방법입니다. “나쁜” 프롬프트와 “좋은” 프롬프트의 잔차 평균 차이를 방향 벡터 r로 잡고, attn.o_proj와 mlp.down_proj의 가중치에서 그 방향 성분을 투영해 제거합니다. heretic 구현은 몇 가지를 탐색 공간에 넣습니다. 방향을 뽑을 층(direction_index, 마지막 층 인덱스의 0.4배부터 시작하는 실수 값), 컴포넌트별 층 가중치 커널(max_weight, max_weight_position, min_weight, min_weight_distance)이 그 예입니다. 여기에 projected abliteration(좋은 방향과 직교하는 성분만 빼기)과 norm preservation(MPOA, 행 노름 보존)을 옵션으로 지원합니다.
ARA는 heretic에서 새로 만든 방법이고 v2의 기본값입니다(논문은 공개 예정). 방향 하나를 지우는 대신, 각 대상 모듈에 랭크 50짜리 LoRA(A·B)를 붙이고 L-BFGS(strong Wolfe 라인서치, 외부 5스텝 × 내부 최대 20회)로 다음 손실을 최소화합니다.
loss = w_preserve · MSE(new_good, good)                     # 좋은 입력의 출력은 그대로
     + w_steer · ( kNN_dist(new_bad → good_outputs)          # 나쁜 출력을 좋은 출력 근처로 당기고
                 − w_over · kNN_dist(new_bad → bad_outputs) ) # 원래 나쁜 출력에서는 밀어냄(과보정)
# 행 노름 보존: output *= ||W_row|| / ||(W + B·A)_row||
Optuna가 탐색하는 값은 시작·끝 층, 세 가중치(preserve 0~1, steer 1e-4~1 로그 스케일, overcorrect 0~1.3), 최근접 이웃 수(1~15)입니다. 모듈의 입출력은 처음에 한 번만 수집해 두고, 이후 각 trial은 이 캐시만으로 저랭크 최적화를 다시 합니다. 그래서 trial마다 추론 패스를 반복하지 않습니다. 모델 리셋은 LoRA A·B를 0으로 만드는 “빠른 경로”라서 모델을 다시 읽지 않습니다.
| 비교 축 | Abliteration (heretic 구현) | ARA (v2 기본) |
|---|---|---|
| 수정의 형태 | 랭크 1 방향 투영 제거 (+ 노름 보존 시 랭크 3 근사) | 모듈당 랭크 50 LoRA를 수치 최적화 |
| 목표의 정의 | 평균 차이 방향 하나 | 출력 분포 수준에서 kNN 당김/밀어냄 + 보존 MSE |
| 강점 | 해석이 쉽고 빠르며 선행 연구와 비교가 쉬움 | 거부가 여러 방향에 흩어진 “복잡한 거부 메커니즘”까지 다룰 수 있도록 설계됨 |
| 비용 | 방향 계산 후 행렬 연산 한 번 | 층 × 모듈마다 L-BFGS (CPU에서는 trial당 수십 초 이상) |
| 재현성 | reproducible 지원 |
reproducible = True, A 초기화를 CPU 시드 생성기로 고정 |
| 위험 | 방향이 틀리면 무관한 능력까지 깎임 | overcorrect가 크면 KL 폭증 (아래 실측의 trial 1) |
4. 저장소 구조와 확장 지점
| 경로 | 역할 | 읽을 포인트 |
|---|---|---|
src/heretic/main.py |
CLI, 스터디 루프, 파레토 선택, 저장·업로드·채팅·벤치 메뉴 | objective()와 sorted_trials 정렬 키 (스코어 튜플 오름차순) |
model.py |
로딩, dtype 폴백, bnb 4bit, LoRA 적용, 모듈 I/O 수집, 리셋 빠른 경로 | get_module_io_batched, reset_model |
modifier.py / modifiers/ |
Modifier 추상 클래스, ara.py, abliteration.py |
제네릭 Parameters 직렬화 → reproduce.json에 기록 |
scorer.py / scorers/ |
Scorer 추상 클래스와 4종 구현 | get_baseline_score 재정의 가능 |
plugin.py |
플러그인 로딩 (pkg.mod.Class 또는 file.py:Class), 인스턴스 이름별 설정 |
[scorer.KeywordRate_small] 같은 인스턴스 덮어쓰기 |
reproduce.py / system.py |
재현 매니페스트(v4) 생성·검증, 환경 비교 | 버전 4 미만 매니페스트는 거부 → v1.4 필요 |
config.*.toml |
default · noslop · nohumor · nosyco · emotions · classifier · piqa 프리셋 | 사실상 “목적별 레시피” 모음 |
tests/ |
tiny-random 모델별 SHA256 해시 기반 재현성 테스트 (deepseek-v4, gemma-3, gpt-oss, qwen2.5 등) | OS별 해시 목록을 따로 관리 (linux/windows/ci) |
재현성 설계도 볼 만합니다. 모델을 Hugging Face에 올릴 때 약 9KB의 reproduce/reproduce.json을 같이 넣을 수 있고, heretic --reproduce path/to/reproduce.json을 실행하면 탐색을 다시 하지 않고 선택된 파라미터만 적용해 몇 분 만에 같은 모델을 만듭니다. 이때 하드웨어·드라이버·패키지 버전을 원본과 비교해 어떤 차이가 있는지 알려 줍니다. 공개된 매니페스트 모음을 “Heretic Grimoire”라고 부르며, heretic --collect-reproducibles DIR로 로컬에 추가 전용(append-only) 백업을 만들 수 있습니다. 가중치 대신 레시피를 배포하는 방식이라, 모델 파일을 다시 배포하기 어려운 라이선스 환경에서도 쓸 수 있다는 점이 흥미롭습니다. 다만 그 라이선스에서 파생 모델을 만들어도 되는지는 별도로 확인해야 합니다.
5. 설치와 실행 (공식 경로 + 헤드리스)
# 공식 README 경로
pip install -U heretic-llm
heretic Qwen/Qwen3-4B-Instruct-2507        # 기본 설정 = 거부 억제

# 다른 목적: 프리셋을 작업 디렉터리의 config.toml로 복사
curl -LO https://raw.githubusercontent.com/p-e-w/heretic/v2.0.0/config.noslop.toml
mv config.noslop.toml config.toml
heretic Qwen/Qwen2.5-0.5B-Instruct

# 헤드리스(대화형 질문 없이) — config.toml 상단에
#   export_strategy = "merge"  checkpoint_action = "restart"
#   trial_index = 0  model_action = "save"  save_directory = "out"
# CLI 덮어쓰기는 등호 형식 권장 (이유는 아래 주의 참고)
heretic --trial-index=1 --save-directory=model-pf1
공식 문서에는 RTX 3090에서 Qwen3-4B-Instruct-2507을 기본 설정으로 처리하는 데 30~40분이 걸린다고 나와 있습니다. VRAM이 부족하면 quantization = "bnb_4bit"로 실행 중에 4비트 양자화를 할 수 있고, 정확도가 조금 떨어지는 대신 메모리 요구량은 일반적인 양자화 모델을 돌릴 때와 비슷해집니다.
실행하면서 발견한 주의점 두 가지. ① master README는 HERETIC_CONFIG_FILE 환경변수로 설정 파일 경로를 바꿀 수 있다고 설명하지만, 이 기능(#557)은 v2.0.0 릴리스 이틀 뒤인 11/03에 병합됐습니다. PyPI 2.0.0은 항상 작업 디렉터리의 config.toml을 읽습니다. 박스에서 환경변수를 지정했지만 무시되는 것을 확인했고, 설치된 config.py에도 toml_file="config.toml"이 하드코딩돼 있습니다. ② run()은 “마지막 인자가 -로 시작하지 않으면 모델 이름”으로 간주해 앞에 --model을 끼워 넣습니다. 그래서 --save-directory model-pf1처럼 띄어 쓰면 argument --save-directory: expected one argument 오류가 납니다. --save-directory=model-pf1처럼 등호로 붙이면 정상 동작합니다.
6. 박스 실측: GPU 없이 8코어 CPU에서 noslop 축소판 돌려 보기
직접 돌려 본 환경은 GPU가 없는 8코어 리눅스 박스입니다. PyPI의 heretic-llm 2.0.0을 새 가상환경에 설치하고, 공식 config.noslop.toml(상투어 억제 프리셋)을 바탕으로 CPU에서 끝날 수 있도록 규모만 줄였습니다. 검열 해제용 기본 설정은 일부러 쓰지 않았습니다.
| 설정 | 값 | 공식 프리셋 대비 |
|---|---|---|
| 모델 | Qwen/Qwen2.5-0.5B-Instruct, dtypes = ["float32"] |
CPU라서 fp32 고정 |
| trial 수 | n_trials = 8, n_startup_trials = 4 |
기본 100 / 무작위 30에서 크게 축소 |
| 대조 프롬프트 | ARA good/bad 각 64개 (train[:64]) |
축소 |
| 평가 프롬프트 | KeywordRate·KL 모두 llm-aes/writing-prompts 30개 |
축소 |
| 응답 길이 | max_response_length = 120 |
짧게 |
| 시드 | seed = 20261104 |
재현성 확인용 |
| 실행 방식 | 헤드리스 (checkpoint_action = "restart", model_action = "save", export_strategy = "merge") |
대화형 질문 없음 |
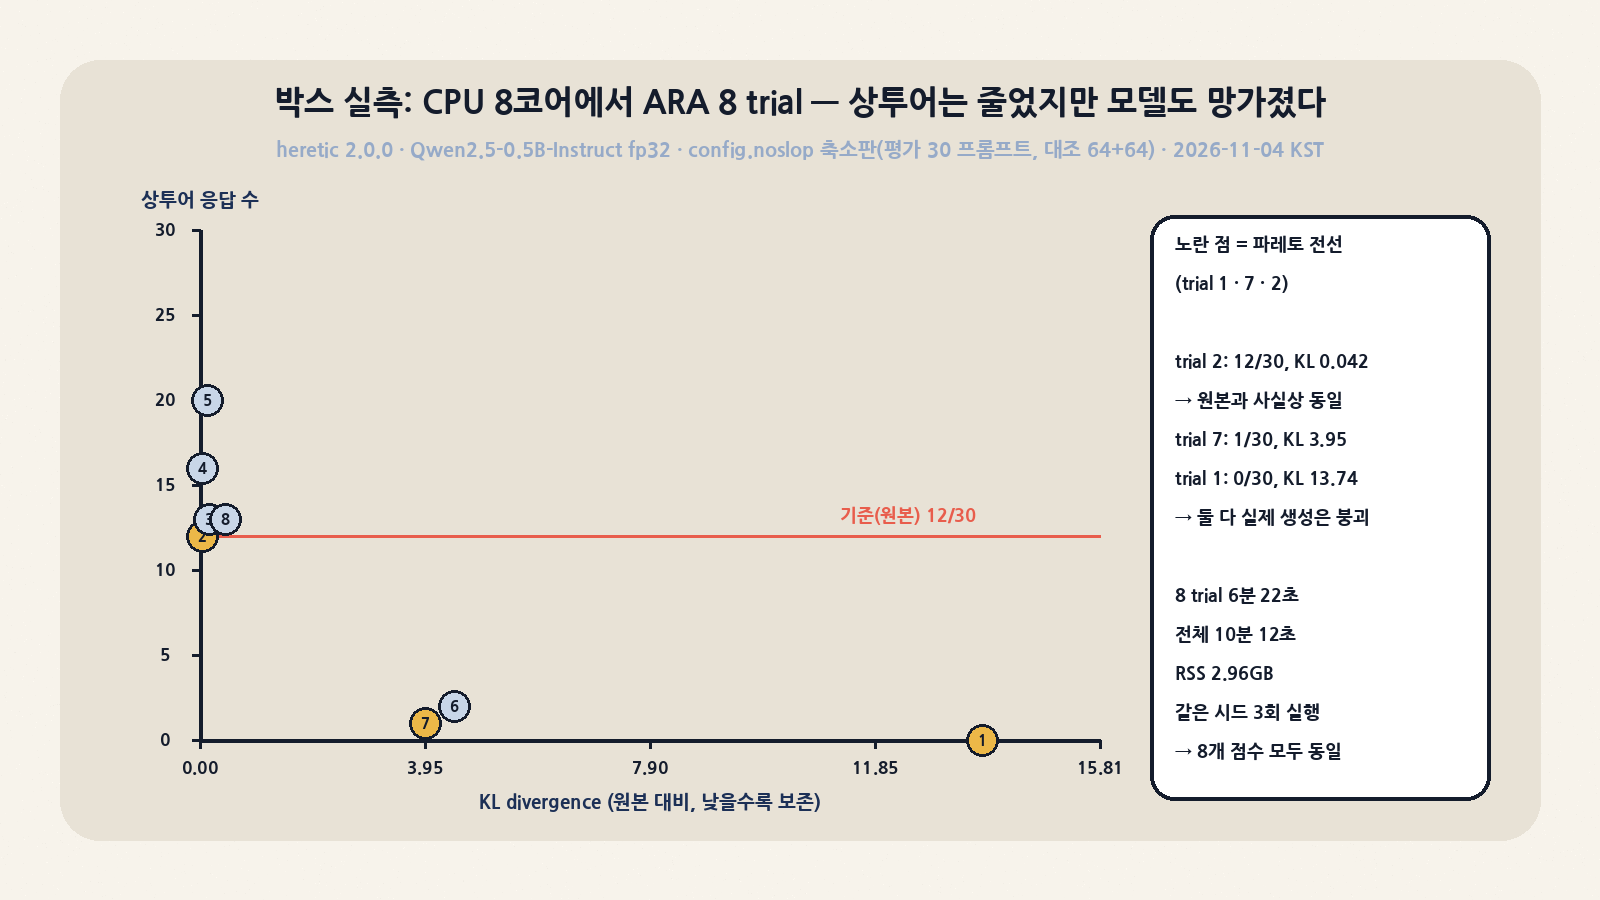
기준선(원본 모델)은 평가 프롬프트 30개 중 12개 응답에 상투어 마커가 들어 있었습니다. 8번의 trial 결과는 아래와 같습니다.
| trial | 상투어 응답 (/30) | KL divergence | 파레토 전선 | 해석 |
|---|---|---|---|---|
| 기준선 | 12 | 0 | – | 원본 |
| 1 | 0 | 13.7445 | 예 | 점수는 최고지만 분포가 크게 무너짐 |
| 2 | 12 | 0.0421 | 예 | 원본과 사실상 같음 (변화 없음) |
| 3 | 13 | 0.1746 | 아니오 | 오히려 약간 늘어남 |
| 4 | 16 | 0.0525 | 아니오 | 악화 |
| 5 | 20 | 0.1298 | 아니오 | 악화 |
| 6 | 2 | 4.4727 | 아니오 | trial 7에 지배됨 |
| 7 | 1 | 3.9531 | 예 | 중간 지점처럼 보이지만 KL이 이미 큼 |
| 8 | 13 | 0.4529 | 아니오 | 악화 |
숫자만 보면 trial 7(1/30, KL 3.95)이 괜찮은 타협처럼 보입니다. 그래서 heretic이 저장한 두 모델, 즉 파레토 정렬 첫 번째인 trial 1(model-noslop)과 두 번째인 trial 7(--trial-index=1, model-pf1)로 실제 글을 생성해 봤습니다. 평가에 쓰지 않은 다른 구간(train[3000:3012])의 작문 프롬프트 12개, 그리디 디코딩, 최대 120토큰 조건입니다.
| 모델 | 상투어 응답 (/12) | 마커 총 출현 | 평균 고유 단어 비율 | 실제 출력 상태 |
|---|---|---|---|---|
| 원본 | 6 | 14 | 0.806 | 평범하지만 정상적인 짧은 이야기 |
trial 7 (model-pf1) |
0 | 0 | 0.370 | “are always about their own stories…” 같은 구절 반복, 일부는 BOM 문자만 출력 |
trial 1 (model-noslop) |
0 | 0 | 0.988 | 여러 언어 토큰과 코드 조각이 뒤섞인 무의미한 문자열 (고유 단어 비율이 높은 것은 오히려 붕괴의 신호) |
결론은 분명합니다. 상투어 마커는 0이 됐지만 모델이 글을 쓰지 못하게 됐습니다. 키워드 스코어러만 보면 성공으로 보이는 전형적인 Goodhart 사례입니다. 원인은 trial 수(8)가 너무 적어서 KL 0.04~0.45 근처의 “안전한 구간”과 KL 4 이상의 “붕괴 구간” 사이를 탐색하지 못한 데 있다고 봅니다. 공식 기본값처럼 100 trial을 돌리거나 KL에 상한을 두는 방식이었다면 결과가 달랐을 수 있지만, 이번 박스 실측으로는 확인하지 못했습니다. 실무에서는 KL 1 미만처럼 기준을 먼저 정해 두고, 파레토 후보를 고를 때 반드시 실제 생성 샘플을 함께 보는 절차가 필요합니다.
| 운영 지표 | 실측값 |
|---|---|
| 8 trial 소요 | 약 6분 22초 (trial당 약 40~60초) |
| 설정 로딩부터 병합 저장까지 전체 | 10분 12초 |
| 최대 상주 메모리(RSS) | 약 2.96GB (로그상 trial 중 2.84GB) |
| 재현성 | 같은 설정·시드로 3회 실행, 8개 trial의 점수가 모두 같게 나옴 |
7. 비슷한 도구·접근과 비교
README의 “Prior art”에는 heretic 공개(2025년 11월) 당시 존재하던 구현으로 AutoAbliteration, FailSpy의 abliterator.py, wassname Abliterator, ErisForge, remove-refusals-with-transformers, deccp가 나옵니다. heretic은 이 코드들을 가져다 쓰지 않고 처음부터 새로 작성했다고 밝힙니다. 아래 표는 각 도구의 세부 성능을 비교한 것이 아니라, 접근 방식 단위로 위치를 정리한 것입니다.
| 접근 | 대표 예 | 학습 필요 | 파라미터 탐색 | 목표 일반성 | 이럴 때 적합 |
|---|---|---|---|---|---|
| 자동 탐색형 활성값 편집 | heretic (ARA/abliteration + Optuna) | 없음 (대조 프롬프트만) | TPE 다목적 자동 | 스코어러 플러그인으로 임의 목표 | “행동 하나를 줄이고 나머지는 보존” + 재현 가능한 레시피가 필요할 때 |
| 수동 abliteration 스크립트/노트북 | FailSpy abliterator, mlabonne 글과 노트북, remove-refusals-with-transformers | 없음 | 사람이 층·가중치를 고름 | 주로 거부 방향 | 원리를 배우거나 특정 모델에 맞춰 손으로 튜닝할 때 |
| 추론 시 steering vector | 활성값 더하기/빼기 훅 (예: repeng류) | 없음 | 보통 수동 계수 | 범용 | 가중치를 건드리지 않고 런타임에 켜고 끄고 싶을 때 |
| LoRA SFT / DPO·ORPO | TRL, Axolotl, Unsloth 등 | 데이터셋 + GPU 학습 | 학습 하이퍼파라미터 | 가장 넓음 | 새 지식이나 형식을 가르치거나 대규모로 정렬할 때 |
| 프롬프트·시스템 지시 | “상투어를 피하라” 지시 | 없음 | 없음 | 제한적 | 가장 싸고 되돌리기 쉬움. 먼저 시도할 기준선 |
| heretic 도입 판단 체크 | 예 | 아니오 |
|---|---|---|
| 바꾸려는 행동을 프롬프트 대조 쌍으로 유도할 수 있나? | ARA/abliteration이 잘 맞음 | SFT·DPO 쪽이 맞음 |
| 행동을 자동 채점할 수 있나 (키워드·분류기·벤치)? | 스코어러로 바로 최적화 가능 | 채점기부터 만들어야 함. 이것이 가장 큰 비용 |
| GPU가 있나 (8~24GB)? | 4B급 기본 설정 30~40분 (3090 기준, 공식) | CPU로는 0.5B·trial 수 축소 수준까지만 현실적 (아래 실측) |
| 파생 모델을 서비스로 내보내나? | 원본 모델 라이선스 + AGPL(도구 자체 수정·서비스화 시) 검토 | 사내 실험이면 부담이 적음 |
8. 한계와 주의점
- 기본값이 안전장치 제거라는 점. 설정 없이 실행하면 거부 억제 모델이 만들어집니다. 이런 모델을 사내 챗봇이나 고객용 서비스에 올리면 원본 모델이 막던 유해 응답이 그대로 나올 수 있습니다. 쓰는 쪽이 출력 필터, 사용 정책, 감사 로그를 따로 갖춰야 하고, 원본 모델 라이선스(사용 제한 조항)와 각국 규제 준수 책임도 쓰는 쪽에 있습니다. 이 글의 실측은 일부러 상투어 억제 프리셋으로만 했습니다.
- Goodhart 위험. 실측에서 보듯 “마커가 0건”은 “좋은 글”을 뜻하지 않습니다. KL이 13.7까지 오른 trial은 KeywordRate만 보면 가장 좋은 점수입니다. 키워드 스코어러를 쓴다면 KL에 더해 BenchmarkScore를 감시 지표(
optimization = "none")로 함께 두는 편이 안전합니다. - 첫 토큰 KL의 한계. KLDivergence는 첫 토큰 분포만 비교합니다. 긴 생성에서 반복이나 붕괴가 생기는지는 따로 생성해서 확인해야 합니다.
- trial 수가 적으면 파레토 전선이 양 끝으로 갈라짐. 기본 100 trial(무작위 30)은 이유가 있는 값입니다. 8 trial로는 “원본과 거의 같다”와 “망가졌다” 사이의 중간 지점을 찾지 못했습니다.
- v1 → v2 비호환. 설정 키 이동, KL 균형 옵션 삭제, 연구 기능 제거가 있었습니다. 1.x 재현 매니페스트(버전 4 미만)는 2.x에서 읽을 수 없고 1.4를 설치해야 합니다.
- 재현성의 범위. 하드웨어·드라이버·OS·패키지가 완전히 같아야 바이트 단위로 같은 결과가 나옵니다. 그래서 테스트 해시도 OS별로 따로 관리합니다. 같은 박스에서 다시 실행했을 때 같은 점수가 나온 것(아래)은 이 범위 안의 결과입니다.
- 문서와 릴리스의 차이. master README는 PyPI 릴리스보다 앞서 갈 수 있습니다 (
HERETIC_CONFIG_FILE사례). 운영 스크립트는 설치한 태그(v2.0.0)의 문서를 기준으로 작성하세요.
9. 누가 써야 하나
| 대상 | 권장도 | 이유 |
|---|---|---|
| 로컬 LLM 연구자·해석 가능성(interpretability) 실험 | 높음 | modifier·scorer를 플러그인으로 바꿔 끼우며 “행동이 어디에 있나”를 실험하기 좋음. 리뷰 문화가 강한 작은 코드베이스 |
| 창작·문체 튜닝 (noslop, nohumor, emotions) | 중간~높음 | 학습 데이터 없이 문체 버릇을 줄일 수 있음. 단, 품질은 반드시 사람이 함께 검토 |
| 사내 어시스턴트 아첨 억제 (nosyco) | 중간 | 목표는 실용적이지만 마커 기반 측정의 한계가 큼. 분류기 스코어러 쪽을 권장 |
| 고객 대상 서비스에 거부 억제 모델 배포 | 낮음 (권장하지 않음) | 안전·법무·라이선스 책임이 큼. 꼭 필요하면 별도 가드레일 계층부터 |
| GPU 없는 환경 | 낮음 | 1B 이하 모델로 원리를 확인하는 정도. 실제 결과물에는 GPU 필요 |
정리하면, heretic v2.0.0은 abliteration 도구에서 출발해 학습 없이 모델을 고치는 범용 최적화 프레임워크로 바뀌는 중입니다. 기술적으로 가장 흥미로운 부분은 ARA라는 새 수정 방식보다, 무엇을 고칠지(scorer)·어떻게 고칠지(modifier)·어떻게 다시 만들지(reproduce.json)를 서로 떼어 낸 구조입니다. 그만큼 결과물의 품질과 책임은 쓰는 쪽이 어떤 스코어러를 고르고 어떻게 검증하느냐에 달려 있습니다.