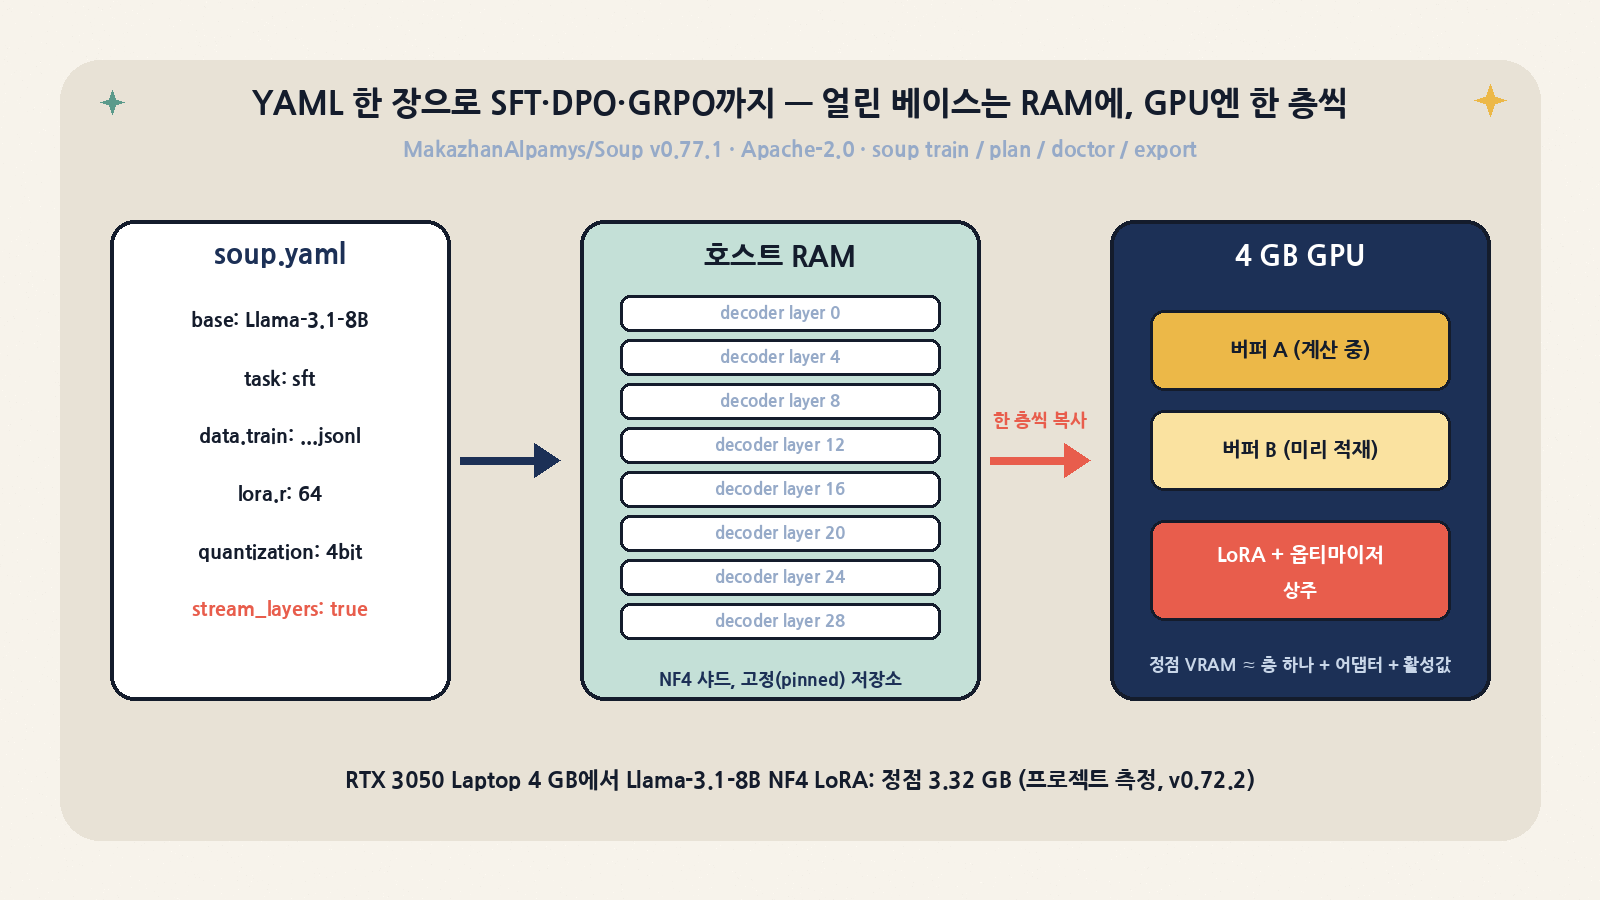
테크부터 경제, 생활까지. 복잡한 소식을 쉽게 풀어봅니다. 오늘 오후 오픈소스 심화는 실무자용입니다. 2026년 11월 4일 GitHub Trending Python 부문에 오른 MakazhanAlpamys/Soup(스타 약 1만 100개, Apache-2.0)는 “YAML 한 장, 명령 하나로 LLM을 파인튜닝한다”는 CLI입니다. 겉으로는 흔한 학습 래퍼처럼 보이지만, 이 저장소가 주목받는 이유는 따로 있습니다. 얼린 베이스 모델을 GPU가 아닌 호스트 RAM에 두고 디코더 층을 하나씩 GPU로 흘려보내는 ‘레이어 스트리밍’으로 4GB 노트북 GPU에서 Llama-3.1-8B LoRA 학습을 돌렸다는 주장, 그리고 그 주장을 뒷받침하는 측정 기록을 실패 사례까지 통째로 공개한 방식입니다.
이 글은 README·docs·benchmarks 폴더와 최신 릴리스 노트(v0.77.0, v0.77.1)를 직접 읽고, GPU가 없는 8코어 박스에 v0.77.1을 설치해 Qwen2.5-0.5B로 상주 학습과 레이어 스트리밍 학습을 같은 조건에서 돌려 본 결과를 함께 정리합니다.
한눈에 보는 Soup v0.77.1
| 항목 | 내용 |
|---|---|
| 저장소 | MakazhanAlpamys/Soup (2026년 2월 20일 생성), PyPI 패키지 이름은 soup-cli |
| 라이선스 | Apache-2.0 (재배포 시 LICENSE·NOTICE 유지, Soup 이름 사용 제한 명시) |
| 최신 릴리스 | v0.77.1 (2026-10-28), 그 직전 v0.77.0 (2026-10-26) |
| 지원 파이썬 | 3.11~3.13 (CI 검증 범위, 3.14는 아직 미지원) |
| 학습 백엔드 | transformers(기본), Unsloth([fast]), Apple Silicon용 MLX |
| 학습 과제 | SFT, DPO, GRPO, PPO, KTO, ORPO, SimPO, IPO, BCO, 보상 모델, 사전학습, 증류, 비전·오디오 등 |
| 내보내기 | LoRA 병합, GGUF(Ollama·llama.cpp), ONNX, TensorRT-LLM, BitNet, TorchAO |
| 오늘 트렌딩 | Python 부문 11위, 하루 +111 스타 (2026-11-04 KST 확인) |
구조: “설정 스키마가 곧 제품”인 CLI
소스는 src/soup_cli/ 아래에 commands(명령 90여 개 모듈), config, trainer, data, eval, recipes, ui, mcp_server 등으로 나뉩니다. 파이썬 코드만 약 24만 줄이고 테스트 디렉터리도 1,200개 파일이 넘습니다. 1인 메인테이너 프로젝트치고 규모가 상당한데, v0.77.0 릴리스 노트에 따르면 그 릴리스의 PR 226개 가운데 151개를 외부 기여자 44명이 냈습니다.
설계의 중심은 config/schema.py입니다. README는 이 파일을 “모든 필드의 단일 진실 공급원”이라고 부릅니다. 실무에서 의미 있는 변화는 v0.75부터 모르는 설정 키를 거부한다는 점입니다. 예전에는 quantizaton 같은 오타가 검증을 통과한 뒤 조용히 버려져, 사용자는 4bit로 학습한다고 믿었지만 실제로는 전정밀도로 돌고 있었습니다. v0.77.0은 한발 더 나아가 v0.76이 “다음 버전에서 거부한다”고 경고만 하던 값들과, 받아들이고도 실제로는 적용하지 않던 설정 14개를 로드 단계에서 막습니다.
| 디렉터리/파일 | 역할 | 실무 포인트 |
|---|---|---|
config/schema.py |
pydantic 기반 설정 스키마 | 모르는 키는 로드 실패, 다른 라이브러리식 이름(learning_rate)이면 Soup 필드(lr)를 제안 |
trainer/ |
과제별 트레이너(sft, dpo, grpo, kto, orpo, ppo, mlx_* 등) | TRL 위에 얹되, MLX 경로는 자체 루프로 TRL 목적함수를 재현 |
trainer/stream_setup.py |
레이어 스트리밍 준비 | 층별 샤드 캐시 생성, 버퍼 계획, VRAM 사전 점검 패널 |
commands/ |
train, plan, apply, profile, doctor, data, export, serve, ui 등 | soup plan·apply는 v0.77.1부터 train과 같은 설정을 같은 메시지로 거부 |
benchmarks/ |
모든 성능 수치의 측정 기록 | 실패, 철회한 가정, 폐기한 수치까지 작성 순서대로 공개 |
recipes/ |
모델별 기본 레시피 100개 이상 | Llama 3.x/4, Qwen 2.5/3, Gemma 3, Mistral, DeepSeek R1/V3, Phi-4 등 |
핵심 기능: 레이어 스트리밍은 어떻게 동작하나
LoRA 학습에서 기울기와 옵티마이저 상태가 필요한 것은 작은 어댑터뿐이고, 수십억 개의 베이스 가중치는 얼어 있습니다. 그런데도 일반적인 학습은 이 얼린 베이스 전체를 VRAM에 올려 둡니다. Soup의 레이어 스트리밍(training.stream_layers: true)은 이 부분을 바꿉니다. docs/performance-and-quantization.md의 설명을 정리하면 다음과 같습니다.
- LoRA 어댑터, 그 기울기, 옵티마이저 상태는 VRAM에 계속 둡니다.
- 얼린 베이스는 미리 층별 샤드로 잘라 호스트 RAM(가능하면 page-locked)에 둡니다.
- VRAM에는 미리 할당한 버퍼 2개(기본값, 2~8 조절)를 두고, 한 층이 계산되는 동안 별도 CUDA 스트림이 다음 층을 다른 버퍼로 복사합니다.
- 어휘 크기의
embed_tokens와 묶이지 않은lm_head는 슬롯 하나를 공유합니다. - 디스크 계층(
stream_source: disk)도 있어서 RAM이 부족하면 NVMe에서 읽어 오며, 이때stream_read_ahead로 몇 층을 미리 올릴지 정합니다.
문서가 강조하는 대목은 각 디코더 층이 한 스텝에 두 번 읽힌다는 점입니다. 순전파에서 한 번, 그리고 역전파에서 체크포인트 재계산을 위해 한 번 더 읽습니다. 아래 층으로 기울기를 넘기려면 dL/dx = WT · dL/dy를 계산해야 하므로, 얼린 가중치도 역전파 때 다시 GPU에 있어야 합니다. 문서 표현대로 이것은 구현 디테일이 아니라 물리적 조건이고, 스트리밍이 시간을 잡아먹는 이유입니다.
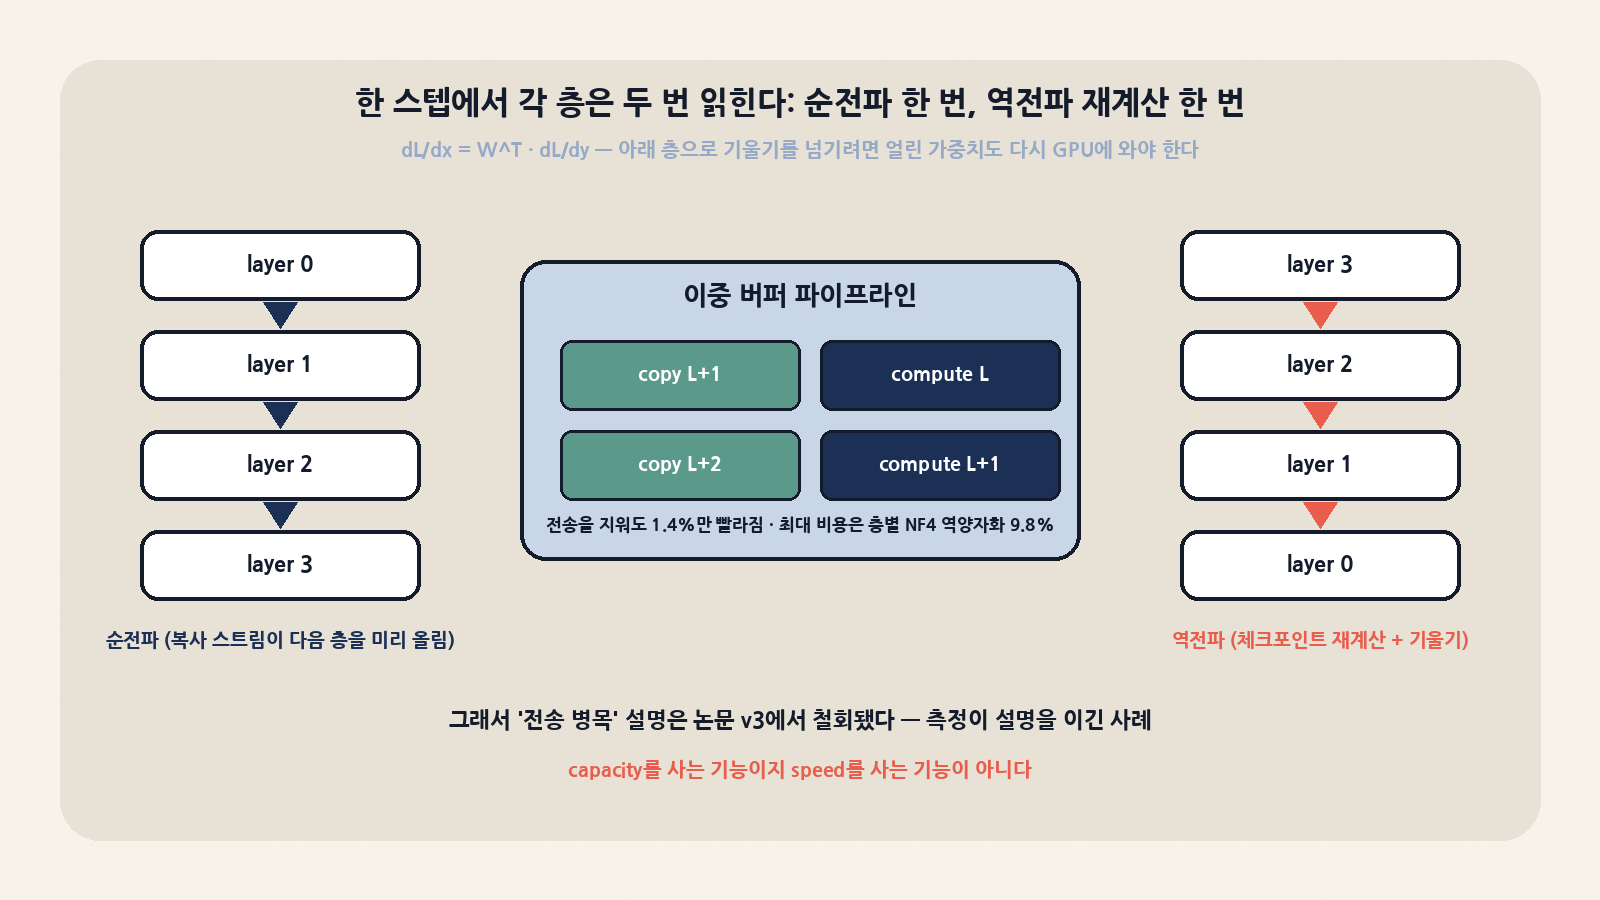
흥미로운 것은 병목에 대한 설명이 바뀐 과정입니다. 프리프린트 v2까지는 “레이어 스트리밍은 GPU가 아니라 호스트에서 디바이스로 가는 전송 속도에 묶여 있다”고 썼습니다. 그런데 8월 11일에 실제로 측정해 보니 호스트→디바이스 전송을 전부 지워도 1.4%만 빨라졌고, 계산 스트림이 복사를 기다린 시간은 스텝의 0.20%에 불과했습니다. 스트리밍 고유 비용 중 가장 큰 항목은 층별 NF4 역양자화(9.8%)였습니다. 그래서 v3(2026-08-13)는 측정값은 하나도 바꾸지 않은 채 이 설명만 공식 철회했습니다. 성능 주장을 볼 때 측정과 해석을 분리해서 읽어야 한다는 좋은 교재입니다.
스트리밍 관련 설정 키
| 키 | 기본값/범위 | 의미 |
|---|---|---|
stream_layers |
false | 레이어 스트리밍 켜기 (CLI 플래그가 아니라 설정 키) |
stream_source |
auto / ram / disk | 얼린 베이스를 어디서 읽을지 정함 (disk는 v0.72.3부터) |
stream_buffers |
2 (2~8) | VRAM 층 버퍼 개수, 2는 이중 버퍼링 |
stream_read_ahead |
2 (1~8) | 디스크 계층 전용, 단계가 하나 늘 때마다 고정 RAM 한 층 분량 추가 |
stream_recompute |
auto | 체크포인트 재계산 대신 활성값 유지 여부 |
stream_loss_chunk |
예: 128 | 긴 컨텍스트에서 출력 헤드와 loss를 N 토큰씩 계산 (sft 전용) |
stream_expert_layout |
fused / per_expert | DeepSeek-V3 계열 MoE에서 전문가를 라우터가 고를 때만 읽음 |
공개된 수치는 무엇을 말하고, 무엇을 말하지 않나
README의 대표 수치는 RTX 3050 Laptop 4GB에서 Llama-3.1-8B-Instruct + NF4 LoRA(배치 1, 시퀀스 512)를 119.6 tok/s, 정점 3.32GB로 돌렸고, 일반 상주 학습과 비트 단위로 같았다는 것입니다. H100에서도 같은 3.32GB에 113.00 tok/s로 재현됐습니다. 다만 두 수치 모두 v0.72.2에서 잰 것이고, 이후 v0.73.0의 정확성 수정(32B에서 −4.8% 비용) 이전 결과입니다. 수정 후 다른 RTX 3050 Laptop에서는 2.40GB 정점에 208.6 tok/s가 나왔지만, 프로젝트 스스로 “1.74배 향상은 클럭 차이(952MHz 대 1935MHz대) 때문이지 실제 속도 향상이 아니다”라고 적어 두었습니다.
| 측정 | 하드웨어 | 처리량 | 정점 메모리 | 주의점 |
|---|---|---|---|---|
| v0.72.2, 수정 전 | RTX 3050 Laptop 4GB, 952MHz | 119.6 tok/s | 3.32GB | 상주 실행과 비트 단위 일치 |
| v0.72.2 재현 | H100 | 113.00 tok/s (중앙값) | 3.32GB | 병목이 GPU 연산이 아님을 시사 |
| #331 수정 후 | 다른 RTX 3050 Laptop 4GB, 1935~1957MHz | 208.6 tok/s | 2.40GB | 클럭 차이 때문, 메모리 패턴도 달라 직접 비교 불가 |
정확성 쪽에서 가장 의미 있는 발견은 “조용히 틀린 기울기” 결함입니다. 층당 약 165MiB를 넘는 NF4 층에서는 순전파는 비트 단위로 맞고 loss 곡선도 정상처럼 보이는데 기울기가 틀렸습니다. 측정 기록에 따르면 원인은 bitsandbytes의 MatMul4Bit가 packed 가중치와 quant_state를 save_for_backward가 아닌 일반 속성으로 저장해, 그래디언트 체크포인팅이 이를 인식하지 못하는 데 있었습니다. loss만 보고 학습이 잘 됐다고 판단하는 관행이 얼마나 위험한지 보여 주는 사례입니다.
DeepSpeed ZeRO-3와의 비교
benchmarks/gate-h100-validation.md에는 같은 H100, 같은 Llama-3.1-8B, 64행 데이터, 시퀀스 256, 배치 1, 4 epoch, LoRA r=8 조건에서 DeepSpeed ZeRO-3 파라미터 오프로드와 비교한 결과가 있습니다. DeepSpeed도 Soup의 --deepspeed 플래그로 돌렸기 때문에 같은 도구 안에서 두 방식을 비교한 셈입니다.
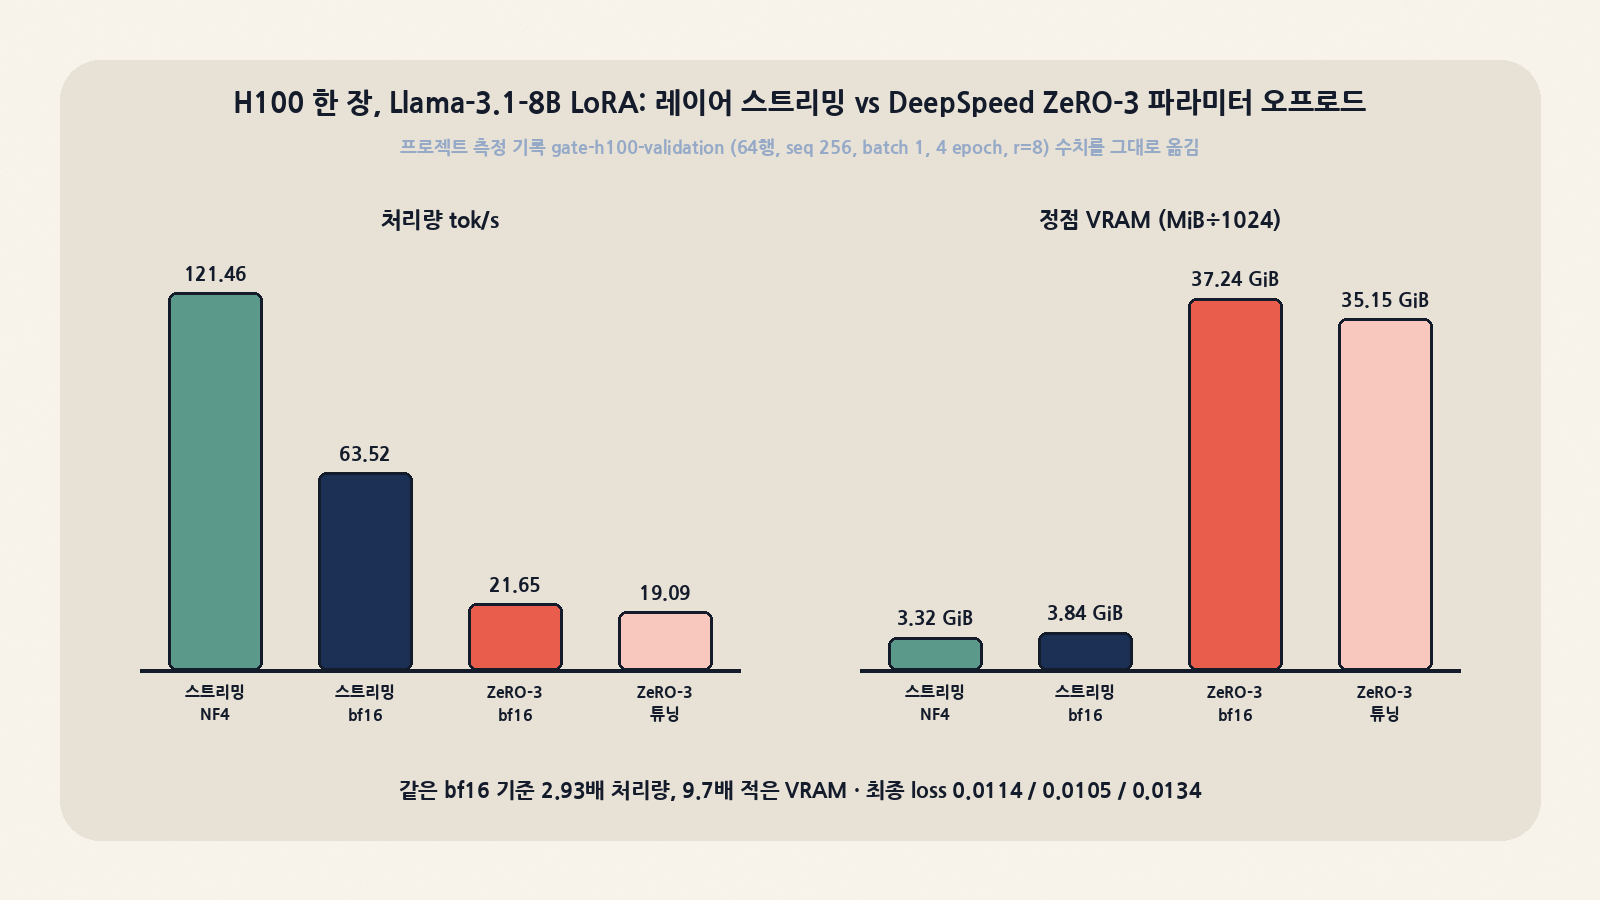
| 실행 | 베이스 dtype | tok/s | 정점 VRAM | train_runtime | 평균 GPU 사용률 |
|---|---|---|---|---|---|
| 레이어 스트리밍 | NF4 | 121.46 | 3,399 MiB | 67.44초 | 54.1% |
| 레이어 스트리밍 | bf16 | 63.52 | 3,935 MiB | 128.97초 | 72.4% |
| ZeRO-3 파라미터 오프로드 | bf16 | 21.65 | 38,135 MiB | 378.41초 | 45.5% |
| ZeRO-3 메모리 튜닝 | bf16 | 19.09 | 35,997 MiB | 429.15초 | 41.8% |
같은 bf16끼리 비교하면 처리량은 2.93배, 정점 VRAM은 9.7배 차이입니다. 4 epoch 후 최종 loss는 0.0114, 0.0105, 0.0134로 비슷해서 세 실행이 같은 과제를 학습했다는 최소한의 검증은 됩니다. 다만 해석에는 조건이 붙습니다. DeepSpeed는 이 박스에서 cpu_adam JIT 빌드가 실패해 옵티마이저 오프로드를 끈 상태였고, LR 스케줄러 충돌을 피하려고 옵티마이저와 스케줄러를 DeepSpeed에 맡겼습니다. 같은 기록에는 “8장의 ZeRO-3가 1장의 상주 학습보다 느리다”는, 프로젝트에 유리하지 않은 결과도 그대로 남아 있습니다. 결국 이 비교가 보여 주는 것은 “DeepSpeed보다 빠르다”가 아니라 카드 한 장, 그것도 작은 카드에서 LoRA를 돌려야 할 때 어느 쪽이 덜 아픈가입니다.
박스 실측: GPU 없이 상주 vs 스트리밍
실제로 설치해서 돌려 봤습니다. 2026-11-04 KST, 8코어·RAM 15GB·GPU 없는 리눅스 박스, Python 3.13.5 venv에 pip install "soup-cli[train]"로 v0.77.1을 깔았습니다(torch 2.15.0+cpu, transformers 5.22.1, peft 0.21.2, trl 0.29.1, bitsandbytes 0.50.2). soup doctor는 필수 의존성을 모두 OK로 표시했습니다. 데이터는 저장소에 들어 있는 10행짜리 alpaca_tiny.jsonl(검증용 1행 자동 분리)이고, README가 밝히듯 이 데이터는 형식 확인용이지 실제 학습용은 아닙니다.
base: Qwen/Qwen2.5-0.5B-Instruct
task: sft
backend: transformers
data:
  train: alpaca_tiny.jsonl
  format: alpaca
  max_length: 512
training:
  epochs: 3
  lr: 5e-4
  batch_size: 2
  quantization: none
  lora: { r: 16, alpha: 32, dropout: 0.05, target_modules: [q_proj, v_proj] }
  # stream_layers: true   # 두 번째 실행에서만 켬
output: ./out_sft/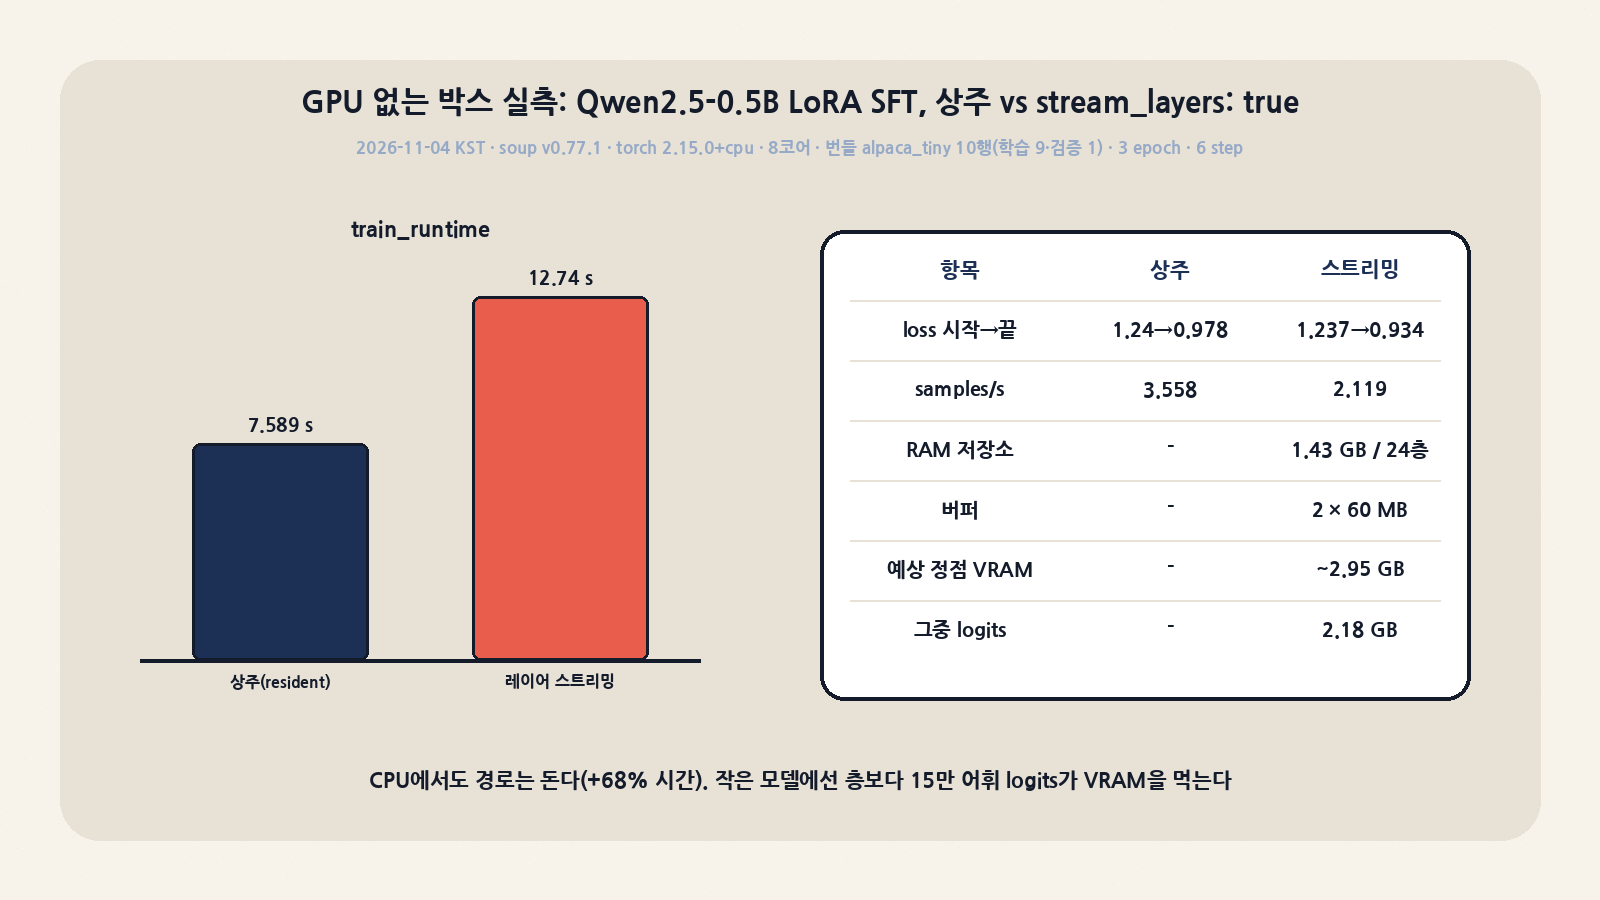
| 항목 | 상주(resident) | 레이어 스트리밍 |
|---|---|---|
| 학습 파라미터 | 1,081,344 / 약 4.95억 (0.22%) | 1,081,344 / 약 4.94억 (0.22%) |
| train_runtime (6 step) | 7.589초 | 12.74초 (약 +68%) |
| samples/s | 3.558 | 2.119 |
| loss 시작 → 끝 | 1.24 → 0.9775 | 1.2366 → 0.9343 |
| 사전 점검 패널 | CPU 모드, 메모리 N/A | RAM 저장소 1.43GB/24층, 버퍼 2×60MB, 예상 정점 VRAM ~2.95GB (그중 logits 2.18GB) |
| 디스크 사전 점검 | 없음 | 원본 0.99GB + 층 샤드 캐시 1.98GB, 합계 3.95GB 예상 |
관찰한 점은 네 가지입니다.
- CPU에서도 스트리밍 경로가 실제로 돈다. 무시되지 않고 층 샤드 캐시(
~/.soup/layer-stream/)를 만든 뒤 24층을 버퍼로 돌려 학습을 끝냈습니다. 다만 CPU에서는 아낄 VRAM이 없으므로 시간만 약 68% 더 들었습니다. 기능 검증과 CI 용도로 보면 됩니다. - 0.5B에서는 층보다 logits가 크다. Qwen2.5의 15만 어휘 때문에 배치 2×시퀀스 512의 logits 추정치(2.18GB)가 층 버퍼(119MB)를 압도했습니다. 작은 모델에 긴 시퀀스를 넣는다면 층 스트리밍보다 출력 쪽 대책이 효과가 큽니다. 스트리밍을 켠 상태라면
stream_loss_chunk, 상주 학습이라면 Cut Cross-Entropy(use_cut_ce, 문서상 레이어 스트리밍과는 병행 불가)를 검토할 만합니다. - loss가 소수점 셋째 자리부터 갈렸다. 프로젝트의 비트 단위 일치 주장은 CUDA·NF4에서 상주 NF4와 비교한 것이고, 이번 실행은 CPU·fp32에 드롭아웃 0.05가 켜진 조건이라 직접 반박도, 확인도 아닙니다. 재현하려면 저장소의
notebooks/proof-4gb.ipynb(Colab T4에서 4GB로 제한한 뒤 비트 일치를 assert)를 쓰는 편이 맞습니다. - 거부 동작은 문서대로다.
quantizaton: 4bit오타는 “unknown config key ‘training.quantizaton’ – did you mean ‘quantization’… Refused.”로 로드 단계에서 막혔고,soup data dedup에 입력과 같은 파일을--output으로 주자 아무것도 읽기 전에 거부했습니다(v0.77.1 수정 사항).
참고로 soup profile로 Llama-3.1-8B 4bit 설정을 RTX 3050 기준으로 추정해 봤더니, 게이트 모델이라 config.json을 못 읽는 오프라인 상태에서는 파라미터 수로 형태를 추측하고 logits 항을 빼고 계산한다고 경고하며 약 14.6GB가 필요하다고 답했습니다. 이 추정은 레이어 스트리밍을 켜지 않은 설정 기준이고, v0.77.0의 통합 VRAM 추정식은 3.5B 이하 dense 모델 39개 실측으로 보정한 것이라 8B에서는 경고 수준으로만 쓰는 편이 안전합니다.
대안과 비교하면
| 도구 | 성격 | 강점 | Soup 대비 고려점 |
|---|---|---|---|
| Soup | YAML 기반 학습·평가·내보내기 올인원 CLI | 레이어 스트리밍, 엄격한 설정 검증, 측정 기록 공개, MLX 선호 학습 | 1인 메인테이너 중심, 기능이 매우 넓어 릴리스마다 설정 호환성 변화가 잦음 |
| Axolotl | YAML 기반 학습 프레임워크 | 멀티 GPU·대규모 학습 사례가 많음 | Soup에는 Axolotl 설정을 가져오는 soup migrate가 있음 |
| LLaMA-Factory | 웹 UI와 CLI를 갖춘 학습 툴킷 | 모델·기법 커버리지가 넓음 | 마찬가지로 soup migrate 대상 |
| Unsloth | 커널 최적화 학습 라이브러리 | 단일 GPU 속도·메모리 최적화 | Soup의 backend: unsloth로 함께 사용 가능, 단 스트리밍·활성값 오프로드와는 병행 불가 |
| DeepSpeed ZeRO-3 | 분산 학습 메모리 분할 | 다중 노드 풀 파인튜닝 | LoRA 단일 카드 시나리오에서는 위 측정처럼 VRAM·처리량 모두 불리 |
도입할 때 체크리스트
| 상황 | 권장 |
|---|---|
| v0.76 이하 설정을 쓰던 팀 | 업그레이드 전 soup doctor --config soup.yaml 실행. v0.77.0부터 경고만 하던 값이 로드 실패로 바뀜 |
| 비대화형 CI·Docker에서 학습 | soup train --yes 필요 (v0.77.0부터) |
| VRAM은 작고 RAM은 넉넉함 | stream_layers: true와 quantization: 4bit 조합. 시간은 늘고 용량은 확보됨 |
| RAM도 부족 | stream_source: disk로 하되 캐시는 NVMe에 두기, 디스크 사전 점검의 예상 용량 확인 |
| DeepSeek-V3 계열 MoE | stream_expert_layout: per_expert는 용량을 위한 선택. 기록상 스텝은 약 1.8~2.6배 느려지고, 라우팅 전문가에 LoRA를 거는 moe_lora는 거부됨 |
| 외부 실행 파일 의존 | v0.77.0부터 현재 디렉터리·상대 PATH를 검색하지 않으므로 절대 경로로 PATH에 등록 |
| 규제 산업 | HIPAA/SOC2/EU AI Act 템플릿, BOM·attest·감사 로그(기본 ~/.soup/audit.jsonl), 텔레메트리는 기본 꺼짐 |
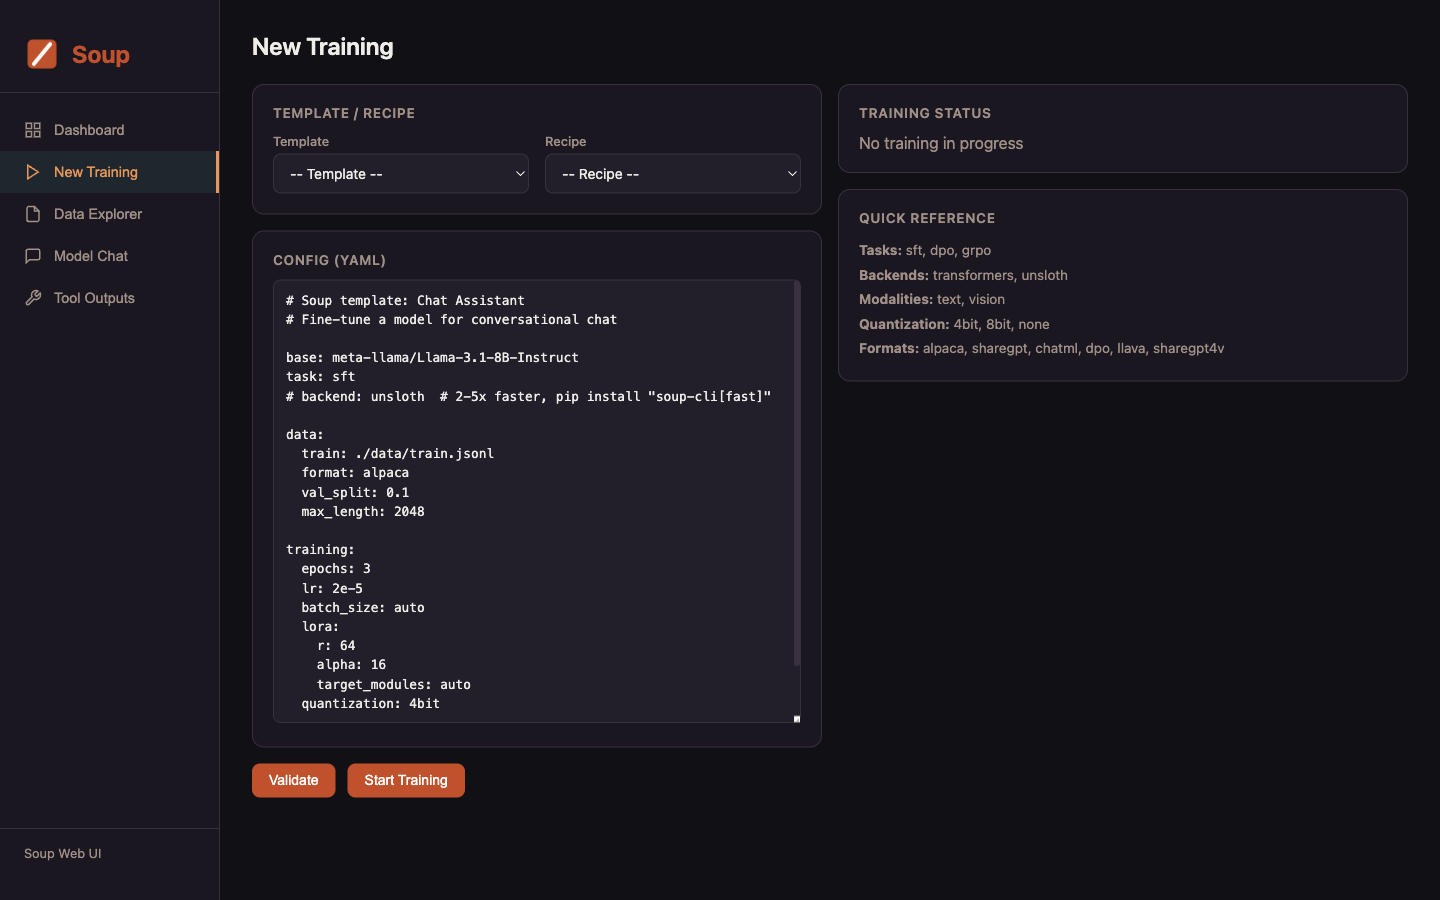
공식 화면: Web UI
pip install "soup-cli[ui]" 후 soup ui를 실행하면 토큰이 붙은 로컬 주소(127.0.0.1:7860)로 대시보드가 열립니다. 실험 관리, 학습 설정, 실시간 지표, 데이터 탐색, 모델 채팅을 브라우저에서 할 수 있습니다.
정리: 누구에게 맞나
Soup에서 가장 배울 점은 기능 목록보다 태도입니다. 4GB에서 8B를 학습했다는 강한 주장을 하면서도, 수치마다 버전·클럭·조건을 붙이고, 틀린 설명은 새 버전으로 철회하고, 경쟁 도구에게 튜닝 기회를 한 번 더 줬습니다. 실무자 입장에서는 이렇게 정리할 수 있습니다.
- 맞는 경우: 소비자급 GPU 한 장으로 7B~8B LoRA·QLoRA를 돌려야 하는 개인·소규모 팀, 설정 오타가 조용히 무시되는 사고를 겪어 본 팀, 학습부터 GGUF 내보내기와 서빙까지 한 도구로 묶고 싶은 경우.
- 신중해야 할 경우: 레이어 스트리밍은 아직 BETA이고, 아키텍처 지원이 정해진 목록 안에서만 열립니다. 릴리스가 잦고 매번 설정을 더 엄격하게 거부하므로, 운영 파이프라인이라면 버전을 고정하고
soup doctor를 CI 게이트로 거는 편이 좋습니다. - 스스로 확인할 것: 공개 수치는 대부분 RTX 3050 Laptop과 H100 기록입니다. 자기 카드에서
notebooks/proof-4gb.ipynb로 비트 일치를, 실제 데이터로 처리량을 먼저 재 보세요. 이 글의 CPU 실측도 기능 검증일 뿐 성능 근거는 아닙니다.