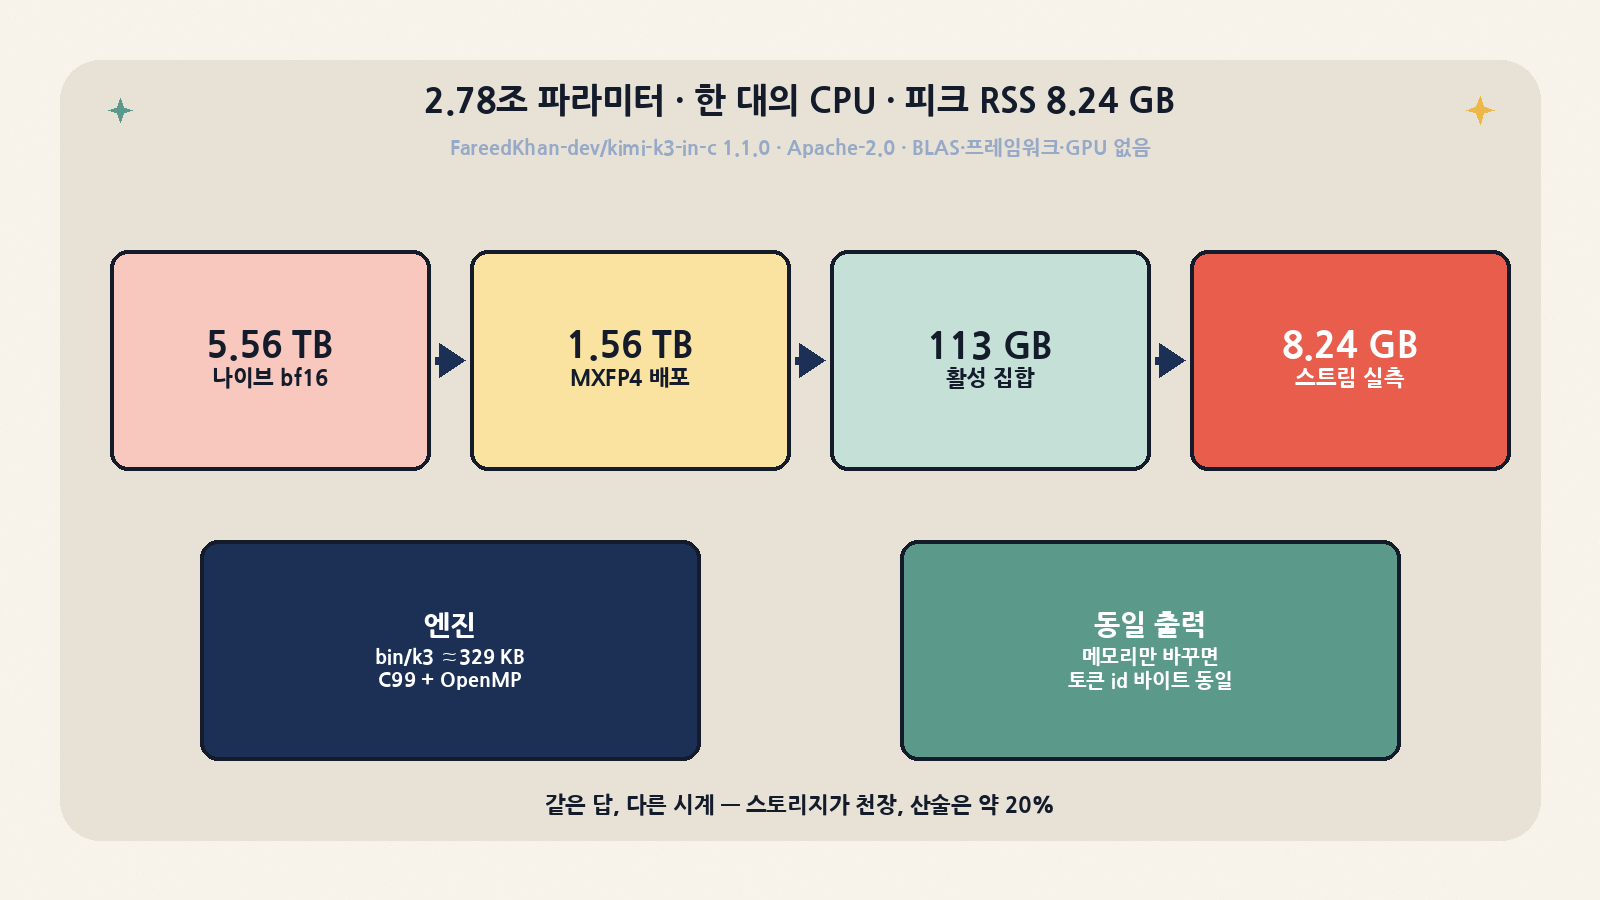
테크부터 경제, 생활까지. 복잡한 소식을 쉽게 풀어봅니다. 오늘 오후 오픈소스 심화는 실무자용입니다. FareedKhan-dev/kimi-k3-in-c는 Moonshot AI의 Kimi K3(2.78조 파라미터)를 GPU·BLAS·프레임워크 없이 한 대의 CPU에서 돌리겠다는 저장소입니다. 공식 README가 내세우는 숫자는 단순합니다. 체크포인트 1.56 TB, 엔진 바이너리 약 330 KB, 노트북급 프리셋에서 측정된 피크 RSS 8.24 GB. 같은 프롬프트에 대해 메모리 예산만 바꿔도 출력 토큰 id는 바이트 단위로 동일하고, 달라지는 것은 시계뿐입니다.
이 글은 README·CHANGELOG·docs/data·소스를 직접 읽고, 2026-11-05 KST 기준 커밋 81bb6c2(버전 1.1.0)를 8코어·15 GB RAM 박스에 클론해 make와 make test를 돌린 결과까지 묶었습니다. 1.56 TB 체크포인트는 내려받지 않았습니다. 대신 저장소에 내장된 13레이어 미니 체크포인트와 커널·캐시·safetensors·트렁크·채팅 계약 테스트를 전부 돌렸고, 기록된 전문가 트레이스(expert_trace.bin, 요청 10만 96건)를 tools/sim_cache.py로 재생했습니다.
한눈에 보는 kimi-k3-in-c
| 항목 | 내용 |
|---|---|
| 저장소 | FareedKhan-dev/kimi-k3-in-c (2026-08-01 생성). 언어 C, 빌드 GNU make / CMake |
| 라이선스 | Apache-2.0 (NOTICE·SECURITY.md 포함) |
| 버전 | 1.1.0 (CHANGELOG 2026-10-02). 확인 커밋 81bb6c2 |
| 대상 모델 | moonshotai/Kimi-K3 · 2.78T · 93레이어 · MoE 896전문가/레이어 · top-16 · 공유 전문가 2 |
| 의존성 | C99 컴파일러, libm, OpenMP, pthread. BLAS·CUDA·PyTorch·ONNX 없음 |
| 플랫폼 | Linux/x86-64 기준. macOS/arm64(NEON+Homebrew libomp), Windows(MinGW-w64)도 게이트 통과 주장 |
| 체크포인트 | 96개 safetensors 샤드, 1,560,936,091,448 바이트. 패킹된 트렁크 약 109 GB |
| 스타·포크 | 약 10,538 / 1,649 (2026-11-05 KST GitHub API) |
| 오늘 박스 실측 | bin/k3 337,344 B · make test 벽시계 7.823 s · PASS 175 / FAIL 0 · 오라클 VERDICT exact match |
왜 이 프로젝트가 눈에 띄는가
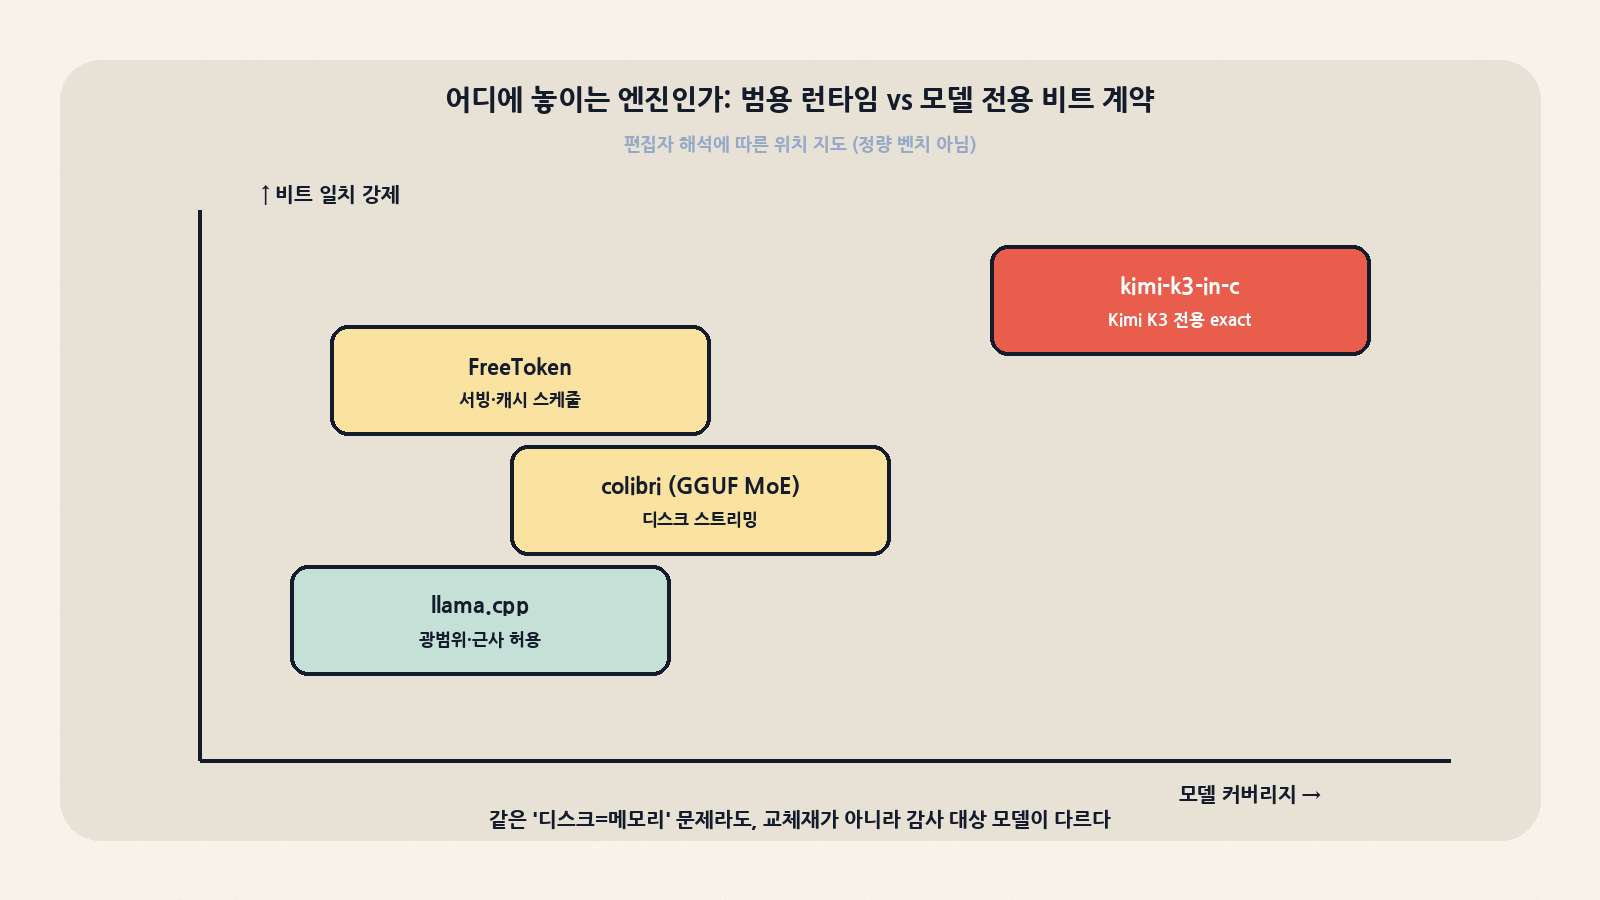
MoE를 디스크에서 스트리밍하는 엔진은 이미 여러 갈래가 있습니다. 지난 2주 모릭월드에서 다룬 JustVugg/colibri(GGUF 전문가 스트리밍)·FlashML FreeToken(q* 미스 분할)도 같은 ‘디스크를 메모리처럼’ 문제를 풀었습니다. kimi-k3-in-c가 다른 점은 세 가지입니다.
- 모델 전용 비트 계약. 범용 GGUF 런타임이 아니라 Kimi K3의 KDA·MLA·Stable LatentMoE·attention residual·MXFP4 니블 순서까지 하드코딩하고, PyTorch 레퍼런스와 허용 오차가 아닌 토큰 id 일치를 게이트로 겁니다.
- 부동소수점 경로를 고정. BLAS를 쓰지 않는 이유가 속도가 아니라 재현성입니다. OpenBLAS·MKL·Accelerate는 블로킹·감축 순서가 달라 비트 패턴이 갈라집니다. 이 엔진은 스칼라·AVX2·NEON이 같은 덧셈 순서를 타도록
-ffp-contract=off와 4-way double 누산을 강제합니다. - 메모리를 다이얼로 바꿈. 같은 가중치·같은 top-16·같은 93레이어를 유지한 채, 트렁크 핀/링과 전문가 LRU 예산만 바꿔 8 GB급부터 224 GB급까지 동일 출력을 냅니다.
ultra프리셋은 Jetson Orin Nano Super에서 완전 모델 검증을 주장합니다.
| 비교 축 | kimi-k3-in-c | colibri류 GGUF 스트리밍 | llama.cpp / 일반 CPU 추론 |
|---|---|---|---|
| 대상 | Kimi K3 전용 | GGUF MoE 다수 | 광범위한 트랜스포머 |
| 정확도 게이트 | 레퍼런스와 토큰 id exact | 구현체별 상이 | 양자화·커널에 따른 근사 |
| 전문가 포맷 | 원본 MXFP4 직접 matmul | 대개 디퀀트 후 연산 | 양자화 포맷별 커널 |
| 어텐션 | KDA 69 + MLA 24 + attn residual | 모델 변환에 의존 | 표준 MHA/GQA 중심 |
| 의존성 | C99+OpenMP만 | C / 자체 런타임 | BLAS·백엔드 선택적 |
| 체크포인트 크기 | 1.56 TB (필수) | 모델별 | 모델·양자화별 |
네 단계 축소: 5.56 TB → 8.24 GB
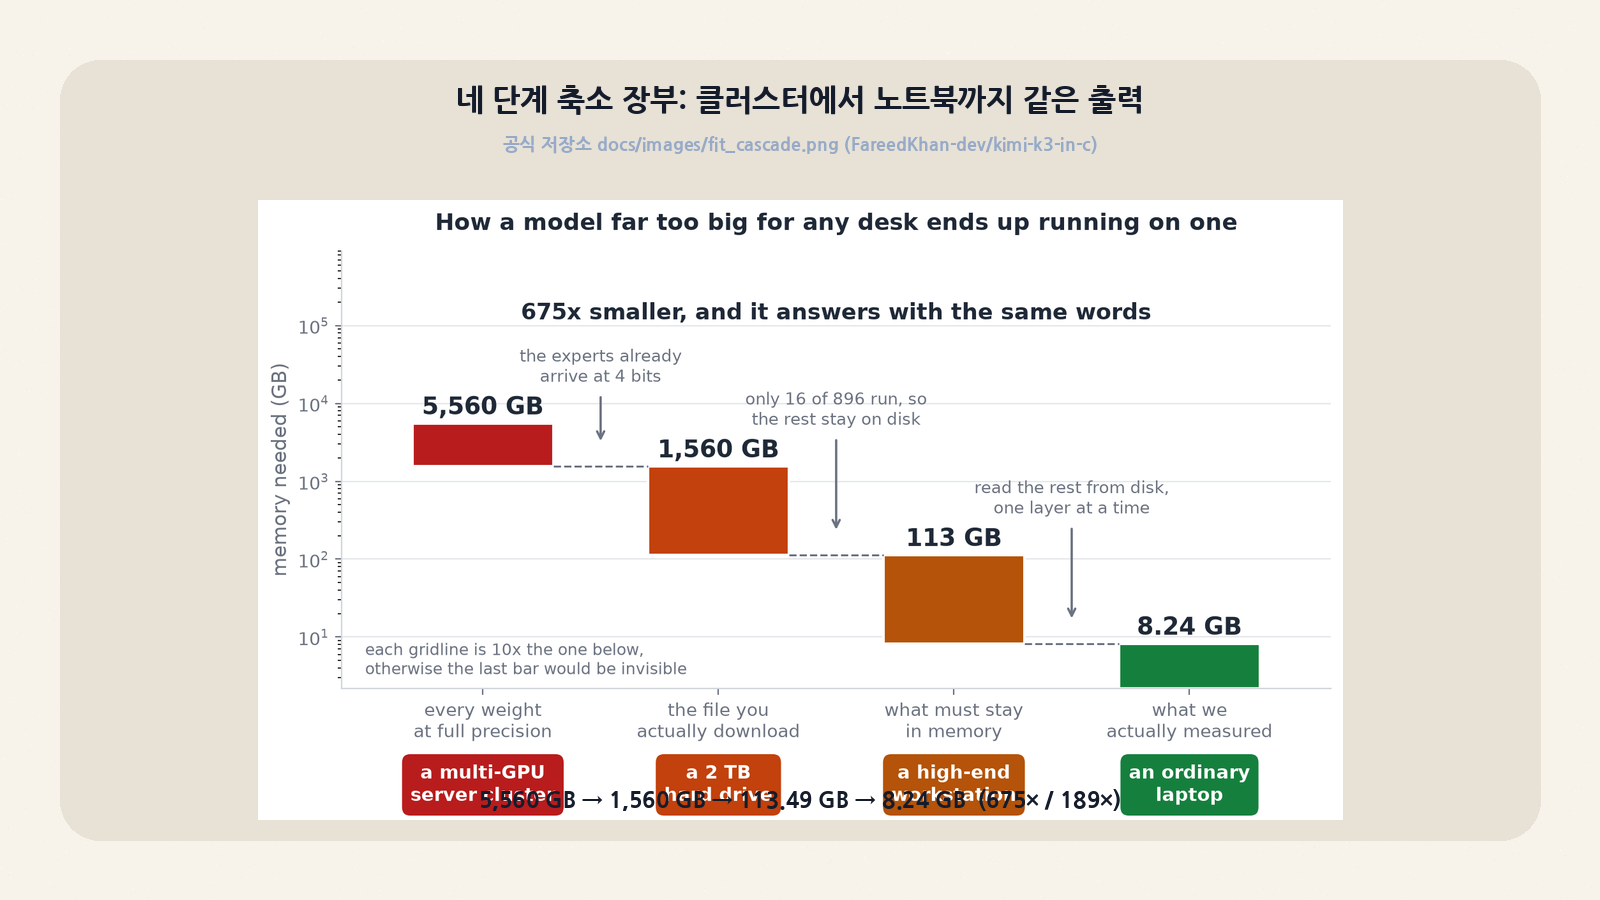
README의 핵심 장부입니다. 숫자를 그대로 옮기면 다음과 같습니다.
| 단계 | 메모리 상한 | 무엇을 버렸는가(정확히는 ‘어디에 뒀는가’) | 출력 |
|---|---|---|---|
| 0. 나이브 bf16 전부 상주 | ≈5,560 GB | 없음 | — |
| 1. 배포 체크포인트 | 1,560 GB | 라우팅 전문가가 이미 MXFP4(0.53125 B/가중치) | 동일 |
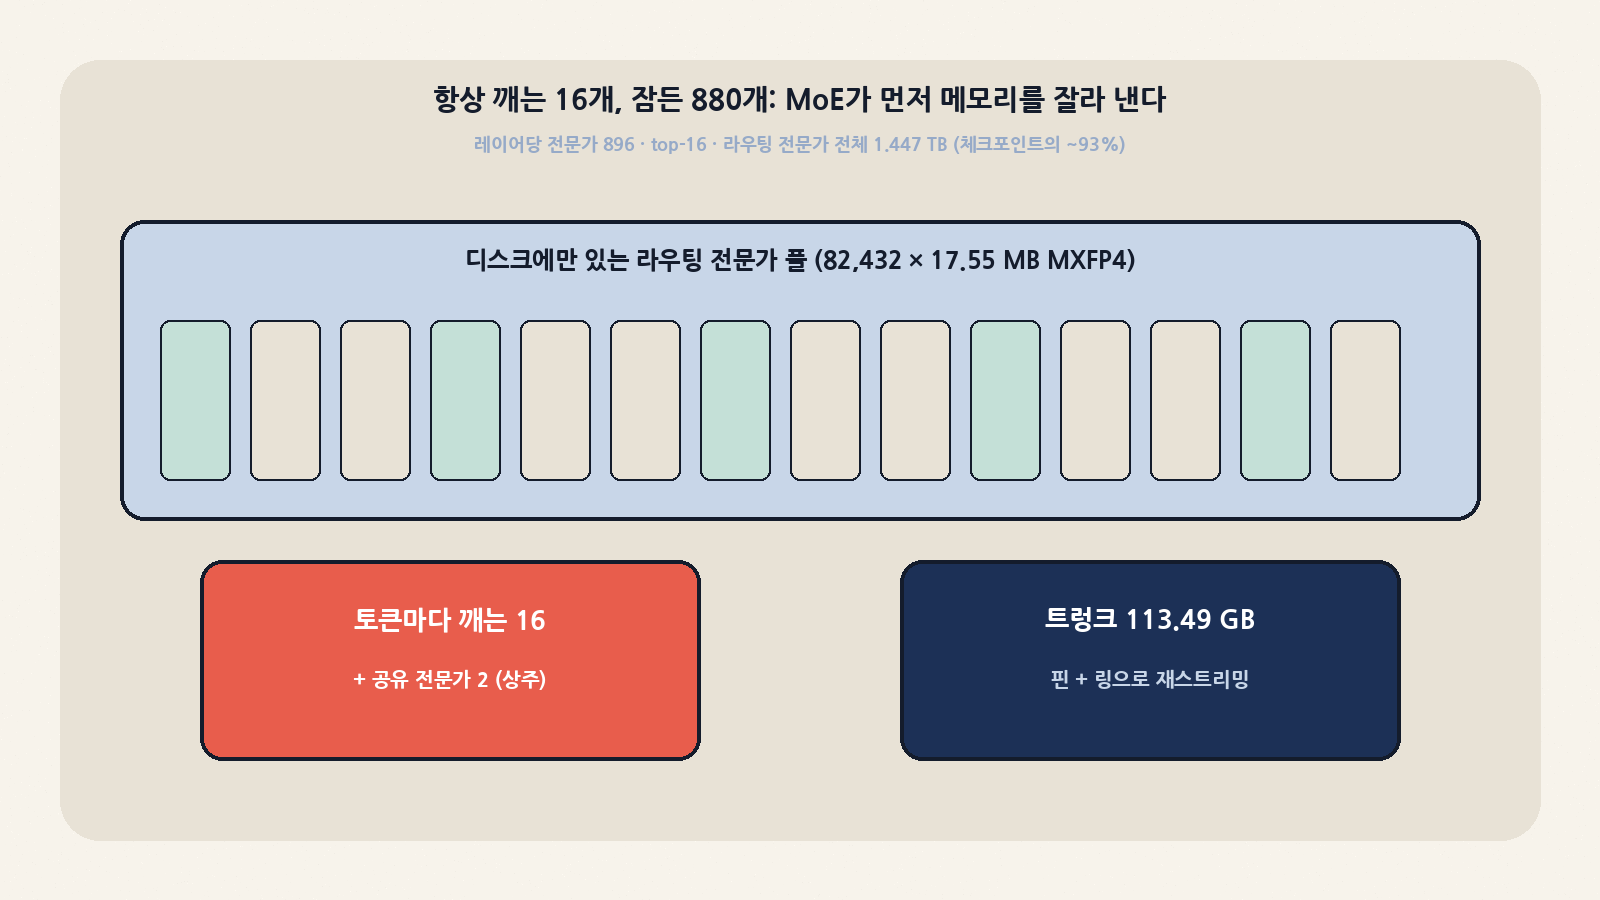
| 2. 활성 집합만 상주 | 113.49 GB | 82,432개 라우팅 전문가(1.447 TB)는 디스크에만 | 동일 |
| 3. 트렁크 스트리밍 + 전문가 LRU | 8.24 GB (laptop 실측) | 밀도 트렁크도 핀+링으로 쪼개 읽음 | 바이트 동일 |
1.447 TB는 전체 체크포인트의 약 93%입니다. 레이어당 896 전문가 중 토큰마다 16개만 깨우므로, 나머지 880개는 이론상 한 번도 RAM에 올리지 않아도 됩니다. 다만 공유 전문가 2개는 매 토큰 실행되므로 스트림 대상이 아닙니다. tools/budget.py가 텐서 이름을 분류할 때 이 구분을 강제하는 이유가 여기 있습니다. 손으로 계산하면 바닥을 과소평가하기 쉽습니다.
아키텍처: 여섯 개의 C 파일과 세 개의 불변식
엔진 소스는 모듈로 나뉘지만 링크 결과는 하나의 bin/k3입니다. 오늘 박스에서 뽑은 바이너리는 337,344바이트(약 329 KB)였습니다. README의 초기 176 KB 수치보다 큰 이유는 1.1.0에서 XTML 채팅·샘플러·상태 파일 v2·Windows 포터블 I/O가 붙었기 때문입니다.
| 경로 | 역할 | 오늘 실측·메모 |
|---|---|---|
src/core/k3_ops.c |
RMSNorm, KDA, MLA, MoE, MXFP4/bf16 matmul, SiTU-GLU | 1,817줄. test_ops 통과 |
src/io/k3_st.c · k3_load.c · k3_trunk.c |
safetensors 인덱스, 전문가 바이트 위치, O_DIRECT 트렁크 링 | 반백만 텐서 인덱스를 0.27 s에 만든다고 README 주장 |
src/cache/k3_cache.c |
라우팅 전문가 LRU + 배치 프리페치 | 트레이스 재생으로 용량표 재현 |
src/model/k3_bind.c |
체크포인트 텐서 이름 → 커널 인자 바인딩 | 레이어 맵은 config에서 읽음(추측 금지) |
src/tokenizer/ · src/chat/ |
tiktoken BPE, XTML 채팅 REPL | 체크포인트의 tiktoken.model 없으면 토크 패리티 스킵(오늘 해당) |
src/cli/k3_run.c |
메모리 플랜, 디코드 루프, 리포트, Ctrl-C 안전 종료 | 2,143줄. exit 0~5 계약 |
공개 헤더가 못 박은 불변식 중 실무적으로 치명적인 세 가지는 다음과 같습니다.
A_log는 헤드별 인덱스이지 채널별이 아니다.- MLA는 NoPE지만 64개 rope 슬롯은 존재하고 캐시된다(회전만 없다). 소프트맥스 스케일은 √192.
- MoE 라우팅 바이어스는 선택만 비튼다. 결합 가중치는 비편향 시그모이드 점수에서 온다.
이 중 하나라도 틀리면 모델은 유창한 영어를 뱉으면서도 Kimi K3가 아닙니다. 설정 리더(k3_cfg)가 기본값 대체를 거부하는 이유도 같습니다. full_attn_layers가 빠지면 93레이어 전부가 KDA로 돌아가고, 마지막 전역 어텐션이 사라집니다.
KDA·MLA·MoE: 메모리가 자라는 곳과 안 자라는 곳
| 메커니즘 | 레이어 수 | 상태 크기 | 컨텍스트에 따른 성장 | 실무 함의 |
|---|---|---|---|---|
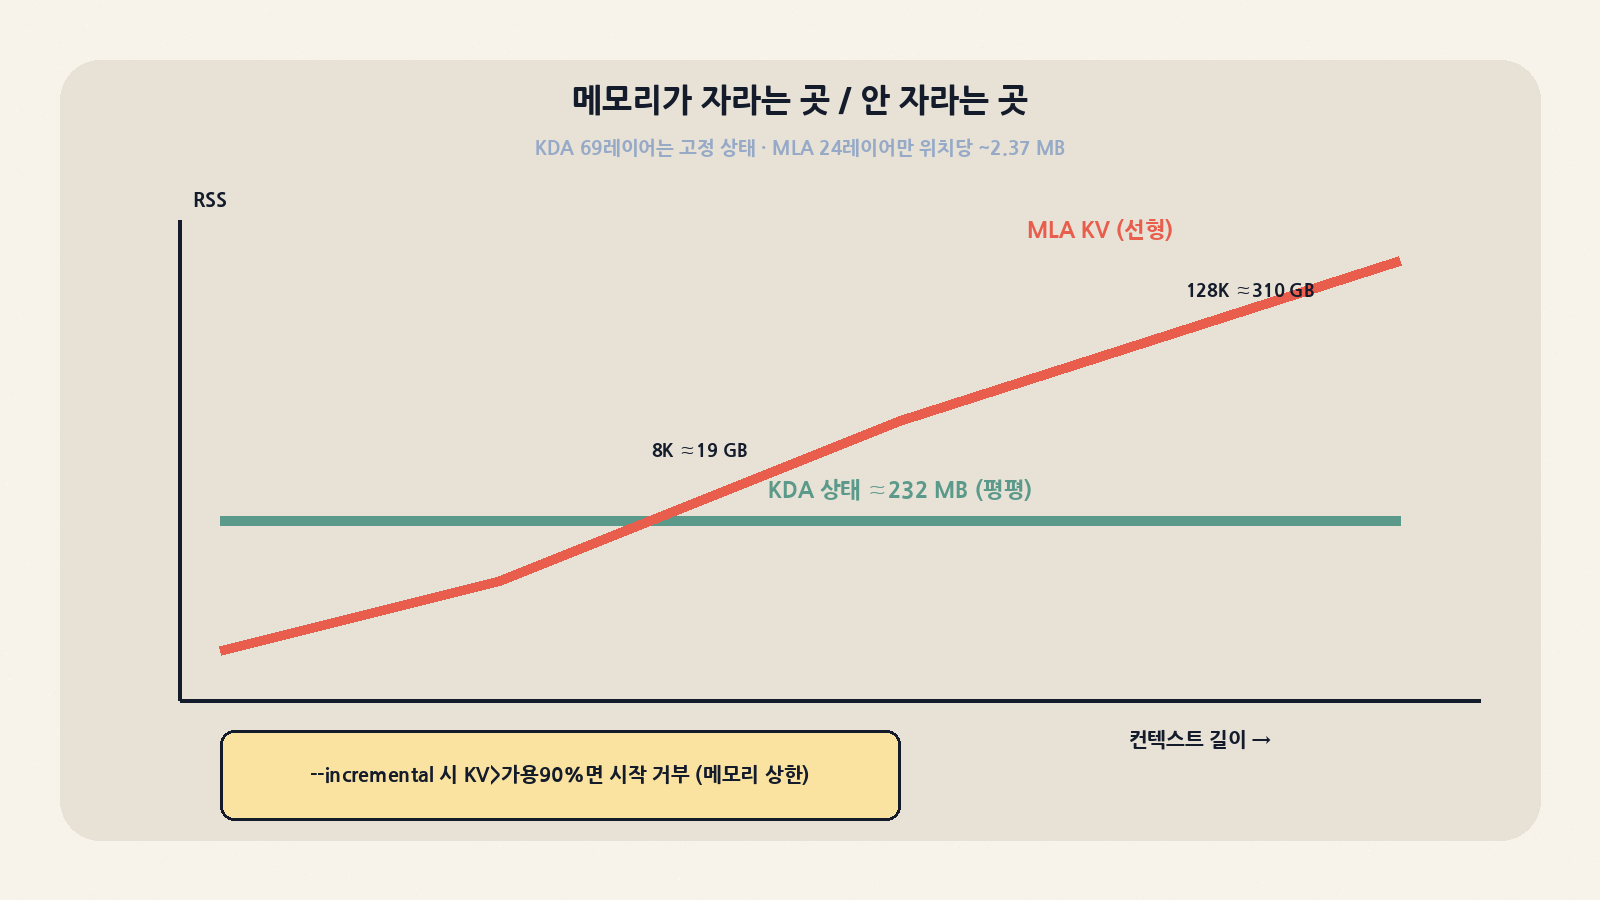
| KDA (Kimi Delta Attention) | 69 | 헤드당 128×128 행렬 고정 ≈217 MB + ShortConv ≈15 MB | 없음 | 긴 문맥에서도 KDA 쪽 RSS는 평평 |
| Gated MLA | 24 | 위치당 ≈2.37 MB (확장 k/v fp32) | 선형 | 8192 토큰 ≈19.4 GB, 131072 ≈310 GB |
| Stable LatentMoE | 92 (+레이어0 밀도 FFN) | 전문가당 17,547,264 B (MXFP4) | 캐시 예산에 따름 | 디퀀트 없이 니블 직접 곱. 토큰당 1,472 전문가 |
| Attention residual | 전 레이어 | 12레이어 블록 스냅샷 | 블록 수 ≤9 | 활성도 톱니가 12레이어 주기로 붕괴 |
엔진은 --incremental일 때 MLA KV가 가용 메모리의 90%를 넘으면 시작을 거부합니다. “엔진 상한”이 아니라 “메모리 상한”이라고 메시지를 찍는 이유는, 하드코딩된 컨텍스트 상수를 찾느라 오후를 날리지 말라는 배려입니다. 대안으로 전체 재계산(증분 끄기)이 있고, 이 경로는 KV를 안 들고 가지만 비용은 O(T²)입니다. 두 경로 모두 동일 토큰을 내놓도록 게이트되어 있습니다.
프리셋과 I/O: 산술은 20%, 디스크가 80%
./bin/k3 --list-presets가 오늘 출력한 표입니다.
| 프리셋 | 트렁크 / 전문가 캐시 (GB) | 피크 RSS 대략 | 용도 |
|---|---|---|---|
| ultra | 2.50 / 0.31 | ~3 GB 계획 | 8 GB급 생존 증명. 느림이 설계 |
| laptop | 3.00 / 1.00 | 8.2 GB | 일반 경로의 바닥 |
| desktop | 16 / 10 | 31.9 GB | 고성능 노트북 |
| workstation | 60 / 30 | 95.5 GB | 전문가 캐시가 의미 있어지는 구간 |
| server | 110 / 13 | ~128 GB | 93중 90레이어 핀. 가장 빠름 |
| max | 110 / 109 | ~224 GB | server 대비 체감 이득 거의 없음(문서 측정) |
| auto | 가용 RAM 기준 | 가변 | 트렁크 우선 배분 |
docs/data/memory-ladder.tsv의 동일 프롬프트 8토큰 측정에서 laptop은 32.69 s/token·피크 8.24 GB, 224 GB 설정은 19.21 s/token입니다. 토큰 id 열은 전 행이 동일합니다. 바닥 구성의 시간 분해는 트렁크 읽기 ≈36 s, 전문가 읽기 ≈11 s, 산술 ≈10 s로, 벽시계의 약 80%가 디스크 대기입니다. 그래서 tools/devbw.py가 dd가 아닌 O_DIRECT 랜덤 읽기로 스토리지를 재고, 네트워크 볼륨에 트렁크를 두면 표의 숫자가 무너진다고 경고합니다.
전문가 캐시 쪽은 더 냉정합니다. Quantile Balancing으로 전문가 사용이 평탄해진 모델이라, 작은 LRU는 Compulsory miss 천장(이 트레이스에서 최대 적중률 90%)에 일찍 막힙니다. 오늘 재생한 표에서 8~64 GB 구간 LRU 적중률은 36.24%로 거의 평평했고, 192 GB에 가서야 90%에 닿았습니다. Belady 상한도 64 GB에서 61.74%에 불과합니다. “캐시를 조금 늘리면 빨라진다”는 직관이 이 모델에서는 깨집니다.
설치·실행·게이트 사다리
| 단계 | 명령 | 필요 자원 | 오늘 박스 |
|---|---|---|---|
| 클론 | git clone …/kimi-k3-in-c.git |
~45 MB | 완료 · 81bb6c2 |
| 의사(doctor) | ./scripts/k3-doctor.sh |
수 분(디스크 측정) | AVX2·8코어·가용 11 GB·순차 6.9 GB/s · 권장 laptop. make 미설치로 한 번 FAIL 후 부트스트랩 |
| 빌드 | make -j |
수 초 | gcc 14.2 · OpenMP · 3.8 s |
| 무가중치 테스트 | make test |
체크포인트 불요 | 7.823 s · ALL WEIGHTLESS TESTS PASSED |
| 다운로드 | ./scripts/download-model.sh ~/k3model |
1.56 TB + HF 토큰 | 미실행 (디스크 47 GB) |
| 트렁크 패킹 | ./scripts/pack-trunk.sh ~/k3model ~/k3trunk |
~109 GB, 수 분 | 미실행 |
| 생성 | ./bin/k3 … --preset laptop --incremental |
위 산출물 | 미실행 |
부분 다운로드(--layers N)는 파이프라인 연습용입니다. N=1 ≈7 GB, N=8 ≈125 GB. 레이어 접두사는 모델이 아니며 출력이 기댓값이 아니라고 스크립트가 배너로 못 박습니다.
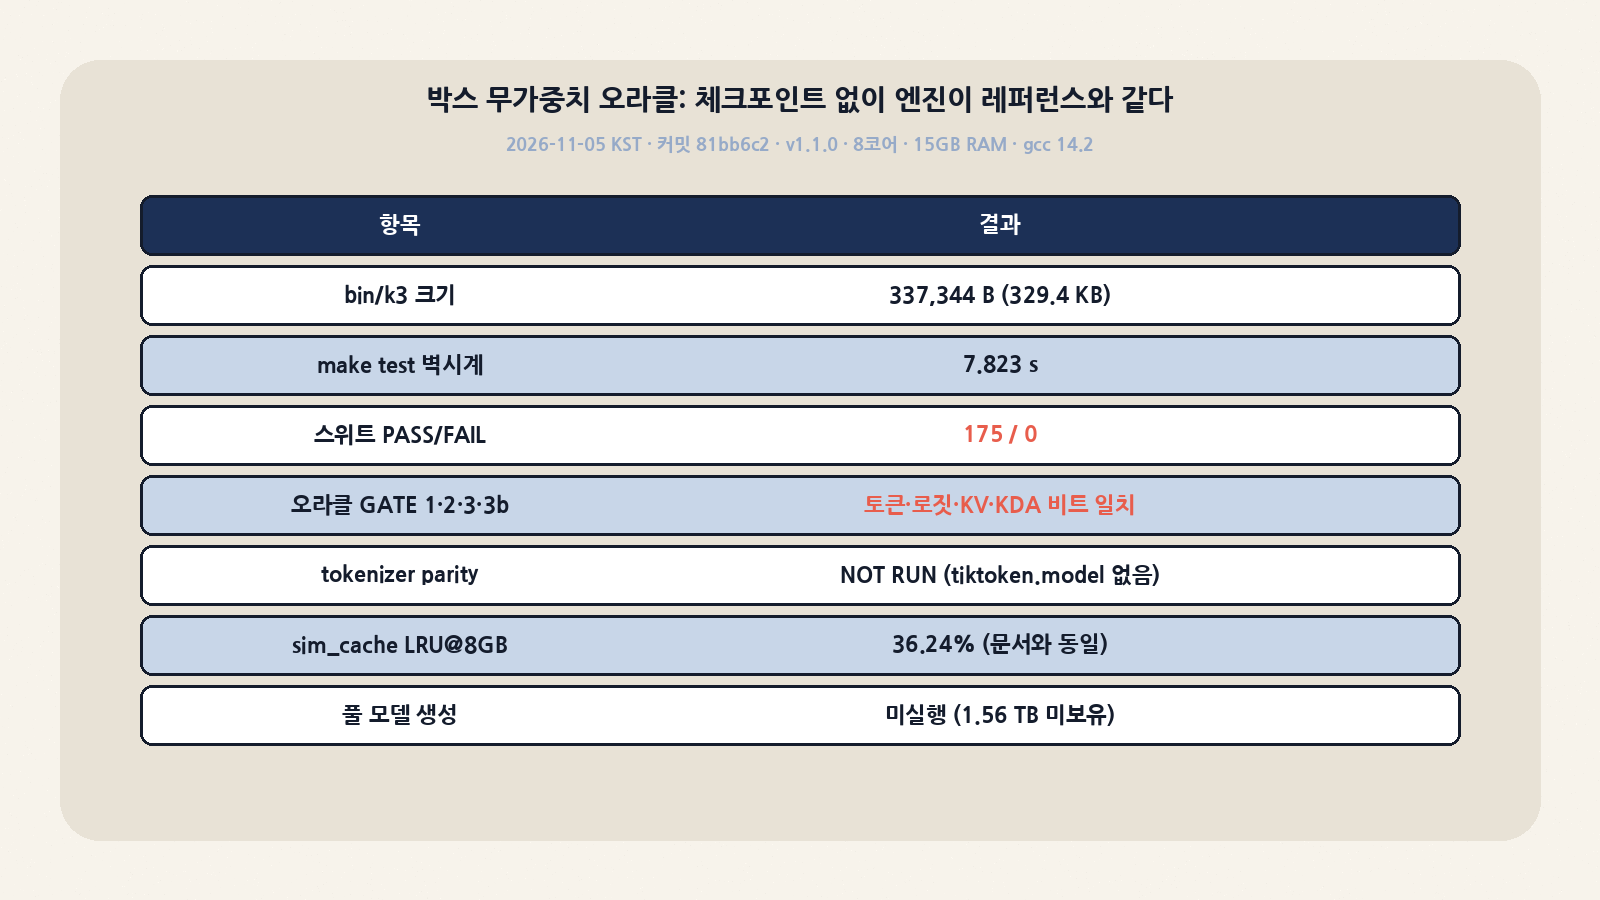
박스 실측: 체크포인트 없이 무엇을 증명했나
환경: Debian(gcc 14.2.0), 8논리 코어, MemTotal 15 GiB / 가용 ≈11 GiB, AVX2·AVX-512 모두 존재, 작업 디렉터리 순차 읽기 6.9 GB/s. 2026-11-05 16:57 KST 전후.
| 게이트·스위트 | 결과 | 해석 |
|---|---|---|
op kernels (test_ops) |
PASS | RMSNorm·SiTU·KDA·MLA·MXFP4·bf16 matmul 계약 |
| streaming cache / split reads | PASS | 전문가 LRU·분할 읽기 |
| safetensors · shard faults | PASS | 손상·부분 샤드에서 침묵 실패 금지 |
| config reader / refusals | PASS | 누락 필드·잘못된 레이어 인덱스 거부 |
| trunk streaming | PASS | 1·2슬롯 링, wrap, truncated bind, bad manifest |
| chat option · template · sampler · prefix | PASS | 1.1.0 XTML 계약(체크포인트 템플릿 없이도 구조 검사) |
| full-model oracle (13L fixture) | GATE1/1b/2/3/3b PASS | teacher forcing·그리디·증분·프리픽스 재사용까지 비트 일치 |
| tokenizer parity | NOT RUN | tiktoken.model 없음(정식 체크포인트 동봉). 나머지는 전부 수행 |
sim_cache.py 트레이스 재생 |
표 재현 | 100,096 요청 · 10,010 distinct · LRU 8GB=36.24% |
오라클 픽스처는 hidden=128, layers=13, experts=8/top2, latent=64로 축소된 동일 텐서 그래프입니다. GATE 3b는 “이전 턴 상태 + 새 꼬리 프리필”이 전체 32토큰 프리필과 로짓·KV·KDA 상태까지 비트 동일해야 통과합니다. 채팅에서 턴 재사용이 단순 최적화가 아니라 정확도 계약임을 여기서 강제합니다.
한계도 명확합니다. 이 실측은 엔진이 레퍼런스와 같다는 것이지, 이 박스가 2.78T를 대화 속도로 돌린다는 뜻이 아닙니다. 풀 체크포인트와 빠른 로컬 NVMe, 그리고 laptop 이상이 필요합니다. 15 GB RAM 박스는 doctor 기준 laptop 후보이지만 디스크가 부족합니다.
1.1.0에서 실무적으로 바뀐 것
| 기능 | 의미 | 주의 |
|---|---|---|
--preset ultra / --ultra-low-memory |
임베딩·lm_head 청크 스트리밍 + 상태 슬롯 재사용으로 8 GB급 완전 모델 | 증명용. 대화 속도 기대 금지 |
--chat XTML REPL |
공식 채팅 템플릿·thinking_effort·reasoning_content JSONL | 히스토리 파일에 추론 전문 포함. 민감 데이터 취급 |
| NEON 커널 | Apple Silicon/ARM 서버에서 bf16·MXFP4·q8 | 스칼라와 비트 동일 주장 |
| 상태 파일 v2 | 체크섬. v1 거부 | --gen 0 --incremental --save-state로 재생성 |
| Ctrl-C 계약 | 1회: 스텝 완료 후 상태·JSON 기록 후 exit 5 / 2회: 즉시 종료 | 장시간 트렁크 로드 중에도 산출물 보존 |
| 전문가 로드 실패 | 드롭 카운트 후 exit 4 | 유창한 오답이 exit 0으로 위장하지 않게 |
트레이드오프와 도입 체크리스트
| 맞는 사람 | 아닌 사람 |
|---|---|
| Kimi K3 가중치를 이미(또는 곧) 보유하고, GPU 없이 바이트 동일 재현이 필요한 연구·검증 팀 | 범용 로컬 LLM 챗봇을 원하는 사용자 (모델·스토리지 장벽이 큼) |
| MoE I/O·캐시 정책을 숫자로 설계하려는 인프라 엔지니어 | 수 GB급 양자화 모델만 돌릴 환경 (1.56 TB는 협상 불가) |
| 커널 부동소수점 계약을 감사해야 하는 포팅·안전성 작업 | 다중 모델·플러그인 생태계가 우선인 제품팀 (단일 아키텍처 고정) |
- 스토리지가 성능 천장. CPU 코어를 늘려도 O_DIRECT 대역이 안 되면 s/token이 안 내려갑니다.
- 전문가 캐시는 가성비가 나쁩니다. 같은 예산을 트렁크 핀에 먼저 쓰는 편이 문서 측정에서 1.69× 유리했습니다.
- colibri/FreeToken과 역할이 겹쳐 보이지만 교체재가 아닙니다. 전자는 GGUF 일반 MoE, 후자는 서빙 스케줄, 이 저장소는 Kimi K3 비트 계약입니다.
- 라이선스. 엔진은 Apache-2.0. 가중치는 Hugging Face의 moonshotai/Kimi-K3 이용 약관을 따로 봐야 합니다.
- 보안. 채팅 히스토리 JSONL에는 사용자 발화와 assistant reasoning이 그대로 남습니다. 공유 디스크에 두지 마십시오.
마무리
kimi-k3-in-c 1.1.0은 “2.78T를 노트북에서”라는 문장을 마케팅이 아니라 측정 가능한 메모리 장부 + 비트 일치 오라클로 뒷받침합니다. MXFP4를 풀지 않은 채 곱하고, KDA로 컨텍스트 RSS를 평평하게 만들며, 트렁크를 스트리밍해 113 GB 상주 집합을 8 GB 다이얼로 낮춥니다. 오늘 박스에서는 풀 모델 생성 대신 무가중치 게이트 전부 7.8초에 통과시켰고, 전문가 트레이스 재생으로 캐시 용량표가 문서와 같음을 확인했습니다. 다음 단계는 스토리지와 라이선스가 허용하는 환경에서 download-model.sh → pack-trunk.sh → --preset laptop --incremental 한 토큰을 실제로 찍어, docs/data의 8.24 GB·32.69 s/token 줄을 자신의 디스크에서 재현하는 일입니다.