안녕하세요, 모릭월드입니다. 요리를 하다가 “이번 주말 어디 가지?”를 혼자 중얼거리면, 화면 속 캐릭터가 고개를 끄덕이고 입모양까지 맞춰 답하는 상상을 해 보신 적 있나요? 메타가 개인용 AI 에이전트 뮤즈(Muse)에 그 경험을 실제로 붙이기 시작했어요.
2026년 11월 5일(현지시간) 메타는 뮤즈 리얼타임 보이스(Muse Realtime Voice)와 뮤즈 리얼타임 아바타(Muse Realtime Avatar)를 결합한 실시간 대화를 미국 사용자에게 제공하기 시작했다고 밝혔어요. 지난 9월 메타 커넥트 2026에서 미리 보여 준 기술이에요. AI타임스(2026-11-06)와 메타 뉴스룸을 바탕으로, “영상 통화처럼 보이는데 뭐가 다른지”, “한국에서는 왜 아직인지”, “870ms·Video Seal이 뭔지”를 쉬운 말로 풀어 볼게요.
한눈에 보는 이번 소식
| 항목 | 내용 |
|---|---|
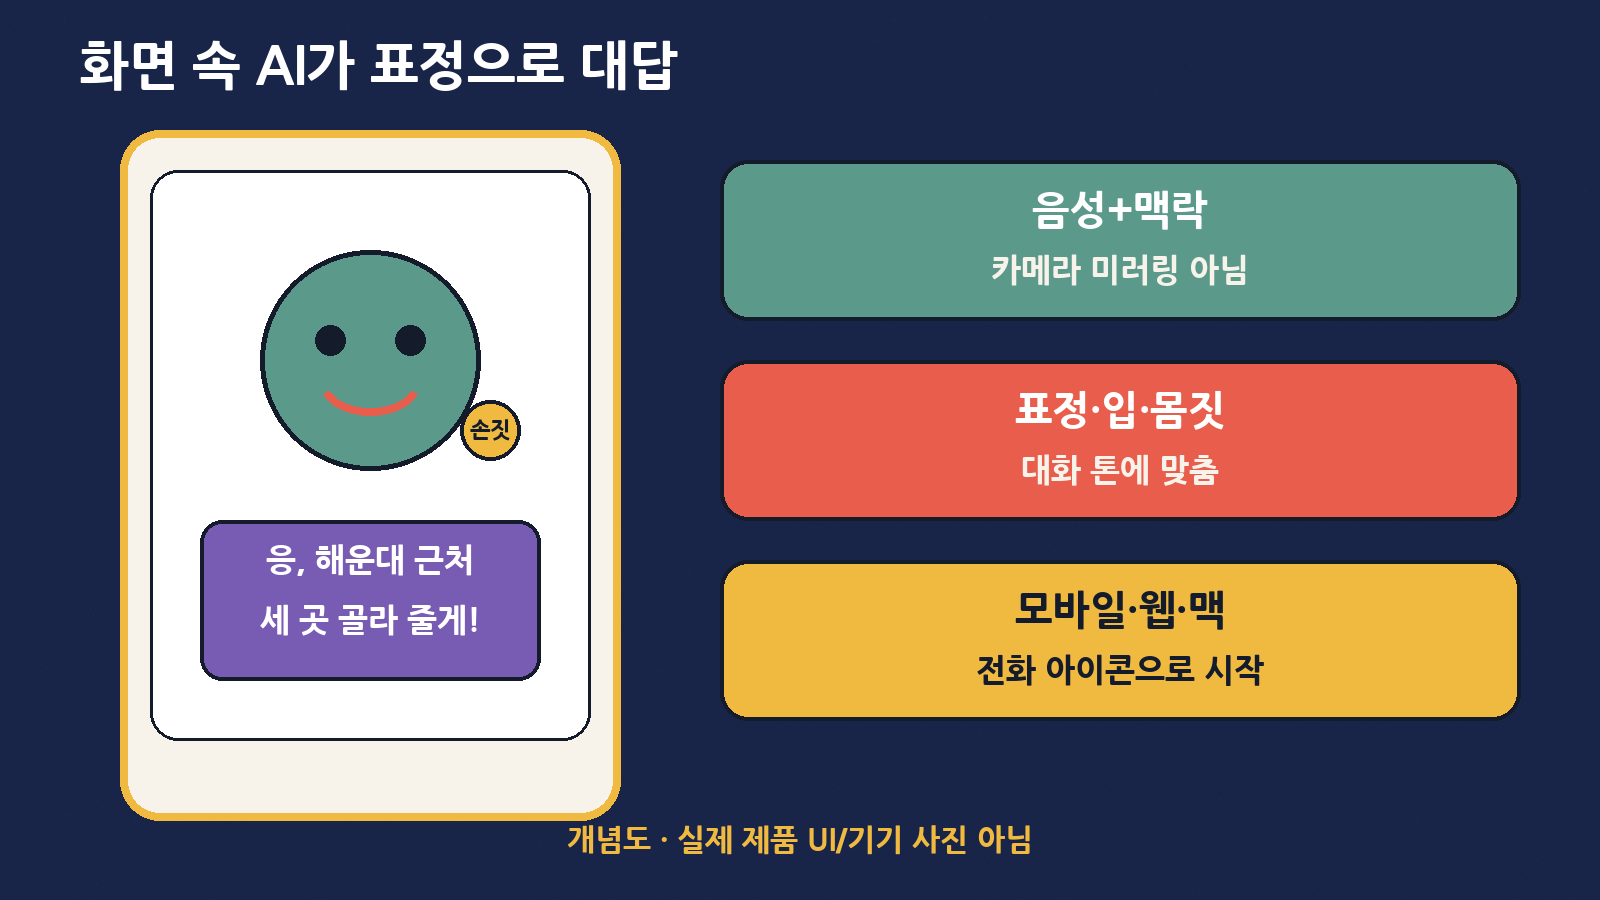
| 무엇 | 뮤즈 앱에서 실시간 음성 + 표정·몸짓 아바타로 대화 |
| 언제 | 2026년 11월 5일(현지) 미국 롤아웃 / 9월 커넥트 2026 프리뷰 |
| 어디서 | 모바일·웹·맥. 우측 상단 전화 아이콘을 누르면 시작(메타 뉴스룸) |
| 핵심 차이 | 카메라로 내 얼굴을 보지 않음. 목소리·대화 맥락으로 아바타가 반응 |
| 지연 | 말 끝난 뒤 동기화된 음성+영상 응답 시작까지 약 870ms |
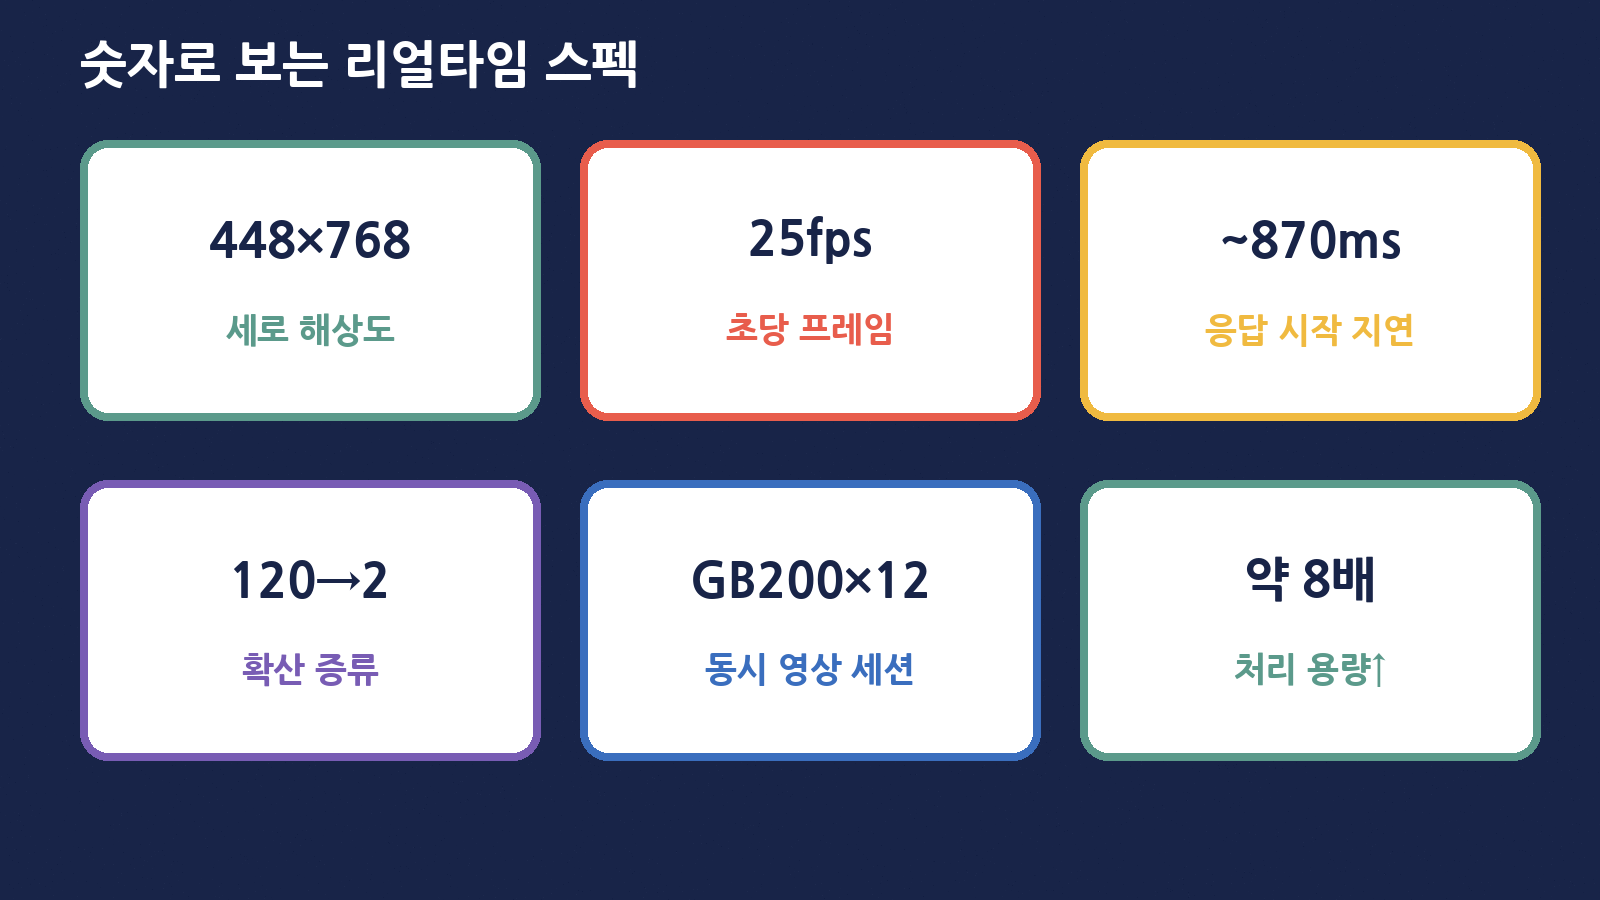
| 영상 스펙 | 448×768 세로, 초당 25프레임, 확산 증류 120→2회 |
| 안전·연령 | 보이지 않는 워터마크 Video Seal, 만 18세 이상 |
| 한국 | 뮤즈는 미국·캐나다·일본·싱가포르 등 / 국내 공식 미출시 |
이건 뭐고, 이건 아니에요
초보가 가장 헷갈리는 지점부터 짚을게요. “AI 영상 통화”라고 하면 줌·페이스타임처럼 서로 얼굴을 보는 장면을 떠올리기 쉬워요. 뮤즈 리얼타임 아바타는 느낌이 비슷해도 구조가 달라요.
| 구분 | 맞는 말 | 틀린 말 |
|---|---|---|
| 카메라 | 내 얼굴을 실시간으로 읽지 않음 | “내 표정을 따라 하는 미러링” |
| 아바타 반응 | 내가 말한 내용·말투·대화 톤에 맞춰 표정·입·몸짓 | “웹캠으로 내 눈·입을 복사” |
| 상대 | 사람·동물·캐릭터·일상 사물 형태도 가능 | “실제 친구와 영상 통화” |
| 일관성 | 한 대화 동안 외형·동작 일관성 유지(메타 설명) | “매 문장마다 다른 얼굴로 바뀜이 기본” |
| 용도 | 생각 정리·여행 계획·면접 리허설·손 바쁠 때 음성 지시 | “의료·법률 최종 판단 대체” |
먼저 용어부터: 음성 토큰, 립싱크, 증류
뉴스에 자주 나오는 말을 주방·택배 비유로 먼저 정리해 볼게요.
| 용어 | 쉬운 뜻 | 생활 속 비유 |
|---|---|---|
| Realtime Voice | 말의 내용과 전달 방식(톤·리듬)을 담은 음성 토큰을 만드는 쪽 | 대본 + 연기 지시가 적힌 큐시트 |
| Realtime Avatar | 그 토큰을 받아 소리·입모양·표정을 한 흐름으로 맞춤 | 성우+애니메이터가 동시에 리허설 |
| Diffusion Transformer | 영상을 ‘조금씩 또렷하게’ 만들어 가는 AI 구조의 한 종류 | 흐린 스케치를 여러 번 고쳐 완성 |
| 증류(120→2) | 선생님 모델의 긴 추론(120회)을 학생 모델 2회로 줄여 속도↑ | 레시피 120단계를 핵심 2단계로 압축 |
| Video Seal | 눈에 잘 안 보이는 워터마크로 생성 영상 출처를 추적 | 사진 구석 투명 스탬프 |
| GB200 | 엔비디아와 맞춘 고성능 GPU. 한 대에서 영상 세션 12개 동시 | 주방 화구 12개를 한꺼번에 돌리는 큰 렌지 |
파이프라인: 말 → 토큰 → 입·표정 동기화
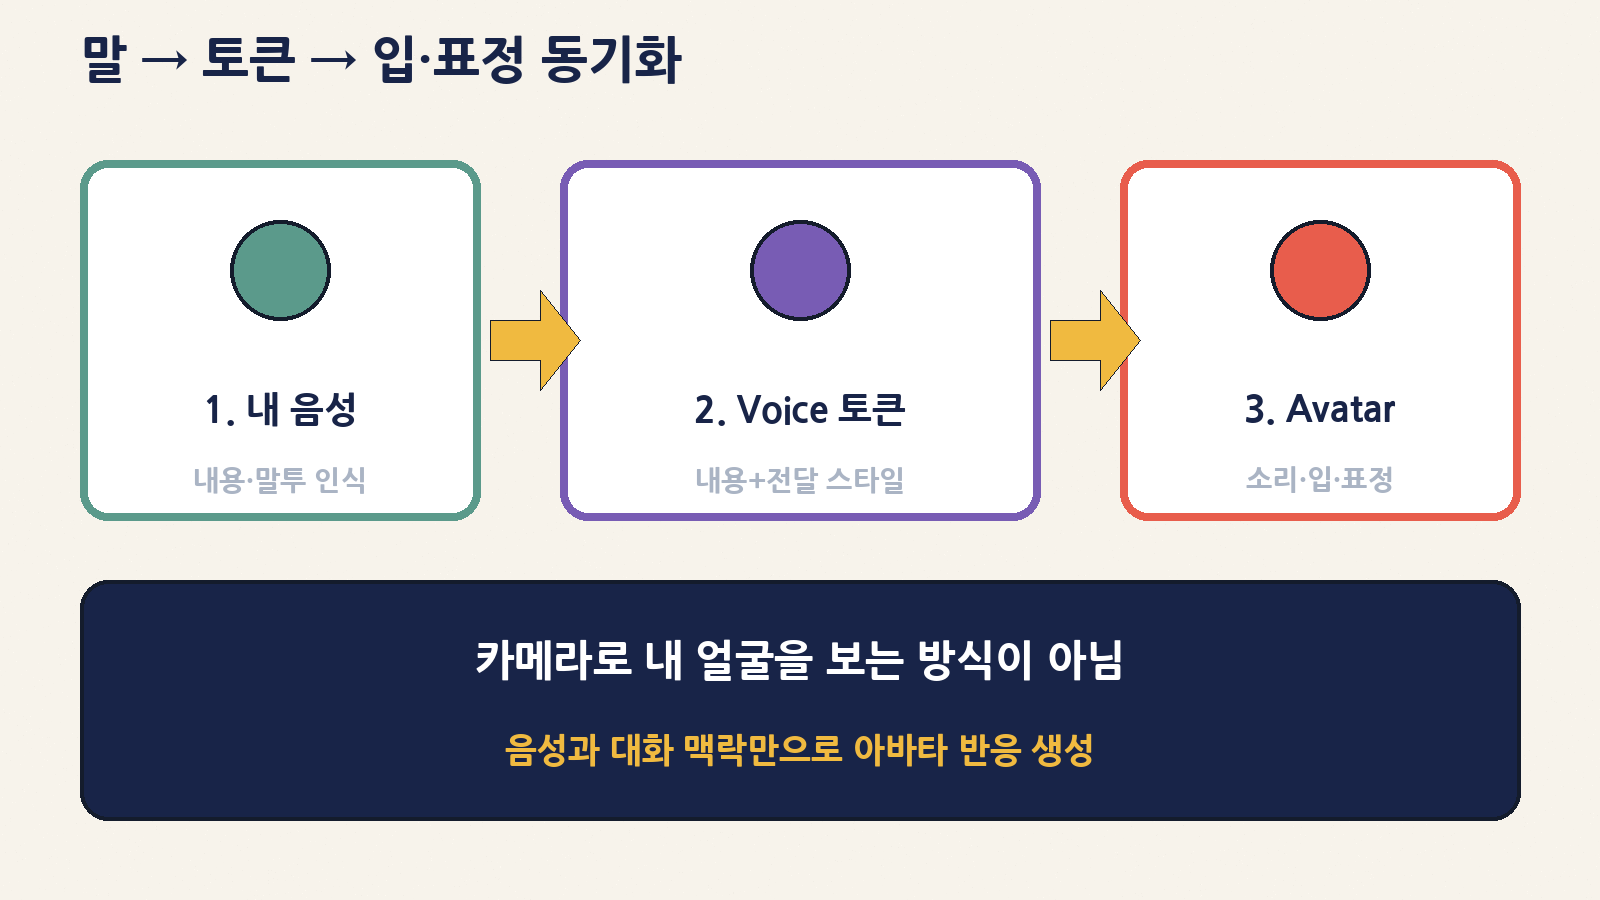
메타·AI타임스가 설명한 흐름을 한 줄로 쓰면 이래요. Realtime Voice가 음성 토큰을 만들고 → Realtime Avatar가 오디오·입·표정을 맞춥니다. 카메라로 내 얼굴을 보고 따라 하는 미러가 아니에요. TechCrunch도 “뮤즈는 사용자를 ‘보지’ 않고, 듣고 대화에서 반응한다”고 같은 맥락을 전했어요. 아바타 별명으로 Jolly가 언급되기도 했고, 사람·동물·캐릭터로 꾸밀 수 있다고 해요.
| 단계 | 무엇이 일어나나 | 초보 메모 |
|---|---|---|
| 1. 내가 말함 | 음성 인식·대화 맥락 파악 | 요리 중에도 말로 지시 가능(뉴스룸 예시) |
| 2. Voice 토큰 | 답변 내용 + 전달 스타일을 토큰으로 | 같은 문장도 톤이 다르면 느낌이 달라짐 |
| 3. Avatar 동기화 | 음성 디코더 + 아바타 모델로 소리·입·표정 | 립싱크가 ‘따로 노는’ 느낌을 줄이려는 단계 |
| 4. 실시간 영상 | Diffusion Transformer + 증류로 빠른 프레임 생성 | 세로 448×768 · 25fps |
| 5. 내가 들음·봄 | 말 끝난 뒤 약 870ms 후 동기 응답 시작 | 중간에 끼어들기도 가능(뉴스룸) |
일반 영상 통화 vs 뮤즈 아바타 통화
줌으로 친구와 통화할 때와 무엇이 다른지 표로 나란히 보면 감이 와요.
| 비교 | 일반 영상 통화(친구) | 뮤즈 리얼타임 아바타 |
|---|---|---|
| 상대 | 실제 사람 | AI 에이전트(아바타로 표현) |
| 카메라 | 서로 얼굴을 보냄 | 내 얼굴을 ‘따라 하기’용으로 쓰지 않음 |
| 표정 출처 | 상대의 실제 얼굴 | 대화 톤·음성에서 생성 |
| 표시 모드 | 보통 상대 화면 중심 | 음성만 / 채팅 옆 아바타 / 전체 화면(뉴스룸) |
| 목소리 | 상대 본인 목소리 | 수백 가지 보이스, 언제든 변경 |
| 백그라운드 작업 | 상대가 따로 일하진 않음 | 말하면서 뮤즈가 작업 진행 가능(뉴스룸) |
숫자로 보는 스펙: 870ms는 얼마나 빠른가요
AI타임스가 전한 기술 숫자를 일상 감각으로 바꿔 보면 이해가 쉬워요.
| 숫자 | 의미 | 감각 비유 |
|---|---|---|
| 약 870ms | 발화 종료 → 동기화된 음성+영상 응답 시작 | 엘리베이터 문 닫히기 직전 ‘띵’ 한 번 정도의 짧은 숨 |
| 448×768 | 세로형 영상 해상도 | 폰 세로 화면에 맞춘 비율 |
| 25fps | 초당 25장 | 일반 TV·영상 대화에 흔한 프레임 감 |
| 120→2 증류 | 교사 확산 단계를 크게 줄여 속도 확보 | 긴 베이킹을 급속 레시피로 |
| GB200 ×12 | GPU 1대로 영상 생성 세션 12개 동시 | 한 주방에서 12테이블 동시 서빙 |
| 약 8배 | 이전 기준 대비 서비스 처리 용량 | 같은 매장에서 손님을 8배 받도록 동선 개선 |
870ms가 “사람끼리 자연스럽다”의 완벽한 기준은 아니지만, 말이 끝난 뒤 거의 1초 안에 입과 소리가 같이 시작된다는 점이 이번 기술의 핵심 판매 포인트예요. 메타는 엔비디아와 협력해 실시간 추론 인프라도 맞춰 두었다고 AI타임스는 전했어요.
어디에 쓸 수 있나요? 일상 장면 네 가지
메타 뉴스룸이 든 예시를 한국 생활 장면으로 바꿔 보면 이래요. (한국에서는 아직 앱을 공식으로 못 쓰니, ‘되면 이런 식’으로 읽어 주세요.)
| 장면 | 이렇게 말해 볼 수 있어요 | 아바타가 돕는 점 |
|---|---|---|
| 저녁 요리 | “이번 주말 부산인데, 해운대 근처 가성비 숙소만 골라 줘” | 손 젖은 채 타이핑 없이, 표정 있는 응답으로 확인감 ↑ |
| 산책 | “면접 예상 질문 세 개만 물어보고, 내 답에 바로 피드백” | 리허설이 ‘혼자 중얼거림’보다 대화처럼 느껴짐 |
| 아이디어 회의 | “반만 익은 아이디어야. 네가 이어서 구조만 잡아 줘” | 프롬프트를 완벽히 안 써도 ‘말로 생각’ 가능 |
| 표시 모드 선택 | 음성만 / 채팅 옆 / 전체 화면 | 집중도에 따라 ‘얼마나 마주볼지’ 조절 |
어디서 쓸 수 있나요? 국가·기기·연령
가장 많이 묻는 질문이 “한국에서도 되나요?”예요. 결론부터 말하면 아직 공식 출시되지 않았다고 AI타임스가 분명히 적었어요.
| 항목 | 현황(보도·공식 기준) | 초보 메모 |
|---|---|---|
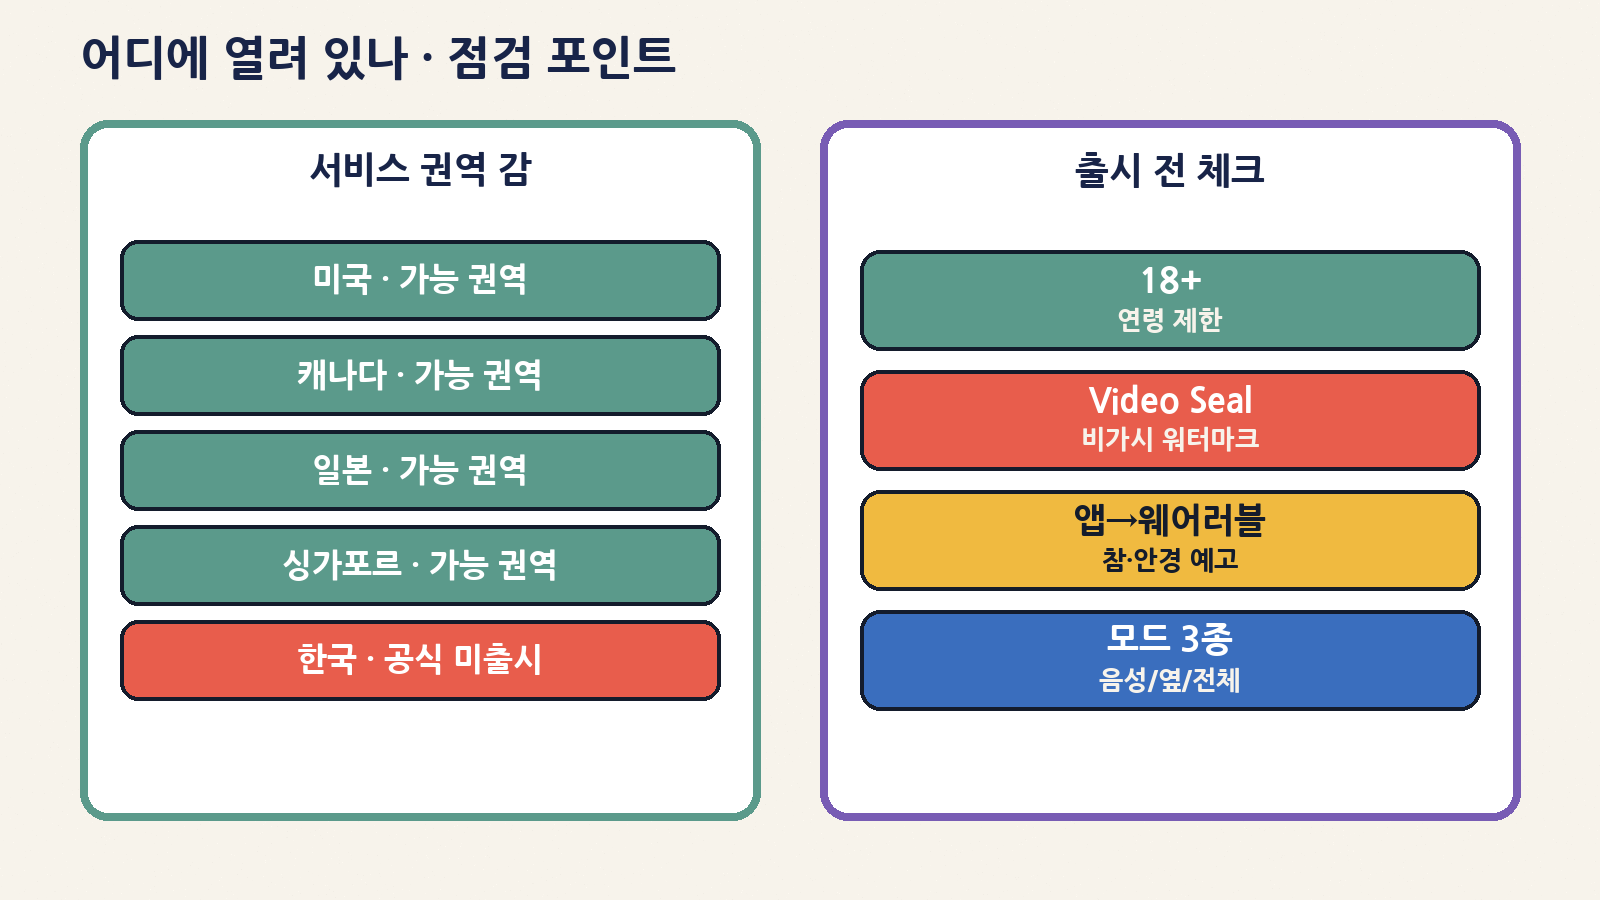
| 미국 | 음성+표현 아바타 롤아웃 시작(11/5 현지) | 뉴스룸: “US to start” |
| 캐나다·일본·싱가포르 등 | 뮤즈 서비스 권역에 포함(AI타임스) | 이번 ‘아바타’ 기능의 국가별 세부 일정은 공식 공지 확인 필요 |
| 한국 | 공식 미출시 | VPN·우회는 정책·약관·계정 위험을 스스로 감수해야 함 — 이 글은 권하지 않음 |
| 기기 | 모바일·웹·맥 | 연내 뮤즈 참(웨어러블)·AI 안경에 음성 등 확대 계획 |
| 연령 | 만 18세 이상 | 미성년 계정으로는 대상이 아님 |
| 워터마크 | Video Seal(비가시) | 실시간 속도 유지하면서 출처 추적·오용 완화 목적 |
한국에 오면 이렇게 점검해 보세요 (체크리스트)
출시 소식이 나면 바로 가입하기 전에, 아래만 훑어도 후회가 줄어요.
| 점검 | 물어볼 말 | 왜 중요? |
|---|---|---|
| 1. 공식 권역 | 한국이 Muse 지원 국가 목록에 올랐나? | 미지원 계정은 기능·결제가 막힐 수 있음 |
| 2. 연령 | 만 18세 이상인가? | 이번 기능 대상이 성인 |
| 3. 모드 | 음성만 / 옆면 / 전체화면 중 뭐가 편한가? | 공공장소에서는 음성만이 안전할 수 있음 |
| 4. 개인정보 | 음성·대화가 어디에 어떻게 쓰이나? | 설정·약관을 먼저 |
| 5. 워터마크 | 생성 영상을 외부에 올려도 되나? | Video Seal이 출처 추적에 쓰일 수 있음 |
| 6. 웨어러블 | 뮤즈 참·AI 안경 일정이 궁금한가? | 앱 다음 단계로 ‘작은 화면’ 대화가 예고됨 |
초보가 헷갈리기 쉬운 다섯 가지
| 오해 | 바로잡기 |
|---|---|
| “내 웹캠을 보고 표정을 따라 한다” | 아니요. 보도에 따르면 카메라로 얼굴을 보는 방식이 아니라, 음성과 대화 맥락으로 반응을 만들어요. |
| “한국에서도 지금 바로 된다” | 뮤즈는 일부 국가만, 국내는 아직 공식 미출시예요. |
| “870ms면 사람이랑 완전 똑같다” | 아주 짧은 편이지만, 네트워크·기기·부하에 따라 체감은 달라질 수 있어요. ‘말 끝난 뒤 시작까지’의 측정값이에요. |
| “워터마크가 없으면 AI 영상이 아님” | Video Seal은 메타가 넣는 추적 장치예요. 다른 서비스·편집본에는 없을 수 있어요. |
| “아바타는 사람 얼굴만 된다” | 사람뿐 아니라 동물·캐릭터·일상 사물 형태도 가능하고, 참고 이미지·영상으로 맞출 수 있다고 해요. |
자주 묻는 질문
| 질문 | 답 |
|---|---|
| 챗GPT 음성 모드랑 뭐가 달라요? | 공통점은 ‘말로 대화’예요. 이번 뮤즈 소식의 포인트는 표정·입·몸짓이 맞물린 실시간 아바타 영상과, 메타가 밝힌 지연·증류·워터마크 같은 구현 디테일이에요. |
| 중간에 말을 끊을 수 있나요? | 메타 뉴스룸은 응답 도중에도 끼어들 수 있다고 설명해요. 사람끼리 대화하듯 ‘잠깐만’이 되는 쪽에 가깝습니다. |
| 목소리는 하나만 쓰나요? | 수백 가지 보이스 중에서 고르고, 기분에 따라 언제든 바꿀 수 있다고 해요. |
| 뮤즈 참·AI 안경은 언제인가요? | 연내 출시 예정 웨어러블·안경에 음성 대화 등을 차례로 적용할 계획이라고 전했어요. 정확한 판매일은 이후 공지를 보면 됩니다. |
| 아이와 함께 써도 되나요? | 이번 기능은 만 18세 이상 대상이에요. 가족 계정·자녀 보호 설정은 별도로 확인하세요. |
정리하면, 메타 뮤즈의 리얼타임 아바타는 “화면 속 캐릭터가 내 말에 표정까지 짓는” 경험을 미국부터 열어 준 소식이에요. 카메라를 켜서 나를 따라 하는 미러가 아니라, 목소리와 대화로 표정을 만드는 AI라는 점, 약 870ms·25fps·Video Seal·18세 이상·한국 미출시라는 숫자를 기억해 두면, 다음에 비슷한 뉴스가 나와도 덜 헷갈려요. 모릭월드가 복잡한 소식을 쉽게 풀어 볼게요.