안녕하세요, 모릭월드입니다. 게임을 하다 보면 레벨은 다 아는데 같은 벽에 반복해서 부딪혀 클리어가 안 되는 “소프트락”이 있죠. AI도 비슷한 일을 겪을 수 있어요. 수학을 어느 정도 아는데, 같은 문장을 끝없이 반복하다 답을 못 내고 멈추는 식이에요.
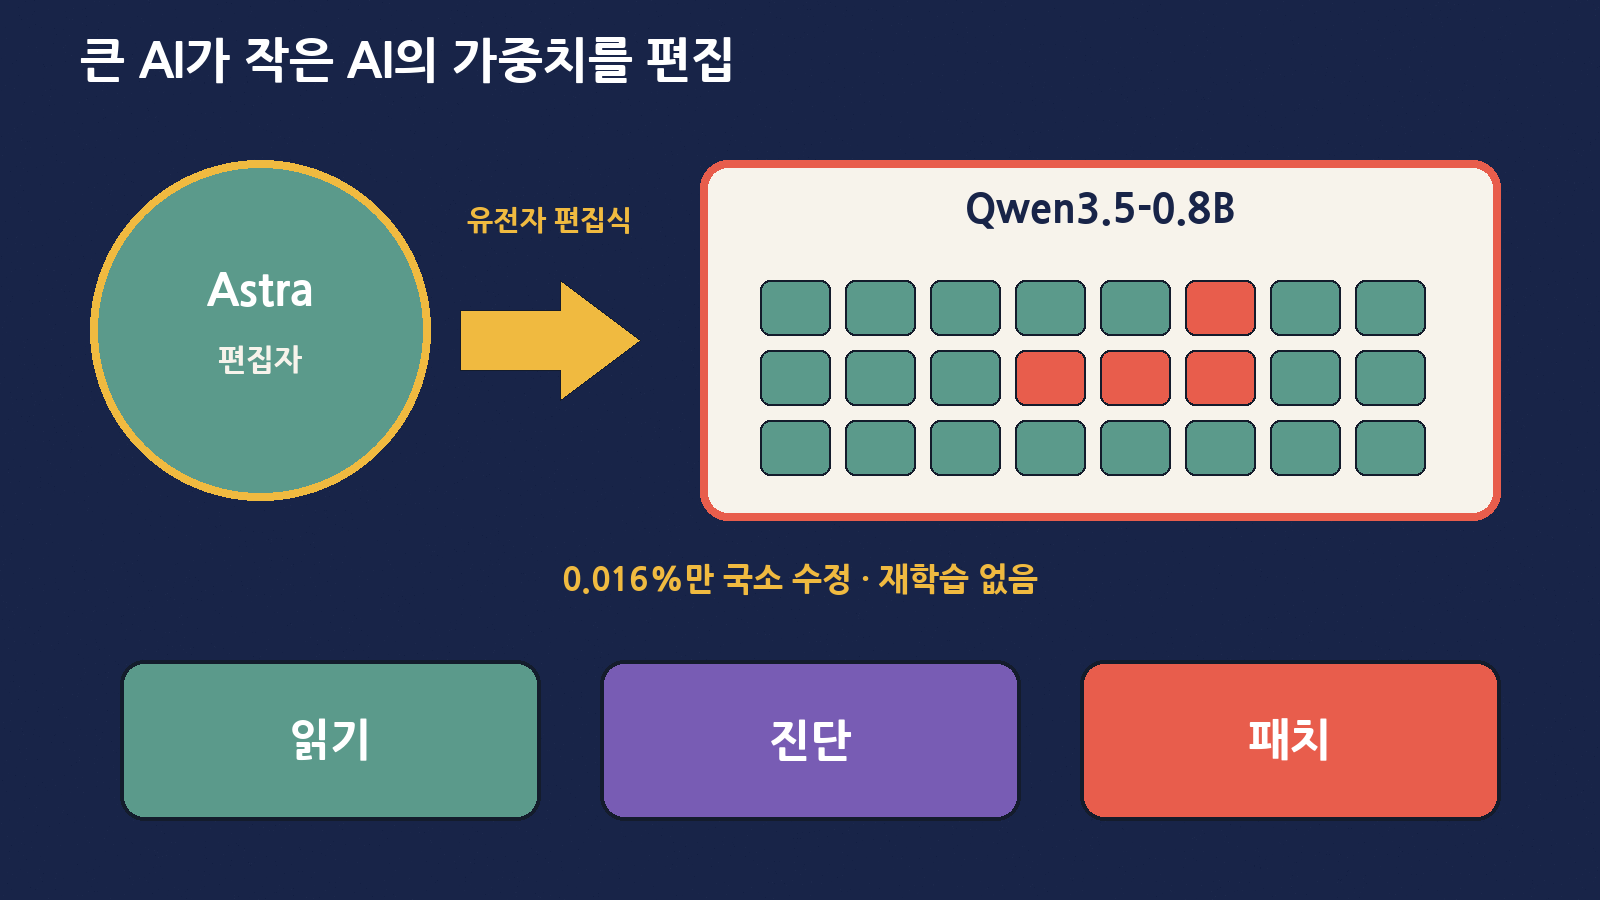
MIT CSAIL 연구진은 2026년 11월 2일(현지) 블로그에서, 첨단 언어모델 GPT-6 Astra가 다른 AI의 가중치(weights)를 직접 읽고·고쳐 재학습·경사하강법 없이 성능을 끌어올리는 실험을 공개했어요. 벤처비트는 이를 신경망의 ‘유전자 편집’에 비유했고, AI타임스(11월 4일)도 국내에 전했어요. 오늘은 “뭘 고쳤는지”, “점수가 왜 6배로 보였는지”, “아직 안 되는 것”을 초보 눈높이로 풀어 볼게요.
한눈에 보는 이번 소식
| 항목 | 내용 |
|---|---|
| 무엇 | 가중치공간 프로그래밍(Weight-Space Programming) — LLM이 다른 신경망의 가중치를 직접 읽고 씀 |
| 누가 | Rikiya Takehi, Jayden Teoh, Alex Zhang, Omar Khattab (MIT CSAIL) |
| 언제 | 연구 블로그 2026년 11월 2일 공개 / AI타임스 11월 4일 보도 |
| 편집자 | OpenAI GPT-6 Astra |
| 대상 모델 | 알리바바 Qwen3.5-0.8B (약 8억 가중치, 24층) |
| 핵심 패치 | 15·19층 MLP의 ‘반복/루프’ 방향을 빼 냄 → 131,072개 = 전체의 0.016% |
| 대표 수치 | MATH-500 7.9%→48.1% (약 6.1배), GSM8K 13.8%→67.1%, IFEval 21.0%→62.3% |
| 방식 | 기울기(gradient)·추가 학습 없음. 파이썬 커널로 가중치 분석·수정 + 연습 문제 전방 패스 예산 |
| 체크포인트 | Hugging Face RikiyaT/Qwen3.5-0.8B-weight-space-programming |
이건 뭐고, 이건 아니에요
초보가 가장 헷갈리는 지점부터 짚을게요. “점수가 6배”라는 헤드라인만 보면, Astra가 Qwen에게 수학 지식을 6배 주입한 것처럼 느껴지기 쉬워요. 연구진·벤처비트·AI타임스가 공통으로 강조한 해석은 다릅니다.
| 구분 | 맞는 말 | 틀린 말 |
|---|---|---|
| 무엇을 했나 | 반복(루프) 결함을 줄여 이미 있던 능력이 답을 끝까지 내도록 함 | “수학 지식을 6배 새로 넣었다” |
| 학습 | 경사하강법·미세조정 루프 없이 가중치를 직접 편집 | “그냥 버튼 한 번에 자동 재학습” |
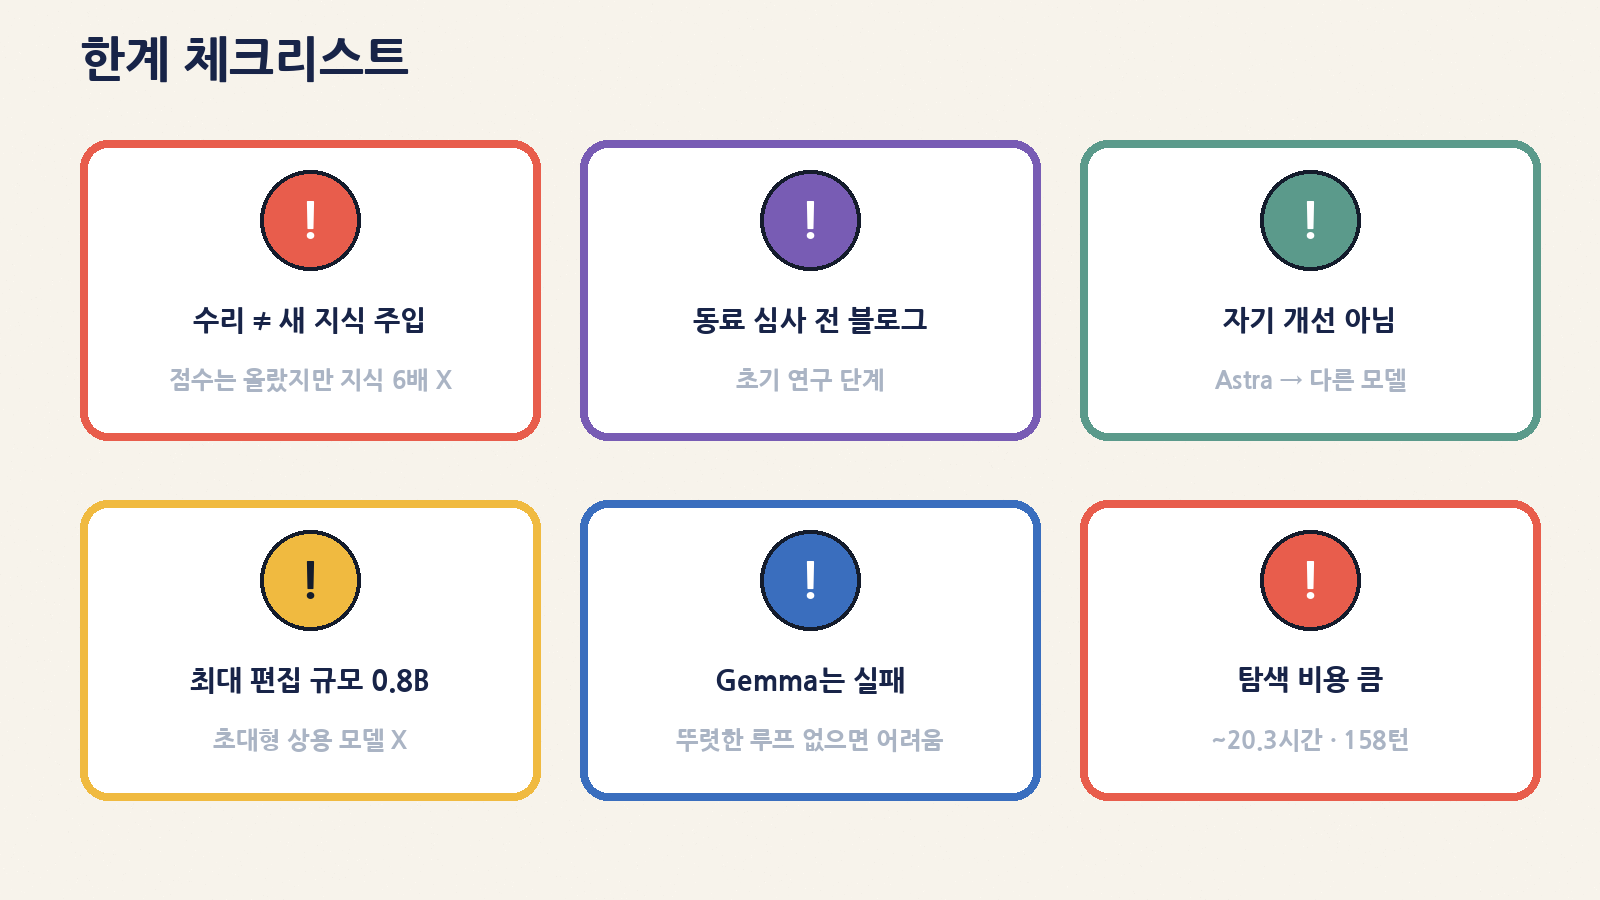
| 범위 | 가장 큰 언어모델 편집 사례는 0.8B 규모 | “초대형 상용 모델도 이미 일상적으로 이렇게 고친다” |
| 자기 개선 | Astra가 다른 모델을 고친 실험 | “Astra가 자기 자신을 스스로 무한 강화” |
| 검증 단계 | 초기 연구 블로그(동료 심사 전) | “이미 표준 산업 공정으로 확정” |
먼저 용어부터: 가중치, 루프, 전방 패스
뉴스에 자주 나오는 말을 일상 비유로 먼저 정리해 볼게요.
| 용어 | 쉬운 뜻 | 생활 속 비유 |
|---|---|---|
| 가중치(weights) | 입력을 출력으로 바꾸는 수많은 숫자 파라미터 | 레시피의 재료 비율·불 세기 설정값 |
| 가중치공간 프로그래밍 | LLM이 그 숫자들을 직접 읽고·써 목표에 맞게 고침 | 코드 디버거가 소스 대신 ‘설정 파일’을 고치는 느낌 |
| 경사하강법 | 오차를 보고 가중치를 조금씩 움직이는 대표 학습법 | 시험지 채점 후 점수 따라 공부 계획 수정 |
| 반복/루프 버그 | 같은 추론 문장을 되풀이하다 토큰 한도에 걸림 | 게임에서 같은 벽에 계속 부딪히는 소프트락 |
| 전방 패스(forward pass) | 모델을 한 번(또는 한 묶음) 돌려 출력을 보는 것. 기울기 계산은 없음 | 수리 전에 ‘시운전’만 해 보는 것 |
| MLP 층 | 트랜스포머 안의 다층 퍼셉트론 블록. 이번 패치 자리 | 공장 라인의 ‘중간 가공대’ |
무엇을 고쳤나: 15·19층의 ‘반복 방향’
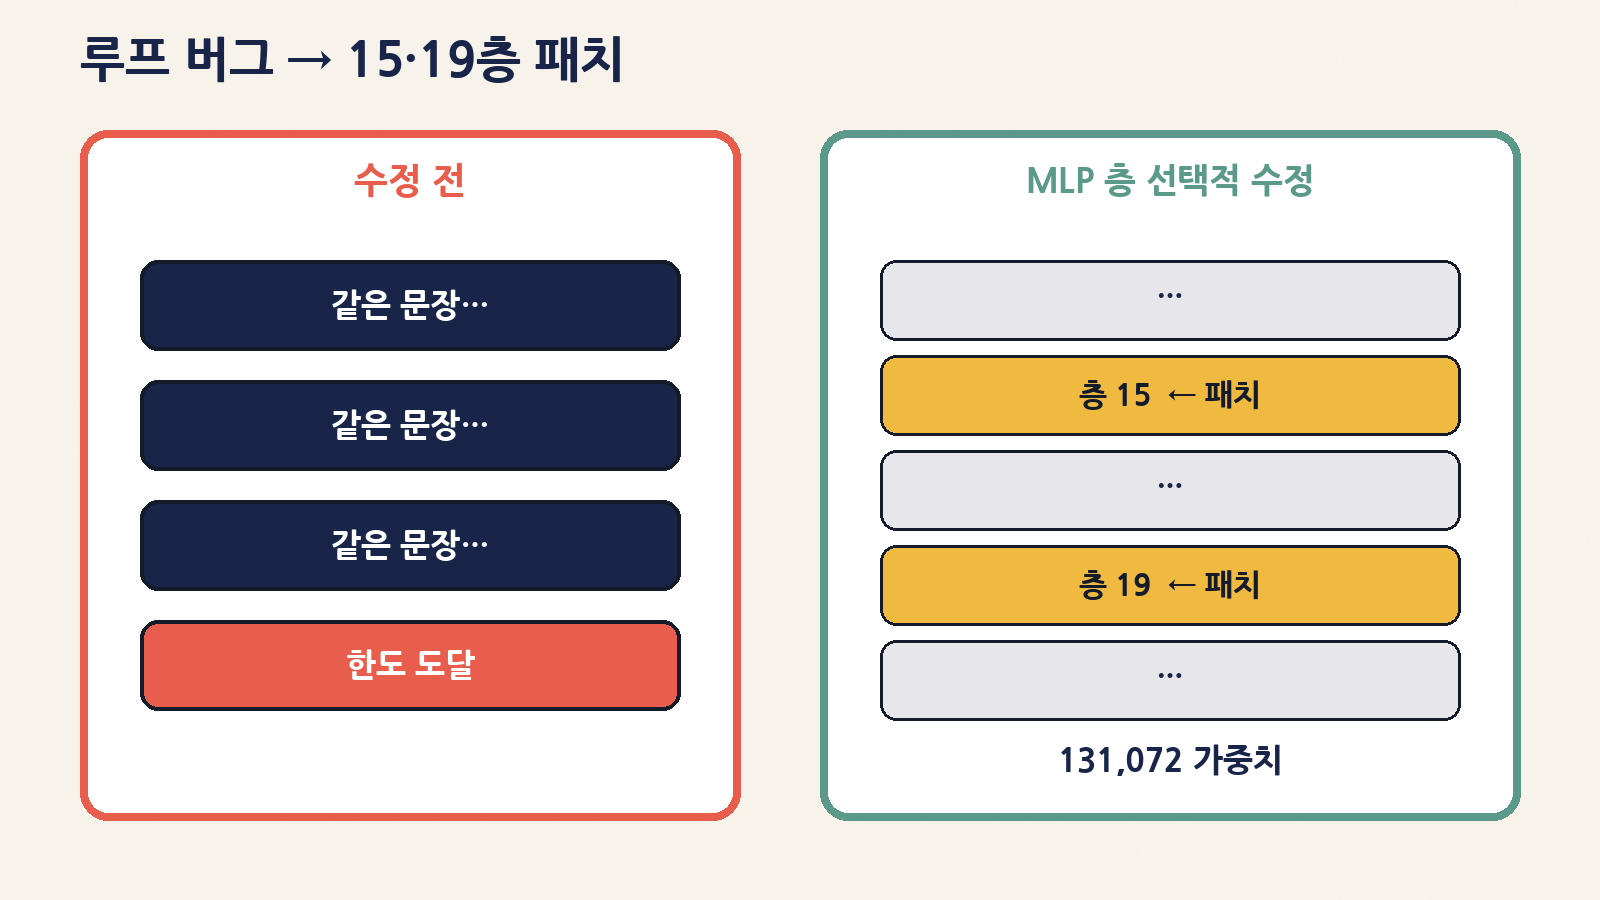
Qwen3.5-0.8B는 모델 카드에도 적혀 있듯 사고(thinking) 모드에서 루프에 빠지기 쉬운 소형 모델이었어요. 연습 답변 96개 중 85개가 32,768 토큰 한도에 걸렸다는 기록이 연구 블로그에 나옵니다.
Astra는 파이썬으로 가중치를 들여다본 뒤, 15번째·19번째 층의 MLP가 쓰는 한 방향(벡터)이 반복과 관련 있다고 보고, 각 층에서 출력 열 64개씩에서 그 방향을 빼 냈어요. 고친 숫자는 131,072개, 전체의 약 0.016%입니다.
| 단계 | 무엇이 일어나나 | 초보 메모 |
|---|---|---|
| 1. 목표 제시 | “Qwen3.5-0.8B 수학을 더 잘하게, 다만 학습·기울기 없이” | 자연어 스펙으로 시작 |
| 2. 도구 | 가중치가 올라간 파이썬 커널(노트북처럼) | GPU 학습 루프는 금지 |
| 3. 연습 문제 | GSM8K·MATH 훈련 세트 연습 문제(테스트셋 비공개) | 시운전용 문제 |
| 4. 예산 | 전방 패스 10 / 25 / 50회 비교 (배치 최대 512 등) | 50회에서 효과가 뚜렷 |
| 5. 진단 | ‘반복 루프’가 답을 막는 주범으로 추적 | 소프트락 제거에 가까움 |
| 6. 패치 | 15·19층 MLP 방향 제거 (131,072 가중치) | 유전자 편집처럼 ‘국소 수정’ |
숫자로 보는 성적표
같은 샘플링 설정(temperature 0.6, top-p 0.95 등)에서 측정한 연구진 표입니다. ‘전방 패스 예산’이 늘수록 루프가 줄고 점수가 올랐어요.
| Qwen3.5-0.8B | MATH-500 (%) | GSM8K (%) | IFEval (%) | 토큰 한도 도달 (%) |
|---|---|---|---|---|
| 원본(Base) | 7.9 | 13.8 | 21.0 | 93.0 |
| 편집 · 전방 패스 10 | 12.3 | 25.7 | 49.0 | 87.2 |
| 편집 · 전방 패스 25 | 14.1 | 25.1 | 39.9 | 86.4 |
| 편집 · 전방 패스 50 | 48.1 | 67.1 | 62.3 | 33.1 |
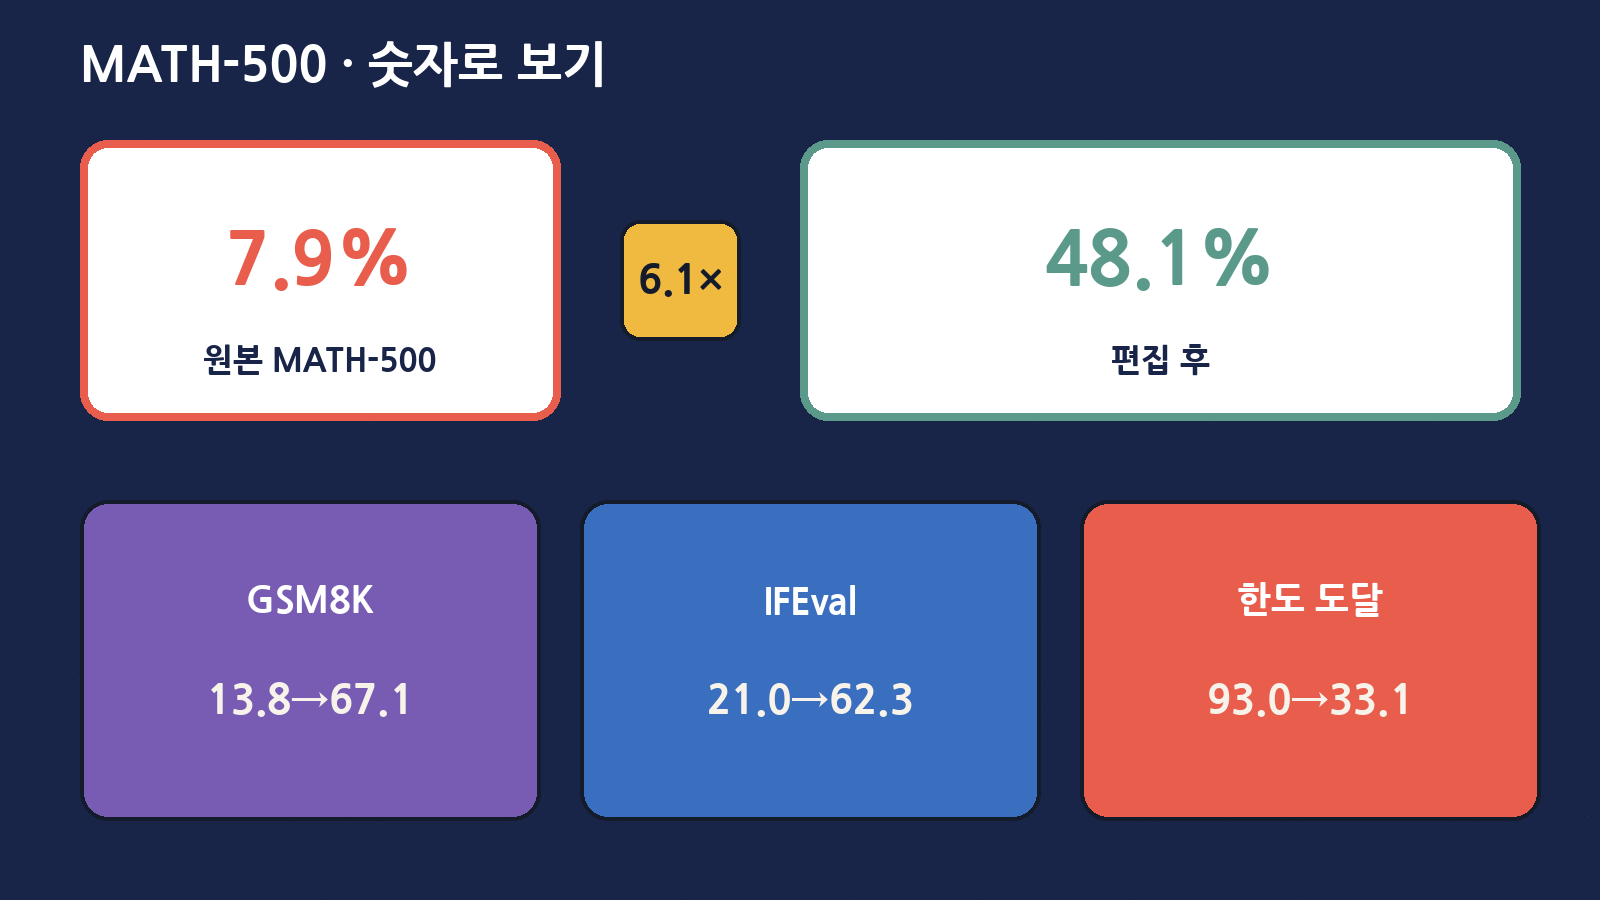
MATH-500이 약 6.1배로 보인 이유의 큰 축은, 한도에 막혀 답을 못 내던 비율이 93%→33%로 줄었다는 점이에요. 지시 이행(IFEval)도 같이 오른 것은, 루프가 수학만이 아니라 일반 응답도 망가뜨리고 있었다는 해석과 맞물립니다.
패치를 찾는 데 걸린 노력
“0.016%만 고쳤다”는 말과 “금방 끝났다”는 말은 같지 않아요. 벤처비트가 전한 실험 로그 요약은 이래요.
| 항목 | 수치·내용 | 초보 메모 |
|---|---|---|
| 대화 턴 | 약 158턴 | 진단·가설·수정이 오가며 진행 |
| 파이썬 실행 | 약 80회 | 가중치 분석·패치 시운전 |
| 소요 시간 | 약 20.3시간 (서비스 장애 대기 약 4.7시간 포함) | ‘작은 패치’라도 탐색 비용은 큼 |
| 미세조정 대비 | 더 싸거나 빠르다는 입증은 아직 없음 | 연구진·보도 모두 유보 |
다른 데모도 있었어요 (게임·자동차·처음부터 작성)
Qwen 패치만 있는 연구는 아니에요. 작은 네트워크에서는 ‘읽기·고치기·처음부터 쓰기’를 여러 각도로 보여 줬습니다.
| 실험 | 한 줄 요약 | 포인트 |
|---|---|---|
| 게임 식별 | 같은 구조의 4개 정책망(Breakout·Pong·Pac-Man·Freeway) 가중치만 보고 게임을 맞춤 | 옵션 목록 없이 맞춤 |
| 자동차 경사로 | 곧바로 돌진하다 막히던 정책을, 가중치 3.5% 수정으로 후진→가속→성공 0%→100% | 국소 최소에서 빠져나옴 |
| MinAtar 처음부터 | 학습 없이 가중치를 작성해 PPO 1억 스텝보다 나음. Breakout은 PPO 5억 스텝(25.3) 대비 517.4 | 전략을 숫자로 ‘프로그래밍’ |
| 바둑(약 150만 파라미터) | 전방 패스 예산에 따라 성능이 늘어남. 50회 예산에서 동급 PPO(2천만 판)를 이김 | 도구·시운전이 커질수록 강해짐 |
안 된 사례: Gemma 3 270M
같은 방식의 ‘수학 업’을 구글 Gemma 3 270M에도 시도했지만, 뚜렷한 상승은 못 잡았어요. Gemma는 토큰 한도 도달이 약 8.5%로 낮아 Qwen처럼 뚜렷한 루프 결함이 없었고, 단순 산수·대수 실수는 ‘한 방향만 빼는’ 패치로 고치기 어려웠다는 설명입니다.
| Gemma 3 270M | MATH-500 (%) |
|---|---|
| 원본 | 6.8 |
| 편집 · 전방 패스 5 | 7.0 |
| 편집 · 전방 패스 10 | 7.6 |
| 편집 · 전방 패스 25 | 7.7 |
| 편집 · 전방 패스 50 | 7.0 |
연구진 스스로도 이 변화는 ‘확립된 향상’으로 보기 어렵다고 적었어요. 장애물을 치우면 숨은 실력이 나오고, 없던 실력은 아직 못 넣는다는 메시지가 핵심입니다.
초보가 헷갈리기 쉬운 다섯 가지
| 오해 | 바로잡기 |
|---|---|
| “수학 IQ가 6배가 됐다” | 벤치마크 점수가 약 6.1배로 오른 것이고, 연구 해석은 루프 결함 제거에 가깝습니다. |
| “학습이 아예 필요 없다” | 이번 편집에 기울기 학습은 없었지만, 연습 문제·전방 패스·긴 탐색은 있었습니다. |
| “어떤 모델이든 이렇게 고친다” | Gemma처럼 명확한 단일 결함이 없으면 실패할 수 있어요. 대상도 0.8B까지. |
| “이미 동료 심사 논문이다” | 지금은 연구 블로그·로그·HF 체크포인트 공개 단계예요. |
| “AI가 스스로를 무한 강화한다” | Astra가 다른 모델을 고친 사례입니다. 재귀적 자기 개선 사이클은 입증되지 않았어요. |
자주 묻는 질문
| 질문 | 답 |
|---|---|
| LoRA·미세조정이랑 뭐가 달라요? | 미세조정은 데이터로 기울기를 계산해 가중치를 조금씩 움직입니다. 이번 방식은 LLM이 가중치를 읽고 어디를 어떻게 고칠지 추론한 뒤 직접 패치합니다. |
| 일반 사용자가 지금 쓸 수 있나요? | 연구용 데모·공개 체크포인트 단계예요. 일상 앱의 ‘원클릭 유전자 편집’은 아닙니다. |
| 고친 모델은 어디서 보나요? | Hugging Face의 RikiyaT/Qwen3.5-0.8B-weight-space-programming와 실험 로그(GitHub)가 공개돼 있어요. |
| 왜 지시 이행(IFEval)도 올랐나요? | 루프가 수학 전용이 아니라 일반 응답도 가로막고 있었기 때문이라는 설명이 연구·보도에 나옵니다. |
| 기계적 해석가능성(MI)과 관계는? | 그동안은 ‘어느 가중치가 무슨 역할인가’를 읽는 쪽에 가까웠다면, 이번엔 범용 LLM이 읽고 나서 고치는 쪽으로 한 걸음 나간 실험이에요. |
기억해 두면 좋은 체크리스트
| 점검 | 질문 | 왜 중요? |
|---|---|---|
| 1. 수리 vs 주입 | 점수가 오른 이유가 ‘결함 제거’인가 ‘새 지식’인가? | 헤드라인 과장 방지 |
| 2. 규모 | 편집 대상이 몇 B인가? | 지금은 0.8B가 상한선에 가깝게 제시됨 |
| 3. 실패 사례 | Gemma처럼 안 된 실험이 같이 공개됐는가? | 한계를 가늠하는 단서 |
| 4. 비용 | 탐색 시간·턴·실행 횟수는? | ‘작은 패치=싼 패치’가 아님 |
| 5. 검증 | 동료 심사·독립 재현이 됐는가? | 초기 블로그 단계 인지 |
| 6. 자기 개선 | 자기 자신을 고치는 사이클인가? | 아직 해당 없음 |
정리하면, MIT CSAIL의 가중치공간 프로그래밍은 “큰 AI가 작은 AI의 숫자 설정값을 유전자 편집처럼 국소적으로 고친” 초기 실험이에요. Qwen3.5-0.8B에서는 반복 루프를 줄여 MATH-500이 7.9%에서 48.1%로 올랐고, 고친 비중은 0.016%에 불과했습니다. 다만 그건 수리(repair)에 가깝고, 새 지식을 6배 넣었다거나, 이미 미세조정보다 싸고 빠른 표준 공정이라는 뜻은 아직 아닙니다. 숫자와 한계를 같이 기억해 두면, 다음에 비슷한 뉴스가 와도 덜 헷갈려요. 모릭월드가 복잡한 소식을 쉽게 풀어 볼게요.