2026년 11월 8일(일) GitHub Trending의 C++ 일간 목록에 Neroued/ninfer가 올라와 있습니다. 이 글을 쓰는 시점 GitHub API 기준 스타 3,288, forks 691, 커밋 1,565, 라이선스는 Apache-2.0입니다. 릴리스와 태그는 하나도 없고, 기본 브랜치는 master, HEAD는 77c2e5e(2026-11-07 17:21 KST, “fix(runtime): recover preempted requests without stalling”)입니다. 저장소 설명은 “High-performance single-GPU inference for selected model checkpoints and GPUs”이고, README 첫 줄은 “Native C++/CUDA inference for selected models on RTX 5090 and DGX Spark”입니다.
범용 엔진은 아닙니다. 하드웨어 두 종(RTX 5090, DGX Spark)과 모델 몇 개를 고르고, 그 조합만 C++/CUDA로 끝까지 깎아 낸 모델 전용(native) 추론 엔진입니다. CLI와 OpenAI·Anthropic 호환 HTTP 서버를 같이 주고, CUDA Graph decode, 추측 디코딩(MTP·DFlash·DFlash2), 공유 prefix 캐시, DGX Spark 두 대에 걸친 모델 병렬(TP2/EP2/ADP2)까지 들어 있습니다. 이 글은 실무자용이라 설치 안내보다 왜 이렇게 설계했는지에 무게를 둡니다. Engine 소유권 구조, Context 바이트 풀, ReplaySSM 커밋, MoE CPU expert offload, .ninfer v3 아티팩트와 변환 레시피, 공식 성능 기록을 읽는 법을 정리하고, GPU 없는 이 박스에서 실제로 돌려 본 것과 돌리지 못한 것도 그대로 적었습니다.
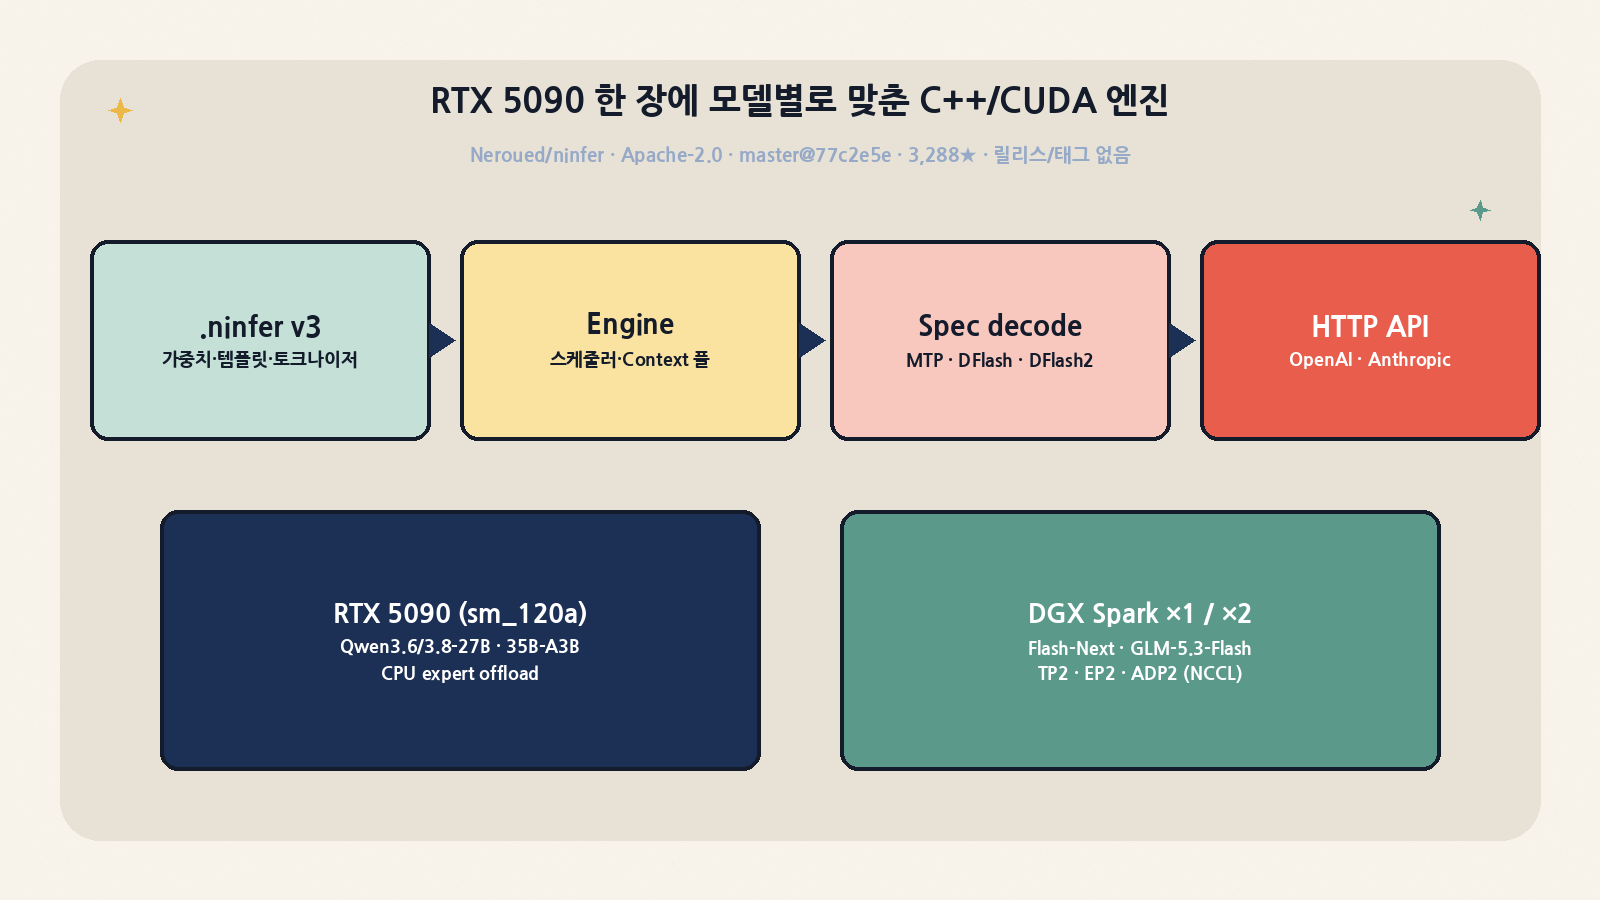
한눈에 보는 핵심 사실
| 항목 | 값 (이 글에서 확인) |
|---|---|
| 저장소 | Neroued/ninfer (2026-06-26 생성) |
| 버전 | 릴리스·태그 없음 → master@77c2e5e 기준으로 읽어야 함 |
| 라이선스 | 엔진 Apache-2.0. 모델 가중치는 따로: 27B·35B-A3B 원본 Apache-2.0, Flash Next는 Qwen Community License 1.0 + NVIDIA Open Model License, GLM 원본은 MIT |
| 스타 / forks / watchers | 3,288 / 691 / 25 (GitHub API, 2026-11-08 KST) |
| 언어 비중 (GitHub) | C++ 62.3% · CUDA 28.4% · Python 7.4% · CMake 0.7% |
| 대상 하드웨어 | RTX 5090 (x86-64, sm_120a) · DGX Spark (AArch64, sm_121a) 1대 또는 2대 |
| 제품 바이너리 | ninfer, ninfer-serve, ninfer-perplexity, 분산 빌드 시 ninfer-worker. 설치형 C++ SDK는 없음 |
| 동시성 | Engine 하나가 모델 하나를 서빙, 활성 요청은 최대 8개(실행 lane 1..8) |
| API | OpenAI Chat Completions · Responses Core · Anthropic Messages · Prometheus /metrics |
무엇을 풀려는가: “선택된 체크포인트 × 선택된 GPU”
vLLM이나 llama.cpp 같은 범용 엔진은 모델 아키텍처 수십 종과 여러 백엔드를 한 추상화로 묶습니다. NInfer는 반대로 갑니다. 문서는 “원생 모델은 자기 층 순서, 상태 수학, Op 조합을 그대로 유지한다”고 하고, “체크포인트 이름이나 양자화 recipe가 또 하나의 실행 아키텍처를 만들지 않는다”고 못 박습니다. 실행 경로는 아키텍처(Qwen3.5 Dense/MoE, Qwen4Exp, GLM5Next)별로 하나씩만 두고, 체크포인트 차이는 아티팩트 안의 설정·바인딩·인코딩으로만 표현합니다.
얻는 것은 분명합니다. GDN/KDA 같은 recurrent 상태를 가진 하이브리드 아키텍처, MTP 헤드, DFlash 계열 드래프트를 모델 수학 그대로 짤 수 있고, RTX 5090 한 장에서 27B 모델에 FP8 KV를 쓰고 요청당 컨텍스트 한도를 240,000토큰으로 잡는 예시 설정처럼, 메모리 계획을 하드웨어에 바짝 맞출 수 있습니다. 치르는 비용도 분명합니다. 지원 목록 밖의 모델이나 GPU는 아예 돌지 않습니다.
| 모델 | 아키텍처 | 배포 | 추측 디코딩 백엔드 |
|---|---|---|---|
| Qwen3.6-27B / Qwen3.8-27B | Qwen3.5 Dense | RTX 5090 | MTP. Qwen3.8-27B는 companion 가중치로 DFlash2 |
| Qwen3.6-35B-A3B | Qwen3.5 MoE | RTX 5090 (상주 또는 CPU expert offload) | MTP 또는 DFlash (companion 가중치) |
| Qwen3.8-Flash-Next | Qwen4Exp | RTX 5090 + CPU expert offload / Spark 1·2대 | MTP |
| GLM-5.3-Flash | GLM5Next | Spark 2대 | MTP |
README에 따르면 모든 행이 텍스트, Vision, 도구 호출, 제약 출력(constrained output), 오프라인 perplexity 채점을 지원합니다. 단 Vision과 추측 디코딩은 아티팩트에 해당 구성요소가 있어야 하고 시작할 때 켜야 합니다. 나중에 HTTP 요청으로는 켤 수 없습니다.
저장소 구조: 코드는 어디에 얼마나 있나
HEAD 77c2e5e를 얕게 클론해 확장자 기준(.cu/.cuh/.cpp/.h/.py/.ts)으로 줄 수를 셌습니다. 대략적인 규모를 보는 용도이고, 주석과 공백 줄도 포함된 숫자입니다.
| 디렉터리 | 역할 | 규모 (줄, 대략) |
|---|---|---|
src/ |
runtime(engine·executor·observability), models(qwen3_5·qwen4_exp·glm5next·common), ops, core, distributed, serve, media, text. .cu 파일 435개 |
~231,600 |
include/ninfer |
Op 계약 헤더 (sampling, moe, gdn_replay, kda_replay 등) | ~6,700 |
tests/ |
C++/CUDA 테스트 + Python(artifact, convert, bench, models) | ~106,100 |
tools/ |
convert(가중치 변환), artifact(검사·reader/writer), bench, smoke(서버 계약 검사) | ~26,400 |
bench/, eval/ |
Engine·Op 마이크로벤치, EvalScope 기반 능력 평가 | ~30,200 / ~3,400 |
dashboard/ |
NInfer Monitor (Vue + Node 수집기, Docker Compose, GPU 불필요) | ~2,700 |
third_party/ |
cpp-httplib, llama-jinja, nlohmann, spdlog, tomlplusplus, utf8proc, xgrammar | (벤더링) |
눈여겨볼 점이 하나 있습니다. 사용자 문서(docs/*.md)는 영어이고, 유지보수자 설계 문서(docs/maintainer/)는 중국어입니다. 엔진 내부를 손볼 생각이라면 중국어 설계 문서를 읽을 각오가 필요합니다. 그 대신 내용이 “누가 무엇을 소유하는가”라는 계약 중심으로 정리돼 있어서, 코드보다 먼저 읽을 가치가 큽니다. AGENTS.md와 .codex/도 있어 코딩 에이전트와 함께 개발하는 흔적이 보입니다.
아키텍처 ①: 소유권으로 나눈 Engine
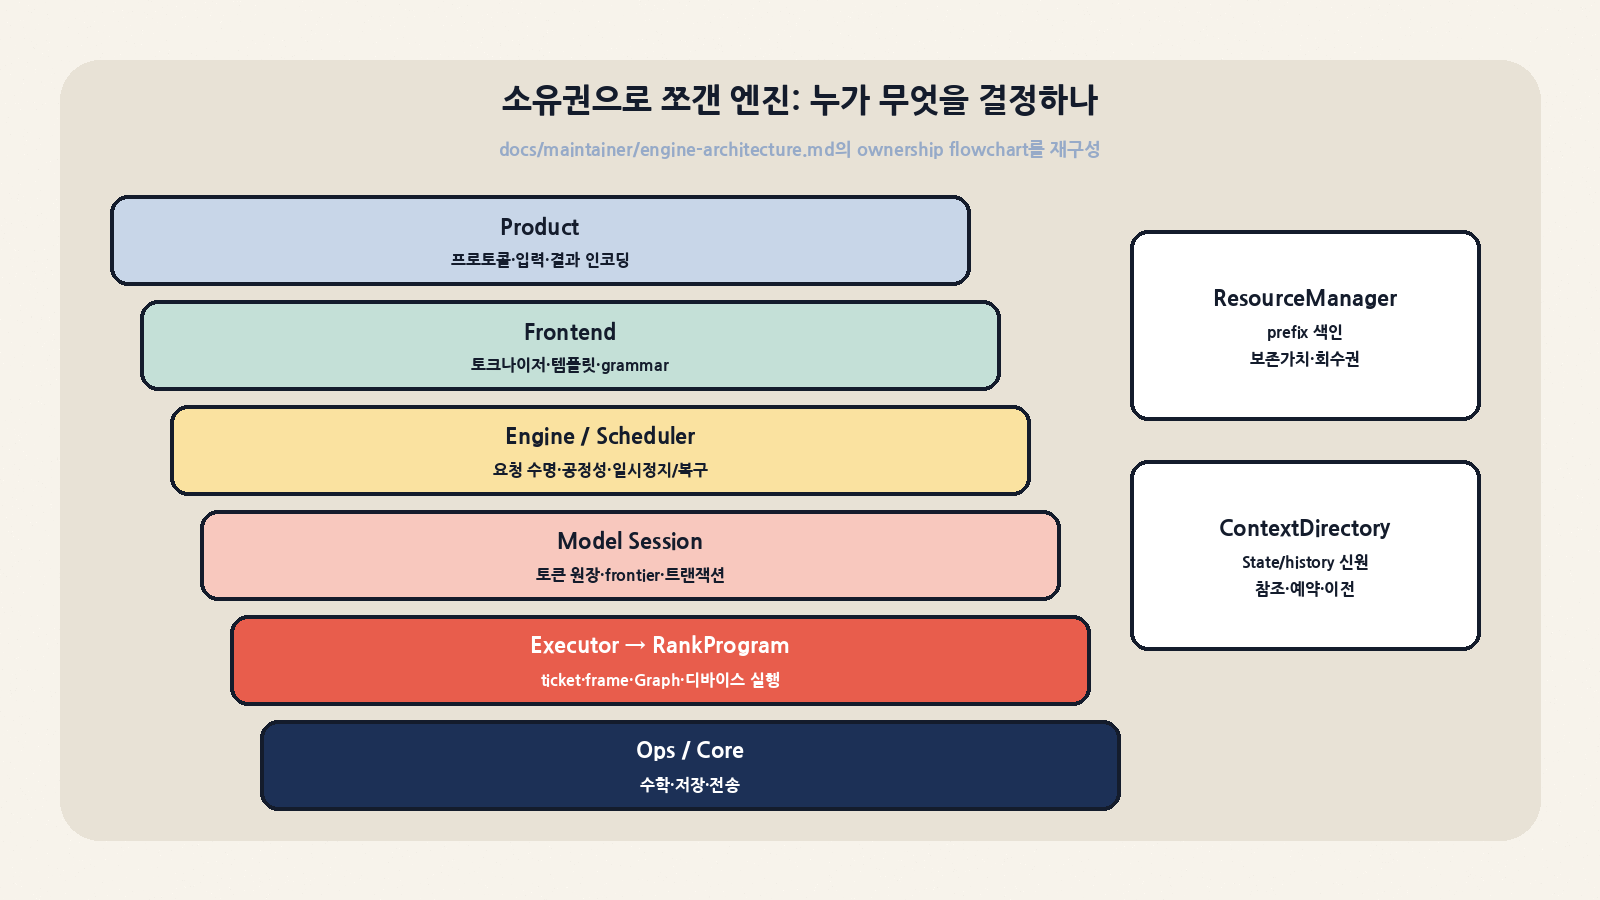
docs/maintainer/engine-architecture.md는 계층을 “누가 결정하고 누가 들고 있는가”로 나눕니다. CLI, Serve, 추론 벤치, PPL이 모두 같은 Engine 입구를 씁니다.
| 소유자 | 결정하고 보유하는 것 | 실무에서의 의미 |
|---|---|---|
| Frontend | 토크나이저, 템플릿, 미디어 준비, 입력 신원. 요청별 출력 파싱과 grammar 상태 | 도구 호출 파싱이나 제약 출력 문제는 여기부터 본다 |
| Engine / Scheduler | 요청 수명, 출력 예산, 공정성, 취소, 일시정지·복구 기회 | 429/503, 선점(preemption) 동작이 여기서 결정된다 |
| ResourceManager | 복구 소스, prefix 색인, 캐시 보존 가치, 회수 권한 | prefix 캐시 적중과 축출 정책 |
| Model Session | 토큰 원장, Main/backend frontier, checkpoint, 생성 트랜잭션 | 추측 디코딩 커밋의 정합성 |
| ContextDirectory | State/history/page 신원, 참조, 할당 예약, 이전 트랜잭션 | KV·State 메모리 회계 |
| Executor → RankProgram | frame 한도, ticket, 명령 순서 / backing, workspace, Graph, 디바이스 실행 | 단일 rank는 LocalExecutor, 다중 rank는 worker 프로세스 |
핵심 설계는 출력 발행 규칙입니다. 생성 결과는 먼저 provisional 상태로 나오고, Frontend가 EOS·정지·예산·취소에 맞는 실제 prefix를 확정합니다. 모델이 커밋을 받아들인 다음에야 Session이 원장을 갱신하고 OutputSession이 출력을 내보냅니다. 문서 표현으로는 “커밋 실패가 이미 대외 발행됐지만 모델 상태의 뒷받침이 없는 토큰을 남길 수 없다”입니다. 실행 사실도 Submitted → ResultReady → CommitReceipt → DeviceRetired 네 단계로 나눠, 논리적 채택과 비동기 디바이스 퇴역을 따로 셉니다. 스트리밍 중 취소나 선점이 많은 서비스에서 이 구분이 정확도를 지킵니다.
아키텍처 ②: Context 바이트 풀과 prefix 재사용
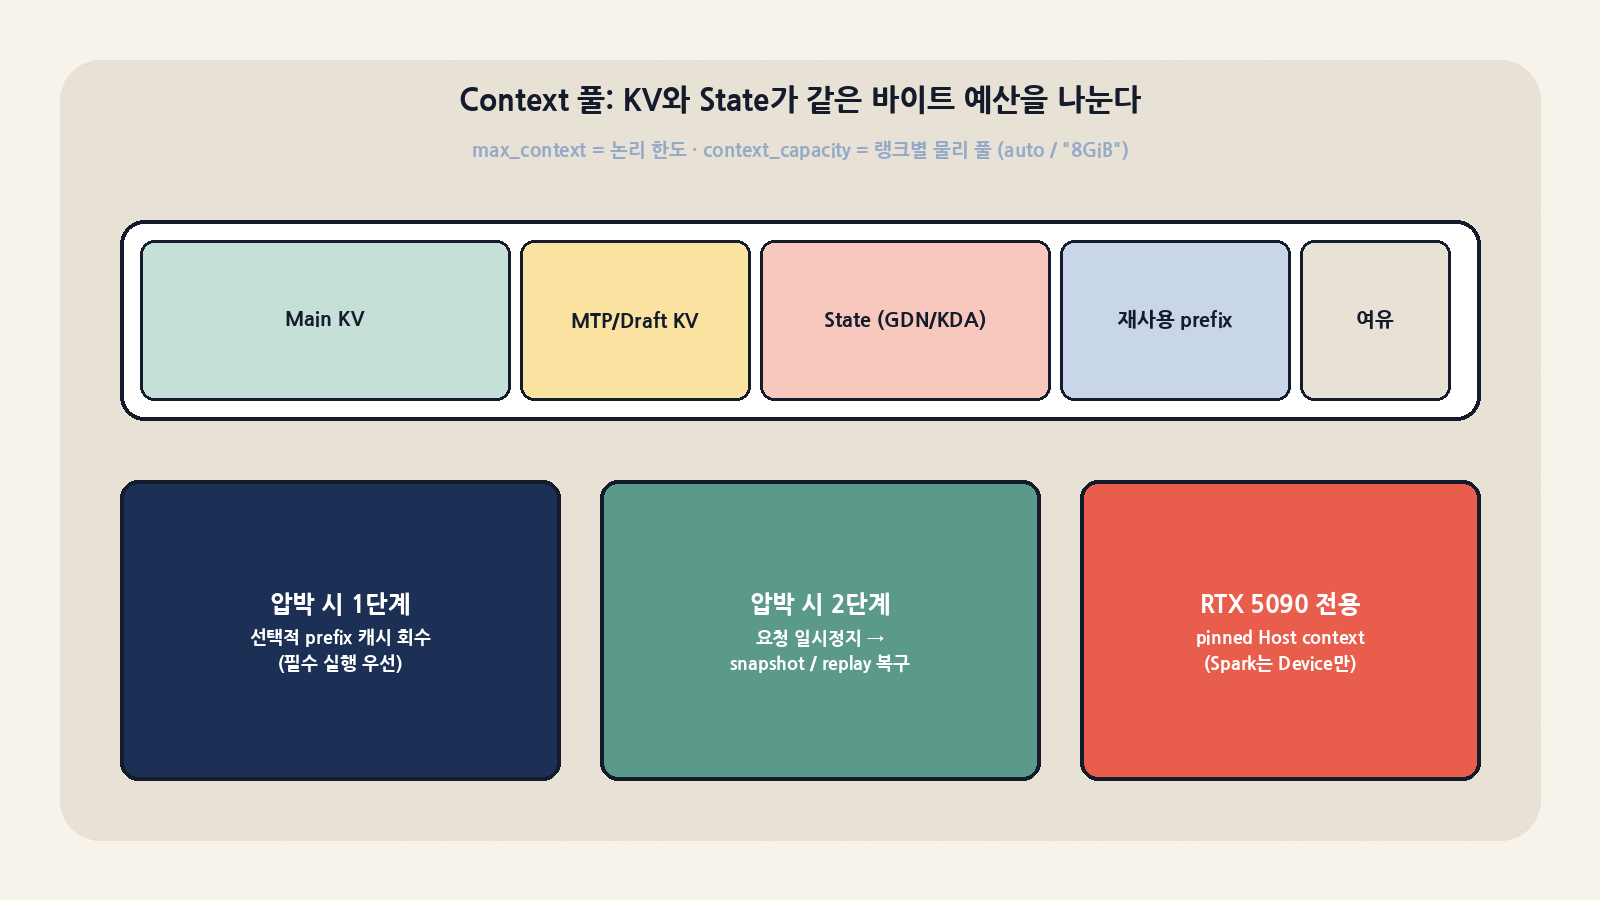
NInfer는 max_context(요청당 논리 한도)와 context_capacity(rank마다 시작 시 크기가 정해지는 물리 바이트 풀)를 분리합니다. 풀 하나를 커지는 KV history와 고정 길이 continuation State(GDN/KDA recurrent state 등)가 같이 쓰고, Main/MTP/Draft history에 고정 할당량을 두지 않습니다. 문서는 이 풀이 “동시성만큼 곱해지지 않으며, 논리 한도가 모든 활성 요청이 동시에 그 길이에 도달함을 보장하지 않는다”고 분명히 적습니다.
| TOML 필드 / 플래그 | 기본값 | 의미 |
|---|---|---|
engine.context_capacity / --context-capacity |
auto |
가중치·workspace·Graph·통신·Vision을 먼저 계획한 뒤 남는 예산으로 풀 크기 결정. "8GiB"처럼 명시 가능 |
memory_headroom / --memory-headroom |
예시 설정 256MiB | 계획상 여유. 시작 중 소비될 수 있으며, 초기화 후 반드시 비어 있어야 하는 양은 아님 |
context_cache.prefix_reuse |
CLI false / Serve true | 요청 간 prefix 조회·보존 |
context_cache.checkpoint_interval |
8192 | 중간 prefill checkpoint 목표 간격 |
context_cache.host_capacity |
default | RTX 5090 전용 pinned Host context 예산. Spark는 0이어야 함 |
vision.memory_budget / media.cache_capacity / media.live_capacity |
1GiB / 1GiB / 2GiB | Vision 인코더 활성 메모리 / 준비된 미디어 캐시 / 살아 있는 패치 페이로드 전체 |
메모리 압박이 오면 순서가 정해져 있습니다. 먼저 선택적 캐시(보존된 prefix)를 회수하고, 그래도 모자라면 활성 요청을 일시정지했다가 snapshot 또는 replay로 복구합니다. Replay는 재샘플링하거나 이미 낸 토큰을 다시 내보내지 않지만 연산은 다시 들고, 그만큼 출력 스트림에 공백이 생길 수 있습니다. prefix 재사용은 토큰만 같다고 되지 않습니다. KV, recurrent state, hidden state, 선택된 backend 상태, 정확한 prefix 신원이 모두 맞아야 하고, 멀티모달은 미디어 digest·레이아웃까지 일치해야 합니다. OpenAI 호환 prompt_cache_options와 prompt_cache_breakpoint는 최적화 힌트일 뿐입니다. 요청당 write 후보는 최대 4개이고, TTL 값은 받아들이지만 실제 체류 시간은 약속하지 않습니다.
아키텍처 ③: 추측 디코딩과 ReplaySSM
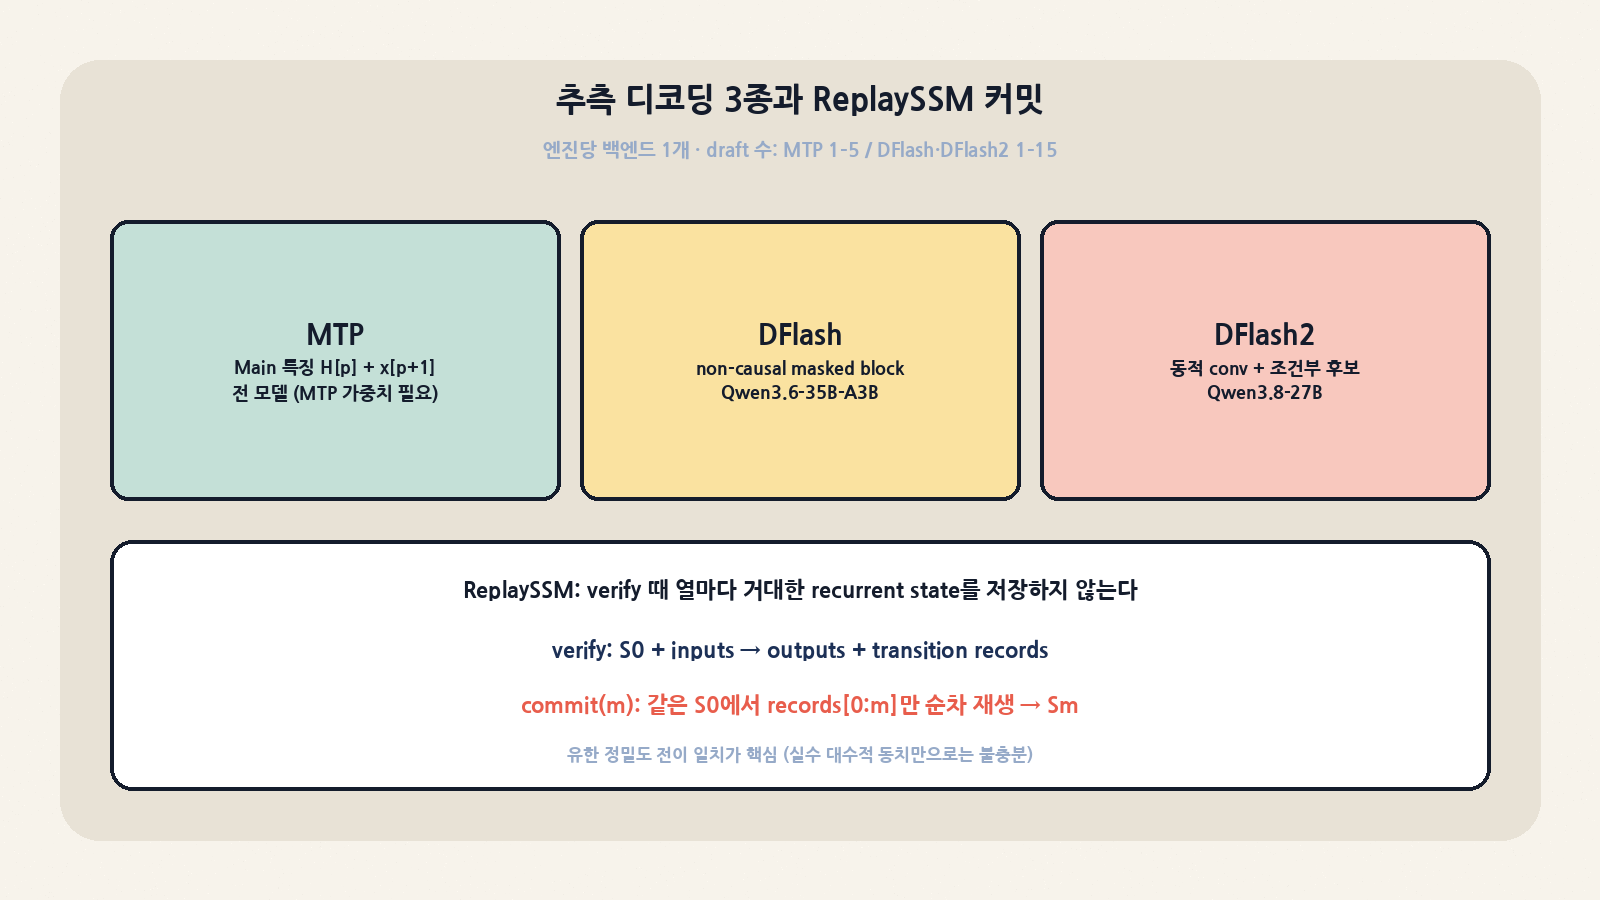
| 백엔드 | 대상 모델 | draft 토큰 | 작동 방식 (설계 문서 요약) |
|---|---|---|---|
mtp |
MTP 가중치가 있는 모든 지원 모델 | 1..5 | MTP ordinal p가 Main 특징 H[p]와 토큰 x[p+1]을 짝짓는다. 첫 단계는 실제 conditioning을 쓰고, 이후는 예측층 자체 hidden을 쓴다 |
dflash |
Qwen3.6-35B-A3B (companion) | 1..15 | anchor + masked columns를 non-causal masked-block attention으로 한 번에 제안. proposal은 one-hot |
dflash2 |
Qwen3.8-27B (companion) | 1..15 | 동적 컨볼루션 + 조건부 후보 선택을 더하고, 실제 조건부 분포 q를 유지 |
--proposal-head optimized |
아티팩트에 있을 때 | – | Qwen3.5 계열은 선택된 어휘(기본 131,072행 shortlist), Flash Next·GLM은 별도의 전체 어휘 Q4 A16 헤드 |
가장 흥미로운 결정은 ReplaySSM입니다. GDN/KDA 같은 선형 attention 계열은 recurrent state가 커서, 짧은 verify 창에서 열마다 전체 state를 저장하면 용량과 쓰기 트래픽이 크게 늘어납니다. 그래서 원래 checkpoint 하나와 상태 전이를 일으킨 compact record만 저장했다가, 채택된 prefix만큼만 같은 S0에서 다시 재생합니다(commit(m): records[0:m] → Sm). 문서는 “실수 영역에서 대수적으로 동치인 것”이 아니라 유한 정밀도에서 전이가 일치하는 것이 중요하다고 강조합니다. fold가 평가 순서를 바꾸면 작은 state 차이가 다음 라운드로 넘어가므로, “지금 출력이 정상으로 보인다”는 것으로 정확성을 증명할 수 없다는 경고도 붙어 있습니다. 하이브리드 SSM 모델에 추측 디코딩을 붙이는 팀이라면 이 부분만 따로 읽어도 얻을 게 있습니다.
운영 쪽에서 볼 점도 있습니다. 엔진 하나에는 백엔드를 하나만 켤 수 있고, draft 수는 워크로드에 따라 고르는 값입니다(CLI 문서: “더 많이 제안하면 연산이 늘고, 충분히 채택될 때만 도움이 된다”). Vision 인코딩과 prefill은 eager로 남고, 추측 디코딩은 생성 텍스트 decode만 가속합니다.
아키텍처 ④: MoE CPU expert offload
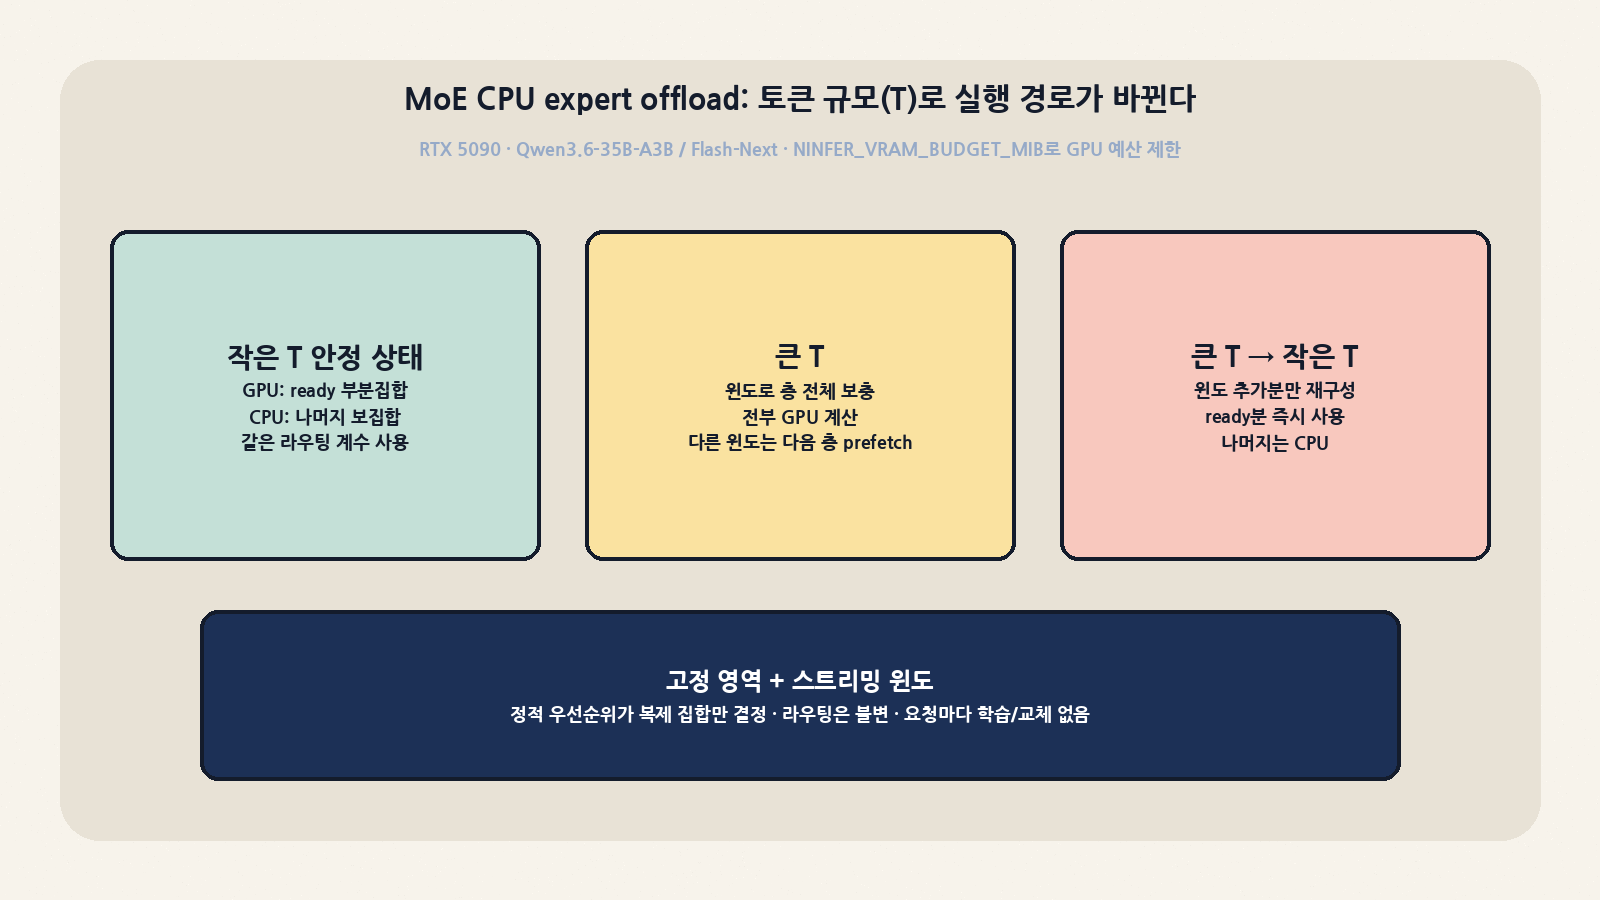
RTX 5090에서 Qwen3.6-35B-A3B와 Flash Next는 Main expert를 Host 메모리에 두고, 일부를 GPU에 캐시하고, 큰 토큰 배치에서는 가중치를 스트리밍할 수 있습니다. CPU와 GPU가 같은 전역 라우팅과 원래 계수를 쓰고, 부분집합으로 나눠도 다시 정규화하지 않는 것이 정확성의 핵심입니다. CPU 쪽은 FP32 부분합을 내고, GPU 결과와 최종 반올림 계약에 맞춰 합칩니다.
실행 경로는 실제 토큰 수(T)로 갈립니다. 작은 T의 안정 상태에서는 GPU가 ready된 부분집합을, CPU가 나머지를 계산하고 상주 스냅샷을 재사용합니다. 큰 T에서는 현재 윈도로 층 전체 expert를 채워 전부 GPU에서 계산하고, 다른 윈도로 다음 층을 prefetch합니다. 큰 T에서 작은 T로 돌아올 때는 윈도 추가 집합만 다시 만들고, ready된 부분은 바로 쓰고 나머지는 CPU가 계산합니다. Prefill, Decode, Verify, Control이 모두 같은 메커니즘을 씁니다.
고정 영역과 스트리밍 윈도는 용량을 함께 계획합니다. 정적 우선순위는 어떤 expert를 복제할지만 정하고 라우팅은 바꾸지 않습니다. 설계 문서는 “현재 메커니즘은 요청마다 학습해 expert 집합을 동적으로 교체하지 않는다”고 명시합니다. GPU 예산은 NINFER_VRAM_BUDGET_MIB로 제한할 수 있습니다(예시: 16384). Flash Next는 이 경로에서 Host Main-expert backing이 약 63.3 GiB 필요하고, 그 밖의 런타임·시스템 메모리가 추가로 듭니다. NF4 PLE 행은 디스크의 아티팩트에서 직접 읽습니다. 이 블로그에서 다뤘던 디스크 스트리밍형 MoE 엔진들과 달리, NInfer는 특정 GPU 한 종과 특정 모델에 맞춰 GPU 캐시와 CPU 연산을 겹쳐 쓰는 쪽입니다.
아티팩트와 변환: .ninfer v3와 Python recipe
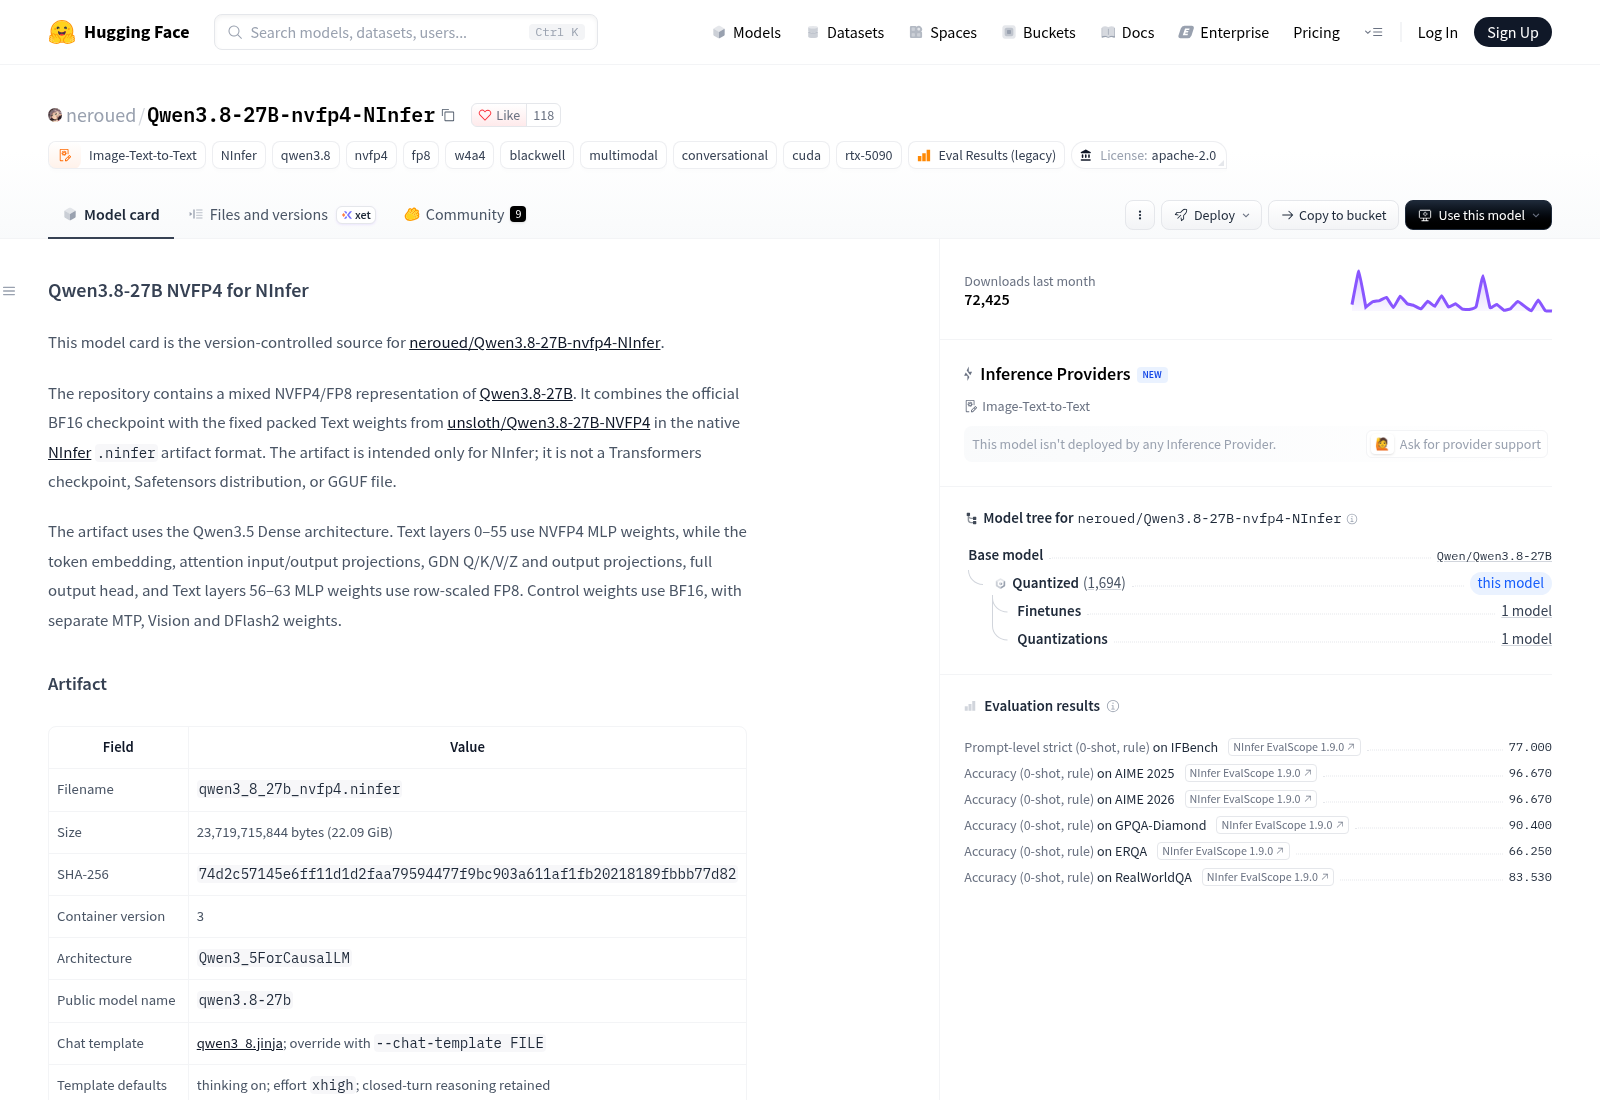
Engine은 가중치, 설정, 토크나이저, chat template, 구성요소 리소스를 담은 v3 .ninfer 아티팩트만 읽습니다. 저자가 Hugging Face에 공식 아티팩트를 올려 두었고, 직접 만들려면 tools/convert로 변환합니다. 원본 가중치 변환에는 Python 3.11, PyTorch, NumPy가 필요하고 기본은 CUDA이며, --device cpu로 CPU 변환도 할 수 있습니다.
| Recipe | 주요 표현 선택 | 추가 소스 |
|---|---|---|
qwen3_6_27b |
Q4/Q5 projection, Q6 vocabulary | 없음 |
qwen3_8_27b |
Q4/Q5 projection, Q8 vocabulary | 없음 |
qwen3_6_35b_a3b |
Q4 experts, Q5/Q6 expert down, Q8 shared/projection | 없음 |
qwen3_8_27b_nvfp4 |
NVFP4/FP8 import, BF16에서 만든 FP8 embedding | quantized |
qwen3_8_flash_next |
Q8 main projection, NVIDIA NVFP4 experts, block-FP8 MTP experts, NF4 PLE | nvidia |
glm5next |
NVFP4 Main experts/dense MLP, Q8 KDA·MLA output, block-FP8 MTP | NVIDIA 체크포인트가 1차 소스 |
포맷 쪽에서 실무자가 알아 둘 점이 있습니다. import_encoded는 이미 인코딩된 NVFP4/FP8 코드와 scale 워드를 역양자화·재양자화 없이 보존합니다. stored_scale_mse(NVFP4, NF4)는 활성값 캘리브레이션을 하지 않습니다. 활성 정밀도 정책(A16Only/AllowA8/AllowA4)은 허용 범위일 뿐 강제가 아니고, 여러 projection이 활성값 하나를 공유하는 fused 연산은 허용 범위의 교집합을 따릅니다. 문서는 “소스 포맷 이름만으로 호환성이 성립하지 않는다. scale 방향, 단위, 코드 의미, 축 순서가 맞아야 한다”고 경고합니다. 공식 Qwen3.8-27B NVFP4 아티팩트 하나는 23,719,715,844바이트(22.09 GiB)입니다(HF 모델 카드). Flash Next는 파일 4개에 101.00 GiB, GLM은 파일 6개에 178.33 GiB입니다.
설치·실행·서빙: README 명령 그대로
의존성은 대상 아키텍처를 지원하는 CUDA 툴킷(개발 기준 CUDA 13.4), CMake 3.28+, C++20 컴파일러, Ninja, pkg-config, libjpeg, FFmpeg 개발 라이브러리, hwloc >= 2.5, liburing >= 2.5, libcurl >= 7.85입니다. 동봉된 Dockerfile의 빌드 베이스 이미지는 nvidia/cuda:13.1.2-devel-ubuntu24.04이고, RTX 5090용 CLI와 서버를 만듭니다.
git clone https://github.com/Neroued/ninfer.git
cd ninfer
cmake --preset rtx5090-release
cmake --build build/rtx5090-release -j

# 가중치 (예: Qwen3.8-27B NVFP4)
hf download neroued/Qwen3.8-27B-nvfp4-NInfer \
  qwen3_8_27b_nvfp4.ninfer --local-dir models

# 단발 실행
./build/rtx5090-release/apps/ninfer models/qwen3_8_27b_nvfp4.ninfer \
  --prompt "Explain prefill and decode briefly." \
  --max-context 8192 --max-tokens 1024 --kv-dtype fp8

# 서빙
cp examples/configs/rtx5090-qwen3_8-27b-nvfp4.toml ninfer.local.toml
./build/rtx5090-release/apps/ninfer-serve --config ninfer.local.toml
예시 TOML(rtx5090-qwen3_8-27b-nvfp4.toml)은 Vision, FP8 KV, MTP3, optimized draft head를 켜고, max_context = 240000, max_concurrency = 2, prefill_chunk = 1024, cuda_graph = true, server.host = "127.0.0.1"로 설정합니다. 서버는 기본적으로 loopback에만 붙고, LAN에 열려면 0.0.0.0과 server.api_key를 같이 설정하라고 README가 안내합니다. 명령줄 값이 --config 파일보다 우선합니다.
| 엔드포인트 | 동작 |
|---|---|
GET /health, GET /metrics |
Engine 준비 상태 / Prometheus 텍스트 0.0.4 (선점·replay·Context 풀 바이트·spec 채택 수 포함) |
GET /v1/models |
설정된 alias와 실제 max_model_len |
POST /v1/chat/completions |
OpenAI 스타일 생성 (도구, 구조화 출력, 스트리밍) |
POST /v1/responses 외 |
Responses Core: 로컬 상태 저장, typed Items, SSE, 입력 토큰 수 |
POST /v1/messages, /count_tokens |
Anthropic 스타일 생성, 체크포인트 기준 입력 토큰 수 |
운영할 때 알아 둘 동작이 몇 가지 있습니다. 생성 요청의 전체 수용량은 max_concurrency + max_pending_requests이고, 이를 넘으면 HTTP 429 server_overloaded, 입장 마감(--pending-timeout)을 넘기면 503 request_queue_timeout을 돌려줍니다. 입장 ETA나 무제한 overflow 큐는 없습니다. 함수 도구는 프롬프트에 렌더링되고 생성된 호출을 파싱해 응답으로 돌려줄 뿐, NInfer가 도구를 실행하지는 않습니다. GLM은 low/high/max reasoning effort를 지원하고 thinking을 끌 수 없습니다.
분산: DGX Spark 두 대
코디네이터 노드에서 CLI나 Serve를 한 번 띄우면 로컬 worker는 posix_spawn으로, 원격 worker는 비대화형 SSH로 띄웁니다. 제어 연결은 따로 있고 GPU 데이터는 NCCL로 오갑니다. 두 노드 모두 -DNINFER_ENABLE_DISTRIBUTED=ON으로 같은 빌드를 해야 하고, 아티팩트 전체 세트를 노드마다 둬야 합니다(rank별 슬라이싱은 로딩 때 일어남). --tp/--ep 같은 명령줄 별칭은 없고 TOML로만 설정합니다.
현재 지원되는 dual-Spark 배치는 두 가지입니다. Flash Next는 TP2에 EP 1 또는 2, ADP 1입니다. ep=1이면 rank마다 모든 expert의 TP shard를 들고, ep=2면 rank가 서로 다른 expert 전체를 소유합니다. GLM5Next는 TP2에 EP 1 또는 2, ADP 2입니다. 여기서 attention DP는 독립 복제본이 아니라, 같은 실행 그룹 안에서 요청별 MLA history 소유자를 고르는 방식입니다. NCCL 네트워크와 HCA 선택은 노드별 environment 항목으로 지정합니다.
DP와 PP는 설정 필드는 있지만 현재 모델들은 1이어야 합니다. 문서 표현으로는 “설정이 어떤 병렬도를 표현할 수 있다고 해서 특정 모델이 그것을 지원한다는 뜻은 아니다”입니다.
성능과 평가: 공식 기록을 읽는 법
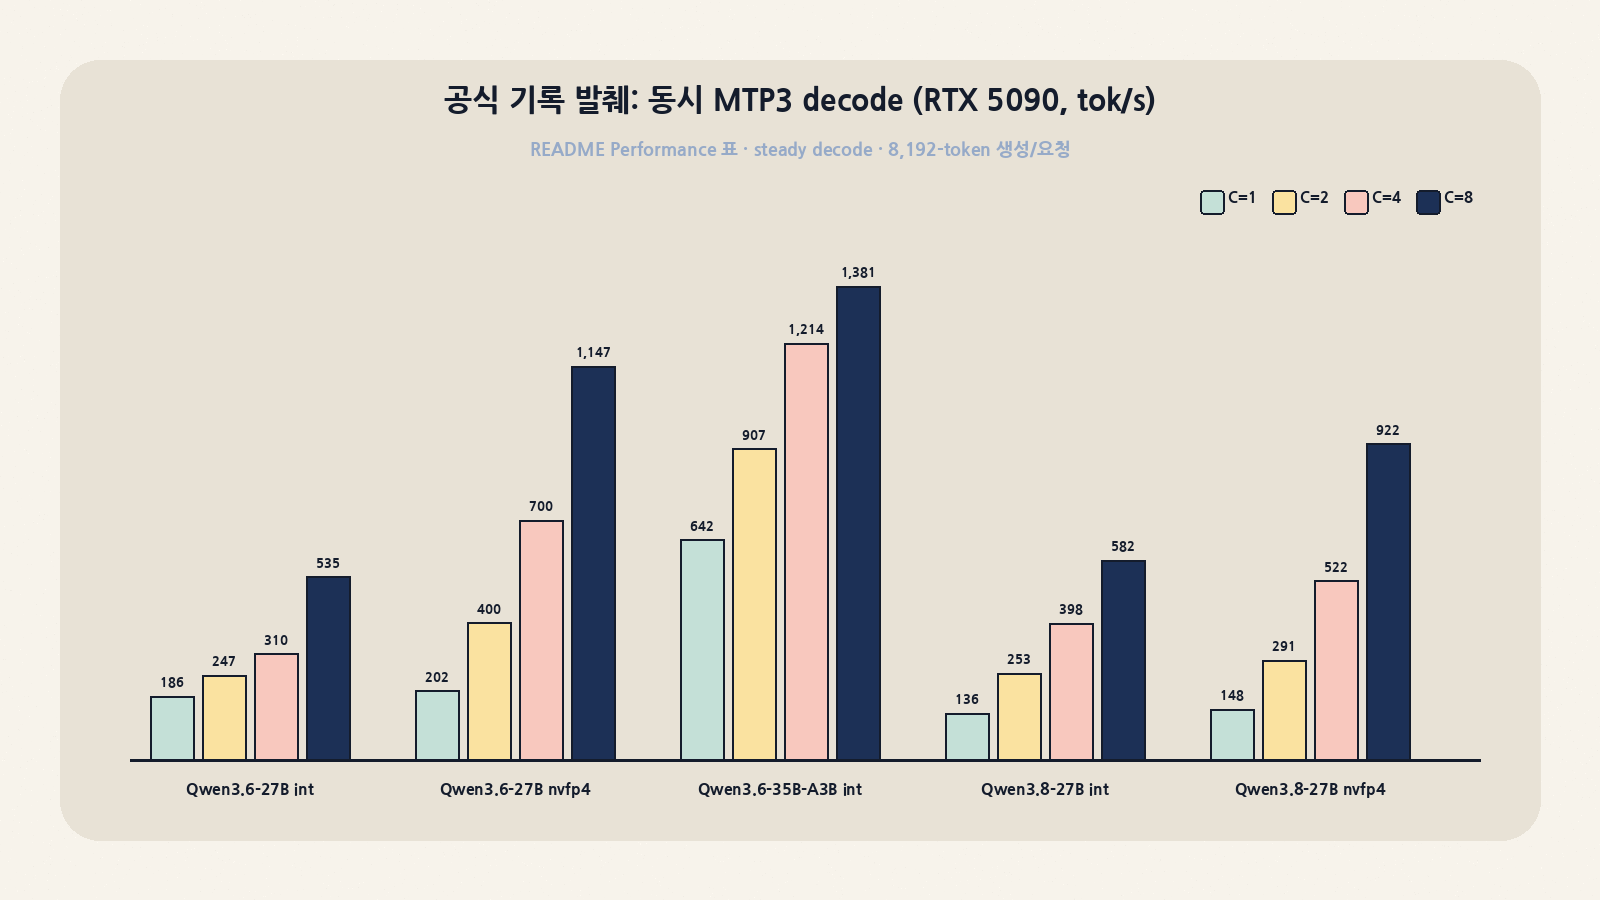
아래 숫자는 모두 저장소가 공개한 RTX 5090 한 장 측정 기록의 발췌이고, 이 글에서 재현한 값이 아닙니다. Qwen3.8 측정은 FP8 E4M3 row-256 KV, Qwen3.6 측정은 INT8 group-64 KV를 썼습니다. 현재의 Spark나 분산 경로를 측정한 값도 아닙니다.
| 모델 프로필 | C=1 tok/s / 채택률 | C=2 | C=4 | C=8 |
|---|---|---|---|---|
| Qwen3.6-27B groupwise-int | 185.8 / 68.2% | 247.0 / 69.0% | 309.5 / 68.4% | 535.0 / 68.3% |
| Qwen3.6-27B nvfp4 | 202.4 / 69.3% | 399.7 / 71.4% | 699.7 / 69.3% | 1,146.9 / 68.6% |
| Qwen3.6-35B-A3B groupwise-int | 642.5 / 68.6% | 907.2 / 66.3% | 1,213.5 / 69.6% | 1,380.7 / 68.0% |
| Qwen3.8-27B groupwise-int | 136.5 / 44.4% | 253.3 / 45.2% | 398.1 / 46.1% | 582.4 / 46.4% |
| Qwen3.8-27B nvfp4 | 147.7 / 46.2% | 291.0 / 48.7% | 522.2 / 45.8% | 922.4 / 46.1% |
(동시 MTP3 decode, CUDA Graph, 요청당 8,192토큰 생성, 실제 decode 배치가 설정 동시성과 같았던 완전한 구간의 steady decode)
| 단일 요청 서빙 | 7,680토큰 prefill | 260,096토큰 prefill | 구조화 출력 MTP3 decode |
|---|---|---|---|
| Qwen3.6-35B-A3B groupwise-int | 17,705.4 tok/s | 5,247.0 tok/s | 779.6 tok/s |
| Qwen3.6-27B groupwise-int | 3,218.1 | 1,614.8 | 193.0 |
| Qwen3.6-27B nvfp4 | 11,191.5 | 2,510.6 | 252.2 |
| Qwen3.8-27B groupwise-int | 3,331.9 | 2,139.4 | 214.7 |
| Qwen3.8-27B nvfp4 | 12,819.1 | 4,016.4 | 231.7 |
읽을 때 주의할 점도 문서에 있습니다. 지표마다 시간 경계가 다릅니다(Prefill phase·Server TTFT·Decode phase vs Corpus makespan vs Steady decode). Server TTFT는 내부 phase 합이고 외부 스트리밍 TTFT와는 다릅니다. 확률적 실행은 같은 프롬프트와 시드라도 생성 토큰 총량이 달라질 수 있고, “처리량만으로 과제 완수가 증명되지 않는다”고 적혀 있습니다. Flash Next, GLM, Spark 배포에 대해서는 이번 캠페인의 성능 결과 페이지가 없습니다.
| 능력 평가 (EvalScope 1.9.0, 0-shot, thinking, MTP3, 문제당 1샘플) | AIME 2025 | AIME 2026 | GPQA-Diamond | ERQA | RealWorldQA |
|---|---|---|---|---|---|
| Qwen3.6-27B groupwise-int | 86.67% | 93.33% | 86.87% | — | — |
| Qwen3.6-27B NVFP4 | 93.33% | 93.33% | 84.34% | — | — |
| Qwen3.6-35B-A3B groupwise-int | 90.00% | 90.00% | 85.35% | — | — |
| Qwen3.8-27B groupwise-int | 96.67% | 96.67% | 87.37% | 66.25% | 82.22% |
| Qwen3.8-27B NVFP4 | 96.67% | 96.67% | 90.40% | 66.25% | 83.53% |
이 점수는 양자화된 아티팩트를 NInfer로 서빙했을 때 품질이 크게 무너지지 않았는지 확인하는 신호로 읽는 게 맞습니다. 모델 간 우열을 가리는 리더보드로 쓰기에는 문제당 1샘플이라는 한계가 있습니다. 별도로 Flash Next를 Spark 두 대(TP2/EP2, BF16 KV)에서 EvalScope 1.10.0으로 평가한 기록은 GPQA-Diamond 91.79%(727/792, 문항당 4회), AIME 2026 97.78%(88/90, 3회), MMMU-Pro 80.81%(1,398/1,730)이며, README는 이것이 pass@k가 아닌 평균 샘플 정확도라고 밝힙니다.
비슷한 도구와 비교
아래 표의 NInfer 열은 저장소 문서 기준입니다. 다른 엔진 열은 각 프로젝트가 일반적으로 내세우는 성격을 정리한 것이고, 성능 우열을 판정하지 않습니다(같은 조건에서 비교한 공식 수치가 없습니다).
| 관점 | NInfer | llama.cpp | vLLM / SGLang | TensorRT-LLM |
|---|---|---|---|---|
| 범위 | 선택된 모델 4계열 × RTX 5090·DGX Spark | 매우 넓은 모델·CPU/GPU 백엔드 | 넓은 모델 지원, 데이터센터 GPU 중심 | NVIDIA GPU 전반, 다양한 모델 |
| 구현 | 네이티브 C++/CUDA, 모델별 수학 직접 구성 | C/C++ (ggml) | Python/PyTorch 기반 + 커스텀 커널 | NVIDIA 최적화 커널·런타임 |
| 가중치 포맷 | 전용 .ninfer v3 (GGUF/Safetensors 아님) |
GGUF | 주로 HF Safetensors | 체크포인트 변환/엔진 빌드 |
| 동시성 목표 | Engine당 활성 요청 1..8 | 로컬·소규모 서빙 | 대규모 배치 서빙 | 대규모 배치 서빙 |
| 추측 디코딩 | MTP / DFlash / DFlash2, ReplaySSM 커밋 | draft 모델 방식 등 | 여러 방식 지원 | 여러 방식 지원 |
| API | OpenAI Chat·Responses + Anthropic Messages | OpenAI 호환 서버 | OpenAI 호환 서버 | 별도 서빙 계층과 조합 |
| 릴리스 관리 | 태그·릴리스 없음 (커밋 고정 필요) | 빈번한 빌드 태그 | 정기 릴리스 | 정기 릴리스 |
박스 실측: GPU 없이 확인한 것과 못 한 것
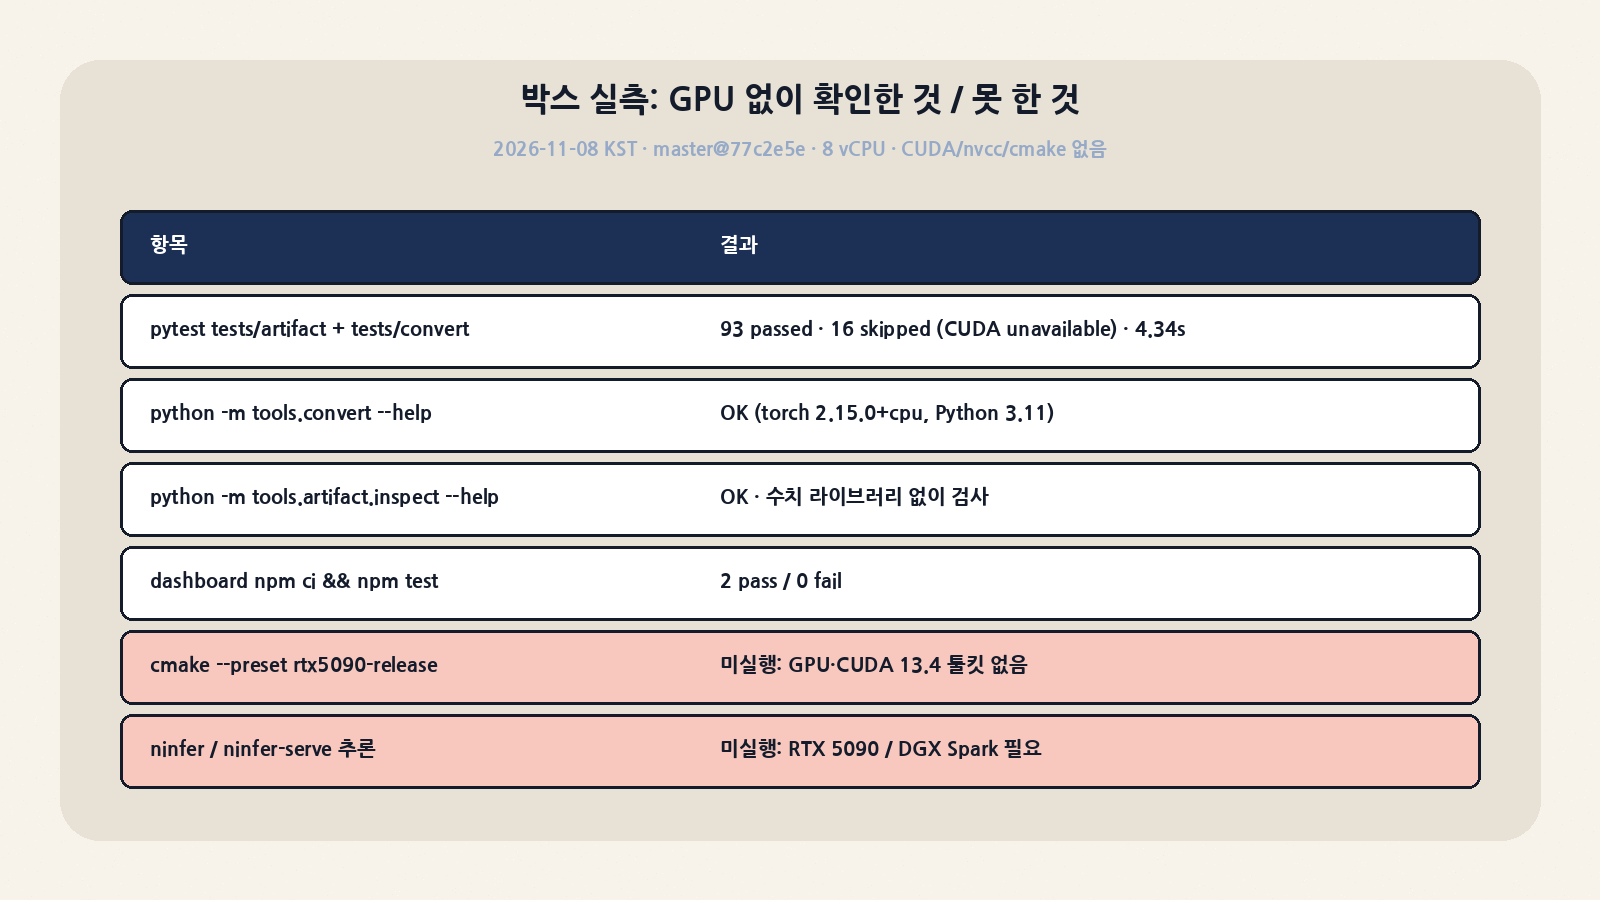
이 박스는 8 vCPU, 메모리 약 15GB이고 NVIDIA GPU, nvcc, cmake가 없습니다. 그래서 엔진 빌드와 추론은 돌리지 못했습니다. 대신 GPU 없이 검증할 수 있는 아티팩트·변환 도구 계층과 대시보드를 HEAD 77c2e5e에서 직접 실행했습니다(2026-11-08 KST).
| 실행한 것 | 결과 |
|---|---|
uv venv -p 3.11 + numpy, pytest, safetensors, torch 2.15.0+cpu |
설치 성공 |
pytest tests/artifact tests/convert |
93 passed, 16 skipped (4.34s). skip 사유는 모두 “CUDA unavailable”(fp8_block, fp8_row, groupwise, stored_scale 양자화 GPU 경로) |
python -m tools.convert --help |
정상. --model/--recipe/--source/--components/--proposal/--device 등 옵션 확인 |
python -m tools.artifact.inspect --help |
정상. “수치 라이브러리 없이” 설정·객체·바인딩·파일을 검사하는 도구 |
dashboard: npm ci && npm test (Node 20.19.2) |
tests 2 / pass 2 / fail 0 |
| 미실행 | cmake --preset rtx5090-release, ninfer/ninfer-serve, 공식 아티팩트 다운로드(22–178 GiB). 성능 수치는 재현하지 않음 |
CPU 단위 테스트가 통과했다는 것은 아티팩트 컨테이너, 코덱(NVFP4, NF4, FP8 row), expert bank 레이아웃, 변환 recipe·소스 해석이 CPU에서 의도대로 돈다는 뜻입니다. 커널 성능이나 실제 생성 품질에 대해서는 아무것도 말해 주지 않습니다. 직접 변환 recipe를 짜려는 팀이라면 GPU가 없는 CI에서도 이 테스트 묶음을 회귀 테스트로 돌릴 수 있다는 점이 쓸모 있습니다.
한계와 주의할 점
| 항목 | 내용 | 대응 |
|---|---|---|
| 하드웨어 고정 | RTX 5090(sm_120a)·DGX Spark(sm_121a)용 프리셋만 있음 |
H100/4090 등은 지원 대상이 아님. 쓰려면 직접 포팅해야 함 |
| 모델 고정 | 4계열 외 체크포인트는 실행 경로가 없음 | 모델 교체가 잦은 조직에는 맞지 않음 |
| 버전 관리 | 릴리스·태그 0개, 하루에도 여러 커밋 | 커밋 SHA를 고정하고 아티팩트 버전(v2→v3 업그레이드 도구 있음)을 함께 관리 |
| 라이선스 이원화 | 엔진 Apache-2.0과 가중치 라이선스가 따로 감(Qwen Community, NVIDIA Open Model, MIT 등) | 상용 배포 전 모델 카드별로 검토 |
| 문서 언어 | 사용자 문서는 영어, 유지보수 설계 문서는 중국어 | 내부 수정 시 번역 비용을 감안 |
| 동시성 상한 | Engine당 활성 요청 최대 8개 | 대규모 멀티테넌트는 범용 서빙 엔진이 맞음 |
| 보안 기본값 | loopback 기본, LAN 노출 시 api_key 권장. 도구는 실행하지 않음 |
리버스 프록시·인증을 앞에 둘 것 |
| 성능 수치 범위 | 공식 기록은 RTX 5090 한 장 한정. Flash Next·GLM·Spark 결과 페이지 없음 | 도입 전 자체 워크로드로 측정 |
누가 도입을 검토할 만한가
| 상황 | 판단 |
|---|---|
| RTX 5090 워크스테이션 한 대에서 Qwen 27B/35B-A3B를 긴 컨텍스트·소수 동시성으로 서빙 | 가장 잘 맞는 대상. MTP3 + FP8 KV 예시 설정부터 시작 |
| DGX Spark 두 대로 Flash Next·GLM-5.3-Flash 같은 대형 MoE를 사내 API로 | 검토할 만함. 다만 공개 성능 페이지가 없으니 직접 측정 필요 |
| 하이브리드 SSM·MTP·DFlash 계열 추측 디코딩 구현을 연구 | 코드와 설계 문서(ReplaySSM, MTP frontier)가 좋은 레퍼런스 |
| 다양한 오픈 모델을 빠르게 갈아 끼우는 서비스 | 부적합. llama.cpp, vLLM, SGLang 계열이 맞음 |
| 데이터센터 GPU에서 대규모 배치 처리량이 목표 | 부적합. 대상 하드웨어와 동시성 설계가 다름 |
정리하면 NInfer는 “어떤 모델이든 돌리는 엔진”이 아니라 “이 GPU에서 이 모델을 끝까지 깎는 엔진”입니다. 범용성을 포기한 대가로 Context 풀 회계, 커밋 트랜잭션, ReplaySSM, expert offload 같은 설계를 모델 수학에 바로 맞출 수 있었습니다. RTX 5090이나 DGX Spark를 이미 갖고 있고 지원 모델이 필요에 맞는다면 커밋을 고정해 시험해 볼 가치가 충분합니다. 그렇지 않다면 설계 문서를 읽는 것만으로도 추론 엔진을 보는 눈을 넓힐 수 있습니다.