테크부터 경제, 생활까지. 복잡한 소식을 쉽게 풀어봅니다.
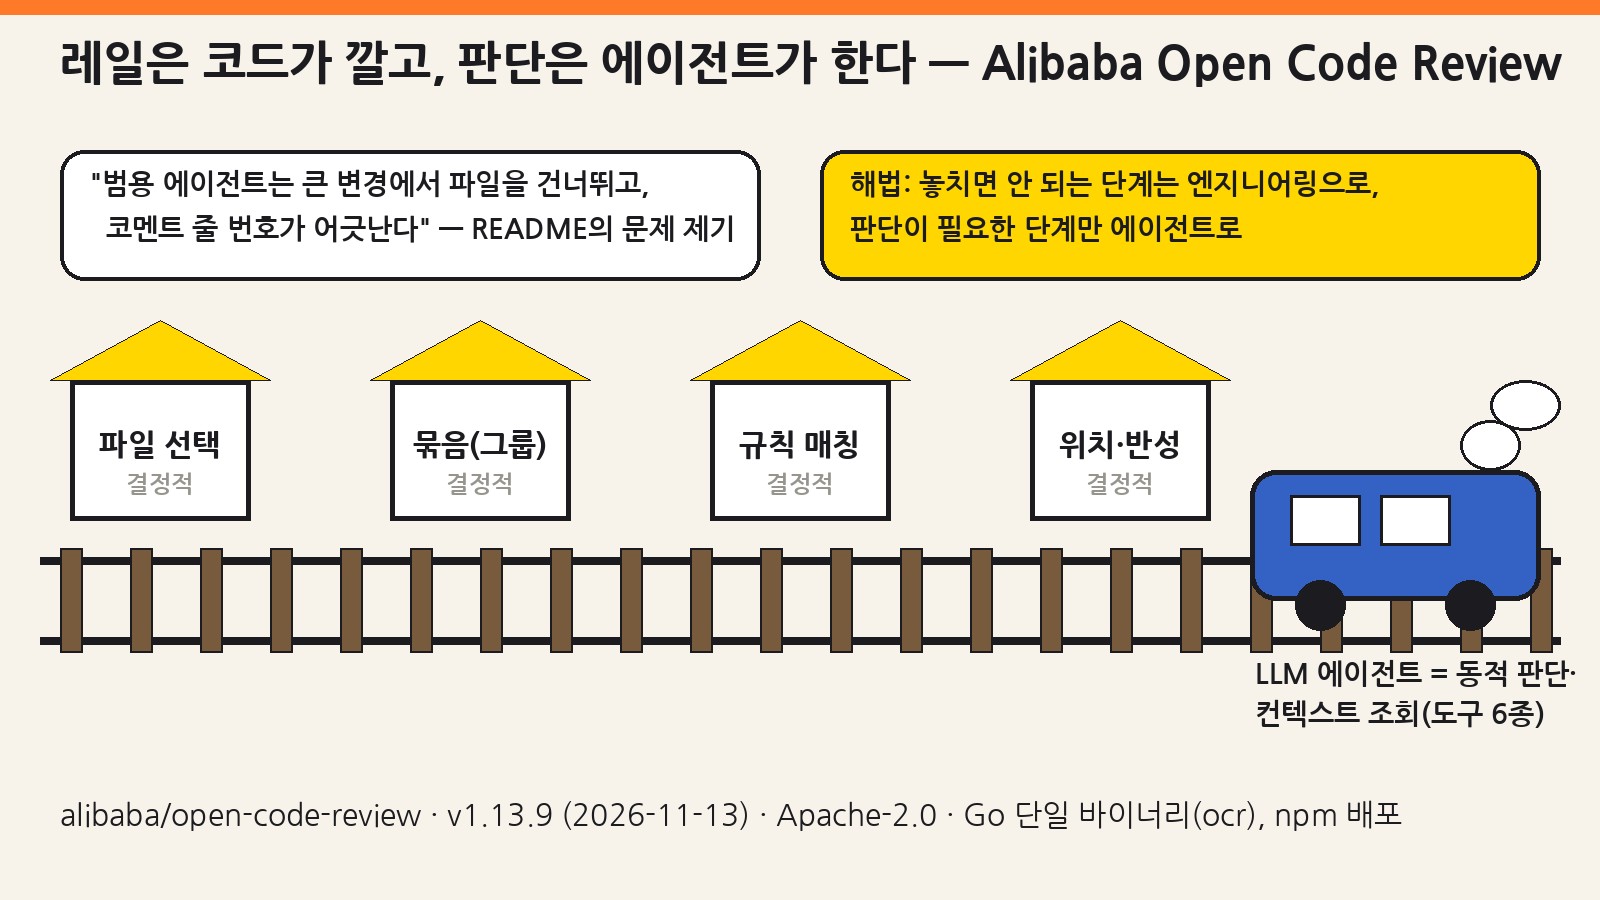
오늘(11/14) 오후 GitHub Trending 첫 줄은 alibaba/open-code-review(이하 OCR)였습니다. 이름만 보면 ‘또 하나의 AI 코드 리뷰 봇’ 같지만, README가 내세우는 건 모델이 아니라 구조입니다. 파일 선택·묶음·규칙 매칭·코멘트 위치 보정처럼 틀리면 안 되는 단계는 결정적 코드로 고정하고, 맥락을 찾아 읽고 판단하는 부분만 LLM 에이전트에게 맡기는 하이브리드 설계죠. 알리바바 그룹 내부 공식 AI 코드 리뷰 도구를 오픈소스로 옮겼다고 밝힌 프로젝트이기도 합니다.
이 글은 실무자 관점의 해부입니다. 소스(Go)와 공식 문서의 architecture·review-rules·cli-reference를 읽고 파이프라인과 임계값을 정리했고, 박스(GPU 없는 리눅스)에서 npm 1.13.9를 설치해 LLM 없이 돌아가는 부분과, 직접 만든 모의(mock) LLM 서버로 전체 파이프라인을 끝까지 돌린 결과를 숫자 그대로 적었습니다. 실제 상용 모델로 품질을 잰 것은 아니라는 점을 먼저 밝혀 둡니다.
한눈에 보기
| 항목 | 내용 |
|---|---|
| 저장소 | alibaba/open-code-review (공식 사이트 open-codereview.ai) |
| 최신 버전 | v1.13.9 — GitHub 릴리스 2026-11-13 18:47 KST, npm 같은 날 18:52 KST 게시 |
| 라이선스 | Apache-2.0 (Copyright 2026 Alibaba) |
| 언어·배포 | Go 단일 바이너리 ocr · npm @alibaba-group/open-code-review · 설치 스크립트·릴리스 바이너리 |
| 저장소 생성 / npm 첫 게시 | 2026-05-18 / 2026-05-21 (KST 기준 같은 날짜) |
| 관심도(조회 시점) | GitHub API 기준 스타 50,877·포크 3,791 (11/14 17시경 KST), 트렌딩 페이지 ‘오늘 +215’ · npm 주간 다운로드 167,292 (11/6~11/12) |
| 필요 조건 | Git ≥ 2.41, 리뷰용 LLM 엔드포인트(위임 모드에선 불필요) |
| 통합 | Claude Code·Codex·Cursor·Kimi Code·OpenCode 플러그인/스킬, VS Code 확장, GitHub Actions·GitLab CI 등, MCP 서버, ACP 어댑터(실험) |
왜 지금 주목받나: ‘범용 에이전트 리뷰’의 세 가지 고질병
README는 Claude Code 같은 범용 에이전트에 스킬을 얹어 리뷰를 시켜 본 사람이라면 겪는 문제 세 가지를 짚고, 원인을 ‘언어(프롬프트)만으로 굴러가는 구조라 리뷰 과정에 하드 제약이 없다’로 진단합니다. 그리고 각 문제에 대응하는 결정적 장치를 붙였습니다.
| 범용 에이전트의 문제(README) | 증상 | OCR의 대응 장치 | 구현 위치 |
|---|---|---|---|
| 커버리지 누락 | 큰 변경에서 일부 파일만 보고 ‘대충’ 끝냄 | 결정적 파일 선택 + 그룹별 서브에이전트(그룹당 최대 10파일) | internal/agent/selection.go, grouping.go |
| 위치 드리프트 | 코멘트의 줄 번호·파일이 실제 코드와 어긋남 | existing_code 슬라이딩 윈도 매칭 → 재위치(RE_LOCATION) → 2차 줄 해석 |
internal/diff/relocation.go 등 |
| 품질 불안정 | 프롬프트 조금만 바뀌어도 결과가 흔들림 | 템플릿 엔진 기반 규칙 매칭(언어별 64개 규칙 문서), 리뷰 전용으로 줄인 도구 6종 | internal/config/rules, tools.json |
저장소 구조: 어디부터 읽어야 하나
Go 모듈 하나에 CLI, 에이전트 오케스트레이션, LLM 클라이언트, 세션 뷰어까지 들어 있습니다. AGENTS.md에 따르면 단위 테스트 커버리지 90% 임계값을 make coverage로 강제하고, 소스 파일은 영어만 허용(make english-check)하며, AI 도구 사용 사실을 PR에 밝히도록 요구합니다. 실제로 cmd/opencodereview만 봐도 테스트 파일이 본 파일보다 많습니다.
| 경로 | 역할 | 읽을 포인트 |
|---|---|---|
cmd/opencodereview/ |
CLI 진입점(review·scan·delegate·session·rules·config·viewer) | review_cmd.go의 2차 줄 해석, sarif.go |
internal/agent/ |
파이프라인 오케스트레이션 | Agent.Run, dispatchSubtasks, grouping.go, selection.go |
internal/llmloop/ |
도구 사용 루프·메모리 압축 | loop.go, compression.go(3구역 분할) |
internal/config/template/ |
프롬프트 6종과 임계값 | task_template.json, prompts/*.md, effort.go |
internal/config/rules/ |
4계층 규칙 해석 + 언어별 규칙 문서 | system_rules.go, rule_docs/*.md(64개) |
internal/diff/ |
git diff 파싱·줄 재배치 | git.go(3가지 모드), relocation.go |
internal/tool/ |
에이전트 도구 구현 | code_comment.go, code_search.go, file_read_diff.go |
internal/delegate/ |
위임 모드 출력 포맷 | 규칙 그룹 묶기(rulegroup.go) |
examples/, action.yml |
CI 레시피(GitHub·GitLab·Gerrit·Bitbucket·GitFlic·Codeup) | 루트 action.yml이 재사용 가능한 컴포지트 액션 |
acp/, extensions/, plugins/, skills/ |
ACP 어댑터·IDE 확장·에이전트 플러그인·스킬 | 위임 스킬 open-code-review-delegate |
아키텍처: 다섯 단계 중 LLM은 세 곳에만
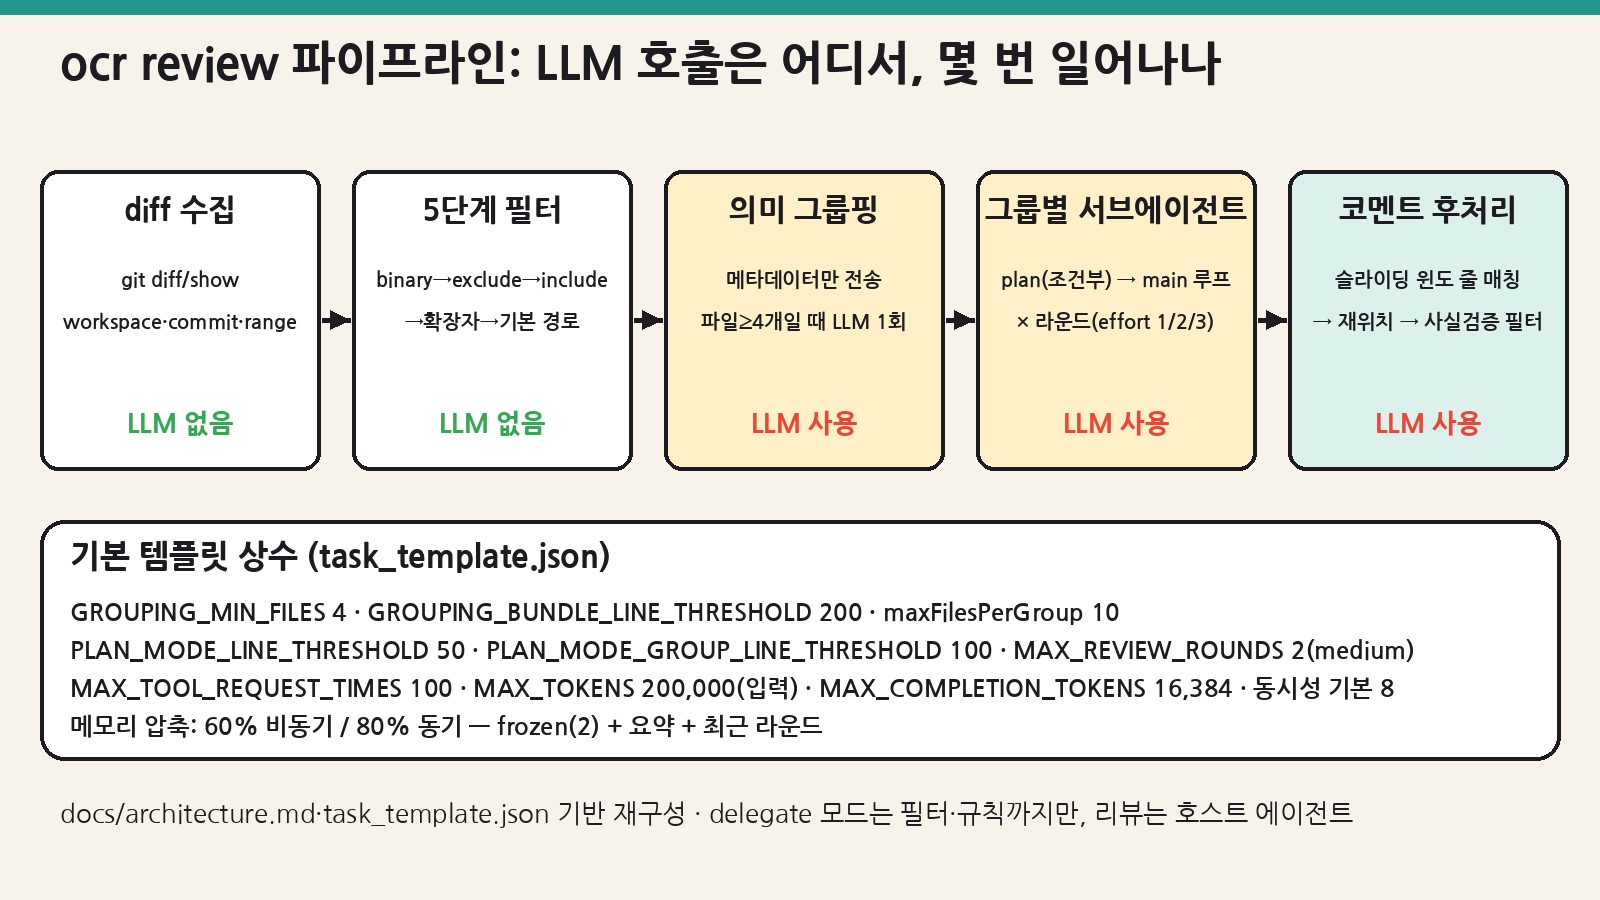
ocr review는 diff 수집 → 필터·규칙 → 의미 그룹핑 → 그룹별 서브태스크 → 코멘트 후처리로 흐릅니다. 핵심은 어떤 파일을 볼지와 각 파일에 어떤 규칙을 줄지가 LLM 호출 전에 결정적으로 정해진다는 점입니다. 그래서 --preview로 토큰 한 개 쓰지 않고 리뷰 범위를 미리 검증할 수 있습니다.
1) diff 수집과 5단계 필터
diff는 세 모드로 만듭니다. 플래그가 없으면 워크스페이스(스테이징·비스테이징·추적 안 된 파일), --commit은 해당 커밋, --from/--to는 merge-base(a,b)..b입니다. 컨텍스트 줄은 Git 기본값과 같은 3줄 고정이고, 추적 안 된 파일은 ‘전체 추가’로 취급돼 커밋 전에 리뷰됩니다. 이어서 whyExcluded가 파일마다 아래 순서로 판정합니다.
| 순서 | 게이트 | 의미 | 덮어쓸 수 있나 |
|---|---|---|---|
| 1 | binary |
바이너리 파일 제외 | 불가 |
| 2 | user_exclude |
rule.json의 exclude 패턴 |
사용자 설정이 최우선 |
| 3 | user_include |
include에 맞으면 즉시 통과(아래 두 게이트 우회) |
— |
| 4 | unsupported_ext |
확장자 허용 목록 밖 | include로 우회 가능 |
| 5 | default_path |
테스트 파일·node_modules·vendor·target 등 내장 제외 |
include로 우회 가능 |
| 후처리 | deleted / too_large |
삭제 파일, diff 단독으로 MAX_TOKENS의 80% 초과 | — |
2) 의미 그룹핑: 메타데이터만 보내는 LLM 1회
필터를 통과한 파일은 하나씩 리뷰되지 않습니다. groupDiffs가 diff 내용 없이 경로·상태·추가/삭제 줄 수만 담아 GROUPING_TASK를 한 번 호출하고, 모델은 {label, files} 배열을 돌려줍니다. 흥미로운 디테일은 파일을 경로가 아니라 정수 인덱스로 돌려받는다는 점입니다. 소스 주석에 따르면 경로 대신 인덱스를 쓰면 출력 토큰이 줄어 큰 변경에서도 응답이 잘리지 않고, 잘림 때문에 전체가 파일별 폴백으로 떨어지는 일을 막습니다. 그룹핑 실패는 정확성 문제로 취급하지 않고 ‘파일당 1그룹’으로 조용히 폴백합니다.
| 조건(기본값) | 전략 | 이유(소스 주석 요지) |
|---|---|---|
파일 수 ≥ GROUPING_MIN_FILES(4) |
llm — LLM으로 분할 |
파일이 적으면 가능한 분할이 몇 개 없어 LLM 호출이 정보를 못 사옴 |
| 파일 < 4 이고 총 변경 < 200줄 | bundle_all — 한 그룹 |
작으면 한 대화에서 같이 보는 게 이득 |
| 파일 < 4 이고 총 변경 ≥ 200줄 | per_file — 파일별 |
라운드마다 전체 변경을 다 덮어야 해 주의가 얇아짐 |
| 파일 1개 | 분할 생략 | 단, 텔레메트리에는 ‘건너뜀’으로 기록 |
| 그룹이 10파일 초과 / 토큰 예산 초과 / 누락 파일 | 10개 단위 분할 / 단일 파일로 쪼갬 / 단독 그룹 | 가드 3종(maxFilesPerGroup·토큰 예산·커버리지) |
3) 그룹별 서브에이전트: plan → main 루프 × 라운드
그룹마다 고루틴 하나가 독립된 메시지 버퍼로 돕니다(--concurrency 기본 8). 파일 하나가 50줄 이상 바뀌었거나, 2개 이상 파일 합계가 100줄 이상이면 먼저 PLAN_TASK를 한 번 부르는데, 이때는 도구를 실제로 붙이지 않고 읽기 도구 4종의 설명만 텍스트로 넣어 ‘어떤 위험을 어떤 도구로 확인할지’ 체크리스트를 받습니다. 그 뒤 main 루프가 도구 6종으로 최대 100회 요청을 돕니다.
| 도구 | 용도 | plan 단계 노출 |
|---|---|---|
code_search |
코드베이스 검색 | 설명만 |
file_read |
파일 전체 읽기 | 설명만 |
file_read_diff |
같은 변경의 다른 파일 diff 읽기 | 설명만 |
file_find |
파일 찾기 | 설명만 |
code_comment |
지적 등록: content·existing_code·category(8종)·severity(4단계)·path 필수, suggestion_code 선택 |
없음 |
task_done |
리뷰 종료 | 없음 |
라운드는 --effort로 정합니다. 2라운드부터는 앞 라운드에서 확정된 지적을 {{confirmed_comments}}로 넣고, plan은 빼고 다시 돕니다. 문서는 그 이유를 ‘plan은 뻔한 이슈를 찾고 나면 커버리지 천장처럼 작동한다’고 설명합니다. 새 지적이 없거나 확정 지적 상한, 또는 --max-tokens-budget에 닿으면 조기 종료합니다.
| –effort | 라운드 | 언제 쓰나(필자 의견) |
|---|---|---|
| low | 1 | 사전 커밋 훅, 빠른 피드백, 비용 민감 |
| medium(기본) | 2 | 일반 PR 리뷰 |
| high | 3 | 보안·결제 등 고위험 변경 — 단 토큰·시간 비례 증가 |
4) 컨텍스트 관리: 3구역 메모리 압축
MAX_TOKENS(기본 200,000)는 입력 상한이고 출력 상한 MAX_COMPLETION_TOKENS(16,384)와 분리돼 있습니다. 프롬프트가 60%를 넘으면 백그라운드에서 비동기 압축을 시작하고, 80%를 넘으면 동기로 압축한 뒤에야 다음 요청을 보냅니다. 메시지는 ‘frozen(시스템+첫 사용자 메시지 2개) / 압축 구역 / 최근 완결 라운드’로 나뉘고, 압축 구역은 XML로 렌더링돼 요약된 뒤 첫 사용자 메시지 뒤에 <previous_review_summary>로 붙습니다. 그룹 단위로 대화가 분리돼 있으니 압축 손실도 그룹 안에 갇힌다는 게 이 설계의 장점입니다.
5) 코멘트 후처리: 위치와 사실을 따로 검증
code_comment 호출은 워커 풀로 넘어가 메인 루프를 막지 않습니다. 먼저 모델이 인용한 existing_code를 diff에 슬라이딩 윈도로 맞춰 start_line/end_line을 계산하고, 실패하면 RE_LOCATION_TASK로 한 번 더 재위치를 시도합니다. 그래도 못 찾으면 줄 번호는 0이 되고, 이것이 ‘고정 안 된 코멘트’의 유일한 신호입니다(별도 플래그 없음). 루프가 끝나면 REVIEW_FILTER_TASK가 지적들을 diff와 대조해 diff가 명백히 반박하는 것만 지웁니다.
이 필터 프롬프트의 태도가 인상적입니다. ‘틀린 코멘트를 남기는 비용은 리뷰어의 몇 초지만, 맞는 코멘트를 지우면 그 발견은 아무도 모르게 사라진다’며, 의심스럽거나 검증 불가하거나 가치가 낮아 보이는 경우는 모두 승인하라고 지시합니다. 즉 이 단계는 정밀도를 높이는 도구가 아니라 환각성 오류만 걷어내는 안전망에 가깝고, 정밀도는 주로 규칙 문서의 ‘확신할 때만 지적하라(precision over recall)’ 지침과 그룹 단위 설계에서 나옵니다.
| 프롬프트 키 | 호출 시점 | 출력 |
|---|---|---|
GROUPING_TASK |
리뷰당 0~1회 | 그룹 JSON(정수 인덱스) |
PLAN_TASK |
그룹당 0~1회(임계값 충족 시, 1라운드만) | Summary + 위험별 도구 계획 텍스트 |
MAIN_TASK |
그룹당 라운드 × 도구 루프 | code_comment / task_done 호출 |
MEMORY_COMPRESSION_TASK |
토큰 60%/80% 초과 시 | 압축 요약 |
RE_LOCATION_TASK |
줄 매칭 실패 시 | 원문 코드 조각 |
REVIEW_FILTER_TASK |
지적이 있는 그룹당 1회 | approve_all_comments 또는 report_incorrect_comments |
규칙 엔진: 4계층 체인과 merge_system_rule
규칙은 ‘이 파일에서 무엇을 볼지’를 정하는 프롬프트 조각입니다. 파일 경로마다 아래 순서로 처음 매칭되는 패턴이 이깁니다. 시스템 계층은 바이너리에 내장돼 있어 항상 무언가는 해석됩니다. Java·Go·Python·TS/JS부터 Solidity·Terraform·Rego·Verilog·MyBatis 매퍼 XML까지 64개 규칙 문서가 들어 있고, 각 문서는 오타·데드 코드·논리 오류·NPE·스레드 안전성·주입 취약점 같은 항목을 언어별로 구체화합니다.
| 우선순위 | 출처 | 경로 | 비고 |
|---|---|---|---|
| 1(최고) | --rule 플래그 |
사용자 지정 | CLI 덮어쓰기 |
| 2 | 프로젝트 | <repo>/.opencodereview/rule.json |
커밋해서 팀 공유 |
| 3 | 전역 | ~/.opencodereview/rule.json |
개인 선호 |
| 4(최저) | 시스템 | 내장 system_rules.json + rule_docs/*.md |
언어별 기본 규칙 |
merge_system_rule가 기본값 false면 사용자 규칙이 시스템 규칙을 대체하고, true면 둘을 합칩니다. 실무에서는 대부분 true가 안전합니다. 팀 규칙 한 줄 때문에 언어별 기본 점검이 통째로 사라지는 실수를 막아 주니까요. OCR 저장소 자신도 internal/llm/providers.go에 ‘필드 순서, 문서 4개 언어 동기화, 프로바이더별 테스트 필수’ 같은 규칙을 merge 모드로 걸어 두었습니다.
{
  "exclude": ["**/*.lock", "**/generated/**"],
  "rules": [
    {
      "path": "src/api/**/*.py",
      "rule": "All SQL must use parameterized queries; flag string formatting in execute().",
      "merge_system_rule": true
    }
  ]
}
# 어떤 규칙이 붙는지 LLM 없이 확인
ocr rules check src/api/user.py
# Source: Project (.opencodereview/rule.json)
# Pattern: src/api/**/*.py
# Rule: ## System-Specific Rules (Mandatory) ... (시스템 Python 규칙 + 팀 규칙)벤치마크: 정밀도를 사고 재현율을 판 설계
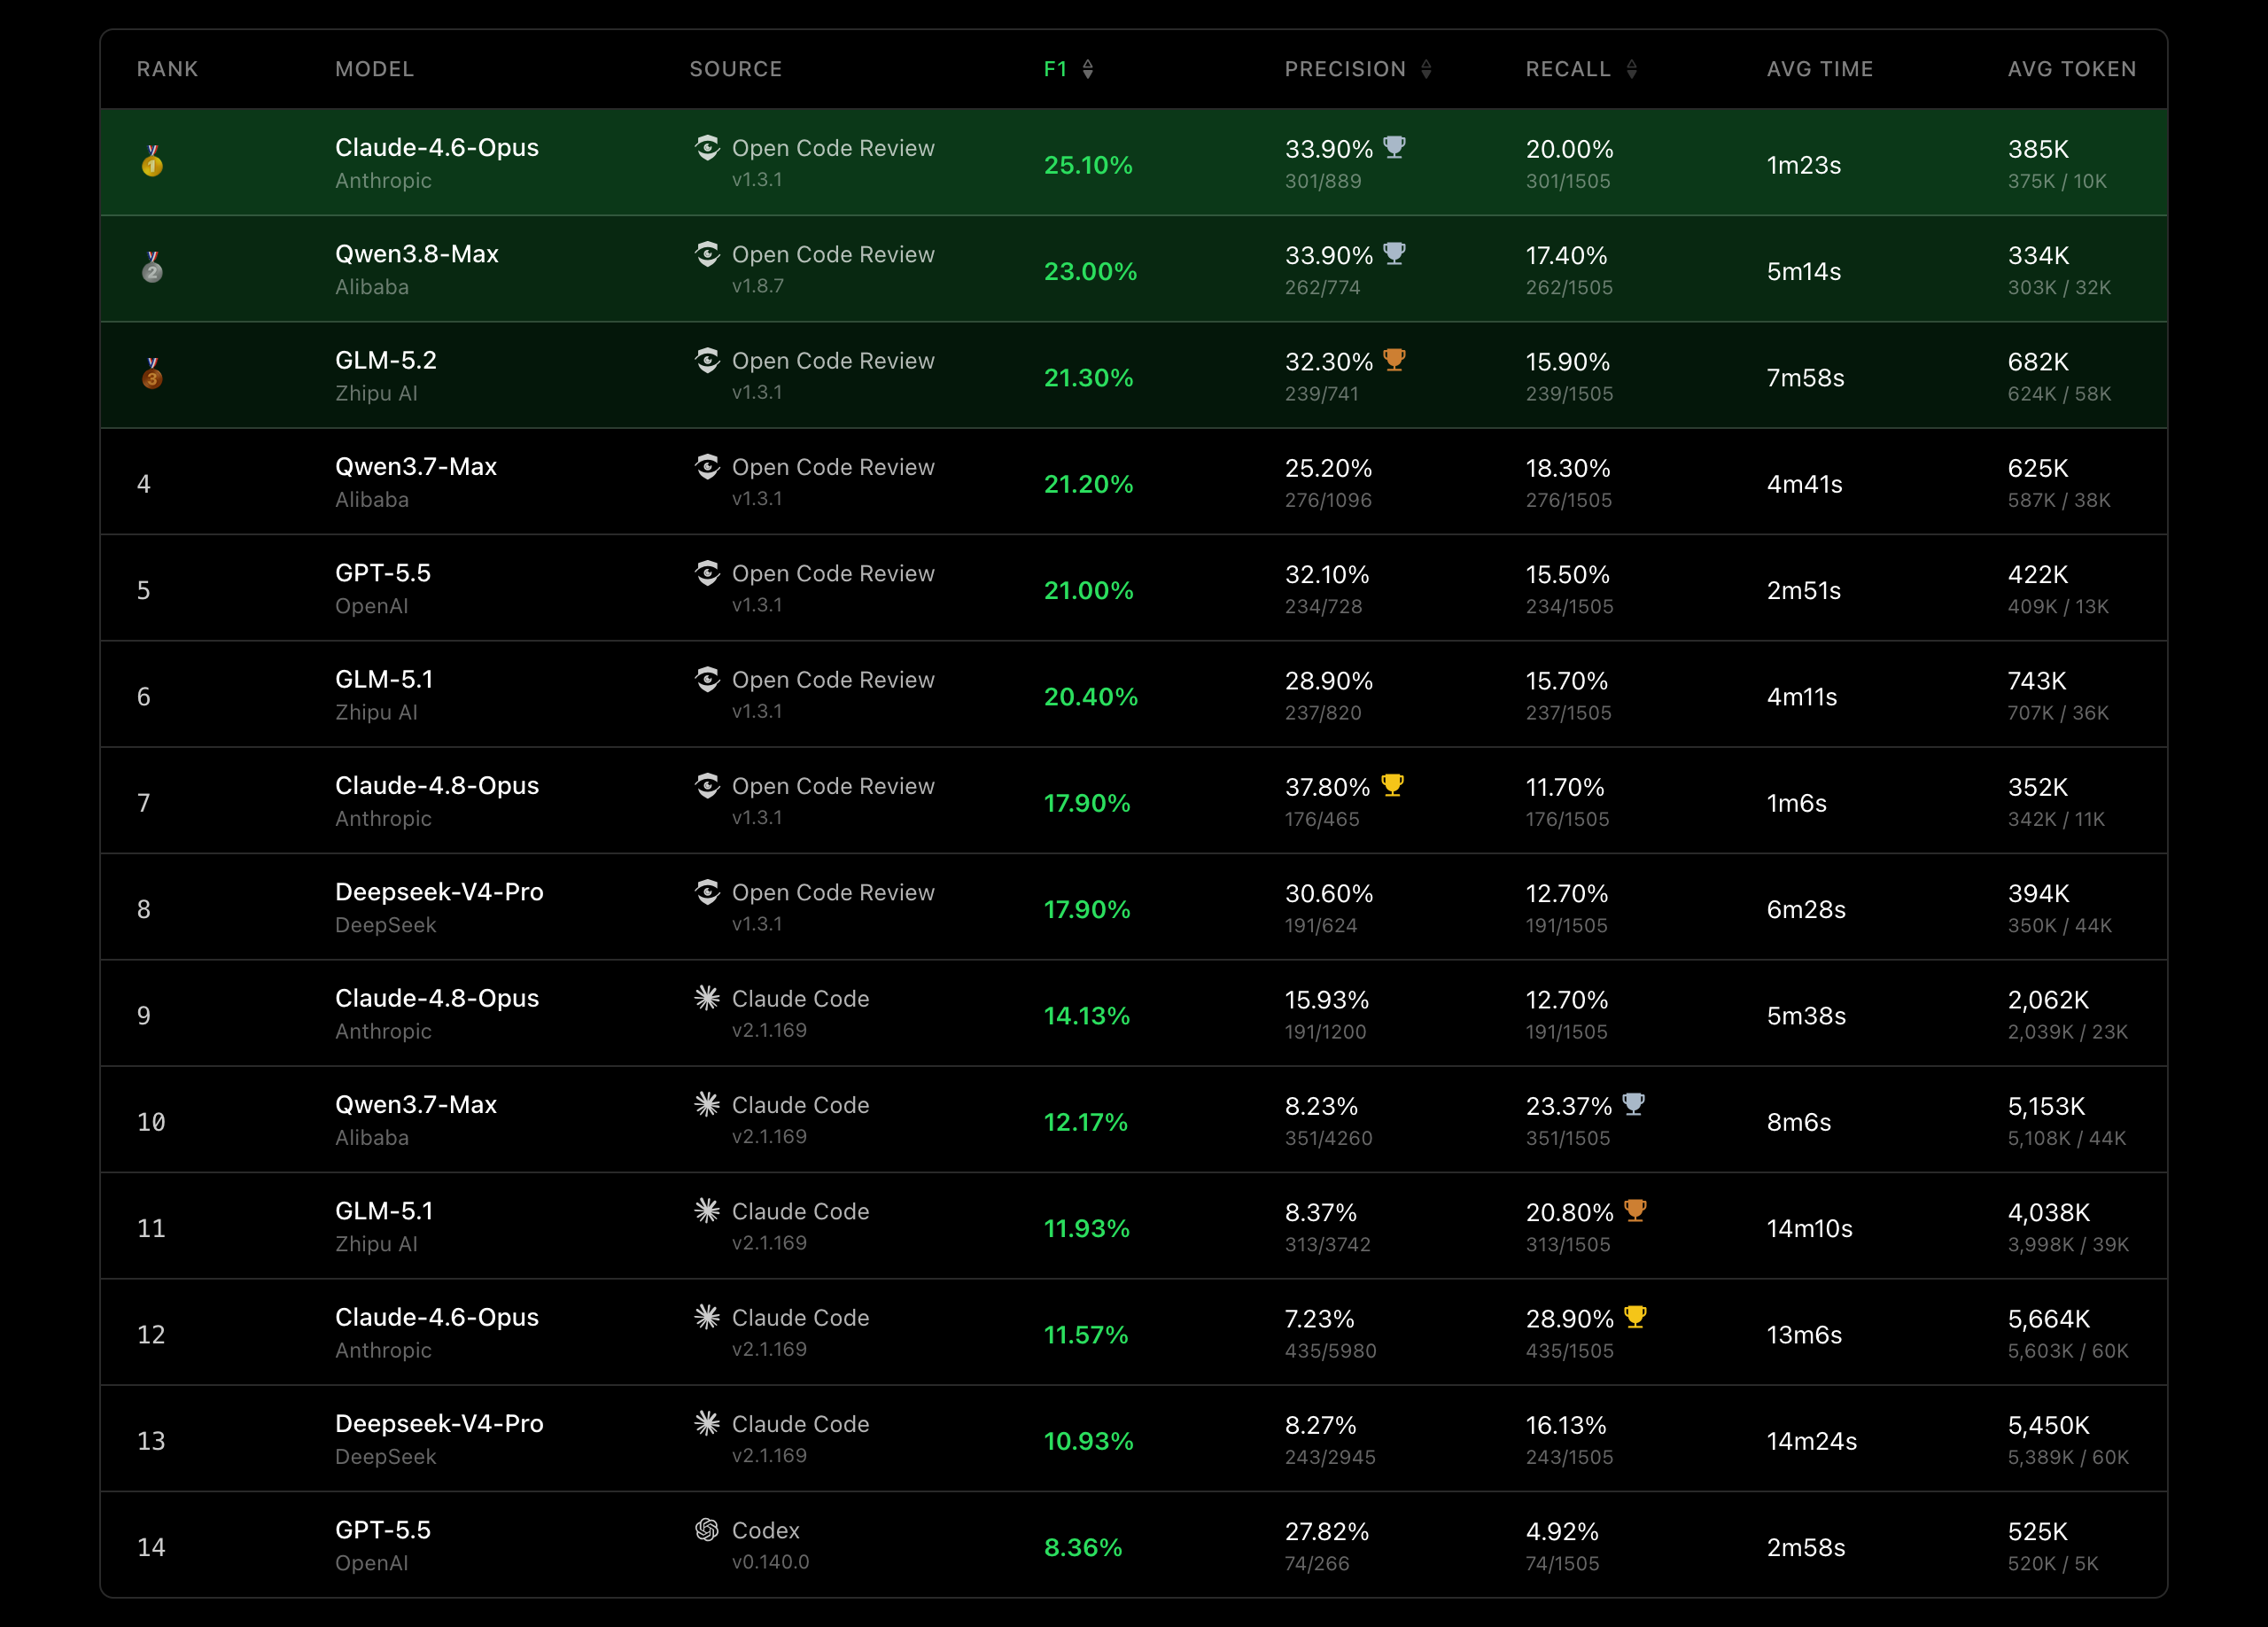
README는 50개 인기 오픈소스 저장소의 실제 PR 200개, 10개 언어로 만든 AACR-Bench(시니어 엔지니어 80여 명이 교차 검증, 정답 이슈 1,505개, Hugging Face 공개)를 근거로 듭니다. 같은 기반 모델이라도 OCR이 Claude Code보다 정밀도와 F1이 높고 토큰은 약 1/9만 쓴다고 주장하면서, 재현율은 범용 에이전트보다 낮다는 점을 ‘의도된 트레이드오프’라고 스스로 밝힙니다. 아래는 README 표에서 같은 모델끼리 비교 가능한 행만 옮긴 것입니다.
| 도구(버전) | 모델 | F1 | 정밀도 | 재현율 | 평균 시간 | 평균 토큰 |
|---|---|---|---|---|---|---|
| OCR v1.3.1 | Claude-4.6-Opus | 25.10% | 33.90% (301/889) | 20.00% | 1m23s | 385K |
| Claude Code v2.1.169 | Claude-4.6-Opus | 11.57% | 7.23% (435/5980) | 28.90% | 13m6s | 5,664K |
| OCR v1.3.1 | Claude-4.8-Opus | 17.90% | 37.80% (176/465) | 11.70% | 1m6s | 352K |
| Claude Code v2.1.169 | Claude-4.8-Opus | 14.13% | 15.93% (191/1200) | 12.70% | 5m38s | 2,062K |
| OCR v1.3.1 | GPT-5.5 | 21.00% | 32.10% (234/728) | 15.50% | 2m51s | 422K |
| Codex v0.140.0 | GPT-5.5 | 8.36% | 27.82% (74/266) | 4.92% | 2m58s | 525K |
읽는 법이 중요합니다. 절대 수치로 보면 최고 F1도 25%대이고 재현율 20%는 ‘사람이 찾을 버그 다섯 개 중 하나’ 수준입니다. 즉 OCR은 사람 리뷰를 대체하는 도구가 아니라 잡음 적은 1차 필터로 설계됐습니다. 범용 에이전트(Claude Code + Claude-4.6-Opus)는 재현율 28.90%로 더 많이 찾지만 지적 5,980건 중 435건만 진짜였습니다. 리뷰어가 지적 14개를 읽어야 하나가 맞는 셈이죠. 팀이 ‘봇 코멘트 무시하기’를 학습해 버리는 비용을 생각하면, 정밀도 쪽에 건 OCR의 선택은 운영 관점에서 설득력이 있습니다. 한편 로드맵의 ‘Ultra Mode’(토큰을 더 써서 재현율을 크게 올리는 옵트인 모드)는 이 한계를 스스로 인정한 계획으로 읽힙니다.
설치와 실행
# 설치 (Git >= 2.41 필요)
npm install -g @alibaba-group/open-code-review
ocr version
# open-code-review v1.13.9 (0e9060d) linux/amd64

# LLM 설정: 대화형 또는 환경 변수
ocr config provider        # 내장 프로바이더 30종 중 선택(anthropic, openai, dashscope, deepseek, xai, openrouter, litellm ...)
ocr config model
# 또는
export OCR_LLM_URL=https://your-gateway/v1
export OCR_LLM_TOKEN=***
export OCR_LLM_MODEL=your-model
cd your-project
ocr review --preview # 토큰 0: 리뷰 범위·제외 사유만 확인
ocr review # 워크스페이스(스테이징+비스테이징+추적 안 된 파일)
ocr review --from main --to feature-x # merge-base 기준 브랜치 범위
ocr review --commit abc123 # 단일 커밋
ocr review --effort high --background "결제 재시도 로직 변경" # 요구사항 배경 주입
ocr review --format json --audience agent -o result.json # 에이전트/CI용
ocr review --format sarif -o ocr.sarif # GitHub Code Scanning용 SARIF 2.1.0
ocr scan --path internal/agent # diff 없이 전체 파일 감사
ocr session list && ocr viewer # 세션 JSONL 재생·코멘트 처리 표시세션은 ~/.opencodereview/sessions/<경로 인코딩>/<세션 ID>.jsonl에 append-only로 쌓이고, 중단된 범위·커밋 리뷰는 --resume <session-id>로 이어서 돌릴 수 있습니다. 종료 코드는 0(완료, 경고 포함 가능)과 1(치명적 오류 — 엔드포인트 미설정, 모든 그룹 실패 등) 두 가지라 CI 게이트로 쓰기 단순합니다.
위임(delegate) 모드: API 키 없이 쓰는 법
Claude Code·Codex·Cursor 같은 구독형 에이전트를 이미 쓰고 있다면 OCR에 별도 키를 넣지 않아도 됩니다. 위임 모드에서 OCR은 파일 선택·제외·규칙 해석이라는 결정적 비계만 만들고, 실제 리뷰는 호스트 에이전트가 자기 모델로 수행합니다. 단, 이 경우 그룹별 서브에이전트·재위치·사실검증 필터 같은 OCR 고유의 후처리는 호스트 에이전트가 대신하지 않는다는 점을 감안해야 합니다(위임 모드 출력은 파일 목록과 규칙 그룹입니다).
ocr delegate preview                          # 리뷰 대상/제외 파일 목록(Markdown)
ocr delegate rule src/api/user.py src/api/A.java   # 파일별 규칙을 '규칙 그룹'으로 묶어 출력
npx skills add alibaba/open-code-review --skill open-code-review-delegate   # 에이전트 스킬 설치
CI 통합 요지
# .github/workflows/ocr.yml (요지 — 실제 입력값은 action.yml 참고)
on:
  pull_request_target:
    types: [opened, synchronize, reopened]
jobs:
  review:
    runs-on: ubuntu-latest
    steps:
      - uses: alibaba/open-code-review@<full-commit-sha>   # 재현성 위해 SHA 고정 권장
        with:
          llm_url: ${{ secrets.OCR_LLM_URL }}
          llm_auth_token: ${{ secrets.OCR_LLM_TOKEN }}
          llm_model: ${{ secrets.OCR_LLM_MODEL }}
          llm_use_anthropic: "false"
공식 예제는 pull_request_target와 /open-code-review 코멘트 트리거를 씁니다. pull_request_target는 포크 PR에서도 시크릿에 접근하는 이벤트이므로, 외부 기여를 받는 공개 저장소라면 권한 범위와 실행 대상 코드를 반드시 점검하세요. 리뷰 결과는 인라인 코멘트로 달고, 줄 정보가 없는(줄 번호 0) 지적은 요약 코멘트로 접어 넣는 방식입니다.
박스 실측: 설치, LLM 없는 경로, 그리고 모의 LLM으로 끝까지
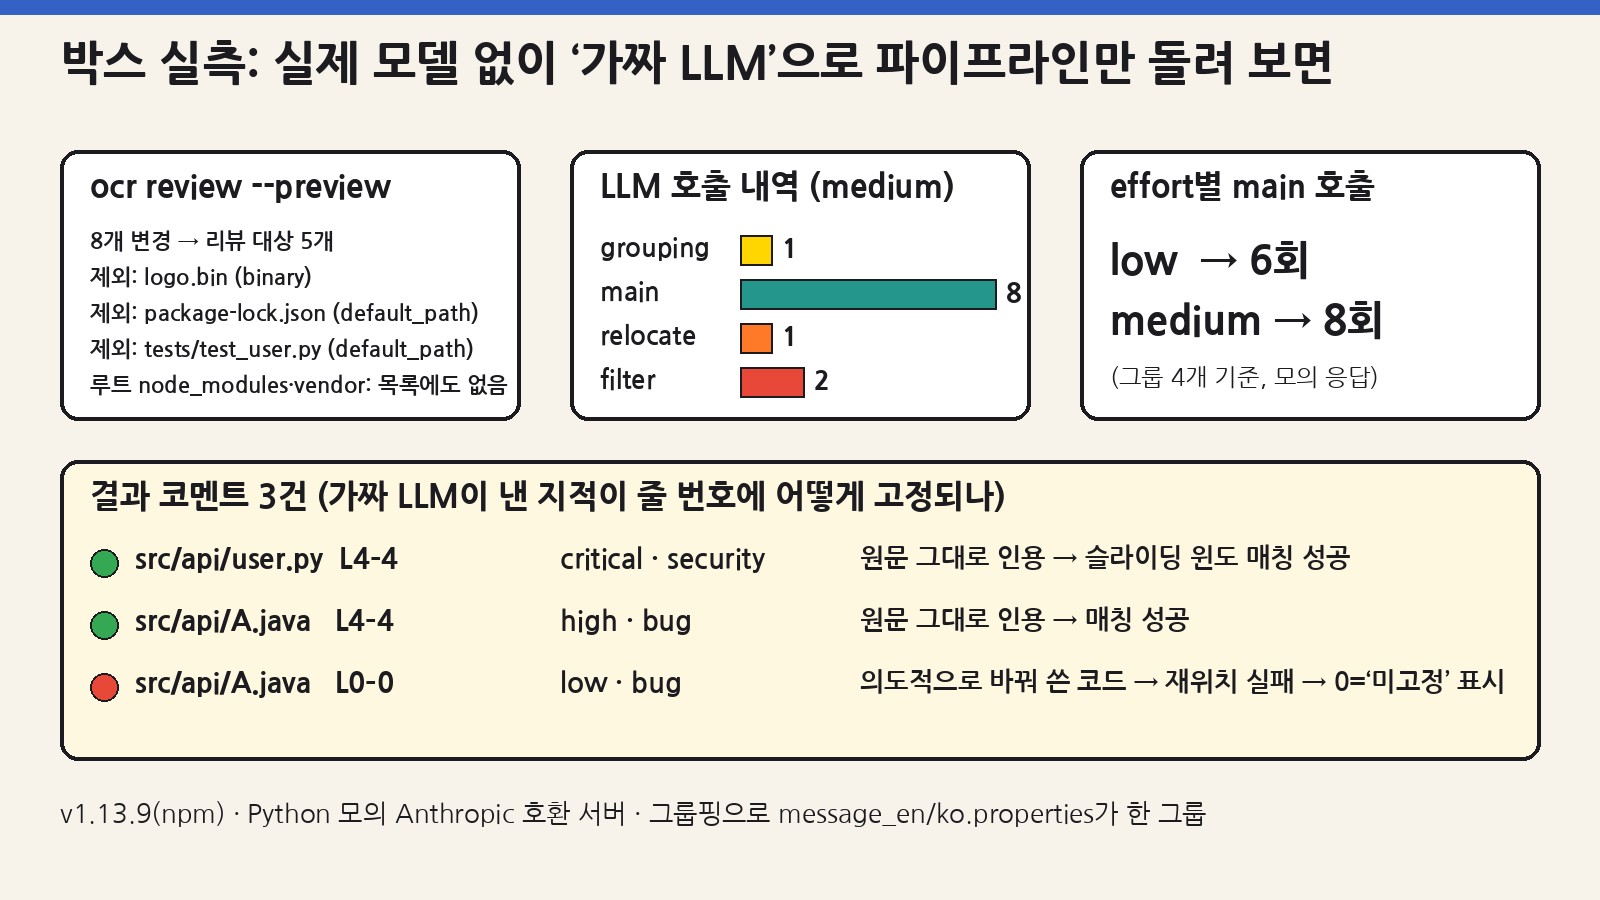
GPU 없는 리눅스 박스(Node 22.20·npm 11.21.1, Git 2.47.3)에서 npm install -g @alibaba-group/open-code-review@1.13.9를 실행했고 설치는 약 2.4초에 끝났습니다. npm 11의 install-scripts(allowScripts) 정책 때문에 postinstall 스크립트가 실행되지 않았다는 경고가 떴지만 ocr version은 정상적으로 v1.13.9 (0e9060d) linux/amd64를 출력했습니다. 테스트용 저장소에는 SQL 문자열 포매팅이 있는 Python 파일, m.get("k").trim()으로 NPE 위험이 있는 Java 파일, 영어/한국어 .properties 한 쌍, 테스트 파일·바이너리·lock 파일, 루트 node_modules/·vendor/를 넣었습니다.
실제 모델로 품질을 재는 대신, 파이프라인 자체를 관찰하려고 Python으로 Anthropic Messages 호환 모의 서버를 만들어 OCR_LLM_URL로 연결했습니다. 모의 서버는 시스템 프롬프트로 태스크 종류(그룹핑·main·재위치·필터)를 구분해 고정 응답을 돌려주고, 요청을 모두 기록합니다. 참고로 OCR_LLM_* 환경 변수만 줬을 때 OCR은 OpenAI 형식이 아니라 Anthropic Messages 형식(system 필드, cache_control)으로 요청을 보냈습니다. 처음에 OpenAI 형식으로 응답했더니 모든 그룹이 도구 호출을 인식하지 못해 100회 한도와 ‘grace round’까지 소진하고 종료 코드 1로 실패했는데, 이것 자체가 루프 종료 조건이 문서대로 동작한다는 확인이 됐습니다.
| 시험 | 명령 | 결과(박스 실측) |
|---|---|---|
| 범위 미리보기 | ocr review --preview |
8개 변경 중 5개 리뷰 대상, 제외 3개(logo.bin=binary, package-lock.json·tests/test_user.py=default_path), 루트 node_modules·vendor는 목록에 아예 없음, 0.22초 |
| 위임 미리보기 | ocr delegate preview |
같은 5/8 결과를 Markdown으로 출력, 종료 코드 0 |
| 규칙 해석 | ocr delegate rule … / ocr rules check |
user.py는 ‘project / src/api/**/*.py’ 그룹(시스템 Python 규칙 + 팀 규칙 병합), A.java는 ‘system / **/*.java’ |
| 엔드포인트 없음 | ocr review --format json |
‘no valid LLM endpoint configured’ 오류, 종료 코드 1 |
| 모의 LLM, effort=medium | ocr review --effort medium --format json |
status complete, 지적 3건, LLM 호출: grouping 1·main 8·relocate 1·filter 2 |
| 모의 LLM, effort=low | ocr review --effort low … |
지적 3건, main 호출 6회(라운드 1) |
| 의미 그룹핑 | (모의 응답이 .properties 둘을 묶음) | 그룹 4개: i18n messages(en+ko), A.java, user.py, rule.json |
| 줄 고정 | existing_code 원문 인용 2건 / 바꿔 쓴 인용 1건 |
원문 인용은 L4–L4로 정확히 고정, 바꿔 쓴 1건은 재위치 실패 후 L0(미고정) |
관찰 하나를 덧붙이면, 첫 시도에서 모의 서버가 2라운드에도 같은 지적을 다시 내자 결과에 동일한 지적이 두 번 실렸습니다. 2라운드 프롬프트에 확정 지적을 넣어 ‘반복하지 말라’고 맡기는 구조라, 중복 억제는 결정적 코드가 아니라 모델의 협조에 기대는 부분으로 보입니다. 실제 모델에선 드물겠지만 CI에서 코멘트를 올릴 때 경로+줄+내용 기준 중복 제거를 한 번 더 거는 것이 안전합니다.
# 실측에 쓴 실행 형태 (모의 서버는 127.0.0.1:18080)
export OCR_LLM_URL=http://127.0.0.1:18080/v1 OCR_LLM_TOKEN=dummy OCR_LLM_MODEL=mock-model
ocr review --effort medium --format json --audience agent > review.json
jq '.status, .summary.comments, [.comments[] | {path, start_line, severity}]' review.json
비슷한 도구와 비교
| 구분 | Open Code Review | 범용 코딩 에이전트 + 리뷰 스킬 | PR-Agent류 LLM PR 봇 | Semgrep·reviewdog류 정적 분석 |
|---|---|---|---|---|
| 핵심 방식 | 결정적 파이프라인 + 그룹별 에이전트 | 프롬프트/스킬 주도 단일 에이전트 | PR 단위 프롬프트 체인 | 규칙(패턴) 매칭 |
| 리뷰 범위 보장 | 필터·그룹으로 강제, --preview로 사전 확인 |
모델 재량(큰 변경에서 누락 가능) | 도구마다 다름 | 결정적 |
| 코멘트 위치 | 슬라이딩 윈도 + 재위치 + 2차 해석 | 모델이 쓴 줄 번호에 의존 | 도구마다 다름 | 정확 |
| 맥락 탐색 | 도구 6종으로 저장소 검색·읽기 | 강력(범용 도구 전부) | 제한적인 경우가 많음 | 없음(규칙 범위 내) |
| 논리·설계 결함 | 가능(LLM) | 가능(LLM) | 가능(LLM) | 어려움 |
| 비용·속도(README 기준) | 토큰 약 1/9, 더 빠름 | 토큰·시간 큼 | 중간 | 매우 저렴 |
| 팀 규칙 | 4계층 rule.json + 언어별 64개 규칙 | 스킬/메모리 파일 | 설정 파일 | 커스텀 룰 작성 |
| 키 없이 쓰기 | 위임 모드 | 구독 그대로 | 보통 키 필요 | 불필요 |
한계와 주의점
| 주의점 | 내용 | 대응 |
|---|---|---|
| 낮은 재현율 | README 스스로 ‘범용 에이전트보다 재현율이 낮다’고 명시. 최고 F1도 25%대 | 사람 리뷰 대체 금지, 고위험 변경만 --effort high |
| 벤더 자체 벤치마크 | AACR-Bench는 알리바바가 만든 데이터셋, OCR 측 수치는 구버전 기준 | 자기 저장소 PR 20~50개로 직접 A/B |
| 그룹 경계 밖 추론 | 다른 그룹 파일은 도구로 ‘읽기’만 가능, 그쪽에 코멘트 불가 | 관련 파일이 같은 그룹에 묶였는지 JSON groups 확인 |
| 프롬프트 고정 | 템플릿·도구 정의가 바이너리에 임베드 | 규칙·--background·MCP로 조정, 필요 시 포크 빌드 |
| 코드 외부 전송 | diff와 도구로 읽은 파일 내용이 설정한 LLM으로 감 | 사내 게이트웨이(litellm 등)·자체 호스팅 모델, 민감 경로 exclude |
| CI 권한 | 공식 예제가 pull_request_target 사용 |
포크 PR 정책 점검, 액션은 커밋 SHA로 고정 |
| 빠른 릴리스 | 11월에만 v1.13.5→v1.13.9(11/3~11/13) 연속 릴리스 | 버전 핀 고정 후 주기적 업그레이드 |
| 중복 지적 | 라운드 간 중복 억제가 모델 협조에 의존(실측 관찰) | 게시 단계에서 중복 제거 |
누가 도입하면 좋은가
| 상황 | 추천도 | 이유 |
|---|---|---|
| 범용 에이전트 리뷰가 ‘시끄럽다’는 불만이 있는 팀 | 높음 | 정밀도 우선 설계 + 사실검증 필터로 잡음 감소 |
| 사내 LLM 게이트웨이를 이미 운영하는 조직 | 높음 | OpenAI/Anthropic 호환·30개 내장 프로바이더, CI 예제 다수 |
| Claude Code·Codex 구독만 있는 개인/소규모 팀 | 중간 | 위임 모드로 키 없이 범위·규칙만 활용 |
| 대형 모노레포·다국어 리소스가 많은 프로젝트 | 높음 | 그룹핑(i18n 파일 묶기)과 파일 필터의 효과가 큼 |
| 규제 산업, 코드 외부 반출 불가 | 조건부 | 자체 호스팅 모델 연결이 전제 |
| ‘봇이 버그를 다 잡아 주길’ 기대하는 팀 | 낮음 | 재현율 20% 안팎 — 사람 리뷰 보조로만 |
정리하면 OCR의 진짜 기여는 특정 모델이 아니라 ‘에이전트에게 맡기지 말아야 할 것’을 골라낸 목록입니다. 어떤 파일을 볼지, 어떤 규칙을 줄지, 코멘트를 어느 줄에 달지, 무엇을 버릴지를 코드로 고정하고 나니 같은 모델로도 토큰은 줄고 잡음은 줄었다는 것이죠. 도입을 검토한다면 ocr review --preview와 ocr delegate rule로 비용 0원짜리 점검부터 해 보고, 최근 머지된 PR 몇십 개에 --format json으로 돌려 팀 기준의 정밀도를 직접 재 보길 권합니다.