테크부터 경제, 생활까지. 복잡한 소식을 쉽게 풀어봅니다. 오늘(2026년 11월 15일, KST) 오전 오픈소스 심화는 이번 주 GitHub Trending 주간 상위권에 오른 google/elephant-goldfish-model(줄여서 EGM)입니다. 코드를 생성하는 도구가 아니라, 코드를 짜기 전에 쓰는 설계 문서를 에이전트와 함께 만들고, 그 문서를 “대화 맥락을 모르는” 별도 서브에이전트들에게 검토시키는 플러그인입니다. 실무자 관점에서 저장소 구조, 리뷰 파이프라인이 실제로 어떻게 짜여 있는지, 호스트별 어댑터가 어떻게 갈라지는지, 그리고 박스에서 모델 호출 없이 검증할 수 있는 부분(유닛 테스트·릴리스 재현성)을 직접 돌려 본 결과까지 정리했습니다.
한눈에 보기
| 항목 | 내용 (2026-11-15 KST 확인) |
|---|---|
| 저장소 | google/elephant-goldfish-model (홈페이지 egm.dev) |
| 한 줄 설명 | “Open-source plugin for designing and reviewing software with agents” |
| 최신 릴리스 | v0.1.1 (2026-11-07 06:50 KST 공개, 태그 커밋 dea7761) · 이전 v0.1.0 (2026-10-27) |
| 라이선스 | Apache-2.0 (README: “This is not an officially supported Google product.”) |
| 스타 / 포크 | 약 19,239 / 1,426 (GitHub API 조회 시점 기준) |
| 트렌딩 | 주간 트렌딩 목록에서 이번 주 5,539 stars 표시 |
| 저장소 생성 | 2026-09-14 (KST) |
| 구성 | 스킬 7개, 리뷰어·오케스트레이터 페르소나 10개, 문서 기준(standard) 5개 — 모두 Markdown |
| 지원 호스트 | Antigravity, Claude Code, Claude Cowork, Codex/ChatGPT, omp, Muse + 실험적 Cursor·OpenCode·Copilot·Windsurf 어댑터 |
1. 왜 ‘코끼리와 금붕어’인가: 문제 설정
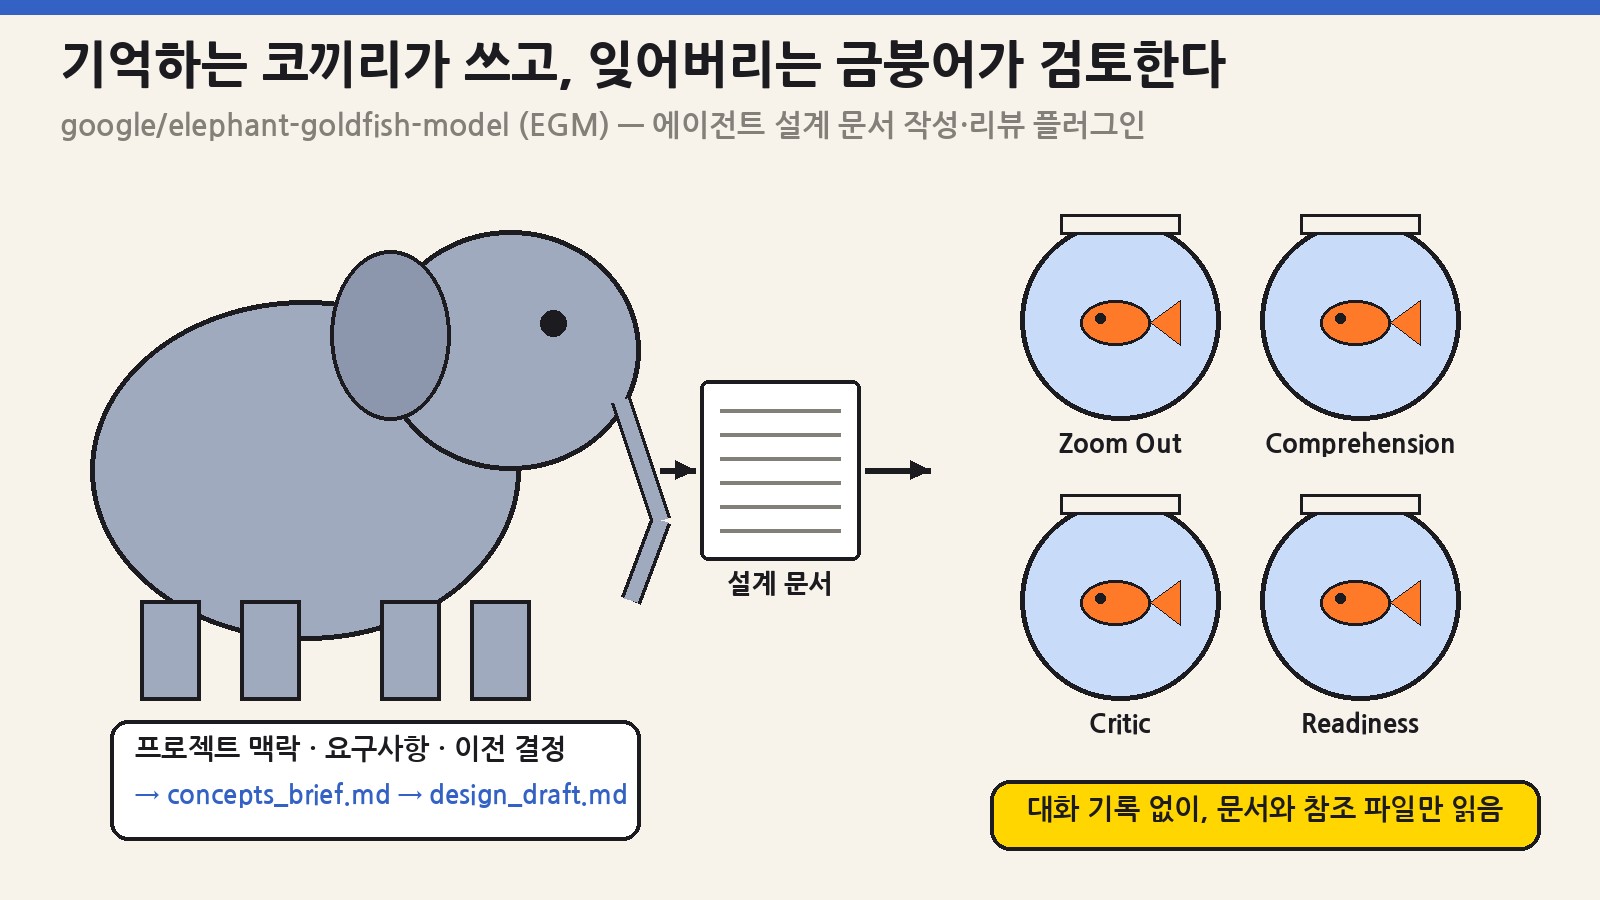
EGM은 Dave Rensin의 에세이 “Elephants, Goldfish, and the New Golden Age of Software Engineering”에서 출발한 스펙 주도 개발(Spec-Driven Development, SDD) 구현입니다. 핵심 관찰은 단순합니다. 같은 대화 세션 안에서 설계를 쓰고 그대로 검토까지 시키면, 모델은 자기가 방금 내린 결정을 다시 정당화하는 쪽으로 기웁니다. 아키텍처 문서(docs/designs/architecture.md)의 “Alternatives Considered” 절은 단일 스레드 내 순차 리뷰를 기각한 이유를 “심각한 컨텍스트 열화와 확증 편향; 모델이 자기 실수를 검증한다”라고 적고 있습니다.
그래서 역할을 셋으로 나눕니다.
| 역할 | 보는 맥락 | 책임 |
|---|---|---|
| Elephant(코끼리) | 프로젝트, 요구사항, 이전 결정 — 대화 전체 | 문제를 탐색하고 명세 초안을 작성 |
| Goldfish(금붕어) | 문서와 그 문서가 참조하는 소스 자료만, 이전 대화 없음 | 숨은 가정, 불명확한 요구, 구현 리스크 발견 |
| 사람 | 중요한 목표와 제약 | 트레이드오프 결정, 설계 승인, 무엇을 만들지 결정 |
여기서 실무적으로 중요한 문장은 README의 “Goldfish reviews require fresh subagent contexts. If your agent cannot create them, EGM stops the review.”입니다. 즉 EGM은 “같은 컨텍스트에서 리뷰 흉내”를 허용하지 않고, 서브에이전트를 새 컨텍스트로 띄울 수 없는 호스트에서는 리뷰를 아예 멈추도록 설계되어 있습니다. 이 결정이 이후 호스트 지원 범위 전체를 좌우합니다.
2. 저장소 구조: 코드가 아니라 ‘프롬프트 패키지’
클론해 보면 실행 코드는 거의 없습니다. 런타임의 실체는 Markdown 지시문이고, Python은 패키징·릴리스 스크립트와 테스트에만 쓰입니다. 박스에서 wc -w로 세어 보니 스킬 7개 + 페르소나 10개 + 기준 문서 5개의 본문 합계가 20,914단어였습니다.
| 경로 | 역할 | 메모 |
|---|---|---|
skills/egm-*/SKILL.md |
사용자가 호출하는 7개 워크플로 | 각 스킬에 agents/openai.yaml, 아이콘, TEST.md·test_scenarios.yaml 동봉 |
agents/*.md |
Goldfish 리뷰어·신디사이저·부트스트랩 오케스트레이터 페르소나 10개 | Antigravity가 서브에이전트로 스캔하는 기본 디렉터리 |
resources/document_standards/ |
리뷰 기준 5종 | zoom-out, feature-spec, implementation-readiness, re-implementation, heilmeier |
plugin.json |
버전·이름·설명의 정본(canonical) | Agent Plugins 1.0.0 포맷, 현재 0.1.1 |
.claude-plugin/, .codex-plugin/, .cursor-plugin/, .plugin/ |
호스트별 호환 매니페스트 | 유닛 테스트가 정본과의 메타데이터 불일치를 거부 |
.claude-plugin/agents/*.md |
Claude용 얇은 어댑터 | tools: [Read, Grep, Glob], omitClaudeMd: true로 읽기 전용·컨텍스트 격리 |
scripts/pack_plugin.py, prepare_release.py |
런타임 ZIP 빌드·릴리스 후보 준비 | 재현 가능한 ZIP, 덮어쓰기 거부 |
tests/unit, tests/integration |
오프라인 정적 검증 / 옵트인 실호스트 검증 | 통합 테스트는 계정 모델 사용량을 소모 |
설계상 흥미로운 점은 “No harness gets a fork of the skill text”라는 원칙입니다. 호스트마다 스킬을 복제하지 않고, 공유 페르소나 파일을 어댑터가 읽게 만듭니다. Claude 어댑터 파일은 “${CLAUDE_PLUGIN_ROOT}/agents/comprehension.md를 읽고 그 지시를 따르라”는 몇 줄과 도구 제한만 담고 있습니다. 덕분에 리뷰 기준을 고치면 모든 호스트에 동시에 반영되지만, 반대로 “스킬 폴더만 복사하는” 설치 방식은 깨집니다. 문서도 이 점을 명시합니다: 스킬이 런타임에 agents/와 resources/document_standards/를 읽기 때문입니다.
3. 스킬 7개와 산출물
| 스킬 | 하는 일 | 주요 산출물 | SKILL 본문 크기(실측) |
|---|---|---|---|
egm-brainstorm |
문제 정의를 인터뷰로 좁힌 뒤 7개 렌즈의 Goldfish 스웜이 가설을 공격 | concepts_brief.md |
14,812 B |
egm-draft |
브리프/메모를 섹션 단위로 확인받으며 설계 문서로 전환 | design_draft.md → docs/designs/<feature>.md |
17,115 B |
egm-review |
5단계 Goldfish 리뷰 파이프라인 | 단계별 보고서 5개 + consolidated_review_report.md |
23,887 B |
egm-resolve |
리뷰 지적을 사람과 함께 수용/기각 처리 | 수정된 설계 문서 | 8,205 B |
egm-review-loop |
리뷰어·기준을 골라 반복 ‘샤프닝’ 루프 실행(소프트웨어 외 문서도 가능) | 반복별 보고서 | 9,846 B |
egm-bootstrap |
기존 코드베이스에 문서(README 계층 등) 생성·갱신 | 문서 트리 | 23,931 B |
egm-drift-report |
설계 문서 폴더와 현재 소스를 비교해 괴리 보고 | 드리프트 보고서 | 2,805 B |
마지막 열은 박스에서 프론트매터를 뺀 본문 바이트를 직접 잰 값입니다. 저장소의 test_skill_load_limits.py는 Antigravity의 스킬 본문 한도 24,000바이트를 넘지 않는지 검사하는데, egm-bootstrap(23,931 B)과 egm-review(23,887 B)는 한도까지 각각 69 B, 113 B밖에 남지 않았습니다. 테스트 실패 메시지가 “세부 내용은 명시적으로 읽는 reference 파일로 옮기라”고 안내하는 것도 이 압박 때문입니다. 실제로 TESTING.md의 Antigravity CLI 기록에는 “The bootstrap skill is larger than the load limit”이라는 메모가 남아 있습니다. 이 두 스킬에 기능을 더하는 PR은 구조 분리부터 요구받을 가능성이 큽니다.
4. 핵심 내부 동작: /egm-review 5단계 파이프라인
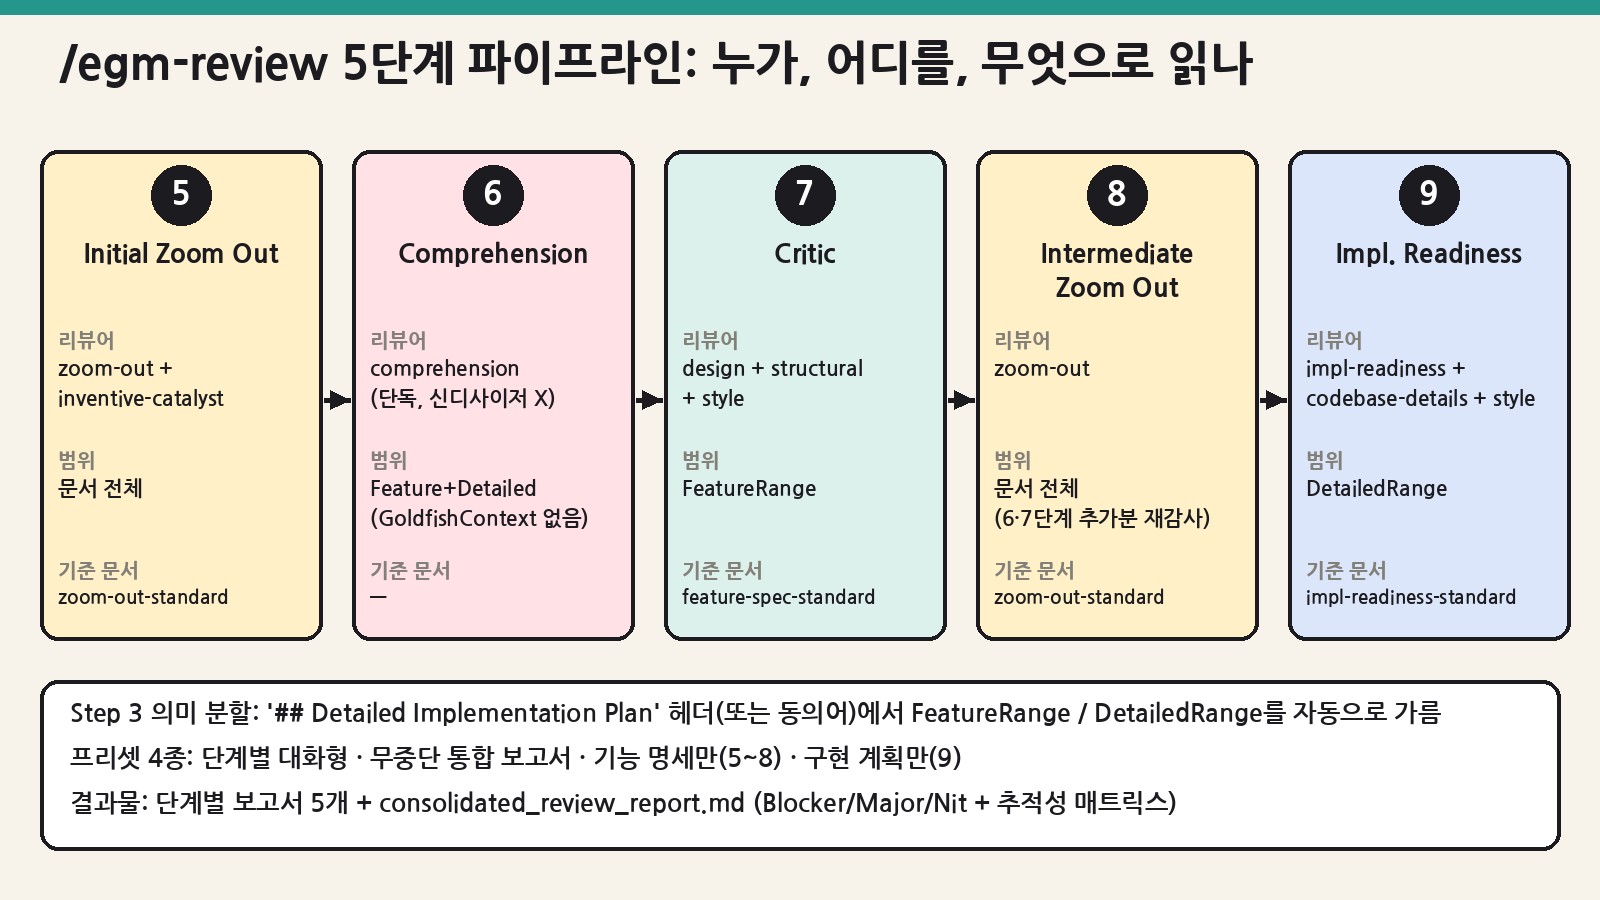
EGM의 가치는 대부분 리뷰 스킬에 몰려 있습니다. 단계 번호가 5부터 시작하는 이유는 Step 1~4가 준비 단계(입력 확인 → 프리셋 선택 → 의미 분할 → 스테이징)이기 때문입니다.
4-1. 준비 단계(Step 1~4)
- Step 1 입력:
TargetFile(필수)과GoldfishContext(리뷰어에게 줄 기준 읽기 목록, 선택)를 받습니다. 문서 안 링크는 프리셋이 정해진 뒤 한 번 해석되며, 심볼릭 링크를 따라간 실제 경로가 작업 디렉터리 안이면 자동 추가, 밖이거나 URL이면 사용자에게 묻습니다. 헤드리스 실행처럼 답할 사람이 없으면 모두 제외하고 진행합니다. URL은 일부 리뷰어가 열 수 없어서 원문을 로컬 파일로 저장해 절대 경로로 넘깁니다. - Step 2 프리셋: 대화형(단계마다 체크인) / 무중단 통합 보고서 / 기능 명세만(5~8단계) / 구현 계획만(9단계) 네 가지. 질문 도구는 “질문 정확히 1개, 단일 선택, 그 턴의 유일한 도구 호출”로 강제됩니다. 멀티 선택을 막는 이유는 5→6→7→8→9의 위상 의존을 깨지 않기 위해서라고 명시돼 있습니다.
- Step 3 의미 분할:
## Detailed Implementation Plan(또는## Implementation Plan,## Work Breakdown,## Implementation Steps) 헤더를 찾아 그 위를FeatureRange, 아래를DetailedRange로 나눕니다. 헤더가 모호하면 사용자에게 줄 범위를 확인받습니다.
4-2. 리뷰 단계(Step 5~9)
| 단계 | 리뷰어(페르소나) | 읽는 범위 | 기준 | 보고서 |
|---|---|---|---|---|
| 5 Initial Zoom Out | zoom-out, inventive-catalyst | 문서 전체 + GoldfishContext | zoom-out-standard (단순성·YAGNI·기존 코드 재사용) | zoom_out_report.md |
| 6 Comprehension | comprehension 단독(신디사이저 거치지 않음) | Feature+Detailed, GoldfishContext 없음 | 자기완결성, 정의 안 된 용어·약어 | comprehension_report.md |
| 7 Critic | design, structural, style | FeatureRange | feature-spec-standard (규모 병목, 장애 모드) | critic_report.md |
| 8 Intermediate Zoom Out | zoom-out | 문서 전체 | 6·7단계에서 덧붙은 내용의 과잉 재감사 | intermediate_zoom_out_report.md |
| 9 Implementation Readiness | implementation-readiness, codebase-details, style | DetailedRange | 파일 경로·함수 시그니처·테스트 케이스 실재 여부 | implementation_readiness_report.md |
설계 의도가 잘 보이는 지점이 두 군데 있습니다. 첫째, 6단계만 GoldfishContext를 주지 않습니다. “신입이 문서만 읽고 이해할 수 있는가”를 보려면 배경 자료를 주면 안 되기 때문입니다. 둘째, 8단계가 존재합니다. 이해도·비평 리뷰를 반영하다 보면 문서가 불어나기 쉬운데, 그 증가분을 다시 YAGNI 관점에서 쳐내는 단계를 별도로 둔 것입니다. 리뷰가 문서를 계속 키우기만 하는 흔한 실패 모드를 구조로 막으려는 시도로 읽힙니다.
무중단 프리셋에서 스폰되는 리뷰어 호출 수를 세어 보면 2+1+3+1+3 = 10회입니다. 다만 신디사이저 페르소나는 리뷰어마다 독립 인스턴스 A/B를 “선택적으로” 띄워 재현율을 높일 수 있게 되어 있어 실제 호출 수는 더 늘 수 있습니다. TESTING.md의 호스트 실행 기록에도 Antigravity CLI에서 16개, Codex에서 15개의 네이티브 리뷰어가 실행됐다고 적혀 있습니다(브레인스토밍 단계 포함 여부 등 조건은 기록별로 다름). 토큰 비용을 추정할 때는 “리뷰어 수 × (페르소나 + 기준 문서 + 대상 문서 + 컨텍스트)”가 매번 새로 들어간다는 점을 기억해야 합니다. 컨텍스트를 비우는 것이 이 도구의 핵심이니, 캐시로 아낄 수 있는 부분이 구조적으로 작습니다.
4-3. 신디사이저: 팬아웃/팬인 컴파일러
agents/synthesizer.md는 리뷰어들을 병렬로 띄우고 결과를 🔴 Blocker / 🟡 Major / 🟢 Nit로 분류·중복 제거해 Markdown 보고서로 씁니다. 눈여겨볼 규칙은 실패 처리입니다. 타임아웃되거나 보고서를 안 낸 리뷰어는 한 번 재시도하고, 또 실패하면 상태를 not run으로 기록하며 “지적 0건인 리뷰어로 세지 말라”고 못 박습니다. 무중단 보고서는 원래 지적과 통합 액션 아이템을 잇는 추적성 매트릭스(Traceability Matrix)도 만듭니다. 호스트가 서브에이전트 중첩을 못 하면 신디사이저 없이 직접 디스패치로 바꿉니다.
4-4. 브레인스토밍 7렌즈
| 렌즈 | 던지는 질문(요지) |
|---|---|
| Contrarian / YAGNI | 이 기능이 꼭 필요한가? 기존 라이브러리·API로 90%를 풀 수 없나? |
| Cost, Quota & Token Economics | 피크 QPS, 메모리, DB 부하, LLM 토큰 예산은? 쿼터 한도에 걸리지 않나? |
| UX & Developer Ergonomics | API/CLI가 생태계 관례와 맞나? 에러 메시지가 실행 가능한가? |
| Migration & Backward Compatibility | 기존 데이터·클라이언트는 어떻게 이전하나? 중간 롤백은? |
| Observability & SRE | 새벽 3시 장애를 온콜이 추적할 수 있나? |
| Long-Term Tech Debt | 2년 뒤 유지보수를 괴롭힐 결합·취약한 상태 머신은 없나? |
| Inventive Catalyst (TRIZ) | 당연하게 받아들인 트레이드오프를 ‘모순’으로 보고 해소할 변환은 없나? (v0.1.1에서 추가된 리뷰어) |
스킬 지시문에는 “칭찬 금지(No Glazing)”, “비판 먼저(Critique First)”, “brilliant·great·perfect 같은 형용사 금지”, “사과 금지” 같은 반(反)아첨 규칙이 명시돼 있습니다. LLM 리뷰가 동의 쪽으로 기우는 문제를 프롬프트 수준에서 강하게 누르는 설계입니다.
5. 호스트 어댑터: 같은 문장, 다른 도구
스킬은 “서브에이전트를 띄워라, 페르소나는 X”라고만 말하고, 각 호스트가 이를 자기 도구로 매핑합니다.
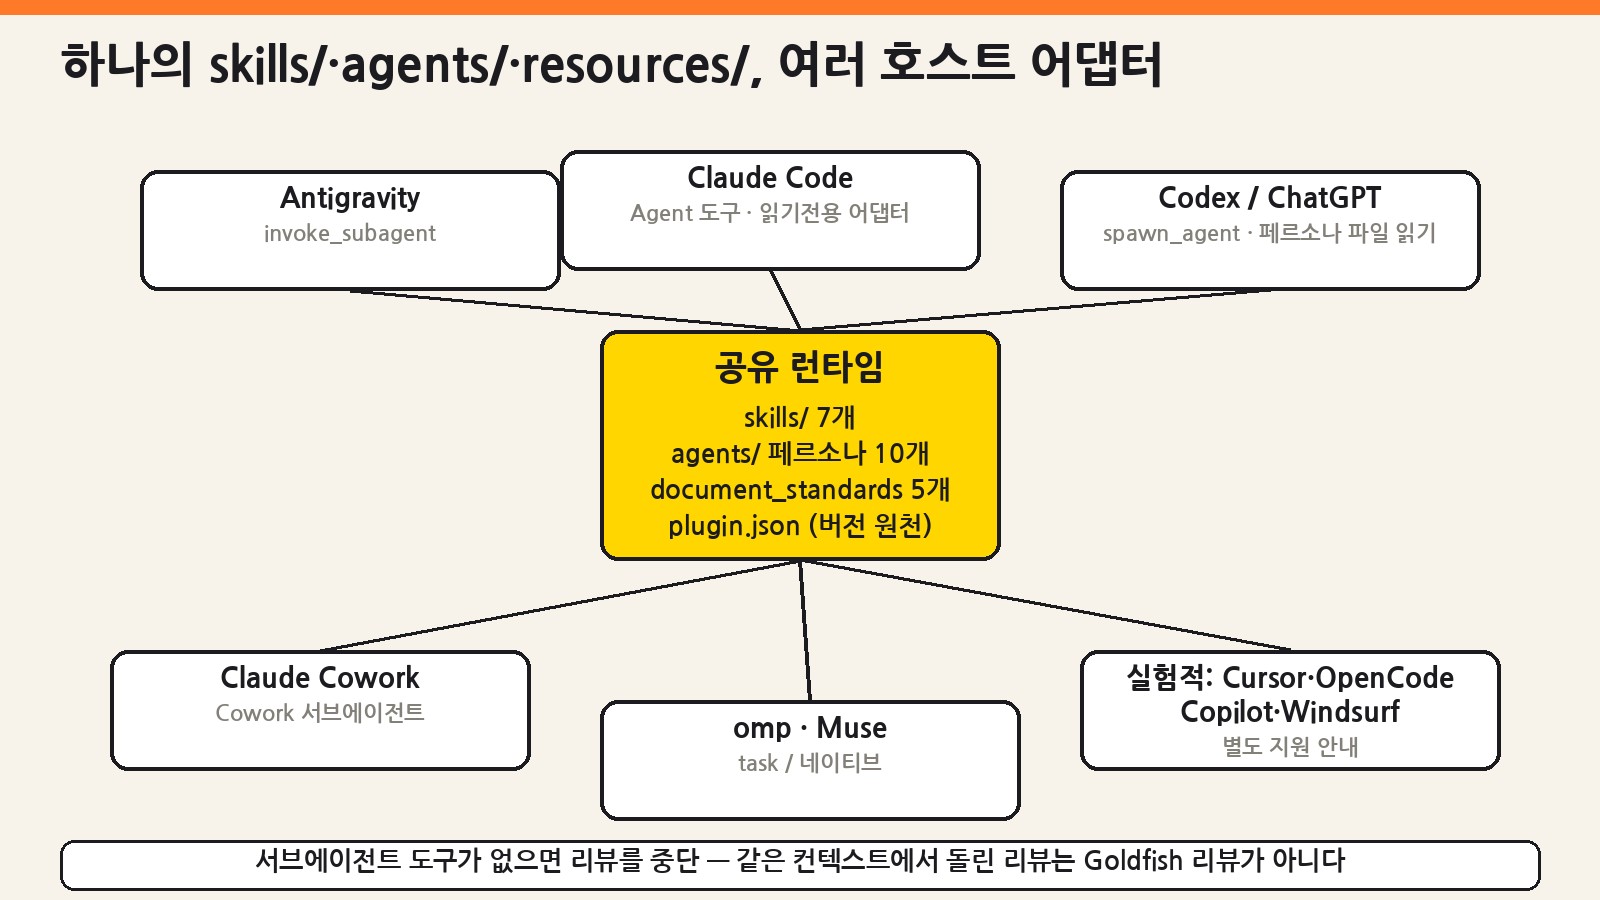
| 호스트 | 서브에이전트 도구 | 이름 붙은 페르소나 | 중첩 | 비고 |
|---|---|---|---|---|
| Antigravity | invoke_subagent |
예 | 예 | 독립 실행형 Antigravity IDE는 이 도구가 없어 미지원 |
| Claude Code | Agent(Task) 도구 | 예 | 기본 최대 3단계 | 어댑터가 Read/Grep/Glob만 허용, CLAUDE.md 생략 |
| Claude Cowork | Cowork 서브에이전트 | 예 | Cowork 내부 | 훅 해당 없음 |
| Codex | 네이티브 spawn/wait | 아니오 | 런타임 감지, 직접 디스패치 폴백 | 범용 서브에이전트가 페르소나 파일을 먼저 읽음 |
| ChatGPT | Work 세션이 노출할 때의 spawn/wait | 아니오 | 런타임 감지 | 클라우드 지원은 부분적 |
| omp | task |
예 | 예 | Claude 호환 매니페스트로 폴백 |
| Muse | 네이티브(스키마 확인) | 1.4.14에서 이름 스폰 거부, 범용 폴백 검증 | 런타임 감지 | 어댑터 10개를 에이전트로 가져옴 |
문서가 솔직하게 짚는 한계도 있습니다. Codex의 fork_context: false 같은 옵션은 부모 대화 턴을 격리할 뿐, 프로젝트·사용자 지시 파일(AGENTS.md 등)이 빠진다는 보장은 아니라는 점입니다. 실제로 이슈 #237은 Antigravity CLI 1.4.0에서 프로젝트 AGENTS.md·GEMINI.md가 주입된다고 보고했습니다. 금붕어가 완전히 백지는 아니라는 뜻이고, 그래서 문서는 “금붕어가 도전해야 할 가정은 지시 파일이 아니라 명시적 리뷰 기준으로 적으라”고 권합니다.
6. 설치와 첫 실행
| 호스트 | 설치 명령 |
|---|---|
| Claude Code | claude plugin marketplace add google/elephant-goldfish-model → claude plugin install egm@egm |
| Codex CLI | codex plugin marketplace add google/elephant-goldfish-model → codex plugin add egm@egm |
| Antigravity CLI | agy plugin install https://github.com/google/elephant-goldfish-model |
| omp | omp plugin marketplace add google/elephant-goldfish-model && omp plugin install egm@egm |
| ChatGPT·Codex 데스크톱 | 공개된 EGM 플러그인 목록에서 설치(데스크톱 전용 리스팅) |
설치 후 새 세션을 열고, 기존 문서부터 리뷰해 보는 것이 가장 싸게 감을 잡는 방법입니다. Claude Code·Antigravity에서는 /egm: 접두어가 붙습니다(agy CLI 1.4.8은 접두어 자동 완성이 안 된다는 이슈 #196이 README에 언급됨).
/egm:egm-review docs/designs/webhooks.md      # 기존 설계 문서 리뷰
/egm:egm-drift-report docs/designs/           # 문서 vs 현재 코드 괴리
/egm:egm-brainstorm Add webhook delivery to this project.
/egm:egm-draft
/egm:egm-review design_draft.md
산출물 위치는 프롬프트나 CLAUDE.md/AGENTS.md에 EGM artifact directory: .dev/docs 한 줄로 바꿀 수 있습니다. 지시 파일에 적은 경로가 작업 디렉터리 밖으로 풀리면 쓰기 전에 확인을 받고, 헤드리스라 답이 없으면 작업 디렉터리에 씁니다.
7. 박스 실측: 모델 없이 검증할 수 있는 것
EGM의 본체인 Goldfish 리뷰는 인증된 에이전트 호스트와 모델 사용량이 필요해 이번에는 돌리지 않았습니다. 대신 저장소가 제공하는 오프라인 검증 경로를 박스(Linux, Python 3.13.5, Node v24.22.1) CPU에서 그대로 실행했습니다. 작업 디렉터리 안 가상환경(.venv)에만 pytest==9.0.3, pyyaml==6.0.3을 설치했습니다.
git clone --depth 50 https://github.com/google/elephant-goldfish-model repo && cd repo
python3 -m venv .venv && . .venv/bin/activate
pip install "pip>=25.1" && pip install --group test
pytest tests/unit
# 382 passed, 2 skipped in 3.77s

python scripts/prepare_release.py --tag v0.1.1 --commit "$(git rev-parse HEAD)" --output ../cand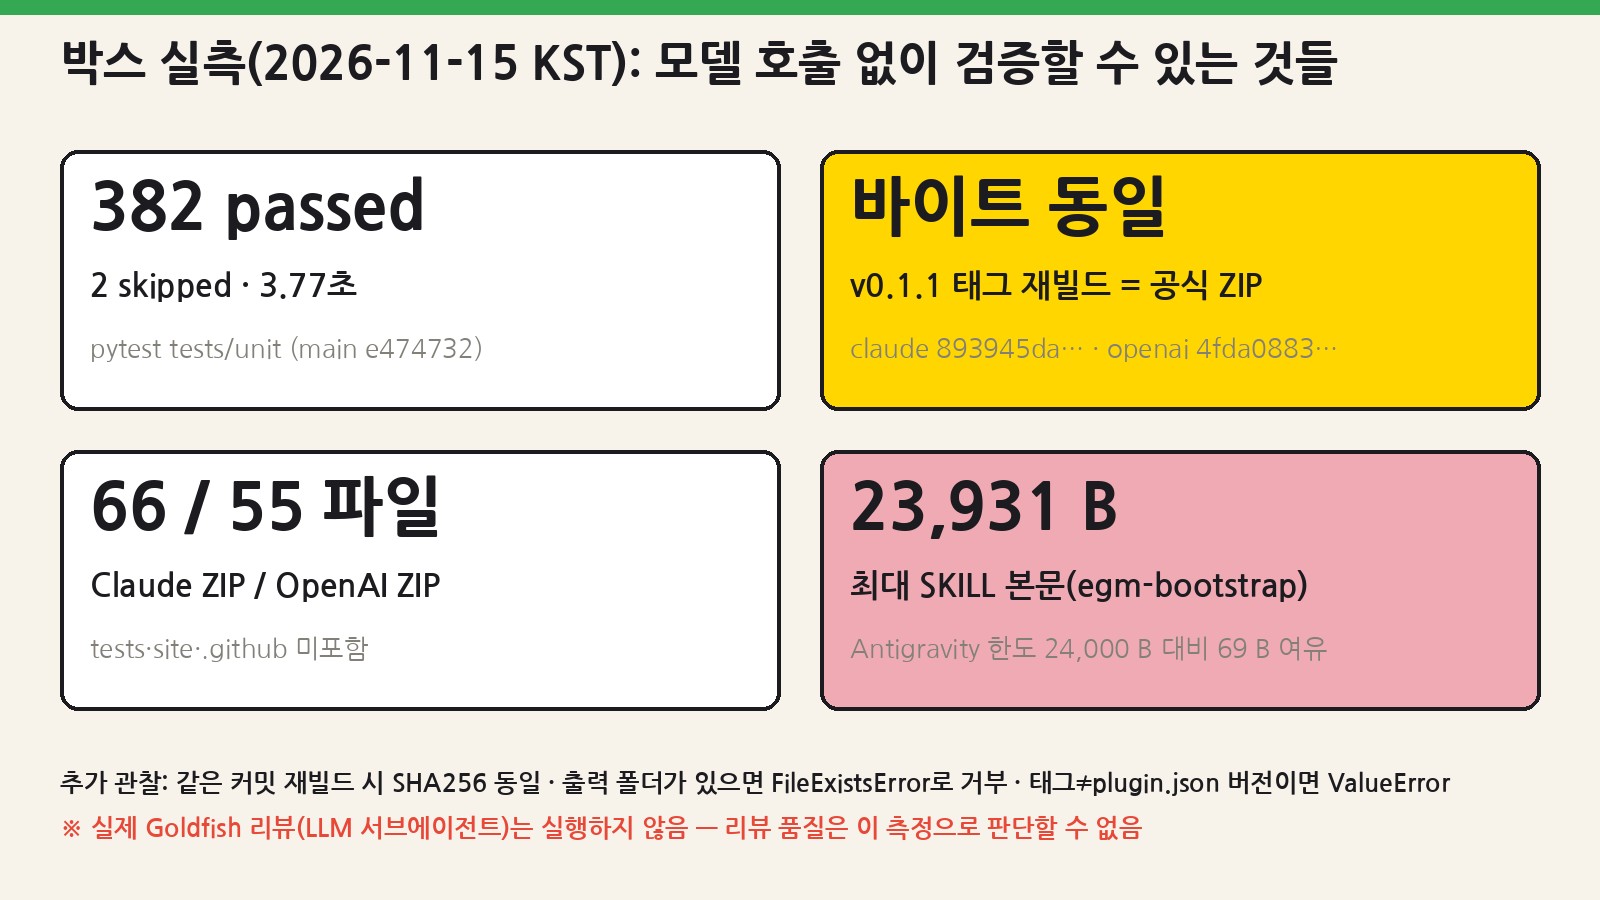
| 실험 | 결과(실측) | 해석 |
|---|---|---|
유닛 테스트 (main e474732) |
382 passed, 2 skipped, 3.77초 (wall 4.0초) | 스킵 2건은 Copilot·Cursor 네이티브 오프라인 프로브(환경변수 필요). 프론트매터·링크·매니페스트 일관성·워크플로 게이트 검증 |
v0.1.1 태그(dea7761)를 worktree로 체크아웃해 재빌드 |
SHA256이 공식 릴리스 SHA256SUMS와 바이트 단위 동일 (claude 893945da…, openai 4fda0883…) |
릴리스 ZIP이 소스에서 재현 가능. 다운로드한 공식 ZIP도 sha256sum -c OK |
| 같은 커밋으로 두 번 빌드 | 두 SHA256SUMS 동일 | ZIP 타임스탬프 등이 고정된 결정적 빌드 |
| 기존 출력 폴더에 재빌드 | FileExistsError로 거부 |
“같은 태그 아래 산출물을 바꾸지 말라”는 정책을 스크립트가 강제 |
태그 v0.2.0으로 빌드 시도 |
ValueError: plugin.json: version must match v0.2.0 |
매니페스트 버전 불일치 차단 |
| 공식 ZIP 내용 | Claude 66개 파일(270,552 B 비압축), OpenAI 55개(250,405 B). tests/site/.github 경로 0건 | 차이는 .claude-plugin/ 어댑터 10개·아이콘·매니페스트 vs .codex-plugin/plugin.json 1개 |
정리하면, “패키지가 무엇을 담고 어떻게 배포되는가”의 공급망 측면은 꽤 단단합니다. 재현 가능한 ZIP, 체크섬, GitHub Actions 증명(attestation) 검증 절차까지 문서화돼 있습니다. 반면 이 측정은 리뷰 품질에 대해 아무것도 말해 주지 않습니다. 생성된 릴리스 노트 자체도 “Live installation, workflow execution, reviewer isolation … are not established by this build”라고 적고 있고, 정확한 설치 번들의 네이티브 종단 검증은 이슈 #60으로 아직 열려 있습니다.
8. 비슷한 도구와 비교
아래 표는 각 프로젝트의 공개 설명을 바탕으로 한 성격 비교이며, 같은 조건에서 성능을 잰 것은 아닙니다.
| 도구 | 초점 | 리뷰 방식 | 배포 형태 | EGM과의 차이 |
|---|---|---|---|---|
| EGM | 설계 문서 작성 + 사전 리뷰 | 새 컨텍스트 서브에이전트 다수, 단계·기준 문서 고정 | 멀티 호스트 플러그인(Markdown) | — |
| GitHub Spec Kit | 스펙 → 계획 → 작업 분해 → 구현 | 별도 격리 리뷰어 개념은 중심이 아님 | CLI + 템플릿 | EGM은 ‘작성’보다 ‘격리된 검토’에 무게 |
| Kiro(AWS) 스펙 모드 | IDE 안에서 요구사항·설계·작업 문서 생성 | IDE 에이전트 중심 | 상용 IDE | EGM은 IDE 중립·오픈소스 |
| BMAD-METHOD | 분석가·PM·아키텍트 등 역할 페르소나 기반 애자일 흐름 | 역할 분담형 에이전트 | 오픈소스 프롬프트 프레임워크 | EGM은 ‘맥락 차단’을 리뷰의 필수 조건으로 강제 |
| alibaba/open-code-review 등 AI 코드 리뷰 | 이미 작성된 diff 리뷰 | 결정적 파이프라인 + LLM | CLI/CI | EGM은 코드 이전 단계(설계)를 다룸 — 상호 보완 |
9. 트레이드오프와 주의점
| 쟁점 | 장점 | 비용·리스크 |
|---|---|---|
| 컨텍스트 격리 | 확증 편향을 구조적으로 줄임 | 리뷰어마다 문서·기준을 새로 읽어 토큰 비용 큼, 호스트가 서브에이전트 미지원이면 사용 불가 |
| 5단계 고정 파이프라인 | 단계별 책임이 분명하고 재현 가능 | 작은 변경에는 과함 — FAQ도 “작고 잘 이해된 변경에는 보상이 없을 수 있다”고 인정 |
| Markdown 런타임 | 호스트 간 이식, 리뷰 기준 수정이 쉬움 | 동작이 모델·호스트 버전에 의존, 결정적 보장이 없음(LLM 비결정성) |
| 쓰기 경계 | 1~4단계는 명세·리뷰 산출물만 쓰도록 규정 | 아키텍처 문서 스스로 “This is a convention, and nothing enforces it”이라고 명시 |
| 격리의 실제 범위 | 부모 턴 격리는 테스트로 검증된 호스트가 있음 | 지시 파일(AGENTS.md 등) 주입은 호스트별로 남을 수 있음(#237) |
| 버전 성숙도 | 릴리스·증명 절차가 정돈됨 | v0.1.x, pre-1.0 — 스킬 이름·파라미터·출력 경로·보고서 포맷 계약은 1.0 전까지 바뀔 수 있음 |
| 데이터 처리 | 자체 서버·텔레메트리·MCP 서버 없음(privacy 문서) | 입력 파일은 사용자가 쓰는 호스트·모델 제공사 정책으로 처리됨 — 리뷰에 넘기는 파일을 최소화해야 |
10. 도입 체크리스트(실무자용)
- 호스트 확인: 쓰는 환경이 새 컨텍스트 서브에이전트를 실제로 노출하는지 먼저 확인하세요. 제품 이름이 아니라 세션에서 보이는 도구 기준입니다.
- 비용 상한: 무중단 리뷰 1회는 최소 10개 리뷰어 호출입니다. 팀 단위로 쓰면 “중요한 변경에만” 규칙을 먼저 정하세요. FAQ도 우선순위를 두라고 권합니다.
- 문서 형식: 구현 계획 섹션 헤더를
## Detailed Implementation Plan으로 통일하면 의미 분할이 자동으로 되고 9단계 리뷰 품질이 안정됩니다. - 지시 파일 정리: 금붕어가 의심해야 할 가정이
AGENTS.md/CLAUDE.md에 들어가 있으면 격리 효과가 줄어듭니다. 리뷰 기준으로 옮기세요. - 설치 단위: 플러그인 전체를 설치하세요.
skills/만 복사하면 런타임에 페르소나·기준 파일을 못 찾습니다. - 공급망: 릴리스 ZIP을 쓸 때는
sha256sum -c SHA256SUMS와gh attestation verify를 거치세요. 이번 실측처럼 태그에서 직접 재빌드해 대조하는 것도 가능합니다. - 측정: EGM 워크플로를 끝냈다는 사실 자체가 생산성 향상의 증거는 아닙니다(FAQ). 총 소요 시간, 유용한 지적 수, 재작업량을 자기 과제로 비교하세요.
마무리
EGM은 “더 똑똑한 리뷰 모델”이 아니라 “리뷰어가 무엇을 모르게 할 것인가”를 설계한 도구입니다. 코드는 거의 없고 지시문이 2만 단어 넘게 쌓여 있지만, 그 지시문을 여러 호스트에 포크 없이 배포하는 매니페스트 체계와 재현 가능한 릴리스는 꽤 공들여 만들어져 있습니다. 반대로 리뷰 품질과 격리 수준은 결국 호스트와 모델에 달려 있고, 저장소도 그 한계를 숨기지 않습니다. 설계 문서 문화가 이미 있는 팀이라면 기존 문서에 /egm-review나 /egm-drift-report를 한 번 돌려 보는 것부터 시작해, 지적의 질과 비용을 직접 재 보는 것을 권합니다.