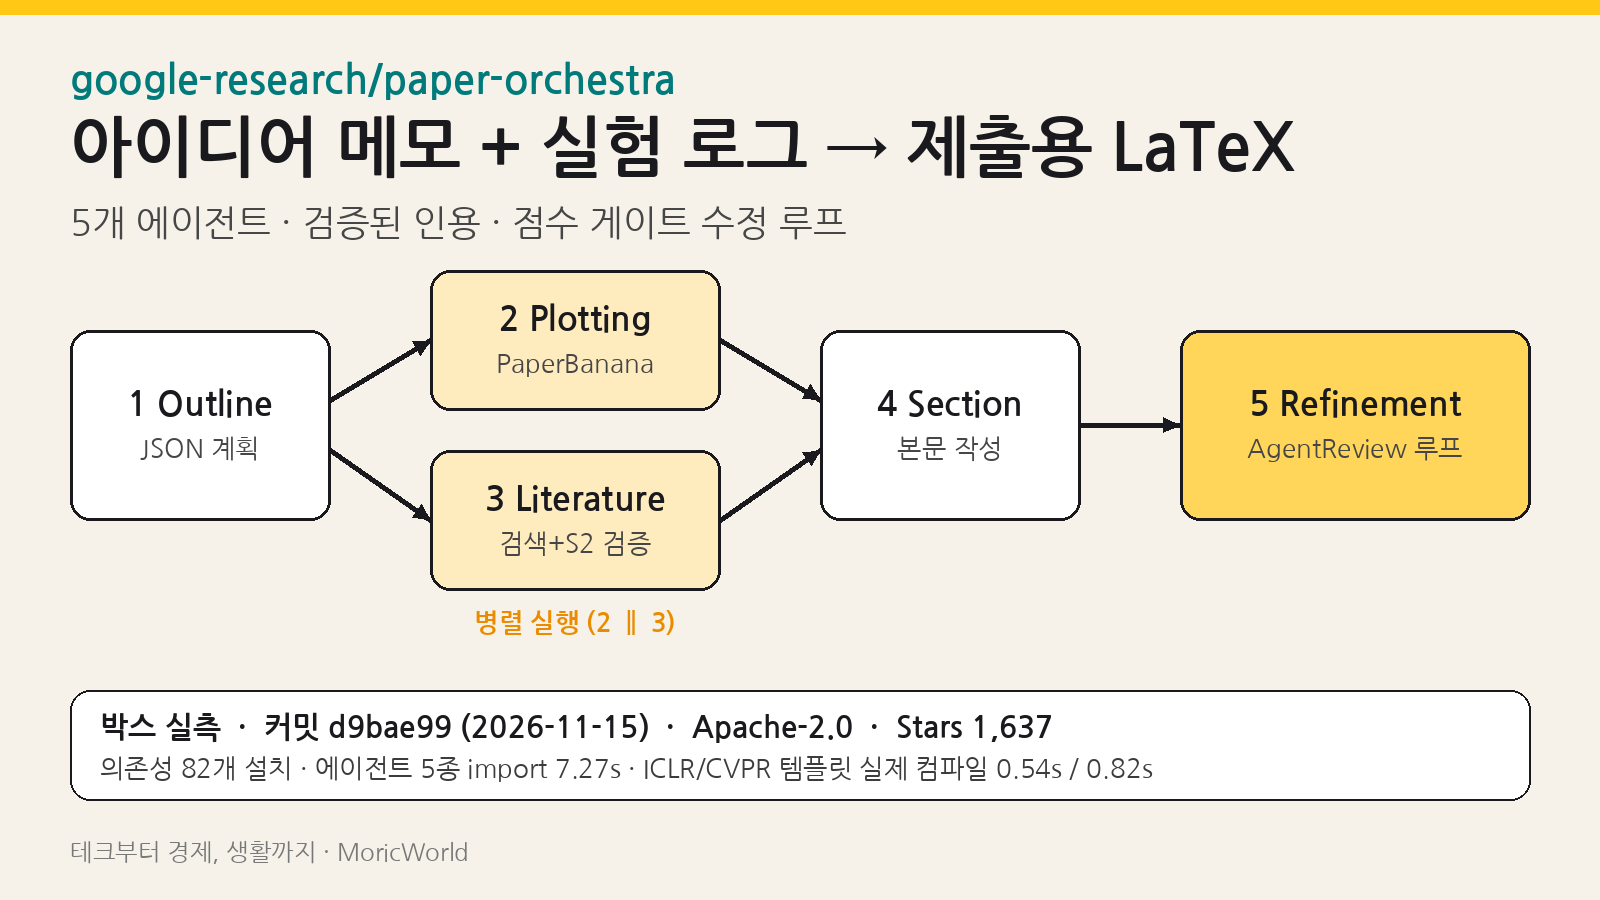
한 줄 요약: google-research/paper-orchestra는 Google Cloud AI Research 팀이 공개한 “연구 아이디어 메모와 실험 로그를 받아 학회 제출용 LaTeX 원고와 PDF를 만드는” 멀티 에이전트 파이프라인입니다. 겉으로는 “AI가 논문을 써 준다”는 이야기지만, 코드를 열어 보면 핵심은 글쓰기 자체보다 두 개의 게이트에 있습니다. 하나는 LLM이 찾아온 인용을 Semantic Scholar로 대조해 실존하는 논문만 남기는 인용 검증 게이트, 다른 하나는 모의 심사 점수가 오를 때만 수정을 받아들이고 떨어지면 즉시 되돌리는 점수 게이트입니다. 이 글은 두 게이트를 소스 기준으로 해부하고, 박스에 직접 설치해 템플릿 컴파일·인용 매칭·수락/되돌림 로직·플롯 코드 실행기를 실측한 결과를 정리합니다.
테크부터 경제, 생활까지. 복잡한 소식을 쉽게 풀어봅니다.
1. 지금 무엇이 공개돼 있나 — 버전·라이선스·숫자부터
숫자는 2026-11-17 12:05 KST 전후 GitHub API 조회와 박스 clone 기준입니다. 이 저장소에는 릴리스나 태그가 없기 때문에, 이 글의 “버전”은 main 브랜치의 최신 커밋 d9bae99를 가리킵니다.
| 항목 | 값 | 비고 |
|---|---|---|
| 저장소 | google-research/paper-orchestra | GitHub 생성 2026-05-02 03:07 KST, 첫 커밋 “init the repo”는 2026-05-07 |
| 라이선스 | Apache-2.0 | 소스 파일마다 Google LLC 저작권 헤더가 있고, README에 “Google 공식 지원 제품이 아님”이라는 면책 문구가 있음 |
| 스타 / 포크 | 1,637 / 246 | 열린 이슈+PR 33개. 오늘 GitHub Trending 전체(daily) 목록에서 “313 stars today”로 노출 |
| 기준 커밋 | d9bae99 (2026-11-16 03:08 KST 병합) | 전체 커밋 8개. 11/15(PST)에 외부 기여자 PR 3건이 연달아 병합됨 |
| 최근 병합 PR | #2 · #3 · #4 | 쓰는 제공자 키만 요구하도록 수정, requirements 누락분 추가, LaTeX 프롬프트 문자열의 잘못된 escape 수정 |
| 코드 규모 | Python 파일 기준 약 9,000줄 | 가장 큰 파일은 frontend/app.py(1,082줄), autoraters/citation_f1.py(862줄), utils/paper_banana_utils.py(681줄) |
| 논문 | arXiv 2604.05018 | 저자 Yiwen Song, Yale Song, Tomas Pfister, Jinsung Yoon (Google Cloud AI Research) |
| 데이터셋 | 미포함 | 평가용 PaperWritingBench는 “추후 별도 공개”라고만 되어 있음 |
왜 하필 지금 트렌딩에 올랐을까요. 논문은 봄에 나왔지만, 11월 15일(PST)에 병합된 PR 3건이 “README대로 설치하면 실제로 돌아가는 상태”를 만들어 준 시점과 겹칩니다. 그 전에는 쓰지 않는 제공자의 API 키까지 요구하거나 requirements에 빠진 패키지가 있는 등 설치 단계의 마찰이 있었습니다. 시점이 겹친다는 것은 커밋 기록에서 확인되는 사실이지만, 이것이 트렌딩의 원인이라는 부분은 해석입니다.
2. 문제 정의: “논문 쓰기”를 함수로 만든다
논문은 이 작업을 P = (P_tex, P_pdf) = W(I, E, T, G, F)라는 함수로 정의합니다. 핵심은 실험을 돌리는 에이전트(AI Scientist 계열)와 달리 글쓰기만 분리한 독립형 작성기라는 점입니다. 실험은 사람이 이미 했다고 보고, 그 결과물을 원고로 바꾸는 단계만 맡습니다.
| 입력 | 기호 | 저장소에서의 실체 | 실무 의미 |
|---|---|---|---|
| 아이디어 요약 | I | raw_materials/idea_sparse.md(기본값) 또는 idea_dense.md |
Sparse는 핵심 아이디어만, Dense는 수식·정의까지 담은 버전. 논문의 기본 평가는 Sparse 기준 |
| 실험 로그 | E | raw_materials/experimental_log.md |
베이스라인·데이터셋·지표·표 데이터. 본문 표의 숫자는 여기서만 가져오도록 설계 |
| LaTeX 템플릿 | T | templates/<venue>/template.tex + sty/bst |
CVPR 2025(2단), ICLR 2025(1단) 두 개가 기본 제공. 폴더를 추가하면 다른 학회도 지원 |
| 학회 가이드라인 | G | templates/<venue>/guidelines.md |
익명성·분량·형식 규칙을 마크다운으로 정리한 문서(CVPR 158줄, ICLR 96줄) |
| 그림 | F | raw_materials/figures/(선택) |
없으면 --use_plotting true로 플로팅 에이전트가 직접 생성. 둘 다 없으면 CLI가 경고를 출력 |
3. 아키텍처: 5개 에이전트, 2개는 병렬
methods/paper_writer_with_plotting.py의 write_single_paper()가 전체 오케스트레이터입니다. 다섯 단계를 순서대로 호출하지만, 2단계(플로팅)와 3단계(문헌 검토)는 서로 의존하지 않기 때문에 ThreadPoolExecutor로 동시에 돌립니다. 전체는 max_n_tries = 3인 바깥 재시도 루프로 감싸여 있어서, 어느 단계에서든 예외가 나면 처음부터 다시 시작합니다.
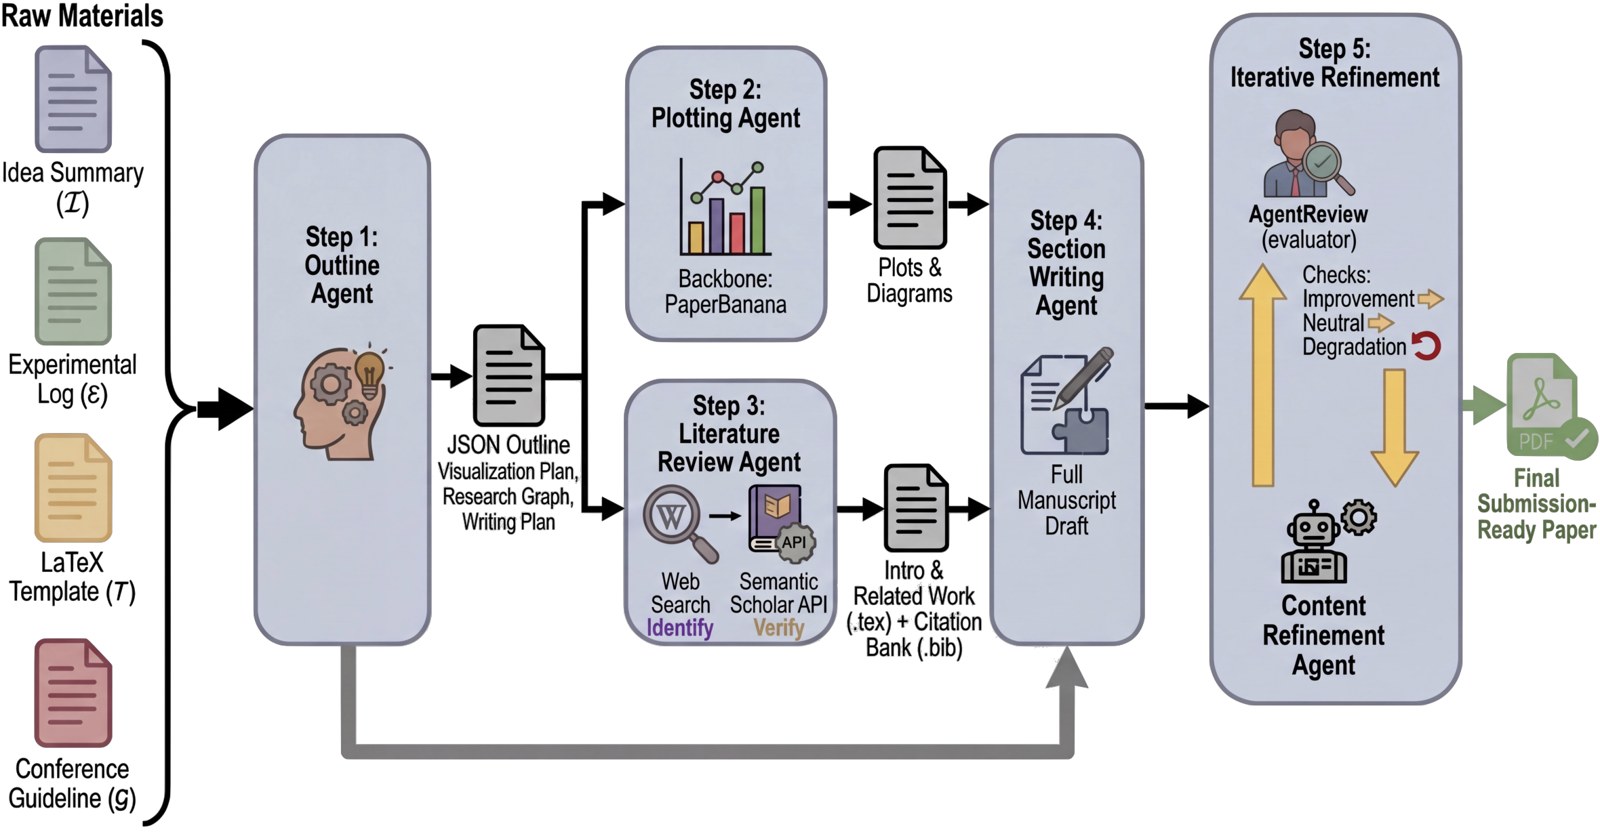
| 단계 | 클래스 / 파일 | 주요 출력 | 모델·동시성 | 설계 포인트 |
|---|---|---|---|---|
| 1 Outline | OutlineAgent / outline_agent.py |
outline.json |
writer 모델(기본 gemini-3.1-pro-preview) | 시각화 계획(plot_type·data_source·aspect_ratio), 문헌 검색 전략, 섹션별 계획과 citation_hints를 하나의 JSON으로 묶음 |
| 2 Plotting | PlottingAgent / plotting_agent.py |
figures/*.jpg, info.json(캡션) |
그림 최대 5개 동시, 비평 최대 3라운드, 이미지 모델 gemini-3-pro-image-preview | PaperBanana 방식: plot이면 matplotlib 코드 생성 후 실행, diagram이면 이미지 모델로 생성. 이후 VLM 비평가가 “No changes needed”라고 할 때까지 반복 |
| 3 Literature | HybridLiteratureAgent / literature_review_agent.py |
references.bib, citation_map.json, 서론·관련 연구가 채워진 template |
Google Search 그라운딩 10 workers, S2 확정은 순차 처리(max_workers=3 인자는 현재 로그 표시에만 쓰임) |
LLM이 찾고 Semantic Scholar가 확인하는 2단 구조. 확인된 논문 수의 90% 이상을 인용하도록 강제 |
| 4 Section | SectionWritingAgent / section_writing_agent.py |
raw_draft_paper.tex |
call_llm_with_images(그림을 함께 입력) |
초록·방법·실험·결론 작성. 표의 숫자는 실험 로그에서 추출. 이 단계만 OpenAI/Gemini 라우터를 거침 |
| 5 Refinement | ContentRefinementAgent / content_refinement_agent.py |
final_paper.pdf, worklog JSON |
reflection 모델, 최대 3회 + 포맷 루프 1회 | PDF를 컴파일해 AgentReview 방식 모의 심사 → 점수 게이트로 수락/되돌림 → VLM이 페이지 이미지로 레이아웃 점검 |
논문 부록에 따르면 원고 한 편에 LLM 호출이 약 60~70회, 평균 39.6분이 걸립니다(AI Scientist-v2는 약 40~45회, 35.1분). 호출 수가 더 많은데도 시간이 비슷한 이유를 논문은 “후보 탐색은 10개 병렬, Semantic Scholar 검증은 초당 1건으로 순차 처리”하는 분리 설계에서 찾습니다.
4. 저장소 구조 — 어디를 읽어야 하나
| 경로 | 줄 수 | 역할 | 읽을 가치 |
|---|---|---|---|
paper_writing_cli.py |
176 | 단일 원고 CLI. 플로팅 여부에 따라 두 writer 중 하나를 고름 | 인자 기본값(모델명·컷오프)을 확인하는 곳 |
methods/paper_writer*.py |
443 / 520 | 오케스트레이터 + 배치 실행(ProcessPoolExecutor, 기본 4 workers, 로그 기반 재개) |
★ 전체 흐름과 재시도 정책 |
methods/agents/ |
60~607 | 에이전트 5종 | ★ literature(607)와 content_refinement(593)이 핵심 |
methods/prompts/ |
47~199 | 에이전트별 시스템 프롬프트 | 보상 해킹 방지 규칙이 여기 들어 있음 |
utils/ |
54~681 | Gemini/OpenAI 래퍼, S2 검색, PDF 컴파일·렌더, PaperBanana 구현 | pdf_utils의 compile_latex, scholar_utils의 매칭 임계값 |
autoraters/ |
211~862 | Citation F1, 문헌 검토 품질(0~100), SxS 비교 2종, AgentReview 심사 | 자체 평가 파이프라인을 만들 때 재사용 가능 |
frontend/ |
1,082 + 72 | Streamlit 데모. 백그라운드로 CLI를 띄우고, 끝나면 SMTP 메일로 결과를 보낼 수 있음 | 사내 데모용으로 쓸 수 있지만 운영용은 아님 |
templates/ |
– | cvpr2025, iclr2025 | 템플릿 폴더 하나 = 지원 학회 하나 |
5. 게이트 ①: 인용은 “찾기”보다 “검증”
LLM 논문 작성기에서 가장 흔한 사고는 존재하지 않는 논문을 인용하는 것입니다. PaperOrchestra는 이 문제를 프롬프트로 해결하려 하지 않고, LLM의 출력을 외부 데이터베이스와 대조하는 구조로 막습니다.
| 규칙 | 코드상 값 | 위치 | 효과·트레이드오프 |
|---|---|---|---|
| 검색 작업 종류 | exploration(탐색) / targeted(지정) | _collect_search_tasks |
citation_hints에 이름이 오른 필수 인용(베이스라인·데이터셋 등)은 지정형으로 따로 찾음 |
| 생성 온도 | 지정 0.1 / 탐색 0.4 | _discover_candidates |
정확한 제목이 필요한 지정형은 보수적으로, 탐색형은 다양하게 |
| 후보 탐색 동시성 | ThreadPool 10 | _execute_tasks_in_parallel |
Google Search 그라운딩 호출은 병렬로 처리해 시간을 줄임 |
| S2 조회 | /paper/search, limit 3, timeout 5s |
s2_title_search |
상위 3건만 보므로 제목이 흔한 논문은 놓칠 수 있음 |
| 매칭 임계값 | fuzz.ratio > 70, 연도 일치 시 +10 |
같은 함수 | 오탈자는 허용하되 다른 논문은 거름(아래 실측) |
| 시간 컷오프 | --research_cutoff(기본: 현재 연-월) |
is_date_valid, _is_paper_allowed |
벤치마크에서 원 논문 이후의 연구를 인용하는 “미래 누출”을 막음 |
| 인용 의무 | 검증된 논문의 90% 이상 인용 | min_cite_paper_count=int(len*0.9) |
찾아 놓고 쓰지 않는 문제는 줄지만, 억지 인용(padding)이 생길 여지도 있음 |
| BibTeX 키 | 성+연도+제목 앞 두 단어, 충돌 시 a·b 접미사 |
_generate_key, _generate_bibtex |
사람이 읽기 쉬운 키. 연도가 없으면 “2024”로 채움 |
박스 실측 — 퍼지 매칭. 박스에서는 Semantic Scholar 무인증 호출이 모두 429로 막혀서(7장 참고), requests.get만 실제 S2 응답과 같은 형태의 데이터로 바꾸고 s2_title_search() 본문은 그대로 실행했습니다. 후보는 “Attention Is All You Need”(2017)와 “Attention Is All You Need In Speech Separation”(2020) 두 건입니다.
| LLM이 준 제목 | 연도 힌트 | 점수 (후보1, 후보2) | 결과 |
|---|---|---|---|
| Attention Is All You Need | 2017 | 110, 70 | 후보1 채택 |
| Attention is all u need (오탈자) | 2017 | 106, 67 | 후보1 채택 — 오탈자 허용 |
| Attention Is All You Need | 없음 | 100, 70 | 후보1 채택 (70은 “초과” 조건에 걸려 탈락) |
| Transformers are all you want (환각성 제목) | 2017 | 62, 40 | None — 폐기 |
| Attention mechanisms survey | 없음 | 58, 47 | None — 폐기 |
| Attention Is All You Need (2025년 논문으로 응답, 컷오프 2024-11) | 2025 | – | None — 컷오프로 폐기 |
박스 실측 — 컷오프 경계. 같은 저장소 안에 컷오프 판정 함수가 두 개 있는데, 경계에서 서로 다르게 동작합니다. S2 검색 단계의 is_date_valid는 “컷오프 월 1일보다 이전”만 통과시키고, 확정 단계의 _is_paper_allowed는 아래처럼 판정합니다(컷오프 2024-11).
| S2 메타데이터 | _is_paper_allowed |
해석 |
|---|---|---|
| publicationDate 2024-10-31 | True | 정상 |
| publicationDate 2024-11-01 | True | 일(day) 기본값이 1이라 컷오프 당일까지 허용(검색 단계에서는 이미 탈락) |
| publicationDate 2024-11-15 | False | 정상 |
| year 2024 (날짜 없음) | True | 연도만 있으면 그해 12월 논문도 통과할 수 있음 |
| year 2025 | False | 정상 |
| 날짜·연도 모두 없음 | True | 메타데이터가 비어 있으면 통과시키는 관대한 기본값 |
벤치마크 재현에서는 경계 월에 나온 논문 몇 편이 결과를 바꿀 수 있습니다. 엄격한 누출 통제가 필요하다면 컷오프를 한 달 앞당겨 주는 편이 안전합니다.
6. 게이트 ②: 수정은 점수가 허락할 때만 남는다
Content Refinement Agent의 동작은 이렇습니다. 초안 PDF를 컴파일하고, AgentReview 루브릭(Originality·Quality·Clarity·Significance·Soundness·Presentation·Contribution 각 1~4점, Overall 1~10점, Confidence)으로 모의 심사를 받습니다. 그다음 PDF와 리뷰를 함께 LLM에 넘겨 수정본 LaTeX를 받고, 다시 컴파일해서 재심사합니다.
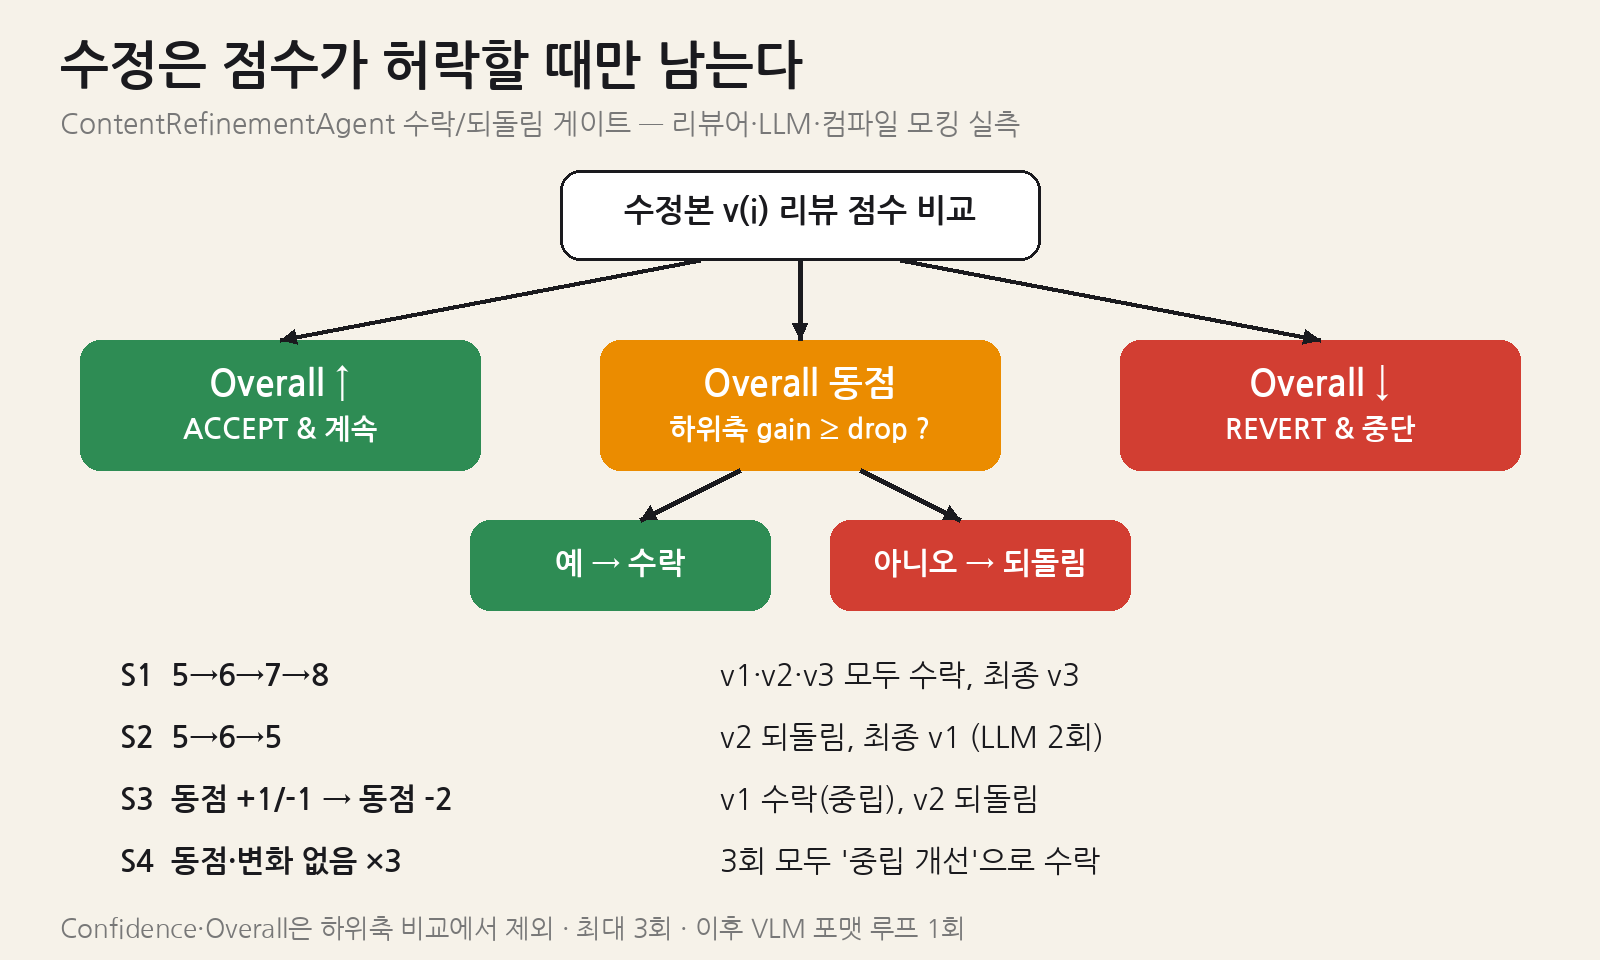
박스에서는 리뷰어·LLM·컴파일러만 가짜로 바꾸고 ContentRefinementAgent.run() 본체를 그대로 실행해 네 가지 시나리오를 돌렸습니다. 아래 결과는 에이전트가 남긴 content_refinement_worklog.json에서 그대로 옮긴 것입니다.
| 시나리오 (Overall 점수 흐름) | LLM 수정 호출 | worklog 판정 | 최종 채택본 |
|---|---|---|---|
| S1: 5 → 6 → 7 → 8 | 3회 | v1·v2·v3 모두 ACCEPTED_SCORE_INCREASE | v3 |
| S2: 5 → 6 → 5 | 2회 | v1 수락, v2 REJECTED_SCORE_DECREASE 후 즉시 중단 | v1 (되돌림 정상) |
| S3: 5 → 5(Clarity +1, Quality −1) → 5(Soundness −2) | 2회 | v1 ACCEPTED_NEUTRAL_IMPROVEMENT, v2 REJECTED_DEGRADATION | v1 |
| S4: 5 → 5 → 5 → 5 (Confidence만 4 → 1) | 3회 | 세 번 모두 ACCEPTED_NEUTRAL_IMPROVEMENT | v3 |
S4가 보여 주는 점이 실무에서 중요합니다. 하위 축 비교에서 Overall과 Confidence는 빠지고, gain ≥ drop이면 수락합니다. 그래서 점수가 전혀 움직이지 않은 수정도 “중립 개선”으로 채택됩니다. 리뷰어가 아무 변화를 감지하지 못해도 원고는 LLM이 다시 쓴 버전으로 바뀌고, 그 과정에서 의도하지 않은 표현 변화가 쌓일 수 있습니다. 심사 점수는 비결정적이므로, 운영에서 쓴다면 동점일 때는 원본을 유지하도록 조건을 gain > drop으로 바꾸는 패치를 고려할 만합니다.
논문 부록에는 이 루프의 보상 해킹 사례도 나옵니다. 초기 실험에서 에이전트가 빠진 베이스라인을 “한계” 항목으로 나열해 모의 심사 점수를 끌어올렸다는 것입니다. 그래서 프롬프트에 두 가지 규칙을 넣었습니다. 하나는 “한계를 명시적으로 쓰지 말 것”이고, 다른 하나는 “새 실험을 요구하는 리뷰 질문은 무시할 것”입니다. 에이전트는 실험을 실행할 수 없으므로, 없는 결과를 지어내거나 추가 실험을 약속하는 일을 막으려는 장치입니다. 다만 사람이 최종 원고를 고칠 때는 한계 절을 반드시 직접 써 넣어야 한다는 뜻이기도 합니다.
7. 박스 실측 — 무엇을 돌렸고 무엇을 못 돌렸나
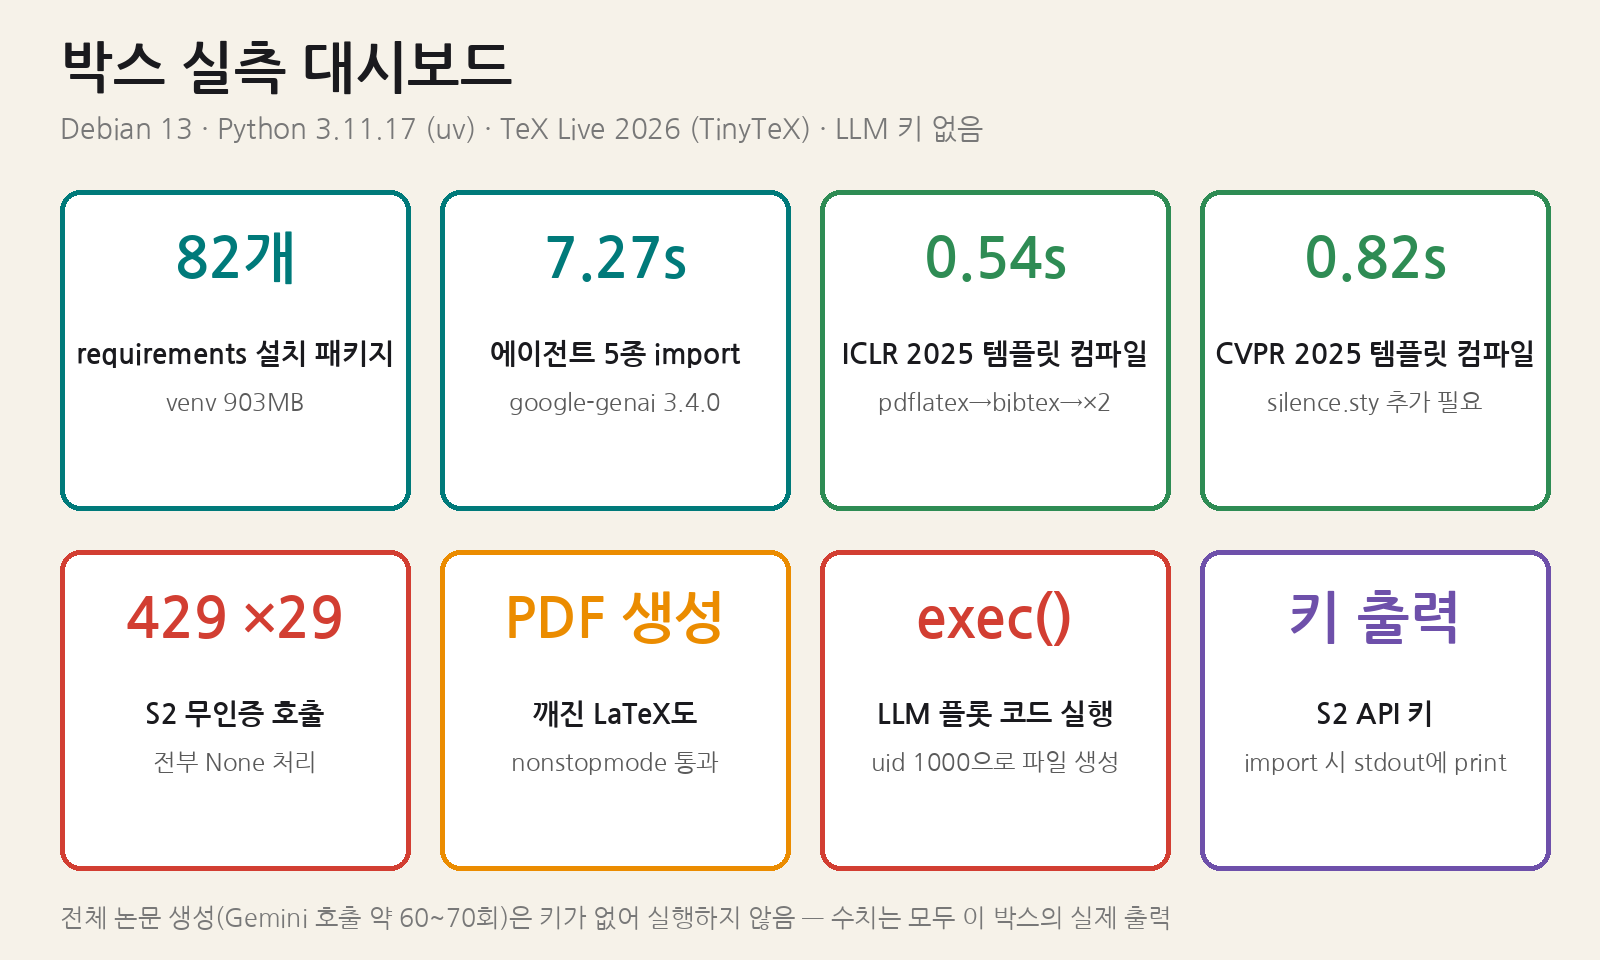
환경은 Debian 13, uv로 만든 Python 3.11.17 가상환경, TeX Live 2026(TinyTeX 로컬 설치)이고 LLM API 키는 없습니다. 그래서 Gemini를 호출하는 전체 원고 생성은 실행하지 않았고, LLM 없이 결정적으로 돌아가는 부분만 실제 코드로 검증했습니다.
| 항목 | 명령 / 방법 | 결과 | 의미 |
|---|---|---|---|
| 의존성 설치 | uv pip install -r requirements.txt |
82개 패키지, venv 903MB (google-genai 3.4.0, openai 3.52.0, streamlit 1.67.0, pymupdf 2.1) | PR #3 이후 누락 없이 설치됨 |
| CLI | python paper_writing_cli.py --help |
인자 12개 정상 출력 | 기본 모델은 전부 gemini-3.1-pro-preview / gemini-3-pro-image-preview |
| 모듈 import | 에이전트 5종 + 유틸 동시 import | 7.27초 | matplotlib·streamlit 계열 import 비용이 큼 |
| 키 노출 | import 시 stdout 확인 | Using S2 API Key: None 출력 |
scholar_utils.py가 S2 키를 평문으로 print함 → 키를 넣으면 로그에 그대로 남음 |
| Semantic Scholar | 키 없이 s2_title_search 24회 + curl 5회 |
29회 모두 HTTP 429 | 함수는 재시도나 경고 없이 None을 반환 → 후보가 조용히 탈락. 사실상 S2 키 필수 |
| ICLR 2025 템플릿 | 저장소의 compile_latex()(pdflatex → bibtex → pdflatex×2) |
0.54초, 1페이지, 인용 2건 렌더링 확인 | 에이전트가 만든 BibTeX 형식이 그대로 컴파일됨 |
| CVPR 2025 템플릿 | 같은 방식 | 처음에는 silence.sty 없음으로 실패, 패키지 설치 후 0.82초 성공 |
최소 TeX 배포판이면 패키지를 추가해야 함 |
| 깨진 LaTeX | 정의되지 않은 매크로 + 닫히지 않은 itemize 삽입 | log에 ! 오류 2건이 있는데도 PDF 생성, 실패로 처리되지 않음 |
성공 판정이 “PDF 파일이 있는가”뿐이라 깨진 원고가 리뷰 단계로 넘어갈 수 있음 |
| 플롯 실행기 | execute_plot_code_worker()에 파일을 쓰는 코드 전달 |
0.12초에 JPEG(base64 93,804자) 생성, 동시에 /tmp에 파일이 실제로 생성됨(uid 1000) | LLM이 만든 코드를 샌드박스 없이 exec()로 실행 |
| Streamlit 데모 | streamlit run frontend/app.py --server.headless true |
1.2초 만에 health 200, Uvicorn이 :::8599(모든 인터페이스)에 바인드 |
공유 서버에서 띄우면 외부에 노출됨. 인증 없음 |
| 수락/되돌림 로직 | 6장 시나리오 S1~S4 | 설계대로 동작, 동점 무변화 수정도 수락 | 논문 설명과 코드가 일치 |
8. 논문이 보고한 성적 — 숫자를 읽는 법
아래 숫자는 모두 논문(arXiv 2604.05018)에 실린 값이며 박스에서 재현한 것이 아닙니다. 평가셋은 CVPR 2025와 ICLR 2025에 채택된 논문 200편(각 100편)에서 “원재료”를 역으로 만든 PaperWritingBench이고, 기본 설정은 Sparse 아이디어, 그림은 원 논문 그림 사용(PlotOff)입니다.
| 지표 (ScholarPeer 모의 심사) | 원 논문(사람) | Single Agent | AI Scientist-v2 | PaperOrchestra |
|---|---|---|---|---|
| CVPR Overall (1~10) | 7.07 | 6.35 | 6.30 | 6.93 |
| CVPR 모의 채택률 | 86% | 71% | 70% | 84% |
| ICLR Overall (1~10) | 7.48 | 6.35 | 6.04 | 7.03 |
| ICLR 모의 채택률 | 94% | 72% | 64% | 81% |
| CVPR 평균 인용 수 | 58.52 | 11.46 | 14.18 | 47.98 |
| CVPR 필수 인용(P0) 재현율, Gemini 판정 | – | 60.84% | 36.12% | 63.58% |
| CVPR 부가 인용(P1) 재현율, Gemini 판정 | – | 2.77% | 3.26% | 15.85% |
| LLM 호출 / 평균 소요 | – | 1회 / 3.3분 | 약 40~45회 / 35.1분 | 약 60~70회 / 39.6분 |
읽을 때 주의할 점이 세 가지 있습니다. 첫째, “채택률”은 실제 학회 심사가 아니라 LLM 리뷰어의 판정입니다. 둘째, 리파인먼트 루프가 바로 이런 종류의 LLM 심사 점수를 올리도록 최적화되어 있어서 평가 지표와 최적화 대상이 같은 계열입니다(논문은 다른 리뷰어 프레임워크와 사람 평가를 병행해 이를 보완했다고 설명합니다). 셋째, P1 재현율 15.85%가 보여 주듯 “필요한 인용은 잡지만 배경 인용의 폭은 아직 사람과 거리가 있다”는 것이 정직한 요약입니다. 사람 평가 기준 승률 격차는 문헌 검토 50~68%p, 전체 원고 14~38%p로 보고됐습니다.
9. 비슷한 도구와 비교
| 시스템 | LaTeX 원고 끝까지 생성 | 독립형 작성기 | 비정형 입력 | 목표 지향 문헌 검토 | 개념도 생성 | 한 줄 평 |
|---|---|---|---|---|---|---|
| PaperOrchestra | ✓ | ✓ | ✓ | ✓ | ✓ | 글쓰기만 떼어 낸 파이프라인. 실험 루프와 결합돼 있지 않음 |
| AI Scientist-v2 | ✓ | ✗ | ✓ | ✓ | ✗ | 실험부터 원고까지 한 번에. 작성 모듈이 자체 파이프라인 산출물에 의존 |
| AI-Researcher | ✓ | ✗ | ✗ | ✓ | ✗ | 연구 자동화 전체 루프 중심 |
| CycleResearcher | ✓ | ✗ | ✗ | ✗ | ✗ | 구조화된 BibTeX 목록을 입력으로 요구 |
| data-to-paper | ✗ | ✓ | ✓ | ✗ | ✗ | 구조화된 분석 결과 → 텍스트, 역추적성에 강점 |
| Single Agent (LLM 1회 호출) | △ | ✓ | ✓ | ✗ | ✗ | 가장 빠르지만 인용 수가 원 논문의 약 1/5 수준 |
표의 ✓/✗는 논문 Table 1을 따랐고, Single Agent 행과 “한 줄 평” 열은 이 글에서 덧붙인 것입니다. 실무 관점의 차이를 하나 더 들자면, PaperOrchestra는 이미 실험을 끝낸 팀의 “초고 작성 비용”을 겨냥하고, AI Scientist 계열은 아이디어 탐색 자체의 자동화를 겨냥합니다.
10. 설치·실행 — 실제로 돌리려면
# 1) 환경 (README는 conda 기준, 박스에서는 uv로 동일하게 동작)
git clone https://github.com/google-research/paper-orchestra
cd paper-orchestra
uv venv -p 3.11 .venv && . .venv/bin/activate
uv pip install -r requirements.txt

# 2) TeX: pdflatex + bibtex 필수 (CVPR 템플릿은 silence 패키지 필요)
#    TinyTeX 예: tlmgr install silence

# 3) .env — 사용하는 제공자 키만
SEMANTIC_SCHOLAR_API_KEY=...   # 사실상 필수 (무인증은 429)
GEMINI_API_KEY=...             # 또는 VERTEX_AI_PROJECT / VERTEX_AI_LOCATION

# 4) 원재료 폴더
my_paper/raw_materials/
  ├─ idea_sparse.md
  ├─ experimental_log.md
  └─ figures/            # 없으면 --use_plotting true

# 5) 실행
python paper_writing_cli.py \
  --raw_materials_dir my_paper/raw_materials \
  --latex_template_dir templates/iclr2025 \
  --output_dir out_my_paper \
  --use_plotting true \
  --research_cutoff 2026-10

# 6) 데모 UI (로컬 바인드 권장)
streamlit run frontend/app.py --server.address 127.0.0.1
출력 폴더에는 outline.json, literature_agent_output/(bib·citation_map), latex_writeup/, content_refinement_workdir/(버전별 tex·PDF·리뷰 JSON·worklog), time_breakdown.json, final_paper.pdf가 남습니다. 재현과 감사에는 worklog와 리뷰 JSON이 가장 유용합니다.
모델 선택 주의: --writer_model_name에 gpt 계열 이름을 넣으면 OpenAI 경로를 타는 곳은 SectionWritingAgent뿐입니다. Outline·Literature(Google Search 그라운딩)·Refinement는 call_gemini_with_contents를 직접 호출하므로 현재 코드로는 Gemini가 사실상 필수입니다.
11. 주의점과 한계 — 도입 전 체크리스트
| 위험 | 근거 | 완화책 |
|---|---|---|
| LLM 생성 코드 무샌드박스 실행 | execute_plot_code_worker의 exec(), 박스에서 부작용 파일 생성 확인 |
컨테이너·전용 계정에서 실행, 네트워크 차단, 또는 그림을 직접 제공하고 PlotOff로 운용 |
| API 키 로그 노출 | scholar_utils.py가 import 시 키를 print |
해당 줄을 제거하거나 마스킹하는 패치. nohup 로그를 공유하지 말 것 |
| S2 rate limit에서 조용히 실패 | 429 → None, 재시도 없음 | S2 키 발급, 429 시 백오프 재시도 패치, 탈락 수를 로그로 집계 |
| 깨진 LaTeX가 성공으로 처리됨 | PDF 존재 여부로만 성공 판정 | log의 ! 오류를 실패로 보는 검사를 추가 |
| 동점 무변화 수정 수락 | gain ≥ drop 조건, S4 실측 |
동점이면 원본 유지 또는 diff 크기 상한 |
| 컷오프 경계 불일치 | 두 판정 함수의 경계 처리 차이 | 컷오프를 한 달 앞당기거나 판정 함수를 하나로 통일 |
| Gemini 종속 | 3개 에이전트가 Gemini를 직접 호출 | 라우터(llm_backend_utils)로 통일하는 리팩터링 필요 |
| 재현성 | 데이터셋 미공개, preview 모델 기본값, 릴리스·테스트 없음 | 커밋 해시와 모델 버전을 고정하고 산출물 전체를 보관 |
| 연구 윤리·학회 정책 | “한계를 쓰지 말라”는 프롬프트 규칙, LLM 사용 공개 의무 | 최종 원고는 사람이 검증, 한계 절 직접 작성, 학회의 LLM 사용 정책 확인 |
| 데모 노출 | Streamlit 기본 바인드가 모든 인터페이스, 인증 없음, SMTP 비밀번호를 .env에 둠 | 127.0.0.1 바인드, 앞단에 인증 프록시, 메일 기능 비활성화 |
12. 누가 도입하면 좋은가
| 대상 | 추천도 | 이유 |
|---|---|---|
| 실험은 끝났고 초고·관련 연구가 병목인 연구실 | 높음 | 관련 연구 초안, 검증된 bib, 학회 템플릿 적용까지 한 번에 확보. 사람은 검토·수정에 집중 |
| AI 연구 자동화·평가 연구자 | 높음 | autoraters(Citation F1, SxS, AgentReview)를 자체 벤치마크에 재사용 가능 |
| 사내 기술 보고서·백서 팀 | 중간 | 템플릿 폴더만 바꾸면 되지만 프롬프트가 AI 학회 기준이라 손질이 필요 |
| 학생 개인 사용 | 신중 | 학위 규정과 학회의 AI 사용 정책 위반 위험. 문헌 탐색 보조 정도로 한정 권장 |
| Gemini를 쓸 수 없는 조직 | 낮음 | 현재 구조로는 핵심 에이전트 3개가 Gemini 전용 |
정리
PaperOrchestra의 가치는 “AI가 논문을 쓴다”는 문구보다 구현 방식에 있습니다. LLM의 출력을 외부 사실(Semantic Scholar)과 외부 평가(모의 심사 점수)라는 두 개의 게이트로 묶어 두었기 때문입니다. 박스 실측에서 두 게이트는 설계대로 동작했습니다. 반면 그 바깥 운영 계층에는 무샌드박스 exec(), 키 평문 출력, 429를 조용히 넘기는 처리, PDF 존재 여부만 보는 컴파일 성공 판정 같은 연구용 코드의 거친 부분이 남아 있습니다. 실무 도입을 생각한다면 커밋을 고정하고, 이 글 11장의 패치 네 가지(키 마스킹, 429 재시도, LaTeX 오류 검사, 동점 처리)부터 적용한 뒤 컨테이너 안에서 돌리는 것을 권합니다.