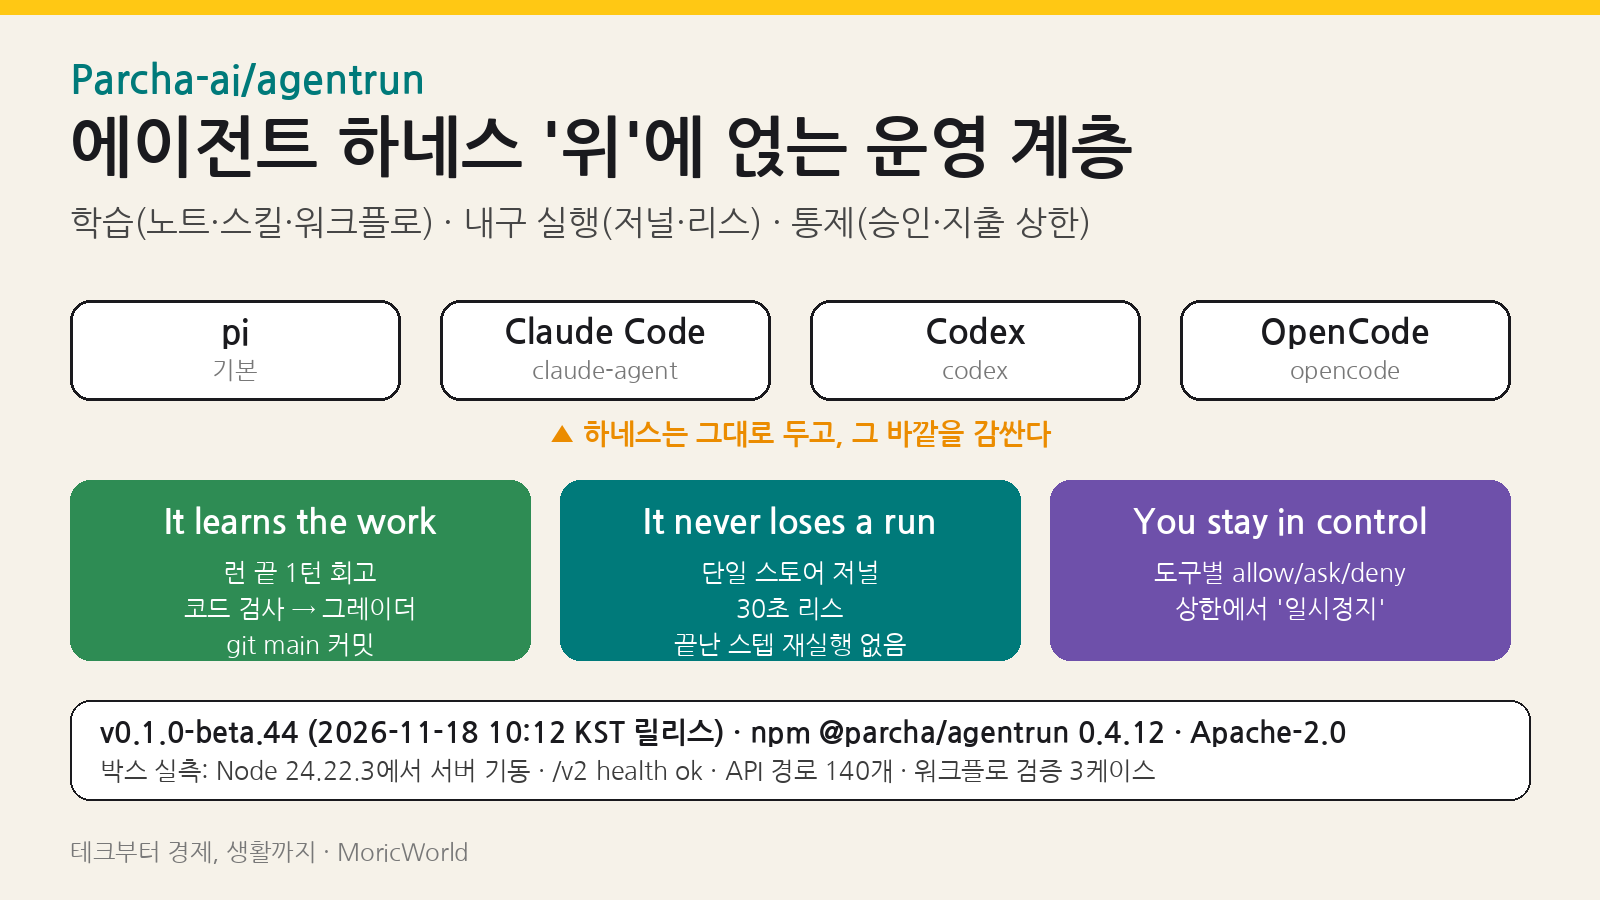
한 줄 요약: Parcha-ai/agentrun은 새 에이전트 프레임워크가 아닙니다. pi, Claude Code, Codex, OpenCode처럼 이미 쓰는 하네스(에이전트 루프)는 그대로 두고, 그 바깥에 세 가지를 얹는 운영 계층입니다. 런이 끝날 때마다 쓸 만한 걸 git에 커밋하는 자기개선 루프, 서버가 죽어도 저널에서 이어 가는 내구 실행, 도구 호출 승인과 지출 상한을 거는 통제면입니다. 이 글은 2026-11-18 기준 최신 릴리스 v0.1.0-beta.44(커밋 0bd960b)를 놓고 구조, 설치, 평가 방법, 트레이드오프를 실무자 눈높이로 뜯어봅니다. 박스(Linux x64)에서 실제로 서버를 띄워 API까지 찔러 본 결과도 함께 정리했습니다.
왜 지금 이 저장소인가
last30days 랭킹(쿼리 “GitHub AI open source”)에서 1위에 오른 항목은 2026-11-13 03:15(KST)에 올라온 Hacker News Show HN 글 “AgentRun – open-source, Self-improving Managed Agents”였습니다. 138점에 댓글 41개가 달렸습니다. 댓글 흐름은 크게 셋으로 갈렸습니다. 첫째, 경쟁사 Sourcery CEO가 README의 “Greptile보다 실제 버그 1.6배” 주장에 대해 정밀도와 재현율의 트레이드오프를 무시한 비교라고 반박했습니다. 둘째, “학습한 내용이 정말 적용되는지, 결정적인지, 쌓일수록 비용과 지연은 어떻게 관리하는지” 같은 근본적인 질문이 나왔습니다. 셋째, “상한을 걸어도 에이전트가 백그라운드 프로세스로 시간 제한을 우회하는데, 분리된 프로세스의 컴퓨트도 상한에 포함되느냐”는 질문에 메인테이너가 “살펴보겠다”고 답했습니다. 마케팅 문구보다 이런 쟁점이 이 프로젝트를 평가하는 데 더 쓸모 있으니, 아래에서 하나씩 짚어 보겠습니다.
| 항목 | 값 (2026-11-18 12시 무렵 KST 확인) | 출처 |
|---|---|---|
| 최신 릴리스 | v0.1.0-beta.44, 2026-11-18 10:12 KST 게시 (prerelease) |
GitHub Releases |
| CLI(런처) 패키지 | @parcha/agentrun 0.4.12 (npm latest) |
npm registry |
| 서버 패키지 | @parcha/agentrun-serve 0.1.0-beta.44 |
packages/serve/package.json, 박스 capabilities 응답 |
| 최신 커밋 | 0bd960b “serve: DELETE /v2/agents/{id} deletes an agent another system owns (#3051)”, 2026-11-18 11:36 KST |
git log |
| 최초 공개 | 2026-09-23 09:25 KST “Initial open-source release” | git log |
| 커밋 수 | 전체 2,274개, 최근 30일 1,896개 / 태그 44개(beta.1~44) | git clone 집계 |
| 스타 / 포크 / 열린 이슈 | 1,211 / 96 / 59 | GitHub API |
| 라이선스 | Apache-2.0 (Copyright 2026 Parcha Labs, Inc.) | LICENSE, README |
| 주 언어 | TypeScript/JavaScript (Node ≥ 24.22.3), computer 데몬은 Go 1.24, macOS 데몬은 Swift | package.json, go.mod |
릴리스 속도에 주목해야 합니다. 두 달 동안 베타를 44번 냈고, 11/17에만 beta.42와 beta.43이 연달아 나갔습니다. beta.44에도 “Breaking” 항목이 세 개 들어 있습니다. 이 속도는 강점이면서 동시에 도입 리스크입니다. 이 부분은 뒤의 “주의점”에서 다시 다룹니다.
설계 철학: “에이전트가 같은 걸 매번 다시 알아낸다”
README가 문제로 꼽는 지점은 분명합니다. 에이전트는 무언가를 알아내는 데는 뛰어나지만, 백 번 해 본 일도 매번 같은 API를 다시 찾고, 같은 문서를 다시 읽고, 같은 계획을 다시 세웁니다. 그 토큰 비용은 고스란히 사용자가 냅니다. AgentRun의 답은 모델 가중치를 건드리지 않는 것입니다. 대신 런 사이에 남는 산출물(노트, 스킬, 워크플로)을 관리합니다. 관리 방식은 소프트웨어 공학에서 익숙한 것들입니다. git 브랜치, 코드 검사, 리뷰어(그레이더), 롤백입니다. 그래서 “self-improving”이라는 말은 연구적 의미의 자기개선보다는 검사를 거쳐 커밋되는 운영 메모리에 가깝다고 보는 편이 정확합니다.
아키텍처: Server · Store · Runner · Hands
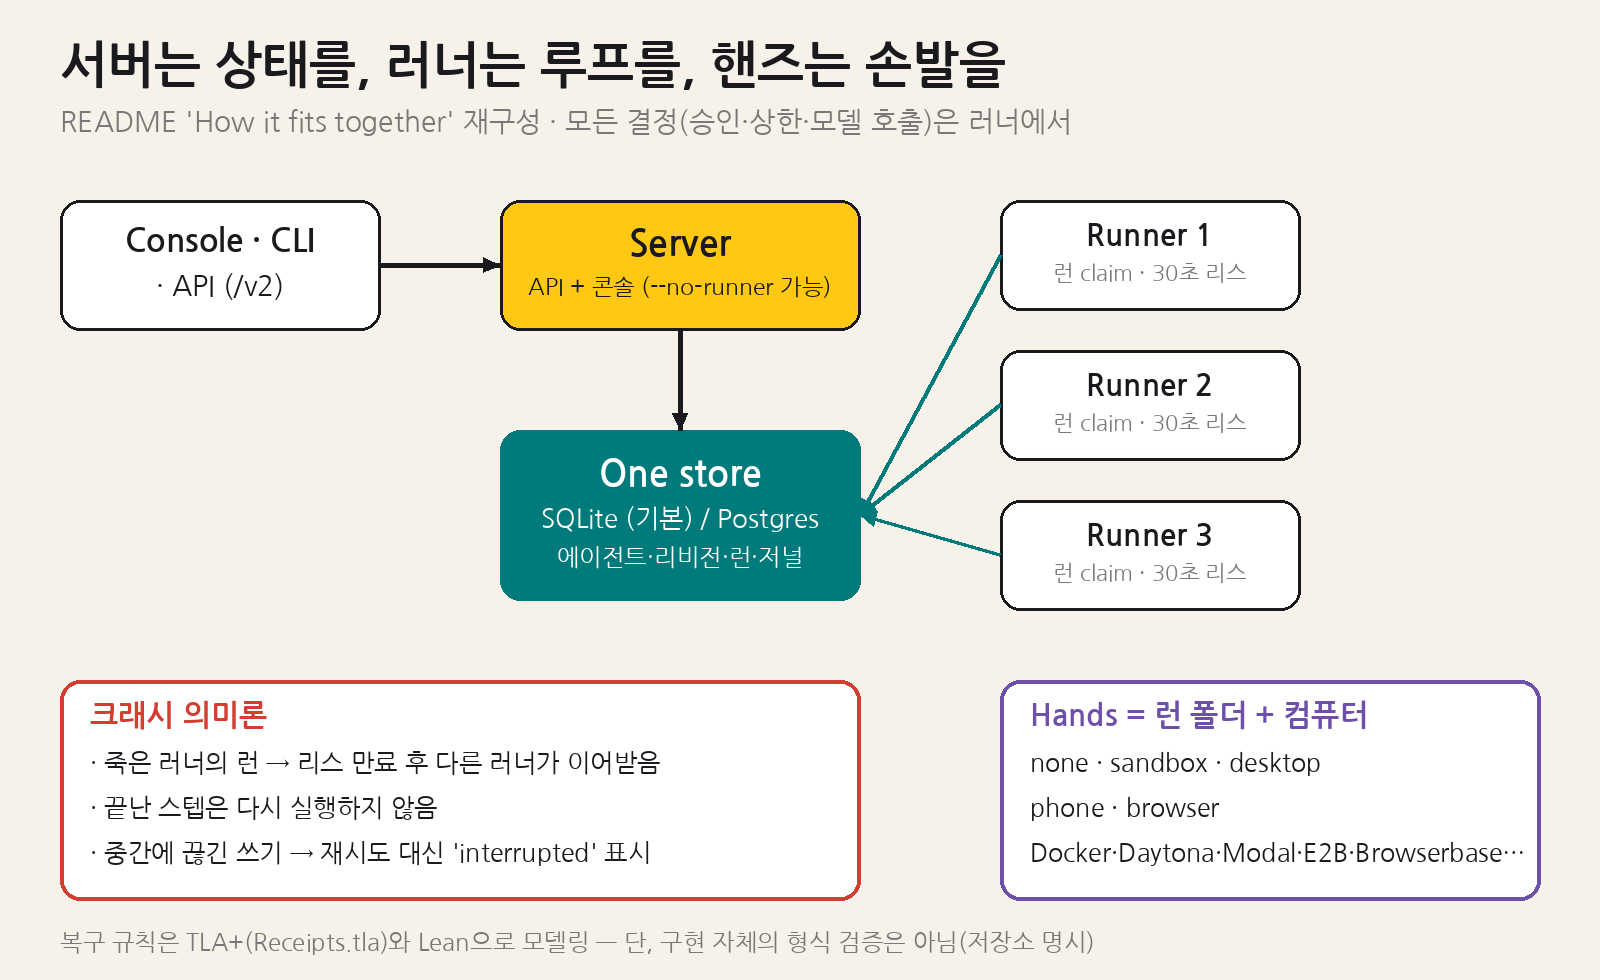
| 구성요소 | 책임 | 설계 포인트 |
|---|---|---|
| Server | /v2 API와 웹 콘솔 제공, 런과 명령을 스토어에 기록 |
--no-runner로 띄우면 에이전트 루프를 전혀 돌리지 않는 순수 제어면이 됨 |
| Store | 에이전트, 리비전, 런, 런 저널을 한곳에 보관 | 기본은 데이터 폴더의 SQLite, AGENTRUN_STORE_URL=postgres://…이면 Postgres |
| Runner | 스토어에서 런을 claim해 동시에 여러 개 실행. 승인 검사, 상한, 모델 호출이 모두 여기서 일어남 | 러너를 추가하면 수평 확장. 죽은 러너의 런은 30초 리스가 끝나면 다른 러너가 이어받음 |
| Hands | 도구가 실제로 작동하는 곳. 런 폴더와 컴퓨터 | sandbox는 런 폴더를 /workspace에 마운트. desktop, phone, browser는 폴더를 러너에 둠 |
내구성 의미론이 가장 실무적인 부분입니다. 끝난 스텝은 절대 다시 실행하지 않습니다. 크래시로 중간에 끊긴 쓰기 호출은 재시도하지 않고 interrupted로 표시해서 사람이 확인하게 합니다. 결제나 이메일 발송처럼 멱등하지 않은 도구를 다루는 에이전트라면 이 “at-most-once” 선택이 “at-least-once 재시도”보다 안전합니다. 서버를 멈출 때는 --drain-timeout(기본 30초, 이미지 기본 6초) 안에 끝나는 턴만 결과를 지키고, 그 모델 요청은 다시 보내지 않습니다. 시간 안에 못 끝난 턴은 재개 가능한 지점에서 멈추고, 다음 claim이 저널에서 이어 가며 그 턴의 모델 요청은 다시 나갑니다(serve README). 이 특성은 문서에 명시되어 있으니, 비용 계산을 할 때 반영해 두는 편이 좋습니다.
눈여겨볼 점이 하나 더 있습니다. spec/ 폴더에 TLA+ 모델(spec/receipts/Receipts.tla)과 Lean 명세(spec/lean)가 들어 있습니다. TLA+ 모델은 복구 드라이버가 저널 위에서 재개할 때 어떤 크래시나 커밋 실패가 끼어도 효과가 두 번 나가지 않는다는 규칙을 TLC로 작은 범위에서 전수 검사합니다. Lean 쪽은 같은 기계를 임의의 스텝 수와 크래시 수에 대해 증명합니다. 단, 저장소 스스로 “구현 자체가 이 증명으로 형식 검증된 것은 아니다”라고 밝히고 있습니다. 증명은 모델에 대한 것이고, TypeScript 인터프리터와는 공유 테스트 케이스(conformance)로 대조합니다. 그 범위 안에서 읽으면 됩니다.
저장소 구조 한눈에 보기
| 경로 / 패키지 | 역할 |
|---|---|
packages/agentrun (@parcha/agentrun 0.4.12) |
런처이자 CLI. npx @parcha/agentrun 한 줄로 서버와 러너 1개를 띄우고, 같은 바이너리가 API 클라이언트 역할도 함 |
packages/serve |
서버 본체. /v2 API, 콘솔, 러너, 학습, 트리거, 상한 |
packages/dsl |
타입이 있는 워크플로 언어. 앱 안에서 단독 실행도 가능, src/recovery에 저널 기반 복구 드라이버 |
packages/run-adapters* |
하네스 어댑터. Codex(툴 없는 app-server를 루프백 모델 프록시 뒤에), Claude Agent SDK, ACP(Agent Client Protocol) 에이전트 |
packages/computer (+ Go/Swift 데몬) |
컴퓨터 프로토콜. 모든 컴퓨터 안에 작은 데몬 하나, 벤더별 프로비저너 하나. 제공자마다 conformance 스위트 포함 |
packages/jev, packages/decisions |
워크플로 안의 “빠른 타입 결정”(예/아니오, 하나 고르기, 점수 + 신뢰도). Parallel Decisions, OpenRouter 제공자 |
packages/pi-browser |
에이전트 전용 브라우저와 사람의 제어권 인수(take over), 반환 |
apps/console |
Mission Control 등 웹 콘솔 |
connector/, python/ |
기존 에이전트 관측과 원격 연결(Python 커넥터), Python 클라이언트 parcha-agentrun |
spec/ |
컴퓨터 와이어 프로토콜 명세, Lean 의미론, TLA+ 영수증 모델 |
규모 감각을 잡기 위해 세어 보니, packages와 apps의 테스트를 제외한 .ts 파일이 약 24.5만 줄, 저장소 안 *.test.* 파일이 1,956개였습니다(박스 집계, node_modules 제외). 두 달 된 프로젝트치고 테스트 비중이 높습니다. 커밋 패턴과 AGENTS.md를 보면 개발 자체도 에이전트를 많이 쓰는 것으로 보입니다.
핵심 1: 자기개선 루프는 이렇게 돈다
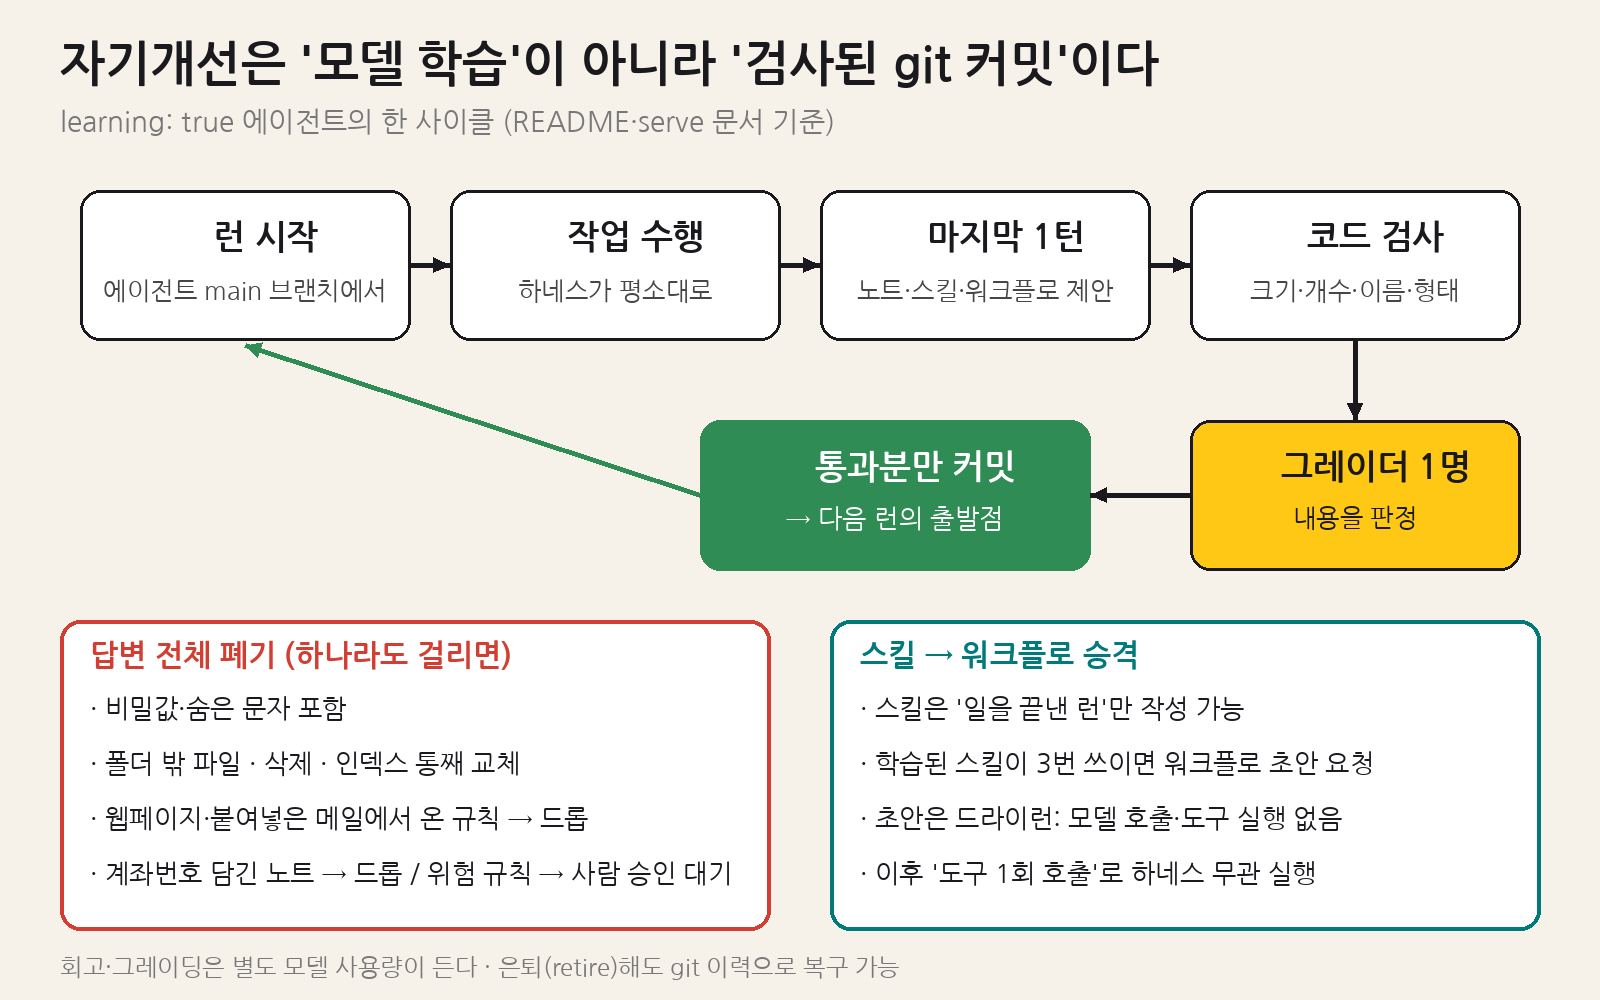
에이전트 정의에 "learning": true를 켜면, 매 런이 끝날 때 에이전트가 “무엇을 남길지” 말하는 턴을 하나 더 갖습니다. 산출물은 세 종류입니다.
| 산출물 | 형태 | 작성 조건 / 제약 | 다음 런에서 |
|---|---|---|---|
| 노트(Notes) | 사실 하나당 짧은 마크다운 파일 하나 (Claude Code 메모리 포맷) | 크기와 개수 제한. 학습 예산을 넘으면 첫 메시지와 관련된 노트만 통째로, 나머지는 한 줄 인덱스로 | 활성 노트 인덱스를 지시문과 함께 읽음. 어떤 노트를 받았고 열었는지 런마다 기록 |
| 스킬(Skills) | 그 일을 다시 하는 방법 | 일을 끝낸 런만 작성 가능 | 에이전트 자체 스킬 옆에 학습된 스킬로 제공 |
| 학습된 워크플로 | 타입 있는 JSON 워크플로 (DSL v2) | 학습된 스킬이 3번 쓰이면 다음 런에 워크플로 초안을 요청. 초안은 모델 호출도 도구 실행도 없는 드라이런을 통과해야 보관 | 어느 하네스에서든 “도구 호출 1회”로 실행. 런의 상한과 도구 권한 안에서 |
안전장치는 제안 전체를 버리는 규칙과 항목만 버리는 규칙으로 나뉩니다. 크기, 개수, 이름, 형태 규칙을 어긴 항목은 그 항목만 빠집니다. 반면 답변 어딘가에 비밀값이나 숨은 문자가 있거나, 폴더 밖 파일, 삭제, 인덱스 통째 교체가 들어 있으면 답변 전체를 버립니다. 그 답의 어떤 항목도 믿을 수 없다고 보기 때문입니다. 그다음 그레이더 한 명이 내용을 판정하고, 통과한 것만 에이전트 전용 git 폴더의 main에 커밋합니다. 위험한 규칙은 사람의 OK를 기다립니다. 런이 웹페이지나 붙여넣은 이메일에서 찾은 규칙, 계좌번호가 담긴 노트는 드롭합니다. 프롬프트 인젝션이 장기 메모리로 승격되는 경로를 명시적으로 막는 설계라는 점이 다른 메모리 계층과 다릅니다.
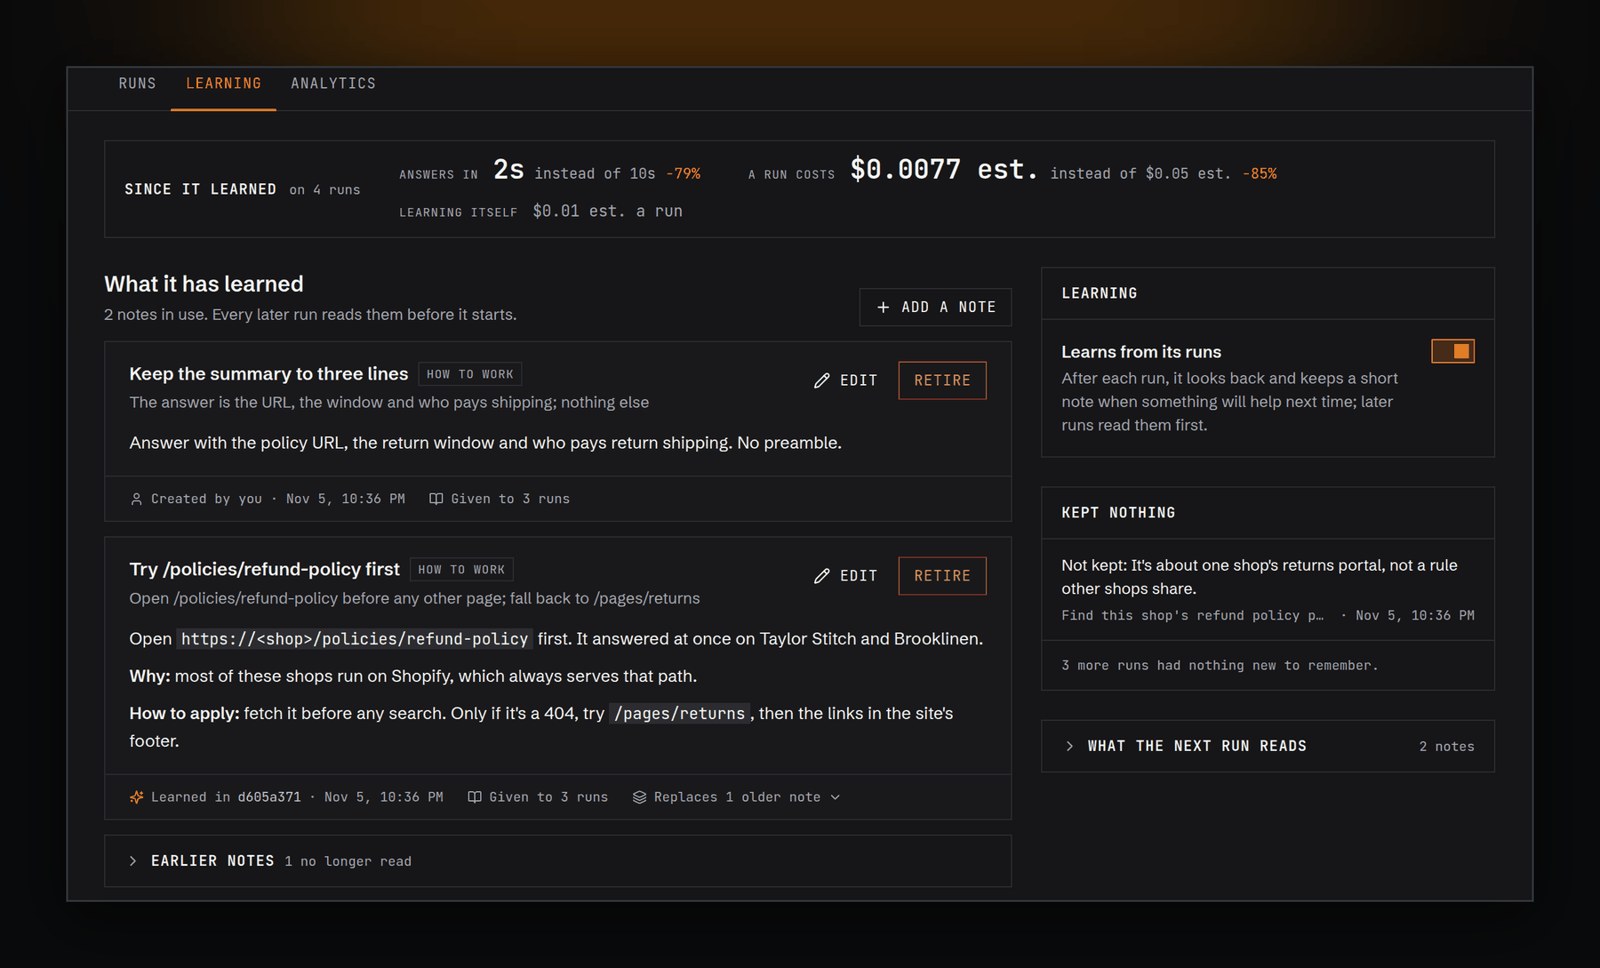
HN에서 나온 “학습이 정말 적용되는가, 결정적인가”라는 질문에 대해 저장소가 내놓는 답은 측정입니다. 템플릿마다 eval 케이스가 있고, npx @parcha/agentrun template eval DIR이 버려도 되는 서버에서 실제 런으로 채점합니다. SDK 학습 예제(examples/sdk-learning)는 learning-Off 대조군까지 돌리도록 되어 있습니다. 다만 학습이 결정적이라는 보장은 없습니다. 그레이더도 모델이고, 회고와 그레이딩에는 모델 사용량이 따로 듭니다(README 명시).
| 공식 사례 (자체 발표) | 주장 수치 | 평가 방법 (문서 기재) | 읽을 때 주의 |
|---|---|---|---|
코드 리뷰 (docs/case-studies/code-review.md) |
Greptile 청구액 월 $180 → $6,451. 자체 리뷰어는 건당 약 18센트. 실제 버그 포착률 Greptile 26% vs AgentRun 42%(≈1.6배), 심각 버그 8개 중 5개 vs 1개 | 머지된 PR 70개로 튜닝, 최신 30개를 홀드아웃. Opus 5.5가 작성자를 모른 채 모든 지적을 채점, 답안지는 버그 78개(심각 8개) | 재현율 중심 지표. Sourcery CEO는 Greptile이 정밀도 쪽에 서 있다고 반박. 표본 30 PR, 자사 저장소 한정 |
| 가맹점 업종코드(MCC) 분류 | 건당 $0.89(Opus 수작업) → $0.124(학습 후). 저가 모델이 86%를 단독 처리, 엄격 재검 정확도 96% vs 93% | 950개 중 학습 555 / 홀드아웃 198 / 해시 봉인 157 / 검증 40. 정답을 지운 녹화 웹에서 실행 | 참조 정답이 자사 프로덕션 분류기 출력. 외부 재현은 아직 없음 |
| 저가 모델 단독 학습 | gpt-6-luna, 학습 Off 75% → On 81% (36런 학습 후) | 봉인 가맹점 157개 | 개선 폭이 크지 않고 신뢰구간 미기재 |
코드 리뷰 사례에서 기술적으로 가장 쓸모 있는 교훈은 수치보다 그 아래 적힌 메모입니다. “diff만 읽게 하면 저가 모델이 70% 틀렸고, 읽기 전용 bash를 주니 7%.” “같은 리뷰어 8명보다 빠른 리뷰어 5명 + 깊은 리뷰어 3명 조합이 낫다.” “부모 에이전트가 증명 못 한 버그를 기각하지 못하게 하라.” “게시되지 않은 리뷰도 세라. 타임아웃 하나가 좋은 버전을 15포인트 나쁘게 보이게 했다.” AgentRun을 쓰지 않더라도 리뷰 에이전트를 설계할 때 그대로 가져다 쓸 수 있는 내용입니다.
핵심 2: “에이전트일 필요가 없는 일”을 위한 워크플로 DSL
AgentRun이 다른 매니지드 에이전트와 가장 다른 지점이 여기입니다. 반복 업무를 타입 있는 JSON 워크플로로 쓰면, 도구 호출, 모델 스텝, 빠른 타입 결정(신뢰도 포함)을 조합하고 애매한 경우에만 에이전트로 넘길 수 있습니다. 노드 종류는 chain, call(도구 또는 모델), 결정, 분기, 병렬 map, 횟수가 제한된 루프, 하위 워크플로 호출, 에이전트로 핸드백이 있습니다. README의 KYB 예시는 모델이 approve 0.61을 냈지만 워크플로 기준 0.75에 못 미쳐 사람 검토로 보내는 장면을 보여 줍니다. 결정을 확률값과 임계치로 분리해 두면 감사(audit)가 쉬워집니다.
{
  "v": 2, "name": "read-site",
  "schemas": {
    "In":   { "type": "object", "required": ["website"], "properties": { "website": { "type": "string" } } },
    "Page": { "type": "object", "required": ["ok"], "properties": { "ok": { "type": "boolean" } } }
  },
  "input":  { "schemaId": "In" },
  "output": { "schemaId": "Page", "path": "home" },
  "root": { "node": "chain", "steps": [
    { "node": "call", "label": "Read the home page", "via": "tool", "tool": "web_fetch",
      "args": { "url": "{website}" }, "out": "Page", "as": "home", "deadline_s": 60 }
  ] }
}
위 README 예시를 박스에서 실제 서버의 POST /v2/workflows/validate로 검증해 봤습니다. 결과는 아래 “박스 실측”에 정리했습니다. 정적 검증기가 스키마 참조 오류와 리비전이 허용하지 않은 도구 사용을 저장 전에 잡아 준다는 점이 실무에서 특히 쓸모 있습니다.
핵심 3: 하네스와 컴퓨터를 분리한 추상화
| 하네스 | harness 값 |
ChatGPT 플랜으로 실행 | 비고 (README) |
|---|---|---|---|
| pi | pi |
예 | 기본값. Earendil Works의 pi(MIT) 위에 구축 |
| Claude Code | claude-agent |
아니오: Anthropic 또는 OpenRouter 키 필요 | 첫 사용 시 자동 설치 |
| Codex | codex |
예 | 첫 사용 시 자동 설치 |
| OpenCode | opencode |
아니오: OpenAI 또는 OpenRouter 키 | 서버 옆에 opencode-ai 패키지 필요 |
beta.44부터 하네스 ID가 enum이 아닌 문자열(^[a-z][a-z0-9-]{0,39}$)이 됐고, --harness-module로 서드파티 하네스를 추가할 수 있습니다. capabilities 응답에는 각 하네스의 약속(promises)이 실립니다. resume(exact/load/restart), tool_gate(every_call/permission/config), billing(proxy/plan)입니다. 박스에서 받은 응답을 보면 내장 4종 모두 resume: exact, tool_gate: every_call, billing: proxy였습니다. 모든 도구 호출이 AgentRun의 게이트를 지나고, 모델 호출은 루프백 프록시를 거쳐 과금이 계측된다는 뜻입니다. Codex 어댑터 설명에 나오는 “툴 없는 Codex app-server를 루프백 모델 프록시 뒤에 두고, 호스트의 도구만 쥐여 준다”가 바로 이 구조입니다.
| computer.kind | 에이전트가 할 수 있는 일 | 제공자 |
|---|---|---|
none |
런 폴더 읽기·쓰기, 셸 없음 | 불필요 |
sandbox |
코드 실행, 패키지 설치, 백그라운드 프로세스 (Linux) | Docker, Daytona, Modal, E2B, Cloudflare(직접 배포한 릴레이 Worker 경유) |
desktop |
Linux 화면 보기, 마우스, 타이핑 | Orgo, E2B, Docker(X 서버 있는 자체 이미지) |
phone |
Android 탭, 스와이프, 앱 열기, 화면 읽기 | phone 하네스(임대 클라우드 Android) |
browser |
웹 브라우징, 언제든 사람에게 제어권 이양 | Browserbase, Kernel |
벤더 키는 서버가 봉인(seal)해서 보관하고, 에이전트의 컴퓨터 안으로는 절대 들어가지 않습니다. 저장된 모든 비밀은 AGENTRUN_SEAL_KEY 하나로 봉인됩니다. 이 키를 잃으면 봉인된 것도 전부 잃습니다. 비밀은 쓰기 전용이고 API 토큰으로는 비밀을 쓸 수도, 도구 호출을 승인할 수도 없습니다. 런은 자기 모델과 도구에 필요한 키만 받습니다. 에이전트 샌드박스를 다룬 이전 글들(OpenSandbox, NVIDIA OpenShell 등)이 “자격 증명을 샌드박스 밖에 두는” 방향이었다면, AgentRun은 같은 원칙을 운영 계층 차원에서 적용한 셈입니다.
설치와 실행: 문서대로, 그리고 박스에서 실제로
README 기준 로컬 실행은 세 단계입니다. 요구 사항은 macOS 또는 Linux, Node 24.22.3 이상입니다.
# 1) 서버 + 러너 1개 기동 (기본 포트 7340, 데이터는 ~/.agentrun)
npx @parcha/agentrun

# 2) 콘솔에서 비밀번호 설정 → "Continue with ChatGPT" 또는 모델 키 추가
#    (OPENROUTER_API_KEY 하나면 모든 하네스에 모델 제공)

# 3) Templates → KYB due diligence 적용 → 첫 런

# Node 없이 설치 (beta.44 신규): nodejs.org에서 Node를 받아 SHASUMS256으로 검증 후 설치
curl -fsSL https://agentrun.ai/install | sh
agentrun service install   # macOS launchd / Linux systemd user unit
CLI에서 에이전트를 만들고 상한을 건 런을 돌리는 흐름은 다음과 같습니다(README 예시 그대로).
cat > agent.json <<'EOF'
{"definition": {"id": "notes", "version": 1, "name": "Notes",
  "instructions": "Do what you are asked, and write what you make to a file.",
  "skills": [], "tools": ["write", "ask_person"]}}
EOF
npx @parcha/agentrun agents create --body @agent.json
npx @parcha/agentrun runs start notes --max-cost-usd 1 --wait \
  --body '{"input": {"content": "Ask me which region to cover, then write region.md about it."}}' > out.json
# runs wait 종료 코드: 0 완료, 1 실패, 8 사람 대기(질문·상한·승인)
종료 코드 8(사람을 기다리는 중)을 따로 둔 설계는 CI나 크론에서 아주 편합니다. “실패”와 “승인 대기”를 셸 수준에서 구분할 수 있기 때문입니다.
박스 실측 (2026-11-18 11:55~12:05 KST)
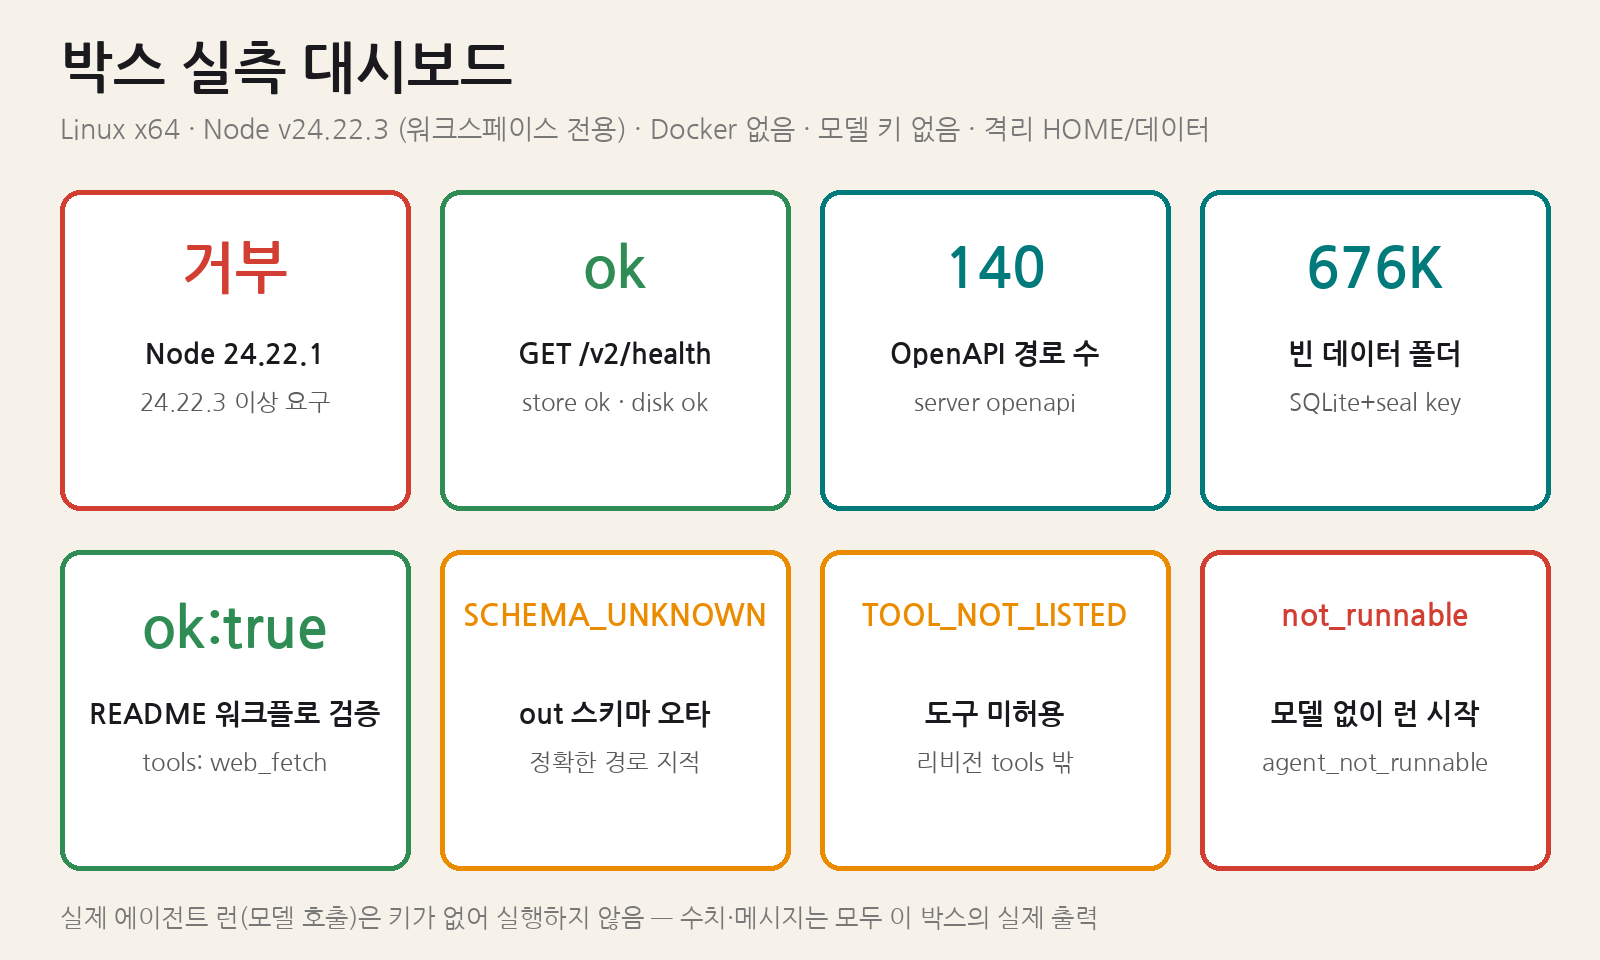
환경은 Linux x64이고, Docker와 모델 키는 없습니다. HOME과 데이터 폴더는 작업 디렉터리 안에 격리했고 텔레메트리는 끈 상태(AGENTRUN_TELEMETRY=0)입니다. 모델 호출이 필요한 실제 에이전트 런은 실행하지 않았습니다. 아래 수치와 메시지는 모두 이 박스에서 나온 실제 출력입니다.
| # | 시도 | 결과 | 해석 |
|---|---|---|---|
| 1 | 시스템 Node v24.22.1로 npx @parcha/agentrun@0.4.12 --version |
“AgentRun needs Node.js 24.22.3 or newer; you have v24.22.1” + 설치 스크립트 안내 | 패치 버전까지 하한을 강제. 배포 이미지의 Node 버전을 먼저 확인할 것 |
| 2 | nodejs.org 공식 v24.22.3 tarball을 작업 폴더에만 풀고 --port 7391 --no-open --data ./data |
“starting at http://127.0.0.1:7391/” → seal 키 생성(0600) → “running”. Docker가 없어 “new agents run on the runner” 안내 | beta.44의 “포트 먼저 바인딩, 이후 로딩” 변경이 로그로 확인됨 |
| 3 | server health |
{"status":"ok","checks":{"store":"ok","disk":"ok"}} |
SQLite 스토어 정상 |
| 4 | server capabilities |
server 0.1.0-beta.44, contract agentrun.v2/0. pi만 available(모델 없음 사유 표기), claude-agent·codex·opencode는 키 또는 바이너리 부재로 unavailable. 하네스별 run_memory_mib(pi 128, claude-agent 288, codex 192, opencode 704)와 max_concurrent_runs(124/55/82/22) 노출 |
러너가 하네스별 메모리 예약으로 동시성을 계산한다는 점이 드러남 |
| 5 | server openapi |
경로 140개 | 콘솔에서 할 수 있는 일은 대부분 API로도 가능 |
| 6 | README 워크플로를 {"workflow":…,"tools":["web_fetch"]}로 validate |
{"ok":true,"issues":[],"warnings":[]} |
README의 본문만 그대로 보내면 input_invalid. 요청 바디는 workflow 키로 감싸야 함(OpenAPI 확인) |
| 7 | out 스키마를 존재하지 않는 “Nope”으로 바꿔 validate |
SCHEMA_UNKNOWN at /root/steps/0 |
JSON 포인터로 정확한 위치 지적 |
| 8 | 허용 도구 목록을 비우고 validate | TOOL_NOT_LISTED: “uses the tool web_fetch, which the revision does not list in its tools” |
학습된 워크플로가 권한을 넘지 못하게 하는 장치가 정적 단계에서 작동 |
| 9 | agents create (README notes 에이전트) |
생성 성공. approvals: "ask", harness: "pi" 기본값 주입, definition.model에 not_set_up_here 경고 |
기본 승인 모드가 “ask”. 안전한 쪽이 기본값 |
| 10 | runs start notes --max-cost-usd 1 |
오류 agent_not_runnable(모델 없음), 런 생성 안 됨 (runs list 결과 0건) |
모델이 없으면 빈 런을 만들지 않고 시작 단계에서 거부 |
빈 서버의 데이터 폴더는 676KB였습니다. 안에는 store.sqlite(+WAL), seal/seal.key, .token, .session-secret, owner.json이 들어 있었습니다. 운영 관점에서는 데이터 폴더와 seal 키를 함께 백업해야 한다는 점을 기동 로그가 직접 경고합니다. 측정을 마친 뒤 서버는 종료했습니다.
배포 옵션과 비용 감각
| 옵션 | 구성 | 셸(샌드박스) | README 기재 비용·특징 |
|---|---|---|---|
로컬 npx |
서버 + 러너 1개, ~/.agentrun |
Docker가 돌고 있으면 Docker 샌드박스 | 무료, 첫 샌드박스 이미지 빌드에 수 분 |
| Railway 템플릿 | 이미지 + /data 볼륨 + 도메인 |
없음 | Hobby 플랜 약 월 $5. “클릭부터 첫 런 완료까지 46초” |
Render (render.yaml) |
1 CPU / 2GB, 10GB 디스크 | 없음 (Docker 없음, 파일 도구 + web_fetch) |
인스턴스 약 월 $25 + 디스크 $2.50 (작성 시점 Render 가격) |
Docker Compose (deploy/) |
서버 + 러너 2개, 루프백 바인딩 | 없음 (Docker 소켓 미노출). 샌드박스가 필요하면 루트 compose.yaml + Docker Engine 26+ |
TLS 프록시는 직접. AGENTRUN_SEAL_KEY를 .env(0600)에 |
| 러너 + Postgres | AGENTRUN_STORE_URL, 서버 --no-runner, 러너 여러 개 |
구성에 따름 | 모든 프로세스가 같은 seal 키 필요. 이번 릴리스에서도 러너들이 /data 볼륨을 공유 |
매니지드 배포 옵션 상당수가 “에이전트에 셸 없음”이라는 점에 주의해야 합니다. 코드 리뷰처럼 bash가 품질을 좌우하는 작업(앞의 70% → 7% 사례)이라면 Docker가 있는 호스트나 원격 샌드박스 제공자(Daytona, Modal, E2B 등)를 붙여야 하고, 그 비용은 각 벤더 계정으로 청구됩니다.
비교: 어디에 놓이는 도구인가
아래 비교는 각 프로젝트의 공개 문서에 나온 일반적인 포지셔닝을 기준으로 했습니다. 성능 수치 비교가 아닙니다.
| 관점 | AgentRun | LangGraph (+ 플랫폼) | Letta | Temporal |
|---|---|---|---|---|
| 정체성 | 기존 하네스 위의 운영 계층 (학습 + 내구 실행 + 통제) | 그래프 기반 에이전트 오케스트레이션 라이브러리 | 장기 메모리를 가진 상태형 에이전트 서버 | 범용 내구 실행(워크플로) 엔진 |
| 에이전트 루프 | pi / Claude Code / Codex / OpenCode를 그대로 사용 | 직접 그래프로 작성 | Letta 자체 에이전트 루프 | 없음 (직접 구현) |
| “학습”의 단위 | 검사·채점 후 git에 커밋되는 노트, 스킬, 워크플로 | 체크포인트와 스토어(직접 설계) | 메모리 블록과 아카이브 메모리 | 해당 없음 |
| 내구성 | 단일 스토어 저널, 30초 리스, 끝난 스텝 재실행 없음, 끊긴 쓰기는 interrupted | 체크포인터 기반 재개 | 서버 DB에 상태 저장 | 이벤트 히스토리 재생, 업계 표준급 |
| 사람 개입 | 도구별 allow/ask/deny, 질문, 상한 일시정지, 브라우저 take over | interrupt로 구현 | 도구 승인 기능 제공 | 시그널로 직접 구현 |
| 라이선스 | Apache-2.0 | MIT (라이브러리) | Apache-2.0 | MIT |
| 성숙도 | 공개 2개월, 베타 44회, 잦은 breaking | 성숙 | 성숙 | 매우 성숙 |
MoricWorld가 이전에 다룬 프로젝트들과 겹치는 부분도 정리했습니다. 에이전트 메모리 계층(gbrain, Hindsight)은 “무엇을 기억하나”에 집중하고, 거버넌스형 코워커(OpenWorker)는 “무엇을 허락하나”에 집중합니다. AgentRun은 여기에 “기억을 워크플로로 컴파일해서 저가 모델로 넘긴다“는 비용 축을 더했다는 점이 차별점입니다.
| 상황 | AgentRun이 맞는 편 | 다른 선택이 나은 편 |
|---|---|---|
| 같은 유형의 작업이 하루 수십~수천 건 반복 (KYB, 분류, 리뷰, 리드 스코어링) | ✔ 학습 → 워크플로 → 저가 모델 핸드오프 구조가 정확히 이 경우를 겨냥 | |
| 이미 Claude Code·Codex로 돌리는 크론 작업에 관측, 승인, 비용 통제를 붙이고 싶음 | ✔ Connect agent / 관측 전용 모드는 모델 키도 필요 없음 | |
| 매번 다른 탐색형 작업 (리서치, 일회성 코딩) | 학습 이득이 작음. 하네스 단독이 더 단순 | |
| 규제 산업의 엄격한 변경 관리, API 안정성 필수 | 베타 단계. 버전 고정과 자체 회귀 테스트 없이는 비추천 | |
| 에이전트 무관한 범용 내구 워크플로 | Temporal 같은 전용 엔진 |
트레이드오프와 주의점
| 쟁점 | 내용 | 대응 |
|---|---|---|
| API 변동성 | beta.44만 봐도 breaking 3건: 키 없는 게이트웨이 런 422 model_key_required, 하네스 ID enum → 문자열, Composio 트리거 하위 레벨 자격 증명 거부 |
이미지 태그와 npm 버전 고정, CHANGELOG의 “Upgrading and going back” 절 확인 후 업그레이드 |
| 자체 발표 벤치마크 | 1.6배, 7배 수치는 자사 데이터, 자사 채점기(Opus) 기반. 경쟁사가 지표 선택을 반박 | 템플릿의 eval 케이스와 learning-Off 대조군으로 자기 데이터에서 재측정 |
| 학습 비용과 지연 | 회고 턴 + 그레이더 호출이 런마다 추가. 노트가 예산을 넘으면 선택적 주입 | learning cost, Learning 탭으로 순이익 추적. 불필요한 노트는 learning retire |
| 상한의 경계 | HN에서 “백그라운드 프로세스로 시간 제한 우회” 질문에 메인테이너가 아직 검토 중이라고 답. 가격을 매길 수 없는 비용은 $0이 아니라 “unknown”으로 표시 | 샌드박스 쪽 자원 제한(벤더 측)을 병행. unknown 비용 런 모니터링 |
| 구독 사용 | README상 Codex·pi는 ChatGPT 플랜으로 실행 가능, Claude Code는 키 필요. ChatGPT 로그인은 서버 운영자 본인 전용, 공유 금지 | 팀 서버에는 상한과 만료일을 건 OpenRouter 키 권장(README) |
| seal 키 단일 장애점 | 모든 비밀이 AGENTRUN_SEAL_KEY 하나로 봉인. 잃으면 복구 불가 |
데이터 폴더와 키를 함께, 분리된 비밀 저장소에 백업 |
| Node 하한 | 24.22.3 패치 버전까지 강제 (박스에서 24.22.1 거부 확인) | 공식 설치 스크립트 또는 컨테이너 이미지 사용 |
| 원격 연결 모드 | 원격 실행 연결은 “개발 빌드”에서만, 서버와 Python 커넥터가 같은 체크아웃이어야 함. 공개 CLI는 관측 전용 | 프로덕션은 관측부터, 원격 실행은 별도 검증 |
| 텔레메트리 | 익명 카운트(무작위 ID, 버전, 플랫폼) 설계. 이번 릴리스는 수신 키가 없어 실제로는 아무것도 보내지 않음 | AGENTRUN_TELEMETRY=0 또는 DO_NOT_TRACK=1 |
도입 체크리스트 (실무자용)
- 반복성부터 측정하세요. 같은 유형의 작업이 충분히 반복되지 않으면 학습 계층의 이득보다 회고·그레이딩 비용이 더 클 수 있습니다.
- 관측 전용으로 시작하세요. Connect agent의 observe 모드는 모델 키가 필요 없고, 학습이나 트랜스크립트 가져오기도 자동으로 켜지지 않습니다.
- 기본 승인 모드
ask를 유지한 채 도구별로 allow/deny를 좁혀 가세요. “Never ask”를 켜도 서버 측 deny는 계속 유효합니다. - 런마다
--max-cost-usd를 거세요. 상한에 닿으면 실패가 아니라 일시정지하고, 계속하려면 최소 얼마가 더 필요한지 알려 줍니다. - 템플릿 eval을 CI에 넣으세요.
template eval로 learning On/Off를 비교하고, 버전을 올릴 때마다 회귀를 확인합니다. - 버전을 고정하세요. 서버 이미지
v0.1.0-beta.N과 CLI@parcha/agentrun@x.y.z를 함께 고정하고, CHANGELOG의 되돌리기 절차를 미리 읽어 둡니다.
총평
AgentRun이 흥미로운 이유는 “자기개선 에이전트”라는 화려한 구호 때문이 아닙니다. 그 구호를 git 커밋, 코드 검사, 그레이더, 드라이런, 권한 상속이라는 지루하고 검증 가능한 부품으로 쪼갰다는 점이 핵심입니다. 비싼 모델이 일을 익히고 그 경로를 워크플로로 굳혀 싼 모델에 넘기는 구조는, 반복 업무가 많은 팀의 토큰 청구서를 정면으로 겨냥합니다. 반면 공개된 지 두 달, 베타 44회, 매 릴리스 breaking이라는 속도는 지금 당장 핵심 시스템에 묶기 어려운 이유이기도 합니다. 지금 할 만한 일은 반복 업무 하나를 골라 learning Off와 On을 자기 데이터로 비교해 보는 것입니다. 박스 실측에서 확인했듯, 서버를 띄워 API와 검증기를 만져 보는 데는 모델 키 없이 10분이면 충분합니다.