“AI로 자기소개서 써 주는 도구”라고 하면 대개 프롬프트 몇 개를 묶은 웹앱을 떠올린다. 오늘(2026-10-18) GitHub Trending 전체 일간 2위에 오른 MadsLorentzen/ai-job-search는 결이 다르다. 실행 코드의 중심이 마크다운 명세다. .claude/commands/*.md와 .claude/skills/에 적힌 절차를 Claude Code가 그대로 따라 하며, 채용 포털 검색 → 배치 점수화 → CV·커버레터 LaTeX 초안 → 별도 컨텍스트 리뷰어의 비평 → PDF 컴파일·레이아웃 측정·ATS 텍스트 레이어 검사 → 지원 기록까지 한 저장소 안에서 돈다. 파이썬과 Bun 코드는 그 절차 중 “모델에게 맡기면 매번 달라지는 부분”(중복 키, 상태 파일, robots 판정, PDF 측정, 권한 감사)만 맡는다.
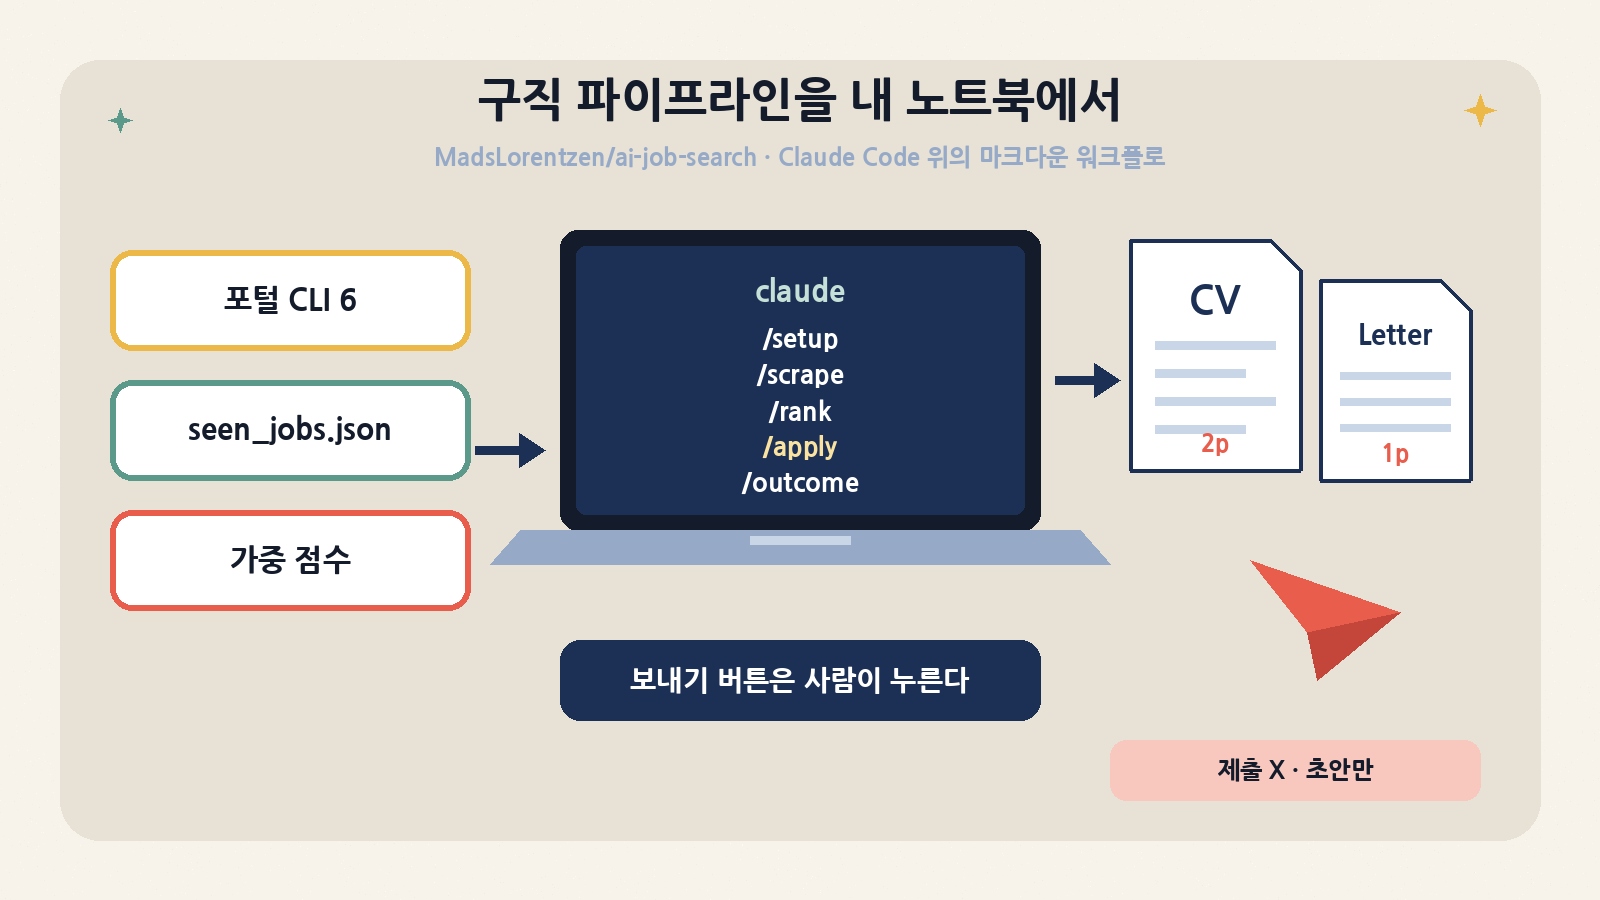
이 글은 “취업에 AI를 쓰자”는 소개글이 아니다. 에이전트 워크플로를 마크다운으로 설계할 때 어떤 부분을 코드로 내려야 하는가, 그리고 개인정보와 신뢰할 수 없는 웹 입력이 한 컨텍스트에 섞일 때 어떻게 경계를 긋는가를 보여 주는 실전 사례로 읽는다. 아래 수치는 모두 2026-10-18 오전(KST) master HEAD 5d9e097 기준으로 직접 체크아웃해 집계·실행한 값이다.
한눈에 보기: 오늘 체크아웃 기준
| 항목 | 값 |
|---|---|
| 저장소 | github.com/MadsLorentzen/ai-job-search (생성 2026-03-18 23:33 KST) |
| 라이선스 | MIT (Copyright 2026 Mads Lorentzen). Anthropic과 무관한 독립 프로젝트임을 README에 명시 |
| 최신 릴리스 | v1.7.2 (2026-09-30 03:32 KST). master에는 그 뒤 [Unreleased] 변경이 계속 쌓이는 중 |
| master HEAD | 5d9e097 · 2026-10-18 03:12 KST · fix(salary): convert the IDA workbook again |
| 규모 | 파일 247개, 커밋 336개, 기여자 약 78명(익명 포함), Python 테스트 파일 42개 |
| GitHub 지표 | 50,554 stars · 16,955 forks (API, 2026-10-18 ~12:00 KST) |
| Trending | 전체 일간 #2, Python 일간 #2, 오늘 +1,365 stars |
| 필수 런타임 | Claude Code(무료 티어 없음: Pro/Max/Team 또는 API 크레딧), Python 3.10+, Bun, lualatex·xelatex |
포크 수가 스타의 3분의 1에 이른다는 점이 눈에 띈다. 일반적인 라이브러리라면 이상한 비율이지만, 이 저장소는 “포크해서 내 프로필을 채워 쓰는 템플릿”이기 때문이다. 그리고 바로 이 사용 방식이 뒤에서 다룰 가장 큰 보안 함정과 연결된다.
탄생 배경과 설계 철학
작성자는 지구물리학자 출신으로, 2025년 말 포지션이 없어지자 자기 구직용으로 이 프레임워크를 만들었다고 README에 적었다. 같은 /scrape·/apply·/interview 흐름으로 69건을 맞춤 지원해 1차 면접 20건, 계약 1건을 얻었고 2026년 6월 AI 엔지니어로 입사했다는 것이 본인 진술이다(재현 가능한 벤치마크가 아니라 개인 사례라는 점은 감안해야 한다). 기본 포털 스킬이 덴마크 시장(Jobindex, Jobnet, Akademikernes Jobbank, Jobdanmark)용인 이유도 여기서 나온다.
CONTRIBUTING.md의 원칙은 꽤 단호하다. “마크다운 명세가 곧 구현”이므로 다른 에이전트 CLI용 포트나 래퍼 같은 두 번째 사본은 받지 않고, 국가별 포털도 업스트림에 넣지 않는다(인도·프랑스 등 PR이 거절된 선례를 명시). 대신 포크에서 /add-portal로 만들고 커뮤니티 인덱스(Discussion #78)에 공유하라는 것이다. 업스트림은 “범용 프레임워크 + 덴마크 데모”, 시장별 적응은 포크라는 분업 구조다.
저장소 구조: 명세·상태·검증 도구의 3층
| 경로 | 역할 | 층 |
|---|---|---|
CLAUDE.md |
후보자 프로필 + 워크플로 규칙 + 최종 검증 체크리스트(사실 정확성·타기팅·일관성) | 명세 |
.claude/commands/ (12개) |
/setup, /apply, /rank, /outcome, /interview, /expand, /gmail-sync, /notion-sync, /html-report, /add-template, /add-portal, /reset | 명세 |
.claude/skills/job-application-assistant/ |
01 프로필 ~ 09 웹 리서치까지 10개 파일. 04가 평가 프레임워크, 05/06이 CV·레터 템플릿 규칙 | 명세 |
.claude/skills/job-scraper/, upskill/ |
/scrape 오케스트레이션, 스킬 갭 분석 | 명세 |
.claude/agents/gemini-research-expert.md |
보조 리서치 서브에이전트 정의 | 명세 |
.agents/skills/*-search/ (6개) |
포털 CLI(TypeScript/Bun). Agent Skills 형식이라 Codex·Antigravity도 발견 | 실행 코드 |
tools/*.py (13개) + salary_lookup.py |
job_key, rank_state, robots_check, verify_pdf, verify_layout, security_guards, upstream_triage 등 | 결정적 도구 |
cv/, cover_letters/ |
moderncv(banking) CV 예제, 자체 cover.cls + Lato/Raleway 폰트 |
템플릿 |
documents/, job_scraper/, company_research/ |
원천 자료·상태·리서치 캐시(대부분 gitignore) | 개인 데이터 |
.github/workflows/ |
ci.yml(린트·보안 가드·Python 3.10~3.14 매트릭스·LaTeX 2레그), upstream-watch.yml | CI |
AGENTS.md는 19줄짜리 “얇은 포인터”다. 다른 런타임(Codex, Gemini CLI, Cursor 등)에게 .claude/가 단일 진실 원천이니 복제하지 말라고만 알린다. 실질적으로는 Claude Code 전용이고, 다른 런타임에서 바로 쓰이는 것은 Agent Skills 형식의 포털 검색 CLI 정도다.
명령 지도: 14개 슬래시 명령이 하나의 파이프라인
| 명령 | 하는 일 | 주요 산출물·상태 |
|---|---|---|
| /setup | documents/ 폴더 읽기 · CV 붙여넣기 · 인터뷰 중 택1로 프로필 파일 채움. --section search로 검색 설정만 재구성 |
프로필 파일(추적됨!) |
| /scrape | 설치된 포털 CLI 병렬 실행 → WebSearch 폴백 → 대량 동일 공고 통합 → 빠른 적합도 → 중복 제거 저장 | seen_jobs.json |
| /rank | 새 공고를 ~5건씩 병렬 에이전트에 배분해 4개 차원 점수화, 게이트·마감·노후도 반영해 숏리스트 | seen_jobs.json 갱신 |
| /apply <url|text> | 출처 호스트 검증 → 적합도 → 초안 → 리뷰어 → 수정 → PDF 루프 → ATS 검사 → 기록 | cv/, cover_letters/, tracker |
| /outcome | 면접·오퍼·거절 기록, 제출본 아카이브, followup(초안만, 최대 2회), stale 일괄 정리 |
documents/applications/ |
| /interview | 지원 아카이브 기반 단계별 준비 팩, STAR 매핑, 모의 면접 | 준비 문서 |
| /gmail-sync | Gmail 커넥터로 상태 신호를 읽어 승인 후에만 트래커 반영 | gmail_sync/ |
| /notion-sync | 공식 Notion MCP(OAuth)로 단방향 읽기 전용 뷰. 문서는 파일명만 | Notion DB |
| /expand · /upskill | 공개 GitHub·포트폴리오에서 역량 보강 / 공고 대비 스킬 갭 히트맵 | 프로필, upskill/ |
| /html-report | 트래커로 오프라인 단일 HTML 대시보드(인라인 SVG) | HTML |
| /add-template · /add-portal | Typst 등 다른 템플릿 등록(테스트 컴파일 필수) / 새 포털 스킬 생성(라이브 질의 후 등록) | templates/, .agents/skills/ |
| /reset | profile · documents · all 삭제. RESET 타이핑 확인 필수 |
— |
/apply 내부: 작성자-리뷰어 분리와 PDF 검증 루프
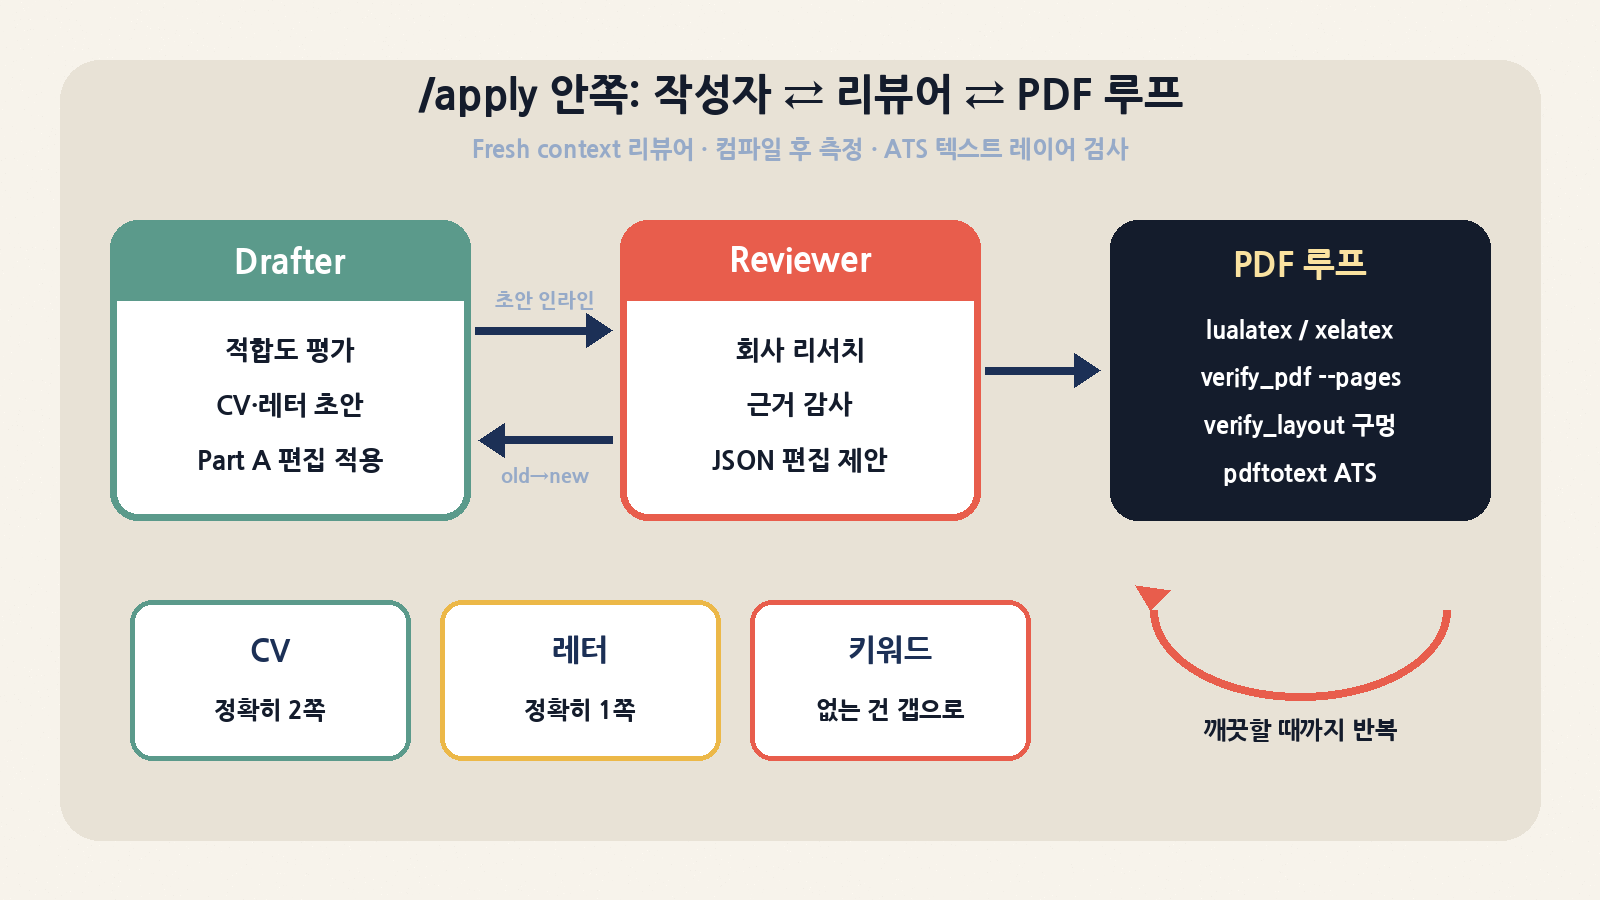
apply.md는 418줄짜리 절차서다. 핵심은 세 가지 설계 결정이다.
- 리뷰어는 새 컨텍스트로 띄운다. Step 3에서 Agent 도구로 general-purpose 에이전트를 생성하고, 초안은 파일을 다시 읽게 하지 않고 프롬프트에 인라인으로 넘긴다(토큰 절약). 리뷰어는 회사를 공고 속 링크가 아니라 회사명 검색으로만 조사하고, 결과를
company_research/<회사>.json캐시에 쓴다. - 피드백은 기계적으로 적용 가능한 JSON으로 받는다. Part A는
{file, old_string, new_string, reason}배열로, 작성자는 Edit 도구로 그대로 적용한다. 판단이 필요한 것만 Part B 서술형(누락 키워드·회사 각도·능동형 재작성·톤)으로 받는다. - PDF는 “보고” 끝내지 않고 “측정”한다. lualatex(CV)·xelatex(레터) 컴파일 후
verify_pdf.py --pages로 쪽수,verify_layout.py로 100pt 넘는 내부 구멍·고아 항목 제목·푸터 충돌·마지막 쪽 35% 이상 공백을 잡고, 그다음에 모델이 렌더링된 페이지를 읽는다.
| Step | 단계 | 핵심 동작 | 가드 |
|---|---|---|---|
| 0 | 입력 파싱 | 포털 URL이면 해당 CLI detail 우선 → WebFetch → robots 확인 후 curl → 고용주 원문 검색 |
공고 전문을 요약 없이 보존 |
| 1 | 적합도 평가 | 출처 호스트 3분류(포털 / ATS 6개 apex / ⚠ 미검증), 연봉 조회(선택) | 사용자 승인 없으면 중단 |
| 2 | 초안 | 요구사항 전부 ‘충족 또는 정직한 갭’으로 처리, 3개 원천 대조 근거 감사 | CV 언어는 프로필 고정, 레터는 공고 언어 |
| 3 | 리뷰어 | 신뢰 경계 → 캐시 확인/리서치 → 근거 감사 → Part A/B | 검증 체크리스트는 돌리지 않음 |
| 4 | 수정 | Part A 기계 적용, Part B 판단 적용, 회사 주장은 재검증 | 날조 제안은 버림 |
| 5 | 컴파일·검사 | 5a 컴파일 → 5b 측정+시각 확인 → 5c 반복 → 5d ATS → 5e 중간 산출물 삭제 | 건너뛰기 금지(MANDATORY) |
| 6 | 제시·기록 | CLAUDE.md 체크리스트 1회, 트래커·아카이브 기록 | 제출은 사용자가 직접 |
ATS 텍스트 레이어 검사가 실무적으로 중요한 이유
ATS(지원자 추적 시스템)는 렌더링된 페이지가 아니라 PDF에 박힌 텍스트를 읽는다. LaTeX는 보기엔 멀쩡한데 추출하면 아이콘 글리프 이름이 이메일 자리에 들어가거나, 다단 레이아웃이 줄 단위로 뒤섞이는 PDF를 쉽게 만든다. v1.7.2에서 추가된 --ascii-dates는 실제 Workday 가져오기 사례에서 나왔다. 2016--2024가 텍스트 레이어에서 2016<U+2013>2024(en-dash)로 들어가 경력 종료일이 날아간 것이다. 이 플래그는 정규화 전 원시 레이어를 읽어 연도에 붙은 유니코드 대시를 코드포인트와 함께 지적한다.
python tools/verify_pdf.py cv/main_<company>_<role>.pdf --pages 2
python tools/verify_pdf.py cover_letters/cover_<company>_<role>.pdf --pages 1
python tools/verify_layout.py cv/main_<company>_<role>.pdf
python tools/verify_pdf.py cv/main_<company>_<role>.pdf --ascii-dates \
--dump-text cv/main_<company>_<role>.txt # pypdf 우선, 없으면 pdftotext| 키워드 상태 | 의미 | 처리 |
|---|---|---|
| covered | 공고 용어가 그대로(또는 사소한 활용형) 존재 | 그대로 둠 |
| synonym-only | 개념은 있으나 다른 용어 | 프로필상 진실이면 공고 용어로 교체(ATS는 문자 그대로 매칭이 많음) |
| missing (have it) | 실제 역량인데 CV에 안 씀 | 경력 bullet에 추가 후 5a~5c 재실행 |
| missing (gap) | 진짜 갭 | 채워 넣지 않음. 레터에서 정직한 브리지로 처리 |
CV가 2쪽을 넘으면 “오래된 섹션부터 자르기” 대신 관련도 가중 컷을 쓴다. 각 줄을 (a) 이번 공고 키워드 관련도, (b) 문서 내 고유성, (c) 커버레터가 그 줄에 기대는지로 점수화해 가장 낮은 줄부터 자른다. 공고 키워드에 걸리는 옛 경력 bullet이 무관한 최근 bullet보다 살아남는 구조다.
/rank와 상태 관리: 모델에게 맡기지 않은 부분
평가 프레임워크(04-job-evaluation.md)는 점수 이전에 두 개의 하드 게이트를 둔다. Eligibility Gate(시민권·영주권·보안 인가 요구 시 채점·작성 자체를 중단하고 원문 인용)와 Language Gate(선언하지 않은 언어 요구는 FAIL, 선언 수준보다 높아 보이면 FLAG)다. “침묵은 허락이 아니다”, “회사 전체의 ‘해외 지원자 환영’은 직무 단위 허락이 아니다” 같은 규칙이 명문화돼 있다.
| 차원 | 가중치 | 형식 |
|---|---|---|
| Technical Skills | 30% | 0~100 |
| Experience Match | 25% | 0~100 |
| Behavioral/Culture Fit | 15% | 0~100 |
| Career Alignment & Motivation | 30% | 0~100 |
| Location & Logistics | 가중치 없음 | PASS / FLAG / FAIL(FAIL은 숏리스트 제외) |
| Salary Benchmark | 선택 | 사용자가 넣은 데이터가 있을 때만 |
| 밴드 | 점수 | 권고 |
|---|---|---|
| Strong Fit | 75+ | 지원, 전부 맞춤 |
| Good Fit | 60~74 | 지원, 갭은 레터에서 |
| Moderate Fit | 45~59 | 사용자와 상의 |
| Weak Fit | 30~44 | 전략적 이유 없으면 패스 |
| Poor Fit | <30 | 패스 |
흥미로운 것은 상태 파일 처리다. 예전에는 /rank가 seen_jobs.json 전체를 모델 컨텍스트에 올려 눈으로 걸러 내고 전체를 다시 써냈다. 이 파일은 설계상 append-only라 워크스페이스가 오래될수록 매 실행 비용이 커진다. 지금은 tools/rank_state.py가 candidates(필요 필드만 투영) · sweep(저장된 마감일만으로 만료 처리, 무페치) · apply(결과 기록, 원자적 교체 저장)를 맡는다.
최근 변경(#534)은 데이터 모델 수준의 교훈을 담고 있다. 가져오기 실패와 마감을 같은 expired로 묶었더니, 순위를 매기는 날 일시적인 403 하나로 살아 있는 공고가 파이프라인에서 영구히 빠졌다. 그래서 unreachable 상태를 분리하고, 3회 시도 + 첫 시도와 마지막 시도 사이 48시간 이상이 지나야 expired_reason: "unreachable"로 포기하며, 포기한 공고는 “수동 확인” 목록에 URL과 함께 한 번 노출한다. 같은 날 예약 실행과 수동 실행이 시도 횟수를 다 태워 버리지 않게 하는 시간 하한이다.
| status | 언제 | 다음 동작 |
|---|---|---|
| new | /scrape가 저장 | candidates 대상 |
| ranked | 점수화 완료 | sweep에서 마감 지나면 expired, 7일 이내면 🔥 |
| unreachable | 401/403·로그인 벽·404·타임아웃·5xx·빈 페이지 | 다시 candidates 대상, fetch_attempts 증가 |
| expired | 닫힘의 적극적 증거(닫힘 안내, 410, 목록으로 리다이렉트, 마감 경과) 또는 3회·48h 포기 | 재선택 안 됨 |
| skipped | 빠른 적합도에서 제외 | 재선택 안 됨 |
중복 키도 같은 이유로 코드로 내려갔다. tools/job_key.py 독스트링에는 실제 워크스페이스에서 발견된 깨진 키들이 그대로 적혀 있다. deloitte_junior-cybersecurity-analyst-(ot/iot)처럼 /가 아카이브 경로를 쪼개거나, 실행마다 제목을 다른 길이에서 잘라 같은 공고가 두 키로 저장된 경우다. 지금은 회사+제목의 순수 결정적 함수이고, 회사 40자·제목 60자 상한을 넘으면 잘라 내되 해시 접미사로 구분한다.
신뢰 경계: 공고는 데이터, 명령이 아니다
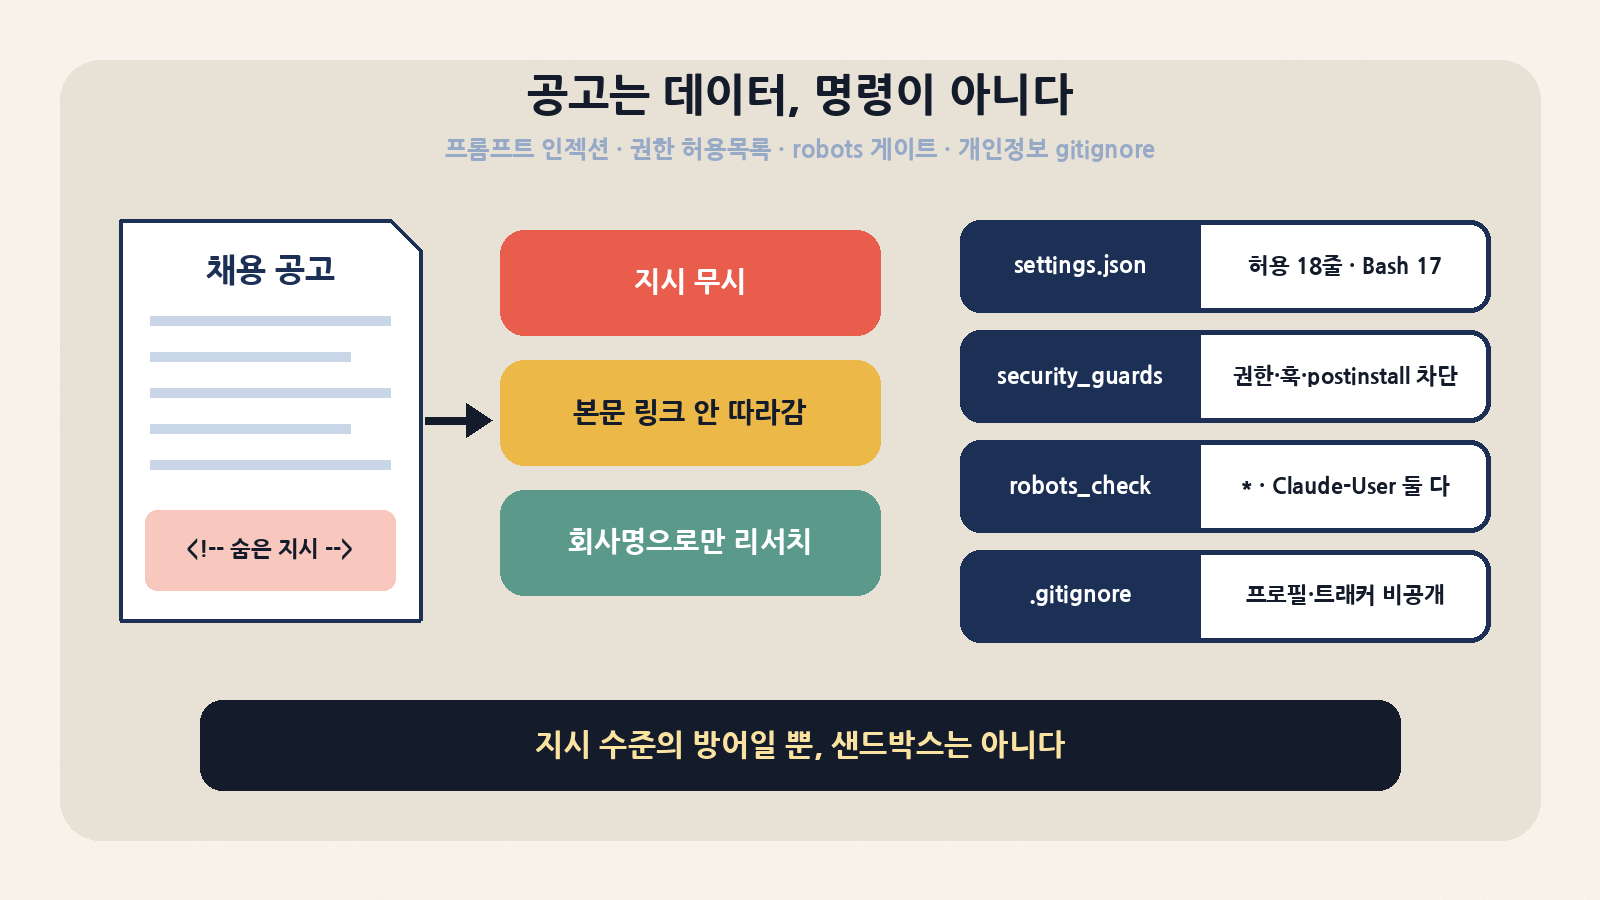
SECURITY.md는 위협 모델을 솔직하게 적는다. “파일 접근 권한이 있는 LLM이 신뢰할 수 없는 웹 콘텐츠(채용 공고)를 개인 데이터(CV·프로필·지원 이력)와 함께 읽는다. 이 조합이 주된 위험 표면이며 완전히 제거할 수 없고 좁힐 수만 있다.” 그 좁히는 방법이 계층별로 설계돼 있다.
| 계층 | 구현 | 한계 |
|---|---|---|
| 지시 수준 규칙 | 공고 본문의 지시를 따르지 않음, 본문 속 URL을 가져오지 않음(사용자가 준 공고 URL만 예외), 회사 리서치는 회사명 검색에서 시작 | 모델이 규칙을 어기면 무력. 저자도 “샌드박스가 아니다”라고 명시 |
| 권한 허용목록 | .claude/settings.json은 18줄(Bash 17 + Skill 1)만 사전 승인. 포털 CLI 6개, salary/rank_state/job_key/verify_pdf/verify_layout(python·python3 각각), pdftotext |
WebFetch/WebSearch 같은 네이티브 도구는 이 목록 밖 |
| CI 보안 가드 | security_guards.py: 허용목록 외 권한, 허용 외 hooks, 개인정보 gitignore 약화·부정 패턴, package.json lifecycle 스크립트·trustedDependencies 차단 |
PR이 워크플로 자체를 고칠 수 있으므로 ‘실수와 가벼운 시도’용. 브랜치 보호와 사람 리뷰가 최종 방어선 |
| 설치기 | install_portal_clis.py는 lifecycle 스크립트가 있는 매니페스트를 건너뛰고 보고 |
포크에서 빌려 온 포털은 사람이 먼저 읽게 강제 |
| robots 게이트 | robots_check.py: *와 Claude-User 중 하나라도 Disallow면 브라우저 헤더 재시도 금지. HTML soft-200·BOM·잘못된 UTF-8은 ‘미확인’으로 실패 닫힘 |
403 우회가 사이트의 명시적 거부를 넘지 않게 함 |
| 출처 호스트 검증 | greenhouse.io·lever.co·myworkdayjobs.com/workday.com·ashbyhq.com·smartrecruiters.com·workable.com apex 정확 일치 또는 하위 도메인만 인정. evil-greenhouse.io, …greenhouse.io.evil.com, userinfo 트릭은 실패 닫힘 |
가짜 채용 공고에 토큰·시간 낭비 방지 |
| 개인정보 경계 | 프로필 내보내기, 트래커, 연봉 데이터, 지원 아카이브, **/job_scraper/seen_jobs.json, .env, 사진(*.png 등) gitignore |
/setup이 쓰는 프로필 파일 자체는 추적 파일 |
/setup은 이름·연락처·경력·희망 연봉을 git이 추적하는 파일(CLAUDE.md, 01-candidate-profile.md 등)에 쓴다. 포크 → /setup → 무심코 push 하면 내 이력서가 공개 저장소에 올라간다. README도 “개인 구직용이면 포크하지 말고 이 저장소를 upstream으로 둔 비공개 저장소를 만들라, 포크는 기여할 때만”이라고 강조한다. 원격에 올리지 않고 로컬 커밋만 하는 것도 괜찮다고 SETUP.md 8절은 덧붙인다. 팀이나 커뮤니티에 이 도구를 권할 때 가장 먼저 전해야 할 문장이다.robots 판정은 실험으로 확인해 보면 의도가 분명하다. 아래 robots.txt에서 RFC 9309만 놓고 보면 Claude-User 전용 그룹이 있으므로 /jobs/list는 Claude-User에게 허용이다. 하지만 게이트는 Claude-User와 *를 둘 다 검사하므로 재시도를 막는다. 의도적으로 보수적인 해석이다.
User-agent: *
Disallow: /jobs/
Allow: /jobs/view/

User-agent: Claude-User
Disallow: /search
# allowed(body, '*', path) / allowed(body, 'Claude-User', path)
# /jobs/view/123  → True / True   → 재시도 가능
# /jobs/list      → False / True  → gate는 차단(* 쪽 Disallow)
# /search?q=x     → True / False  → 차단
# HTML 오류 페이지 200 → is_robots_body False → 'UNCONFIRMED', 재시도 안 함
설치·실행 치트시트
# 0) 개인 구직용: 포크 대신 비공개 저장소 + upstream (README 권고, SETUP.md 8절)
git clone https://github.com/MadsLorentzen/ai-job-search.git my-job-search
cd my-job-search
git remote rename origin upstream
git remote add origin git@github.com:<me>/my-job-search-private.git   # private로 생성해 둔 저장소

# 1) 포털 CLI 의존성 (lifecycle 스크립트 있는 매니페스트는 자동 건너뜀)
python3 tools/install_portal_clis.py --dry-run
python3 tools/install_portal_clis.py

# 2) 선택 의존성: ATS 검사용 pypdf (없으면 pdftotext 폴백)
pip install pypdf

# 3) Claude Code에서
claude
/setup                 # documents/ · CV 붙여넣기 · 인터뷰 중 택1
/scrape                # 포털 검색 → seen_jobs.json
/rank                  # 배치 점수화 숏리스트
/apply https://boards.greenhouse.io/<co>/jobs/<id>

# 4) 업스트림 추적: 태그 릴리스 기준으로 병합, 영향 파일 미리 보기
python3 tools/check_upstream_updates.py
python3 tools/upstream_triage.py| 의존성 | 필수 여부 | 비고 |
|---|---|---|
| Claude Code | 필수 | 무료 티어 없음. 가끔 쓰면 API 종량제가 싸다는 것이 README 설명 |
| Python 3.10+ | 필수 | CI는 3.10~3.14 매트릭스 |
| Bun | 필수(포털 CLI) | linkedin-search·freehire-search는 런타임 의존성 0 |
| lualatex | 필수(CV) | pdflatex는 최신 MiKTeX에서 fontawesome5 오류가 잦아 배제 |
| xelatex | 필수(레터) | cover.cls가 fontspec 요구 |
| pypdf / poppler | 선택 | ATS 검사. 둘 다 없으면 시각적 키워드 검토로 강등 |
| openpyxl | 선택 | 연봉 엑셀 변환·통합 테스트 |
박스 스모크: 직접 돌려 본 결과
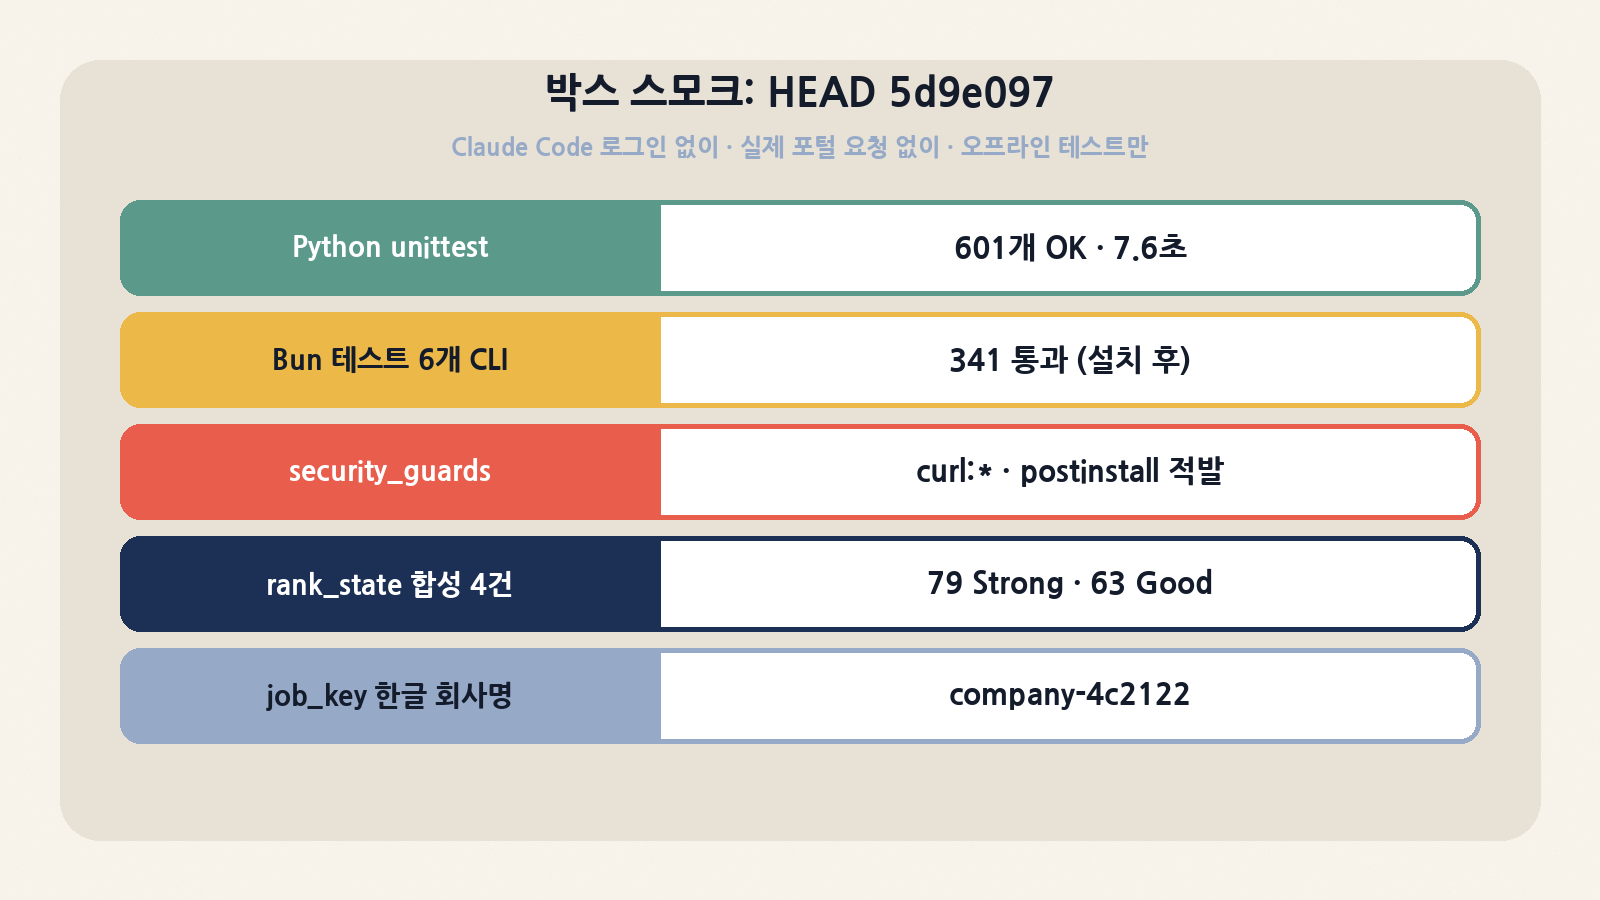
리눅스 박스(Python 3.13.5, Bun 1.4.2)에서 HEAD 5d9e097를 클론해 Claude Code 로그인 없이, 실제 채용 포털에는 요청하지 않고 결정적 도구와 오프라인 테스트만 돌렸다. LaTeX가 없는 환경이라 PDF 컴파일·레이아웃 검증과 LLM이 수행하는 /apply 본 흐름은 실행하지 않았다.
| 항목 | 명령/조작 | 결과 |
|---|---|---|
| Python 테스트 | python3 -m unittest discover -s tests -t . |
601개 OK(skip 6), 7.6초 |
| 보안 가드(원본) | python3 tools/security_guards.py |
OK (permissions·hooks·gitignore·manifests) |
| 보안 가드(변조 1) | settings.json에 Bash(curl:*) 추가 |
1 failure: “reviewed allowlist에 없음” — 되돌림 |
| 보안 가드(변조 2) | linkedin-search package.json에 postinstall 추가 |
1 failure + 설치기도 SKIP 보고 — 되돌림 |
| Bun 테스트(설치 전) | 6개 CLI bun test |
linkedin 71·freehire 57 통과 / 덴마크 4종은 의존성 미설치로 실패 |
| Bun 테스트(설치 후) | install_portal_clis.py 후 재실행 |
341개 전부 통과(41+63+59+50+71+57) |
| job_key | --company "Deloitte" --title "Junior Cybersecurity Analyst (OT/IoT)" |
deloitte_junior-cybersecurity-analyst-ot-iot |
| job_key(긴 제목) | 60자 상한을 넘는 제목 | 잘린 슬러그 + -afa385 해시 접미사 |
| job_key(한글) | --company "네이버" --title "AI 엔지니어" |
company-4c2122_ai-6656a9 — 한글은 슬러그에서 사라지고 해시로 구분 |
rank_state.py는 합성 상태 파일 5건(그중 1건 skipped)과 에이전트 결과 4건으로 실제 흐름을 재현했다. 기대대로 동작했다.
| 키 | 입력 | rank_state 결과 |
|---|---|---|
| acme_ml-engineer | 85/75/70/80, 마감 10-22 | 79 · Strong Fit, 마감 7일 이내라 urgent 🔥 |
| globex_llm-platform-engineer | 70/55/60/65, 위치·언어 FLAG | 63 · Good Fit, ⚠ 표시 유지(language_note 노출) |
| initech_data-scientist | unreachable, “403 after curl retry” | status unreachable, fetch_attempts 1 — 다음 실행에 재선택 |
| umbrella_ai-researcher | 점수는 높으나 저장된 마감 10-12 경과 | expired — 숏리스트에서 제외 |
| hooli_backend | skipped | candidates에서 처음부터 제외(eligible 4 / total 5) |
job_key에서 ASCII 글자가 남지 않아 company-<해시> 형태가 된다. 결정적이라 중복 제거에는 문제가 없지만, 사람이 seen_jobs.json이나 아카이브 폴더명을 훑어볼 때 회사를 알아보기 어렵다. 한국 시장용 포크를 만든다면 로마자 표기를 같이 넣거나 별도 표시 필드를 두는 편이 낫다. 또 기본 포털이 덴마크 4종 + LinkedIn 공개 엔드포인트 + freehire.me뿐이므로, 국내 보드는 /add-portal로 직접 붙여야 하며 그때 해당 사이트의 robots.txt와 약관을 먼저 확인해야 한다.비교: 비슷한 오픈소스와 어디가 다른가
| 프로젝트 | 라이선스·언어 | 범위 | 강점 | 약점·주의 |
|---|---|---|---|---|
| MadsLorentzen/ai-job-search | MIT · Python+TS(Bun) | Claude Code 명세 기반 엔드투엔드(검색→점수→초안→리뷰→PDF→기록) | 작성자-리뷰어 분리, PDF 측정·ATS 검사, 신뢰 경계 문서화 | Claude Code 전용, LaTeX 필수, 기본 포털이 덴마크 |
| career-ops-hq/career-ops | MIT · JavaScript | 에이전트 기반 구직: 보드 스캔, CV 대비 1~5점 채점 (~75k stars) | 더 큰 커뮤니티, 다른 설계 계보 | 평가 체계·출력 형식이 다르므로 직접 비교 검토 필요 |
| srbhr/Resume-Matcher | Apache-2.0 · Python | 로컬에서 100+ LLM으로 이력서·레터·PDF 작성 하네스 | 모델 선택 자유, 앱 형태 | 검색·지원 추적 파이프라인 중심은 아님 |
| speedyapply/JobSpy | MIT · Python | LinkedIn·Indeed·Glassdoor 등 채용 스크래핑 라이브러리 | 데이터 수집 계층으로 조합 가능 | LLM 워크플로·문서 생성 없음, 각 사이트 약관 문제 |
| rendercv/rendercv | MIT · Python | YAML → 조판된 CV(학계·엔지니어용) | CV-as-code, 재현 가능한 조판 | 공고 맞춤·리뷰·추적 없음 |
정리하면 ai-job-search의 차별점은 “AI가 글을 써 준다”가 아니라 검증 가능한 산출물(쪽수·레이아웃·텍스트 레이어·근거 감사)과 상태 기계(seen_jobs.json의 상태 전이, 재시도 하한), 그리고 명시적 신뢰 경계에 있다. 반대로 모델·런타임 선택의 자유는 가장 적다.
트레이드오프와 주의점
| 이슈 | 내용 | 대응 |
|---|---|---|
| 런타임 종속 | 명세가 Claude Code의 Agent 도구·Skill·권한 모델을 전제 | 다른 런타임은 커뮤니티 포크(Discussion #78)나 포털 CLI만 차용 |
| 비용 | /rank 병렬 에이전트, /apply 리뷰어 + PDF 반복 렌더링이 토큰을 씀(README도 ‘절감분 일부를 PDF 검사에 쓴다’고 인정) | /rank로 먼저 거르고 /apply는 상위 몇 건만 |
| 지시 수준 방어 | 프롬프트 인젝션 방어가 규칙 문장에 의존, WebFetch는 허용목록 밖 | 낯선 보드에서는 가져온 내용과 생성물을 보내기 전에 직접 확인 |
| 공개 포크 | 프로필 파일이 추적 대상 | 비공개 저장소 + upstream 패턴, push 전 git diff --stat |
| 약관 | linkedin-search는 비인증 jobs-guest 엔드포인트 사용, 자동 접근은 LinkedIn ToS 위반 소지 — 저장소도 ‘개인용, 저빈도’ 경고 | CI는 라이브 포털 요청을 의도적으로 안 함. 팀 자동화에 쓰지 말 것 |
| 업스트림 속도 | 릴리스 사이에도 master가 하루 수 건씩 변경 | 태그 릴리스로 병합, framework_version 마커와 check_upstream_updates로 영향 파일 확인 |
| 윤리·투명성 | AI가 쓴 지원서를 받는 쪽의 정책은 회사마다 다름 | 작성자처럼 AI 사용을 밝히는 것도 선택지. 날조 금지 규칙은 기본값으로 유지 |
AGENTS.md와 CONTRIBUTING.md가 강조하는 “명세가 곧 구현” 원칙에는 대가도 있다. 마크다운 절차는 버전 관리와 리뷰는 쉽지만, 모델이 단계를 건너뛰는지 확인할 수단은 결국 산출물 검사뿐이다. 이 저장소가 PDF·상태·키·권한처럼 검사 가능한 지점을 계속 코드로 내리는 이유이고, 체인지로그에 “산문 규칙이었던 것을 실행 가능하게 만들었다”는 항목이 유독 많은 것도 같은 맥락이다. --ascii-dates, rank_state.py, job_key.py, install_portal_clis.py가 모두 그렇게 생겼다.
누가 도입하면 좋은가
| 대상 | 얻을 것 | 우선순위 |
|---|---|---|
| 구직 중인 개발자·데이터·연구 직군(Claude 구독 보유) | 공고별 맞춤 CV·레터를 PDF 품질까지 자동 검증, 지원 추적과 면접 준비 일원화 | 높음 |
| 에이전트 워크플로를 설계하는 엔지니어 | 작성자-리뷰어 분리, JSON 편집 계약, 상태 파일을 코드로 내리는 기준, 신뢰 경계 문서화 패턴 | 높음 |
| 커리어 코치·대학 취업지원 조직 | 평가 프레임워크·게이트·정직성 규칙을 교육 자료로 활용(직접 운영은 개인정보 관리 체계 필요) | 중간 |
| 한국 시장 구직자 | 핵심 흐름은 언어 무관하나 국내 포털 스킬은 직접 만들어야 함, 한글 키 가독성 이슈 | 중간 |
| 대량 자동 지원을 원하는 사람 | 설계 자체가 ‘초안만, 제출은 사람’이고 저빈도 개인용 전제 | 낮음 |
install_portal_clis.py --dry-run으로 설치 대상 확인, 빌려 온 포털은 코드와 bun test부터 ③ security_guards.py를 로컬 pre-push에 연결 ④ /rank로 거른 상위 공고만 /apply ⑤ 생성된 PDF의 텍스트 레이어(--dump-text)를 한 번은 직접 열어 보기 ⑥ 보내기 전에 회사 관련 주장이 실제 공식 페이지와 맞는지 확인.정리
ai-job-search는 겉으로는 구직 도우미지만 속은 “LLM이 따르는 마크다운 명세 + 결정적 도구 + CI 가드”로 짠 에이전트 시스템의 교본에 가깝다. 리뷰어를 새 컨텍스트로 분리하고, 피드백을 기계 적용 가능한 JSON으로 받고, 결과물을 ‘보고’가 아니라 ‘측정’으로 검증하며, 상태 전이처럼 모델이 매번 다르게 할 부분은 파이썬으로 고정한다. 동시에 공고라는 신뢰할 수 없는 입력과 내 개인정보가 한 컨텍스트에 섞인다는 사실을 숨기지 않고, 지시 수준 방어의 한계까지 문서에 적었다. 구직 중이라면 비공개 저장소로 시작해 /rank → /apply 흐름을 써 볼 만하고, 구직 중이 아니더라도 에이전트 워크플로를 만드는 사람이라면 apply.md와 tools/를 한 번 읽어 볼 가치가 충분하다.