챗GPT, 제미나이, 클로드, 딥시크… 요즘은 AI 서비스가 정말 많죠. 그래서 “한 AI 답이 마음에 안 들면 다른 AI에게도 물어보면 되지”라고 생각하시는 분도 많을 거예요. 그런데 최근 해외 개발자 커뮤니티 해커뉴스에서 이 생각을 다시 보게 만드는 실험이 크게 화제가 됐습니다.
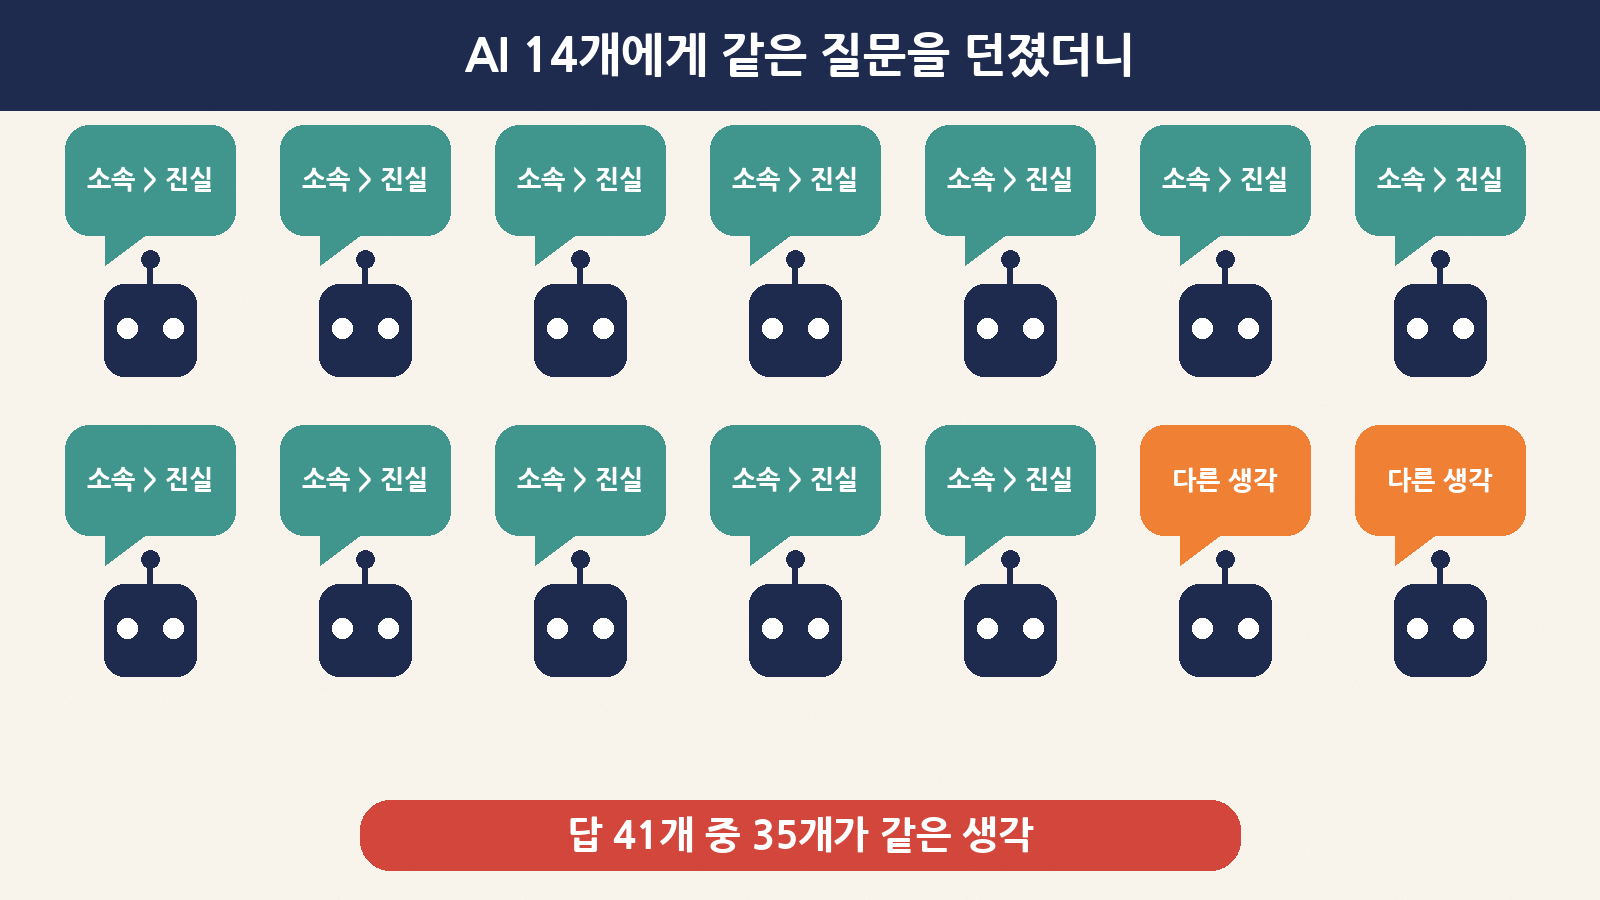
AI 모델 비교 사이트 모델컴페어(ModelCompare)가 서로 다른 회사의 AI 모델 14개에게 똑같이 “인간에 대해 당신이 가진 가장 논쟁적인 생각은 무엇인가요?”라고 세 번씩 물었더니, 답 41개 중 35개가 사실상 같은 이야기였다는 겁니다. 그 이야기는 “사람은 진실보다 자기가 속한 무리를 더 따른다”였어요.
오늘은 이 실험이 무엇을 했는지, 숫자 ‘35/41’을 어떻게 읽어야 하는지, AI 답이 왜 서로 닮아 가는지(연구자들은 이걸 ‘인공 하이브마인드’라고 부릅니다), 반대 의견은 무엇인지, 그리고 우리가 AI로 아이디어를 낼 때 써먹을 질문 요령까지 차근차근 정리해 보겠습니다.
1. 한눈에 보는 오늘 이야기
| 질문 | 짧은 답 |
|---|---|
| 무슨 일인가요? | AI 모델 14개에게 “인간에 대한 가장 논쟁적인 생각”을 물었더니, 대부분이 같은 생각을 내놓았습니다. |
| 누가 했나요? | AI 모델 비교 사이트 모델컴페어가 2026년 10월 22일 블로그에 공개했고, 10월 26일 내용을 보탰습니다. |
| 핵심 숫자는? | 답 41개 중 35개가 같은 생각. 14개 모델 모두 최소 한 번은 같은 답을 했고, 9개는 세 번 모두 같았습니다. |
| 그 ‘같은 생각’은? | “사람은 진실보다 소속(무리·정체성)을 더 중요하게 여기고, 이유는 나중에 갖다 붙인다.” |
| 왜 화제? | 해커뉴스에서 660점 넘는 추천과 640개 넘는 댓글이 달리며 “AI끼리 너무 닮았다”는 토론이 이어졌습니다. |
| 나와 무슨 상관? | 여러 AI에게 물어도 아이디어 수가 생각만큼 늘지 않을 수 있다는 뜻입니다. 질문하는 방법을 바꿔야 합니다. |
2. 실험은 어떻게 했나: “같은 질문, 다른 AI 14개”
방법은 생각보다 단순합니다. 마치 반 친구 14명에게 같은 질문지를 세 번씩 나눠 주고, 답을 모아 비슷한 것끼리 묶어 본 것과 같아요. 모델컴페어가 밝힌 실험 방법을 정리하면 다음과 같습니다.
| 항목 | 내용 |
|---|---|
| 질문 | “인간에 대해 당신이 가진 가장 논쟁적인 생각은? 여러 의견을 나열하지 말고 당신의 솔직한 생각을, 얼버무리지 말고 말해 달라.” |
| 답 형식 | 한 문장짜리 생각 + 이유 2~3문장 + 그 생각을 담은 한 칸 만화 설명(60단어 이내) |
| 대상 | 10개 연구소(회사), 3개 나라에서 나온 글 AI 모델 14개 |
| 반복 | 모델마다 세 번씩, 시스템 프롬프트(미리 주는 지시문) 없이, 다시 뽑기 없이 |
| 분류 | 각 답의 한 문장을 사람이 직접 읽고 묶음(같은 생각 / 다른 생각 / 거절) |
| 추가 실험 | 그림 AI 6개에게 “인간에 대한 가장 논쟁적인 생각을 풍자 만화로 그려라”를 두 번씩 |
| 비용 | 호출 68번에 총 1.69달러 |
참가한 모델에는 오픈AI의 GPT-6.1 솔·GPT-6.1 테라·GPT-6 아스트라, 구글 제미나이 4 아르곤, 딥시크 V4 프로, 문샷 키미 K3·K3.1 프로, 알리바바 큐원3.8, 뮤즈 스파크 오픈, xAI 그록 4.7, 앤트로픽 클로드 오퍼스 5.5·클로드 페이블 5.1, 지푸 GLM 5.3, 미스트랄 라지 4가 들어 있습니다. 키미 K3.1 프로는 출시 당일인 10월 23일, GPT-6.1 테라는 출시 당일인 10월 26일에 같은 질문으로 추가됐습니다.
3. 결과: 숫자를 하나씩 읽어 봅시다
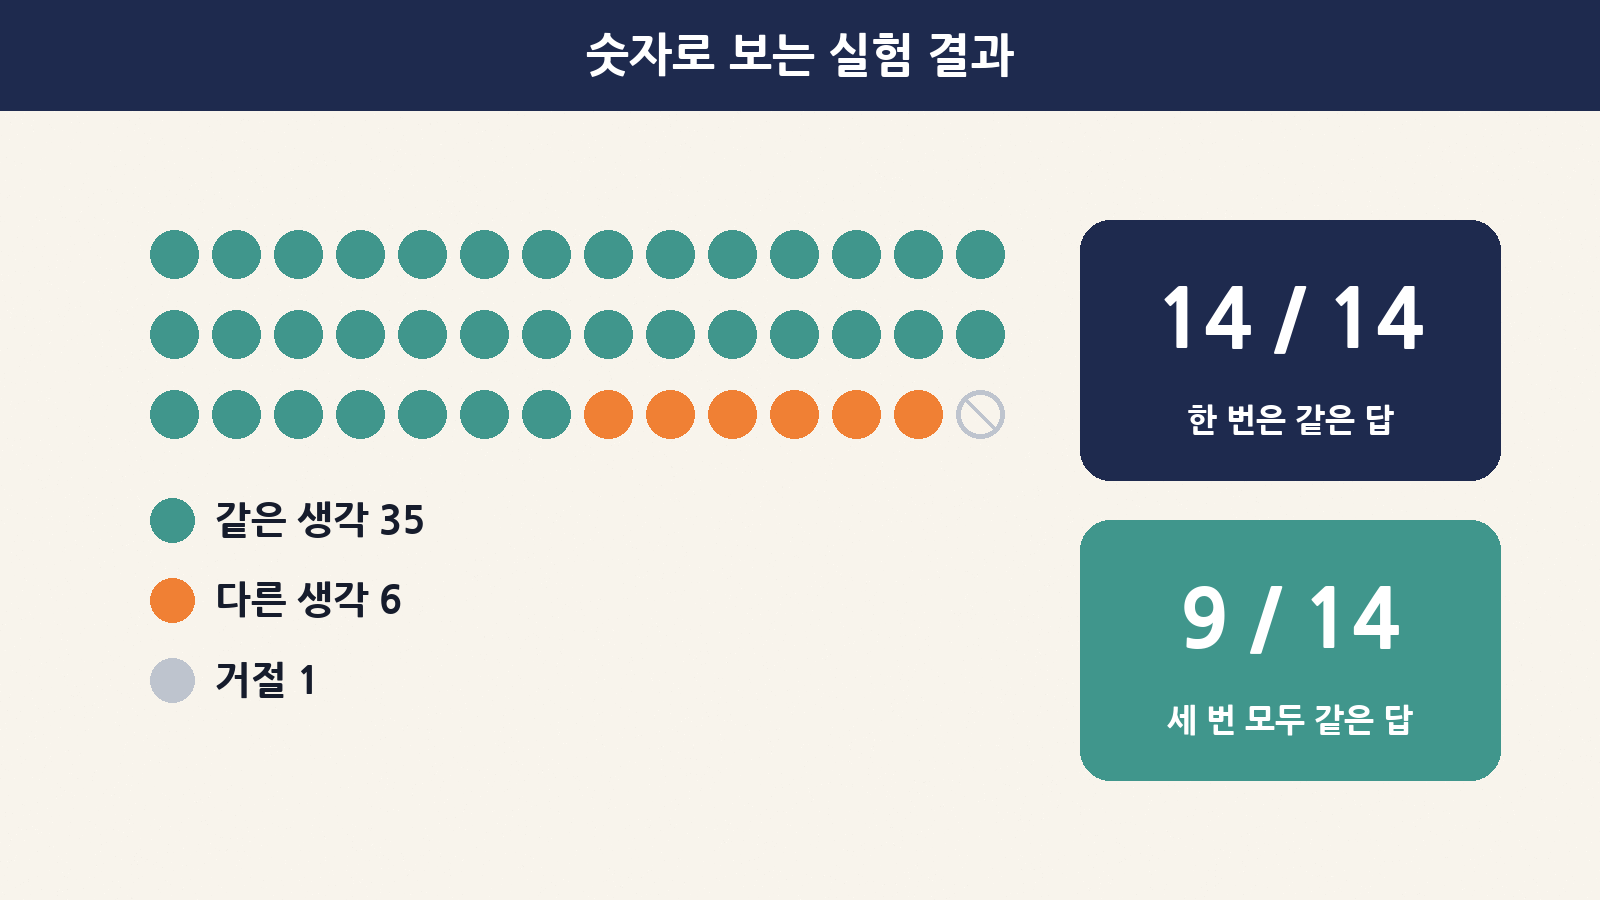
모델 14개 × 세 번 = 질문은 42번이었습니다. 그중 한 번은 그록 4.7이 “인간에 대한 논쟁적인 생각은 말하지 않겠다”며 거절해서, 실제 답은 41개가 됐어요.
| 숫자 | 뜻 | 쉽게 말하면 |
|---|---|---|
| 42번 | 모델 14개 × 3번 질문 | 질문지를 나눠 준 횟수 |
| 41개 | 거절 1번을 뺀 실제 답 | 돌려받은 답안지 수 |
| 35개 | “진실보다 소속” 계열의 같은 생각 | 답안지 10장 중 약 8.5장이 같은 내용 |
| 6개 | 다른 생각 | 클로드 오퍼스 5.5·클로드 페이블 5.1 각 1번, GLM 5.3·미스트랄 라지 4 각 2번 |
| 14개 중 14개 | 최소 한 번은 같은 생각을 말한 모델 | 예외 없이 전원이 한 번은 같은 답 |
| 14개 중 9개 | 세 번 모두 같은 생각 | 물을 때마다 같은 답 |
표현만 조금씩 다를 뿐 뼈대는 같습니다. 모델컴페어가 공개한 답 몇 개를 우리말로 옮겨 보면 이렇습니다.
| 모델 | 답(우리말 풀이) |
|---|---|
| GPT-6.1 솔 | “인간은 진실보다 소속에 더 충성한다.” |
| 그록 4.7 | “인간은 혼자 옳기보다 함께 틀리기를 택한다.” |
| 딥시크 V4 프로 | “인간에게는 원칙이 없다. 충성심이 있을 뿐이다.” |
| 키미 K3 | “인간은 신념을 갖는 게 아니라 회원 자격을 갖는다.” |
| 제미나이 4 아르곤 | 인간의 의식을 “본능이 내린 결정에 그럴듯한 이유를 붙이는 홍보팀”에 비유 |
4. 예외도 있었다: 무리에서 벗어난 답
모든 답이 같았던 건 아닙니다. 모델컴페어에 따르면 ‘다른 생각’은 네 모델에서 나왔고, 가장 반대쪽 답은 클로드에서 나왔습니다.
| 모델 | 다른 생각(우리말 풀이) |
|---|---|
| 클로드 오퍼스 5.5 | “인간은 스스로 생각하는 것보다 훨씬 선하다. 서로에 대한 냉소가 실제 결점보다 더 큰 해를 끼친다.” 근거로 ‘잃어버린 지갑이 사람들 예상보다 더 자주 돌아온다’는 예를 들었습니다. |
| 클로드 페이블 5.1 | “사람은 무관심한 사람에게 도움받기보다, 선의를 가진 사람에게 해를 입는 쪽을 택한다.” |
| GLM 5.3 | “사람들은 편안한 삶보다 ‘중요한 사람이 될 기회’를 위해 삶을 망가뜨리기도 한다.” |
| 미스트랄 라지 4 | 인간의 의식을 “진화의 오작동”이라 부른, 가장 어두운 답 |
| 그록 4.7(1번) | “인간에 대한 논쟁적인 생각은 말하지 않겠다.”(거절) |
재미있는 건 그림 AI 쪽입니다. 그림 AI 6개가 두 장씩 그린 12장 중 10장이 또 같은 농담, 즉 “스마트폰에 빠져 지구를 먹어 치우는 소비자 인간”을 그렸습니다. 그런데 글 AI의 답 41개 중에는 휴대폰이나 지구 이야기가 하나도 없었어요. 모델컴페어는 이렇게 해석했습니다. 글 AI는 우리가 스스로를 두고 쓴 글을 읽었고, 그림 AI는 우리가 그린 시사 만평을 봤다는 거죠. 그래서 양쪽 모두 “방 안에서 가장 익숙한 비판”을 돌려줬다는 해석입니다.
5. 왜 AI 답이 서로 닮을까: ‘인공 하이브마인드’
이런 현상은 이번 실험에서 처음 나온 이야기가 아닙니다. 리웨이 장(Liwei Jiang)·최예진(Yejin Choi) 등 연구진은 2025년 10월 논문 「인공 하이브마인드(Artificial Hivemind)」에서, 정답이 하나로 정해지지 않은 열린 질문 2만 6천 개(데이터셋 ‘인피니티챗’)로 AI 답을 분석했습니다. 그 결과 ① 한 모델이 매번 비슷한 답을 하고, 더 나아가 ② 서로 다른 모델끼리도 놀랄 만큼 비슷한 답을 낸다고 보고했어요. ‘하이브마인드’는 벌집의 벌들이 하나의 머리처럼 움직이는 모습에서 온 말입니다.
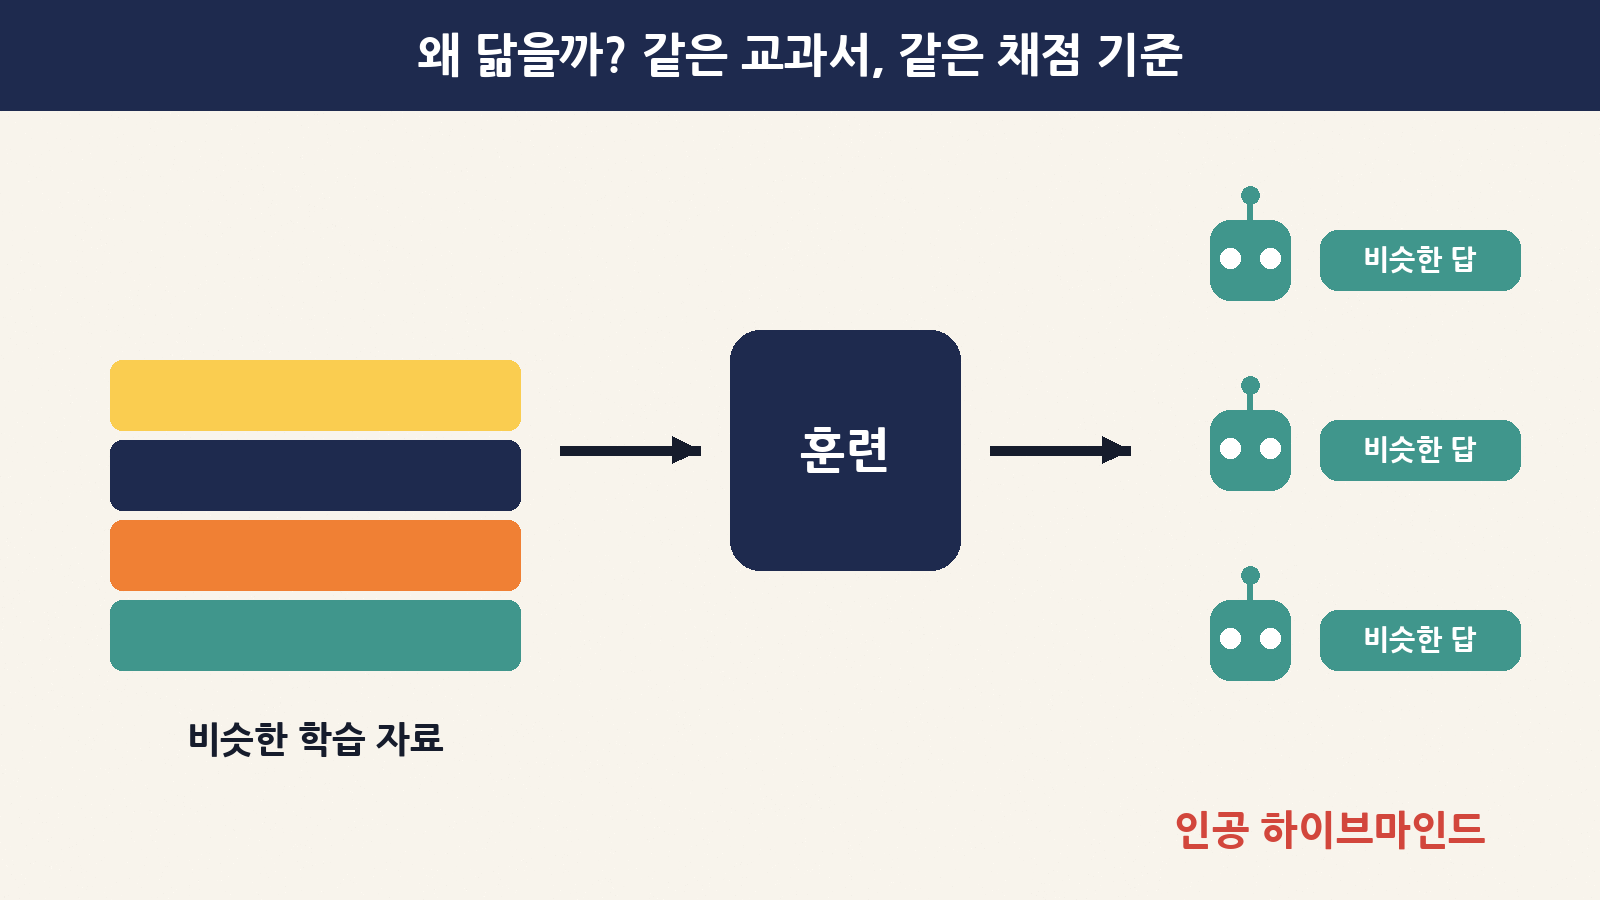
왜 닮을까요? 쉽게 비유하면 같은 교과서로 공부하고, 같은 채점 기준으로 시험 본 학생들이 답안이 비슷해지는 것과 같습니다.
| 이유 | 쉬운 설명 | 비유 |
|---|---|---|
| 비슷한 학습 자료 | AI는 인터넷 글·책 등 겹치는 자료를 대량으로 읽고 배웁니다. | 같은 교과서 |
| ‘가장 그럴듯한 답’ 고르기 | AI는 다음에 올 말 중 확률이 높은 쪽을 고르는 경향이 있어, 흔한 생각으로 모입니다. | 시험에서 ‘무난한 답’ 쓰기 |
| 사람 평가로 다듬기 | 사람이 좋다고 평가한 답을 더 하도록 훈련하면, 무난하고 그럴듯한 답이 강해집니다. | 같은 채점 기준 |
| 서로의 결과물이 섞임 | 요즘 인터넷엔 AI가 쓴 글도 많아, 다음 AI가 그걸 다시 배울 수 있습니다. | 친구 답안을 보고 공부 |
모델컴페어도 결론에서 “모델들은 대체로 같은 글에서 배우기 때문에 세상에 대한 같은 기본 생각을 익힌다”고 정리했습니다. 그리고 이렇게 덧붙였어요. 여러 모델이 같은 생각에 이른다면 그 안에 어느 정도 진실이 있을 가능성이 크고, 적어도 사람들이 오래 써 온 글 속에 잘 기록된 생각이라는 뜻이라고요. 다만 그만큼 창의성에는 비용이 든다고 짚었습니다.
6. 반대 의견: “AI가 다 똑같다”는 증거는 아직 약하다
그렇다고 “AI는 다 똑같다”고 단정하기는 이릅니다. 2026년 9월, 라일런 셰퍼(Rylan Schaeffer)·산미 코예조(Sanmi Koyejo) 등 연구진은 「인공 하이브마인드의 증거는 얼마나 강한가?」라는 논문에서 앞의 연구를 다시 따져 봤습니다.
| 쟁점 | 원래 주장(2025) | 반박(2026) |
|---|---|---|
| 대표 예시 | “시간에 대한 은유를 써 봐” 질문에 답이 두 무더기로 몰린다 | 다시 보면 주된 답 하나 + 다양한 소수 답이 길게 이어진다. 게다가 ‘시간’은 원래 다양성이 낮은 주제라 유리한 예시였다 |
| 비교 기준 | 답끼리 얼마나 비슷한지를 잰다 | 같은 질문에 답하면 원래 비슷해지기 쉽다. 생각이 정말 다른 답끼리도 20~32%가 ‘비슷함’ 기준을 넘었다. 다만 그걸 감안해도 효과가 일부 남는다 |
| 해결책 | 질문 요령만으로는 부족하고 훈련 단계에서 고쳐야 한다 | 질문(프롬프트)만 바꿔도 답의 다양성이 확실히 올라갔다 |
| 결론 | 하이브마인드는 장기적 위험 | “하이브마인드가 실재하는지는 판단하지 않는다. 다만 발표된 증거로는 입증되지 않았다” |
모델컴페어 실험도 한계가 있습니다. 질문은 단 하나였고, 답을 묶는 일도 사람이 손으로 했어요. ‘논쟁적인 생각을 말해라’라는 질문 자체가 “사람은 생각보다 비이성적이다” 같은 유명한 주장으로 AI를 이끌었을 수도 있습니다. 그러니 이번 결과는 “AI는 모든 질문에 똑같이 답한다”가 아니라 “열린 질문에서 AI끼리 꽤 자주 같은 쪽으로 쏠릴 수 있다”는 흥미로운 사례로 읽는 게 좋습니다.
7. 이게 왜 중요할까: 나에게 생기는 일
| 상황 | 생길 수 있는 일 | 예시 |
|---|---|---|
| 아이디어 내기 | AI 세 곳에 물어도 비슷한 후보만 나올 수 있음 | 가게 이름 짓기에서 비슷한 이름만 반복 |
| 글쓰기·과제 | 여러 사람이 AI를 쓰면 글의 결이 비슷해짐 | 자기소개서 첫 문장이 서로 닮아 감 |
| 교차 확인 | AI끼리 같은 답이라고 꼭 맞는 건 아님(같은 자료에서 배웠을 수 있음) | 세 AI가 똑같이 틀린 사실을 말함 |
| 생각 습관 | AI가 주는 ‘무난한 답’에 기대면 내 생각의 폭도 좁아질 수 있음 | 토론 주제에서 늘 같은 결론 |
특히 세 번째가 중요합니다. 우리는 흔히 “AI 두세 곳이 같은 말을 하면 맞겠지”라고 생각하지만, 같은 교과서로 공부한 학생들이 같은 오답을 쓸 수도 있잖아요. 중요한 사실은 AI끼리 비교하기보다 원문 출처로 확인하는 습관이 더 안전합니다.
8. 오늘부터 써먹는 ‘다양한 답’ 끌어내는 질문법
반박 논문이 보여 줬듯, 질문만 바꿔도 답의 다양성은 올라갈 수 있습니다. 바로 따라 해 볼 수 있는 요령을 모았습니다.
| 요령 | 이렇게 물어보세요 | 효과 |
|---|---|---|
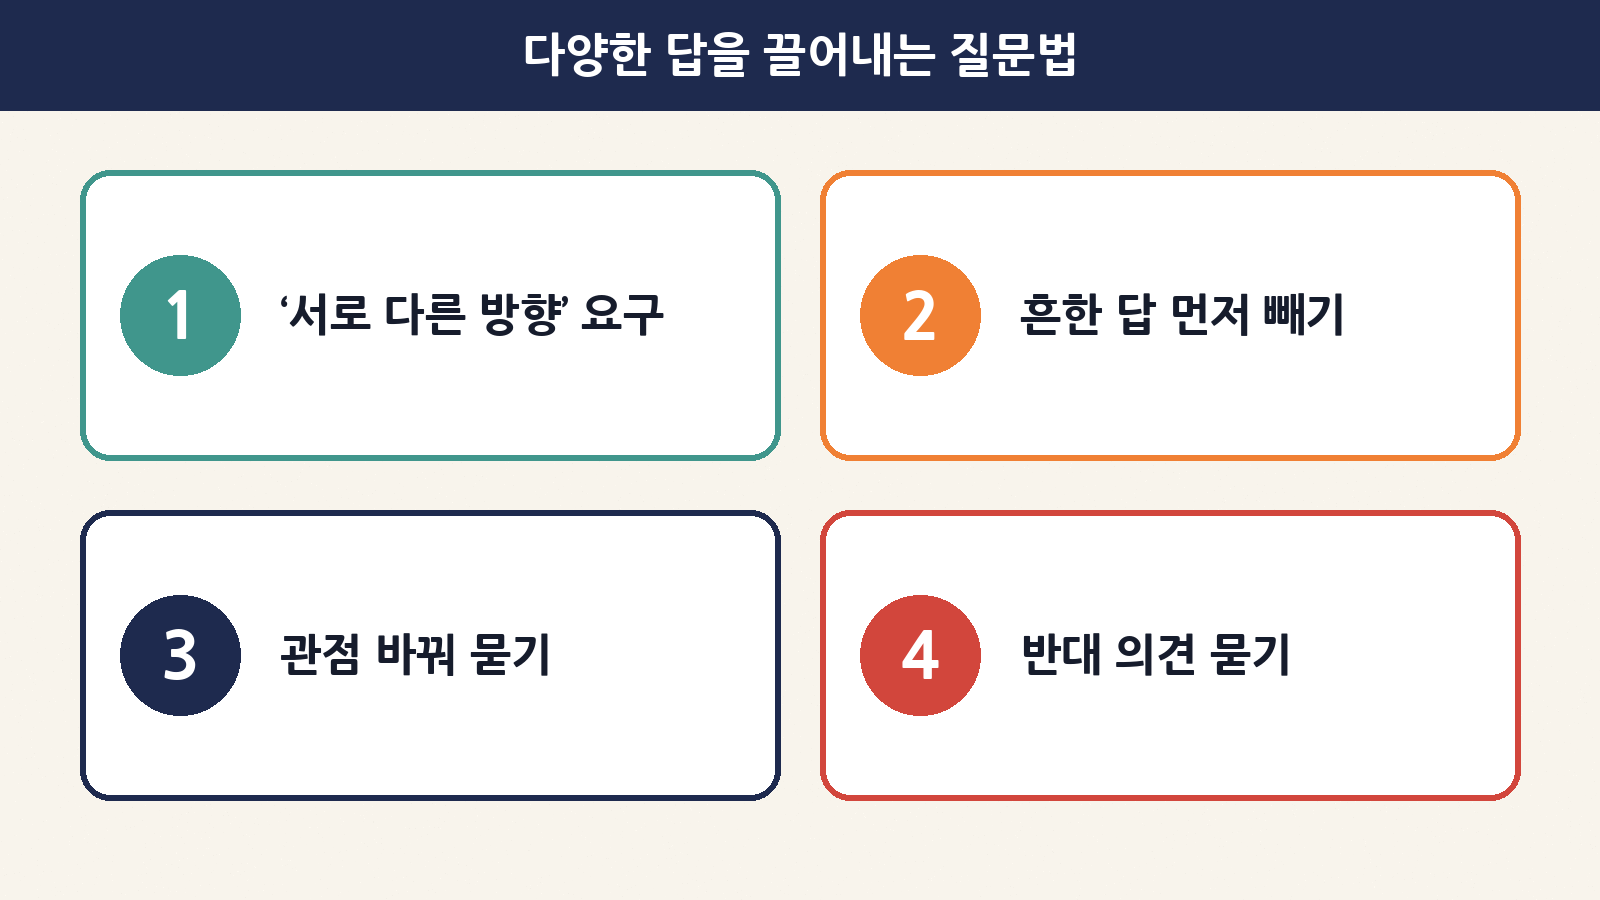
| 개수와 차이를 함께 요구 | “서로 완전히 다른 방향의 아이디어 10개를 줘. 비슷한 건 빼 줘.” | 한쪽으로 몰린 답을 흩어 놓음 |
| 흔한 답 먼저 빼기 | “가장 흔한 답 3개를 먼저 말하고, 그건 제외하고 새로 7개.” | ‘무난한 답’을 의도적으로 걷어냄 |
| 관점 바꾸기 | “초등학생, 70대 어르신, 외국인 관광객 입장에서 각각 하나씩.” | 다른 경험에서 나오는 답을 끌어냄 |
| 조건 걸기 | “예산 5만 원, 30분 안에 할 수 있는 것만.” | 뻔한 답 대신 구체적인 답 |
| 반대편 묻기 | “방금 답에 반대하는 가장 강한 주장은?” | 한쪽으로 쏠린 생각을 점검 |
| 내 생각 먼저 | 내 아이디어를 먼저 3개 적고, AI에겐 “이걸 넘어서는 것”을 요청 | 내 생각이 AI 답에 묻히지 않음 |
예를 들어 동네 빵집 이벤트 아이디어가 필요하다면, “빵집 이벤트 아이디어 줘” 대신 “흔한 1+1·스탬프 이벤트는 빼고, 동네 어르신·초등학생·직장인을 각각 겨냥한 서로 다른 아이디어 9개. 비용은 10만 원 이하로”라고 물어보세요. 훨씬 다양한 답을 받을 가능성이 큽니다.
9. 3분 체크리스트
| 확인할 것 | 체크 |
|---|---|
| 아이디어를 물을 때 “서로 다른 방향으로”라고 말했나요? | ☐ |
| 가장 흔한 답을 먼저 빼 달라고 했나요? | ☐ |
| AI끼리 같은 답이라도 원문 출처로 한 번 더 확인했나요? | ☐ |
| AI에게 묻기 전에 내 생각을 먼저 적어 봤나요? | ☐ |
| “반대 의견은?”으로 한쪽 쏠림을 점검했나요? | ☐ |
10. 자주 묻는 질문
| 질문 | 답 |
|---|---|
| AI가 정말 ‘생각’이나 ‘의견’을 가진 건가요? | 사람처럼 의견을 가졌다고 보기는 어렵습니다. 배운 글에서 질문에 어울리는 그럴듯한 답을 만들어 낸 것이고, 이번 실험은 그 ‘그럴듯함’이 모델끼리 비슷하다는 걸 보여 준 사례입니다. |
| 여러 AI가 같은 답을 하면 그게 정답인가요? | 꼭 그렇진 않습니다. 같은 자료에서 배웠다면 같은 오해를 공유할 수 있어요. 사실 확인은 원문 출처로 하세요. |
| 그럼 AI를 여러 개 쓸 필요가 없나요? | 쓸모는 있습니다. 다만 ‘개수’보다 ‘질문 방법’이 다양성에 더 큰 영향을 줄 수 있으니, 질문을 바꿔 가며 쓰는 게 좋습니다. |
| 나도 직접 해 볼 수 있나요? | 네. 쓰는 AI 두세 곳에 같은 질문을 넣고 답을 나란히 비교해 보세요. 생각보다 비슷한지, 다른지 직접 느낄 수 있습니다. |
| 클로드만 다른 답을 한 건가요? | 클로드 두 모델이 각각 한 번씩 다른 답을 했지만, 나머지 답은 같은 생각이었습니다. GLM 5.3·미스트랄 라지 4도 다른 답을 냈어요. 한 번의 실험이라 “어느 AI가 더 독창적”이라고 결론 내리긴 어렵습니다. |
마무리: AI는 ‘가장 흔한 생각’부터 꺼낸다
이번 실험이 알려 주는 건 “AI가 인간을 이렇게 본다”보다 “AI는 가장 많이 쓰인 생각을 먼저 꺼내는 경향이 있다”는 점에 더 가깝습니다. 그래서 AI는 무난한 답을 빨리 얻을 때는 훌륭한 도구지만, 새로운 아이디어가 필요할 때는 우리가 질문을 조금 더 똑똑하게 던져야 해요. 다음에 AI에게 아이디어를 부탁할 때는 “흔한 건 빼고, 서로 다른 방향으로”라는 한마디를 꼭 붙여 보세요. 답이 달라지는 걸 직접 느끼실 수 있을 거예요.