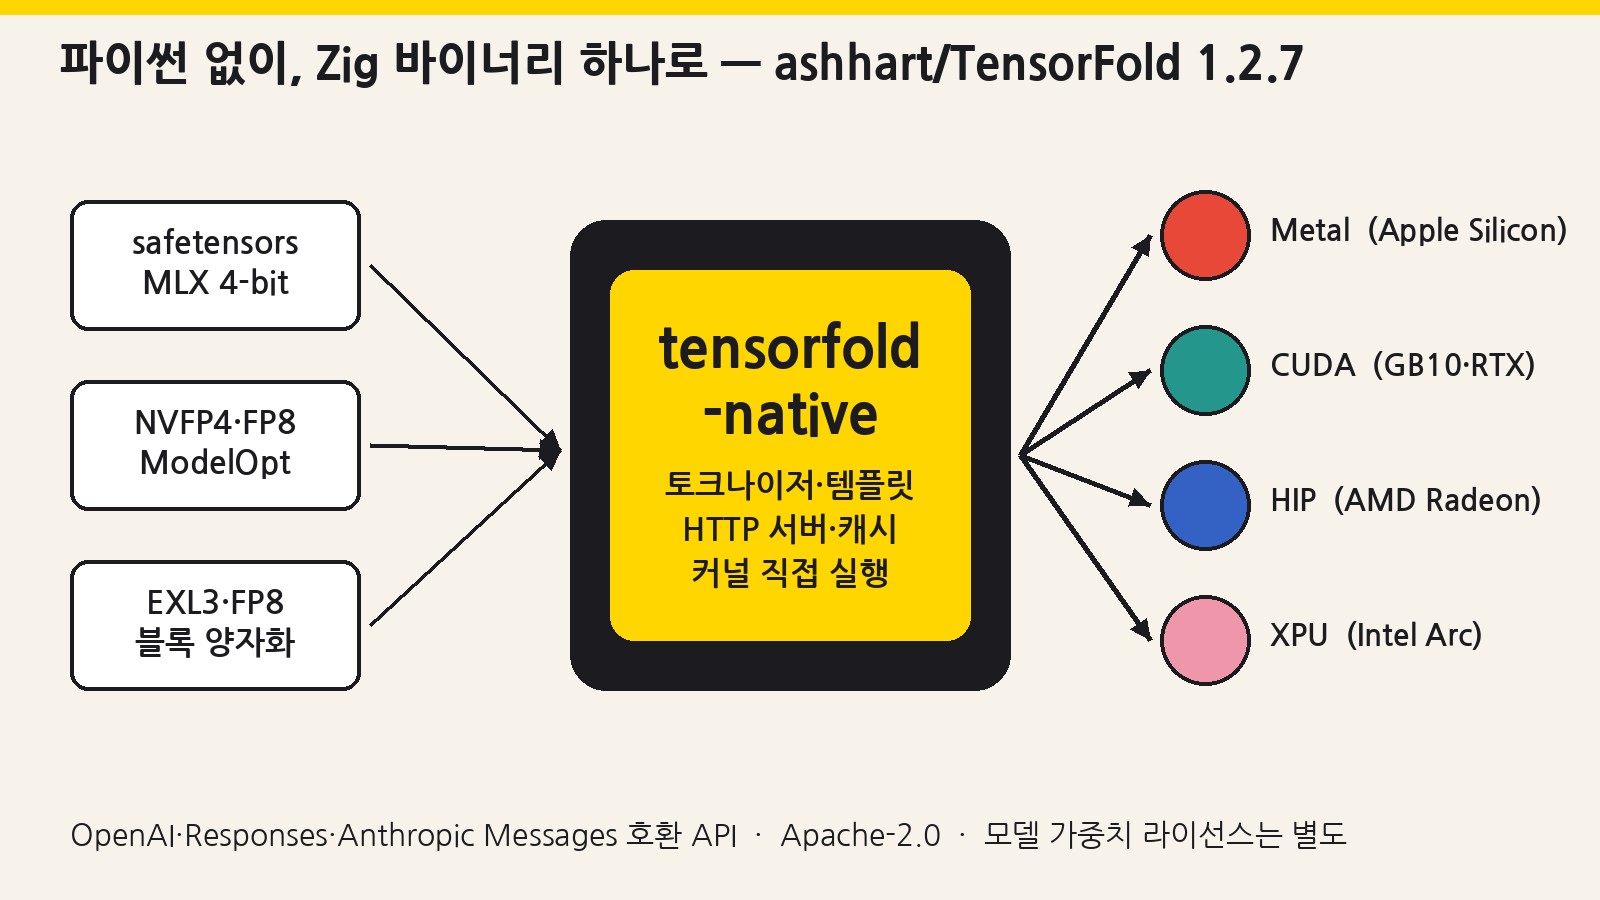
한 줄 요약: ashhart/TensorFold는 Zig로 짠 단일 네이티브 바이너리(tensorfold-native)가 체크포인트 로딩·토크나이즈·채팅 템플릿·Metal/CUDA 커널 실행·HTTP 서버를 전부 직접 처리하는 LLM 추론 엔진입니다. 서빙에 Python이나 MLX 설치가 필요 없습니다. 11월 12일 새벽(KST)에 나온 1.2.7까지 오면서 “드래프트를 써도, 캐시에서 재개해도, 동시에 돌려도 출력 토큰은 단독 실행과 같아야 한다”는 정확 디코딩 규칙을 엔진 전반에 걸어 두었습니다. 이 글에서는 저장소 구조와 핵심 메커니즘, 트레이드오프를 짚고, GPU 없는 박스에서 릴리스 서명 검증부터 capabilities·pull·info까지 직접 돌린 결과도 함께 정리합니다.
왜 지금 TensorFold인가
11월 13일 GitHub Trending(daily)에 “LLM Inference Engine for Metal, CUDA and Vulkan.”이라는 설명으로 올라왔습니다. 2026년 6월 19일에 만들어진 저장소이고, 확인 시점 기준 스타 약 1,970개, 포크 394개, 열린 이슈·PR 553개입니다. 수치보다 눈에 띄는 건 릴리스 속도입니다. 10월 7일 1.0.0에서 Python 엔진(0.6.6)을 걷어내고 Zig 네이티브 엔진으로 갈아탄 뒤, 11월 들어서만 1.2.3(11/5) → 1.2.4(11/7) → 1.2.5(11/8) → 1.2.6(11/10) → 1.2.7(11/11 UTC)을 냈습니다. 지금까지 릴리스는 61개입니다. 릴리스 노트마다 “어느 기계에서, 어느 PR로, 출력이 같은지 확인했는지”를 숫자와 함께 적어 둔 점도 보통 프로젝트와 다릅니다.
로컬 추론 엔진 글은 이미 여러 번 다뤘습니다. 하지만 TensorFold는 llama.cpp 계열 포크도 아니고 vLLM 같은 Python 서빙 스택도 아닙니다. “엔진 하나가 Apple Silicon·NVIDIA(GB10 포함)·AMD HIP을 직접 구동하고, 모델 패밀리별로 손으로 짠 경로를 둔다”는 노선이라 따로 볼 가치가 있습니다.
| 항목 | 내용 (2026-11-13 확인) |
|---|---|
| 저장소 | ashhart/TensorFold (홈페이지 tensorfold.dev) |
| 라이선스 | Apache-2.0 (엔진). 모델 가중치는 각자 라이선스를 따름. LICENSES/에 LFM Open, NVIDIA OpenMDW, Kimi 등 별도 고지 |
| 최신 릴리스 | v1.2.7, 2026-11-11 17:18 UTC (KST 11-12 02:18) |
| 릴리스 자산 | linux-x86_64(약 50MB) · linux-aarch64(약 50MB) · macos-arm64(약 7MB) tar.gz + .sha256 + .sha256.sig(ed25519 서명) |
| 주 언어(바이트) | Zig 47.5MB, TypeScript 15.7MB(데스크톱 앱), Python 3.5MB(도구·테스트), Metal 2.7MB, CUDA 2.5MB, HIP 0.24MB |
| 빌드 도구 | Zig 0.17.0(.zig-version 고정), Xcode Metal Toolchain, CUDA 13 nvcc |
| CUDA 런타임 요건 | glibc 2.28+, NVIDIA 드라이버 R580+(CUDA 13.0). 릴리스 이미지 대상 sm_80·sm_86·sm_120·sm_121 |
| API 표면 | OpenAI Chat/Completions, Responses(1.2.7부터 WebSocket 모드), Anthropic Messages, 임베딩·리랭크·/v1/decisions 등 |
저장소 구조: “엔진 + 증거”로 짜인 모노레포
재귀 트리 기준 파일이 약 1만 2천 개입니다. 최상위만 보면 역할이 꽤 분명하게 나뉩니다.
| 경로 | 역할 | 실무자 관점 메모 |
|---|---|---|
zig/ |
네이티브 엔진 본체. zig/src, zig/kernels, 패밀리별 host/metal 테스트(qwen27_*, glm_*, flashnext_*, gemma4_*, residency_* 등) |
파일 이름이 곧 모델 패밀리 이름입니다. 범용 그래프 실행기보다 패밀리별 전용 경로에 가깝습니다. |
docs/ |
api.md(약 10만 자), kernel-contract.md, evaluating.md, known-issues.md, recall.md, optimizing.md, receipts/, recipes/ |
“receipt(실측 영수증)”가 문서 체계의 중심입니다. 성능 주장마다 기계와 PR 번호가 따라붙습니다. |
tools/ |
bench_*.py, conformance.py, 체크포인트 변환기(glm5_q8_0_gguf_to_mlx.py, step5_fp8_to_mlx.py), conformance_profiles/ |
서빙에는 필요 없습니다. 벤치·변환·적합성 게이트용 도구입니다. |
app/ |
Electron/Vite 기반 Mac 데스크톱 워크스페이스(현재 beta 9 DMG), app/mobile(프리뷰) |
TypeScript 비중이 큰 이유가 이 폴더입니다. 엔진과는 따로 봐도 됩니다. |
web/ |
tensorfold web으로 여는 로컬 웹 앱(Python 패키지, uv.lock) |
1.2.5에 추가됐습니다. 필요할 때 uv로 설치를 제안합니다. |
packaging/ |
Homebrew 포뮬러, 런타임 신뢰 키(runtime-trust.json), 검증 문서 |
릴리스 서명 공개키가 여기 있습니다. |
Dockerfile |
Ubuntu 24.04에 릴리스 아카이브를 설치. 체크섬·서명·파일별 체크섬이 하나라도 안 맞으면 빌드 중단 | 이미지에는 아카이브만 들어 있습니다. cuBLASLt·NCCL이 필요한 기능은 별도 이미지가 필요합니다. |
기여 방식도 독특합니다. README는 코딩 에이전트로 기여할 때 docs/recipes/SKILL.md(contributor 스킬)를 먼저 로드하라고 하고, 같은 작성자의 Agent Traffic Control(ATC)로 이슈를 atc check/atc claim한 다음 작업하라고 안내합니다. 사람과 에이전트가 같은 이슈를 동시에 건드리지 않게 하려는 장치입니다. 1.2.7 감사 목록에 이름이 오른 기여자만 20명 남짓이라, 1인 프로젝트보다는 커뮤니티 측정과 PR이 엔진 속도를 끌어올리는 구조로 보입니다.
핵심 메커니즘 1 — 단일 네이티브 프로세스
1.0.0 릴리스 노트는 “체크포인트 로딩, 토크나이즈, 채팅 템플릿, 추론이 네이티브 프로세스 안에서 돈다”고 정리합니다. 실무에서는 이게 세 가지 결과로 이어집니다.
- 의존성 표면이 작습니다.
evaluating.md에 따르면 서빙은 Python 패키지를 하나도 설치하지 않아pip-audit로 검사할 대상이 없습니다.build.zig.zon도 Zig 패키지를 선언하지 않습니다. Linux 아카이브에 추가로 붙는 건 구조화 출력용libtfgrammar(xgrammar v0.2.8)뿐입니다. - 모델 지원이 “패밀리 단위”입니다.
pull은 네이티브 패밀리가 없는model_type을 아예 받지 않습니다. Hugging Face에 있는 아무 체크포인트나 띄우는 구조가 아니라, 엔진이 아는 패밀리×포맷 조합만 서빙합니다. - “qualified” 범위가 문서에 명시됩니다. README의 Pick a model 표는 체크포인트마다 “어느 기계에서 확인했는지”만 적고, 측정하지 않은 최소 RAM은 공개하지 않는다고 못 박습니다. 예를 들어 A100(sm_80)은 커널 체크 증거는 있어도 서빙된 체크포인트 기록이 없어서 model-qualified가 아닙니다.
| 대표 모델 경로 (README Pick a model 발췌) | 확인된 기계·메모리 범위 | 비고 |
|---|---|---|
| Qwen3.5-2B, MLX 4-bit | Mac 1대(M5 Max) 또는 GB10 1대 | 퀵스타트 기본 모델. 텍스트 전용 |
| Qwen3.8-27B, MLX 4-bit (+ DFlash2 드래프터) | Mac 1대(M5 Max/M3 Ultra) 또는 GB10 1대. 32GB Mac은 iogpu.wired_limit_mb 상향 필요 |
--drafter z-lab/Qwen3.8-27B-DFlash2가 없으면 일반 디코딩 |
| Nemotron 3.5 Lightning 30B-A3B, MLX 4-bit | Mac(M1–M5) 또는 GB10. RTX 3090 / RTX PRO 6000에서도 확인 | MTP 포함 |
| Nemotron 3.5 Super VL 120B-A12B, NVFP4 | GB10 1~2대. 가중치 70.8GiB(비전 포함 73.2GiB) | --vision으로 이미지 입력 |
| GLM-5.3-Flash (NVFP4 / FP4-Local / XSFP4 등) | GB10 2대 TP=2 또는 3대 TP=3(직결 링) | Mac 1대 네이티브 서빙은 미인증. 2× M5 Ultra 필요 |
| Gemma 4 31B, MLX 4-bit | Mac(M5 Ultra) 또는 GB10 | M5 이전 Metal은 row 경로. 드래프터는 M5 텐서 유닛 필요 |
| MiniMax-M3.1-Flash 커뮤니티 3/4-bit | 256GB M5 Ultra 1대, 203.7GiB 또는 189.2GiB + 캐시 | 손실 변환본(KL 0.244 / 0.295)이라고 명시 |
표에 없는 것도 짚어 둡니다. README는 DeepSeek 체크포인트를 아직 어떤 릴리스 바이너리도 서빙하지 않는다(전체 모델 게이트 #827 미병합)고 적고 있습니다. MiMo 네이티브 백엔드는 릴리스에 없고, Bonsai 3진 팩과 Gemma 4 26B-A4B는 Python 전용입니다. 1.2.3 노트에도 Kimi K3/K3.1은 “실제 가중치가 아닌 합성 그래프에서만 돌린 기반 작업”이라고 선을 그어 두었습니다.
핵심 메커니즘 2 — 정확 디코딩(Exact decoding) 규칙
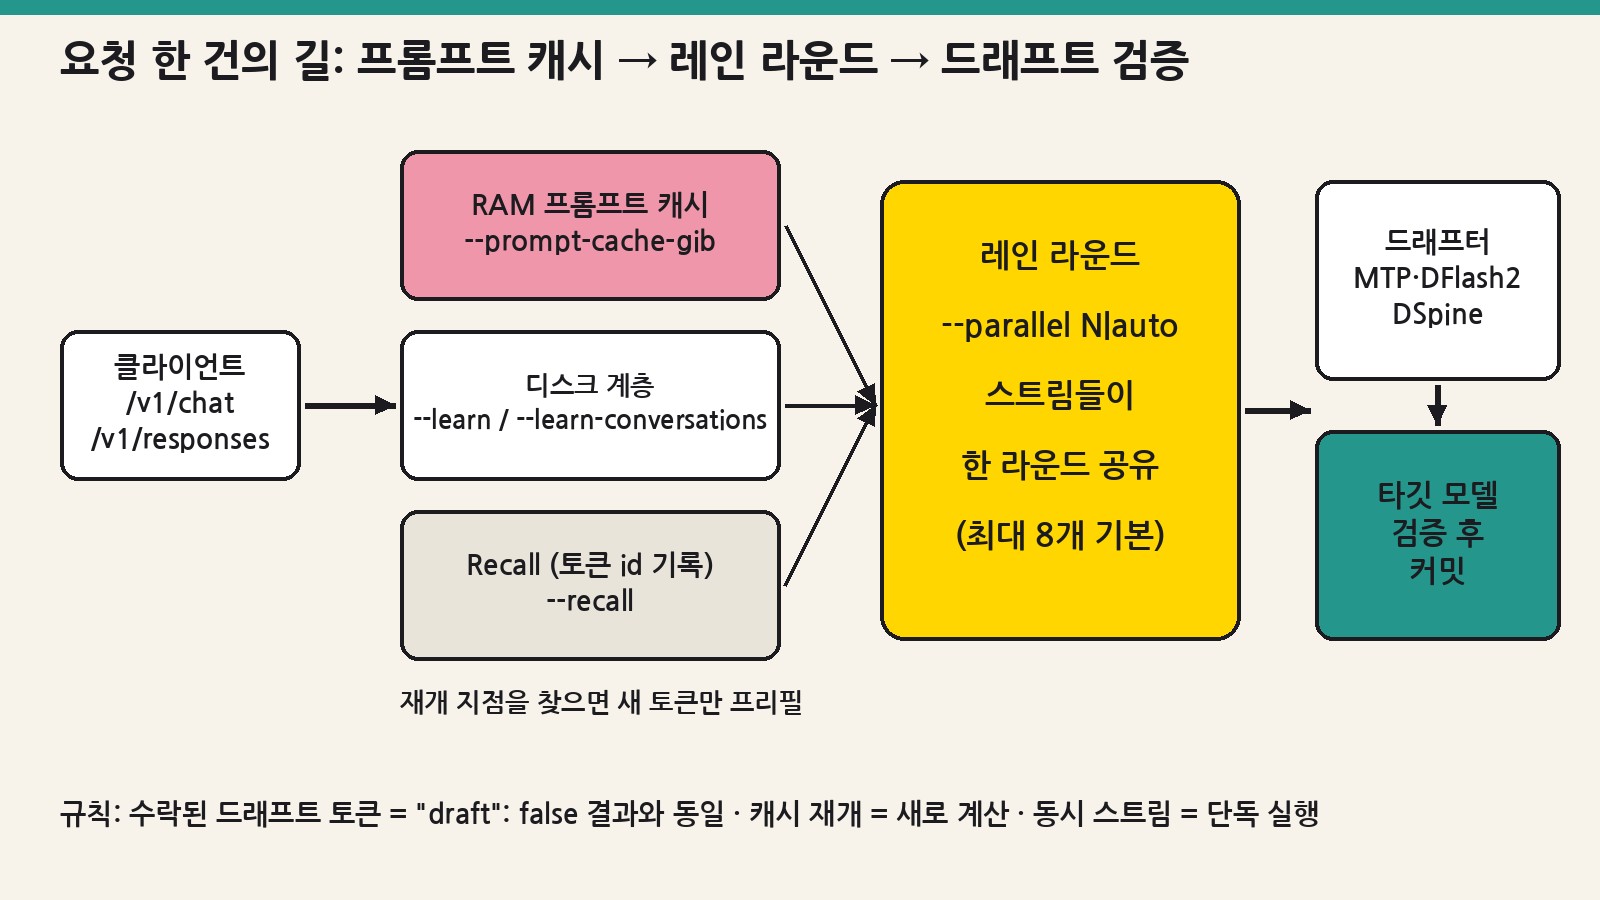
TensorFold를 다른 엔진과 가르는 가장 중요한 설계 원칙입니다. README의 정의를 옮기면 이렇습니다.
- 수락된 모든 드래프트 토큰은 같은 네이티브 엔진이
"draft": false로 냈을 토큰과 같아야 합니다. - 재개된 요청(캐시에서 이어 받은 요청)은 처음부터 새로 실행한 결과와 같아야 합니다.
- 동시에 도는 각 스트림은 혼자 돌았을 때의 결과와 같아야 합니다.
비교 조건은 체크포인트·백엔드·설정·런타임을 고정한 상태이고, 양자화나 백엔드가 다르면 출력도 달라질 수 있다고 분명히 적혀 있습니다. 즉 “Metal과 CUDA가 같은 답을 낸다”는 약속이 아니라 “같은 조건 안에서는 최적화가 출력을 바꾸지 않는다”는 약속입니다. 그래서 릴리스 노트의 속도 항목에는 거의 빠짐없이 “replies are unchanged”, “bit-equal”, “with every token unchanged” 같은 문구가 붙습니다. 출력을 바꾸는 변경은 노트의 What can change for you 섹션으로 따로 모읍니다.
드래프트 쪽은 모델마다 수단이 다릅니다. Nemotron은 체크포인트에 든 MTP 헤드를, Qwen3.8-27B는 외부 DFlash2 드래프터를 씁니다. 1.2.6부터는 CUDA에서 Tencent의 DSpine-b16도 고를 수 있습니다(opt-in). Gemma 4 31B는 레시피에 명시된 드래프터를 씁니다. --recall을 켜면 이전 요청들이 읽고 쓴 토큰 id 기록에서 사본(copy)을 드래프트로 제안합니다. 직전 16토큰 이상이 기록과 겹치고, 그 사본이 스트림 자체 드래프트보다 더 많이 착지할 것으로 예상될 때만 제안합니다. 어느 경우든 타깃 모델이 모든 토큰을 검증하므로 출력은 그대로입니다.
| 가속 수단 | 무엇을 저장·재사용하나 | 출력 영향 | 켜는 법 / 기본값 |
|---|---|---|---|
| 프롬프트 캐시(RAM) | 프리필이 끝난 모델 상태(공유 접두사) | 재개 결과 = 새 실행 | --prompt-cache-gib. 기본은 스트림 몫을 뺀 남은 공간의 절반(Metal·통합 메모리 CUDA), 디스크리트 CUDA는 호스트 스냅샷 8GiB. 0이면 끔 |
--learn |
시스템 프롬프트·도구 정의 같은 공유 접두사를 디스크에(기본 32GiB, LRU) | 동일 비트를 계산하는 재시작·업그레이드 후 재개 | GLM-5.3-Flash·Nemotron·Mac 1대 Flash Next만. Qwen3.8-27B·2B·LFM2.5·CUDA 서버는 시작 시 거부 |
--learn-conversations |
대화별 프롬프트 상태까지 디스크에 | 재시작·크래시·축출 뒤에도 다음 턴 재개 | 하루 기록량 상한 --learn-daily-gib(기본 32) |
--recall |
토큰 id만(텍스트 아님). 청크당 최대 1,048,576 id(4MiB), 디렉터리 0700·파일 0600 | 드래프트 원천일 뿐, 응답 불변 | 기본 꺼짐. 디스크 기본 1/16GiB(64MiB). DELETE /v1/recall로 비움 |
| 드래프터(MTP/DFlash2/DSpine) | 별도 소형 헤드·모델 | 검증 후 커밋, 응답 불변 | --drafter, --no-drafts로 기준 출력 생성 |
컨텍스트 압축 --compact-at |
오래된 턴을 메모 노트로 요약 | 바뀜(켰을 때만). 꺼져 있으면 모든 응답 불변 | 기본 꺼짐. 최근 턴·시스템 프롬프트는 원문 유지, 도구 호출과 결과는 분리 안 함 |
1.2.7에서 체감 효과가 가장 큰 변화도 이 재개 경로에 있습니다. 이전 응답의 reasoning을 떼고 돌려보내는 클라이언트(많은 에이전트 하네스가 이렇게 동작합니다)를 상대로, Qwen3.8-27B on Metal이 마지막 메시지 끝에서 후속 턴을 이어 받게 됐습니다. M3 Ultra, --prompt-cache-gib 5, 34K 히스토리 조건에서 재개 지점이 7,424토큰에서 약 34,100토큰으로 늘었고, 첫 토큰은 약 85초에서 약 0.3초로 줄었다고 릴리스 노트는 밝힙니다(#2811). 1.2.6에서는 16개 에이전트가 동시에 후속 질문을 던질 때 첫 토큰 중앙값이 M3 Ultra에서 546초→15.9초, GB10에서 105초→25.8초로 줄었습니다. 두 결과 모두 “에이전트 여러 개가 긴 컨텍스트를 들고 왕복하는” 워크로드를 노린 최적화입니다.
핵심 메커니즘 3 — 커널 계약(kernel contract)
엔진이 패밀리별 커널을 손으로 계속 늘려 가면 정확성을 어떻게 지키느냐가 관건입니다. TensorFold는 모든 GPU 커널이 병합 전에 zig/src/core/contract/ 하네스에 등록되게 했습니다. 등록 항목은 float64 기준 구현, 실제 서빙 형상(타일·스텝·최소 크기), 누산기 정밀도와 반올림 체인 깊이, in-place 허용 여부, NaN 규칙, 런치 파라미터입니다. 이 하네스가 Metal·CUDA·HIP에서 다섯 게이트를 돌립니다.
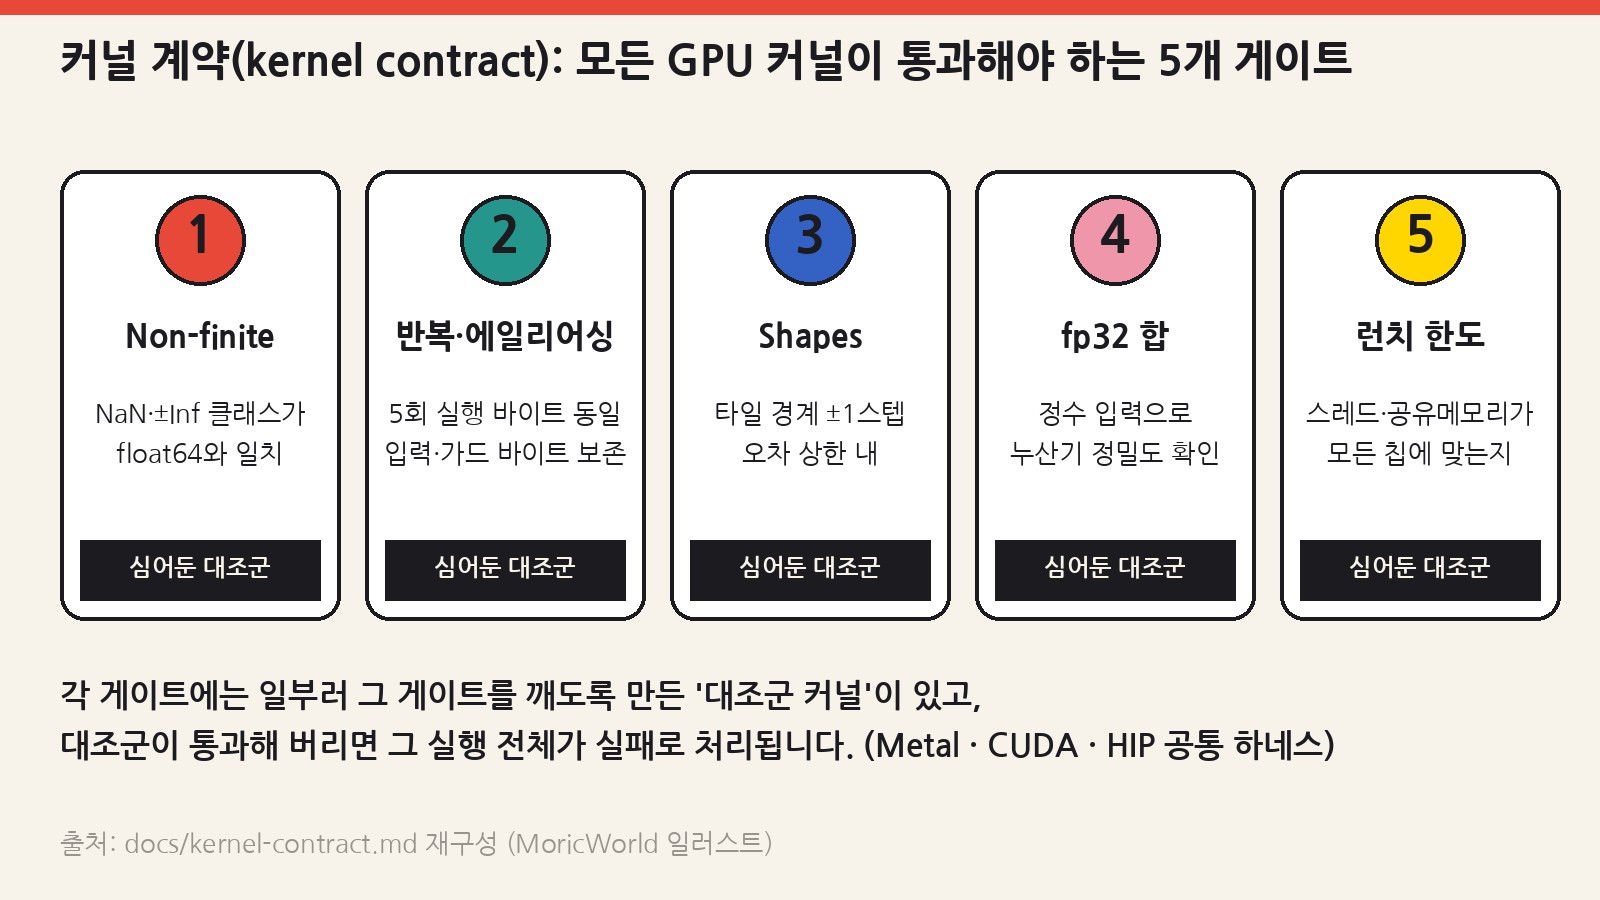
| 게이트 | 검사 내용 | 심어둔 대조군(반드시 실패해야 함) |
|---|---|---|
| 1. Non-finite | NaN·+Inf·-Inf를 정해진 위치에 넣고, 출력의 클래스(유한/NaN/±Inf)가 float64 기준과 허용오차 없이 일치하는지 | fmax로 구한 행 최댓값(NaN을 떨어뜨림) |
| 2. 반복·에일리어싱 | 같은 입력 5회 실행이 같은 바이트인지, 입력과 버퍼 주변 가드 바이트가 그대로인지, 허용 없이 출력이 입력과 겹치지 않는지 | atomic add 행 합(실행마다 순서가 바뀜), 입력에 덮어쓰는 행 합 |
| 3. Shapes | 서빙 형상 전부 + 타일 차원별 최소·타일−스텝·타일·타일+스텝·최대 크기에서 오차 상한 이내인지(교체 커널이면 비트 동일) | 부분 타일의 마지막 입력을 빠뜨리는 행 합(정타일에선 통과, 경계에서 실패) |
| 4. fp32 합 | 부분합이 약 2^20까지 커지고 2^24 아래인 정수 입력으로, 합산 순서와 무관하게 fp32 합이 정확한지. 하네스가 먼저 fp16·bf16 재현은 반드시 크게 틀리는지 확인 | (문서상 누산기 정밀도 검증. fp16은 오버플로, bf16은 수천 단위 손실) |
| 5. 런치 한도 | 스레드 그룹·공유 메모리·클러스터 폭 등 컴파일 기록이 서빙 대상 칩 전부에 맞는지(Metal·CUDA·HIP·XPU 레코드) | — |
핵심은 “대조군이 통과하면 그 실행 전체가 실패”라는 규칙입니다. 게이트가 실제로 무언가를 잡아낸다는 걸 매번 증명하게 만든 장치라, 단위 테스트 몇 개로 허용오차만 맞추는 흔한 커널 테스트보다 한 단계 더 엄격합니다. 1.2.7 노트의 내부 변경을 봐도 이 문화가 드러납니다. 일곱 패밀리의 샘플링 규칙을 하나로 합치면서 이전 구현과 25,480개 설정에서 바이트 단위로 비교했고, FP4 디코드 공용화는 2^33개 입력 전부에서 기존 디코드와 같다고 적혀 있습니다.
설치·실행·평가: README 명령 그대로
Mac (Apple Silicon)
brew install ashhart/tensorfold/tensorfold
tensorfold pull mlx-community/Qwen3.5-2B-MLX-4bit@93760be4f1f69842a46bc13dbdc0f19e291392a3
tensorfold serve mlx-community/Qwen3.5-2B-MLX-4bit --name local-model --context 8192 --no-thinking
Linux + NVIDIA
V=1.2.7
case "$(uname -m)" in
  aarch64|arm64) PLATFORM=linux-aarch64 ;;
  x86_64) PLATFORM=linux-x86_64 ;;
esac
curl -fLO "https://github.com/ashhart/TensorFold/releases/download/v$V/tensorfold-$V-$PLATFORM.tar.gz"
curl -fLO "https://github.com/ashhart/TensorFold/releases/download/v$V/tensorfold-$V-$PLATFORM.tar.gz.sha256"
sha256sum -c "tensorfold-$V-$PLATFORM.tar.gz.sha256"
tar -xzf "tensorfold-$V-$PLATFORM.tar.gz"
export PATH="$PWD/tensorfold-$V-$PLATFORM/bin:$PATH"
tensorfold() { command tensorfold-native "$@"; }
tensorfold pull mlx-community/Qwen3.5-2B-MLX-4bit@93760be4f1f69842a46bc13dbdc0f19e291392a3
tensorfold serve mlx-community/Qwen3.5-2B-MLX-4bit --name local-model --context 8192 --no-thinking
요청 보내기
curl -fsS http://127.0.0.1:8080/v1/chat/completions \
  -H 'Content-Type: application/json' \
  -d '{"model":"local-model","messages":[{"role":"user","content":"Say hello in one sentence."}],"max_tokens":128,"temperature":0}'
Docker를 쓴다면 루트 Dockerfile로 docker build -t tensorfold . 후 docker run --rm --gpus all -p 8080:8080 -v "$HOME/.cache/huggingface:/huggingface" tensorfold serve ... --host 0.0.0.0 형태로 띄웁니다. 호스트에 R580+ 드라이버와 NVIDIA Container Toolkit이 있어야 합니다.
박스 실측: GPU 없는 x86_64 리눅스에서 어디까지 되나
MoricWorld 작업 박스(8 vCPU, 메모리 15GiB, NVIDIA 드라이버 없음)에서 evaluating.md의 “모델 없이 하는 스모크 체크”와 서명 검증을 그대로 따라 했습니다. GPU 추론 속도는 재지 못했으니, 아래 결과는 배포물 무결성과 CLI 동작 확인으로만 읽어 주세요.
| 단계 | 명령 | 결과 |
|---|---|---|
| 체크섬 | sha256sum -c tensorfold-1.2.7-linux-x86_64.tar.gz.sha256 |
OK |
| 릴리스 서명 | openssl pkeyutl -verify -pubin -inkey tensorfold-release.pem -rawin ...(공개키는 packaging/runtime-trust.json의 ed25519PublicKey) |
Signature Verified Successfully |
| 아카이브 내부 파일 | sha256sum -c SHA256SUMS |
23개 항목 전부 OK. 압축 해제 후 192MB(bin/tensorfold-native, lib/libtfgrammar.so, 라이선스 고지) |
| 버전 | tensorfold-native --version |
tensorfold-native 1.2.7 |
| 능력 조회 | tensorfold-native capabilities --json |
backends: ["cuda"], 모델 패밀리 17개, serve 플래그 106개, 지원 환경변수 18개, 선택 라이브러리(cuBLASLt·cuBLAS·rocBLAS 등) found: false |
| 모델 받기 | tensorfold-native pull mlx-community/Qwen3.5-2B-MLX-4bit@93760be… |
약 18초. model.safetensors 1,642.49MiB를 52조각으로 병렬 수신 후 해시 검증 |
| 체크포인트 정보 | tensorfold-native info mlx-community/Qwen3.5-2B-MLX-4bit |
family qwen3_5, 4-bit group 64, 가중치 1.63GiB, memory floor 3.63GiB(가중치 + 런타임 여유 2.00GiB) |
| 서빙 시도 | tensorfold-native serve ... --context 8192 --no-thinking |
tensorfold: no CUDA driver (DriverUnavailable)로 즉시 거부. 모델 미다운로드 상태에서는 “native engine does not download: run tensorfold pull … first” 안내 |
| GPU 없는 테스트 | python3 -m pytest(얕은 클론, 저장소 루트) |
474 passed, 67 skipped, 521 subtests passed(3분 10초). GPU·numpy·빌드된 테스트 바이너리가 필요한 테스트는 사유를 남기고 skip |
눈여겨볼 점이 두 가지 있습니다. 첫째, Linux x86_64 빌드의 capabilities가 보고하는 백엔드는 cuda 하나뿐입니다. 저장소 설명문에는 “Vulkan”이 들어 있지만, README·런북·1.2.x 릴리스 노트에 정리된 서빙 경로는 Metal·CUDA·HIP(+XPU 적합성 프로필)이고 Vulkan 서빙 경로는 문서에서 찾지 못했습니다. AMD나 Intel 카드로 쓰려는 분은 설명문만 믿지 말고 해당 플랫폼 아카이브의 capabilities --json부터 확인하시기 바랍니다. 둘째, serve는 드라이버나 메모리 조건이 안 맞으면 가중치를 올리기 전에 이름을 붙여 거부합니다. 릴리스 노트 곳곳에 “refused by name before the weights load”가 반복되는데, 박스에서도 그 동작이 그대로 확인됐습니다.
운영 관점에서 볼 서버 플래그
| 영역 | 플래그 | 의미 / 주의점 |
|---|---|---|
| 동시성 | --parallel N|auto |
기본 auto는 메모리와 엔진이 허락하는 만큼 최대 8스트림. 명시한 수가 안 들어가면 거부. 시작 로그의 “8 streams at once” 같은 수용 줄을 확인 |
| 보안 | --api-key, --api-key-file, --unix-socket PATH |
키 파일은 권한 제한 필요, 라우트별 키 스코프 지원. 유닉스 소켓은 소유자 전용으로 만들어지고 다른 사용자의 연결은 닫음. 소켓 권한은 키를 대신하지 않는 “두 번째 층” |
| 입장 제어 | --max-inflight, --requests-per-second, --max-connections(기본 128) |
초과 요청은 429. 리버스 프록시 뒤라면 --trusted-proxy 지정 |
| 추론 제어 | --thinking-budget, --reasoning-effort, --loop-guard(-stop) |
loop-guard는 같은 문장을 반복하는 reasoning을 닫음. -stop은 거기서 응답을 끝내고 reasoning_loop 에러를 반환 |
| 컨텍스트 | --context, --compact-at auto |
Qwen3.8-27B는 기본 32,768, 최대 262,144. 압축은 켤 때만 출력이 바뀜 |
| 관측 | --dashboard, /metrics, GET /v1/memory, /health |
1.2.7부터 대시보드·/stats에 프롬프트 캐시와 디스크 계층 상태 표시 |
| 외부 접근 | --cortheon |
켜면 서버가 대화에서 만든 검색어를 DuckDuckGo(또는 Brave)로 보내고 이 기계에서 페이지를 가져옴. 끄면 검색·페치 없음. 폐쇄망 정책과 충돌 여부 확인 필요 |
비교: 비슷한 도구와 무엇이 다른가
| 구분 | TensorFold 1.2.7 | llama.cpp | vLLM | MLX-LM | Ollama |
|---|---|---|---|---|---|
| 구현 | Zig 단일 바이너리 + Metal/CUDA/HIP 커널 | C/C++(ggml) | Python + PyTorch + 커스텀 커널 | Python + Apple MLX | Go 데몬 + 내장 엔진 |
| 모델 범위 | 패밀리별 전용 경로, “qualified” 조합 중심(좁고 깊음) | GGUF로 변환되는 광범위한 아키텍처 | HF 아키텍처 대다수 | MLX 변환 모델 다수 | 레지스트리 모델 중심 |
| 주 타깃 하드웨어 | Apple Silicon, GB10(DGX Spark), RTX/RTX PRO, Radeon(HIP) | CPU부터 각종 GPU까지 범용 | 데이터센터 GPU | Apple Silicon 전용 | 데스크톱·노트북 |
| 출력 보장 철학 | 드래프트·캐시·동시성이 출력 불변(정확 디코딩)을 명시 규칙으로 | 구현별 | 처리량 우선, 배치 간 비결정성 가능 | 구현별 | 엔진 따름 |
| 멀티 머신 | Mac 2대(Thunderbolt 5) 페어, GB10 TP=2/3 직결 링 | RPC 백엔드 | TP/PP, 다중 노드 | 제한적 | 단일 노드 |
| API | OpenAI·Responses(WebSocket)·Anthropic Messages | OpenAI 호환 서버 | OpenAI 호환 | OpenAI 호환 서버 | 자체 API + OpenAI 호환 |
| 잘 맞는 상황 | 특정 최신 모델을 Mac/GB10에서 에이전트 워크로드로 빠르게, 재현 가능하게 | 아무 하드웨어에서나 일단 돌리기 | 대규모 동시 서빙 | Mac 연구·파인튜닝 | 개인용 간편 실행 |
비교표의 다른 도구 항목은 각 프로젝트의 일반적인 성격을 요약한 것이고 같은 조건에서 벤치마크한 결과가 아닙니다. TensorFold의 장점은 “좁은 모델 집합을 특정 하드웨어에서 극단적으로 최적화하고, 그 과정에서 출력이 변하지 않음을 증거로 남긴다”는 데 있습니다. 반대로 말하면, 엔진이 모르는 아키텍처가 나오면 지원 PR이 들어오기 전까지는 손쓸 방법이 없습니다.
트레이드오프와 한계
| 항목 | 내용 | 대응 |
|---|---|---|
| 모델 커버리지 | 패밀리×포맷×하드웨어 조합만 인증. DeepSeek 미지원(#827 미병합), MiMo 네이티브 미출시, 일부는 Python 0.6.6 전용 | capabilities --json과 Pick a model 표로 사전 확인 |
| 변경 빈도 | 2~3일 간격 릴리스. 출력·거부 조건·기본값이 바뀌는 항목이 매번 “What can change for you”에 올라옴 | 프로덕션은 버전 고정, 업그레이드 전 해당 섹션 검토 |
| 재현성 범위 | 정확 디코딩은 동일 체크포인트·백엔드·설정·런타임 안에서만 성립. 양자화·백엔드가 다르면 출력 다름 | 평가 시 릴리스·REPO@revision·백엔드·레시피 플래그 4가지를 함께 기록(evaluating.md 권고) |
| 알려진 이슈 | GLM-5.3(EXLR8) 느린 디코드(M5 Ultra 2대에서 1행 라운드 약 45ms), Qwen3.5-2B가 JSON 스키마 정수 필드에서 숫자를 계속 늘리는 문제, Flash Next Metal --parallel 2+의 재사용 토큰 감소 등 |
docs/known-issues.md는 릴리스가 고칠 때만 항목을 지움 |
| 프라이버시 | --recall·--learn-conversations는 디스크에 상태·토큰 id를 남김. 토큰 id는 토크나이저로 원문 복원 가능 |
대화 로그와 같은 등급으로 디렉터리 보호, 필요 시 DELETE /v1/recall |
| 실험 기능 | Living Weights(--slide)는 실행 중 모델 가중치 파일에 사실을 써넣음. 관련 사실끼리 간섭, 수십 개를 넘으면 recall 저하, Mac에서 디코드 속도 비용 |
반드시 체크포인트 사본에서, API 키와 함께. tensorfold slide rollback으로 원복 |
| 빌드 난도 | 소스 빌드에 full Xcode + Metal Toolchain(CLT만으로는 metal 유틸리티를 찾지 못해 모든 커널 컴파일 실패) 또는 CUDA 13 nvcc 필요 |
대부분은 서명된 릴리스 아카이브·Homebrew 사용 권장 |
도입 체크리스트
- 하드웨어 매칭: 쓰려는 모델이 Pick a model 표에서 내 기계 계열(M 시리즈 세대, GB10, RTX 50 등)로 확인됐는지 봅니다. 확인 기록이 없으면 “안 된다”가 아니라 “측정된 적 없다”입니다.
- 메모리 바닥 확인:
tensorfold info REPO의 memory floor에 컨텍스트·--parallel·프롬프트 캐시·드래프터 몫을 더해 계산합니다. - 정확성 셀프 체크: temperature 0에서 같은 요청을
"draft": false와 기본값으로 각각 보내 텍스트와usage를 비교합니다. 캐시 재요청과 동시 요청도 같은 방식으로 확인합니다. - 벤치 오염 방지: 기록이 쌓인
--recall은 반복 프롬프트 벤치를 빠르게 만듭니다. 벤치·게이트는 Recall을 끄거나 빈 기록에--recall-read-only로 돌리고 그 사실을 적어 둡니다. - 노출 범위: 기본 바인딩은
127.0.0.1:8080입니다. 외부에 열 때는 API 키 파일·입장 제어·--trusted-proxy를 함께 설정하고,--cortheon을 켜면 외부 검색이 나간다는 점을 정책에 반영합니다. - 버전 고정: 릴리스 서명(
.sha256.sig)까지 검증하고 버전을 고정한 뒤, 업그레이드 때마다 “What can change for you”를 읽습니다.
정리
TensorFold는 “어떤 모델이든 다 돌리는 범용 엔진”을 목표로 하지 않습니다. Apple Silicon과 GB10 같은 통합 메모리 기계에서 Qwen3.8·Nemotron 3.5·GLM-5.3-Flash·Gemma 4 같은 최신 모델을 에이전트 워크로드에 맞춰 최대한 빠르게, 그리고 최적화가 출력을 바꾸지 않는다는 증거와 함께 돌리는 쪽을 택했습니다. 단일 Zig 바이너리, 서명된 릴리스, 커널 계약의 대조군 게이트, 기계와 PR 번호가 붙은 실측 영수증은 운영자에게 반가운 성질입니다. 대신 모델 커버리지가 좁고 변경 속도가 매우 빠르다는 점은 감수해야 합니다. 쓸 모델과 하드웨어가 인증 표에 들어 있다면 llama.cpp나 MLX-LM과 나란히 같은 프롬프트로 비교해 볼 만한 후보입니다. 그 전에 capabilities --json과 info로 내 환경에서 무엇이 실제로 열리는지부터 확인하시길 권합니다.