책 한 권을 한 번에 베껴 쓰는 OCR: baidu/Unlimited-OCR의 R-SWA 링 버퍼 KV 캐시·DeepEncoder 16배 압축·3B MoE 디코더 심층 해부와 박스 CPU 실측
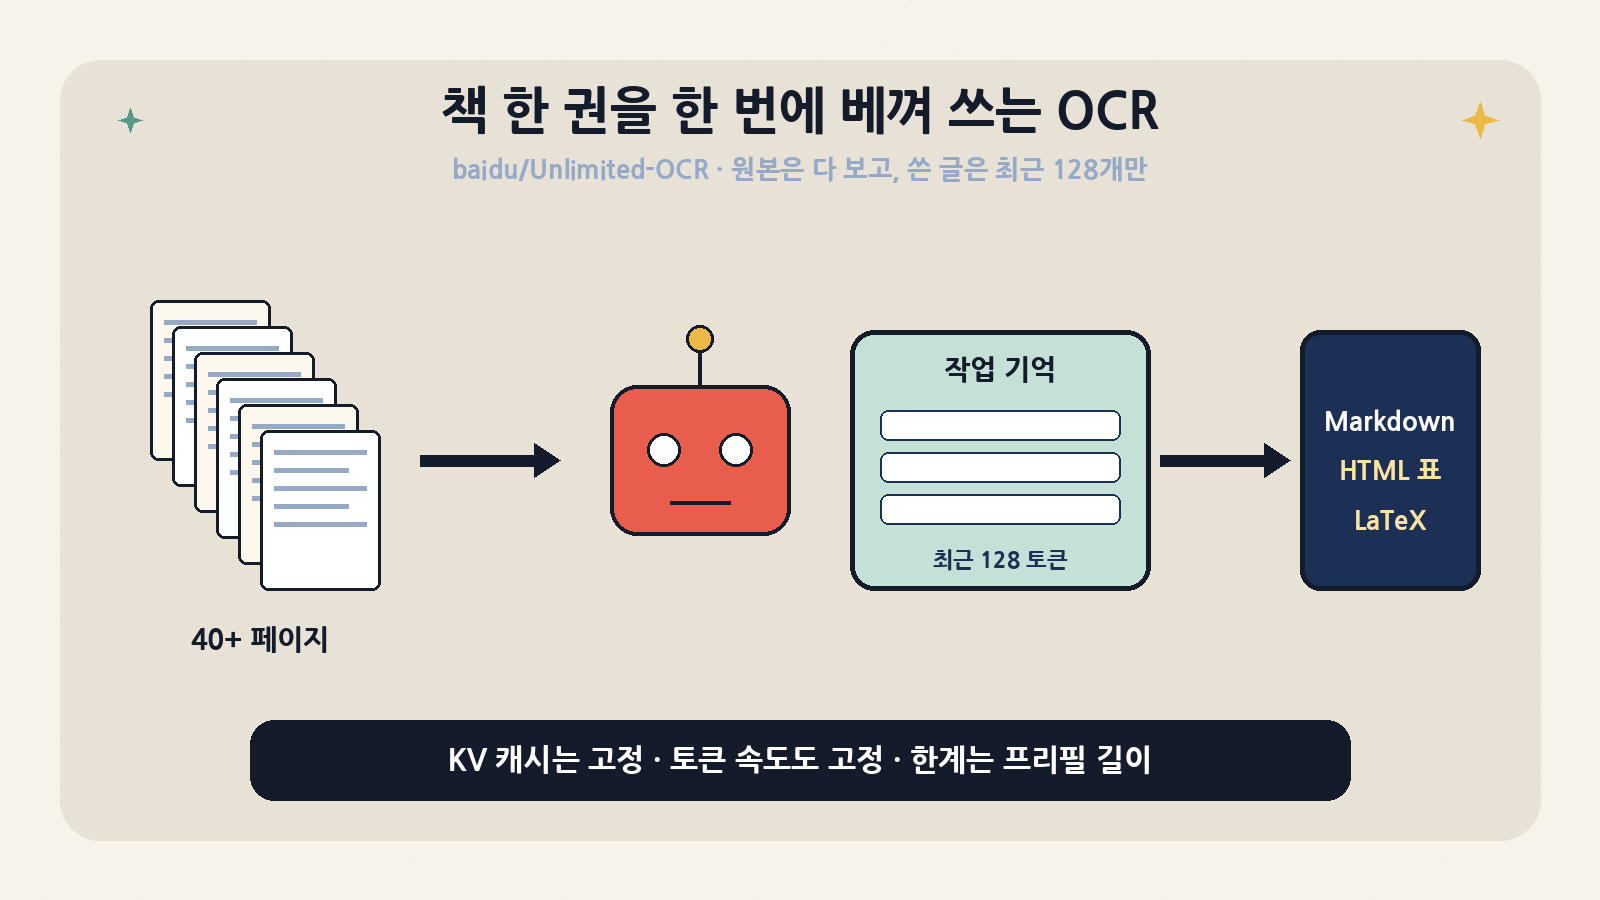
LLM 디코더를 단 엔드투엔드 OCR은 품질이 좋아진 대신 운영자에게 익숙한 골칫거리를 하나 남겼다. 출력이 길어질수록 KV 캐시가 자라고, 토큰당 지연도 함께 늘어난다는 점이다. 그래서 현장의 문서 파이프라인은 PDF를 페이지 단위로 잘라 for 루프로 돌리고, 페이지마다 모델의 “기억”을 초기화한다. 바이두가 공개한 baidu/Unlimited-OCR은 이 루프를 모델 안으로 끌어들이려는 시도다. DeepSeek-OCR을 베이스로 디코더의 모든 어텐션을 R-SWA(Reference Sliding Window Attention)로 바꿨다. 이미지와 프롬프트(참조 토큰)는 끝까지 전부 보되, 이미 쓴 출력은 최근 128토큰만 본다. 그 결과 디코드 쪽 KV 캐시가 참조 길이 m + 128에서 멈추고, 수십 쪽을 한 번의 forward 패스로 연속 전사할 수 있다는 것이 주장이다.
Unlimited-OCR는 원본 페이지(참조 토큰)는 끝까지 전부 보고, 이미 쓴 출력은 최근 128토큰만 기억하는 방식으로 여러 쪽을 한 번에 전사한다
오늘(2026-10-24) GitHub Trending Python 일간 4위(+75, 11:52 KST 스냅숏)에 다시 올라왔다. 10월 23일 README가 갱신됐고, 이슈 트래커에는 지난주부터 infer.py 품질 개선 PR과 멀티 페이지 구분자 누락 리포트가 이어지고 있다. 이 글은 저장소 README·기술 보고서 PDF·Hugging Face의 trust_remote_code 모델 코드를 직접 읽고 구조와 타협점을 해부한다. 그리고 GPU가 없는 박스(x86_64 VM, 8코어, RAM 15GB)에서 6.67GB 가중치를 실제로 받아 CPU로 돌려 R-SWA 링 버퍼가 정말 KV 캐시를 고정하는지, 링을 끄면 어떻게 되는지, 8쪽 연속 전사가 되는지 측정한 결과를 그대로 적는다.
한눈에 보기: 오늘 기준 스냅숏
항목
값
저장소
github.com/baidu/Unlimited-OCR · 생성 2026-06-18 17:40 KST · 기본 브랜치 main · 커밋 15개(대부분 README), 기여자 3명(API 기준)
라이선스
MIT(Copyright 2026 Baidu) — 코드와 Hugging Face 가중치 카드 모두 license: mit
버전
GitHub Release 없음. 태그·브랜치 UnlimitedOCR1.0(2026-06-22 공개). 가중치는 HF baidu/Unlimited-OCR 최신 수정 2026-10-14 15:17 KST
GitHub 지표
28,292 stars · 3,003 forks · 열린 이슈+PR 91 · 마지막 push 2026-10-23 15:06 KST(README 갱신)
Hugging Face
pipeline image-text-to-text, custom_code · 최근 다운로드 약 228만 · 좋아요 4,888
모델
DeepEncoder(SAM-ViT-B + CLIP-L) + DeepSeek-V2 계열 MoE 디코더 3B 총/약 0.5B 활성, 12층, 라우팅 전문가 64 + 공유 2, 토큰당 6개, 32K 컨텍스트, sliding_window_size: 128
가중치 크기
BF16 safetensors 단일 파일 6,672,547,120바이트(약 6.67GB)
추론 경로
Transformers(trust_remote_code), vLLM(전용 Docker 이미지 vllm/vllm-openai:unlimited-ocr), SGLang(저장소에 동봉된 dev 휠)
논문
기술 보고서 “Unlimited OCR Works” (arXiv 2606.23050, 저장소에 PDF 동봉)
무엇을 풀려는가: for 루프 OCR의 진짜 비용
보고서의 문제 설정은 단순하다. 사람은 책을 베낄 때 지금까지 쓴 글 전체를 다시 훑지 않는다. 원본을 보고, 방금 쓴 몇 글자로 “어디까지 썼는지”만 확인한 뒤 다음 글자를 쓴다. 반면 표준 어텐션 디코더는 매 토큰마다 지금까지의 출력 전체를 다시 본다. 페이지 하나에 수천 토큰이 나오는 문서 OCR에서는 이것이 그대로 메모리와 지연 증가로 이어진다. 보고서의 계산으로 1024×1024 기준 약 20~30쪽이면 시각 토큰이 1만 개 수준이고, 시각:텍스트 토큰 비율을 1:10으로 잡으면 출력이 10만 토큰을 넘는다.
접근
방식
장점
대가
페이지별 for 루프
페이지마다 독립 요청, 기억 초기화
구현 쉬움, 병렬화 쉬움
페이지 경계를 넘는 표·문단·각주 연결이 끊김, 외부 스케줄러 필요
긴 컨텍스트 + 전체 어텐션
모든 페이지를 한 번에 넣고 끝까지 생성
문맥 연결
KV 캐시가 출력 길이에 비례해 증가, 토큰 속도 점점 저하, 최대 길이 초과
일반 SWA·선형 어텐션
최근 창만 보거나 상태를 재귀 갱신
메모리 고정
시각 토큰까지 창 밖으로 밀리거나 상태에 섞여 흐려짐(보고서가 지적하는 ‘progressive blurring’)
R-SWA (Unlimited-OCR)
참조(이미지+프롬프트)는 항상 전부, 출력은 최근 n=128만
디코드 캐시 상한 고정, 시각 토큰 원형 유지
한계가 ‘프리필 길이’로 이동, 출력 쪽 장거리 의존은 버림
아키텍처: 인코더는 그대로, 디코더 어텐션만 바꿨다
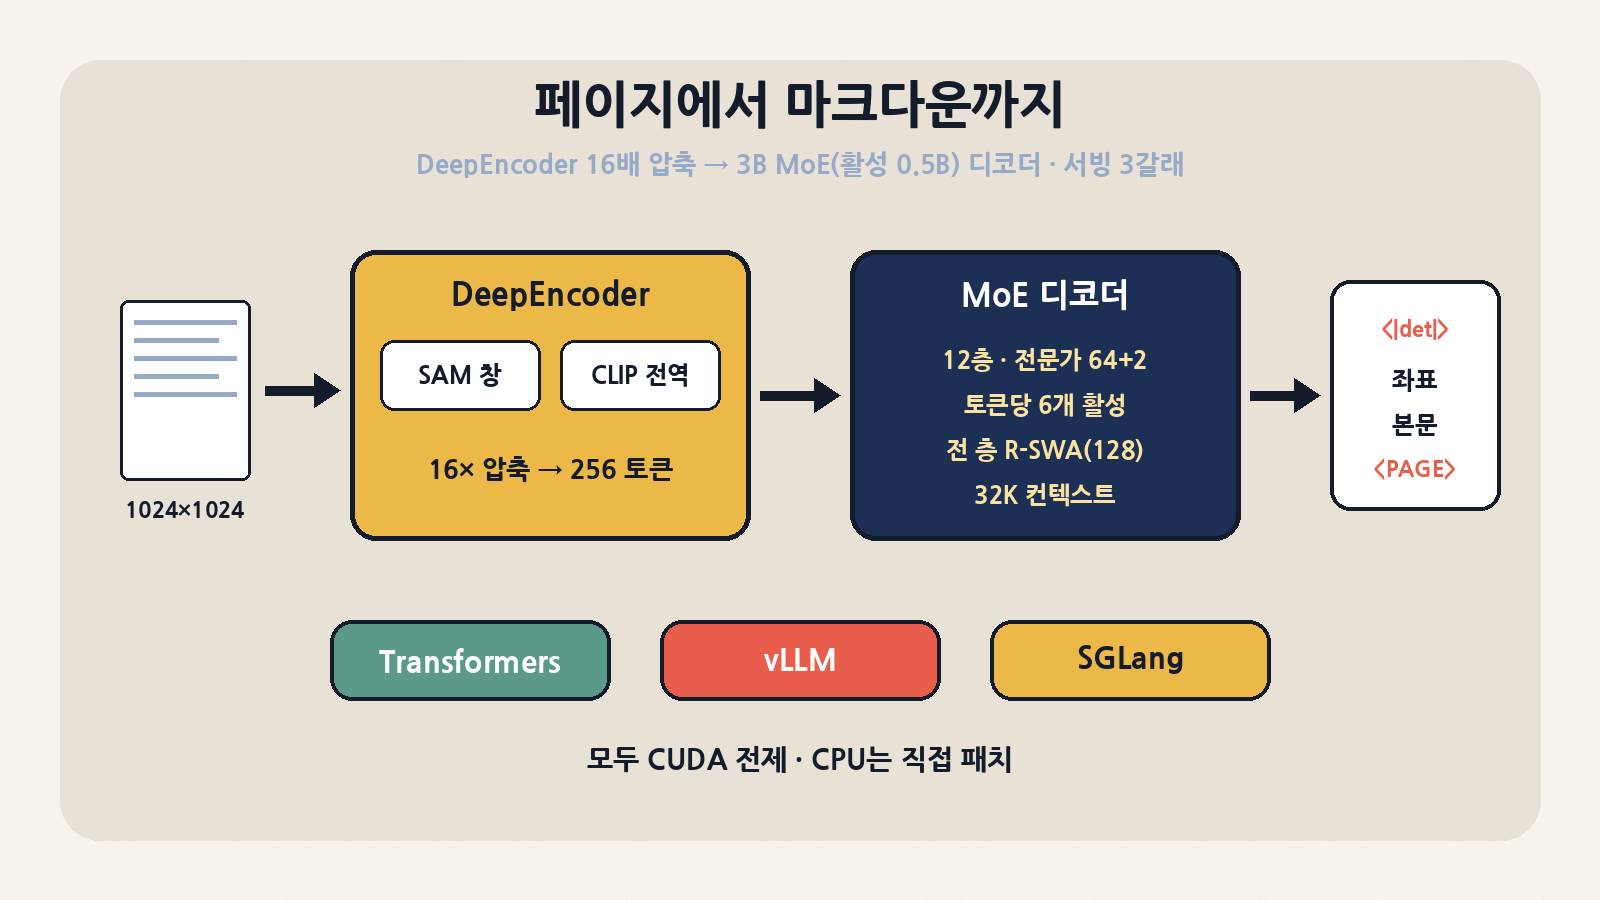
페이지 이미지 → DeepEncoder(SAM 창 어텐션 → 16배 압축 → CLIP 전역) 256토큰 → 3B MoE 디코더(활성 약 0.5B, 전 층 R-SWA) → det 좌표·본문·PAGE 구분자. 서빙은 Transformers·vLLM·SGLang
구조적으로 Unlimited-OCR은 DeepSeek-OCR의 부분 수정판이다. 보고서에 따르면 DeepSeek-OCR 체크포인트에서 출발해 DeepEncoder는 동결하고 LLM 디코더만 4,000스텝 이어서 학습했다(전역 배치 256, 시퀀스 32K, 8×16 A800, Megatron-LM + DeepEP, 전문가 병렬 4). 학습 데이터는 약 200만 개 문서 OCR 샘플로, 단일:다중 페이지 비율이 9:1이다. 단일 페이지 라벨은 PaddleOCR로 만들었고, 다중 페이지 데이터(약 20만 개, 2~50쪽)는 단일 페이지를 <page> 구분자로 이어 붙여 합성했다.
<|det|>종류 [x1,y1,x2,y2]<|/det|>본문, 표는 HTML, 페이지 사이 <PAGE>
레이아웃 감지와 인식을 한 시퀀스로
좌표는 0~1000 정규화
R-SWA를 코드로 읽기: 링 버퍼 KV 캐시
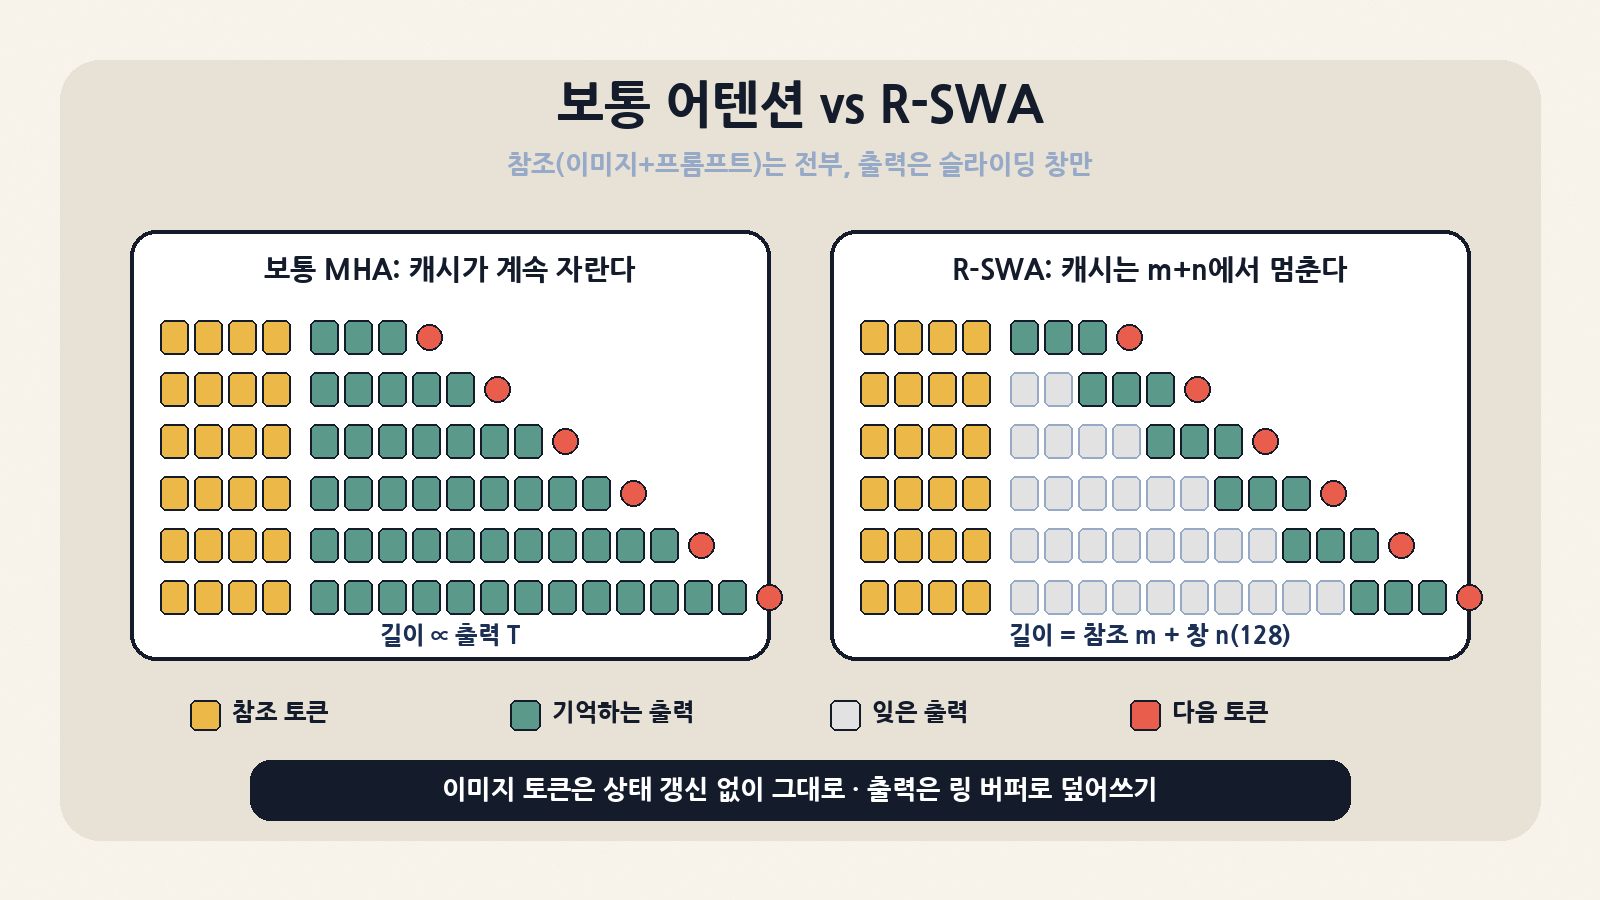
보통 MHA는 출력이 길어질수록 KV 캐시가 자라지만, R-SWA는 참조 m + 창 n(128)에서 캐시가 멈추고 오래된 출력 KV는 링 버퍼에서 덮어쓴다
보고서의 정의는 이렇다. 프리필 길이 Lm(시각 토큰 + 프롬프트)은 한 번의 추론에서 고정이고, 디코드 t번째 토큰이 볼 수 있는 집합은 N(t) = P ∪ Dn(t), 즉 전체 프리필 P와 직전 n개 출력의 합집합이다. 따라서 T개를 생성한 뒤 캐시 크기는 CR-SWA(T) = Lm + min(n, T) ≤ Lm + n 이고, 표준 MHA의 Lm + T와 대비된다. 흥미로운 건 이게 새 커널이 아니라 캐시 관리 규칙이라는 점이다. Hugging Face에 올라간 modeling_deepseekv2.py의 SlidingWindowLlamaAttention을 보면 구현이 매우 직선적이다.
단계
코드 동작
의미
1. 프리필
첫 forward에서 프리필 KV를 평범하게 쌓고, 층별로 _prefill_length를 기록
이 구간은 절대 지우지 않는다(참조 토큰 보존)
2. 워밍업
디코드 토큰을 cat-append로 붙이다가 길이가 prefill_len + W(W=128)에 도달하면 링 모드로 전환
처음 128토큰은 일반 디코드와 동일
3. 링 덮어쓰기
새 K/V를 slot = prefill_len + ring_pos 자리에 in-place로 쓰고 ring_pos = (ring_pos+1) % W
가장 오래된 출력 KV가 자동 퇴출 — 메모리 할당이 더 늘지 않음
4. 어텐션
링 상태에선 마스크 없이 전체 캐시(프리필 + 128)에 대해 softmax
RoPE가 K에 이미 적용돼 있어 슬롯 순서가 섞여도 위치 정보는 유지
5. 설정 토글
infer()가 config.sliding_window를 잠시 None으로 바꾸고 _ring_window에 128을 옮겨 둔 뒤 generate, 끝나면 복원
Transformers의 DynamicCache가 프리필까지 잘라 버리는 것을 막기 위한 우회
운영 관점에서 짚을 점 — 5번의 “설정을 잠시 바꿨다가 복원”하는 방식은 하나의 모델 객체를 여러 스레드가 공유하면 경합이 생길 수 있는 구조다. Transformers 경로로 서비스할 때는 요청 직렬화나 프로세스 단위 격리를 기본으로 두고, 동시성은 SGLang/vLLM 경로에 맡기는 편이 안전하다. 또 링 상태의 어텐션은 여전히 순수 PyTorch matmul이라, Transformers 경로에선 보고서가 말하는 FlashAttention v3 커널 이득을 그대로 기대하기 어렵다.
보고서가 내세운 숫자, 그리고 읽는 법
OmniDocBench v1.5 (보고서 표 1)
크기
Overall↑
Text Edit↓
Formula CDM↑
Table TEDS↑
읽기순서 Edit↓
Unlimited-OCR
3B-A0.5B
93.23
0.038
92.61
90.93
0.045
DeepSeek-OCR (베이스)
3B-A0.5B
87.01
0.073
83.37
84.97
0.086
DeepSeek-OCR 2
3B-A0.5B
89.17
0.049
86.85
85.60
0.060
dots.ocr
3B
88.41
0.048
83.22
86.78
0.053
Gemini-2.5 Pro
—
88.03
0.075
85.82
85.71
0.097
Qwen3-VL
235B
89.15
0.069
88.14
86.21
0.068
MinerU2-VLM
0.9B
85.56
0.078
80.95
83.54
0.086
OmniDocBench v1.6 (보고서 표 1)
Overall↑
Text Edit↓
Formula CDM↑
Table TEDS↑
Unlimited-OCR
93.92
0.042
95.79
90.16
Qianfan-OCR (4B)
93.90
0.040
95.08
90.53
Logics-Parsing-v2 (4B)
93.33
0.041
95.65
88.42
FireRed-OCR (2B)
93.26
0.037
95.44
88.04
dots.ocr (3B)
90.77
0.048
89.95
87.18
DeepSeek-OCR 2
90.25
0.050
91.84
83.89
읽을 때 주의할 점이 세 가지다. 첫째, v1.6에서 1위라고는 하지만 2위(Qianfan-OCR 93.90)와 차이는 0.02포인트이고 Text Edit·Table TEDS는 오히려 뒤진다. “동급 최상위권”이 정확한 표현이다. 둘째, v1.5에서 베이스 대비 +6.22포인트는 R-SWA만의 효과로 단정하기 어렵다. 같은 실험에서 200만 개 문서 특화 데이터로 추가 학습을 했기 때문에, 어텐션 변경과 데이터 효과가 섞여 있다(보고서도 “R-SWA may allow…”라고 조심스럽게 쓴다). 셋째, 장문 성능(표 3)은 사내 테스트셋이라 재현이 어렵다.
장문 전사 (보고서 표 3, 사내셋)
Distinct-20↑
Distinct-35↑
Edit Distance↓
2쪽
99.76%
99.87%
0.0362
5쪽
99.78%
99.98%
0.0452
10쪽
97.49%
99.83%
0.0526
15쪽
99.92%
99.99%
0.0787
20쪽
98.73%
99.89%
0.0572
40쪽 이상
96.08%
96.90%
0.1069
출력 길이 (보고서 표 4, 프리필 10)
DeepSeek-OCR TPS
Unlimited-OCR TPS
차이
256
7,229
7,230
≈ 동일
1,024
7,423
7,841
+5.6%
2,048
7,167
7,881
+10.0%
4,096
6,430
7,905
+22.9%
6,144
5,823
7,848
+34.8%
표 4는 R-SWA의 핵심 효과를 가장 깨끗하게 보여 준다. 출력이 짧으면 차이가 없고, 길어질수록 베이스는 떨어지는데 Unlimited-OCR은 7,800 TPS대에서 평평하다. OmniDocBench 실측 처리량은 512 동시성에서 5,580 vs 4,951 TPS(+12.7%)로 보고됐다. 문서 길이가 짧은 벤치마크에선 이득도 작다는 뜻이다. 보고서 스스로 밝힌 한계도 분명하다. 32K 컨텍스트 안에서 프리필이 쌓이면 결국 막힌다. 보고서 초록도 “표준 최대 길이 32K에서 수십 쪽”이라고 쓴다. 그래서 ‘진짜 무제한’은 아니며, 128K 학습과 “프리필 KV 풀에서 필요한 페이지를 꺼내 오는” 방식이 향후 과제로 적혀 있다.
실제 모델 코드. infer()/infer_multi(), 링 버퍼 어텐션, n-gram 반복 차단 로짓 프로세서가 여기 있다
즉 “저장소를 클론해서 테스트를 돌린다”는 개념이 거의 없다. 학습 코드나 단위 테스트는 공개되지 않았고(CONTRIBUTING은 단위 테스트를 요구하지만 저장소에 테스트 디렉터리가 없다), 모델 코드는 Hugging Face 쪽 trust_remote_code로 배포된다. 도입 검토는 HF 리비전 고정 + 원격 코드 리뷰가 사실상 코드 리뷰다.
설치와 실행: 세 갈래
1) Transformers (가장 단순, CUDA 전제)
pip install torch==2.10.0 torchvision==0.25.0 transformers==4.57.1 \
  einops==0.8.2 addict easydict pymupdf==1.27.2.2 Pillow matplotlib psutil

python - <<'EOF'
import torch
from transformers import AutoModel, AutoTokenizer
name = "baidu/Unlimited-OCR"
tok = AutoTokenizer.from_pretrained(name, trust_remote_code=True)
model = AutoModel.from_pretrained(name, trust_remote_code=True,
        use_safetensors=True, torch_dtype=torch.bfloat16).eval().cuda()
# 단일 페이지: gundam(base_size=1024, image_size=640, crop) 또는 base(1024, no crop)
model.infer(tok, prompt="<image>document parsing.", image_file="page.png",
            output_path="out", base_size=1024, image_size=640, crop_mode=True,
            max_length=32768, no_repeat_ngram_size=35, ngram_window=128, save_results=True)
# 멀티 페이지/PDF: base(1024)만, n-gram 창 1024
model.infer_multi(tok, prompt="<image>Multi page parsing.",
            image_files=["p1.png", "p2.png", "p3.png"], output_path="out",
            image_size=1024, max_length=32768, no_repeat_ngram_size=35,
            ngram_window=1024, save_results=True)
EOF
필수에 가깝다. vLLM 레시피는 “없으면 긴 문서가 <|det|> 좌표 토큰에서 루프”라고 경고. 크기 35, 창 128(단일)/1024(멀티)
skip_special_tokens=False
<|det|>·<PAGE> 같은 구조 토큰이 사라지면 후처리가 불가능
프롬프트
<image>document parsing.(단일), <image>Multi page parsing.(멀티). 채팅 템플릿에 의존하지 말 것
prefix cache 끄기
문서 페이지는 재사용이 거의 없어 vLLM 레시피도 prefix caching과 멀티모달 캐시를 끈다
멀티 페이지 = Base 모드
페이지마다 1024 전역 뷰 하나(약 273토큰). 작은 글씨는 단일 페이지 Gundam보다 불리
양자화·GGUF
공식 제공 없음. 커뮤니티 GGUF/Vulkan 시도 이슈(#99)는 있지만 공식 경로 아님
박스 실측: GPU 없이 CPU로 정말 돌려 봤다
공식 경로는 모두 CUDA 전제다. infer()와 infer_multi() 안에 .cuda() 호출과 torch.autocast("cuda")가 하드코딩돼 있어(이슈 #81도 같은 지적) 그대로는 CPU에서 즉시 실패한다. 박스에서는 코드를 고치지 않고 torch.Tensor.cuda를 항등 함수로 바꾸는 한 줄 몽키패치로 우회했다(autocast는 CUDA가 없으니 경고 후 비활성). 환경은 Python 3.12 가상환경, torch 2.10.0+cpu · transformers 4.57.1, BF16 가중치, attn_implementation="eager"(= 링 버퍼 어텐션 클래스), 8스레드다. 입력은 정답을 아는 합성 문서(1240×1754, 제목·문단·3×3 표)를 PIL로 만들어 썼다. 가중치 다운로드(6.67GB)는 약 3분, 모델 로드는 1~2초(페이지 캐시 적중)였다.
import torch
torch.Tensor.cuda = lambda self, *a, **k: self      # CPU 박스용 우회
model = AutoModel.from_pretrained(MD, trust_remote_code=True, use_safetensors=True,
        torch_dtype=torch.bfloat16, attn_implementation="eager").eval()
# 링을 끈 대조군: 같은 가중치에서 sliding_window를 None으로
model.config.sliding_window_size = None; model.config.sliding_window = None
# forward hook으로 스텝별 시간과 0번 층 KV 길이를 기록
실행 (Base 1024, 박스 CPU)
프리필 토큰
생성 토큰
최종 KV 길이(0번 층)
디코드 tok/s
최대 RSS(GB)
정규화 편집거리↓
1쪽, R-SWA
277
211
405
18.49
6.75
0.0
1쪽, 링 끔
277
212
489
11.63
6.83
0.0018
3쪽, R-SWA
824
567
952
8.78
7.13
0.002
3쪽, 링 끔
824
568
1392
16.34
7.36
0.0066
서로 다른 8쪽, R-SWA
2189
1034
2317
21.59
8.5
0.0011
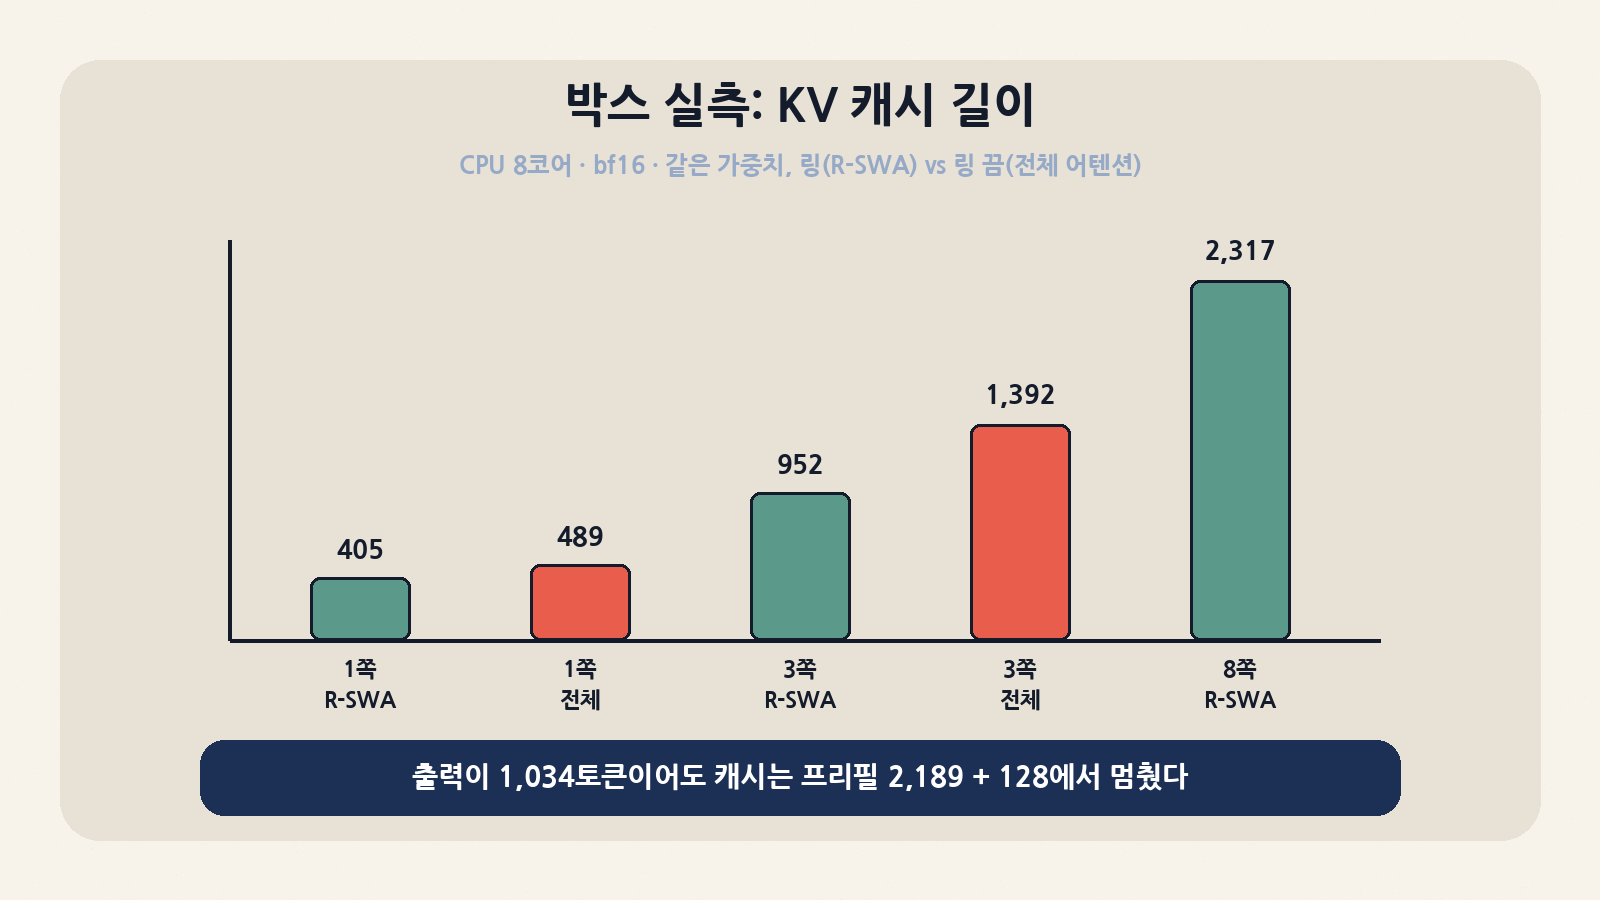
박스 CPU 실측: R-SWA는 KV 캐시가 프리필 + 128에서 고정(405·952·2,317), 링을 끄면 생성 토큰만큼 증가(489·1,392). 서로 다른 8쪽은 1,034토큰 생성 동안 2,317로 고정
가장 분명한 결과는 KV 캐시 길이다. R-SWA 실행은 모든 경우 정확히 프리필 + 128에서 멈췄다(277→405, 824→952, 2,189→2,317). 같은 가중치에서 링을 끄면 프리필 + 생성 토큰 수만큼 자랐다(277→489, 824→1,392). 서로 다른 8쪽 문서는 프리필 2,189토큰(페이지당 약 273토큰 × 8 + 텍스트)으로 시작해 1,034토큰을 생성하는 동안 캐시가 2,317에서 고정됐고, 페이지 구분자 <PAGE> 7개(8쪽 사이 7곳)가 모두 정상으로 나왔으며 정답 대비 정규화 편집거리는 0.0011였다. 3쪽 R-SWA 출력에서는 “becomes”를 “becoming”으로 쓴 단어 오류가 하나 있었다.
관찰
측정
해석
KV 고정
R-SWA는 프리필 + 128에서 정확히 고정, 링 끔은 선형 증가
보고서 식 (6)과 일치. 코드가 주장대로 동작
토큰 속도
CPU에선 R-SWA와 링 끔의 차이가 작고 노이즈가 큼(박스 공유 부하, 3쪽 R-SWA는 첫 4분의 1 구간이 140ms/토큰으로 튐). 8쪽 R-SWA는 첫 4분의 1 48.3ms → 마지막 4분의 1 45.4ms로 평평
이 길이(수천 토큰)·CPU에선 MoE FFN이 병목이라 어텐션 이득이 잘 안 보임. TPS 이득 검증은 GPU에서 6K+ 출력으로 해야 함
스트레스 테스트: 똑같은 페이지가 반복되면 길을 잃는다 — 1·2·3쪽을 반복해 8쪽(1,2,3,1,2,3,1,2)을 만든 입력에선 R-SWA가 <PAGE>를 12번 내며 2,178토큰을 생성했고(정답 7번), 5쪽 이후 같은 페이지를 다시 쓰거나 빈 페이지를 냈다(편집거리 0.3152). 최근 128토큰만으로 “지금 몇 번째 쪽인가”를 추적하는 구조라, 직전 문맥이 완전히 같은 페이지가 이어지면 위치를 구분할 단서가 없다. 같은 입력에서 링을 끈 대조군은 785토큰에서 footer [aside_text] 같은 깨진 토큰으로 일찍 끝났다. 이 가중치는 R-SWA로 학습됐으니 링을 끈 쪽은 원래 분포 밖이다. 서식이 똑같은 송장·양식 묶음, 반복 헤더가 많은 보고서처럼 현실에서 흔한 ‘거의 같은 페이지’ 묶음은 반드시 따로 검증하자. 이슈 #107(멀티 페이지 구분자 누락)과도 맞닿아 있다.
범위
내용
실행함
HF 가중치 6.67GB 실다운로드, CPU BF16 추론(단일·멀티 페이지), 링 on/off KV 길이·스텝 시간 계측, 합성 정답 대비 편집거리, 한국어 1쪽, 중복 페이지 스트레스
실행 못 함
GPU 경로 전부(SGLang 동봉 휠, vLLM 전용 이미지, FlashAttention), OmniDocBench 재현, Gundam(크롭) 모드 품질 비교, 실제 스캔 문서·수식·손글씨, 40쪽 이상 장문
측정 한계
CPU 8코어 공유 VM이라 절대 속도는 참고용. 합성 문서는 깨끗한 디지털 렌더링이라 실제 스캔보다 쉬움. 편집거리는 det 태그와 표 태그를 벗긴 평문 기준
비교: 어디에 놓이는 도구인가
도구
유형
라이선스
강점
약점
Unlimited-OCR
엔드투엔드 VLM(3B MoE, 활성 0.5B)
MIT
멀티 페이지 한 번에 연속 전사, 디코드 KV 고정, v1.6 최상위권
CUDA 전제, 32K 프리필 한계, 학습 코드 없음, 반복 페이지 취약
DeepSeek-OCR / OCR 2
엔드투엔드 VLM(3B MoE)
MIT
강력한 시각 토큰 압축, 원조 생태계
출력 길수록 KV·지연 증가, 페이지별 처리가 기본
PaddleOCR(PP-StructureV3, PaddleOCR-VL)
파이프라인 + 소형 VLM
Apache-2.0
레이아웃·표·다국어 운영 성숙도, CPU 배포 경험 풍부
구성 요소가 많아 튜닝 포인트도 많음
MinerU
파이프라인/VLM 하이브리드
자체 라이선스(GitHub 표기 ‘Other’)
PDF→Markdown 도구 체인 완성도
의존성 무거움
olmOCR
VLM(7B) 기반 PDF 선형화
Apache-2.0
대규모 PDF 코퍼스 변환 레시피
GPU 비용, 페이지 단위
dots.ocr
단일 VLM(3B)
GitHub 자동 표기 없음 — LICENSE 직접 확인
레이아웃+인식 통합, 다국어
페이지 단위
Tesseract
전통 OCR 엔진
Apache-2.0
CPU에서 매우 빠름, 의존성 가벼움
복잡한 레이아웃·표·수식·저품질 스캔에 약함
이슈 #100의 외부 R&D 리포트가 현실적인 기준점을 준다. T4 GPU에서 단일 페이지 세 건을 비교했더니 Unlimited-OCR은 어려운 스캔에서 문자 정확도 79.36% → 99.54%로 크게 앞섰지만, 페이지당 시간은 Tesseract보다 8~19배 느렸다. 정확도가 돈이 되는 문서(계약·논문·재무제표)라면 투자할 만하고, “대충 검색만 되면 되는” 경량 인입 파이프라인이라면 과하다.
타협점과 주의 사항
주제
내용
대응
‘무제한’의 실제 의미
고정되는 것은 디코드 쪽 캐시다. 배포된 설정은 32K 위치 임베딩(max_position_embeddings 32,768)과 README 예시의 max_length=32768을 쓰므로 프리필(페이지 수 × 약 273토큰)과 출력이 이 범위 안에 있어야 한다 → 보고서 표현대로 ‘32K 안에서 수십 쪽’이 실질 상한
긴 책은 수십 쪽 단위 청크로 나누고 청크 경계에서 겹침 두기
출력 장거리 의존 포기
128토큰 밖의 출력은 다시 볼 수 없다. 긴 표의 열 머리글 반복, 앞쪽 각주 참조 같은 정보는 이미지(참조)로만 유지
표·각주가 페이지를 넘는 문서에서 후처리 검증
반복 페이지 취약
박스 스트레스 테스트에서 동일 페이지 반복 시 위치 상실 · 이슈 #107 구분자 누락
페이지 수와 <PAGE> 수 불일치 시 페이지별 재처리로 폴백
반복 루프
n-gram 프로세서가 없으면 좌표 토큰 루프. 숫자가 바뀌며 도는 루프는 정확 일치 n-gram 차단을 피해 간다(이슈 #84, #82)
모델은 trust_remote_code, SGLang은 저장소 내 사전 빌드 dev 휠(.pyc 포함, 해시 공지 없음)
HF revision 고정, 휠 해시 기록, 격리 환경에서 빌드 재현
재현성
학습 코드·데이터 비공개, 장문 평가는 사내셋, GitHub Release 없음
자체 문서로 골든셋을 만들어 편집거리·TEDS 회귀 테스트
언어 편향
학습 라벨이 PaddleOCR 기반. 히브리어 환각(#90)·아랍어 요청(#89, #95) 등 비라틴·비중국어권 이슈, 박스 한국어 테스트도 오탈자 다수
한국어 비중이 큰 조직은 도입 전 필수 검증
Transformers 경로 동시성
infer()가 공유 config를 잠시 바꾸는 구조
요청 직렬화 또는 SGLang/vLLM 사용
평가 방법: 우리 문서로 이렇게 재 보자
단계
할 일
목적
1. 골든셋
실제 업무 문서 50~200쪽을 단일·연속 묶음(2/5/10/20쪽)으로 준비하고 사람 검수 정답 확보
벤치마크 점수 대신 우리 문서 분포
2. 후처리 통일
README의 remove_det 정규식으로 det 태그 제거, 표는 HTML 그대로 TEDS 측정
도구 간 공정 비교
3. 지표
문자 편집거리, 표 TEDS, 페이지 수 대비 <PAGE> 일치율, Distinct-35(반복 감지)
보고서와 같은 축 + 운영 지표
4. 대조군
같은 문서를 페이지별 for 루프로도 돌려 품질·처리량 비교
‘한 번에’가 실제로 이득인지 확인
5. 처리량
GPU에서 출력 1K/4K/8K 토큰 구간별 TPS와 GPU 메모리 추적
R-SWA의 평탄한 TPS 주장 확인
6. 폴백 규칙
구분자 불일치·Distinct 급락·max_tokens 도달 시 페이지 단위 재처리
운영 안전망
누가 도입하면 좋은가
판단
대상
적극 검토
논문·보고서·교과서처럼 길고 서식이 다양한 문서를 대량으로 Markdown/HTML로 바꾸는 팀, GPU가 있고 페이지 경계 연결(문단·표)이 중요한 RAG 인입 파이프라인, R-SWA를 ASR·번역 같은 ‘참조 기반 장문 생성’에 응용하려는 연구 팀
조건부
한국어 비중이 큰 문서(사전 검증 필수), 양식·송장처럼 거의 같은 페이지가 반복되는 묶음(페이지 단위 폴백 필수), CPU 전용 야간 배치(1쪽 20초 수준 감수)
비추천
실시간·저지연 경량 OCR(Tesseract·PaddleOCR 경량 모델이 낫다), Apple Silicon MPS 단독 환경, 학습 코드까지 필요한 재학습 계획
정리
Unlimited-OCR의 핵심은 거창한 새 커널이 아니라 “참조는 끝까지, 출력은 128토큰만”이라는 캐시 규칙 하나다. 박스에서 CPU로 돌려 보니 그 규칙은 코드에서 정확히 지켜졌다. 캐시는 프리필 + 128에서 멈췄고, 서로 다른 8쪽 문서를 한 번에 전사해 페이지 구분자까지 맞췄다. 반면 같은 페이지가 반복되면 위치를 잃었고, 한국어는 오탈자가 눈에 띄었으며, 처리량 이득은 GPU와 긴 출력에서만 의미 있게 드러나는 성질이다. 벤치마크 1위라는 숫자보다 “for 루프를 모델 안으로 옮길 수 있는가”라는 질문을 자기 문서로 검증하는 데 쓰기 좋은 저장소다. MIT 라이선스에 3B·활성 0.5B라는 크기도 실험 비용을 낮춰 준다.