한 줄 요약: deepseek-ai/DeepGEMM은 “빠른 FP8 행렬곱 라이브러리”로 출발했지만, 지금은 DeepSeek 계열 모델 서빙에 필요한 GEMM·MoE·인덱서 어텐션·HyperConnection 커널을 한 CUDA 코드베이스로 묶은 LLM 전용 텐서코어 커널 모음에 가깝습니다. 10월 7일 GitHub Trending(전체 언어) 목록에 하루 약 199 스타로 다시 올라왔고, 직전 9월 30일 공개 릴리스(PR #462)에서 GPU 내부 메모리 지역성을 인식하는 Mega MoE와 화웨이 Ascend 포팅판 공개가 함께 나왔습니다. 이 글은 사용자가 아니라 도입을 검토하는 엔지니어 기준으로 구조, 규약, 비용, 함정을 정리합니다.
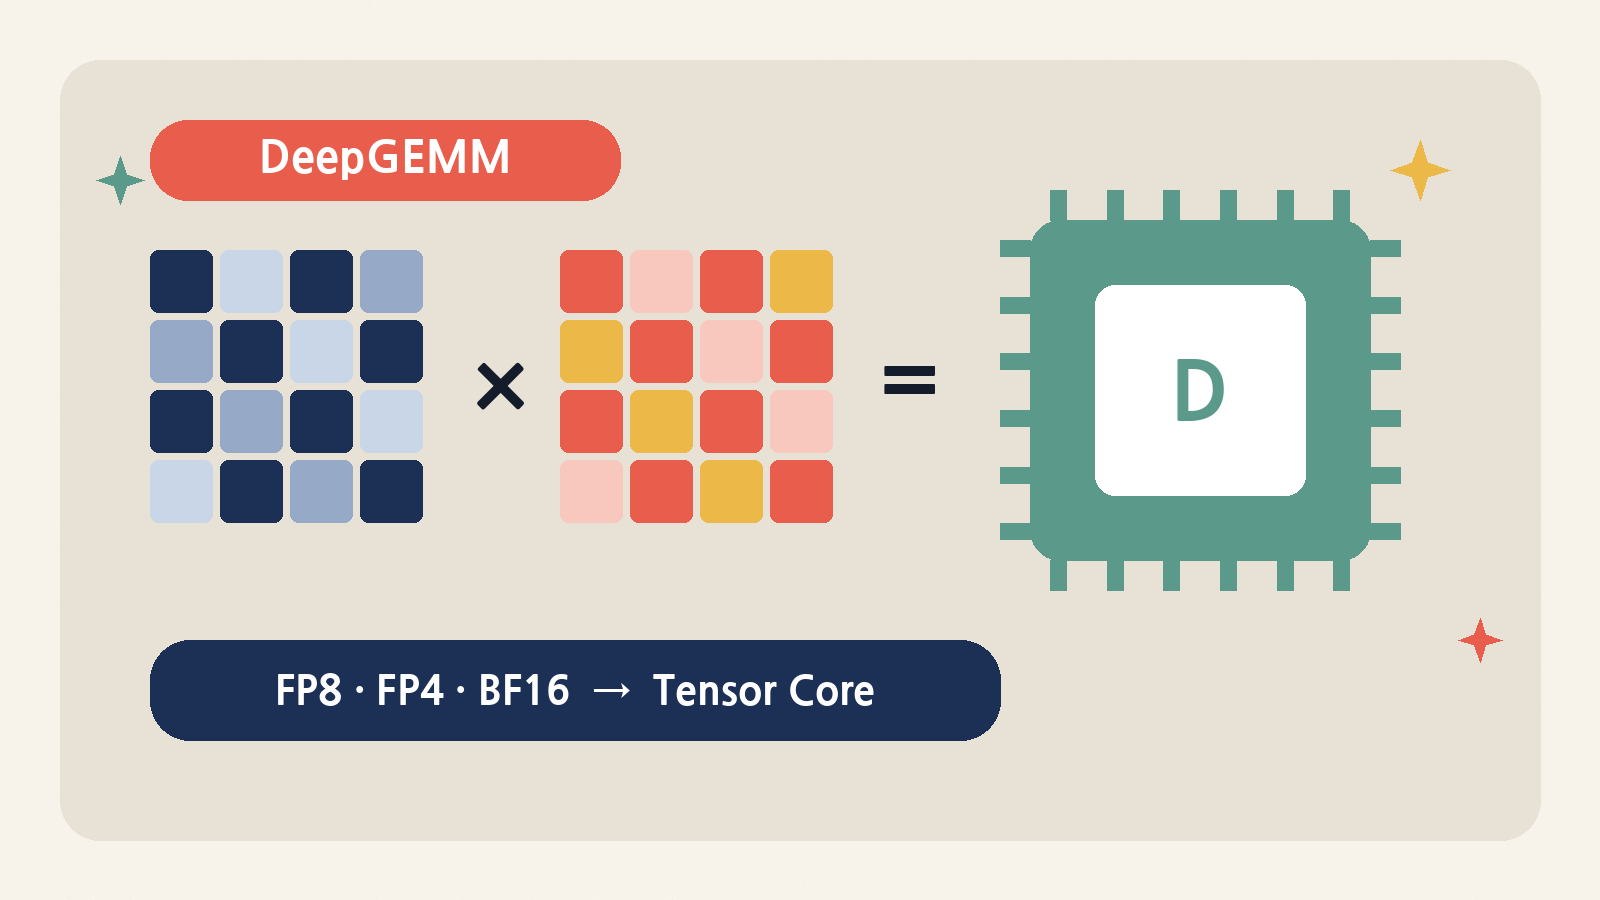
1. 지금의 DeepGEMM은 무엇인가
README의 자기소개는 “현대 LLM의 핵심 연산 프리미티브를 하나의 응집된 CUDA 코드베이스로 모은 통합 고성능 텐서코어 커널 라이브러리”입니다. CUTLASS와 CuTe의 개념은 빌려 오되 그 템플릿·대수 체계에 깊게 기대지 않고, 핵심 커널 함수 수를 제한해 읽을 수 있는 커널을 지향한다는 점이 특징입니다. 저장소 기준 csrc/와 deep_gemm/include/의 C++/CUDA 소스는 합쳐 약 2.6만 줄로, CUTLASS 전체와 비교하면 훨씬 작습니다. 라이선스는 MIT이고, 패키지 버전은 deep_gemm/__init__.py 기준 2.8.1입니다.
| 항목 | 내용 |
|---|---|
| 대상 GPU | NVIDIA SM90(Hopper), SM100(Blackwell 데이터센터). A100용은 레거시 Triton 커널로만 제공 |
| 정밀도 | FP8, FP4(FP8×FP4 혼합 포함), BF16, 일부 TF32(HC prenorm) |
| 빌드 요건 | CUDA 12.9 이상, PyTorch 2.3 이상, Python 3.8 이상, C++20 <format> 지원 컴파일러, CUTLASS 4.0 이상(서브모듈) |
| 컴파일 방식 | 설치 시 CUDA 커널 컴파일 없음. 모든 커널은 DeepJIT 서브모듈로 런타임 JIT |
| 서브모듈 | third-party/cutlass, third-party/deep_jit, third-party/tilelang_ops |
| 최근 공개 릴리스 | 2026.09.30(#462), 2026.09.10(#432), 2026.07, 2026.04.16(#304) |
2. 저장소 구조: 어디를 읽어야 하나
처음 열어 보면 디렉터리가 단순합니다. 다만 호스트 쪽 휴리스틱과 디바이스 쪽 커널이 분리돼 있다는 점을 알고 읽어야 길을 잃지 않습니다.
| 경로 | 역할 | 읽는 이유 |
|---|---|---|
csrc/apis/*.hpp |
Python에 노출되는 API(gemm, attention, mega_moe, mega_gate, hyperconnection, locality_domain 등)와 입력 검증 | shape·dtype·레이아웃 제약이 assert로 명시돼 있어 “왜 안 돌지?”의 답이 여기 있음 |
csrc/jit_kernels/heuristics/ |
shape별 블록 크기, 스테이지 수, SM 수 선택 로직 | 성능 편차의 원인 추적. DG_PRINT_CONFIGS=1과 함께 보면 좋음 |
csrc/jit_kernels/impls/ |
커널별 런타임 래퍼(템플릿 인자 생성, 런치 파라미터) | 어떤 템플릿 인스턴스가 JIT되는지 확인 |
deep_gemm/include/deep_gemm/impls/*.cuh |
실제 디바이스 커널(sm90_*, sm100_*) | TMA·WGMMA/UMMA 파이프라인 학습용으로 가장 가치 있는 부분 |
deep_gemm/include/deep_gemm/epilogue/ |
출력 저장·변환 에필로그 | 9월 30일 릴리스에서 에필로그 클래스와 BF16 확률적 반올림이 추가됨 |
deep_gemm/mega/ |
Mega MoE용 대칭 메모리 버퍼, 가중치 변환 Python 계층 | 멀티프로세스 실행 방식 이해 |
docs/scaling-factor-format.md |
스케일링 팩터 포맷 규격(약 470줄) | FP8/FP4 도입 시 가장 많이 틀리는 부분의 기준 문서 |
tests/ |
test_fp8_fp4, test_bf16, test_attention, test_mega_moe, test_mega_gate, test_mega_mhc, test_locality_domain 등 | 사실상의 사용 예제이자 벤치마크 하네스 |
흥미로운 디테일 하나: setup.py는 wheel을 만들 때 csrc와 docs를 패키지 안에 복사하는데, 주석에 “에이전트 쪽 오류 조회용”이라고 적혀 있습니다. 런타임 assert가 터졌을 때 코딩 에이전트가 설치된 패키지 안에서 바로 원인 소스를 찾게 하려는 의도로 읽힙니다. 대신 wheel 용량이 커진다는 점은 9월 릴리스 리뷰에서도 지적됐습니다.
3. 인터페이스 규약: 가장 먼저 맞춰야 할 세 가지
DeepGEMM은 “편하게 쓰는 범용 BLAS”가 아닙니다. README도 입력 전치나 FP8 캐스팅은 사용자가 앞단 커널에 직접 융합하라고 분명히 말합니다. 라이브러리가 제공하는 PyTorch 유틸은 느릴 수 있고, 최적화 대상은 GEMM 커널 자체라는 입장입니다.
- 연산 표기: 모든 GEMM은
D = C + A @ B형태이고 기본은 NT 레이아웃입니다. 즉fp8_gemm_nt는D = C + A @ B.T를 계산합니다. SM90 구현은 NT만, SM100은 NT·TN·NN·TT를 모두 지원합니다. - 스케일링 팩터: LHS 스케일은 TMA 정렬된 전치 레이아웃이어야 하고, 포맷이 아키텍처마다 다릅니다. SM90은 FP32, SM100은 UE8M0 네 개를
torch.int하나에 패킹한 형식입니다. 같은 모델 코드를 H100과 B200에서 함께 돌리려면 이 변환 경로를 따로 둬야 합니다. - 정렬: 그룹 GEMM의 contiguous 레이아웃에서는 전문가(expert)별 구간이 M 블록 크기에 정렬돼야 하며,
get_mk_alignment_for_contiguous_layout()으로 확인합니다.
그룹 GEMM 세 가지, 언제 무엇을 쓰나
| API 계열 | 그룹 축 | 적합한 단계 | 핵심 제약 |
|---|---|---|---|
m_grouped_*_contiguous |
M(토큰) | 학습 forward, 추론 prefill | N·K는 전문가 간 동일, 전문가별 토큰을 한 텐서로 이어 붙이고 M 정렬 필요 |
m_grouped_*_masked |
M(마스크) | CUDA Graph를 켠 decode | CPU가 전문가별 토큰 수를 모를 때 마스크로 유효 구간만 계산. DeepEP 저지연 커널 출력과 결합 예시 |
k_grouped_*_contiguous |
K | MoE 가중치 backward | M·N 고정. FP8 TN, FP8/FP4 NT 변형 존재 |
CUTLASS의 일반 grouped GEMM이 그룹마다 서로 다른 (M, N, K)를 허용하는 것과 달리, DeepGEMM은 “MoE 전문가는 모양이 같다”는 가정을 설계에 박아 넣었습니다. 범용성을 포기한 대가로 스케줄링이 단순해지고, 그만큼 휴리스틱을 MoE 형태에 맞춰 공격적으로 튜닝할 수 있습니다.
4. Mega MoE: 통신과 연산을 한 커널에서 겹치기
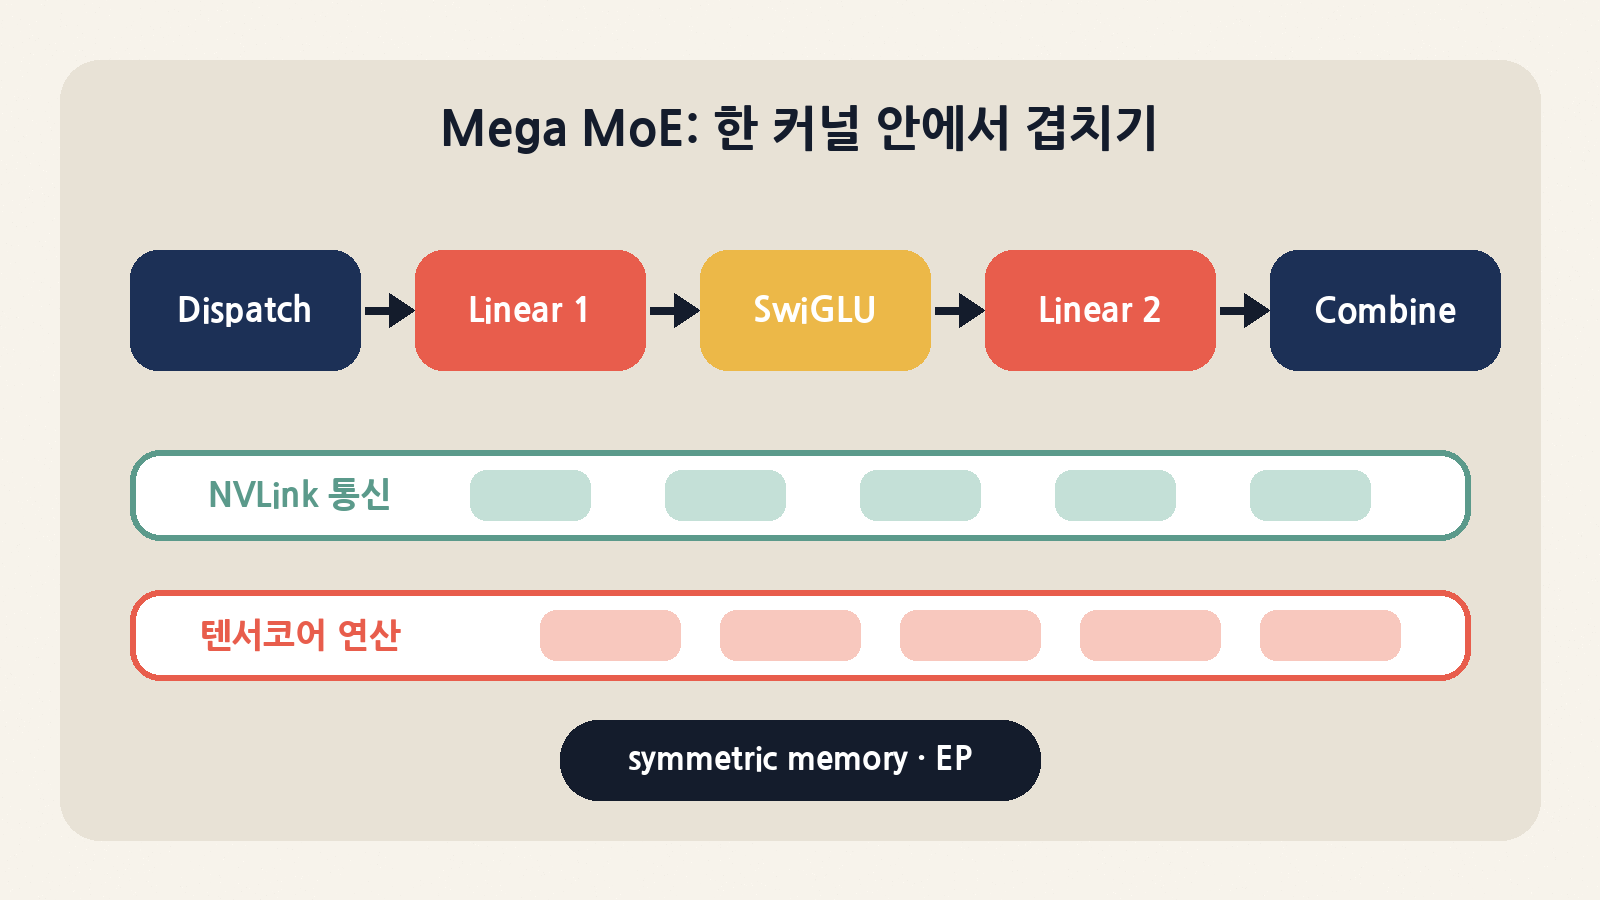
2026년 4월 릴리스에서 들어온 Mega MoE는 이 저장소의 성격을 바꾼 기능입니다. 전문가 병렬(EP) dispatch, 첫 번째 선형층, SwiGLU, 두 번째 선형층, EP combine을 하나의 메가 커널로 융합하고, NVLink 통신과 텐서코어 연산을 겹칩니다. 기존에는 DeepEP 같은 통신 라이브러리와 그룹 GEMM 커널을 번갈아 런치하면서 그 사이 동기화와 커널 경계 비용을 치러야 했는데, 이 경계를 없앤 셈입니다.
# README 예시를 요약 (PyTorch 2.9 이상, 멀티프로세스 + symmetric memory 필요)
buffer = deep_gemm.get_symm_buffer_for_mega_moe(
    group, num_experts, num_max_tokens_per_rank, num_topk,
    hidden, intermediate_hidden, mma_type='fp8xfp4')   # 'fp8xfp8'도 가능
l1, l2 = deep_gemm.transform_weights_for_mega_moe(l1_weights, l2_weights)
l1 = (deep_gemm.localize(l1[0]), l1[1])               # 9/30 신규, 선택
l2 = (deep_gemm.localize(l2[0]), l2[1])
deep_gemm.destroy_localizer()
buffer.x[:n].copy_(x_fp8); buffer.x_sf[:n].copy_(x_sf)
buffer.topk_idx[:n].copy_(topk_idx); buffer.topk_weights[:n].copy_(topk_w)
y = torch.empty((n, hidden), dtype=torch.bfloat16, device='cuda')
deep_gemm.fp8_fp4_mega_moe(y, l1, l2, buffer)
운영 관점에서 읽어야 할 포인트는 세 가지입니다. 첫째, 대칭 메모리 버퍼를 최대 토큰 수 기준으로 미리 잡습니다. 배치 상한을 보수적으로 잡으면 HBM을 낭비하고, 너무 낮게 잡으면 피크 트래픽에서 막힙니다. 둘째, 입력은 매 호출 전에 버퍼로 복사해야 하며, README는 이 복사를 앞단 커널에 융합하라고 권합니다. 셋째, 라우팅 전문가 가중치는 FP4 또는 FP8(UE8M0 스케일)이어야 하므로 체크포인트 양자화 파이프라인과 맞물려 있습니다. 벤치마크는 PR #316에서 DeepSeek-V4-Flash와 V4-Pro를 8-way EP로, 랭크당 토큰 수를 바꿔 가며 측정한 결과가 공개돼 있습니다.
9월 10일 릴리스(#432)는 같은 방향으로 더 나아갔습니다. MoE 게이트(BF16 gate GEMM과 top-k 선택, sigmoid·sqrtsoftplus·identity 지원)를 융합한 Mega Gate, HC prenorm GEMM·Sinkhorn·RMSNorm·FP8 양자화 출력을 한 번에 처리하는 Mega mHC, 그리고 paged 버전을 포함한 Sparse MQA logits가 추가됐습니다. 모델 한 층의 상당 부분이 “커널 몇 개”로 압축되는 흐름입니다.
5. DeepJIT: 설치는 가볍게, 컴파일은 첫 호출에
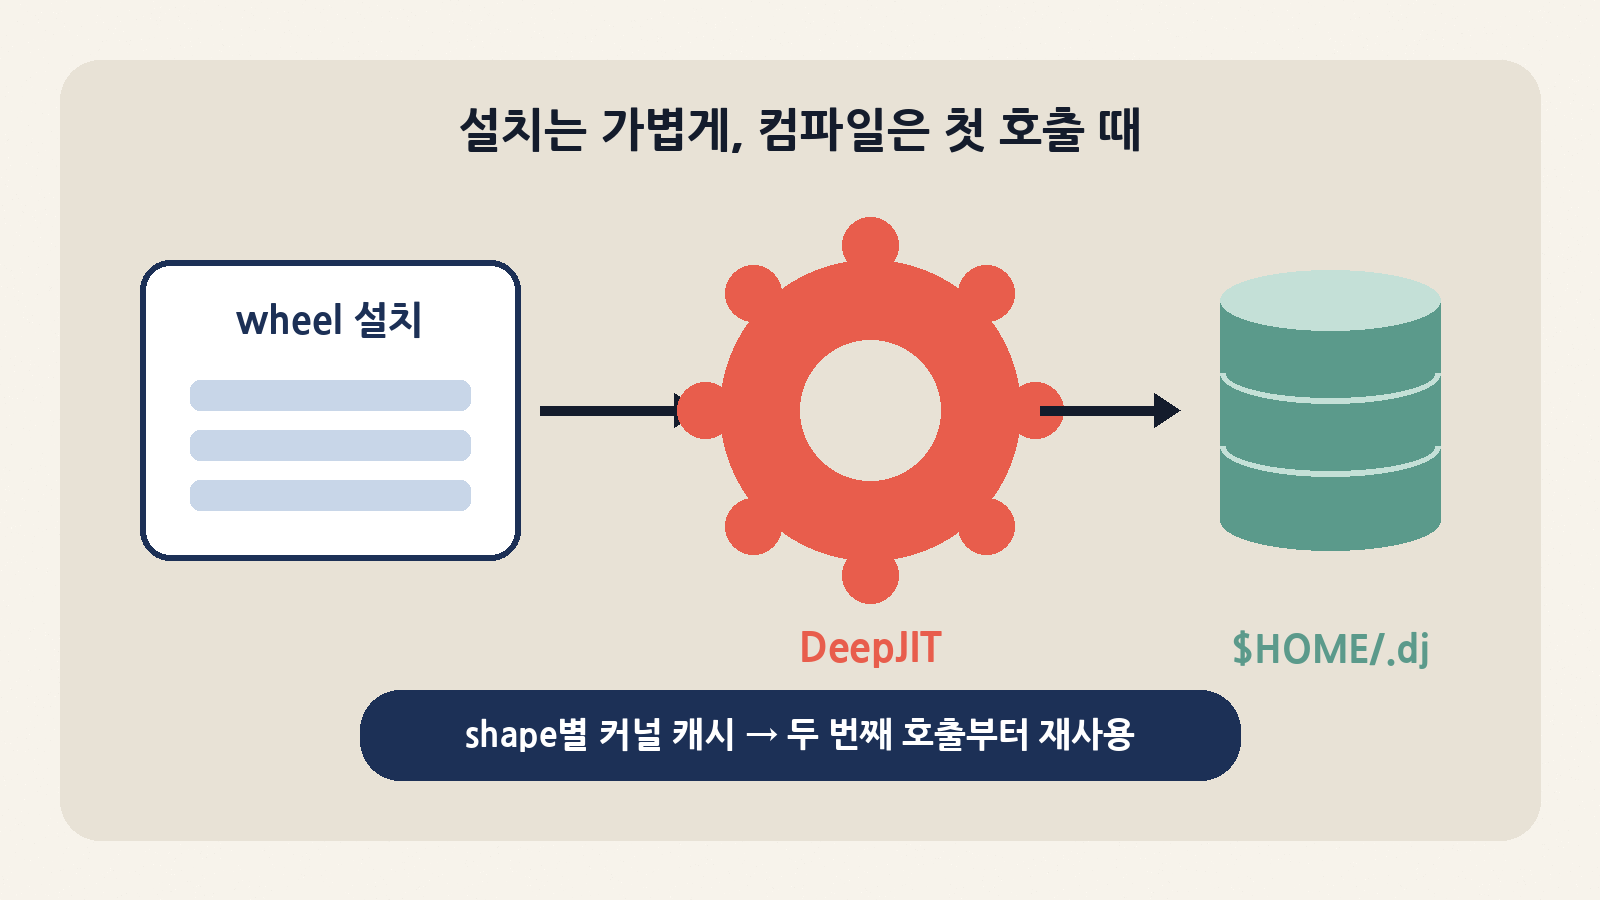
DeepGEMM은 설치 단계에서 CUDA 커널을 빌드하지 않습니다. setup.py는 CUDA 메이저 버전, PyTorch 버전, Python 버전, C++11 ABI, 플랫폼 조합으로 사전 빌드된 wheel 이름을 만들어 내려받고, 맞는 wheel이 없거나 DG_FORCE_BUILD=1이면 로컬에서 확장 모듈을 빌드합니다. 실제 커널은 shape와 설정이 정해지는 첫 호출 시점에 JIT 컴파일되어 캐시됩니다. 9월 릴리스에서는 이 JIT 계층이 별도 서브모듈 DeepJIT로 분리됐고, NVRTC와 fmt 의존성이 빠지는 대신 C++20과 CUDA 12.9가 필수가 됐습니다.
| 환경 변수 | 용도 | 실무 팁 |
|---|---|---|
DG_JIT_CACHE_DIR |
컴파일 캐시 경로(기본 $HOME/.dj). 콜론으로 여러 경로 지정 시 앞에서부터 조회, 미스는 첫 경로에 기록 |
읽기 전용 공유 캐시를 뒤에, 노드 로컬 쓰기 캐시를 앞에 두면 콜드 스타트를 줄일 수 있음 |
DG_PRINT_CONFIGS |
shape별 선택된 설정 출력 | 성능 회귀 조사 시 첫 단계 |
DG_JIT_CHECK_NO_SPILLS / DG_JIT_CHECK_NO_LOCAL_MEMORY |
레지스터 스필·로컬 메모리 사용 시 assert | 커널 수정·포크 시 CI 가드로 유용 |
DG_JIT_DUMP_PTX / DG_JIT_DUMP_SASS |
PTX·SASS 덤프 | 컴파일러 버전 차이로 성능이 흔들릴 때 비교 |
DG_COMM_KERNEL_DEBUG |
Mega MoE 호출 전 대칭 버퍼를 0으로 초기화 | 통신 버그 재현용. 운영에서는 끄기 |
DG_SKIP_CUDA_BUILD / DG_FORCE_BUILD |
설치 시 빌드 생략 / wheel 대신 강제 로컬 빌드 | 사내 미러·에어갭 환경에서 빌드 경로 통제 |
트레이드오프는 분명합니다. 설치가 빠르고 shape별로 특화된 커널을 얻는 대신, 첫 요청 지연(콜드 스타트)이 생기고 런타임 노드에 CUDA 툴킷(nvcc)이 있어야 합니다. 서빙 환경이라면 배포 직후 대표 shape로 워밍업을 돌려 캐시를 채우고, 컨테이너 이미지나 공유 볼륨에 캐시를 고정하는 절차를 넣는 게 안전합니다. 동적 배치로 M이 계속 바뀌는 경우에는 set_ignore_compile_dims로 특정 차원을 컴파일 키에서 빼서 캐시 폭발을 막을 수 있습니다.
6. 9월 30일 릴리스의 핵심: locality domain
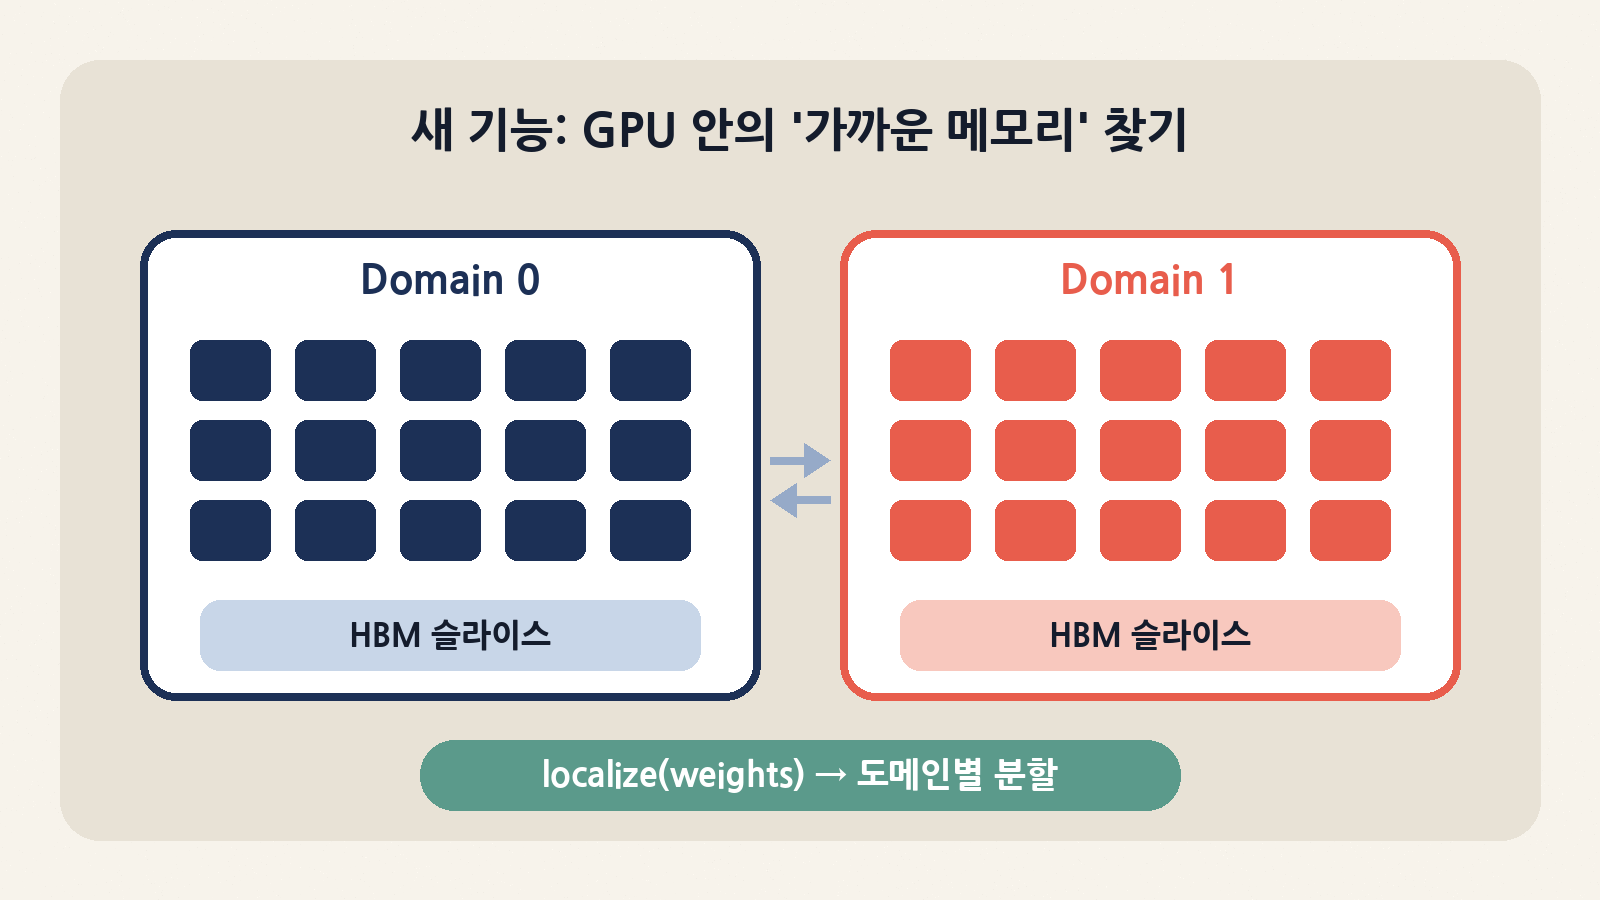
가장 최근 공개 릴리스(#462)의 커밋 메시지는 “지역성 인식 Mega MoE 실행, BF16 확률적 반올림을 지원하는 GEMM 에필로그 클래스, 더 넓은 sparse MQA 헤드 지원, 패킹된 SF stride”를 요약으로 내걸었습니다. 이 중 구조적으로 가장 새로운 것은 locality_domain입니다.
코드를 보면 개념은 이렇습니다. 하나의 GPU 안에서도 SM마다 “가까운” 메모리 영역과 “먼” 메모리 영역이 존재한다는 전제 아래, 라이브러리가 각 SM에서 포인터 체이싱 방식의 지연 시간 측정(probe)을 돌려 SM이 어느 도메인에 속하는지 알아냅니다. 먼 쪽과 가까운 쪽의 지연 비율이 1.25배 이상일 때만 의미 있는 구분으로 보고, 최대 5회 시도해도 결과가 불안정하면 균등 매핑으로 물러납니다. 같은 TPC(SM 두 개 묶음)는 같은 도메인으로 묶고, 도메인 간 SM 수를 맞추기 위해 최소한의 TPC만 옮겨 균형을 잡습니다. 그런 다음 localize()가 가중치를 N 축으로 도메인 수만큼 쪼개 각 도메인에 매핑된 메모리에 배치합니다.
| 구성 요소 | 동작 | 운영상 의미 |
|---|---|---|
| SM 도메인 탐지 | 지연 측정 기반, 불안정 시 균등 매핑 폴백 | 지역화를 못 해도 기능적으로는 정상 동작(성능 이득만 사라짐) |
| 지역화 할당기 | NVIDIA MLOPart 기반. CUDA 13.4 이전에는 IPC(파일 디스크립터 공유)를 거쳐 Python에서 할당 | 드라이버·CUDA 버전에 따라 경로가 달라지므로 is_localization_available() 확인 필수 |
localize(t, dim=-2) |
(*B, N, K)를 (도메인 수, *B, N/도메인 수, K)로 재배치 |
N이 도메인 수로 나누어떨어져야 함. 위반 시 assert |
destroy_localizer() |
할당기 종료. 이미 만든 텐서는 유효 | 가중치 로딩 후 한 번 호출하는 패턴 |
같은 날 공개된 deepseek-ai/DeepGEMM-Ascend는 저장소 설명상 “화웨이 Ascend NPU를 위한 행렬곱 커널 라이브러리”입니다. NVIDIA 전용이던 커널 설계를 다른 가속기로 옮기기 시작했다는 신호로 볼 수 있지만, 본 저장소와 API·기능이 1:1로 맞는지는 별도 검증이 필요합니다.
7. 대안과의 비교
| 기준 | DeepGEMM | CUTLASS / CuTe | cuBLASLt | Triton 커널 |
|---|---|---|---|---|
| 범위 | LLM 특화(MoE, 인덱서, HC) 소수 커널 | 범용 템플릿 프레임워크 | 범용 GEMM, 닫힌 소스 | 범용 DSL, 직접 작성 |
| MoE 그룹 GEMM | M축 그룹, contiguous·masked·K-grouped 내장 | 그룹별 서로 다른 shape 허용, 직접 조립 | 제한적 | 직접 구현 |
| 통신 융합 | Mega MoE로 EP dispatch·combine까지 단일 커널 | 없음(사용자 구현) | 없음 | 없음 |
| 지원 하드웨어 | SM90·SM100(A100은 레거시 Triton) | 폭넓음 | 폭넓음 | 폭넓음(성능 편차 큼) |
| 가독성·학습 가치 | 높음. 짧은 커널, 명시적 파이프라인 | 강력하지만 템플릿 진입 장벽 | 소스 없음 | 높음, 저수준 제어는 제한 |
| API 안정성 | 공개 릴리스마다 인터페이스 변경 잦음 | 상대적으로 안정 | 안정 | 프로젝트별 |
DeepGEMM 자체도 내부적으로 cuBLASLt GEMM(cublaslt_gemm_*, cublaslt_nvfp4_gemm_nt)을 함께 노출합니다. “전부 자체 커널”을 고집하기보다, 모양이 특수하지 않은 연산은 벤더 라이브러리에 맡기고 MoE·인덱서처럼 차별화가 큰 부분에 집중하는 실용적인 구성입니다.
8. 설치와 검증, 이렇게 시작하세요
git clone --recursive https://github.com/deepseek-ai/DeepGEMM.git
cd DeepGEMM
./install.sh            # bdist_wheel 생성 후 설치 (개발 중엔 ./develop.sh)
DG_PRINT_CONFIGS=1 python tests/test_fp8_fp4.py
python tests/test_bf16.py
python tests/test_attention.py
# Mega MoE는 멀티프로세스·대칭 메모리가 필요하니 tests/test_mega_moe.py의 실행 방식을 먼저 확인
평가 순서는 이렇게 권합니다. 먼저 자사 모델의 실제 shape 목록(전문가 수, hidden, intermediate, 배치 분포)을 뽑고, tests/의 하네스로 cuBLASLt 대비 처리량을 비교합니다. 다음으로 첫 호출 JIT 시간과 캐시 적중 후 지연을 분리해 측정합니다. 마지막으로 수치 정확도를 확인하는데, 저장소의 deep_gemm.testing에는 비트 단위 동일성 검사 도우미가 있고 use_deterministic_algorithms로 결정적 모드를 켤 수 있으니 회귀 테스트에 활용하세요. Mega MoE와 locality domain은 GPU 세대·드라이버 의존성이 크므로 프로덕션과 동일한 노드에서만 결론을 내려야 합니다.
9. 도입 전에 짚을 위험 요소
- 인터페이스 변동: 공개 릴리스가 큰 단위(9월 10일 릴리스는 115개 파일, 약 +12k/−5k 줄)로 몰아서 나옵니다. 함수 이름 별칭 정리, 게이트·어텐션 인터페이스 변경이 반복되므로 버전을 고정하고 업그레이드 시 테스트를 다시 돌려야 합니다.
- 리뷰에서 지적된 런타임 리스크: 9월 릴리스 PR에는 자동 코드 리뷰 봇이 정적·멤버 맵으로 CUDA 텐서를 쥐는 전역 상태의 스레드 안전성, 프로세스 종료 시 소멸 순서 문제,
use_fp8_dispatch하위 호환 처리 등을 지적한 기록이 남아 있습니다. 봇은 “발표를 막을 수준은 아니다”라고 판단했지만, 다중 스레드 서빙 프레임워크에 넣는다면 직접 확인할 부분입니다. - 하드웨어 편중: 새 기능 상당수가 SM100 전용입니다. H100 중심 클러스터라면 Mega Gate, Mega mHC, sparse 인덱서 같은 최신 기능의 혜택이 제한될 수 있습니다.
- 운영 의존성: 런타임 JIT 때문에 서빙 노드에 CUDA 12.9 이상 툴킷이 필요하고, 캐시 디렉터리 권한·용량 관리가 운영 항목이 됩니다.
- 책임 범위: 전치, 캐스팅, 스케일 레이아웃 변환은 사용자 몫입니다. 이 부분을 느린 유틸로 때우면 커널 이득이 상쇄됩니다.
정리: 누가 지금 볼 만한가
DeepSeek V3.2·V4 계열이나 비슷한 대형 MoE를 Hopper·Blackwell에서 직접 서빙하는 팀, 그리고 vLLM·SGLang 같은 엔진의 커널 백엔드를 다루는 엔지니어라면 지금 릴리스를 기준으로 평가해 볼 가치가 큽니다. 반대로 범용 추론 엔진을 그대로 쓰는 팀이라면 직접 통합보다 엔진 쪽 채택 여부를 따라가는 편이 비용 대비 합리적입니다. GPU 커널 최적화를 공부하려는 사람에게는 여전히 가장 읽기 좋은 실전 코드 중 하나입니다.