테크부터 경제, 생활까지. 복잡한 소식을 쉽게 풀어봅니다.
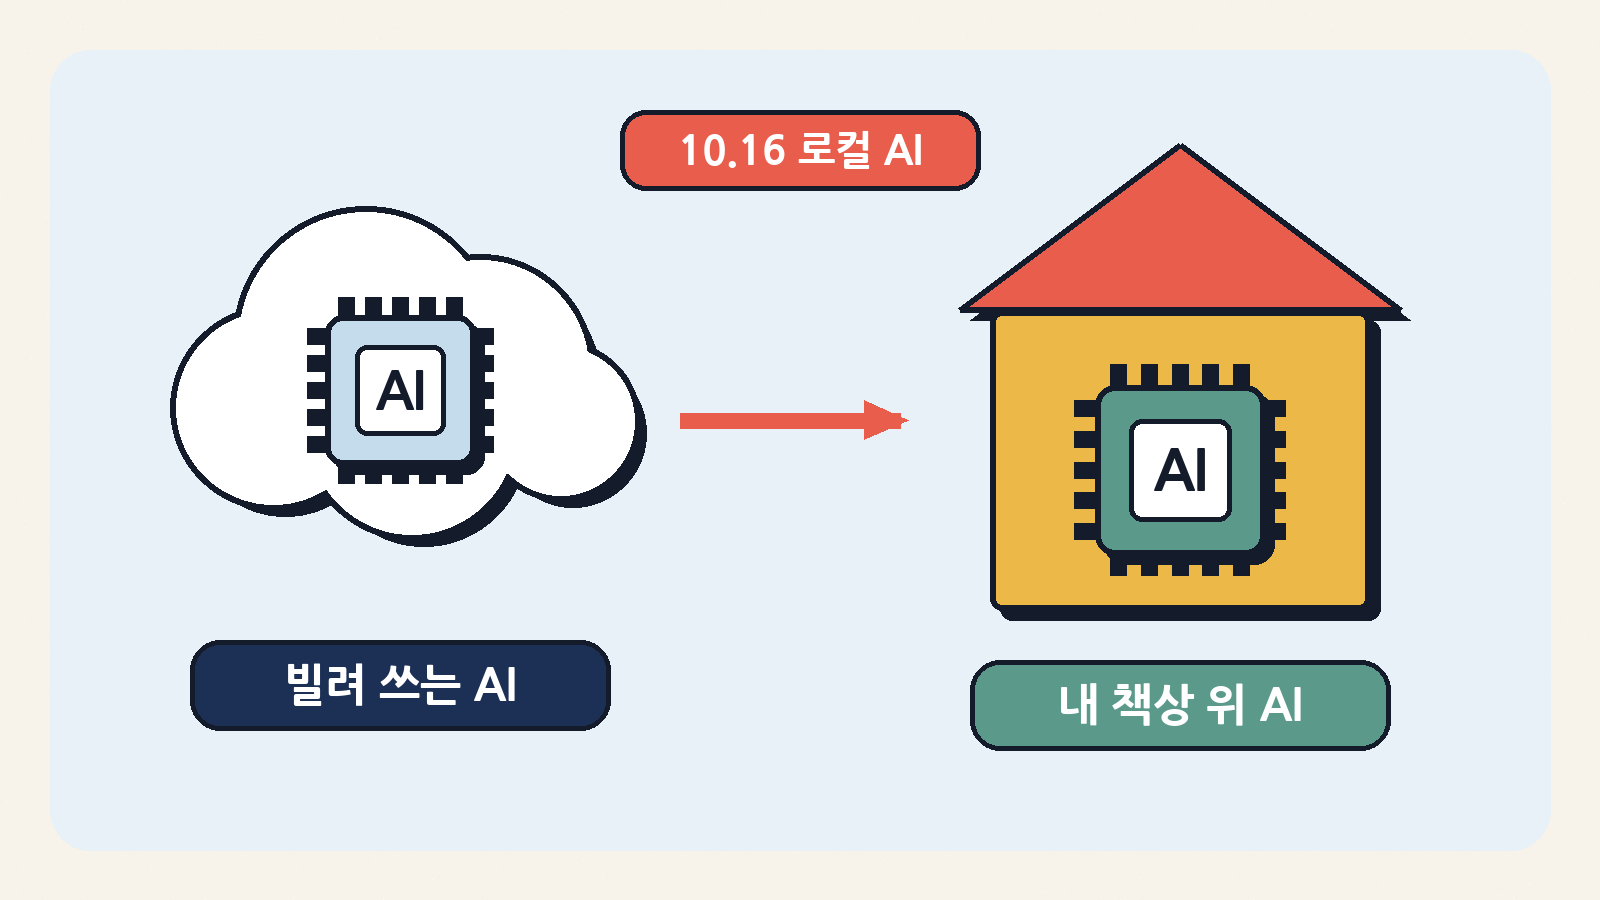
챗GPT나 제미나이에 질문하면, 사실 그 답은 내 휴대폰이 아니라 멀리 떨어진 데이터센터에서 만들어져 날아와요. 인터넷이 끊기면 못 쓰고, 많이 쓰면 “사용량 한도”에 걸리고, 내가 올린 문서도 일단 회사 서버를 한 번 거쳐 가죠. 말하자면 식당에서 사 먹는 AI예요.
그런데 2026년 10월 16일(한국 시간) 하루 동안, “이제 AI를 집 부엌에서 직접 해 먹을 수 있다”는 소식이 연달아 나왔어요. 하나는 메타가 8천억 개가 넘는 매개변수를 가진 AI ‘뮤즈 스파크 오픈(Muse Spark Open)’의 설계도(가중치)를 통째로 공개하면서 “맥 스튜디오 2대면 책상 위에서 돌릴 수 있다”고 한 것. 다른 하나는 엔비디아가 AI 전용 칩을 넣은 ‘RTX 스파크’ 노트북을 이날 전 세계에서, 그리고 한국에서도 판매하기 시작한 거예요. 오늘은 이 두 소식으로 ‘로컬 AI(내 컴퓨터 안에서 돌아가는 AI)’가 뭔지, 나한테 정말 필요한지 초보 눈높이로 풀어 볼게요.
한 줄로 먼저
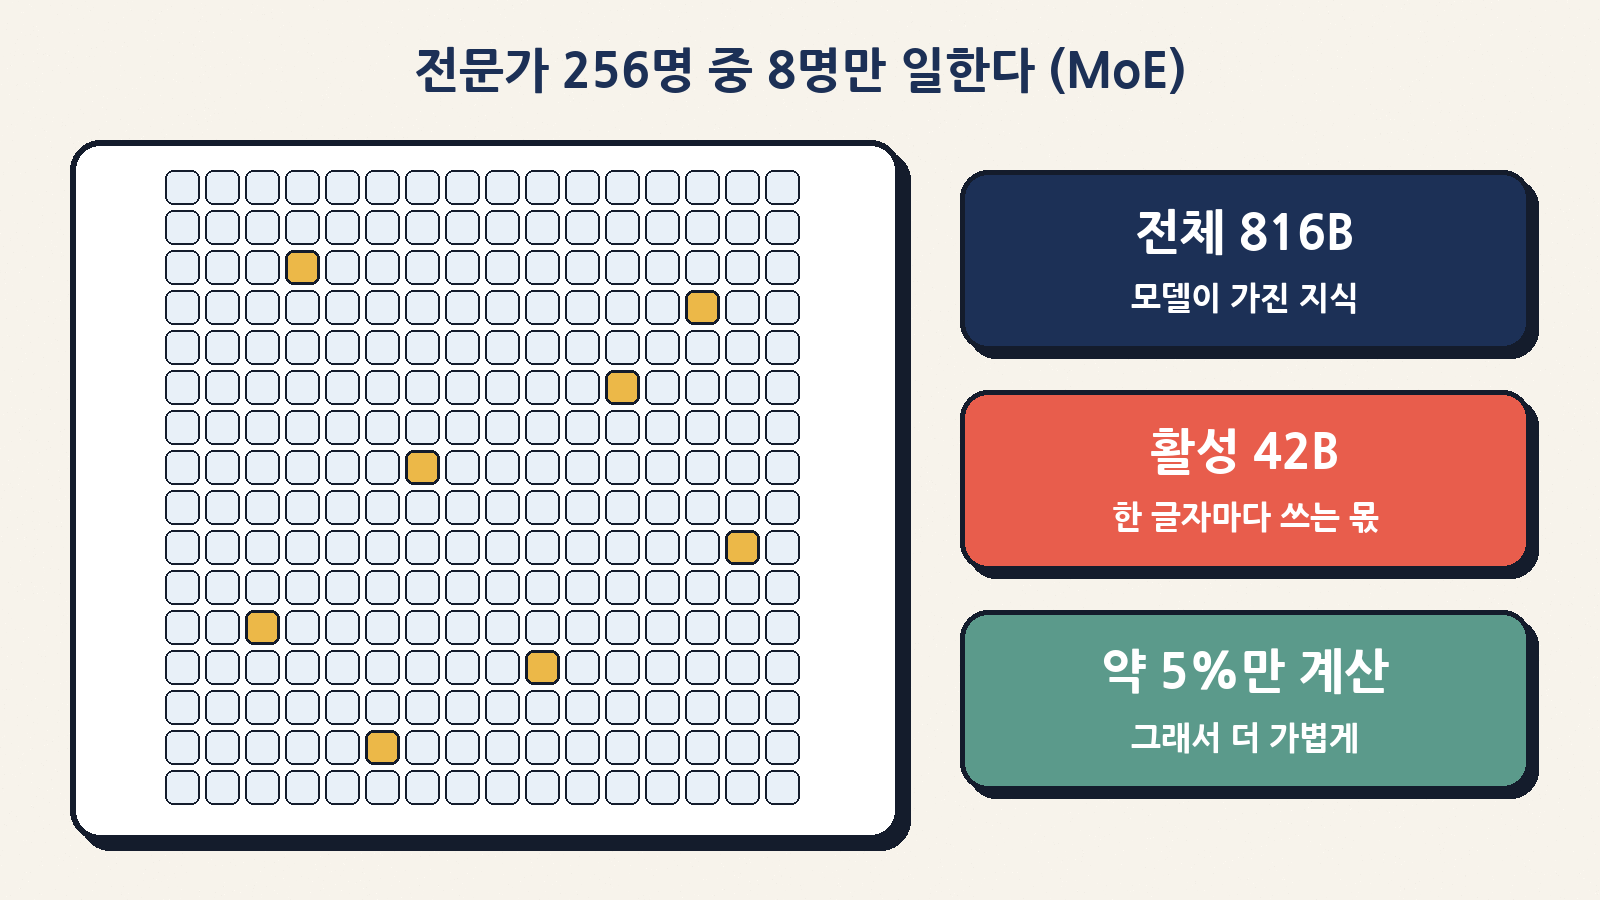
- 메타가 10월 15일(미국 시간) 뮤즈 스파크 오픈의 가중치를 공개했어요. 총 8,160억(816B) 매개변수, 글자 하나 만들 때는 그중 420억(42B)만 쓰는 구조예요.
- 메타는 애플과 협력해 이 모델을 M5 울트라 맥 스튜디오 2대(각 512GB 메모리)에서 돌릴 수 있게 했다고 밝혔어요.
- 엔비디아는 10월 16일 RTX 스파크 노트북 판매를 시작했어요. 최대 128GB 메모리로 70B급 공개 AI 모델을 노트북 안에서 돌린다는 게 핵심이에요.
- 다만 가격은 만만치 않아요. 미국 시작가 2,599달러, 국내 최저가 모델은 579만 9,000원(디일렉 보도)이에요.
- 초보에게 결론: 당장 비싼 장비를 살 필요는 없어요. 지금 쓰는 PC로 작은 모델부터 맛보고, “내 자료는 내 컴퓨터에” 원칙만 기억해도 충분해요.
한눈에 보는 10월 16일 두 소식
| 항목 | 메타 뮤즈 스파크 오픈 | 엔비디아 RTX 스파크 |
|---|---|---|
| 무엇? | AI 모델(두뇌) — 가중치 공개 | AI를 돌리는 칩(엔진)을 넣은 윈도 노트북 |
| 언제? | 미국 10월 15일 발표 (한국 16일) | 10월 16일 판매 시작 · 같은 날 서울 코엑스 출시 행사 |
| 핵심 숫자 | 총 816B · 활성 42B · 문맥 100만 토큰 | 최대 128GB 통합 메모리 · AI 성능 1페타플롭스(FP4) |
| 어디서 돌리나? | M5 울트라 맥 스튜디오 2대(512GB×2) 또는 4대(256GB×4), 대형 GPU 서버 | 노트북 한 대 (70B급 공개 모델) |
| 누가 만들었나? | 메타 슈퍼인텔리전스 랩 (애플 MLX 팀과 협력) | 엔비디아 칩 + 에이수스·델·HP·레노버·MS·MSI 노트북 |
| 값 | 다운로드 무료 (조건 있는 라이선스) | 미국 2,599달러부터 · 국내 579만 9,000원부터 |
‘로컬 AI’가 대체 뭔가요?
로컬(local)은 “내 쪽, 내 자리”라는 뜻이에요. 로컬 AI는 AI 두뇌 파일을 내 컴퓨터에 내려받아, 인터넷 서버 대신 내 기기의 칩과 메모리로 답을 만드는 방식이에요. 요리로 치면 밀키트와 레시피를 받아 집에서 해 먹는 것이죠. 재료(내 자료)가 집 밖으로 나가지 않는 대신, 부엌(컴퓨터)이 충분히 커야 해요.
| 비교 | 클라우드 AI (챗GPT 등) | 로컬 AI |
|---|---|---|
| 답을 만드는 곳 | 회사 데이터센터 | 내 PC·노트북 |
| 인터넷 | 꼭 필요 | 모델만 받아 두면 끊겨도 사용 가능 |
| 내 자료 | 서버로 전송됨 (회사 정책에 따라 처리) | 기본적으로 내 기기 안에 머묾 |
| 사용량 한도 | 요금제별 한도·대기 | 한도 없음 (대신 내 전기·내 장비) |
| 성능 | 가장 똑똑한 최신 모델 | 장비 크기에 따라 작게~크게 |
| 초기 비용 | 무료~월 구독료 | 모델은 무료가 많지만 장비가 비쌈 |
| 관리 | 알아서 업데이트 | 설치·업데이트를 내가 챙김 |
마이크로소프트 유수프 메흐디 부사장은 이번 발표에서 “AI는 필요할 땐 로컬에서, 필요할 땐 클라우드로” 돌아가는 ‘하이브리드’가 될 거라고 말했어요. 즉 둘 중 하나를 고르는 게 아니라, 상황에 따라 섞어 쓰는 시대가 온다는 뜻이에요.
뉴스가 어려운 이유: 용어 7개만 잡고 가요
| 용어 | 쉽게 말하면 | 이번 뉴스에서 |
|---|---|---|
| 가중치(Weights) | AI가 배운 내용이 담긴 두뇌 파일 | 메타가 이 파일을 내려받게 공개 |
| 오픈 웨이트(Open-weight) | 두뇌 파일을 공개하되, 사용 조건은 붙은 형태 | ‘뮤즈 모델 라이선스’ 적용 |
| 매개변수(Parameter) | 두뇌 속 연결 고리 수. 많을수록 대체로 똑똑하지만 무거움 | 816B = 8,160억 개 |
| MoE(전문가 혼합) | 여러 전문가 중 질문에 맞는 몇 명만 불러 일하는 구조 | 전문가 256명 중 8명만 활성 |
| 토큰(Token) | AI가 글을 읽고 쓰는 조각 단위(대략 글자·단어 조각) | 문맥 창 100만 토큰 |
| 통합 메모리 | CPU와 GPU가 한 그릇의 메모리를 같이 쓰는 방식 | RTX 스파크 128GB · 맥 스튜디오 512GB |
| 양자화(Quantization) | 숫자를 덜 정밀하게 줄여 파일 크기를 줄이는 압축 | NVFP4(4비트), 2비트 모델 |
소식 ① 메타 ‘뮤즈 스파크 오픈’, 뭐가 특별할까?
메타는 이 모델을 “미국에서 나온 공개 가중치 모델 중 가장 뛰어난 모델”이라고 소개했어요. 코딩과 에이전트 작업(AI가 여러 단계를 스스로 계획하고 도구를 써서 일을 끝내는 것)에 맞춰 만들었고, 글뿐 아니라 이미지·영상·오디오도 입력으로 알아듣는 멀티모달 모델이에요. 덧붙이면, 메타는 최근 공개한 최상위 모델 ‘뮤즈 원더’는 여전히 공개하지 않고 있어요. 이번 건 그보다 한 단계 아래 모델을 “누구나 받아 쓰라”고 연 거예요.
| 항목 | 내용 (메타 모델 카드 기준) |
|---|---|
| 전체 매개변수 | 8,160억 개 (816B) |
| 한 번에 쓰는 매개변수 | 420억 개 (42B) — 전체의 약 5% |
| 구조 | MoE: 전문가 256개 중 토큰마다 8개 선택 |
| 문맥 창 | 100만 토큰 (아주 긴 문서·코드도 한 번에) |
| 입력 / 출력 | 텍스트·이미지·영상·오디오 입력 → 텍스트 출력 |
| 언어 | 100개 이상 언어 데이터로 학습 (모든 언어를 평가한 건 아님) |
| 받는 곳 | 허깅페이스, 아마존·구글·마이크로소프트 클라우드 등 |
| 바로 써 보는 곳 | Together AI, Fireworks, Groq, OpenRouter 등 API 업체 |
| 나이 제한 | 모델 카드상 만 18세 미만 이용 대상 아님 |
MoE를 병원에 비유하면 쉬워요. 큰 종합병원에 전문의가 256명 있어도, 배가 아픈 환자 한 명을 진료할 때 256명이 다 모이진 않죠. 내과·영상의학과 등 필요한 8명만 와서 봐요. 그래서 병원(모델) 전체는 아주 크지만, 한 번 진료(글자 하나)에 드는 수고는 훨씬 적어요. 다만 함정이 하나 있어요. 진료엔 8명만 와도 256명 전원이 병원 안에 대기하고 있어야 하잖아요? 그래서 계산은 가벼워도 메모리(병원 건물)는 여전히 커야 해요.
성적표는 어때요? (메타가 직접 발표한 수치)
| 시험 (높을수록 좋음) | 뮤즈 스파크 오픈 | 키미 K3 (중국) | GLM 5.3 (중국) | 한마디 |
|---|---|---|---|---|
| MCP-Atlas (도구 쓰기) | 89.2 | 82.3 | 84.2 | 도구 활용은 앞섬 |
| JobBench (실무형 과제) | 61.8 | 54.3 | 61.4 | 근소하게 앞섬 |
| Terminal-Bench 2.1 (코딩) | 76.4 | 85.0 | 83.9 | 코딩은 뒤처짐 |
| Artificial Analysis 종합 지수 | 39 | 44 | 45 | 종합 점수는 중국 모델이 위 |
💡 숫자 읽는 팁
위 점수는 모두 메타가 직접 발표한 수치예요. 시험 문제와 채점 방식을 만든 쪽이 유리할 수 있으니, “에이전트·도구 쓰기는 강하고 코딩·종합 점수는 중국 최상위 공개 모델보다 약간 아래” 정도로 큰 그림만 기억하면 충분해요.
정말 ‘우리 집’에서 돌아갈까?
메타 개발자 문서를 보면, “책상 위에서 돌린다”는 말 뒤에는 꽤 높은 조건이 붙어 있어요. 일반 가정용 PC 이야기는 아니라는 점, 꼭 알아 두세요.
| 필요한 것 | 조건 |
|---|---|
| 맥으로 돌릴 때 | M5 울트라 맥 스튜디오 512GB 2대 또는 256GB 4대 (4대가 가장 빠름) |
| 연결 | 맥끼리 썬더볼트 5 케이블로 직접 연결 (쌍마다 2가닥 권장) |
| 운영체제·도구 | macOS 26.2 이상, 애플 MLX 0.30.1 이상 |
| 설치 시간 | 메타 문서 기준 약 4시간 |
| GPU 서버로 돌릴 때 | 4비트(NVFP4) 기준 그래픽 메모리 700GB 이상, 원본(BF16)은 2TB |
| 구매 시점 | 외신(맥루머스) 보도로는 512GB 맥 스튜디오 구성은 아직 판매 전, 이달 말 예정 |
왜 맥일까요? 맥 스튜디오는 CPU와 GPU가 한 그릇의 메모리를 같이 쓰는 통합 메모리 구조라, 한 대에 최대 512GB까지 AI에 쓸 수 있어요. 메타는 “두 대를 이으면 1TB 메모리를 가진 슈퍼컴퓨터 한 대처럼 동작한다”고 설명했어요. 실제로 메타는 이 조합으로 오픈소스 마스토돈 앱(Ice Cubes)의 버그를 고치고, 영상 편집 프로그램 다빈치 리졸브를 처음부터 끝까지 조작하는 시험을 했다고 밝혔어요.
공짜면 아무렇게나 써도 되나요? 라이선스 정리
| 질문 | 답 (뮤즈 모델 라이선스) |
|---|---|
| 내려받아 써도 되나요? | 네, 무료예요. 수정·미세조정·재배포·판매도 허용돼요 |
| 표시 의무가 있나요? | 네. 제품·서비스 화면이나 문서에 “Built with Muse Spark Open”을 눈에 띄게 표시해야 해요 |
| 큰 회사도 자유롭게? | 이 모델을 API 서비스로 파는 회사가 연 매출 2천만 달러를 넘으면 메타에 알리고 별도 계약이 필요해요 |
| 회사 내부용은? | 내부 업무·연구, 자사 제품 기능에 넣는 건 위 조건과 무관해요 |
| 금지된 용도 | 불법 행위, 악성코드 제작, 사기·허위정보, 무기 개발 등은 이용 정책으로 금지 |
| 만든 결과물 소유권 | 메타는 출력물에 대해 소유권을 주장하지 않아요 |
소식 ② 엔비디아 ‘RTX 스파크’ 노트북, 뭐가 다른데?
지금까지 게이밍 노트북의 그래픽카드는 전용 메모리가 작아서(보통 8~24GB) 큰 AI 모델을 통째로 올리기 어려웠어요. RTX 스파크는 CPU와 GPU를 칩 하나에 넣고 메모리를 최대 128GB까지 같이 쓰게 만든 게 핵심이에요. 엔비디아 이다 케이타 부사장은 16일 코엑스 행사에서 “토큰 사용량 제한 없는 온디바이스 AI를 안전하게 쓸 수 있다”고 말했어요.
| 항목 | 내용 |
|---|---|
| CPU | Arm 기반 20코어 그레이스 CPU (대만 미디어텍이 함께 설계) |
| GPU | 블랙웰 아키텍처, 쿠다 코어 6,144개, 5세대 텐서 코어 |
| AI 성능 | 최대 1페타플롭스 (FP4 기준) |
| 메모리 | LPDDR5X 최대 128GB, CPU·GPU 공유 |
| 소비전력 | 전체 약 80W 수준 (디일렉 보도) |
| AI로 할 수 있는 것 | 70B급 공개 모델·AI 에이전트를 노트북 안에서 실행 |
| 그 밖에 | 전원 없이 8K 영상 편집, 최대 90GB 3D 장면 렌더링, 1440p 게임 100fps 이상(엔비디아 발표) |
| 가격 | 미국 2,599달러부터 · 국내 최저가 MSI 프레스티지 N16 579만 9,000원 |
| 제조사 | RTX 스파크 노트북 (엔비디아 발표 라인업) |
|---|---|
| 에이수스(ASUS) | ProArt P14, ProArt P16 |
| 델(Dell) | XPS 16 |
| HP | OmniBook Ultra, OmniBook X 14 |
| 레노버(Lenovo) | Yoga Pro 9n |
| 마이크로소프트 | Surface Laptop Ultra |
| MSI | Prestige N16 Flip AI+, Prestige N16 |
국내 값이 미국보다 많이 비싼 이유로 엔비디아 관계자는 메모리 가격 상승을 꼽았어요. “개발할 때만 해도 128GB는 감당할 만한 가격이었는데, 메모리 값이 이렇게까지 오를 줄은 몰랐다”는 거죠. 같은 날 엔비디아는 이 노트북용으로 ‘네모트론 3.5 볼트(Nemotron 3.5 Bolt) 74B-A9B’라는 모델도 내놨어요. 전체 740억 개 중 90억 개만 쓰는 MoE 모델을 2비트로 압축해 24GB에 담았고, LM Studio·Ollama·llama.cpp 같은 무료 프로그램에서 돌릴 수 있다고 해요.
내 컴퓨터로는 어디까지? 메모리로 감 잡기
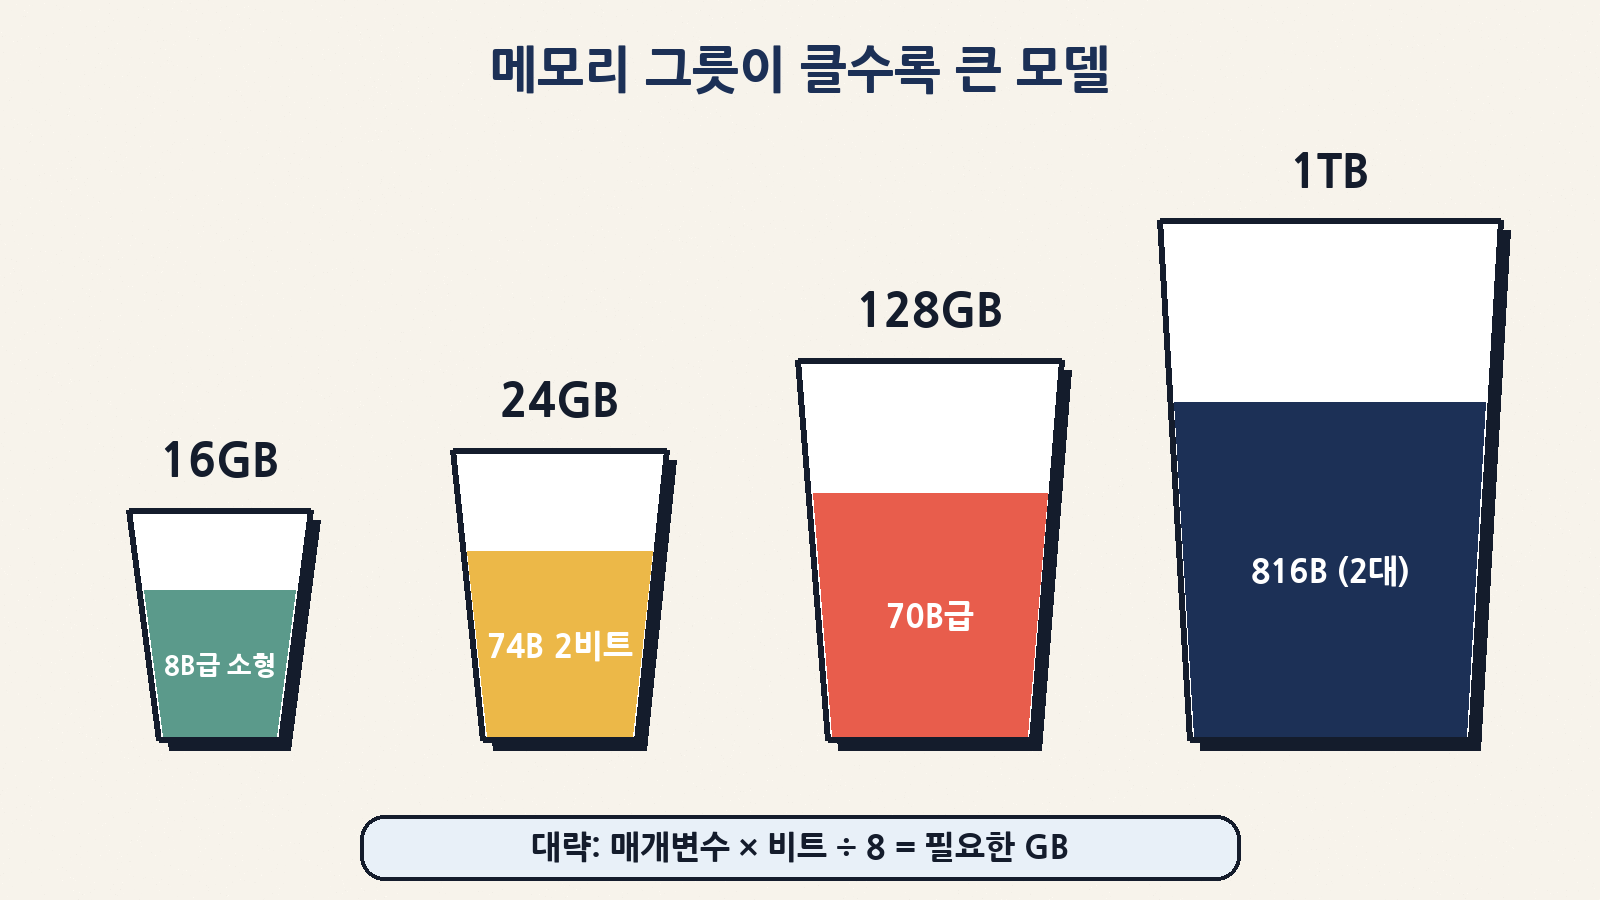
로컬 AI의 제1 법칙은 “메모리 그릇보다 큰 모델은 못 담는다”예요. 아주 대략적인 계산법은 매개변수(B) × 비트 수 ÷ 8 = 필요한 GB예요. 여기에 대화 기록(문맥)을 담을 여유 공간이 더 필요하니, 아래 숫자는 최소치로 보세요.
| 모델 예시 | 압축 | 모델만 대략 | 어울리는 장비 |
|---|---|---|---|
| 8B급 소형 모델 | 4비트 | 약 4~5GB | 메모리 16GB 일반 노트북·PC |
| 네모트론 3.5 볼트 74B | 2비트 | 약 19GB (엔비디아 패키지 24GB) | 메모리 32GB 이상, RTX 스파크 |
| 70B급 모델 | 4비트 | 약 35GB 이상 | RTX 스파크 128GB, 고용량 맥 |
| 뮤즈 스파크 오픈 816B | NVFP4(4비트) | 약 400GB+ (메타: GPU 700GB 권장) | 맥 스튜디오 512GB × 2대 이상 |
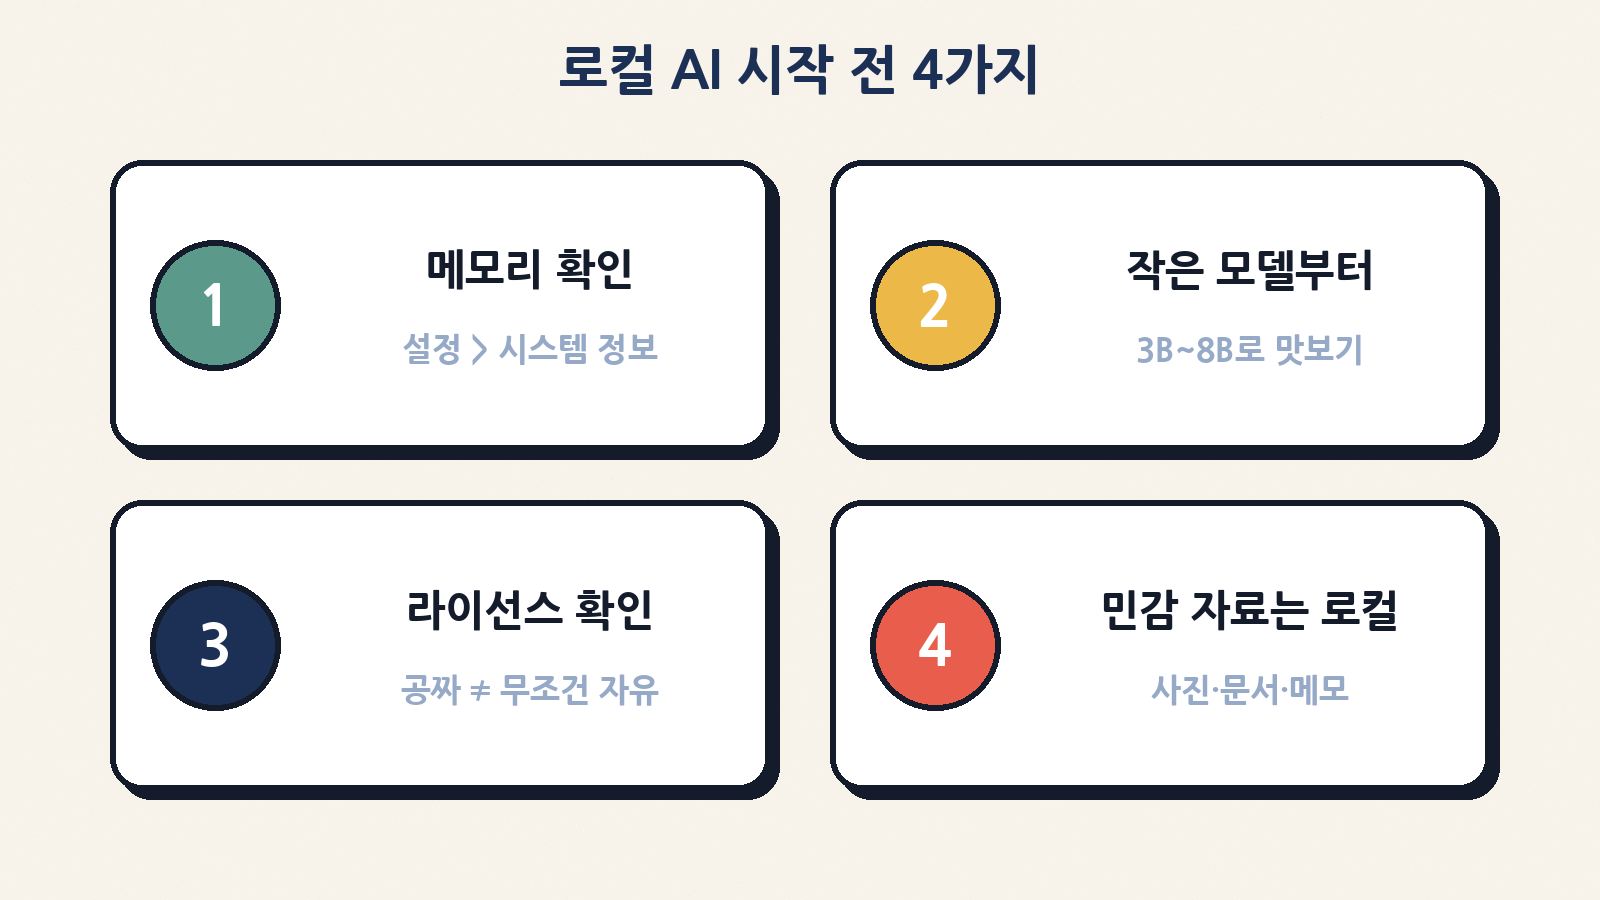
내 PC 메모리는 윈도우라면 설정 > 시스템 > 정보의 ‘설치된 RAM’, 맥이라면 애플 메뉴 > 이 Mac에 관하여에서 바로 볼 수 있어요.
그래서, 지금 사야 할까요?
| 이런 분이라면 | 판단 | 이유 |
|---|---|---|
| 챗GPT로 글 다듬기·검색 정도만 해요 | 안 사도 OK | 클라우드 AI가 더 똑똑하고 훨씬 저렴해요 |
| 회사 기밀·환자 정보처럼 밖으로 못 보내는 자료를 다뤄요 | 검토할 만 | 자료가 기기 밖으로 안 나가는 게 가장 큰 장점 |
| 개발자, AI 에이전트를 하루 종일 돌려요 | 관심 가질 만 | 사용량 한도 걱정 없이 반복 실험 가능 |
| 영상 편집·3D·게임도 같이 해요 | 고려 가능 | AI + 창작 + 게임을 한 대로 (단, 가격 확인) |
| “AI 노트북이라니 일단 최신으로!” | 잠깐 멈춤 | 580만 원대부터라, 실제 쓸 일을 먼저 적어 보기 |
오해와 진실
| 오해 | 진실 |
|---|---|
| “오픈 웨이트 = 완전 무료·무조건 자유” | 다운로드는 무료지만 표시 의무·대기업 조건·금지 용도가 있어요 |
| “로컬 AI면 해킹 걱정 끝” | 자료가 서버로 안 가는 건 장점이지만, 내 PC 보안이 뚫리면 소용없어요. 업데이트는 필수 |
| “816B 모델을 우리 집 PC로 돌릴 수 있다” | 최고 사양 맥 스튜디오 여러 대가 필요해요. 일반 PC로는 어려워요 |
| “로컬 AI가 챗GPT보다 무조건 똑똑하다” | 대체로 클라우드 최신 모델이 더 똑똑해요. 로컬은 프라이버시·한도 없음이 강점 |
| “AI 노트북 없으면 로컬 AI는 못 해 본다” | 메모리 16GB PC로도 작은 모델은 충분히 체험할 수 있어요 |
초보를 위한 ‘로컬 AI 맛보기’ 3단계
- 내 메모리 확인 — 16GB면 3B~8B급 소형 모델, 32GB 이상이면 조금 더 큰 모델에 도전해 볼 수 있어요.
- 공식 사이트에서 무료 프로그램 설치 — LM Studio나 Ollama처럼 많이 쓰는 도구를 반드시 공식 홈페이지에서 받으세요. 이름을 흉내 낸 가짜 설치 파일을 조심!
- 작은 모델로 시작 — 목록에서 크기가 작은 모델을 내려받아 “이 메모를 세 줄로 요약해 줘”처럼 간단한 일부터 시켜 보세요. 인터넷을 끄고도 답이 나오는 경험이 꽤 신기할 거예요.
⚠️ 기억해 두세요
작은 로컬 모델은 클라우드 AI보다 틀린 답을 더 자주 할 수 있어요. 건강·돈·법처럼 중요한 내용은 꼭 다시 확인하고, 모델마다 라이선스(사용 조건)가 다르니 회사 업무에 쓰기 전에는 조건을 한 번 읽어 보세요.
오늘 해 볼 4가지 체크리스트
| 순서 | 할 일 | 걸리는 시간 |
|---|---|---|
| 1 | 내 PC·노트북 메모리(RAM) 용량 확인 | 1분 |
| 2 | 로컬로 돌리고 싶은 일 적어 보기 (예: 회사 문서 요약, 사진 정리) | 3분 |
| 3 | 공식 사이트에서 무료 도구 설치 후 소형 모델 하나 실행 | 20분 |
| 4 | AI 노트북 구매를 고민 중이라면 가격·메모리·실사용 목적 세 가지를 비교 | 10분 |
마무리: ‘빌려 쓰는 AI’와 ‘내 AI’를 함께
10월 16일의 두 소식은 한 방향을 가리켜요. 최고 수준의 AI가 데이터센터에서 내 책상 위로 내려오기 시작했다는 거예요. 아직은 수백만 원짜리 노트북, 최고 사양 맥 여러 대처럼 문턱이 높지만, 몇 년 전만 해도 서버실에서나 돌던 모델이라는 걸 생각하면 속도가 정말 빨라요.
당장 지갑을 열 필요는 없어요. 오늘은 내 컴퓨터 메모리를 한 번 확인해 보고, 시간이 나면 작은 모델로 “인터넷 없이 대답하는 AI”를 체험해 보세요. 그리고 민감한 자료일수록 “내 자료는 내 컴퓨터에”라는 원칙만 기억하면, 다가오는 하이브리드 AI 시대를 훨씬 똑똑하게 쓸 수 있을 거예요. 🙂