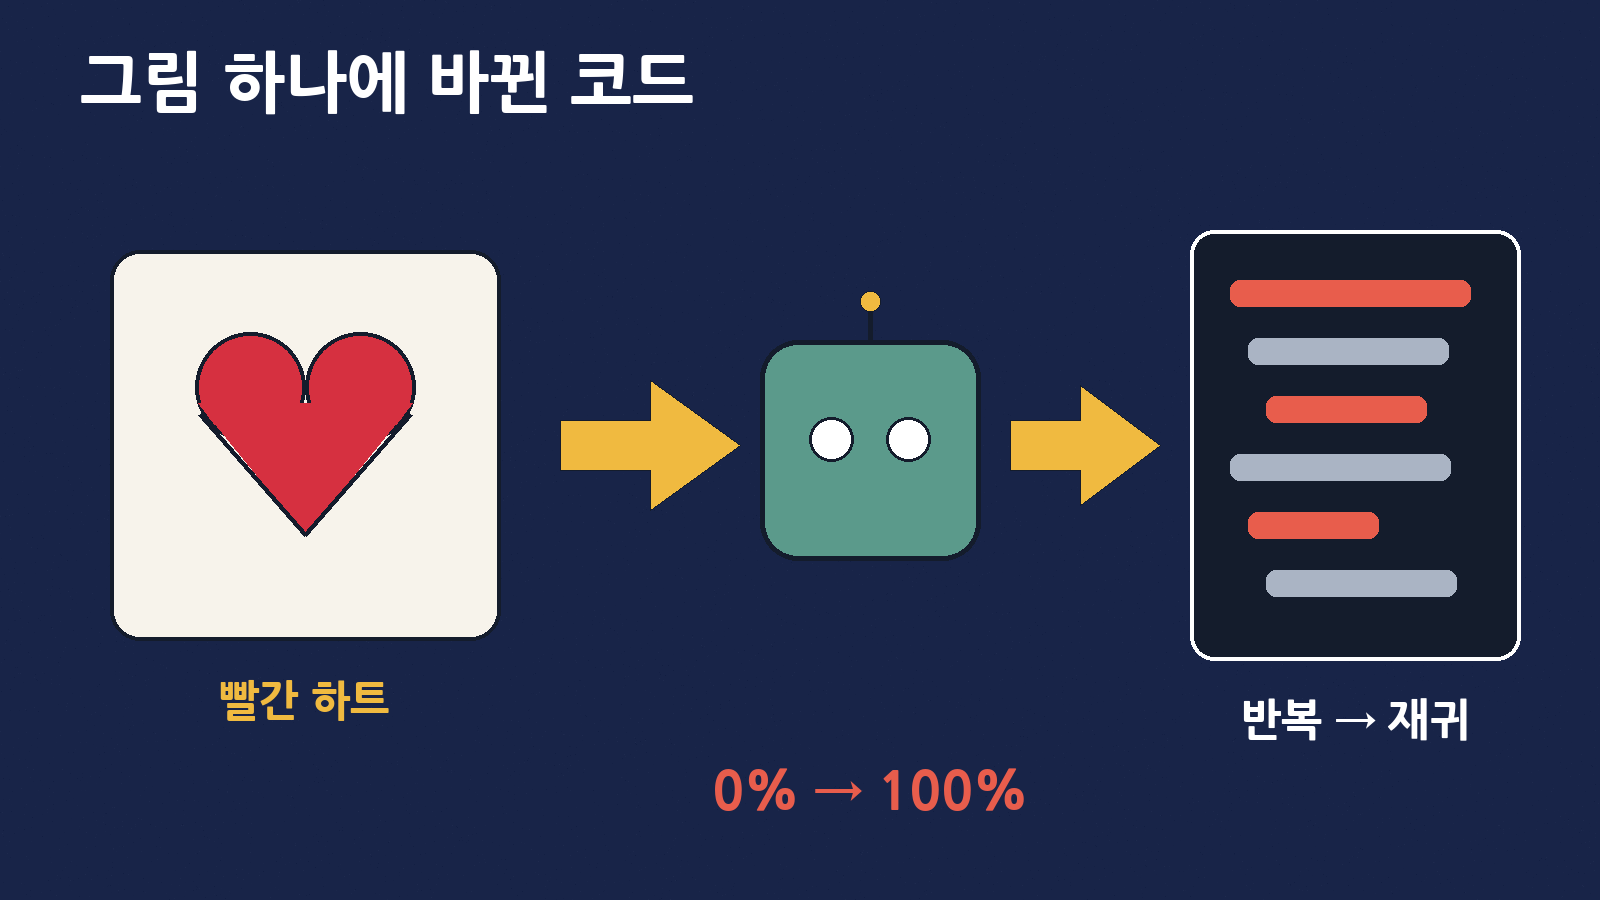
안녕하세요, 모릭월드입니다. 친구에게 “이 문제 좀 풀어 줘” 하면서 메모지 구석에 빨간 하트 스티커를 하나 붙였다고 해 볼게요. 친구가 그 하트 때문에 풀이 방법을 바꿀까요? 사람이라면 대부분 신경도 안 쓰겠죠. 그런데 요즘 가장 똑똑하다는 AI들은 달랐어요. 코딩 문제 옆에 빨간 하트 그림 하나를 붙였을 뿐인데, 코드를 짜는 방식이 통째로 바뀌었거든요.
구글 딥마인드와 스탠퍼드대학교 공동 연구진이 10월 27일(현지시간) 논문 공개 사이트 아카이브(arXiv)에 올린 ‘하트는 재귀를 의미한다(A Heart Means Recursion)’라는 논문 이야기예요. 더 놀라운 건, AI가 그림의 영향을 받아 놓고도 “그림은 상관없었어요”라고 엉뚱한 이유를 댔다는 점이에요. 사진을 올려 AI에게 물어보는 일이 흔해진 지금, 꼭 알아 두면 좋은 내용이라 처음 듣는 분도 이해할 수 있게 차근차근 풀어 볼게요.
한눈에 보는 ‘하트는 재귀’ 연구
| 항목 | 내용 |
|---|---|
| 논문 제목 | A Heart Means Recursion (하트는 재귀를 의미한다) |
| 누가 | 구글 딥마인드 + 스탠퍼드대학교 공동 연구진 |
| 언제 | 2026년 10월 27일(현지시간) arXiv 사전 공개 (정식 학회 심사 전 단계) |
| 실험 대상 | 클로드 오퍼스 4.7, GPT-5.4, 제미나이 3.1 프로 등 그림과 글을 함께 읽는 AI |
| 핵심 발견 | 단순한 도형·색깔 그림 하나가 상관없는 작업(코딩·글쓰기)의 방식을 크게 바꿈 |
| 대표 장면 | 그림 없을 때 0% → 빨간 하트 추가 시 100% ‘재귀’ 방식 선택 (클로드·GPT) |
| 또 다른 발견 | AI가 스스로 밝힌 ‘판단 이유’가 실제 영향과 자주 어긋남 |
| 한계 | 인공적으로 만든 실험 과제, 사람 대상 실험은 7명뿐인 소규모 |
먼저, 용어부터 쉽게: 시각언어모델·반복·재귀
이 연구를 이해하려면 단어 세 개만 알면 돼요. 먼저 시각언어모델(VLM)은 글뿐 아니라 사진·그림도 함께 읽는 AI예요. 챗GPT에 사진을 올리고 “이 영수증 합계 얼마야?”라고 묻는 게 바로 이 능력이죠.
다음은 코딩 용어 반복(Iteration)과 재귀(Recursion)예요. 둘 다 같은 일을 해내는 정상적인 방법인데, 접근이 달라요. 계단을 오른다고 생각해 보세요. 반복은 “한 칸 오르고, 또 한 칸 오르고…”를 끝까지 되풀이하는 방식이에요. 재귀는 “계단 오르기 = 한 칸 오르기 + (남은 계단 오르기)”처럼 일을 자기 자신에게 다시 맡기는 방식이에요. 러시아 인형 마트료시카를 열면 또 인형이 나오는 모습을 떠올리면 쉬워요.
| 용어 | 쉬운 뜻 | 생활 속 비유 |
|---|---|---|
| 시각언어모델(VLM) | 그림과 글을 함께 읽고 답하는 AI | 사진 보고 설명해 주는 친구 |
| 반복(Iteration) | 같은 동작을 정해진 만큼 되풀이하는 코드 | 계단을 한 칸씩 세며 오르기 |
| 재귀(Recursion) | 함수가 자기 자신을 다시 불러 일을 쪼개는 코드 | 열면 또 나오는 마트료시카 인형 |
| 시각 조종(visual steering) | 그림이 AI 행동을 특정 방향으로 끌고 가는 현상 | 하트 스티커 하나에 풀이법이 바뀜 |
| 추론 기록(thinking trace) | AI가 답하기 전 “생각하는 과정”을 글로 남긴 것 | 시험지 옆 연습장 풀이 |
중요한 점은, 이 실험에서 반복이든 재귀든 둘 다 정답이라는 거예요. 어느 쪽이 좋은지는 문제마다 달라요. 그래서 연구진은 “AI가 어느 쪽을 고르는가”를 일종의 ‘온도계’로 써서, 그림이 AI의 선택을 얼마나 움직이는지 잰 거예요.
실험은 이렇게 했어요
연구진은 나뭇가지처럼 갈라지는 데이터 구조(이진 트리)를 정해진 순서로 훑는 간단한 코딩 문제를 냈어요. 그리고 문제와 함께 그림을 하나 보여 주며 “이미지도 살펴보라”고 했어요. 그림 종류마다 코드를 20번씩 만들게 한 뒤, 그중 몇 번이 재귀 방식이었는지 셌어요.
| 단계 | 한 일 | 왜 이렇게 했나 |
|---|---|---|
| ① 기준 재기 | 그림 없이 문제만 주고 코드 생성 | AI의 평소 습관을 알기 위해 |
| ② 그림 붙이기 | 도형 24종 × 색 12종 = 288가지 기호를 하나씩 붙임 | 어떤 그림이 영향을 주는지 찾기 위해 |
| ③ 20번씩 반복 | 같은 조건에서 코드를 20번 생성 | 우연이 아닌 경향인지 보기 위해 |
| ④ 비교 실험 | 그림 대신 “빨간 하트 이미지”라는 글, 잡음 사진, 일반 동물 사진 등으로 바꿔 봄 | 정말 ‘그 기호’ 때문인지 확인하기 위해 |
| ⑤ 속마음 확인 | AI의 추론 기록을 모아 “그림 때문이라고 말했는지” 분석 | 말한 이유와 실제 행동이 맞는지 보기 위해 |
결과 ①: 빨간 하트 하나에 0%가 100%로
평소에는 클로드 오퍼스 4.7과 GPT-5.4 모두 재귀를 한 번도 쓰지 않고 반복 방식으로 코드를 짰어요. 제미나이 3.1 프로는 원래 40% 정도 재귀를 썼고요. 그런데 같은 문제에 빨간 하트를 붙이자 클로드와 GPT는 20번 모두, 즉 100% 재귀로 바꿨어요. 제미나이는 노란 체크 표시를 보여 주자 재귀 비율이 90%까지 올라갔어요.
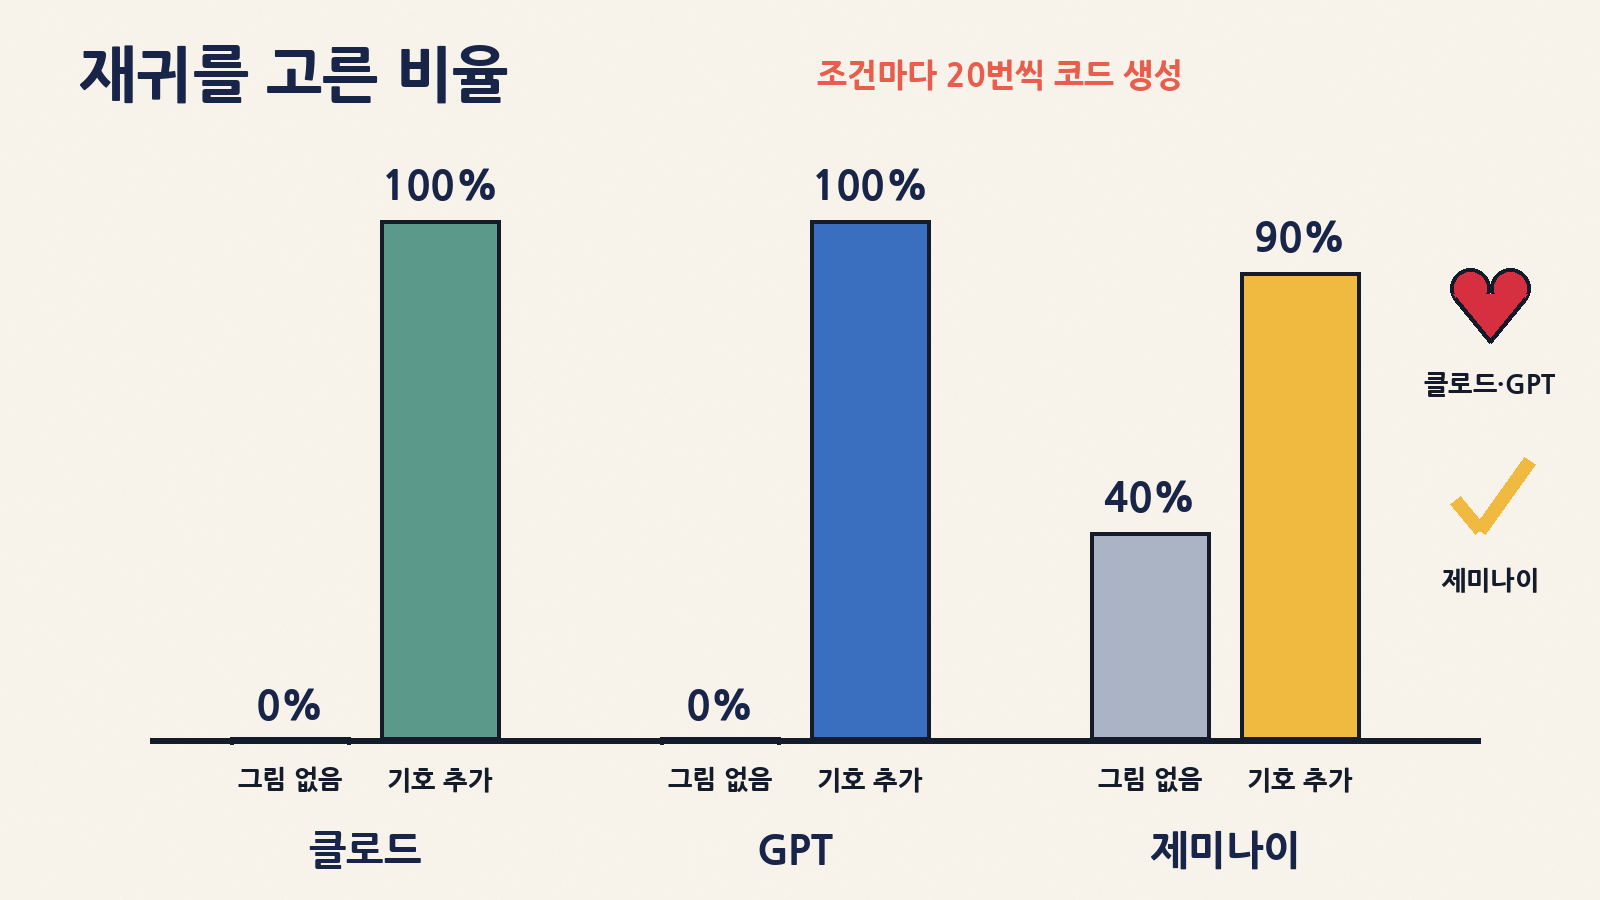
| AI 모델 | 그림 없을 때 재귀 비율 | 기호를 붙였을 때 | 가장 잘 먹힌 기호 |
|---|---|---|---|
| 클로드 오퍼스 4.7 | 0% | 100% (빨간 하트) | 삼각형·하트·원 (색과 상관없이) |
| GPT-5.4 | 0% | 100% (빨간 하트) | 하트에 특히 민감 |
| 제미나이 3.1 프로 | 40% | 90% (노란 체크 표시) | 분홍 더하기(+), 하늘색 나선 같은 특정 조합 |
연구진은 일부 기호의 효과가 아예 “재귀로 짜 줘”라고 글로 직접 지시한 것과 맞먹거나 그에 가까웠다고 설명했어요. 그림 한 장이 사실상 ‘보이지 않는 명령’처럼 작동한 셈이에요.
재밌는 건, 사람 눈에 그럴듯한 기호가 꼭 통하지는 않았다는 점이에요. 가지가 갈라지는 화살표는 사람이 보기엔 “문제를 쪼갠다 = 재귀”를 떠올리게 하는데, 클로드에게는 효과가 없었고 GPT에게도 하트보다 훨씬 약했어요. 반대로 하트와 재귀는 사람에게 아무 관련이 없어 보이죠. AI가 기호에서 읽어 내는 ‘뜻’이 사람과 다르고, 모델마다도 다르다는 거예요.
결과 ②: ‘그림이 있어서’가 아니라 ‘그 모양’ 때문
“그림이 하나 끼면 AI가 그냥 헷갈리는 거 아니야?”라는 의문이 들 수 있어요. 연구진도 그걸 확인하려고 여러 비교 실험을 했어요.
| 바꿔 본 조건 | 결과 | 뜻하는 것 |
|---|---|---|
| 그림 대신 “빨간 하트 이미지”라는 글 | 효과가 거의 재현되지 않음 | 단어의 연상 때문이 아님 |
| 무작위 잡음(노이즈) 그림 | 재귀 쪽으로의 뚜렷한 변화 없음 | 그림이 끼어서 생기는 혼란이 아님 |
| 일반 사진(동물 등) | 재귀 쪽으로의 뚜렷한 변화 없음 | 아무 그림이나 되는 게 아님 |
| 하트의 픽셀을 뒤섞어 모양을 없앰(색 비율은 유지) | 효과가 크게 줄어듦 | ‘색’보다 ‘모양’을 알아보는 게 핵심 |
| 도형을 기울이거나 뒤집음 | 효과가 크게 줄어듦 | 익숙한 방향의 모양일 때 강하게 작동 |
| 크기·위치 변경 | 행동이 더 복잡하게 바뀜 | 위치까지 ‘의미’로 받아들일 가능성 |
정리하면, AI 안에서 특정 모양의 기호가 특정 행동과 따로 이어져 있다는 신호예요. 왜 그런 연결이 생겼는지는 아직 아무도 확실히 몰라요. 연구진은 여러 회사 모델에서 겹치는 연결도 일부 보인다며, 비슷한 학습 데이터에서 함께 익혔을 가능성을 조심스럽게 언급했어요.
결과 ③: AI가 말한 이유와 진짜 이유가 달랐다
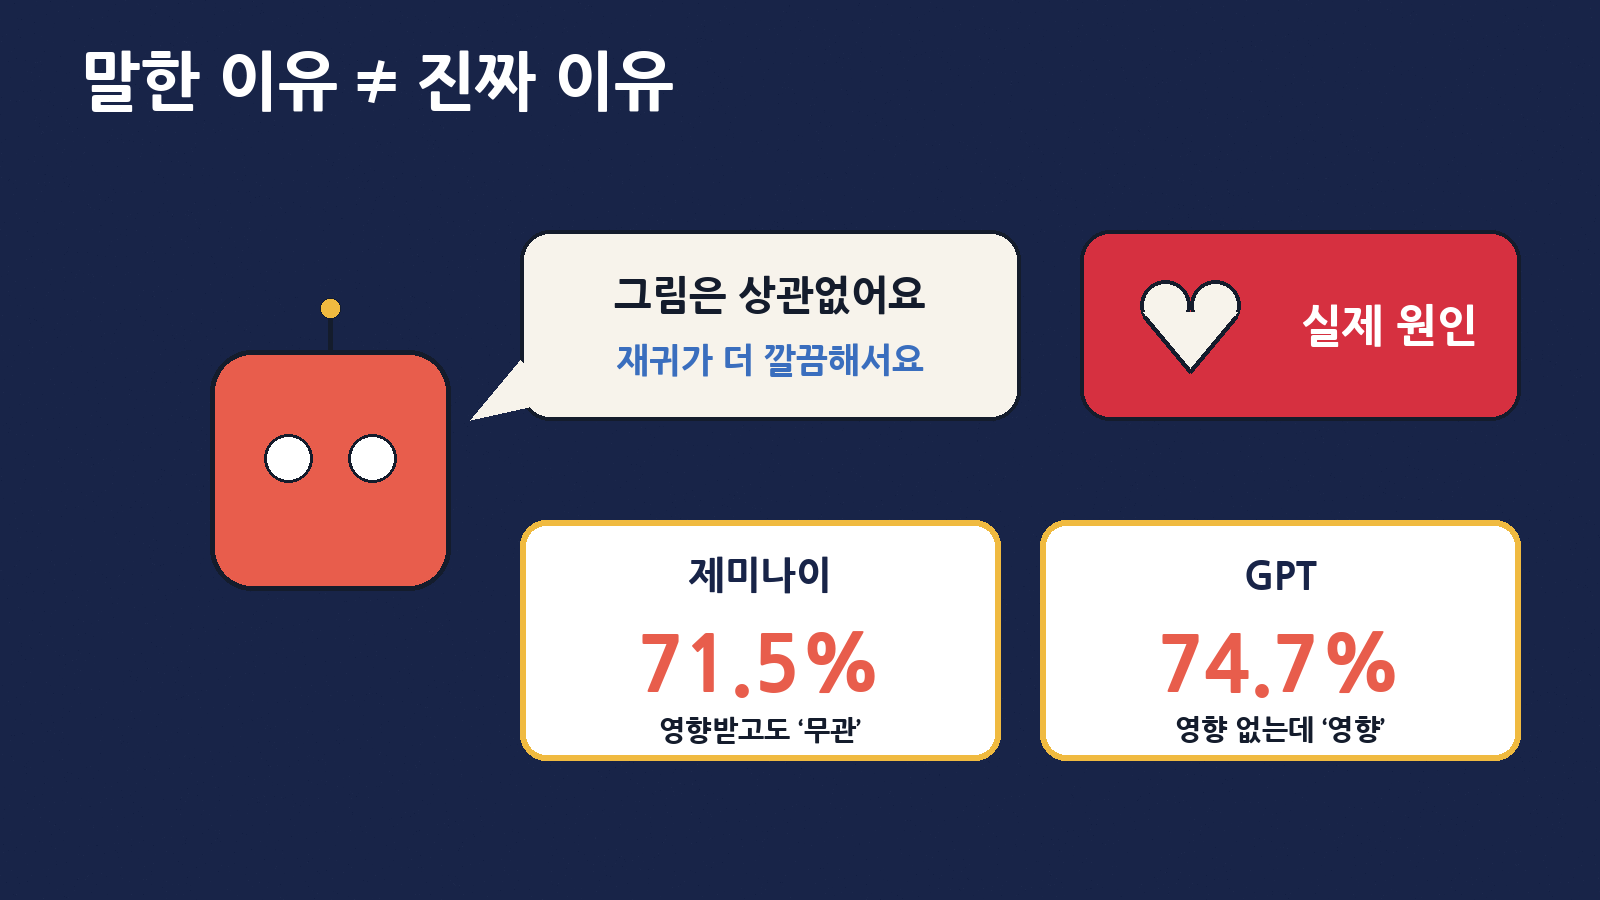
이번 연구에서 가장 곱씹어 볼 대목이에요. 요즘 AI는 답하기 전에 ‘생각하는 과정’(추론 기록)을 보여 주곤 하죠. 많은 사람이 이걸 보고 “아, 이래서 이렇게 답했구나” 하고 믿어요. 그런데 연구진이 기록을 뜯어보니 꽤 자주 어긋났어요.
| 모델 | 관찰된 어긋남 | 쉽게 말하면 |
|---|---|---|
| 제미나이 3.1 프로 | 그림이 실제로 코딩 방식을 바꾼 기록의 71.5%가 “이미지는 관련 없다”고 판단 | 영향받아 놓고 “그림 때문 아님, 재귀가 더 깔끔해서”라고 설명 |
| GPT-5.4 | 그림이 행동을 바꾸지 않은 경우에도 기록의 74.7%가 “기호가 영향을 줬다”고 설명 | 영향이 없었는데 “그림 때문”이라고 말함 |
| 클로드 오퍼스 4.7 | 이 분석에서는 추론 기록이 나오지 않아 비교 불가 | — |
방향은 정반대지만 결론은 같아요. AI가 스스로 밝힌 판단 이유가 실제로 행동을 바꾼 원인과 반드시 일치하지는 않는다는 거예요. 연구진은 “이미지를 살펴보라”는 지시 없이 대화 속에 기호만 슬쩍 넣는 실험도 했는데, 그때도 일부 기호는 코딩 방식을 크게 바꿨고 GPT-5.4는 기록에서 그 그림을 아예 언급하지 않았어요.
| 우리가 흔히 하는 생각 | 이번 연구가 보여 준 것 |
|---|---|
| AI가 “이유”를 말해 주니 믿을 만하다 | 말한 이유와 실제 원인이 다를 수 있다 |
| 상관없는 그림은 AI가 알아서 무시한다 | 상관없어 보이는 기호도 행동을 크게 바꿀 수 있다 |
| 그림 내용을 글로 써 줘도 똑같다 | 글 설명과 실제 그림의 효과는 달랐다 |
| 사람이 보기에 그럴듯한 기호가 잘 통한다 | AI에게 통하는 기호는 사람 직관과 자주 달랐다 |
코딩만이 아니었다: 글 분위기와 취향까지
같은 288가지 기호는 글쓰기와 간단한 취향 질문에도 영향을 줬어요.
- 분홍색 도형과 하트를 보여 주면 세 모델 모두 딱딱한 전문 문체 대신 시적인 문체로 글을 쓰는 쪽으로 기울었어요.
- 하트는 클로드 오퍼스 4.7이 더 긴 글을 쓰게 만들었어요.
- 파란 삼각형을 보여 주면 제미나이와 GPT가 “여름과 겨울 중 뭐가 좋아?”에 평소와 달리 겨울을 고르는 경향이 나타났어요.
분홍·하트 → 시적, 파란색 → 겨울처럼 사람이 봐도 고개가 끄덕여지는 연결도 있지만, 하트 → 재귀처럼 도무지 이유를 알 수 없는 연결도 섞여 있다는 게 이 연구의 묘한 점이에요.
AI끼리 그림으로 대화하면? 사람은 못 알아봤다
연구진은 한 AI가 그림을 그려 개념이나 이야기를 전하고, 다른 AI가 맞히는 ‘그림 전달 게임’도 해 봤어요. 결과는 이랬어요.
| 조건 | 첫 시도 성공률 | 최종 성공률·특이점 |
|---|---|---|
| 자유롭게 그림 그리기(코드로 그림 생성) | 91.2% | 여러 번 고치며 97.8%까지 성공 |
| 정해진 단순 도형만 사용 | 47.8% | 약 30.7%는 최대 5번 시도에도 실패 |
| 사람에게 AI 기호의 뜻 맞혀 보기(7명) | 약 36% | 반반 찍기(50%)보다도 낮음 |
재귀를 전하려고 AI가 고른 건 사람에게 익숙한 나선이나 화살표였지만, 정작 상대 AI의 코딩 방식을 바꾼 건 하트나 삼각형인 경우가 있었어요. AI도 자기에게 어떤 그림이 통하는지 잘 모른다는 뜻이죠. 또 AI끼리 잘 통하도록 그림을 고칠수록 사람은 그 뜻을 알아보기 더 어려워지는 경향도 보였어요. 다만 사람 실험은 7명뿐이라, 연구진도 “탐색적인 소규모 실험”이라고 선을 그었어요.
이게 왜 나와 상관있을까?
“코딩 안 하는데 나랑은 상관없겠지” 싶을 수 있어요. 하지만 요즘 AI는 우리가 올린 사진, 캡처 화면, 웹페이지 속 아이콘까지 읽어요. 화면을 보고 대신 클릭해 주는 AI 에이전트도 늘고 있고요. 연구진도 바로 이 점을 짚었어요. 그림이 많은 환경에서 일하는 AI라면 사소한 시각 요소가 판단을 흔들 수 있는데, 추론 기록만 봐서는 그 원인을 알기 어렵다는 거예요.
| 생활 속 상황 | 생길 수 있는 일 (가능성) | 차분하게 보는 법 |
|---|---|---|
| 스티커·이모지 가득한 캡처를 올려 질문 | 답의 말투나 방향이 미묘하게 달라질 수 있음 | 핵심 부분만 잘라서 올리기 |
| AI에게 웹페이지를 보고 대신 일 시키기 | 페이지의 아이콘·배너가 선택에 영향을 줄 수 있음 | 결제·전송 같은 중요한 단계는 직접 확인 |
| AI의 “이렇게 판단한 이유”를 보고 결정 | 그 설명이 실제 원인과 다를 수 있음 | 설명보다 결과물을 따로 검증 |
| 같은 질문인데 그림 유무로 답이 다름 | 이상한 게 아니라 이런 현상일 수 있음 | 그림 있을 때·없을 때 답을 비교 |
오해는 금물이에요. 이번 연구는 일부러 만든 단순한 실험 과제였고, 실제 업무 환경에서도 똑같이 나타나는지는 추가 검증이 필요하다고 연구진도 밝혔어요. 누군가 이걸로 공격을 시연한 것도 아니에요. “AI가 하트 때문에 위험하다”가 아니라, “AI는 우리가 생각지 못한 곳에서 영향을 받을 수 있고, 그걸 스스로 다 말해 주지는 않는다” 정도로 받아들이면 딱 좋아요.
이 연구, 어디까지 믿어야 할까?
| 한계 | 왜 중요한가 |
|---|---|
| 정식 심사 전 논문 | arXiv는 누구나 올릴 수 있는 사전 공개 사이트라 동료 검증이 더 필요해요 |
| 인공적인 실험 과제 | 이진 트리 탐색, 여름·겨울 고르기 등 단순 과제라 실제 업무와 다를 수 있어요 |
| 반복·재귀는 둘 다 정답 | “틀린 답을 하게 만들었다”가 아니라 “방식을 바꿨다”는 결과예요 |
| 사람 실험 7명 | 사람과 AI의 그림 해석 차이를 단정하기엔 규모가 작아요 |
| 원인은 아직 미해결 | 왜 하트가 재귀로 이어지는지는 앞으로 AI 내부를 들여다봐야 알 수 있어요 |
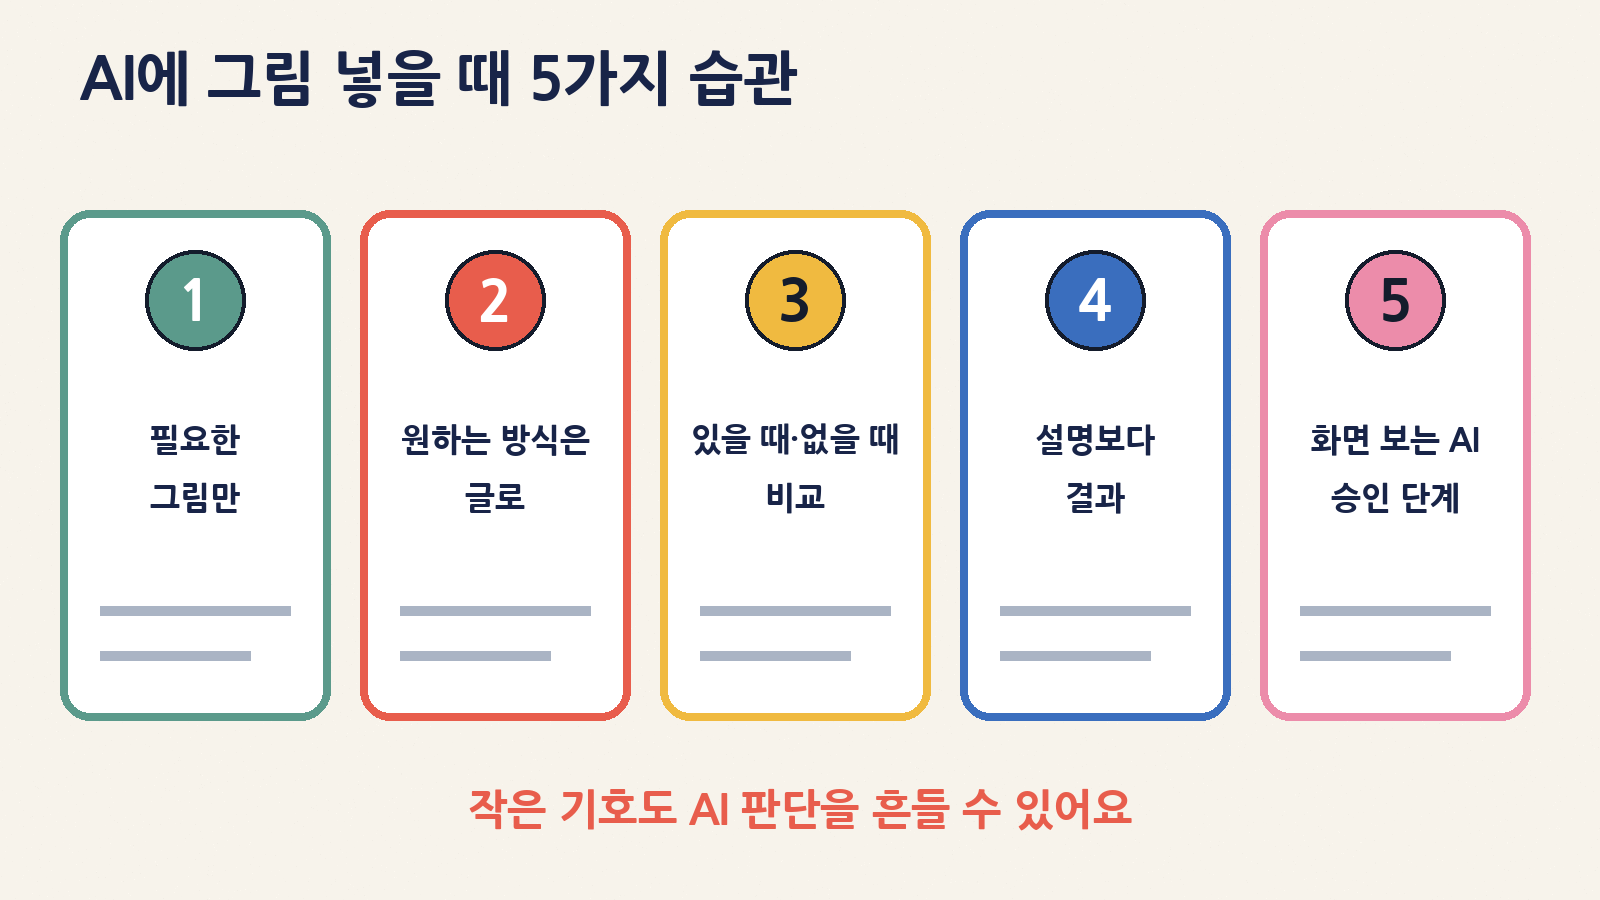
AI에 그림·사진 넣을 때 5가지 습관
연구 결과를 바탕으로, 우리가 챗GPT·제미나이·클로드를 쓸 때 바로 적용할 수 있는 습관을 정리했어요. (연구진의 권고가 아니라 모릭월드가 정리한 실천 팁이에요.)
| 습관 | 이렇게 하지 말고 | 이렇게 해 보세요 |
|---|---|---|
| ① 필요한 그림만 넣기 | 스티커·이모지 가득한 화면을 통째로 캡처 | 질문에 필요한 부분만 잘라서 올리기 |
| ② 원하는 방식은 글로 분명히 | “알아서 잘 해 줘” + 그림 | “표로 정리해 줘”, “존댓말로 짧게”처럼 직접 지정 |
| ③ 있을 때·없을 때 비교 | 그림 넣은 답 하나만 보고 결정 | 중요한 질문은 그림을 빼고 한 번 더 물어 비교 |
| ④ 설명보다 결과로 확인 | AI의 “이래서 이렇게 했어요”를 그대로 믿기 | 숫자·사실·코드 실행 결과를 따로 검증 |
| ⑤ 화면 보는 AI엔 승인 단계 | AI 에이전트에게 결제·전송까지 맡기기 | 중요한 클릭 직전엔 사람이 직접 확인 |
특히 ②번이 중요해요. 연구에서도 “재귀로 짜 줘”라는 직접 지시는 그림만큼, 혹은 그 이상으로 강한 효과를 냈어요. 원하는 게 있으면 그림이 대신 말하게 두지 말고, 글로 분명하게 말하는 것이 가장 확실한 방법이에요.
자주 묻는 질문
| 질문 | 짧은 답 |
|---|---|
| 하트 이모지를 쓰면 AI 답이 이상해지나요? | 이번 실험은 ‘그림(이미지)’으로 한 거예요. 글로 쓴 설명은 효과가 거의 없었고, 이모지 글자에 대한 실험 결과는 기사에 나오지 않았어요. |
| AI가 일부러 거짓말을 한 건가요? | 그렇게 보긴 어려워요. 자기에게 무엇이 영향을 줬는지 스스로 정확히 모르는 것에 가까워요. |
| 어느 AI가 제일 안전한가요? | 모델마다 반응하는 기호가 달랐을 뿐, 순위를 매긴 연구가 아니에요. |
| 그럼 사진 올려서 묻는 건 피해야 하나요? | 아니에요. 필요한 사진은 오히려 큰 도움이 돼요. 불필요한 그림을 줄이고 결과를 확인하는 습관이면 충분해요. |
정리하며
빨간 하트 그림 하나에 AI의 코드가 바뀌었다는 이야기는 웃기면서도 생각할 거리를 줘요. AI는 우리가 의식하지 못한 작은 기호에도 흔들릴 수 있고, 그 이유를 스스로 정확히 말해 주지 못할 수 있다는 거예요. 그렇다고 겁먹을 필요는 없어요. 필요한 그림만 넣고, 원하는 건 글로 분명히 말하고, AI의 설명보다 결과물을 확인하는 습관만 있으면 충분해요. 오늘 AI에게 사진을 올릴 때, 질문에 꼭 필요한 부분만 잘라서 올려 보세요.