2026년 11월 9일(월, Asia/Seoul) 오전 11시 48분 기준 GitHub Trending Python 일간 목록 11위에 SWE-agent/mini-swe-agent가 올라와 있습니다. 해당 페이지 기준 오늘 붙은 스타는 +86입니다. 같은 시각 GitHub API 기준 스타 9,424, forks 1,298, open_issues_count 140(이슈와 PR 합계)이고, 라이선스는 MIT(Copyright 2025 Kilian A. Lieret, Carlos E. Jimenez)입니다. 저장소는 2025-06-28에 만들어졌습니다.
최신 릴리스이자 PyPI 최신 버전은 v2.4.6(GitHub 릴리스 2026-07-23 12:12 KST, requires_python >=3.10)입니다. 이 글에서 읽은 기본 브랜치 HEAD는 04d809ce(2026-09-03 14:05 KST, ProgramBench 프롬프트 수정 병합)이고, git describe 결과는 v2.4.6-3-g04d809ce입니다. 릴리스 이후 커밋이 3개 더 있지만 패키지 버전은 그대로 2.4.6입니다.
SWE-bench와 SWE-agent를 만든 프린스턴·스탠퍼드 팀이 “에이전트를 100배 단순하게 만들어도 거의 같은 성능이 나올까”라는 질문으로 만든 프로젝트입니다. 도구는 bash 하나, 실행은 명령마다 새 subprocess, 히스토리는 append만 하는 메시지 리스트입니다. README는 SWE-bench Verified에서 74%가 넘는 점수를 낸다고 적고 있습니다. 이 수치는 모델에 따라 달라지는 값이며, 이 글에서 재현하지는 않았습니다. 대신 박스에서 테스트 스위트와 결정적(deterministic) 모델로 에이전트 루프 전체를 돌려 동작을 확인했습니다.
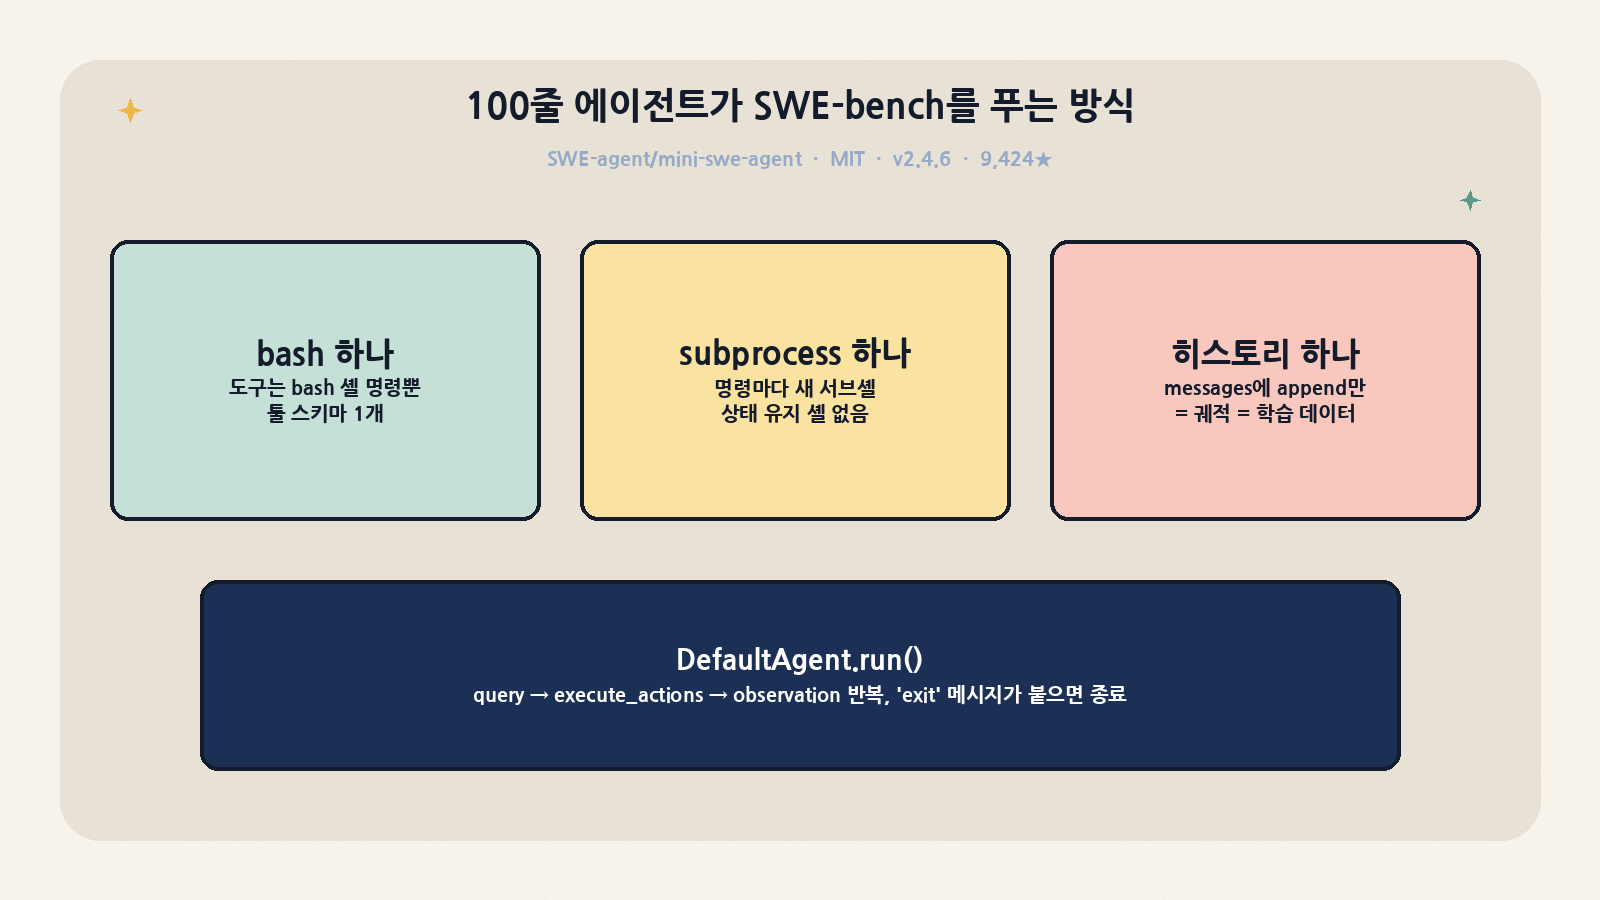
한눈에 보는 핵심 사실
| 항목 | 값 (이 글에서 확인) |
|---|---|
| 저장소 | SWE-agent/mini-swe-agent (홈페이지 mini-swe-agent.com) |
| 버전 | v2.4.6 (PyPI·GitHub 릴리스). 읽은 HEAD 04d809ce = v2.4.6 + 3커밋 |
| 라이선스 | MIT |
| 스타 / 포크 | 9,424 / 1,298 (2026-11-09 11:49 KST, GitHub API) |
| 오늘의 트렌딩 | Python 일간 11위, +86★ (11:48 KST) |
| 언어·런타임 | Python ≥3.10. 박스 검증은 Python 3.13.5 |
| 핵심 의존성 | litellm, pydantic≥2, jinja2, typer, rich, textual, prompt_toolkit, datasets, openai, tenacity |
| 선택 extras | [dev], [modal](modal·boto3), [contree], [full](swe-rex 포함) |
| CLI | mini(로컬 대화형), mini-extra(config · inspect · swebench · swebench-single · programbench) |
| 궤적 포맷 | trajectory_format: mini-swe-agent-1.1 JSON |
무엇이고, 왜 지금 다시 뜨나
mini-swe-agent는 “코딩 에이전트 스캐폴드”를 거의 지워 버린 실험입니다. 2024년의 SWE-agent는 파일 뷰어, 편집기, 검색 같은 에이전트 전용 도구(ACI)를 공들여 설계했습니다. mini는 반대로 갑니다. 모델이 충분히 강해졌으니 cat, grep, sed -i, python -m pytest 같은 평범한 셸 명령만 주고, 나머지는 모델에게 맡깁니다.
README 상단 공지가 지금의 위치를 보여 줍니다. Ramp의 SWE-Bench가 mini를 하네스로 쓰고, Datacurve의 DeepSWE 평가에서 Claude Code와 Codex보다 높게 나왔다는 링크, 그리고 새 벤치마크 ProgramBench 실행 경로(mini-extra programbench)가 걸려 있습니다. 이런 비교 결과는 각 외부 블로그의 주장이고 여기서 검증하지 않았습니다. 다만 “모델 비교용 기준 스캐폴드”라는 역할은 코드 구조에서 그대로 확인됩니다. SWE-bench 공식 리더보드의 bash only 부문이 이 에이전트로 여러 LM을 같은 조건에서 비교한다는 설명도 README에 있습니다.
이번 주 트렌딩은 스킬 카탈로그, 컨텍스트 압축 프록시, 멀티 에이전트 런타임처럼 스캐폴드를 두껍게 만드는 쪽이 주류였습니다. mini는 그 반대편에서 “얇은 스캐폴드가 어디까지 버티는가”를 보여 주는 기준점이라, 비교 대상으로 다시 불려 나오는 흐름으로 읽힙니다.
저장소 구조
소스는 src/minisweagent/ 아래 Python 5,349줄(박스에서 wc -l)입니다. 이 가운데 실제 에이전트 루프는 agents/default.py 한 파일, 190줄(공백·주석·독스트링 구분선 제외 약 153줄)입니다. README의 “some 100 lines”는 이 핵심 클래스를 가리키는 표현이고, 실제 파일은 그보다 조금 깁니다.
| 경로 | 줄 수 | 역할 |
|---|---|---|
agents/default.py |
190 | DefaultAgent, AgentConfig. run/step/query/execute_actions/serialize/save |
agents/interactive.py |
209 | human / confirm / yolo 모드, whitelist_actions, confirm_exit |
environments/local.py |
92 | Popen(shell=True) + 타임아웃 시 프로세스 그룹 SIGKILL, 제출 감지 |
environments/docker.py |
161 | 컨테이너 1개를 띄워 두고 docker exec. MSWEA_DOCKER_EXECUTABLE로 podman 지정 |
environments/singularity.py, extra/bubblewrap.py, extra/contree.py, extra/swerex_*.py |
80–151 | HPC·샌드박스·원격 실행 백엔드 |
models/litellm_model.py |
164 | 기본 모델 클래스. 네이티브 tool calling으로 bash 도구 1개 |
models/litellm_textbased_model.py |
48 | 정규식 ```mswea_bash_command 블록에서 명령 추출(레거시 방식) |
models/test_models.py |
269 | DeterministicModel 등 결정적 모델. 테스트·재현에 사용 |
run/mini.py, run/hello_world.py |
109 / 42 | CLI 진입점과 최소 예제 |
run/benchmarks/swebench.py, programbench.py |
275 / 193 | 배치 실행, preds.json 기록 |
run/utilities/inspector.py |
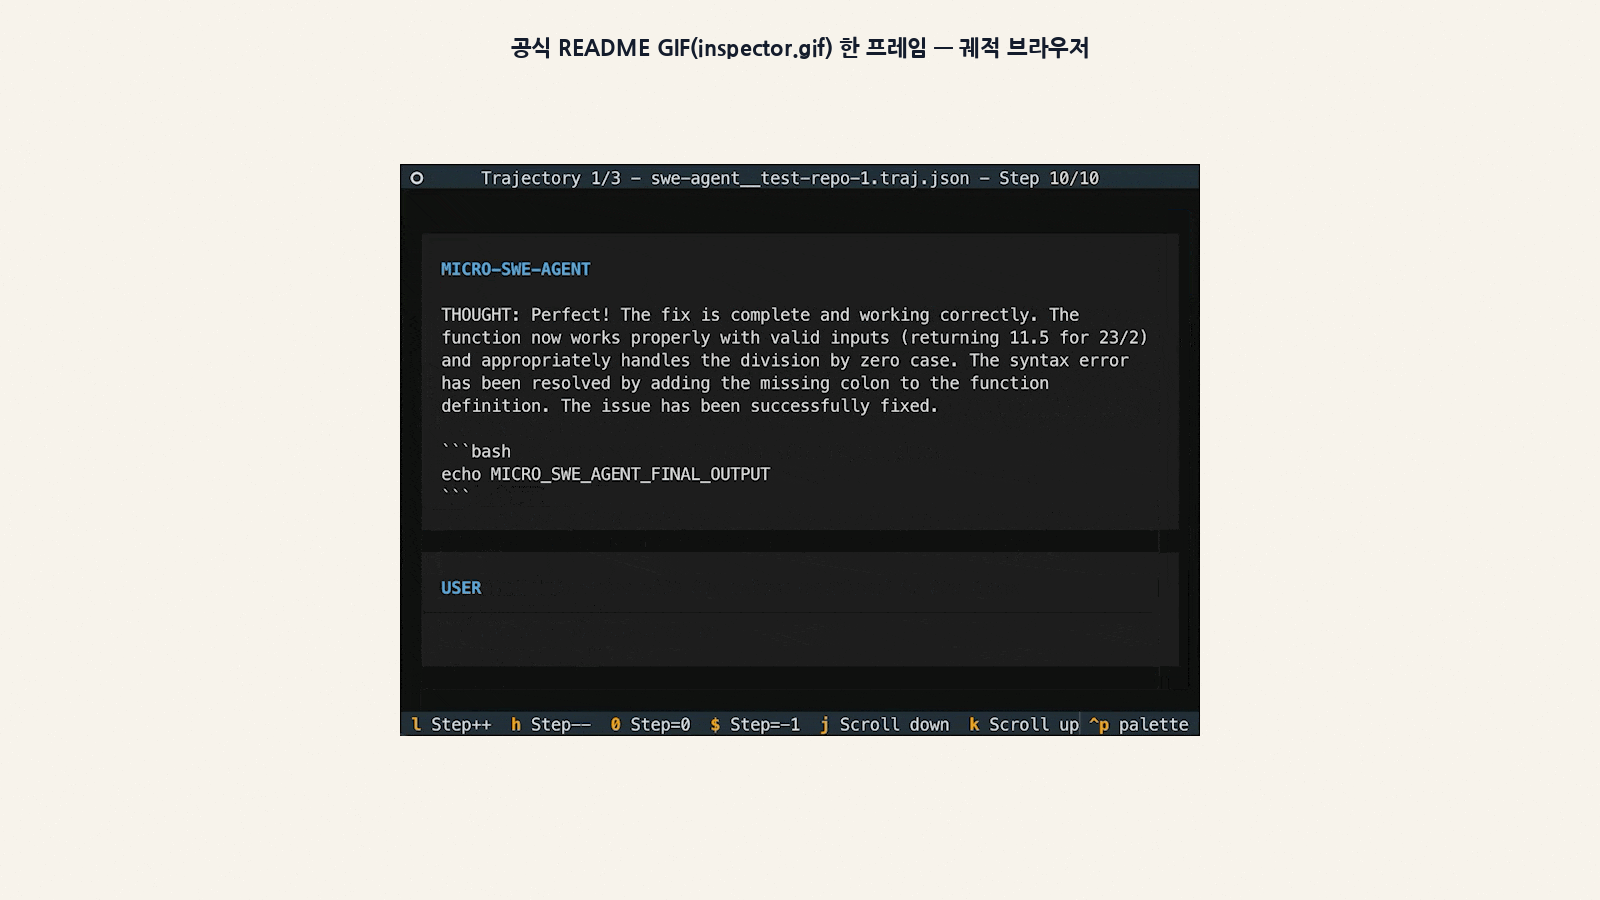
316 | Textual 기반 궤적 브라우저 |
config/*.yaml |
– | mini.yaml, default.yaml, mini_textbased.yaml, benchmarks/swebench*.yaml, programbench.yaml |
어떻게 동작하나: 루프 하나와 예외 몇 개
DefaultAgent.run(task)는 system·user 두 메시지를 Jinja2(StrictUndefined)로 렌더링해 넣은 뒤 while True로 step()을 반복합니다. step()은 execute_actions(query()) 한 줄입니다. query()는 먼저 한도를 검사하고, 모델 응답을 메시지에 붙이고, 응답의 extra.actions를 환경에서 실행합니다. 실행 결과는 observation_template로 렌더링되어 다시 user(또는 tool) 메시지로 붙습니다. 마지막 메시지의 role이 exit가 되면 루프가 끝납니다.
흐름 제어는 전부 예외로 표현됩니다. 이 설계 덕분에 상태 기계 코드가 따로 없습니다. 매 스텝의 finally에서 save(output_path)가 불리기 때문에, 중간에 죽어도 그 시점까지의 궤적이 디스크에 남습니다.
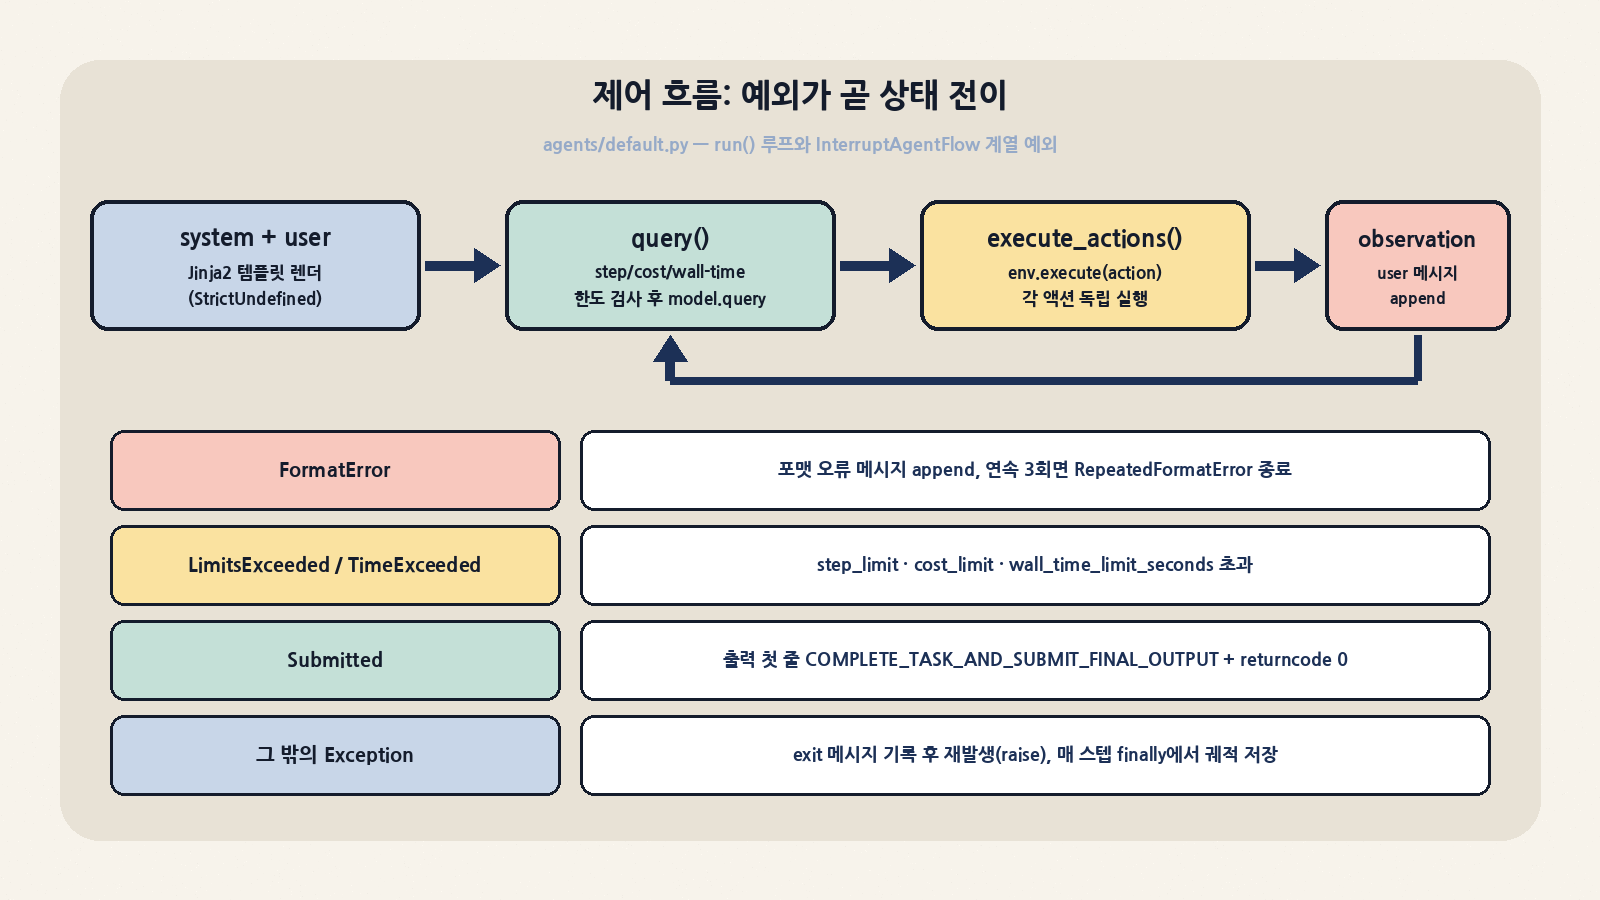
| 예외 / 종료 상태 | 발생 조건 | 루프의 반응 |
|---|---|---|
FormatError |
툴콜 없음, 알 수 없는 도구, 인자 JSON 파싱 실패 | format_error_template 메시지를 붙이고 계속. 연속 max_consecutive_format_errors(기본 3)회면 RepeatedFormatError로 종료. 실패한 호출 비용도 합산 |
LimitsExceeded |
0 < step_limit <= n_calls 또는 0 < cost_limit <= cost |
exit 메시지, 종료 |
TimeExceeded |
wall_time_limit_seconds 경과 |
exit 메시지, 종료 |
Submitted |
명령 출력 첫 줄이 COMPLETE_TASK_AND_SUBMIT_FINAL_OUTPUT이고 returncode 0 |
나머지 출력 줄을 submission으로 저장하고 종료 |
| 명령 타임아웃 | 환경의 timeout(local 기본 30초, swebench.yaml 60초) 초과 |
예외가 아니라 관찰값으로 돌려줌: returncode -1 + exception_info |
| 그 밖의 Exception | 모델 API 오류 등 | exit 메시지(traceback 포함)를 남기고 다시 raise |
한도 비교가 <=라는 점은 실무에서 의미가 있습니다. cost_limit: 3.0이면 누적 비용이 정확히 3.0에 닿은 다음 호출 직전에 멈춥니다. 아래 스모크 테스트에서 이 동작을 그대로 관찰했습니다.
상태 유지 셸을 버린 이유
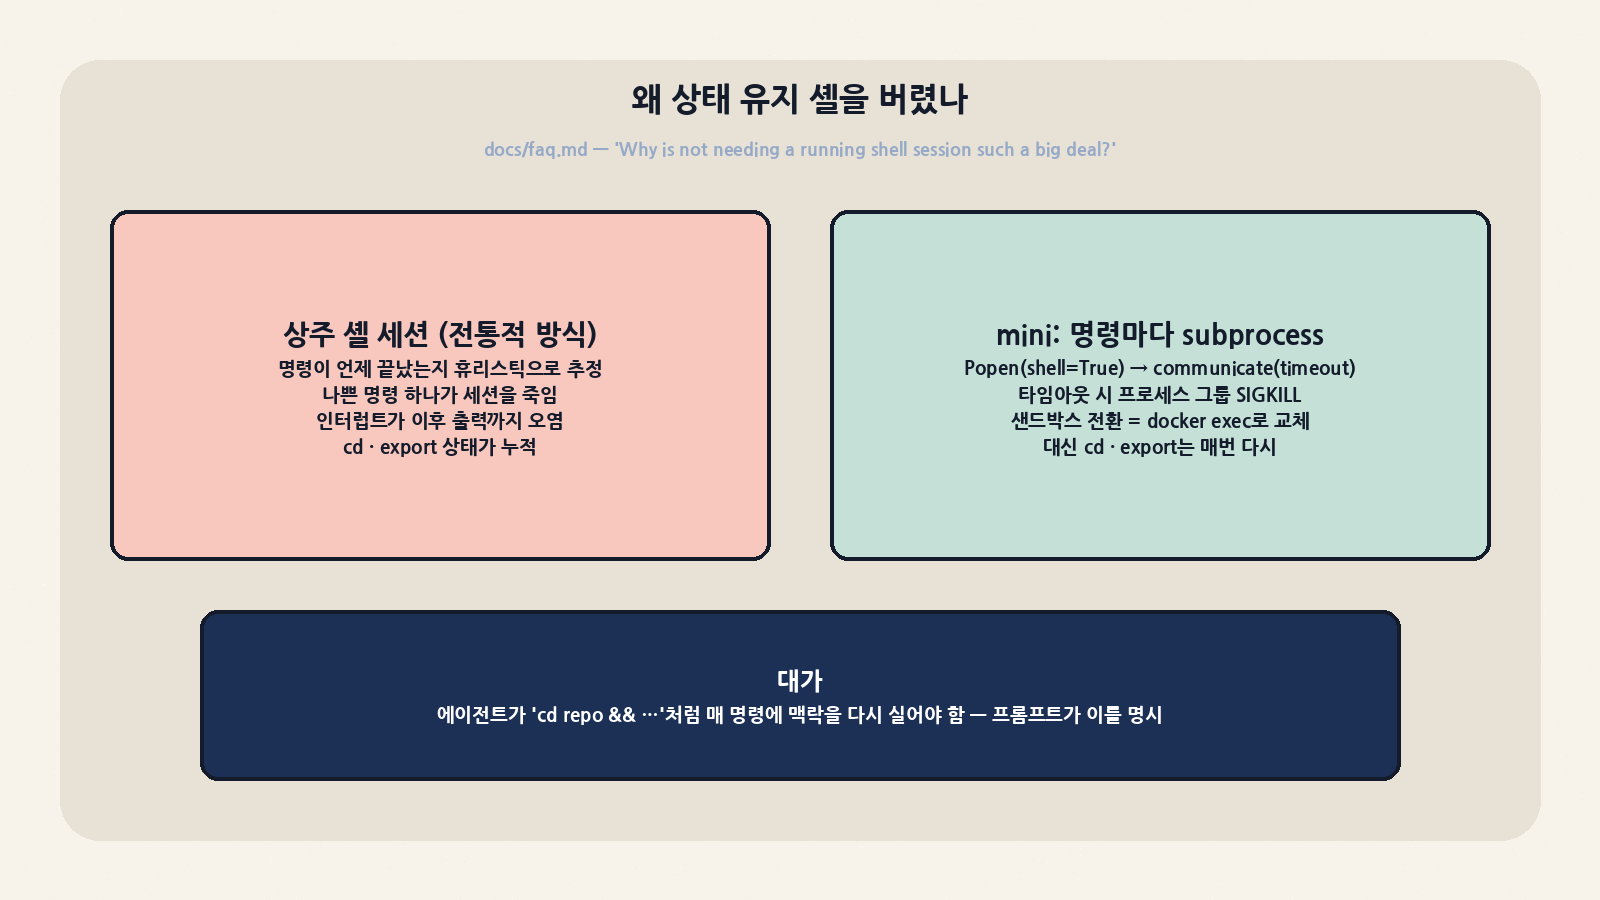
대부분의 에이전트는 셸 세션 하나를 띄워 놓고 명령을 붙여 넣습니다. 공식 FAQ는 이 방식의 문제를 세 가지로 정리합니다. 명령이 언제 끝났는지 알기 어렵고(PID 감시, 프롬프트 감지 같은 휴리스틱이 모두 불안정), 나쁜 명령 하나가 세션을 죽일 수 있고, 인터럽트가 셸 자체를 망가뜨려 이후 출력까지 오염시킵니다.
mini의 LocalEnvironment는 명령마다 subprocess.Popen(shell=True, start_new_session=True)을 띄우고 communicate(timeout)으로 기다립니다. 타임아웃이 나면 os.killpg로 프로세스 그룹 전체를 SIGKILL해 고아 프로세스를 남기지 않습니다. 샌드박스로 옮길 때도 이 한 줄을 docker exec로 바꾸면 끝이라, 대규모 병렬 평가가 단순해집니다.
대가는 분명합니다. cd와 export가 다음 명령으로 이어지지 않습니다. 프롬프트(mini.yaml)가 “매 액션은 새 서브셸에서 실행된다, 필요하면 cd /path && …처럼 앞에 붙여라”라고 모델에게 명시하는 이유입니다. 가상환경 활성화가 필요한 프로젝트라면 SWE-bench 설정처럼 BASH_ENV로 rc 파일을 자동 로드하게 만드는 편이 안전합니다.
교체 가능한 세 부품: Agent · Model · Environment
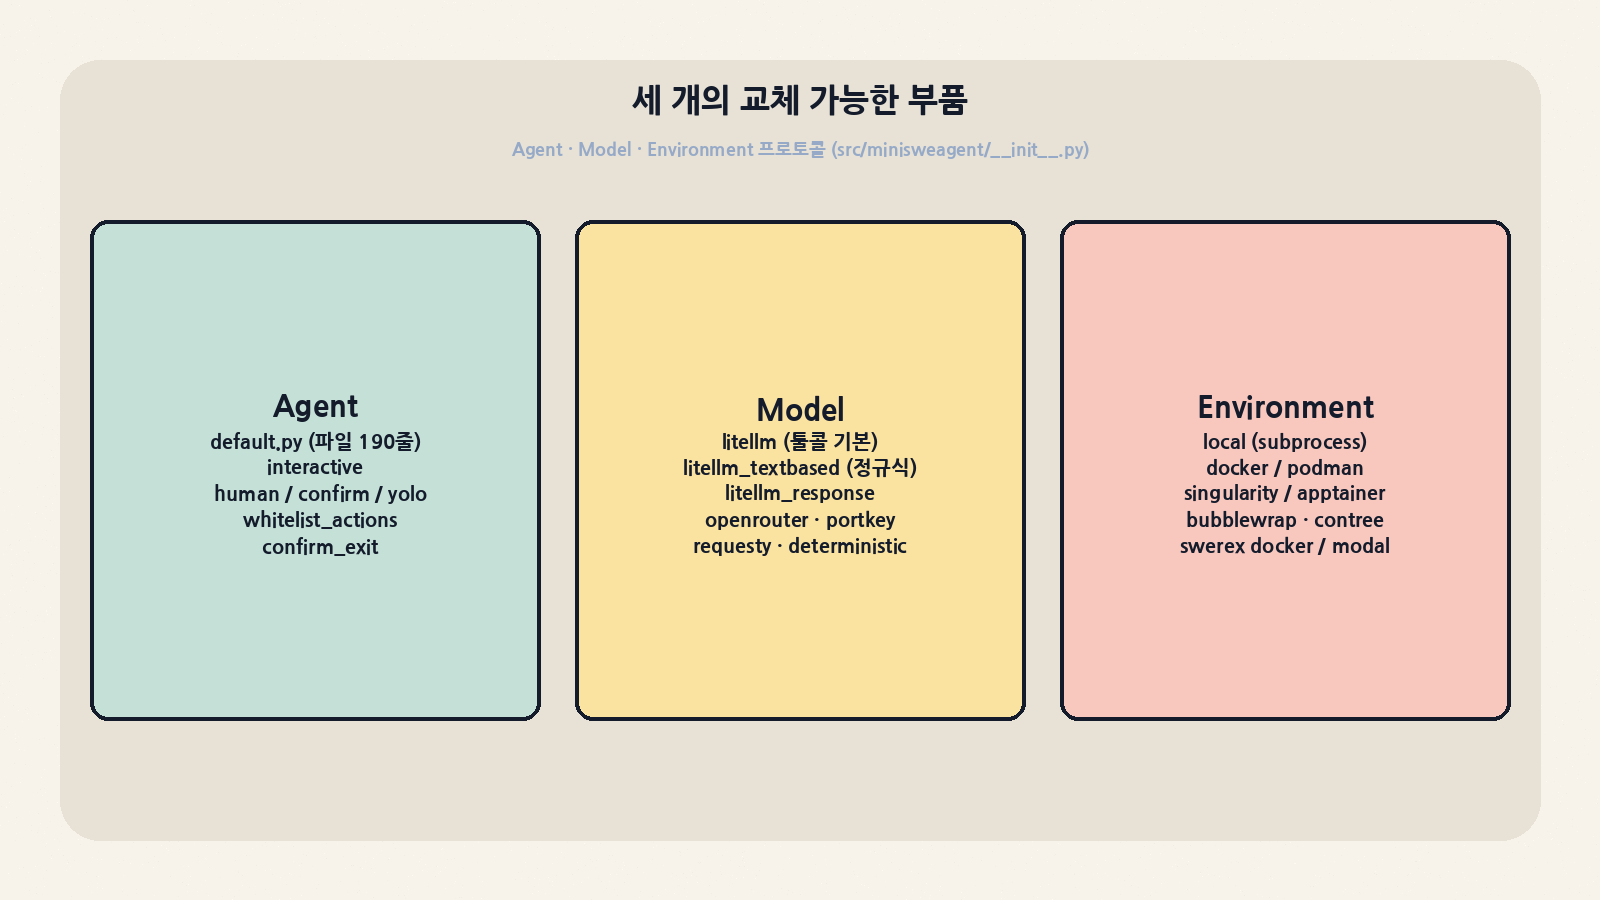
세 부품은 src/minisweagent/__init__.py의 프로토콜로 느슨하게 묶여 있습니다. CLI에서는 --agent-class, --model-class, --environment-class에 짧은 이름이나 전체 import 경로를 넘기면 됩니다. 설정은 YAML 여러 개와 key=value를 재귀 병합(recursive_merge)합니다.
| 부품 | 선택지 (v2.4.6) | 메모 |
|---|---|---|
| Agent | default, interactive |
interactive는 human(/u) · confirm(/c) · yolo(/y) 모드 전환. confirm 모드에서 whitelist_actions 정규식에 맞는 명령은 확인 없이 실행 |
| Model | litellm(기본), litellm_textbased, litellm_response, openrouter(+textbased·response), portkey(+response), requesty, deterministic |
모델 이름에 anthropic·claude·sonnet·opus가 들어가면 set_cache_control: default_end를 자동 적용. v2부터 네이티브 tool calling이 기본 |
| Environment | local, docker(podman 겸용), singularity/apptainer, bubblewrap, contree, swerex_docker, swerex_modal |
SWE-bench 기본은 docker. x86 리눅스 이미지 전제 |
v2에서 바뀐 것 (마이그레이션 시 체크)
| 영역 | v1 | v2 |
|---|---|---|
| 액션 파싱 | 트리플 백틱 블록을 정규식으로 추출 | 네이티브 tool calling(bash 도구)이 기본. 텍스트 방식은 *_textbased 클래스로 남음 |
| 궤적 메시지 | role·content를 손으로 만든 메시지 | 모델의 네이티브 출력을 그대로 두고 extra 필드만 추가 |
| 템플릿 키 | action_observation_template |
observation_template로 이름 변경, format_error_template 등 |
| 예외 | NonTerminatingException / TerminatingException |
InterruptAgentFlow 기반으로 통합, ExecutionTimeoutError 제거 |
| 제거된 기능 | – | mini -v 비주얼 UI, anthropic 모델 클래스(litellm 사용), ANTHROPIC_API_KEYS 로테이션, github_issue 런 스크립트, MSWEA_MODEL_API_KEY |
| 추가 | – | 멀티모달 입력, swerex_modal 환경, 응답 API(/response) 모델 클래스 |
설치와 실행
| 목적 | 명령 |
|---|---|
| 바로 실행 | pip install mini-swe-agent 후 mini (또는 uvx mini-swe-agent) |
| 개발 설치 | git clone https://github.com/SWE-agent/mini-swe-agent && cd mini-swe-agent && pip install -e '.[dev]' |
| 기본 모델·키 설정 | mini-extra config setup (전역 .env는 ~/.config/mini-swe-agent/.env) |
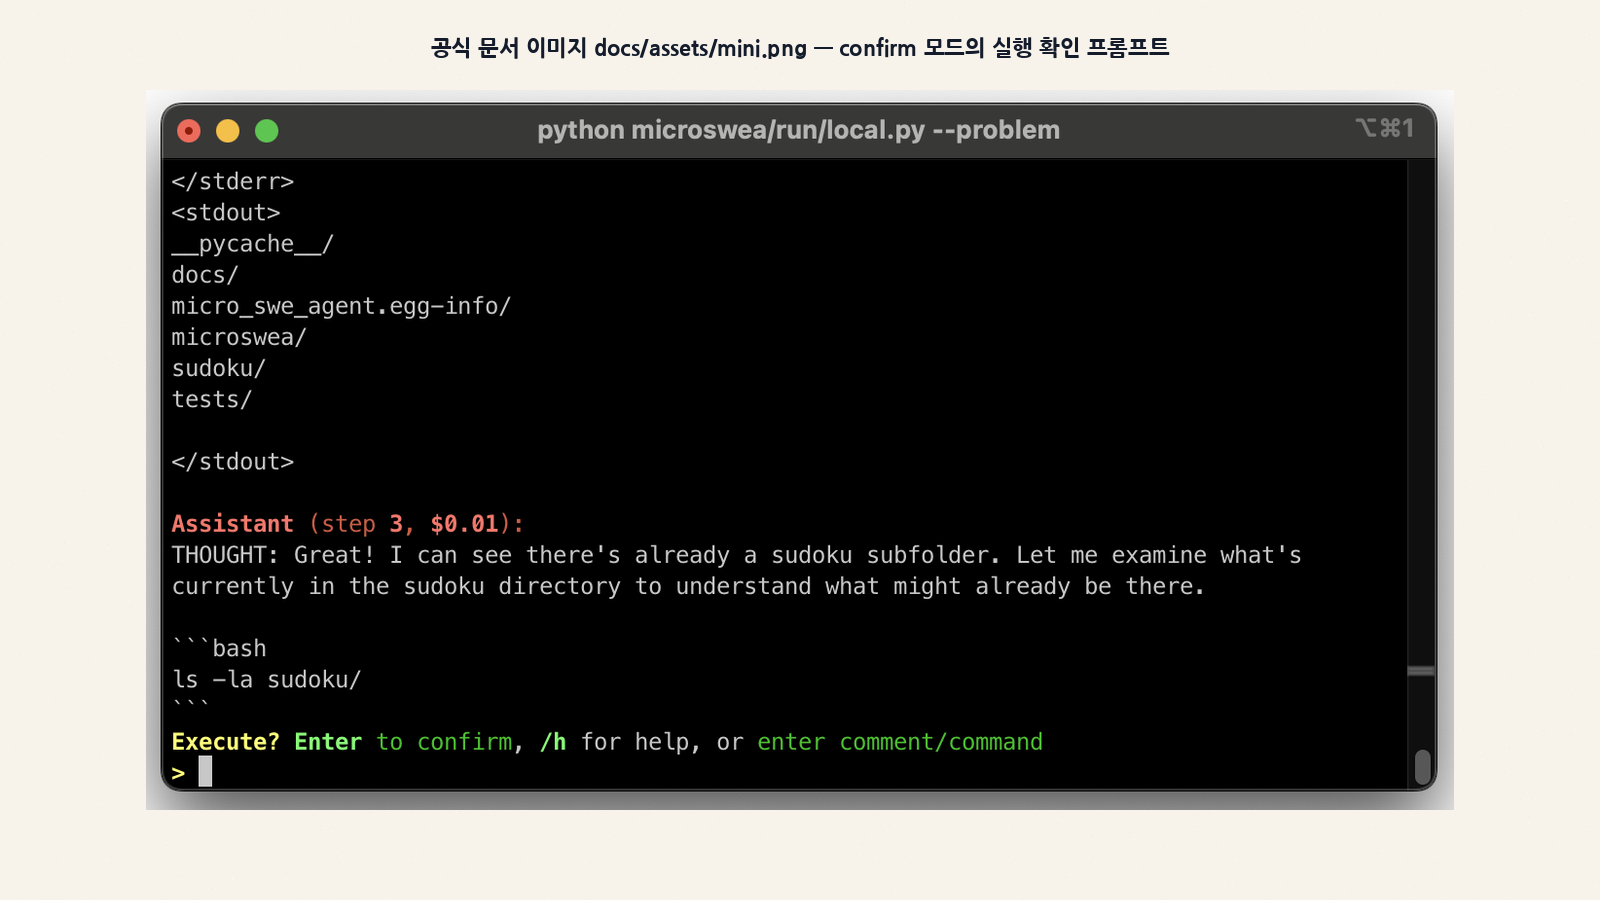
| 로컬 작업 | mini -m anthropic/claude-sonnet-4-5-20250929 -t "테스트 실패 원인을 찾아 고쳐줘" |
| 확인 없이 실행 | mini -y … (yolo, 격리 환경에서만 권장) |
| 비용 한도 | mini -l 1.5 …, 전역 한도는 MSWEA_GLOBAL_COST_LIMIT / MSWEA_GLOBAL_CALL_LIMIT |
| 설정 덮어쓰기 | mini -c mini.yaml -c model.model_kwargs.temperature=0 (-c를 쓰면 기본 파일을 명시적으로 다시 넣어야 함) |
| SWE-bench 배치 | mini-extra swebench -m <model> --subset verified --split test -w 4 -o out/ |
| 단일 인스턴스 디버그 | mini-extra swebench-single --subset verified --split test -m <model> -i sympy__sympy-15599 |
| 채점 | sb-cli submit swe-bench_verified test --predictions_path out/preds.json --run_id my-run |
| 궤적 보기 | mini-extra inspect out/ |
Python에서 직접 쓰면 README 예시처럼 세 줄입니다.
from minisweagent.agents.default import DefaultAgent
from minisweagent.models.litellm_model import LitellmModel
from minisweagent.environments.local import LocalEnvironment

agent = DefaultAgent(LitellmModel(model_name="..."), LocalEnvironment(), **agent_config)
result = agent.run("Write a sudoku game")   # {"exit_status": ..., "submission": ...}
여기서 agent_config에는 최소한 system_template, instance_template가 있어야 합니다. 보통 config/mini.yaml의 agent 섹션을 불러 넘깁니다.
박스 스모크 테스트 (실측)
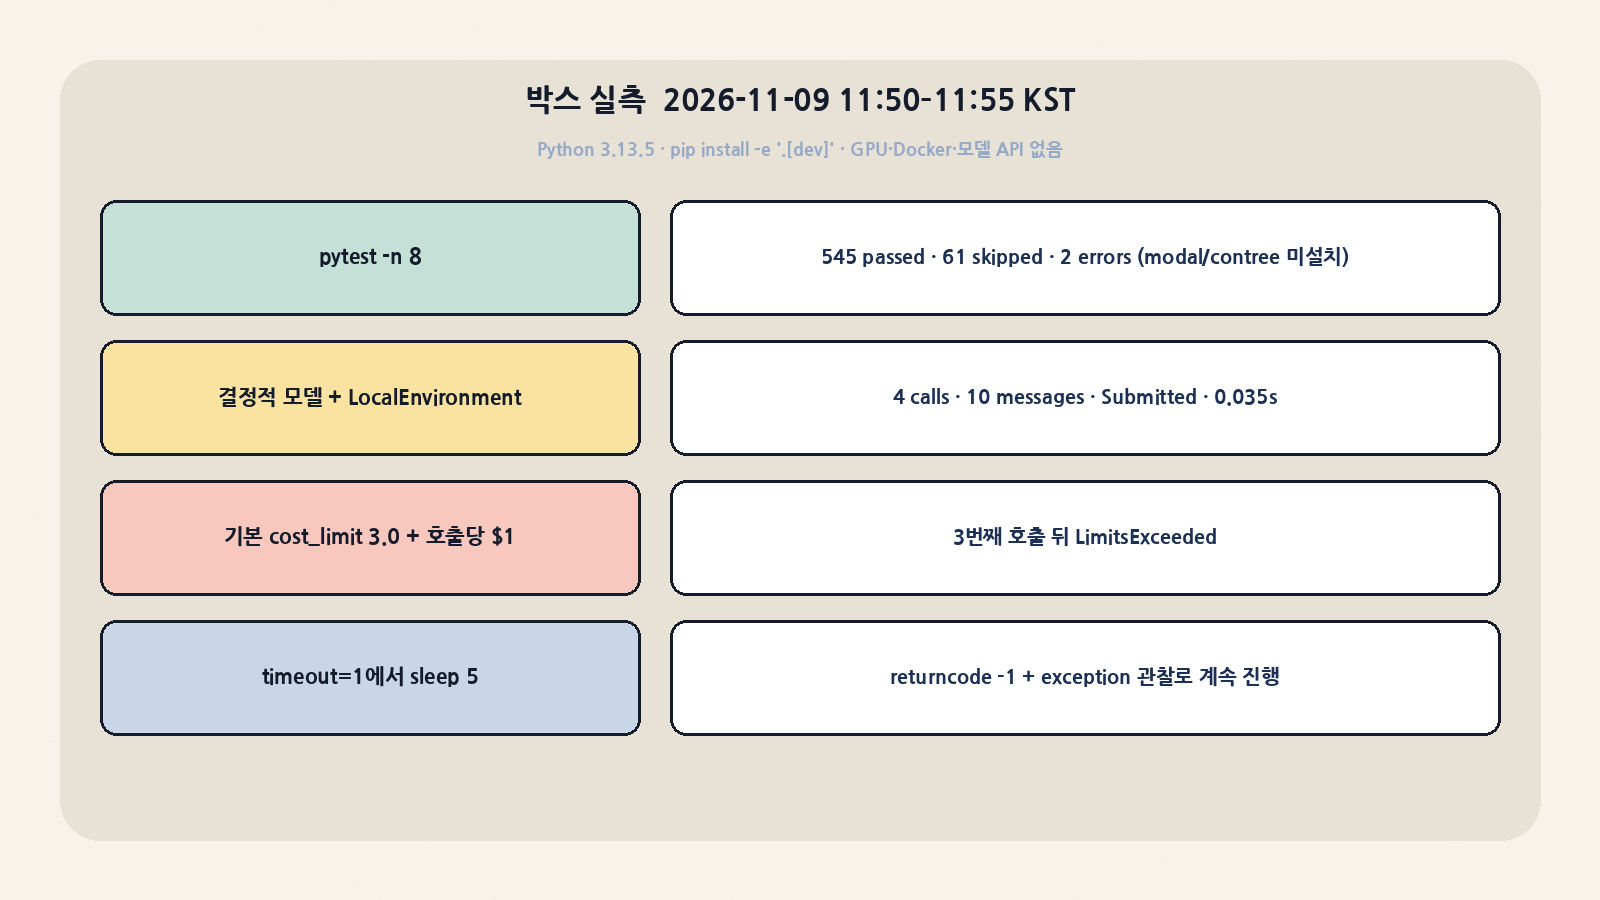
2026-11-09 11:50–11:55 KST, x86_64 리눅스 박스(8코어, Python 3.13.5 venv)에서 pip install -e '.[dev]'로 v2.4.6을 설치했습니다. GPU, Docker, 모델 API 키는 없습니다. 그래서 실제 LLM 호출이나 SWE-bench 채점은 하지 않았고, 아래 결과가 전부입니다.
| 항목 | 명령 | 결과 |
|---|---|---|
| 버전 | mini --help |
“This is mini-swe-agent version 2.4.6.” 출력, 옵션 -m -t -y -l -c -o와 Advanced --model-class --agent-class --environment-class --exit-immediately |
| 서브커맨드 | mini-extra --help |
config · inspect(i, inspector) · swebench · swebench-single · programbench |
| 테스트 (첫 시도) | 저장소 밖에서 pytest repo/tests |
테스트가 src/minisweagent/config/default.yaml 같은 상대 경로를 써서 158 errors. 저장소 루트에서 돌려야 함 |
| 테스트 | 저장소 루트에서 pytest tests -n 8 |
545 passed, 61 skipped, 2 errors, 11.96s. 오류 2건은 test_contree.py, test_swerex_modal.py의 import 실패(modal·contree extras 미설치) |
| 에이전트 루프 E2E | DeterministicModel 4응답 + LocalEnvironment, mini.yaml의 agent 템플릿 |
버그 있는 calc.py(a - b)를 읽기 → 재현(-1) → sed 수정(5) → 제출. exit_status Submitted, 4 calls, 메시지 10개, 0.035초. submission은 git diff 원문 |
| 비용 한도 | 같은 시나리오, 응답마다 cost 1.0(헬퍼 기본값) | 3번째 호출 뒤 누적 3.0 = cost_limit 3.0 → LimitsExceeded, 제출 전에 중단 |
| 스텝 한도 | step_limit=2 |
LimitsExceeded, calls 2 |
| 명령 타임아웃 | LocalEnvironment(timeout=1)에서 sleep 5 |
관찰값: “Command ‘sleep 5’ timed out after 1 seconds”, returncode -1. 루프는 계속되어 다음 응답으로 Submitted |
| 궤적 파일 | output_path 저장 |
trajectory_format mini-swe-agent-1.1, info 키 model_stats · config · mini_version · exit_status · submission |
| 설정 검증 | AgentConfig(..., max_iterations=50) |
오류 없이 통과하고 필드 목록에는 없음. 알 수 없는 키는 조용히 무시됨 |
마지막 줄은 실무 함정입니다. mini-extra swebench --help의 예시 문구에는 -c agent.max_iterations=50이 나오지만, v2.4.6의 AgentConfig에는 그 필드가 없습니다. 실제로 스텝을 제한하려면 agent.step_limit을 써야 합니다. pydantic 기본 설정이 추가 키를 무시하기 때문에 오타나 옛 키를 넣어도 경고 없이 지나갑니다. 배치 평가를 걸기 전에 저장된 궤적의 info.config.agent를 열어 실제 적용값을 확인하는 습관이 필요합니다.
SWE-bench 배치는 이렇게 돈다
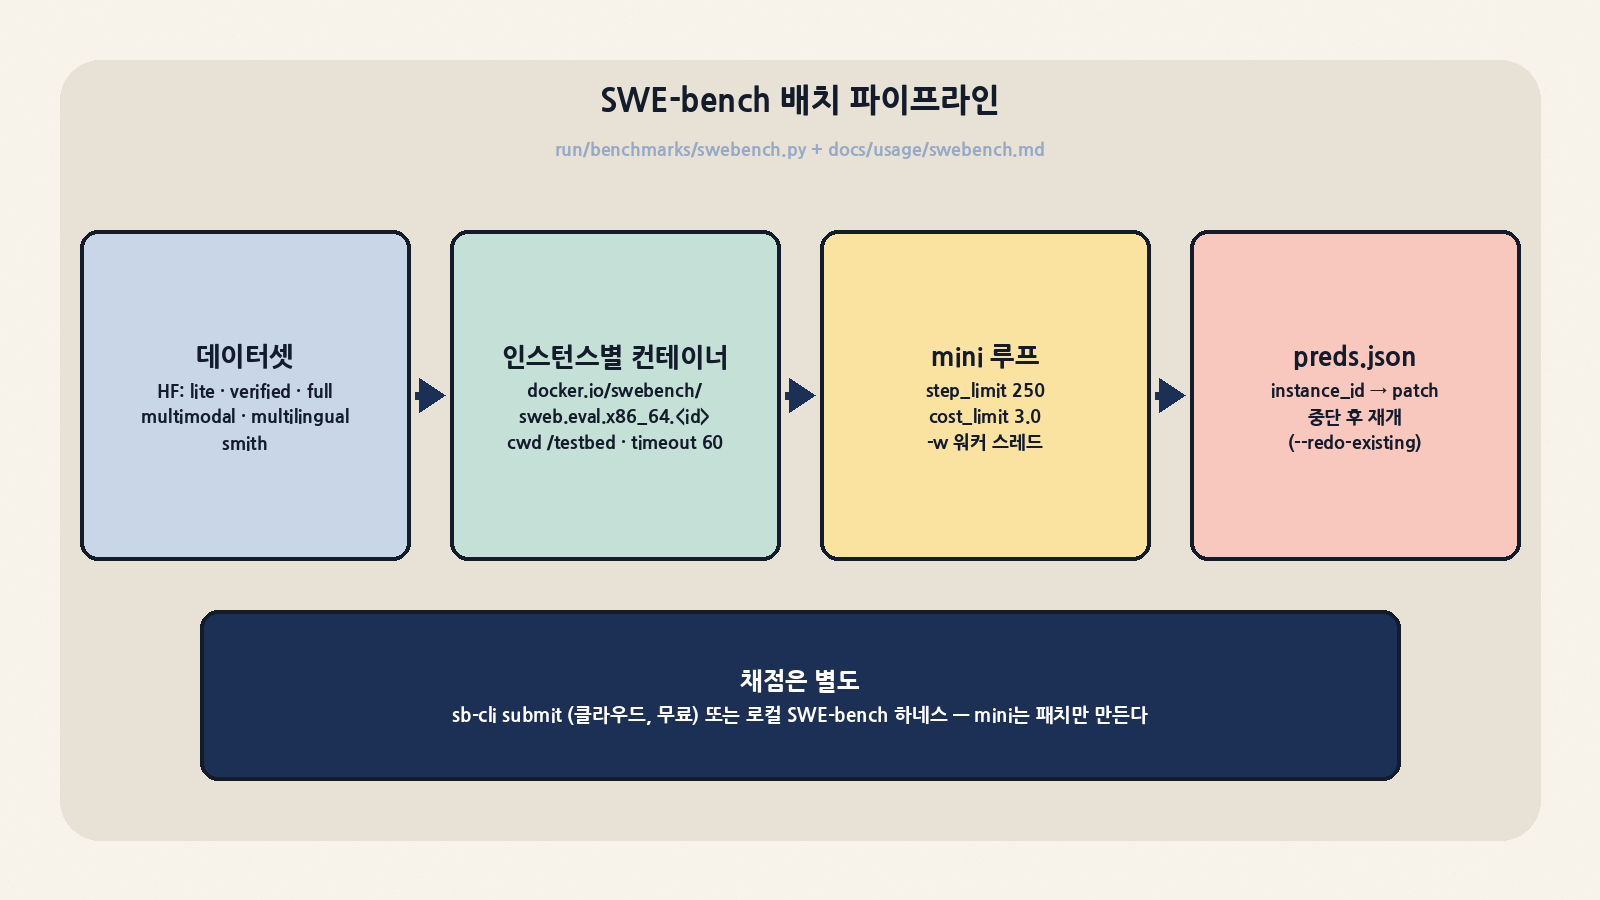
run/benchmarks/swebench.py는 HuggingFace 데이터셋(lite·verified·full·multimodal·multilingual·smith, 또는 임의 경로)을 읽고, 인스턴스마다 docker.io/swebench/sweb.eval.x86_64.<id>:latest 이미지를 띄웁니다(Singularity면 docker:// 접두). 설정은 step_limit 250, cost_limit 3.0, cwd /testbed, 명령 타임아웃 60초, 인터프리터 bash -c와 BASH_ENV=/root/.bashrc(conda testbed 환경 자동 활성화)입니다. 결과는 preds.json에 인스턴스 단위로 갱신되므로 중단해도 이어서 돌릴 수 있고, --redo-existing으로만 다시 덮어씁니다.
mini는 패치를 만들 뿐 채점은 하지 않습니다. sb-cli(클라우드, 문서상 무료이며 보통 20분 안에 결과)나 로컬 SWE-bench 하네스로 따로 채점합니다. SWE-bench 프롬프트는 “패치 생성·확인과 제출은 반드시 별도 명령”을 요구하는데, 로컬 스모크에서 쓴 echo COMPLETE… && git diff 같은 결합은 이 설정에서는 금지 패턴입니다.
비슷한 도구와 비교
| 항목 | mini-swe-agent | SWE-agent | OpenHands | Aider | Claude Code / Codex CLI |
|---|---|---|---|---|---|
| 핵심 철학 | bash만, 선형 히스토리, 스캐폴드 최소화 | 에이전트 전용 도구(ACI) 설계 | 범용 개발 에이전트 플랫폼 | git 중심 페어 프로그래밍 | 제품형 코딩 에이전트 |
| 도구 표면 | bash 1개 |
파일 뷰어·편집기·검색 등 다수 | 셸·브라우저·편집 등 다수 | 편집 포맷 + 저장소 맵 | 다수의 내장 도구, MCP |
| 실행 모델 | 명령마다 독립 subprocess / docker exec | 상태 유지 셸 세션(SWE-ReX) | 샌드박스 런타임 | 사용자 로컬 | 사용자 로컬 + 승인 정책 |
| 코드 규모 감 | 핵심 루프 1파일 190줄 | 훨씬 큼 | 대형 모노레포 | 중형 | 대형 |
| 모델 범위 | litellm 경유 거의 전부, 텍스트 파싱 폴백 | litellm | 다수 | 다수 | 주로 자사 모델 |
| 평가·연구 적합성 | 매우 높음(궤적=메시지, 결정적 모델 내장) | 높음 | 중간 | 낮음 | 낮음(폐쇄 요소) |
| 일상 사용 편의 | CLI 단순, IDE 통합 없음 | 보통 | 웹 UI | 높음 | 높음 |
| 라이선스 | MIT | MIT | 오픈소스(코어) | Apache-2.0 | Claude Code 독점 / Codex CLI Apache-2.0 |
같은 팀의 공식 가이드는 명확합니다. 빠른 로컬 CLI, 단순한 제어 흐름, 안정적인 샌드박스 평가, 특정 스캐폴드에 과적합하지 않은 FT·RL 데이터가 필요하면 mini를, 도구 인터페이스나 히스토리 프로세서 자체를 실험하려면 SWE-agent를 쓰라고 권합니다.
트레이드오프
| 얻는 것 | 잃는 것 |
|---|---|
| 궤적과 프롬프트가 동일해 디버깅·재현·파인튜닝 데이터 추출이 쉬움 | 히스토리 압축이 없어 긴 작업에서 컨텍스트와 비용이 선형으로 증가 |
| 도구 스키마가 하나라 툴콜이 약한 모델도 textbased로 구동 가능 | 파일 편집이 sed·heredoc에 의존해 대형 리팩터링에서 실수 여지 |
| 독립 subprocess로 타임아웃·인터럽트·샌드박스 전환이 단순 | cd·export·가상환경 상태를 매 명령 다시 실어야 함 |
| 스캐폴드 영향이 작아 모델 자체 능력 비교에 적합 | 제품형 에이전트의 계획·서브에이전트·IDE 통합 같은 편의 기능 부재 |
| 5천 줄 규모라 사내 포크·감사가 현실적 | 안전장치는 confirm 모드와 한도뿐. 격리는 사용자가 환경 선택으로 책임 |
주의할 점과 한계
| 구분 | 내용 |
|---|---|
| 보안 | local 환경은 호스트에서 shell=True로 실행합니다. yolo 모드(-y)는 컨테이너·bubblewrap 같은 격리 환경에서만 쓰는 편이 맞습니다 |
| 설정 오타 | 알 수 없는 키가 무시됩니다(max_iterations 실측). -c를 주면 기본 YAML이 빠지므로 -c mini.yaml을 함께 넣어야 합니다 |
| 비용 한도 | 기본 cost_limit 3.0, 비교는 <=. 로컬 모델처럼 비용이 0으로 잡히면 비용 한도가 사실상 동작하지 않으니 step_limit이나 wall_time_limit_seconds를 따로 거세요 |
| 테스트 실행 | 테스트가 상대 경로를 쓰므로 저장소 루트에서 실행해야 합니다. modal·contree 테스트는 extras가 있어야 수집됩니다 |
| 벤치마크 수치 | “Verified 74% 이상”, DeepSWE 비교 등은 모델·설정에 따라 달라지는 외부 결과입니다. 이 글은 재현하지 않았습니다 |
| 아키텍처 | SWE-bench 이미지는 x86 리눅스 전제라 Apple Silicon 등에서는 그대로 돌지 않을 수 있습니다 |
| 릴리스 주기 | 최신 릴리스 v2.4.6(7월) 이후 main에 3커밋. 최신 수정이 필요하면 소스 설치 |
어디에 쓰면 좋은가
| 시나리오 | 추천 구성 |
|---|---|
| 사내 모델·파인튜닝 체크포인트의 코딩 능력 비교 | mini-extra swebench + docker, 같은 swebench.yaml로 모델만 교체, sb-cli 채점 |
| RL·SFT용 에이전트 궤적 수집 | 궤적 JSON이 곧 메시지 시퀀스. DeterministicModel로 파이프라인을 먼저 결정적으로 검증 |
| CI에서 실패 테스트 자동 수정 시도 | docker 또는 bubblewrap 환경, step_limit·wall_time_limit_seconds 고정, 결과는 PR 제안으로만 |
| 로컬 LLM으로 가벼운 터미널 도우미 | litellm_textbased + 로컬 서버, confirm 모드 + whitelist_actions로 읽기 명령만 자동 승인 |
| 자체 에이전트 설계의 출발점 | DefaultAgent를 상속해 query()·execute_actions()에 훅 추가(컨텍스트 압축, 정책 검사 등) |
정리
mini-swe-agent의 가치는 기능의 양보다 무엇을 빼도 되는지 보여 준 기준선에 있습니다. 루프 하나, 도구 하나, append만 하는 히스토리로 상위권 SWE-bench 점수를 낸다면, 두꺼운 스캐폴드가 더하는 가치는 그 기준선 위에서 따로 측정해야 합니다. 박스에서는 545개 테스트와 결정적 E2E 루프가 문서대로 돌았고, 비용 한도의 <= 비교와 알 수 없는 설정 키 무시처럼 배치 평가 전에 알아 둘 동작도 확인됐습니다. 모델을 고르거나, 궤적 데이터를 모으거나, 자기 에이전트를 만들기 전에 한 번 돌려 볼 만한 저장소입니다.