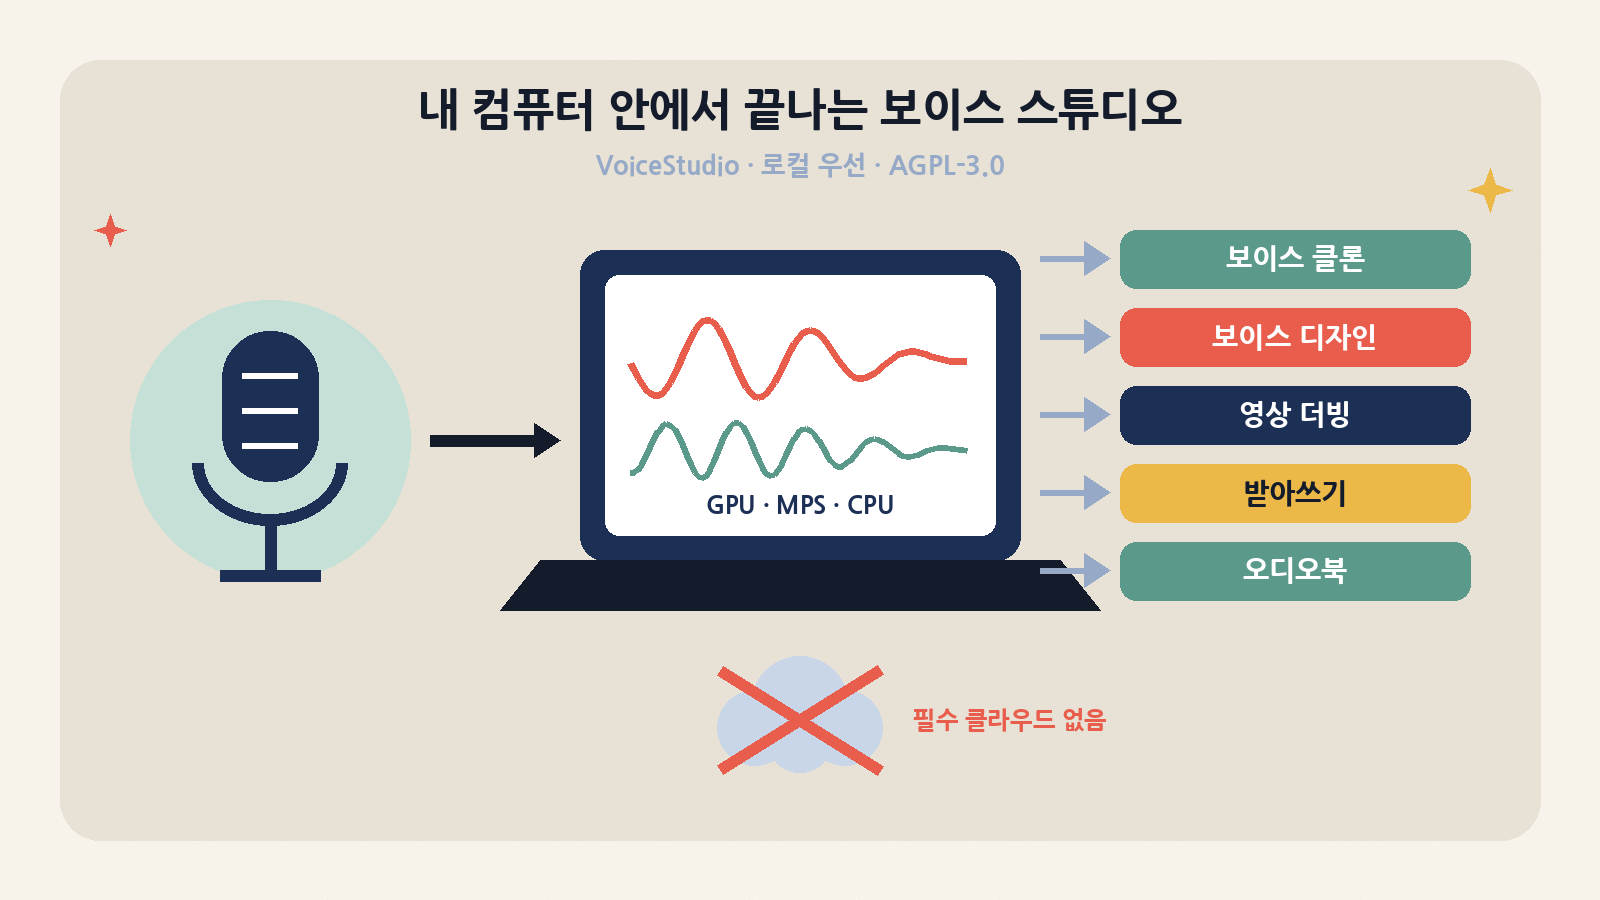
한 줄 요약: debpalash/VoiceStudio는 “ElevenLabs를 내 컴퓨터로 옮기겠다”는 목표의 로컬 우선 음성 스튜디오입니다. 보이스 클론·보이스 디자인·영상 더빙·받아쓰기·오디오북을 하나의 Electron 앱과 FastAPI 백엔드로 묶고, TTS 17종·ASR 10여 종 엔진을 고르게 하며, OpenAI 호환 /v1·WebSocket·MCP로 다른 도구와 에이전트에 음성을 열어 줍니다. 오늘은 GitHub Trending Python 일간 3위(오늘 +1,691 스타)에 오른 이 저장소를 소스 트리와 문서 기준으로 해부하고, 박스에서 직접 돌려 본 범위와 도입 전에 반드시 걸러야 할 라이선스 층위를 정리합니다.
왜 지금 이 저장소인가
음성 생성은 텍스트 LLM보다 “로컬로 옮기기” 어려운 영역이었습니다. 모델마다 의존성 핀이 충돌하고, GPU 메모리 요구가 제각각이며, 더빙처럼 ASR·번역·TTS·믹싱을 엮는 순간 파이프라인 운영 문제가 됩니다. VoiceStudio가 흥미로운 지점은 새 모델을 내놓는 것이 아니라 여러 오픈 음성 모델을 하나의 운영 가능한 제품으로 묶는 통합 계층을 만들었다는 데 있습니다. 아래 수치는 모두 2026-10-13 16:57 KST 기준 GitHub API·저장소에서 확인한 값입니다.
| 항목 | 확인한 값 | 해석 |
|---|---|---|
| 저장소 | debpalash/VoiceStudio (주 언어 Python, 홈페이지 voicestudio.sh) |
설명문: “open-source, fully-local ElevenLabs alternative — voice cloning, voice design, video dubbing, dictation, transcription & audiobook creation in 646 languages” |
| 스타 / 포크 | 60,996 / 6,841 | 2026-04-10 06:40 KST 생성 → 약 6개월 만의 수치. 열린 이슈+PR 120건 |
| Trending | Python 일간 3위, 오늘 +1,691 스타 | 전체 일간 목록에는 없었고, 언어별(Python) 목록에서 상위 |
| 최신 GitHub 릴리스 | v0.5.6 (2026-09-23 17:53 KST) | Windows x64·macOS arm64/x64·Linux AppImage/deb 설치 파일 제공 |
| main 브랜치 버전 | package.json 0.5.7, CHANGELOG에 [0.5.7] — 2026-10-13 섹션 |
확인 시점에는 v0.5.7 태그·릴리스가 아직 없었습니다. ‘곧 나올 버전’으로 보는 게 정확합니다 |
| 라이선스 | 앱: AGPL-3.0-only / 번들 omnivoice/: Apache-2.0 |
기본 모델 가중치는 별개(CC-BY-NC). 아래 라이선스 장에서 상세히 다룹니다 |
| 최근 푸시 | 2026-10-13 16:20 KST | 릴리스 직전 활발히 커밋 중인 저장소 |
기능 지도: 무엇을 하는 앱인가
README는 기능을 Create / Produce / Connect 세 축으로 정리합니다. 실무자 관점에서 다시 묶으면 아래와 같습니다. 핵심은 “음성 생성기”가 아니라 음성 작업용 워크스테이션 + 로컬 음성 API 서버라는 점입니다.
| 축 | 기능 | 실무 포인트 |
|---|---|---|
| Create | 보이스 클론, 보이스 디자인(텍스트 설명→목소리), 받아쓰기 위젯 | 클론 참조 음성은 최대 75초까지 받고 5–15초의 깨끗한 음성을 권장. 엔진마다 실제로 쓰는 길이가 다릅니다 |
| Produce | 영상 더빙, 스토리/오디오북, 배치 큐, 보컬 분리, 화자 분리 | 오디오북은 챕터 큐시트·M4B 챕터, 더빙은 SRT/VTT 붙여넣기 번역 지원 |
| Connect | 로컬 HTTP·WebSocket API, MCP 서버, 레시피·감시 폴더 | 포트 3900 하나에 OpenAI 호환 전사, 스트리밍 전사, MCP가 함께 올라옵니다 |
| 안전장치 | AI 워터마크(AudioSeal), 동의 기반 분석, 모델 라이선스 안내 | 코드상 비가청 워터마크 기본 ON, 영상 로고 오버레이 기본 ON, 가청 시그니처 톤 기본 OFF |
| 하드웨어 | CUDA, Apple Silicon(MPS), AMD ROCm(Linux), CPU 자동 감지 | Windows의 PyTorch GPU 가속은 NVIDIA/CUDA 전용이라고 문서가 명시합니다 |
아키텍처: Electron 셸, FastAPI 백엔드, 엔진 어댑터
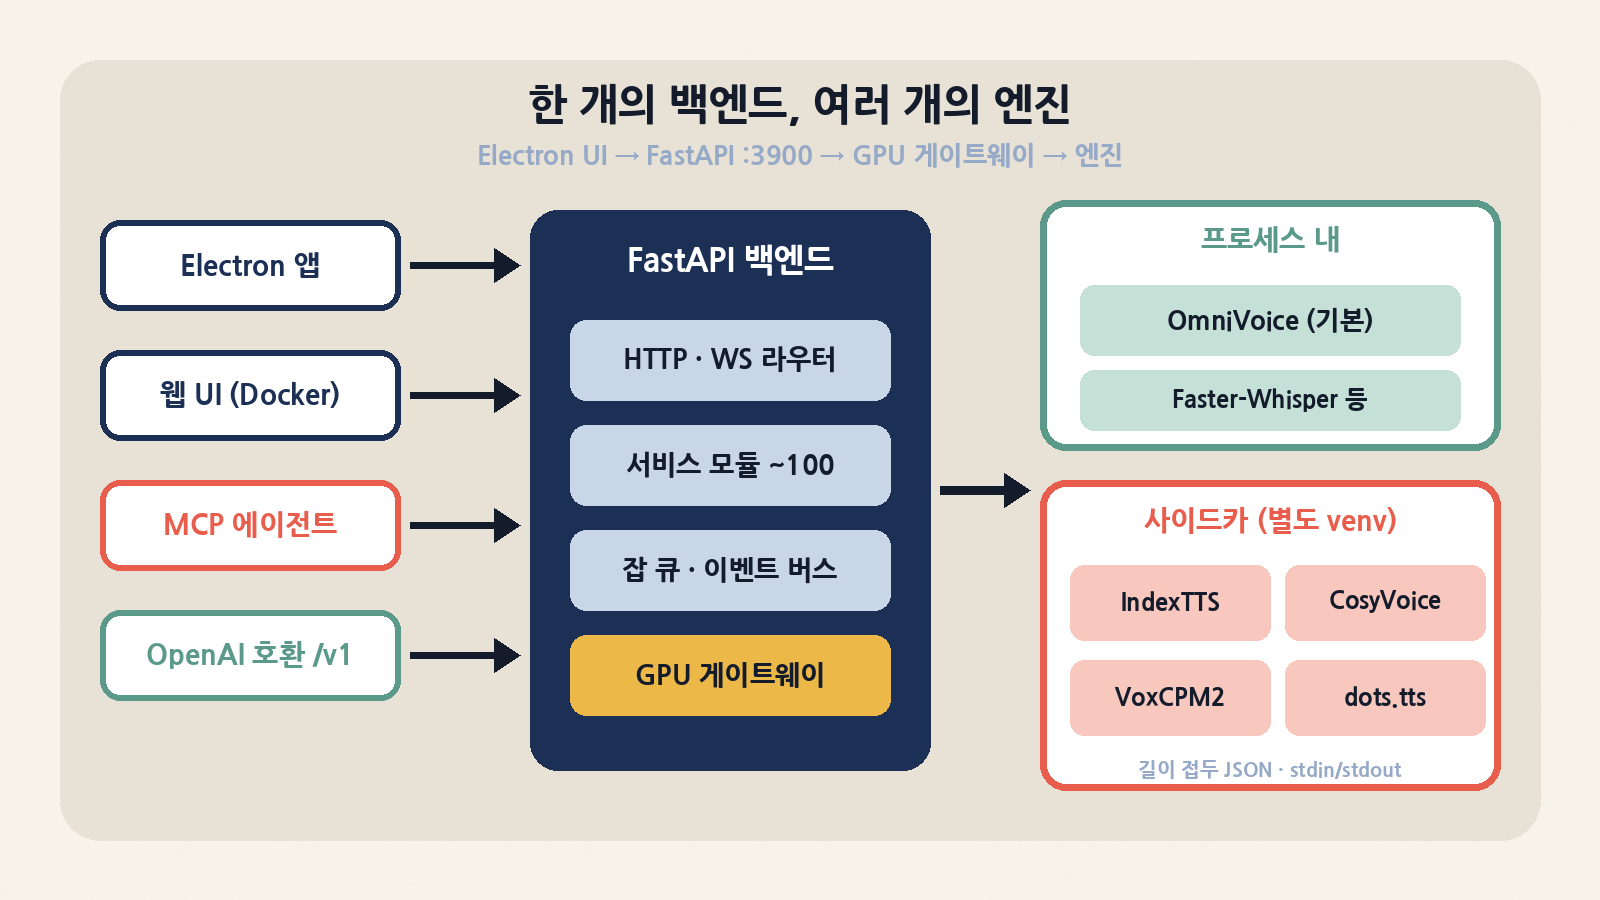
저장소 루트는 Bun 워크스페이스 + Turborepo 모노레포이고, package.json이 앱 버전의 단일 원천입니다(pyproject.toml과 backend/core/version.py가 미러로 따라가며 테스트로 강제). 데스크톱 UI는 0.5.3을 끝으로 Tauri에서 Electron(React 19)으로 완전히 옮겨졌고, Docker 배포에서는 같은 렌더러를 웹 UI로 빌드해 백엔드가 서빙합니다.
| 디렉터리 | 역할 | 눈여겨볼 점 |
|---|---|---|
electron/ |
유일한 데스크톱·웹 UI. main(수명주기·백엔드 감독·업데이터), preload(window.voicestudio), renderer |
UI 문자열은 전부 i18n 키. 하드코딩 CJK를 CI 테스트로 막습니다 |
native/desktop-bridge/ |
Electron이 쓰는 Rust 네이티브 헬퍼 | 변경 시 CI가 별도로 검증(CLAUDE.md) |
backend/main.py |
FastAPI 단일 진입점 | 문서가 “부팅 순서가 하중을 받는다(load-bearing)”고 경고합니다 |
backend/api/routers/ |
HTTP/WS 라우터(문서 기준 42개, 자동 포함) | 얇은 HTTP 표면만 두고 로직은 services로 |
backend/services/ |
약 100개 모듈: TTS, 더빙 파이프라인, DSP, GPU 게이트웨이, 엔진 라우팅, 모델 수명주기 | dub_pipeline.py, gpu_gateway.py, subprocess_backend.py, engine_routing.py, watermark.py가 핵심 |
backend/engines/ |
엔진별 어댑터: indextts, cosyvoice, voxcpm2, dots_tts, moss_tts_v15, supertonic3, audiocpp, omnivoice_gguf 등 | 대부분 사이드카 프로세스 방식 |
omnivoice/ |
기본 TTS 모델 패키지(k2-fsa OmniVoice 계열, Apache-2.0) | models·training·eval·cli까지 포함 |
tests/ |
메인 pytest 세션 + smoke·evals·frontend | conftest.py가 데이터 디렉터리를 격리해 실제 앱 상태를 건드리지 않음 |
deploy/ |
CUDA 기본 Dockerfile(같은 파일로 ROCm 변형), compose, 설치 워커 | 이미지는 linux/amd64 전용 |
엔진 격리의 핵심: SubprocessBackend
여러 음성 모델을 한 앱에 넣을 때 가장 먼저 터지는 문제는 의존성 충돌입니다. 소스 주석은 구체적인 예를 듭니다. IndexTTS는 transformers<5를 요구하고 VoiceStudio 본체는 transformers>=5.3을 요구합니다. 그래서 backend/services/subprocess_backend.py의 SubprocessBackend는 엔진마다 별도 venv의 다른 파이썬 인터프리터를 subprocess.Popen으로 띄우고, stdin/stdout 위에서 길이 접두(length-prefixed) JSON 프레임으로 대화합니다. multiprocessing은 현재 인터프리터만 복제하므로 일부러 배제했다고 명시합니다.
| 설계 요소 | 구현(소스 기준) | 왜 중요한가 |
|---|---|---|
| 프로세스 경계 | 엔진별 venv_python() + sidecar_script()만 오버라이드 |
새 엔진 추가 비용이 어댑터 두 메서드 수준으로 줄어듭니다 |
| 프레임 크기 제한 | MAX_FRAME_BYTES = 64 MB |
길이 접두를 악용한 메모리 DoS 차단 |
| 역방향 메시지 허용 목록 | PARENT_INBOUND_OPS: ready, pong, audio, segments, progress, error, gpu_acquire, gpu_release |
사이드카가 오염돼도 부모가 받는 명령을 제한 |
| GPU 슬롯 회계 | generate의 try/finally로 슬롯 반환 |
사이드카가 죽어도 GPU 슬롯 누수 방지 |
| 정리(teardown) | POSIX 프로세스 그룹 / Windows Job 객체, atexit, stderr 배출 시 HF 토큰 마스킹 | 백엔드가 죽어도 고아 프로세스·토큰 노출을 줄임 |
같은 원리가 기본 엔진에도 적용됩니다. omnivoice-subprocess 엔진은 기본 OmniVoice 모델을 크래시 격리된 자식 프로세스에서 돌립니다. 문서 설명에 따르면 파이썬은 네이티브 torch 호출을 중단시킬 수 없어서, 프로세스 내 엔진이 예산을 넘기면 GPU를 붙든 채 “버려진 워커”가 되고 뒤 요청이 줄줄이 멈췄습니다(#730, #1190). 자식 프로세스는 proc.kill()로 확실히 회수할 수 있고, 다음 요청 때 새 사이드카가 뜹니다. Apple Silicon에서는 기본 omnivoice ID가 자동으로 이 격리 구현을 쓰고, CUDA·ROCm·CPU는 호출 오버헤드가 낮은 프로세스 내 구현을 유지합니다.
engine_routing.py는 엔진이 선언한 gpu_compat과 캐시된 호스트 능력을 대조해 accelerated / cpu_fallback / cpu_only / unavailable 중 하나를 결정하는 순수 함수입니다. 모델을 로드하거나 I/O를 하지 않고 OS 간 결과가 동일하도록 설계했다는 점, 그리고 “조용한 CPU 폴백 금지(no-silent-fallback)”를 계약으로 둔 점이 운영 친화적입니다. 실제로 성능 문서가 꼽는 느려짐의 대표 원인이 “GPU인 줄 알았는데 CPU에서 돌고 있었다”입니다.
엔진 카탈로그: TTS와 ASR 선택지
엔진은 Model Catalogue에서 고르거나 OMNIVOICE_TTS_BACKEND / OMNIVOICE_ASR_BACKEND 환경 변수로 고정합니다. 다음 표는 docs/engines/README.md를 요약한 것입니다.
| TTS 엔진 | 실행 환경 | 클론 | 활성화 방법 |
|---|---|---|---|
| VoiceStudio(OmniVoice) — 기본 | CUDA · MPS · CPU | ✅ | 기본 설치. 첫 사용 시 가중치 다운로드(MCP 문서 기준 약 2.3GB) |
| OmniVoice GGUF | CUDA · MPS · CPU | ✅ | 양자화 네이티브 바이너리, 저VRAM·CPU용 |
| VoxCPM2 | CUDA · MPS · CPU | ✅ + 보이스 디자인 | pip install "voxcpm>=2.0.3" |
| IndexTTS 2.5 | CUDA · CPU | ✅ + 감정 | 원클릭 사이드카 설치 |
| CosyVoice 3 | CUDA · CPU | ✅ | clone + requirements |
| MOSS-TTS-v1.5 (8B) / dots.tts (2B) / Confucius4-TTS | CUDA · CPU | ✅ | clone + 환경 변수 (dots.tts는 Windows 미지원) |
| KittenTTS / Supertonic-3 / PocketTTS | CPU 중심 | 프리셋 음성 위주(PocketTTS는 클론 가능) | pip 또는 uv sync --extra … + 라이선스 동의 |
| MLX-Audio (Kokoro, CSM, Dia 등) | Apple Silicon | 모델별 상이 | pip install mlx-audio |
| audio.cpp (Breeze-TTS-2) | CPU + Vulkan/Metal/CUDA/HIP | ✅ + 보이스 디자인 | 프리빌트 바이너리. 가중치는 연구·비상업용 |
| GPT-SoVITS / Sherpa-ONNX | 외부 서버 / CUDA · CPU | GPT-SoVITS만 ✅ | 자체 API 서버 / 모델 디렉터리 지정 |
| ASR 엔진 | 강점(문서 표현) | 비고 |
|---|---|---|
| WhisperX — 기본 | 더빙(단어 단위 타임스탬프 + 화자 분리) | CUDA · CPU |
| Faster-Whisper / 격리판 | 일반 전사 / 무인 배치 | 격리판은 옵트인 |
| MLX Whisper / Parakeet TDT(MLX) | Mac 기본 / 받아쓰기 | Apple Silicon |
| Parakeet TDT (NeMo) | 25개 언어, 빠른 CPU | 앱과 분리된 별도 venv |
| FunASR (SenseVoice) | 50+ 언어, 인라인 화자 분리 | pip install funasr |
| Sherpa-ONNX 받아쓰기 / Moonshine | 실시간 스트리밍 / 저전력 엣지 | Moonshine은 타임스탬프 없음 |
| OpenAI 호환(로컬·원격) | 설정한 엔드포인트 사용 | 루프백 주소면 로컬로 유지 |
클론 참조 음성 처리도 엔진마다 다릅니다. OmniVoice는 최대 20초를 쓰며 긴 클립에서는 음성이 가장 많은 15초 구간을 골라 전사하고(best_window), VoxCPM2는 앞뒤 무음을 자른 뒤 처음 30초를 씁니다(head). 그 외 엔진은 “검증되지 않음”으로 클립을 그대로 넘깁니다. GET /engines가 엔진별 max_ref_seconds와 ref_strategy를 보고하므로, 자동화 파이프라인이라면 이 값을 먼저 읽고 참조 클립을 잘라 보내는 편이 안전합니다.
더빙 파이프라인의 데이터 흐름
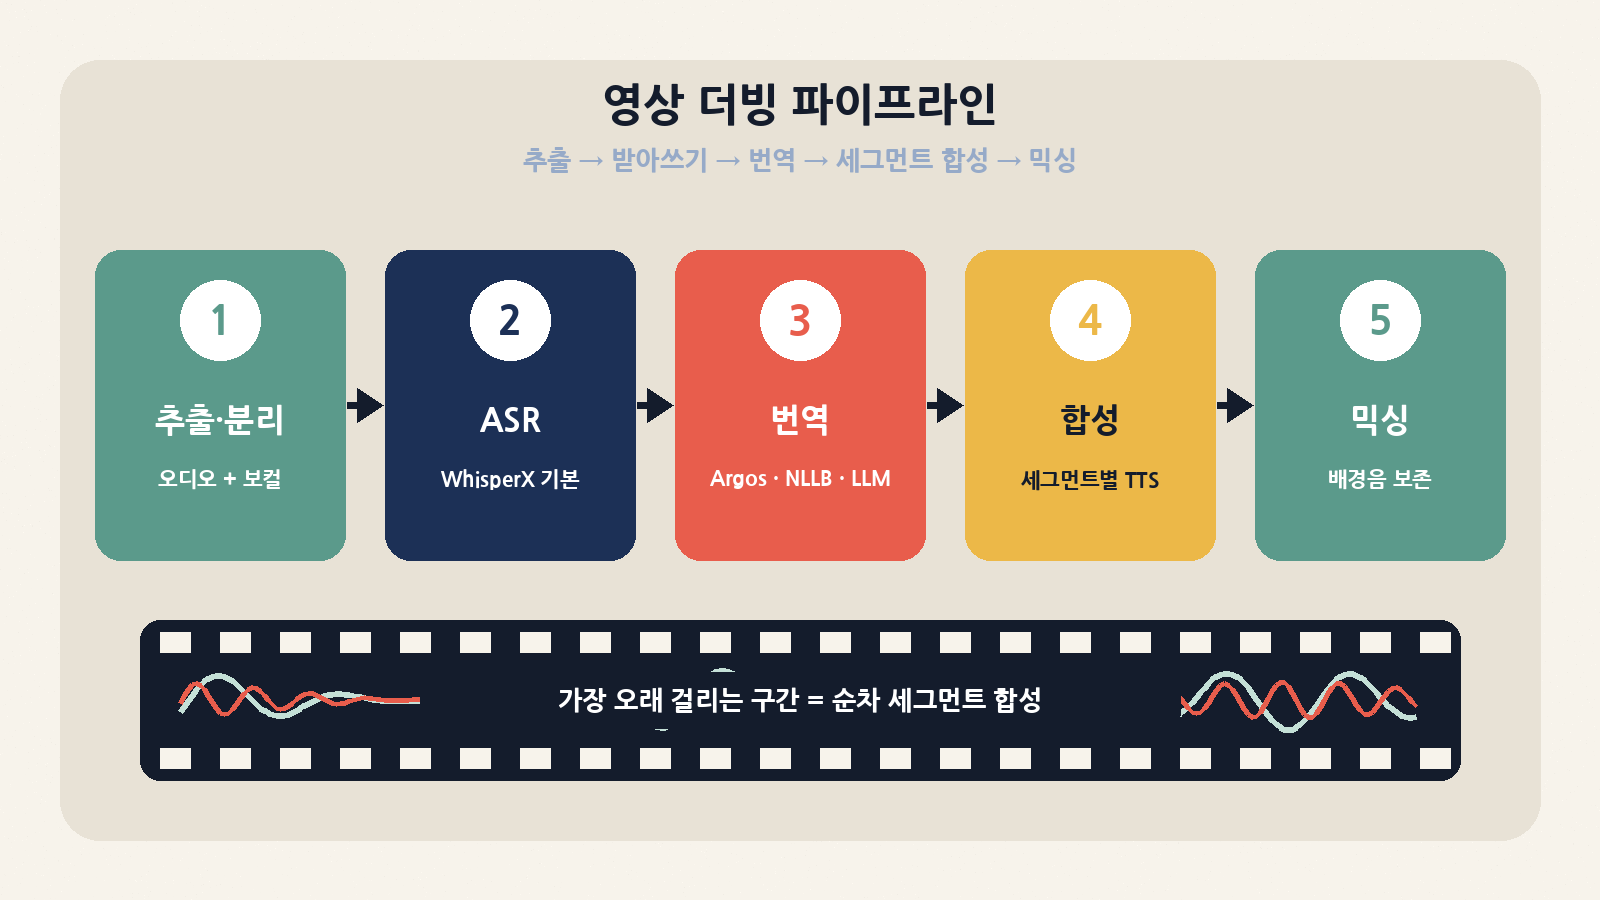
성능 문서는 더빙을 다섯 단계로 설명합니다. 오디오 추출 + 보컬 분리(긴 영상은 수 분, 1회성) → 전사(가용한 최상의 가속기, Apple Silicon은 v0.3.21부터 MLX) → 번역(LLM 제공자는 동시 6요청 병렬) → 세그먼트별 합성(순차, 전체 시간의 대부분) → 믹싱과 내보내기(대부분 스트림 복사라 빠름). services/dub_pipeline.py는 잡 상태(메모리 dict + dub_history 복원), 콘텐츠 해시 캐시(같은 파일 재처리 방지), 안전한 잡 경로, ffmpeg/demucs 하위 프로세스 추적과 POST /dub/abort/{id} 중단, SSE 진행 이벤트를 맡습니다.
| 번역 엔진 | 분류 | 패키지 / 키 |
|---|---|---|
| Argos (Local, Fast) | 오프라인 | argostranslate 번들 / 키 불필요 |
| NLLB-200 (Local, Heavy) | 오프라인 | 핵심 transformers 사용 / 키 불필요 |
| Google Translate(Free), MyMemory | 온라인 | deep_translator / 키 불필요 |
| DeepL, Microsoft Translator | 온라인 | deep_translator / DEEPL_API_KEY, MICROSOFT_API_KEY |
| LLM (OpenAI 호환) | LLM | openai / 대개 키 필요 |
| Paste Translation | 직접 입력 | SRT/VTT, 번호 매긴 줄, 일반 줄을 자동 인식해 세그먼트에 매핑. 원문 보존, 단일 실행 취소 |
여기서 실무적으로 중요한 함정이 하나 있습니다. 문서가 직접 밝힌 과거 버그로, 더빙은 ASR 모델에 VRAM을 내주려고 TTS 모델을 CPU로 옮겼다가 전사가 끝나면 되돌리는데, v0.3.23 이전에는 취소·오류 경로에서 되돌리지 않아 이후 모든 생성이 CPU에서 10–50배 느리게 돌았습니다(#1191). 현재는 모든 종료 경로에서 복귀하고, 생성마다 디바이스를 검증합니다. 단일 GPU에서 ASR과 TTS를 번갈아 쓰는 구조라는 점은 여전하므로, 대량 더빙이라면 VRAM 여유와 배치 순서를 미리 설계하는 편이 좋습니다.
연결 계층: OpenAI 호환 API, WebSocket, MCP
VoiceStudio를 단순 데스크톱 앱 이상으로 만드는 부분입니다. 백엔드가 ASR 모델을 따뜻하게 유지한 채 포트 3900에서 여러 프로토콜을 동시에 제공합니다. 모든 인터페이스가 각자 모델 로딩을 다시 구현하지 않게 하는 것이 설계 목표라고 문서는 설명합니다.
| 전송 방식 | 엔드포인트 | 용도 |
|---|---|---|
| 능력 탐색 | GET :3900/.well-known/voicestudio-speech |
voicestudio.speech.v1 문서를 상대 URL로 반환(리버스 프록시 뒤에서도 동작) |
| OpenAI 호환 HTTP | POST :3900/v1/audio/transcriptions |
기존 SDK·스크립트로 파일 전사 |
| WebSocket 스트리밍 | ws://…:3900/v1/audio/transcriptions/stream |
WebM/Opus 기본, ?pcm=1&sr=16000로 PCM. partial/final 이벤트 |
| MCP Streamable HTTP | POST :3900/mcp/ (끝 슬래시 권장) |
Claude Code, Cursor, Codex CLI, Hermes 등 |
| MCP stdio | python -m backend.mcp_shim |
stdio만 지원하는 클라이언트 |
| 파이썬 브리지 | python -m backend.speech_client |
의존성 없는 CLI. 훅·TUI용 |
| MCP 도구 / 변수 | 동작 |
|---|---|
generate_speech |
텍스트→WAV(기본). 에이전트별로 묶인 목소리 사용, files/both 모드에서 ogg/opus 가능(ffmpeg 필요) |
clone_voice / design_voice / describe_voice |
참조 음성→프로필 / 설명→고정 시드 디자인 프로필 / 설명→속성 매핑만(저장 안 함) |
transcribe, list_voices, check_health 등 |
전사, 목록 조회, 백엔드 상태·GPU 디바이스 확인 |
OMNIVOICE_MCP_OUTPUT_MODE |
resources(기본, base64 인라인) / files / both. 에이전트 컨텍스트 비용을 줄이려면 files |
OMNIVOICE_MCP_BASE_PATH |
파일 입출력의 보안 경계. 심볼릭 링크 해석 후 검사, no-follow 디스크립터로 열기 |
X-OmniVoice-Client-Id 헤더 |
에이전트별 목소리 바인딩(예: claude-code) |
에이전트 연동 관점에서 좋은 결정은 오디오를 컨텍스트 밖으로 빼는 모드입니다. 문서가 직접 “LLM 에이전트는 컨텍스트에 받는 모든 바이트에 비용을 낸다”고 쓰며, files 모드면 경로만 돌려줍니다. 다만 LAN 공유 시 PIN은 평문 HTTP로 오가므로 신뢰할 수 있는 LAN에서만 쓰고, 그 밖에서는 Tailscale Serve나 TLS 리버스 프록시를 쓰라고 경고합니다. 또 로컬 프록시를 거친 루프백 요청은 PIN 게이트를 우회하므로 프록시 쪽에 별도 인증이 필요합니다.
설치와 실행: 데스크톱, 소스, Docker
세 경로가 있습니다. 일반 사용자는 설치 스크립트나 릴리스 설치 파일, 개발자는 소스 실행, 서버 운영은 Docker입니다.
# 1) 데스크톱(macOS/Linux) — 최신 Electron 릴리스
curl -fsSL https://voicestudio.sh/install | sh
# 특정 버전 / main 빌드 / 데이터 유지한 채 제거
curl -fsSL https://voicestudio.sh/install | sh -s -- --version X.Y.Z
curl -fsSL https://voicestudio.sh/install | sh -s -- --main
curl -fsSL https://voicestudio.sh/install | sh -s -- --uninstall
# Windows PowerShell
irm https://voicestudio.sh/install | iex
# 2) 소스에서 Electron 미리보기 실행
git clone https://github.com/debpalash/VoiceStudio.git
cd VoiceStudio
bun install
bun run setup:api # Python 의존성 준비(uv)
bun run dev
bun run smoke-test # 격리된 패키지 앱 빌드·실행 점검# 3) Docker (CPU 예시, linux/amd64 전용 이미지)
export OMNIVOICE_API_KEY="$(python3 -c 'import secrets; print(secrets.token_urlsafe(32))')"
docker pull ghcr.io/debpalash/voicestudio:stable
docker run -d --name omnivoice \
-p 127.0.0.1:3900:3900 \
-e OMNIVOICE_API_KEY="$OMNIVOICE_API_KEY" \
ghcr.io/debpalash/voicestudio:stable
# 분석을 완전히 끄려면 -e OMNIVOICE_ANALYTICS_DISABLED=1| Docker 태그 | 의미 | 운영 권장 |
|---|---|---|
:latest / :main |
main 최신 커밋의 롤링 프리뷰 | 운영 서버에는 쓰지 않기 |
:stable |
가장 최근 정식 릴리스 | 운영 기본값 |
:0.5.6 / :0.5 |
정확한 버전 / 0.5 최신 패치 | 재현성이 필요하면 정확한 버전 고정 |
:sha-xxxxxxx |
특정 커밋 | 장애 분석·롤백용 |
:rocm, :stable-rocm 등 |
AMD GPU(ROCm) 변형 | Linux + AMD GPU 서버 |
| 하드웨어 | 지원 수준(README) | 현실적 기대치 |
|---|---|---|
| NVIDIA GPU (Windows / Linux) | CUDA 가속 | OmniVoice 권장 VRAM 하한 6GB. 4GB 카드는 RAM으로 페이징돼 수 분씩 걸린 사례(#1226, #1222) |
| Apple Silicon | Metal(MPS) 가속 | 통합 메모리 16GB에서는 브라우저 탭 등 메모리 압박에 주의 |
| 전용 GPU 없음 | CPU에서 완전 사용 가능, 느림. 소형 CPU PyTorch 빌드(약 5GB 여유 공간) | CPU 생성 예산은 600초로 더 깁니다(가속 시 300초) |
| Windows on ARM | 실험적: 네이티브 ARM64 앱 + x64 파이썬 에뮬레이션, CPU 전용 | 검증 대기 중 |
| Intel Mac | 앱 UI만, 원격 백엔드 연결 | 로컬 추론 대상 아님 |
성능을 어떻게 평가할 것인가
솔직하게 짚어야 할 대목이 있습니다. docs/benchmarks.md의 결과 표는 확인 시점에 “No verified rows yet”, 즉 검증된 측정값이 한 줄도 없습니다. 프로젝트는 숫자를 추정하지 않고, 저장소 내 하네스로 측정한 값만 PR로 받겠다는 원칙을 세워 두었습니다. 따라서 “ElevenLabs급 품질”이나 속도 비교를 이 글에서 단정할 근거는 없고, 도입 팀이 직접 재야 합니다. 도구는 이미 준비돼 있습니다.
# 앱을 끈 상태에서 실행(실행 중인 백엔드가 모델을 잡고 있으면 수치가 왜곡됨)
uv run python scripts/bench_pipeline.py        # 전체 단계
uv run python scripts/bench_pipeline.py tts    # TTS 단계만
# 출력: warm 짧은 문장 RTF(초당 생성 오디오 대비 계산 시간), CUDA에서는 Peak VRAM| 평가 항목 | 측정 방법 | 판단 기준 예시 |
|---|---|---|
| 속도 | bench_pipeline.py tts의 warm RTF |
RTF < 1이면 실시간보다 빠름. 첫 생성은 지연 로드(~8초)·커널 컴파일로 항상 느리니 두 번째부터 판단 |
| 메모리 | Peak VRAM(CUDA), Settings → Performance | 사이드카 엔진은 하네스 밖에서 할당돼 n/a로 표시 |
| 클론 품질 | 내부 화자 동의를 받은 5–15초 참조 + 고정 스크립트 블라인드 청취 | 참조 클립 전사(Transcript) 필드가 비어 있으면 매 생성마다 ASR이 돌아 느려짐 |
| 더빙 품질 | 타이밍(세그먼트 길이 적합), 번역 정확도, 배경음 보존 | LLM 번역 vs Argos/NLLB 오프라인 번역을 같은 영상으로 비교 |
| 안정성 | 장시간 배치·취소·오류 경로 반복 | 무인 작업이면 omnivoice-subprocess 같은 격리 엔진 사용 검토 |
| 가속 여부 | Settings → Performance → GPU acceleration, /system/diagnose |
엔진별 GPU/CPU 라우팅 사유 확인(조용한 CPU 폴백 확인) |
라이선스: 앱, 패키지, 가중치는 서로 다른 층입니다
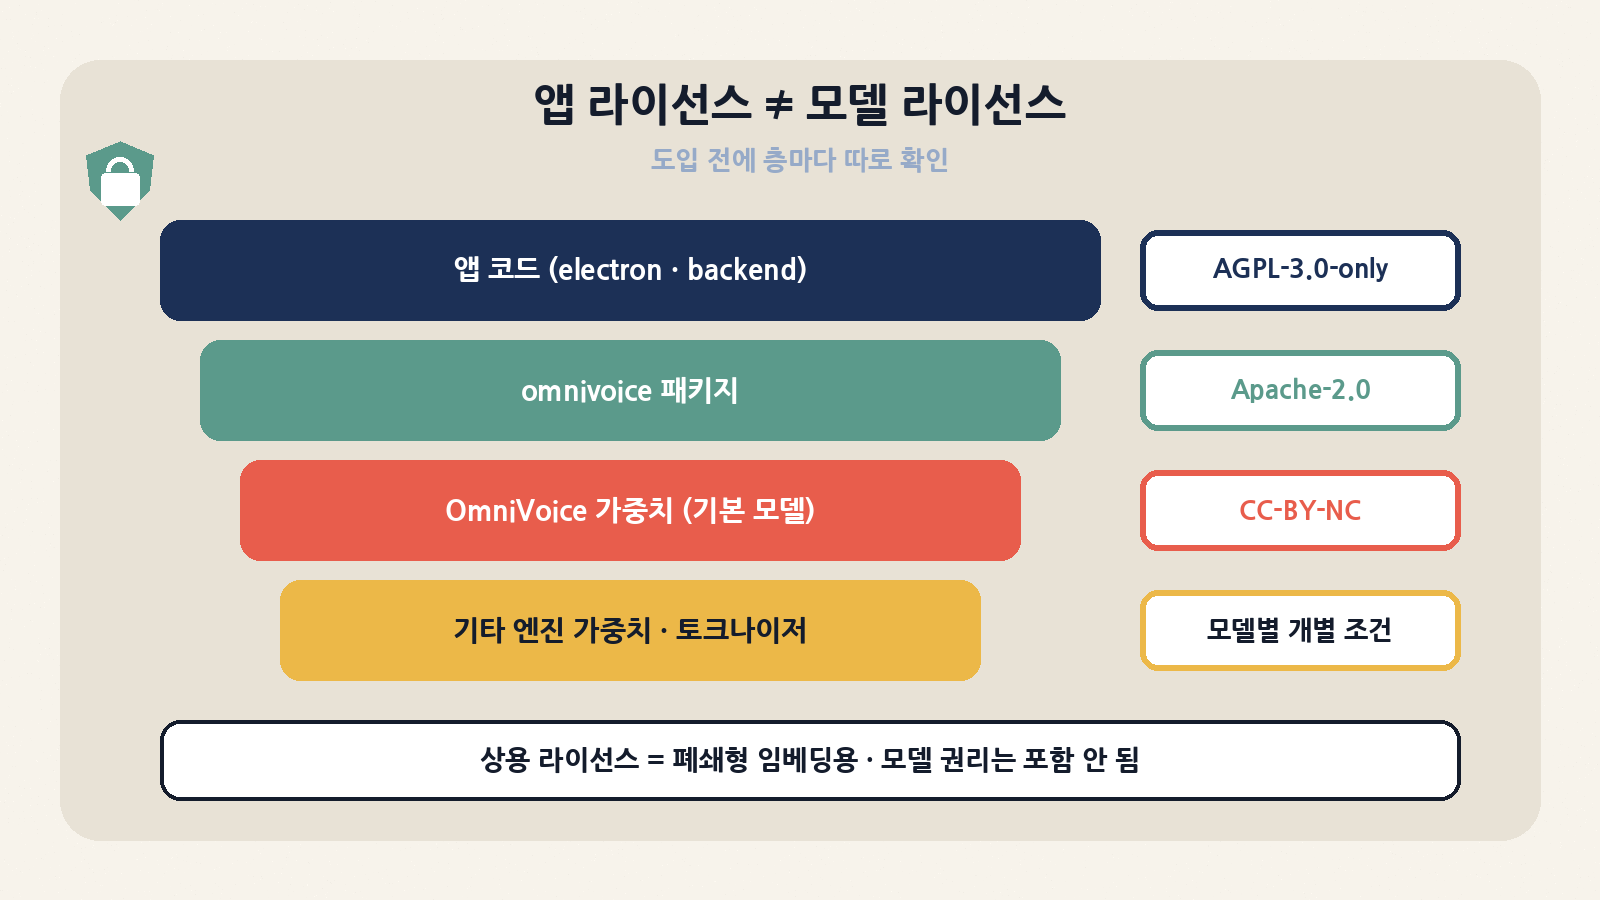
도입 검토에서 가장 오해하기 쉬운 부분입니다. LICENSE-NOTICE.md를 기준으로 정리하면, 앱 코드(electron, native, backend, scripts, deploy)는 AGPL-3.0-only이고 상업적·사내 사용도 AGPL 조건 아래 무료입니다. 단, 수정한 버전을 네트워크로 다른 사람에게 제공하면 그 사용자에게 전체 소스를 제공해야 합니다. 폐쇄형 제품·서비스에 넣고 싶은 조직을 위한 유료 상용 라이선스가 별도로 있고, 기여자는 CLA로 관리 회사(Yupcha Softwares Private Limited)에 권리를 부여합니다.
| 층위 | 조건 | 실무 해석 |
|---|---|---|
| 앱 코드 | AGPL-3.0-only (+ 유료 상용 라이선스 옵션) | 내부망에서 수정본을 웹 서비스로 제공해도 AGPL 네트워크 조항 적용 대상이 될 수 있음 |
omnivoice/ 패키지 |
Apache-2.0 (업스트림 저작자) | AGPL과 결합 가능 |
| 기본 OmniVoice 가중치 | 모델 카드 기준 CC-BY-NC(비상업) | 앱의 상용 라이선스로도 해소되지 않음. 상업 용도 생성물이면 다른 엔진·가중치 검토 필요 |
| 오디오 토크나이저 | Boson Higgs Audio 2, Meta Llama 커뮤니티 조건이 별도 포함 | About 패널 표기만으로 고지 의무 충족을 보장하지 않는다고 문서가 명시 |
| 기타 엔진 가중치 | 모델별 개별 조건(예: audio.cpp 가중치는 연구·비상업) | Model Manager의 버전별 고지 확인. ‘알 수 없음’은 허가가 아님 |
| 번들 바이너리 | PyAV 15.1.0 휠의 FFmpeg/x264/x265 | 재배포 요건이 미해결로 기록돼 있음(wheel audit 문서) |
main의 0.5.7 CHANGELOG에는 이 방향을 강화하는 변경이 이미 적혀 있습니다. 기본 OmniVoice를 포함해 상업 라이선스가 명확하지 않은 모델은 Model Catalogue에서 라이선스를 한 번 수락해야 하고, 그 전에는 API·MCP 요청이 라이선스 오류를 반환합니다(#2689). 또 원격 컴퓨트 디바이스·원격 워커·GPU 공유는 VoiceStudio Pro로 이동해 오픈소스 앱에서 빠졌다고 적혀 있습니다(#2748). 오픈코어 경계가 움직이고 있다는 신호이므로, 원격 GPU 구성을 전제로 도입하려던 팀은 특히 확인이 필요합니다.
대안과 비교
프로젝트 자체 문서(docs/competitive-analysis.md, 2026-06-11 작성, 수치는 당시 스냅샷)가 가장 직접적인 경쟁자로 꼽는 것은 voicebox이고, 더빙 사용자 기준으로는 pyvideotrans와 KrillinAI/KlicStudio를 함께 봅니다. 아래 비교는 그 문서와 각 저장소의 공개 라이선스를 바탕으로 한 정성적 비교이며, 품질·속도 우열 판단은 포함하지 않았습니다.
| 선택지 | 형태 | 라이선스 | 이럴 때 적합 |
|---|---|---|---|
| VoiceStudio | Electron + FastAPI, 다중 엔진, MCP·OpenAI 호환 API | AGPL-3.0 (+상용), 가중치 별도 | 클론·더빙·받아쓰기·오디오북을 한 도구로, 에이전트 연동까지 |
| voicebox (jamiepine) | 로컬 우선 보이스 스튜디오(Tauri + React + FastAPI) | MIT | 허용적 라이선스로 코드를 가져다 쓰고 싶을 때 |
| pyvideotrans | PySide6 데스크톱 영상 번역·더빙 파이프라인(GUI+CLI) | GPL-3.0 | 성숙한 영상 번역 파이프라인 위주 |
| KrillinAI / KlicStudio | Go, 데스크톱+웹+CLI, 에이전트 지향 | GPL-3.0 | 더빙 중심 + CLI 자동화 |
| ElevenLabs 등 클라우드 API | SaaS | 상용 약관 | 운영 부담 없이 품질·SLA가 필요할 때. 데이터가 외부로 나가는 것이 허용될 때 |
| 개별 모델 직접 운영(OmniVoice, CosyVoice 등) | 라이브러리/스크립트 | 모델별 | 단일 엔진만 서빙하면 되고 UI·파이프라인이 필요 없을 때 |
박스에서 직접 확인한 범위
과장을 피하려고, 이번 글을 쓰며 실제로 실행한 것과 하지 않은 것을 구분해 둡니다. Linux x86_64 박스(Python 3.13, uv, Bun 설치)에서 main 브랜치(커밋 36862c1, 2026-10-13 04:59 KST)를 얕은 클론했습니다.
| 점검 | 결과 | 해석 |
|---|---|---|
| 얕은 클론 | 성공, 작업 트리 약 121MB | uv.lock 1.8MB, CHANGELOG 369KB 등 문서·잠금 파일이 큼 |
python3 -m backend.speech_client --help |
정상 출력(capabilities, transcribe 하위 명령) | 표준 라이브러리만으로 동작하는 브리지라는 문서 설명과 일치 |
경량 pytest 일부 (test_app_version, test_no_hardcoded_cjk, test_locale_parity) |
576 통과, 1 실패 (약 3.8초) | 실패 1건은 omnivoice 패키지를 설치하지 않아 메타데이터가 없어서 생긴 예상된 실패 |
bin/omnivoice-tts-* |
저장소 안 파일은 0바이트 자리표시자 | GGUF 사이드카는 빌드 스크립트·릴리스 산출물로 공급되는 구조 |
| 실제 음성 합성·클론·더빙 | 실행하지 않음 | PyTorch·모델 가중치(수 GB) 설치와 GPU가 필요해 이번 점검 범위에서 제외 |
도입 전 체크리스트와 한계
| 주의점 | 내용 | 대응 |
|---|---|---|
| 가중치 라이선스 | 기본 모델 가중치가 CC-BY-NC | 상업 생성물이면 엔진 교체 또는 권리 확인을 먼저 |
| 음성 동의 | README: “Clone voices only with permission.” 앱이 동의를 검증하지는 않음 | 사내 동의서·보관 정책 마련, 워터마크 유지 |
| 설치 파일 신뢰 | Electron 설치 파일은 미서명 또는 ad-hoc 서명, Apple 공증 없음. macOS 자동 업데이트 미검증 | 사내 배포 시 해시(SHA256SUMS.txt) 검증, 수동 업데이트 |
| 원격 접근 | LAN 공유 PIN은 HTTP 평문, 로컬 프록시 경유 시 PIN 우회 | Tailscale/TLS + 프록시 인증, 0.5.7부터 호스트 이름은 OMNIVOICE_ALLOWED_HOSTS 필요 |
| 오픈코어 경계 | 0.5.7에서 원격 컴퓨트·GPU 공유가 Pro로 이동 | 필요 기능이 오픈소스 앱에 남아 있는지 버전별 확인 |
| 분석 데이터 | PostHog US 옵트인(첫 실행 동의, 기본 OFF), 저장소에 쓰기 전용 토큰 포함 | 정책상 불가하면 OMNIVOICE_ANALYTICS_DISABLED=1 |
| Docker 아키텍처 | linux/amd64 전용, ARM64 네이티브 이미지 없음 | Apple Silicon은 네이티브 앱 사용 |
| 벤치마크 부재 | 공식 결과 표가 비어 있음 | bench_pipeline.py로 자체 측정 후 결정 |
| 변경 속도 | 릴리스 후보 없이 main에서 바로 패치 태그(CLAUDE.md의 베타 정책) | 운영은 :stable/정확한 버전 고정, main은 검증용 |
누가 도입하면 좋을까
적합한 팀: 녹음·영상 원본을 외부 클라우드로 보낼 수 없는 미디어·교육·사내 콘텐츠 팀, 받아쓰기와 TTS를 에이전트(Claude Code, Codex 등)에 붙이고 싶은 개발 팀, 여러 오픈 음성 모델을 같은 UI·API로 비교 평가하려는 연구·PoC 팀입니다. 특히 MCP files 모드와 OpenAI 호환 전사 엔드포인트는 기존 자동화에 끼워 넣기 쉬운 형태입니다.
신중해야 할 팀: 생성 음성을 상업 콘텐츠로 내보내야 하는데 가중치 권리를 따로 확보하지 못한 경우, 수정본을 외부 고객용 웹 서비스로 제공하면서 AGPL 소스 공개를 원치 않는 경우(상용 라이선스 검토 필요), 서명·공증된 설치 파일과 SLA가 필수인 엔터프라이즈 데스크톱 환경입니다.
정리하면 VoiceStudio의 진짜 가치는 단일 모델의 품질보다 엔진 격리(사이드카 venv), 조용한 폴백을 금지하는 라우팅, 단일 포트의 음성 API·MCP라는 통합 설계에 있습니다. 반대로 가장 큰 리스크는 코드가 아니라 가중치 라이선스와 빠르게 움직이는 오픈코어 경계입니다. PoC는 :stable Docker나 데스크톱 앱으로 시작하고, 사내 동의를 받은 음성으로 bench_pipeline.py 수치와 블라인드 청취를 함께 기록한 뒤 결정하시길 권합니다.