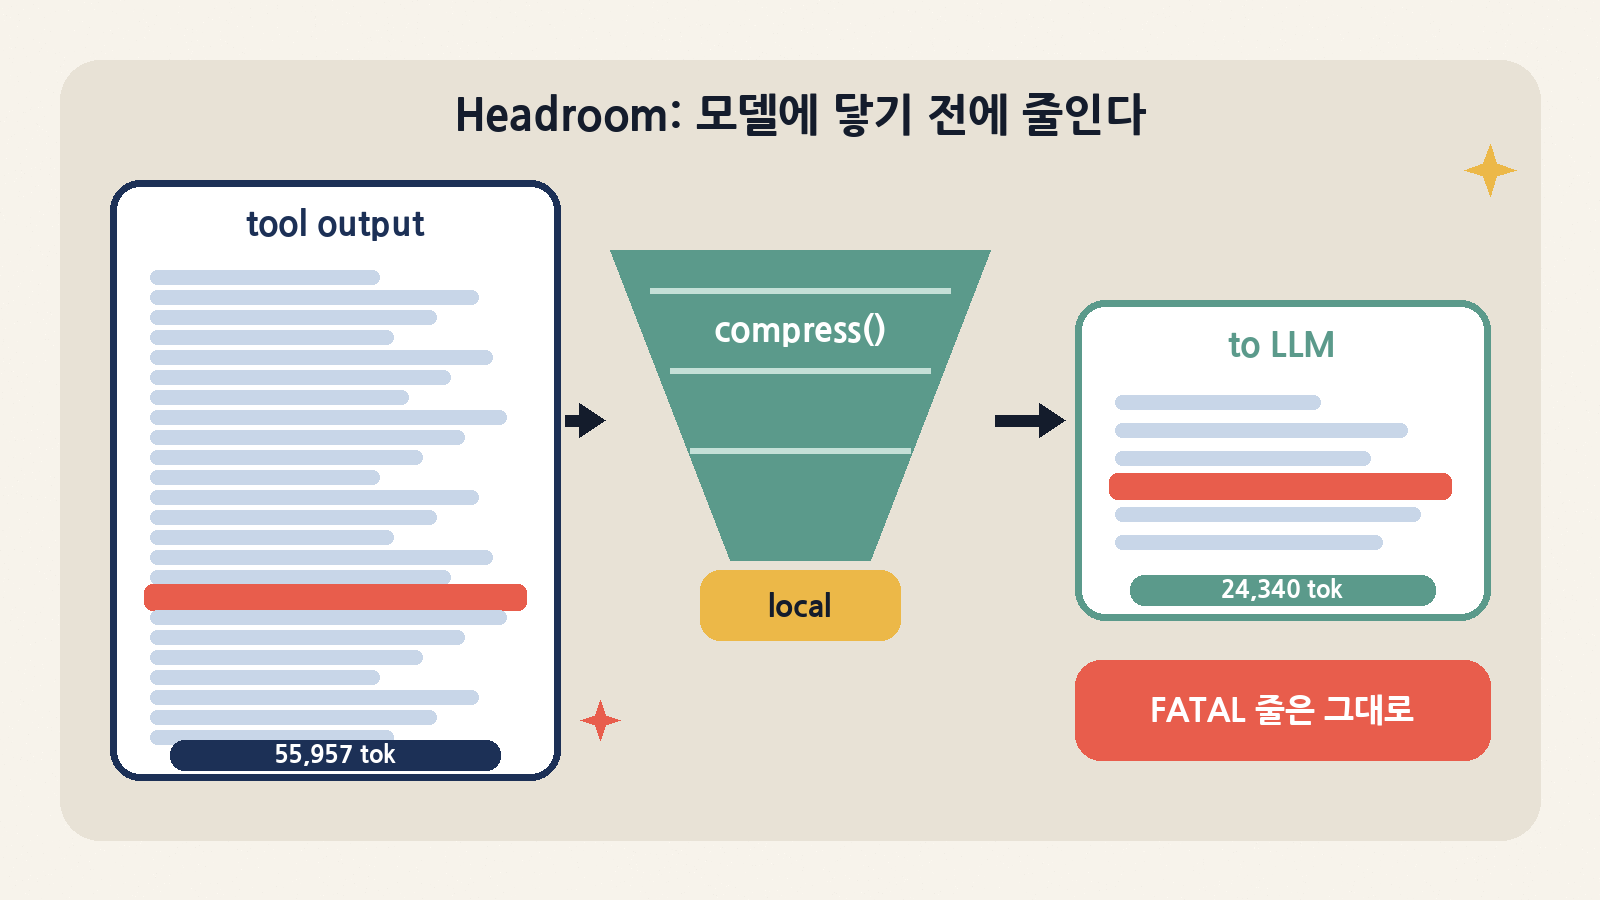
한 줄 요약: 코딩 에이전트가 쓰는 토큰의 대부분은 사람이 쓴 프롬프트가 아니라 에이전트가 읽어 들인 도구 출력·로그·검색 결과다. headroomlabs-ai/headroom은 그 덩어리를 모델에 보내기 직전, 내 컴퓨터 안에서 내용 종류에 맞게 줄이고, 원본은 따로 맡겨 두었다가 모델이 원하면 돌려준다. 오늘 GitHub Trending Python 일간 7위에 오른 이 프로젝트를 구조·설계 선택·운영 위험까지 뜯어봤다.
왜 지금 이 저장소인가
에이전트 세션이 길어질수록 비용 구조가 바뀐다. 파일을 읽고, grep을 돌리고, 테스트 로그를 붙이고, MCP 서버가 JSON 수백 건을 돌려준다. 이런 도구 출력은 반복이 많고, 대부분은 모델 판단에 쓰이지 않는다. 그런데 한 번 대화에 들어간 내용은 다음 턴마다 다시 실려 간다. Headroom의 출발점은 단순하다. 모델이 보기 전에 줄이되, 정답을 바꿀 만한 줄(오류·이상값·경계)은 남기고, 버린 것은 언제든 되찾을 수 있게 하자.
| 항목 | 확인한 값 (10/10 KST 기준) | 해석 |
|---|---|---|
| 저장소 | headroomlabs-ai/headroom (Python + Rust, Apache-2.0) |
2026년 1월 8일 공개. ‘AI 에이전트용 컨텍스트 압축 계층’을 표방한다 |
| 별 / 포크 | 74,864 / 5,805 (17:00 KST, GitHub API) | 오늘 GitHub Trending Python 일간 7위(오늘 +104). 열린 이슈+PR 448건 |
| 최신 릴리스 | v0.40.0 (10/6 12:06 KST) |
9/22 v0.38.0 → 9/26 v0.39.0 → 9/27 v0.39.1 → 10/6 v0.40.0. 아직 0.x이고 v0.40.0에도 ‘BREAKING CHANGES’ 항목이 두 개 있다 |
| main 상태 | HEAD 8c1beb2 (10/10 13:44 KST) |
릴리스 뒤에도 프록시·캐시 관련 수정이 매일 들어온다. CHANGELOG 맨 위 ‘Unreleased’ 칸에는 v0.40.0 코드에 이미 들어간 항목도 섞여 있어, 버전별 반영 여부는 코드로 확인해야 한다 |
| 코드 규모 (직접 집계, HEAD) | Python 약 24만 7천 줄(headroom/), Rust 약 9만 줄(crates/), 테스트 파일 1,018개 |
‘작은 유틸’이 아니라 프록시·SDK·CLI·대시보드까지 갖춘 큰 시스템이다 |
| 배포 형태 | PyPI headroom-ai(CLI 포함), npm headroom-ai(TS SDK만), Docker ghcr.io/headroomlabs-ai/headroom |
Python 3.10 이상. 리눅스·macOS·윈도용 휠에 Rust 확장이 미리 빌드돼 있다 |
| 텍스트 압축 모델 | Hugging Face chopratejas/kompress-v2-base (Apache-2.0, ModernBERT-base 기반) |
프로즈(일반 문장)는 이 ONNX 모델로 줄인다. 첫 실행 때 내려받는다 |
| 사업 구조 | OSS는 ‘노트북 한 대, 개발자 한 명’ 기준. 팀 기능은 Enterprise | 프롬프트 인젝션 탐지, 자동 모델 라우팅 등은 유료 쪽. 저장소 코드는 전부 Apache-2.0으로 남는다고 명시 |
이 글은 README, 저장소 안 문서(docs/content/docs/의 architecture·how-compression-works·ccr·cache-optimization·limitations·security-model·proxy), CHANGELOG와 v0.40.0 릴리스 노트, 그리고 박스에서 직접 설치·벤치·스모크·테스트한 결과를 바탕으로 썼다. 정확도 벤치(GSM8K 등)는 프로젝트가 공개한 값이며 다시 돌리지 않았다.
저장소 구조: Python 위의 얇은 껍데기, 무거운 일은 Rust
사용자가 만나는 진입점은 넷이다. 앱 안에서 부르는 compress() 라이브러리(Python·TypeScript), 기본 URL만 바꾸면 되는 headroom proxy, Claude Code·Codex·Cursor 같은 에이전트를 한 줄로 감싸는 headroom wrap, 그리고 MCP 서버다. 네 경로 모두 같은 파이프라인으로 들어간다. 압축기의 핵심(SmartCrusher, 검색·로그·diff 압축, 내용 감지)은 Rust로 짜서 PyO3 확장 headroom._core로 싣는다. Python 클래스는 API 호환용 껍데기다.
| 경로 | 역할 | 눈여겨볼 점 |
|---|---|---|
headroom/compress.py·client.py |
라이브러리 진입점 compress(messages, model=…), SDK 래퍼 |
결과 객체에 tokens_before/after/saved, transforms_applied가 붙어 무엇이 일어났는지 바로 보인다 |
headroom/transforms/ |
ContentRouter와 압축기들: smart_crusher, log/search/diff/code/config/html/tabular, kompress, cross_turn_dedup, read_lifecycle, cold_prefix 등 | 압축 로직의 거의 전부. 파일 이름만 봐도 ‘내용 종류별 전용 압축기’ 설계가 보인다 |
headroom/proxy/ |
FastAPI 프록시. Anthropic·OpenAI(Chat/Responses)·Gemini·Bedrock 핸들러 | CCR 도구 주입과 응답 가로채기는 프록시에만 있다. 라이브러리만 쓰면 이 루프가 없다 |
headroom/ccr/·cache/ |
Compress-Cache-Retrieve 저장소(SQLite/메모리), 마커 해석, 응답 핸들러 | 원본 보관과 회수. 프로세스 재시작에도 살아남도록 기본이 SQLite |
headroom/providers/ |
Claude·Codex·Copilot·Grok·Gemini 등 도구·제공자별 차이 | 공통 오케스트레이션과 제공자별 예외를 분리해 둔 구조 |
headroom/memory/·learn/ |
에이전트 간 공유 메모리, 실패 세션 분석(headroom learn) |
압축과 별개인 부가 기능. 기본은 꺼져 있다 |
crates/headroom-core |
Rust 코어: 토크나이저, CCR 저장소, 압축 정책, BM25, 변환기 | PyO3로 묶여 headroom._core가 된다. Python 클래스는 이 위의 얇은 껍데기 |
crates/headroom-proxy·parity·simulators |
Rust 프록시, Python↔Rust 동작 일치 검사, 시뮬레이터 | Python 구현을 Rust로 옮기면서 결과가 같은지 따로 검증하는 패리티 크레이트가 있다 |
benchmarks/ |
시드 고정 Proof 표, 지연 시간, CCR 회귀, 적대적·최악 사례 벤치 | README의 숫자를 누구나 다시 만들 수 있게 하려는 의도가 스크립트 주석에 적혀 있다 |
코드 양에서 보이듯 이 프로젝트는 ‘압축 알고리즘 라이브러리’보다 LLM 트래픽 중간자(man-in-the-middle) 제품에 가깝다. 제공자별 핸들러, 프롬프트 캐시 추적, 스트리밍 응답 처리, Copilot 토큰 교환, 대시보드와 비용 추적이 모두 들어 있다. CHANGELOG 대부분이 압축 품질보다 ‘프록시가 제공자 프로토콜의 미묘한 부분을 깨지 않게’ 하는 수정이라는 점도 그 성격을 보여 준다.
ContentRouter: 내용 종류마다 다른 압축기
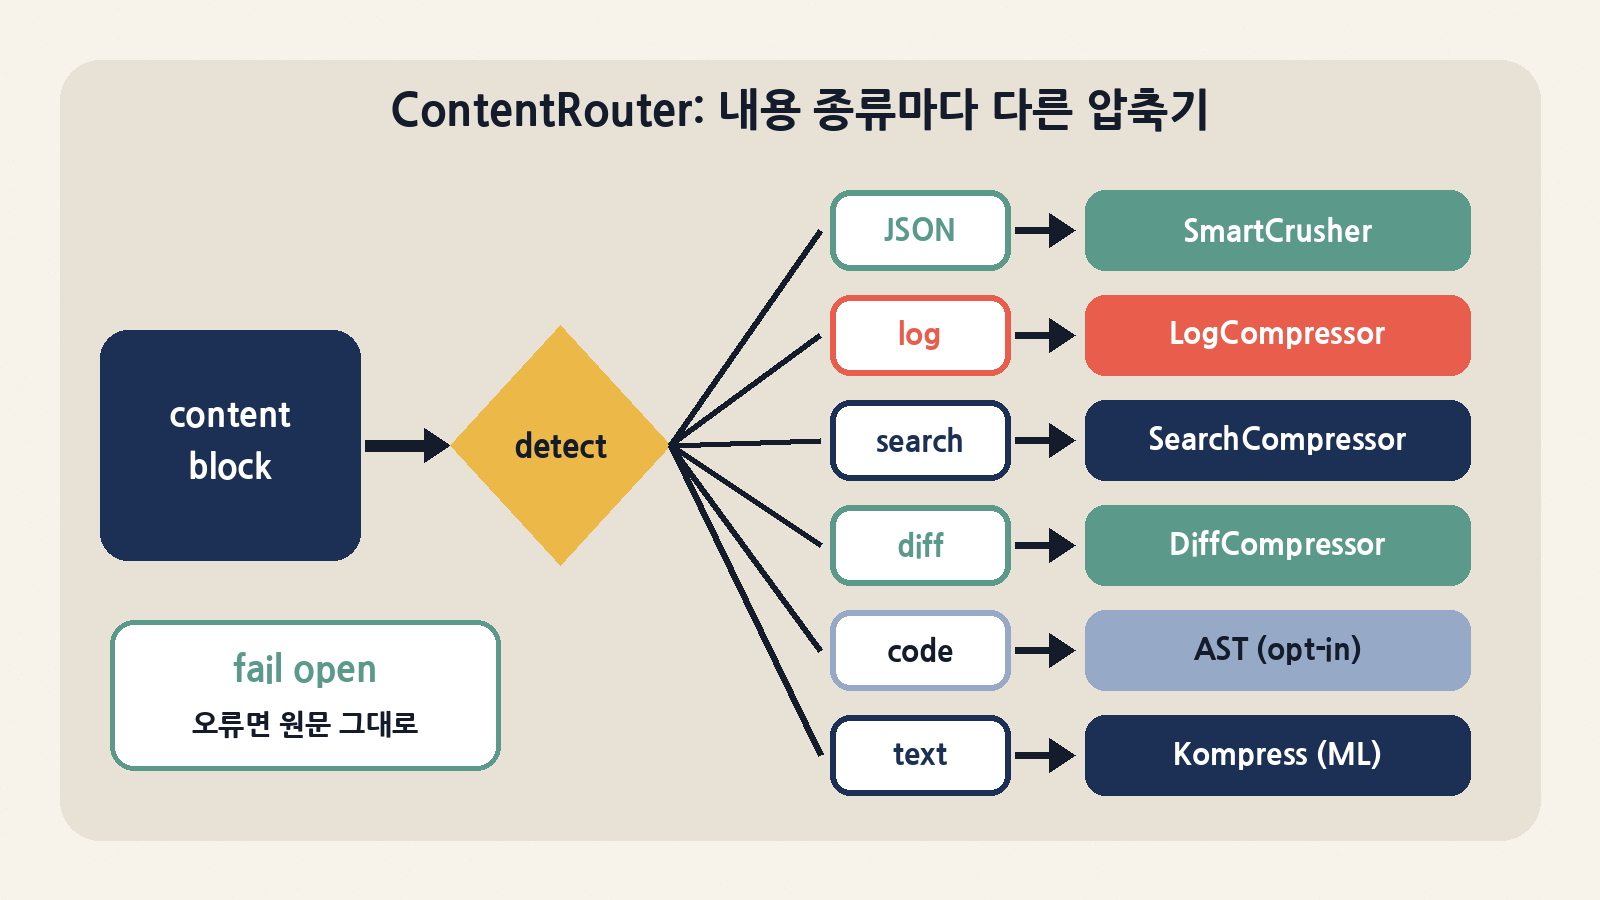
파이프라인은 짧다. 기본으로 꺼진 탐지기 CacheAligner, 그리고 사실상 모든 압축을 맡는 ContentRouter다. 라우터는 블록마다 내용 종류를 판별해 정확히 하나의 압축기로 보낸다. 같은 내용을 두 번 압축하지 않도록 ‘압축이 안 되는 내용’ 목록과 ‘이미 압축한 결과’를 30분 TTL 캐시로 들고 있다. 모든 단계는 오류가 나면 원문을 그대로 돌려주는 fail open 원칙을 따른다.
| 감지된 내용 | 압축기 | 문서상 절감 폭 | 메모 |
|---|---|---|---|
| JSON 배열 (도구 결과, API 응답) | SmartCrusher | 26~54% (중복 없는 실제형 배열), 반복이 많으면 훨씬 큼 | 핵심 사용처. 오류 항목·이상값·처음/끝은 예산과 무관하게 남긴다 |
| 빌드·테스트 로그 | LogCompressor | 85~95% | 로그 레벨과 반복 패턴을 보고 접는다 |
검색 결과 (file:line:content) |
SearchCompressor | 80~95% | 다른 문서(limitations)는 ‘검색 결과는 이미 촘촘해 압축 안 함’이라고 적어 서로 엇갈린다 |
| diff | DiffCompressor | 60~80% | 문맥 줄 수·파일당 헝크 수 상한으로 줄인다 |
| HTML | HTMLExtractor (trafilatura) | 70~90% | 내비게이션·광고·스크립트 제거 |
| YAML/TOML/INI | ConfigCompressor | 40~70% | 주석·빈 줄 위주 |
| 소스 코드 | CodeAwareCompressor (tree-sitter AST) | 작업마다 다름 | 라이브러리 경로는 기본 꺼짐. 최근 4개 메시지의 코드, ‘review·fix·debug’ 같은 분석 의도가 보이면 모든 코드를 보호 |
| 일반 문장 | Kompress (ModernBERT ONNX) | 작업마다 다름 | 모델이 없거나 못 받으면 압축하지 않고 그대로 보낸다 |
| git status 출력 | 무손실 통과 | 0% | 경로가 하나라도 빠지면 안 되는 구조화 출력이라 바이트 그대로 |
표의 ‘문서상 절감 폭’은 프로젝트 문서가 합성 데이터로 잰 값이다. limitations 문서는 이런 숫자가 반복 가능한 벤치가 아니라 ‘방향을 보여 주는 단일 측정’이라고 스스로 밝힌다. 이런 솔직함은 장점이지만, 문서끼리 어긋나는 곳도 있다. 검색 결과를 두고 한 문서는 80~95% 절감, 다른 문서는 ‘압축 안 함’이라고 적었다. 코드 압축의 프록시 기본값도 옵션 표는 ‘disabled’, 압축 원리 문서는 ‘프록시에선 기본 on’이라 적었다. 박스에서 띄운 v0.40.0 프록시 로그는 Code-Aware: LAZY (will load when code content detected)였다. 도입 전에는 문서보다 x-headroom-transforms 응답 헤더와 headroom inspect로 실제 동작을 확인하는 편이 안전하다.
SmartCrusher: ‘몇 개 남길까’를 정보량으로 정한다
가장 많이 쓰이는 압축기는 JSON 배열용 SmartCrusher다. 설계상 흥미로운 점은 두 가지다. 첫째, 무손실 접기를 먼저 시도한다. 박스 실험에서 300행짜리 JSON은 한 행도 버려지지 않고 [300]{id:int,latency_ms:int,…} 같은 스키마 한 줄과 CSV 행으로 바뀌어 58%가 줄었다. 키 이름이 300번 반복되던 부분만 사라진 것이다. 둘째, 손실 압축으로 넘어갈 때도 남길 개수를 고정하지 않는다.
| SmartCrusher 규칙 | 기본값 | 의미 |
|---|---|---|
분석 최소 항목 수 min_items_to_analyze |
5 | 이보다 짧은 배열은 그대로 |
최소 토큰 min_tokens_to_crush |
200 | 작은 JSON은 오버헤드가 이득보다 커서 건너뜀 |
남길 항목 상한 max_items_after_crush |
15 | 손실 압축으로 갈 때의 상한. 아래 ‘안전 보장’ 항목은 이 상한을 넘어도 남는다 |
| 적응형 K | Kneedle + SimHash + zlib 검증 | 몇 개를 남길지 고정값 대신 ‘정보가 더 늘지 않는 지점’에서 정한다. 앞 30%·뒤 15%·중요도 55%로 나눔 |
| 안전 보장 (항상 유지) | error·exception·failed·critical 포함 항목, 평균±2σ 밖의 수치·길이, 변화점 | variance_threshold=2.0. 낮출수록 더 많이 남긴다 |
| 중첩 깊이 | 5단계까지 | 그보다 깊은 배열은 보지 않는다 |
| 실패 시 | 원문 반환 | 잘못된 JSON, 결과가 더 커지는 경우, 의존성 누락 모두 경고 로그만 남기고 통과(fail open) |
| TOIN | 신뢰도 0.3 미만이면 무시 | 도구별로 어떤 필드가 다시 조회되는지 로컬에서 학습해 중요도 점수에 반영. 다른 사용자와 공유하지 않는다고 문서에 명시 |
‘오류는 무조건 남긴다’는 규칙은 키워드 목록(error, exception, failed, critical)에 기대고, ‘이상값’은 통계에 기댄다. 그래서 오류를 다른 단어로 표현하는 도구(예: status: "degraded")라면 손실 압축에서 빠질 수 있다. 이 빈틈을 메우는 장치가 다음에 볼 CCR이고, 반복 사용에서 배우는 TOIN이다.
CCR: 줄이되 버리지 않는다
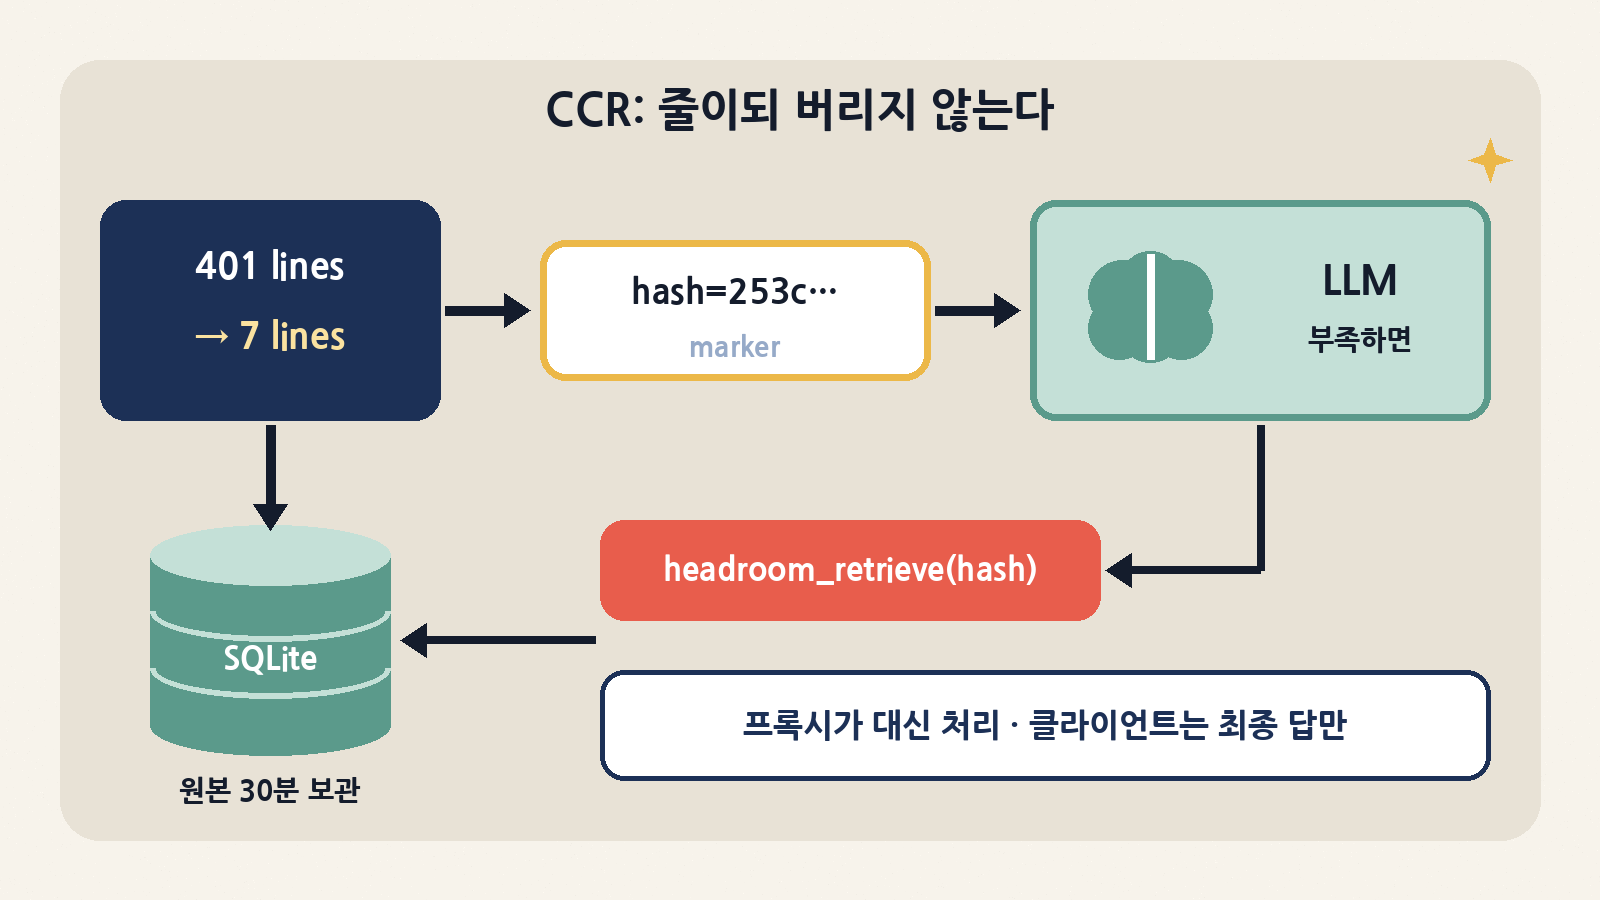
CCR(Compress-Cache-Retrieve)은 Headroom을 다른 프롬프트 압축 도구와 가르는 핵심이다. 손실 압축을 할 때 원본을 해시 키로 로컬 저장소에 넣고, 압축 결과 끝에 [401 lines compressed to 7. Retrieve more: hash=…] 같은 마커를 붙인다. 프록시는 요청에 headroom_retrieve 도구를 몰래 추가한다. 모델이 줄인 내용만으로 답할 수 있으면 그대로 끝나고, 부족하면 이 도구를 부른다. 그러면 프록시가 응답을 가로채 원본을 붙여 다시 업스트림에 보내고, 클라이언트는 최종 답만 받는다.
박스에서 이 루프를 그대로 확인했다. 직접 짠 가짜 OpenAI 호환 서버(마커를 보면 무조건 headroom_retrieve를 부르게 만든 스크립트)를 업스트림으로 두고 FATAL 한 줄이 섞인 401줄 로그를 보냈다. 1차 요청에서 업스트림이 받은 도구 결과는 518자였고 도구 목록에는 headroom_retrieve가 추가돼 있었다. 회수 호출 뒤 2차 요청에는 22,963자짜리 원본이 실려 갔다. 클라이언트 쪽에서는 업스트림 호출이 두 번이었다는 사실이 보이지 않았다.
여기서 읽어야 할 교환이 있다. CCR은 위험을 바꿀 뿐 절감률을 보장하지 않는다. 모델이 회수를 부르면 그 턴은 원본 전체에 왕복 한 번이 더 붙어 압축하지 않았을 때보다 비싸진다. CCR 문서도 ‘CCR은 위험을 바꾸지 절감 비율을 바꾸지 않는다’고 적었다. 또 이 자동 루프는 프록시 경로(Anthropic·OpenAI)에만 있다. 라이브러리 compress()만 쓰면 원본은 저장되지만 도구 주입과 회수 처리는 직접 구현해야 한다. Gemini 스트리밍 경로나 클라이언트 자체 함수 호출과 섞인 응답 같은 경계 사례도 문서에 따로 적혀 있다.
캐시 모드: 압축이 프롬프트 캐시를 깨면 손해다
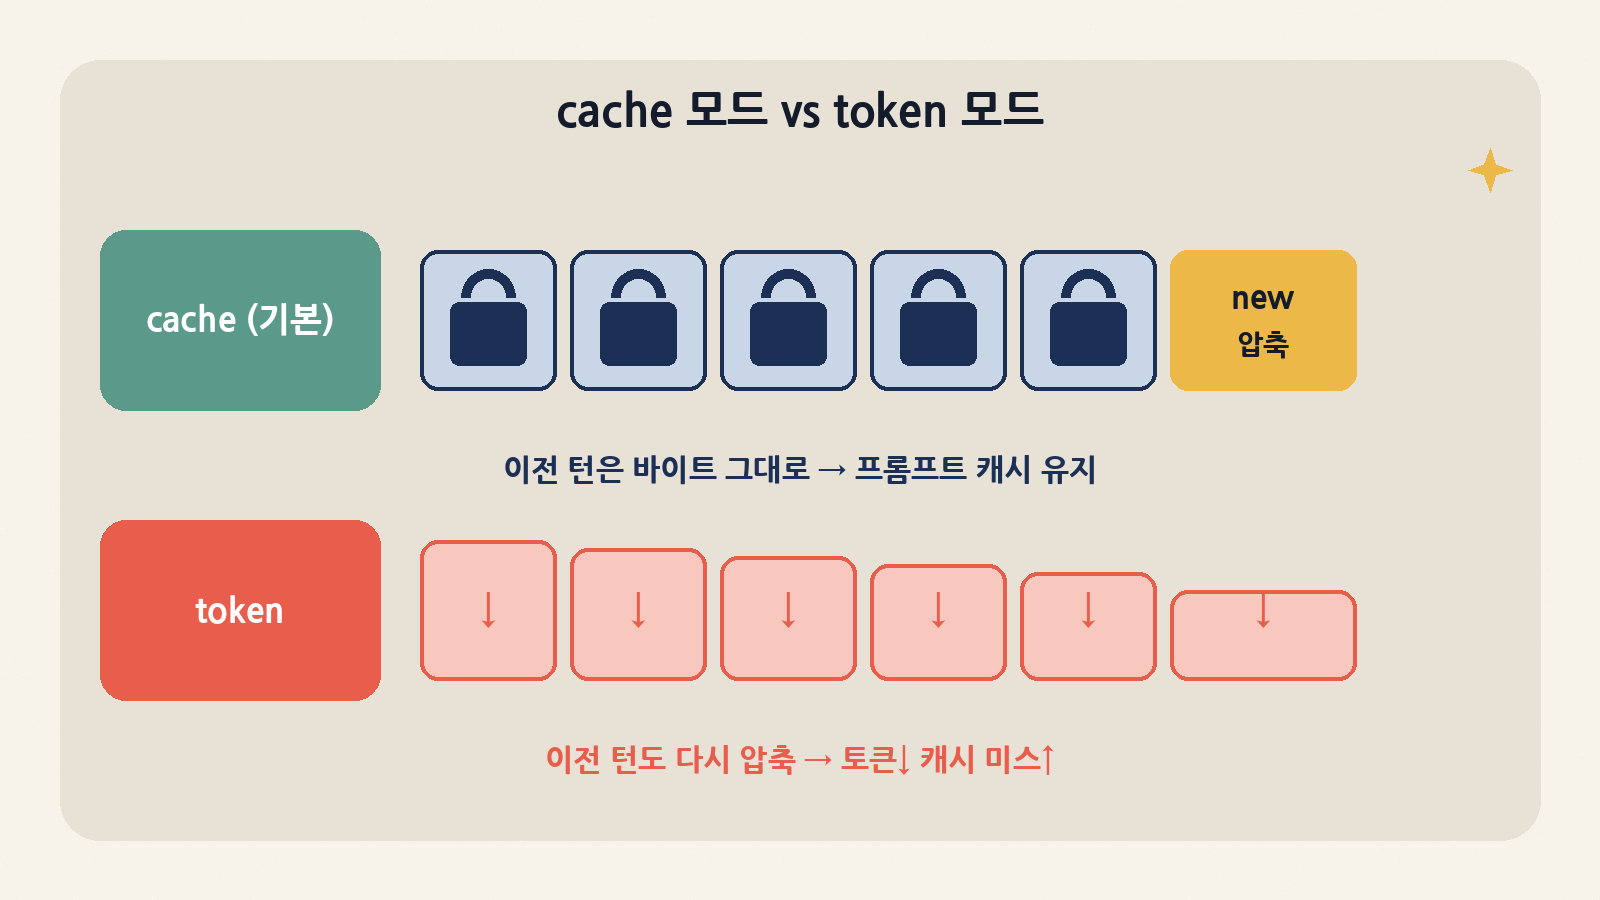
실무에서 가장 중요한 설계 결정은 여기 있다. Anthropic의 프롬프트 캐시는 캐시된 입력을 90% 싸게, OpenAI의 자동 접두어 캐시는 50% 싸게 처리한다. 둘 다 앞부분이 바이트 단위로 같아야 적중한다. 압축기가 이전 턴을 매번 조금씩 다르게 줄이면 토큰 수는 줄어도 캐시가 깨져 오히려 비용이 늘 수 있다. 그래서 Headroom 프록시의 기본은 --mode cache다. 이전 턴은 바이트 그대로 다시 보내고, 이번 턴에 새로 들어온 부분(live zone)만 압축한다. --mode token은 이전 턴까지 다시 압축해 토큰은 더 줄이지만 캐시 안정성을 포기한다.
프로필 (HEADROOM_SAVINGS_PROFILE) |
모드 | 목표 절감 | 성격 |
|---|---|---|---|
coding (기본, wrap이 씀) |
cache | ~50% (결과로 나오는 값) | 새로 들어온 델타만 압축, 이전 턴은 바이트 그대로. 파일 읽기 결과는 손실 압축하지 않음(protect_reads). 교차 턴 중복 제거와 도구 검색 켬 |
balanced |
token | ~70% | keep-ratio 0.3, 최근 4턴 보호. 무손실 경로 우선 |
general |
token | ~60% | 코드가 거의 없는 대화용. 사용자·시스템 메시지는 건드리지 않음 |
agent-90 |
token | ~90% | Kompress 강제, keep-ratio 0.10, 사용자·시스템 메시지까지 압축. 가장 공격적 |
이 문제가 얼마나 까다로운지는 CHANGELOG가 보여 준다. 최근 수정 항목 하나는, 세션 ID 헤더 없이 같은 시스템 프롬프트를 쓰는 Claude Code 본 세션과 병렬 서브에이전트들이 접두어 추적기 하나를 나눠 쓰는 바람에 캐시가 거의 매 턴 새로 쓰였다는 내용이다. 보고된 피해는 ‘캐시 생성 약 4.4배, 순비용 2.5~3배 증가’였다. Bedrock 백엔드에서는 추적기가 아예 갱신되지 않아 cache 모드가 매 턴 전체 통과(passthrough)로 돌았다는 수정도 있다. 두 항목은 CHANGELOG ‘Unreleased’ 칸에 적혀 있지만, 박스에 설치한 v0.40.0 코드에서 해당 변경(대화 계보별 추적기 max_lineages_per_session=32, Bedrock 스트리밍 경로의 추적기 갱신)이 이미 들어가 있는 것을 확인했다. 교훈은 버전과 무관하다. 압축 프록시는 버그 하나로 절감을 손해로 뒤집을 수 있다. 절감 대시보드만 보지 말고 제공자 청구서의 캐시 생성·캐시 읽기 토큰을 같이 봐야 한다.
캐시가 이미 식은 경우를 위한 장치도 있다. 세션이 제공자 캐시 TTL을 넘겨 놀았다면 접두어를 그대로 보낼 이유가 없으므로, ‘콜드 프리픽스’ 훅이 이때만 접두어 전체를 다시 압축한다. 판단이 틀리면 따뜻한 캐시를 깨기 때문에 기본은 꺼져 있다. 출력 쪽에는 시스템 프롬프트 끝에 ‘간결하게’ 지시를 붙이고, 도구 결과 뒤에 이어 가는 단순한 턴에서 추론 노력(reasoning effort)을 낮추는 Output Shaper가 있다. 역시 기본은 꺼짐이고, 절감치는 반사실 추정이라 ‘estimated’로 표시하거나 10% 대조군을 두어 ‘measured’로 바꾸게 했다.
설치·실행·평가
# CLI는 PyPI 패키지에만 있다 (npm은 TS SDK만)
uv tool install --python 3.13 "headroom-ai[all]"
headroom proxy --port 8787            # 기본: cache 모드, coding 프로필, CCR 켬
headroom wrap claude                  # 프록시 띄우고 에이전트를 그쪽으로 연결
headroom doctor                       # 라우팅 점검

# 텔레메트리 비콘은 기본 켜짐 - 끄려면
export HEADROOM_BEACON=off            # 또는 DO_NOT_TRACK=1, HEADROOM_OFFLINE=1

# 원본을 디스크에 남기지 않기 / TTL 늘리기
HEADROOM_CCR_BACKEND=memory headroom proxy
HEADROOM_CCR_TTL_SECONDS=7200 headroom proxy
from headroom import compress
r = compress(messages, model="gpt-4o")
print(r.tokens_before, r.tokens_after, r.transforms_applied)
# 예) 9267 246 ['router:protected:user_message', 'router:log:0.02']headroom wrap은 편하지만 내 환경을 꽤 바꾼다. 프록시를 띄우고, 코드 탐색용 MCP 서버 Serena를 (Claude Code라면 해당 프로젝트 범위로) 등록하고, 에이전트 설정을 프록시로 돌린다. 되돌리는 명령은 headroom unwrap <tool>이다. 처음에는 wrap보다 headroom proxy를 띄우고 기본 URL만 바꿔 보는 쪽이 변화 범위를 통제하기 쉽다.
README의 Proof 표는 네트워크나 API 키 없이 재현된다. 박스에서 돌린 결과가 README와 정확히 같았다.
| 시나리오 (시드 20260902, gpt-5.6 토크나이저) | 압축 전 | 압축 후 | 절감 |
|---|---|---|---|
| 코드 검색 결과 100건 | 17,199 | 13,597 | 21% |
| SRE 장애 디버깅 | 55,957 | 24,340 | 57% |
| 코드베이스 탐색 | 58,801 | 33,895 | 42% |
| GitHub 이슈 분류 | 46,067 | 32,429 | 30% |
| 합계 | 178,024 | 104,261 | 41% |
숫자를 읽는 법이 중요하다. 이 표는 토큰 수에 대한 진술이지 답의 품질에 대한 진술이 아니다. 시나리오도 실제 MCP 출력 형식을 흉내 낸 합성 데이터다. 정확도 쪽 근거로 프로젝트는 GSM8K·TruthfulQA·SQuAD v2·BFCL을 각 100문항으로 돌려 ‘차이 없음’을 보였는데, 스스로 N=100에서 ±0.03은 신뢰구간 안이라고 밝힌다. 그러니 ‘같은 답’은 입증이라기보다 ‘눈에 띄는 손상은 없었다’ 정도로 받아들이는 게 맞다. 지연 시간도 마찬가지다. 문서는 10K 토큰 JSON에 p50 0.21ms를 내세우지만, 박스 실험의 첫 호출은 초기화를 포함해 수백 ms가 걸렸고 프록시 로그의 압축 단계는 137ms였다. 첫 요청 비용과 정상 상태 비용을 나눠 재야 한다.
박스에서 직접 돌려 본 결과
실제 LLM 키는 쓰지 않았다. 대신 ① 휠 설치, ② 시드 고정 Proof 벤치, ③ 일부러 오류·이상값·FATAL 줄을 심은 데이터로 compress(), ④ 가짜 OpenAI 호환 업스트림을 둔 프록시 전체 경로, ⑤ 보안 가드 두 가지, ⑥ v0.40.0 태그의 핵심 테스트를 돌렸다. 모든 실험은 임시 HOME과 HEADROOM_BEACON=off·HEADROOM_OFFLINE=1로 바깥과 격리했다.
| 점검 항목 (박스: Linux x86_64 8코어, Python 3.13.5, 10/10 KST) | 결과 | 메모 |
|---|---|---|
uv pip install headroom-ai==0.40.0 |
성공. Rust 확장 _core.abi3.so 포함 휠 |
프록시는 [proxy] extra가 따로 필요했다. 기본 설치로 headroom proxy를 부르면 ‘Proxy dependencies not installed’로 멈춘다 |
benchmarks/index_proof_table.py --seed 20260902 |
README Proof 표 네 줄과 한 자리까지 같은 값 재현, 약 12초 | 네트워크·API 키 없이 토크나이저와 compress()만으로 계산된다 |
compress() – JSON 300행 (오류 1건, 지연 이상값 1건) |
10,855 → 4,570 토큰 (58% 절감) | 300행을 하나도 버리지 않고 ‘스키마 한 줄 + CSV 행’ 형태로 접었다. 오류 메시지·4800ms 이상값 모두 남음. CCR 마커 없음(무손실이라 필요 없음) |
compress() – 로그 401줄 (FATAL 1줄) |
9,267 → 246 토큰 (97% 절감), 54ms | FATAL 줄 포함 7줄만 남기고 [394 lines omitted …] 요약과 Retrieve more: hash=… 마커를 붙였다 |
compress() – 81토큰 짧은 문장 |
변화 없음 (바이트 동일) | 작은 블록은 건드리지 않는다는 문서 그대로 |
| CCR 저장소에서 해시로 원본 회수 | 22,469자 원본 그대로 복원 | 라이브러리 경로에서도 원본은 저장된다. 다만 모델 쪽 도구 주입·자동 회수는 프록시에만 있다 |
| 프록시 + 가짜 OpenAI 호환 업스트림 | 클라이언트는 최종 답 한 번만 받음. 업스트림 호출은 2회 | 1차 요청: 도구 결과 518자 + headroom_retrieve 도구 자동 주입. 가짜 모델이 회수를 호출하자 프록시가 원본(22,963자)을 붙여 2차 요청을 보냈다. 응답 헤더 x-headroom-tokens-before 9271 / after 250 |
x-headroom-base-url: http://169.254.169.254 |
무시하고 설정된 업스트림으로 전송 | 로그에 ‘ignoring unsafe x-headroom-base-url override’. 클라우드 메타데이터 SSRF 방어가 문서대로 동작 |
/v1/retrieve/stats에 Host: evil.example |
404 | 루프백 IP와 Host 헤더를 둘 다 본다(DNS 리바인딩 방어). 정상 요청은 200, 백엔드 sqlite, TTL 1800초 |
| Kompress 모델 (오프라인 모드) | 다운로드 거부 → 텍스트 ML 경로만 비활성, 프록시는 정상 | fail open 확인. 실제로 쓰려면 [ml] extra와 Hugging Face 접근이 필요하다 |
| v0.40.0 태그의 테스트 67개 파일 (ccr·compress·cache_aligner·content_router 등) | 1,116 통과 / 9 건너뜀 / 0 실패, 130초 | 태그 소스에 휠의 Rust 확장을 얹어 돌렸다. 전체 1천여 개 테스트 파일 중 압축·CCR 핵심부만 골랐다 |
2026-10-10T07:05:08Z INFO worker-0 heartbeat ok queue=0
2026-10-10T07:05:09Z INFO worker-1 heartbeat ok queue=0
2026-10-10T07:05:10Z INFO worker-2 heartbeat ok queue=0
2026-10-10T07:05:11Z FATAL worker-3 OOMKilled: container exceeded 2Gi
2026-10-10T07:05:11Z INFO worker-3 heartbeat ok queue=0
2026-10-10T07:05:12Z INFO worker-0 heartbeat ok queue=0
2026-10-10T07:05:13Z INFO worker-1 heartbeat ok queue=0
[394 lines omitted: 1 ERROR, 400 INFO]
[401 lines compressed to 7. Retrieve more: hash=253c1c683fb603712cb4bba8]
401줄 로그가 위 9줄로 바뀌었다. FATAL 줄은 앞뒤 문맥과 함께 남았고, 나머지는 개수 요약과 회수 마커로 접혔다. 요약에 적힌 수치(1 ERROR, 400 INFO)는 블록 전체 기준이라 ‘생략된 줄 394개’와 딱 맞지는 않는다. 사람이 읽기엔 헷갈릴 수 있지만 모델에게는 ‘이 안에 오류가 하나 있었고 그건 보여 줬다’는 신호로 충분하다. 실제 모델로 잰 품질·비용 변화는 이번에 측정하지 않았다.
위험·라이선스·운영 주의점
보안 문서(security-model.mdx)가 이례적으로 솔직하다. 첫 문단부터 ‘프록시는 에이전트 트래픽 전체를 평문으로 본다’, ‘같은 계정의 다른 프로세스로부터는 보호하지 않는다’, ‘멀티테넌트 호스트용이 아니다’라고 적는다. 압축하려면 읽어야 하니 당연한 일이지만, 도입 검토서에는 그대로 옮겨 적어야 할 문장이다.
| 저장 위치 | 내용 | 주의점 |
|---|---|---|
~/.headroom/ccr_store.db |
압축 전 원본(도구 출력·파일 내용) 평문 | 권한 0600. TTL 30분이지만 만료 삭제는 ‘다음 조회 때’ 일어나는 지연 방식이라 한가한 프록시에선 더 오래 남는다. HEADROOM_CCR_BACKEND=memory로 디스크 저장을 끌 수 있다 |
~/.headroom/settings.json |
대시보드 설정 59개, 그중 자격 증명 헤더 맵 2개 | 화면에선 가리지만 디스크엔 평문 |
~/.headroom/logs/proxy.log |
운영 로그 + 관리 API 감사 로그 | 항상 켜짐. 별도 권한 지정이 없어 umask 0002면 0664(다른 계정도 읽기 가능) |
--log-file + --log-messages |
요청·응답 전문 | 켜는 순간 프롬프트와 답이 평문 파일로 쌓인다. 설정 화면에서도 켤 수 있다 |
{cwd}/.headroom/memory.db |
--memory 사용 시 프로젝트별 메모리 |
작업 디렉터리마다 생겨 삭제 절차에서 빠뜨리기 쉽다 |
| 익명 비콘 | 토큰 합계·압축률·모델 ID·OS 등 집계값 | 기본 켜짐. 프롬프트·코드·경로는 보내지 않는다고 명시. HEADROOM_BEACON=off, DO_NOT_TRACK=1, HEADROOM_OFFLINE=1로 끈다 |
- 라이선스: 코드와 Kompress-v2-base 모델 모두 Apache-2.0. 상업적 사용·수정·재배포가 가능하다. 다만 팀 기능(자동 모델 라우팅, 프롬프트 인젝션 탐지, 중앙 설정)은 Enterprise 쪽이라 ‘OSS만으로 조직 표준 게이트웨이’를 만들려면 직접 메워야 할 부분이 있다.
- 로컬 관리 API:
/admin/*·/settings·/v1/retrieve*같은 민감 경로는 루프백 IP + Host 헤더 + (쓰기 경로는) Origin 검사를 거치고, 막힐 때는 403이 아니라 404를 돌려준다. 하지만--host 0.0.0.0으로 열거나 신뢰 CIDR 환경 변수를 설정하는 순간 경계가 바뀐다. 공유 서버에 띄우려면HEADROOM_PROXY_TOKEN을 반드시 걸자. - 업스트림 지정 헤더:
x-headroom-base-url로 요청마다 목적지를 바꿀 수 있다. 사설·루프백·링크 로컬 주소는 거부되고, 운영자가 넣은 자격 증명 헤더는 지정된 호스트에만 붙는다. 그래도 이 가드는 ‘누가 요청하는가’를 인증하지 않는다. - 요청 내용 속 지시문: 압축은 도구 출력에 숨은 프롬프트 인젝션을 지우지도, 막지도 않는다. 오히려 요약 과정에서 맥락이 줄어 판단이 어려워질 수 있다. 인젝션 탐지는 OSS 범위 밖이다.
- 빠른 변화: 0.x 버전이고 최근 한 달 사이 마이너 릴리스가 세 번(0.38·0.39·0.40) 나왔다. v0.40.0에도 Breaking 항목이 있다. 프록시는 하루 한 번 PyPI에서 새 버전을 확인한다(
HEADROOM_UPDATE_CHECK=off로 끔). 운영 환경에서는 버전을 고정하고, 올릴 때마다 Proof 벤치와 자체 트래픽headroom savings를 비교하자. - 효과가 작은 곳: 짧은 대화, 코드만 읽고 쓰는 세션(코드는 대부분 보호되어 통과), 이미 촘촘한 출력, 단일 턴 요청. 문서도 ‘도구 출력이 많은 긴 세션에서 효과가 난다’고 범위를 좁힌다.
대안과 비교
| 접근 | 무엇을 줄이나 | 강점 | 약점·주의 |
|---|---|---|---|
| Headroom (Apache-2.0) | 도구 출력·로그·JSON·파일·RAG 조각 (내용 종류별) | 로컬 실행, 가역(CCR), 캐시 보존 모드, 프록시·SDK·MCP·에이전트 래핑 | 프록시가 모든 트래픽을 평문으로 본다. 0.x라 변화가 빠르고 문서끼리 어긋나는 곳이 있다 |
| LLMLingua 계열 (Microsoft, MIT) | 프롬프트 텍스트의 토큰 삭제 | 연구 기반, 라이브러리로 단순 | 구조화 데이터(JSON·로그)에 특화돼 있지 않고 되돌릴 수 없다. Headroom도 예전 LLMLingua 연동을 걷어냈다 |
| 제공자 네이티브 압축·컴팩션 | 대화 히스토리 요약 | 설정 거의 없음, 모델 공급자가 품질 책임 | 제공자에 묶이고 로컬이 아니며 원문 회수 개념이 없다 |
| 호스티드 압축 API | API로 보낸 텍스트 | 운영 부담 없음 | 압축하려고 내용을 또 다른 외부 서비스로 보내야 한다 |
| 에이전트 하네스 자체 절단 (head/tail 자르기) | 긴 도구 출력 | 추가 의존성 0 | 중간에 있는 오류 한 줄을 그대로 잘라 버릴 수 있다. Headroom 데모의 ‘FATAL 줄 보존’이 정확히 이 차이를 겨냥한다 |
| LLM 게이트웨이 (LiteLLM 등) | 압축이 아니라 라우팅·비용 관리 | 다중 공급자·예산·로깅 | 경쟁이 아니라 결합 대상. Headroom은 LiteLLM 콜백·백엔드를 공식 지원한다 |
정리하면 Headroom의 차별점은 압축률 자체보다 세 가지 설계의 조합이다. 내용 종류별 전용 압축기, 버린 것을 되찾는 CCR, 그리고 제공자 프롬프트 캐시를 깨지 않는 cache 모드. 어느 하나만 있으면 흔한 도구지만, 셋이 함께 있어야 ‘토큰은 줄었는데 답이 틀리거나 청구서는 늘었다’는 두 가지 실패를 동시에 피할 수 있다.
누가 도입하면 좋은가
- 도구 출력이 많은 긴 에이전트 세션을 매일 돌리는 팀: SRE 로그 분석, 대량 MCP JSON, 테스트 로그를 반복해서 붙이는 워크플로가 가장 큰 수혜자다.
- 여러 에이전트·여러 공급자를 섞어 쓰는 개인·소규모 팀: 프록시 하나로 Claude Code·Codex·Cursor 트래픽을 같은 방식으로 다룰 수 있다.
- 자체 에이전트를 만드는 개발자: 프록시 대신
compress()만 가져다 도구 결과 전처리기로 써도 된다. 이 경우 CCR 회수 루프는 직접 붙여야 한다. - 신중할 경우: 여러 사용자가 한 호스트를 공유하는 환경(문서가 직접 비권장), 트래픽이 디스크에 평문으로 남으면 안 되는 규제 환경(
memory백엔드·--stateless·로그 권한 점검이 선행돼야 한다), 그리고 청구서로 캐시 적중률을 검증할 여력이 없는 팀(위에서 본 캐시 추적 버그 같은 일이 생겨도 알아채기 어렵다).
평가 방법은 이렇게 권한다. 일주일치 실제 에이전트 세션을 고른 뒤 같은 작업을 ① 프록시 없이, ② --no-optimize 통과 모드, ③ 기본 coding 프로필로 나란히 돌린다. 비교할 값은 셋이다. 제공자 청구 기준의 입력·캐시 생성·캐시 읽기 토큰, 작업 성공률(테스트 통과, 사람이 인정한 답), 그리고 headroom_retrieve 호출 빈도다. 회수가 잦다면 그 도구는 압축이 과한 것이니 variance_threshold를 낮추거나 해당 도구를 제외하면 된다.
Headroom이 던지는 메시지는 이것이다. 에이전트 비용을 줄이는 가장 싼 방법은 모델을 바꾸는 게 아니라, 모델이 읽지 않아도 될 것을 읽히지 않는 것이다. 다만 그 일을 하는 프록시는 모든 대화를 들여다보는 위치에 선다. 절감 효과와 함께 그 위치의 무게까지 따져 보고 들이자.