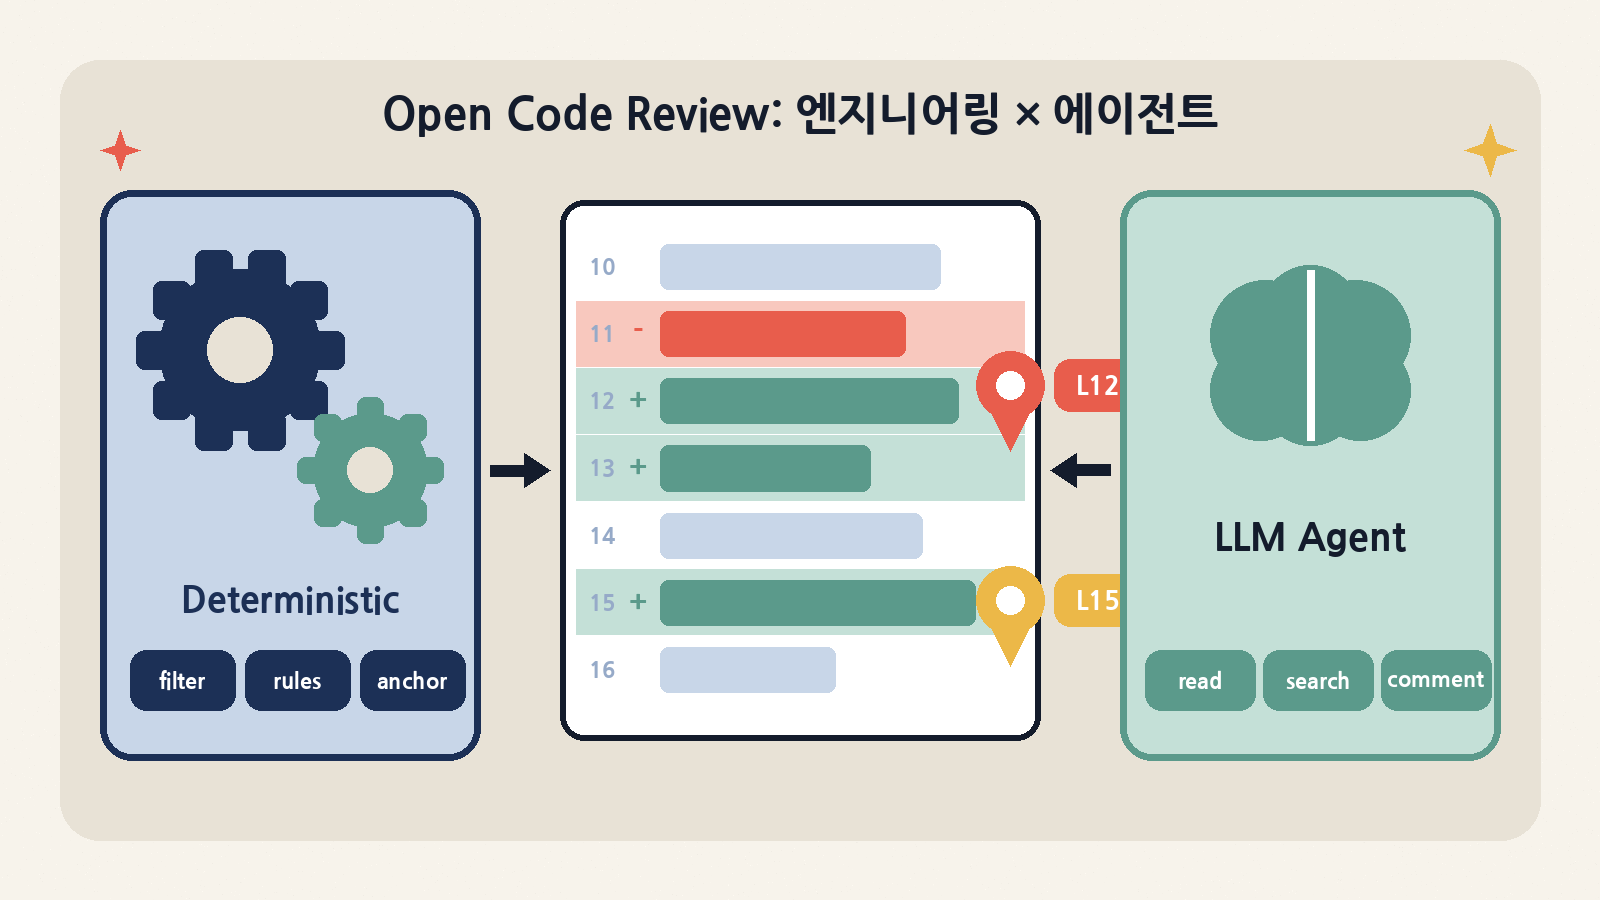
한 줄 요약: 알리바바가 사내에서 2년간 굴렸다는 AI 코드 리뷰 CLI를 오픈소스로 내놨다. 핵심은 ‘에이전트에게 다 맡기지 않는다’는 것이다. 어떤 파일을 볼지, 어떤 규칙을 줄지, 코멘트를 몇 번째 줄에 붙일지는 코드가 정하고, LLM은 그 울타리 안에서 읽고 판단만 한다. 오늘 GitHub Trending 전체 일간 5위, Go 일간 1위에 오른 alibaba/open-code-review를 실무 관점에서 뜯어봤다.
왜 지금 이 저장소인가
AI 코드 리뷰는 이미 흔하다. 문제는 품질이 들쭉날쭉하다는 점이다. Open Code Review(이하 OCR) README는 범용 에이전트에 리뷰 스킬을 얹었을 때 생기는 문제를 세 가지로 정리한다. 변경이 크면 일부 파일만 보고 넘어가는 커버리지 누락, 지적한 줄 번호가 실제 코드와 어긋나는 위치 어긋남, 프롬프트를 조금만 바꿔도 결과가 흔들리는 품질 불안정이다. 원인은 ‘리뷰 과정에 단단한 제약이 없다’는 것. OCR은 그 제약을 프롬프트가 아니라 코드로 건다.
| 항목 | 확인한 값 (10/10 KST 기준) | 해석 |
|---|---|---|
| 저장소 | alibaba/open-code-review (Go, Apache-2.0, Copyright 2026 Alibaba) |
2026년 5월 18일 공개. README는 ‘알리바바 그룹 사내 공식 AI 코드 리뷰 도우미로 2년간 수만 명의 개발자가 썼다’고 소개한다 |
| 별 / 포크 | 45,335 / 3,270 (11:58 KST, GitHub API) | 같은 시각 GitHub Trending 전체 일간 5위(오늘 +326), Go 카테고리 일간 1위 |
| 최신 릴리스 | v1.12.13 (10/8 21:05 KST) |
9월 21일 v1.12.8부터 10월 8일까지 릴리스가 여섯 번 나왔다. 패치 버전이 며칠 간격으로 올라간다 |
| main 상태 | HEAD 35fc3e2 (10/10 09:55 KST) |
같은 날 아침에도 테스트·문서 커밋이 들어왔다. 열린 이슈+PR 283건 |
| 코드 규모 (직접 집계) | Go 약 11만 3천 줄, 그중 테스트 파일 약 7만 7천 줄 | 테스트 코드가 본체보다 많다. AGENTS.md는 커버리지 90% 하한을 CI 조건으로 건다 |
| 배포 형태 | npm @alibaba-group/open-code-review, 설치 스크립트, 릴리스 바이너리, 소스 빌드 |
실행 파일 이름은 ocr. Git 2.41 이상이 필수다 |
| 확장 | Claude Code·Codex·Cursor·Kimi Code·OpenCode 플러그인, VS Code·IntelliJ 확장, GitHub Action, GitLab CI 레시피 | CLI가 본체이고 나머지는 CLI를 부르는 껍데기라는 구조가 일관된다 |
이 글은 README, 저장소 안 문서(pages/src/content/docs/en/의 architecture·tools·review-rules·delegate·ci·faq), 보안 보증 문서(ASSURANCE_CASE.md), 릴리스 노트, 그리고 박스에서 직접 빌드·테스트·스모크한 결과를 바탕으로 썼다. 벤치마크 수치는 프로젝트가 스스로 공개한 것이고, 따로 재현하지 않았다.
저장소 구조: CLI 하나, 내부 패키지 열여덟 개
Go 모듈 github.com/alibaba/open-code-review 하나에 진입점은 cmd/opencodereview뿐이다. 나머지는 모두 internal/ 아래에 있어 외부에서 라이브러리로 가져다 쓸 수 없다. 에이전트 플러그인과 GitHub Action·GitLab 레시피는 이 CLI(ocr)를 불러 쓰는 구조다. 통합 지점이 늘어도 리뷰 로직은 한 곳에 모여 있다.
| 패키지 | 역할 | 눈여겨볼 점 |
|---|---|---|
cmd/opencodereview |
Cobra 기반 CLI. review·scan·delegate·rules·session·viewer·config·llm 하위 명령 | SARIF 변환(sarif.go)과 출력 포맷이 여기 있다 |
internal/agent |
오케스트레이션. Agent.Run → dispatchSubtasks, 파일 선택(selection.go), 의미 그룹핑(grouping.go) |
리뷰 품질을 좌우하는 ‘결정적’ 단계 대부분이 이 패키지에 몰려 있다 |
internal/llmloop |
도구 호출 루프, 메모리 압축, 코멘트 워커 풀, 도구 실패 연속 감지 | 루프 종료 조건 다섯 가지가 코드로 박혀 있다 |
internal/diff |
git diff 파싱, 따옴표 경로, 헝크, 줄 번호 재계산(resolver.go), 재배치(relocation.go) |
‘코멘트가 엉뚱한 줄에 붙는’ 문제를 푸는 핵심 |
internal/tool |
모델이 부르는 도구 6종 구현 | 모두 읽기 전용이거나 코멘트 수집뿐. 파일을 고치거나 셸을 여는 도구가 없다 |
internal/config |
규칙(rules), 프롬프트 템플릿(template), 도구 정의(toolsconfig), 확장자 허용 목록(allowlist) | 언어별 규칙 문서 54개가 rule_docs/에 마크다운으로 들어 있다 |
internal/llm |
OpenAI·OpenAI Responses·Anthropic·Bedrock 프로토콜, 공급자 프리셋, 재시도, 토큰 계산 | 내장 공급자 프리셋 24종(문서 표 기준). 임베디드 BPE로 오프라인 토큰 계산 |
internal/session·viewer |
JSONL 세션 기록, 재개(resume), 로컬 웹 뷰어 | DB 없이 추가 전용 로그. 뷰어는 Host 헤더 허용 목록으로 DNS 리바인딩을 막는다 |
internal/mcp·telemetry |
외부 MCP 서버 도구 연결, OpenTelemetry 스팬·메트릭 | 프롬프트·응답 본문은 텔레메트리에 붙지 않는다고 문서에 명시 |
코드 기여 규칙도 독특하다. AGENTS.md는 AI로 쓴 PR이면 사용한 도구·모델을 밝히라고 요구하고, 커밋 트레일러에 AI를 공동 저자로 올리지 말라고 못박는다. 커밋 전에는 ocr review --audience agent로 자기 자신을 리뷰하라고 적어 뒀다. 소스 파일 전체에 SPDX 라이선스 헤더와 ‘영어만’ 검사(make english-check)가 걸려 있다.
파이프라인: 결정적인 단계와 판단하는 단계를 나눈다
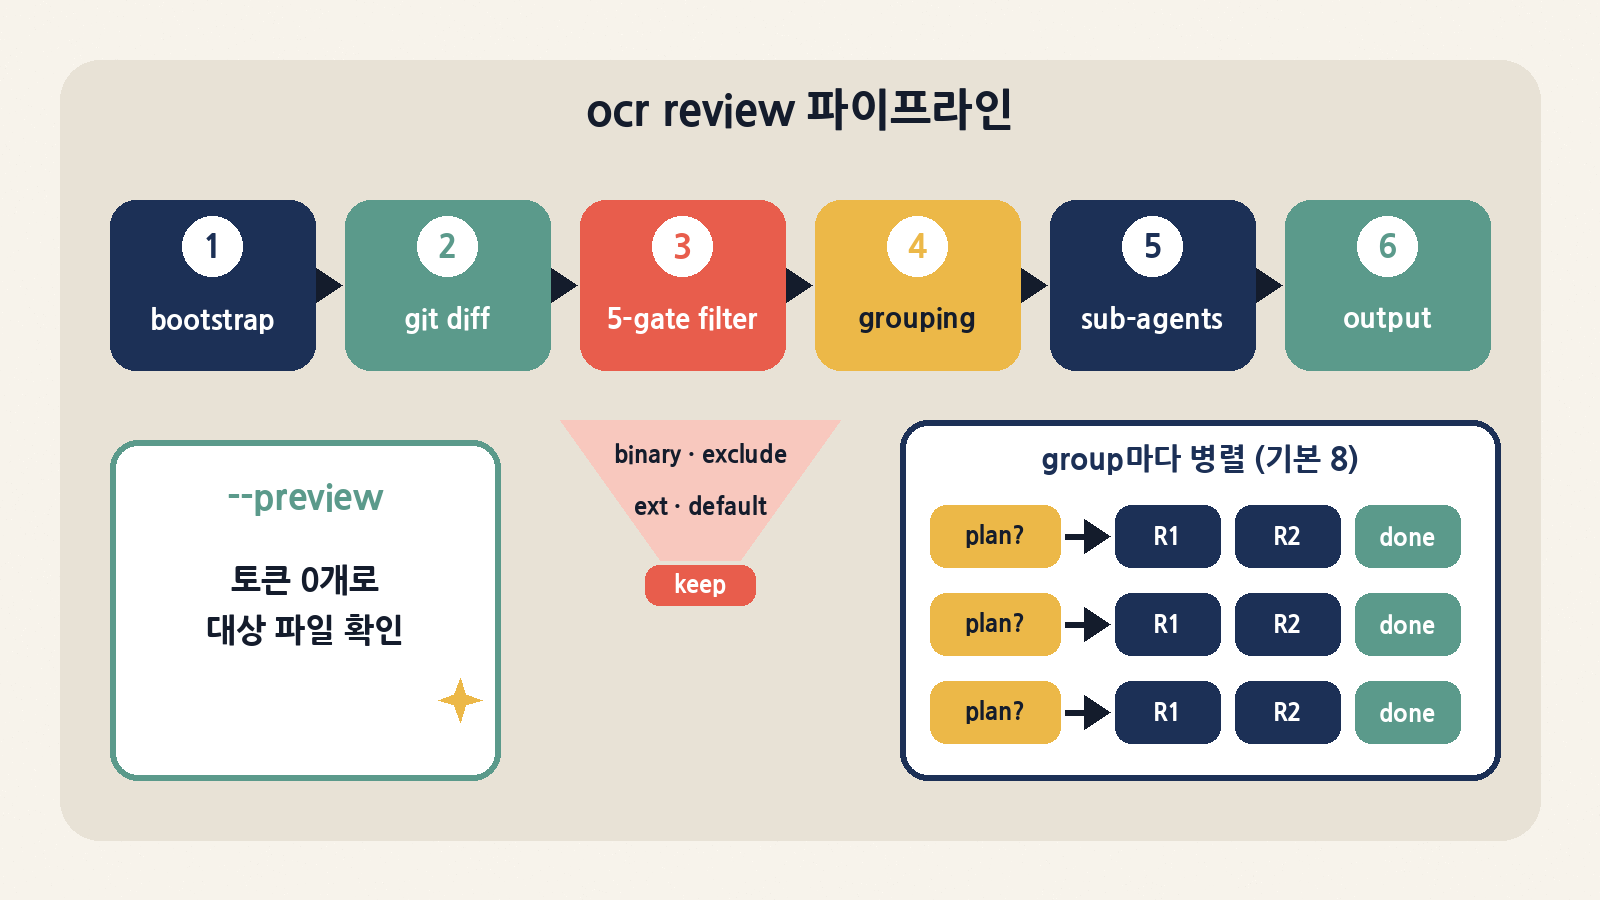
ocr review를 누르면 여섯 단계를 지난다. ① 부트스트랩: 설정 → 환경 변수 → rc 파일 순으로 LLM 엔드포인트를 찾고, 템플릿·도구 레지스트리·시스템 규칙을 싣는다. ② diff 공급자: Workspace(스테이징·미스테이징·추적 안 된 파일), Commit(--commit), Range(merge-base(a,b)..b) 세 모드 가운데 하나로 []model.Diff를 만든다. 문맥 줄 수는 Git 기본값과 같은 3줄로 고정이다. ③ 5단계 파일 필터와 파일별 규칙 매칭. ④ 의미 그룹핑. ⑤ 그룹마다 서브 에이전트를 병렬(기본 8)로 띄운다. ⑥ 줄 번호 확정과 필터를 거쳐 text·JSON·SARIF로 출력한다.
| 단계 | 규칙 | 숫자·기본값 |
|---|---|---|
| 1. binary | 바이너리 파일 제외 | 가장 먼저 적용 |
| 2. user_exclude | 사용자 exclude 패턴. 언제나 이긴다 |
--exclude와 rule.json이 합쳐진다 |
| 3. user_include | include에 걸리면 아래 두 관문을 건너뛰고 통과 |
화이트리스트가 아니라 ‘기본 제외 우회’ 장치 |
| 4. unsupported_ext | 확장자 허용 목록에 없으면 제외 | .xyz 같은 미지원 확장자 |
| 5. default_path | 테스트 파일(**/*_test.go, __tests__ 등)과 의존성·빌드 산출물 디렉터리 |
루트의 vendor/·node_modules/는 이보다 앞선 diff 공급자 단계에서 이미 빠진다 |
| 뒤처리 | 삭제 파일, diff만으로 프롬프트 한도 80%를 넘는 파일 | deleted, too_large |
| 의미 그룹핑 | 파일 4개 이상이면 메타데이터(경로·상태·증감 줄 수)만 LLM에 보내 묶음을 받는다 | GROUPING_MIN_FILES=4, 그룹당 최대 10파일 |
| 소규모 변경 | 4개 미만이면 LLM 호출 없이 결정. 총 변경 200줄 미만이면 한 그룹으로 묶음 | GROUPING_BUNDLE_LINE_THRESHOLD=200, 라벨 small change set |
여기서 가장 실용적인 기능은 --preview다. 토큰을 하나도 쓰지 않고 어떤 파일이 왜 빠지는지 보여 준다. ‘이 파일은 왜 리뷰가 안 됐지?’라는 질문을 LLM 로그를 뒤지지 않고 풀 수 있다. 그룹핑도 설계가 조심스럽다. LLM에는 diff 본문 없이 경로·상태·증감 줄 수만 보내고, 응답도 경로 대신 정수 인덱스로 받아 출력 토큰을 아낀다. 응답이 깨지거나 비면 경고만 남기고 파일당 한 그룹으로 돌아간다. 그룹핑은 최적화일 뿐 정확성을 좌우하지 않는다는 원칙이다.
서브 에이전트: Plan은 선택, Main은 여러 라운드
그룹마다 뜨는 서브 에이전트는 메시지 버퍼를 따로 갖는다. 변경이 크면 먼저 Plan 단계에서 도구 없이 LLM을 한 번 불러 체크리스트를 받는다. 이때 읽기 전용 도구 세 개의 정의는 실제 도구가 아니라 텍스트로만 넣는다. 계획 단계에서 모델이 도구를 부르는 일 자체를 막는 것이다. 이어지는 Main 루프에서 모델은 여섯 도구를 쓴다.
| 도구 | Plan | Main | 하는 일 |
|---|---|---|---|
task_done |
✗ | ✓ | 루프 종료 신호 |
code_comment |
✗ | ✓ | 코멘트 배열 제출. existing_code로 위치를 잡는다 |
file_read |
✗ | ✓ | 변경 후 파일의 줄 범위 읽기. 호출당 최대 500줄 |
file_read_diff |
✓ | ✓ | 같은 변경 세트의 다른 파일 diff 읽기 |
file_find |
✓ | ✓ | 경로 부분 문자열로 파일 찾기. 최대 100건 |
code_search |
✓ | ✓ | git grep 기반 검색. 파일당 최대 100건, PCRE 선택 가능 |
도구 목록이 곧 보안 경계다. 파일을 쓰거나 셸을 여는 도구가 하나도 없다. 맥락용 도구로 다른 파일을 읽다가 문제를 봐도 코멘트 대상은 ‘지금 맡은 diff’로 제한된다고 프롬프트에 박혀 있다. 그룹 간 교차 지적이 사라지는 대신 결과가 그룹 단위로 결정적이고 비용이 예측 가능해진다. --tools로 JSON 도구 정의를 바꿔 특정 도구를 끄거나 설명을 고칠 수는 있지만, 새 도구 이름을 추가하려면 Go 코드를 고쳐야 한다.
Main 루프는 --effort에 따라 1~3라운드를 돈다. 2라운드부터는 앞서 확정된 코멘트를 {{confirmed_comments}}로 넣고 Plan은 뺀다. 문서 표현으로는 ‘계획이 일단 뻔한 문제를 찾고 나면 커버리지의 천장 역할을 한다’는 이유다. 재현율을 올리려고 라운드를 늘리되, 같은 계획에 갇히지 않게 한 장치다.
코멘트 한 줄의 여정: 위치 잡기와 반성 필터
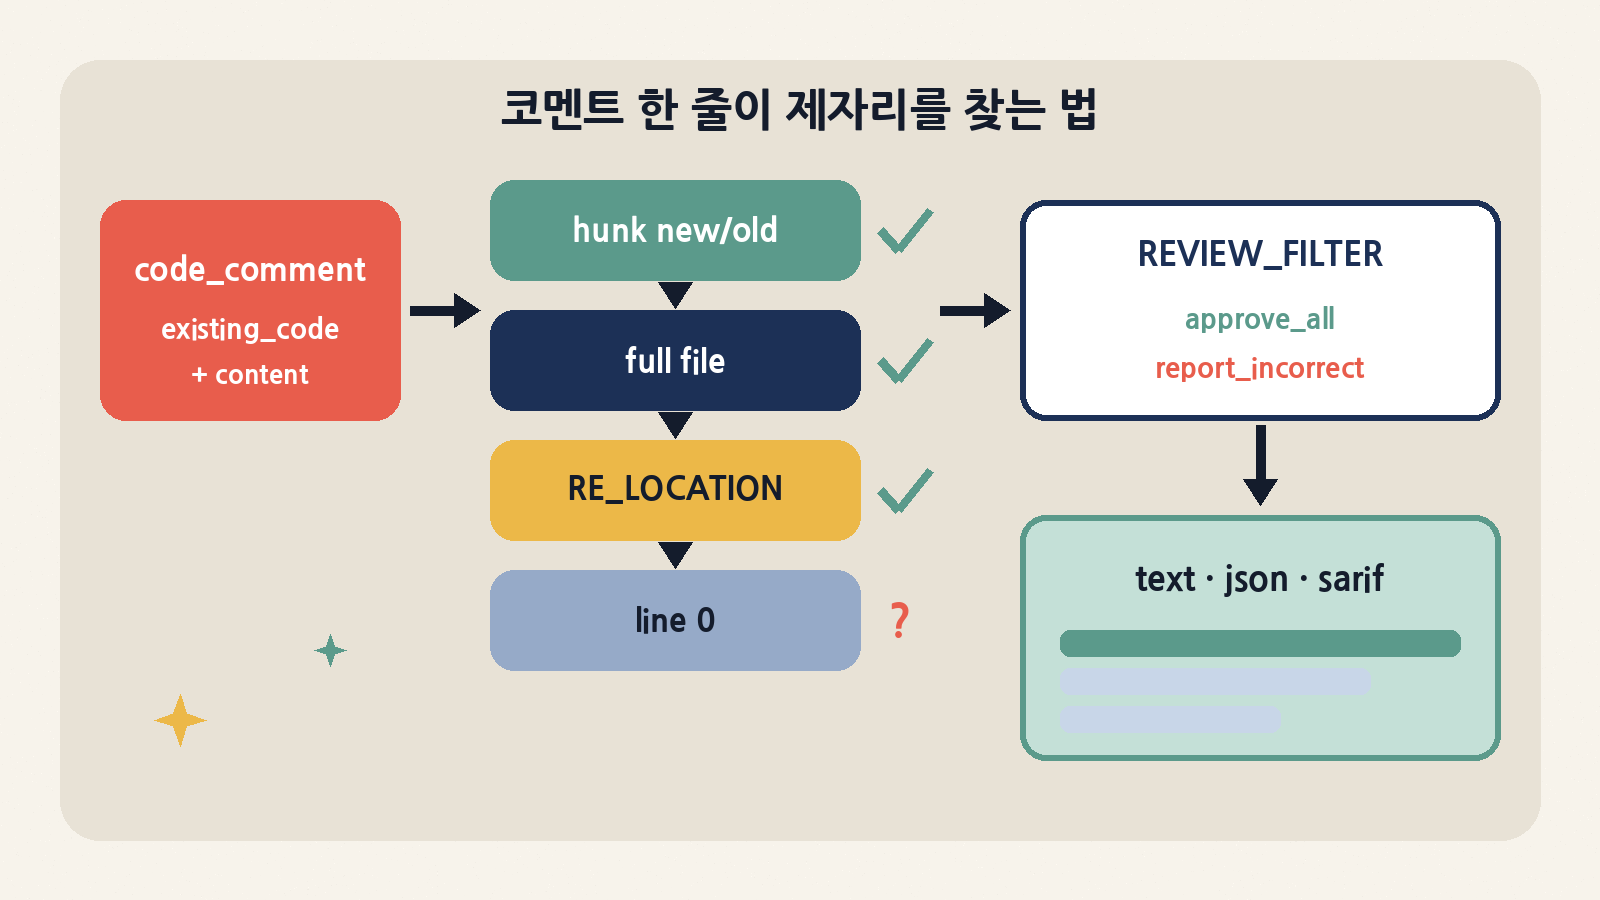
OCR이 ‘라인 단위 정밀 코멘트’를 내세우는 근거가 이 부분이다. 모델은 줄 번호를 직접 쓰지 않는다. 대신 문제 코드 조각을 existing_code로 그대로 인용한다. 그러면 코멘트 워커 풀이 메인 루프를 막지 않고 뒤에서 위치를 계산한다. 순서는 ① 헝크의 새 쪽(문맥+추가 줄), 실패하면 옛 쪽(문맥+삭제 줄)에서 슬라이딩 윈도 매칭 → ② 변경 후 파일 전체 스캔 → ③ RE_LOCATION_TASK로 모델에게 다시 위치를 묻기 → ④ 그래도 안 되면 start_line=0. 매칭은 앞뒤 공백과 diff 기호를 지우고 비교해서 들여쓰기 차이에 강하다.
루프가 끝나면 REVIEW_FILTER_TASK가 모은 코멘트를 diff와 대조한다. 이 필터의 프롬프트가 흥미롭다. 메모리 안전·동시성·호환성 변경 같은 ‘보호 주제’는 틀려 보여도 지우지 않고, 스타일 지적은 사실이기만 하면 남긴다. 지울 수 있는 건 두 경우뿐이다. 설명한 코드가 diff에 아예 없거나(Ground A), diff의 한 줄이 추론 없이 곧바로 주장과 모순될 때(Ground B). 모델이 고를 수 있는 도구도 approve_all_comments와 report_incorrect_comments 둘뿐이다. 반성 단계가 오히려 진짜 결함을 지워 버리는 흔한 실패를 막으려는 설계다.
긴 루프의 기억 관리와 토큰 안전장치
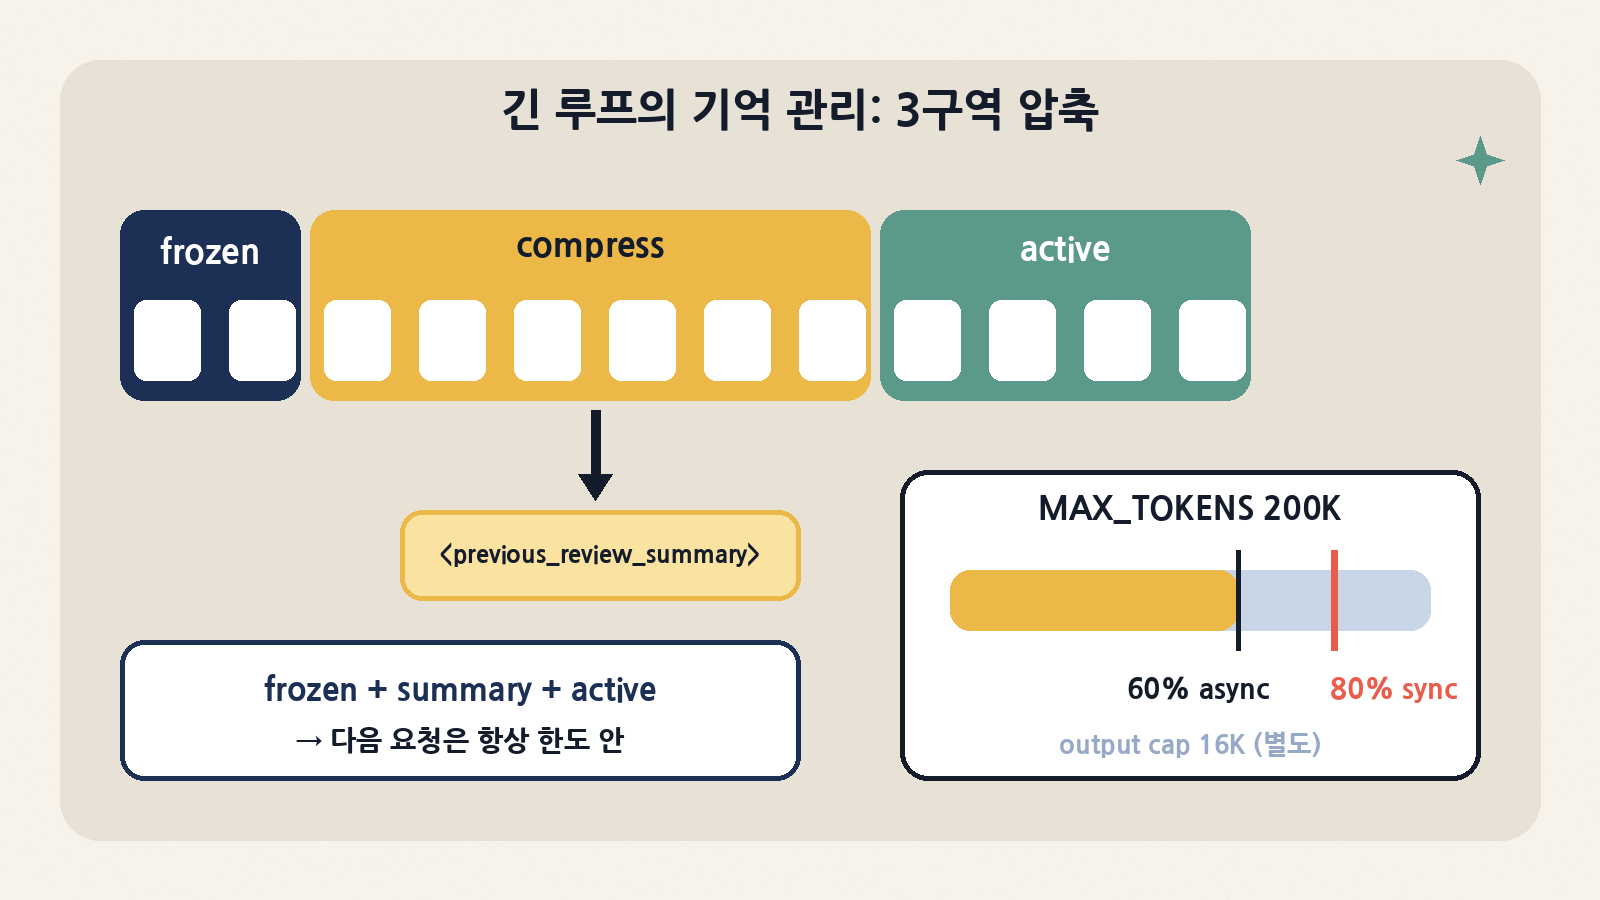
도구 호출이 길어지면 컨텍스트가 넘친다. OCR은 메시지를 세 구역으로 나눈다. 시스템·첫 사용자 메시지 2개는 동결, 최근의 완결된 라운드(어시스턴트 메시지 1개 + 뒤따른 도구 결과)는 한도 안에서 최대한 활성으로 남기고, 그 사이를 압축 구역으로 잡아 XML로 렌더링한 뒤 요약시킨다. 요약은 첫 사용자 메시지 끝에 <previous_review_summary>로 붙는다.
| 장치 | 값 | 왜 필요한가 |
|---|---|---|
MAX_TOKENS |
200,000 (입력 프롬프트 상한) | 압축·건너뛰기 판단의 기준선. 출력 상한과 분리돼 있다 |
MAX_COMPLETION_TOKENS |
16,384 | 프롬프트 한도를 키워도 출력 예산이 덩달아 늘지 않게 |
| 비동기 압축 | 60%에서 시작 | 루프를 멈추지 않고 뒤에서 요약을 만들어 다음 검사 때 교체 |
| 동기 압축 | 80%에서 강제 | 다음 요청이 반드시 한도 안에 들어가게 보장 |
| 사전 건너뛰기 | 그룹 메시지가 80% 초과 시 호출 없이 경고 | 락 파일·자동 생성 코드 같은 괴물 diff에 돈을 쓰지 않는다 |
MAX_TOOL_REQUEST_TIMES |
100회 | 끝없이 도구만 부르는 루프 차단 |
| 빈 라운드 | 연속 3회 | 도구 호출을 못 하는 모델에서 빨리 빠져나오기 |
| Plan 단계 발동 | 단일 파일 50줄 이상, 또는 2파일 이상 합계 100줄 이상 | 작은 변경에는 지연만 늘어서 생략 |
| 리뷰 라운드 | --effort low 1 · medium 2(기본) · high 3 |
2라운드부터는 확정된 코멘트를 주입하고 Plan 없이 다시 본다. 새 발견이 없으면 조기 종료 |
--max-tokens-budget |
기본 0(무제한) | 전체 토큰 상한. 넘으면 그 그룹은 마지막 라운드만 돌고 failed(budget) |
설계상 눈에 띄는 선택은 실패 처리다. 그룹 하나가 실패해도 재시도하지 않고 경고만 남긴다. 재시도는 감싸는 CI 파이프라인의 몫이라는 입장이다. 그래서 일부 그룹이 실패해도 종료 코드는 0이고, 선택된 항목이 전부 실패했을 때만 0이 아니다. CI에서 ‘성공’만 보고 넘어가면 안 되는 이유다. JSON의 warnings 배열이나 결과 매니페스트의 coverage를 같이 봐야 한다.
규칙 체계: 4단 우선순위와 언어별 규칙 54개
무엇을 볼지는 규칙이 정한다. 우선순위는 --rule 플래그 → 프로젝트 .opencodereview/rule.json → 전역 ~/.opencodereview/rule.json → 바이너리에 내장된 시스템 규칙 순이다. 파일마다 위에서부터 처음 맞는 glob이 이긴다. 기본은 ‘대체’지만 merge_system_rule: true를 주면 내장 언어 규칙 위에 팀 규칙을 덧붙인다. 내장 규칙 문서는 Go·Java·C/C++·Kotlin·PHP·GitHub Workflows·MyBatis 매퍼 XML·Prisma·Nix 등 54개가 마크다운으로 들어 있다. 필자가 확인한 Go 규칙의 첫 문장은 “재현율보다 정밀도를 택하라. 오탐은 리뷰어의 신뢰를 깎는다”였다. 도구 전체의 철학이 규칙 문서 첫 줄에 그대로 있다.
{
  "exclude": ["**/generated/**"],
  "rules": [
    { "path": "src/api/**/*.go",
      "rule": "모든 공개 핸들러는 요청 본문을 쓰기 전에 검증해야 한다." },
    { "path": "**/*",
      "rule": "하드코딩된 비밀값, 검증 없는 리다이렉트, 권한 검사 누락을 찾아라.",
      "merge_system_rule": true }
  ]
}
규칙이 실제로 어느 파일에 붙는지는 ocr rules check <path>로 바로 확인된다. glob은 대소문자를 구분하지 않는다는 점도 기억해 두자.
설치·실행: 세 가지 운용 모드
# 설치 (Git 2.41+ 필요)
npm install -g @alibaba-group/open-code-review

# 모델 설정: 대화형 / 비대화형
ocr config provider && ocr config model
export OCR_LLM_URL=https://api.example.com/v1 OCR_LLM_TOKEN=... OCR_LLM_MODEL=...
ocr llm test                      # 도구 호출 왕복까지 점검

# 토큰 0개로 범위 확인 → 실제 리뷰
ocr review --preview
ocr review --from main --to feature --format json --audience agent -o result.json
ocr scan --path internal/agent # diff 없이 파일 전체 감사- OCR 관리 모드(기본): OCR이 설정된 LLM으로 전 과정을 돈다. 앞서 본 파이프라인이 모두 적용된다.
- 위임(delegate) 모드: OCR은 파일 선택과 규칙 해석만 하고 LLM을 아예 부르지 않는다.
ocr delegate preview로 대상과 제외 사유를,ocr delegate rule로 규칙 묶음을 받아 Claude Code·Codex·Cursor 같은 호스트 에이전트가 자기 구독 모델로 리뷰한다. API 키가 따로 없는 팀에 맞다. 다만 위치 잡기·반성 필터·다중 라운드 같은 OCR 쪽 품질 장치는 쓰지 못한다. - CI 모드: GitHub Action(
action.yml)과 GitLab CI 레시피가 있다. Range 모드 JSON을 파싱해 인라인 코멘트로 달고, 줄 정보가 없는 지적은 요약 코멘트로 접는다.--format sarif로 GitHub Code Scanning에도 올릴 수 있다.
로컬 모델도 쓸 수 있지만 조건이 있다. 리뷰 전체가 도구 호출로 진행되므로 네이티브 함수 호출을 지원하는 모델이어야 한다. FAQ는 도구 호출을 텍스트로 ‘흉내만 내는’ 모델로는 아무리 프롬프트를 바꿔도 안 된다며 deepseek-r1을 예로 들고, qwen3처럼 도구를 지원하는 모델은 잘 된다고 적었다.
벤치마크: 정밀도를 사고 재현율을 판다
프로젝트는 인기 오픈소스 저장소 50곳의 실제 PR 200개, 10개 언어로 만든 리뷰 벤치마크(AACR-Bench, Hugging Face 공개)를 내놨다. 시니어 엔지니어 80여 명이 교차 검증한 정답 이슈가 1,505개다. 같은 모델을 OCR에 물렸을 때와 범용 에이전트에 물렸을 때를 비교한 표가 핵심이다.
| 같은 모델, 다른 하네스 (프로젝트 자체 벤치) | F1 | Precision | Recall | 평균 시간 | 평균 토큰 |
|---|---|---|---|---|---|
| Claude-4.6-Opus + Open Code Review v1.3.1 | 25.10% | 33.90% | 20.00% | 1분 23초 | 385K |
| Claude-4.6-Opus + Claude Code v2.1.169 | 11.57% | 7.23% | 28.90% | 13분 6초 | 5,664K |
| Claude-4.8-Opus + Open Code Review v1.3.1 | 17.90% | 37.80% | 11.70% | 1분 6초 | 352K |
| Claude-4.8-Opus + Claude Code v2.1.169 | 14.13% | 15.93% | 12.70% | 5분 38초 | 2,062K |
| GPT-5.5 + Open Code Review v1.3.1 | 21.00% | 32.10% | 15.50% | 2분 51초 | 422K |
| GPT-5.5 + Codex v0.140.0 | 8.36% | 27.82% | 4.92% | 2분 58초 | 525K |
읽는 법이 중요하다. 첫째, OCR은 같은 모델에서 정밀도와 F1이 크게 높다. 토큰은 Claude Code 대비 약 1/6(4.8-Opus)~1/15(4.6-Opus) 수준이고, README는 이를 ‘약 1/9 토큰’으로 요약한다. Codex와의 비교에서는 토큰 차이가 크지 않고 F1 차이가 두드러진다. 둘째, 재현율은 범용 에이전트가 더 높은 경우가 있다(Claude-4.6-Opus 기준 28.90% 대 20.00%). README도 이를 ‘잡음보다 정밀도를 택한 의도된 교환’이라고 밝힌다. 셋째, 측정된 OCR 버전은 v1.3.1로 지금(v1.12.13)보다 한참 이전이고, 데이터셋과 채점 모두 알리바바 쪽에서 만들었다. 우리 코드베이스에서 같은 경향이 나오는지는 직접 확인해야 할 가설로 두는 게 맞다. 절대 수치(F1 20%대)가 낮다는 것도 짚어 둘 만하다. AI 리뷰는 아직 사람 리뷰를 대체하는 수준이 아니라 거르는 체로 쓰는 단계다.
박스에서 직접 돌려 본 결과
실제 LLM 키는 쓰지 않았다. 대신 ① 소스 빌드와 전체 단위 테스트, ② LLM이 필요 없는 명령(preview·delegate·rules), ③ 직접 짠 가짜 OpenAI 호환 서버(정해진 도구 호출만 돌려주는 Python 스크립트)로 전체 파이프라인을 돌렸다. 마지막 실험은 모델의 실력이 아니라 OCR의 결정적 배관이 문서대로 움직이는지를 보려는 것이다. 데모 저장소에는 SQL 문자열 연결, 잠금 없이 쓰는 전역 맵, 오류 경로의 트랜잭션 롤백 누락을 일부러 넣은 Go 파일과 테스트 파일·이미지·미지원 확장자·node_modules를 섞었다.
| 점검 항목 (박스: Linux x86_64, Go 1.26.9, 10/10 KST) | 결과 | 메모 |
|---|---|---|
go build ./cmd/opencodereview |
성공, 약 4.2초 (의존성 내려받은 뒤) | 단일 정적 바이너리 약 80MB. ocr --version → v1.12.13 (35fc3e2) |
전체 단위 테스트 go test ./... (extensions 제외) |
24개 패키지 모두 ok. 최상위 테스트 2,509 통과·3 건너뜀, 서브테스트 2,730 통과 | make가 없어 make test의 -race 없이 돌렸다. 셸에 OCR_LLM_* 환경 변수가 남은 상태에선 1건이 실패했고, 변수를 지우고 다시 돌리자 0건 |
ocr review --preview (6파일 데모 저장소) |
리뷰 대상 3 / 제외 3 | _test.go는 default_path, 미지원 확장자 2개는 unsupported_ext. 루트 node_modules/는 목록에 아예 안 나왔다(diff 공급자 단계 제외) |
ocr delegate preview / delegate rule |
LLM 없이 즉시 출력 | Go 파일에는 시스템 규칙 **/*.go가 붙고, 첫 문단이 ‘재현율보다 정밀도를 택하라’는 원칙이다 |
ocr review (LLM 미설정) |
종료 코드 1, ‘no valid LLM endpoint configured’ | 추측해서 아무 엔드포인트로 보내지 않는다. 문서에 적힌 ‘대체 경로 없음’ 원칙 그대로 |
| 가짜 OpenAI 호환 서버로 전체 파이프라인 | status complete, 코멘트 3건, LLM 요청 3회 | 소규모 변경이라 그룹핑 호출 없이 small change set 한 그룹. Main 2턴(code_comment → task_done) + 리뷰 필터 1회 |
| 줄 위치 잡기 | 2건은 20줄·21~24줄에 정확히 붙음, 1건은 start_line 0 |
일부러 들여쓰기를 바꾼 스니펫도 공백 무시 매칭으로 붙었다. diff에 없는 스니펫은 ‘위치 미확정’으로 남았다 |
| 세션 기록 | JSONL 12줄 (요청 3·응답 3·도구 호출 1·파일 완료 3·시작/끝) | 임시 HOME 아래 .opencodereview/sessions/에 기록 |
$ ocr review --preview
Preview: 6 file(s) changed  |  +25  -3
Will review (3):
  [M]  api/handler.go                 +20   -3
  [A]  page.html                      +1    -0
  [A]  src/main/java/UserService.java +1    -0
Excluded from review (3):
  [A]  api/handler_test.go  (default_path)
  [A]  logo.png             (unsupported_ext)
  [A]  notes.xyz            (unsupported_ext)
가짜 서버 실험에서 배운 점이 둘 있다. 하나, 코멘트를 그룹 키(파일 세 개를 쉼표로 이은 경로)로 냈더니 OCR이 내용을 보고 실제 파일(api/handler.go)로 다시 배정하며 comment_refiled 경고를 남겼다. 모델이 경로를 대충 써도 사후에 바로잡는 장치가 있다는 뜻이다. 둘, diff에 없는 스니펫을 준 코멘트는 버려지지 않고 start_line 0으로 남았다. 이번 실험에서는 재배치(RE_LOCATION) 요청이 발생하지 않았다. 문서는 ‘사소하지 않은 diff’에서 시도한다고만 적고 있다. CI 연동 스크립트가 0번 줄 코멘트를 인라인이 아닌 요약으로 접어야 하는 이유가 여기 있다. 실제 모델로 측정한 품질·속도·비용은 이번에 재지 않았다.
대안과 비교
| 도구 | 방식 | 강점 | 약점·주의 |
|---|---|---|---|
| Open Code Review (Apache-2.0) | 결정적 파이프라인 + 도구 쓰는 LLM 서브 에이전트 | 파일 누락·위치 어긋남을 코드로 막음. 토큰 적게, 정밀도 우선. 위임 모드·SARIF·GitLab까지 | 재현율은 일부러 낮다. 프롬프트를 바꾸려면 템플릿 수정 후 재빌드 |
| 범용 코딩 에이전트 + 리뷰 스킬 (Claude Code 등) | 자연어 지시로 에이전트가 알아서 리뷰 | 설정이 거의 없고 재현율이 높게 나올 수 있다 | 큰 변경에서 파일을 건너뛰거나 줄이 어긋난다는 게 OCR 측 지적. 토큰 사용이 크다 |
| PR-Agent (The-PR-Agent/pr-agent, MIT) | PR 단위 LLM 명령(리뷰·설명·개선 제안) | PR 플랫폼 연동과 명령 체계가 성숙 | 리뷰 범위·위치를 강제하는 파이프라인 설계는 OCR만큼 전면에 있지 않다. 직접 비교 수치는 없다 |
| reviewdog (MIT) | 린터·정적 분석 결과를 PR 코멘트로 옮기는 배관 | 결정적이고 저렴. 어떤 분석기든 붙는다 | 스스로 ‘이해’하지 않는다. 규칙에 없는 결함은 못 본다 |
| Semgrep (LGPL-2.1) | 패턴 기반 정적 분석 | 재현 가능, 보안 규칙 생태계가 크다 | 문맥·의도가 필요한 결함(동시성 설계, 계약 위반)에 약하다 |
| 상용 SaaS 리뷰 봇 | 호스티드 LLM 리뷰 | 설치·운영 부담이 없다 | 코드가 외부 서비스로 나간다. 모델·프롬프트를 통제하기 어렵다 |
정리하면 OCR은 ‘리뷰를 더 많이 찾는 도구’가 아니라 오탐을 줄여 리뷰어가 믿고 읽게 만드는 도구다. 정적 분석(Semgrep·린터+reviewdog)이 못 잡는 문맥형 결함을 LLM으로 보되, LLM이 흔히 망치는 범위·위치·일관성은 코드로 묶는다. 이미 정적 분석을 CI에 넣은 팀이라면 대체재보다 그 위층으로 보는 게 맞다.
위험·라이선스·운영 주의점
- 라이선스: Apache-2.0. 상업적 사용·수정·재배포가 가능하고 특허 조항이 있다. 저장소 구조상 CLI·규칙·프롬프트가 모두 공개돼 있어 사내 포크도 쉽다.
- 코드가 LLM 공급자로 나간다: 보안 보증 문서의 위협 모델 자체가 ‘diff를 설정된 LLM으로 HTTPS 전송’이다. 외부 API를 못 쓰는 조직은 사내 OpenAI 호환 엔드포인트나 Bedrock 경로를 먼저 마련해야 한다. 공급자 프리셋 24종에는 국외 사업자도 다수 있으니 무엇을 고르는지 확인하자.
- diff는 신뢰하지 않는 입력: 문서는 diff에 악성 페이로드가 들어올 수 있다고 보고, 외부 명령을 하드코딩된
git하위 명령으로만 제한하고--end-of-options로 플래그 주입을 막는다고 밝힌다. LLM이 제시한 경로도 저장소 루트 안인지 심볼릭 링크 해석 전후로 검사한다. 다만 PR 본문·코드 주석을 통한 프롬프트 인젝션으로 리뷰 결과를 흐리는 공격은 도구 권한과 별개로 남는다. 쓰기 도구가 없으니 피해는 ‘잘못된 리뷰’에 그친다는 점이 위안이다. - 키 저장:
ocr config set은 키를~/.opencodereview/config.json에 평문으로 쓴다(새 파일은 0600 권한). 공용 러너라면 환경 변수나api_key_cmd(키체인·시크릿 서비스에서 읽기)를 쓰자. - ‘성공’ 종료 코드의 함정: 일부 그룹 실패나 토큰 예산 초과도 종료 코드 0이다. CI 게이트로 쓰려면 JSON의 status·warnings·coverage를 따로 검사해야 한다.
- 빠른 릴리스 주기: 9월 21일부터 10월 8일까지 18일 동안 패치가 여섯 번 나왔다. CI에서는 버전을 고정하고(Action과 GitLab 레시피 모두 지원) 올릴 때 미리보기·스모크를 거치자.
- 사내 프롬프트 수정 비용: 프롬프트 템플릿은 CLI로 덮어쓸 수 없고 수정 후 다시 빌드해야 한다. 규칙(
rule.json)과 도구 설명(--tools)으로 해결되지 않는 요구는 포크 유지 비용이 든다.
누가 도입하면 좋은가
- AI 리뷰를 써 봤는데 잡음 때문에 끈 팀: 정밀도 우선 설계와 반성 필터가 정확히 그 문제를 겨냥한다.
--effort low와--preview로 작게 시작하기 좋다. - PR이 크고 여러 언어가 섞인 모노레포: 파일 필터·의미 그룹핑·그룹별 병렬 서브 에이전트가 ‘큰 변경에서 일부만 보는’ 문제를 구조로 막는다.
- GitLab·Gerrit을 쓰거나 모델을 직접 고르고 싶은 조직: 공급자 중립, 사내 엔드포인트, SARIF 출력까지 갖췄다.
- 신중할 경우: 코드가 외부로 한 줄도 나가면 안 되는데 도구 호출을 지원하는 사내 모델이 없는 곳, 놓치는 결함이 치명적이라 재현율이 최우선인 곳(이때는 정적 분석과 사람 리뷰가 먼저다), 그리고 AI 리뷰 결과를 머지 차단 게이트로 바로 쓰려는 곳.
평가 방법은 단순하다. 지난 분기에 사람이 리뷰에서 실제로 잡아낸 결함이 있는 PR 20~30개를 골라, 같은 모델로 OCR과 지금 쓰는 방식을 나란히 돌린다. 정답 대비 정밀도·재현율, 그리고 리뷰어가 ‘읽을 가치가 있었다’고 표시한 코멘트 비율, 건당 토큰과 시간을 잰다. 세션 뷰어(ocr viewer)로 어떤 도구를 몇 번 불렀는지 같이 보면 프롬프트·규칙 튜닝 포인트가 보인다.
Open Code Review의 메시지는 결국 하나다. 모델이 똑똑해질수록 하네스가 중요해진다. 무엇을 볼지, 어디에 붙일지, 언제 멈출지를 코드로 정해 주면 같은 모델이 더 적은 토큰으로 더 믿을 만한 리뷰를 낸다. 그 대가로 일부 결함은 놓친다는 사실까지 숨기지 않는다는 점에서, 도입을 검토할 만한 정직한 도구다.