한 줄 요약: vectorize-io/hindsight는 “대화 기록을 다시 찾아 주는 메모리”가 아니라 사실을 구조화해 쌓고, 그 위에서 믿음(observation)을 다듬어 가는 에이전트 메모리 서버입니다. 저장은 retain, 검색은 recall(시맨틱·키워드·그래프·시간 4갈래 병렬 검색 + RRF 융합 + 크로스인코더 재정렬 + 토큰 예산), 추론은 reflect(최대 10회 도는 에이전트 루프) 세 동사로 정리됩니다. MIT 라이선스, 최신 릴리스 v1.1.0. 이 글에서는 모노레포 구조와 엔진 내부, 운영 시 반드시 바꿔야 할 기본값(인증 꺼짐·0.0.0.0 바인딩), 그리고 박스에서 외부 API 키 없이 돌린 블랙박스 시스템 테스트 결과까지 정리합니다.
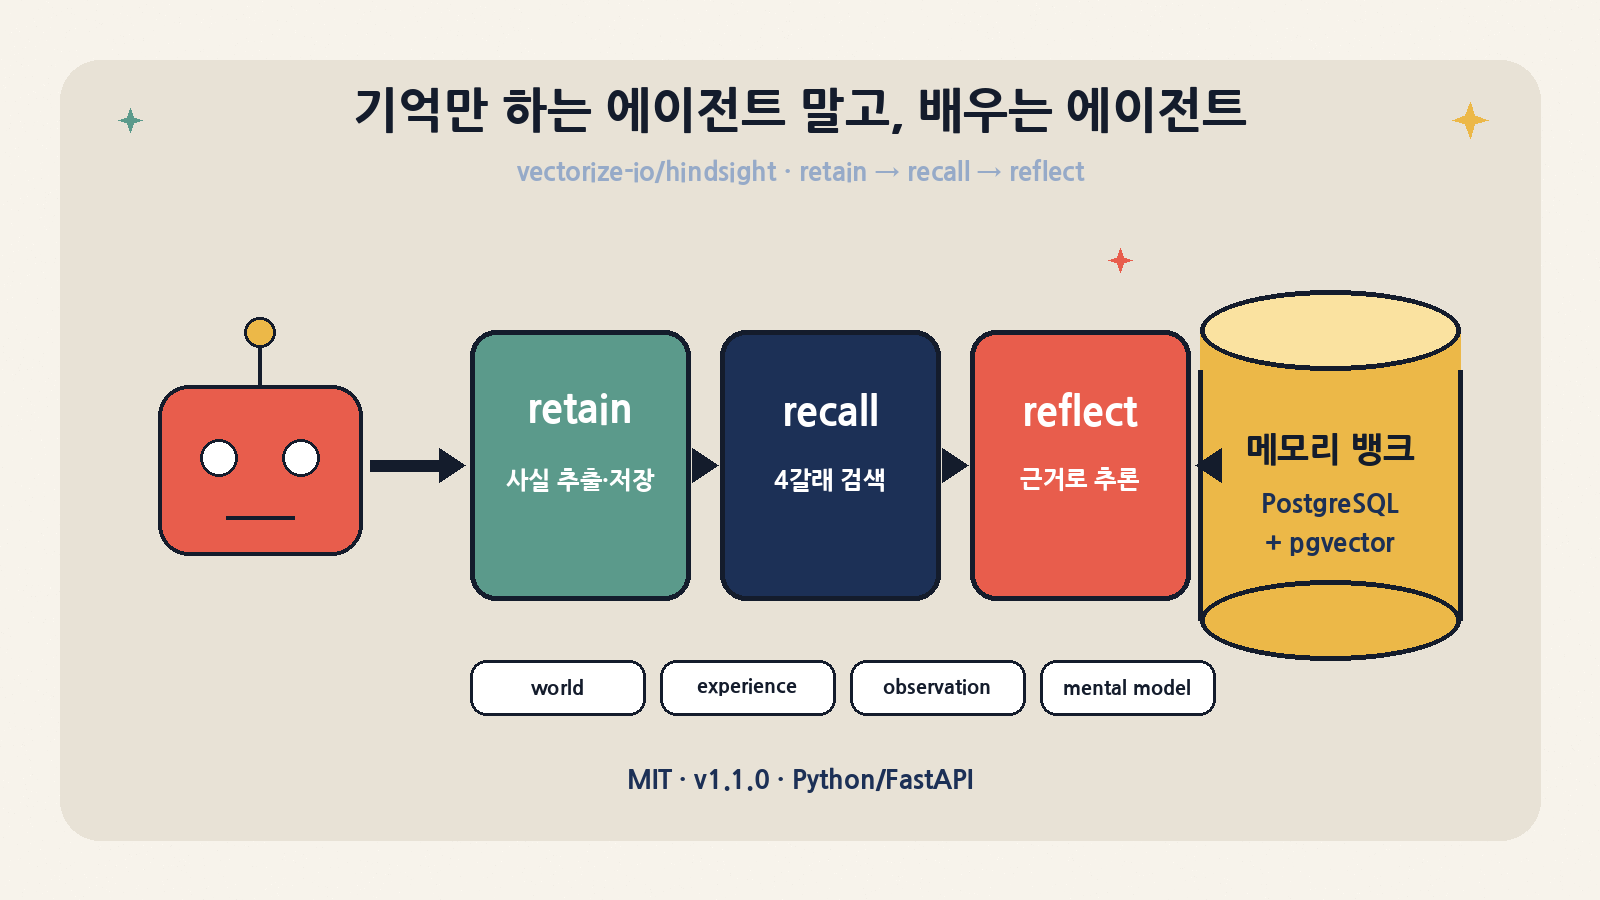
1. 지금 이 리포가 트렌딩에 오른 이유
2026-10-25(일) 오후 GitHub Trending 데일리 Python 10위(오늘 +329)에 올라 있습니다. 전체 랭킹 상위 10위에는 없지만, 누적 별이 5만 3천 개를 넘긴 상태에서 하루 수백 개씩 꾸준히 붙는 유형입니다. 배경은 세 가지입니다. 10월 13일(KST) v1.0.0으로 1.x 안정 버전을 선언했고, 10월 22일 새벽(KST) v1.1.0이 나왔으며, 같은 릴리스 노트에 “50,000 GitHub Stars” 블로그 글이 함께 들어갔습니다. 여기에 Claude Code·Codex·Cursor·opencode 같은 코딩 에이전트에 한 줄로 붙는 hindsight-coding-agents 패키지가 붙으면서, “에이전트가 세션을 넘어 프로젝트 결정을 기억한다”는 수요와 정확히 맞물렸습니다.
| 항목 | 값 (2026-10-25 KST 확인) | 메모 |
|---|---|---|
| 리포 | vectorize-io/hindsight |
Vectorize.io가 만든 모노레포 |
| 라이선스 | MIT | 상업 사용·수정·재배포 자유, 저작권 고지 유지 |
| 스타 / 포크 | 53,518 / 6,239 | GitHub API, 오후 5시 전후 |
| 트렌딩 | Python 데일리 10위 (+329) | 전체 데일리 상위 10위 밖 |
| 최신 릴리스 | v1.1.0 (2026-10-22 01:41 KST) | PyPI hindsight-api 1.1.0, npm @vectorize-io/hindsight-client 1.1.0 |
| 직전 메이저 | v1.0.0 (2026-10-13 23:08 KST) | 그 전은 v0.10.3 (10-09) |
| 생성일 | 2025-10-30 | 1년 만에 1.x 도달 |
| 최근 커밋 | 2026-10-24 23:21 KST (4822d66) |
main 기준, 박스에서 이 커밋으로 테스트 |
| 열린 이슈 | 144개 | PR 포함 수치 |
| 요구 Python | 3.11 이상 | 서버는 FastAPI, 패키지 관리는 uv |
| 논문 | arXiv 2512.12818 (2025-12) | “Hindsight is 20/20”, Vectorize + 버지니아공대 공동 |
2. 문제 정의: 왜 “RAG를 붙이면 된다”가 아닌가
대부분의 에이전트 메모리는 대화에서 눈에 띄는 조각을 뽑아 벡터나 그래프 저장소에 넣고, 질문이 오면 top-k를 프롬프트에 꽂습니다. 논문이 지적하는 약점은 세 가지입니다. ① 증거와 추론의 경계가 흐려진다(LLM이 요약한 문장이 사실처럼 저장됨), ② 긴 시간축에서 정리가 안 된다(같은 사람에 대한 상충되는 사실이 계속 쌓임), ③ 왜 그렇게 답했는지 설명하기 어렵다. Hindsight는 메모리를 “외부 레이어”가 아니라 추론의 1급 기반으로 보고, 저장소를 네 개의 논리 네트워크로 나눕니다.
| 메모리 종류 | 담는 것 | 예시 | 누가 만드나 |
|---|---|---|---|
| world fact | 바깥 세계·타인에 대한 사실 | “Alice는 Google에서 일한다” | retain 시 LLM 추출 |
| experience | 뱅크 주인(에이전트) 자신의 행동·경험 | “내가 Alice에게 Python을 추천했다” | retain 시 LLM 추출 (화자 기준으로 분류) |
| observation | 여러 사실에서 통합된, 근거가 달린 믿음 | “Alice는 가독성을 중시하는 Python 개발자” | 백그라운드 consolidation |
| mental model | 미리 정해 둔 질문에 대한 ‘상시 답변’ | “이 사용자의 선호는?” | 사용자가 질문 정의 → 엔진이 작성·갱신 |
실무에서 가장 헷갈리는 부분은 world와 experience의 구분입니다. 문서에 따르면 문법이 아니라 화자로 결정됩니다. 사용자가 “나 테슬라 샀어”라고 하면 그건 에이전트의 경험이 아니라 사용자에 대한 world fact입니다. 그래서 retain 때 context에 “고객 Maria가 말하는 중” 같은 화자 정보를 넣으라고 권장합니다. 트랜스크립트를 그대로 밀어 넣는 파이프라인이라면 이 한 줄이 분류 품질을 좌우합니다.
3. 모노레포 구조
리포는 서버, 클라이언트 4종, CLI, UI, 60여 개 통합, 테스트 스위트 3종이 한곳에 있는 모노레포입니다. 클론만 약 468MB이고, 핵심 서버 패키지 hindsight_api의 Python 코드만 약 18만 줄입니다.
| 디렉터리 | 언어/도구 | 역할 | 실무 포인트 |
|---|---|---|---|
hindsight-api-slim/ |
Python · FastAPI · uv | 메모리 엔진 본체 (retain/recall/reflect, 워커, MCP) | 코드를 읽는다면 여기부터. tests/에 test_*.py 677개 |
hindsight-api/ |
Python 배포 패키지 | hindsight-api·hindsight-worker·hindsight-local-mcp·hindsight-admin 엔트리포인트 |
PyPI에 올라가는 이름 |
hindsight-all/, -slim |
Python | 서버+클라이언트를 한 프로세스에 넣는 임베디드 번들 | Intel Mac은 slim 사용 |
hindsight-control-plane/ |
Next.js | 관리 UI (기본 9999 포트) | 뱅크·메모리·개체 그래프 탐색 |
hindsight-cli/ |
Rust (progenitor) | OpenAPI에서 생성한 CLI | 스크립트 운영용 |
hindsight-clients/ |
Python · TS · Rust · Go | OpenAPI 생성 SDK | 엔드포인트 변경 시 재생성 필수 |
hindsight-integrations/ |
혼합 | LangGraph, CrewAI, LiteLLM, Pydantic AI, n8n, coding-agents 등 48개 디렉터리 | README는 “60+ 통합” 표기 |
hindsight-extensions/ |
Python | 테넌시·인증, 추가 HTTP, MCP 도구, 검증 훅, Memory Defense | 멀티테넌트는 여기서 결정 |
hindsight-system-tests/ |
pytest | 실제 서버 프로세스를 SDK로만 두드리는 블랙박스 E2E | LLM·임베딩·리랭크를 스텁으로 대체, 키 불필요 |
hindsight-system-evals/ |
pytest + AMB | LoCoMo·LongMemEval·BEAM 품질 평가 | 실제 프로바이더와 LLM 판정자 필요 |
helm/, docker/, monitoring/ |
운영 | Helm 차트, compose, Prometheus 대시보드 | K8s 배포 경로가 공식 제공 |
3-1. 엔진 내부 모듈 지도
모듈 (hindsight_api/engine/) |
하는 일 |
|---|---|
memory_engine.py |
retain/recall/reflect 오케스트레이터 |
retain/orchestrator.py, fact_extraction.py |
청크 분할 → LLM 사실 추출(시간·개체·관계·인과) → 정규화 |
memories/pg/entity_resolver.py, links.py |
개체 해소(퍼지 이름 매칭 + 공출현), 링크 생성 |
search/retrieval.py |
4갈래 검색 병렬 실행 |
search/fusion.py |
reciprocal_rank_fusion(..., k=60)과 소스별 상한 cap_per_source |
search/reranking.py, cross_encoder.py |
크로스인코더 재정렬 (로컬 또는 TEI·Cohere·Jina 등 원격) |
consolidation/ |
observation 생성·병합·모순 처리 (백그라운드 워커) |
reflect/ |
도구를 쓰는 에이전트 루프, 인용 검증 |
llm_wrapper.py, providers/ |
25개 이상 LLM 프로바이더 추상화, 구조화 출력·JSON 복구·재시도 |
4. retain: 쓰기 경로가 사실상 핵심이다
Hindsight의 품질은 대부분 쓰기 시점에 결정됩니다. retain은 텍스트를 그대로 저장하지 않고, LLM으로 사실·시간·개체·관계·인과를 뽑아 정규화한 뒤 개체 그래프와 시계열, 희소/밀집 벡터를 함께 만듭니다. 문서의 예시처럼 “Bob이 Summer Vibes를 제안했지만 Alice가 더 독특한 걸 원해서 Beach Beats로 정했다”를 세 조각으로 쪼개지 않고 서사를 보존한 사실로 남기는 것이 설계 의도입니다.
| 링크 종류 | 어떻게 생기나 | 가능해지는 질문 |
|---|---|---|
| 개체(entity) 링크 | 같은 개체를 언급한 사실끼리 연결 | “Alice에 대해 아는 것 전부” |
| 시간(temporal) 링크 | 시점이 가까울수록 강하게 연결 | “그 무렵 또 무슨 일이 있었지?” |
| 의미(semantic) 링크 | 표현은 달라도 의미가 비슷한 사실끼리 | “비슷한 주제” |
| 인과(causal) 링크 | 추출 단계에서 원인-결과를 명시 | “왜 번아웃이 왔나?” ← 주 80시간 근무 |
개체 해소는 퍼지 이름 매칭에 공출현·시간 근접성을 더하는 방식입니다. “Alice”, “Alice Chen”, “Alice C.”는 합쳐지지만, 닮지 않은 별명과 본명은 이름만으로는 합치지 않습니다. 반대 방향의 오류도 문서에 솔직하게 적혀 있습니다. 히스토리가 긴 뱅크에서는 짧은 새 이름이 기존 개체에 흡수될 수 있어, 사람이 많은 CRM형 데이터라면 매칭을 엄격하게 하는 설정을 먼저 보라고 권합니다. 분류 라벨(key:value 형태의 entity label)은 반대로 퍼지 매칭에서 제외되고 정확 일치로만 해소됩니다.
5. recall: 4갈래 검색과 토큰 예산
recall은 네 가지 검색을 병렬로 돌리고 결과를 합칩니다. 핵심은 “점수가 아니라 순위”를 합친다는 점입니다. 코드상 reciprocal_rank_fusion의 기본 k는 60이고, 여러 전략에서 동시에 상위에 오른 기억이 위로 올라갑니다. 그 뒤 크로스인코더가 질문-기억 쌍을 다시 채점하고, 마지막으로 top-k가 아니라 max_tokens(기본 4,096)만큼 잘라 돌려줍니다. 에이전트의 컨텍스트 창은 개수가 아니라 토큰으로 측정되니, 이 설계는 실무적으로 꽤 반갑습니다.
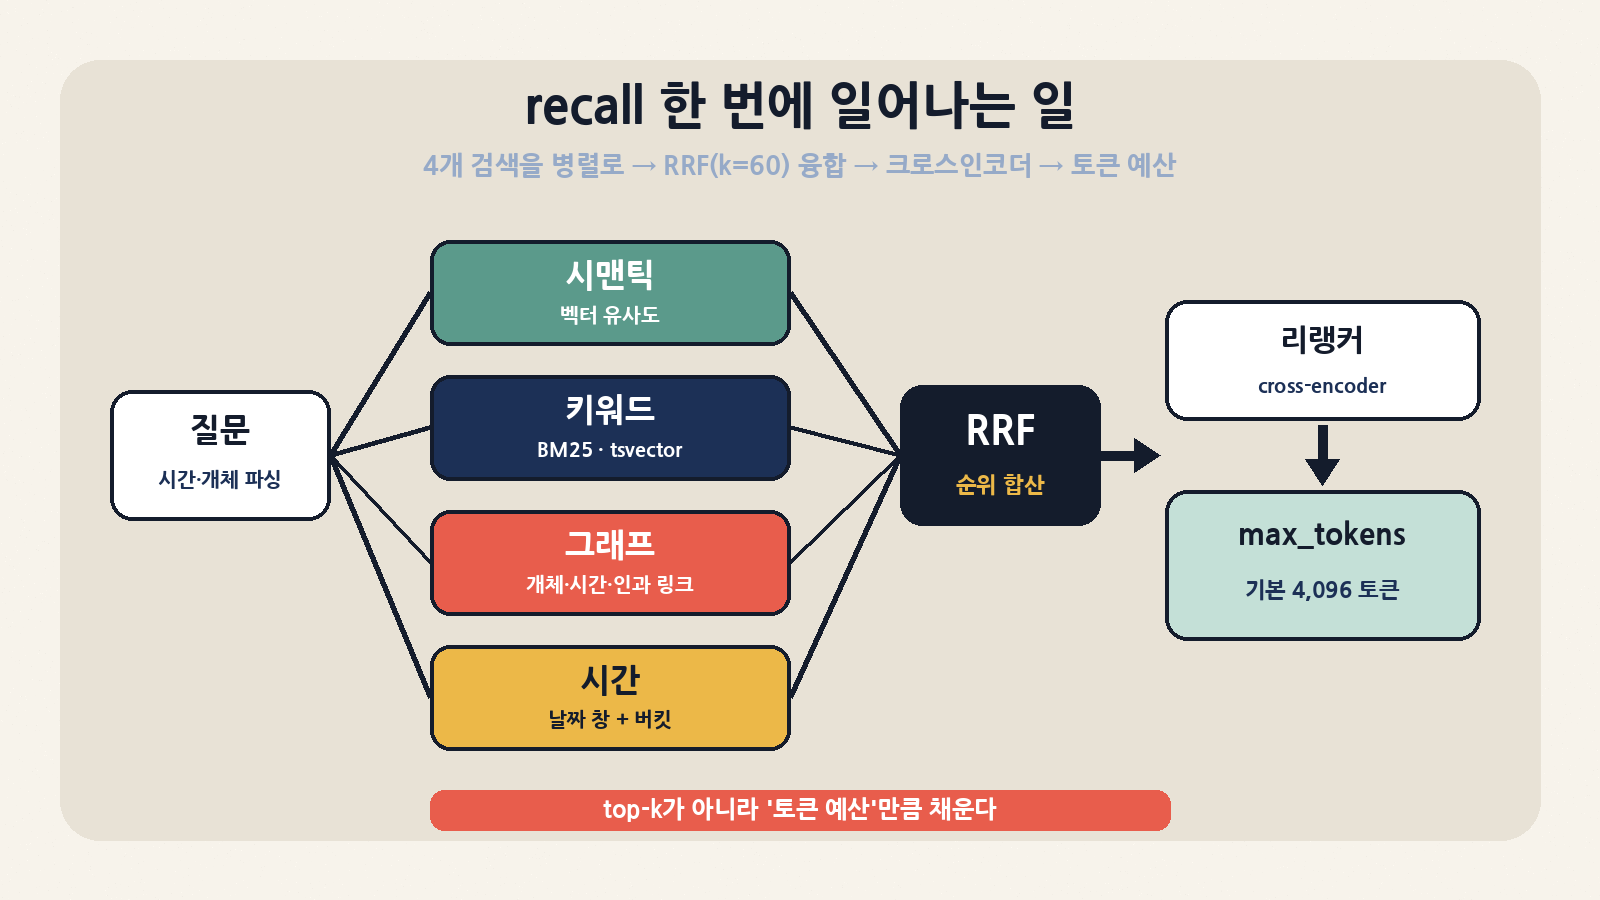
| 전략 | 구현 | 강한 질문 | 약점·주의 |
|---|---|---|---|
| 시맨틱 | pgvector 임베딩 유사도 | “Alice 직업이 뭐지?” 같은 의역 | 임베딩 모델 언어 성능에 좌우 |
| 키워드 | BM25 계열 5개 백엔드 중 선택 | 고유명사, 제품명, URL, 에러 코드 | 기본 native는 tsvector+ts_rank_cd라 엄밀한 BM25가 아님 |
| 그래프 | 개체·시간·인과 링크 확장 | “Alice 팀이 겪은 장애” 같은 멀티홉 | 개체 해소가 틀리면 엉뚱한 확장 |
| 시간 | 질문의 시간 표현 → 날짜 창, 창 안을 버킷으로 나눠 고르게 선택 | “작년 봄에 뭐 했지?” | retain 때 timestamp를 안 넣으면 효과 반감 |
한국어 서비스라면 키워드 백엔드 선택이 중요합니다. 문서에 정리된 백엔드는 native(PostgreSQL tsvector), vchord, pg_textsearch, pgroonga(TokenBigram 다국어 토크나이저), pg_search(ParadeDB, 토크나이저 지정 가능)입니다. Citus로 수평 확장하면서 진짜 BM25를 원하면 pg_search가 유일한 선택지라고 명시돼 있습니다. 한국어 형태소 문제를 생각하면 PGroonga의 bigram이나 pg_search의 ngram 계열을 먼저 실험해 볼 만합니다.
| 파라미터 | 제어 대상 | 지연 영향 | 추천 조합 |
|---|---|---|---|
budget = low |
그래프 깊이·후보 풀·재정렬 범위 최소 | 가장 빠름 | 챗봇 매 턴 자동 주입 |
budget = mid |
균형 | 보통 | 대부분의 질의 |
budget = high |
멀티홉까지 깊게 탐색 | 느림 | 세션 시작 시 한 번, 분석 질의 |
max_tokens 2,048 / 4,096 / 8,192 |
돌려받는 기억 분량 | 하위 LLM 처리 시간 | 작은 모델은 2,048부터 |
include_chunks + max_chunk_tokens |
사실의 원문 청크 동봉 | 응답 크기 증가 | 인용이 필요한 답변 |
types, tags, tags_match |
메모리 종류·가시성 태그 필터 | 오히려 감소 | 사용자별 격리의 1차 수단 |
6. observation과 mental model: “배운다”의 실체
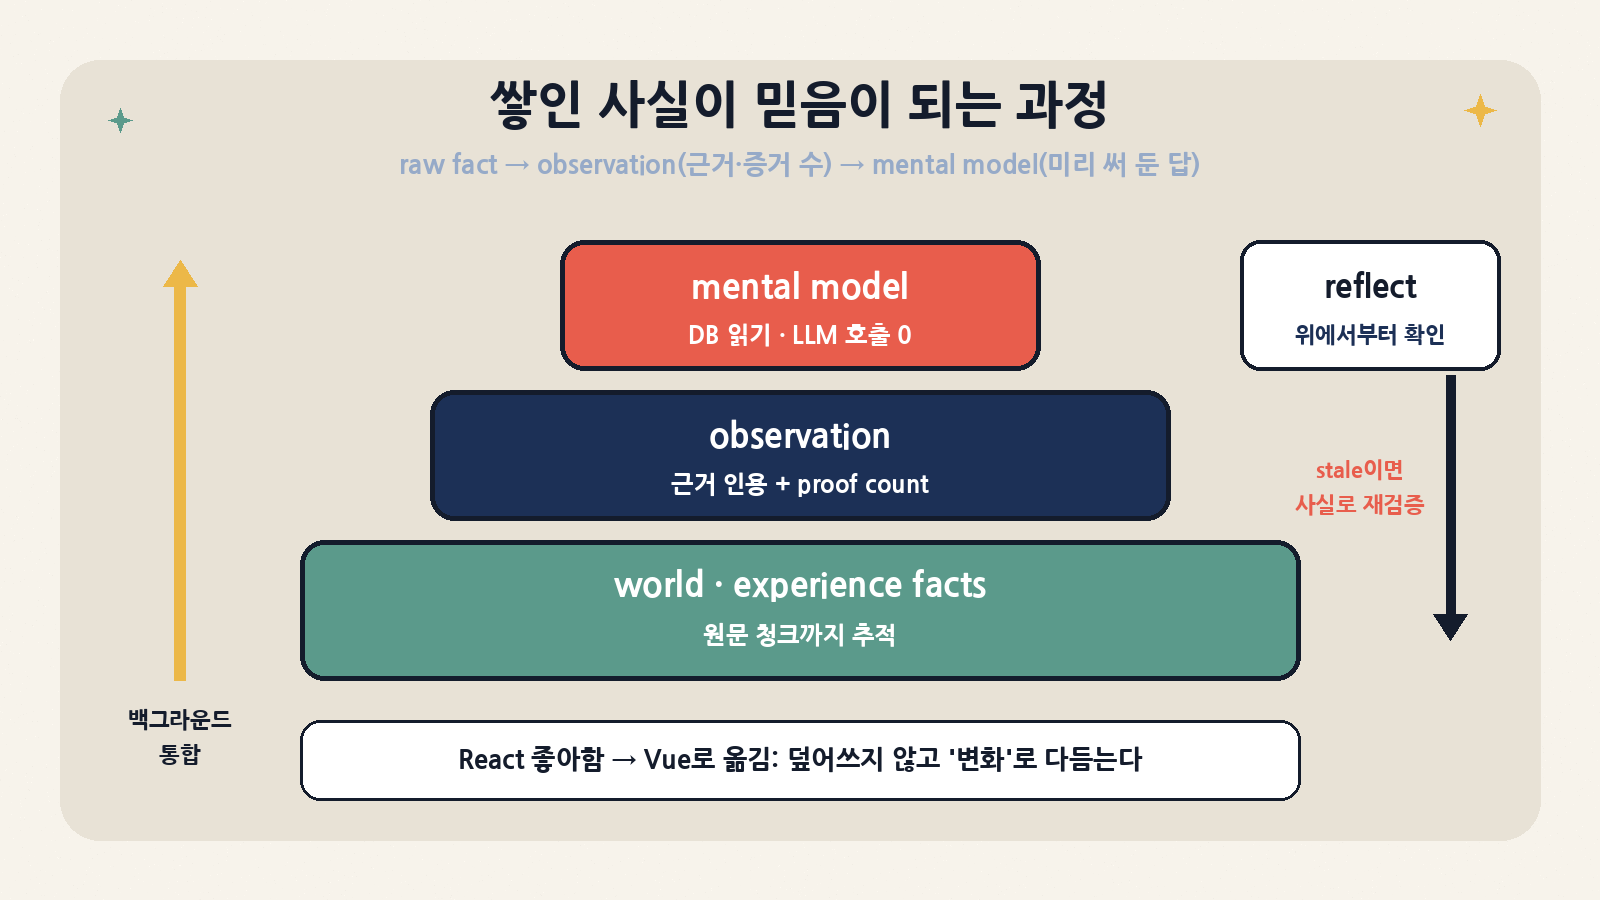
README의 “Agent Memory That Learns”라는 문구를 코드로 번역하면 consolidation입니다. retain이 끝나면 워커가 새 사실을 기존 observation과 비교해 새로 만들거나, 다듬거나, 병합합니다. 각 observation은 근거 사실의 정확한 인용과 증거 개수(proof count)를 들고 다니고, 새 증거가 오면 덮어쓰지 않고 정제됩니다. 문서 예시로는 “React를 좋아함” → “Vue로 옮겼고 React는 더 안 씀”이 단순 교체가 아니라 “예전엔 React 애호가였지만 지금은 Vue로 전환”이라는 변화의 서사로 남습니다.
| 설정/동작 | 기본값 | 의미 | 운영 팁 |
|---|---|---|---|
| 자동 consolidation | 켜짐 | retain·삭제·수정 후 백그라운드 실행 | 대량 적재 시 끄고 배치 후 수동 실행 |
CONSOLIDATION_DEDUP_THRESHOLD |
0.97 (코사인) | 거의 같은 observation 병합 여부 판정 | 1.0이면 비활성, PostgreSQL에서만 동작 |
| 태그 스코프 | 태그 조합별로 분리 | 세션 ID 같은 휘발성 태그면 세션마다 중복 observation | observation_scopes: "shared"로 전역 통합 |
| stale 표시 | 자동 | 아직 통합 안 된 새 사실이 있으면 해당 observation을 stale로 | reflect가 원 사실로 재검증 |
| mental model 읽기 | — | DB 읽기만, 검색·LLM 호출 없음 | 에이전트 부팅 시 “확정 지식 한 페이지” 주입 |
| knowledge page | — | mental model을 위키처럼 폴더로, 마크다운으로 디스크 투영 가능 | 코딩 에이전트의 아키텍처·컨벤션 문서로 활용 |
7. reflect: 메모리 위에서 도는 에이전트 루프
reflect는 “검색 결과를 LLM에 넣고 답하기”가 아니라 도구를 고르는 루프입니다. 최대 10회 반복하며, 증거를 하나도 모으지 않은 빈 답변은 가드레일로 막고, 실제로 조회된 ID만 인용할 수 있게 검증합니다. 뱅크에는 skepticism·literalism·empathy 세 가지 성향(disposition)과 지침(directive)을 줄 수 있어, 같은 기억이라도 지원 봇은 외교적으로, 코드 리뷰어는 직설적으로 답하게 만들 수 있습니다.
| reflect 도구 | 용도 | 우선순위 |
|---|---|---|
search_mental_models |
사용자 정의 상시 답변 검색 (예산 내 전문 + 나머지 스니펫) | 가장 먼저 |
read_mental_models |
스니펫만 받은 페이지의 전문 읽기 | 관련 있어 보일 때 |
search_observations |
통합된 믿음 검색 | 높음 |
recall |
원 사실(ground truth) 검색 | 폴백·재검증 |
expand |
특정 기억의 주변 맥락 확장 | 필요 시 |
done |
최종 답변과 인용 반환 | 근거가 충분할 때 |
비용 관점에서 정리하면 recall은 LLM 호출 없이(임베딩·리랭커만) 돌 수 있고, retain은 청크마다 사실 추출 LLM 호출, consolidation은 백그라운드에서 추가 호출, reflect는 루프 횟수만큼 호출이 생깁니다. 매 턴 reflect를 부르는 설계는 지연과 비용이 빠르게 커지니, 매 턴은 recall(low), 세션 시작과 중요한 판단만 reflect로 나누는 것이 현실적인 기본값입니다.
8. 설치와 실행 경로
| 방식 | 명령 | 저장소 | 적합한 경우 |
|---|---|---|---|
| Docker 단일 컨테이너 | docker run ... -p 8888:8888 -p 9999:9999 -e HINDSIGHT_API_LLM_API_KEY=... ghcr.io/vectorize-io/hindsight:latest |
내장 pg0 (볼륨 /home/hindsight/.pg0) |
가장 빠른 체험 |
| Docker Compose | cd docker/docker-compose && docker compose up |
외부 PostgreSQL | 팀 공용 서버 |
| pip (베어메탈) | pip install hindsight-api → hindsight-api |
기본 pg0, HINDSIGHT_API_DATABASE_URL로 교체 |
기존 Python 인프라 |
| 임베디드 | pip install hindsight-all → with HindsightServer(...) |
pg0 | 노트북·단일 프로세스 실험 |
| Kubernetes | helm install hindsight oci://ghcr.io/vectorize-io/charts/hindsight ... |
차트 내 PostgreSQL 또는 외부 | 운영 |
| LLM 래퍼 | pip install hindsight-litellm → wrap_openai(OpenAI(), bank_id=..., hindsight_api_url=...) |
서버 필요 | 기존 코드에 두 줄로 붙이기 |
| 코딩 에이전트 | npx @vectorize-io/hindsight-coding-agents install claude-code |
Cloud·자체 서버·로컬 데몬 중 선택 | Claude Code·Codex·Cursor CLI 등 |
| MCP | http://localhost:8888/mcp/{bank_id}/ |
서버 내장 | MCP 클라이언트에서 retain/recall/reflect 도구로 |
실무 함정 하나. hindsight-api를 extra 없이 설치하면 기본 임베딩·리랭커가 로컬 sentence-transformers를 가리키는데 패키지가 없어 시작 단계에서 실패한다는 경고가 뜹니다(박스에서 직접 확인). pip install "hindsight-api[local-ml]"로 torch를 받거나, HINDSIGHT_API_EMBEDDINGS_PROVIDER=openai(또는 tei·gemini)와 HINDSIGHT_API_RERANKER_PROVIDER=none(또는 tei)처럼 원격으로 돌려야 합니다. GPU 없는 서버라면 TEI 컨테이너를 따로 두는 구성이 관리가 쉽습니다.
8-1. 최소 사용 예
from hindsight_client import Hindsight
c = Hindsight(base_url="http://localhost:8888")

c.retain(bank_id="proj-api", content="결제 재시도는 멱등 키가 있는 POST만 허용하기로 했다",
         context="백엔드 리드 김OO이 회의에서 결정", timestamp="2026-10-20T10:00:00+09:00")

c.recall(bank_id="proj-api", query="결제 재시도 규칙", budget="low", max_tokens=2048)
c.reflect(bank_id="proj-api", query="새 결제 엔드포인트를 만들 때 지켜야 할 것은?")context에 화자를, timestamp에 실제 결정 시점을 넣는 것이 품질을 가장 싸게 올리는 방법입니다. 시간 검색과 consolidation의 모순 처리가 모두 이 두 값에 기대기 때문입니다.
9. 박스 스모크 테스트: 외부 키 없이 무엇을 확인했나
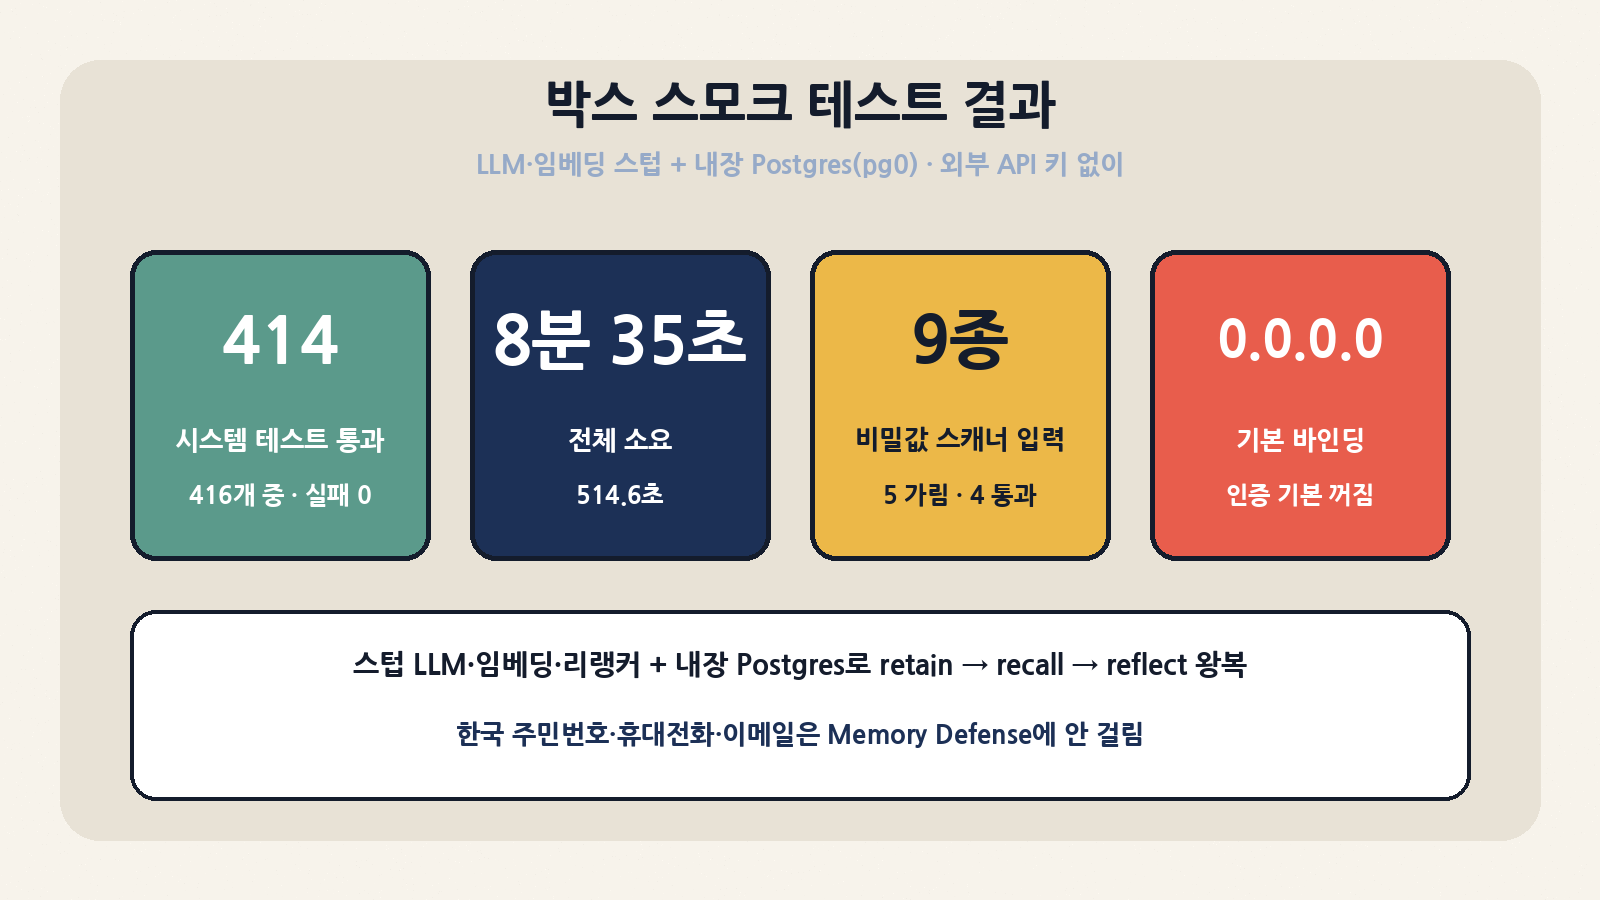
리포에는 LLM 채팅·임베딩(OpenAI 호환)과 Cohere 호환 리랭크를 흉내 내는 스텁 서버가 들어 있는 블랙박스 시스템 테스트(hindsight-system-tests)가 있습니다. 규칙은 요청 본문이 아니라 JSON 스키마 이름·프롬프트 일부로 매칭되고, 매칭 안 되는 호출은 그럴듯한 기본값 대신 테스트를 실패시킵니다. 실제 hindsight-api 프로세스를 띄우고 내장 PostgreSQL(pg0)을 쓰며, 테스트는 공개 Python 클라이언트로만 서버를 두드립니다. torch도, 모델 다운로드도, API 키도 필요 없어 박스에서 그대로 돌렸습니다(main 4822d66, Python 3.11.17, uv).
| 항목 | 결과 | 비고 |
|---|---|---|
| 블랙박스 시스템 테스트 | 414 passed, 2 skipped, 실패 0 (수집 416개) | uv run pytest tests, 514.62초(8분 35초) |
| 의존성 설치 | uv sync --frozen --extra embedded-db 약 2.3초 (캐시 상태) |
venv는 리포 루트 .venv에 생성 |
| 커버 범위(파일명 기준) | retain/recall, 4갈래 검색과 융합 기록, 토큰·recall 예산, 시간·극단 날짜, 문서 교체·추가·삭제·재처리, consolidation 실패 복구·모순·스코프, mental model 갱신 실패, 구조화 출력 등 | 테스트 파일 98개 |
| 스킵 2개 | ONNX 임베딩·ONNX 크로스인코더 실모델 테스트(test_76, test_77) | 실제 모델 파일이 필요한 선택 테스트 |
| 관찰된 로그 | 스텁 미매칭 ERROR 로그 2줄(reflect의 search_observations) | 해당 테스트는 통과, 의도된 실패 경로 검증으로 보임 |
hindsight-api --help |
기본 --host 0.0.0.0, --port 8888 |
local-ml extra 없이 설치 시 시작 실패 경고 출력 |
| Memory Defense 스캐너 | 가짜 값 9종 중 키·토큰·DB URL·카드 5종 가림, 이메일·주민번호·휴대전화·평문 4종 통과 | 호출당 0.01~0.04ms |
Memory Defense의 정규식 스캐너(apply_redaction)도 가짜 값으로 직접 호출해 봤습니다. 실제 키가 아닌 형식만 맞춘 문자열입니다.
| 입력 (가짜 값) | 결과 | 판정 |
|---|---|---|
OpenAI 프로젝트 키 sk-proj-… |
[REDACTED:openai_key] |
가려짐 |
GitHub 토큰 ghp_… |
[REDACTED:github_token] |
가려짐 |
AWS 액세스 키 AKIA… |
[REDACTED:aws_access_key] |
가려짐 |
postgresql://admin:…@db.internal:5432/app |
[REDACTED:db_url_postgres] |
가려짐 |
| 카드번호 4111 1111 1111 1111 | [REDACTED:credit_card] |
가려짐 (Luhn 검사) |
이메일 alice@example.com |
원문 그대로 | 통과 |
| 주민등록번호 형식 900101-1234567 | 원문 그대로 | 통과 |
| 휴대전화 010-1234-5678 | 원문 그대로 | 통과 |
| 평문 “Alice works at Google…” | 원문 그대로 | 정상 (오탐 없음) |
소스에서 확인한 패턴 라벨을 보면 PII는 credit_card와 미국 사회보장번호 ssn_us 정도이고 나머지는 API 키·토큰·DB URL입니다. 즉 Memory Defense는 “비밀값 필터”이지 한국형 개인정보 필터가 아닙니다. 주민번호·휴대전화·주소를 다루는 서비스라면 retain 앞단에 자체 마스킹을 두거나, 확장 슬롯(operation validator)에 국내 패턴을 추가해야 합니다. 또 정책은 기본 꺼짐이고, 켜도 이미 저장된 기억을 소급 스캔하지 않습니다.
테스트하지 않은 것도 분명히 적어 둡니다. 실제 LLM으로 사실을 추출하는 품질, LongMemEval·LoCoMo 재현, Docker·Helm 배포, 컨트롤 플레인 UI, 코딩 에이전트 훅 설치는 이번 박스 테스트 범위 밖입니다.
10. 벤치마크 수치는 어떻게 읽어야 하나
| 주장 | 출처 | 읽을 때 주의 |
|---|---|---|
| 20B 오픈 모델로 전체 정확도 39% → 83.6% (같은 백본 full-context 대비) | arXiv 2512.12818 초록 | 베이스라인이 “같은 모델에 전체 대화 통째로”라는 점 |
| LongMemEval 91.4%, LoCoMo 최대 89.61% (기존 최강 오픈 시스템 75.78%) | 논문 초록 | 백본을 키운 설정 기준, 판정자 LLM 의존 |
| 버지니아공대 Sanghani 센터·워싱턴포스트가 독립 재현 | README | 다른 시스템 점수는 “벤더 자체 보고”라고 README가 명시 |
| 코딩 에이전트: 61개 과제 정답률은 거의 동일, 교정 횟수·비용 감소 | AMB sdebench (coding-agents README) | 정확도가 아니라 “사람이 끼어드는 횟수”를 줄인다는 주장 |
| 에이전트 | 과제당 교정 횟수 (메모리 없음 → Hindsight) | 과제당 비용 |
|---|---|---|
| Claude Code | 0.85 → 0.36 | $0.445 → $0.338 |
| Codex CLI | 1.34 → 0.47 | $0.577 → $0.276 |
| opencode | 1.20 → 0.80 | $0.634 → $0.553 |
세 번 실행 평균이고 벤치마크 운영 주체(AMB)도 Vectorize 쪽 프로젝트라는 점을 감안해야 합니다. 도입을 판단할 때는 리포의 hindsight-system-evals(uv run run-amb --dataset locomo --split locomo10)로 자기 도메인 데이터를 넣어 보는 것이 가장 정직한 평가입니다. 특히 한국어 대화로 world/experience 분류, 개체 해소, 시간 표현(“지난주 금요일”, “추석 연휴”) 파싱이 얼마나 맞는지를 먼저 보시길 권합니다.
11. 비슷한 도구와 비교
| 프로젝트 | 라이선스 · 별 (10-25) | 접근 방식 | Hindsight와 다른 점 |
|---|---|---|---|
| vectorize-io/hindsight | MIT · 53.5k | 사실 추출 + 4갈래 검색 + observation 통합 + reflect 루프 | — |
| mem0ai/mem0 | Apache-2.0 · 67.8k | LLM으로 기억 추출·갱신, 벡터(+선택적 그래프) 저장 | 생태계가 가장 넓음. 증거 인용·성향 기반 추론 같은 계층은 얇음 |
| getzep/graphiti | Apache-2.0 · 32.2k | 시간 축을 가진 지식 그래프(bi-temporal 엣지) | 그래프 엔진(Neo4j 등) 중심. Hindsight는 PostgreSQL 하나로 벡터·키워드·그래프를 처리 |
| letta-ai/letta | Apache-2.0 · 25.3k | 에이전트 런타임 자체가 메모리 블록을 스스로 편집 | “에이전트 프레임워크”에 가깝고, Hindsight는 아무 에이전트에 붙는 메모리 서버 |
| topoteretes/cognee | Apache-2.0 · 32.7k | 문서 → 지식 그래프 ETL(cognify) + 검색 | 문서 지식 베이스 쪽 성향. 대화형 경험 축적은 Hindsight가 더 직접적 |
| langchain-ai/langmem | MIT · 1.7k | LangGraph 스토어 위의 메모리 도구·프롬프트 최적화 | 라이브러리 수준, 별도 서버·관리 UI 없음 |
| thedotmack/claude-mem | GitHub 표기 Apache-2.0 · 102.9k | 코딩 에이전트 세션 캡처·압축·주입 | 코딩 에이전트 전용. Hindsight는 범용 서버 + coding-agents 통합 패키지 |
12. 보안·운영 체크리스트: 기본값을 그대로 두면 안 되는 이유
가장 중요한 사실부터. 인증은 기본으로 꺼져 있고(HINDSIGHT_API_TENANT_EXTENSION 미설정 = auth disabled), 서버는 기본으로 0.0.0.0:8888에 바인딩되며(박스에서 hindsight-api --help로 확인), MCP 엔드포인트도 기본 공개입니다. README의 Docker 예시처럼 -p 8888:8888로 띄우면 같은 네트워크의 누구나 뱅크를 읽고 쓸 수 있습니다. 메모리 서버에는 사용자 선호, 프로젝트 결정, 때로는 대화 원문 청크가 들어가니, 노출 시 피해 범위가 일반 API보다 큽니다.
| 위험 | 기본 상태 | 조치 |
|---|---|---|
| 무인증 API·MCP | 꺼짐 | ApiKeyTenantExtension + HINDSIGHT_API_TENANT_API_KEY, 다중 사용자는 JWT 기반 커스텀 TenantExtension(또는 레지스트리의 Supabase·StaticKeys 확장)으로 스키마 분리 |
| 전 인터페이스 바인딩 | 0.0.0.0 |
--host 127.0.0.1 또는 -p 127.0.0.1:8888:8888, 앞단 리버스 프록시+TLS |
| 사용자 간 기억 혼입 | 뱅크 단위 격리는 엄격, 뱅크 안은 태그 필터에 의존 | 사용자마다 뱅크 분리가 가장 안전. 공유 뱅크면 태그 필터를 서버 측에서 강제 |
| 비밀값·개인정보 저장 | Memory Defense 꺼짐, 켜도 한국형 PII 미탐 | 정책 켜기 + 국내 패턴 자체 마스킹, 기존 데이터는 재적재 |
| 메모리 오염(지속형 프롬프트 인젝션) | retain은 들어온 말을 사실로 추출 | 외부 문서·웹 결과는 별도 뱅크/태그, 출처 context 명시, 중요한 mental model은 사람 검토 |
| 코딩 에이전트 패키지 자동 업데이트 | autoUpdate 켜짐 (하루 1회 npm 확인) |
회사 환경은 false로 고정하고 버전 핀 |
| 구독형 프로바이더(claude-code, openai-codex 등) | API 키 없이 사용 가능 | 서버형 상시 사용이 해당 서비스 약관에 맞는지 먼저 확인 |
| LLM 비용 폭주 | 자동 consolidation 켜짐 | Prometheus 지표로 LLM 호출·토큰 모니터링, 대량 적재 시 consolidation 일시 중지 |
라이선스는 MIT라 사내 포크·상용 제품 내장에 제약이 거의 없습니다. 다만 Hindsight Cloud(관리형, 사용량 과금)와 Enterprise가 별도로 있고, wrap_openai의 기본 대상이 Hindsight Cloud라는 점은 놓치기 쉽습니다. 자체 서버를 쓴다면 hindsight_api_url을 반드시 명시하세요. 그렇지 않으면 대화가 외부로 나갈 수 있습니다. 저장소로 Oracle AI Database 23ai도 지원하지만, observation 근접 중복 병합처럼 PostgreSQL에서만 동작하는 기능이 있습니다.
13. 도입 판단: 언제 쓰고 언제 쓰지 말까
| 상황 | 판단 | 이유 |
|---|---|---|
| 사용자별로 오래 대화하는 상담·코칭·영업 에이전트 | 적극 검토 | 선호 변화의 서사, 시간 질의, 성향 기반 reflect가 정확히 맞음 |
| 코딩 에이전트에 프로젝트 결정 기억시키기 | 검토 | git 히스토리·세션에서 자동 적재, knowledge page. 자동 업데이트·데이터 위치만 통제 |
| 사내 문서 Q&A (정적 문서 중심) | 보류 | 일반 RAG·하이브리드 검색이 더 싸고 단순. README도 단순 워크플로엔 과할 수 있다고 인정 |
| n8n 같은 단발성 자동화 | 대체로 과함 | retain마다 LLM 추출 비용이 붙음 |
| 엄격한 개인정보 규제 데이터 | 설계 후 도입 | 자체 마스킹, 뱅크 분리, 인증·감사 로그, 삭제 절차부터 |
13-1. 1주일 평가 플랜
| 일차 | 할 일 | 통과 기준 |
|---|---|---|
| 1 | hindsight-system-tests를 로컬에서 실행해 빌드 체인 확인 |
전부 통과, 스텁만으로 동작 |
| 2 | 인증·127.0.0.1 바인딩·외부 PostgreSQL로 서버 구성 | 키 없는 요청 401 |
| 3 | 실제 한국어 대화 200~500건 retain (화자 context·timestamp 포함) | world/experience 오분류율, 개체 병합 오류 샘플 점검 |
| 4 | recall budget·max_tokens 조합별 지연·적중 측정 | 매 턴 주입 p95 지연 목표 충족 |
| 5 | 모순 시나리오(선호 변경, 정정) 주입 후 observation 확인 | 덮어쓰기 대신 변화가 기록되는지 |
| 6 | reflect 비용·루프 횟수 측정, mental model 2~3개 정의 | 세션당 LLM 비용 상한 내 |
| 7 | Memory Defense + 자체 PII 마스킹, 오염 시나리오 테스트 | 주민번호·키가 저장되지 않음 |
마무리
Hindsight의 진짜 차별점은 “검색을 네 개 돌린다”가 아니라 증거(사실)와 추론(observation·mental model)을 구조적으로 분리하고, 추론에 근거를 매달아 두는 것입니다. 덕분에 에이전트가 왜 그렇게 기억하는지 추적할 수 있고, 생각이 바뀐 과정도 남습니다. 대신 쓰기 경로에 LLM이 깊게 들어가 비용과 품질이 추출 모델에 좌우되고, 기본값은 개발 편의에 맞춰져 있어 운영 전에 인증·바인딩·PII부터 손봐야 합니다. MIT 라이선스에 스텁 기반 E2E 테스트까지 갖춘 만큼, 우리 데이터로 직접 재 보기에는 진입 장벽이 낮은 편입니다.