회의가 끝나고 녹음 파일을 다시 들으며 회의록을 정리해 본 적 있으신가요? 1시간짜리 녹음이면 받아 적는 데만 두세 시간이 훌쩍 가고, 여러 명이 동시에 말한 부분은 “이건 누가 한 말이더라?” 하며 몇 번이고 되감게 되죠. 강의 녹음, 인터뷰, 유튜브 영상 자막도 마찬가지예요.
엔비디아가 10월 28일(미국 현지 시각, 한국 시각 29일) 바로 이 일을 겨냥한 AI를 누구나 무료로 내려받을 수 있게 공개했어요. 이름은 ‘네모트론 3.5 트랜스크라이브(Nemotron 3.5 Transcribe)’. 녹음을 글로 받아 적는 것은 물론, 누가 말했는지 구분하고, 영어로(또는 영어에서) 번역하고, 녹음 내용에 대한 질문에 답하는 일까지 모델 하나로 해요. 국내에서는 AI타임스가 29일 “오픈 모델 최고 정확도”라는 제목으로 이 소식을 전했고요.
반가운 건 한국어가 가장 잘하는 ‘최상위(Leading)’ 등급에 들어 있다는 점이에요. 오늘은 ① 무엇이 나왔는지, ② ‘받아쓰기 AI’가 어떻게 작동하는지, ③ 한국어로는 어디까지 되는지, ④ 일반인은 어떻게 써 볼 수 있는지, ⑤ 녹음을 AI에 맡길 때 지킬 매너까지 초보 눈높이로 차근차근 정리해 볼게요.
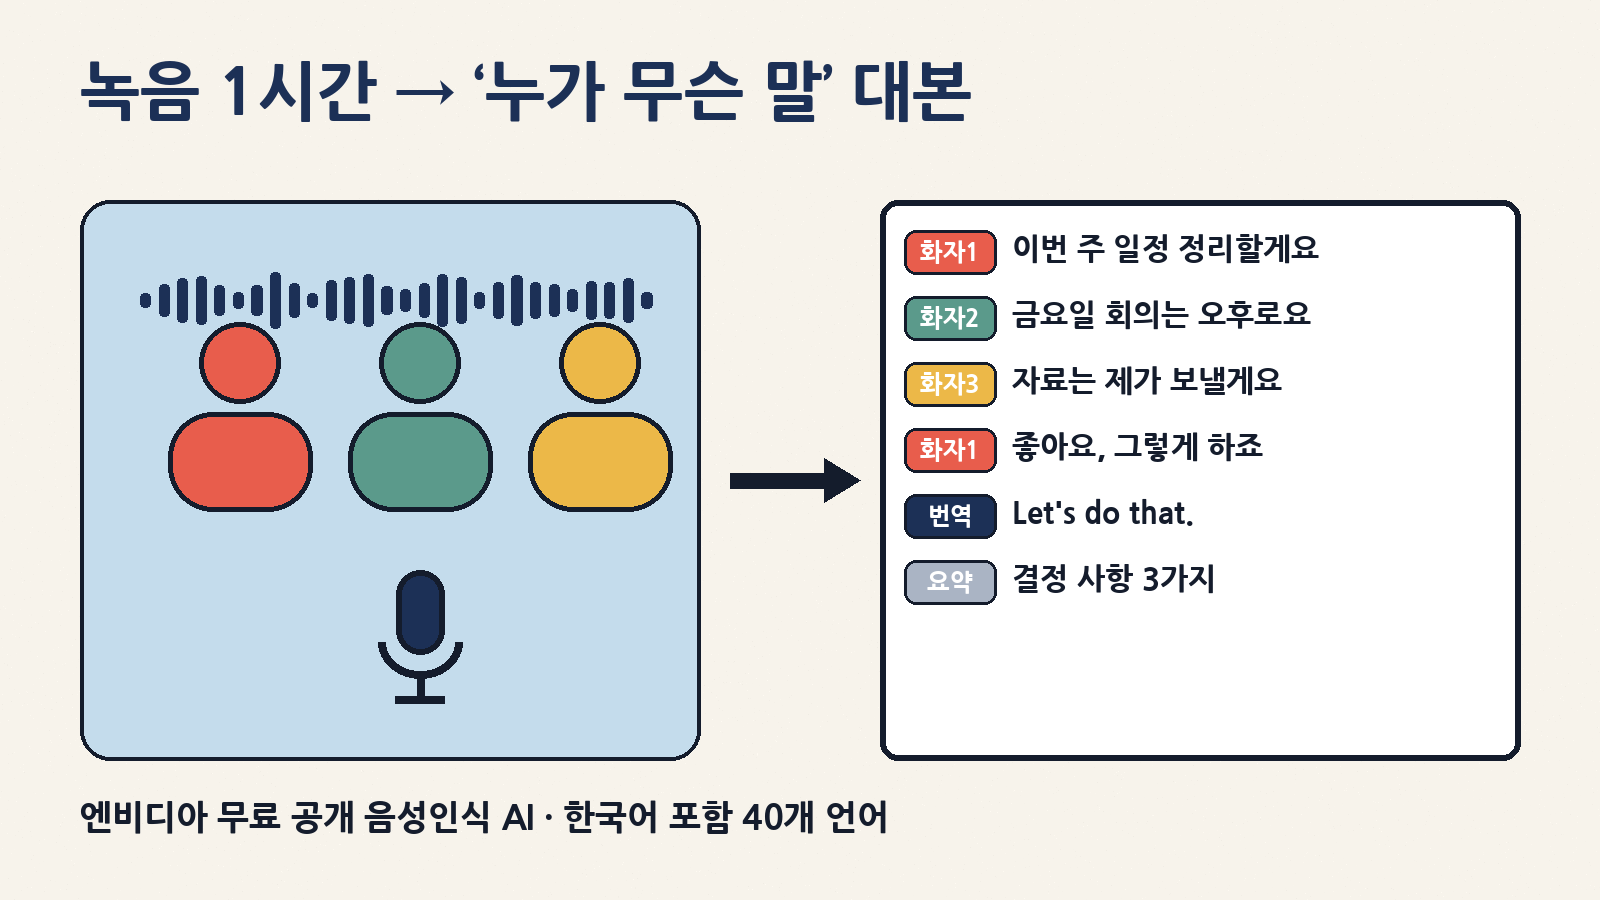
엔비디아가 한국어 포함 40개 언어를 받아 적고, 최대 8명의 목소리를 구분하며, 31개 언어를 영어와 서로 번역하는 음성 AI를 무료 공개(상업적 이용 가능)했어요. 최대 1시간 녹음을 한 번에 처리하지만 녹음 파일 전용이라 실시간 통역은 안 되고, 직접 돌리려면 고성능 GPU가 필요해 일반인은 웹 데모나 이 모델을 쓰는 서비스로 만나게 될 가능성이 커요.
무슨 일이 있었나요? 한눈에 보기
| 항목 | 내용 |
|---|---|
| 발표 | 엔비디아, 10월 28일(미국 현지 시각) 허깅페이스·모델스코프·엔비디아 개발자 사이트에 동시 공개 |
| 정식 이름 | NVIDIA-Nemotron-3.5-Transcribe-30B-A4B (줄여서 ‘네모트론 3.5 트랜스크라이브’) |
| 하는 일 | 받아쓰기, 화자(말한 사람) 구분, 단어별 시간 표시, 번역, 언어 알아맞히기, 녹음 내용 질문 답하기 |
| 언어 | 받아쓰기 40개 언어(한국어 포함) · 영어와 서로 번역 31개 언어 · 화자 구분 13개 언어 |
| 녹음 길이 | 한 번에 최대 1시간, 화자는 최대 8명까지 구분 |
| 가격·라이선스 | 무료로 내려받기 가능, ‘OpenMDW-1.1’ 라이선스로 상업적 이용도 허용 |
| 한계 | 녹음된 파일 전용(실시간 스트리밍 아님), 직접 돌리려면 데이터센터급 GPU 1장(H100 80GB 기준) |
| 함께 공개 | 음성 학습 데이터 ‘그래너리(Granary) v2’ — 48개 언어, 약 46만 시간 분량의 목록과 정리 도구 |
‘받아쓰기 AI’, 예전 것과 뭐가 다를까요?
예전의 음성 인식은 대체로 ‘들리는 대로 적는 기계’였어요. 회사가 처음에 정해 둔 규칙대로만 적었죠. 예를 들어 “이만 오천 원”을 “25,000원”으로 적을지 “이만 오천 원”으로 적을지는 이용자가 고를 수 없었어요. 또 누가 말했는지 가려내려면 ‘화자 분리’라는 별도 프로그램을 한 번 더 돌려야 했고요.
네모트론 3.5 트랜스크라이브는 여기에 챗GPT 같은 ‘언어 두뇌(대형 언어 모델)’를 붙였어요. 그래서 말로 지시할 수 있어요. 같은 회의 녹음이라도 이렇게 부탁하는 문장에 따라 결과가 달라지는 거죠.
| 이렇게 부탁하면 | 이런 결과가 나와요 | 어디에 좋을까 |
|---|---|---|
| “말한 사람을 구분해서 받아 적어 줘” | 화자1, 화자2… 표시가 붙은 대본 | 회의록, 인터뷰 정리 |
| “‘음’, ‘어’ 같은 군말은 빼고 읽기 좋게 적어 줘” | 깔끔하게 다듬은 문장 | 자막, 강의 노트 |
| “들리는 그대로, 더듬은 것까지 다 적어 줘” | 말버릇까지 살린 원본 대본 | 연구, 녹취록 검토 |
| “이 녹음을 영어로 번역해 줘” | 영어 번역문(한국어 포함 31개 언어 지원) | 해외 협력사 공유 |
| “용어 힌트: 당화혈색소, 메트포르민” | 어려운 전문용어를 올바른 철자로 적기 | 병원·법률·IT 회의 |
| “이 회의에서 결정된 게 뭐야?” | 녹음 내용을 바탕으로 한 답(영어에서만 검증) | 긴 녹음 훑어보기 |
엔비디아 설명에 따르면 실제로 의료 녹음 실험에서 지시문을 더 정확하게 쓰는 것만으로 단어 오류율이 30.8%에서 23.8%로 줄었고, 그 분야 녹음으로 추가 학습(파인튜닝)을 하자 새로운 화자 기준으로 오류가 45.8% 더 줄었다고 해요. ‘어떻게 부탁하느냐’가 결과를 바꾸는, 요즘 AI다운 특징이에요.
어떻게 작동하나요? 귀·목소리 구별·두뇌, 3단 구조
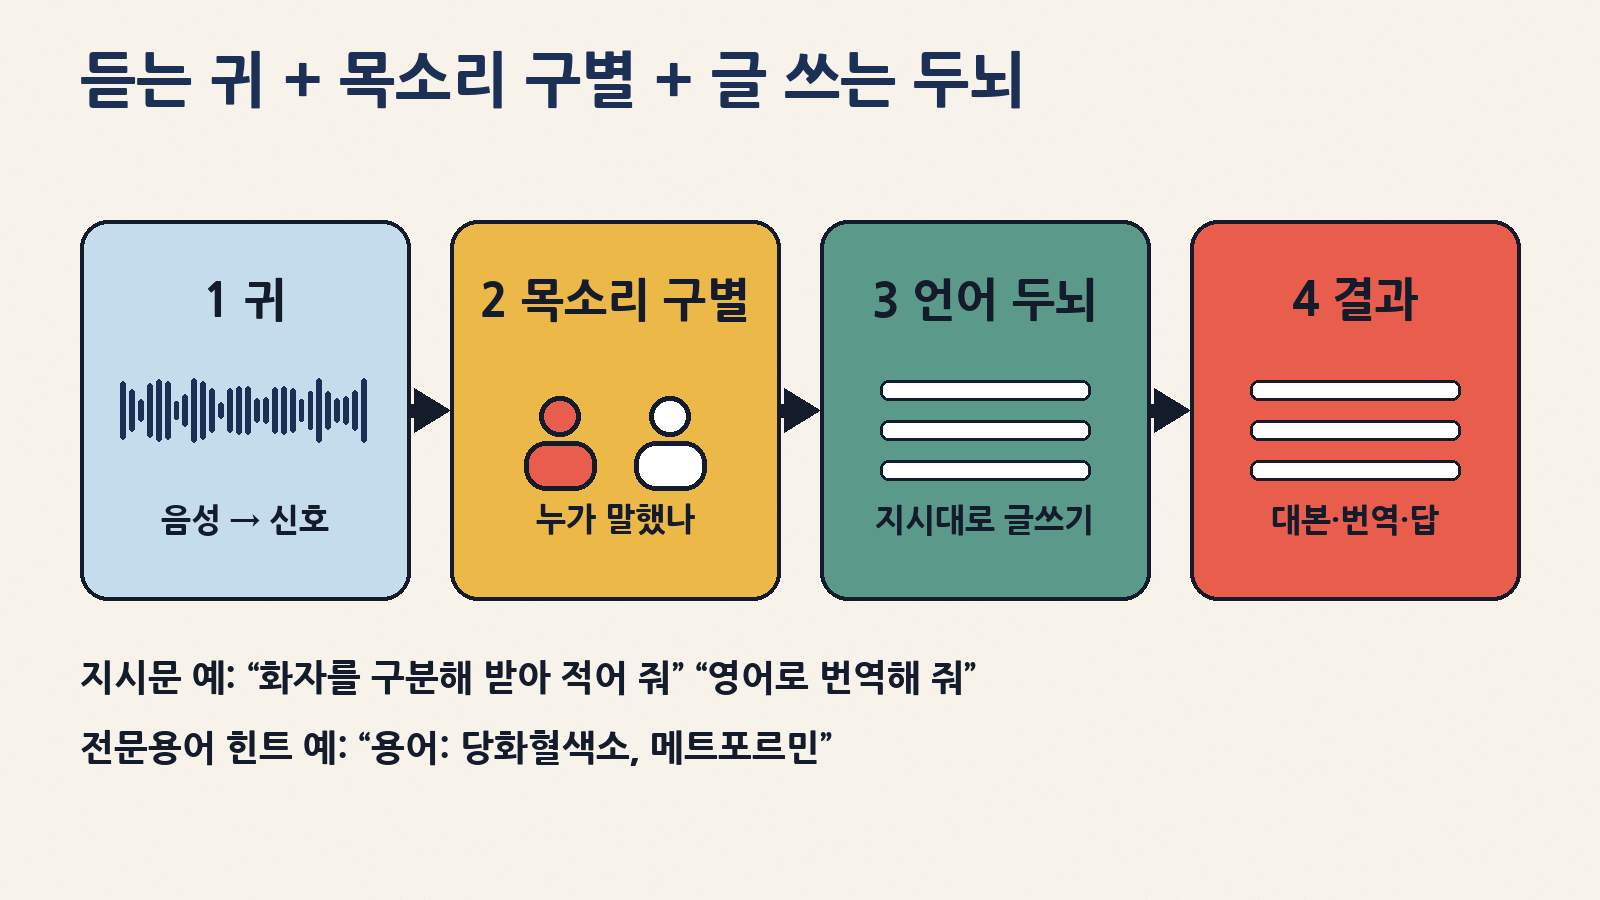
구조를 아주 쉽게 풀면 세 부품이 한 몸으로 묶여 있다고 보시면 돼요.
| 부품 | 비유 | 하는 일 |
|---|---|---|
| 음성 인코더(약 6억 개 매개변수) | 귀 | 소리를 AI가 다룰 수 있는 신호로 바꿔요 |
| 화자 인코더(약 1억 개) | 목소리 구별 담당 | ‘이 목소리는 아까 그 사람’처럼 목소리 특징을 가려내요 |
| 언어 모델 ‘네모트론 3.5 라이트닝’ | 글 쓰는 두뇌 | 지시문을 읽고, 들은 내용을 원하는 형식의 글로 써요 |
| 시간 정렬 장치 | 타임코드 담당 | 각 단어가 몇 분 몇 초에 나왔는지 표시해요 |
특히 화자 정보가 ‘두뇌’에 처음부터 함께 들어가서, 글을 쓰는 도중에 “여기서부터는 화자2”라고 바로 표시할 수 있어요. 예전처럼 받아 적기를 다 끝낸 뒤 나중에 화자를 덧붙이는 방식보다, 여러 명이 겹쳐 말하는 부분에 강하다는 게 엔비디아의 설명이에요.
‘340억 개인데 43억 개만 쓴다’는 말의 뜻
이 모델의 전체 매개변수(AI의 ‘뇌세포’ 같은 숫자)는 약 340억 개인데, 실제로 한 번에 움직이는 건 약 43억 개뿐이에요. ‘전문가 혼합(MoE)’이라는 방식인데요, 큰 병원에 의사가 많아도 환자 한 명을 볼 때는 그 분야 전문의 몇 명만 들어오는 것과 비슷해요. 덕분에 덩치에 비해 빠르고 전기도 덜 써요. 엔비디아는 서버용 GPU 한 장으로 100시간 분량 녹음을 3분 안에 처리했다고 밝혔어요(앞으로 나올 경량 버전 기준).
성적은 어느 정도인가요?
음성 인식 실력은 보통 ‘단어 오류율(WER)’로 매겨요. 100단어를 받아 적었을 때 몇 단어를 틀렸는지를 뜻해서, 숫자가 낮을수록 잘하는 거예요. 한국어처럼 띄어쓰기 단위가 애매한 언어는 글자 기준인 ‘글자 오류율(CER)’을 써요.
| 평가 | 네모트론 3.5 트랜스크라이브 | 비교 대상 | 쉽게 말하면 |
|---|---|---|---|
| 허깅페이스 오픈 ASR 리더보드(영어) | 공개 모델 중 1위 | API로만 쓰는 유료 모델은 제외한 순위 | 무료 공개 모델 중 영어 받아쓰기 최상위 |
| 다국어 평가(7개 언어 평균 WER) | 4.62% | 큐원3-ASR-1.7B 6.49% | 100단어 중 약 5개 틀림 |
| 1시간짜리 긴 녹음 평가(WER) | 10.98% | 파라키트-TDT-0.6B-v3 13.37% | 긴 녹음에서도 상대적으로 덜 틀림 |
| 한국어 받아쓰기(FLEURS, CER) | 2.78% | — | 100글자 중 약 3글자 틀림(낭독 음성 기준) |
| 여러 명 대화(화자 포함 오류율) | 15.80% | 다음 공개 결과 16.83% | 겹쳐 말하는 회의에서 최고 기록 |
위 숫자는 또박또박 읽은 문장이나 정해진 평가용 녹음에서 나온 결과예요. 시끄러운 카페, 사투리, 전화 통화, 여러 명이 동시에 웃고 떠드는 자리에서는 더 틀릴 수 있어요. 엔비디아도 “이름·화자가 바뀌는 부분·답변은 원본 녹음과 꼭 대조하라”고 안내하고 있어요.
한국어로는 어디까지 되나요?
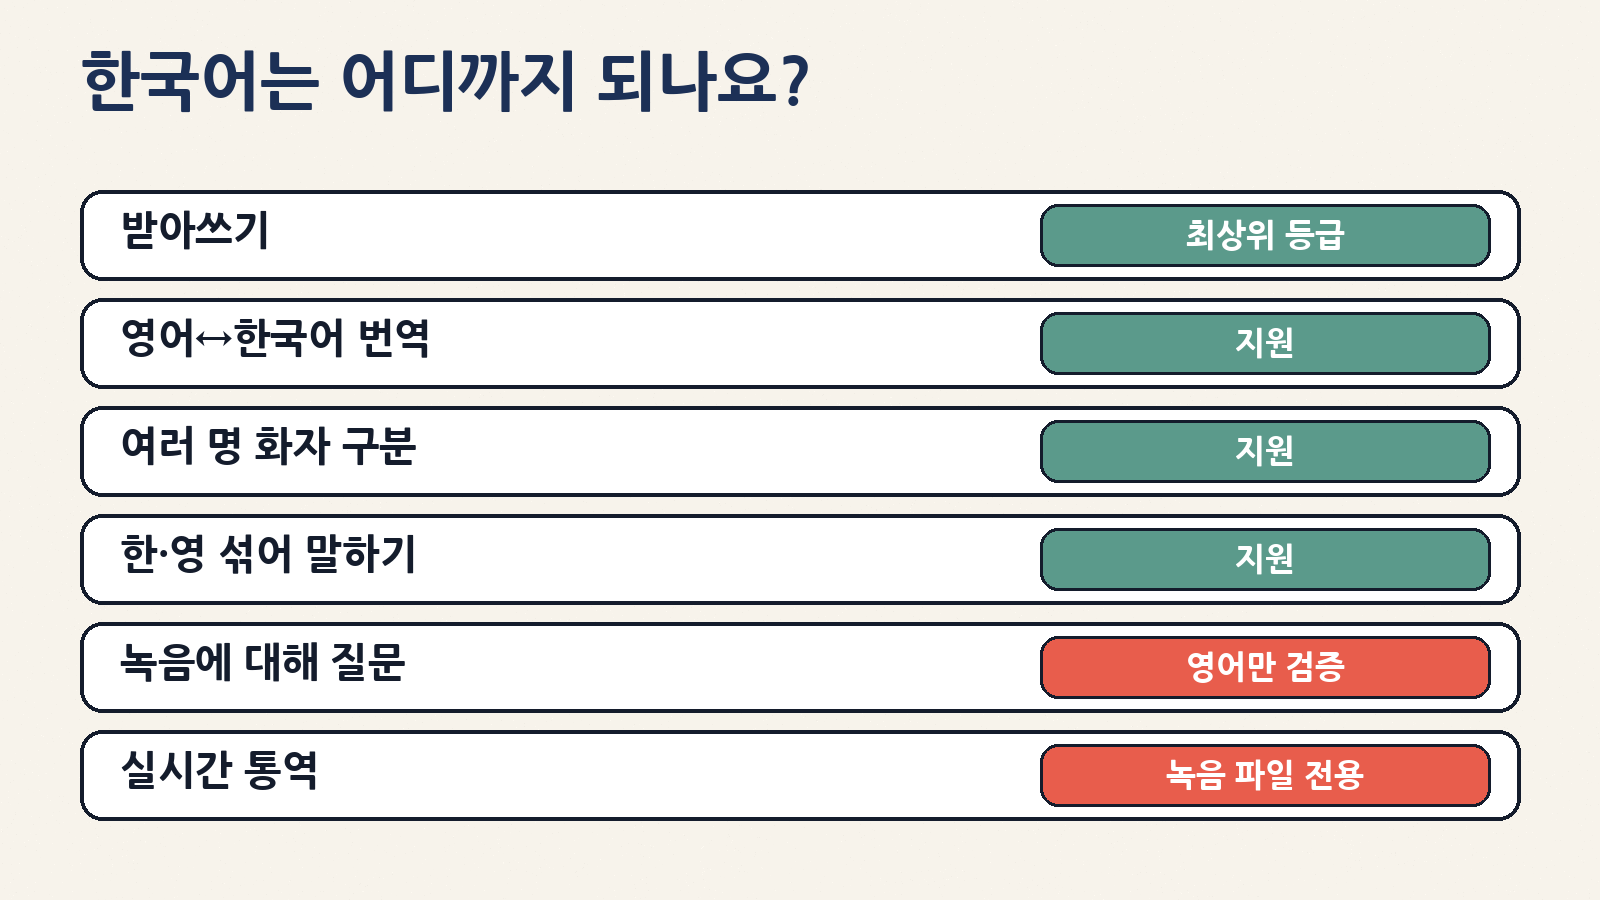
엔비디아가 공개한 ‘언어별 지원표’를 보면 한국어는 영어·프랑스어·독일어 등과 함께 가장 높은 ‘최상위(Leading)’ 등급이에요. 별도 추가 학습 없이도 최고 수준에 가깝다는 뜻이죠. 같은 표에서 일본어는 한 단계 아래 ‘실사용 가능(Production-ready)’, 중국어(만다린)는 ‘지원(Supported)’ 등급이었어요.
| 기능 | 한국어 | 설명 |
|---|---|---|
| 받아쓰기 | 지원(최상위 등급) | 한국어 녹음을 한국어 글로 |
| 영어와 서로 번역 | 지원 | 한국어 녹음을 영어 글로, 영어 녹음을 한국어 글로 |
| 여러 명 화자 구분 | 지원 | 화자 구분이 되는 13개 언어에 한국어 포함 |
| 언어 섞어 말하기 | 지원 | “이번 미팅 어젠다는 리뷰부터” 같은 한·영 혼용 |
| 녹음 내용 질문·답 | 영어에서만 검증 | 한국어 녹음에 질문하면 엉뚱한 답이 나올 수 있어요 |
| 실시간 통역·자막 | 지원 안 함 | 녹음이 끝난 파일만 처리해요 |
참고로 실시간 받아쓰기가 필요한 개발자를 위해 엔비디아는 별도의 작은 실시간용 모델(네모트론 3.5 ASR 스트리밍, 약 6억 개 매개변수)도 허깅페이스에 올려 두었어요. 이 모델 역시 한국어를 바로 쓸 수 있는 언어로 분류해 두었어요. 다만 오늘 소개하는 트랜스크라이브와는 다른, 더 단순한 모델이에요.
그럼 나는 어떻게 써 볼 수 있나요?
솔직히 말씀드리면, 이 모델을 집 컴퓨터에서 직접 돌리기는 아직 어려워요. 엔비디아가 기준으로 든 장비가 데이터센터용 GPU(H100 80GB) 한 장이거든요. 지원 목록에 일반 소비자용으로는 최고급 그래픽카드(RTX 5090)가 올라 있고, 노트북·소형 PC에서 돌릴 수 있는 가벼운 버전은 “곧 나온다”고 했어요. 그래서 지금 일반인이 만날 수 있는 길은 크게 세 가지예요.
| 방법 | 누구에게 | 어떻게 | 주의할 점 |
|---|---|---|---|
| ① 웹 데모 | 궁금해서 한번 들어 보고 싶은 분 | 허깅페이스·모델스코프의 공개 데모 페이지에 짧은 녹음을 올려 보기 | 공개 데모에는 개인정보·회사 기밀이 담긴 녹음을 올리지 마세요 |
| ② 이 모델을 쓰는 서비스 | 회의록·자막 앱을 쓰는 직장인·학생 | 앞으로 회의록·자막 서비스들이 이 모델을 넣을 가능성이 커요 | 서비스마다 녹음 보관·학습 활용 정책을 확인 |
| ③ 회사에서 직접 운영 | IT 담당자·개발자 | 내려받아 사내 서버에서 돌리거나, 베이스텐·딥인프라 같은 호스팅 업체 이용 | 녹음이 회사 밖으로 나가지 않게 설계 가능 — 이게 공개 모델의 큰 장점 |
③번이 특히 의미가 커요. 병원 진료 녹음이나 법률 상담처럼 밖으로 내보내기 곤란한 녹음도, 공개 모델이면 회사 안 컴퓨터에서만 처리할 수 있거든요. 엔비디아도 “오디오를 어디서 처리할지 개발자가 고를 수 있다”는 점을 장점으로 내세웠어요.
다른 받아쓰기 방법과 비교하면?
| 구분 | 스마트폰 녹음 앱 받아쓰기 | 유료 클라우드 회의록 서비스 | 네모트론 3.5 트랜스크라이브(직접 운영) |
|---|---|---|---|
| 쓰기 쉬움 | 가장 쉬움(버튼 하나) | 쉬움(가입·업로드) | 어려움(서버·GPU 필요) |
| 비용 | 대체로 무료 또는 기본 제공 | 월 구독료 | 모델은 무료, 대신 GPU 비용 |
| 녹음이 가는 곳 | 기기 또는 제조사 서버(제품마다 다름) | 서비스 회사 서버 | 내가 정한 컴퓨터·서버 |
| 원하는 형식 지시 | 제한적 | 서비스가 정한 기능 위주 | 지시문으로 자유롭게 |
| 전문용어 맞추기 | 어려움 | 일부 서비스에서 단어 등록 | 용어 힌트·추가 학습 가능 |
| 실시간 | 되는 경우 많음 | 되는 경우 많음 | 안 됨(녹음 파일 전용) |
정리하면, 지금 당장 개인이 쓰기에는 이미 쓰고 계신 녹음 앱이나 회의록 서비스가 여전히 편해요. 이번 발표의 진짜 의미는 “최고 수준의 다국어 받아쓰기 AI가 무료로 풀렸다”는 데 있어요. 앞으로 국내외 앱들이 이 모델을 가져다 쓰면서 받아쓰기 품질은 올라가고 가격은 내려갈 가능성이 커진 거죠.
왜 하필 지금, 엔비디아가 무료로 풀었을까요?
테크크런치는 이번 공개를 두고 “음성 AI가 대세(Voice AI in vogue)”라고 표현했어요. 회의 기록과 의료 받아쓰기는 기업이 AI를 가장 먼저, 가장 많이 쓰는 분야 중 하나예요. 엔비디아 입장에서는 모델을 무료로 풀어 많이 쓰이게 할수록 그 모델을 돌리는 자사 GPU가 더 팔리는 구조예요. 모델 설명서에도 “엔비디아 GPU에서 가장 잘 돌도록 최적화했다”고 적혀 있어요.
| 누가 | 얻는 것 |
|---|---|
| 엔비디아 | 자사 GPU·소프트웨어 생태계 확대, 음성 AI 시장에서 존재감 |
| 앱·서비스 회사 | 비싼 유료 API 대신 무료 고성능 모델로 기능 개발 |
| 병원·법률·공공기관 | 녹음을 밖으로 내보내지 않고 내부에서 처리할 선택지 |
| 일반 이용자 | 시간이 지나면서 더 정확하고 저렴한 받아쓰기·자막 서비스 |
녹음을 AI에 맡기기 전, 꼭 지킬 4가지
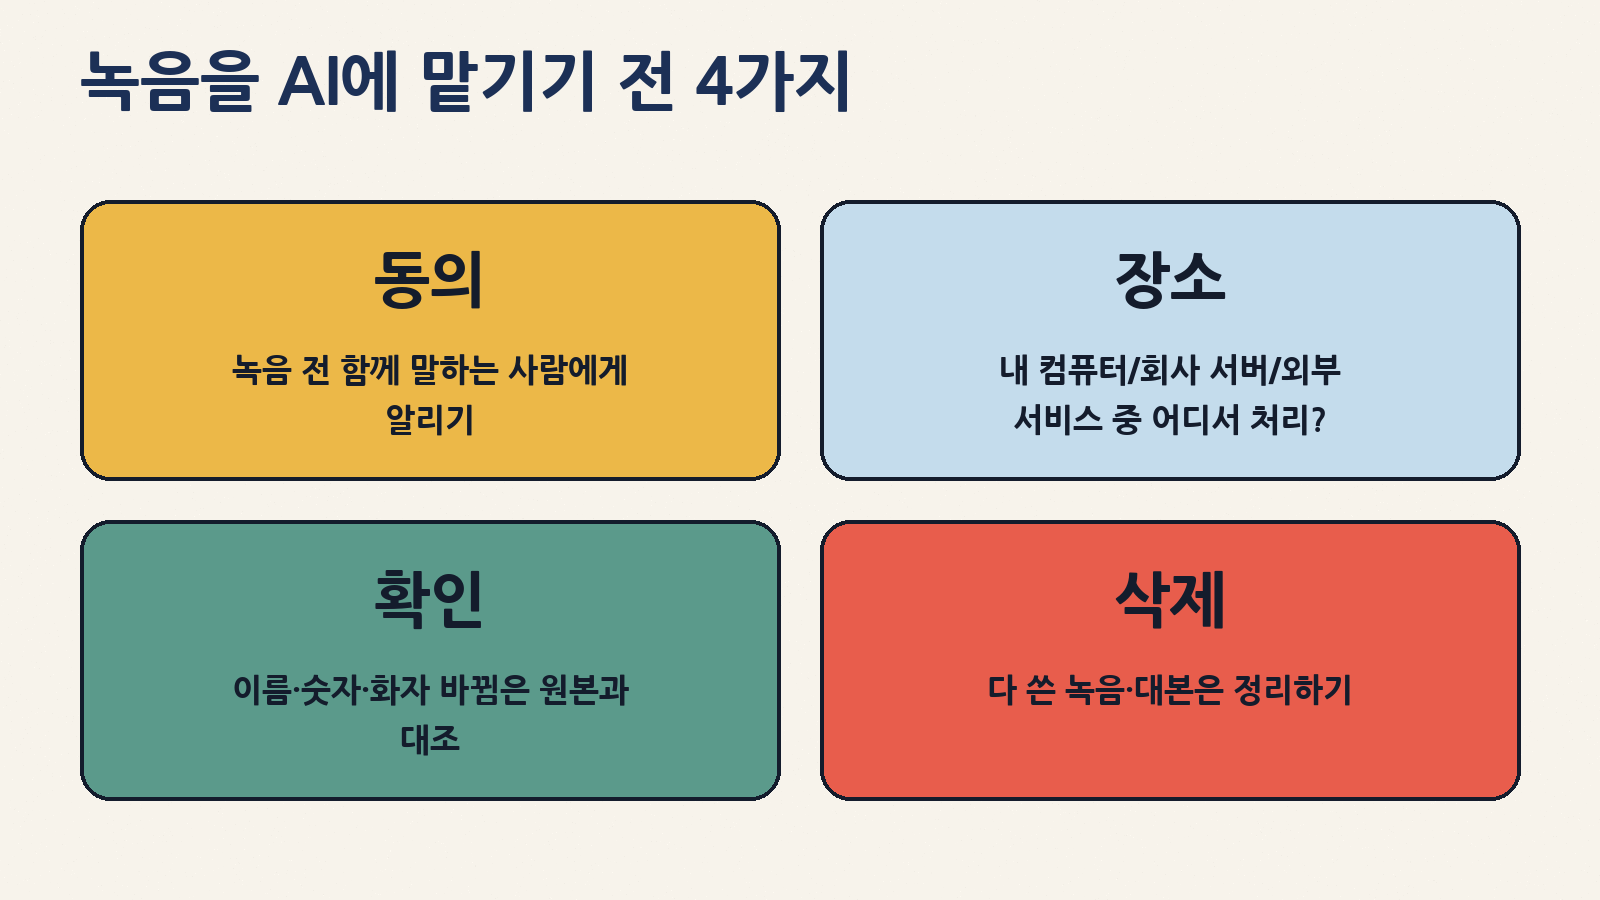
| 습관 | 왜 중요할까 | 이렇게 해요 |
|---|---|---|
| ① 녹음 전에 알리기 | 함께 말하는 사람의 목소리와 말도 개인정보예요 | “정리용으로 녹음해도 될까요?” 한마디 먼저. 내가 대화에 참여하지 않은 남의 대화를 몰래 녹음하는 건 우리나라에서 불법이에요 |
| ② 처리 장소 확인하기 | 공개 데모·외부 서비스에 올리면 녹음이 남의 서버로 가요 | 회사 회의·진료·상담 녹음은 회사가 허용한 도구에서만 |
| ③ 원본과 대조하기 | AI는 이름·숫자·화자 바뀜에서 자주 틀려요 | 금액·날짜·사람 이름·결정 사항은 녹음을 다시 들어 확인 |
| ④ 다 쓴 파일 정리하기 | 녹음·대본이 쌓이면 유출 시 피해가 커져요 | 회의록을 확정했으면 원본 녹음은 보관 기간을 정해 지우기 |
AI가 붙이는 ‘화자1, 화자2’는 같은 녹음 안에서 목소리를 구분한 표시일 뿐이에요. 엔비디아도 “화자 표시는 실제 신원을 확인해 주지 않는다”고 못 박았어요. 회의록에 이름을 붙이는 건 사람이 직접 확인한 뒤에 하세요.
자주 묻는 질문
| 질문 | 답 |
|---|---|
| 정말 무료인가요? | 네, 모델 파일 자체는 무료로 내려받을 수 있고 상업적 이용도 허용돼요. 다만 돌리는 데 드는 GPU·서버 비용은 별도예요. |
| 카카오톡 음성 메시지나 통화 녹음도 되나요? | 녹음 파일 형식(wav, mp3 등)이면 처리할 수 있어요. 다만 통화 녹음은 음질이 낮아 오류가 늘 수 있고, 상대방 동의 매너는 꼭 지켜 주세요. |
| 유튜브 영상 자막 만들 때 써도 되나요? | 단어별 시간 표시 기능이 있어 자막 제작에 잘 맞아요. 단, 다른 사람의 영상이라면 저작권을 먼저 확인하세요. |
| 2시간짜리 강의는요? | 한 번에 학습된 길이는 최대 1시간이라, 1시간 이하로 나눠 처리하는 게 안전해요. |
| 한국어 녹음을 바로 영어 회의록으로? | 네, 한국어는 영어와 서로 번역되는 31개 언어에 들어 있어요. 번역문도 중요한 부분은 사람이 한 번 더 확인하세요. |
마무리: ‘받아 적는 시간’이 줄어드는 시대
네모트론 3.5 트랜스크라이브는 당장 내 스마트폰에 깔리는 앱은 아니에요. 하지만 한국어를 최상위 수준으로 받아 적고, 누가 말했는지까지 가려내는 AI가 무료로 공개됐다는 건 우리가 매일 쓰는 회의록·자막·강의 노트 서비스가 조만간 더 좋아질 거라는 신호예요. 그때를 위해 오늘 기억해 두실 건 딱 두 가지예요. 녹음 전에는 알리고, 결과는 원본과 대조하기. 이 두 습관만 있으면 받아쓰기 AI를 훨씬 안심하고 쓰실 수 있을 거예요.