한 줄 요약: magnitudedev/magnitude(Apache-2.0, 최신 @magnitudedev/cli@0.2.15, 스타 약 7.6k)는 “모든 칩에 같은 커널”을 버리고, 모델을 받는 순간 내 하드웨어에서 최대 60초 동안 커널 구성을 직접 측정해 고르는 Rust 추론 엔진입니다. 오늘(10/30) GitHub Trending Rust 일간 10위(+141)에 올랐습니다. 이 글은 README의 “Ollama보다 2배 빠름” 문구 대신, 저장소의 설계 문서(inference/docs/tuning.md, precision.md, kernels/drafting-and-verification.md)와 릴리스 바이너리를 GPU 없는 박스에서 실제로 돌린 결과를 근거로 구조와 트레이드오프를 정리합니다.
1. 무엇을 하는 프로젝트인가 — “튜닝된 커널” + “에이전트 연결”의 묶음
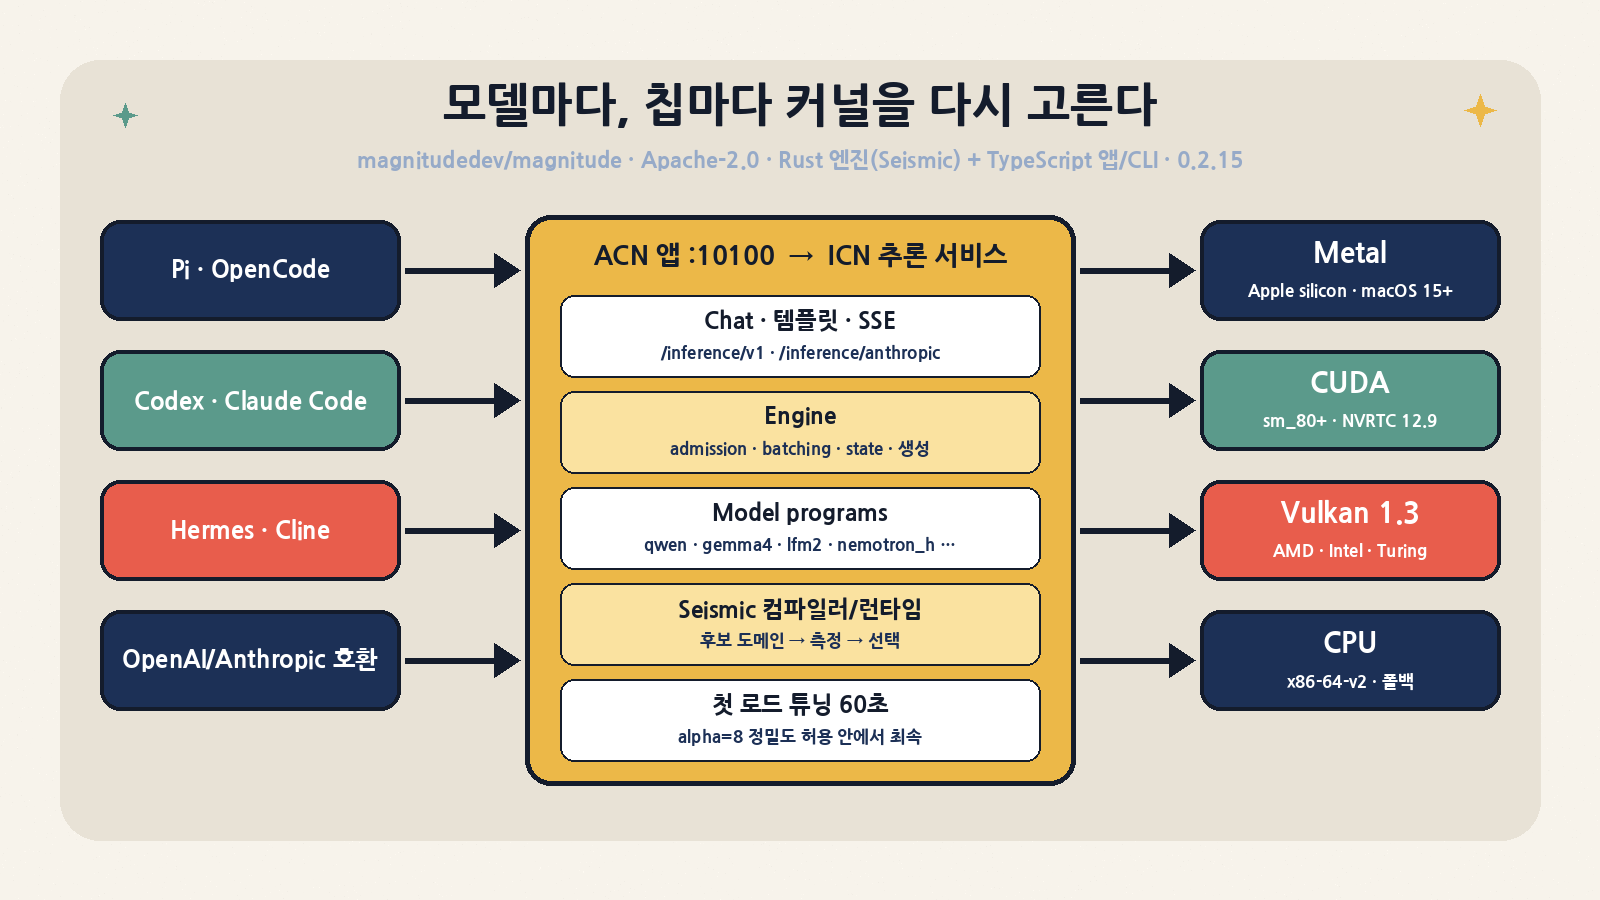
Magnitude는 두 층으로 나뉩니다. 아래층은 ICN(Inference Compute Node)이라 부르는 추론 서비스(magnitude-inference)와 그 안의 엔진·Seismic 컴파일러이고, 위층은 데스크톱 앱/CLI와 에이전트 런타임(ACN)입니다. 사용자 입장에서 보이는 것은 127.0.0.1:10100에 열리는 OpenAI·Anthropic 호환 API와, Pi·OpenCode·Hermes·Codex·Claude Code·Cline 등을 “원클릭”으로 이 API에 붙여 주는 Connections 기능입니다.
차별점은 엔진 쪽에 있습니다. llama.cpp·Ollama·LM Studio가 범용 커널 하나를 모든 GPU에 배포하는 반면, Magnitude는 지원 모델 패밀리별로 커널을 직접 작성하고(Qwen·Gemma 4·LFM·Nemotron-H·MiniCPM 등), 모델을 내려받을 때 “GPU 스레드를 몇 개씩 묶을지, 한 스레드가 얼마나 큰 덩어리를 맡을지, 데이터를 얼마나 앞서 불러올지”를 실제 칩에서 측정해 출력을 바꾸지 않는 범위에서 가장 빠른 조합을 저장합니다. README가 내세우는 수치는 인기 로컬 모델 11개 평균 기준 Mac에서 프리필 1.32배·디코드 2.19배, NVIDIA에서 1.34배·2.17배(대 Ollama)입니다.
| 항목 | 값 (2026-10-30 KST 확인) | 비고 |
|---|---|---|
| 저장소 | magnitudedev/magnitude | 2026-06-12 생성, 주 언어 Rust |
| 라이선스 | Apache-2.0 | 번들 NVRTC는 별도 NVIDIA 라이선스 파일 동봉 |
| 최신 릴리스 | @magnitudedev/cli@0.2.15 | 10/30 10:40 KST, 소스 커밋 0754172 |
| 스타 / 포크 | 약 7,568 / 540 | GitHub API 기준, Trending Rust 일간 10위(+141) |
| 릴리스 속도 | 10/15 0.2.9 → 10/30 0.2.15 | 보름 새 패치 7회 (사실상 일 단위 배포) |
| 코드 규모 | 추적 파일 5,413개 · Rust 약 64만 줄 · TS 약 26만 줄 · Python 약 3만 줄 | 얕은 클론 실측, 테스트·벤치 포함 |
| 카탈로그 | 30개 모델 항목: supported 23 · disabled 6 · deprecated 1 | inference/catalog/models.json |
최근 2주 릴리스 노트를 보면 엔진보다 “에이전트 연결과 모델 관리” 쪽 변화가 빠릅니다. 트렌딩 진입 배경도 Claude Code를 로컬 모델에 붙이는 기능과 커스텀 GGUF 지원이 맞물린 결과로 보입니다.
| 버전 | 배포 (KST) | 핵심 변경 |
|---|---|---|
| 0.2.9 | 10/15 15:01 | Claude 로그인 없이 Claude Code 연결 — 서브에이전트 요청까지 로드된 로컬 모델 사용 |
| 0.2.10 | 10/20 14:56 | 통합 메모리(GB10·Apple silicon)에서 1회 최적화가 이미 로드된 모델 메모리를 계산하도록 수정 |
| 0.2.11 | 10/26 17:54 | 지원 패밀리의 임의 GGUF 실행(다른 양자화·파인튜닝·병합·uncensored 포함) |
| 0.2.12 · 0.2.13 | 10/28 04:49 · 12:59 | 앱 UX 개선, Discover 화면의 반복 assessing 깜빡임 수정 |
| 0.2.14 | 10/29 16:19 | 카탈로그 정렬: 내 기기 50K 컨텍스트 예상 속도(Fastest) 또는 지능 점수(Most intelligent) |
| 0.2.15 | 10/30 10:40 | Anthropic 호환 messages·count_tokens가 임의 anthropic-version 헤더(또는 헤더 없음) 허용 |
2. 저장소 구조 — 모노레포 안의 “제품”과 “엔진”
루트는 Bun/Turbo 기반 TypeScript 모노레포(cli/, desktop/, web/, packages/*)이고, 실제 추론은 inference/ Rust 워크스페이스가 담당합니다. 계층 규칙이 엄격하게 문서화돼 있는데, 클라이언트는 client-common과 sdk만 import하고, SDK는 Effect RPC로 ACN 데몬과 통신하며, ACN은 에이전트 런타임·세션·파일 연산을 호스팅합니다. 추론은 다시 ICN에 위임됩니다.
| 경로 | 역할 | 실무 관점 메모 |
|---|---|---|
inference/engine/ |
모델 패밀리, 스케줄러, 생성, 상태, 서빙 라우터, magnitude-engine 헤드리스 CLI |
families/에 qwen·qwen35·gemma4·lfm2·llama·nemotron_h·dflash 등 |
inference/seismic/ |
커널 언어·컴파일러·런타임·백엔드(CPU/Metal/CUDA/Vulkan) | “후보 도메인 → 측정 → 선택”의 본체 |
inference/service/ |
HTTP 서비스, 카탈로그, 하드웨어 평가(assessment), 워커 수명주기 | 관리 API /api/v1/* + 서빙 라우트 |
inference/catalog/ |
모델 카탈로그·플래너 입력 | 지원 수준(supported/disabled)과 사유가 명시됨 |
inference/evaluation/ |
mrig 계측 도구, 레퍼런스, 서빙 벤치 |
품질·속도 검증은 여기서 (Python, uv) |
packages/acn*, agent, providers |
에이전트 런타임과 프로토콜 | 이벤트 소싱 기반 세션, bun session으로 재생 |
아키텍처 문서(inference/docs/overview.md)의 책임 분리가 명확합니다. 엔진은 “무엇을 계산할지와 언제 받아들일지(admission·batching·state)”를, Seismic은 “어떻게 물리적으로 실행할지(컴파일·자원·디바이스)”를 소유합니다. 원칙 중 실무자가 눈여겨볼 문장은 “하드웨어를 모델 아래에 둔다(Keep hardware below the model)”와 “성능은 설명 가능해야 한다(Make performance explainable)”입니다. 실제로 박스에서 로그를 열어 보면 유닛별 튜닝 결정, 메모리 계정, 로드 단계 시간이 모두 구조화돼 찍힙니다.
3. 핵심 메커니즘 ① — 첫 로드 60초 튜너
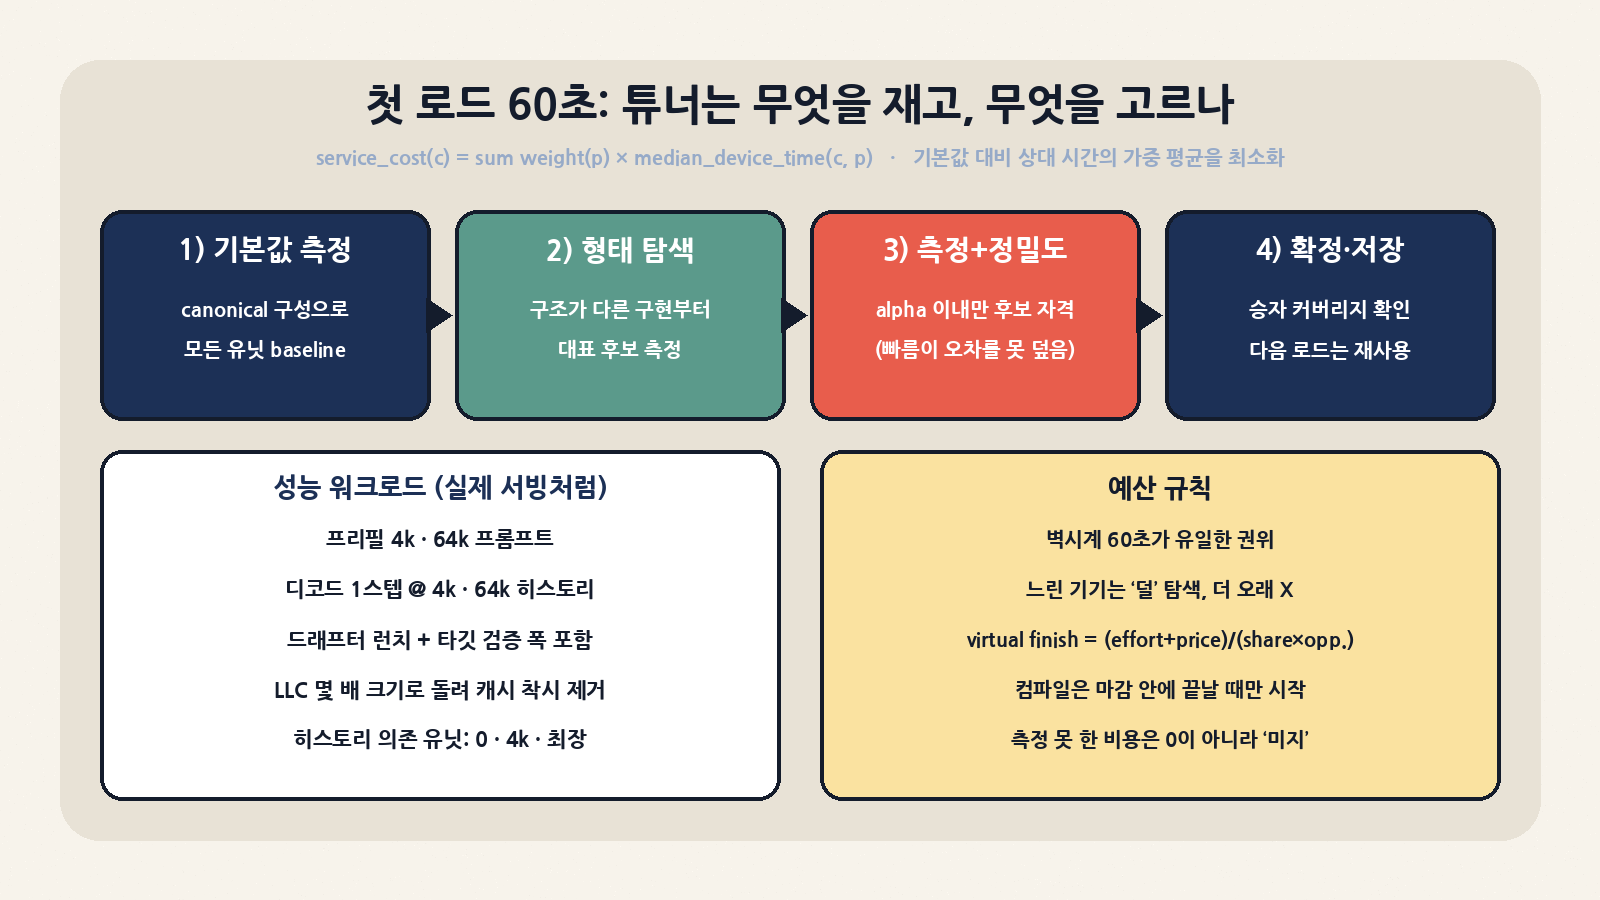
tuning.md는 튜너를 “한 번의 첫 로드 허용 시간 안에서, 증거로 뒷받침되는 합법적 구성 중 가장 빠른 것을 고르는 장치”로 정의합니다. 서빙 허용 시간은 60초이고, 표준 구성 생성·입력 구성·기본값 측정·후보 컴파일·비교·확정·결과 저장까지 전부 이 시계 안에 들어갑니다. 시계 밖으로 일을 빼서 총합을 작아 보이게 만드는 것은 명시적으로 금지돼 있습니다.
최적화 목표는 단순 커널 속도가 아니라 실제 서빙 워크로드의 가중 비용입니다.
service_cost(c) = Σₚ weight(p) × median_device_time(c, p)
weight(p)       = Σₜ term_weight(t) × launches(t, p) / time_at_defaults(t)
측정 항목은 4k·64k 프롬프트 프리필, 4k·64k 히스토리에서의 디코드 1스텝, 그리고 드래프터가 있다면 드래프터 런치와 타깃 검증 폭까지 포함합니다. 타이밍 패스는 디바이스의 마지막 레벨 캐시(LLC)의 몇 배를 차지하도록 구성해 “앞선 호출이 캐시를 데워 놓은” 착시를 막습니다. 탐색 순서는 (effort + price) / (share × opportunity)로 매기는 가상 완료 시각 기준이며, 같은 유닛 안에서는 구조가 다른 구현을 먼저 훑고 나서 하나를 세밀하게 다듬습니다.
| 설계 규칙 | 의미 | 트레이드오프 |
|---|---|---|
| 벽시계 60초가 유일한 예산 | 느린 기기는 “더 오래”가 아니라 “덜” 탐색 | 저사양일수록 기본값에 가까운 결과가 남을 수 있음 |
| 측정 못 한 비용은 “미지” | 0이나 추정치로 채우지 않음 | 공정하지만 탐색이 보수적 |
| 컴파일은 마감 안에 끝날 때만 시작 | 관측된 최장 컴파일 시간 기준으로 시작 여부 결정 | 셰이더 캐시가 비어 있는 첫 실행은 손해 |
| 결과 영구 저장·재사용 | 다음 로드는 측정 없이 저장된 선택 사용 | 드라이버·툴체인이 바뀌면 identity가 달라져 재탐색 |
| 메모리도 시간처럼 허용 | 예측 바이트가 여유 메모리에 들어갈 때만 작업 시작 | 다른 앱이 메모리를 많이 쓰면 탐색 폭 감소 |
4. 핵심 메커니즘 ② — “빠른데 틀린” 커널을 막는 정밀도 시스템
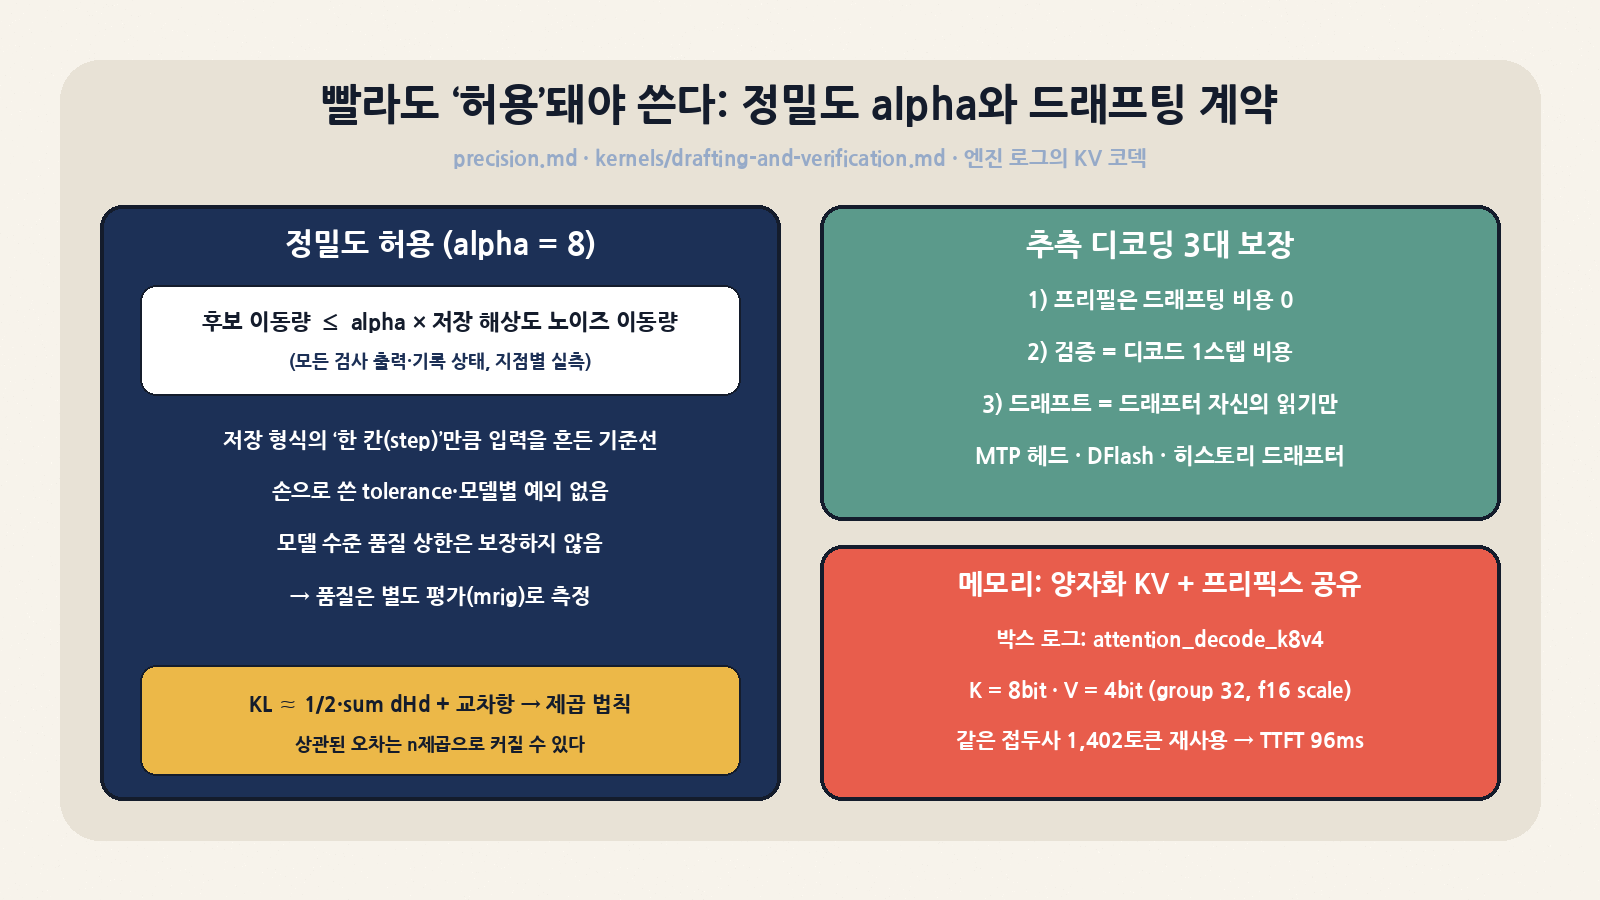
자동 튜닝의 가장 큰 위험은 “조금 더 빠르지만 수치가 미묘하게 다른” 구현을 고르는 것입니다. Magnitude는 이를 precision.md에서 단일 정책 값 α로 다룹니다. 엔진 표준은 α = 8이며, 허용 조건은 “모든 검사 출력과 기록 상태에서, 후보가 기본값 결과를 움직인 양이 저장 해상도 노이즈가 그 지점을 움직이는 양의 α배를 넘지 않는다”입니다. 저장 해상도 노이즈란 저장된 입력을 그 형식의 한 칸(step)만큼 흔들었을 때 기본값 출력이 움직이는 양으로, 원본 가중치나 파일 생성 과정에 대한 지식 없이 저장 데이터와 선언 타입만으로 계산됩니다.
이 문서가 솔직한 지점은 “허용은 모델 수준 품질 변화의 상한을 보장하지 않는다”고 명시한다는 점입니다. 오차의 하류 비용은 네트워크가 그 오차 방향에 어떻게 반응하는지(야코비안·공분산)에 달려 있고, 튜너는 모델 수준 패스를 돌리지 않으므로 이를 추측해 보정하지 않습니다. 대신 KL 이차 근사(대각항 → 제곱 법칙, 교차항 → 상관된 오차의 n² 증가)를 근거로, 모델 품질은 mrig 평가로 따로 측정한다는 구조입니다. 실무적으로는 “튜닝된 커널이 출력 분포를 크게 바꾸지 않는다”는 국소 보장과 “최종 답변 품질”이 별개라는 뜻입니다.
5. 핵심 메커니즘 ③ — 추측 디코딩, 양자화 KV, 프리픽스 공유
README의 “모델마다 가장 빠른 드래프터 내장”은 kernels/drafting-and-verification.md의 세 가지 보장으로 구체화됩니다.
| 보장 | 내용 | 구현 요점 |
|---|---|---|
| 프리필은 드래프팅 비용 0 | 드래프터가 있어도 TTFT·프리필 처리량이 일반 모드와 같아야 함 | 프롬프트 행에서는 상태 기록만, 남는 연산 여유에 배치, 숨길 수 없으면 디코드로 지연 |
| 검증 = 디코드 1스텝 비용 | 여러 드래프트 토큰 검증이 토큰 1개 디코드와 같은 비용 | 디코드는 메모리 대역폭 병목이라 산술 유닛이 놀고 있음을 활용 |
| 드래프트 = 드래프터 자신의 읽기만 | 드래프트 스텝 비용 = 드래프터가 읽어야 하는 바이트 | MTP 헤드, DFlash 같은 별도 드래프터, 히스토리 기반 드래프터 모두 적용 |
메모리 쪽에서 “양자화 KV로 에이전트당 메모리 절반”이라는 문구는 박스 로그에서 실제 코덱으로 확인됐습니다. MiniCPM5 1B 로드 시 디코드 어텐션 유닛 이름이 attention_decode_k8v4였고, 코덱은 Key 8비트·Value 4비트 affine(그룹 32, f16 스케일)였습니다. 동시 세션이 접두사 캐시를 공유한다는 주장도 아래 스모크 테스트에서 1,402토큰 재사용으로 확인됩니다.
6. 지원 하드웨어와 바닥선
| 백엔드 | 플랫폼 | 하드웨어 바닥선 | 드라이버/OS |
|---|---|---|---|
| Metal | macOS arm64 | macOS 15가 도는 모든 Apple silicon | macOS 15 (정밀 수학 모드 의존) |
| CUDA | Linux x64/arm64, Windows x64 | Compute capability 8.0(Ampere) 이상 | R525(CUDA 12.0), 번들 NVRTC 12.9로 사용자 기기에서 CUBIN 컴파일 |
| Vulkan | Linux, Windows | Vulkan 1.3 기능 바닥선 충족 기기 | 최신 벤더 드라이버 (Turing·AMD·Intel 경로) |
| CPU | 모든 호스트 | x86-64-v2 또는 AArch64 | glibc 2.35(Linux), macOS 15 |
주의할 점이 몇 가지 있습니다. Turing(RTX 20·GTX 16·T4)과 Volta(V100)는 CUDA에서 의도적으로 제외되고 Vulkan으로 처리됩니다. Intel Mac은 CPU 전용이고, ROCm 백엔드는 없습니다(AMD는 Vulkan). NVRTC 12.9를 번들하는 동안 Jetson Thor(sm_110)와 Rubin 같은 더 새로운 아키텍처는 지원되지 않습니다. 사용자 기기에 CUDA 툴킷이 필요 없는 대신 리눅스 ICN 패키지가 약 369MB로 큽니다.
7. 설치와 실행 — 공식 경로와 헤드리스 경로
공식 경로는 설치 스크립트 또는 데스크톱 패키지입니다.
# macOS / Linux
curl -fsSL https://magnitude.dev/install.sh | sh

# 서버로 상시 실행 (부팅 시 시작, 자동 업데이트, 원격 접속 키 발급)
magnitude server setup

# 하드웨어 확인 · 카탈로그 · 모델 · 에이전트 연결
magnitude hardware
magnitude catalog
magnitude models
magnitude connections
설치 스크립트는 420줄짜리 POSIX sh로, 다운로드 URL이 github.com/magnitudedev/magnitude/releases/download/ 경로인지 검사하고 릴리스 메타데이터의 퍼블리셔 서명을 openssl pkeyutl -verify로 검증한 뒤 패키지 SHA-256을 대조합니다(macOS는 codesign으로 앱 서명까지 확인). 파이프 설치가 꺼려지면 릴리스 자산(magnitude-icn-base-linux-x64-gnu.tar.gz, magnitude-cli-linux-x64-gnu.tar.gz, magnitude-release.json)을 직접 받아 SHA-256을 대조하는 방법도 있습니다. 서버가 올라오면 OpenAI 호환 클라이언트는 http://127.0.0.1:10100/inference/v1, Anthropic 호환 클라이언트는 http://127.0.0.1:10100/inference/anthropic를 base URL로 씁니다.
curl http://127.0.0.1:10100/inference/v1/chat/completions \
  -H 'Content-Type: application/json' \
-d '{"model":"MODEL_ID","messages":[{"role":"user","content":"Explain prompt caching."}],"max_tokens":256}'| API | 경로 | 메모 |
|---|---|---|
| 헬스 | GET /health |
준비되면 200 |
| 모델 목록 | GET /inference/v1/models |
표시명이 아닌 정확한 id 사용 (예: minicpm5-1b:gguf:q4) |
| Chat Completions | POST /inference/v1/chat/completions |
JSON/스트리밍, 응답에 timings(prompt_ms·predicted_per_second·cache_n) 포함 |
| Responses | POST /inference/v1/responses |
OpenAI Responses 호환 |
| Anthropic Messages | POST /inference/anthropic/v1/messages |
0.2.15부터 anthropic-version 헤더 값 제한 해제 |
| 토큰 수 계산 | POST /inference/anthropic/v1/messages/count_tokens |
Claude Code 연동용 |
8. 박스 스모크 테스트 — GPU 없는 환경에서 실제로 돌린 결과
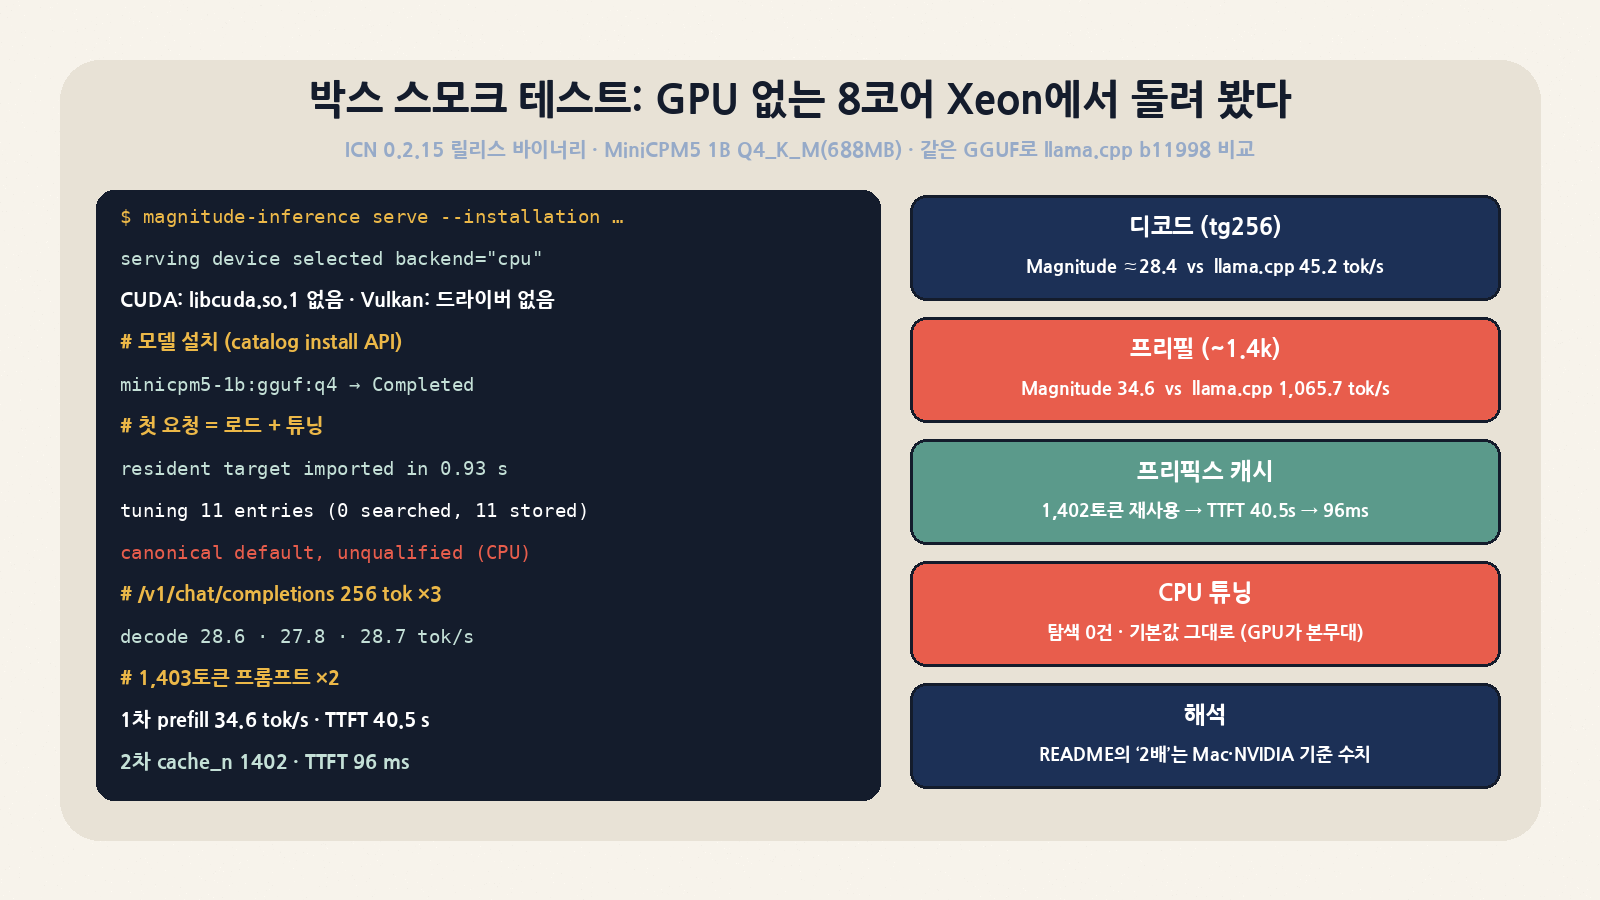
MoricWorld 박스(Intel Xeon 8 vCPU, AVX-512 지원, RAM 16GB, GPU 없음, Debian glibc 2.41)에서 0.2.15 릴리스 바이너리를 받아 ICN 서비스를 직접 실행했습니다. 데스크톱/ACN 없이 서비스 단독 실행이므로, 설치 선언 파일(installation.json)의 nativeBuild를 magnitude-release.json에 적힌 값(0.1.0+src.6a5596045ea1345d51192a4b)과 맞춰야 했고, 이 경우 서빙 경로는 /inference 접두사 없이 /v1/chat/completions입니다.
magnitude-inference serve --installation $PWD/icn/installation.json \
  --bind 127.0.0.1:10100 --model-store $PWD/store --cache-root $PWD/cache
# → serving device selected device=host-cpu backend="cpu"
#   CUDA: libcuda.so.1 없음 · Vulkan: 드라이버 없음 (진단 메시지로 명시)
curl -X POST 127.0.0.1:10100/api/v1/catalog/models/minicpm5-1b:gguf:q4/install
# → Admitted → 688MB 다운로드(약 3.5MB/s) → Completed
# 첫 요청: resident target imported in 0.93 s (219 distinct weights), warm-up 18 ms
# tuning 11 entries (0 searched, 11 stored) … canonical default, unqualified| 측정 | Magnitude 0.2.15 (CPU, HTTP 경유) | llama.cpp b11998 (CPU, llama-bench) | 해석 |
|---|---|---|---|
| 디코드 256토큰 | 28.6 / 27.8 / 28.7 tok/s (3회) | tg256: 45.21 ± 8.85 tok/s | CPU에서는 llama.cpp가 약 1.6배 |
| 프리필 약 1.4k토큰 | 34.6 tok/s (1,403토큰, TTFT 40.5초) | pp1400: 1,065.66 ± 26.15 tok/s | CPU 프리필은 수십 배 차이 |
| 같은 접두사 재요청 | cache_n 1,402 · TTFT 96ms | (llama-bench는 해당 없음) | 프리픽스 캐시는 확실히 동작 |
| 첫 로드 | 가중치 임포트 0.93초 + 워밍업 18ms, 요청 전체 3.4초 | — | CPU에서는 튜닝 탐색 0건 |
| 메모리 | 로드 후 footprint 약 1.04GB | 모델 파일 651MiB | KV 코덱 k8v4 |
결론을 정확히 적으면 이렇습니다. GPU 없는 x86 서버에서 Magnitude는 llama.cpp보다 느렸고, 특히 프리필 차이가 컸습니다. 로그상 CPU 백엔드는 11개 유닛 모두 “0 searched, 11 stored, canonical default, unqualified”, 즉 탐색 없이 표준 기본값으로 서빙했습니다. Magnitude의 경쟁력인 커널 튜닝이 이 환경에서는 사실상 작동하지 않은 셈이고, README의 “2배”는 Mac(Metal)과 NVIDIA(CUDA) 기준 수치라는 점과도 일치합니다. 다만 비교 조건이 완전히 같지는 않습니다. Magnitude 쪽은 HTTP·채팅 템플릿·샘플러를 포함한 서빙 경로의 timings이고, llama.cpp 쪽은 엔진 단독 마이크로벤치입니다. GPU 환경 수치는 이 박스에서 검증하지 못했습니다.
품질 쪽 관찰도 덧붙입니다. 1B 모델에 “추측 디코딩이 무엇인가”를 물었더니 “speculation(추측)” 일반론으로 답했고, Anthropic 엔드포인트에서는 기본값으로 thinking 블록이 먼저 나왔습니다(모델 기본 reasoning effort가 high). 엔진 문제가 아니라 모델 크기와 기본 설정의 문제지만, 에이전트에 연결할 때는 reasoning_effort를 명시하는 편이 낫습니다.
9. 유사 도구와 비교
| 도구 | 커널 전략 | 강점 | 약점/주의 | 라이선스 |
|---|---|---|---|---|
| Magnitude | 패밀리별 수작업 커널 + 기기별 60초 자동 튜닝, 정밀도 α 허용 | Mac·NVIDIA 디코드 속도, 내장 드래프터, 양자화 KV, 에이전트 원클릭 연결 | 지원 패밀리 한정, CPU에서는 튜닝 이점 없음, 일 단위 릴리스 | Apache-2.0 |
| llama.cpp | 범용 ggml 커널, CPU ISA별 백엔드 동적 로드 | 모델 커버리지, CPU 성능, 이식성 | 기기별 자동 탐색은 제한적 | MIT |
| Ollama | llama.cpp 계열 엔진 + 자체 런타임 | 설치·모델 관리 UX, 생태계 | Magnitude 측 벤치에서 디코드 약 2배 열세(벤더 측정) | MIT |
| LM Studio | llama.cpp·MLX 런타임 | GUI, 모델 탐색 | 앱 자체는 비공개 소스 | 독점(런타임 일부 오픈) |
| vLLM | PagedAttention, CUDA 그래프, 서버 지향 | 대량 동시 처리, 데이터센터 GPU | 개인 노트북·Mac 지향 아님 | Apache-2.0 |
| MLX-LM | Apple MLX 프레임워크 | Apple silicon 최적화 | Mac 전용 | MIT |
10. 실무 도입 전에 확인할 것
| 체크 항목 | 왜 중요한가 | 권장 행동 |
|---|---|---|
| 내 모델이 카탈로그에서 supported인가 | DeepSeek V4 Flash, GLM 5.2, Qwen3.5 122B, Nemotron 3 Super/Ultra, Laguna는 disabled(“미구현” 사유 명시) | 생태계 이미지의 로고만 보고 판단하지 말고 models.json의 support.level 확인 |
| GPU 세대 | CUDA는 sm_80+만, Turing·Volta는 Vulkan 경로 | T4·V100 서버라면 Vulkan 성능을 따로 측정 |
| CPU 전용 서버 | 박스 측정에서 llama.cpp 대비 디코드 0.6배, 프리필 크게 열세 | CPU 서빙이 주 용도면 llama.cpp 계열 유지 |
| 커스텀 GGUF | 0.2.11부터 지원 패밀리의 임의 GGUF(파인튜닝·병합 포함) 실행 가능 | 패밀리 밖 아키텍처는 여전히 불가 |
| 원격 서버 노출 | 로컬은 키 없이 허용, 원격은 서버 API 키 필요 | magnitude server setup이 발급한 키만 사용, 방화벽 범위 제한 |
| 릴리스 속도 | 보름에 7회 패치, RPC 버전·프로토콜 지문이 릴리스마다 고정 | 팀 배포 시 버전 고정 후 단계적 업데이트 |
| 품질 검증 | α 허용은 국소 보장일 뿐, 모델 수준 품질 상한이 아님 | 업무 프롬프트 세트로 기존 엔진 대비 회귀 테스트 |
11. 정리 — 어디에 맞고, 어디에 안 맞나
Magnitude의 설계는 “범용 커널의 평균 성능”이 아니라 “이 칩에서 이 모델의 최선”을 노립니다. 튜너의 예산 규칙, 정밀도 허용의 수학, 드래프팅 비용 계약을 문서로 못 박고 로그로 설명 가능하게 만든 점은 로컬 추론 엔진 중에서도 엔지니어링 성숙도가 높은 편입니다. Apple silicon이나 Ampere 이상 NVIDIA GPU에서 Qwen·Gemma 4·LFM·Nemotron 계열을 코딩 에이전트에 붙여 쓰는 개인·소규모 팀이라면 Ollama 대체 후보로 시험할 가치가 충분합니다.
반대로 GPU 없는 서버, 카탈로그 밖 아키텍처, 대규모 동시 서빙(vLLM의 영역)에는 아직 맞지 않습니다. 이번 박스 테스트는 “튜닝할 대상이 없으면 이점도 없다”는 당연하지만 중요한 사실을 수치로 보여 줬습니다. 도입을 검토한다면 자신의 GPU에서 첫 로드 튜닝 로그(searched 건수와 선택 사유)를 직접 확인하고, 같은 GGUF로 llama.cpp·Ollama와 프리필·디코드를 나란히 재 보는 것이 가장 빠른 판단 방법입니다.