한 줄 요약: 0xShug0/audio.cpp(Apache-2.0, 최신 v0.9.3, 스타 약 3.9k)는 TTS·음성 클로닝·ASR·VAD·화자 분리·음원 분리·음악 생성 같은 오디오 모델 130여 패밀리를 ggml 위의 C++ 런타임 하나로 돌리는 프로젝트입니다. 모델마다 Conda 환경과 파이썬 패키지 수백 개를 따로 맞추던 일을, 공통 CLI·OpenAI 호환 서버·C ABI 하나로 정리하겠다는 겁니다. 오늘(10/30) GitHub Trending C++ 일간 목록에 올라 있습니다. 이 글은 README의 RTX 5090 수치를 옮기는 대신 저장소 설계 문서(docs/gguf.md, docs/lora.md, app/server/README.md, 패리티 테스트 흐름)를 읽고, 릴리스 바이너리를 GPU 없는 박스에서 직접 돌려 한국어 TTS→ASR 왕복을 측정한 결과로 구조와 트레이드오프를 정리합니다.
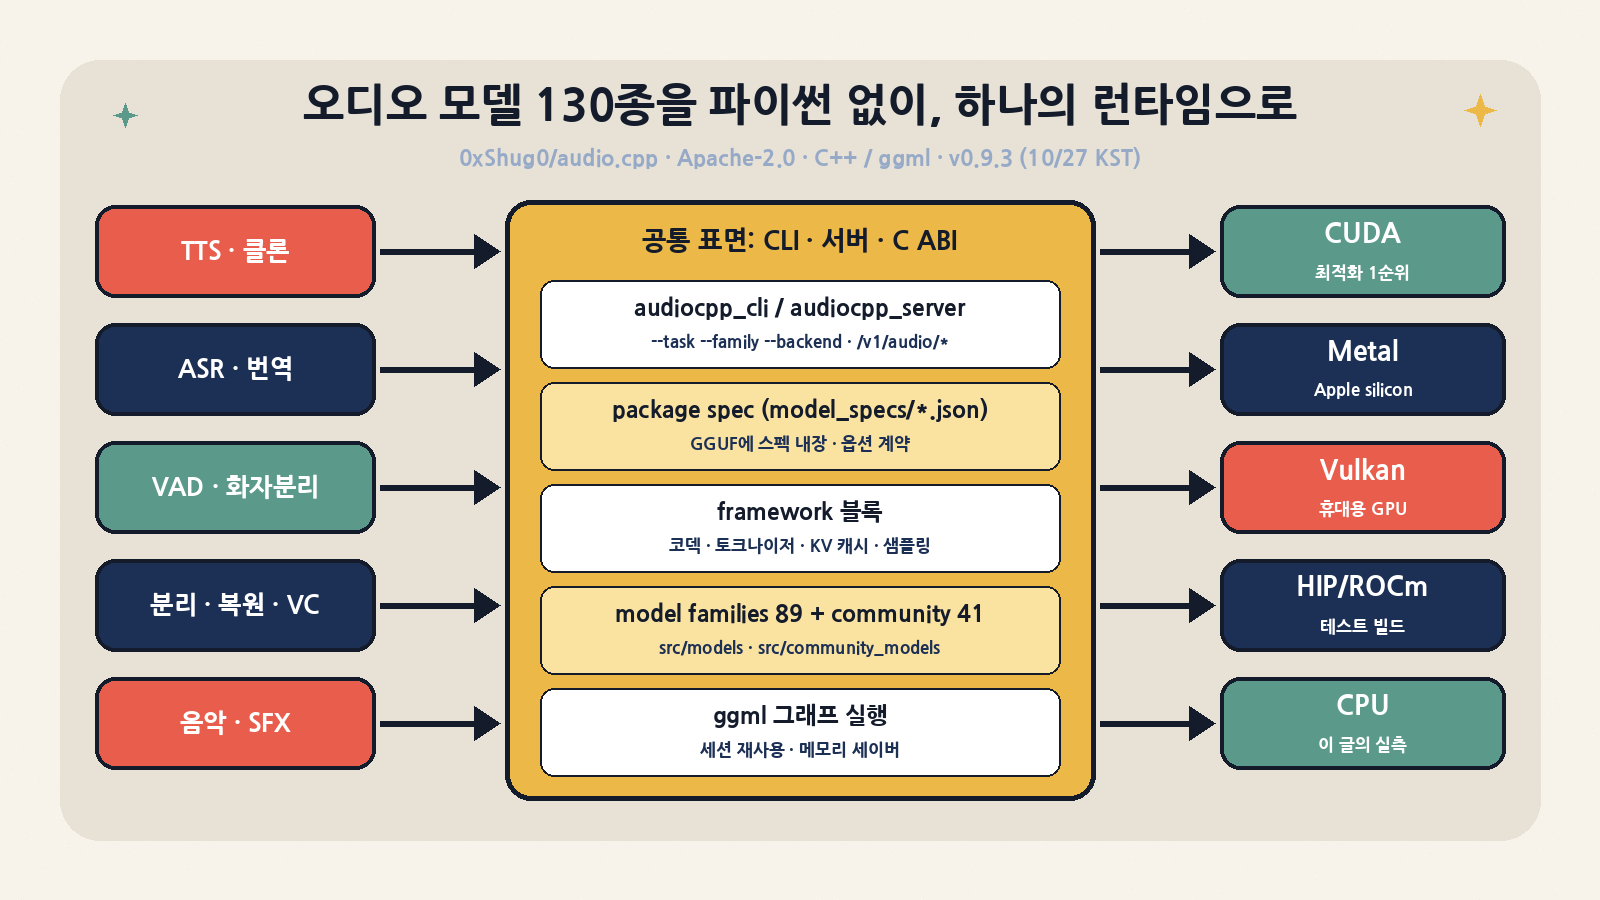
1. 무엇을 하는 프로젝트인가: “모델 데모 모음”이 아니라 오디오 공통 런타임
오디오 AI 쪽은 LLM보다 훨씬 파편화돼 있습니다. TTS 하나에도 자기회귀 LM + 코덱(Qwen3-TTS, Fish Audio), 플로 매칭 DiT(F5-TTS, Supertonic), VITS 계열(Piper, Kitten) 등 구조가 제각각이고, 각 레퍼런스 구현은 서로 다른 PyTorch·torchaudio·NeMo·FunASR 버전을 요구합니다. audio.cpp는 이 모델들을 공통 빌딩 블록(코덱, 토크나이저, KV 캐시, 샘플러, STFT/ISTFT, VAD 기반 청킹)으로 다시 구현하고, ggml 그래프로 CUDA·HIP/ROCm·Vulkan·Metal·CPU에서 실행합니다. 같은 바이너리가 TTS, 클로닝, VC, ASR, 화자 분리, VAD, 음원 분리, 정렬(alignment), 코덱 모델, 음악·효과음 생성까지 처리하고, 그 위에 JSON 파이프라인과 내장 레시피(크로스 랭귀지 더빙 등)가 올라갑니다.
whisper.cpp가 “Whisper 계열 ASR을 C++로”였다면, audio.cpp는 “오디오 모델 전반을 위한 llama.cpp급 공통 런타임”을 노립니다. 다만 그 대가로 모델 패밀리마다 손으로 포팅해야 하고, 그래서 패리티 검증이 프로젝트의 중심 축이 됩니다(5장).
| 항목 | 값 (2026-10-30 KST 확인) | 비고 |
|---|---|---|
| 저장소 | 0xShug0/audio.cpp | 2026-06-24 KST 생성, 주 언어 C++ |
| 라이선스 | Apache-2.0 (Copyright ShugoAI LLC) | GitHub API는 NOASSERTION으로 표시(LICENSE 앞에 저작권 헤더가 붙어 있어서). 모델 가중치 라이선스는 별도 |
| 최신 릴리스 | v0.9.3 | 2026-10-27 05:46 KST, 서버 /health 기준 git 41c1f8ff |
| 스타 / 포크 | 약 3,861 / 468 | GitHub API 기준, Trending C++ 일간 목록 진입 |
| 개발 속도 | 커밋 1,117개, 기여자 137명, 최근 7일 커밋 77개 | 메인테이너(0xShug0) 커밋이 642개로 절반 이상 |
| 지원 범위 | 로더 133개 등록(박스 바이너리 실측), 코어 89 + 커뮤니티 41 패밀리 디렉터리 | README 표기: 130+ 패밀리, 200+ 변형 |
| 배포물 | Windows·Ubuntu·macOS 바이너리, C API 라이브러리, CUDA 런타임 별도 아카이브, Docker, Homebrew | Ubuntu CPU 바이너리 55MB |
2. 왜 이번 주에 다시 떴나: v0.9.3의 세 가지 변화
v0.9.3(10/27 KST)은 기능 추가 폭이 컸습니다. 실무자 관점에서 의미 있는 건 세 가지입니다. 첫째, LoRA를 11개 모델로 확장했습니다. Qwen3-TTS, Qwen3-ASR, VoxCPM2, Fish Audio S2 Pro, CosyVoice3, F5-TTS, VibeVoice, ACE-Step, YuE2 등에서 PEFT 어댑터를 세션 옵션(<family>.lora, <family>.lora_scale)으로 얹고, 공용 도구로 GGUF에 병합할 수 있습니다. 파인튜닝한 화자·도메인 모델을 파이썬 없이 배포하는 길이 열린 셈입니다. 둘째, perf_mode 프리셋입니다. README는 CUDA에서 Qwen3-TTS 스트리밍 RTF 27%, ACE-Step 59~62% 감소 등을 제시하지만, 이런 최적화는 호환성을 이유로 기본값이 꺼져 있다는 점이 중요합니다(예: voxcpm2.perf_mode=cuda_perf는 QKV·gate/up 투영을 묶으며 “수치 결과와 생성 오디오가 바뀔 수 있다”고 문서에 명시). 셋째, WebUI에 여러 화자·문단 단위 편집이 되는 TTS 작업공간이 생겼고, AMD DevLab 지원으로 HIP 테스트 빌드가 정식 릴리스에 붙었습니다. Unsloth Studio가 음성·음악·STT 엔진으로 audio.cpp를 쓰고 있다는 점도 관심을 끌어올린 요인입니다.
| 버전 | 시점 | 핵심 변화 |
|---|---|---|
| 0.1 ~ 0.8 | 2026-06-25 ~ 09-23 | 80+ 패밀리, 네이티브 WebUI·Arena, GGUF 패키징, LoRA 초기, 스트리밍, Vulkan·실험적 HIP, C ABI |
| 0.9.0 | 2026-10-01 KST (README 표기 09-30) | 100+ 모델, 디노이즈·향상 탭, 화자 태그 ASR, 메모리 개선 |
| 0.9.2 | 2026-10-16 KST | Voxtral TTS, TF-GridNet, MossFormer2, FireRed VAD, 웨이크워드, C API 라이브러리 배포 |
| 0.9.3 | 2026-10-27 KST | LoRA 11개 모델, perf_mode, TTS 작업공간, Fish Drama3·XTTS v2·Earshot VAD 등 신규, HIP 테스트 릴리스, Rockchip NPU 경로 확대 |
3. 아키텍처와 저장소 구조
구조는 “앱 → 런타임 계약 → 프레임워크 블록 → 모델 패밀리 → ggml” 순으로 내려갑니다. C API 문서는 이를 가장 잘 요약합니다. include/audiocpp.h는 engine::runtime 위의 얇은 파사드이고 자체 동작을 추가하지 않으며, 모든 호출이 ModelRegistry → ILoadedVoiceModel → IVoiceTaskSession으로 이어집니다. CLI와 서버도 같은 표면을 씁니다. 즉 “모델 로드”와 “작업 세션”이 분리돼 있어서, 한 번 올린 모델로 여러 요청을 처리하는 장기 세션(long-lived session)이 기본 사용 형태입니다. README의 Python 대비 수치도 one-shot과 long-lived를 따로 보고합니다.
| 경로 | 규모(추적 파일 / C++ 라인) | 역할 |
|---|---|---|
app/ (cli, server, workflow, recipe, streaming, model_manager, gguf) |
72 / 약 1.9만 | 사용자 진입점. audiocpp_cli, audiocpp_server, audiocpp_gguf, 파이프라인·레시피 실행기 |
src/framework/ |
(src 전체 1,089 / 약 48.7만) | 공통 블록: audio, codecs, conditioners, decoders, tokenizers, sampling, runtime(kv_cache, flow_kv_cache, graph_executor, graph_optimizer, session), package_manager, neon, rknn |
src/models/, src/community_models/ |
89 / 41 디렉터리 | 패밀리별 포팅. 커뮤니티 트리는 리뷰 기준이 가볍고, 검증되면 코어로 승격 |
include/ |
1,061 / 약 7만 | audiocpp.h(C ABI)와 engine 헤더 |
model_specs/ |
JSON 130개(릴리스 번들 기준) | 패밀리별 패키지·옵션 계약 |
webui/ |
82 | SvelteKit/TypeScript UI. 프로덕션 빌드는 서버 바이너리에 내장 |
tests/, tools/ |
752 / 112 | tests/warmbench.py(패리티·장기 세션), run_audiocpp_cli_path_tests.py(사용자 경로 회귀), 변환기 |
external/ |
— | ggml, cpp-httplib, cJSON, sentencepiece, utf8proc, libyaml, llama_tokenizer, 서버 프런트엔드 서브모듈 |
빌드 측면의 설계도 눈여겨볼 만합니다. Composite build(AUDIOCPP_MODEL_SET=full|core|custom)로 필요한 패밀리만 컴파일할 수 있어, 예컨대 --models qwen3_tts,pocket_tts,qwen3_asr만 넣은 임베디드용 바이너리를 만들 수 있습니다. AUDIOCPP_DEPLOYMENT_BUILD=ON은 패키지 스펙을 바이너리에 컴파일해 넣어 외부 JSON 없이 GGUF 하나로 로드되게 합니다. 130개 패밀리를 다 품는 대가로 풀 빌드가 무겁다는 걸 인정하고, 배포 단위를 잘게 자를 수 있게 한 선택입니다.
4. GGUF는 컨테이너일 뿐: 패키지 스펙이 계약을 정한다
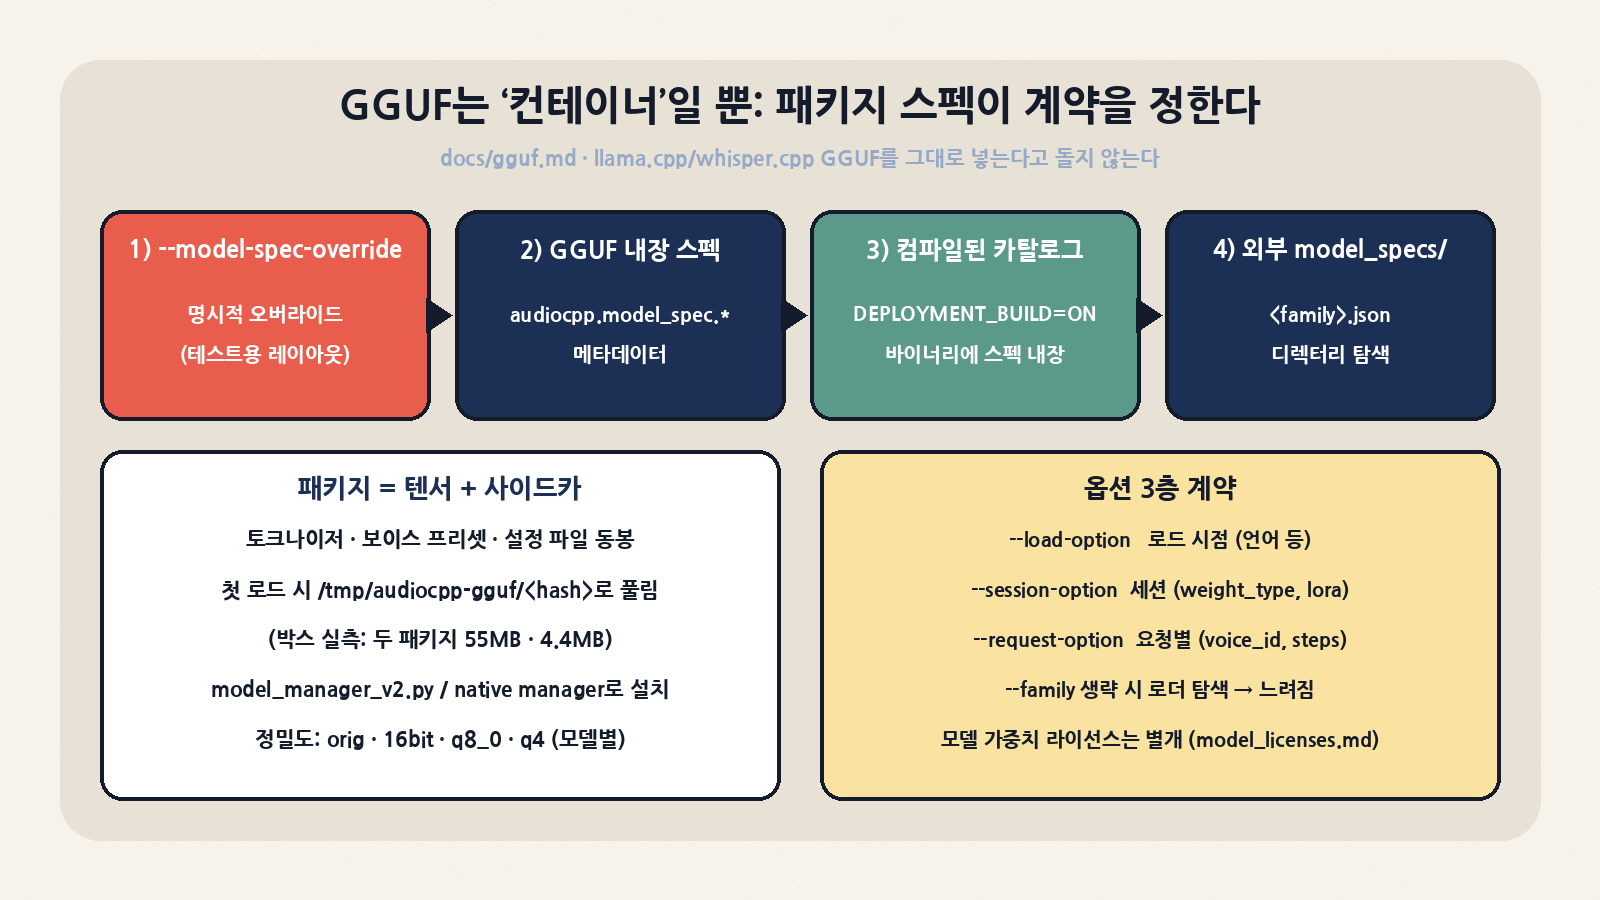
가장 먼저 오해를 풀어야 할 부분입니다. audio.cpp도 GGUF를 쓰지만, docs/gguf.md는 “GGUF는 텐서와 사이드카 파일을 담는 컨테이너이지, 임의의 llama.cpp·whisper.cpp GGUF를 위한 범용 어댑터가 아니다”라고 못박습니다. 텐서 이름과 메타데이터가 선택한 --family 구현과 맞아야 합니다. 새 GGUF는 audiocpp.model_spec.* 메타데이터에 패키지 스펙을 내장하고, 리소스 해석 순서는 명시적 오버라이드 → GGUF 내장 스펙 → 컴파일된 카탈로그 → 외부 model_specs/<family>.json으로 결정적입니다. 옵션 검증·도움말용 “계약” 조회는 별도 순서(오버라이드 → 로컬 JSON → 컴파일 카탈로그 → 내장 스펙)를 따르는데, 이렇게 둘을 나눈 이유는 가중치를 재배포하지 않고도 옵션 계약을 고칠 수 있게 하기 위해서입니다.
박스에서 확인한 실제 동작: Supertonic 3 GGUF를 처음 로드하자 사이드카(보이스 스타일·설정 등)가 /tmp/audiocpp-gguf/<hash>로 풀렸고(두 패키지에서 55MB, 4.4MB), 도움말 출력도 model_root=/tmp/audiocpp-gguf/...를 가리켰습니다. 컨테이너·읽기 전용 루트 파일시스템에 배포할 때는 이 임시 디렉터리 공간과 권한을 챙겨야 합니다.
| 옵션 층 | CLI 플래그 | 적용 시점 | 예시 |
|---|---|---|---|
| 로드 | --load-option k=v |
모델 로드 시 1회 | PocketTTS language=spanish |
| 세션 | --session-option k=v |
세션 생성 시 | supertonic.weight_type=q8_0, qwen3_asr.lora=..., *.mem_saver=true |
| 요청 | --request-option k=v |
요청마다 | Supertonic voice_id, num_inference_steps(기본 8), speed(기본 1.05), seed(기본 1234) |
| 패밀리 선택 | --family |
항상 | 생략은 하위 호환용일 뿐, 로더 자동 탐색으로 시작이 “상당히” 느려진다고 문서가 경고 |
5. 핵심 트레이드오프: “빠르다”보다 먼저 “같다”
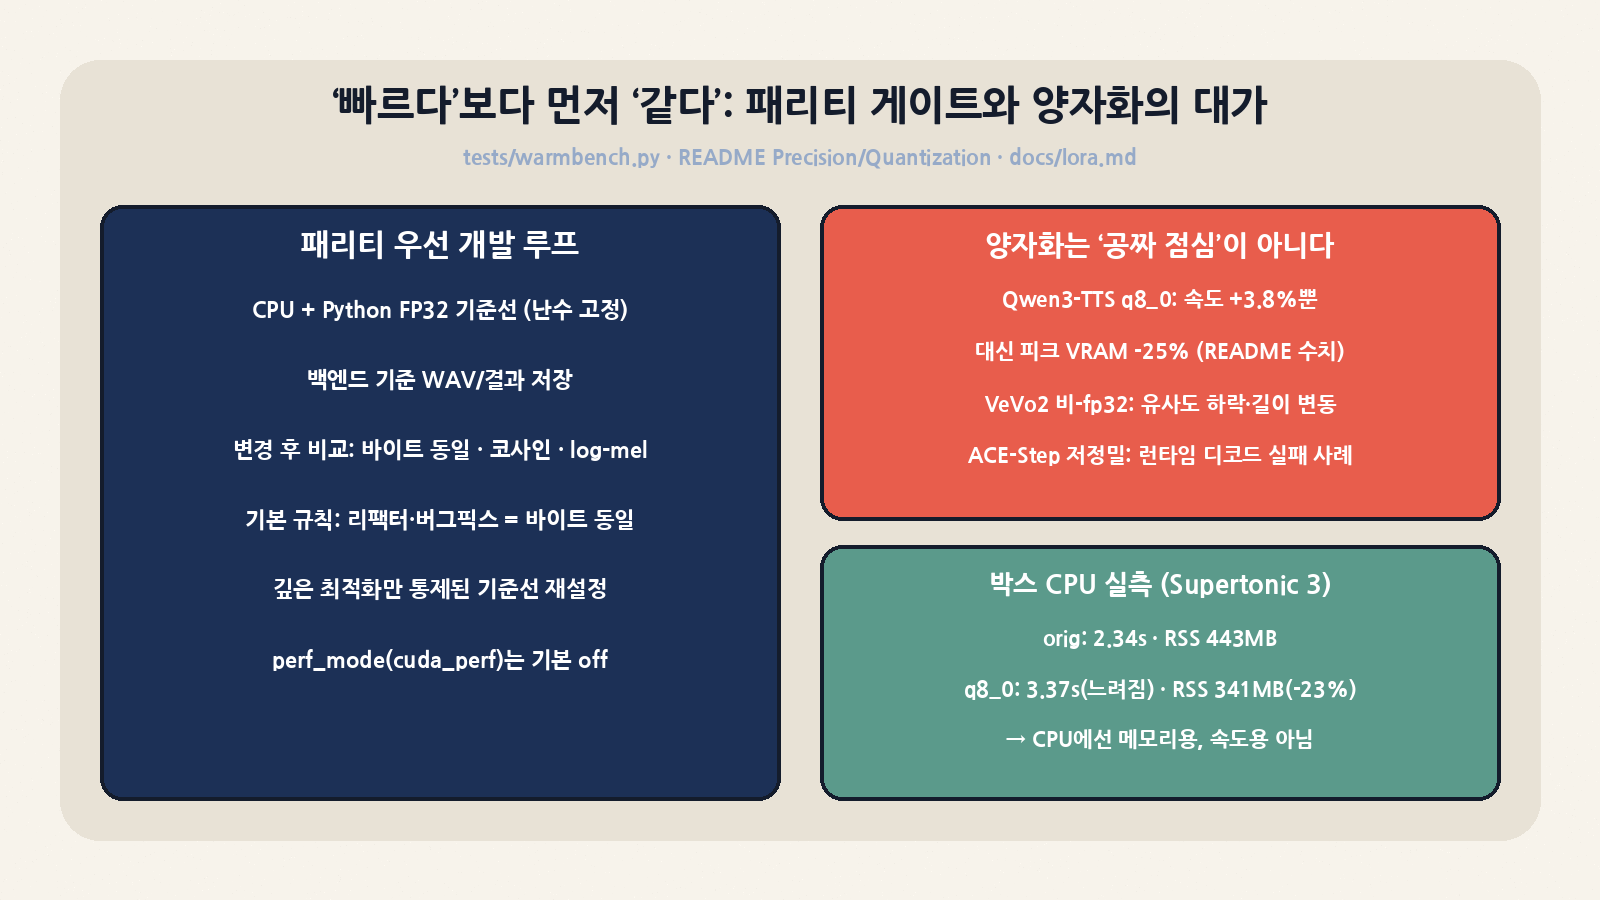
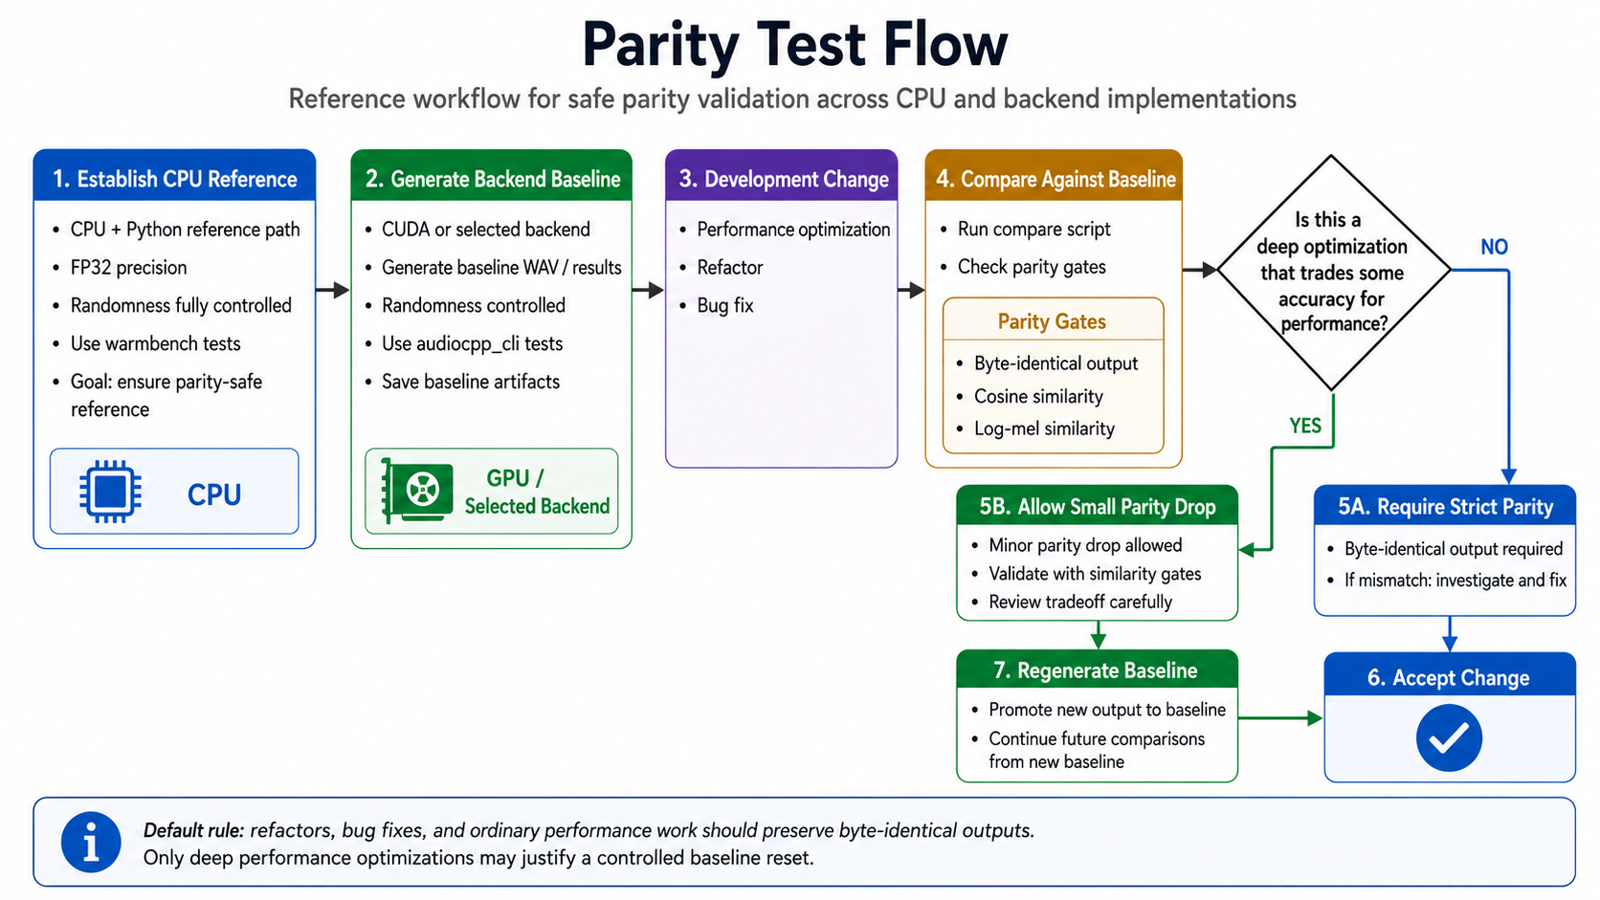
손 포팅 프레임워크의 최대 리스크는 조용한 품질 저하입니다. audio.cpp는 이를 개발 프로세스로 막습니다. 공식 패리티 흐름은 ① CPU + Python FP32 레퍼런스를 난수 고정 상태로 만들고, ② 대상 백엔드의 기준 WAV·결과를 저장한 뒤, ③ 변경 후 바이트 동일성·코사인 유사도·log-mel 유사도 게이트로 비교합니다. 기본 규칙은 “리팩터·버그 수정·일반 성능 작업은 바이트 동일 출력을 유지해야 하며, 깊은 성능 최적화만 통제된 기준선 재설정을 정당화한다”입니다. perf_mode가 기본으로 꺼진 것도 같은 철학의 연장입니다.
양자화에 대한 태도도 LLM 진영과 다릅니다. README는 이를 “모델·경로별 최적화이지 보편적으로 안전한 기본값이 아니다”라고 정리하면서 스스로 불리한 수치를 공개합니다. 박스 CPU에서 측정한 결과도 같은 방향이었습니다.
| 관찰 | 수치 | 함의 |
|---|---|---|
| Qwen3-TTS q8_0 (README, CUDA) | 속도 +약 3.8%, 피크 RAM -3.7%, 피크 VRAM -25% | 속도보다 “VRAM에 올리기” 용도 |
| VeVo2 비-fp32 (README) | fp32 대비 파형·log-mel 유사도 하락, 출력 길이 변동 | TTS는 토큰 하나 차이가 길이·운율로 번진다 |
| ACE-Step 저정밀 (README) | “planner masked decode found no valid token” 런타임 실패 | 파서가 옵션을 받아도 경로가 안전하다는 뜻은 아님 |
| Supertonic 3 q8_0 (박스 CPU 실측) | 2,338ms → 3,368ms(약 44% 느려짐), RSS 443MB → 341MB(-23%) | CPU에서는 역양자화 비용이 커서 메모리 절약용 |
| Q8 패키지 (README 보고서) | 일부 모델 최대 1.53배 빠름, 피크 VRAM 37% 감소 | 모델·백엔드 조합별로 직접 재야 함 |
6. 작업 표면: CLI·서버·파이프라인
CLI는 audiocpp_cli --task <task> --model <path> --family <family> [--backend] [--mode offline|streaming] 한 가지 형태입니다. 작업은 vad|asr|diar|sep|gen|tts|clon|vc|s2s|align|vdes|spk|svc|midi|wake|cls. 서버는 OpenAI 스타일 엔드포인트를 노출하고, 설정 파일로 여러 모델을 등록하되 lazy_load와 max_loaded_models(LRU 언로드)로 메모리를 관리합니다. 경고 하나: lazy 로드는 첫 사용 시 올릴 뿐, 이후 요청이 끝나도 내리지 않습니다. 기본값 0은 사용한 모델을 전부 상주시키므로, GPU 하나에 여러 모델을 올리는 서버라면 max_loaded_models를 반드시 지정해야 합니다.
| 표면 | 형태 | 실무 포인트 |
|---|---|---|
| CLI 배치 | --batch-text-file, --batch-audio-dir, --request-sequence |
한 세션에서 여러 요청 처리, --metrics로 RTF·피크 RSS 출력 |
| 장시간 오디오 | --audio-chunk-mode auto|fixed|vad|none |
ASR·정렬 모델이 안전한 청킹 정책을 스스로 선택 |
| 구조화 출력 | --segments-out, --words-out, --turns-out |
타임스탬프·화자 턴 JSON |
| 서버 | /health, /v1/models, /v1/audio/speech, /v1/audio/transcriptions(/details), /v1/audio/alignments, /v1/tasks/run|batch |
OpenAI SDK의 speech/transcription 클라이언트와 형태가 같아 교체가 쉬움 |
| 파이프라인·레시피 | --pipeline x.json, --recipe any-tts|cross-language-dubbing |
ASR→TTS 재더빙, 번역 더빙 등 다단계 작업을 한 명령으로 (실험적) |
| 임베딩 | C ABI (libaudiocpp.so), 커뮤니티 .NET 바인딩 |
Python 없는 데스크톱·서버 앱에 인프로세스 탑재 |
7. 설치와 실행: 실제로 쓴 명령
박스(Ubuntu, x86-64, GPU 없음)에서 그대로 실행한 순서입니다. 소스 빌드 없이 릴리스 바이너리로 충분했습니다. GPU 환경이면 CUDA/Vulkan 아카이브로 바꾸고 --backend cuda를 쓰면 됩니다.
# 1) 릴리스 바이너리 (Ubuntu CPU, 55MB)
curl -LO https://github.com/0xShug0/audio.cpp/releases/download/v0.9.3/audio-v0.9.3-bin-ubuntu-x64-cpu.tar.gz
mkdir bin && tar xzf audio-v0.9.3-bin-ubuntu-x64-cpu.tar.gz -C bin
./bin/audiocpp_cli --list-devices        # CPU:0 "Intel(R) Xeon(R) Processor"
./bin/audiocpp_cli --list-loaders        # registered_loaders=133

# 2) 모델 설치 (model_specs 기반, Hugging Face에서 GGUF 패키지)
python3 bin/tools/model_manager_v2.py sizes supertonic_3_orig qwen3_asr_0_6b_q8_0
python3 bin/tools/model_manager_v2.py install supertonic_3_orig   --models-root models
python3 bin/tools/model_manager_v2.py install qwen3_asr_0_6b_q8_0 --models-root models
python3 bin/tools/model_manager_v2.py install sensevoice_small_q8 --models-root models

# 3) 한국어 TTS (Supertonic 3, 프리셋 보이스 F1)
./bin/audiocpp_cli --task tts --family supertonic --model models/Supertonic-3-GGUF \
  --backend cpu --threads 8 --language ko --voice-id F1 \
  --text "테크부터 경제, 생활까지. 복잡한 소식을 쉽게 풀어봅니다. ..." \
  --out out/ko.wav --metrics

# 4) 같은 음성을 ASR로 되돌리기
./bin/audiocpp_cli --task asr --family qwen3_asr --model models/Qwen3-ASR-0.6B-GGUF \
  --backend cpu --threads 8 --audio out/ko.wav --text-out out/qwen3.txt --metrics

# 5) SenseVoice는 16kHz 입력 + 저장소 assets(내장 Silero VAD)가 필요
git clone https://github.com/0xShug0/audio.cpp && cd audio.cpp
ffmpeg -i ../out/ko.wav -ar 16000 -ac 1 ../out/ko_16k.wav
../bin/audiocpp_cli --task asr --family sense_asr --model ../models/SenseVoice-Small-GGUF \
  --backend cpu --audio ../out/ko_16k.wav --metrics

# 6) 서버 모드 (server.json에 supertonic·qwen3-asr 등록, lazy_load)
../bin/audiocpp_server --config server.json --log-file server.log
curl http://127.0.0.1:18080/v1/audio/speech -H 'Content-Type: application/json' \
  -d '{"model":"supertonic","input":"서버 모드에서는 ...","language":"ko"}' -o speech.wav
curl http://127.0.0.1:18080/v1/audio/transcriptions -F model=qwen3-asr -F file=@speech.wav
macOS는 brew tap 0xShug0/audio-cpp 후 brew install audio-cpp로 설치할 수 있고, 처음 둘러볼 때는 audiocpp_server --ui --ui-management로 내장 WebUI(카탈로그·다운로드·Arena 비교)를 띄우는 편이 가장 빠릅니다.
8. 박스 스모크 테스트: GPU 없이 한국어 TTS→ASR 왕복
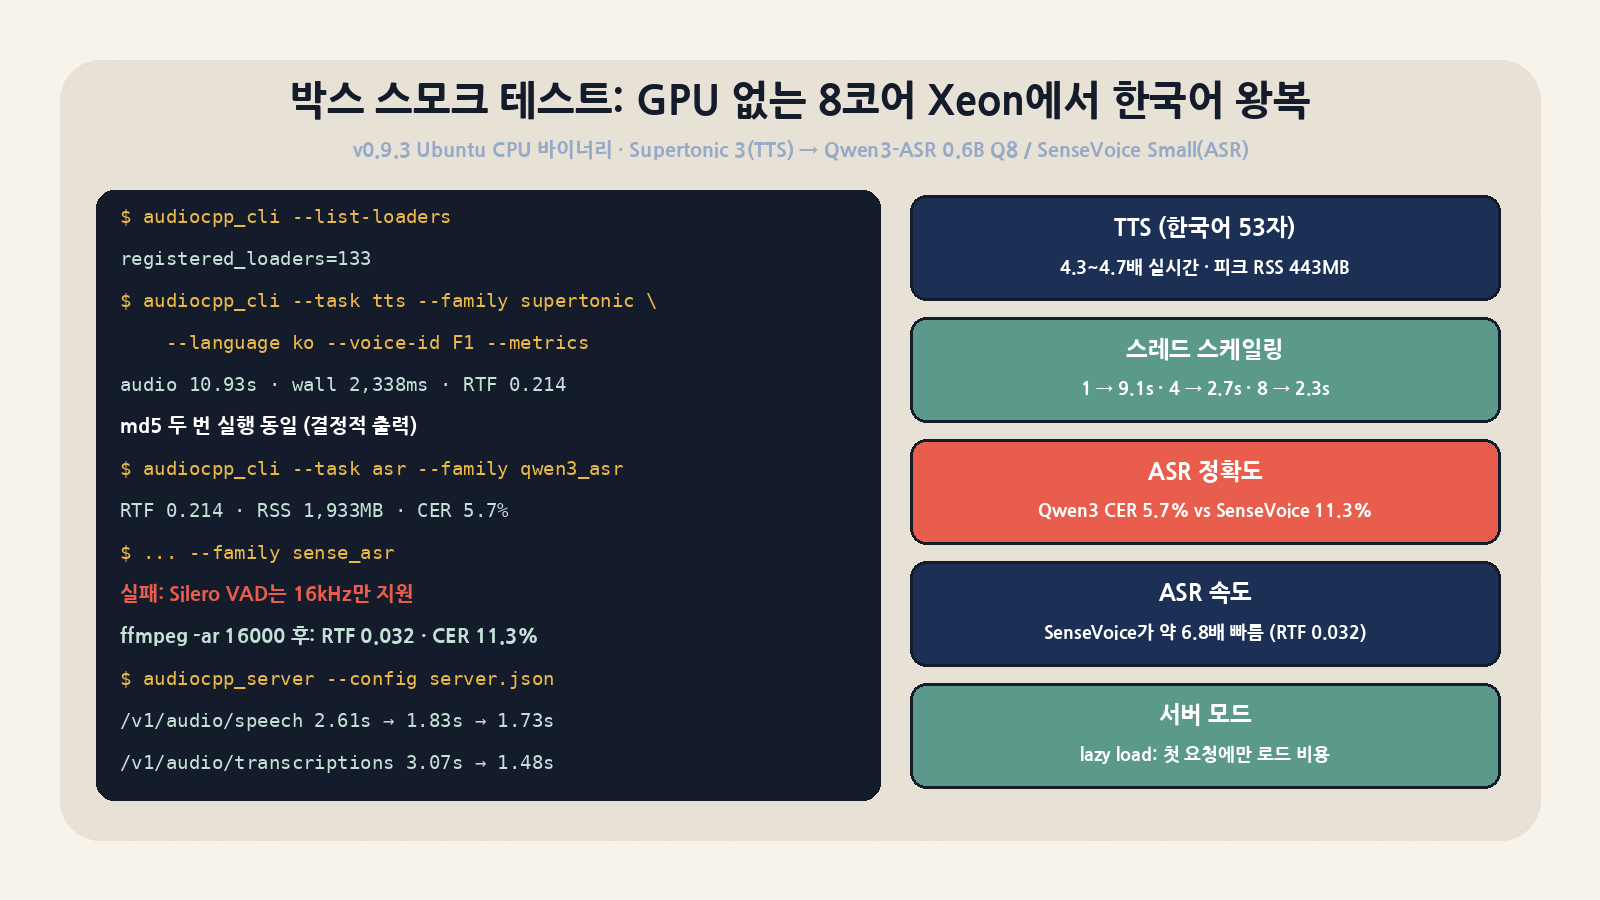
환경은 Intel Xeon 8 vCPU(AVX-512·AVX-VNNI 지원), RAM 15GB, GPU 없음입니다. 모델 다운로드는 Supertonic 3 orig 434MB(9초), Qwen3-ASR 0.6B Q8 1.1GB(17초), SenseVoice Small Q8 243MB(9초)였습니다. 한국어 문장 하나(공백·문장부호 제외 53자)를 TTS로 만들고, 그 WAV를 두 ASR 모델로 되돌려 문자 오류율(CER)을 쟀습니다. 모든 수치는 CLI의 --metrics 출력과 curl 측정값이며 손으로 보정하지 않았습니다.
| 측정 | 결과 | 메모 |
|---|---|---|
| Supertonic 3 TTS, 8스레드 (1차/2차) | 오디오 10.93초 생성, 2,544ms / 2,338ms, RTF 0.233 / 0.214 (실시간의 4.3~4.7배) | 44.1kHz 모노, 피크 RSS 443MB |
| 결정성 | 두 실행의 WAV md5 동일 | 기본 seed 1234. 회귀 테스트에 유리 |
| 스레드 1 / 4 / 8 | 9,096ms / 2,723ms / 약 2,338ms | 4스레드 이후 효율이 꺾임 |
| weight_type=q8_0 | 3,368ms (RTF 0.308), RSS 341MB | CPU에서는 느려지고 메모리만 줄었음 |
| Silero VAD (내장) | 44ms, RTF 0.004, 음성 구간 3개 | 16kHz 전용 |
| ASR 모델 | 속도 | 메모리 | CER | 전사 결과의 차이 |
|---|---|---|---|---|
| Qwen3-ASR 0.6B Q8 | 2,340ms, RTF 0.214 | 피크 RSS 1,933MB | 5.7% | “오디오 씨피피”를 “오디오 CPP”로 표기, 쉼표 누락. 의미상 사실상 완벽 |
| SenseVoice Small Q8 | 346ms, RTF 0.032 (약 6.8배 빠름) | 피크 RSS 307MB | 11.3% | “태크부터”, “풀어봅” 끝 잘림, “오디오시” |
| 서버 모드 (lazy_load, 모델 2개) | 1회차 | 2회차 | 3회차 |
|---|---|---|---|
/v1/audio/speech (5.18초 음성) |
2.61초 (로드 포함) | 1.83초 | 1.73초 |
/v1/audio/transcriptions (multipart) |
3.07초 (로드 포함) | 1.48초 (RTF 0.29) | — |
해석하면, CPU만으로도 “실시간보다 빠른” 한국어 TTS와 쓸 만한 ASR이 나옵니다. 서버 전사 결과는 띄어쓰기(“한번”, “올려두고”) 외에는 원문과 같았습니다. 다만 이 수치는 짧은 문장 한 개짜리 스모크 테스트라 벤치마크로 일반화하면 안 됩니다. 또 TTS 출력을 같은 계열 ASR로 되돌리는 왕복 테스트는 실제 마이크 녹음보다 쉬운 조건입니다. 실제 걸림돌은 숫자보다 운영 쪽에서 나왔습니다. SenseVoice는 44.1kHz 입력을 그대로 받지 않고 “Silero VAD 16k 모델은 sample_rate=16000만 지원”이라며 실패했고, 리샘플 전에는 assets/framework/models/silero_vad를 찾지 못해 실패했습니다. 릴리스 바이너리 tarball에는 이 번들 자산이 없어서 저장소 체크아웃 안에서 실행해야 했습니다. Qwen3-ASR은 44.1kHz 입력을 그대로 받았습니다. 패밀리마다 전처리 계약이 다르다는 것, 이게 “통합 런타임”의 현실적인 경계입니다.
9. 유사 도구와 비교
| 도구 | 실행 기반 | 커버리지 | 강점 | 약점·주의 |
|---|---|---|---|---|
| audio.cpp | C++ / ggml (CUDA·HIP·Vulkan·Metal·CPU) | TTS·클론·VC·ASR·VAD·화자분리·분리·음악·SFX, 130+ 패밀리 | 파이썬 없는 단일 런타임, OpenAI 형태 서버, LoRA, 패리티 문화, 빠른 신모델 흡수 | 모델별 성숙도 편차, 매주 바뀌는 API·스펙, CUDA 외 백엔드는 “이식·테스트용” |
| whisper.cpp | C/C++ / ggml | Whisper 계열 ASR(+VAD) | 성숙도·임베디드 사례·안정 API | ASR 한 계열에 집중. GGUF/ggml 파일은 audio.cpp와 호환되지 않음 |
| sherpa-onnx | ONNX Runtime | ASR·TTS·VAD·KWS·화자분리 | 모바일·임베디드·다국어 바인딩, 스트리밍 ASR 실전 경험 | ONNX로 내보낼 수 있는 모델 위주, 최신 LLM 기반 TTS 흡수는 느린 편 |
| Piper | ONNX (VITS) | 경량 TTS | 라즈베리파이급에서도 빠름, 단순함 | 표현력·클로닝 한계, TTS만 |
| Python 레퍼런스 스택 (Transformers·NeMo·FunASR 등) | PyTorch | 가장 넓음 + 학습·파인튜닝 | 원본 그대로의 품질, 연구·학습 | 환경 충돌, 배포 무게. README 기준 일부 TTS 경로는 audio.cpp가 1.8~8배 빠름(RTX 5090) |
10. 한계와 주의사항
| 주제 | 내용 | 대응 |
|---|---|---|
| 가중치 라이선스 | 코드는 Apache-2.0이지만 가중치는 원 라이선스를 따름. 예: Supertonic 3 = BigScience OpenRAIL-M(사용 제한 전달 의무), SenseVoice = FunASR 모델 라이선스(출처·모델명 표기), IndexTTS2 = 조건부 상업 이용, 일부 커뮤니티 포트는 CC-BY-NC | 상용 전 docs/model_licenses.md의 “Commercial use” 열 확인 |
| 성능 기대치 | “CUDA가 최적화 경로”. CPU·Vulkan·Metal·HIP는 성능·모델 커버리지가 낮을 수 있다고 공식 문서가 명시. README 성능 수치는 RTX 5090 + 초기 릴리스 기준 | 목표 하드웨어에서 --metrics로 직접 측정 |
| 전처리 계약 | 샘플레이트(16kHz 전용 VAD), 번들 자산 경로, 입력 길이(예: Whistle ASR은 16kHz 모노·최대 30초) 등이 패밀리마다 다름 | 모델별 문서(docs/models/*.md) 확인, 파이프라인 앞단에서 리샘플 |
| 양자화·perf_mode | 출력 변화·런타임 실패 가능, 이득이 작을 수 있음 | 패리티 게이트(유사도·ASR 역전사)로 검증 후 채택 |
| 메모리 상주 | lazy 로드 모델은 서버 종료까지 상주(기본 max_loaded_models=0) |
운영 서버는 상한 지정, mem_saver 세션 옵션 검토 |
| 변화 속도 | 최근 7일 커밋 77개, 메인테이너 1인 비중 큼, Build_xcframework 스크립트 등 일부는 리팩터 후 재검증 전 | 릴리스 태그 고정, 외부 model_specs는 런타임 버전과 맞춰 사용 |
| 오용 위험 | 제로샷 음성 클로닝이 기본 기능 | 동의받은 음성만 사용, 생성물 표기·워터마크 정책 마련 |
11. 누구에게 맞나
| 상황 | 추천도 | 이유 |
|---|---|---|
| 로컬 음성 기능(TTS·STT)을 데스크톱·서버 앱에 Python 없이 넣고 싶은 팀 | 높음 | C ABI·단일 바이너리·OpenAI 형태 API. Unsloth Studio 같은 실제 통합 사례 |
| 여러 TTS/ASR 모델을 같은 조건에서 비교·선정하려는 사람 | 높음 | 같은 CLI·--metrics·Arena UI로 패밀리 간 A/B가 쉬움 |
| 더빙·내레이션·회의록 같은 다단계 오디오 파이프라인 | 중간~높음 | 파이프라인·레시피가 있지만 아직 실험적 |
| 모바일·초저전력 임베디드 | 중간 | Composite build·NEON·Rockchip NPU 경로는 있으나 sherpa-onnx가 더 검증됨 |
| Whisper 하나만 안정적으로 쓰면 되는 서비스 | 낮음 | whisper.cpp가 더 단순하고 성숙 |
| 모델 학습·연구 | 낮음 | 추론 런타임. 학습은 Python 스택, 결과물 배포에만 LoRA·GGUF로 연결 |
정리
audio.cpp의 진짜 가치는 “빠르다”보다 “오디오 모델을 같은 계약으로 다룬다”는 데 있습니다. 패키지 스펙이 내장된 GGUF, 로드·세션·요청 3층 옵션, 바이트 동일성을 기본으로 하는 패리티 규칙이 130개 패밀리를 하나의 도구로 묶는 뼈대입니다. GPU 없는 8코어 박스에서도 한국어 TTS가 실시간의 4배 이상으로 나오고, Qwen3-ASR이 이를 CER 5.7%로 되돌렸습니다. 반대로 16kHz 전용 VAD, tarball에 빠진 번들 자산, CPU에서 오히려 느려지는 q8 같은 모서리도 바로 드러났습니다. 도입한다면 릴리스 태그를 고정하고, 쓸 패밀리만 composite build로 묶고, 목표 하드웨어에서 --metrics와 ASR 역전사로 품질·속도를 직접 재는 것부터 시작하길 권합니다.