한 줄 요약: FreeToken은 “모델이 GPU에 들어가느냐”가 아니라 “이 기계의 GPU·CPU·호스트 RAM·PCIe를 얼마나 잘 엮느냐”로 질문을 바꾼 MoE 전용 로컬 서빙 엔진입니다. 라우팅 전문가 전체는 호스트 RAM에 두고(원본), VRAM은 전 레이어가 함께 쓰는 LRU 전문가 캐시로만 씁니다. 그리고 디코드 단계의 캐시 미스를 q* ≈ m·B_P/B_H라는 닫힌 식으로 PCIe로 가져올 것과 CPU에서 그 자리 계산할 것으로 나눕니다. 이 결정은 CUDA Graph 안에서 GPU 커널이 직접 내립니다. 버클리·MIT·UT 오스틴 연구진(Ion Stoica, Matei Zaharia, Song Han, Kurt Keutzer 등)이 논문과 함께 공개했고, 오늘(2026-11-02 KST) GitHub Trending 전체 16위·Python 5위에 올랐습니다.
이 글은 입문서가 아닙니다. README·docs·v0.2.0/v0.2.1 릴리스 노트·소스 코드·논문(arXiv 2608.16157)을 대조해서 구조와 설계 판단, 그 대가를 정리했습니다. GPU가 없는 박스에서 실제로 돌려 본 것과 돌리지 못한 것도 구분해 적었습니다. 성능 수치는 모두 개발팀이 측정한 값이고, 이 글에서 직접 잰 값은 체크포인트 진단과 CLI 동작뿐입니다.
1. 한눈에 보기
| 항목 | 내용 |
|---|---|
| 저장소 | FlashML-org/FreeToken (2026-07-21 KST 생성) |
| 라이선스 | Apache-2.0 |
| 최신 버전 | v0.2.1 (2026-10-26 12:24 KST 릴리스, PyPI freetoken==0.2.1), 매일 밤 nightly 휠 |
| 스타 / 트렌딩 | 15,476개(오늘 +242) · 2026-11-02 Trending 전체 16위, Python 5위 |
| 언어·규모 | Python 중심 + CUDA/Triton 커널, python/ 아래 약 11만 3천 줄 |
| 요구 사항 | Linux x86_64, NVIDIA GPU(RTX 30/40/50, 드라이버 r580+, CUDA 13), Python ≥3.10, torch 2.14.x. AMD ROCm은 WIP |
| API | OpenAI(/v1/chat/completions, /v1/responses, /v1/models) + Anthropic(/v1/messages, count_tokens), 기본 127.0.0.1:1919 |
| 지원 모델 | DeepSeek-V4/V4.1-Flash, GLM-5.2/5.3-Flash/4.7, Qwen3.x MoE·dense·VL, gpt-oss, Gemma-4, MiniMax-M2.5/M3, Muse-Glimmer, Flint 등 (safetensors·GGUF·FTW) |
| 뿌리 | mini-sglang에서 출발, SGLang·vLLM·FlashInfer·flash-linear-attention·LightLLM·llama.cpp 코드와 설계를 차용 |
2. 왜 지금 이 문제인가: MoE의 ‘희소성’은 반쪽짜리다
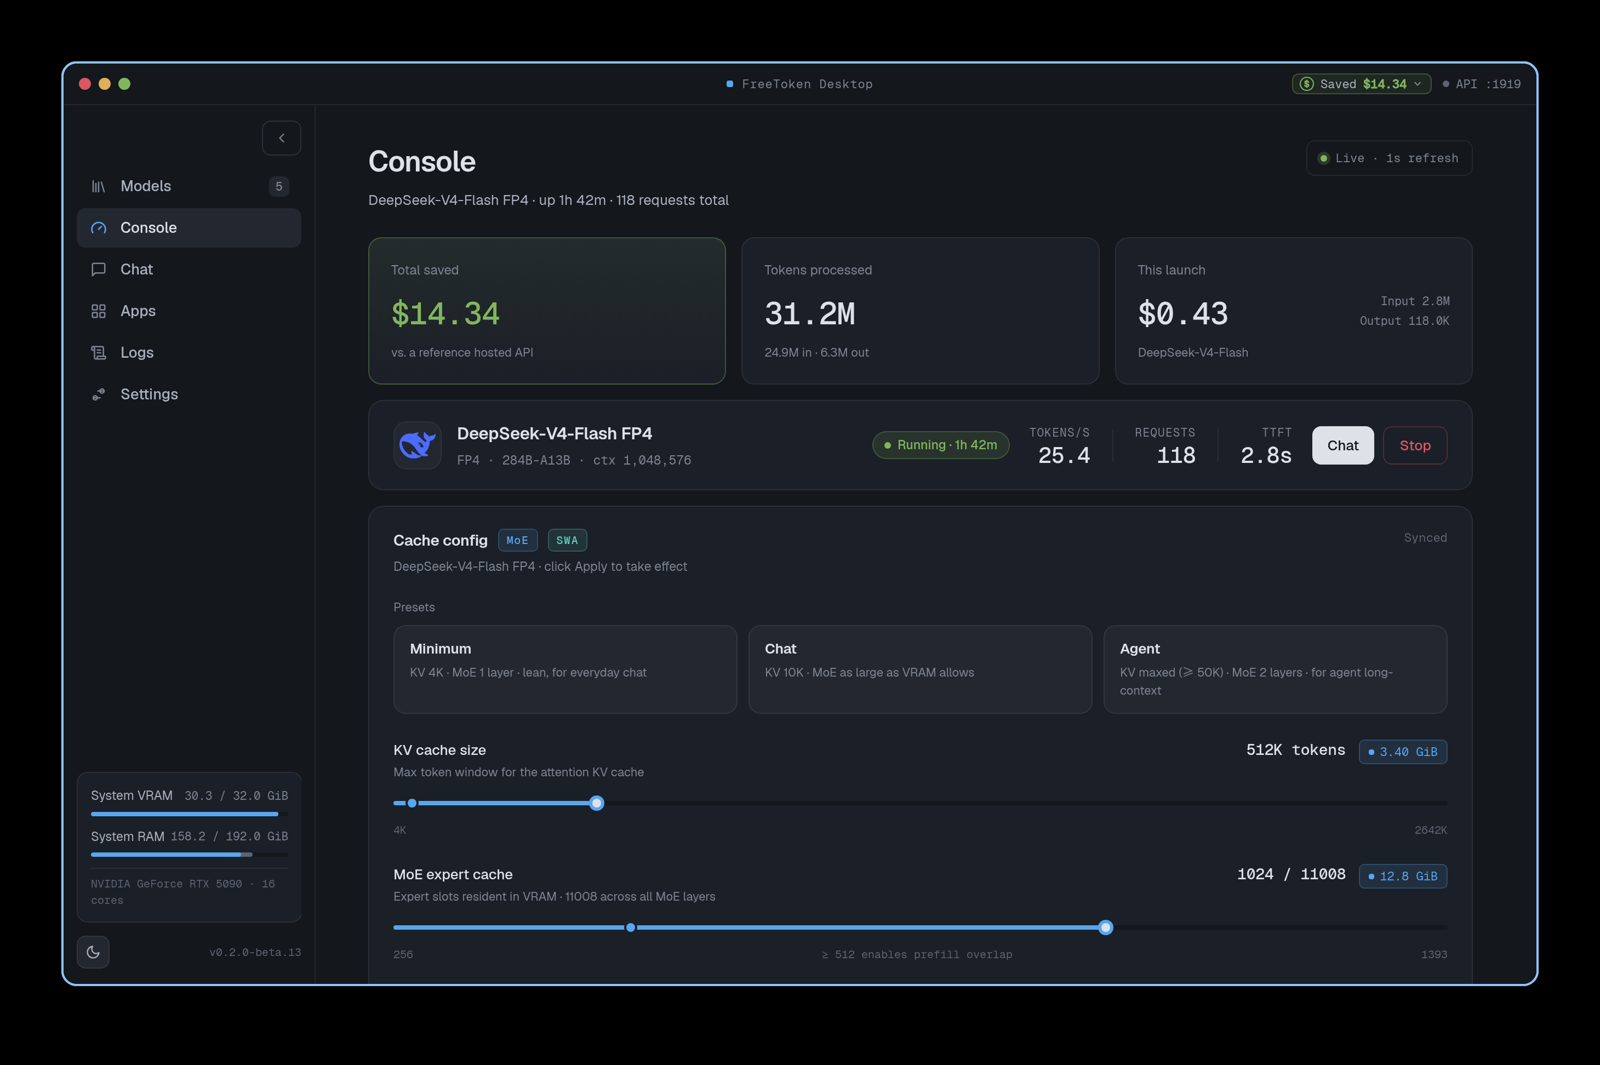
DeepSeek-V4-Flash는 43개 층마다 256개 라우팅 전문가 중 6개만 켭니다. 토큰 하나가 실제로 건드리는 파라미터는 284B 중 13B뿐이라, 계산량만 보면 RTX 5090(32GB)에 충분히 들어갑니다. 문제는 메모리입니다. 어느 전문가가 불릴지 모르니 전체 풀을 어딘가에 들고 있어야 하고, FP4 기준으로도 약 140GB입니다. 논문은 기존 엣지 엔진이 놓친 지점을 셋으로 정리합니다.
- 프리필은 희소성을 깨뜨린다. 프롬프트 수천 토큰의 라우팅을 합치면 거의 모든 전문가가 켜집니다. 그래서 프리필마다 전문가 풀 전체가 PCIe를 지나가고, 5090(PCIe 5.0 x16, 약 60GB/s)에서 약 2초, 4090/3090급(약 25GB/s)에서 약 5초, x8 노트북에서는 10초 이상이 걸립니다. 에이전트는 도구를 부를 때마다 문맥을 고쳐서 다시 프리필하므로 이 비용이 반복됩니다.
- 디코드는 반대로 희소하지만 미스가 비싸다. llama.cpp처럼 로드할 때 배치를 고정하거나 KTransformers처럼 ‘핫’ 전문가만 GPU에 고정하면, 토큰마다 바뀌는 라우팅을 따라가지 못합니다. 그렇다고 CPU에 모두 맡기면 듀얼 채널 DDR5의 80~90GB/s가 1~1.8TB/s인 VRAM 대역폭과 비교가 되지 않습니다.
- 엣지 자원은 전용이 아니다. 브라우저와 게임이 VRAM을 수시로 가져가고, 에이전트 세션이 길어지면 KV 수요는 늘어나는데 전문가 작업 집합은 거의 그대로입니다. 처음 정한 분할이 몇 턴 뒤에는 틀린 분할이 됩니다.
3. 아키텍처: 2층 전문가 메모리와 세 가지 메커니즘
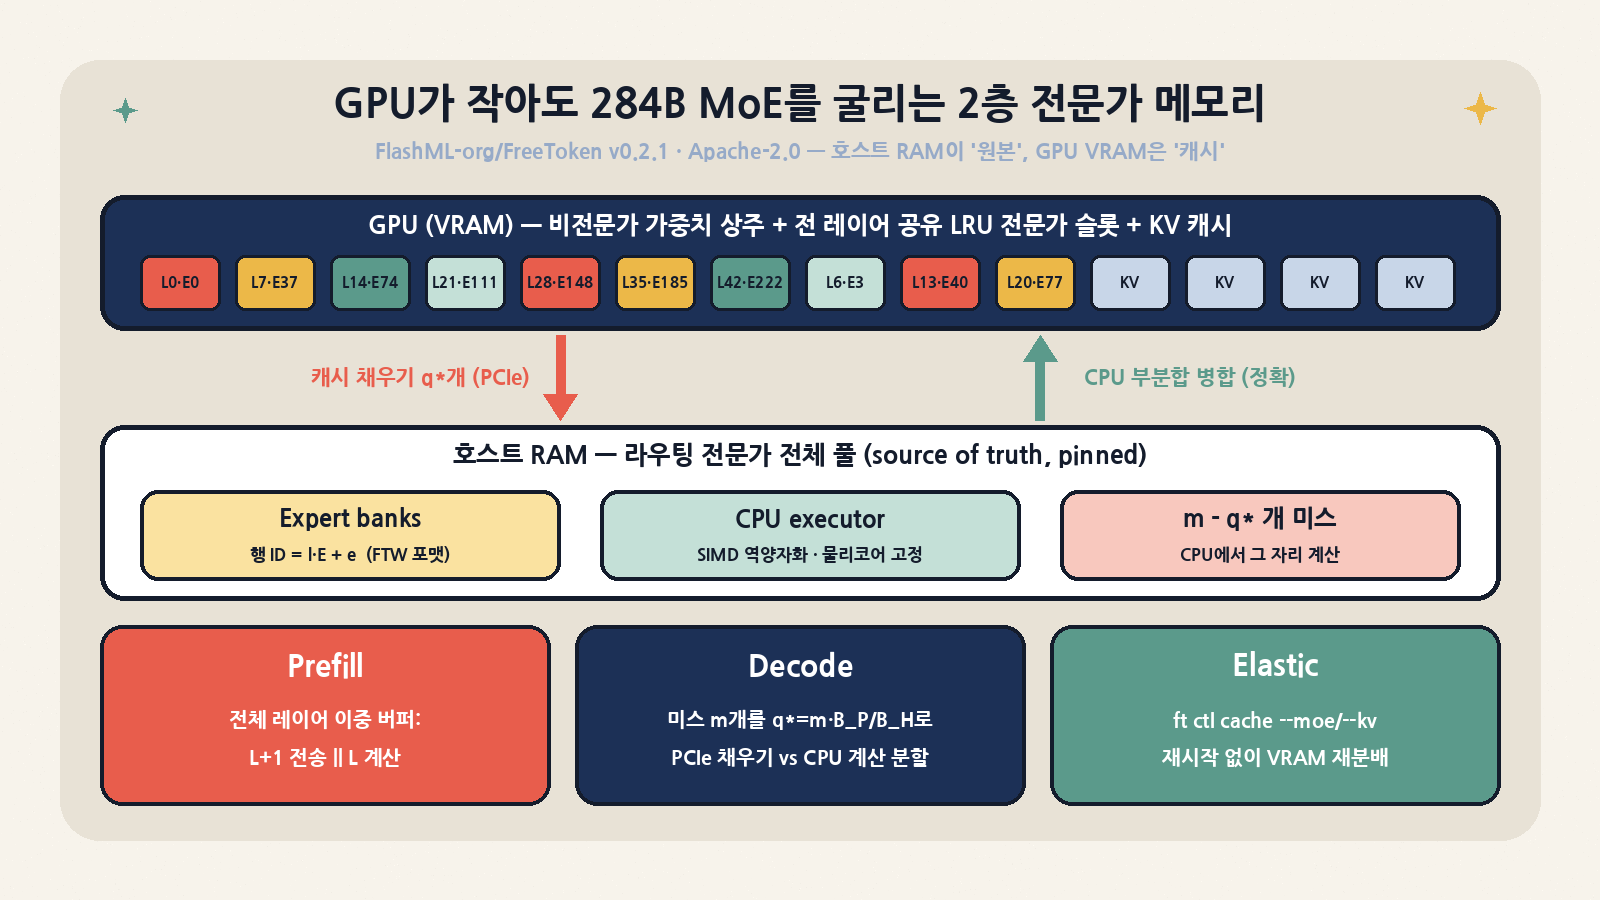
핵심 불변식은 하나입니다. 호스트 RAM의 전문가 풀이 언제나 원본(source of truth)이고, GPU 메모리는 성능에만 영향을 줄 뿐 정확성에는 영향을 주지 않는다. 비전문가 가중치(어텐션, 임베딩 등)는 GPU에 상주하고, 남는 VRAM은 KV 페이지와 ‘완전한 전문가 슬롯’으로 나뉩니다. 슬롯 하나는 (layer, expert) 한 쌍을 계산하는 데 필요한 텐서를 모두 담습니다. 그래서 잔류 여부 판단, 조회, 실행이 텐서 조각이 아니라 논리 ID 단위로 이뤄집니다.
3-1. 프리필: 전체 레이어 이중 버퍼
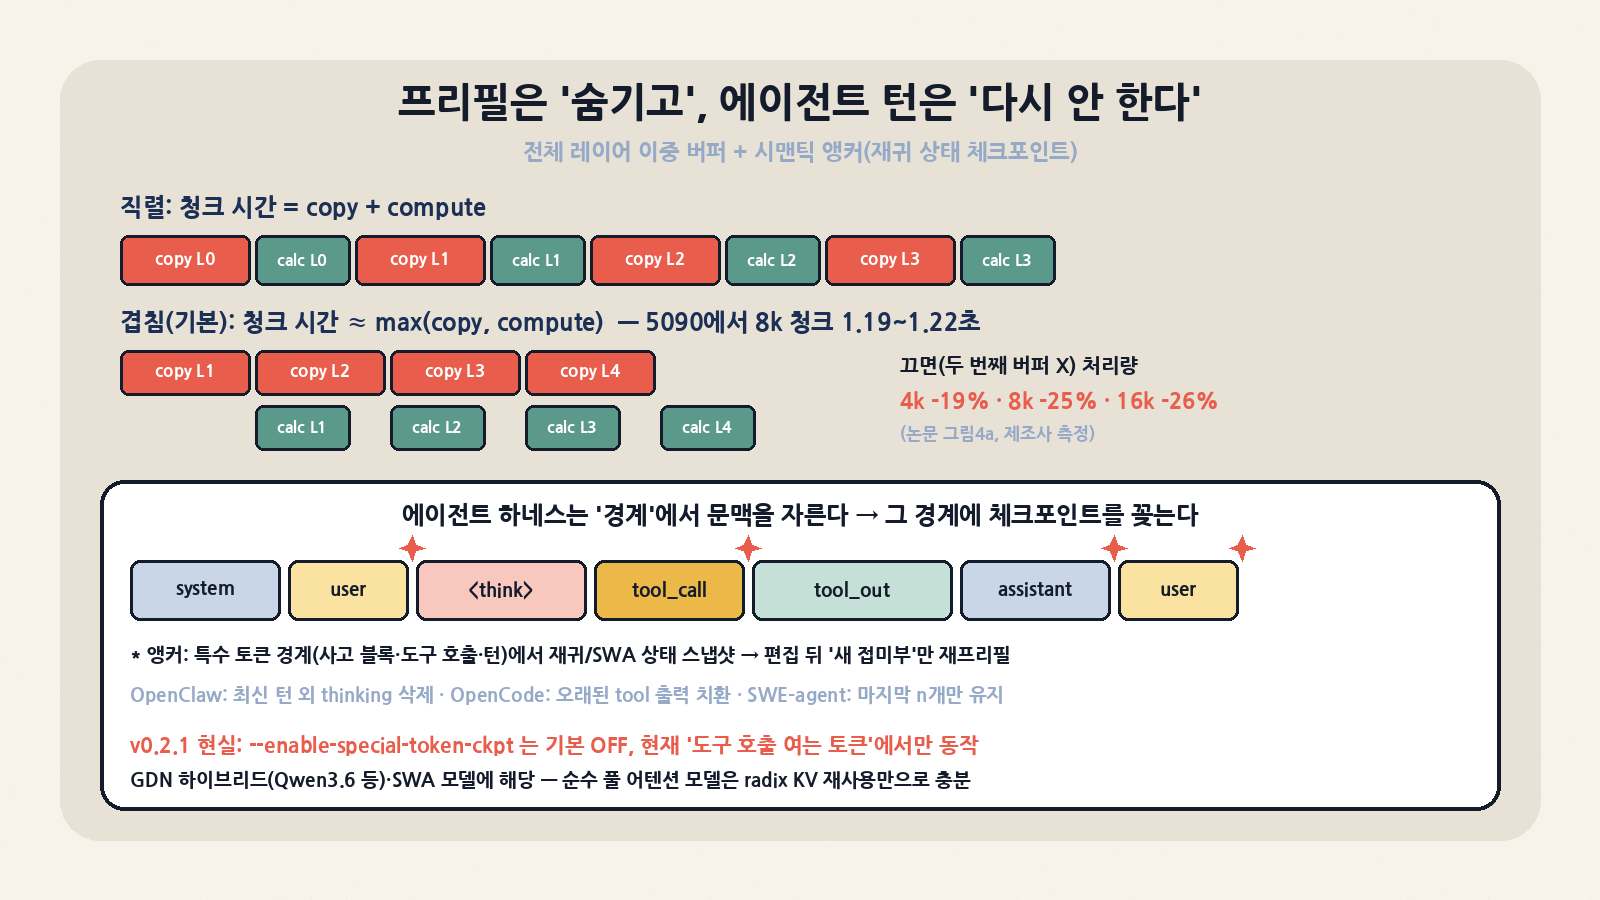
프리필은 어차피 거의 모든 전문가를 쓰므로 FreeToken은 필요할 때마다 가져오는(on-demand) 방식을 버렸습니다. 대신 전역 슬롯 풀에서 ‘레이어 하나 분량’ 버퍼 두 개를 떼어 냅니다. 레이어 L을 계산하는 동안 레이어 L+1의 전문가 전부를 별도 스트림으로 미리 보냅니다. L+1의 라우팅 결과를 기다리지 않고 전송을 시작할 수 있다는 점이 핵심입니다. 이 버퍼는 디코드 캐시와 같은 슬롯 풀에서 나오므로 프리필 뒤에 남은 항목이 그대로 디코드 캐시의 초기값이 됩니다. 두 레이어 분량을 확보하지 못하면 시작할 때 Disabling MoE prefill overlap 경고를 남기고 직렬 방식으로 내려갑니다. 그래서 운영할 때 가장 먼저 확인해야 할 로그 한 줄이기도 합니다.
3-2. 디코드: 공유 LRU 전문가 캐시 + q* 미스 분할
디코드에서는 연속한 토큰이 비슷한 전문가로 라우팅되는 시간적 지역성을 이용합니다. 로드할 때 고정 배치를 정하는 대신 모든 MoE 레이어가 하나의 LRU 잔류 공간을 함께 씁니다(--moe-cache-scope unified가 기본값). 그래도 남는 미스 m개는 두 경로로 나눕니다.
- 채우기 집합 F (q개): PCIe로 슬롯에 복사한 뒤 GPU에서 실행하고, 다음 토큰을 위해 남겨 둡니다.
- CPU 집합 C (m−q개): 호스트 풀에서 바로 CPU가 계산하고, 잔류 상태는 바꾸지 않습니다.
DMA 전송과 CPU 계산은 같은 호스트 메모리 대역폭을 나눠 씁니다. 그래서 PCIe가 포화되면 CPU가 쓸 수 있는 대역폭은 B_H − B_P만 남습니다. 두 갈래가 동시에 끝나도록 맞추면 q* ≈ m·B_P/B_H가 나옵니다. B_H가 B_P에 가까워지면 q*는 m에 수렴하고, 자연스럽게 ‘전부 캐시 채우기’로 바뀝니다. 실제 코드(moe/bench_profile.py의 fetch_fraction)는 ft bench bw가 두 경로를 동시에 돌려 잰 값으로 pcie_ov/(pcie_ov+cpu_ov)를 계산합니다. 겹침 측정값이 없으면 pcie/cpu로 대신하는데, 겹침 측정의 CPU 값이 곧 잔여 대역폭이라 두 식은 같은 이야기입니다. 캐시가 계속 데워지도록 채우기는 최소 1개를 유지하고, GPU와 CPU의 부분합을 합쳐 MoE 출력을 정확하게 보존합니다. 근사는 없습니다.
공학적으로 가장 흥미로운 부분은 이 모든 결정이 CUDA Graph 안에서 이뤄진다는 점입니다. 레이어마다 GPU 커널 하나가 라우팅된 전문가의 중복을 없애고, 잔류 테이블과 대조하고, q를 정하고, 희생 슬롯을 고르고, 논리 ID를 물리 슬롯 ID나 CPU 할당 플래그로 바꿉니다. 희생 슬롯은 한 번의 스캔으로 LRU 후보 K개를 뽑아 앞에서부터 q개를 씁니다. CPU 갈래도 고정된 pinned I/O 버퍼와 host-function 노드로 그래프에 함께 캡처됩니다. 그래서 토큰마다 Python 스케줄링이 끼어들지 않습니다. 논문 관련 연구 절은 기존 하이브리드 엔진의 호스트 측 휴리스틱이 그래프 캡처와 맞지 않는다는 점을 차별점으로 꼽습니다.
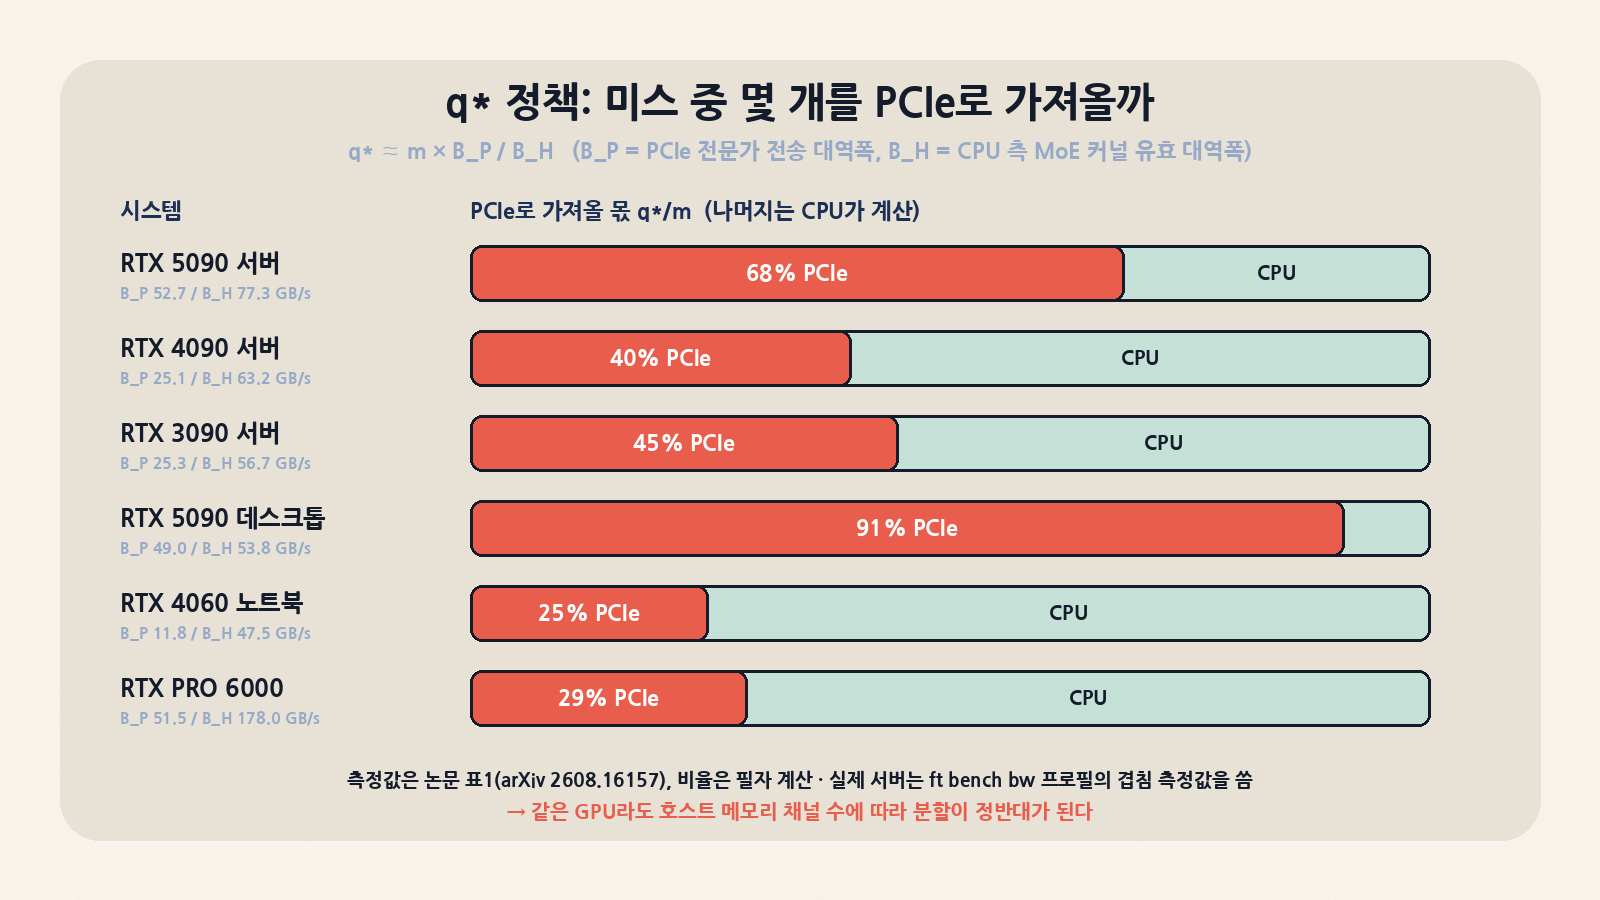
| 시스템(논문 표1) | B_P (GB/s) | B_H (GB/s) | q*/m (필자 계산) | 해석 |
|---|---|---|---|---|
| RTX 5090 · 2×Xeon(6스레드 제한) | 52.7 | 77.3 | 68% | 미스 3개 중 2개는 PCIe로 |
| RTX 4090 · 2×Xeon | 25.1 | 63.2 | 40% | PCIe 4.0이 병목, CPU 비중 증가 |
| RTX 3090 · 2×Xeon | 25.3 | 56.7 | 45% | 4090과 비슷한 균형 |
| RTX 5090 데스크톱 · Ryzen 9 9950X3D | 49.0 | 53.8 | 91% | 듀얼 채널 DDR5라 거의 캐시 채우기만 |
| RTX 4060 노트북 · i9-13900H | 11.8 | 47.5 | 25% | PCIe x8, 미스의 3/4을 CPU가 |
| RTX PRO 6000 · Xeon 8559C | 51.5 | 178 | 29% | 호스트 대역폭이 커서 CPU가 주력 |
같은 RTX 5090이라도 서버(68%)와 데스크톱(91%)의 분할이 크게 다릅니다. 사양표만 보고 정할 수 없고 그 기계에서 직접 재야 한다는 논문의 주장이 이 숫자로 드러납니다. 단, 표의 비율은 논문 측정값으로 필자가 계산한 것이고, 실제 서버는 프로필에 기록된 겹침 측정값을 씁니다.
3-3. 시맨틱 앵커: 에이전트가 자르는 자리에 체크포인트를
Qwen3.6-35B-A3B(gated DeltaNet), DeepSeek-V4-Flash·gpt-oss(SWA)처럼 하이브리드 어텐션을 쓰는 모델은 KV만으로는 프리픽스를 재사용할 수 없습니다. 재귀 층은 과거 전체를 하나의 상태로 압축하므로 부분 재사용이 불가능하고, 상태 체크포인트 하나가 KV 수백 토큰 분량을 차지해서 몇 개밖에 둘 수 없습니다. FreeToken은 이 적은 예산을 특수 토큰 경계, 즉 사고 블록·도구 호출·도구 출력·대화 턴에 씁니다. OpenClaw는 최신 턴을 뺀 thinking 블록을 지우고, OpenCode는 오래된 도구 출력을 자리표시자로 바꾸고, SWE-agent는 마지막 n개 관찰만 남깁니다. 결국 하네스는 이 경계 단위로 블록을 통째로 지우거나 바꾸므로, 경계에 꽂아 둔 체크포인트가 가장 오래 살아남습니다. 풀 어텐션 층은 radix 트리로 KV를 재사용하고 재귀 층은 앵커에서 재개하므로, 새로 붙은 접미부만 다시 프리필하면 됩니다.
다만 현재 릴리스에는 주의할 점이 있습니다. 소스의 --enable-special-token-ckpt는 기본값이 꺼져 있고, 도움말에 따르면 지금은 “도구 호출을 여는 토큰”에서만 동작합니다. 박스에서 ft serve를 띄웠을 때 출력된 ServerArgs에도 special_token_ckpt=False가 찍혀 있었습니다. 논문의 설계 전체가 기본값으로 켜져 있다고 가정하면 안 됩니다. GDN·SWA 모델로 에이전트를 돌린다면 이 플래그부터 켜고 TTFT를 비교해 보시기 바랍니다.
3-4. 탄력 메모리와 빠른 부팅
스케줄러의 안전 지점(safe point)에서 GPU 전문가 캐시를 새 예산에 맞춰 다시 만들 수 있습니다. 엔진을 재시작하지 않고, 호스트 풀도 다시 읽지 않습니다. 운영 인터페이스는 ft ctl cache --moe N | --kv N | --mamba N | --swa N(POST /v1/cache/rebuild)입니다. 게임을 켜기 전에 전문가 슬롯을 줄이고, 긴 세션에서 KV를 늘리는 식으로 쓸 수 있습니다. 부팅 쪽에서는 디스크의 전문가를 최종 호스트 레이아웃으로 바로 읽은 뒤 pin합니다. 빈 버퍼를 먼저 pin하면 수 GB 페이지를 0으로 채운 다음 다시 덮어쓰게 되기 때문입니다. ft checkpoint로 만드는 FTW(FreeToken Weight) 포맷은 전문가 뱅크 레이아웃(행 ID = l·E + e)을 미리 합쳐 두어 텐서 탐색과 재배치를 생략하고, 병렬 O_DIRECT로 읽습니다. GPU 워밍업은 하지 않습니다. 첫 요청은 콜드 캐시 상태에서 일반 미스 경로로 처리되고, 캐시는 서비스하면서 데워집니다.
4. 저장소 구조
| 경로 | 역할 | 읽을 포인트 |
|---|---|---|
python/freetoken/moe/ |
전문가 뱅크, 오프로드 캐시, CPU 실행기, 벤치 프로필 | offload_cache.py의 ensure_experts_hybrid, bench_profile.py의 fetch_fraction·locked_fetch_fraction |
python/freetoken/scheduler/, kvcache/ |
배치 스케줄러, radix 캐시, SWA/GDN 상태 풀, DSV4 전용 풀 | special_token_ckpt 분기, hybrid_swa_pool.py |
python/freetoken/models/ |
모델 패밀리별 구현(약 20개 디렉터리) | deepseek_v4/v41, glm5_next, qwen3_5_moe, gguf 로더 |
python/freetoken/kernel/, attention/ |
Triton 폴백 커널, 어텐션 백엔드 선택 | [accel]이 없으면 순수 Triton 경로로 폴백 |
python/freetoken/server/ |
FastAPI 기반 OpenAI/Anthropic 호환 서버, 인자 파서 | args.py에 문서에 없는 플래그도 있음 |
python/freetoken/daemon/ |
ft daemon: torch 없이 도는 감독 프로세스(:1900) |
CUDA 장애가 제어 평면까지 죽이지 않도록 import를 격리하고 테스트로 강제 |
scripts/checkpoint_diagnose/, gguf_check/ |
GPU 없이 체크포인트 로드 가능 여부 진단 | 헤더만 받아 서버 로드 경로를 meta 텐서로 재현 |
benchmarks/, docs/performance/ |
디코드 tok/s, 뱅크 로드, 캐시 복사 벤치와 프리필 튜닝 가이드 | copy-bound인지 compute-bound인지 판별하는 절차가 실무에 유용 |
5. MoE 전략: 기본값은 hybrid가 아니다
--moe-strategy |
전문가 위치 | 미스 처리 | 언제 |
|---|---|---|---|
fused |
전부 GPU | 미스 없음 | VRAM에 다 들어갈 때. 통합 메모리 GPU(GB10/DGX Spark)에서는 auto가 이것을 고름 |
offload |
호스트 RAM + GPU LRU 슬롯 | 전부 PCIe로 가져옴 | MoE 모델의 auto 기본값 |
cpu |
호스트 RAM | 전부 CPU에서 계산 | pin/DMA를 못 쓰는 플랫폼의 최후 수단 |
hybrid |
호스트 RAM + GPU LRU 슬롯 | q*만큼 가져오고 나머지는 CPU가 계산, 두 갈래를 겹쳐 실행 | 논문의 대역폭 적응 실행. ft bench bw로 먼저 보정해야 함 |
auto |
– | dense는 fused, MoE는 offload | 처음 띄울 때 |
논문의 대표 기법인 q* 분할은 opt-in입니다. 기계마다 한 번 ft bench bw --model <checkpoint>를 돌려 ~/.cache/freetoken/benchbw/<gpu-uuid>.json을 만든 다음 --moe-strategy hybrid로 띄워야 합니다. 프로필의 행 키에는 CPU 스레드 수가 들어가므로 bench의 --cpu-threads와 서버의 --moe-cpu-threads를 맞춰야 하고, 일치하는 행이 없으면 레이어당 가져오기 상한이 1로 떨어집니다. WSL처럼 pinned 메모리에 상한이 있는 호스트에서는 --moe-cpu-layers auto가 가운데 레이어부터 pin하고 나머지는 OS-lock합니다. lock된 레이어는 p/(2p+c) 비율로 staging 버퍼를 거쳐 가져옵니다.
6. 설치와 실행 (README·docs의 명령 그대로)
# PyPI (uv 권장). CUDA 커널은 처음 쓸 때 JIT로 컴파일되므로 nvcc(CUDA 13)가 PATH에 있어야 함
uv venv && source .venv/bin/activate
uv pip install "freetoken[accel]"

# 소스 빌드
git clone https://github.com/FlashML-org/FreeToken.git && cd FreeToken
uv venv && source .venv/bin/activate
uv pip install -e ".[accel]"

# 서버 기동 (--model은 로컬 디렉터리, HF repo id, FTW 디렉터리, .gguf 모두 가능)
ft --version
ft serve --model ~/models/Qwen3.6-35B-A3B
curl http://127.0.0.1:1919/v1/models

# 하이브리드 디코드 보정 → 기동
ft bench bw --model ~/models/Qwen3.6-35B-A3B
ft serve --model ~/models/Qwen3.6-35B-A3B --moe-strategy hybrid

# 코딩 에이전트 연결 (claude / codex / dsh / hermes / openclaw / opencode)
ft launch claude --dry-run
ft launch claude

# 운영
ft ctl stats
ft ctl cache --moe 2k --wait 300
ft checkpoint --model <hf_dir> --out <ftw_dir>
평가할 때는 benchmarks/bench_decode_moe.py --model ... --backend offload,cpu,hybrid가 백엔드별로 ft serve를 띄우고 스트리밍 응답의 토큰 도착 시각을 잽니다. 서빙 경로 전체가 포함된 bs=1 디코드 tok/s를 얻을 수 있습니다. 프리필은 --max-prefill-length(기본 8192)를 키워 가며 입력 처리량이 청크 크기에 비례해서 늘면 copy-bound, 거의 그대로면 compute-bound로 판단합니다. 이 절차는 docs/performance/prefill.md에 Nsight Systems 확인 방법까지 정리되어 있습니다.
7. 개발팀이 밝힌 성능 (논문, 제조사 측정)
| 항목 | 수치 | 조건 |
|---|---|---|
| 디코드, Qwen3.6-35B-A3B BF16 | 77~83 tok/s (가장 강한 비교 대상의 1.8~2.3배) | RTX 5090, 에이전트 워크로드 W1~W4, CPU 6스레드 |
| 디코드, DeepSeek-V4-Flash MXFP4 | 22~25 tok/s (1.5~1.9배) | RTX 5090, CPU 8스레드 |
| 에이전트화에 따른 디코드 안정성 | 단일 턴 대비 12% 이내 | KTransformers(DSV4)는 W2에서 이미 31% 하락 |
| 최악 TTFT | 모든 셀에서 44초 미만 | llama.cpp 232초, Ollama 179초, KTransformers 946초 |
| 디코드 전문가 미스율 (같은 캐시 용량) | 16% / 39% | Qwen3.6 / DSV4. KTransformers 41%/59%, llama.cpp 62%/89% |
| 8GB RTX 4060 노트북 | 35B 모델 39.3 tok/s (NVFP4) | Codex 실서비스 디코드 중앙값 33 tok/s보다 빠름 |
| GLM-5.2 753B-A40B | 14.9 tok/s (llama.cpp 7.3) | RTX PRO 6000 96GB 1장, 호스트 512GiB |
v0.2.1 --embed-weights host |
디코드 8.7% 향상 | Qwen3.6-35B-A3B, 여유 VRAM 24GiB |
측정 설계에는 짚어 둘 점이 있습니다. 3090/4090/5090 ‘서버’는 CPU를 6스레드로 제한하고 GPU가 붙은 NUMA 노드에 고정해서 엣지 수준의 호스트 대역폭(56.7~77.3GB/s)을 흉내 냈습니다. 실제 데스크톱과 노트북으로 이 방식을 검증했다고 하지만, 결국 저자들이 직접 잰 값입니다. 에이전트 궤적은 엔진마다 갈라지므로 벽시계 총시간은 비교하지 않았다고 스스로 밝힌 점은 정직합니다. 도입을 검토한다면 위 표를 결론으로 받아들이지 말고, 자기 GPU와 메모리 구성에서 bench_decode_moe.py를 다시 돌려 볼 가설로 다루는 편이 맞습니다.
8. 박스 스모크 테스트: GPU 없이 확인한 것과 못 한 것
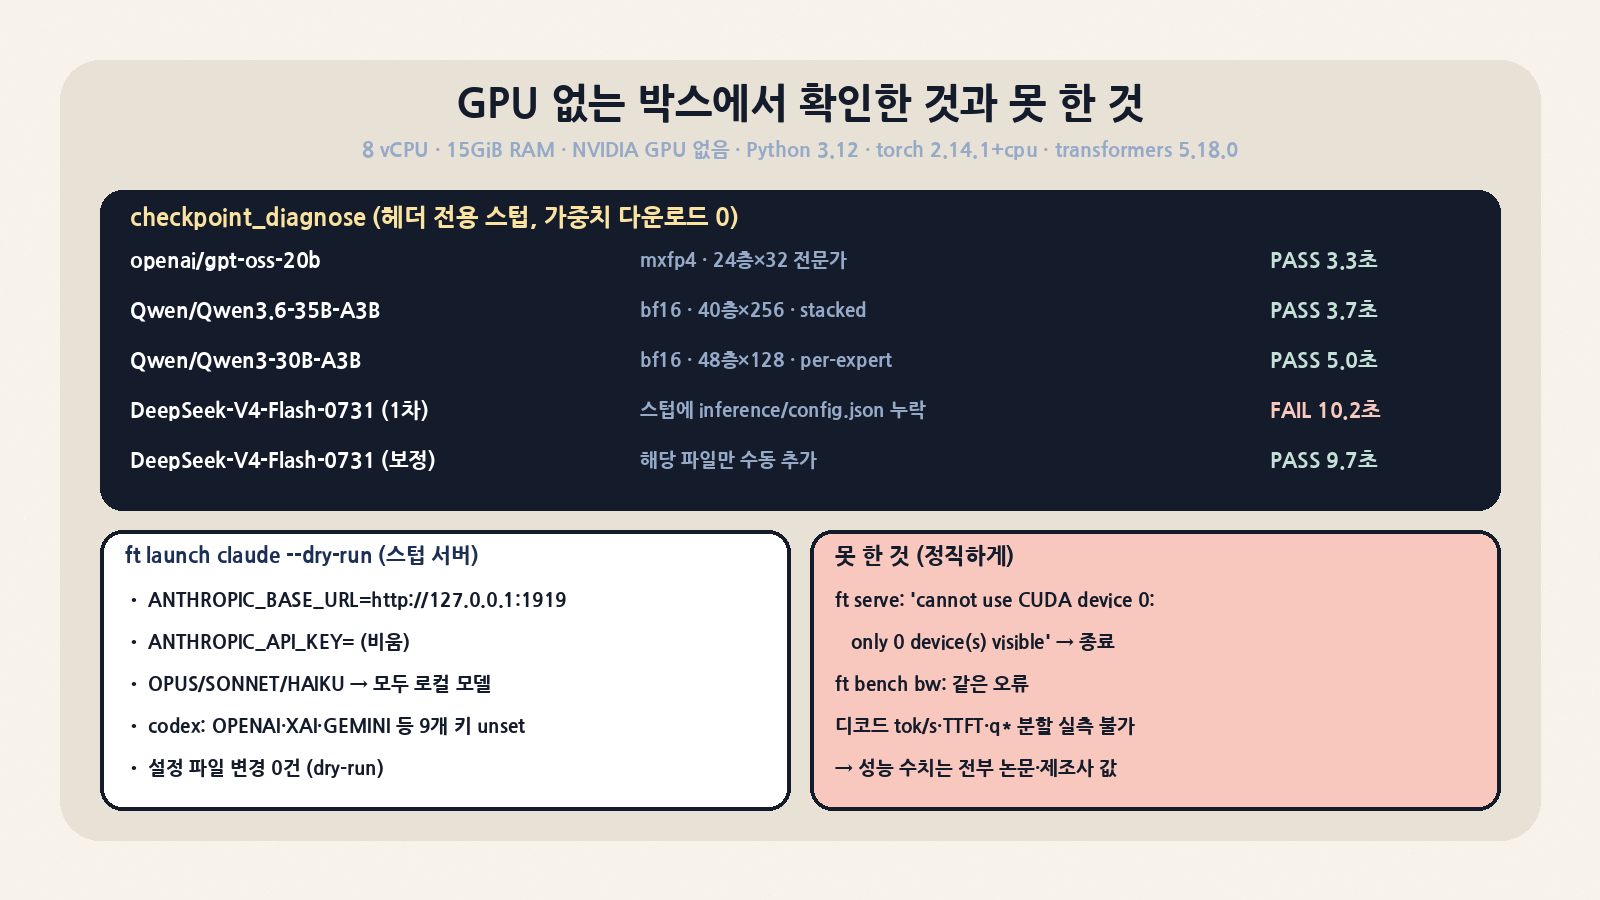
MoricWorld 박스에는 NVIDIA GPU가 없습니다(8 vCPU, 15GiB RAM). 그래서 추론 성능은 한 줄도 재지 못했습니다. 대신 GPU 없이 돌아가도록 설계된 부분, 즉 torch 없는 CLI, 체크포인트 진단기, 에이전트 런처가 문서대로 동작하는지 확인했습니다. 환경은 Python 3.12, freetoken==0.2.1(의존성을 직접 골라 설치), torch 2.14.1+cpu, transformers 5.18.0, triton 3.8.0, flashlib 0.4.0입니다.
| 시험 | 결과 (실제 출력 요약) | 의미 |
|---|---|---|
ft --version, ft --help |
freetoken version 0.2.1. 명령은 serve·shell·ctl·daemon·launch·checkpoint·bench |
docs/cli.md 표에 없는 daemon이 실제로 있음 |
diagnose.py openai/gpt-oss-20b |
GptOssForCausalLM, mxfp4, MoE 24층×32 전문가 → PASS (3.3초) | 헤더 전용 스텁(140KB)만으로 config→build→dense load→expert bank까지 CPU meta 텐서로 재현 |
diagnose.py Qwen/Qwen3.6-35B-A3B |
Qwen3_5MoeForConditionalGeneration, 40층×256, stacked 전문가 → PASS (3.7초) | 스텁 356KB, 가중치 다운로드 0 |
diagnose.py Qwen/Qwen3-30B-A3B |
Qwen3MoeForCausalLM, 48층×128, per-expert → PASS (5.0초) | 스텁 4.0MB |
diagnose.py deepseek-ai/DeepSeek-V4-Flash-0731 |
1차 FAIL at quant: No DeepSeek-V4 ModelArgs JSON found ... (looked for inference/config.json) (10.2초) |
HF 저장소에는 inference/config.json이 있음. 스텁 수집기가 하위 디렉터리를 받지 않아 생긴 거짓 음성 |
| 위와 같음, 해당 JSON 하나만 스텁에 추가 | DeepseekV4ForCausalLM, fp8, 43층×256 → PASS (9.7초) + 정보성 note 3건 | README의 “진단은 휴리스틱이라 틀릴 수 있다”는 경고가 실제로 맞음 |
ft launch claude --dry-run (필자가 만든 /v1 스텁 서버) |
ANTHROPIC_BASE_URL=http://127.0.0.1:1919, ANTHROPIC_API_KEY=(비움), OPUS·SONNET·HAIKU·서브에이전트 모델을 모두 로컬 모델로 지정, 컨텍스트 262144 |
클라우드로 몰래 넘어가는 경로를 막는 설계가 실제로 확인됨 |
ft launch codex --dry-run |
codex --profile freetoken-launch .... OPENAI·ANTHROPIC·GEMINI·XAI·OPENROUTER 등 9개 키를 unset. 임시 HOME에 생성된 파일 0개 |
dry-run은 정말로 아무것도 건드리지 않음 |
ft serve --model Qwen/Qwen3-30B-A3B |
RuntimeError: cannot use CUDA device 0: only 0 device(s) visible → 백엔드 종료 후 API 서버도 정지 |
CPU 단독 서빙 모드는 없음. cpu 전략도 비전문가 층은 GPU에 둠 |
ft bench bw |
같은 CUDA 장치 오류 | q* 보정값은 GPU가 있는 기계에서만 생성 가능 |
설치하면서 알게 된 점도 있습니다. freetoken[accel]은 cu130 빌드 torch, flashinfer-python[cu13], sglang-kernel을 끌어옵니다. --no-deps로 설치하면 ft serve는 torch, flashlib, triton, uvicorn이 없다는 오류를 차례로 냅니다. 진단 스크립트만 GPU 없는 CI에서 돌리고 싶다면 CPU용 torch에 transformers 5.18, flashlib 0.4.0, apache-tvm-ffi, triton을 직접 맞춰 넣으면 됩니다(위 환경 그대로). 대형 체크포인트를 수백 GB 내려받기 전에 “이 엔진이 이 저장소를 읽을 수 있는가”를 몇 초 만에 확인할 수 있다는 점은 GPU 유무와 상관없이 실무에서 쓸모가 있습니다.
9. 비슷한 도구와 비교
| 엔진 | 전문가 배치 | 미스 처리 | 에이전트 프리픽스 재사용 | 하드웨어 | 적합한 경우 |
|---|---|---|---|---|---|
| FreeToken | 호스트 풀 + 전 레이어 공유 GPU LRU | q* 분할(PCIe 채우기 ∥ CPU 계산), CUDA Graph 내부 결정 | radix KV + 시맨틱 앵커(기본 OFF) | NVIDIA CUDA 13, Linux(데스크톱 앱은 Windows/Linux) | VRAM보다 큰 MoE를 에이전트용으로 로컬에서 |
| llama.cpp | 로드 시 텐서별 장치 고정(-ot 등) |
CPU에 놓인 전문가는 CPU가 계산 | KV 프리픽스 위주 | CPU·Metal·Vulkan·CUDA·ROCm 등 가장 넓음 | 범용성, GPU 없는 환경, 맥 |
| Ollama | llama.cpp 기반 자동 분할 | llama.cpp와 동일 | 제한적 | 넓음 | 설치 편의, 단일 사용자 데모 |
| KTransformers | 핫 전문가 GPU 고정 + 나머지 CPU(AMX 최적화) | CPU 실행 위주, 프리필 때 배치 갱신 | 제한적 | CUDA + 고성능 x86 CPU | 메모리 채널이 많은 워크스테이션 |
| MoE-Infinity | 활성 패턴 추적 기반 프리페치·캐시 | 전부 PCIe 전송 | 서버가 요청 간 KV를 유지하지 않음(논문 기준) | CUDA | 단발 추론 연구 |
| vLLM / SGLang | 전부 GPU(데이터센터 가정) | – | 강력한 radix/프리픽스 캐시 | 데이터센터 GPU, 다중 GPU | 모델이 VRAM에 들어가는 서빙 환경 |
MoricWorld에서 앞서 다룬 추론 엔진과도 갈래가 다릅니다. Mesh-LLM(10/31)은 여러 기계를 QUIC으로 묶는 분산 접근이고, magnitude(10/30)는 칩별 커널 튜너, uzu(10/29)는 앱 내장형 Rust 엔진입니다. FreeToken은 단일 기계 안에서 이종 자원을 엮어 MoE 미스를 처리하는 방식에 집중합니다.
10. 도입 전 확인할 점 (한계와 주의 사항)
| 주제 | 사실 | 권장 대응 |
|---|---|---|
| 하드웨어 종속 | NVIDIA + CUDA 13 + 드라이버 r580+ 필수, JIT 컴파일에 nvcc 필요. AMD는 WIP, 맥은 미지원 | nightly 휠과 freetoken-kernel-cache(사전 빌드 커널) 조합으로 JIT 의존을 줄임 |
| 호스트 RAM 요구량 | 전문가 전체가 RAM에 pin됨. DSV4.1-Flash는 98GiB Engram 테이블 2개를 NVMe에서 스트리밍, Qwen3.8-Flash-Next는 47.7GiB PLE 테이블을 RAM에 pin | “VRAM이 작아도 된다”는 말은 “RAM이 커야 한다”는 뜻으로 읽기. 128~192GB 이상 계획 |
| 기본값과 논문의 차이 | MoE auto는 offload(hybrid 아님), 시맨틱 앵커 플래그는 기본 OFF |
ft bench bw → --moe-strategy hybrid → --enable-special-token-ckpt 순서로 A/B 측정 |
| 네트워크 노출 | 기본 bind는 127.0.0.1이지만 --api-key는 기본 OFF. 이미지 URL은 --allowed-media-domains 기본값이 “모든 도메인” |
외부에 열 때는 API 키 + 도메인 허용 목록 + 리버스 프록시. 로컬 파일 참조(--allowed-local-media-path)는 기본으로 막혀 있음 |
| FTW 포맷 호환성 | 버전에 따라 “에러 없이 로드되지만 출력이 틀리는” 경우가 있음(Qwen3.5/3.6/3.8-27B 정규화 가중치) | 업그레이드 후 FTW를 다시 변환하거나 scripts/ftw_hotfix.py로 수리 |
| 동시성 | --max-running-requests 기본 4. 엣지 단일 사용자 가정 |
팀 공용 서버라면 vLLM/SGLang 계열과 병행 검토 |
| 성숙도 | v0.2.x, 2026년 7월 생성. 릴리스마다 플래그 이름 변경(--moe-backend → --moe-strategy) |
버전을 고정하고 nightly는 태그가 아니라 휠 URL로 고정(docs 권고) |
| 진단기 오판 | 박스 실측에서 DSV4 원격 스텁이 거짓 FAIL | FAIL이 나오면 로컬 다운로드본으로 다시 진단한 뒤 판단 |
11. 누가 도입해야 하나
| 상황 | 판단 | 이유 |
|---|---|---|
| RTX 4090/5090 + RAM 128GB 이상, Claude Code·Codex·OpenCode를 로컬 MoE로 돌리고 싶음 | 우선 검토 | ft launch로 바로 연결되고, 에이전트처럼 문맥이 계속 바뀌는 상황의 TTFT 꼬리 지연을 줄이는 데 맞춰 설계됨 |
| 8GB급 노트북 GPU로 35B-A3B를 쓰고 싶음 | 시도해 볼 만함 | NVFP4 체크포인트 + offload/hybrid. 단 RAM 32GB 이상, PCIe x8 한계 감안 |
| RTX PRO 6000급 1장으로 GLM-5.2급 초대형 MoE | 현재 유력한 선택지 | 호스트 512GiB와 높은 B_H 조합에서 llama.cpp 대비 2배(제조사 측정) |
| 맥·AMD·CPU 전용 | 보류 | 미지원 또는 WIP. llama.cpp가 현실적인 선택 |
| 모델이 VRAM에 다 들어가는 다중 사용자 서빙 | 불필요 | 오프로드가 핵심인 엔진이라 이점이 적음. vLLM/SGLang이 적합 |
정리
FreeToken에서 가장 배울 만한 점은 특정 기법 하나보다 문제를 다시 정의한 방식입니다. 전문가 미스를 줄이는 예측기 경쟁은 결국 PCIe에서 막힙니다. FreeToken은 “남은 미스를 어디서 처리할 것인가”를 두 개의 측정 대역폭으로 푸는 닫힌 식과 GPU 상주 제어로 바꿨습니다. 여기에 에이전트 하네스가 문맥을 자르는 위치를 캐시 정책에 반영했습니다. 반대로 지금 v0.2.1에서는 논문의 핵심 기능 일부(hybrid 분할, 시맨틱 앵커)가 기본값이 아니고, NVIDIA 전용에 호스트 RAM을 많이 쓴다는 현실적인 비용이 있습니다. GPU가 있는 기계라면 ft bench bw 한 번과 bench_decode_moe.py --backend offload,hybrid 비교 한 번으로 자기 기계의 q*부터 확인해 보시기 바랍니다. 그 숫자가 FreeToken이 그 기계에서 얼마나 쓸모 있는지 가장 정확하게 알려 줄 것입니다.