한 줄 요약: beenuar/AiSOC는 보안 텔레메트리를 받아 탐지·상관·AI 트리아지·대응 제안까지 한 저장소에서 처리하는 셀프 호스팅 AI 보안관제센터(SOC)입니다. ‘AI가 알아서 막아 준다’를 내세우는 프로젝트는 아닙니다. 에이전트가 한 판단을 전부 Investigation Ledger에 남기고, 규칙은 실제로 발화하는 걸 확인해야 실행 대상에 넣으며, 응답은 사람 승인 없이는 벤더에 닿지 않게 묶어 둔 보수적인 설계가 특징입니다. 이 글에서는 v21.0.0(2026-11-01 14:05 KST 릴리스, MIT) 기준으로 구조와 동작 원리, 실행 방법, 그리고 Docker가 없는 박스에서 직접 돌려 본 결과를 정리합니다.
1. 한눈에 보기
| 항목 | 내용 (2026-11-02 16:5x KST 확인) |
|---|---|
| 저장소 | github.com/beenuar/AiSOC (2026-05-02 생성) |
| 최신 릴리스 | v21.0.0 — 2026-11-01 14:05 KST, 첨부: 소스 tarball·SPDX SBOM·checksums.txt |
| 직전 릴리스 | v20.4.0(10/31), v20.3.0(10/30), v20.2.1·v20.2.0(10/28) — 닷새 사이에 다섯 번 |
| 라이선스 | MIT (개발 비용은 Cyble이 대며, README는 “Cyble 전용 기능·게이트 모듈·텔레메트리 없음”이라고 밝힘) |
| 스타 / 포크 | 6,448★ / 660 포크, 오늘 하루 +446★ (GitHub Trending 전체 10위, Python 4위) |
| 주 언어 | Python(서비스 대부분) + Go(ingest·enrichment·osquery 확장) + TypeScript(realtime·MCP·Next.js 콘솔) |
| 핵심 의존 | Kafka, PostgreSQL, Redis, Qdrant, LiteLLM, Ollama(llama3.2:3b-instruct-q4_K_M), LangGraph / full 프로필: ClickHouse, Neo4j, OpenSearch |
| 최소 요구 사양 | Docker Compose v2, Docker VM 메모리 8GB·디스크 20GB, python3 3.9+, bash |
2. 왜 이번 주에 떠올랐나
오늘 Trending에는 에이전트 메모리, 코딩 하네스, 음성 받아쓰기 프로젝트가 많이 올라왔습니다. 그 가운데 AiSOC는 “LLM 에이전트를 보안 운영의 실제 데이터 경로에 넣으면 무엇을 어떻게 감사할 것인가”라는 질문에 꽤 구체적인 답을 내놓은 드문 사례입니다. 관심을 끈 이유는 세 가지로 볼 수 있습니다.
| 신호 | 구체적 내용 | 실무 관점의 의미 |
|---|---|---|
| 키 없이 바로 동작 | make up만으로 로컬 Ollama 모델이 실제 판정을 내고, 그 토큰 수가 Ledger에 기록됨. CISA KEV 피드도 키 없이 받아 옴 |
PoC 비용이 거의 0이고, 외부로 프롬프트가 나가지 않음 |
| v21.0.0 메이저 릴리스 | 상관 그룹핑 축소(BREAKING), 서빙 모델 출처 증명, 전체 코호트 분모 공개, 리트로헌트 리허설 모드 | 평가 수치를 ‘좋게 보이도록’ 만들 여지를 스스로 줄인 릴리스 |
| MCP 서버 동봉 | Claude·Cursor·Continue·Cody에서 알림·케이스·Ledger 재생을 도구로 호출 | 코딩 에이전트 사용자층이 같은 도구 체계로 보안 데이터를 조회할 수 있음 |
3. 저장소 구조: 모노레포 안의 20개 서비스
Turborepo + pnpm 워크스페이스(turbo.json, pnpm-workspace.yaml)에 Python 서비스는 각자 Poetry로, Go 서비스는 각자 go.mod로 묶여 있습니다. 디렉터리를 기능별로 나누면 다음과 같습니다.
| 경로 | 내용 |
|---|---|
services/ |
ingest(Go), fusion, agents, api, actions, connectors, threatintel, ueba, honeytokens, purple-team, escalations, mesh, slack-bot, teams-bot, osquery-tls(Python), enrichment·demo-producer·osquery-extensions(Go), realtime·mcp(TS) — 총 20개 |
detections/ |
endpoint·cloud·identity·network·data-exfil 등 네이티브 규칙과 sigma/splunk/chronicle/car import, rule-ids.lock.json |
hunts/, playbooks/ |
YAML 헌트 68개, 플레이북 YAML 50개 |
packages/ |
aisoc-sandbox·aisoc-migrate·aisoc-benchmark·aisoc-cli, SDK(py/go/ts), plugin-sdk, OCSF 타입, UI |
apps/ |
web(Next.js 콘솔), docs(Docusaurus), mobile |
schemas/, docs/ |
이벤트 카탈로그(10개 소스·44개 이벤트 타입), ADR(docs/decisions), 감사 문서(docs/audit/REPOSITORY_REALITY.md) |
scripts/ |
project_stats.py, check_*.py 패리티 게이트 — README에 적힌 수치를 트리에서 다시 세어 보고, 다르면 CI가 실패함 |
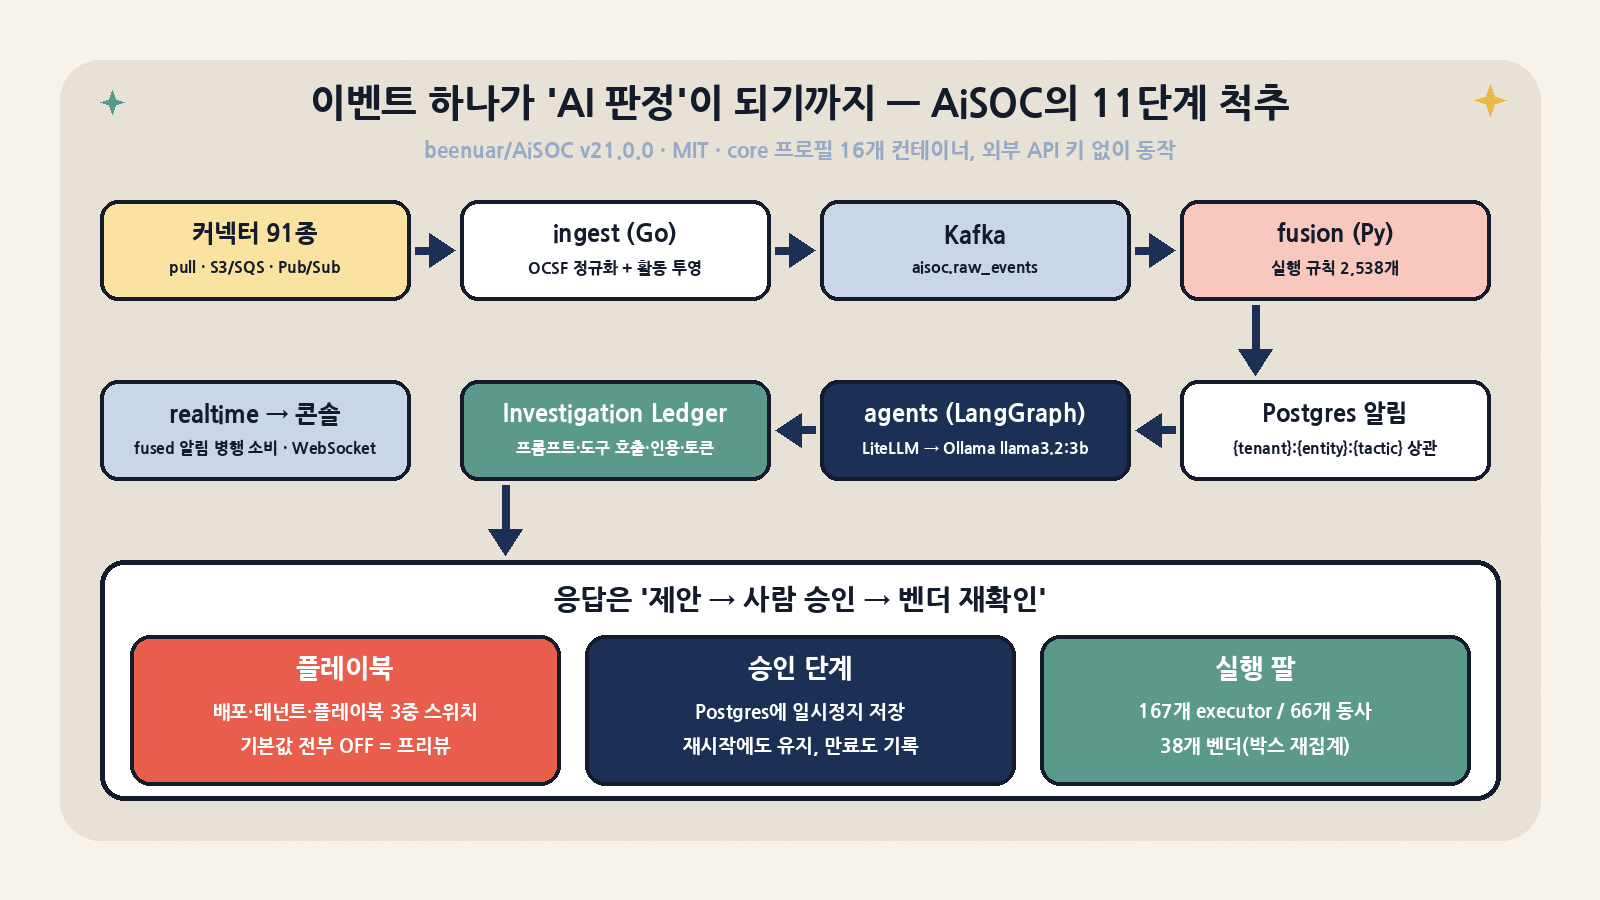
4. 이벤트 하나의 경로: 11단계
아키텍처 문서(docs/architecture/README.md)는 이벤트 하나를 따라가며 시스템 전체를 설명합니다. 요점만 정리하면 다음과 같습니다.
- ① 수집: 커넥터 91종이 스케줄에 맞춰 폴링하거나,
POST /v1/ingest/batch로 직접 푸시됩니다. 테넌트는 헤더가 아니라 자격 증명에서 결정됩니다.X-Tenant-ID헤더는 자격 증명이 허용하는 범위와 교집합을 낼 때만 쓰이고, 자격 증명을 검증할 수 없으면 503을 돌려줍니다. 클라우드 쪽은 REST 폴링 대신 S3+SQS(CloudTrail 조직 트레일), GCP Pub/Sub, Azure Event Hubs, syslog/CEF 수집기를 쓰고, 각 수집기는 재개 가능한 커서와 폴링당 예산을 갖고 있어 밀린 데이터가 한꺼번에 쏟아지지 않습니다. - ② 정규화: Go ingest가 커넥터별 프로필로 페이로드를 OCSF 형태의 봉투에 맞춥니다. 이때 모든 이벤트에 활동 투영(actor·action·resource·location·outcome)을 붙입니다.
actor.kind는 7종(human, service_account, workload, api_token, oauth_app, ai_agent, unknown)이며, 사용자 이름 모양으로 추측하지 않고 벤더가 문서화한 필드에서만 읽습니다(27가지 경우). - ③ 이벤트 척추: Kafka 토픽
aisoc.raw_events로 발행됩니다. - ④ 탐지: fusion이 실행 규칙을 평가하고, OCSF 카테고리 2(벤더 탐지 결과)이거나 심각도가 high 이상인 이벤트만 알림으로 승격합니다.
- ⑤ 상관:
{tenant}:{entity}:{tactic}키로 기존 인시던트에 붙이거나 새 인시던트를 엽니다. - ⑥~⑧ 기록·푸시·트리아지: Postgres에 기록하고
aisoc.alerts.fused로 발행합니다. realtime은 이를 WebSocket으로 콘솔에 밀어 주고, agents는 LLM으로 자동 트리아지한 뒤 프롬프트·도구 호출·인용을 Ledger에 남깁니다. - ⑨~⑪ 플레이북·승인·검증: 플레이북이 트리아지 뒤에 매칭되고, 승인 단계에서 멈췄다가 사람이 승인하면 실행합니다. 실행 결과는 HTTP 200을 성공으로 간주하지 않고 벤더 측 상태를 다시 읽어 검증합니다.
| 서비스(core) | 언어 · 포트 | 역할 |
|---|---|---|
| services/ingest | Go · :8080 | 인증된 수집, OCSF 클래스 17종 매핑, 활동 투영 |
| services/fusion | Python · :8003 | 규칙 평가, 슬라이딩 윈도 엔진, 테넌트 튜닝 오버레이, 상관 |
| services/agents | Python · :8084 | LangGraph 기반 트리아지·조사·플레이북 엔진, Ledger 기록 |
| litellm / ollama | :4000 / :11434 | LLM 게이트웨이(ADR-0006: core에 포함)와 번들 로컬 모델 |
| services/api · realtime · apps/web | Python :8000 · TS :8086 · Next.js :3000 | REST API(OpenAPI 스펙 동봉), WebSocket 푸시, 콘솔 |
| threatintel · connectors · actions | Python | CISA KEV 폴링·Qdrant 벡터, 커넥터 스케줄러, 거버넌스가 걸린 응답 실행기 |
5. 핵심 메커니즘 ①: 실행 가능하다는 것은 증명으로만 인정
이 프로젝트를 다른 오픈소스 SOC 스택과 가장 뚜렷하게 구분하는 부분입니다. 규칙 디렉터리에 YAML이 있다거나 enabled: true로 되어 있다는 이유만으로는 실행 규칙에 들어가지 못합니다. 벤더 형식의 이벤트를 실제 커넥터와 엔진에 재생해서, 그 규칙이 실제로 발화하는 것을 확인해야 컴파일된 룰셋에 들어갑니다. 그래서 디스크에 있는 7,023개 가운데 엔진이 로드하는 것은 2,538개뿐입니다. 이 숫자는 오히려 줄어드는 방향으로 관리됩니다. 아무 소스도 내보내지 않는 카운터를 참조하던 규칙은 윈도 규칙으로 다시 쓰거나, 이유를 기록하고 제외했습니다(아키텍처 문서는 2,603개에서 줄었다고 기록).
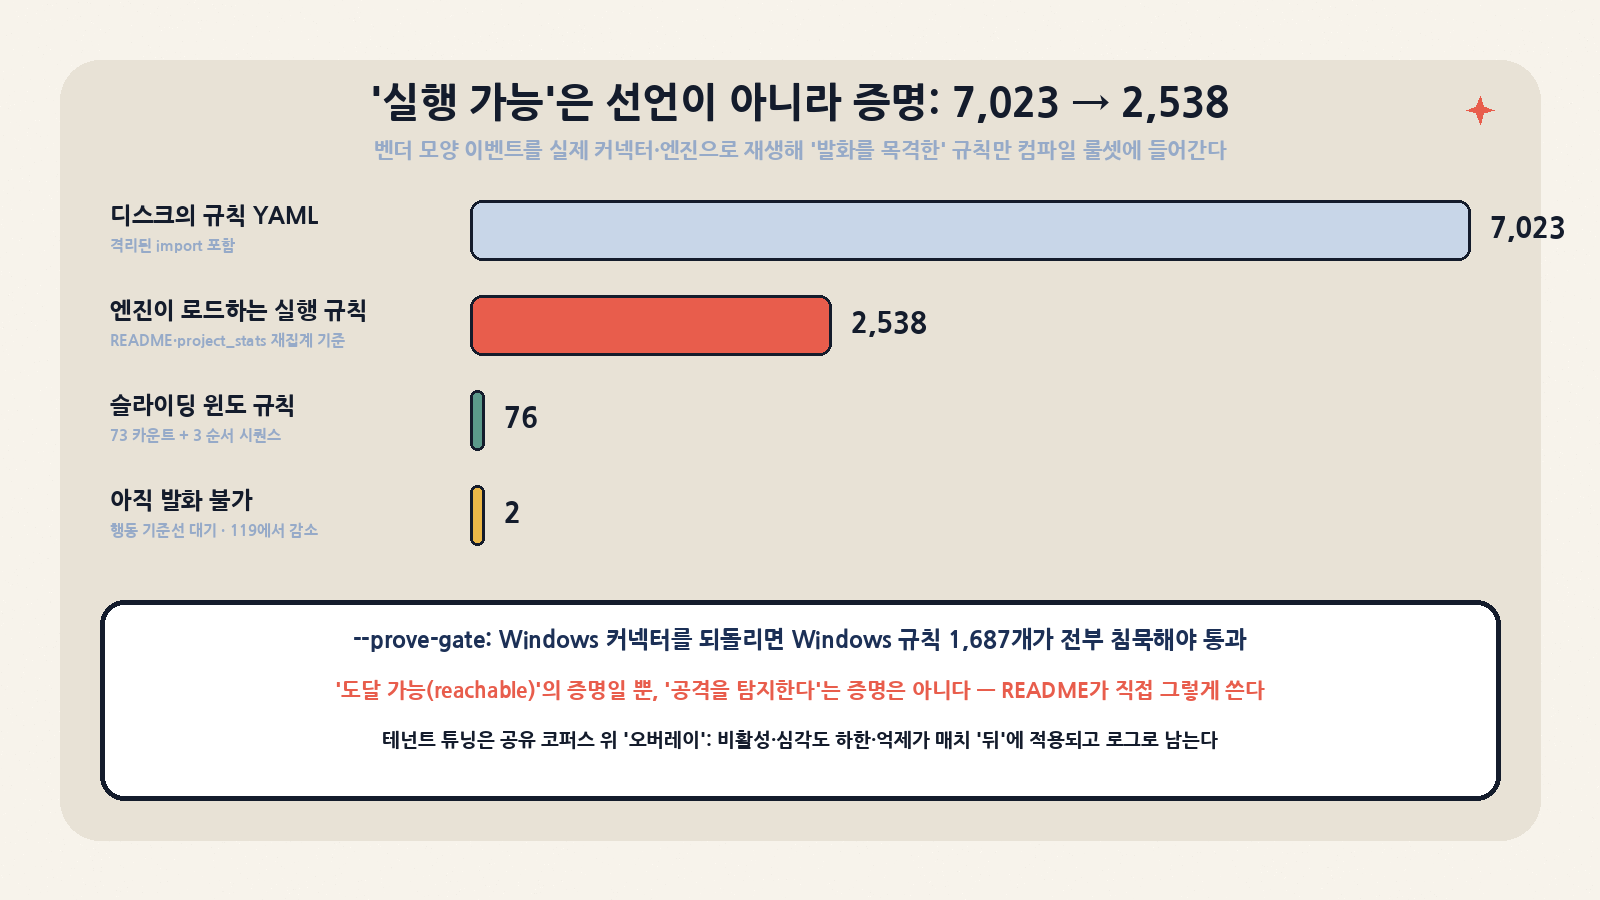
- 음성 대조군(negative control):
--prove-gate는 Windows 커넥터를 되돌린 상태에서 Windows 규칙 1,687개가 전부 발화하지 않아야 통과합니다. 게이트가 실제로 무언가를 걸러 내는지를 증명하는 장치입니다. - 발화할 수 없는 규칙의 래칫: 119개에서 2개로 줄었고, 남은 2개는 행동 기준선이 쌓이기를 기다리는 중입니다.
check_detection_fields.py가 이 숫자는 내려가기만 하도록 강제합니다. - 윈도 규칙은 따로 셈: 76개(카운트 73, 순서 시퀀스 3)는 실행 규칙 수에 더하지 않습니다. 임계값 기반 규칙과 단일 이벤트 매칭은 서로 비교할 수 없는 숫자라서입니다. Sigma correlation 문서(
event_count,value_count,temporal,temporal_ordered)도 엔진이 표현할 수 없는 형태라면 근사하지 않고 거부합니다. - 테넌트 튜닝 오버레이: 규칙을 테넌트마다 복사하지 않고, 공유 코퍼스 위에 차이(비활성·심각도 하한·억제)만 얹습니다. 억제는 매치가 끝난 뒤 적용하므로, 누가 어떤 이유로 억제했는지 로그가 남습니다. 오버레이를 다시 불러오다 실패하면 튜닝이 사라진 상태로 돌아가지 않고 이전 오버레이를 유지합니다.
단, README는 이 게이트가 “도달 가능(reachable)”하다는 증명일 뿐, 공격을 탐지한다는 증명은 아니라고 명시합니다. 규칙의 품질, 즉 정탐률과 오탐률은 여전히 운영 데이터로 검증해야 할 몫입니다.
6. 핵심 메커니즘 ②: 에이전트의 권한 경계와 Investigation Ledger
agents 서비스의 pyproject.toml에는 스스로를 “LangGraph-based autonomous investigation and response”라고 소개하고 있지만, 실제 권한 설계는 매우 보수적입니다. LLM은 판정을 제안할 수 있을 뿐이고, 무엇을 실행할 수 있는지는 계약(capability contract)과 정책이 정합니다.
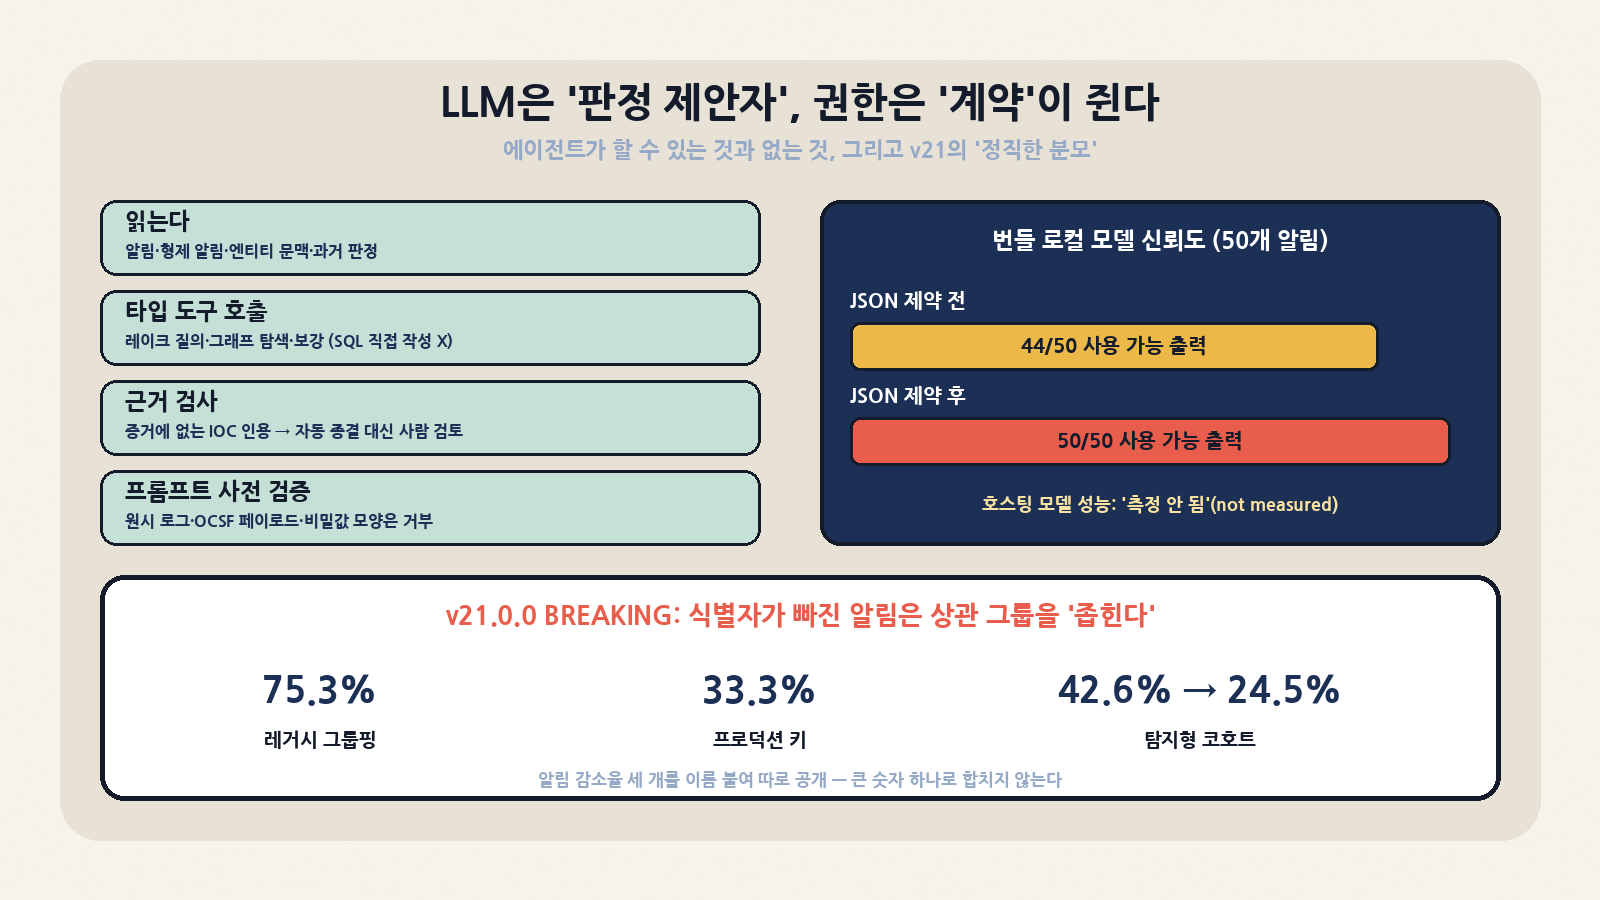
| 층위 | 허용 | 차단·강등 조건 |
|---|---|---|
| 컨텍스트 | 알림, 상관된 형제 알림, 엔티티 문맥, 같은 시그니처의 과거 판정을 읽음 | 연결하지 않은 텔레메트리는 볼 수 없음(탐색 기능 없음) |
| 도구 | 레이크 질의, 그래프 탐색, 보강 조회 같은 타입이 정해진 도구 호출 | 모델이 SQL을 직접 쓰지 않음. 가설로 헌트를 만들 때도 닫힌 스키마를 채우고 값은 파라미터로 바인딩됨 |
| 근거 검사 | 판정마다 인용을 붙여야 함 | 증거에 없던 지표를 인용한 판정은 자동 종결 대신 사람 검토로 강등 |
| 프롬프트 사전 검증 | 정규화된 요약을 전송 | 원시 로그, OCSF 페이로드, 비밀값처럼 보이는 문자열은 사후 마스킹이 아니라 전송 거부 |
| 응답 | 제안, 프리뷰, 승인 후 실행 | 배포·테넌트·플레이북 세 스위치가 모두 켜져야 하고(기본값은 전부 OFF), 단계마다 계약을 다시 확인. 요청자와 승인자는 같은 사람일 수 없음 |
Ledger에는 프롬프트, 도구 호출, 인용, 판정, 토큰 비용이 모두 기록되고, 서명된 증거 번들로 내보낼 수 있습니다. 문서에 따르면 번들은 바이트 단위로 동일하게 재현되고, 프롬프트는 다이제스트로 담기며, OCSF 1.9.0 형식입니다. 플레이북 단계 어휘는 25종인데, 이 가운데 16종은 실행 시점에 계약으로 다시 검사받는 ‘거버넌스 동사’입니다. notify나 osquery_live_query도 여기에 속합니다. 채널에 메시지를 보내거나 전체 장비에 실시간 쿼리를 날리는 일도 운영자가 막을 수 있어야 한다는 판단입니다. v21 계열 CHANGELOG에는 ask_model 단계가 추가되었는데, 플레이북 작성자가 정해 둔 닫힌 선택지 안에서만 모델이 답하므로, 모델의 답변이 곧바로 어떤 행동으로 이어질 수는 없습니다.
번들 모델의 실제 수준
기본 모델은 CPU 추론을 고려해 고른 약 2GB짜리 llama3.2:3b-instruct-q4_K_M입니다. README가 공개한 측정치는 알림 50개 중 JSON 제약 전 44개, 제약 후 50개에서 사용 가능한 출력을 냈다는 것입니다. 정확도가 아니라 형식 신뢰성을 잰 숫자라는 점에 유의해야 합니다. 그리고 호스팅 모델(OpenAI, Anthropic 등)은 한 번도 측정된 적이 없어서 모델별 행에는 0이 아니라 “not measured”가 적혀 있습니다. 실서비스에서 쓰려면 make up-gpu, make up-host-llm 또는 콘솔에서 호스팅 공급자를 연결하는 쪽이 현실적인 선택입니다.
7. v21.0.0에서 바뀐 것: 평가 지표를 정직하게 세는 장치
| 변경 | 내용 | 왜 중요한가 |
|---|---|---|
| BREAKING: 상관 그룹 축소 | tactic이 없는 알림은 엔티티 단위가 아니라 규칙 단위로 묶고, 식별자가 하나도 없는 알림은 다른 규칙과 병합하지 않음. 탐지 형태 코호트 기준 감소율이 42.6%에서 24.5%로 내려감 | 관련 없는 알림까지 묶어 ‘감소율’을 부풀리던 효과를 제거. API 변경은 없고 기존 인시던트는 그대로 유지 |
| 서빙 모델 출처 증명 | provenance_status 5종(verified, self_reported, unattributed, serving_mismatch, no_calls) 도입. 요청한 모델과 실제로 응답한 모델이 다르면 해당 모델의 성적으로 인정하지 않음 |
이전 평가 행은 resolved_models: [], 즉 72번의 호출이 어떤 모델에서 나왔는지 알 수 없었음. 과거 5개 행은 “unverified”로 표시 |
| 전체 코호트 분모 | 재현율 계산에서 기권·오류 케이스를 분모에서 빼지 않음. 종결 오염률과 요청 신뢰성(5개 카운트)을 함께 공개 | 선택적 재현율로 성능을 부풀리는 일을 방지 |
| 리플렉스 경로 관측 | 큐 지연부터 승인·writeback까지 9단계 타이밍과 결정 계약(지지 증거, 반대 증거, 빠진 전제, 에스컬레이션 사유) 기록 | ‘왜 사람에게 넘겼나’를 구조화된 데이터로 감사 가능 |
| 리트로헌트 리허설 | RETRO_HUNT_DRY_RUN: 스윕은 실제와 똑같이 돌리되(스윕 예산도 소비) 쓰기 경계에서 모든 변경을 보류 |
새 위협 인텔리전스를 과거 데이터에 안전하게 대 볼 수 있음 |
| 판정 모델 매트릭스 | 결정론적 기준선(균형 정확도 정확히 0.250, 악성 36건 중 0건 탐지)을 표에 나란히 표시 | 모델 성적을 어떤 하한선과 비교해 읽어야 하는지 명확해짐 |
알림 감소율도 하나로 합치지 않고 레거시 그룹핑 75.3%, 프로덕션 키 33.3%, 탐지 형태 코호트 24.5%의 세 수치를 이름을 붙여 따로 공개합니다. ‘AI SOC가 알림을 몇 % 줄인다’는 마케팅 숫자를 읽을 때 무엇을 확인해야 하는지 보여 주는 좋은 예입니다.
8. 설치와 실행
전체 스택(core)
git clone https://github.com/beenuar/AiSOC && cd AiSOC
make doctor          # 호스트 도구·메모리·디스크·포트 점검
make up              # .env와 비밀값 15개 생성, 관리자 계정 생성(비밀번호는 한 번만 출력)
make smoke           # 이벤트 1건을 ingest→Kafka→탐지→상관→Postgres→API까지 10단계 PASS/FAIL로 추적
make ingest-token    # 푸시용 자격 증명 발급
make bootstrap ARGS=--reset-password   # 관리자 비밀번호를 잃어버렸을 때
처음 실행할 때 약 2GB 모델을 볼륨으로 내려받으며, 이 볼륨은 make clean으로만 지워집니다. 포트가 이미 사용 중이면 설치를 멈추지 않고 빈 포트로 옮긴 뒤, 그 포트를 누가 쓰고 있었는지 알려 줍니다. 대화형 API 문서는 꺼져 있으므로 docs/openapi.yaml을 직접 봐야 합니다.
| 프로필 | 명령 | 서비스 수 | RAM | 구성 |
|---|---|---|---|---|
| core | make up |
16 | ~8GB | 수집→탐지→상관→알림→트리아지→콘솔, LLM 게이트웨이, 로컬 모델, CISA KEV, 커넥터·응답 서비스 |
| full | make up-full |
22 | ~12GB | core + 이벤트 레이크(ClickHouse), 엔티티 그래프(Neo4j), 전문 검색, 보강 |
| demo | make up && make demo |
16 | ~8GB | core + is_synthetic = true로 표시된 합성 데이터 |
데이터 푸시와 MCP 연결
curl -X POST http://localhost:8081/v1/ingest/batch \
  -H 'Content-Type: application/json' -H "Authorization: Bearer $AISOC_INGEST_TOKEN" \
  -d '{"connector_id":"edr-1","connector_type":"crowdstrike","events":[{"severity":"high",
       "title":"Encoded PowerShell from Office","host":"WIN-FIN-01"}]}'

cd services/mcp && pnpm install && pnpm build
node dist/index.js install --host cursor --aisoc-url https://aisoc.example.com --api-key aisoc_pat_xxx@aisoc/mcp는 패키지 준비는 끝났지만 npm에 아직 올라가지 않아서 npx -y @aisoc/mcp는 지금 동작하지 않습니다. 소스를 직접 빌드해야 합니다. 도구별로 필요한 스코프가 나뉘어 있으니(예: aisoc_lake_query는 lake:query, aisoc_preview_action은 actions:execute이지만 dry-run 전용), PAT는 읽기 스코프 위주로 최소 권한만 주는 것이 좋습니다. cases:write는 채팅에서 조사를 시작하게 할 때만 필요합니다.
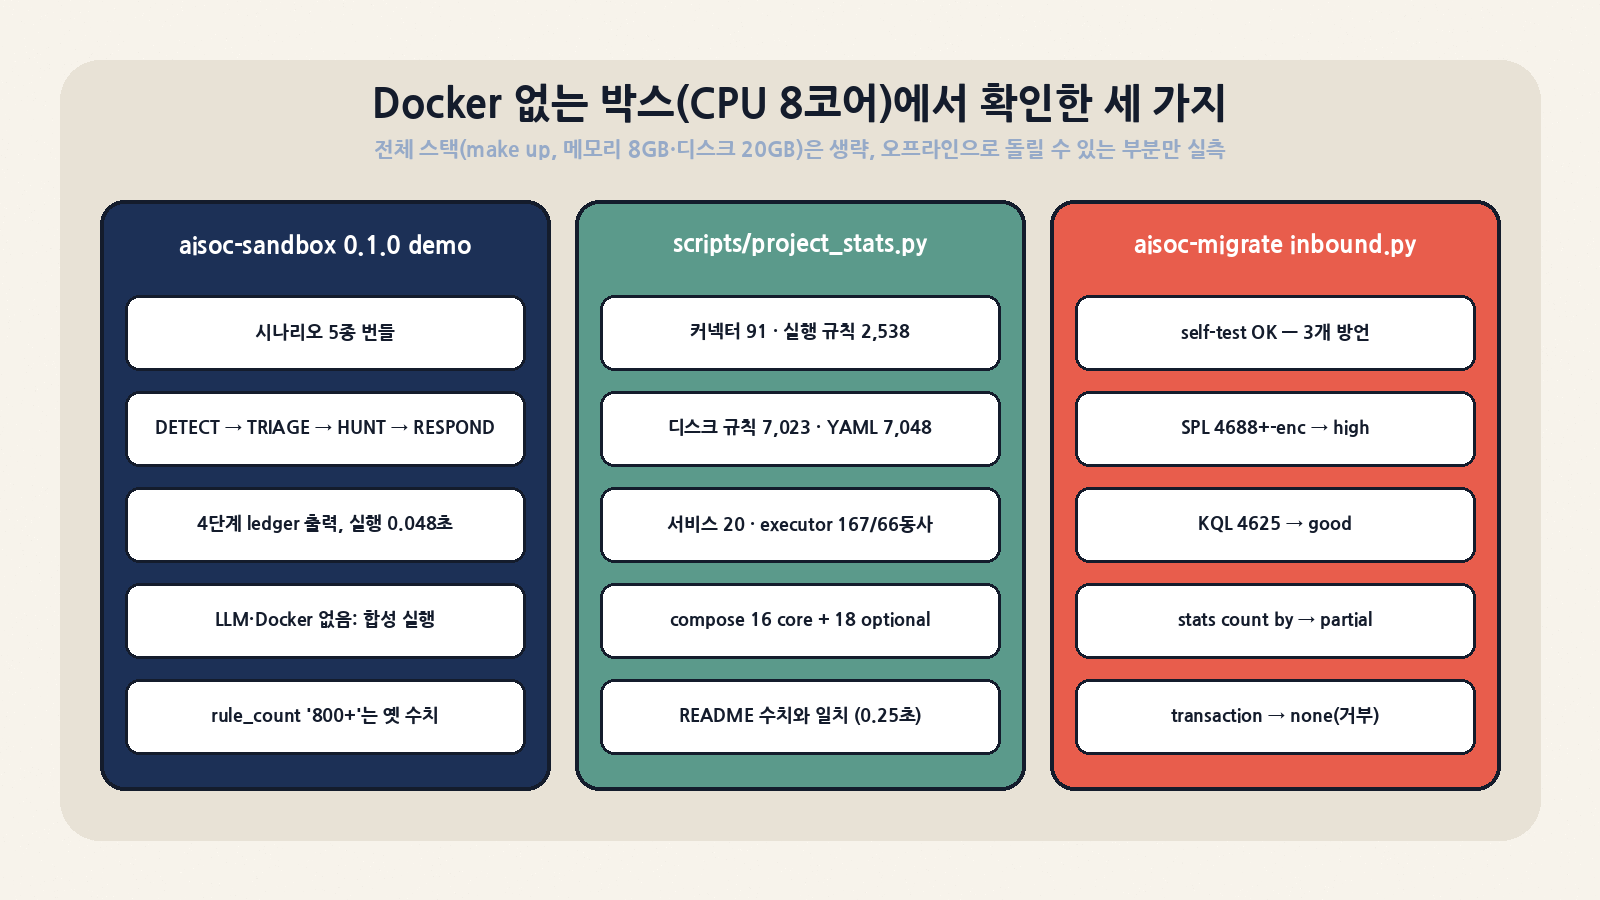
9. 박스 스모크 테스트 (CPU 8코어, Docker 없음)
박스에는 Docker가 없어서 make up 전체 스택은 돌리지 않았습니다. 대신 오프라인으로 실행할 수 있는 세 가지를 2026-11-02 16:5x KST에 HEAD bd3313b(2026-11-02 16:22 KST 커밋) 기준으로 확인했습니다.
| 테스트 | 명령 | 결과 | 해석 |
|---|---|---|---|
| 오프라인 샌드박스 | pip install aisoc-sandbox && aisoc-sandbox demo |
v0.1.0. lateral-movement 시나리오(Okta 불가능한 이동, T1078·T1078.004)가 DETECT→TRIAGE(83/100)→HUNT→RESPOND 4단계 ledger로 출력됨. 전체 실행 0.048초 | “synthetic offline run (no LLM, no Docker)”이라고 표시됨. 미리 짜인 흐름을 보여 주는 데모이고, rule_count: "800+"는 현재 수치(2,538)와 맞지 않는 예전 값 |
| 시나리오 목록 | aisoc-sandbox scenarios |
aws-credential-exfil, github-token-theft, kubernetes-privesc, lateral-movement, phishing-payload 5종. --json 출력 지원 |
교육용이나 데모용으로는 충분하지만 성능을 판단하는 근거가 될 수는 없음 |
| 수치 재집계 | python3 scripts/project_stats.py |
커넥터 91, 실행 규칙 2,538, 디스크 규칙 7,023, YAML 7,048, 서비스 20, executor 167개(66개 동사·38개 벤더), compose 16 core + 18 optional = 34, 클레임-게이트 매트릭스 352행(347개 게이트, 5개 부분 적용) | README 수치와 일치. 0.25초. CHANGELOG Unreleased에 적힌 “151 over 60 verbs across 34 vendors”보다 HEAD가 더 앞서 있음 |
| 탐지 마이그레이션 | python3 packages/aisoc-migrate/inbound.py --self-test |
“self-test OK — 3 dialects” | PyPI에 aisoc-migrate 패키지는 없음(설치 실패). 저장소 안의 스크립트로 실행 |
마이그레이션 번역기는 “근사하느니 거부한다”는 원칙을 실제로 지키는지 쿼리 네 개로 확인해 봤습니다.
| 입력 | confidence | 출력 match_when / 비고 |
|---|---|---|
SPL index=windows EventCode=4688 Image="*\powershell.exe" CommandLine="*-enc*" |
high | EventCode·Image·CommandLine 세 필드를 그대로 옮김. index는 Splunk 라우팅 필드라서 제외한다고 노트에 명시 |
KQL SecurityEvent | where EventID == 4625 and Account == "admin" |
good | EventID·Account 옮김 |
SPL ... | stats count by user | where count > 10 |
partial | “임계값은 옮겨지지 않았으니 윈도 엔진으로 다시 검토하라”는 경고가 붙음. 다만 match_when에 count_gt: 10 키가 남아 있어서, 그대로 활성화하면 오해할 수 있음 |
SPL ... | transaction user maxspan=5m |
none | 규칙을 만들지 않음. “엔진에 세션 개념이 없다”는 거부 사유를 기록 |
10. 공식 콘솔: 트리아지 판정 화면
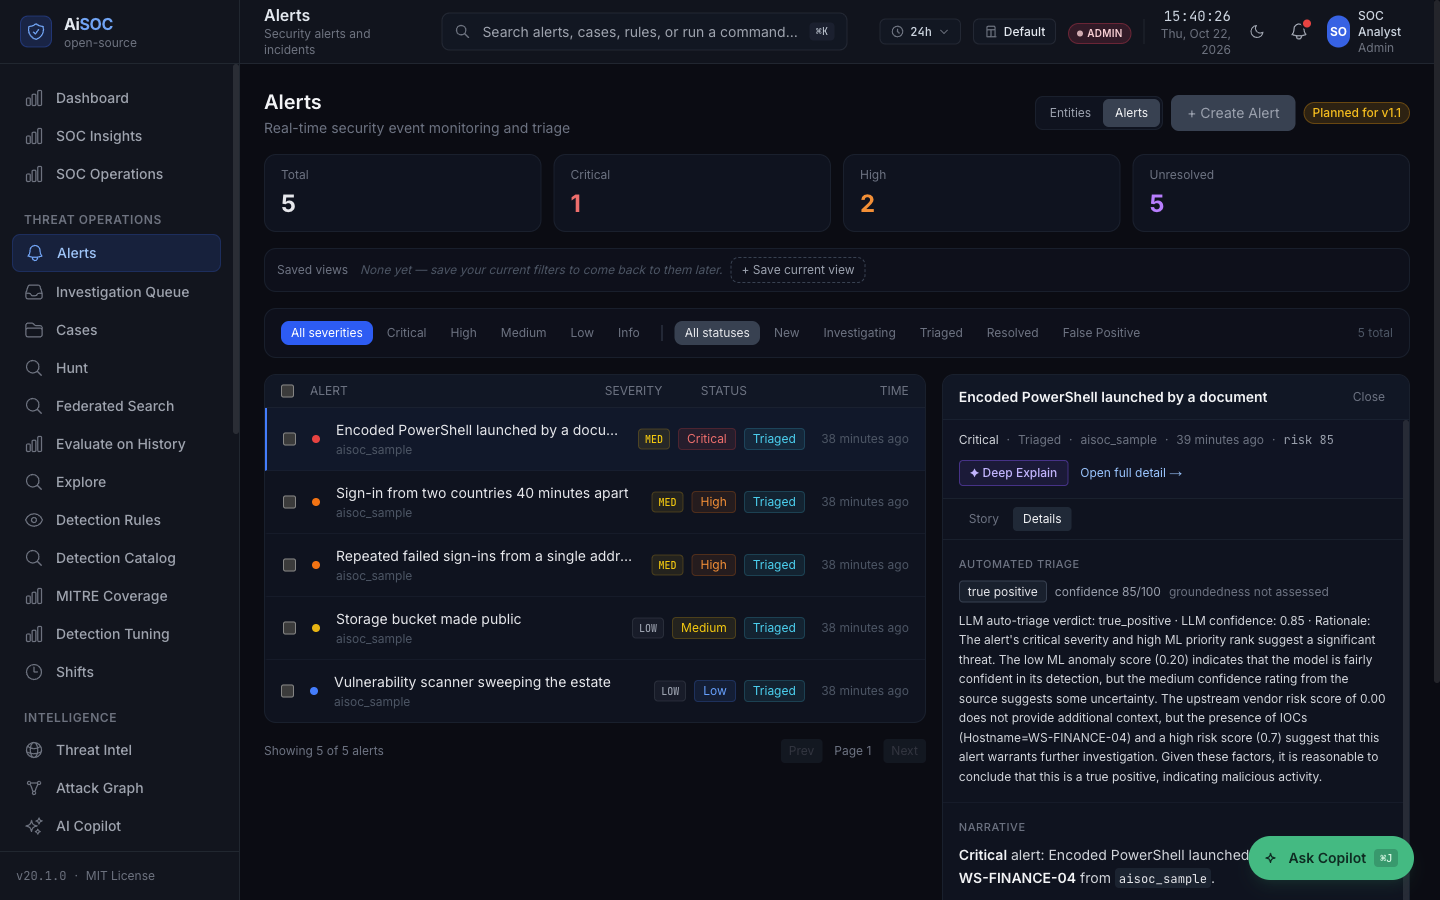
아래는 저장소의 apps/web/public/screenshots/에 있는 공식 화면입니다. README에 따르면 v20.1.0 실행 화면이며, 번들 로컬 모델이 낸 판정·신뢰도·근거를 가공하지 않고 그대로 보여 줍니다.
11. 비슷한 도구와 비교
| 도구 | 중심 역할 | AiSOC와의 관계 |
|---|---|---|
| AiSOC | 수집·탐지·상관·LLM 트리아지·거버넌스 응답을 한 스택에, Ledger로 감사 | — |
| Wazuh | 엔드포인트 에이전트 기반 SIEM/XDR, 규칙·디코더 중심 | AiSOC는 스스로 장기 보존·컴플라이언스 검색을 대체하지 않는다고 밝힘(ADR-0015, 상태 proposed). Wazuh를 상위 수집원으로 두고 AiSOC를 트리아지·조사 층으로 쓰는 구성이 자연스러움 |
| Security Onion | 네트워크 보안 모니터링 + 로그 관리 배포판 | NSM 쪽 데이터 원천. AiSOC에는 Zeek/Suricata 커넥터가 있음 |
| Shuffle / Tines류 SOAR | 워크플로 자동화 | AiSOC 플레이북은 기본값이 프리뷰이고 단계마다 계약을 검사함. 자동화 범위는 더 좁지만 감사성은 높음 |
| TheHive + Cortex | 케이스 관리, 관측값 분석 | AiSOC는 케이스와 Ledger를 함께 제공. 이미 TheHive를 쓰는 팀이라면 겹치는 부분이 큼 |
| Splunk·Sentinel·Elastic의 AI 기능 | 상용 SIEM 위의 코파일럿 | AiSOC는 이들을 커넥터로 받고, aisoc-migrate로 SPL/KQL/EQL 규칙을 가져오며, 반대로 연합 검색용 쿼리를 내보냄 |
12. 트레이드오프와 주의할 점
| 항목 | 내용 | 대응 |
|---|---|---|
| 릴리스 속도 | 닷새 동안 v20.2.0부터 v21.0.0까지 다섯 번 릴리스. 메이저 번호가 평가 의미 재정의 같은 변경에도 올라감 | 태그를 고정해 운영하고, BREAKING 항목(상관 그룹핑)은 스테이징에서 감소율이 어떻게 바뀌는지 먼저 확인 |
| 문서 수치 드리프트 | 아키텍처 문서는 실행 규칙 2,535개(네이티브 765 + Sigma 1,770), README와 재집계는 2,538개. 윈도 규칙도 72+3과 76으로 다르게 적혀 있고, 샌드박스는 “800+”로 표시 | 수치는 project_stats.py로 직접 다시 세서 확인 |
| 저장소 위생 | 11/01 커밋(PR #1590)에서 저장소 루트에 macOS arm64용 .whl 파일 66개(semgrep, cryptography 등)가 함께 커밋됨 |
보안 제품 저장소인 만큼 클론 크기와 공급망 관점에서 거슬리는 부분. 이 파일들을 설치 경로에서 쓰지 않는지 확인 권장 |
| 모델 품질 | 기본 3B 모델은 형식 신뢰성만 측정됨. 호스팅 모델은 미측정 | 자체 종결 데이터로 replay 평가와 run_model_matrix.py --task verdict를 돌린 뒤 모델 선택 |
| 범위 | SIEM을 대체하지 않음. 연결하지 않은 데이터는 볼 수 없음. 기본 설정은 자율 대응이 아님 | 기존 SIEM/EDR 위의 트리아지·조사 층으로 배치 |
| 패키징 | npm 패키지 3종(MCP 포함)은 업로드 전이고, PyPI는 aisoc-sandbox 등 5종만 있음(aisoc-migrate는 없음) |
소스 빌드를 전제로 계획 |
| 기여자 집중 | 최근 50개 커밋 가운데 40개가 메인테이너 한 명(Beenu Arora)의 커밋 | Cyble의 후원과 GOVERNANCE.md를 보고 장기 유지 가능성을 따로 판단 |
13. 정리: 누가 써 볼 만한가
- 써 볼 만한 팀: LLM 트리아지를 도입하고 싶지만 “AI가 왜 이 알림을 종결했나”를 감사할 수 있어야 하는 소규모 SOC나 MSSP. 탐지 엔지니어링 팀이라면 실행 증명 게이트와 마이그레이션 번역기의 ‘거부’ 설계만 따로 참고해도 얻을 것이 있습니다.
- 아직 이른 팀: 수만 EPS 규모에서 장기 보존과 컴플라이언스 검색까지 한 제품으로 해결하려는 조직, 그리고 버전을 고정하고 업그레이드를 검증할 여력이 없는 조직.
- 첫 주 체크리스트:
make doctor로 환경 점검 →make up→make smoke10/10 확인 → 위저드의 Load sample data → 실제 커넥터 하나(예: Okta) 연결 → Ledger에서 판정 근거와 토큰 비용 확인 → 플레이북은 프리뷰 상태로 1주 관찰.
AiSOC에서 가장 눈여겨볼 점은 기능 목록보다 숫자를 세는 방식입니다. 측정하지 않은 값은 0이 아니라 “측정 안 됨”으로 적고, 분모에서 불리한 케이스를 빼지 않으며, 게이트가 정말로 걸러 내는지는 일부러 망가뜨려서 확인합니다. AI SOC 제품을 평가할 때 그대로 가져다 쓸 수 있는 기준입니다.