테크부터 경제, 생활까지. 복잡한 소식을 쉽게 풀어봅니다. 오늘 오전 오픈소스 심화는 실무자용입니다. 2026년 11월 5일 GitHub Trending 전체 부문 1위는 NVIDIA/auto-ontology입니다. 정오 무렵(KST) 기준 스타 약 5,300개에 하루 +2,050개가 붙었습니다. 겉으로는 “자연어로 DB에 질문하는 또 하나의 text-to-SQL”처럼 보입니다. 하지만 저장소가 실제로 파는 건 SQL 생성기가 아니라 그 앞단의 ‘뜻’ 계층입니다. 어느 열이 ‘매출’이고, 어떤 식으로 합산하며, 어떤 경로로 조인해야 하는지를 온톨로지로 컴파일합니다. 사람이 그 정의를 인증(certify)하면, 에이전트는 매 질문마다 그 정의 위에서 SQL을 쓰고 검증합니다.
README가 내세우는 문제의식은 한 줄입니다. “더 빨리 나온 매출 숫자라도 틀렸다면 가치가 없다.” 이 글은 README·docs·skills 폴더와 백엔드 소스(auto_ontology/)를 직접 읽고 정리했습니다. 실측도 함께 싣습니다. NVIDIA API 키도 Postgres도 없는 8코어 CPU 박스에서 저장소를 설치해 테스트 스위트를 돌렸고, LLM 없이도 동작하는 결정론적 검증 모듈들을 SQLite 예제 DB에 직접 붙여 봤습니다.
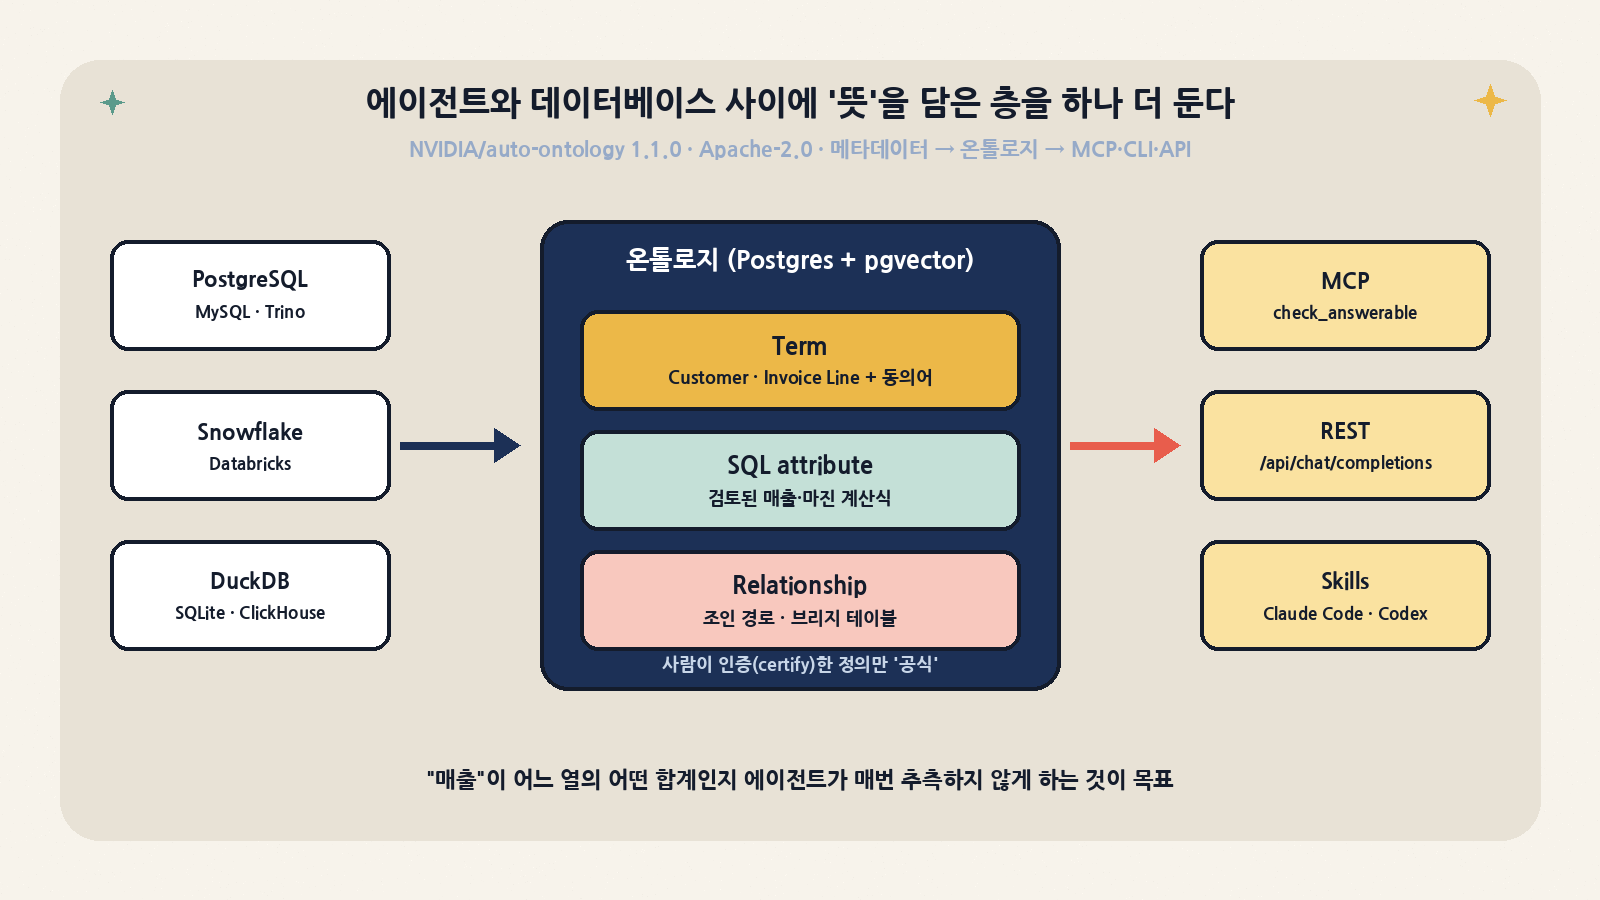
한눈에 보는 Auto Ontology
| 항목 | 내용 |
|---|---|
| 저장소 | NVIDIA/auto-ontology (2026년 4월 28일 KST 생성), 파이썬 패키지 이름 auto-ontology-server |
| 라이선스 | Apache-2.0. 파일마다 SPDX 헤더가 있고, 서드파티 고지는 THIRD_PARTY_NOTICES.md와 컨테이너용 별도 문서로 나뉨 |
| 버전 | pyproject.toml 기준 1.1.0. GitHub Releases·태그는 없음. 확인한 최신 커밋은 2a24f5d(2026-11-05 04:31 KST, Ossie 변환기 설치 경로 변경) |
| 런타임 | Python 3.12 이상 3.14 미만, FastAPI, LangChain·LangGraph, sqlglot, Postgres 17 + pgvector |
| 프런트엔드 | Next.js 16(React 19), Better Auth, Prisma. 웹 UI이자 공개 API 게이트웨이 |
| 연결 엔진 | PostgreSQL, MySQL, Databricks, Snowflake, ClickHouse, Trino, Apache Kyuubi, HeavyDB, DuckDB, SQLite (총 10종) |
| 에이전트 노출 | MCP 서버(읽기 전용 도구), REST /api/chat/completions(SSE), 코딩 에이전트용 스킬 3종 |
| 기여 정책 | 외부 PR은 받지 않음. 이슈(버그·통합 요청)만 받음 |
| 오늘 트렌딩 | 전체 1위·Python 1위, 하루 +2,050 스타 (2026-11-05 KST 확인) |
왜 ‘온톨로지’인가: 스키마만으로는 부족한 이유
스키마만 프롬프트에 넣는 text-to-SQL은 열 이름이 의미를 다 말해 준다고 가정합니다. 현실의 데이터 웨어하우스는 그렇지 않습니다. extendedprice와 unitprice * quantity 중 무엇이 매출인지, 고객의 ‘주(州)’가 청구지 기준인지 배송지 기준인지, 브리지 테이블을 거쳐야 하는 조인이 어디인지는 스키마 어디에도 적혀 있지 않습니다. 모델은 매번 그럴듯하게 추측합니다. 같은 질문에 다른 숫자가 나오는 문제는 대개 여기서 시작됩니다.
Auto Ontology는 이 추측을 한 번에 몰아서 하고 그 결과를 사람이 검토하게 만듭니다. 온톨로지는 세 종류의 정의로 이뤄집니다.
| 정의 | 담는 내용 | 예시 (README의 Wide World Importers) | 에이전트가 얻는 것 |
|---|---|---|---|
| Term | 업무 개념, 설명, 동의어, 매핑된 열 | Customer, Invoice Line, State Province | 질문 속 단어를 실제 열로 해석 |
| SQL attribute | Term 아래 검토된 SQL 식 (마진, 이동 합계 등) | Invoice Line의 revenue = SUM(extendedprice) |
같은 지표를 매번 같은 식으로 계산 |
| Relationship | 테이블 조인 방식, 브리지 테이블. 키와 실제 데이터에서 추론 | invoice line → invoice → customer → city → state province | 조인 경로를 추측하지 않고 따라감 |
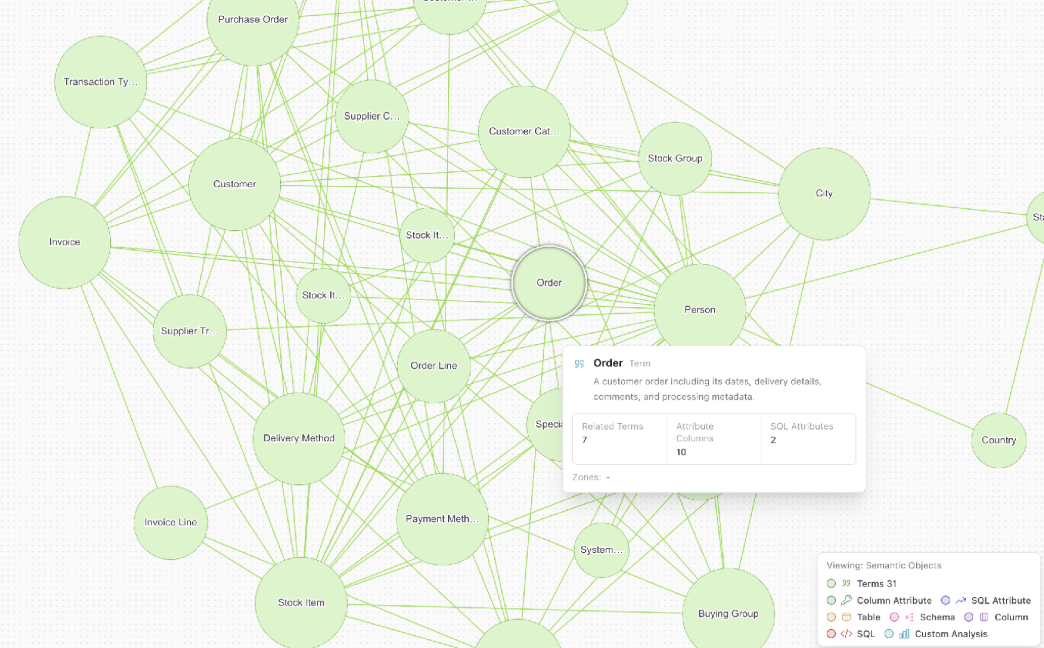
README의 한 컴파일 예시에서 Wide World Importers 한 DB로부터 Term 31개가 나왔습니다. 중요한 건 이 정의들이 Postgres에 일반 테이블로 저장되고, 검색용 임베딩은 같은 Postgres의 pgvector에 들어간다는 점입니다. 별도 그래프 DB도 벡터 DB도 없습니다. 운영 관점에서는 의존성이 하나 줄어드는 대신, Postgres가 카탈로그·온톨로지·앱 데이터·벡터 저장소를 한꺼번에 떠안습니다.
아키텍처: 다섯 개의 프로세스와 하나의 Postgres
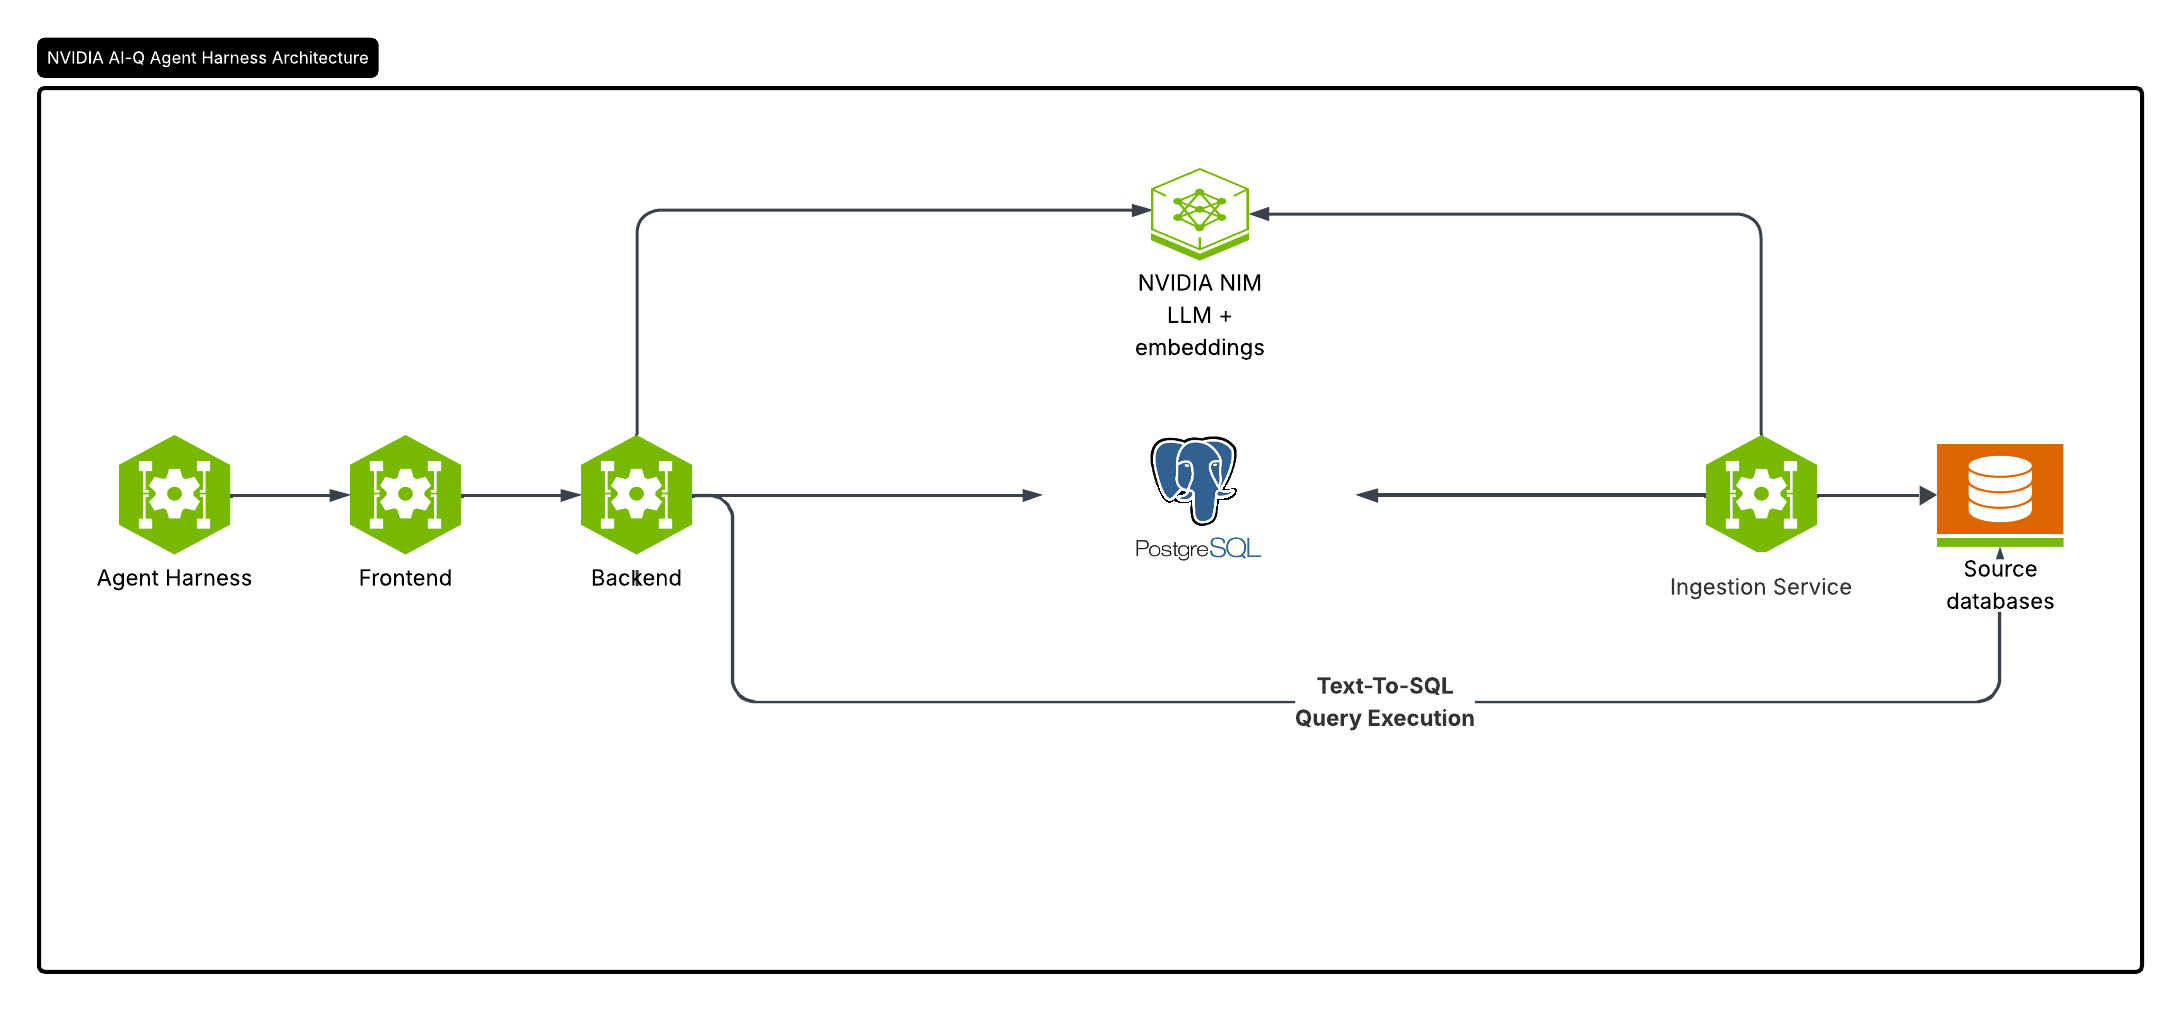
공식 아키텍처 그림 그대로, 에이전트 하네스 → 프런트엔드 → 백엔드로 들어온 질문이 Postgres의 온톨로지를 참조합니다. 그렇게 만들어진 SQL은 원본 DB에서 실행됩니다. 원본 DB를 읽어 온톨로지를 만드는 일은 별도 인제스천 서비스가 맡고, LLM과 임베딩은 양쪽 모두 NVIDIA NIM 엔드포인트를 씁니다.
| 컴포넌트 | 기술 | 역할 | 포트 | 운영 메모 |
|---|---|---|---|---|
| Frontend | Next.js, Better Auth, Prisma | 웹 UI, 인증, 공개 API 게이트웨이 | 3000 | 외부에 노출하는 유일한 진입점이어야 함 |
| Backend | FastAPI, LangChain·LangGraph | text-to-SQL 에이전트, 카탈로그·온톨로지 API | 3001 | x-auto-ontology-user-id 헤더를 그대로 신뢰 |
| Ingestion service | FastAPI | 인제스천, 시맨틱 컴파일 | 3002 | ingest·delete·reset·compile 엔드포인트에 자체 인증 없음 |
| MCP server | FastMCP | 공개 API 위의 읽기 전용 에이전트 도구 | 3003 | 사용자별 OAuth 로그인, 서버 자체 토큰 설정 불가 |
| Postgres + pgvector | PostgreSQL 17 | 카탈로그, 온톨로지, 앱 데이터, 벡터 저장소 | 5432 | Compose 기본값은 호스트에 포트를 연다 |
| HashiCorp Vault | 선택 | 연결 자격 증명 저장 | – | 없으면 연결 문자열은 환경 변수·DB에 |
표의 마지막 열이 이 프로젝트를 도입할 때 가장 먼저 확인할 부분입니다. README는 3001·3002 포트를 사설망에만 두라고 명시합니다. 백엔드는 프런트엔드가 넘겨준 사용자 ID 헤더를 검증 없이 믿고, 인제스천 서비스는 아예 인증이 없습니다. 쿠버네티스에 올릴 때 NetworkPolicy나 서비스 메시로 이 두 서비스를 프런트엔드 파드에서만 닿게 막아 두지 않으면, 같은 네트워크의 누구든 사용자를 사칭하거나 온톨로지를 리셋할 수 있습니다. 문서에 적혀 있는 신뢰 경계라 버그는 아니지만, 기본 Compose 그대로 공용 VM에 띄우면 위험한 구성입니다.
저장소 구조: 백엔드 7만 9천 줄이 어디에 쓰였나
auto_ontology/ 아래 테스트를 뺀 파이썬 파일은 277개, 약 7만 8,800줄입니다. 테스트 코드도 약 4만 3,700줄이고, pytest가 수집하는 테스트는 2,590개입니다. 모듈은 다음처럼 나뉩니다.
| 디렉터리 | 하는 일 | 눈여겨볼 파일 |
|---|---|---|
catalog/ |
스키마 추출, 프로파일링, 쿼리 이력 파싱 | parsers/sqlglot_extractor.py (별칭·CTE를 풀어 테이블·열·조인 쌍 추출) |
connectors/ |
10개 엔진 어댑터, Vault 연동 | base.py의 SQLDatabase 추상 클래스, 엔진별 구현 |
semantic/ |
시맨틱 컴파일(온톨로지 생성) | pipeline.py, term_extractor.py, semantic_fk.py, bridge_tables.py, sql_attribute_suggester.py |
retrieval/text_to_sql/ |
질문 → SQL LangGraph 그래프 | text_to_sql_graph.py, agents/(노드 20여 개), db_probe/(실제 DB 대조 검사) |
retrieval/kumo/ |
예측성 질문을 KumoRFM으로 라우팅 | pql_gen.py, predictor.py |
dal/ |
온톨로지·카탈로그 데이터 접근 계층 | terms.py, model_interchange.py(Ossie 입출력) |
server/, ingestion_service/ |
FastAPI 앱 두 개 | server/chat/router.py |
mcp/, skills/ |
MCP 서버(별도 프로젝트), 에이전트 스킬 3종 | mcp/auto_ontology_mcp/tools.py, 각 스킬의 BENCHMARK.md |
내부 동작 1: 시맨틱 컴파일은 테이블 단위 LLM 패스
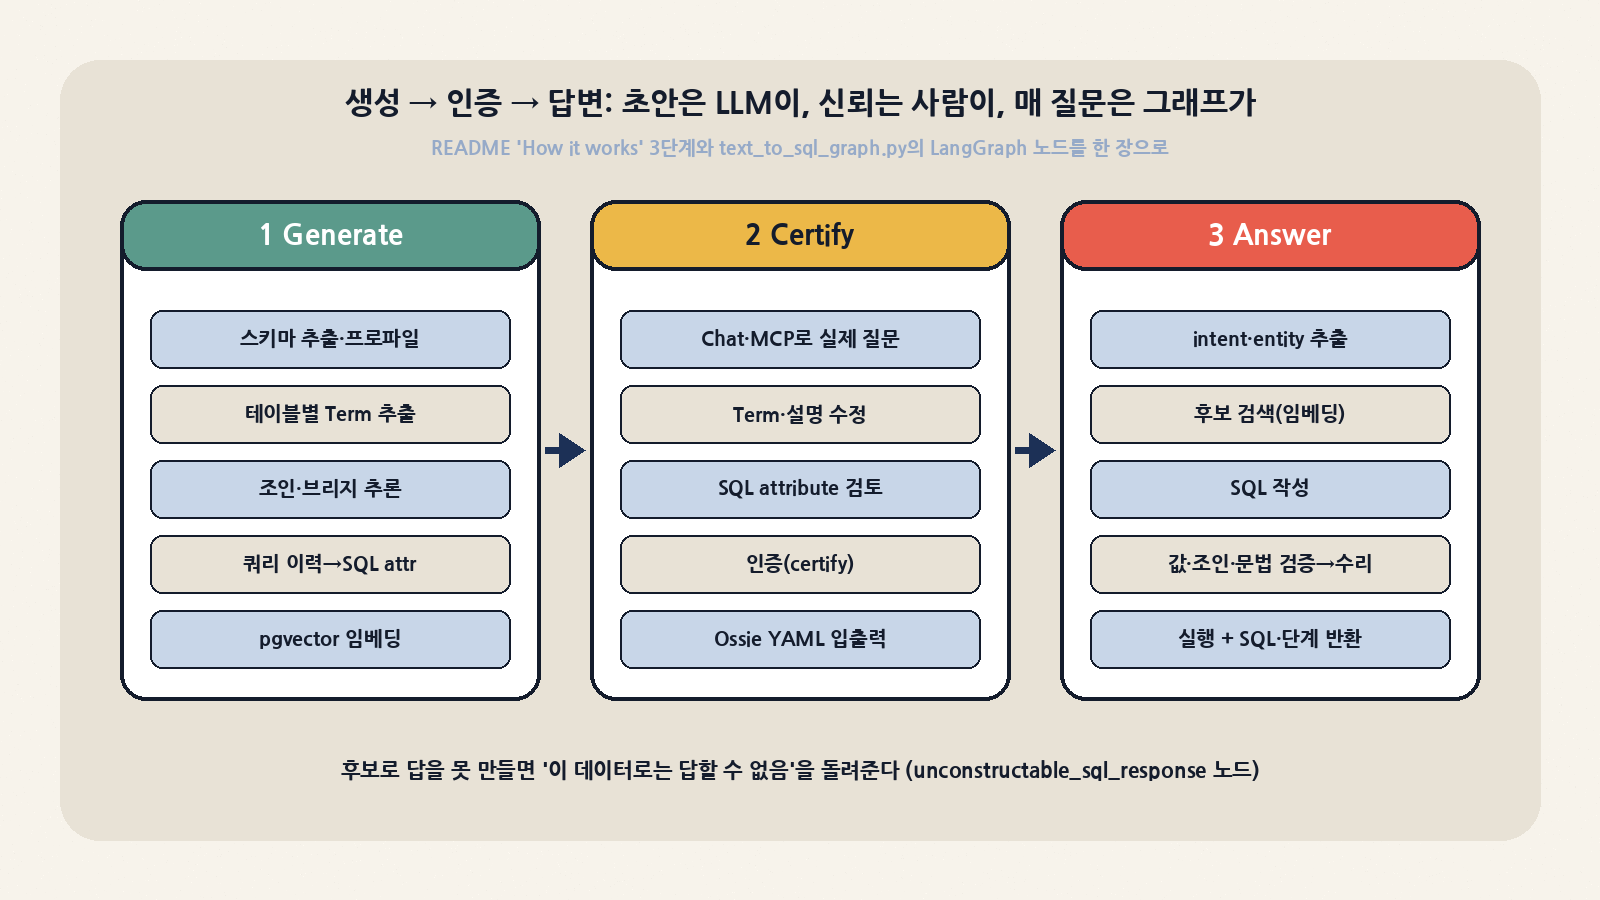
컴파일 진입점 semantic/pipeline.py는 스스로를 “flat table-by-table taxonomy pass”라고 소개합니다. 아직 Term이 없는 테이블을 가져와 워커 3개로 병렬 처리하되, 커밋 순서는 _OrderedCommitQueue로 고정합니다. LLM 추출은 병렬로 돌리고 결과 기록만 순서대로 하는 구조라 재실행할 때 결과가 덜 흔들립니다. 취소하면 대기 중인 테이블이 자기 차례를 기다리지 않고 바로 건너뛰도록 짜여 있어, 큰 웨어하우스에서 컴파일을 멈출 때 워커가 묶이지 않습니다.
열 설명은 semantic/deterministic.py가 15개씩 묶어 구조화 출력으로 요청합니다. 주석을 보면 넓은 테이블을 한 번에 보내면 응답 토큰이 너무 많아져 타임아웃이 났고, 그래서 배치로 쪼갰다고 합니다. 구조화 출력을 지원하는 모델을 쓰라는 README 요구가 여기서 나옵니다.
외래 키 해석(semantic_fk.py)은 3단 폴백입니다.
- 선언된 FK 빠른 경로. DB에 FOREIGN KEY가 있으면 그대로 씁니다. 같은 테이블을 가리키는 자기참조는 “FK가 가리키는 엔티티가 아니다”라며 버립니다.
- 벡터 검색 + LLM 선택. FK가 선언되지 않은 열이면 열 문맥을 임베딩합니다. 자기 테이블을 제외한 후보 열 상위 5개를 pgvector에서 찾고, LLM이 고르게 합니다. 시스템 프롬프트는 “확신이 없으면 null, 추측하지 말 것”을 강제합니다.
- 실데이터 대조. LLM이 기권하면 라이브 DB에서 샘플 값이 겹치는 후보를 직접 찾습니다.
FK를 선언하지 않는 분석용 웨어하우스(Snowflake·Databricks에서 흔합니다)에서는 2·3단계 품질이 곧 조인 품질입니다. 컴파일 비용도 대부분 이 단계에서 나옵니다. 테이블 수가 수천 개라면 컴파일 한 번에 들어가는 LLM 호출 수와 NIM 요금을 미리 계산해 둬야 합니다.
내부 동작 2: 질문 하나가 지나가는 LangGraph
text_to_sql_graph.py는 노드 20개 안팎의 상태 그래프입니다. 순서는 이렇습니다. question_intent → question_extraction → retrieve_candidates를 지나면 분기합니다. 정보성 질문은 information_agent로, 예측 질문은(Kumo 설정 시) kumo_predict로, 나머지는 prepare_candidates → refine_evidence → construct_sql_from_candidates로 갑니다. 그다음 validate_sql_values → validate_sql_query → execute_sql_query → check_empty_like_result → format_and_respond로 끝납니다. 검증에 실패하면 reconstruct_sql로 돌아가고, 재구성이 7번 실패하면(MAX_RECONSTRUCTION_ATTEMPTS = 7) unconstructable_sql_response로 빠져 “이 데이터로는 답할 수 없다”고 응답합니다.
설계에서 눈에 띄는 점은 검증 노드 상당수가 LLM이 아니라는 것입니다. db_probe/ 아래 모듈들은 생성된 SQL을 sqlglot으로 파싱한 뒤 실제 DB에 작은 읽기 전용 쿼리를 날려 사실관계를 확인합니다.
literal_check.py:WHERE의 문자열 리터럴이 실제 값에 있는지 확인합니다. 철자나 대소문자만 다른 근접 값이 있으면 제안합니다. 같은 값이 대소문자만 달리 여러 개 저장돼 있으면('Gold','GOLD','gold') 정확히 일치하는 필터는 과소 집계를 한다고 경고합니다. 대소문자를 구분하는LIKE도 같은 방식으로 검사합니다.- 정수 나눗셈 검사: Postgres에서
SUM(x)/COUNT(y)가 소수점을 잃는 문제를 AST에서 찾아 분자를CAST로 감쌉니다. MySQL·Snowflake·BigQuery는/가 원래 소수 나눗셈이라 오탐을 피하려고 Postgres에서만 켭니다. join_path_check.py: 조인 등식의 양쪽 열 값이 실제로 겹치는지, 온톨로지에 검증된 경로가 있는지 확인하고 빠진 브리지 테이블을 보완합니다.executor.py: 모든 프로브는 단일SELECT/WITH만 허용합니다. 기본 상한은 호출 40회, 50행, 테이블 8개, 테이블당 열 8개입니다(DB_PROBE_*환경 변수로 조정).
LLM이 SQL을 쓰고 결정론적 코드가 그 SQL을 데이터와 대조해 고치는 분업입니다. 프롬프트로 “Postgres 정수 나눗셈 주의”를 이미 지시했는데도 같은 규칙을 코드로 한 번 더 강제한다고 주석에 적혀 있습니다. 모델이 지시를 어기는 경우를 전제로 한 설계입니다.
모델 구성: 네 개의 역할, 세 개짜리 환경 변수 묶음
| 역할 접두사 | 기본 모델 (.env.example) | 하는 일 |
|---|---|---|
REASONING |
nvidia/nemotron-3.5-lightning-30b-a3b | 온톨로지 생성(Term·관계·SQL attribute), 답변 SQL·설명 작성, 답변 가능성 채점 |
NON_REASONING |
nvidia/nemotron-3.5-lightning-30b-a3b | 의도 분류, 엔티티 추출, 후보 선택, SQL 검사·수리 등 빠른 단계 |
EMBED |
nvidia/nemotron-3.5-embed-1b | 테이블·열·Term·SQL attribute를 pgvector에 색인하고 질문과 매칭 |
RERANK |
nvidia/nemotron-3.5-rerank-8b | 브리지 테이블용 SQL attribute를 만들 때 후보 테이블 순위 매김 |
DEFAULT_MODELS |
위 필드가 비면 여기로 폴백 | _ENDPOINT·_API_KEY·_MODEL 세 개 묶음. 레거시 NVIDIA_API_KEY도 폴백으로 인정 |
기본값은 NVIDIA API 카탈로그(integrate.api.nvidia.com)지만, 역할마다 OpenAI 호환 엔드포인트를 넣을 수 있습니다. 자체 호스팅 NIM이나 vLLM 서버로 바꾸는 것도 설정만으로 됩니다. 이때 지켜야 할 조건이 둘 있습니다. 구조화 출력을 지원하는 모델을 써야 하고, 인제스천과 질의에 같은 임베딩 모델을 써야 합니다. 임베딩 모델을 바꾸면 pgvector 색인 전체를 다시 만들어야 합니다.
문서를 꼼꼼히 보면 작은 불일치도 있습니다. README 상단 ‘Software Components’ 아래 NIM 기본값에는 임베딩이 nemotron-3-embed-1b, 리랭커가 llama-nemotron-rerank-vl-1b-v2로 적혀 있습니다. 같은 README 아래쪽 Models 표와 .env.example은 3.5 계열입니다. 11월 3~4일 커밋에서 Nemotron 3.5 기본값으로 옮기며 위쪽 문단이 따라오지 못한 것으로 보입니다. 실제로 쓰이는 값은 .env.example을 기준으로 보는 게 안전합니다.
에이전트에 붙이기: MCP 도구와 REST
| 용도 | MCP 도구 | 언제 쓰나 |
|---|---|---|
| 준비 상태 | check_readiness |
이 배포가 답을 낼 수 있는 상태인지 (컴파일 완료 등) |
| Term 탐색 | search_terms, get_term, get_term_columns, get_term_sql_attributes, get_sql_attribute, describe_table |
에이전트가 스스로 정의를 읽고 SQL 계획을 세울 때 |
| 답변 가능성 | check_answerable |
온톨로지가 질문을 덮는지 먼저 확인. README 예시에서 “광고비 대비 수익”은 coverage 0.5에 “ad spend” Term이 없어 되묻기로 전환 |
| 질문 | ask_question |
답, SQL, 결과 행을 한 번에 |
MCP 서버는 모두 읽기 전용이고, 호출마다 로그인한 사용자 권한으로 실행됩니다. 서버 자체에 토큰을 설정하는 방법은 일부러 없앴습니다. 서비스 계정 하나로 모든 사용자를 대신하면 RBAC가 무의미해지기 때문입니다. 토큰은 불투명 토큰이고 매 호출마다 Auto Ontology의 OAuth UserInfo로 확인합니다. 그래서 역할 변경이나 계정 정지가 즉시 반영됩니다. 실행은 이렇게 합니다.
AUTO_ONTOLOGY_API_URL=http://localhost:3000 \
  uvx --from "git+https://github.com/NVIDIA/auto-ontology.git#subdirectory=mcp" auto-ontology-mcp

# 클라이언트 쪽 (예: ~/.cursor/mcp.json)
{ "mcpServers": { "auto-ontology": { "url": "http://localhost:3003/mcp" } } }
REST는 웹 앱 오리진의 POST /api/chat/completions에 사용자 메뉴에서 발급한 API 토큰을 x-api-key로 붙입니다. 응답은 SSE 스트림이고, result 이벤트에 answer.response와 answer.sql_code가 실리며 data: [DONE]으로 끝납니다. README 예제의 타임아웃이 900초라는 점도 참고할 만합니다. 검증·재구성 루프를 다 돌면 질문 하나에 몇 분이 걸릴 수 있다는 뜻입니다.
설치와 실행: 공식 Quickstart의 요점
git clone https://github.com/NVIDIA/auto-ontology.git && cd auto-ontology
cp .env.example .env
# .env: DEFAULT_MODELS_API_KEY=nvapi-..., AUTH_SECRET, POSTGRES_PASSWORD,
#       CONNECTION_STRINGS=postgresql://postgres:...@postgres:5432/wideworldimporters 등

docker compose up -d --wait postgres
git clone https://github.com/NVIDIA/auto-ontology-eval.git ../auto-ontology-eval
(cd ../auto-ontology-eval && uv sync && cp .env.example .env && \
  POSTGRES_PASSWORD='...' uv run python scripts/seed/seed_wwi.py --database-name wideworldimporters --drop)

docker compose up -d --build
# http://localhost:3000 → Settings → Semantic Compilation 켜기 → "ready" 후 Chat
Compose는 Postgres·pgAdmin·웹 앱 포트를 호스트에 엽니다. .env.example의 기본 비밀번호는 전부 바꿔야 합니다. 쿠버네티스는 helm/ 차트와 DEPLOYMENT.md를 따릅니다. 원본 DB 연결은 UI의 Settings → Connections나 CONNECTION_STRINGS로 하며, DuckDB·SQLite는 연결 문자열로만 붙습니다.
박스 실측: 키 없이 어디까지 돌아가나
이 글을 쓴 박스는 GPU·Docker·NVIDIA API 키가 없는 8코어 리눅스 머신입니다(2026-11-05 KST, 커밋 2a24f5d, Python 3.12). 그래서 온톨로지 컴파일과 LLM 질의는 재현하지 않았습니다. Postgres와 pgvector도 시스템 패키지 저장소 오류로 설치하지 못했습니다. 대신 두 가지를 측정했습니다.
1) 설치와 테스트 스위트
| 항목 | 측정값 | 해석 |
|---|---|---|
uv sync --python 3.12 |
8.3초 (uv 캐시가 있는 상태), 가상환경 711MB | Snowflake·Databricks·Trino·HeavyDB 커넥터가 기본 의존성이라 무겁다 |
| 수집된 테스트 | 2,590개 (수집 8.7초) | – |
| 전체 실행 | 1,780 통과 · 792 건너뜀 · 18 실패 · 1 에러, 49.8초 | 건너뜀은 대부분 “POSTGRES_* not set”(638건 등) |
| 18 실패 | retrieval/kumo/tests/test_wiring.py 전부 |
선택 extra [kumo]를 설치하지 않아 생긴 ModuleNotFoundError: kumo_relational_client. 코드 결함이 아니라 테스트가 선택 의존성을 가정함 |
| 1 에러 | vdb/tests/test_records.py 셋업 |
KeyError: 'POSTGRES_USER'. 다른 테스트처럼 skip 처리되지 않은 경우 |
Postgres 없이도 2/3 이상의 테스트가 돈다는 건, 검증·파싱 로직 상당수가 DB와 LLM 없이 단위 테스트되도록 분리돼 있다는 뜻입니다. 반대로 온톨로지 DAL과 벡터 검색은 Postgres가 있어야 검증됩니다.
2) LLM 없이 결정론적 가드레일 직접 호출
SQLite로 4테이블 예제 DB를 만들었습니다. 주 4개, 고객 200명, 송장 2,000건, 송장 라인 1만 건이고, 고객 등급 열에는 일부러 Gold/GOLD/gold를 섞었습니다. 여기에 ‘에이전트가 썼을 법한’ 틀린 SQL을 넣어 저장소의 SQLiteDatabase 커넥터와 ProbeExecutor, find_literal_mismatches, extract_tables_and_columns, 정수 나눗셈 검사·수정 함수를 그대로 호출했습니다.
SELECT SUM(il.amount) AS revenue FROM invoice_lines il
JOIN invoices i ON il.invoice_id=i.invoice_id
JOIN customers c ON i.customer_id=c.customer_id
JOIN states s ON c.state_id=s.state_id
WHERE s.state_name='pennsylvania' AND c.tier='Gold'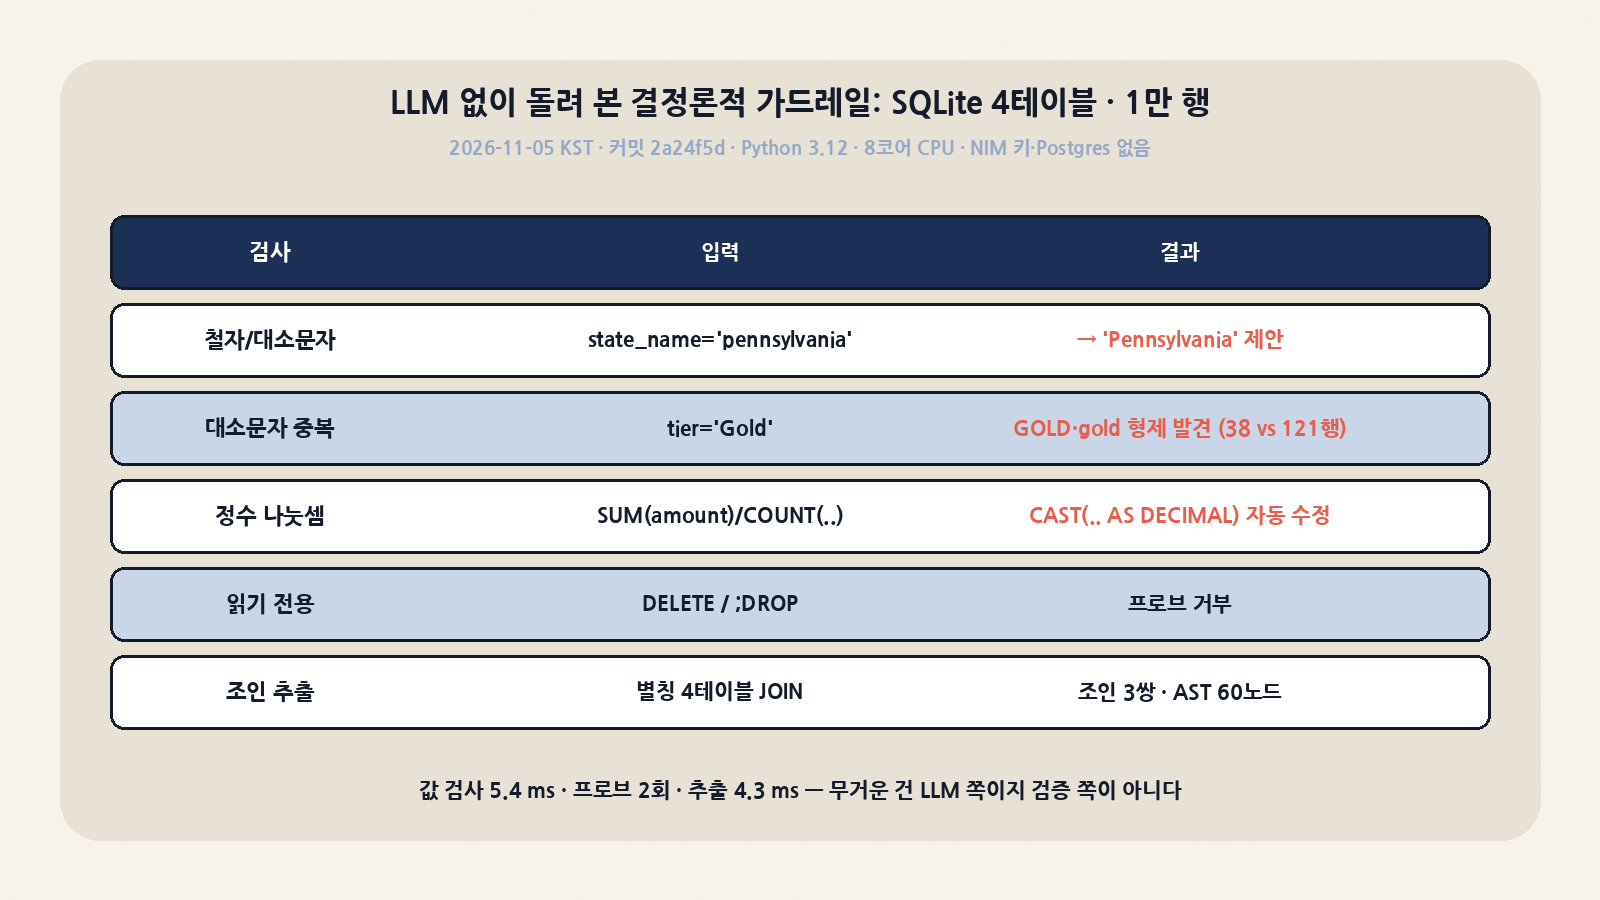
| 검사 | 입력 | 실측 결과 |
|---|---|---|
| 조인·열 추출 (sqlglot) | 위 쿼리, 별칭 4개 | 4.28ms, sqlite 방언, AST 60노드. 조인 3쌍을 실제 테이블 이름으로 복원(invoice_lines.invoice_id = invoices.invoice_id 등) |
| 리터럴 철자 | state_name='pennsylvania' |
kind: string, 제안 'Pennsylvania', 실제 값 4개 첨부 |
| 대소문자 중복 | tier='Gold' |
kind: case_duplicate, 형제 값 GOLD·Gold·gold. 정확 일치 38행 대 대소문자 무시 121행이라, 그대로 두면 고객 수를 3분의 1만 센다 |
| 값 검사 비용 | 위 두 리터럴 | DISTINCT 프로브 2회, 합계 5.44ms |
| 정수 나눗셈 (postgres 방언) | SUM(il.amount) / COUNT(il.line_id) |
검출 후 CAST(SUM(il.amount) AS DECIMAL) / ...로 자동 수정, 남은 항목 0. 같은 데이터에서 정수 결과 248 대 실제 평균 248.783 |
| 읽기 전용 강제 | DELETE FROM states, SELECT 1; DROP TABLE states |
둘 다 거부(“rejected: not a single read-only SELECT”). WITH ... SELECT는 허용 |
정직하게 짚을 한계가 있습니다. 정수 나눗셈 검사에 넣은 열 타입 정보(known_types)는 실제 파이프라인에서는 카탈로그가 공급하는데, 이번에는 제가 손으로 넣었습니다. 또 이 측정은 ‘검증 모듈이 설계대로 작동하는가’를 본 것이지, 전체 에이전트의 text-to-SQL 정확도를 잰 것이 아닙니다. 그래도 알 수 있는 사실이 하나 있습니다. 검증 단계는 밀리초 단위라 지연의 대부분은 LLM 호출과 재구성 루프에서 나옵니다. 그리고 과소 집계 같은 ‘그럴듯하지만 틀린 숫자’를 잡는 일을 모델 지능에 기대지 않고 코드로 한다는 점은 실측으로 확인했습니다.
정확도는 어떻게 주장하나: 벤치마크의 실체
README는 정확도 숫자를 직접 내세우지 않습니다. 대신 별도 저장소 NVIDIA/ontology-sql-eval을 가리킵니다. 이 평가 하네스의 설계는 꽤 정직합니다. 같은 모델에 같은 질문을 두 번 묻되, 대조군(schema_only_sql)은 스키마 덤프만, 실험군(auto_ontology_sql)은 온톨로지 에이전트를 씁니다. 두 SQL과 정답 SQL을 같은 DB에서 실행해 결과를 비교하고, LLM 심판 없이 BIRD 실행 정확도(BEAVER는 ex_acc) 규칙으로 채점합니다. 결과는 정확도 차이 하나와, 온톨로지가 고친 질문·망친 질문 목록입니다. 데이터셋은 BIRD(Dev 1,534문항, Mini-Dev 500문항), BEAVER dw 100문항, FDABench-Lite 169문항, Wide World Importers 41문항, 멀티턴 BIRD-Interact입니다.
즉 “우리 데이터에서 온톨로지가 몇 점을 더해 주는가”를 직접 재 보라는 구조입니다. 도입을 검토한다면 공개 벤치마크보다 사내 질문 40~100개로 이 A/B를 돌려 보는 것이 의미 있습니다. 참고로 스킬 폴더의 BENCHMARK.md에는 에이전트 스킬 평가가 있습니다. 2026-10-08 평가에서 nvidia-ontology-query 스킬은 Claude Code 기준 정답성 47.7%→100%, Codex 기준 50.8%→70.8%였습니다. 다만 13개 과제를 1회씩 돌린 결과이고, 온톨로지 자체의 text-to-SQL 정확도가 아니라 ‘스킬을 읽은 코딩 에이전트가 이 시스템을 제대로 다루는가’를 잰 수치입니다. 둘을 혼동하면 안 됩니다.
비슷한 도구와 비교
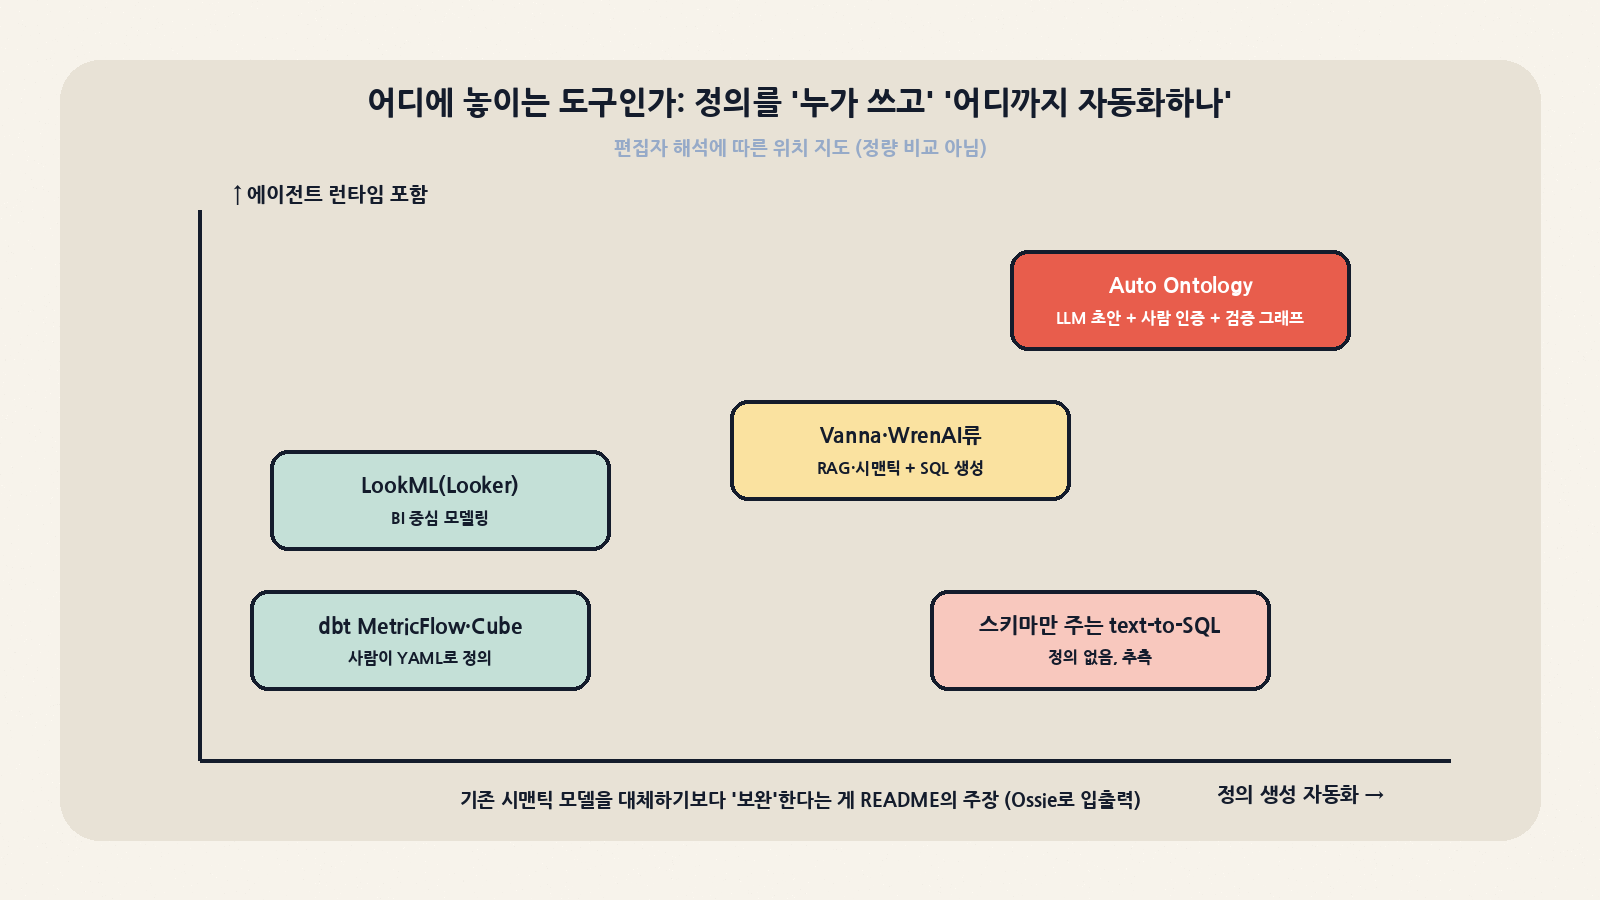
| 접근 | 정의는 누가 만드나 | 에이전트 런타임 | 답변 검증 | Auto Ontology와의 관계 |
|---|---|---|---|---|
| 스키마만 주는 text-to-SQL | 없음 (모델이 추측) | 단발 프롬프트 | 대개 실행 오류만 | ontology-sql-eval의 대조군 자체 |
| dbt MetricFlow / Cube 등 시맨틱 레이어 | 사람이 YAML·코드로 정의 | 없음 (API·BI가 소비) | 정의가 곧 계산식이라 결정론적 | README는 “이미 가진 시맨틱 모델을 보완”한다고 주장. Apache Ossie로 모델 입출력 |
| LookML (Looker) | 사람이 모델링 | BI 중심 | 탐색 범위 안에서 결정론적 | BI 밖의 에이전트가 쓰기 어려운 부분을 MCP로 메움 |
| Vanna·WrenAI류 오픈소스 | 학습 예제·시맨틱 모델 + RAG | SQL 생성 중심 | 도구별로 다양 | LLM 초안 → 사람 인증 → DB 대조 검증까지 한 제품에 묶은 점이 차별점 |
| NVIDIA Auto Ontology | LLM이 메타데이터·쿼리 이력으로 초안, 사람이 인증 | LangGraph 20여 노드 + MCP·REST·스킬 | 값·조인·나눗셈·빈 결과 검사, 최대 7회 재구성 | – |
비교표의 핵심은 ‘정의 생성의 자동화’와 ‘정의의 신뢰성’ 사이의 긴장입니다. dbt·Cube는 사람이 정의를 쓰니 믿을 수 있지만 대신 비쌉니다. Auto Ontology는 그 초안을 LLM에게 맡기고, 신뢰는 인증 워크플로와 실데이터 검증으로 되찾으려 합니다. 이미 잘 관리된 dbt 시맨틱 모델이 있다면 Ossie로 가져와 인증된 정의로 쓰는 방식이 가장 현실적인 경로입니다.
도입 전 체크리스트와 한계
| 주제 | 확인할 것 | 근거 |
|---|---|---|
| 네트워크 경계 | 3001·3002를 사설망에만, 클라이언트는 3000으로만 | 백엔드는 사용자 ID 헤더를 신뢰, 인제스천은 무인증 |
| 데이터 반출 | NIM 호스팅 사용 시 스키마·샘플 값·질문이 외부 엔드포인트로 감 | 컴파일 단계에서 열 샘플 값을 프롬프트에 사용 |
| KumoRFM | KUMO_RFM_API_KEY를 켜면 연결된 테이블을 외부 서비스에 업로드 (기본 최대 20테이블, 행 수는 기본 무제한) |
README Predictions 절. 켜기 전 사내 데이터 검토 필요 |
| PII | pii_detection/ 모듈과 인제스천의 PII 처리 범위 확인 |
샘플 값이 프롬프트·임베딩에 들어가기 때문 |
| 버전 고정 | 릴리스 태그가 없으니 커밋 해시로 고정 | 평가 하네스도 Git 리비전으로 고정해 설치 |
| 의존성 무게 | 모든 커넥터가 기본 의존성, 가상환경 약 711MB | 박스 실측 |
| 모델 교체 | 구조화 출력 지원 여부, 임베딩 모델 변경 시 재색인 | README Models 절 |
| 거버넌스 | 외부 PR 불가, 이슈만 가능. 포크해서 고칠 계획이면 업스트림 추적 비용을 감안 | README·CONTRIBUTING.md |
| 비용 | 컴파일 LLM 호출 수는 테이블·열 수에 비례, 질문당 최대 7회 재구성 | pipeline.py, text_to_sql_graph.py |
정리: 이 저장소가 트렌딩 1위에 오른 이유
오늘 Auto Ontology가 주목받는 건 text-to-SQL을 “더 똑똑한 모델” 문제가 아니라 데이터 정의의 공급망 문제로 다시 짰기 때문입니다. 초안은 LLM이 메타데이터와 쿼리 이력으로 만들고, 사람이 인증해 공식 정의로 승격하고, 매 질문은 그 정의 위에서 결정론적 검증을 거칩니다. 답을 만들 수 없으면 만들 수 없다고 말합니다. 직접 돌려 보니 ‘그럴듯하지만 틀린 숫자’를 잡는 장치들은 LLM 없이도 밀리초 단위로 확실히 작동했습니다.
반대로 정확도 향상 폭은 아직 각자 데이터로 재 봐야 하는 숫자입니다. 기본 구성은 NVIDIA NIM 생태계에 기울어 있고, 내부 서비스 간 신뢰 경계는 배포하는 쪽이 직접 막아야 합니다. 분석 에이전트를 사내 웨어하우스에 붙이려는 팀이라면 시도해 볼 만합니다. Wide World Importers로 Quickstart를 한 번 돌린 뒤, ontology-sql-eval로 사내 질문 수십 개를 A/B 해 보면 도입 여부를 판단할 근거가 생깁니다.