우리가 쓰는 컴퓨터와 스마트폰 안에는 모든 계산을 맡는 ‘두뇌’ 칩, CPU가 들어 있습니다. CPU 하나를 새로 설계하려면 보통 수백 명의 엔지니어가 몇 년씩 매달려야 해요. 그런데 이번 주, 미국의 칩 설계 스타트업 아키텍트 랩스(Architect Labs)가 “AI가 새 CPU 구조를 찾아내고, 설계하고, 검증까지 처음부터 끝까지 해냈다”며 ‘프로스트바이트(Frostbite)’라는 CPU를 공개했습니다.
회사가 내세운 숫자는 꽤 큽니다. 비슷한 크기의 기존 CPU 코어와 비교해 전력당 성능(같은 전기로 해내는 일의 양) 4.59배, 면적당 성능 평균 8.77배라고 해요. 이 소식은 해외 개발자 커뮤니티 해커뉴스에서 550점이 넘는 추천과 300개 가까운 댓글을 받으며 화제가 됐고, 댓글 창에서는 “놀랍다”와 “과장 아니냐”가 팽팽하게 맞섰습니다.
오늘은 칩을 처음 접하는 분도 따라올 수 있도록, CPU가 어떤 단계를 거쳐 만들어지는지부터 시작해 AI가 그중 무엇을 맡았는지, 4.59배라는 숫자를 어떻게 읽어야 하는지, 그리고 아직 실제로 공장에서 찍어 낸 칩은 없다는 점까지 차근차근 풀어 보겠습니다.
1. 한눈에 보는 오늘 이야기
| 질문 | 짧은 답 |
|---|---|
| 무슨 일인가요? | 칩 설계 스타트업 아키텍트 랩스가 AI 에이전트 무리가 설계한 새 CPU ‘프로스트바이트’를 블로그로 공개했습니다(미국 시간 2026년 11월 18일). |
| 뭐가 새롭나요? | 명령어 집합(ISA)부터 새로 만든 범용 CPU예요. 1990년에 나온 계산 이론 ‘상호작용 네트(interaction nets)’를 하드웨어로 옮겼습니다. |
| AI는 뭘 했나요? | 컴파일러, 명령어 집합, 구조, 회로 설계(RTL), 검증, 최종 도면(GDS)까지 반복 개선을 스스로 돌렸다고 회사가 밝혔습니다. |
| 성능은요? | 25개 작업 평균(기하평균) 전력당 성능 4.59배. 단, 처음 보는 작업 15개만 따로 보면 3.83배입니다. |
| 비교 대상은요? | 실제로 만들어진 적 있는 ‘2개씩 순서대로 처리하는(in-order, 듀얼 이슈)’ CPU 코어 1개. 법적 이유로 제품명은 밝히지 않았어요. |
| 실제 칩이 있나요? | 아직 없습니다. 7나노 공정 기준 설계 도면과 시뮬레이션 수치까지예요. 회사도 “실리콘 이전(pre-silicon) 전력 수치”라고 적었습니다. |
| 다음 계획은? | 누구나 써 볼 수 있는 FPGA 놀이터, 간단한 운영체제, 더 큰 벤치마크, 그리고 RTL과 명령어 집합 공개를 예고했습니다. |
2. 먼저, CPU는 어떻게 만들어질까요?
CPU 설계는 건물 짓기와 많이 닮았습니다. “어떤 건물을 지을까”를 정하고, 설계도를 그리고, 구조 계산으로 검증하고, 마지막에 시공사에 넘길 최종 도면을 만들죠. 이번 글에 나오는 낯선 단어들을 건물에 빗대 정리해 볼게요.
| 칩 설계 용어 | 건물에 빗대면 | 뜻 |
|---|---|---|
| 워크로드(작업) | “이 건물에서 뭘 할 건가” (학교? 병원?) | 칩이 잘 돌려야 하는 프로그램 종류 |
| 명령어 집합(ISA) | 건물과 사람 사이의 약속 (문 여는 법, 엘리베이터 버튼) | 소프트웨어가 CPU에게 내릴 수 있는 명령의 목록. x86, ARM, RISC-V가 대표적 |
| 아키텍처·마이크로아키텍처 | 층 구성, 방 배치 | 명령을 실제로 처리하는 내부 구조 |
| RTL | 상세 설계도 | 회로가 어떻게 움직일지 코드로 적은 설계 (Verilog 같은 언어) |
| 검증(verification) | 구조 안전 진단 | 설계가 약속대로 정확히 동작하는지 확인하는 과정 |
| GDS | 시공사에 넘기는 최종 도면 | 공장(파운드리)에 보내는 칩의 최종 배치 파일 |
| 테이프아웃·실리콘 | 실제 준공 | 공장에서 진짜 칩을 찍어 내는 단계. 프로스트바이트는 아직 여기 전 |
보통 이 단계마다 다른 팀이 붙고, 사람 설계자가 영어로 쓴 두꺼운 PDF 문서를 넘겨 가며 일합니다. 아키텍트 랩스는 이 모든 단계를 AI 에이전트 무리(스웜)가 한꺼번에 오가며 고치게 했다는 점을 가장 크게 내세웠어요.
3. 프로스트바이트의 아이디어: ‘서로 겹치지 않는 일’만 골라 동시에
요즘 CPU의 큰 고민 중 하나는 “어떤 명령이 어떤 명령을 기다려야 하는지”를 칩이 실행 중에 일일이 알아내야 한다는 점입니다. 우리가 쓰는 대부분의 프로그래밍 언어는 아무 코드나 아무 변수를 읽고 쓸 수 있어서, CPU는 최악을 가정하고 복잡한 장치로 순서를 다시 찾아내요. 코어가 여러 개면 “모든 코어가 같은 메모리를 보고 있다”는 착각을 유지하려고 큰 캐시와 복잡한 규칙도 필요하고요.
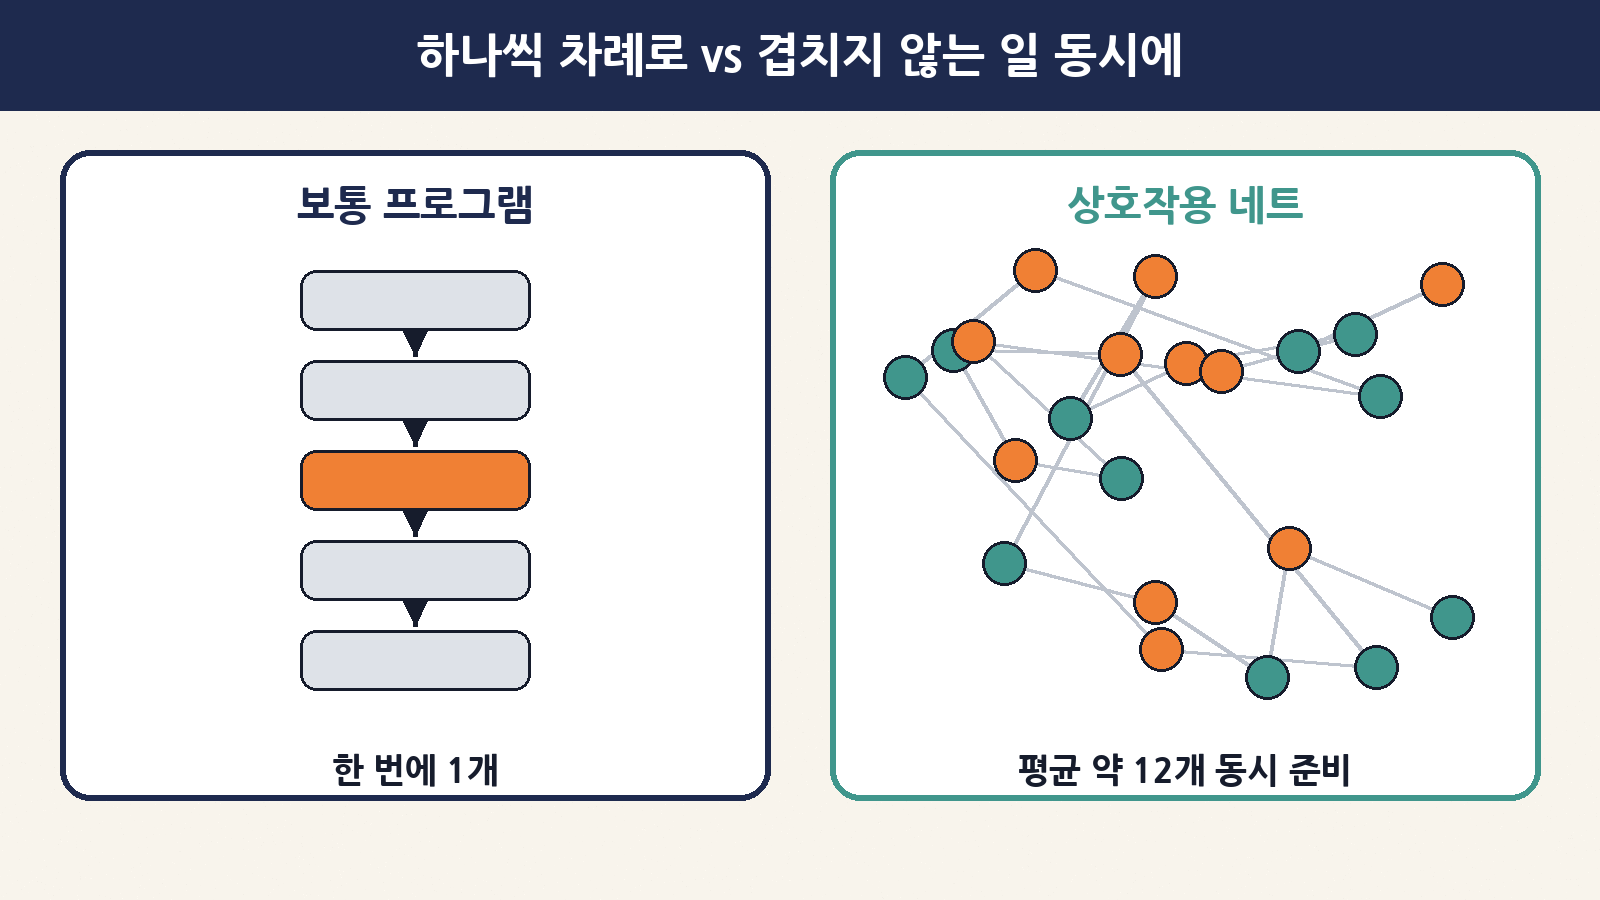
프로스트바이트가 고른 상호작용 네트는 접근이 다릅니다. 프로그램을 점(노드)과 선으로 이어진 그림(그래프)으로 보고, 연결된 두 점을 정해진 규칙으로 바꿔 쓰는 방식으로 계산해요. 회사 설명에 따르면 세 가지 성질이 핵심입니다.
| 성질 | 쉬운 말로 | 칩에 주는 이점 |
|---|---|---|
| 모든 단계가 ‘국소적’ | 한 번에 그림의 아주 작은 부분만 바꿈 | 멀리 있는 데이터를 가져올 일이 줄어듦 |
| 모든 의존 관계가 드러나 있음 | “누가 누구를 기다리는지”가 그림에 그대로 보임 | 순서를 실행 중에 다시 찾아낼 필요가 적음 |
| 모든 값은 주인이 딱 하나 | 한 값은 정확히 한 번만 쓰임 | 여러 곳이 같은 값을 건드리는 충돌이 없어 큰 공유 캐시가 덜 필요 |
예를 들어 볼게요. 5×5 체스판에 퀸 5개를 서로 공격하지 않게 놓는 퍼즐을 풀 때, 보통 프로그램은 후보를 하나씩 차례로 확인합니다. 같은 문제를 상호작용 네트로 바꾸면 매 단계 평균 약 12개의 일이 동시에 실행 준비 상태가 된다고 회사는 설명했어요. 프로그램을 고쳐 쓴 것도 아닌데, 원래 숨어 있던 ‘동시에 해도 되는 일’이 보이게 된 거죠.
상호작용 네트 자체는 새 이론이 아닙니다. 1990년 프랑스 수학자 이브 라퐁(Yves Lafont)이 발표한 개념이에요. 회사도 “35년 넘게 있었지만 실제 쓸모는 분명하지 않았다”고 인정하며, 이런 낯선 구조를 시험해 보는 데 드는 시간과 비용을 AI가 확 줄였다는 점을 강조했습니다. 프로스트바이트용 프로그램은 러스트(Rust)와 비슷한 문법의 언어 바인(Vine)으로 쓰고, ‘아이비(Ivy)’라는 중간 형태로 바꿔 칩에 올립니다.
4. AI는 정확히 무엇을 했을까요?
회사 블로그에 적힌 과정을 순서대로 정리하면 이렇습니다. 숫자는 모두 아키텍트 랩스의 발표 기준이에요.
| 단계 | AI가 한 일 | 눈에 띄는 숫자 |
|---|---|---|
| ① 목표 작업 정하기 | 병렬 작업, 긴 순차 작업, 분기, 재귀 등 프로그램 유형별로 ‘연습용’과 ‘시험용’ 작업을 나눔 | 총 25개 (연습 10 · 시험 15) |
| ② 구조 탐색 | 논문·벤치마크를 종합하고 파이썬 모델로 아이디어를 비교해 하나로 좁힘 | 141쪽짜리 구상 PDF → 첫 설계 후 삭제 |
| ③ 정식 명세 만들기 | 자체 명세 언어 ASL로 칩 전체 모델 ‘아크모델(Arcmodel)’을 작성, 수학 증명 도구 린(Lean)으로 확인 | 블록 31개, 린 코드 80만 줄 이상 |
| ④ 회로 설계(RTL)와 맞추기 | 모델 예측과 실제 회로의 전력 차이를 자동으로 줄임 | 처음 최대 약 250% 차이 → 5% 이내 |
| ⑤ 반복 개선 | 에이전트들이 여러 갈래에서 동시에 개선안을 내고, 검증·측정 후 채택 또는 폐기 | 아이디어 58개 시도, 37개 채택 |
| ⑥ 최종 도면 | 7나노 공정 기준으로 합성하고 최종 배치(GDS)까지 완료 | 합성 800MHz, 최종 GDS 500MHz |
여기서 초보자분들이 기억하면 좋은 포인트가 하나 있어요. 회사는 사람이 쓰는 영어 문서 대신 기계가 검사할 수 있는 ‘정식 명세’를 유일한 기준으로 삼았다고 했습니다. AI가 그럴듯하게 틀리는 ‘환각’이나, 점수만 올리고 실제로는 꼼수를 쓰는 ‘보상 해킹’을 걸러 내려면, 말이 아니라 수학적으로 확인할 수 있는 기준이 필요하다는 거죠. 아크모델은 실제 회로 시뮬레이션보다 약 200배(칩 전체 시뮬레이션은 660배) 빠르면서 전력·성능 추정이 1~5% 안쪽으로 맞는다고 회사는 밝혔습니다.
| 기존 방식 | 프로스트바이트 방식(회사 설명) |
|---|---|
| 설계자가 영어 PDF를 여러 권 써서 다음 팀에 넘김 | 기계가 검사하는 명세(ASL)가 처음부터 끝까지 ‘유일한 정답지’ |
| 구조 → 회로 → 검증이 순서대로, 팀별로 진행 | 명세·모델·회로·전력 측정을 에이전트가 동시에 오가며 수정 |
| 소프트웨어와 하드웨어가 따로 최적화 | 예: 아주 세밀한 클럭 게이팅(안 쓰는 부분 전기 끄기)을 찾고 소프트웨어 런타임까지 몇 시간 만에 함께 조정 |
5. 아무도 시키지 않은 규칙: ‘일 훔쳐 오기’
회사가 가장 신기했다고 꼽은 장면은 칩 안의 작은 계산 단위(타일)들이 일을 나누는 방식입니다. 프로스트바이트에는 일을 나눠 주는 중앙 관리자가 없어요. 대신 에이전트들이 설계한 타일은 세 가지 규칙만 따른다고 합니다.
| 순서 | 타일의 규칙 | 식당 주방에 빗대면 |
|---|---|---|
| 1 | 내 입구에 쌓인 일을 먼저 한다 | 내 앞에 들어온 주문부터 요리 |
| 2 | 내 일이 없으면, 일이 남는 옆 타일에서 가져온다 | 손이 비면 옆 요리사의 밀린 주문을 가져와 도움 |
| 3 | 가져올 일도 없으면 쉬면서 전기를 아낀다 | 할 일이 없으면 불을 끄고 대기 |
이런 방식은 컴퓨터 과학에서 ‘워크 스틸링(work stealing)’이라 부르는 오래된 아이디어예요. 회사는 이 동작을 “어떤 사람도 지정하지 않았다”며, 성능 지표를 조금씩 끌어올리는 과정에서 필요에 의해 생겨난 것이라고 설명했습니다. 다만 아이디어 자체가 처음 나온 것은 아니니, “AI가 새 개념을 발명했다”기보다는 “AI가 스스로 이 방식에 도달해 하드웨어로 구현했다”로 이해하시면 정확해요.
6. ‘4.59배’, 이렇게 읽으세요
이제 숫자를 볼 차례입니다. 비교는 프로스트바이트 ‘쿼드’(타일 2×2 묶음 + L3 노드 4개) 하나와 기존 CPU 코어(회사는 TCPU, ‘전통 CPU’라고 부름) 하나를 같은 7나노 공정에서 맞붙인 결과예요.
| 항목 | 프로스트바이트 쿼드 | 비교 CPU 코어(TCPU) |
|---|---|---|
| 공정 | 7나노 | 7나노 |
| 면적 | 0.792㎟ | 0.895㎟ |
| 구조 | 타일 4개가 일을 나눠 갖는 공간형 구조 | 2개씩 순서대로 처리하는(듀얼 이슈, in-order) 코어 |
| 실제 생산 여부 | 아직 없음(설계·시뮬레이션) | 실리콘으로 검증된 코어(제품명 비공개) |
| 지표 | 결과 | 읽는 법 |
|---|---|---|
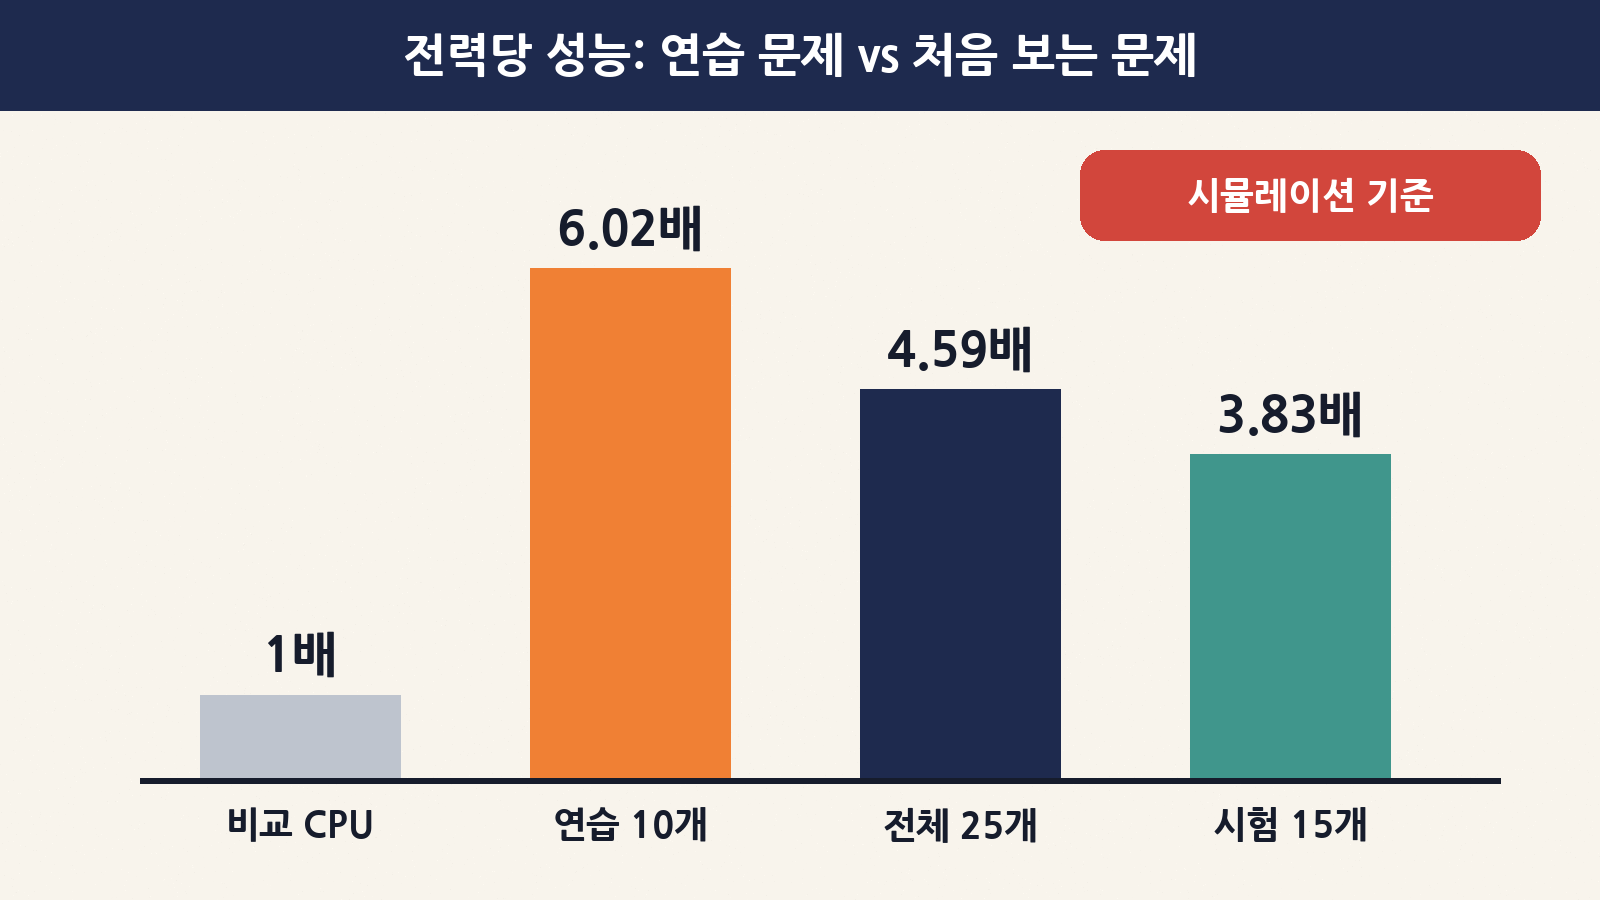
| 전력당 성능, 25개 전체(기하평균) | 4.59배 | 헤드라인 숫자. 연습용과 시험용이 섞여 있음 |
| 전력당 성능, 연습용 10개 | 6.02배 | AI가 이 작업들을 보면서 설계를 다듬었으니 높게 나오는 게 자연스러움 |
| 전력당 성능, 시험용 15개 | 3.83배 | 설계 중 한 번도 보지 않은 작업. 가장 냉정한 숫자 |
| 면적당 성능(평균) | 8.77배 | 같은 넓이의 실리콘으로 얼마나 일하는지 |
여기서 ‘연습용’과 ‘시험용’을 나눈 이유가 중요해요. 학생이 기출문제만 외우면 기출 점수는 높지만 처음 보는 문제에선 떨어지죠. 그래서 회사는 15개 작업을 끝까지 숨겨 두고 마지막에만 시험했다고 합니다. 칼만 필터(센서 값 보정), PCA(데이터 요약), 유한요소해석(구조물 계산), LU 분해(방정식 풀이), LZ4 압축 풀기 같은 실용 작업 5개도 나중에 시험용에 추가했어요.
그러니 기사 제목에서 “4.59배”를 보면, 마음속으로 “처음 보는 문제에선 3.83배, 그것도 시뮬레이션 기준”이라고 한 번 더 읽어 주시면 좋습니다. 회사도 병렬로 쪼개기 쉬운 작업에서 가장 강하고, 분기가 많은 작업에서도 앞섰다고 설명했어요.
7. 전기를 어디서 아꼈을까?
회사는 에너지가 어디에 쓰이는지도 나눠 보여 줬습니다. 클럭(칩 전체에 박자를 나눠 주는 신호) 분배에 쓰는 에너지는 빼고 비교한 수치예요(클럭 분배는 TCPU 에너지의 49%, 프로스트바이트 쿼드의 41%).
| 에너지 쓰임새(클럭 제외) | TCPU | 프로스트바이트 |
|---|---|---|
| 메모리 | 57% | 38% |
| 명령 가져오기·해석·내보내기 | 27% | 6% |
| 칩 안 네트워크·스케줄러(일 나누기) | 본문에 따로 언급 없음 | 26% |
쉽게 말해, 기존 CPU가 “데이터를 어디서 가져오고 명령을 어떻게 처리할지”에 쓰던 전기를 크게 줄이고, 그 대신 타일끼리 일을 주고받는 데 전기를 썼다는 뜻입니다. 회사는 타일을 4×4로 늘려도 이 비율이 비슷하게 유지돼, 코어를 늘릴수록 복잡해지는 기존 멀티코어와 달리 확장이 쉽다고 주장했어요. 다만 이 비교도 앞으로 해야 할 일로 남아 있습니다.
8. 해커뉴스 댓글이 짚은 의문점
발표가 화려한 만큼 반론도 많았습니다. 해커뉴스 댓글에서 자주 나온 의견을 정리해 봤어요. 아래는 댓글 작성자들의 의견이지, 확인된 사실이 아니라는 점은 감안해 주세요.
| 의문 | 댓글의 요지 | 초보자를 위한 해석 |
|---|---|---|
| 비교 대상이 약하다 | 순서대로 처리하는 듀얼 이슈 코어는 마이크로컨트롤러급이고, 요즘 PC·폰의 ‘비순차(out-of-order)’ 고성능 코어가 아니다 | 경차와 비교해 연비가 좋다고 한 셈일 수 있음. 회사도 더 큰 CPU와의 비교를 “앞으로 할 일”로 적음 |
| 시험 문제가 작다 | JSON 4,096자 파싱, 원소 1,024개 정렬, 피보나치 20 같은 작은 규모 | 회사도 일부 작업을 원래보다 64배 작게 줄였다고 밝힘. SPEC·PARSEC 같은 표준 벤치마크는 아직 |
| 정말 새로운가 | 20여 년 전 ‘웨이브스칼라(WaveScalar)’, 80년대 데이터플로 컴퓨터, 트랜스퓨터와 닮았다 | “데이터가 준비되면 바로 계산”하는 데이터플로 계열 아이디어는 역사가 깊음 |
| ‘발견’이란 표현 | 땅에서 캐낸 게 아니라 설계한 것이니 ‘발명’이 맞다 | 마케팅 표현과 기술적 사실을 구분해서 읽기 |
| 사람 몫은? | 검사 도구를 만들고 시험 작업을 고른 건 사람, AI는 반복 노동을 했다 | ‘완전 자율’이라기보다 사람이 짠 판 위에서 AI가 대량 탐색한 구조 |
| 칩이 없다 | 실제 CPU를 만들어 쓸 수 있게 하면 그때 이야기하자 | 시뮬레이션과 실제 칩 사이엔 늘 차이가 있음(회사도 인정) |
한편 “설계 기간이 2년에서 2개월로 줄면, 그동안 경제성이 없던 분야별 맞춤 칩이 훨씬 많아질 것”이라는 기대 섞인 댓글도 많았어요. 의심과 기대가 동시에 큰, 전형적인 ‘초기 발표’의 모습입니다.
9. 아키텍트 랩스는 어떤 회사?
| 항목 | 내용(회사 공개 정보 기준) |
|---|---|
| 법인명 | Architect Silicon Inc. |
| 목표 | “AI로 새 실리콘(칩)을 처음부터 끝까지 만든다” |
| 창업팀 | 인텔 데이터센터 AI 그룹 전 시니어 디렉터, 앤트로픽 전 신뢰·안전 머신러닝 책임자, 애플·테슬라·메타·시놉시스·퀄컴·삼성 출신 등 |
| 자문·엔젤 | 트랜스포머 논문 ‘Attention Is All You Need’ 공저자 루카시 카이저(오픈AI), 퍼플렉시티 CEO 아라빈드 스리니바스 등 |
| 이전 발표 | 2026년 8월 ‘레드우드(Redwood)’: AI가 2주 안에 설계했다는 AI 가속기. FPGA에서 Qwen3-0.6B 모델을 초당 12.1토큰으로 실행 |
| 문제의식 | 회사 소개에 따르면 첫 시제품 칩이 한 번에 성공하는 비율이 2020년 약 30%에서 2024년 14%로 떨어졌고, 칩 프로젝트의 75%가 일정보다 늦어지고 있음 |
회사를 처음 공식 소개한 글(‘Introducing Architect Labs’)이 2026년 6월에 올라왔으니, 세상에 알려진 지 반년도 안 된 젊은 회사예요. 해커뉴스에서도 “믿을 만한 회사냐”는 질문이 나왔는데, 결국 판단은 회사가 약속한 RTL·명령어 집합 공개와 누구나 써 보는 FPGA 놀이터가 실제로 나오느냐에 달려 있습니다.
10. 이런 ‘AI가 만들었다’ 뉴스, 이렇게 읽어 보세요
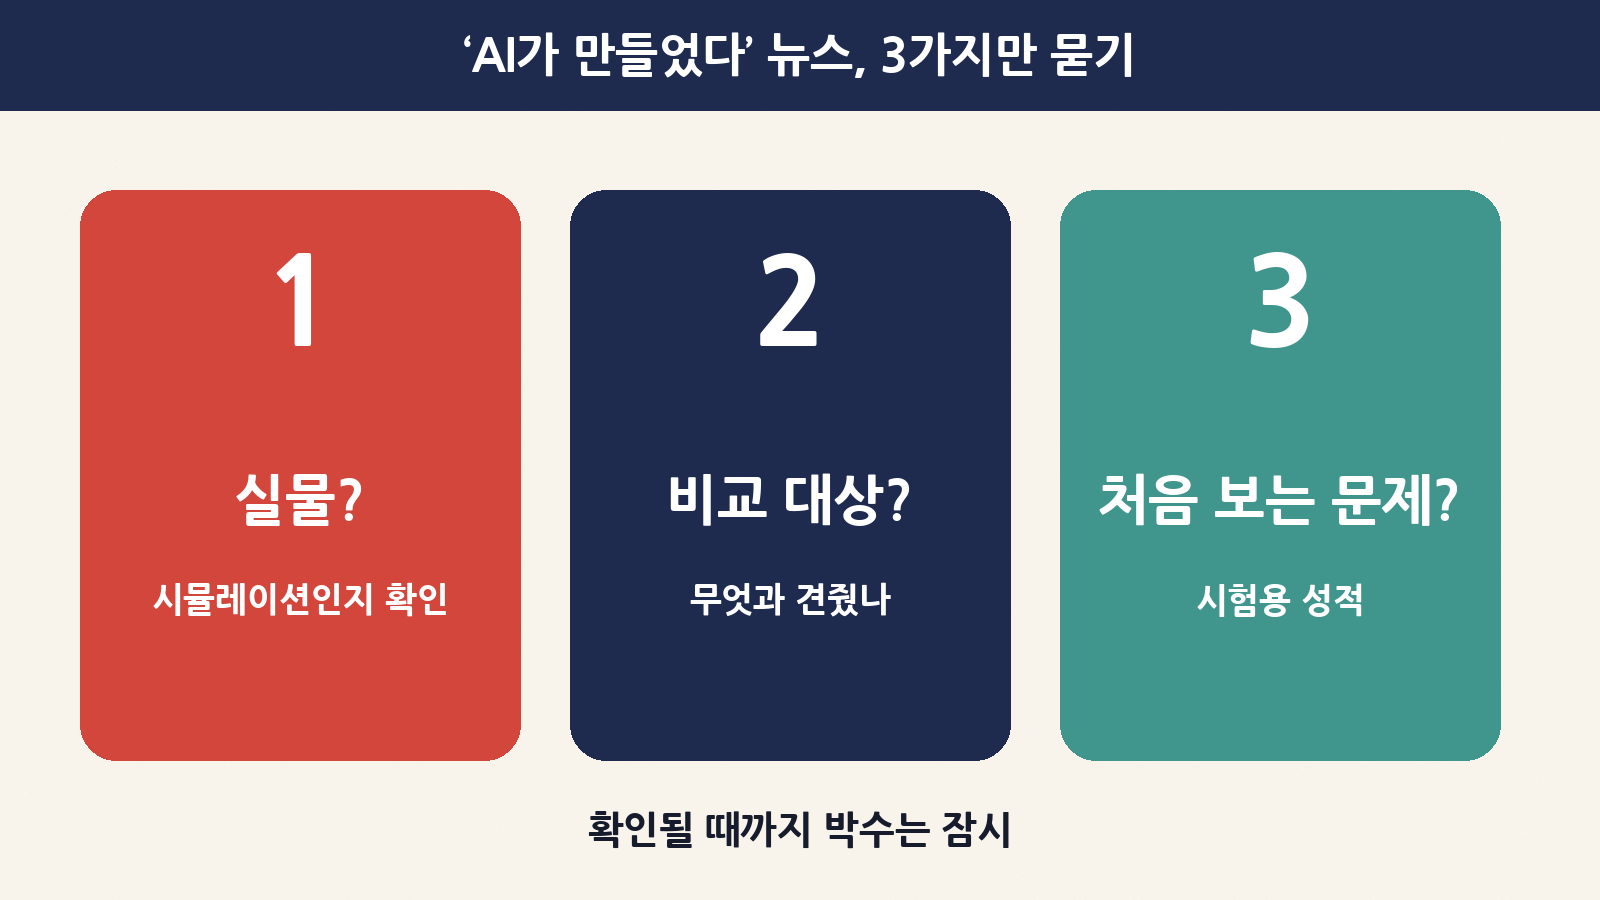
앞으로도 “AI가 신약을 찾았다”, “AI가 칩을 설계했다” 같은 소식은 계속 나올 거예요. 이번 프로스트바이트를 연습 문제 삼아, 어떤 분야든 쓸 수 있는 체크리스트를 만들어 봤습니다.
| 체크 질문 | 프로스트바이트의 경우 |
|---|---|
| 누가 발표했나? (회사 자체 발표 vs 외부 검증) | 회사 블로그 자체 발표. 외부 기관 검증이나 학술 심사는 아직 없음 |
| 실물이 있나, 시뮬레이션인가? | 7나노 최종 도면과 시뮬레이션까지. 실제 칩은 없음 |
| 무엇과 비교했나? | 순서대로 처리하는 작은 코어 1개(제품명 비공개) |
| 처음 보는 문제로도 시험했나? | 했음. 숨겨 둔 15개 작업에서 3.83배 |
| 사람은 무엇을 했나? | 목표 작업 선택, 검사 도구·명세 언어 설계 등 판을 짜는 일 |
| 다른 사람이 재현할 수 있나? | RTL·명령어 집합 공개와 FPGA 놀이터를 “예정”으로 발표. 아직은 확인 불가 |
이 여섯 가지만 확인해도 “와, 대단하다!”와 “어차피 과장이겠지” 사이에서 훨씬 차분하게 판단할 수 있어요. 특히 ‘시험용 데이터 성적’과 ‘실물 여부’는 AI 뉴스에서 가장 자주 생략되는 부분이니 꼭 찾아보세요.
11. 자주 묻는 질문
| 질문 | 답 |
|---|---|
| 이 CPU를 살 수 있나요? | 아닙니다. 실제로 생산된 칩이 없고, 판매 계획도 발표되지 않았어요. 먼저 FPGA(회로를 바꿔 끼울 수 있는 칩)로 누구나 프로그램을 돌려 보는 놀이터를 만들겠다고 했습니다. |
| 내 PC의 인텔·AMD CPU보다 빠른가요? | 알 수 없습니다. 비교 대상은 작은 순차 처리 코어였고, 고성능 CPU와의 비교는 “앞으로 몇 달 안에” 하겠다고 했어요. |
| 윈도우나 기존 앱이 돌아가나요? | 아니요. 명령어 집합이 완전히 새것이라 프로그램을 ‘바인’ 같은 전용 언어로 써야 합니다. 운영체제도 이제 기초부터 만들 계획이에요. |
| AI가 사람 칩 설계자를 대신하나요? | 이번 사례에서도 목표와 기준을 정한 건 사람입니다. 회사 소개 역시 “사람 설계자가 의도와 방향을 정한다”고 적고 있어요. 반복 탐색은 AI, 판 짜기와 판단은 사람에 가깝습니다. |
| 한국 반도체 산업과도 관련 있나요? | 회사는 설계가 쉬워지면 분야별 맞춤 칩 수요가 늘 것이라고 봅니다. 그렇게 되면 칩을 실제로 찍어 내는 파운드리의 역할도 커질 수 있다는 의견이 해커뉴스에서도 나왔어요. 다만 아직은 전망 단계입니다. |
마무리: ‘AI가 설계한 칩’의 첫 장면, 박수는 실물이 나온 뒤에
프로스트바이트를 한 줄로 줄이면 “35년 묵은 계산 이론을 AI 에이전트 무리가 7나노 CPU 도면으로 옮겼고, 시뮬레이션에서는 작은 기존 코어보다 전력당 성능이 4.59배(처음 보는 작업에선 3.83배) 좋았다. 하지만 아직 실제 칩은 없다”입니다. AI가 글과 그림, 코드를 넘어 반도체 설계라는 가장 까다로운 영역까지 들어오고 있다는 점은 분명히 흥미로운 신호예요. 동시에 비교 대상, 시험 규모, 실물 여부라는 세 가지 물음표도 함께 기억해 두시면 좋겠습니다. 회사가 약속한 설계 공개와 FPGA 놀이터가 나오면, 그때 다시 숫자를 맞춰 보는 재미도 있을 거예요.