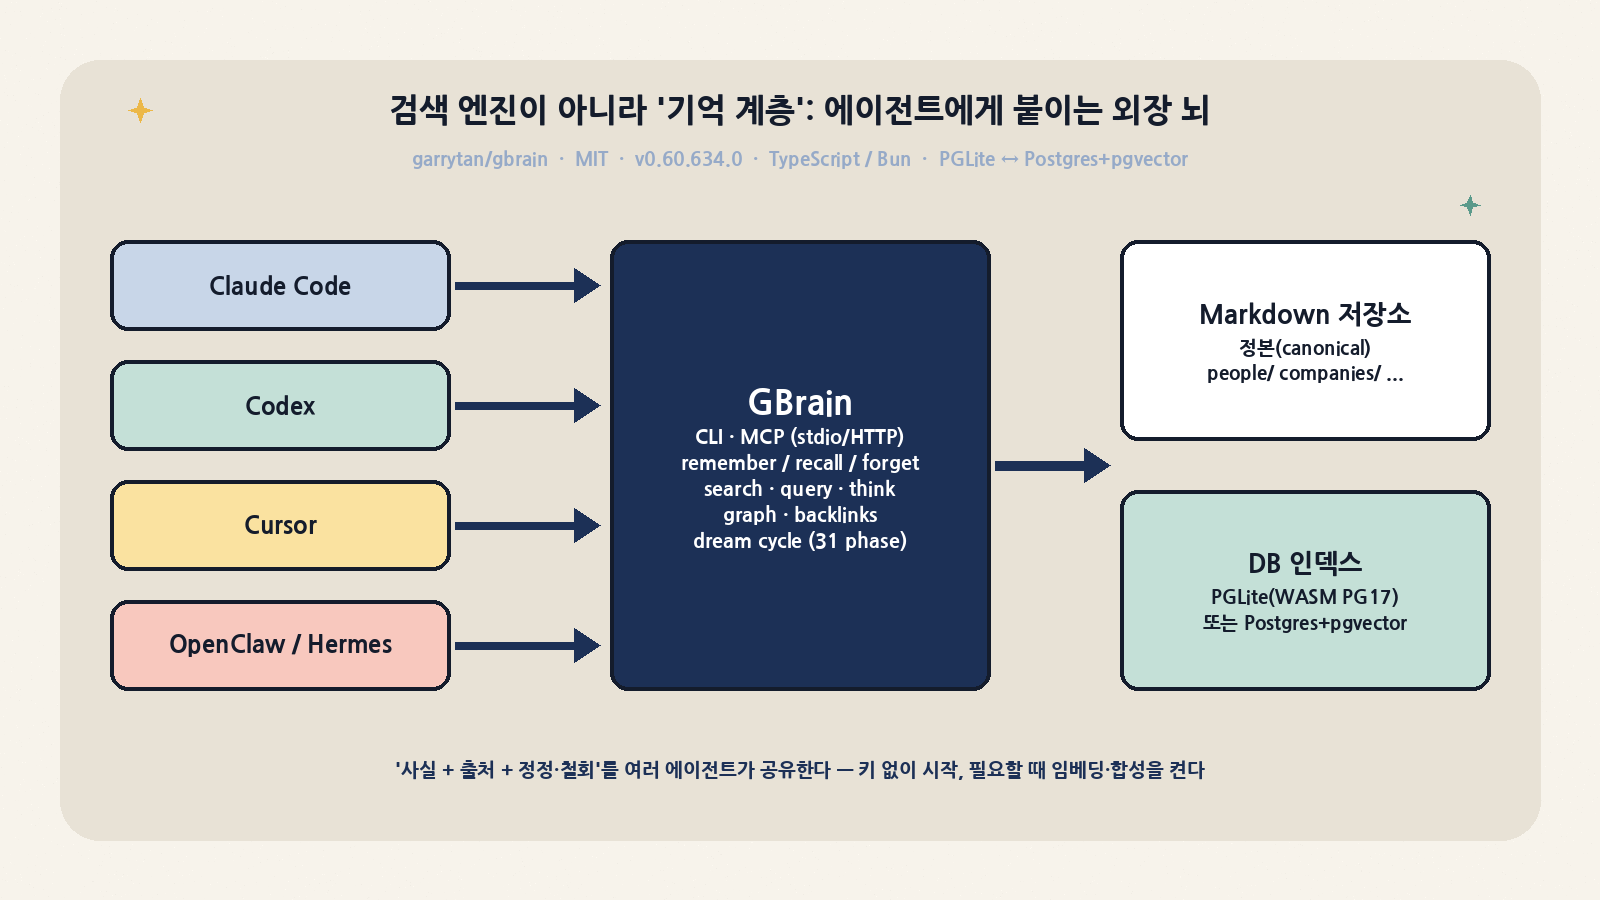
한 줄 요약: garrytan/gbrain은 Y Combinator 대표 Garry Tan이 자기 에이전트(OpenClaw·Hermes)를 돌리려고 만든 “에이전트용 외장 기억 계층”입니다. Markdown 파일을 정본으로 두고, PGLite(WASM Postgres 17) 또는 Postgres+pgvector에 인덱스를 만든 뒤, CLI와 MCP로 remember / recall / search / query / think를 제공합니다. 오늘(2026-11-10) GitHub Trending 일간 전체 6위(하루 +216★), 누적 32,210★·4,770 fork. 이 글은 구조·검색 파이프라인·dream cycle을 코드 기준으로 해부하고, 박스에서 API 키 없이 설치→임포트→검색→그래프→기억 왕복까지 직접 돌린 결과를 정리했습니다.
1. 왜 지금 이 저장소인가
코딩 에이전트와 개인 비서 에이전트가 늘면서 병목은 “모델이 똑똑한가”보다 “세션이 끝나면 다 잊는다”로 옮겨 왔습니다. 각 하네스(Claude Code, Codex, Cursor 등)가 저마다 메모리 기능을 붙이고 있지만, 대부분 그 제품 안에 갇혀 있고 출처·정정·철회 개념이 약합니다. GBrain의 문제 정의는 분명합니다. “이미 쓰는 에이전트에게, 내가 통제하는 기억을 준다.” 사실(fact)은 출처와 함께 저장되고, 정정·철회가 가능하며, 같은 기억을 여러 에이전트가 MCP로 공유합니다.
트렌딩에 다시 오른 배경은 릴리스 속도입니다. 2026-11-10 하루에만 v0.60.630.0(09:12 KST)부터 v0.60.634.0(11:25 KST)까지 태그 5개가 찍혔고, 기본 설치 채널은 이를 바로 받지 않고 주 1회 검증 후 승격하는 stable 채널을 따릅니다. 제작자의 운영 수치(155,795 페이지, 24,589명, 5,340개 회사, 66개 cron)는 README의 자기 보고이므로 그대로 인용만 합니다.
| 항목 | 값 (2026-11-10 확인) |
|---|---|
| 저장소 | garrytan/gbrain (2026-04-05 생성) |
| 라이선스 | MIT (gbrain.io 호스팅은 선택형 유료) |
| 버전 | VERSION 0.60.634.0 / 최신 태그 v0.60.634.0 |
| Stars / Forks | 32,210 / 4,770 · Trending 일간 #6 (+216★ today) |
| 런타임 | TypeScript on Bun 1.4.4 이상 (박스 기본 1.4.2 → 1.4.4로 올려 실행) |
| 저장 엔진 | PGLite(기본, 서버 없음) / Postgres + pgvector(Supabase·자체 호스팅) |
| 인터페이스 | CLI gbrain, MCP gbrain serve(stdio) / serve --http(OAuth 2.1) |
| 규모(얕은 클론 기준) | src/ TS 파일 3,542개·약 80만 줄, 테스트 파일 5,959개, 번들 skill 75개 |
2. 저장소 구조: 어디부터 읽어야 하나
파일이 1만 4천 개를 넘는 거대한 저장소지만, 핵심 경로는 몇 군데로 모입니다. 저장소 스스로도 사람이 아니라 에이전트가 읽도록 AGENTS.md, CLAUDE.md, llms.txt/llms-full.txt(약 80만 바이트)를 진입점으로 둡니다.
| 경로 | 역할 | 읽을 포인트 |
|---|---|---|
src/cli.ts |
CLI 진입점 (package.json의 bin.gbrain) |
명령 → op 레지스트리 매핑 |
src/core/engine.ts |
BrainEngine 인터페이스(100+ 메서드) |
PGLite/Postgres가 공유하는 유일한 계약 |
src/core/engine-sql/ |
도메인별 SQL 단일 구현 | 두 엔진이 같은 SQL을 한 번만 갖도록 이전 중 (ratchet 체크) |
src/core/search/ |
hybrid.ts, fusion-lists.ts, mode.ts |
RRF, 부스트, reranker, 모드 번들 |
src/core/cycle.ts |
dream cycle 오케스트레이션 | ALL_PHASES 31개 순서와 scope(source/mixed/global) |
src/core/minions/ |
백그라운드 잡 큐 | admission, 예산 미터, 자식 워커 감독 |
src/mcp/ |
MCP 서버 | surface(starter/full), verbs 광고 |
skills/ |
번들 skill(SKILL.md) | skills.lock.json로 무결성 고정, doctor가 검증 |
docs/architecture/ |
RETRIEVAL, brains-and-sources, system-of-record 등 | 설계 근거와 벤치마크 수치의 출처 |
recipes/ |
통합 레시피(Twilio 음성, 메일·캘린더 등) | 코드가 아니라 에이전트가 따라 하는 Markdown |
3. 아키텍처: 하나의 계약, 두 개의 엔진
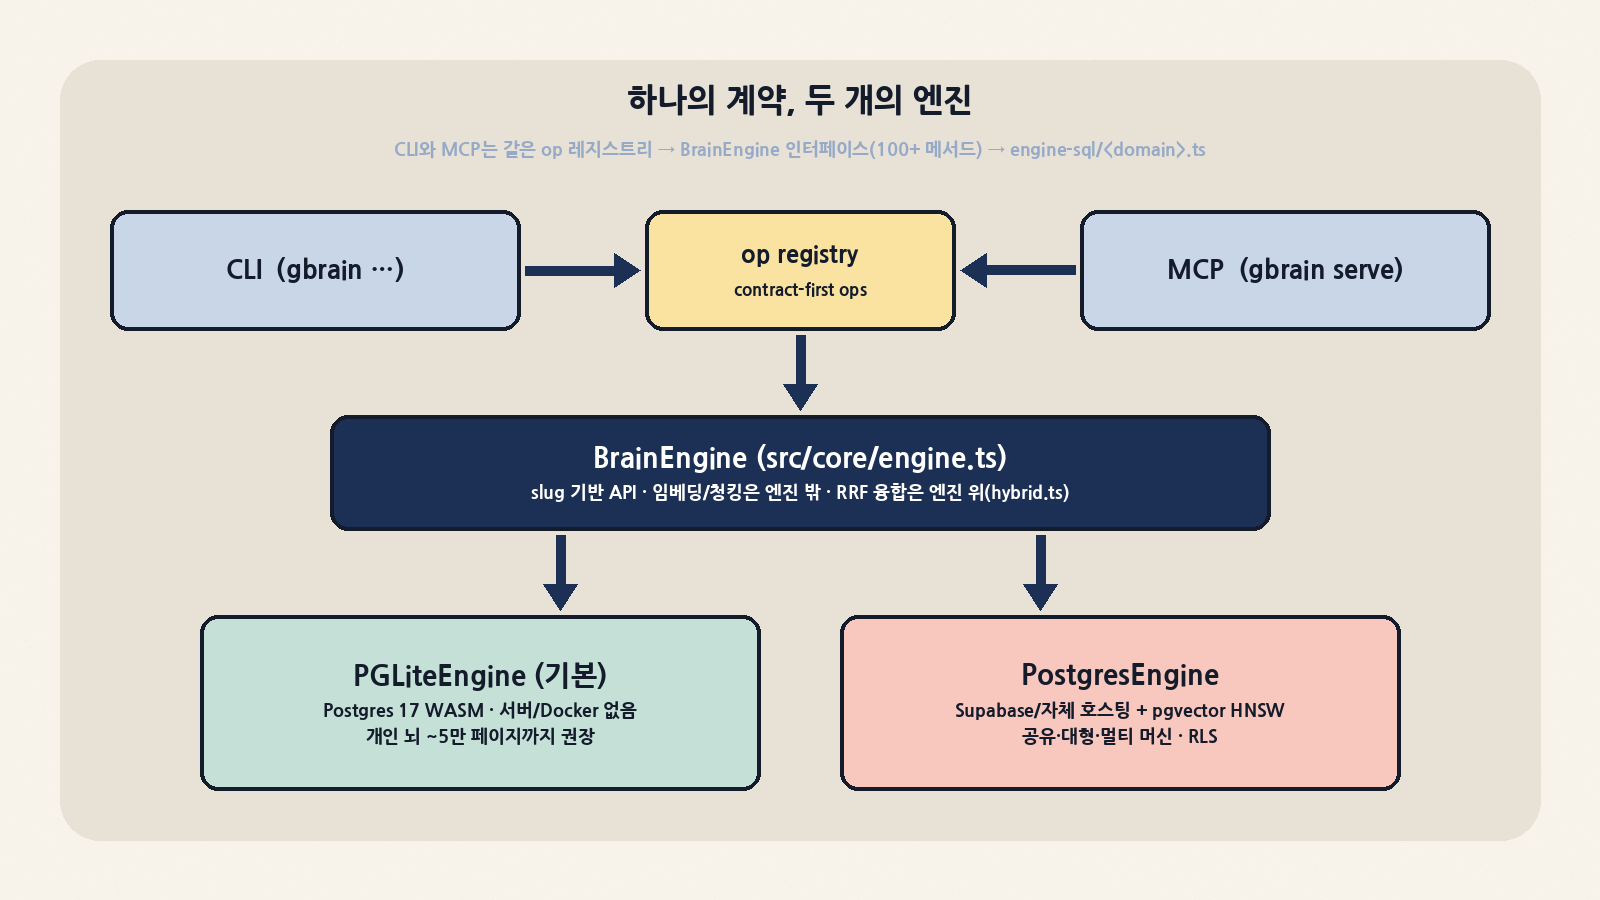
설계의 중심은 BrainEngine입니다. 모든 연산이 이 인터페이스를 지나가고, CLI와 MCP는 같은 op 레지스트리를 공유합니다. 문서(docs/ENGINES.md)가 강조하는 설계 선택은 세 가지입니다.
- slug 기반 API — 메서드는 숫자 ID가 아니라
people/alice-example같은 slug를 받습니다. 파일 경로가 곧 slug이므로, Markdown 정본과 DB 인덱스를 오가기 쉽습니다. - 임베딩과 청킹은 엔진 밖 — 임베딩은
src/core/ai/gateway.ts를 통한 외부 호출(Voyage 기본, OpenAI·Gemini·Ollama·llama.cpp 등)이고, 엔진은 벡터를 저장·검색만 합니다. 엔진을 바꿔도 임베딩 계층은 그대로입니다. - 융합은 엔진 위 — 엔진은 키워드·벡터 결과를 균일한
SearchResult[]로 돌려주고, RRF와 중복 제거는hybrid.ts에서 합니다.
| 구분 | PGLiteEngine (기본) | PostgresEngine |
|---|---|---|
| 실체 | @electric-sql/pglite, Postgres 17 WASM | Supabase 또는 자체 Postgres + pgvector |
| 필요 인프라 | 없음 (서버·Docker 불필요) | DB 서버, 백업, 접근 제어 |
| 권장 규모 | 개인 뇌 ~5만 페이지 | 공유·대형·멀티 머신 |
| 벡터 검색 | pgvector 호환 (임베딩 켰을 때) | pgvector HNSW |
| 격리 | 로컬 파일 신뢰 경계 | RLS, OAuth 스코프 원격 클라이언트 |
| 이동 | gbrain migrate --to postgres(계획 → --yes --expect) / 쓰기 이력이 없으면 --to pglite 역방향 |
|
또 하나 중요한 축은 brain ⊥ source입니다. brain은 데이터베이스(개인 뇌, 합류한 팀 마운트), source는 그 안의 저장소입니다. 라우팅은 .gbrain-source 파일과 6단계 우선순위로 결정됩니다. 문서는 여기서 솔직하게 선을 긋습니다. 인증된 원격 클라이언트는 source·operation 권한과 가시성 필터로 제한되지만, 로컬 파일이나 공유 DB 자격증명을 가진 호출자는 source만으로 격리되지 않는다는 것입니다. 회사 뇌로 쓰려면 이 경계부터 읽어야 합니다.
4. 페이지 해부: compiled truth, facts, takes, timeline
GBrain 페이지는 고정된 모양의 Markdown 한 장입니다. 위에서부터 YAML frontmatter(type, trust_tier, ingested_via 등) → 자유 서술 본문(compiled truth) → gbrain:facts 펜스 안의 사실 표 → <!-- timeline --> 센티널 아래 타임라인 순입니다. 사실 표에는 claim, kind, confidence, visibility, valid_from/valid_until, source가 칼럼으로 들어가므로 “언제부터 언제까지 유효했던, 어디서 온 주장인가”가 행 단위로 남습니다.
문서가 “절대 섞지 말라”고 강조하는 구분이 facts vs takes입니다.
| 층 | 무엇 | 누가 만든다 | 쓰임 |
|---|---|---|---|
| facts | 사용자가 말한 지속적 사실, 출처·가시성 포함 | remember(에이전트/사용자 명시) |
새 세션에 push(world 가시성), recall |
| takes | “누가 무엇을 얼마나 믿는가” (take/fact/bet/hunch, 가중치) | 페이지에서 LLM 추출, dream cycle | takes search, think의 근거 스트림 |
| links | typed edge (mentions 등), 출처(markdown/manual) | LLM 없이 [[slug]] 패턴 매칭 |
backlinks, graph, 관계 검색 arm |
| timeline | 시간순 이벤트 | timeline-add, 회의록 추출 |
시간 질의, 최신성 판단 |
이 분리가 실무에서 의미 있는 이유는 정정과 철회입니다. 벡터 DB에 청크를 던져 넣는 방식에서는 “이 주장은 틀렸다”를 표현하기 어렵지만, GBrain은 forget <fact-id>로 특정 사실을 철회하고, takes에는 보유자와 가중치가 붙습니다. “Alice가 그렇게 믿는다”와 “그것이 사실이다”를 다른 행으로 다룹니다.
5. 검색 파이프라인: search, query, think는 서로 다른 동사다
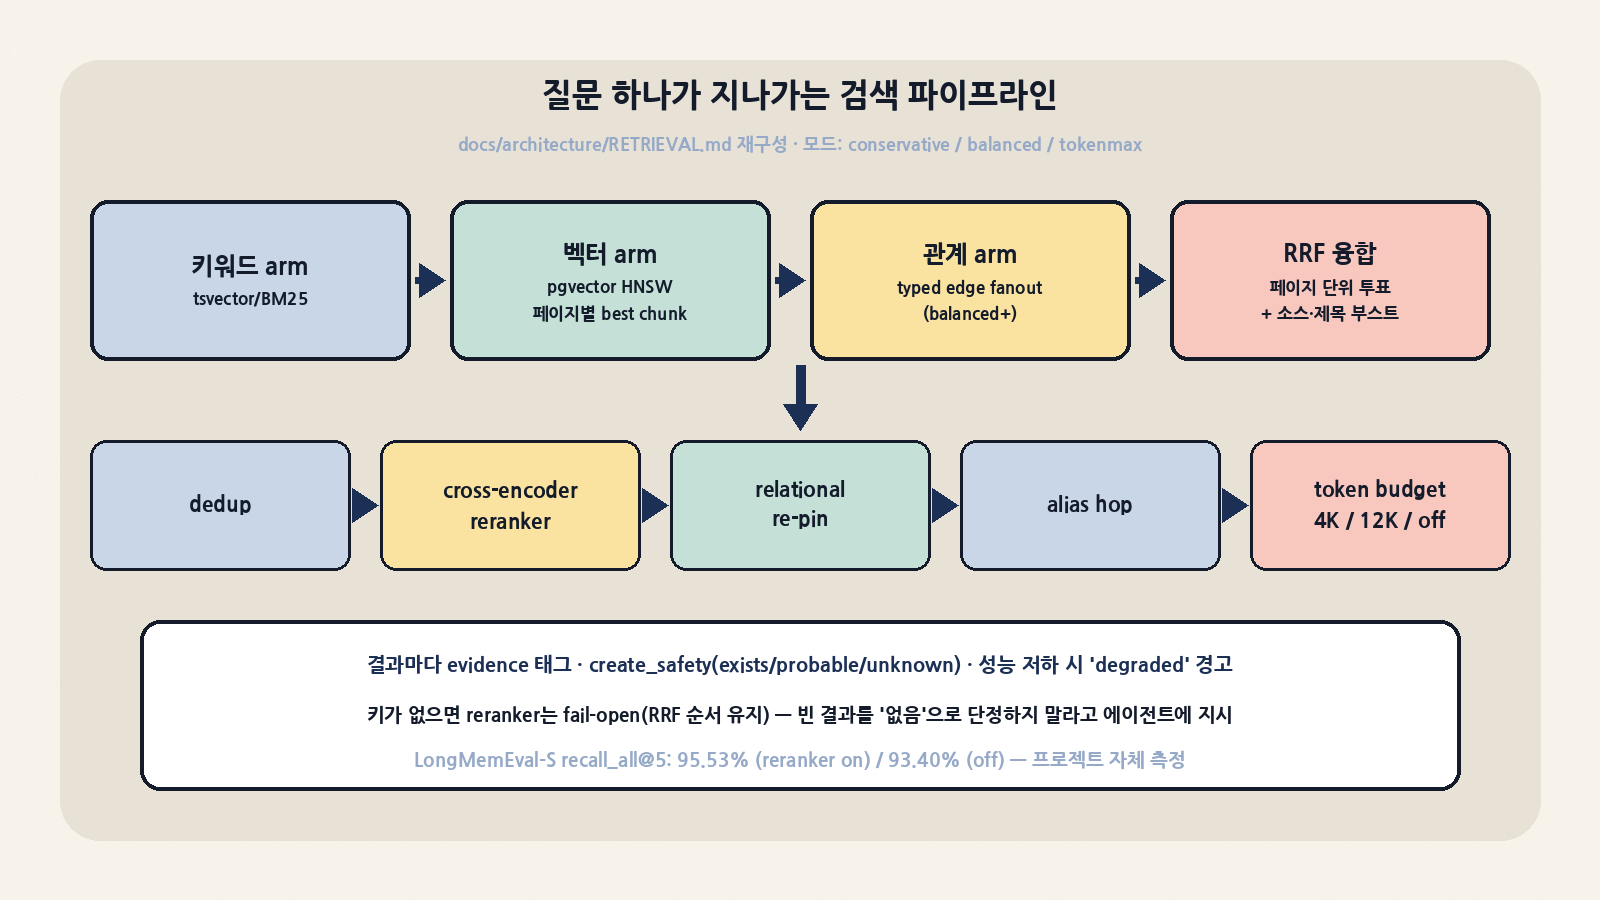
세 동사의 비용 구조가 다릅니다. search는 키워드(tsvector) 중심의 저렴한 경로, query(별칭 ask)는 벡터+키워드+RRF 하이브리드, think는 같은 수집 뒤에 LLM 합성으로 인용이 달린 답과 “모르는 것(Gaps)”을 만듭니다. README의 데모가 바로 이 차이입니다. 페이지 5개 목록 대신 “Alice와 열려 있는 일 3가지 + 6주간 새 정보 없음, 메일·슬랙 DM은 뇌가 못 본다”를 돌려줍니다.
docs/architecture/RETRIEVAL.md 기준 하이브리드 경로의 핵심 단계는 이렇습니다.
- arm별 검색: 키워드 arm, 벡터 arm(페이지별 best chunk 풀링), 관계 arm(typed edge fanout, balanced 이상).
- 페이지 단위 RRF: 투표 대상이 청크가 아니라 페이지. arm마다 다른 청크를 골라도 그 페이지의 대표 청크로 표가 합쳐지고, 나머지 청크는 자기 표만 유지해 다른 페이지를 밀어내지 못하게 합니다.
- 사후 부스트: 소스 prefix 부스트(
archive/는 숨기지 않고 0.5배 감점), 제목 구절·별칭 부스트. 시간 질의는 소스 부스트를 우회합니다. - dedup → cross-encoder reranker: balanced/tokenmax에서 Voyage
rerank-3-lite기본. 키가 없으면 에러 대신 fail-open으로 RRF 순서를 유지하고 메타에reranker_skipped (no_key)를 찍습니다. - relational re-pin: reranker는 텍스트에 질의어가 없는 “관계로 찾은 페이지”를 강등시키는 경향이 있어, 관계 arm 결과를 최대 3개까지 다시 위로 고정합니다. 문서의 A/B에서 pin 없이 reranker만 켜면 hit@1이 21/39에서 3/39로 떨어졌다고 밝힙니다.
- alias hop → 토큰 예산: 마지막에 모드별 토큰 예산(4K/12K/무제한)을 적용합니다.
| 모드 번들 | tokenBudget | relationalRetrieval | reranker | 언제 |
|---|---|---|---|---|
conservative |
4,000 | off | off | 키 없는 설치, Haiku급 서브에이전트 |
balanced |
12,000 | on | on | search.mode 미설정 시 질의 시점 기본값 |
tokenmax |
off | on | on | 대형 컨텍스트 모델, 회상 극대화 |
세 모드 모두 LLM multi-query expansion은 기본 off입니다. 프로젝트가 직접 측정한 결과(LongMemEval-S, k=5)에서 확장을 켠 실험이 plain hybrid보다 나빴기 때문입니다. 같은 문서에 따르면 기본 경로(balanced, reranker on, autocut off)의 strict recall_all@5는 95.53%(449/470), reranker off는 93.40%(439/470)입니다. 리더 모델 없는 검색 단계만의 수치이고, 자체 측정이라는 점은 감안해야 합니다. 과거 기본값이던 autocut이 다중 세션 질문에서 379/470으로 떨어져 꺼졌다는 기록까지 남긴 점은 평가 문화 측면에서 눈여겨볼 만합니다.
6. dream cycle: “자는 동안 정리한다”의 실체
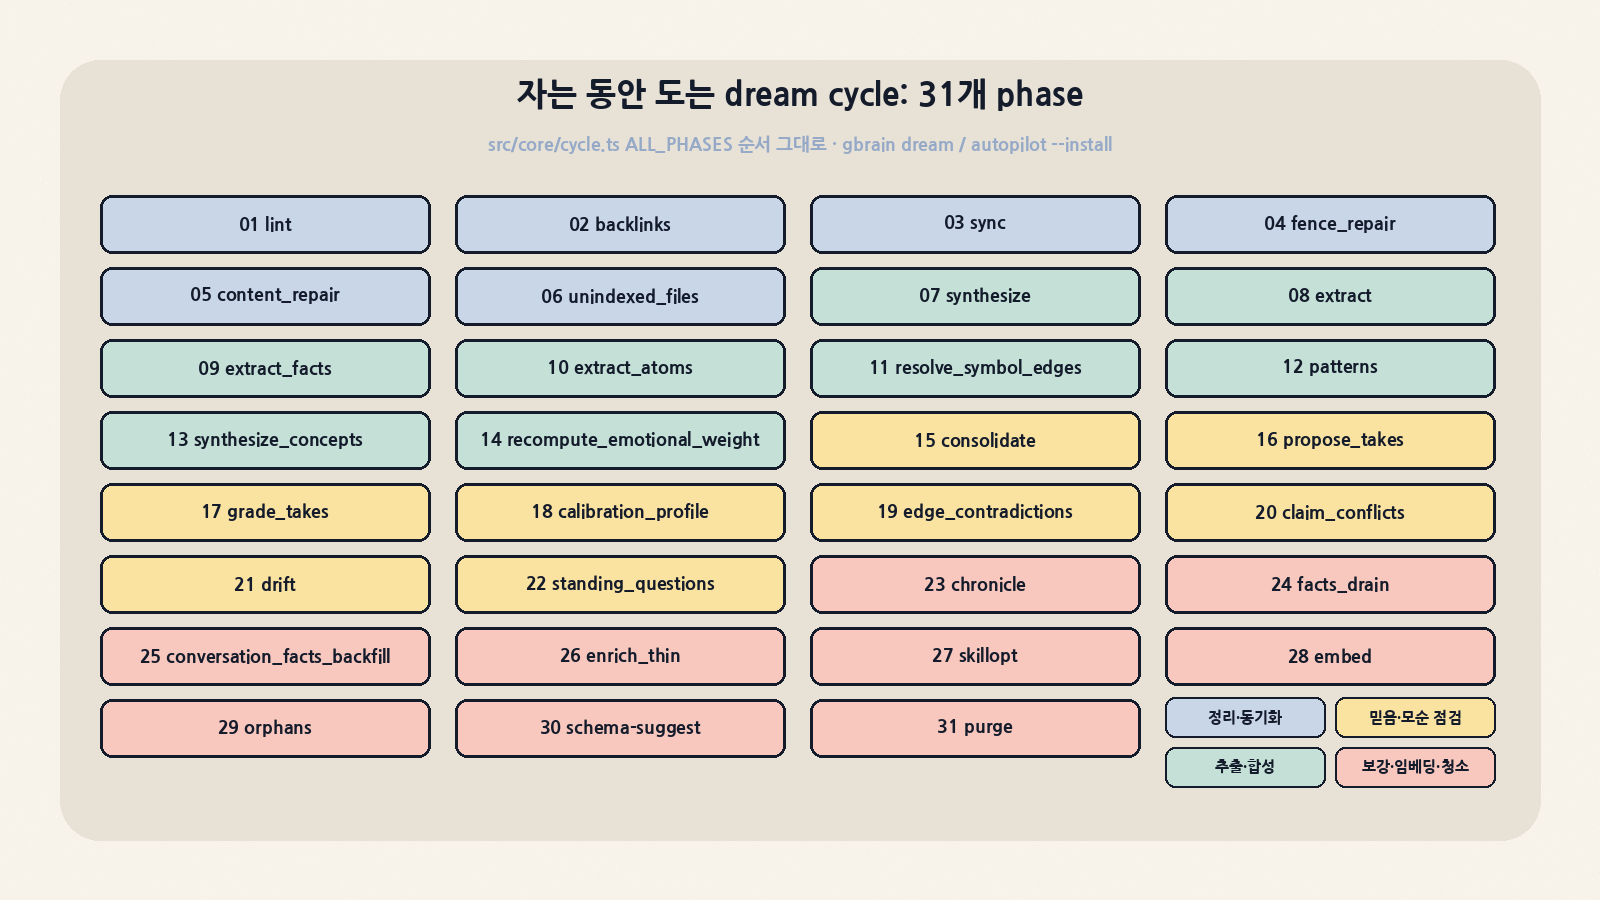
README의 “자고 일어나면 더 똑똑해진다”는 마케팅 문구의 실체는 src/core/cycle.ts의 ALL_PHASES 배열입니다. 코드 기준 31개 phase가 정해진 순서로 돕니다. lint·backlinks·sync로 시작해 펜스·콘텐츠 복구를 먼저 끝내고(그래야 추출이 깨진 페이지를 읽지 않음), extract → extract_facts → extract_atoms → 심볼 엣지 해석 → patterns·concept 합성을 거쳐, consolidate·propose_takes·grade_takes·edge_contradictions·claim_conflicts·drift 같은 믿음/모순 점검을 하고, enrich_thin·skillopt·embed·orphans·schema-suggest·purge로 마무리합니다. 각 phase에는 source/mixed/global scope가 붙어, 특정 source만 동기화할 때는 신선도 관련 phase만 돌릴 수 있습니다.
실행은 gbrain dream(1회, cron 친화), gbrain autopilot --install(상주 데몬), 무거운 작업은 Minions 잡 큐(gbrain jobs, gbrain agent run)로 나갑니다. 주의할 점은 상당수 phase가 LLM 호출을 전제한다는 것입니다(코드 주석에도 Haiku 3-check, Sonnet 합성 등이 명시). README가 “상시 보강은 8GB+ RAM 서버와 별도 API 비용”이라고 따로 적은 이유입니다.
7. 설치와 실행: 실제로 쓰는 명령
설치 경로에서 가장 중요한 경고부터. npm의 gbrain 패키지는 무관한 다른 패키지이고 실제 바이너리를 가릴 수 있으니 npm install -g gbrain을 쓰면 안 됩니다. 공식 경로는 GitHub에서 직접 받는 방식입니다.
# 1) Bun 1.4.4+ (박스 기본 1.4.2는 미달이어서 업그레이드함)
curl -fsSL https://bun.sh/install | bash
export PATH="$HOME/.bun/bin:$PATH"

# 2) stable 채널 설치 (또는 git clone --branch stable + bun install && bun link)
bun install -g github:garrytan/gbrain#stable

# 3) 키 없는 로컬 뇌 + Markdown 임포트 + 검색
gbrain init --pglite --no-embedding
gbrain import ~/notes/ --no-embed
gbrain search "a phrase from a note" --json
gbrain extract links --source db      # 대량 임포트 뒤 [[slug]] 링크 추출
gbrain backlinks people/alice-example
gbrain doctor

# 4) 에이전트 연결
gbrain setup claude-code --dry-run    # 무엇을 쓸지 미리보기, --remove로 원복
gbrain setup codex
"$(command -v gbrain)" serve --surface starter --advertise verbs   # 기타 stdio MCP 클라이언트

# 5) 나중에 의미 검색 켜기 (기존 페이지·사실 유지)
gbrain embeddings enable --embedding-model voyage:voyage-4
격리 테스트를 하려면 GBRAIN_HOME을 절대 경로로 지정하세요. 상대 경로나 ..가 들어가면 거부되고, 지정한 경로 아래에 .gbrain/이 만들어집니다. 개인 홈의 ~/.gbrain을 건드리지 않고 실험할 수 있습니다.
8. 박스 실측: 키 없이 어디까지 되나
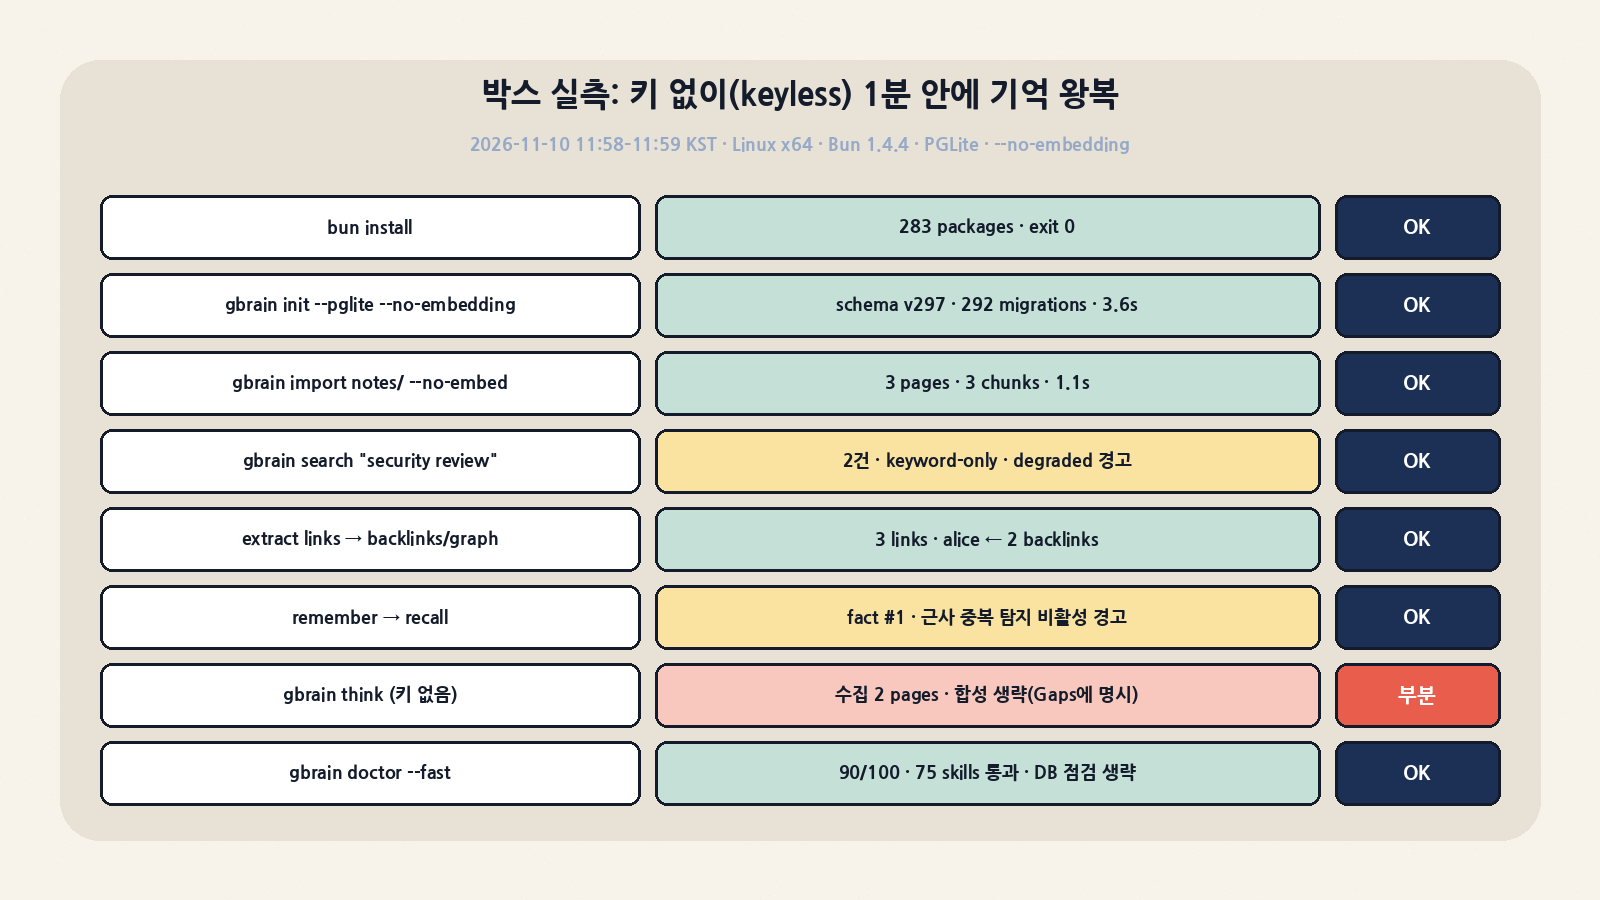
2026-11-10 11:58–11:59 KST, Linux x64 박스에서 저장소 HEAD(f2a40ba3, CLI가 gbrain 0.60.634.0 보고)를 클론해 bun run src/cli.ts로 돌렸습니다. API 키는 하나도 설정하지 않았고, GBRAIN_HOME을 작업 폴더로 격리했습니다. 테스트 데이터는 README 예시를 본뜬 3장짜리 노트(사람 1, 회사 1, 회의 1, 서로 [[slug]]로 연결)입니다. 아래는 실제 출력 그대로입니다.
| 단계 | 명령 | 결과 | 소요 |
|---|---|---|---|
| 의존성 | bun install |
283 packages, exit 0 (락파일 캐시 상태) | <1s |
| 초기화 | init --pglite --no-embedding |
schema v297, 마이그레이션 292개 적용, 스키마 팩 gbrain-base-v2, 검색 모드 conservative 자동 선택(키·reranker 없음) | 3,567ms |
| 임포트 | import notes/ --no-embed |
3 pages, 3 chunks, 오류 0 | 1,086ms |
| 검색 | search "security review" --json |
2건(people/alice-example 0.476, meetings/… 0.436), evidence·create_safety·trust_tier 필드 포함, “degraded: embed_unavailable” 경고 |
744ms |
| 그래프(추출 전) | backlinks / graph |
빈 배열 — 대량 import만으로는 엣지가 생기지 않음 | ~0.5s |
| 링크 추출 | extract links --source db |
3 pages에서 links 3개 생성 | 640ms |
| 그래프(추출 후) | backlinks people/alice-example |
2건(companies, meetings), link_type mentions, context 문장 포함; graph --depth 2에서 acme ↔ alice 양방향 |
~0.5s |
| 기억 | remember → recall |
fact #1 저장, recall에서 conf 1.00으로 회수. 임베딩 없어 “정확히 같은 문장만 중복 탐지” 경고 | 1,112ms / 390ms |
| 합성 | think "what is open with alice?" |
수집은 2 pages 성공, LLM 키 없어 합성 생략 — 결과의 Gaps 섹션에 이유 명시, exit 0 | 612ms |
| 헬스 | doctor --fast |
90/100, skill 75/75 통과, 236개 번들 파일 lock 일치, DB 점검은 fast 모드라 생략 | 854ms |
체감 포인트는 세 가지였습니다. 첫째, 키 없이도 핵심 루프(임포트·키워드 검색·그래프·사실 기억)는 1분 안에 끝까지 돕니다. 데이터 디렉터리는 66MB. 둘째, 출력이 사람보다 에이전트에게 말을 거는 형식입니다. [AGENT] why: ... 블록으로 “검색이 degraded이니 빈 결과를 ‘없음’으로 보고하지 말라”, “모드를 운영자에게 물어보라”처럼 행동 지침을 붙입니다. 셋째, 문서와 실제 동작 사이에 함정이 하나 있었습니다. README는 auto-linking이 켜진 “trusted local page write”에서 링크가 추출된다고 쓰지만, import로 넣은 페이지는 extract links를 따로 돌려야 엣지가 생겼습니다. 대량 이관 후에는 꼭 확인하세요. 임베딩·reranker·think 합성은 키가 필요해 이번에는 검증하지 않았습니다.
9. 비슷한 도구와 비교
| 도구 | 성격 | 정본(source of truth) | 강점 | GBrain과의 차이 |
|---|---|---|---|---|
| GBrain | 에이전트 외장 기억 + 지식 그래프 + 유지보수 데몬 | Markdown 파일 (DB는 재구축 가능한 인덱스) | facts/takes 분리, 정정·철회, 31단계 cycle, MCP 공유 | — |
| mem0 | LLM 앱용 메모리 레이어 SDK/서비스 | 벡터(+선택적 그래프) 스토어 | 앱 코드에 몇 줄로 붙는 API | GBrain은 파일 정본·개인 지식베이스 지향, SDK보다 운영 도구에 가까움 |
| Letta (구 MemGPT) | 상태 있는 에이전트 런타임 | 에이전트 서버 DB의 메모리 블록 | 에이전트가 자기 메모리를 편집하는 루프 | GBrain은 런타임이 아니라 “기존 에이전트에 붙이는” 계층 |
| Zep / Graphiti | 시간성 지식 그래프 메모리 | 그래프 DB | 시점별 사실 유효성, 엔티티 해석 | GBrain도 valid_from/until을 갖지만 Postgres 하나로 그래프·벡터·키워드를 처리 |
| claude-mem 류 | 코딩 세션 자동 캡처·압축 | 세션 로그 요약 | 설치 즉시 세션 연속성 | GBrain은 자동 캡처가 opt-in, 명시적 사실·출처 우선 |
| Obsidian + 플러그인 | 사람용 노트 + 의미 검색 | Markdown 볼트 | 편집 UX, 생태계 | GBrain은 같은 Markdown 위에 에이전트용 API·그래프·cycle을 얹음(볼트 이관 대상) |
선택 기준을 한 줄로 줄이면, 앱에 메모리 API를 넣고 싶다면 mem0/Zep, 에이전트 자체를 새로 만들 거라면 Letta, 이미 쓰는 여러 에이전트에 하나의 출처 있는 기억을 공유시키고 그 원본을 Markdown으로 소유하고 싶다면 GBrain입니다.
10. 트레이드오프와 한계
| 영역 | 내용 | 대응 |
|---|---|---|
| 복잡도 | 코드 80만 줄, 명령 200줄 넘는 help, 마이그레이션 292개. 단순 메모리 도구를 기대하면 과합니다 | serve --surface starter(memory verbs만)로 시작 |
| 릴리스 속도 | 하루 태그 5개. 내부 API·스키마가 자주 바뀜 | stable 채널 유지, 업그레이드 전 gbrain doctor --json |
| 비용 | 키리스는 무료지만 임베딩·reranker·synthesis·dream cycle은 API 과금 | init이 출력하는 모드별 월 비용표로 사전 추정, conservative |
| 데이터 유출 경로 | 설정한 임베딩·리랭커·합성 제공자로 텍스트가 나가고, 하네스 모델은 키리스에서도 회상 내용을 봄 | docs/guides/memory-boundaries.md 확인, visibility:"private" |
| 공유 경계 | 로컬 파일·공유 DB 자격증명 보유자는 source만으로 격리되지 않음 | 회사 뇌는 원격 OAuth 클라이언트 + RLS 구성 |
| 백업 | Markdown export는 완전한 백업이 아님(DB 전용 페이지, 미해결 사실, 이력) | DB 백업 별도 구성 |
| 설치 함정 | npm 동명 패키지, Bun 최소 버전 1.4.4 | GitHub 경로로만 설치, bun --version 확인 |
| 벤치마크 해석 | LongMemEval·BrainBench 수치는 프로젝트 자체 측정, 검색 단계 한정 | gbrain eval longmemeval ... --retrieval-only로 재현 |
11. 누가 쓰면 좋은가
| 상황 | 권장 | 이유 |
|---|---|---|
| Claude Code·Codex·Cursor를 섞어 쓰는 개발자 | 강력 추천 (키리스 시작) | 하네스를 바꿔도 같은 사실·결정 기록이 따라옴 |
| 미팅·메일·연락처가 많은 창업자·투자자·영업 | 추천 (임베딩+synthesis) | people/companies 스키마와 think의 Gaps가 정확히 이 용도 |
| Obsidian/Notion 볼트를 가진 지식 노동자 | 추천 | Markdown 정본 유지, schema detect/suggest로 기존 폴더 구조 학습 |
| 10–50명 팀의 사내 지식 | 조건부 | Postgres+OAuth 구성과 공유 경계 검토 필요(튜토리얼 약 90분) |
| 앱에 메모리 API만 필요한 제품팀 | 비추천 | 운영 도구 성격이 강해 SDK형 대안이 가벼움 |
| 오프라인·폐쇄망 | 가능 | Ollama·llama.cpp 임베딩, llama-server reranker 레시피로 로컬 구성 |
정리
GBrain의 진짜 기여는 “벡터 검색 하나 더”가 아닙니다. 기억을 Markdown 정본 + 출처 있는 사실 + 정정 가능한 믿음 + typed 그래프로 나누고, 그 위에서 검색 품질을 자체 벤치마크로 깎아 온 설계입니다. 박스 실측에서 확인했듯 키 없이도 1분이면 기억 왕복이 되니, 우선 GBRAIN_HOME을 격리해 자기 노트 몇 장으로 돌려 보고 extract links와 doctor까지 확인한 다음에 임베딩·reranker·autopilot을 단계적으로 켜는 순서를 권합니다. 다만 하루에 다섯 번 릴리스되는 저장소라는 점, 공유 시 격리 경계는 문서가 스스로 밝힌 만큼만 믿어야 한다는 점은 잊지 마세요.