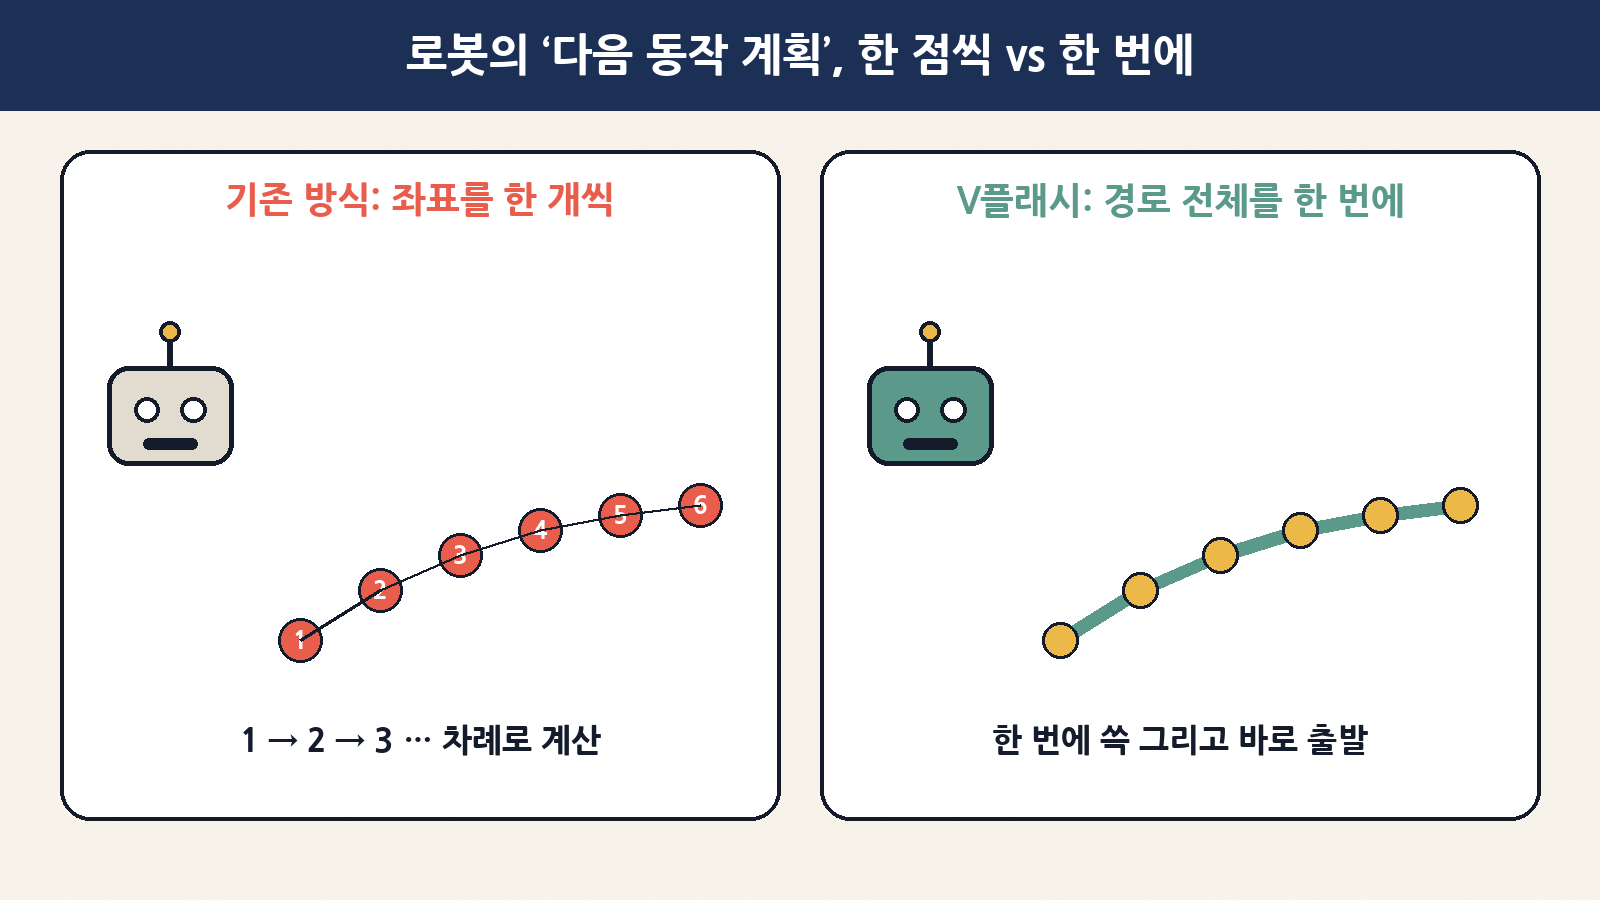
로봇에게 “서랍 열어 줘”라고 말하면, 로봇은 바로 손을 뻗지 않습니다. 먼저 머릿속으로 ‘손을 여기서 저기로, 이런 길로 움직이자’는 계획을 세웁니다. 그런데 요즘 로봇 두뇌로 쓰이는 AI는 이 길을 점 하나씩, 순서대로 적어 내려가는 버릇이 있어서 생각이 느렸습니다. 엔비디아가 지난 11월 6일(현지시간) 이 길을 한 번에 통째로 그리게 해서, 계산 시간을 최대 5배가량 줄였다는 연구 ‘V플래시(VFlash)’를 공개했습니다.
오늘은 이 소식을 계기로 로봇 AI가 ‘계획’을 어떻게 세우는지, 왜 한 점씩 적으면 느리고 틀리기 쉬운지, V플래시는 무엇을 바꿨는지, 그리고 발표된 숫자를 어떻게 읽어야 과장 없이 이해할 수 있는지까지 하나씩 쉽게 풀어 보겠습니다.
한눈에 보는 핵심 요약
| 항목 | 내용 |
|---|---|
| 무엇이 나왔나 | 로봇·자율주행 AI가 ‘움직일 경로’를 더 빨리, 더 정확하게 계획하게 하는 새 계산 방식 V플래시(VFlash) |
| 누가, 언제 | 엔비디아 연구진, 2026년 11월 6일(현지시간) 연구 페이지·기술 보고서 공개 |
| 핵심 아이디어 | 좌표를 한 개씩 차례로 쓰지 않고, 경로 전체를 한 번에 예측 |
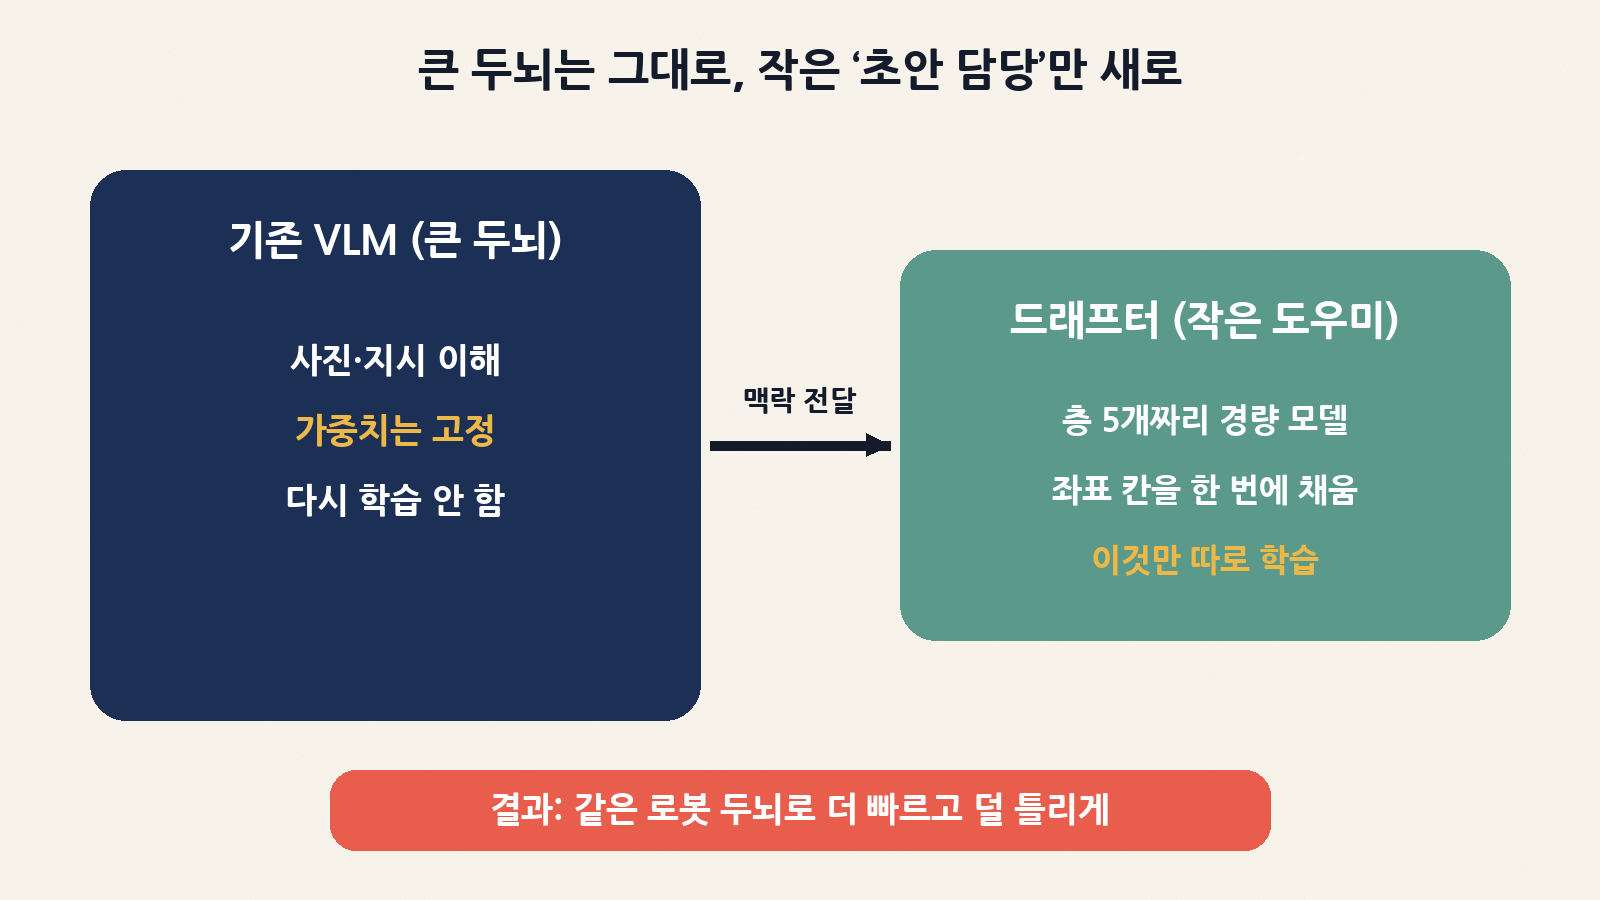
| 어떻게 | 기존 큰 AI는 그대로 두고, 층 5개짜리 작은 ‘초안 담당(드래프터)’만 새로 학습 |
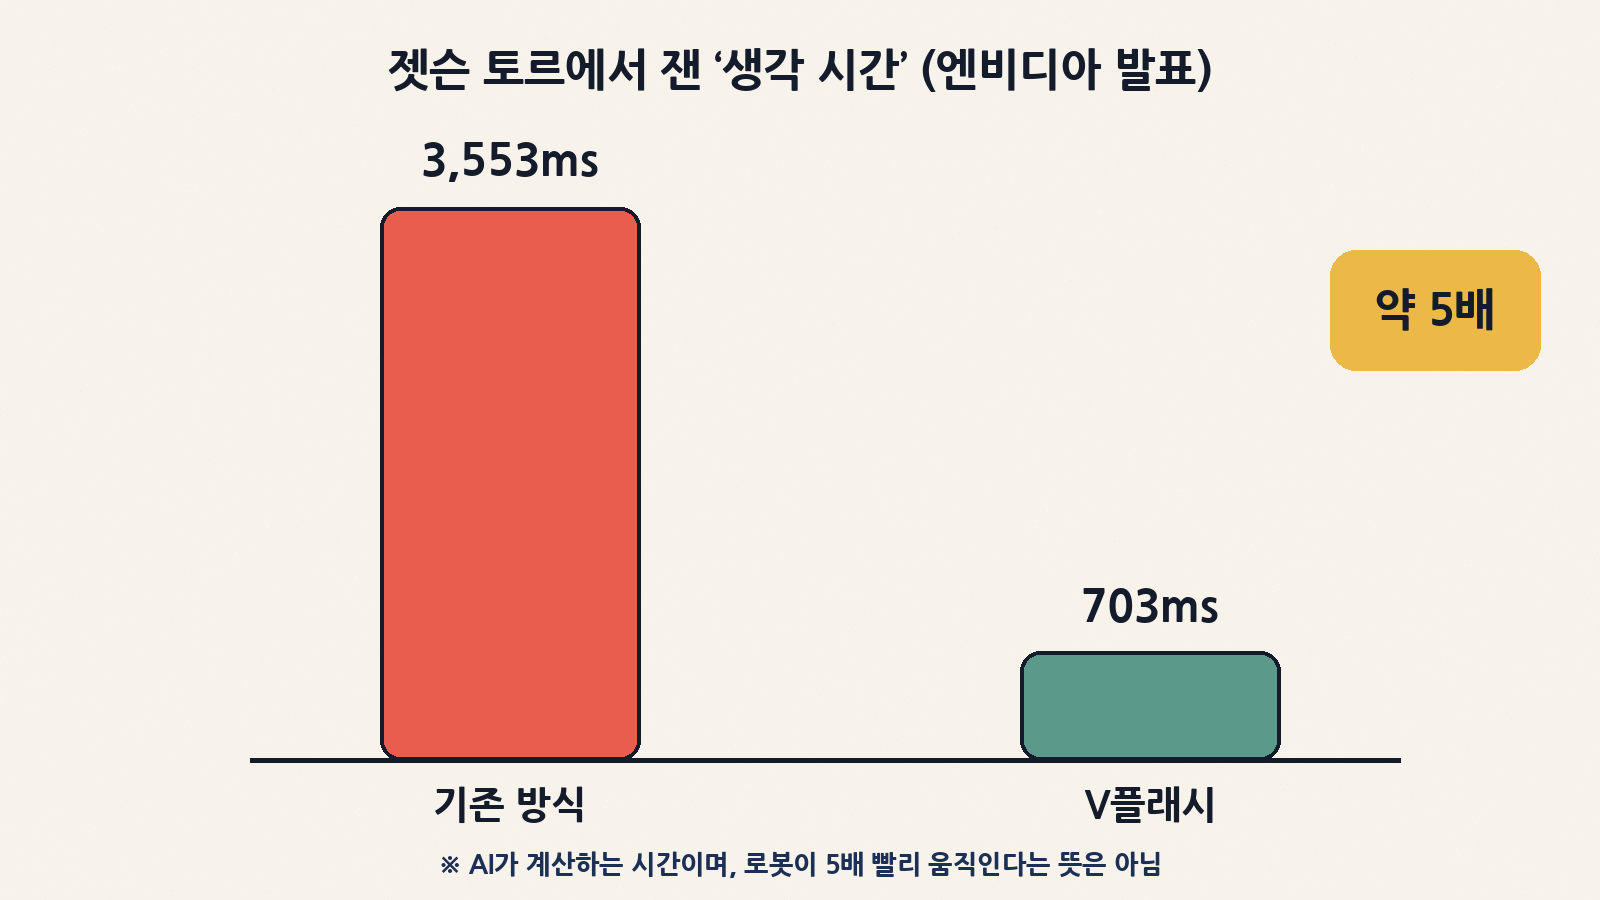
| 대표 숫자 | 젯슨 토르에서 3,553ms → 703ms(약 5배), 3D 경로 오차 평균 42.6%·최대 61% 감소, 로봇 작업 성공률 62.6% → 70.2% |
| 지금 써 볼 수 있나 | 코드는 깃허브에 공개(아파치 2.0), 학습된 모델 파일은 “추후 공개”. 일반 소비자 제품은 아님 |
먼저, 로봇 AI는 계획을 어떻게 세울까요?
요즘 로봇의 ‘두뇌’ 역할을 하는 AI는 VLM(비전언어모델, Vision-Language Model)이라는 종류가 많습니다. 이름이 어렵지만 뜻은 간단합니다. 사진(눈)과 말(귀)을 함께 이해하는 AI예요. 챗GPT에 사진을 올리고 “이거 뭐야?” 하고 묻는 것과 비슷한 능력이, 로봇 안에서는 카메라 화면과 사람의 지시를 함께 이해하는 데 쓰입니다.
이 AI가 로봇에게 내려 주는 계획은 보통 세 가지 모양입니다.
| 계획의 모양 | 쉬운 설명 | 예시 |
|---|---|---|
| 점(Point) | “여기”를 콕 찍기 | 컵 손잡이의 위치 |
| 상자(Bounding Box) | 물건 둘레에 네모 그리기 | 사진 속 사과 3개에 각각 네모 |
| 경로(Trajectory) | 점들을 이어 “이 길로 가자” 선 긋기 | 로봇 팔이 서랍 손잡이까지 가는 길, 자율주행차가 차선을 바꾸는 길 |
문제는 이 좌표들을 AI가 글자 쓰듯이 만든다는 점입니다. 챗GPT가 답변을 한 단어씩 이어서 쓰는 것처럼, 로봇 AI도 “첫 번째 점 → 두 번째 점 → 세 번째 점…” 하고 한 칸씩 차례로 적습니다. 이런 방식을 전문 용어로 자기회귀(Autoregressive) 방식이라고 부릅니다.
한 점씩 적으면 뭐가 문제일까요?
쉽게 비유하면, 친구에게 길을 알려 줄 때 지도를 보여 주지 않고 “100m 가서, 잠깐만, 그다음 오른쪽, 잠깐만…” 하고 한 마디씩 끊어 말하는 것과 비슷합니다. 문제는 두 가지입니다.
- 느립니다. 경로가 길어지거나 물건이 많아질수록 적어야 할 좌표 수가 늘어나고, 그만큼 계산을 여러 번 반복해야 합니다. 로봇은 주변이 바뀔 때마다 계획을 다시 세워야 하므로 이 시간이 쌓이면 반응이 굼떠집니다.
- 실수가 번집니다. 앞에서 한 점을 살짝 잘못 찍으면, 뒤의 점들은 그 잘못된 점을 기준으로 이어지기 때문에 오차가 점점 커질 수 있습니다.
V플래시는 무엇을 바꿨나요?
엔비디아 연구진이 눈여겨본 것은 “경로나 상자에는 정해진 모양이 있다”는 사실입니다. 상자는 늘 꼭짓점 좌표 몇 개로 이뤄지고, 로봇 팔 경로는 “점 32개짜리 선”처럼 길이와 구조를 미리 정할 수 있습니다. 빈칸의 개수와 모양을 미리 알면, 한 칸씩 채울 필요 없이 빈칸 전체를 한꺼번에 채울 수 있겠죠. 이것이 연구진이 ‘플래시 프리미티브 디코딩(Flash Primitive Decoding)’이라고 부르는 방법입니다.
구체적으로는 이렇게 움직입니다.
| 단계 | 하는 일 | 비유 |
|---|---|---|
| ① 이해 | 기존 큰 AI(VLM)가 카메라 화면과 지시(“서랍 열어 줘”)를 읽고 상황을 파악 | 선배가 현장을 보고 상황 설명 |
| ② 틀 정하기 | “점 32개짜리 경로를 그리자”처럼 결과물의 길이와 모양을 먼저 선언 | 빈 양식지 꺼내기 |
| ③ 한 번에 초안 | 층 5개짜리 작은 AI ‘드래프터’가 모든 좌표 칸을 한 번의 계산으로 채움 | 후배가 양식을 한 번에 작성 |
| ④ 행동으로 | 완성된 계획을 큰 AI가 받아 다음 행동(로봇 팔 제어)으로 연결 | 선배가 확인하고 작업 지시 |
여기서 재미있는 점이 하나 있습니다. 원래 비슷한 기술(추측 디코딩, Speculative Decoding)은 작은 AI가 초안을 쓰면 큰 AI가 “내가 썼을 답과 글자 하나하나까지 똑같은지” 검사했습니다. V플래시는 경로나 점에 대해서는 이 엄격한 검사를 하지 않습니다. 큰 AI와 똑같이 쓰는 것보다, 실제 정답 경로(사람이 표시해 둔 데이터)에 가까운 것이 더 중요하다고 봤기 때문입니다. 그래서 작은 드래프터가 오히려 큰 AI보다 더 정확한 경로를 그리는 결과도 나왔습니다.
단, 모든 것을 무검사로 통과시키지는 않습니다. “다음엔 손잡이를 잡는다” 같은 글로 된 계획은 큰 AI가 검사하고, 물건 둘레의 상자는 자신 없는 좌표만 예전 방식으로 다시 계산하는 안전장치를 뒀습니다.
또 하나의 장점: 큰 두뇌를 다시 가르칠 필요가 없다
V플래시는 기존 큰 AI의 가중치(AI가 배운 지식이 저장된 숫자)를 그대로 얼려 두고, 작은 드래프터만 따로 학습시킵니다. 회사에 비유하면 베테랑 팀장을 새로 교육하는 대신, 양식을 빠르게 채우는 신입 한 명만 뽑아 훈련시키는 셈입니다. 이미 잘 돌아가는 로봇 두뇌를 처음부터 다시 학습시키는 데 드는 큰 비용을 피할 수 있다는 점이 실용적인 장점으로 꼽힙니다.
숫자로 보는 V플래시 (엔비디아 발표 기준)
| 항목 | 기존 방식 | V플래시 | 쉽게 말하면 |
|---|---|---|---|
| 젯슨 토르 추론 시간 | 3,553ms(약 3.6초) | 703ms(약 0.7초) | 생각하는 시간이 약 5분의 1 |
| 전체 AI 추론 속도(젯슨 토르·DGX 스파크) | 기준 | 최대 5.1~5.2배 | 로봇용 소형 컴퓨터에서도 효과 |
| 3D 로봇 경로 평균 오차 | 기준 | 평균 42.6%↓, 최대 61%↓ | 팔이 엉뚱한 곳으로 덜 감 |
| 예: 인턴A1 벤치마크 평균 오차 | 0.130m(13cm) | 0.060m(6cm) | 오차가 절반 이하 |
| 로봇 조작 평균 성공률(MolmoSpaces 4종) | 62.6% | 70.2% | 10번 중 약 6번 → 7번 성공 |
| 물건 상자 찾기 속도(H100 1장, Dense200) | 초당 6.73개 | 초당 17.46개 | 약 2.6배 빠르게 네모 그리기 |
여기서 젯슨 토르(Jetson Thor)는 로봇 몸 안에 넣는 엔비디아의 소형 AI 컴퓨터이고, DGX 스파크(DGX Spark)는 책상 위에 올려 쓰는 개인용 AI 컴퓨터입니다. 거대한 데이터센터가 아니라 로봇에 실제로 들어가는 크기의 기기에서 빨라졌다는 점이 이번 발표에서 강조된 부분입니다.
그런데, 모든 게 좋아진 건 아닙니다
엔비디아가 공개한 상세 결과를 보면 솔직한 부분도 있습니다. 초보자도 꼭 알아 두면 좋은 대목입니다.
| 분야 | 결과 | 의미 |
|---|---|---|
| 일반 사진 속 물건 찾기(COCO) | 정확도 48.68% → 47.79%로 소폭 하락, 대신 속도는 약 2.8배 | 속도와 정확도를 조금 맞바꾼 경우 |
| 장면 속 점들의 3D 움직임 예측(HOT3D·WorldTrack) | 일부 지표는 기존 방식이 더 좋음 | 모든 과제에서 이기는 ‘만능’은 아님 |
| 5배 빨라졌다는 숫자 | AI 모델의 계산 시간 기준 | 로봇이 물리적으로 5배 빨리 움직이거나 일을 5배 빨리 끝낸다는 뜻은 아님 |
그래서 우리 생활과는 무슨 상관일까요?
당장 내일 집에 오는 로봇청소기가 바뀌는 이야기는 아닙니다. 다만 흐름은 분명합니다. 로봇과 자율주행차가 사람처럼 “보고, 이해하고, 움직이는” 이른바 피지컬 AI(Physical AI)에서 가장 큰 숙제 중 하나가 ‘생각이 느리다’는 점이었습니다. 0.7초와 3.6초의 차이는, 공장 로봇 팔이 옆으로 굴러온 물건에 맞춰 계획을 다시 세우거나 자율주행차가 갑자기 끼어든 차를 피해 경로를 고칠 때 체감될 수 있는 차이입니다.
- 공장·물류 로봇: 상자 위치가 매번 달라도 더 자주 계획을 고쳐 가며 움직일 수 있습니다.
- 자율주행: 엔비디아는 웨이모 관련 평가와 NAVSIM에서도 성능을 유지하며 계산 지연을 줄였다고 밝혔습니다.
- 가정용 로봇: 값비싼 대형 컴퓨터 없이 로봇 안의 작은 컴퓨터로도 똑똑한 계획을 세우는 데 도움이 될 수 있습니다.
발표 숫자를 읽을 때 꼭 볼 3가지
| 질문 | V플래시의 경우 |
|---|---|
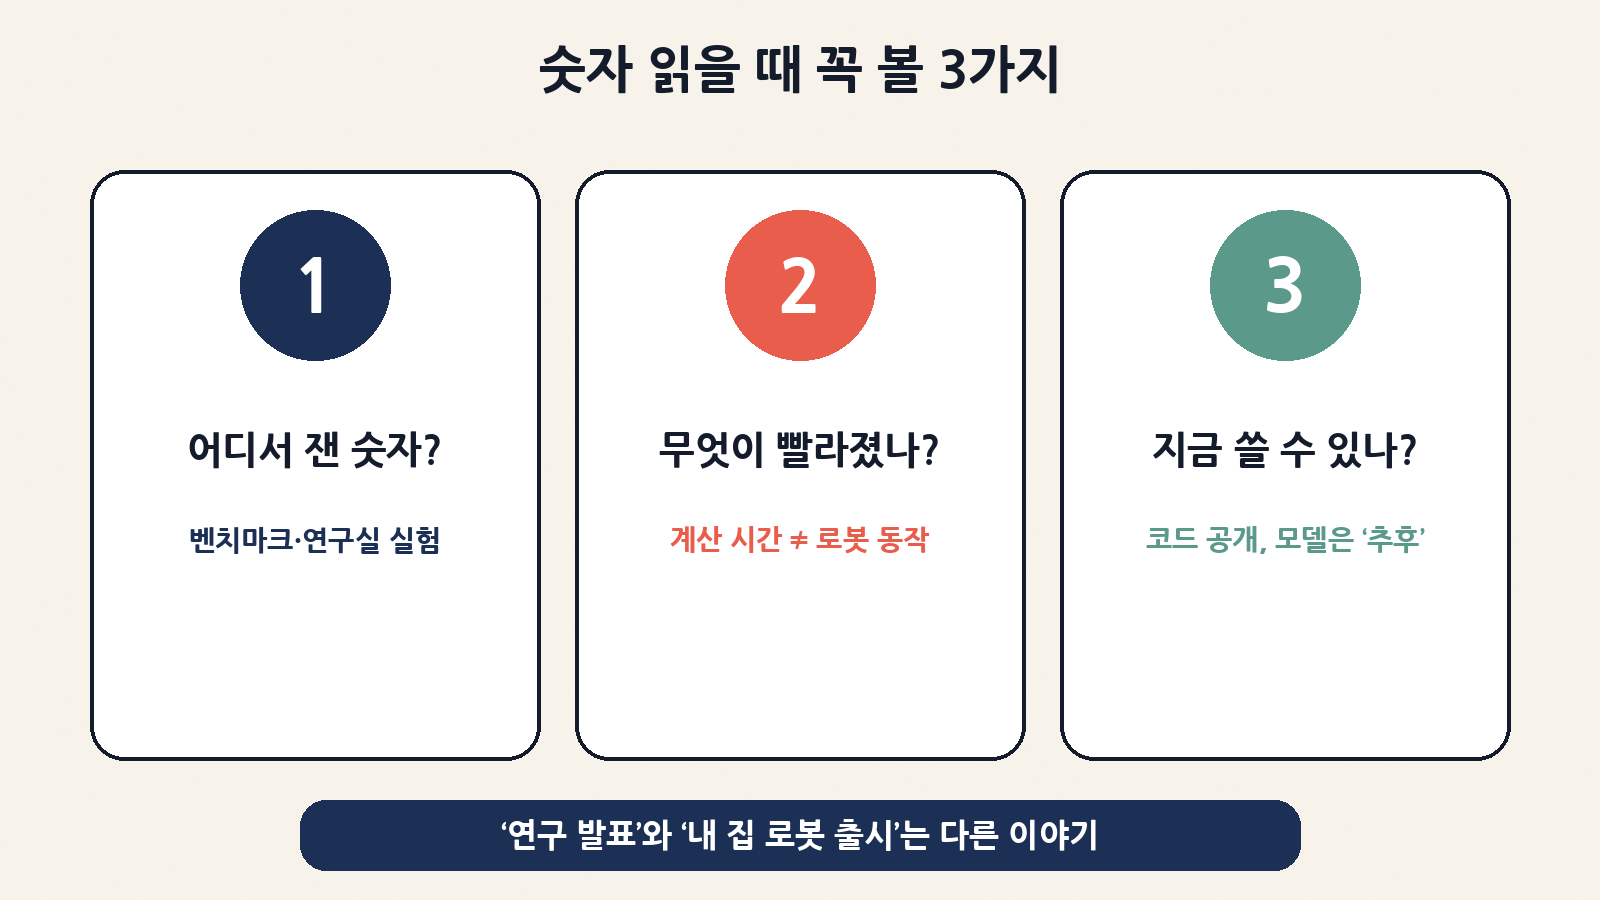
| ① 어디서 잰 숫자인가? | 엔비디아 연구진이 직접 정한 벤치마크와 실험 환경. 다른 연구자가 똑같이 재현했는지는 아직 확인 전 |
| ② 무엇이 빨라졌나? | ‘AI가 계획을 계산하는 시간’. 로봇 동작 속도나 작업 완료 시간과는 다름 |
| ③ 지금 쓸 수 있나? | 연구 코드는 엔비디아 ‘이글(Eagle)’ 깃허브 저장소에 아파치 2.0으로 공개. 하지만 학습을 끝낸 모델 파일은 “추후 공개” 예정이라, 지금은 직접 학습시켜야 함(대형 GPU 여러 대 필요) |
이 세 가지는 V플래시뿐 아니라 앞으로 “AI가 몇 배 빨라졌다”, “오류가 몇 % 줄었다”는 기사를 볼 때마다 써먹을 수 있는 습관입니다. 특히 “무엇이” 빨라졌는지를 확인하는 것만으로도 과장된 기대를 꽤 걸러 낼 수 있습니다.
자주 묻는 질문
Q. V플래시는 새로운 로봇인가요?
아닙니다. 로봇 두뇌 AI가 답(계획)을 만들어 내는 방법을 바꾼 기술입니다. 기존 AI에 덧붙이는 방식이라 특정 로봇 제품 이름이 아닙니다.
Q. 챗GPT 같은 채팅 AI도 빨라지나요?
V플래시는 좌표·경로처럼 모양이 정해진 결과물에 특화된 방법입니다. 일반 대화 문장에는 기존 추측 디코딩처럼 큰 AI가 검사하는 방식을 그대로 씁니다. 채팅 AI가 갑자기 5배 빨라지는 이야기는 아닙니다.
Q. 작은 AI가 큰 AI보다 정확하다는 게 말이 되나요?
작은 드래프터는 큰 AI를 흉내 내도록 배운 게 아니라 사람이 표시한 정답 경로로 따로 배웠습니다. 또 경로를 한 번에 그리니 앞 점의 실수가 뒤로 번지는 문제도 줄었습니다. 다만 앞서 본 것처럼 모든 과제에서 그런 것은 아닙니다.
마무리: ‘한 줄씩’에서 ‘한 번에’로
정리하면, V플래시는 로봇 AI가 움직일 길을 점 하나씩 받아쓰듯 적던 방식에서 양식을 펴 놓고 한 번에 그리는 방식으로 바꾼 연구입니다. 큰 두뇌는 그대로 두고 작은 도우미만 붙였다는 점에서 실용적이고, 엔비디아 발표 기준으로 계산 시간은 약 5분의 1, 경로 오차는 평균 40% 넘게 줄었습니다. 물론 아직은 연구 단계이고 모델 파일도 공개 전이니, “로봇이 당장 5배 빨라진다”가 아니라 “로봇이 더 자주, 더 빨리 생각을 고칠 수 있는 길이 하나 더 열렸다” 정도로 이해하시면 딱 좋겠습니다.