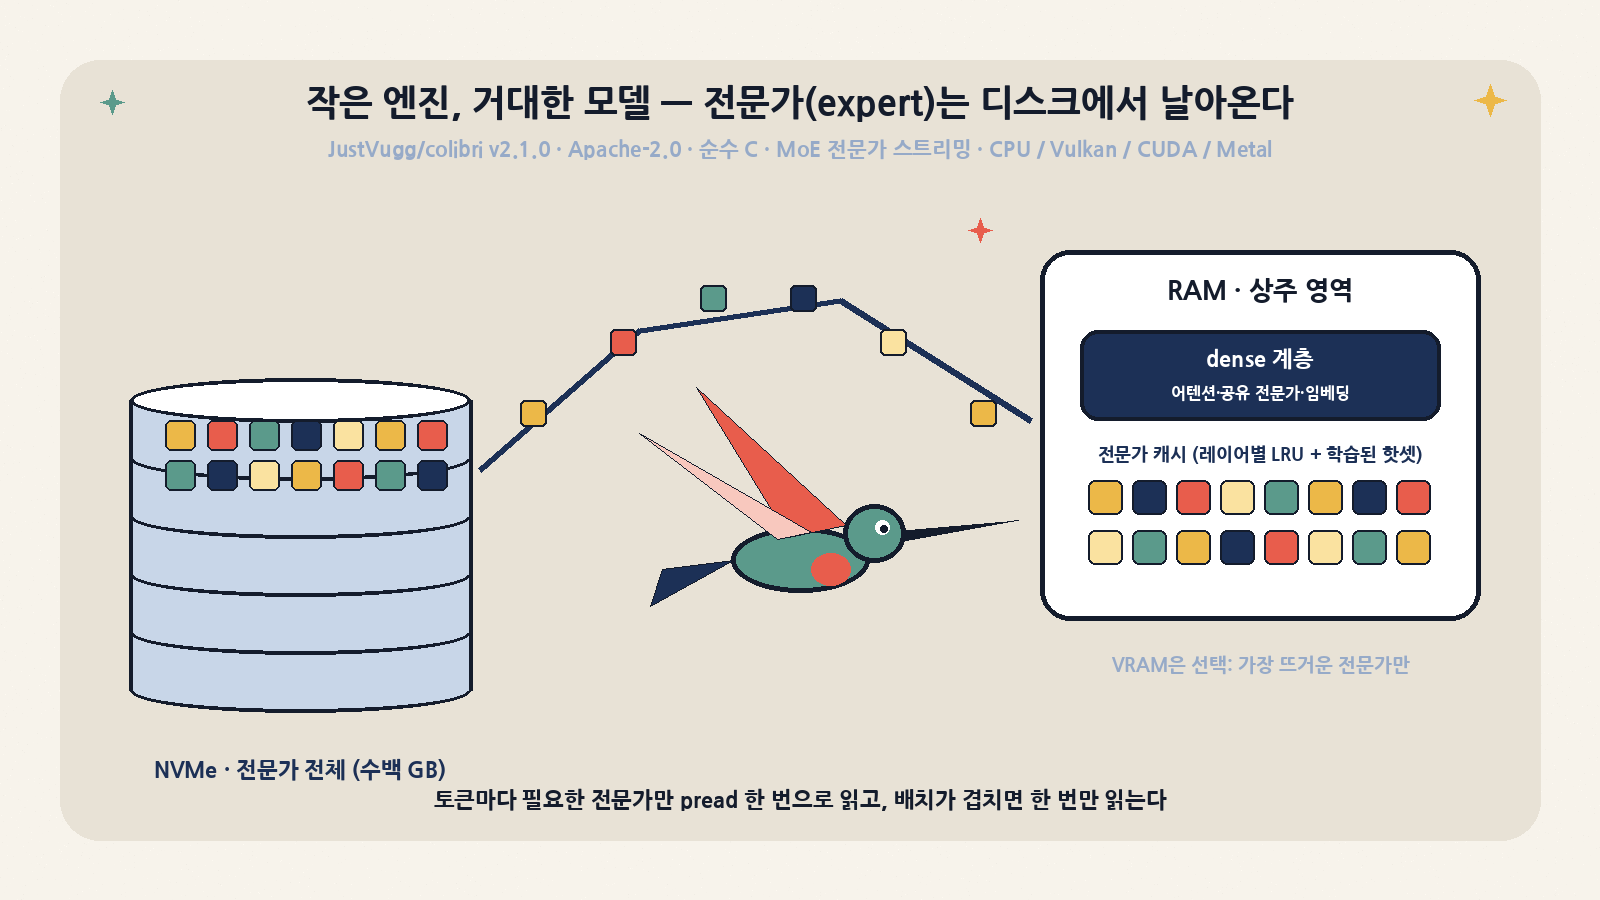
한 줄 요약: JustVugg/colibri(Apache-2.0, 최신 v2.1.0)는 수천억 개 파라미터짜리 MoE(Mixture-of-Experts) 모델을 “다 메모리에 올릴 수 있느냐”가 아니라 “어디에 놓느냐”의 문제로 바꿔 놓은 순수 C 추론 엔진입니다. 토큰마다 항상 쓰이는 dense 부분(어텐션·공유 전문가·임베딩)만 RAM에 두고, 라우팅 전문가는 디스크에 둡니다. 라우터가 부를 때만 읽고, 캐시는 사용자의 실제 라우팅 기록으로 점점 똑똑해집니다. 오늘(2026-11-03 KST) GitHub Trending 전체 10위(+675★), 누적 46,794★입니다.
이 글은 입문서가 아닙니다. README, docs/, CHANGELOG, 소스(c/olmoe.c 등)를 대조해 설계와 그 대가를 정리했습니다. 그리고 GPU 없는 8코어·16GB 박스에서 OLMoE-1B-7B GGUF로 캐시 슬롯(–cap)만 바꾸는 실측을 직접 돌렸습니다. 표에 “개발팀 측정”이라고 적힌 수치는 저장소 문서의 값이고, “박스 실측”은 이 글을 쓰며 직접 잰 값입니다.
1. 한눈에 보기
| 항목 | 내용 (2026-11-03 KST 확인) |
|---|---|
| 저장소 | JustVugg/colibri (2026-07-01 생성, 저작권자 Vincenzo Fornaro) |
| 라이선스 | Apache-2.0 (LICENSE·NOTICE·GitHub API 일치). 모델 가중치는 각 모델의 라이선스를 따름(예: Qwen-Image-2.1은 비상업) |
| 최신 릴리스 | v2.1.0, 2026-10-31 21:50 KST. v2.0.0 이후 PR 387개, 그중 208개가 기여자 35명의 것(CHANGELOG) |
| 스타·포크 | 46,794★ / 5,402 포크 (16:5x KST, API). 17:03 KST 재조회 46,801★. 열린 이슈·PR 155개 |
| 트렌딩 | GitHub Trending 전체 일간 10위, 오늘 +675★ |
| 언어·규모 | C 엔진 + Python 런처·설치·게이트웨이. c/ 아래 .c·.h 합계 약 19.9만 줄, .py 약 2.6만 줄, Vulkan 셰이더(.comp) 59개, CUDA(.cu) 33개 (박스 집계, 커밋 0a5504a1) |
| 엔진 | 13종: 언어 모델 10(GLM-5.2/5.3·Mistral-Large-4, GLM-5.3-Flash, Inkling, Kimi K3, DeepSeek V4/V4.1 Flash, MiMo-V2.6, Qwen3.8-Flash-Next, Qwen3.6 계열, OLMoE), 이미지 1(Qwen-Image-2.1), 결정 모델 2(Laya, GLiNER2.5-Decide) |
| 백엔드 | CPU(기본, 필수), Vulkan 1.2(모든 GPU), CUDA(NVIDIA), Metal(Apple Silicon), 실험적 AMD XDNA NPU |
| API | OpenAI 호환(/v1/chat/completions 등), Anthropic 호환(/v1/messages), 결정 전용 /v1/systemone, MCP 서버(coli mcp) |
| 최소 사양(README) | RAM 8GB(16GB 이상 권장), 가장 작은 모델 기준 디스크 22GB. GPU는 선택 |
2. 왜 이게 되는가: MoE는 “디스크에선 거대하고, 토큰당으론 작다”
README가 드는 기준 모델은 GLM-5.2입니다. 전체 744B 파라미터 중 토큰 하나가 쓰는 것은 약 40B(5.4%)이고, 그중 토큰과 토큰 사이에 실제로 바뀌는 것은 라우팅 전문가 약 11GB뿐이라고 설명합니다. 그러니 모델을 빠른 메모리에 통째로 담을 필요는 없고, 잘 배치하면 된다는 것이 colibri의 출발점입니다.
여기서 이 프로젝트의 핵심 계약이 나옵니다. “배치는 속도만 결정한다.” 전문가가 VRAM에서 왔든 RAM이나 디스크에서 왔든 라우터의 결정과 가중치 정밀도는 같아야 합니다. 메모리가 모자라면 느려질 뿐, 조용히 다른 모델이 되면 안 된다는 뜻입니다. 기본 정책은 정밀도나 라우터 의미를 몰래 바꾸지 않고, 출력이 달라지는 근사 모드(DEGRADE_ZERO, EXPERT_DROP 등)는 전부 명시적 옵트인입니다. 이 계약이 실제로 지켜지는지는 6장에서 직접 확인했습니다.
참고로 MoricWorld가 11월 2일 다룬 FreeToken은 “RAM이 원본, VRAM이 캐시”인 GPU 중심 서빙 엔진이었습니다. colibri는 한 단계 더 내려가 “디스크가 원본, RAM이 캐시, VRAM은 선택”인 CPU 우선 엔진입니다. 같은 MoE 희소성을 다루지만 다른 저장소이고, 겨냥하는 하드웨어도 다릅니다.
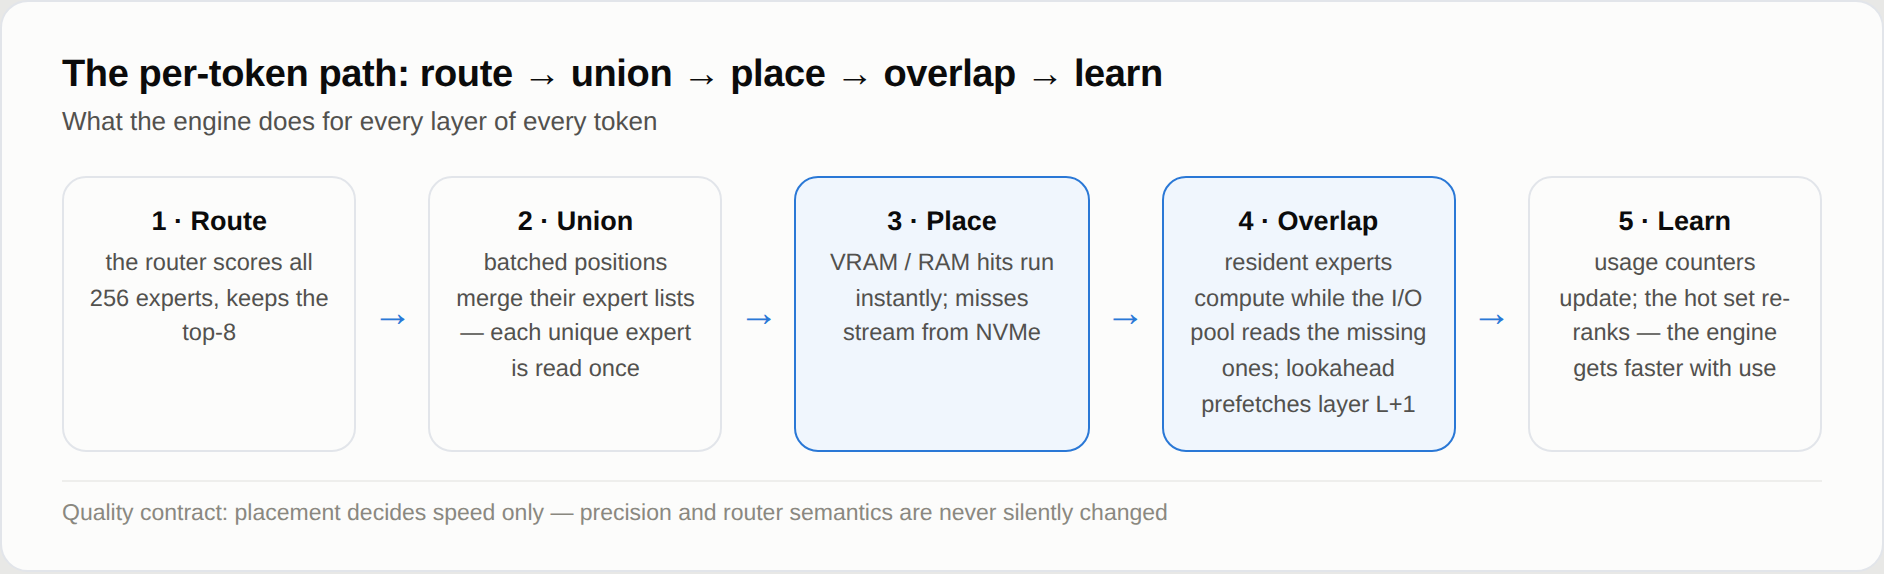
3. 아키텍처: 토큰 한 개가 레이어 하나를 지나는 다섯 단계
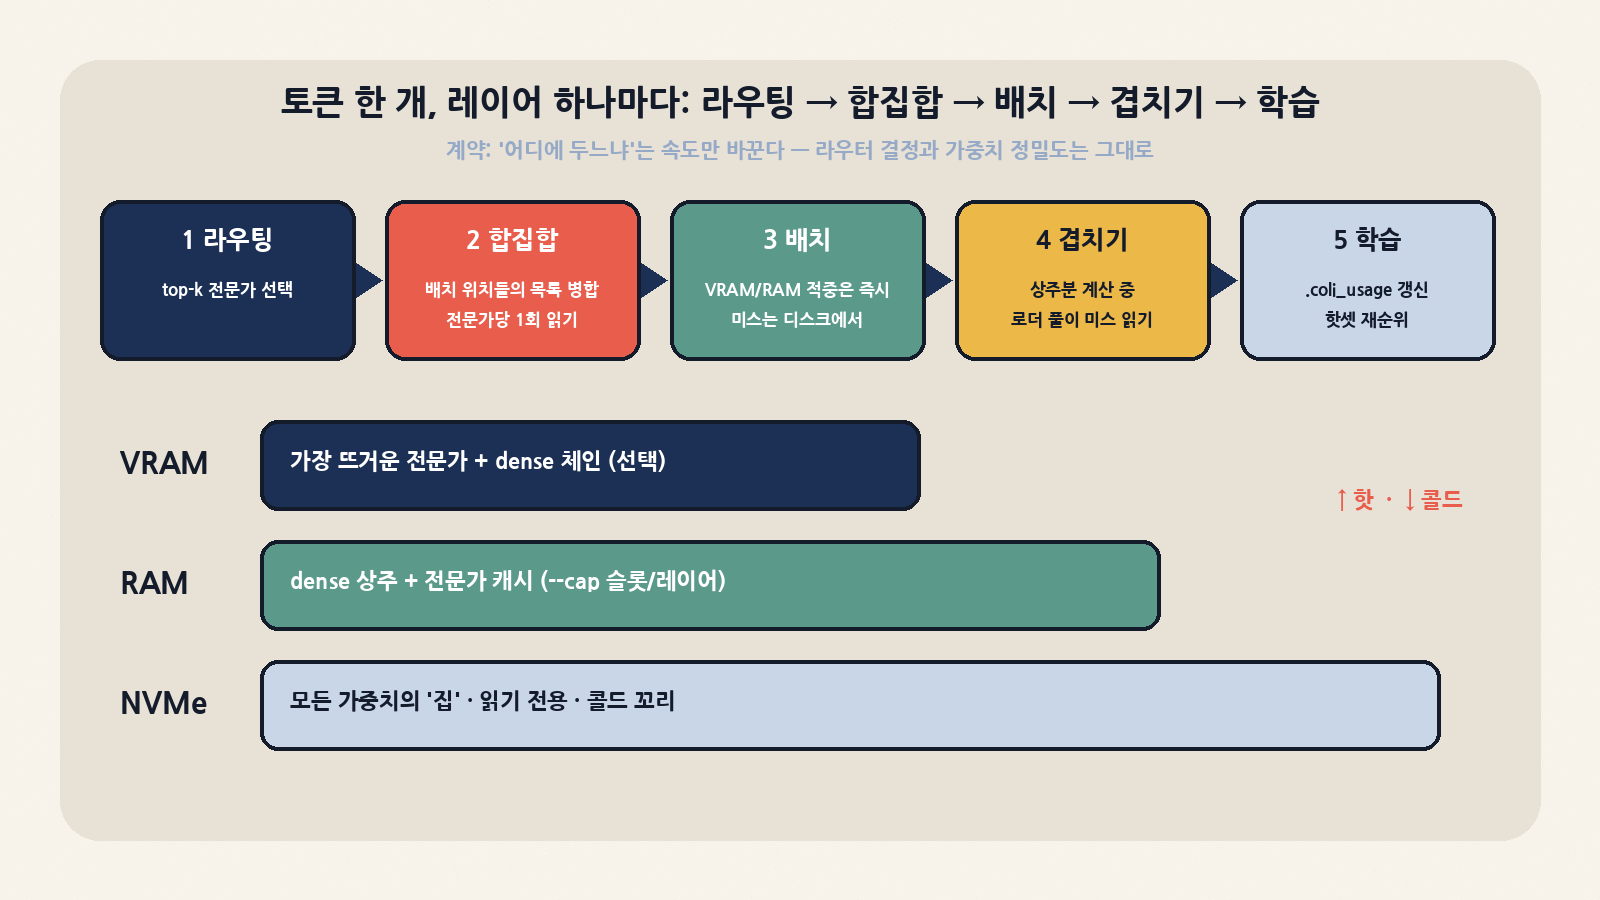
README의 “How it works”를 엔진 동작 순서로 다시 풀면 다음과 같습니다.
| 단계 | 하는 일 | 구현 포인트 / 수치(개발팀 측정) |
|---|---|---|
| 1. Route | 라우터가 전문가 점수를 매겨 top-k를 고름 | 라우터 의미는 배치와 무관하게 고정 |
| 2. Union | 배치 안 여러 위치의 전문가 목록을 합침 | 프롬프트·배치에서 같은 전문가는 한 번만 읽음 |
| 3. Place | VRAM·RAM 적중은 즉시 계산, 미스는 디스크에서 읽음 | 전문가의 세 행렬(gate·up·down)을 pread 한 번에 |
| 4. Overlap | 상주 전문가를 계산하는 동안 로더 풀이 미스를 읽음 | 라우터 lookahead 스레드가 다음 레이어를 프리페치. GLM-5.2 라우팅은 한 레이어 앞을 71.6% 예측 가능 |
| 5. Learn | 사용 카운터 갱신, 핫셋 재순위 | .coli_usage가 매 턴 갱신. 레이어별 LRU에 학습된 고정(pinned) 핫셋을 더함. “쓸수록 빨라진다” |
README는 이 구조를 “가중치용 JIT”라고 부릅니다. JIT 컴파일러가 프로그램 전체가 아니라 실행 중에 뜨거워진 경로만 컴파일하듯, 실제로 측정한 라우팅 열기가 어떤 전문가를 VRAM·RAM·디스크 중 어디에 둘지 정한다는 비유입니다. 이 방식이 통하는 이유는 라우팅에 측정 가능한 구조가 있기 때문입니다(저장소의 expert atlas 이슈 #175).
3-1. I/O 경로의 선택지
| 스위치 | 의미 | 주의 |
|---|---|---|
DIRECT=1 |
전문가 슬랩을 O_DIRECT로 읽음 | 드라이브마다 다름. 문서 표현으로 “빠른 NVMe에선 큰 이득, QLC·DRAM 없는 SSD·가상 디스크에선 중립이거나 손해”이니 직접 재야 함 |
URING=1 |
Linux io_uring 큐 기반 전문가 I/O | COLI_MMAP=1과 함께 못 씀. 커널이 막으면 명시적으로 실패 |
COLI_MODEL_MIRROR / COLI_MODEL_DIRS |
두 번째 드라이브의 복사본에서 읽기 / 샤드를 여러 드라이브에 나누기 | 독립 컨트롤러 NVMe 두 개로 디코드 +37.5%(개발팀). 느린 세 번째 드라이브는 효과 없었음 |
PIN_GB, AUTOPIN |
고정 핫셋의 크기, 사용 기록 5,000회 이상이면 자동 고정 | 자동 고정은 적응형 LRU 용량을 깎지 않게 상한이 있음 |
DEGRADE_ZERO |
게이트 가중치가 낮은 미스 슬롯을 0으로 채움 | 출력이 바뀜. OLMoE 기준 tau=0.03이면 ppl +2.9%, 0.05면 +41% |
4. 저장소 구조: 모델 계열마다 .c 하나
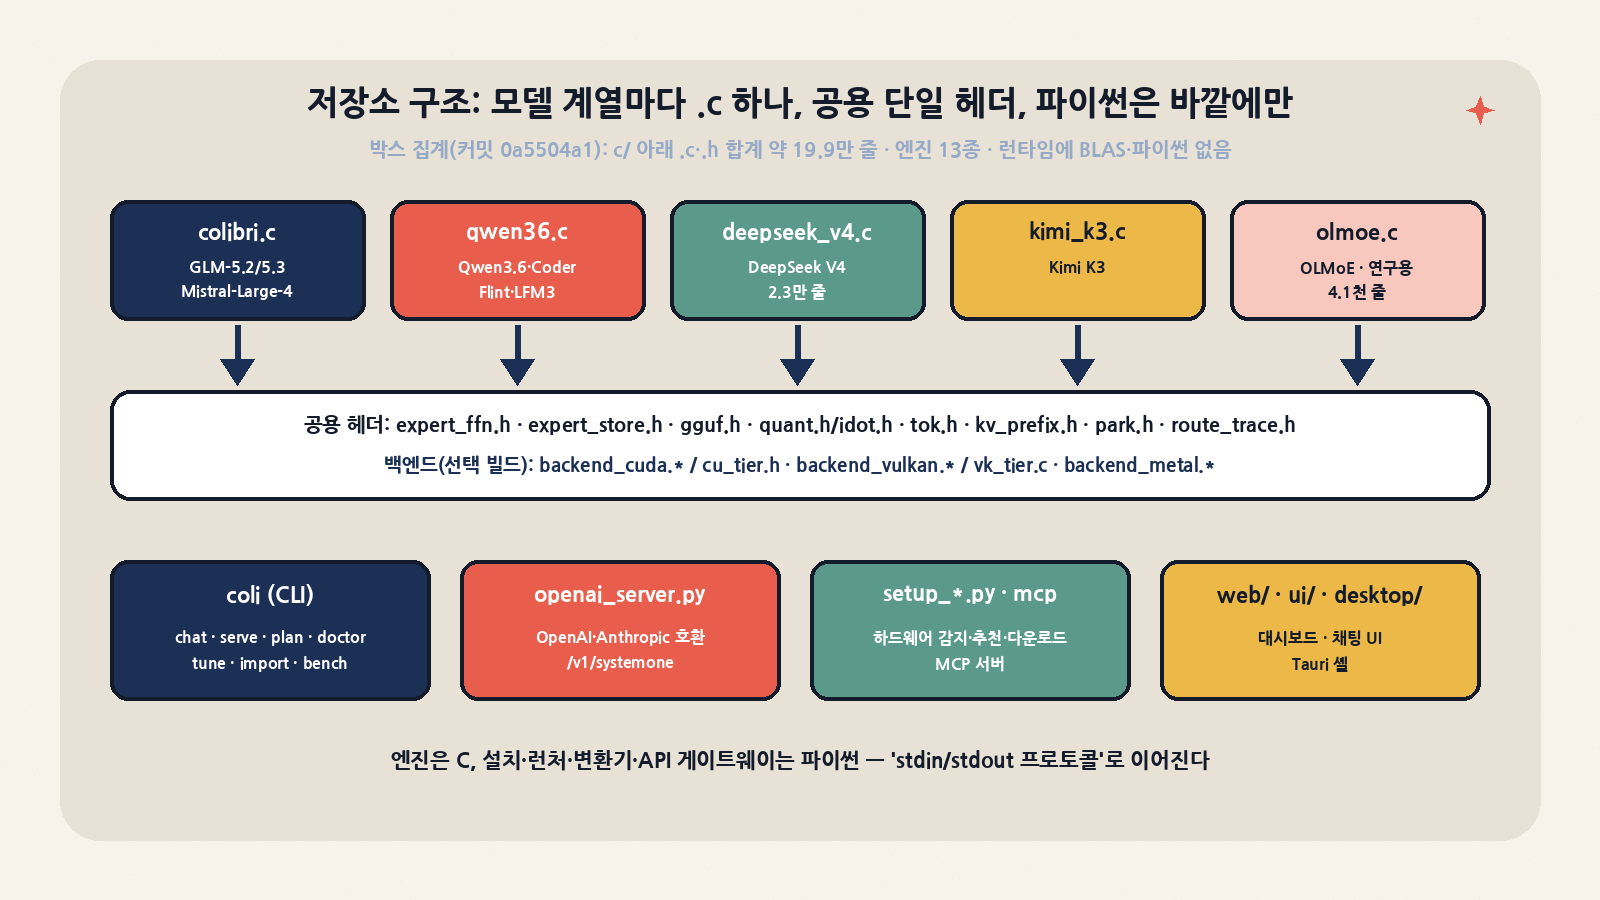
설계 원칙은 README의 한 문장으로 요약됩니다. “엔진은 자기 아키텍처만 소유하고, 두 엔진이 함께 필요한 것은 둘 다 include하는 헤더에 산다.” 그래서 c/colibri.c(GLM-5.2, 박스 집계 15,826줄), c/deepseek_v4.c(22,741줄), c/qwen36.c(10,698줄), c/olmoe.c(4,105줄)처럼 모델 계열마다 큰 C 파일이 하나씩 있고, 전문가 커널(expert_ffn.h), 스트리밍 캐시(expert_store.h), GGUF 리더(gguf.h), 토크나이저(tok.h) 같은 공용 기능은 단일 헤더로 공유합니다. 런타임에는 BLAS도 파이썬도 없습니다. 파이썬은 설치, 런처(coli), 변환기, API 게이트웨이(openai_server.py)에만 쓰이고, 엔진과 게이트웨이는 stdin/stdout 위의 줄 단위 프로토콜(docs/serve_protocol.md)로 통신합니다.
| 경로 | 역할 | 실무 관점 |
|---|---|---|
start-here.sh / START-HERE.bat |
하드웨어 감지 → 모델 추천 → 엔진 빌드 또는 받기 → 이어받기 다운로드 → 대시보드 | --list, --model, --backend, --dir로 전부 비대화형 제어 가능 |
c/coli |
사용자 CLI: chat·serve·web·plan·doctor·tune·import·bench·mcp | plan·doctor는 읽기 전용 점검이라 CI에 넣기 좋음 |
c/setup_catalog.py |
모델 카탈로그(필요 RAM·디스크·GPU 경로) | README 모델 표의 원천 |
c/resource_plan.py |
RAM/VRAM 플래너(coli plan) |
캐시 슬롯 cap과 예상 적중률을 계산 |
c/tests/, c/*_tiny |
의존성 없는 C·Python 테스트, 소형 픽스처 | CI는 엔진마다 소형 픽스처로 레퍼런스 구현과 토큰 단위 대조 |
web/, ui/, desktop/ |
대시보드(순수 API 클라이언트), 새 채팅 UI(coli ui), Tauri 셸 |
전문가 맵·프로파일링 페이지로 “어떤 전문가가 켜졌는지”를 볼 수 있음 |
5. 설치와 실행
5-1. 원스텝(권장)
# Ubuntu/Debian
sudo apt install git python3 build-essential
git clone https://github.com/JustVugg/colibri
cd colibri
./start-here.sh              # 질문 하나(모델), Enter = 추천값
./start-here.sh --list       # 이 기계 기준으로 모델별 적합 여부와 이유
./start-here.sh --model qwen36-35b --yes --backend cpu
설치가 끝나면 http://127.0.0.1:8000/(대시보드), http://127.0.0.1:8000/v1(OpenAI base URL), http://127.0.0.1:8000(Anthropic base URL)이 열립니다.
5-2. 이미 가진 GGUF로 바로 쓰기(이 글의 실측 경로)
cd colibri/c
make olmoe                                   # 엔진 하나만 빌드 (박스에서 15초)
./coli import ~/models/OLMoE-1B-7B-0924-Instruct-Q4_K_M.gguf   # --mode link: 원본을 그대로 읽음
./coli plan   --model ~/models/OLMoE-1B-7B-0924-Instruct-Q4_K_M.colibri
./coli doctor --model ~/models/OLMoE-1B-7B-0924-Instruct-Q4_K_M.colibri
./coli serve  --model ~/models/OLMoE-1B-7B-0924-Instruct-Q4_K_M.colibri --cap 32 --port 8765
coli import는 GGUF 옆에 config.json·토크나이저·채팅 템플릿·gguf.json(원본 파일 포인터)을 담은 모델 디렉터리를 만듭니다. 기본 --mode link는 아무것도 복사하지 않습니다. --mode copy는 레이어별 라우팅 전문가를 4KiB 정렬 슬롯 하나에 gate·up·down이 붙도록 재배치한 model.colibri.gguf를 씁니다. 그러면 전문가 하나가 정렬된 읽기 한 번이 됩니다. 문서에 따르면 두 모드 모두 무손실로, 같은 블록에서 같은 토큰이 나옵니다.
5-3. 평가·튜닝 명령
| 목적 | 명령 | 비고 |
|---|---|---|
| 배치 계획 | coli plan --model M |
RAM 예산, dense 크기, 캐시 cap, 예상 적중률 |
| 준비 상태 점검 | coli doctor --model M |
읽기 전용. ok/warn/skip 항목별 판정 |
| 스토리지 측정 | make -C c iobench && ./c/iobench |
plan이 “required”로 요구하는 단계 |
| 이 기계 최적값 저장 | coli tune --model M |
품질을 유지하는 설정 중 가장 빠른 것을 측정·저장 |
| 퍼플렉서티 | PPL=1 SNAP=M ./olmoe CAP 8 ref.json |
OLMoE·Qwen3.8 엔진의 teacher-forced NLL 모드 |
| 토큰 대조 | SNAP=M ./olmoe CAP 8 ref.json |
prompt_ids/full_ids로 생성 결과, 적중률, 속도를 출력 |
6. 박스 실측: 캐시 슬롯만 바꿨을 때 무엇이 변하고 무엇이 그대로인가
환경: Intel Xeon 가상 CPU 8코어, RAM 16GB(측정 시점 가용 약 3.8GB, 다른 작업과 공유), 가상 디스크(/dev/vdb), GPU 없음, Debian(trixie), gcc 14.2. colibri v2.1.0(main 0a5504a1)을 make olmoe로 빌드했습니다. 모델은 bartowski/OLMoE-1B-7B-0924-Instruct-GGUF의 Q4_K_M(4,213,513,024바이트)입니다. 엔진 로그 기준 전문가 gate/up은 Q4_K, down은 Q6_K이고, 텐서 3,219개를 원본 GGUF에서 직접 읽었습니다.
방법: 37토큰 프롬프트 뒤에 96토큰을 greedy로 생성하는 같은 ref 파일로 엔진 하니스(SNAP=… ./olmoe CAP 8 ref.json)를 돌렸습니다. cap마다 drop_caches로 OS 페이지 캐시를 비운 뒤 한 번(콜드), 바로 이어 한 번(웜) 실행했습니다. 속도는 엔진이 출력한 값이고, 프롬프트 처리 시간이 포함됩니다.
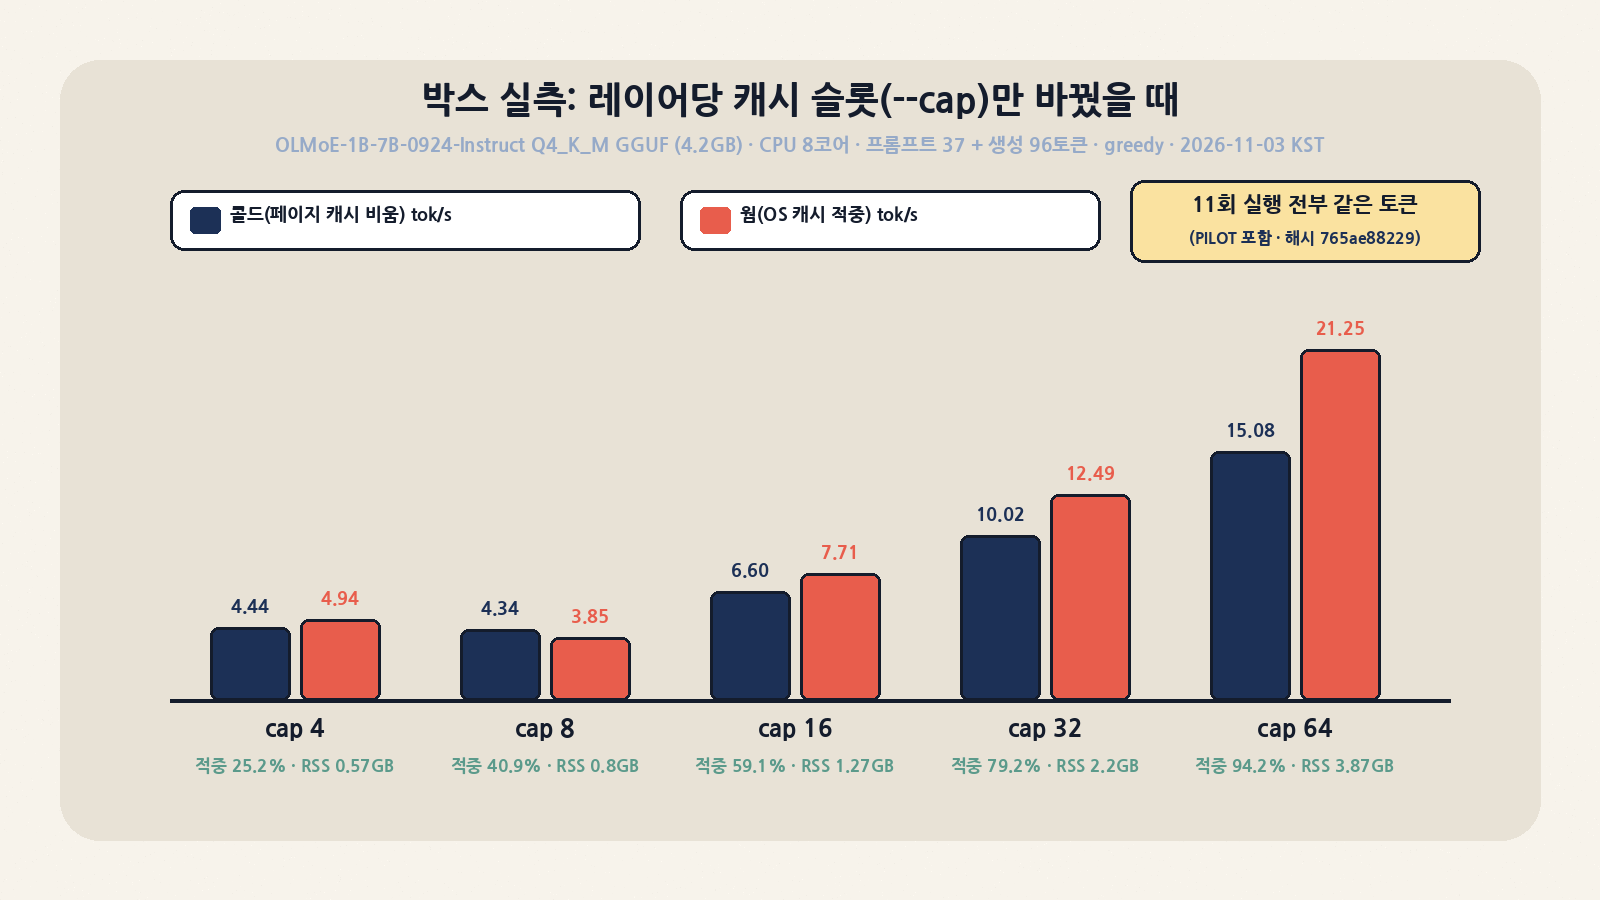
| cap (슬롯/레이어) | 전문가 캐시 적중률 | 콜드 tok/s | 웜 tok/s | 피크 RSS | 출력 토큰 해시 |
|---|---|---|---|---|---|
| 4 | 25.2% (hit 4,262 / miss 12,634) | 4.44 | 4.94 | 0.57 GB | 765ae88229 |
| 8 | 40.9% (6,916 / 9,980) | 4.34 | 3.85 | 0.80 GB | 765ae88229 |
| 16 | 59.1% (9,993 / 6,903) | 6.60 | 7.71 | 1.27 GB | 765ae88229 |
| 32 | 79.2% (13,381 / 3,515) | 10.02 | 12.49 | 2.20 GB | 765ae88229 |
| 64 (전 전문가) | 94.2% (15,921 / 975) | 15.08 | 21.25 | 3.87 GB | 765ae88229 |
16 + PILOT=1 (콜드) |
62.4% (10,550 / 6,346) | 6.33 | – | 1.27 GB | 765ae88229 |
읽는 법
- 계약은 지켜졌습니다. 캐시를 4슬롯으로 굶기든 64슬롯으로 다 채우든, 11번의 실행 모두 96개 출력 토큰이 한 개도 다르지 않았습니다(해시 765ae88229). RAM을 줄이면 속도만 떨어지고 모델은 그대로라는 README의 주장이 이 범위에서는 재현됐습니다.
- dense 상주분은 0.30GB입니다. 7B MoE인데 로드 직후 RSS가 0.30GB, 로드 시간은 0.3~0.5초였습니다. 나머지는 전부 cap이 정하는 전문가 캐시입니다. 같은 모델을 0.57GB로도, 3.87GB로도 돌릴 수 있고, 그 차이는 속도로 나타납니다(콜드 기준 4.4 → 15.1 tok/s).
- cap 8이 cap 4보다 느린 구간이 있습니다. 적중률은 25% → 41%로 올랐는데 웜 속도는 오히려 떨어졌습니다(4.94 → 3.85). 공유 박스의 잡음일 수도 있고, 적중률이 낮은 구간에서는 캐시 관리 비용이 이득을 상쇄했을 수도 있습니다. 이 박스에서는 의미 있는 변화가 16슬롯부터 시작됐습니다.
- PILOT 프리페치는 이 박스에서 효과가 없었습니다. 적중률은 59.1% → 62.4%로 조금 올랐지만 속도는 6.60 → 6.33으로 내려갔습니다. 저장소의
chat_olmoe.sh주석도 “8코어 CPU 전용 박스에서는 프리페치 스레드가 연산과 CPU를 다툰다”고 적고 있어, 같은 방향의 결과입니다. - 웜과 콜드의 차이는 “디스크 대신 OS 페이지 캐시”의 효과입니다. cap 64에서 15.08 → 21.25 tok/s였습니다. 개발팀이 OLMoE에서 잰 22~23 tok/s(Ryzen 7 PRO 8700GE CPU)와 비슷한 수준입니다.
6-1. plan·doctor·setup –list의 실제 판정
| 명령 | 박스 출력(요약) |
|---|---|
coli plan |
RAM 7.9GB 예산 · dense 0.3GB · 런타임 5.0GB · 웜 전문가 2.5GB · cap 41/layer · 디스크 콜드 전문가 1.4GB · 예상 적중 65% · 다음 행동: [required] iobench, [recommended] coli tune |
coli doctor |
ok 10 · warn 1(콜드 미스가 디스크까지 갈 수 있음) · skip 2(GPU 없음, SSD 프로브 없음). 결과 warning. GGUF를 링크 모드로 가져왔는데도 “safetensors headers are valid” 문구가 나오는 사소한 표기 차이가 있음 |
start-here.sh --list |
추천 qwen36-35b(23GB, tight: 작은 전문가 캐시로 실행). DeepSeek V4 Flash·GLM-5.2 등은 디스크 부족(needs-disk), MiMo·Kimi K3·Inkling 등은 RAM 부족(needs-ram)으로 사유와 함께 표시 |
6-2. 서버 모드: OpenAI·Anthropic·System One
coli serve --cap 32로 띄우자 /v1/models가 olmoe-colibri를 반환했습니다(capabilities: chat, systemone, context 4096). 모델 이름을 olmoe로 보내면 model_not_found가 나오므로, 클라이언트에는 /v1/models에 나온 id를 그대로 넣어야 합니다.
| 엔드포인트 | 요청 | 박스 결과 |
|---|---|---|
/v1/chat/completions |
max_tokens 60, temperature 0 | 7.16초, 28+60 토큰. 답 세 줄 뒤에 <|endoftext|> 문자열이 그대로 섞이고 생성이 계속돼 finish_reason이 length였음(아래 한계 참고) |
/v1/messages (Anthropic) |
max_tokens 30, “Say hello in Korean.” | 3.42초, “안녕하세요 (annyeonghaseyo) is the Korean way to say…” stop_reason max_tokens |
/v1/systemone |
README 예제 그대로(PR 리뷰 3지선다 + 위험 여부) | review = request changes 0.9947(merge 0.0013, close 0.0039), confidence 0.992, risky(noul) 0.9997, input 55 / output 6 토큰 |
System One은 생성 대신 허용된 선택지 각각의 확률을 읽는 방식이라, 답이 목록 밖으로 나갈 수 없고 “모델이 확신이 없다”는 상태를 임계값으로 다룰 수 있습니다. 1B 활성 파라미터 모델로도 응답 형식은 완전히 지켜졌습니다. 다만 확률이 0.99대로 몰린 것은 작은 모델의 과신일 수 있으니, 실제 판정에 쓰려면 보정(calibration)을 확인해야 합니다. 생성 품질도 모델 몫입니다. 박스 하니스 출력에서 OLMoE는 “공유 가중치는 디스크에, 작업별 가중치는 메모리에”라는, 사실과 다른 설명을 내놨습니다. 엔진이 충실하다고 모델이 정확해지는 것은 아닙니다.
7. 개발팀 벤치마크에서 실무적으로 볼 숫자
| 시나리오 | 구성 | 디코드(개발팀 측정) |
|---|---|---|
| GLM-5.2 744B, 바닥선 | RAM 25GB 노트북, 전 전문가 디스크 스트리밍 | 0.05~0.1 tok/s (콜드) |
| GLM-5.2, CPU만 | 128GB Ryzen AI Max+ 395 | 1.83 tok/s (웜) |
| GLM-5.2, 전부 상주 | RTX 5090 ×6 | 5.8~6.8, 선택적 NUMA 인터리브로 9.0~9.2 tok/s |
| Qwen3.6-35B-A3B UD-Q4_K_M | i5-13500 + RTX PRO 4000(24GB) | CUDA 104.8 · Vulkan 92.9 · CPU 13.9 tok/s |
| OLMoE-1B-7B-0125 Q4_K_M | 같은 기계 | CUDA 354.6 · Vulkan 299.4 · CPU 47.4 tok/s |
| Qwen3.8-Flash-Next IQ2_XS(68GB) | 같은 기계, 카드에 안 들어가는 전문가는 RAM 호스트 풀 | CUDA 51.4 · Vulkan 50.6 tok/s |
| Kimi K3 UD-IQ1_S(594GB) | 같은 기계, Vulkan | 0.349 tok/s |
이 표에서 읽어야 할 것은 “거대 모델이 빠르다”가 아닙니다. 같은 엔진과 같은 컨테이너에서 하드웨어가 바꾸는 것은 전문가가 사는 곳뿐이라는 점입니다. 디스크에서 스트리밍하는 거대 모델은 초당 1토큰 안팎이 현실이라 대화형보다는 배치나 야간 작업, 또는 “되긴 된다”를 검증하는 데 맞습니다. 대화형 속도가 필요하면 Qwen3.6-35B-A3B처럼 RAM에 들어가는 MoE를 고르는 것이 맞고, setup도 그렇게 추천합니다.
8. 비슷한 도구와 비교
| 항목 | colibri | llama.cpp | FreeToken | KTransformers | AirLLM |
|---|---|---|---|---|---|
| 기본 전제 | 디스크가 원본, RAM 전문가 캐시, VRAM은 선택 | 범용 GGUF 러너. mmap과 OS 페이지 캐시, 전문가 CPU 오프로드 옵션 | RAM이 원본, VRAM이 공유 LRU 전문가 캐시 | CPU/GPU 이종 MoE(전문가 CPU, 어텐션 GPU) | 레이어 단위로 디스크에서 올림 |
| 캐시 정책 | 레이어별 LRU + 사용 기록 기반 핫셋(.coli_usage), 프리페치 | 커널 페이지 캐시에 맡김(전문가를 따로 인식하지 않음) | q* 식으로 미스를 PCIe 전송/CPU 계산으로 분할 | 전문가 배치는 설정 중심 | 캐시보다 순차 로딩 |
| GPU 필요 | 아니요(CPU 기본, Vulkan/CUDA/Metal 선택) | 아니요 | 예(NVIDIA, CUDA 13) | 사실상 예 | 보통 예 |
| 모델 범위 | 엔진 13종(계열별 .c), 지원 아키텍처 GGUF | 매우 넓음 | 주요 MoE·dense 다수 | 주요 MoE 위주 | HF 모델 다수 |
| 정확성 보장 방식 | 엔진마다 CI에서 레퍼런스와 토큰 단위 대조, “배치는 속도만” 계약 | 커뮤니티 테스트, perplexity 비교 | 논문·벤치 | 벤치 중심 | – |
| API | OpenAI + Anthropic + System One + MCP | OpenAI 호환 서버 | OpenAI + Anthropic | OpenAI 호환 | 파이썬 라이브러리 |
| 맞는 사람 | RAM이 모델보다 훨씬 작은 개인 기계에서 거대 MoE를 “정확하게” 돌려 보려는 사람, 스트리밍 연구자 | 가장 넓은 호환성과 생태계가 필요한 대부분의 사용자 | 소비자용 NVIDIA GPU + 넉넉한 RAM | 서버급 CPU + GPU 워크스테이션 | VRAM이 아주 작은 GPU에서 dense 모델 실험 |
colibri와 llama.cpp의 결정적 차이는 전문가를 알고 있는 캐시입니다. llama.cpp도 mmap 덕분에 RAM보다 큰 모델을 “열 수는” 있지만, 무엇을 남길지는 커널이 페이지 단위로 정합니다. colibri는 라우터 출력, 배치 합집합, 사용 기록으로 전문가 단위의 캐시를 직접 운영하고, 그 결과를 적중률로 보여 줍니다(박스 실측 표의 hit/miss가 바로 그 숫자입니다). 반대로 llama.cpp의 넓은 모델 지원, 성숙한 생태계, 양자화 도구 체인은 colibri가 따라가는 쪽입니다. colibri가 GGUF를 “있는 그대로” 읽는 쪽으로 간 것(v2.1.0의 큰 축)도 그 생태계에 올라타려는 선택으로 보입니다.
9. 트레이드오프와 한계
| 주제 | 내용 | 실무 판단 |
|---|---|---|
| 디스크가 속도를 정함 | 거대 모델은 NVMe 대역폭과 적중률이 디코드 속도의 상한. GLM-5.2를 25GB 노트북에서 돌리면 0.05~0.1 tok/s | 스트리밍 모델은 대화형이 아니라 배치·검증용으로 계획 |
| SSD 수명·가상 디스크 | 읽기 전용이라 쓰기 마모는 없지만, 클라우드 가상 디스크는 IOPS 과금이나 상한이 있음. DIRECT=1은 가상 디스크에서 중립 이하일 수 있음(문서) | iobench로 먼저 재고 결정 |
| 엔진 단위 지원 | 새 아키텍처는 엔진(.c)이 생겨야 돌아감. 지원 목록 밖 GGUF는 coli import가 거부 |
쓰려는 모델이 13개 엔진에 들어가는지 먼저 확인 |
| 빠른 릴리스 속도 | v2.0.0 → v2.1.0 사이 PR 387개. 하루에 여러 번 머지되고 열린 이슈·PR이 155개 | 운영에서는 태그(v2.1.0)를 고정하고, git pull 후 start-here.sh로 재빌드 |
| 서버 모드 정지 토큰 | 박스에서 bartowski GGUF의 OLMoE를 serve로 돌리자 “batched serve mode: filtered 3 non-EOS stop tokens”가 찍히고 정지 토큰이 0번 하나만 남음. 그 결과 <|endoftext|>가 본문에 섞이고 max_tokens까지 생성됨. 하니스 모드는 같은 토큰에서 정상 종료 |
OLMoE를 서버로 쓸 때는 클라이언트 쪽 stop 시퀀스를 지정하고 재현되면 이슈로 보고. 다른 엔진에서도 재현되는지는 확인하지 않았음 |
| 도구 호출 | Inkling과 OLMoE를 뺀 모든 채팅 엔진이 지원 | 에이전트용이면 OLMoE는 학습용으로만 |
| 근사 모드의 유혹 | DEGRADE_ZERO는 OLMoE에서 보정된 값이고, GLM-5.2와 Kimi K3에서는 측정되지 않았다고 문서가 명시 |
기본값(무손실)을 유지하고, 켤 때는 ppl을 같이 측정 |
| 가중치 라이선스 | 엔진은 Apache-2.0이지만 모델마다 라이선스가 다름(Qwen-Image-2.1 비상업, Muse Spark Open은 Meta 라이선스 등) | 상업 배포 전에 모델 라이선스를 따로 검토 |
10. 누가 지금 도입하면 좋은가
| 상황 | 권장 | 이유 |
|---|---|---|
| 16~64GB 데스크톱, GPU 없음, 로컬 코딩 보조가 필요 | 도입 검토(강력) | Qwen3.6-35B-A3B·Qwen3-Coder-30B가 RAM 안에서 돌고, OpenAI·Anthropic 호환 API로 기존 도구에 그대로 연결됨 |
| 프런티어급 MoE를 사내 데이터로 오프라인 검증 | 도입 검토 | 느려도 정확한 출력이 계약이라, 품질 평가나 야간 배치에 적합. 다만 디스크 용량(수백 GB~1.5TB)이 먼저 |
| 멀티 유저 프로덕션 서빙(높은 동시성·SLA) | 보류 | vLLM·SGLang 계열이 여전히 표준. colibri는 개인 기계와 연구 쪽에 무게 |
| MoE 캐시·프리페치·스토리지 연구자 | 바로 사용 | README의 연구 가설 표, 벤치 프로토콜, olmoe.c의 실험 스위치(PILOT·WIDE·SMOOTH·EXPERT_DROP·DEGRADE_ZERO)가 그대로 실험대 |
| 분류·라우팅 같은 “결정” 업무 자동화 | 파일럿 | System One이 확률과 확신도를 주고 Jev API 호환. 보정은 별도로 검증 필요 |
마무리: “모델이 들어가느냐”에서 “어디에 두느냐”로
colibri가 흥미로운 이유는 속도 기록 때문이 아닙니다. MoE의 희소성을 메모리 계층 설계 문제로 정직하게 다루기 때문입니다. 박스에서 RAM 사용량을 0.57GB에서 3.87GB까지 바꾸는 동안 속도는 약 3.4배 달라졌지만 출력 토큰은 하나도 바뀌지 않았습니다. “적게 가진 기계는 느리게, 그러나 같은 모델을”이라는 약속을, 적어도 7B MoE와 CPU 경로에서는 확인할 수 있었습니다. 도입을 고민한다면 순서는 이렇습니다. start-here.sh --list로 기계를 진단하고, coli plan으로 예상 적중률을 보고, iobench로 디스크를 잰 다음, 자기 작업에서 cap을 바꿔 가며 직접 측정해 보십시오. 숫자는 결국 자기 기계에서 나옵니다.