안녕하세요, 모릭월드입니다. 카페에서 찍은 브이로그를 다시 들어 보니 커피 머신 소리에 내 목소리가 묻혀 있고, 화장실처럼 울리는 방에서 녹음한 강의는 말끝이 웅웅거리고, 화상회의 녹화본은 중간중간 소리가 뚝뚝 끊겨 있던 경험, 한 번쯤 있으시죠? “다시 녹음할 수도 없고, 이걸 어떻게 살리지?” 싶을 때가 있어요.
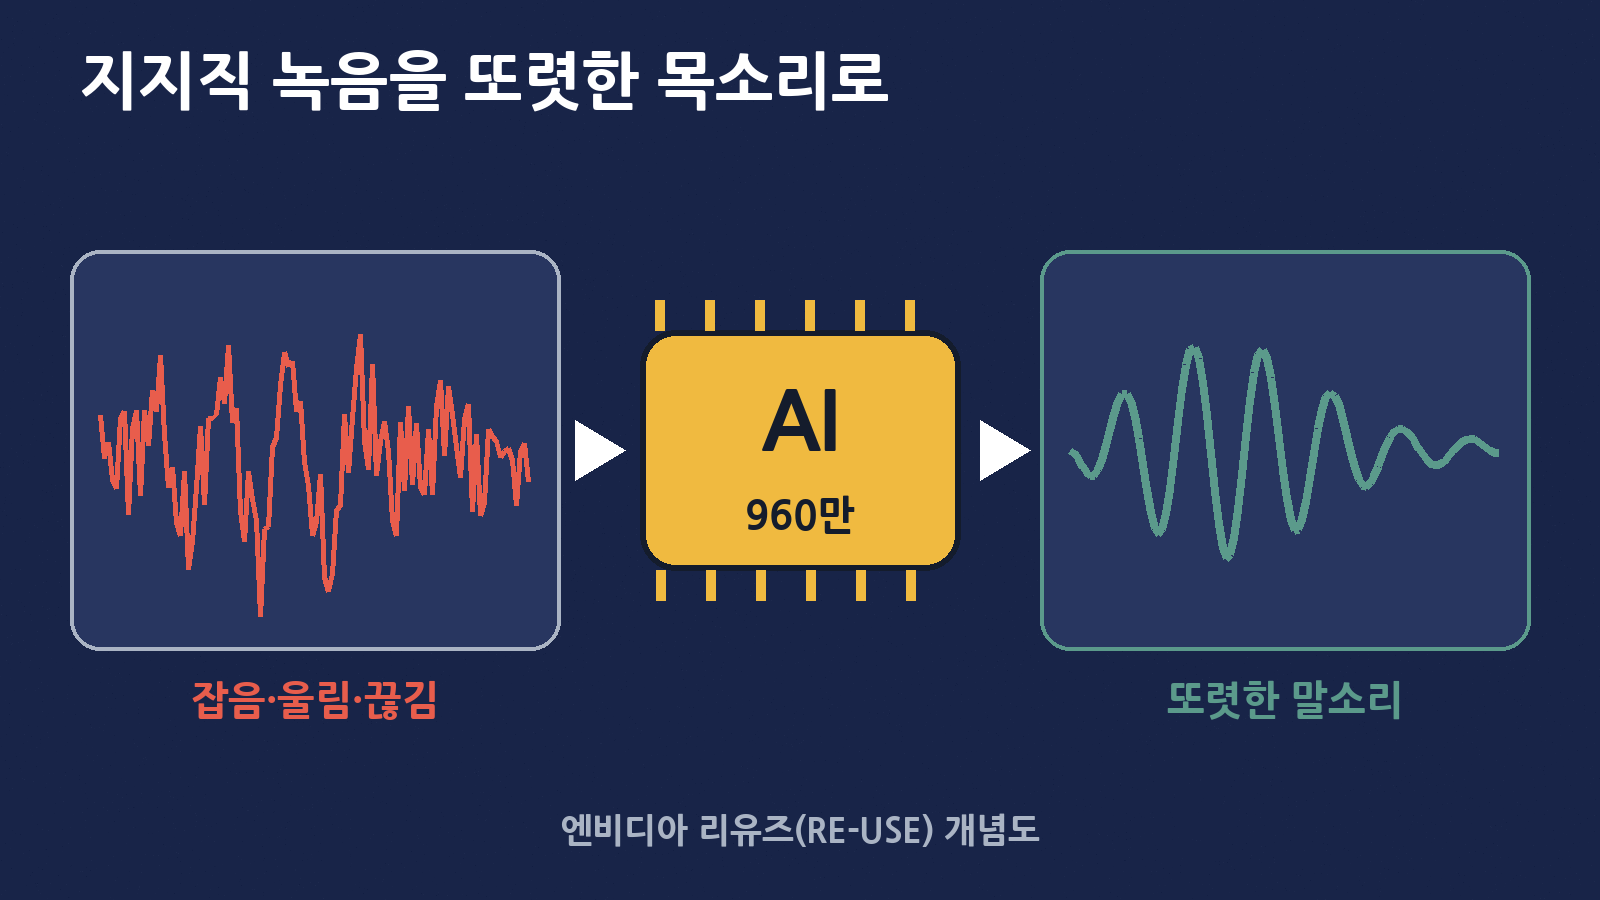
이런 고민을 겨냥한 AI가 무료로 공개됐어요. 엔비디아(NVIDIA)가 내놓은 음성 복원 AI ‘네모트론랩스 리유즈(NemotronLabs RE-USE)’예요. 잡음, 방 울림, 소리 찢어짐, 압축 손상까지 한 모델로 걷어 내는데, 크기가 매개변수 960만 개로 아주 작아요. 그런데도 수십 배 큰 공개 모델들을 시험에서 앞섰다고 해요. 오늘은 이 AI가 무엇을 고쳐 주는지, 작은데 어떻게 잘하는지, 그리고 한국어 녹음에 써 볼 때 무엇을 조심해야 하는지 차근차근 풀어 볼게요.
한눈에 보는 이번 소식
| 항목 | 내용 |
|---|---|
| 무엇이 | 엔비디아의 범용 음성 향상(음성 복원) AI 모델 ‘네모트론랩스 리유즈(NemotronLabs RE-USE)’ |
| 언제 | 허깅페이스 모델 카드 기준 10월 22일 공개, 엔비디아 AI 공식 X 계정이 10월 30일(현지 시간) 소개, AI타임스가 11월 2일 보도 |
| 크기 | 매개변수 960만 개, 모델 파일 약 38.4MB(FP32 기준, AI타임스 보도) |
| 고쳐 주는 것 | 배경 잡음, 방 울림(잔향), 소리 찢어짐(클리핑), 좁은 음역(대역폭 제한), 압축 손상(코덱 잡음), 끊긴 패킷, 저품질 마이크 |
| 지원 음질 | 8kHz부터 48kHz까지 7가지 샘플링 속도를 모델 하나로 처리 |
| 학습 언어 | 영어·독일어·스페인어·프랑스어·중국어(특정 언어에 묶이지 않는 범용 모델을 지향) |
| 가격·사용 조건 | 무료 공개, 상업적 이용 가능(OpenMDW-1.1 라이선스) |
| 바로 써 보기 | 허깅페이스 웹 데모에 음성·영상 파일을 올려 시험 가능 |
먼저, ‘음성 복원 AI’가 뭐예요?
음성 복원(전문 용어로는 음성 향상, Speech Enhancement)은 망가진 녹음에서 사람 목소리만 깨끗하게 되살리는 기술이에요. 오래된 사진의 얼룩과 긁힌 자국을 지우고 원래 얼굴을 또렷하게 살리는 ‘사진 복원’ 앱을 떠올리면 쉬워요. 리유즈는 그걸 소리에 하는 셈이에요.
예전 잡음 제거 프로그램은 보통 한 가지 문제만 잘 다뤘어요. 에어컨 소리 같은 일정한 잡음은 잘 지워도, 방 울림이나 소리 찢어짐은 그대로 남는 식이었죠. 리유즈 이름에 들어간 USE(Universal Speech Enhancement, 범용 음성 향상)는 “여러 종류의 손상을 한 모델이 한꺼번에 고친다”는 뜻이에요.
| 구분 | 예전 잡음 제거 도구(일반적인 경우) | 리유즈 같은 범용 음성 복원 AI |
|---|---|---|
| 다루는 문제 | 주로 배경 잡음 한 가지 | 잡음·울림·찢어짐·음역·압축·끊김 등 여러 가지를 한꺼번에 |
| 녹음 품질 | 정해진 음질에 맞춰야 하는 경우가 많음 | 8kHz 전화 음질부터 48kHz 고음질까지 모델 하나로 |
| 결과 | 잡음은 줄지만 목소리가 뭉개지기도 함 | 목소리의 또렷함과 ‘그 사람 목소리다운 느낌’을 지키는 데 초점 |
| 비유 | 얼룩 하나만 지우는 지우개 | 얼룩·긁힘·빛바램을 함께 고치는 사진 복원 앱 |
리유즈가 고쳐 주는 6가지 소리 문제
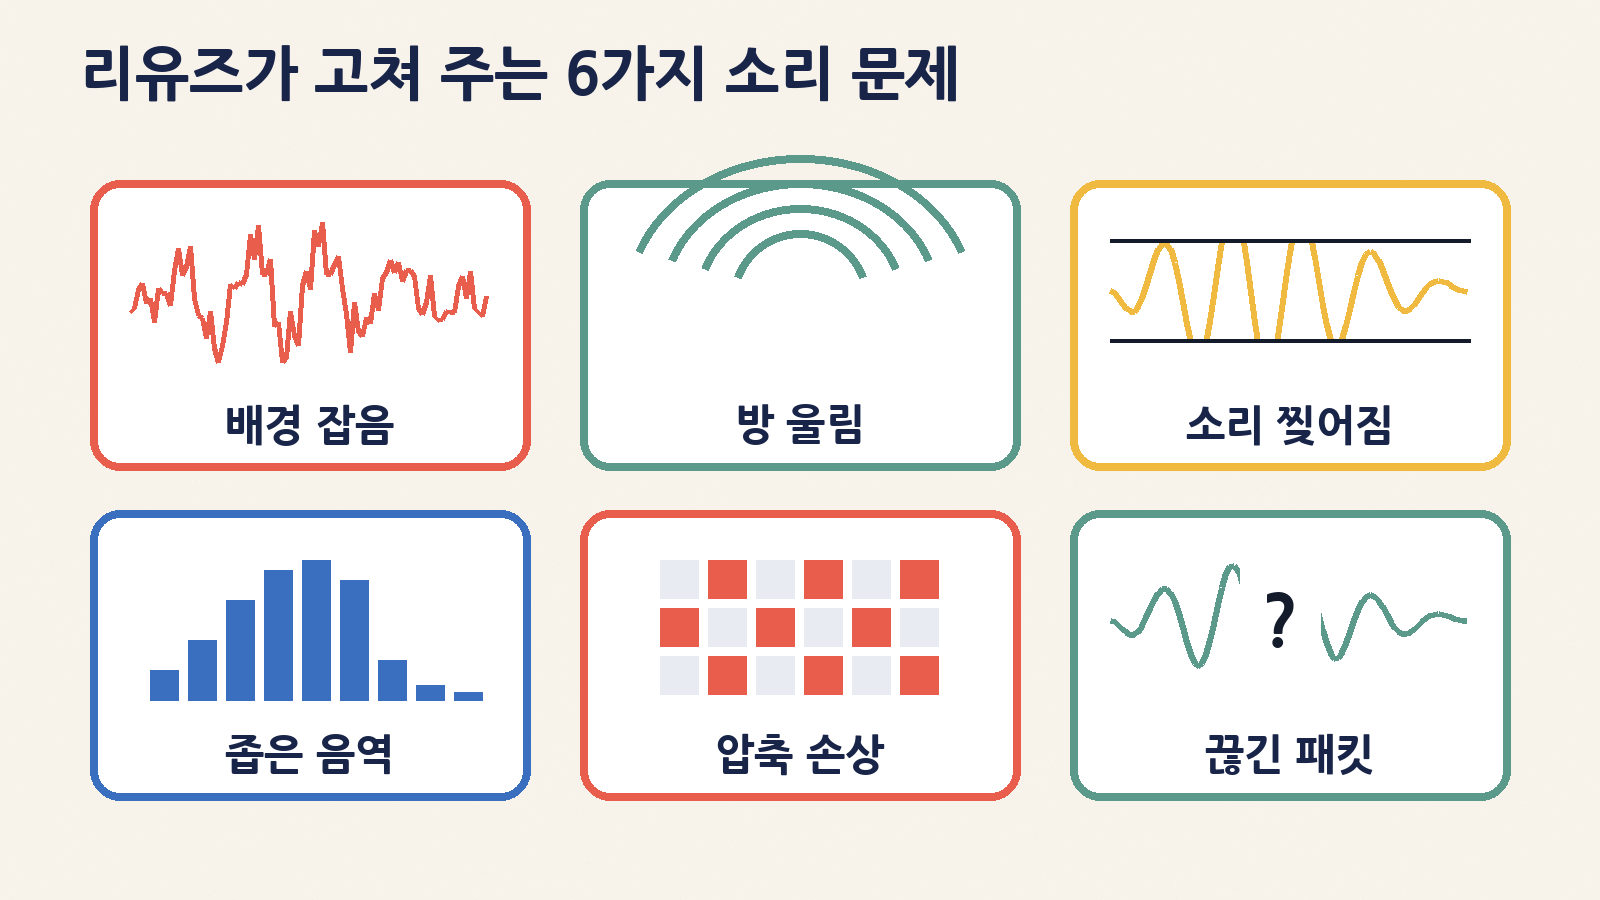
모델 카드에 적힌 손상 종류를 우리 생활 속 장면으로 바꿔 보면 이래요.
| 소리 문제 | 이런 상황에서 생겨요 | 들리는 느낌 |
|---|---|---|
| 배경 잡음 | 카페, 길거리, 에어컨·선풍기 옆 녹음 | 목소리 뒤로 ‘쏴아’ 하는 소리, 웅성거림 |
| 방 울림(잔향) | 욕실, 빈 사무실, 강당에서 녹음 | 말끝이 길게 끌리고 동굴처럼 웅웅거림 |
| 소리 찢어짐(클리핑) | 마이크에 너무 가까이 대고 크게 말함 | 큰 소리에서 ‘지직’ 하고 깨짐 |
| 좁은 음역(대역폭 제한) | 옛날 전화 녹음, 저음질 통화 | 답답하고 먹먹한 ‘전화기 목소리’ |
| 압축 손상(코덱 잡음) | 메신저로 여러 번 주고받은 음성, 낮은 음질로 저장한 파일 | 쇳소리, 물속 같은 뭉개짐 |
| 끊긴 패킷·저품질 마이크 | 불안정한 와이파이의 화상회의, 싼 이어폰 마이크 | 말이 뚝뚝 끊기거나 소리가 찌그러짐 |
한 가지 더 있어요. 여러 사람이 동시에 말할 때는 주인공 목소리 하나만 살리고 나머지는 줄이도록 학습했어요. 인터뷰나 팟캐스트에서 진행자 말소리를 또렷하게 만들 때 쓸모가 있죠. 반대로 말하면, 대화에 참여한 모든 사람의 목소리를 각각 분리해 주지는 않아요. 이 부분은 뒤에서 다시 짚을게요.
작은데 어떻게 큰 모델을 이겼을까요?
AI 모델의 크기는 보통 매개변수(파라미터) 수로 말해요. AI 머릿속에 있는 ‘조절 손잡이’의 개수라고 생각하면 돼요. 손잡이가 많을수록 더 복잡한 걸 배울 수 있지만, 그만큼 무겁고 느려지죠. 리유즈는 960만 개로, 비교 대상인 공개 모델 ‘시돈(Sidon)’ 2억 5천만 개의 약 26분의 1, ‘유니파스(UniPASE)’ 5억 개의 약 52분의 1 크기예요.
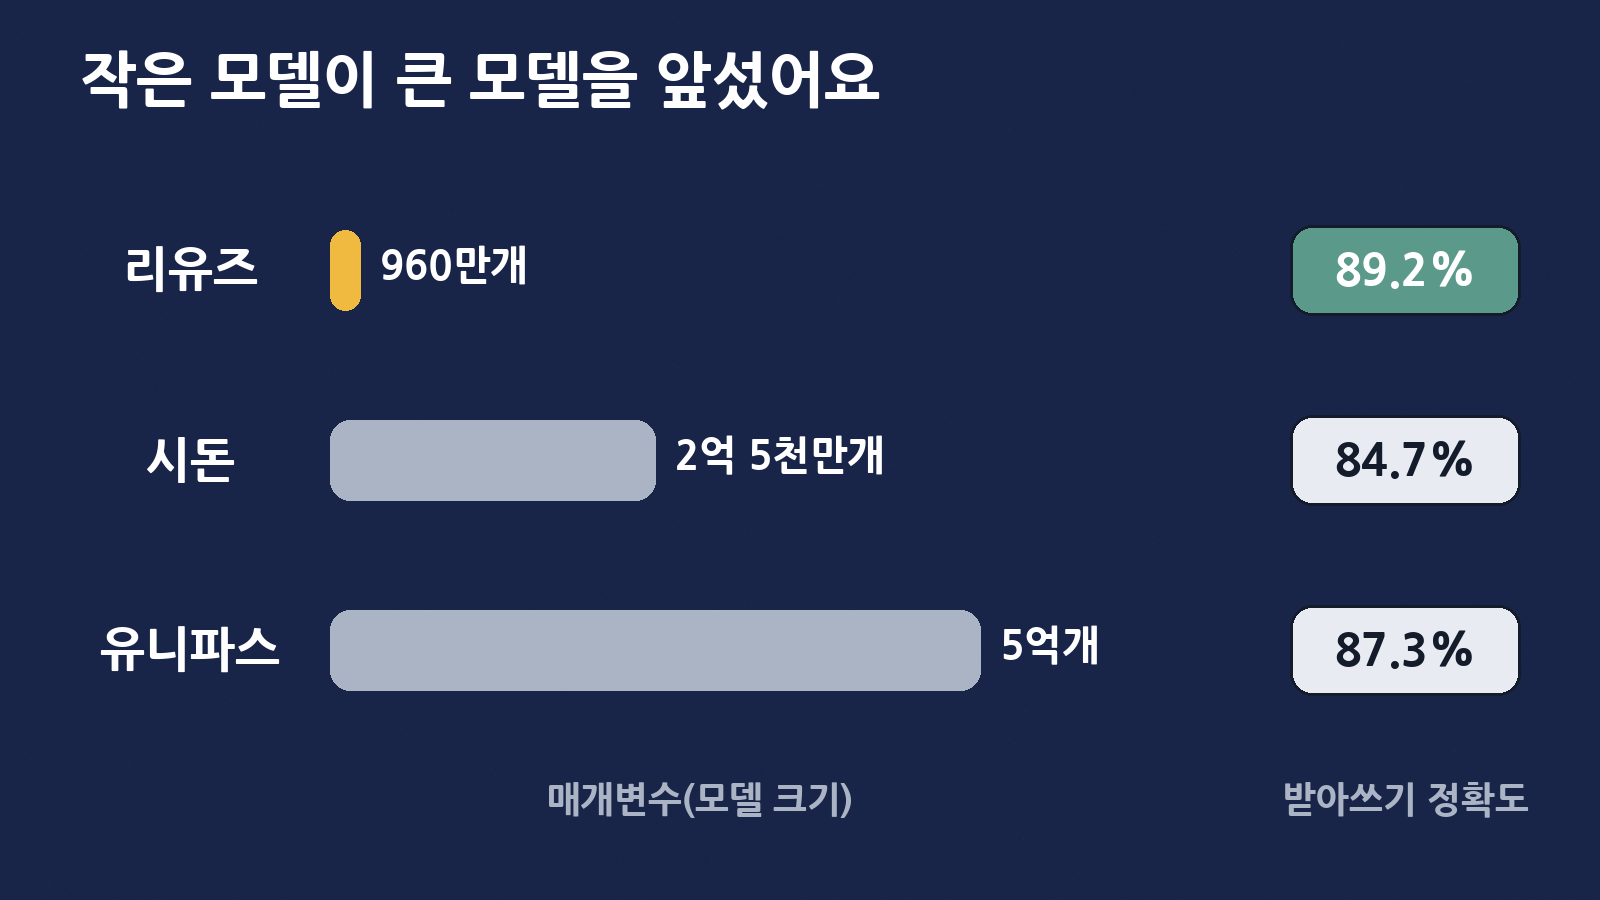
엔비디아는 음성 복원 대회용 시험 문제집인 URGENT 2025 시험 세트로 성능을 비교했어요. 그중 이해하기 쉬운 숫자 몇 개만 골라 보면 이래요.
| 모델 | 매개변수 | 음질 점수 PESQ(높을수록 좋음) | 알아듣기 쉬움 STOI(높을수록 좋음) | 같은 사람 목소리 유지(Spk) | 받아쓰기 정확도(CAcc) |
|---|---|---|---|---|---|
| 손대지 않은 원본(잡음 포함) | — | 1.34 | 0.50 | 0.73 | 81.29% |
| 시돈(Sidon) | 2억 5천만 | 1.73 | 0.62 | 0.74 | 84.68% |
| 유니파스(UniPASE) | 5억 | 2.17 | 0.76 | 0.81 | 87.28% |
| 리유즈(RE-USE) | 960만 | 2.57 | 0.78 | 0.86 | 89.17% |
표의 숫자는 허깅페이스 모델 카드의 전체 시험 세트 결과예요. 다만 모든 항목에서 1등은 아니에요. AI가 매기는 음질 점수 가운데 DNSMOS·UTMOS 같은 일부 항목은 시돈이 조금 더 높았어요. 그래도 “말을 알아듣기 쉬운가”, “원래 그 사람 목소리 같은가”, “받아쓰기가 잘 되는가”처럼 실제로 중요한 항목에서 리유즈가 앞섰다는 점이 눈에 띄어요.
특히 받아쓰기 숫자가 재미있어요. 16kHz 녹음만 따로 보면, 잡음 섞인 원본을 받아쓰기 AI에 넣었을 때 글자 정확도가 76.54%였는데 리유즈로 먼저 다듬은 뒤에는 87.09%로 올라갔어요. 100글자 중 틀리던 글자가 약 23개에서 13개로 줄어든 셈이에요. 회의록 AI나 자막 AI 앞에 ‘소리 세탁기’처럼 붙여 쓰기 좋다는 뜻이죠.
비결 1: 긴 소리도 가볍게 읽는 ‘맘바(Mamba)’
리유즈의 가운데에는 양방향 맘바(Mamba)라는 구조가 30층으로 쌓여 있어요. 챗GPT 같은 언어 모델이 주로 쓰는 ‘트랜스포머’는 문장의 모든 단어를 서로 한 번씩 다 비교해요. 그래서 내용이 두 배로 길어지면 계산은 네 배로 늘어나요. 맘바는 앞에서부터 차례로 읽으면서 중요한 것만 ‘메모장’에 적어 두는 방식이라, 길이가 두 배면 계산도 대략 두 배만 늘어요. 초 단위로 길게 이어지는 소리 데이터에 잘 맞는 이유예요. ‘양방향’이라는 말은 앞에서 뒤로, 뒤에서 앞으로 두 번 읽어서 소리의 앞뒤 맥락을 함께 본다는 뜻이에요.
| 트랜스포머(셀프 어텐션) | 맘바(상태공간 모델) | |
|---|---|---|
| 읽는 방식 | 모든 부분을 서로 한 번씩 비교 | 차례로 읽으며 요점을 메모 |
| 길이가 2배가 되면 | 계산이 약 4배(제곱으로 증가) | 계산이 약 2배(길이에 비례) |
| 비유 | 반 학생 모두가 서로 한 명씩 악수 | 한 줄로 서서 쪽지를 전달 |
| 소리 처리에서 | 긴 녹음일수록 무거워짐 | 긴 녹음도 비교적 가볍게 처리 |
비결 2: 2,500시간의 ‘일부러 망가뜨린’ 연습 문제
AI에게 복원을 가르치려면 “망가진 소리”와 “원래 깨끗한 소리” 짝이 필요해요. 엔비디아는 깨끗한 음성 약 2,500시간에 잡음 약 180시간을 섞고, 방 6만여 가지의 울림 특성과 마이크 70여 종의 특성을 입혀 일부러 망가뜨린 연습 문제를 대량으로 만들었어요. 다양한 방과 마이크를 미리 겪어 보게 한 덕분에, 처음 듣는 녹음 환경에서도 잘 버티도록 훈련한 거예요.
어디에 쓰면 좋을까요?
| 이런 분 | 이런 녹음에 | 기대할 수 있는 점 |
|---|---|---|
| 유튜버·브이로거 | 야외·카페 촬영 영상의 목소리 | 배경 소음과 바람 소리를 줄이고 말소리를 또렷하게 |
| 팟캐스터·인터뷰어 | 울리는 방에서 녹음한 대화 | 방 울림을 줄이고 진행자 목소리 중심으로 정리 |
| 직장인 | 화상회의 녹화본, 회의 녹음 | 끊김·잡음을 다듬어 회의록 AI의 받아쓰기 정확도 향상 |
| 강사·학생 | 강의실 녹음, 온라인 강의 | 먹먹한 소리를 정리해 다시 듣기 편하게 |
| 개발자·연구자 | 음성 AI 학습용 데이터 | 음성 데이터 정리, 받아쓰기(ASR) 전처리, TTS 학습 데이터 정제 |
| 가족 기록을 모으는 분 | 오래된 통화 녹음, 저음질 음성 메모 | 좁은 음역과 압축 손상을 줄여 듣기 편하게(결과는 녹음 상태에 따라 다름) |
참고로 웃음소리를 더 잘 살리고 싶다면 엔비디아가 따로 낸 ‘웃음 보존(laughter)’ 버전도 있어요. 기본 모델은 말소리에 집중하다 보니 웃음소리를 잡음처럼 줄일 수 있거든요. 예능 같은 분위기를 살리고 싶은 영상이라면 이 버전을 비교해 보세요.
써 보기 전에 챙길 4가지
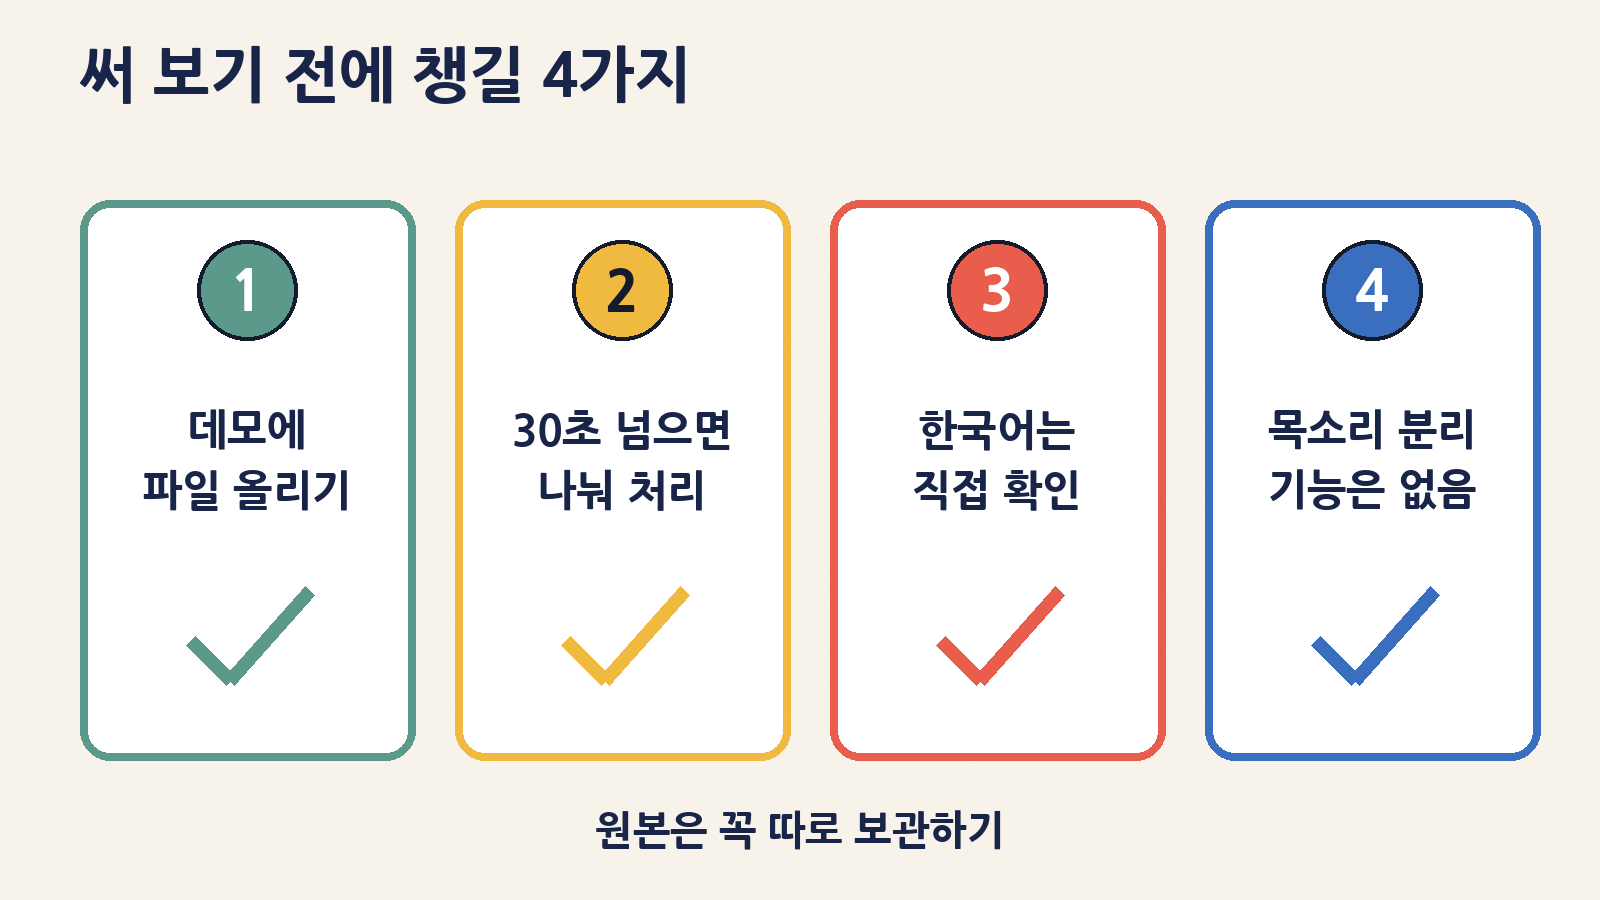
1. 가장 쉬운 방법은 웹 데모
설치가 부담스럽다면 허깅페이스에 올라온 그라디오(Gradio) 웹 데모에 잡음 섞인 음성이나 영상 파일을 올려 보는 게 가장 쉬워요. 브라우저만 있으면 되고, 결과를 바로 들어 보고 내려받을 수 있어요. 다만 무료 공개 데모는 이용자가 몰리면 기다려야 할 수 있어요.
2. 내 컴퓨터에서 돌리려면 조건이 까다로워요
| 항목 | 공식 안내 내용 | 초보자에게 의미하는 것 |
|---|---|---|
| 운영체제 | 리눅스(Linux) | 윈도·맥에서는 바로 돌리기 어려움 |
| 그래픽카드 | 엔비디아 암페어(Ampere) 계열 GPU(A100 등), 트리톤(Triton) 추론 가속 | 엔비디아 그래픽카드가 사실상 필수 |
| 준비물 | 맘바 설치용 도커(Docker) 환경, 필요하면 resampy 패키지 | 개발 환경에 익숙해야 함 |
| 파일 형식 | 모노(한 채널) .wav 파일 입력, .wav 출력 | mp3·mp4는 먼저 wav로 바꿔야 함 |
| 실행 | noisy_audio 폴더에 파일을 넣고 inference.sh 실행 | 명령어 한 줄이지만 환경 설정이 관건 |
| 긴 파일 | 30초가 넘으면 inference_chunk.sh로 겹치게 잘라 처리 | 긴 강의·회의는 조각 처리 스크립트 사용 |
모델이 10초보다 짧은 음성으로 학습됐기 때문에, 긴 녹음은 메모리 부족을 막으려고 조금씩 겹치게 잘라서 처리한 뒤 다시 이어 붙이는 별도 스크립트를 쓰라고 안내하고 있어요.
3. 한국어는 직접 들어 보고 판단하세요
학습 언어 목록에 한국어는 없어요. 엔비디아는 특정 언어에 묶이지 않는 범용 모델을 지향한다고 밝혔고, 잡음과 울림은 언어와 상관없이 비슷한 성질이 있어서 한국어 녹음에도 효과가 있을 수 있어요. 하지만 한국어 성능을 따로 측정한 공식 숫자는 없으니, 중요한 녹음이라면 짧은 구간으로 먼저 시험해 보고 발음이 뭉개지지 않는지 귀로 확인하는 게 안전해요.
4. 목소리 분리기가 아니에요, 그리고 원본은 꼭 보관
| 리유즈가 잘하는 것 | 리유즈가 하지 않는 것 |
|---|---|
| 주인공 목소리 하나를 또렷하게 | 대화 참여자 모두의 목소리를 각각 분리 |
| 잡음·울림·끊김 등 손상 줄이기 | 누가 말했는지 구분(화자 구분) |
| 받아쓰기 AI의 정확도 높이기 | 받아쓰기 자체(별도 받아쓰기 AI 필요) |
| 음성 데이터 정리 | 배경 음악만 따로 뽑아내기 같은 음원 분리 |
복원 AI는 ‘없던 소리를 추정해서 채우는’ 부분이 있어요. 그래서 결과가 듣기엔 더 좋아도 원본과 미묘하게 다를 수 있어요. 원본 파일은 반드시 따로 보관하고, 법적 증거나 중요한 기록처럼 원본 그대로가 중요한 녹음이라면 복원본을 원본 대신 쓰지 않는 게 좋아요. 다른 사람이 등장하는 녹음을 데모 사이트에 올릴 때는 그분의 동의도 한 번 챙겨 주세요.
자주 묻는 질문
| 질문 | 답 |
|---|---|
| 정말 무료인가요? | 모델은 무료로 공개됐고, OpenMDW-1.1 라이선스로 상업적 이용도 가능하다고 안내돼요. 회사 서비스에 넣을 때는 라이선스 전문을 꼭 확인하세요. |
| 스마트폰 앱으로 쓸 수 있나요? | 엔비디아가 낸 공식 앱은 없어요. 지금은 허깅페이스 웹 데모나 리눅스·엔비디아 GPU 환경에서 쓰는 방식이에요. |
| 실시간 통화에도 되나요? | 이번 모델은 녹음된 파일을 다듬는 용도예요. 엔비디아는 실시간용 ‘Real-time RE-USE’를 별도로 허깅페이스에 공개해 두었어요. |
| 노이즈 캔슬링 이어폰과 같은 건가요? | 아니에요. 이어폰은 내 귀에 들어오는 주변 소리를 줄이는 장치고, 리유즈는 이미 녹음된 파일 속 목소리를 다듬는 AI예요. |
| 영상 파일도 되나요? | 웹 데모는 음성·영상 파일 업로드를 안내해요. 직접 돌리는 공식 스크립트는 .wav 파일 기준이에요. |
정리하며
리유즈의 의미는 “작은 AI도 제대로 훈련하면 큰 AI를 이길 수 있다”는 걸 소리 분야에서 보여 줬다는 데 있어요. 38MB 남짓한 작은 모델이라 받아쓰기 AI나 영상 편집 도구 안에 쏙 넣기 좋고, 앞으로 우리가 쓰는 회의록 앱이나 영상 편집 앱에 이런 ‘소리 세탁’ 기능이 조용히 들어올 가능성도 커요.
오늘 해 볼 일은 간단해요. 휴대전화에 잠들어 있는 시끄러운 녹음 파일 하나를 골라 웹 데모에 올려 보세요. 원본과 복원본을 번갈아 들어 보면 “AI가 소리를 고친다”는 게 어떤 느낌인지 바로 와닿을 거예요. 한국어 발음이 어떻게 살아나는지도 직접 확인해 보시고요.