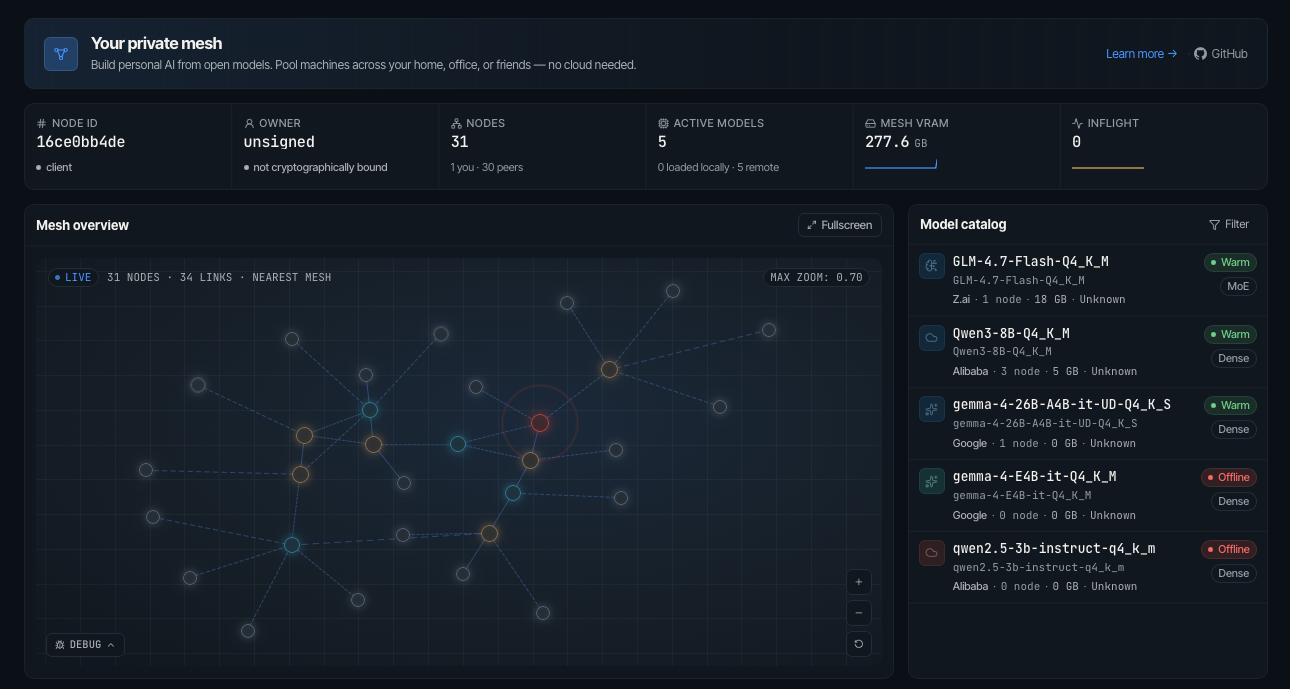
한 줄 요약: Mesh-LLM/mesh-llm(Apache-2.0, 최신 안정판 v0.78.1, 스타 약 3.7k)은 여러 대의 컴퓨터에 흩어진 GPU·메모리를 묶어 http://localhost:9337/v1 하나의 OpenAI 호환 API로 내놓는 Rust 분산 추론 시스템입니다. 한 대에 들어가는 모델은 그 자리에서, 다른 피어가 가진 모델은 QUIC로 라우팅해서, 한 대에 안 들어가는 큰 모델은 “Skippy”라는 내장 런타임이 레이어 구간을 나눠 여러 노드에 올려서 서빙합니다. 10월 31일(KST) GitHub Trending Rust 일간 9위(+38)에 올랐습니다. 이 글은 저장소 문서와 코드 구조를 따라 아키텍처를 해부하고, GPU 없는 8코어 박스에서 2노드 비공개 메시를 실제로 띄워 잰 숫자와, 실패한 분할(split) 시도의 로그까지 그대로 정리합니다.
1. 무엇인가: “분산 llama.cpp”보다 넓은 문제 정의
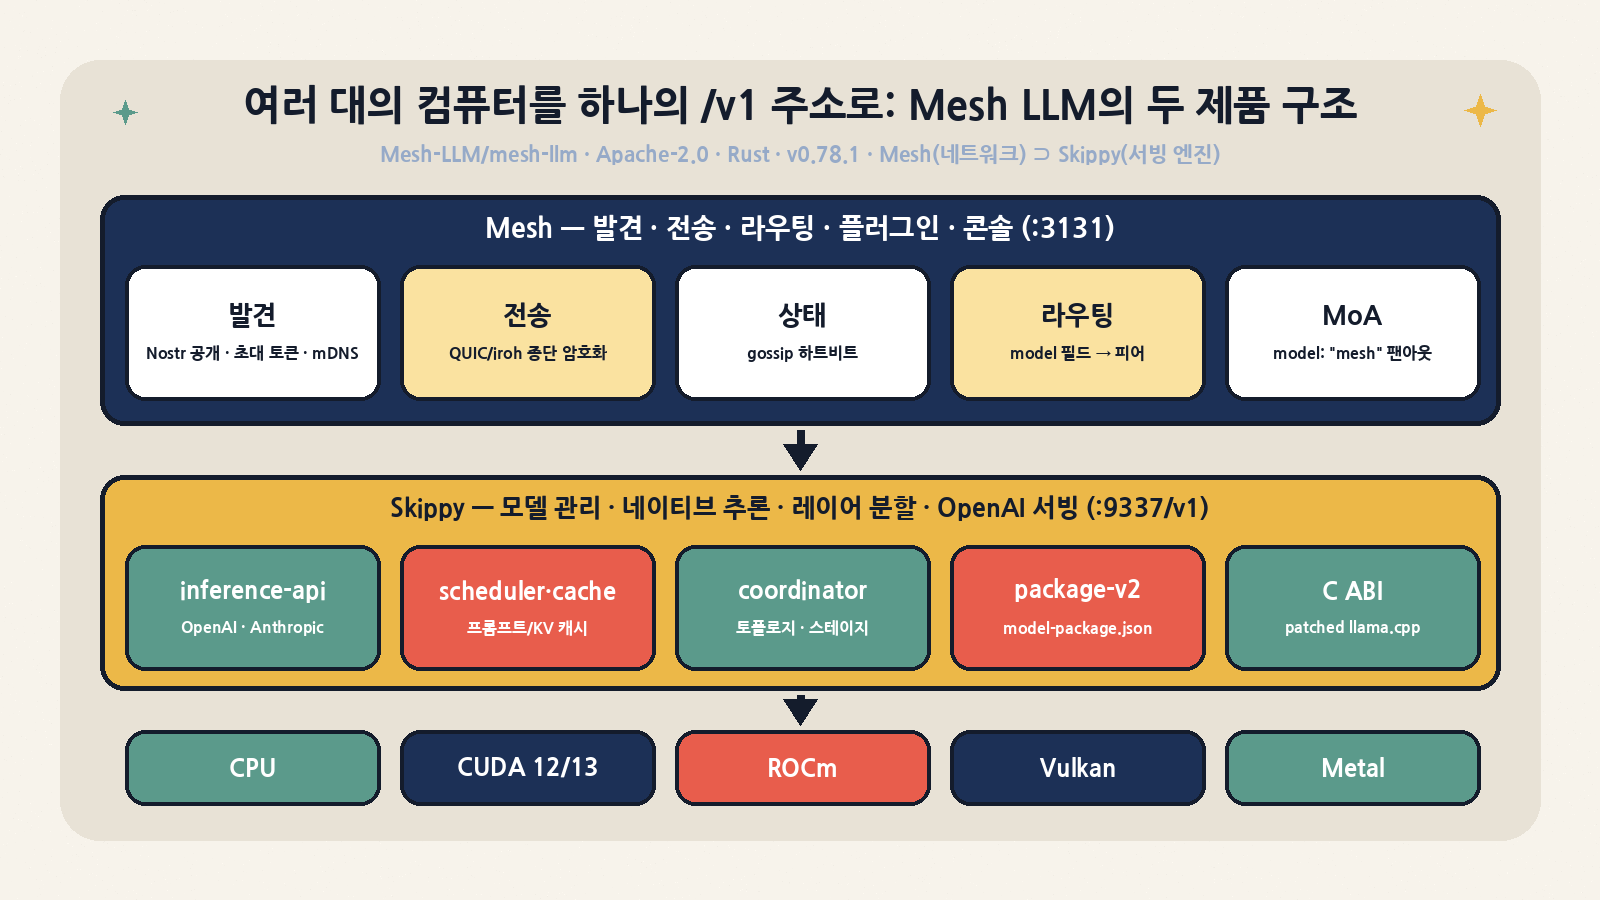
분산 LLM 추론 도구는 보통 둘 중 하나입니다. 데이터센터 안에서 텐서/파이프라인 병렬로 한 모델을 쪼개는 쪽(vLLM, SGLang 계열), 혹은 집 안의 맥 여러 대를 묶는 쪽(Exo)입니다. Mesh LLM은 질문을 조금 다르게 던집니다. “서로 다른 하드웨어를 가진, 서로 다른 네트워크에 있는 노드들이 각자 무엇을 서빙할지 스스로 정하고, 클라이언트는 그냥 하나의 /v1만 보면 되게 할 수 없을까?” 그래서 핵심은 텐서 병렬 커널이 아니라 발견(discovery) · 전송(transport) · 라우팅(routing) · 배치(placement)입니다.
| 항목 | 내용 (2026-10-31 KST 확인) |
|---|---|
| 저장소 | Mesh-LLM/mesh-llm (2026-02-11 생성, 마지막 커밋 2026-10-31 15:12 KST) |
| 라이선스 | Apache-2.0 (LICENSE 파일 · GitHub API 모두 Apache-2.0) |
| 최신 안정 릴리스 | v0.78.1 — 2026-10-05 21:25 KST. 이후 v0.78.0-preview.40959817943.1 프리릴리스가 2026-10-30 09:53 KST에 나옴 |
| 규모 | 스타 3,689 · 포크 478 · 열린 이슈/PR 202 · 기여자 약 49명(API 기준) |
| 언어/빌드 | Rust 단일 Cargo 워크스페이스 + TypeScript/React 웹 콘솔, just로 빌드. 네이티브 추론은 패치된 llama.cpp |
| API | OpenAI 호환 /v1/models·chat completions·completions·Responses (Skippy 측 프런트엔드는 Anthropic Messages도 공유) |
| 배포 형태 | macOS(Metal) · Linux CPU/CUDA 12·13/ROCm/Vulkan · Linux ARM64 · Windows CPU/CUDA/ROCm/Vulkan 번들, Homebrew, OCI 이미지 |
| 오늘 트렌딩 | GitHub Trending Rust 일간 9위, 오늘 +38 스타 |
2. 두 제품, 한 워크스페이스: Mesh와 Skippy
저장소를 열면 최상위에 mesh/와 skippy/ 두 트리가 있습니다. README와 skippy/docs/ARCHITECTURE.md는 이 경계를 꽤 엄격하게 정의합니다. Skippy는 단독으로도 쓰는 모델 서빙 제품(모델 관리, 네이티브 추론, 분할 실행, OpenAI 서빙)이고, Mesh는 그 위에 피어 발견·전송·라우팅·플러그인·콘솔을 얹은 제품입니다. 의존성은 Mesh → Skippy 한 방향뿐이고, 반대 방향 의존은 금지입니다. 두 제품은 릴리스 버전과 네이티브 런타임 아티팩트를 공유하지만 CLI·설정·데이터 경로는 각자 가집니다.
| 경로 | 역할 | 실무 관점에서 볼 곳 |
|---|---|---|
mesh/crates/ (40여 크레이트) |
노드, 전송, 멤버십, 라우팅, 콘솔 서버, 플러그인 매니저, MoA, SDK(FFI/Node.js), 결제·지갑 | mesh-llm-routing, mesh-llm-transport, mesh-llm-membership, mesh-mixture-of-agents |
skippy/crates/ (30여 크레이트) |
추론 API, 스케줄러, 캐시, 코디네이터/토폴로지, 패키지 포맷, 양자화, 토크나이저, 런타임 설치 | skippy-coordinator, skippy-topology, skippy-package-format, skippy-cache |
skippy/llama_cpp/ |
llama.cpp 업스트림 핀 + 순서 있는 패치 큐 (C ABI 노출) | 업스트림 대비 무엇을 바꿨는지, 패리티 큐(LLAMA_PARITY.md) |
mesh/docs/, skippy/docs/ |
운영 가이드, 설계 문서, 벤치마크, 인증 매트릭스 | MESHES.md, SKIPPY_SPLITS.md, TOPOLOGY_PLANNER.md, FAMILY_STATUS.md, EXO_COMPARISON.md |
mesh/evals, skippy/evals |
평가 하네스 (라우터·MoA·패리티) | 벤치 수치를 재현하려면 이곳부터 |
schemas/, ci/, tools/xtask |
스키마, CI 정책, 릴리스 증명(attestation) 도구 | xtask release-attestation inspect |
소유 흐름을 문서 그대로 옮기면 operator/client → Skippy CLI 또는 Mesh ingress → 공용 inference 프런트엔드 / Skippy lifecycle API → serving + scheduler + cache → Rust runtime → Skippy C ABI → 패치된 llama.cpp입니다. 분할 실행에서는 Mesh가 “입장 허가된 피어, 측정된 용량, 전송 지연”을 넘기고, skippy-coordinator::topology가 배치·런타임 여유분·KV/연산 예약·컷 이동 후 용량 재확인을 맡습니다. 즉 “누가 참여하나”는 Mesh, “어디서 어떤 레이어를 돌리나”는 Skippy로 책임이 갈립니다.
릴리스 구조도 같은 철학입니다. 각 번들은 OS/아키텍처별 백엔드 중립 호스트 하나 + 버전 고정된 네이티브 런타임 하나로 조립됩니다. 박스에서 받은 Linux CPU 번들(67.0MB, sha256 일치)을 풀어 보면 mesh-bundle/mesh-llm 실행 파일과 native-runtimes/meshllm-native-runtime-linux-x86_64-cpu/lib(libllama 0.5.0, libggml 0.25.1, libmtmd) 그리고 해시를 묶은 product-manifest.json(contract mesh-llm-product-v2)가 들어 있습니다. CUDA로 바꾸고 싶으면 호스트는 그대로 두고 런타임만 교체하는 구조입니다.
3. 요청은 어디로 가는가: 네 가지 서빙 경로
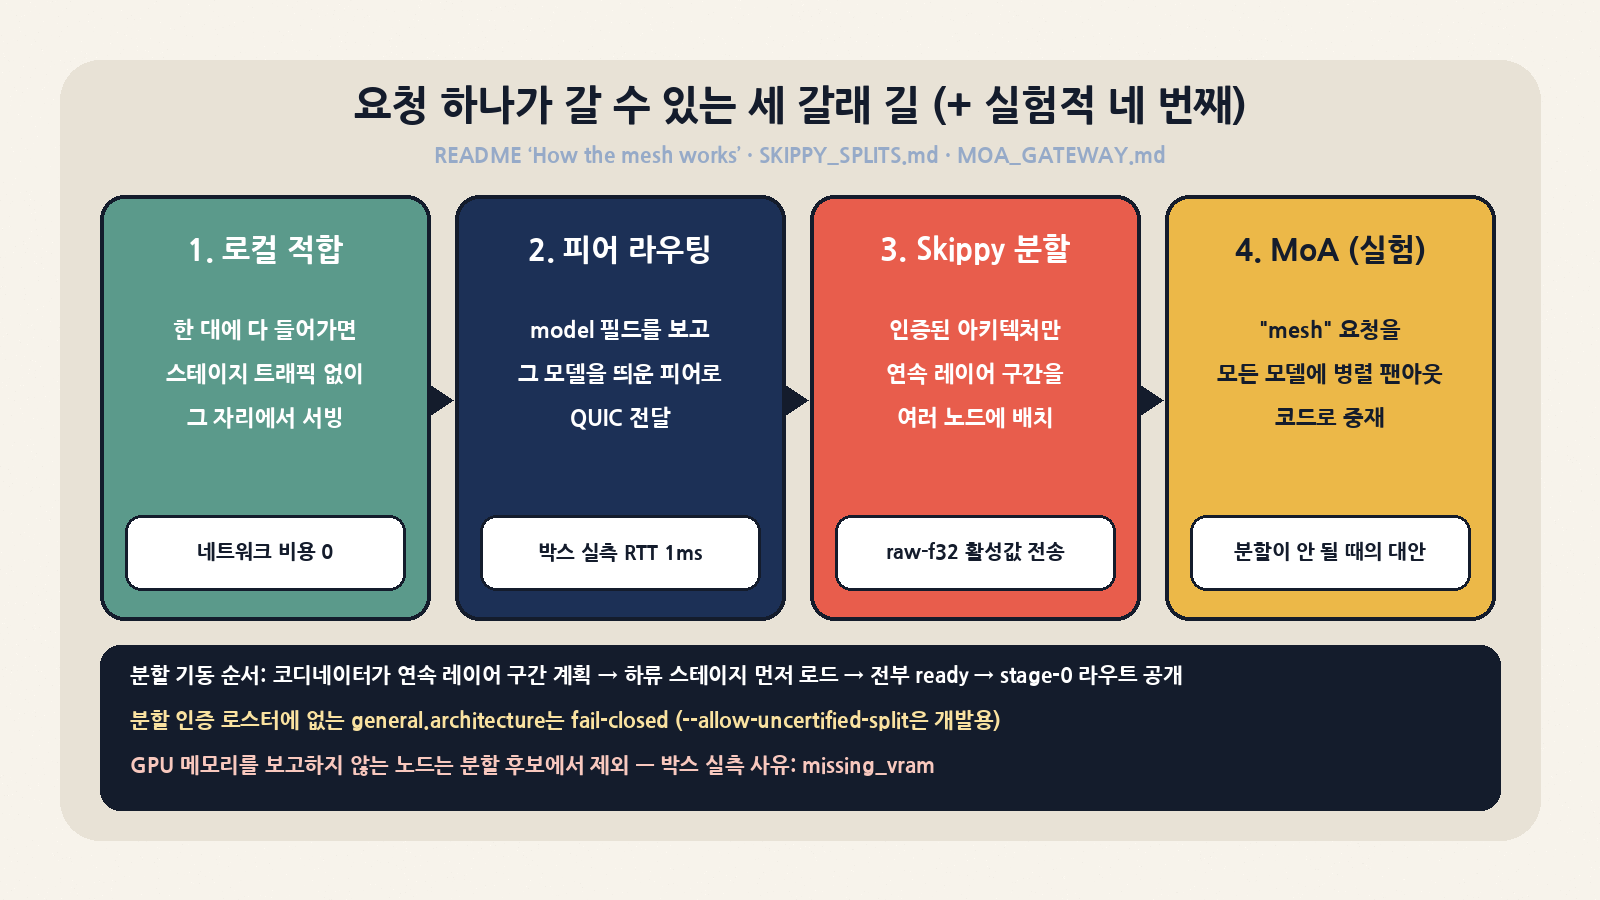
모든 노드는 같은 /v1 API를 노출하고, 요청의 model 필드가 라우팅 키입니다. README의 “How the mesh works”와 분할·MoA 설계 문서를 합치면 경로는 네 갈래입니다.
| 경로 | 언제 | 네트워크가 지는 부담 | 주의점 |
|---|---|---|---|
| 로컬 적합(single-machine fit first) | 한 노드가 모델 전체를 올릴 수 있을 때 — 항상 1순위 | 없음 (스테이지 트래픽 없음) | 가장 빠르고 단순. 분할은 “물리적으로 필요하거나 명시적으로 요청할 때”만 |
| 피어 라우팅 | 다른 피어가 그 모델을 서빙 중일 때 | 요청·응답 스트림만 QUIC로 (토큰마다 왕복하지 않음) | HTTP 라우팅은 지연에 관대. 프리픽스/스티키 어피니티로 같은 세션을 같은 피어에 붙임 |
| Skippy 스테이지 분할 | 모델이 한 대에 안 들어갈 때 (--split) |
토큰마다 스테이지 경계에서 활성값(raw-f32) 전송 — 네트워크가 크리티컬 패스 | 인증된 아키텍처만 허용(fail-closed). 지연·손실이 크면 대화형 성능이 무너짐 |
MoA model: "mesh" (실험) |
메시에 서로 다른 모델이 2개 이상 있을 때 | 팬아웃·수집·리듀서 단계에서만 | “분할이 안 되는 네트워크에서도 메시를 쓰는 길”. 품질 목표는 단일 중형 모델 이상 |
흥미로운 건 MoA 문서(mesh/docs/design/MOA_GATEWAY.md)의 문제의식입니다. 노드가 N개면 큰 모델 하나를 쪼개는 게 VRAM 대비 품질이 가장 좋지만, 그 순간 네트워크가 모든 출력 토큰의 크리티컬 패스에 올라갑니다. RTT·손실·피어 불안정이 일정 수준을 넘으면 split은 대화형 성능을 아예 못 냅니다. 그래서 각 워커는 자기 노드에서 완전히 로컬로 돌리고, 네트워크는 팬아웃·수집·리듀서에서만 쓰는 MoA를 “보완재”로 둡니다. 중재는 LLM 호출이 아니라 결정적 코드로 하고, 진짜 충돌일 때만 리듀서 LLM으로 올립니다. 도구 호출 결과가 돌아오는 턴은 팬아웃 없이 리듀서 경로만 탑니다.
4. 큰 모델을 쪼개는 방식: 레이어 패키지와 토폴로지 플래너
Skippy 분할의 단위는 텐서가 아니라 연속된 레이어 구간입니다. 그리고 쪼개는 대상은 원본 GGUF가 아니라 Hugging Face에 올린 레이어 패키지입니다. 패키지 저장소에는 model-package.json 매니페스트와 레이어별 GGUF 조각(layers/layer-00000.gguf …, shared/)이 들어 있고, 각 피어는 자기에게 배정된 스테이지의 조각만 받습니다. 예를 들어 meshllm/Llama-3.2-1B-Instruct-Q4_K_M-layers는 파일 25개, 약 956MB로 구성돼 있습니다.
| 분할 기동 단계 | 무엇이 일어나나 | 설계 의도 |
|---|---|---|
| 1. 해석 | 코디네이터가 요청된 모델/레이어 패키지를 해석 (불변 리비전 @<sha> 권장) |
피어 간 동일성은 아티팩트 다이제스트가 보장 |
| 2. 아키텍처 입장 검사 | GGUF general.architecture가 번들된 분할 인증 로스터에 없으면 즉시 거절 |
로스터는 llama.cpp 핀 + Skippy ABI + 패치 큐에 묶임. 다른 양자화·재패킹은 허용 |
| 3. 토폴로지 계획 | 피어와 연속 레이어 범위 선택, 런타임 여유분·KV·연산 예약 반영 | 작은 레이어 조각은 캐시/배포 단위, 런타임 스테이지는 실행 단위 |
| 4. 하류 먼저 로드 | 마지막 스테이지부터 올리고 ready 대기 | 절반만 뜬 파이프라인에 요청이 들어가지 않게 |
| 5. stage-0 공개 | 모든 스테이지 ready 후에만 stage-0 라우트 게시 | 클라이언트는 계속 같은 /v1만 사용 |
스테이지 경계의 활성값은 모든 모델에서 고정된 raw-f32로 보냅니다. TOPOLOGY_PLANNER.md는 “전송이 모델별 반올림·클리핑·오버플로를 더하지 않게” 하기 위함이라고 적고, f16·q8 압축 실패 사례는 “연구 증거”로만 남겨 뒀습니다. 대역폭을 희생하고 정합성을 산 선택입니다. 같은 문서의 재미있는 대목은 Falcon-H1/Qwen3Next 같은 재귀(recurrent)·하이브리드 모델입니다. 거대한 시퀀스별 재귀 상태를 옮기지 말고, 그 레이어 구간을 소유한 노드로 다음 토큰을 되돌려 보내며 작은 활성값만 하류로 넘기면 된다는 규칙(“activation crosses topology boundaries, recurrent state defines topology affinity”)입니다.
지원 범위는 FAMILY_STATUS.md가 관리합니다. README 기준 검토된 P0/P1 패밀리 행 72개, 전체 패리티 인벤토리의 인증 행 89개이며 Qwen·Llama·Gemma·Mistral·DeepSeek·GLM·MiniMax·Phi·Granite·EXAONE·Falcon·RWKV 등을 포함합니다. 분할 멀티모달은 Qwen2-VL·Qwen3-VL·Qwen3-VL-MoE·Hunyuan-VL·DeepSeek-OCR이 실제 GGUF+프로젝터 픽스처로 인증돼 있습니다.
5. 네트워크와 신뢰 모델: “private”의 정확한 의미
전송은 QUIC/iroh로 종단 간 암호화되고, 직접 경로가 없으면 관리형 iroh 릴레이가 내용을 읽지 못한 채 암호화 패킷만 전달합니다. 공개 메시는 Nostr 릴레이로 광고되고, 공개하지 않은 메시는 초대 토큰으로 들어갑니다. LAN 전용이라면 --mesh-discovery-mode mdns가 Nostr·공용 iroh 릴레이·공용 STUN을 아예 건드리지 않습니다. 상태는 하트비트에 실린 가십으로 퍼지고, 마스터나 전역 이벤트 로그는 없습니다(최종 일관성).
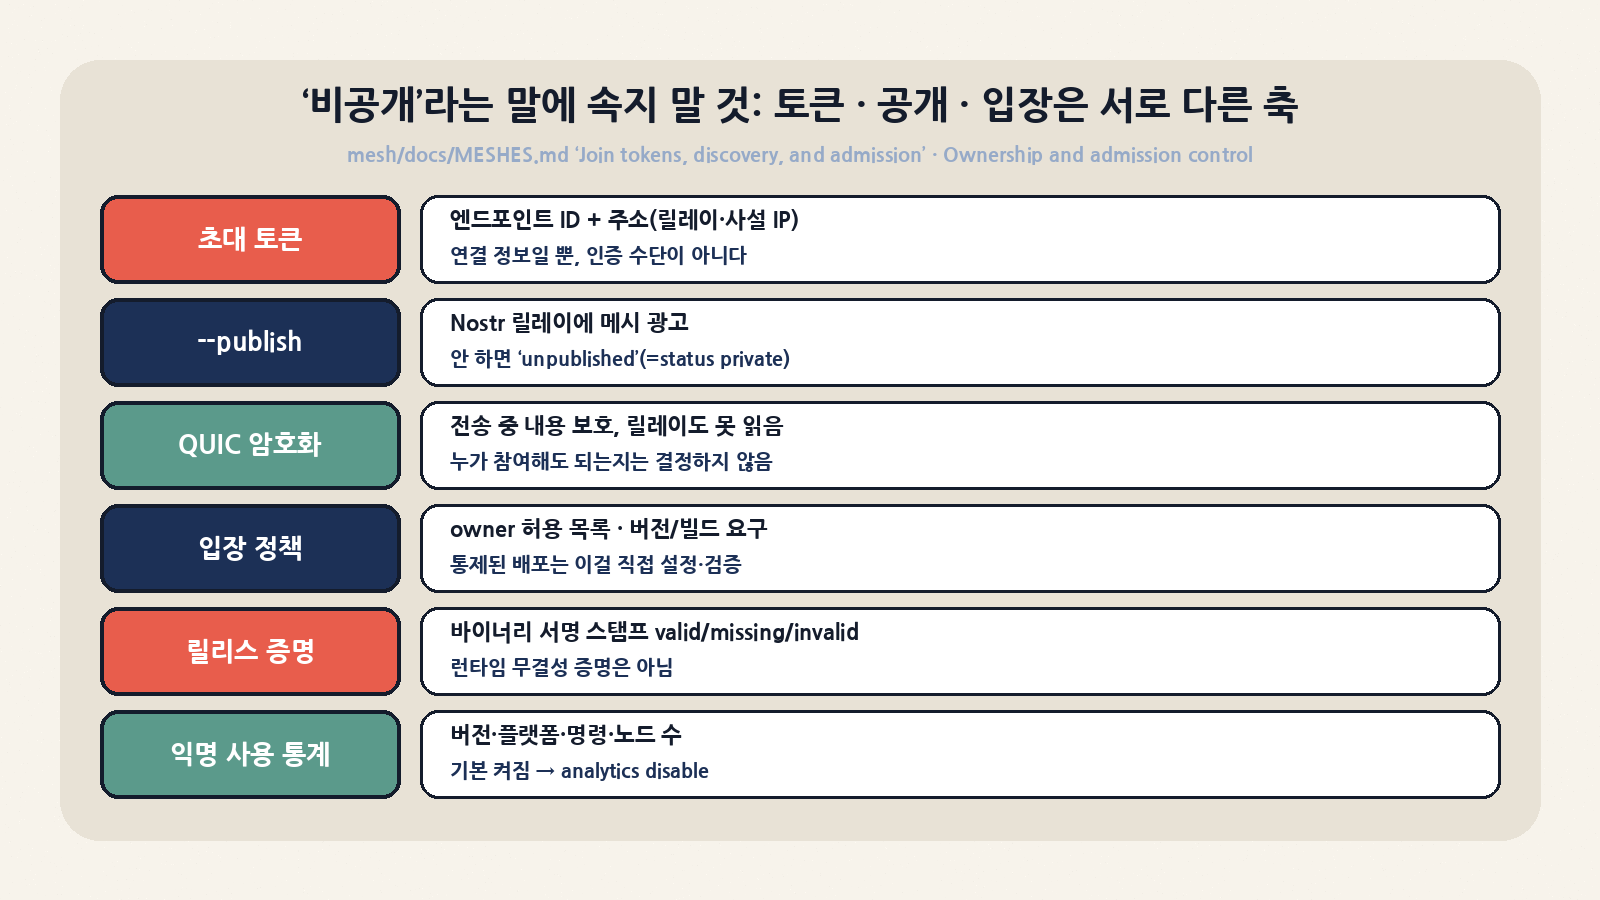
실무자가 가장 오해하기 쉬운 부분을 MESHES.md가 별도 절로 못 박아 두었습니다. 토큰 전달, 공개 여부, 입장 통제는 서로 다른 속성입니다. 상태 API의 publication_state: "private"는 “광고하지 않았다(unpublished)”는 뜻이지 접근 통제가 있다는 증거가 아닙니다. 박스에서 받은 초대 토큰을 base64 디코드해 보면 실제로 노드 ID와 iroh 릴레이 URL, 사설 IP:포트 목록이 들어 있을 뿐입니다.
| 축 | 실제로 보장하는 것 | 보장하지 않는 것 | 운영 권고 |
|---|---|---|---|
| 초대 토큰 | 어디로 연결할지 (엔드포인트 ID + 주소) | 보유자가 참여·추론해도 된다는 권한 | 민감 정보로 취급하되, 숨기는 것을 입장 통제로 착각하지 말 것. argv 대신 --join-file/MESH_LLM_JOIN_FILE |
--publish |
Nostr를 통한 발견 가능성 | 입장 거절 (공개 메시도 거절은 가능) | 사내망은 publish 하지 말고 mDNS 모드 검토 |
| QUIC 암호화 | 전송 중 기밀성 (릴레이 포함) | 누가 피어가 될 수 있는지 | 입장 정책과 별개로 생각 |
| 입장 정책 | owner 허용 목록, 노드 버전·빌드·프로토콜 세대 요구, 서명된 가십 요구 | — | 통제된 배포는 참여 노드 전부에서 직접 설정·검증. 요구 조건을 바꾸면 메시 ID가 새로 파생됨(불변) |
| 릴리스 증명 | 패키징된 바이너리가 서명 당시 그대로인지(valid/missing/invalid) | 런타임 무결성, SDK·네이티브 아티팩트 | 기본 기동은 invalid여도 허용 → 필요하면 attestation 요구 메시로 |
| 익명 사용 통계 | 버전·플랫폼·실행 명령·노드/모델 수 전송 (프롬프트·출력·경로·IP·피어 정보 제외라고 명시) | — | 기본 켜짐. 첫 실행 시 1회 고지. mesh-llm analytics disable |
공개 메시(--auto)에서 블랙보드 게시물은 그 메시의 모든 피어에게 보이고, 공개 메시에 내 GPU를 내놓는다는 건 낯선 사람의 프롬프트를 내 하드웨어에서 돌린다는 뜻입니다. 저장소에는 Lightning 결제·지갑 크레이트와 payment.offers 필드(박스의 /v1/models 응답에서 free_available: true, rate_unit: msat_per_million_tokens)도 이미 보이는데, 문서는 이것을 “계획된 PoC”로 설명하고 최신 프리릴리스 노트에는 “내장 Lexe 지갑을 기본 빌드에서 제외”한다는 변경이 있습니다. 유료 컴퓨트 공유는 아직 실험 단계로 보는 게 맞습니다.
6. 설치와 운영 명령
설치는 릴리스 실행 파일 스크립트(curl -fsSL https://raw.githubusercontent.com/Mesh-LLM/mesh-llm/main/install.sh | bash), Apple Silicon Homebrew(brew install Mesh-LLM/tap/mesh-llm), 또는 포터블 번들 압축 해제입니다. 파이프 설치가 꺼려지면 이 글처럼 릴리스 tarball과 .sha256을 받아 직접 확인하는 편이 낫습니다. 소스 빌드는 just, cmake, Rust, sccache, mold(Linux), Node.js 24가 필요합니다.
# 0) 통계 끄기 (첫 serve 전에)
mesh-llm analytics disable

# 1) 메시 없이 GGUF 하나만 OpenAI API로 (디버그/개발용 경로)
mesh-llm serve --local-model-only --gguf /models/model.gguf --port 9337

# 2) 비공개 메시 시작 (광고 안 함) → 상태 API에서 초대 토큰 확인
mesh-llm serve --gguf /models/model.gguf
curl -s localhost:3131/api/status | jq -r .token > invite.token

# 3) 다른 머신: 모델 없이 API만 쓰는 클라이언트로 합류
mesh-llm client --join-file ./invite.token

# 4) 큰 모델 분할 (각 노드에 같은 불변 리비전)
mesh-llm serve --model hf://meshllm/<repo>@<rev> --split

# 5) 진단
mesh-llm doctor
mesh-llm gpus
curl -s localhost:3131/api/status | jq '{state:.node_state, peers:(.peers|length)}'| 포트/엔드포인트 | 기본값 | 용도 |
|---|---|---|
| OpenAI 호환 API | 127.0.0.1:9337/v1 (--port, --listen-all) |
추론. 모든 노드가 같은 표면 |
| 웹 콘솔·관리 API | :3131 (--console, --headless로 UI만 숨김) |
/api/status, /api/runtime/stages, 런타임 이벤트, MCP 서버 /mcp |
| 메시 QUIC | 임의 UDP (--bind-port, 다중 NIC은 --bind-ip) |
피어 전송·스테이지 트래픽. 방화벽·NAT 설정 대상 |
| 에이전트 런처 | mesh-llm goose | claude | opencode | pi |
메시를 추론 공급자로 붙여 코딩 에이전트 실행 |
| 플러그인 | mesh-llm plugins install … |
Flash-MoE SSD 백엔드, DwarfStar(ds4) 엔진 등 |
--local-model-only에는 함정이 몇 개 있습니다. 경로는 절대 경로여야 하고 심볼릭 링크면 안 됩니다(HF 캐시 경로는 realpath로 풀어야 함). 카탈로그 이름은 이 모드에서 해석되지 않고, 모델이 로컬 용량에 안 맞으면 분산으로 폴백하지 않고 그냥 실패합니다. README는 이 경로를 “도구 호출 정규화가 빠진 디버그 경로”라고 분명히 적고, 프로덕션 OpenAI 클라이언트는 일반 메시 포트를 쓰라고 권합니다.
7. 박스 스모크 테스트: 2노드 비공개 메시를 실제로 띄워 봤다
GPU 없는 VM에서 무엇을 확인할 수 있고 무엇은 못 하는지부터 분명히 해 두겠습니다. 단일 노드 서빙, 초대 토큰 합류, QUIC 피어 라우팅, 호스트 장애 시 동작은 CPU로도 검증됩니다. 반면 Skippy 분할은 GPU 메모리를 전제로 배치하기 때문에(아래 결과 참조) 이 박스에서는 돌지 않았습니다. 공개 메시(--auto, --publish)에는 일절 참여하지 않았고, 노드마다 HOME을 분리하고 통계를 끈 뒤 시작했습니다.
| 환경 | 값 |
|---|---|
| 머신 | 8 vCPU Xeon VM, RAM 15GiB, GPU 없음 (mesh-llm doctor: flavor cpu, “runtime-selectable GPU 없음 → CPU 전용”) |
| 바이너리 | mesh-llm-v0.78.1-x86_64-unknown-linux-gnu.tar.gz 67,046,654B, sha256 공식 파일과 일치. mesh-llm 0.78.1, 릴리스 증명 valid |
| 모델 | Qwen2.5-3B-Instruct Q4_K_M GGUF (2.1GB, qwen2, 36블록, 컨텍스트 32,768) |
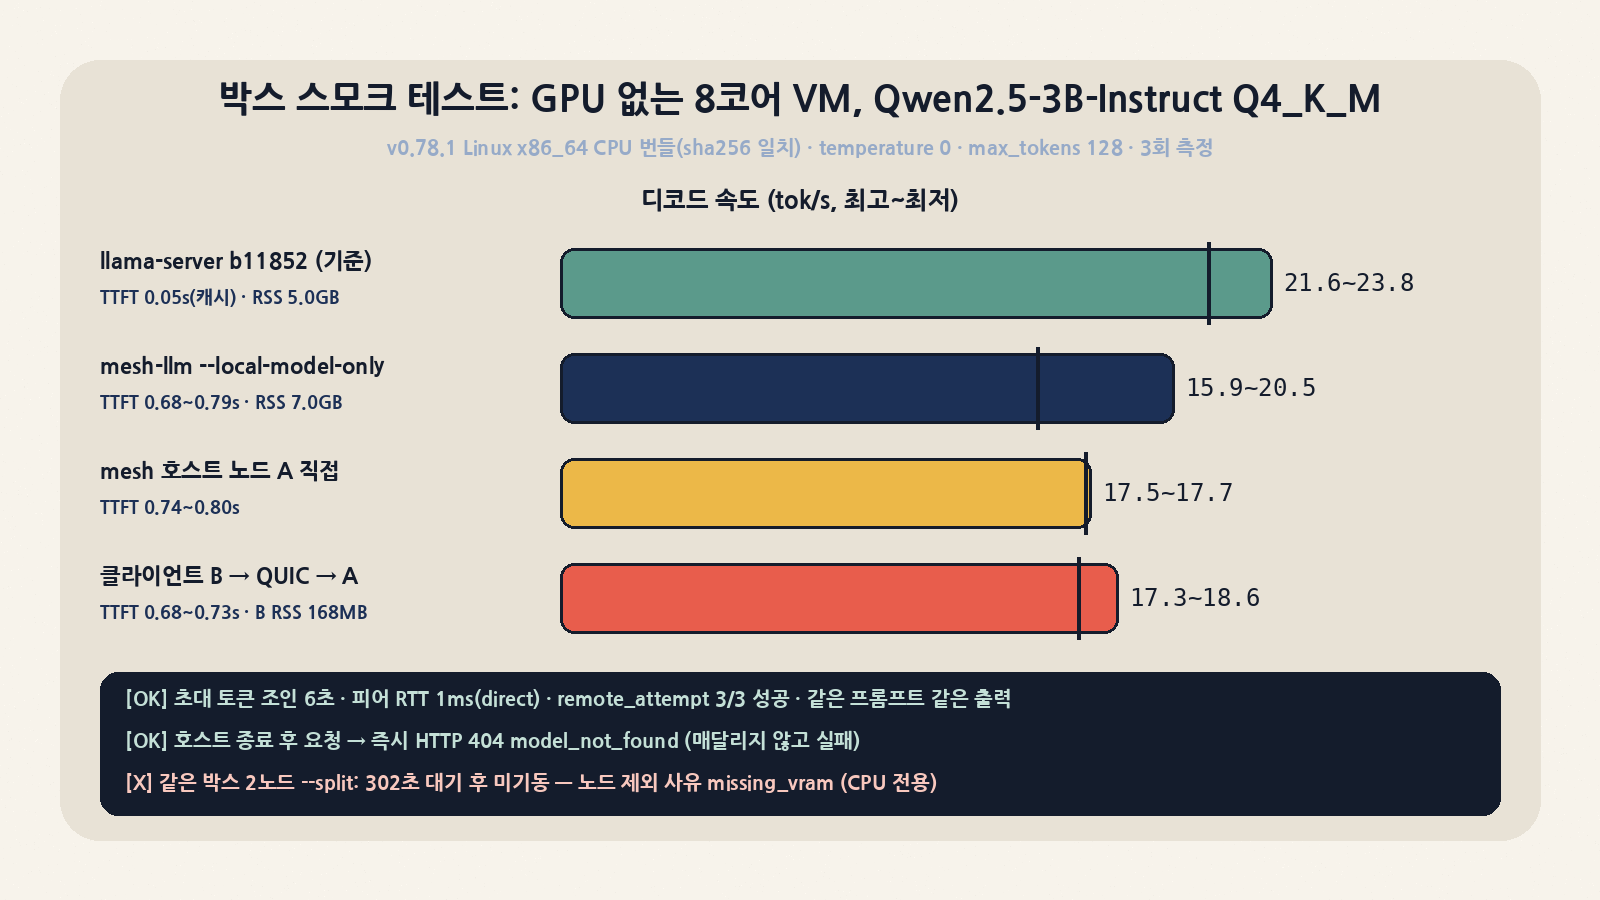
| 측정 | 스트리밍 chat completions, 한국어 프롬프트(입력 58토큰), temperature 0, max_tokens 128, 구성마다 3회. TTFT는 첫 콘텐츠 청크, 디코드 속도는 (출력 토큰−1)/(전체−TTFT) |
| 기준선 | 같은 GGUF를 llama.cpp b11852 llama-server -t 8로 |
| 구성 | TTFT (1/2/3회, 초) | 디코드 tok/s (1/2/3회) | 피크 RSS |
|---|---|---|---|
| llama-server b11852 (기준) | 0.241 / 0.049 / 0.049 | 21.61 / 23.75 / 22.17 | 4.99GB |
mesh-llm --local-model-only |
0.793 / 0.698 / 0.680 | 15.90 / 20.42 / 20.48 | 7.00GB |
| 메시 호스트 노드 A에 직접 | 0.800 / 0.749 / 0.741 | 17.67 / 17.72 / 17.52 | 7.05GB |
| 클라이언트 노드 B → QUIC → A | 0.684 / 0.728 / 0.697 | 18.12 / 17.28 / 18.60 | B 자체 168MB |
읽는 법은 이렇습니다. 첫째, 같은 llama.cpp 계열 커널이라 디코드 속도는 기준선 대비 약 86~93% 수준(로컬 전용 모드 20.4 vs 22~24 tok/s)입니다. 둘째, TTFT 차이가 큽니다. llama-server는 같은 프롬프트를 반복하면 프롬프트 캐시로 0.05초에 첫 토큰을 냈지만, mesh-llm 경로는 반복해도 0.68~0.80초에 머물렀습니다. 이번 측정만으로는 원인(프롬프트 캐시 재사용 정책인지, 프런트엔드·런타임 이벤트 계층 오버헤드인지)을 가를 수 없어서 단정하지 않겠습니다. 셋째, 메시 모드 호스트는 로컬 전용 모드보다 디코드가 약 14% 느렸고(17.6 vs 20.4), RSS도 llama-server보다 약 2GB 컸습니다. 두 쪽 모두 컨텍스트 32,768로 잡혀 있었으니 기본 KV·워크스페이스 예약 차이로 보이지만, 이것도 이번 데이터로는 추정입니다.
정작 이 프로젝트다운 결과는 2노드 쪽입니다.
| 시나리오 | 실제 관찰 (로그·API 값 그대로) | 해석 |
|---|---|---|
| 합류 | client --join-file 실행 후 6초 만에 B의 /v1/models에 A의 모델 노출. 피어 rtt_ms: 1, latency_source: direct |
같은 호스트라 릴레이 없이 직접 경로. 실제 WAN에선 릴레이 경유 가능 |
| 원격 라우팅 | B의 routing_metrics: request_count 3, success_rate 1.0, remote_attempt_count 3, local 0 |
요청이 실제로 A로 넘어가 처리됨. 클라이언트 노드는 168MB로 가벼움 |
| 결과 동일성 | A 직접 호출과 B 경유 호출의 출력 문장이 글자 하나까지 동일 (temperature 0) | 프록시 경로가 샘플링에 개입하지 않음 |
| 가상 모델 | /v1/models에 실제 모델 외에 mesh(owned_by plugin:mesh-moa)가 함께 노출 |
클라이언트가 모델 목록을 그대로 UI에 띄우면 사용자가 MoA를 고를 수 있음에 유의 |
| 호스트 장애 | A 종료 4초 뒤 B로 요청 → 0.0008초 만에 HTTP 404 model_not_found “no local or remote host serving this model”, 모델 목록 비워짐 |
매달리지 않고 빨리 실패. 다만 대체 호스트가 없으면 그냥 실패이므로 중복 배치는 운영자 몫 |
2노드 --split (Llama-3.2-1B 레이어 패키지, 불변 리비전) |
302초 대기 후 미기동. A: “split runtime needs at least two participating nodes … found 1 eligible [0.0GB …]; excluded [missing_vram]”. B: “stat package-v2 artifact shared/metadata.gguf: No such file or directory”. 내려받은 건 카탈로그 8.6MB뿐 |
CPU 전용 노드는 VRAM 0GB로 보고돼 분할 후보에서 빠짐. 분할을 평가하려면 GPU 노드 2대 이상이 필요 (B 쪽 오류는 분할 계획 전 단계에서 패키지 조각이 아직 없어서 난 것으로 보임) |
8. 비슷한 도구와 비교
아래 표는 각 프로젝트의 공개 문서에 적힌 설계 방향을 기준으로 정리한 것입니다. Mesh LLM 저장소에도 EXO_COMPARISON.md가 따로 있는데, Exo 쪽을 꽤 공정하게 설명하고 있어 읽어 볼 만합니다.
| 관점 | Mesh LLM | Exo | llama.cpp RPC (ggml-rpc-server) |
vLLM / SGLang (+Ray) |
|---|---|---|---|---|
| 주 무대 | 이기종 노드, 사설·공개 메시, WAN 포함 | 근거리 Apple Silicon 클러스터 | 신뢰하는 LAN 안 원격 백엔드 | 데이터센터 GPU 클러스터 |
| 분할 방식 | 연속 레이어 구간 스테이지(레이어 패키지) | 텐서 병렬 + 파이프라인 병렬, 토폴로지 인식 배치 | 레이어를 원격 장치에 오프로드 | 텐서·파이프라인·전문가 병렬 |
| 추론 엔진 | 패치된 llama.cpp (GGUF) | MLX / MLX distributed | llama.cpp | 자체 엔진(PagedAttention 등), HF 가중치 |
| 발견·전송 | Nostr / 초대 토큰 / mDNS, QUIC·iroh, 가십 | libp2p, mDNS | 수동으로 호스트:포트 지정 | 클러스터 매니저가 담당 |
| 요청 라우팅 | model 필드 → 피어, 어피니티, MoA |
인스턴스 생성·배치 모델 | 없음 (단일 서버) | 앞단 게이트웨이를 따로 둠 |
| 보안 모델 | 종단 암호화 + 별도 입장 정책·증명 | 로컬 클러스터 전제 | 공식 문서가 신뢰망 밖 노출을 경고 | 인프라 레이어에 위임 |
| CPU 전용 노드 | 서빙·클라이언트 가능, 분할 후보에선 제외(박스 실측) | Linux CPU는 하위 티어 | 가능 | 사실상 GPU 전제 |
| 잘 맞는 질문 | “흩어진 장비를 하나의 API로” | “맥 여러 대로 큰 모델을” | “옆 머신 GPU를 빌려 쓰기” | “최대 처리량·SLA” |
9. 트레이드오프와 주의점
| 선택 | 얻는 것 | 치르는 것 |
|---|---|---|
| llama.cpp/GGUF 위에 구축 | 넓은 하드웨어 커버리지(CPU~CUDA~Metal), 방대한 GGUF 생태계 | 업스트림 핀·패치 큐 유지 부담. 데이터센터급 배칭 처리량은 전용 엔진에 못 미침 |
| 레이어 구간 파이프라인 분할 | WAN 친화적(경계에서 활성값만), 노드별 필요한 조각만 다운로드 | 토큰마다 경계 왕복 → RTT가 디코드 지연에 직결. 텐서 병렬 같은 장치 내 대역폭 이득은 없음 |
| raw-f32 활성값 고정 | 모델별 수치 문제 없는 정합성 | 압축 대비 대역폭 손해 |
| 인증 로스터 fail-closed | “돌긴 도는데 결과가 미묘하게 틀린” 분할 방지 | 새 아키텍처는 인증 전까지 --allow-uncertified-split 없이 못 씀 |
| 가십 기반 최종 일관성 | 단일 마스터 장애점 없음 | 노드마다 메시 뷰가 잠시 다를 수 있음. 디버깅은 /api/status 비교부터 |
| 빠른 릴리스 주기 | 기능·수정이 빠르게 들어옴 (최근 1주 커밋 50개 이상) | 버전 혼합 시 스테이지 프로토콜은 세대가 다르면 fail-closed. 노드 버전 핀 필요 |
- 기본값 점검: 익명 통계는 기본 켜짐, 업데이트 확인도 기본 켜짐(
updates.check = false또는MESH_LLM_NO_UPDATE_CHECK=1). 사내 배포 이미지에서는 둘 다 명시적으로 끄세요. --auto는 공개 메시 합류: 모델 미지정 시 1~8GB 소형 노드에는 기본 소형 모델(현재meshllm/laya-multilingual-F16-GGUF, chat이 아니라/systemone판정 전용)을 내려받아 서빙합니다. 시험 삼아 쳐 보기 전에 무엇이 일어나는지 알고 치세요.- Windows 네이티브: README에 v0.76 시점 기준 배포·로딩 버그 우회 절차가 길게 남아 있습니다. 현재 버전에서 재현되는지 먼저 확인하세요.
- macOS 다중 노드: 모든 노드에서 실행 바이너리 단위로 Local Network 권한을 허용해야 분할이 붙습니다. 처리량을 기록하기 전에 양쪽에서
path_type=direct,observed_via_relay=false를 확인하라는 게 공식 권고입니다. - 도구 호출이 필요한 에이전트:
--local-model-only가 아니라 일반 메시 포트를 쓰세요(호스트 런타임 정규화기가 거기에만 있음).
10. 누가 도입하면 좋은가
| 상황 | 판단 | 이유 |
|---|---|---|
| 팀원 PC·워크스테이션 GPU가 흩어져 있고, 에이전트들이 쓸 공용 로컬 LLM 엔드포인트가 필요 | 적극 검토 | 피어 라우팅 + 클라이언트 노드(박스 168MB) + 에이전트 런처가 정확히 이 용도 |
| 70B~200B급 GGUF를 GPU 여러 대에 나눠 올리고 싶은 홈랩/연구실 | 검토 (GPU 필수) | 레이어 패키지 분할이 핵심 기능. 단 CPU 노드는 분할에서 빠지고, 노드 간 지연이 디코드 속도를 좌우 |
| Apple Silicon 여러 대 + Thunderbolt | Exo와 병행 비교 | MLX·RDMA 경로는 Exo가 더 직접적. Mesh는 이기종 혼합 시 강점 |
| SLA가 있는 고처리량 프로덕션 API | 비추천(현재) | 저장소 스스로 “experimental distributed-systems software”라고 명시. vLLM/SGLang 쪽이 맞음 |
| 규제 데이터·사내 기밀 프롬프트 | 조건부 | mDNS/비공개 메시 + owner 허용 목록 + 증명 요구 메시 + 통계 끄기까지 설정·검증한 뒤에만. 공개 메시는 금지 |
정리하면 Mesh LLM의 진짜 기여는 “분산 추론 커널”이 아니라 분산 추론을 운영 가능한 제품으로 포장하는 계층입니다. 발견·입장·라우팅·배치·증명을 Rust 크레이트 경계로 나눠 두고, 실패해야 할 때 빨리 실패하도록(인증 로스터, 세대 불일치, 모델 없음 404) 설계했습니다. GPU 없는 박스에서도 2노드 라우팅은 6초 만에 붙고 결과가 바이트 단위로 같았지만, 단일 노드 TTFT와 메모리 오버헤드는 llama-server보다 분명히 무거웠고, 분할은 GPU가 없으면 아예 시작되지 않았습니다. 흩어진 GPU를 이미 갖고 있는 팀이라면 비공개 메시 하나를 띄워 /api/status와 라우팅 지표부터 보는 것이 가장 싼 평가 방법입니다.