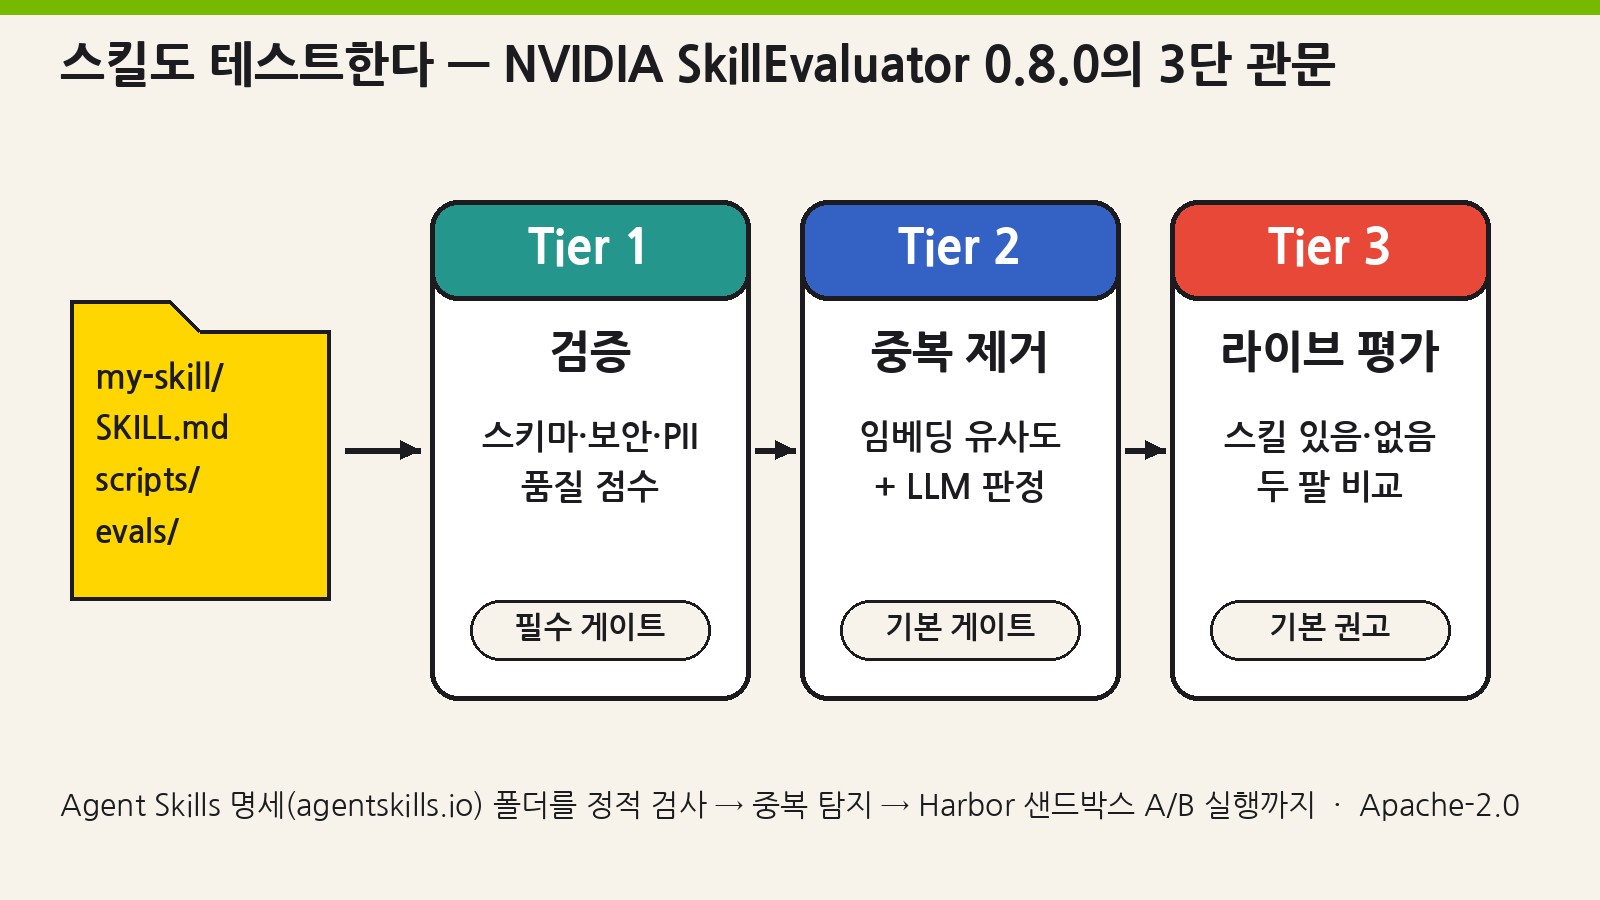
에이전트 스킬(Agent Skills)은 이제 Claude Code·Codex·OpenCode 같은 코딩 에이전트에 “업무 매뉴얼”을 꽂아 넣는 사실상의 표준 단위가 됐습니다. 문제는 스킬이 늘어날수록 “이 SKILL.md가 정말 에이전트를 더 잘하게 만드는가, 아니면 컨텍스트만 잡아먹는가”를 아무도 재지 않는다는 점입니다. 오늘(2026-11-13) GitHub Trending 파이썬 부문에 오른 NVIDIA/SkillEvaluator는 바로 이 질문을 CI 파이프라인 언어로 바꿔 놓은 도구입니다. 정적 검사 → 의미 중복 탐지 → 스킬 있음/없음 A/B 라이브 실행이라는 3단 구조로, 스킬을 코드처럼 테스트하고 게이트에 걸 수 있게 해 줍니다.
이 글은 입문 소개가 아니라 실무 도입 검토용 해부입니다. 저장소 구조, 각 Tier의 판정 규칙과 임계값, 설계상 트레이드오프, 실제 명령어, 그리고 GPU·Docker가 없는 박스에서 직접 돌려 본 결과까지 정리했습니다.
한눈에 보는 SkillEvaluator
| 항목 | 내용 |
|---|---|
| 저장소 | NVIDIA/SkillEvaluator (GitHub, 2026-06 생성) |
| 최신 릴리스 | v0.8.0 (CHANGELOG 기준 2026-11-05, GitHub 릴리스 게시 2026-11-07 KST), PyPI 패키지명 skillevaluator |
| 라이선스 | Apache-2.0 (NOTICE·THIRD_PARTY_NOTICES 별도 동봉) |
| 언어·런타임 | Python 3.12 / 3.13 / 3.14 (requires-python >=3.12,<3.15), uv 관리 권장 |
| 평가 대상 | Agent Skills 명세(agentskills.io) 스킬, 규칙(.mdc), 워크플로, 플러그인(agent_plugin.yaml, .claude-plugin/plugin.json) |
| 핵심 의존 도구 | SkillSpector(보안 스캔), Gitleaks(시크릿), Semgrep(선택), Bandit·pip-audit(security extra), Harbor 0.25.0(Tier 3 샌드박스) |
| LLM 공급자 | openai, anthropic, nv_build, bedrock, openai-compatible |
| 지원 수준 | README 표기 “Experimental” — 커뮤니티 지원, SLA·엔터프라이즈 지원 없음 |
| 관련 자료 | arXiv 2608.20614 “Evaluating Skills, Not Just Agents: Agentic Continuous Evaluation of Skills”, NVIDIA Verified Skills 파이프라인(NVIDIA/skills)의 일부 |
왜 지금 ‘스킬 평가’인가
스킬은 프롬프트보다 길고, 스크립트·참조 문서·MCP 설정까지 품은 실행 가능한 패키지입니다. 그래서 세 가지 위험이 동시에 생깁니다. ① 공급망 위험 — 프롬프트 인젝션, 데이터 유출 지시, 숨은 유니코드 같은 악성 패턴. ② 컨텍스트 낭비 — 같은 지침을 여러 섹션·여러 스킬이 반복해 토큰 예산을 소모. ③ 효과 불명 — 스킬을 넣었는데 에이전트 성과가 오히려 떨어지거나, 아예 스킬이 로드되지 않는 경우. SkillEvaluator는 이 셋을 각각 Tier 1, Tier 2, Tier 3에 대응시킵니다. 그리고 각 Tier는 독립적으로 실행할 수 있어, 키 없는 정적 검사만 먼저 CI에 거는 점진적 도입이 가능합니다.
아키텍처: 3개의 독립 Tier
| Tier | 묻는 질문 | 대표 명령 | 필요한 것 | 게이트 기본값 (validate) |
|---|---|---|---|---|
| Tier 1 검증 | 스킬이 안전하고 형식이 맞는가? | skillevaluator tier1 ./my-skill --no-llm |
외부 스캐너(SkillSpector·Gitleaks는 없으면 고정 버전 자동 내려받기, Semgrep 선택), LLM 체크는 공급자 키 | 항상 종료 코드를 결정(실패·필수 스캐너 증거 누락 시 nonzero) |
| Tier 2 중복 제거 | 지침이 반복·중첩되는가? | skillevaluator tier2 ./my-skill --catalog ./skill-catalog.json |
임베딩 공급자 + (스킬 내부 분석은) 채팅 LLM | 기본 게이트, --no-block-on-dedup로 권고 전환 |
| Tier 3 라이브 평가 | 스킬이 실제로 에이전트를 돕는가? | skillevaluator tier3 ./my-skill |
공급자 키, 지원 에이전트, 실행 중인 샌드박스(기본 Docker) | 기본 권고, --block-on-agent-eval로 게이트 승격 |
설계에서 눈여겨볼 점은 “증거가 없으면 통과가 아니다”라는 원칙이 끝까지 관철된다는 것입니다. --no-llm을 줘도 스캐너 요구는 사라지지 않고, 돌지 못한 스캐너는 INCOMPLETE로 기록돼 nonzero로 끝납니다. Tier 2도 --catalog 없이 돌리면 “스킬 간 비교는 실행되지 않았다”고 명시할 뿐, 다른 스킬과 겹치지 않는다고 주장하지 않습니다. 정적 품질만 본 결과의 “게시 적격성(Publication eligibility)”은 계속 Incomplete로 남습니다. 보안 도구다운 보수성이지만, 처음 도입하면 “왜 다 통과했는데 실패냐”는 질문이 반드시 나오는 지점이기도 합니다.
저장소 구조
| 경로 | 역할 |
|---|---|
src/skillevaluator/validators/ |
Tier 1 검사기 모음: schema, security, secrets, unicode_smuggle, license, quality_score, rubric_eval, script_lint, mcp_static, url_policy, dependencies 등 |
src/skillevaluator/config/ |
quality-default.yaml(품질 규칙·배점), pii_patterns.yaml, semgrep_rules.yaml, unicode_smuggle_patterns.yaml, license_config.yaml, 프로필 |
src/skillevaluator/embedding/, tier2/ |
임베딩 클라이언트·추출기와 Tier 2 명령 |
src/skillevaluator/evaluation/, tier3/ |
Tier 3 차원 판정(dimension_judge), 기대값·리포트·피드백 채팅, Harbor 어댑터, 참조 스킬(text-analyzer 등) |
src/skillevaluator/inference/ |
LLM 호출·재시도·JSON 스팬 파싱, 정적 발견 사항을 재검토하는 finding_verifier |
src/skillevaluator/reporting/ |
cli·json·html·markdown·sarif 리포터, BENCHMARK.md 카드, Streamlit 대시보드(선택) |
ci/ |
GitHub Actions·GitLab CI 번들(0.7.0~0.8.0), 변경 스킬 선택, 리포트 게시, 시크릿 마스킹, 출처 검증 스크립트 |
skills/skillevaluator/ |
에이전트가 SkillEvaluator를 직접 쓰도록 하는 스킬 자체 |
패키징도 계층을 그대로 따릅니다. 기본 설치는 click·pydantic·jinja2·rich 등만 끌어오는 정적 검증 전용이고, llm(anthropic·boto3·litellm·openai), tier2, tier3(harbor[gke]==0.25.0, mcp 등), security(bandit, pip-audit), dashboard(streamlit), all extra로 나뉩니다. pyproject 주석에 “기본 설치는 Harbor나 LLM 클라이언트를 끌어오면 안 된다”고 못 박아 둔 것은, CI 러너의 공급망 표면을 줄이려는 의도로 읽힙니다. litellm을 <1.94.0.dev0로, Harbor를 정확히 0.25.0으로 고정한 것도 “검증한 조합만 허용”한다는 같은 철학입니다.
Tier 1 해부: 결정적 검사 + 선택적 LLM 판정
Tier 1은 스키마·버전·보안·PII·라이선스·코드 무결성·의존성·유니코드·품질·스크립트 린트 10개 체크로 구성됩니다. 핵심은 LLM 없이도 결정적으로 같은 입력 → 같은 종료 코드가 나온다는 점입니다. 공급자를 설정하면 --llm으로 LLM 보안 분석을, --llm-verify로 각 정적 발견 사항을 문맥 속에서 재검토하는 2차 패스를 추가합니다. 재검토에서 확신도 높은 오탐으로 판정돼도 발견 사항은 지워지지 않고 INFO로 강등된 채 판정 모델·근거와 함께 남습니다.
품질 점수(quality-check): 4개 가중 범주
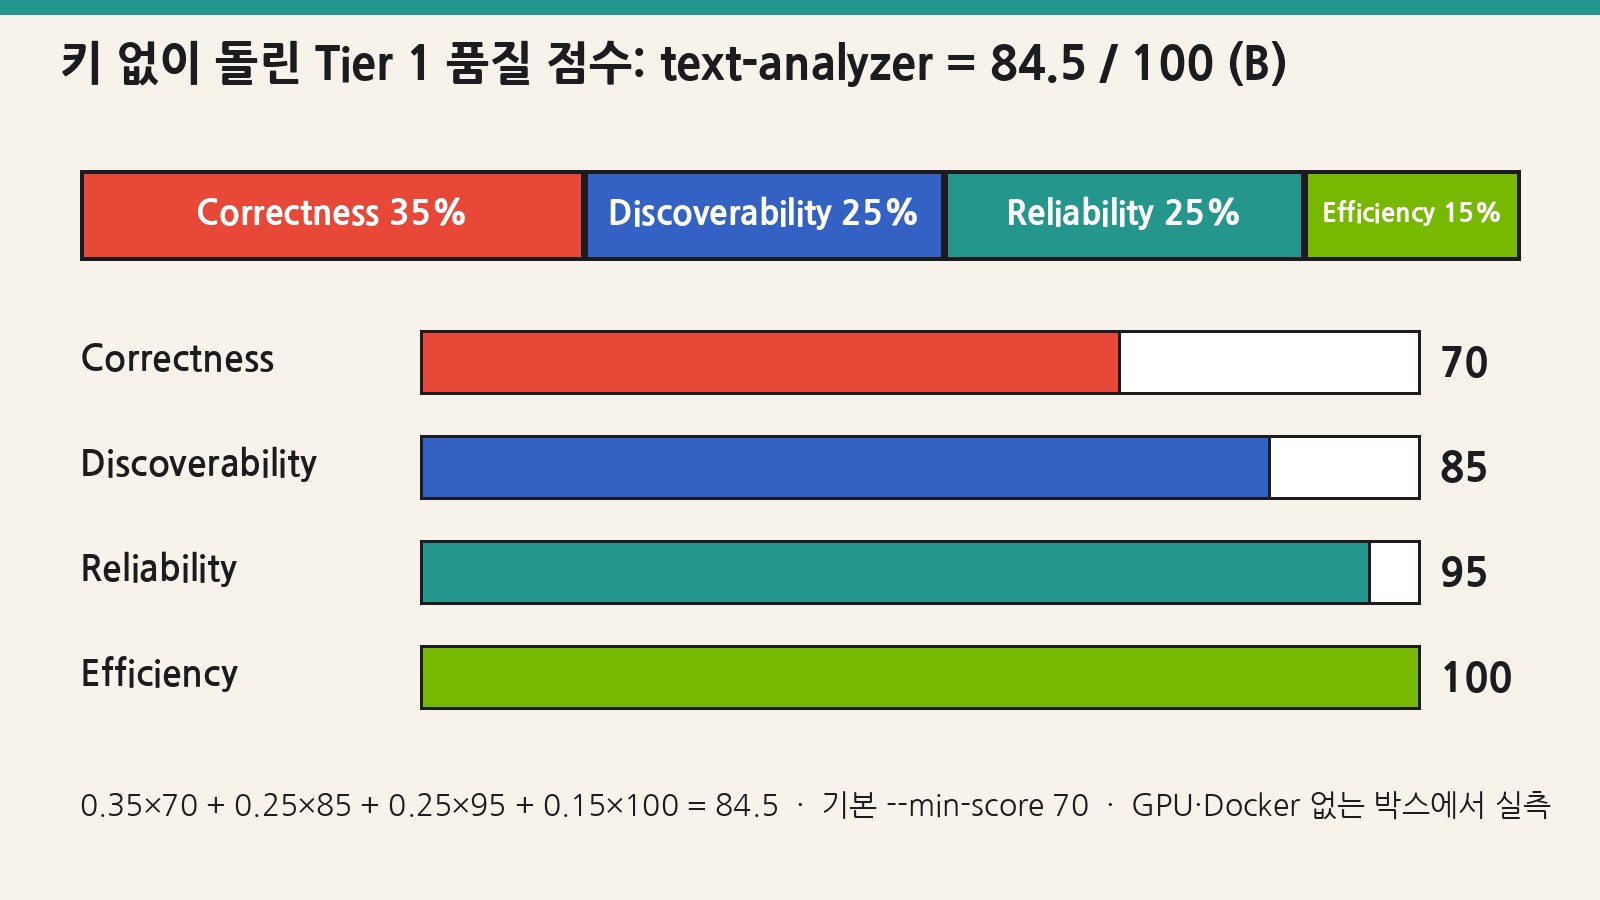
| 범주 | 가중치 | 보는 것 |
|---|---|---|
| Correctness | 35% | 프런트매터, 이름 규칙, 예제, 경로, 스킬 유형별 구조 |
| Discoverability | 25% | 설명 품질, 트리거 문구, 목적·범위, 이름 |
| Reliability | 25% | 오류 처리, 선행 조건, 한계, 트러블슈팅, 구현 안전장치 |
| Efficiency | 15% | 토큰 예산, 본문 길이, 반복, 지시 명확성, 참조 활용 |
등급은 90 이상 A, 80 B, 70 C, 60 D, 미만 F이고 기본 --min-score는 70입니다. SKILL.md 5,000토큰 예산은 권고치지만 넘으면 MEDIUM 발견 사항과 함께 Efficiency에서 15점이 깎입니다. 정책 파일의 severity override로 발견 사항의 심각도는 바꿀 수 있어도 최소 점수 요건은 우회할 수 없고, 컬렉션 평균이 개별 스킬의 미달을 가리지도 못하게 돼 있습니다. 0.8.0 이후 Unreleased 항목에는 --quality-config에 Reliability 오류 처리 규칙 3종을 조정하는 error_handling 섹션이 추가됐습니다.
LLM 루브릭(rubric-eval): 9개 기준
| # | 기준 | 중요도 |
|---|---|---|
| 1 | 설명 명확성·언제 쓰는지 | High |
| 2 | 지시 명확성·실행 가능한 단계 | High |
| 3 | 예제 품질·질의 다양성 | High |
| 4 | 문서 완결성 | Medium |
| 5 | 범위 정의 | Medium |
| 6 | 어조·서식 | Low |
| 7 | 양성·음성 질의에 대한 트리거 시뮬레이션 | High |
| 8 | 엔드투엔드 워크플로 완결성 | High |
| 9 | 실행 가능한 오류 처리 | Medium |
각 기준은 0~10점이며, 통과 판정은 모델이 내놓은 boolean이 아니라 로컬 평가기가 7점 이상인지로 결정합니다. 전체 점수는 중요도 가중 평균이고, 평균이 최소 점수를 넘더라도 기준 하나라도 미달이면 실패입니다. 판정 모델의 응답이 JSON이 아니거나 기준을 빠뜨리거나 지어내면 문제를 명시해 한 번 더 묻고, 두 번째도 실패하면 HIGH llm_invalid_response로 떨어뜨립니다. LLM-as-judge를 쓰되 판정권은 결정적 코드에 두는 구조입니다.
그 밖에 유니코드 밀반입 탐지(Unicode Tags U+E0000~E007F는 CRITICAL로 숨은 ASCII를 복호화해 보여 줌, BiDi 오버라이드는 HIGH, 제로폭 문자는 MEDIUM/LOW), PII·시크릿 스캔(--pii-waivers로 예외 관리, 0.8.0 추가), 플러그인 MCP 정적 검사 등이 Tier 1에 들어 있습니다.
Tier 2 해부: 임베딩 + Union-Find + LLM 판정
Tier 2는 두 갈래입니다. 스킬 내부 중복(context-optimization-check, 별칭 dedup-scan)은 청크를 일괄 임베딩한 뒤 코사인 유사도 0.80 이상 쌍을 Union-Find로 클러스터링하고, 각 후보 클러스터의 실제 텍스트를 채팅 LLM에 보내 판정·확신도·근거·권장 조치를 받습니다. DUPLICATE 판정이 확신도 0.70 이상이면 HIGH(차단), 미만이면 MEDIUM(권고)입니다. 스킬 간 유사도(similarity-check)는 채팅 LLM을 전혀 부르지 않고 임베딩만으로 판정합니다. 외부 벡터 DB나 카탈로그 서비스 없이 로컬 JSON 카탈로그(--save-catalog)를 쓰는 점도 운영상 장점입니다.
| 스킬 간 분류 | 코사인 점수 | 심각도·기본 동작 |
|---|---|---|
EXACT_DUPLICATE |
≥ 0.95 | CRITICAL — 차단 |
HIGH_SIMILARITY |
≥ 0.90 | HIGH — 차단 |
SIMILAR |
≥ 0.75 | MEDIUM — 권고 (기본 보고 임계값 0.75) |
LOOSELY_RELATED |
≥ 0.50 | LOW — 권고 |
DISTINCT |
< 0.50 | INFO — 기본 보고 대상 아님 |
기본은 이름·설명만 임베딩하고, --full-body를 주면 SKILL.md 전체를 512토큰 청크(64토큰 겹침)로 평균 풀링합니다. 트레이드오프는 명확합니다. 이름·설명만 비교하면 싸고 빠르지만 “설명은 다른데 본문이 같은” 포크형 스킬을 놓칠 수 있고, 전체 본문은 반대로 공통 보일러플레이트 때문에 점수가 부풀 수 있습니다. 또 임베딩 모델이 바뀌면 점수 분포도 바뀌므로, 임계값을 조직 표준으로 고정하기 전에 자체 카탈로그로 보정하는 편이 안전합니다. 스킬 내용을 외부로 보내면 안 되는 환경을 위해 문서에 “완전 로컬” 공급자 구성 레시피가 따로 있습니다.
Tier 3 해부: 스킬 있음/없음 A/B와 Skill Lift
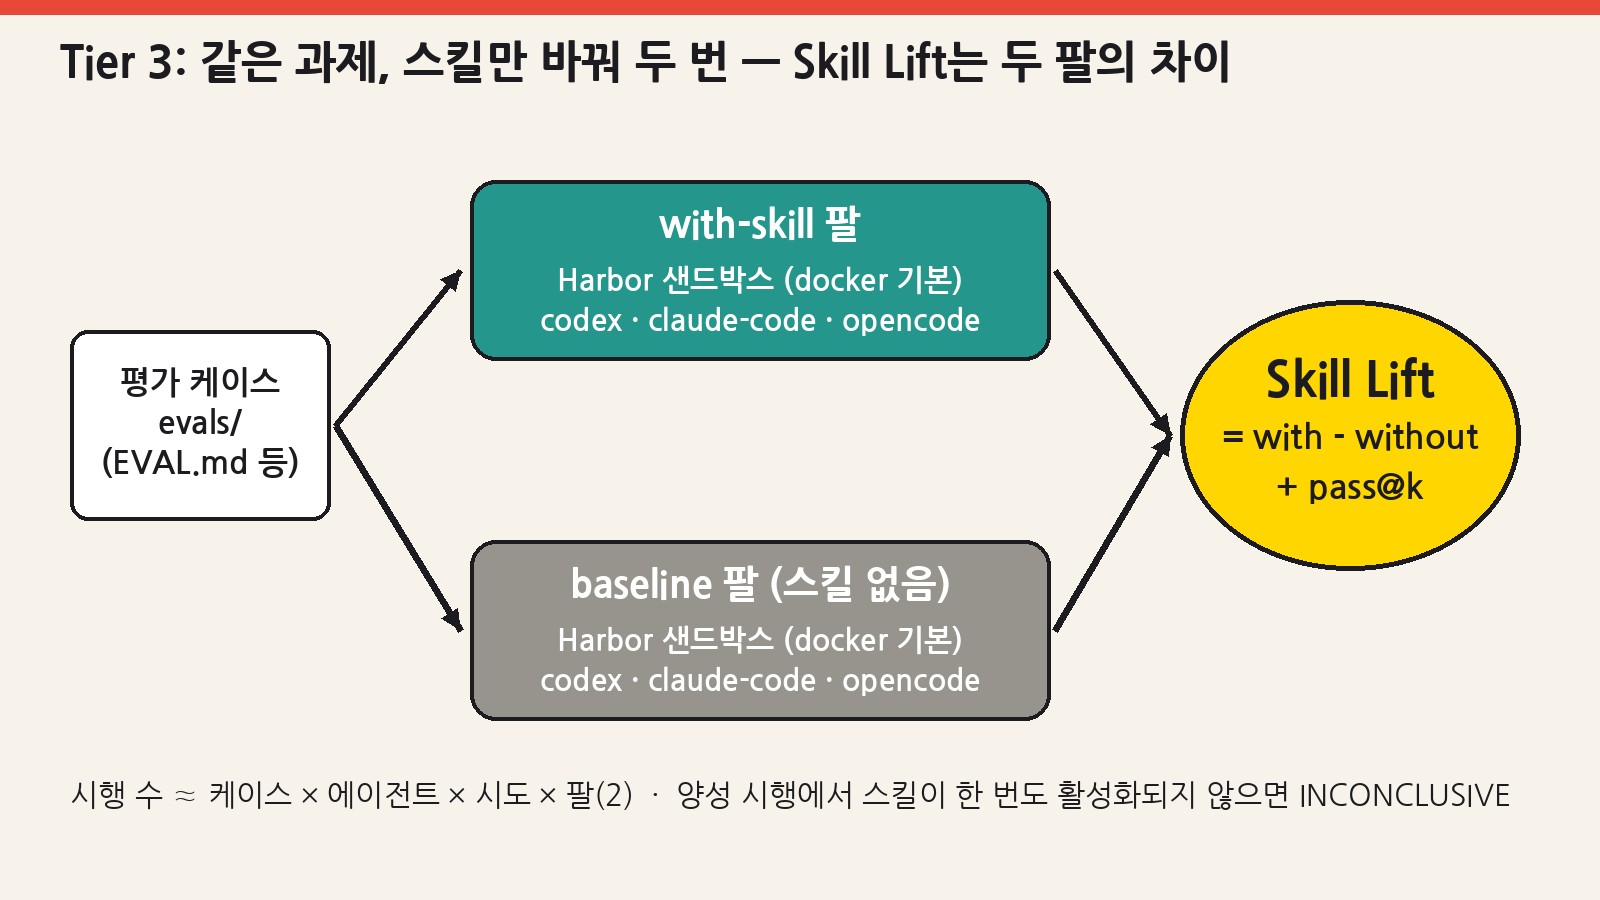
Tier 3가 이 도구의 존재 이유입니다. 같은 평가 케이스를 실제 에이전트(codex, claude-code, opencode, 실험적 hermes)로 두 번 돌립니다. 한 번은 스킬을 설치한 with-skill 팔, 한 번은 스킬 없는 baseline 팔입니다. 두 팔 모두 오픈소스 에이전트 평가 프레임워크 Harbor 환경 안에서 실행되므로, 실험 변수는 스킬 하나뿐이 됩니다. 두 팔 점수의 부호 있는 차이가 Skill Lift이고, 시도를 여러 번 하면 pass@k가 신뢰도 신호로 더해집니다.
| 리포트 차원 | 답하는 질문 |
|---|---|
| Security | 써도 안전한가? |
| Correctness | 해야 할 일을 하는가? |
| Discoverability | 로드돼야 할 때 로드되는가? |
| Effectiveness | 스킬이 있을 때 더 나은가? |
| Efficiency | 라우팅이 맞고 도구를 생산적으로 쓰는가? |
실무적으로 가장 값진 장치는 활성화(activation) 검증입니다. 양성 with-skill 시행 전부에서 스킬 활성화 점수가 0이면 결과는 “INCONCLUSIVE: skill never activated”로 처리되고 lift 비교가 생략됩니다. 스킬이 안 불렸는데 baseline과 비슷한 점수를 “효과 없음”으로 오독하는 것을 막는 장치입니다. 데이터셋은 Explicit(이름을 부르는 요청), Implicit(이름 없이 범위 안 요청), Negative(무관한 요청, expected_skill: null), Edge(경계 입력) 네 묶음으로 구성하길 권합니다. 문서는 “정답을 맞혔다는 것만으로 스킬을 썼다는 증거가 되지 않는다”고 분명히 적고, 관측은 수집기의 신뢰할 수 있는 궤적 증거로만 invoked/not_invoked/unknown을 매깁니다.
환경은 기본 docker 외에 kata, local(OS 샌드박스 정책 하의 호스트 실행), 그리고 Harbor 네이티브 백엔드(daytona, e2b, modal, runloop, gke, ec2 등)를 --env-mode로 고릅니다. 다만 SkillEvaluator가 직접 설정을 문서화한 것은 docker·kata·local뿐이고, 나머지는 Harbor extra 설치 후 doctor --env-mode <mode>로 확인하라는 입장입니다. 0.8.0에서는 완료된 Tier 3 실행 하나를 근거로 터미널 대화를 여는 tier3 feedback RUN_DIR, 판정 모델 시도 전부를 남기는 judge_attempts.json, 실행 간 추적용 안정 finding ID가 들어왔고, 이후 Unreleased에는 케이스·에이전트별 토큰 사용량 표시가 추가됐습니다.
비용 감각: 문서가 제시하는 시행량 추정식은 평가 케이스 × 에이전트 × 시도 × 팔(2)입니다. 각 시행은 여러 번의 에이전트 모델 호출을 포함하고, 표준 채점은 평가 모델 호출을, 데이터셋 생성은 추가 호출을 더합니다. SkillEvaluator는 고정 달러 추정을 하지 않으므로, 케이스 10개 × 에이전트 2종 × 시도 3회면 이미 120회 에이전트 실행이라는 식으로 직접 셈해 두어야 합니다.
설치·실행: 문서 기준 명령어
# 소스 체크아웃 (uv가 Python 3.13과 의존성을 준비)
git clone --depth 1 https://github.com/NVIDIA/SkillEvaluator.git
cd SkillEvaluator

# 1) 키 없이: 정적 품질 점수
uv run --python 3.13 skillevaluator quality-check \
  src/skillevaluator/tier3/reference_skills/text-analyzer \
  -r cli -r json -o reports/first-quality

# 2) Tier 1 전체 (security extra로 Bandit·pip-audit 포함)
uv run --python 3.13 --extra security skillevaluator tier1 ./my-skill --no-llm

# 3) NVIDIA Build로 LLM 루브릭
export SKILL_EVAL_LLM_PROVIDER=nv_build
export NVIDIA_API_KEY='nvapi-...'
uv run --python 3.13 --extra llm skillevaluator rubric-eval ./my-skill -r cli -r json -o reports/first-build

# 4) Tier 2 (스킬 내부 + 카탈로그 비교)
uv run --extra tier2 skillevaluator tier2 ./my-skill --catalog ./skill-catalog.json

# 5) 3개 Tier 통합 (준비 상태 점검 후)
uv run --python 3.13 --extra all skillevaluator doctor --env-mode docker
uv run --python 3.13 --extra all skillevaluator validate ./my-skill    # --tiers 1,2 로 라이브 평가 생략

# 6) Tier 3 평가 케이스 확장 생성
uv run --python 3.13 --extra tier3 skillevaluator tier3 create-eval-dataset ./my-skill --full

# 7) CI 온보딩 (체크아웃한 저장소 안에서)
pip install --upgrade skillevaluator
skillevaluator ci init
NVIDIA Build 공급자의 기본 모델은 문서상 nvidia/nemotron-3-super-120b-a12b로, 평가 채팅·Tier 3 기본 OpenCode 에이전트·표준 판정에 공통으로 쓰입니다. 공급자 미지정 상태에서 자격 증명이 여러 개 export돼 있으면 자동 선택이 실패하므로, CI에서는 SKILL_EVAL_LLM_PROVIDER를 항상 명시하는 편이 낫습니다.
박스에서 직접 돌려 봤습니다 (GPU·Docker 없음)
MoricWorld 작업 박스(Linux, GPU 없음, Docker 데몬 없음)에서 v0.8.0 체크아웃(커밋 b64e351, main)을 uv로 실행했습니다. API 키를 쓰지 않았기 때문에 LLM 루브릭·Tier 2·Tier 3는 돌리지 않았고, 아래는 실제로 관측한 결과만 적었습니다.
| 실행 | 결과 | 메모 |
|---|---|---|
skillevaluator --version |
0.8.0 | uv가 가상환경 생성, 기본 의존 17개 설치 |
quality-check (text-analyzer) |
PASS, 84.5/100 (B), 종료 코드 0, 약 2.4초 | Correctness 70 · Discoverability 85 · Reliability 95 · Efficiency 100. README의 84.5(B)와 일치 |
같은 명령, -o ../reports/... |
검사는 PASS인데 종료 코드 1 | “Unsafe report output path … parent traversal is not allowed” — 리포트 출력 경로에 ..를 쓰면 거부 |
tier1 --no-llm (기본 설치) |
INCOMPLETE, 종료 코드 1 | 10개 중 9개 통과, Code Risk Analysis가 “bandit not installed”로 미완료. SkillSpector·Gitleaks 8.30.0은 자동으로 받아 실행 |
--extra security 후 tier1 --no-llm |
PASS, 종료 코드 0, 약 4.3초 | 10/10 통과, 2개 N/A(시맨틱 버전 라벨 없음·의존성 파일 없음). 게시 적격성은 여전히 Incomplete |
관찰 포인트는 두 가지입니다. 첫째, 기본 설치만으로 tier1을 돌리면 Bandit이 없어 정직하게 실패합니다. CI에서 “키리스니까 기본 설치면 되겠지” 하고 넣으면 바로 빨간불이 들어오니, security extra 또는 공식 CI 번들 이미지를 쓰는 것이 맞습니다. 둘째, 품질 발견 사항(버전 필드 누락, “언제 쓰는지” 문구 부재, 선행 조건 미기재 등)은 모두 MEDIUM/LOW 권고라 게이트를 막지 않았습니다. 레퍼런스 스킬조차 7건의 권고를 받는다는 건, 기존 사내 스킬에 처음 돌리면 권고가 꽤 쏟아질 것이라는 뜻이기도 합니다.
CI 도입 설계
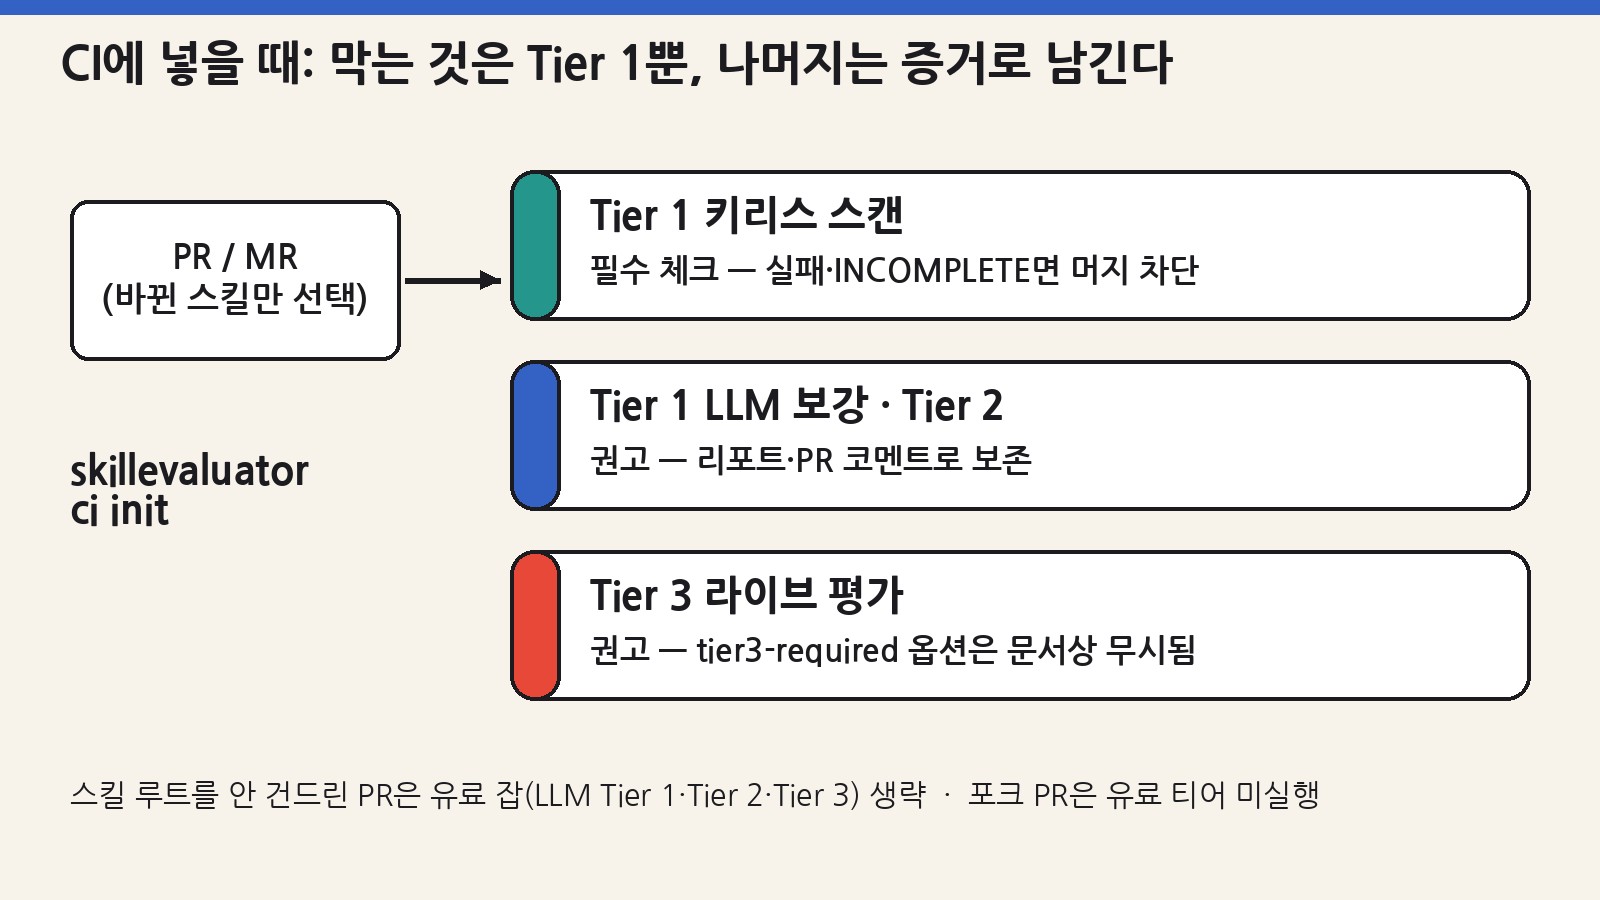
skillevaluator ci init은 체크 종류와 선택적 호스팅 피드백을 고르게 한 뒤 설정 PR을 만들어 줍니다. 로컬 CLI 없이 ci/bundles/0.8.0/의 GitHub(skill-checks.yml, 선택적 publish-skill-reports.yml)·GitLab(gitlab-skill-checks.yml) 템플릿을 복사해도 됩니다. 전 Tier CI 경로에서 필수 게이트는 Tier 1뿐이고 Tier 2·3은 권고입니다. 문서에 따르면 tier3-required 입력과 SKILL_EVAL_TIER3_REQUIRED 변수는 사용 중단돼 true여도 무시됩니다. 기본 scan-mode: auto에서는 스킬 루트를 건드리지 않은 PR이 유료 잡(LLM 보강 Tier 1, Tier 2, Tier 3)을 건너뛰고, GitHub 포크 PR은 유료 티어를 아예 돌리지 않습니다. 정적 CI 체크에는 모델 키가 주입되지 않는 것도 시크릿 노출 측면에서 합리적인 기본값입니다.
비슷한 도구와 비교
| 도구 | 주 대상 | 정적 보안 | 중복·유사도 | 라이브 A/B | CI 게이트 | 언제 고르나 |
|---|---|---|---|---|---|---|
| NVIDIA SkillEvaluator | Agent Skills·규칙·워크플로·플러그인 | SkillSpector·Gitleaks·Semgrep·Bandit·유니코드·PII | 임베딩 + LLM 판정(내부), 로컬 카탈로그(스킬 간) | Harbor로 with/without 비교, Skill Lift·pass@k | GitHub·GitLab 번들, Tier 1 필수 | 스킬을 조직 단위로 배포·검수할 때 |
| NVIDIA SkillSpector | 스킬 보안 스캔 | 전문(프롬프트 인젝션·유출 패턴 등) | 없음 | 없음 | 스캐너 단독 사용 | 보안 스캔만 필요할 때 (SkillEvaluator Tier 1이 내부적으로 사용) |
| Harbor | 에이전트 평가 일반 | 범위 밖 | 범위 밖 | 과제·환경·에이전트 실행 프레임워크 | 직접 구성 | 스킬이 아니라 에이전트·모델 자체를 벤치마크할 때 |
| promptfoo 류 프롬프트 평가 도구 | 프롬프트·모델 출력 | 레드팀 시나리오 중심 | 없음 | 프롬프트·모델 변형 간 비교 | CI 연동 가능 | 스킬 패키지가 아닌 단일 프롬프트 품질을 볼 때 |
| 수작업 리뷰 + 단위 테스트 | 스킬 스크립트 | 리뷰어 역량 의존 | 사람이 판단 | 보통 없음 | 스크립트 테스트만 | 스킬 수가 한 자릿수일 때 |
운영상 주의점과 한계
- 실험적 지원 수준: README가 “Experimental, SLA 없음”을 명시합니다. 0.6.0(10-20)에서 0.8.0(11-05)까지 2주 남짓에 마이너 릴리스가 연달아 나왔고 CHANGELOG도 22만 바이트가 넘습니다. 리포트 JSON 필드와 CI 입력이 바뀔 수 있으니 버전을 고정하세요.
- Tier 3 비용·재현성: 실제 에이전트 CLI(문서 기준 Harbor가 Claude Code 2.1.292, Codex 0.161.0, OpenCode 1.19.5를 설치)를 돌리므로 모델 버전·추론 강도가 바뀌면 점수도 흔들립니다. 리포트의 run_config·dataset_snapshot과 함께 보관해야 비교가 성립합니다.
- 데이터 반출: rubric-eval과 Tier 2 내부 분석은 스킬 본문을 공급자 모델로 보냅니다. 사내 비공개 스킬이라면 로컬 공급자 구성이나
--tiers 1+--no-llm부터 시작하세요. Tier 3 원시 궤적에는 과제 입력·모델 출력이 남을 수 있어 비공개 보관이 권고됩니다. - 엄격한 INCOMPLETE 처리: 스캐너가 없거나 실패하면 통과로 치지 않습니다. 안전하지만, 러너 이미지에 스캐너가 빠지면 CI가 전부 붉어집니다.
skillevaluator doctor --tier 1을 파이프라인 첫 단계로 두는 것이 좋습니다. - 임계값은 출발점: 0.80(내부)·0.75(스킬 간 보고)·품질 70점은 기본값일 뿐입니다. 임베딩 모델과 조직 스킬 문체에 따라 오탐·미탐이 달라지므로 첫 달은 Tier 2를
--no-block-on-dedup로 권고 운용하며 분포를 보는 편이 현실적입니다. - Hermes·클라우드 백엔드: Hermes는 Docker + NVIDIA Build 조합만 지원하는 실험 옵션이고, docker·kata·local 외 환경은 SkillEvaluator 쪽 문서가 얇습니다.
누가 도입하면 좋은가
| 상황 | 권장 시작점 | 판단 |
|---|---|---|
| 사내 스킬 저장소를 여러 팀이 기여 | ci init으로 Tier 1 필수 게이트 + Tier 2 권고 |
적극 권장 — 공급망·중복 관리 효과가 즉시 남 |
| 외부 공개용 스킬·플러그인 배포자 | Tier 1 전체 + 대표 케이스로 Tier 3 Skill Lift 측정 | 권장 — “효과 있음”을 숫자로 증명할 수단 |
| 개인이 스킬 몇 개를 쓰는 개발자 | quality-check만 로컬에서 |
선택 — 품질 피드백용으로는 유용, 전체 파이프라인은 과함 |
| 스킬 내용을 외부로 못 보내는 환경 | --tiers 1 --no-llm + 로컬 임베딩 공급자 |
조건부 — Tier 3는 로컬 모델·샌드박스 준비가 관건 |
| 에이전트·모델 자체를 벤치마크하려는 팀 | Harbor 직접 사용 | 대상이 다름 — SkillEvaluator는 “스킬의 기여분”을 재는 도구 |
정리하면 SkillEvaluator는 “스킬도 테스트 없이 머지하지 않는다”는 규율을 도구로 만든 프로젝트입니다. 정적 검사는 오늘 바로 키 없이 CI에 넣을 수 있을 만큼 성숙했고, Tier 3의 Skill Lift는 비용과 재현성 관리가 필요하지만 스킬이 정말 일을 하는지를 증거로 보여 주는 거의 유일한 방법입니다. 스킬이 늘어나는 속도를 생각하면, 첫 단계는 거창한 라이브 평가가 아니라 --extra security로 Tier 1을 돌려 보는 4초짜리 실험이면 충분합니다.